

Qwen 4 Max mérite quelques jours d'usage concret dans ton outil de code, et rien de plus pour l'instant. La preview (qwen4-max-preview) a 1M de tokens de contexte et 393 216 tokens de sortie max, mais Alibaba n'a publié ni benchmarks ni prix au token. Elle ne tourne que via l'abonnement Token Plan, qui interdit les backends d'app, et elle est retirée le 25 novembre 2026. Essaie-la pendant que les crédits coûtent 20 % du tarif standard. Construis plutôt sur Qwen 3.8 Max. Pour le support, un agent de helpdesk comme eesel tourne sur des modèles stables, et avec le CLI eesel un agent de code peut charger tes articles d'aide et tester des réponses avant que quoi que ce soit passe en direct.
Qu'est-ce que Qwen 4 Max ?
Qwen 4 Max est le premier modèle de la génération Qwen 4 d'Alibaba, et pour l'instant il n'existe qu'en preview. La documentation du modèle d'Alibaba qualifie qwen4-max-preview de "modèle phare multimodal de nouvelle génération de la famille Qwen", conçu pour le code, le travail de bureau, le design frontend et les tâches d'agents.
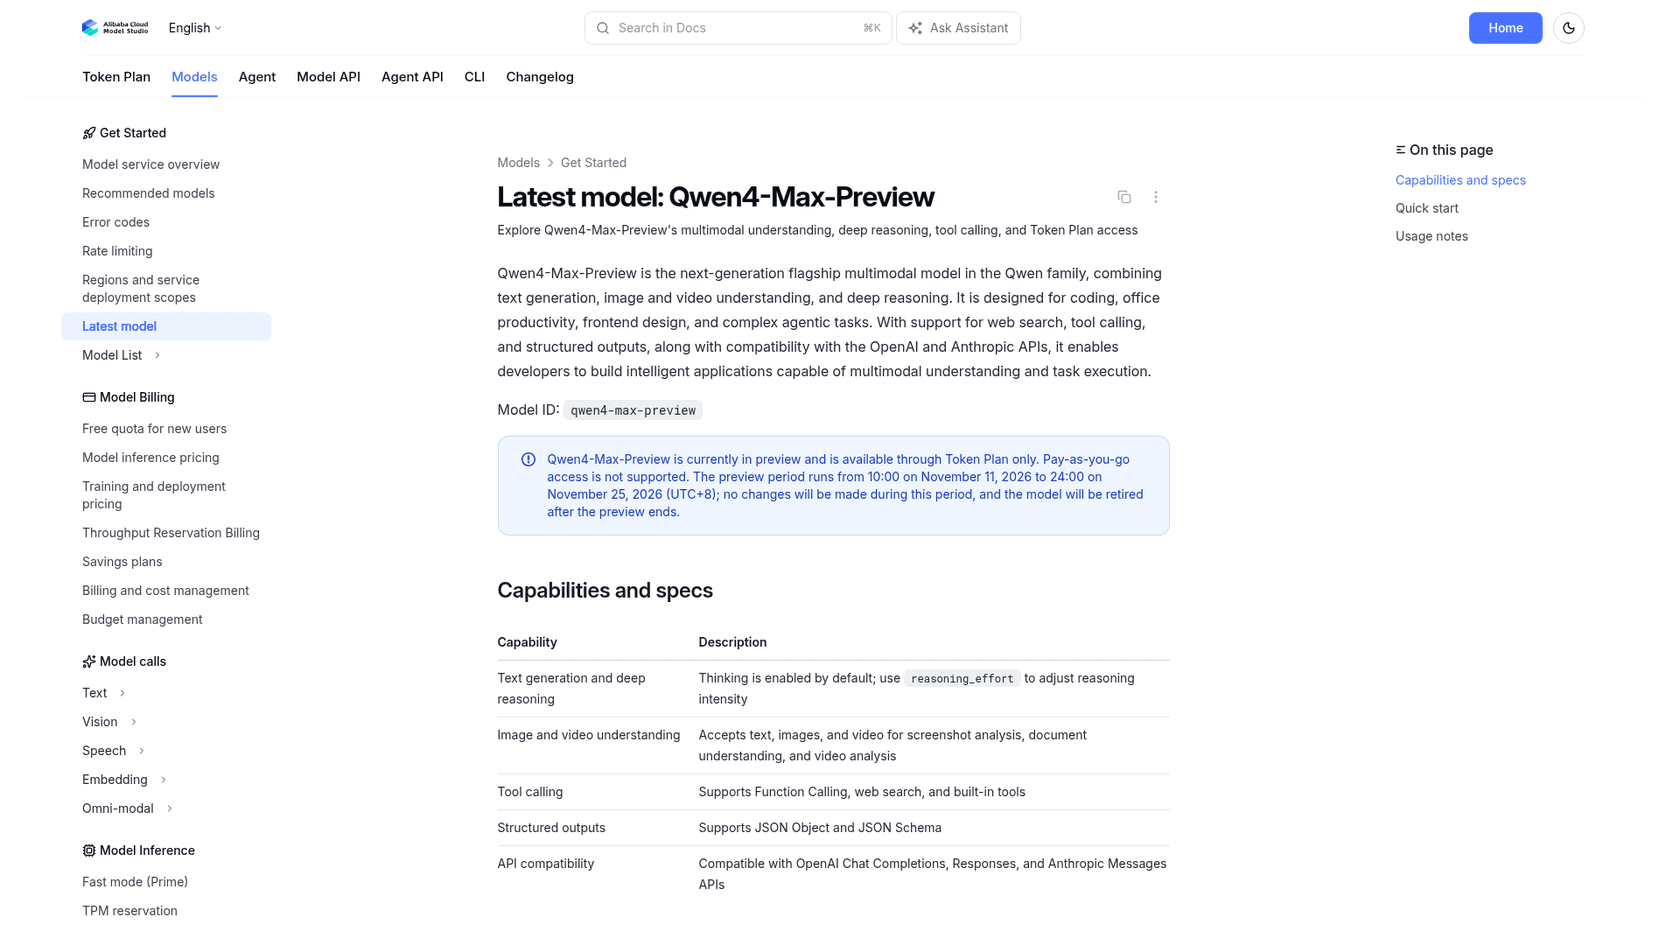
Elle est passée en direct le 11 novembre 2026 à 10h00 heure de Pékin. Voici ce que confirme la documentation :
| Spécification | Qwen4-Max-Preview |
|---|---|
| ID du modèle | qwen4-max-preview (alias qwen4.0-max-preview) |
| Entrée | Texte, images et vidéo |
| Longueur de contexte | 1M de tokens |
| Sortie max | 393 216 tokens, partagés entre réflexion et réponse |
| Réflexion | Activée par défaut, low, medium ou xhigh (par défaut) |
| Outils | Appel de fonctions, recherche web, outils intégrés |
| Sortie structurée | JSON Object et JSON Schema |
| Formats d'API | OpenAI Chat Completions, Responses, Anthropic Messages |
| Accès | Uniquement Token Plan, pas de paiement à l'usage |
| Fenêtre de preview | Du 11 au 25 nov. 2026 (UTC+8), puis retrait |
Une partie de mon travail consiste à vérifier ce qu'un lancement promet réellement avant que quiconque ne construise dessus. Alors avant de parler du ressenti du modèle, voici ce qui manque. Comparé au lancement de Qwen 3.8 Max, celui-ci est beaucoup plus maigre.
Qu'est-ce qu'Alibaba a laissé de côté ?
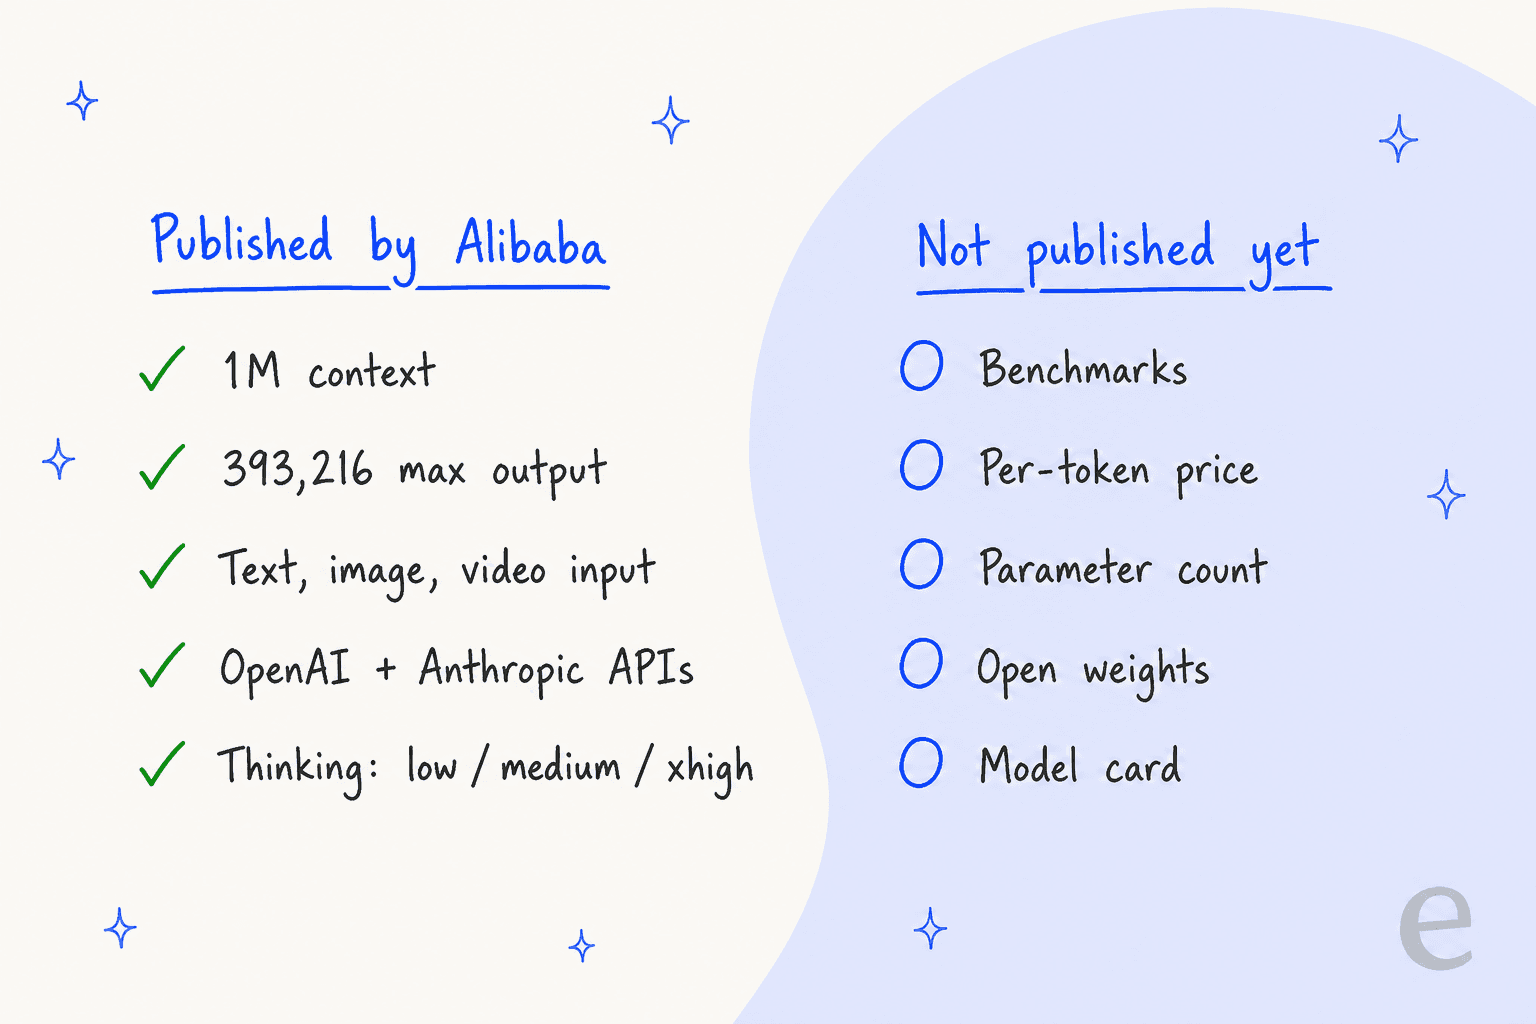
Alibaba a publié des capacités et des limites, mais pas les chiffres qu'on utilise normalement pour juger un modèle. La page de documentation n'a pas de tableau de benchmarks. Il n'y a pas de nombre de paramètres, pas de model card, pas de poids ouverts et pas de prix au token. Quand j'ai vérifié le 12 novembre, Qwen 4 Max n'avait non plus de page sur Artificial Analysis, alors que Qwen 3.8 Max y figure.
Donc tout graphique "Qwen 4 Max obtient X" que tu vois cette semaine vient d'un tiers testant la preview, pas d'Alibaba. Ce n'est pas accablant, les previews sortent souvent ainsi. Mais cela veut dire qu'un avis aujourd'hui est un avis sur les conditions d'accès, pas sur l'intelligence. Le fil de lancement sur Hacker News disait la même chose :
"No benchmarks yet. The smaller Qwen models are extremely popular for people running things locally, yet I don't know absolutely anyone running Qwen Max."

Cette deuxième phrase compte aussi. Les modèles Qwen que les gens adorent sont les petits modèles ouverts comme Qwen 3.8 Flash Next et le 27B. Le niveau Max n'est disponible qu'hébergé, et cette preview ne change rien à cela.
Comment obtenir l'accès, et combien ça coûte ?
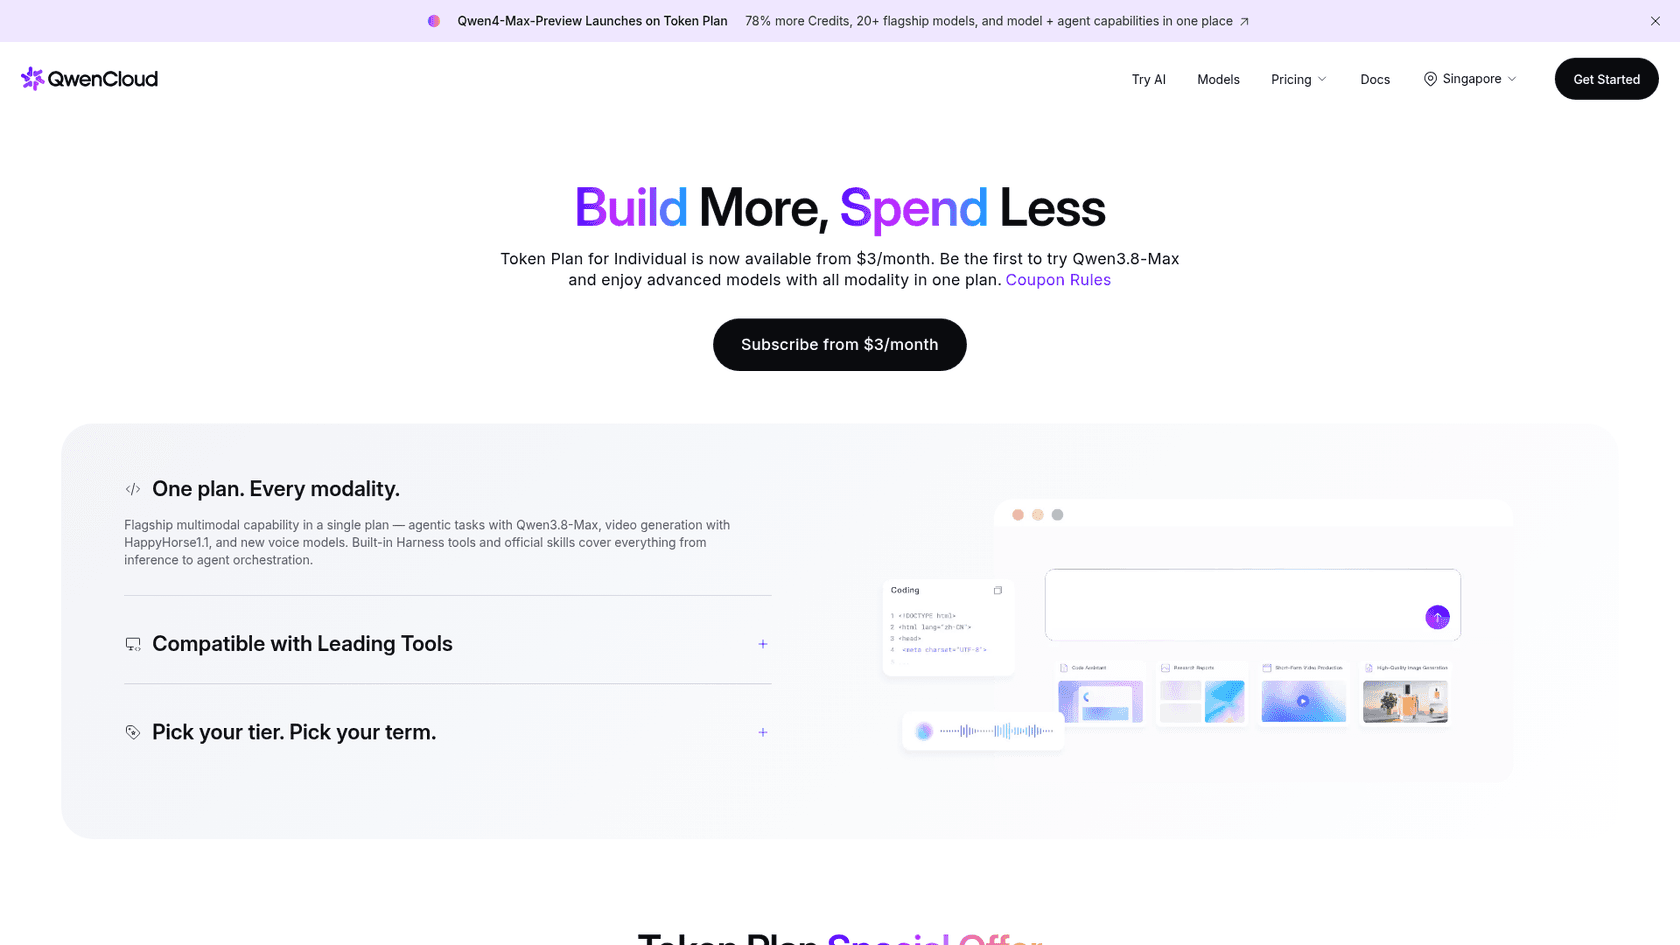
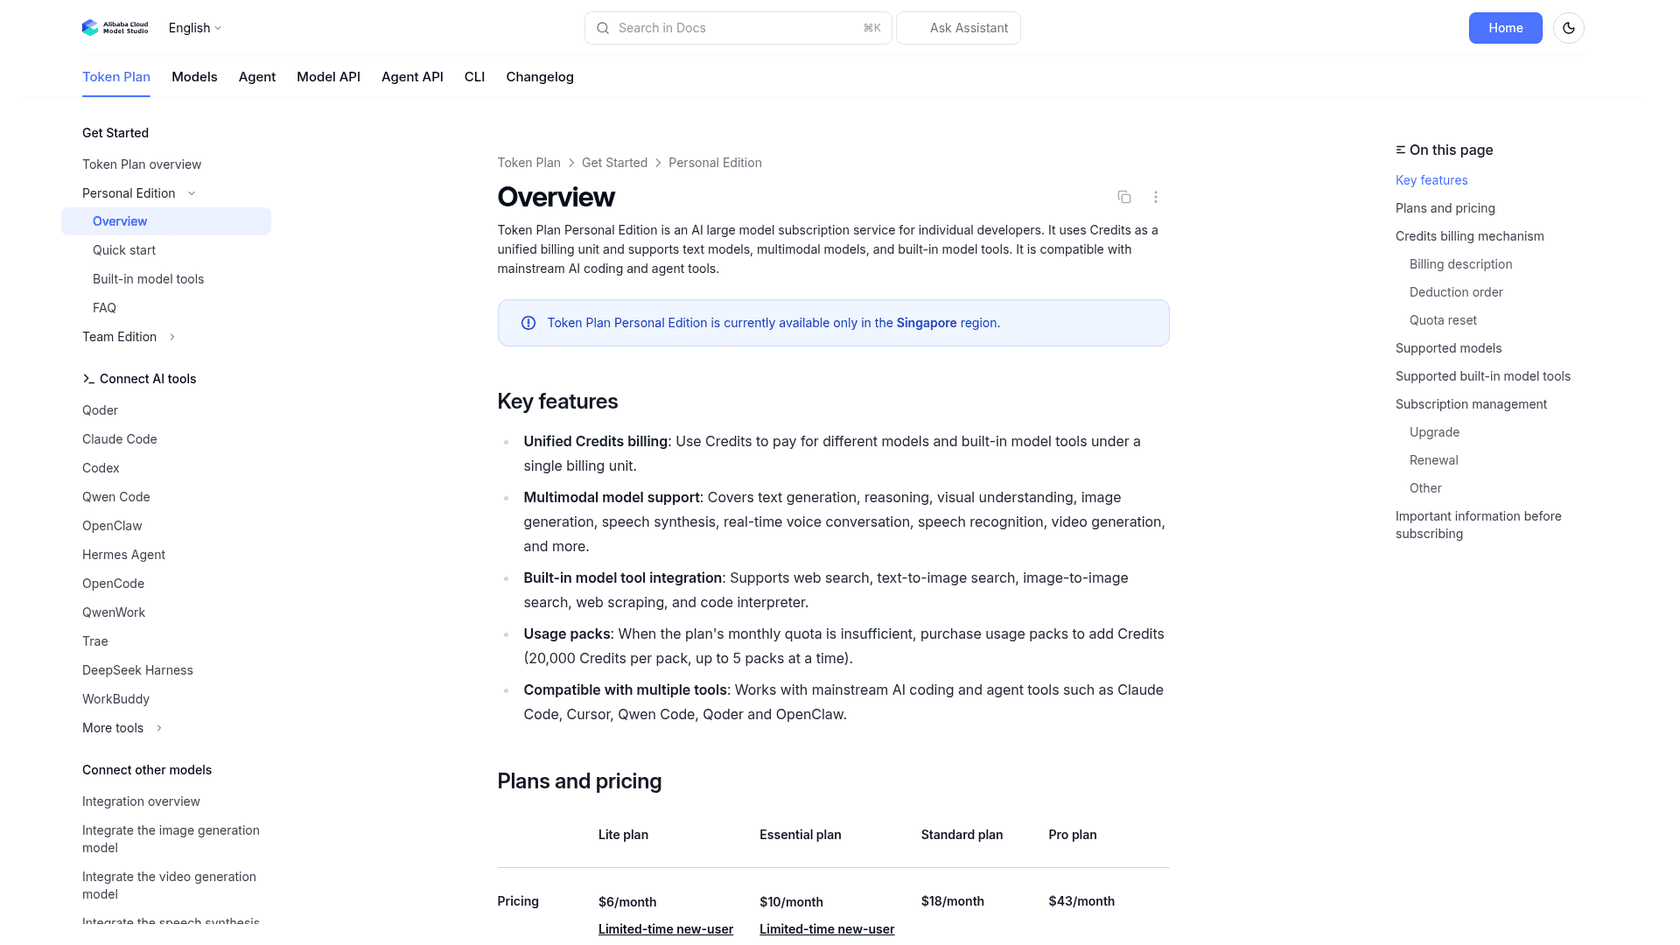
Tu obtiens Qwen 4 Max via le Token Plan d'Alibaba, un abonnement mensuel payé en crédits. Il n'y a pas d'option de paiement à l'usage pour la preview. Les prix de la Personal Edition viennent de la documentation du Token Plan d'Alibaba :
| Plan | Prix catalogue | Prix nouvel utilisateur | Crédits mensuels | Agents simultanés |
|---|---|---|---|---|
| Lite | 6 $/mois | 3 $/mois | 20 000 | 1-2 |
| Essential | 10 $/mois | 5 $/mois | 45 000 | 2-3 |
| Standard | 18 $/mois | - | 80 000 | 3-4 |
| Pro | 43 $/mois | - | 200 000 | 6-8 |
Le prix nouvel utilisateur court jusqu'au 30 novembre 2026 pour les comptes qui n'ont jamais acheté d'abonnement Personal. Les packs supplémentaires coûtent 15 $ pour 20 000 crédits, et tu peux en détenir jusqu'à cinq. La Personal Edition est réservée à la région Singapour, et l'inférence tourne dans le déploiement Global d'Alibaba, donc tes prompts traversent des frontières.
Voici le piège pour qui essaie de comparer les coûts. Alibaba dit que les crédits par requête sont "déterminés dynamiquement selon le type de modèle, l'usage de tokens, le mode de réflexion et les appels d'outils", et ne publie pas de taux crédits par token pour Qwen 4 Max. Tu découvres le coût d'un appel sur la page d'usage de la console, après l'avoir fait. Tu ne peux donc pas chiffrer un travail à l'avance comme avec Qwen 3.8 Max, qui affiche 2 $ en entrée et 6 $ en sortie par 1M de tokens sur sa page modèle QwenCloud.
La réduction preview, et pourquoi "la nuit" c'est ta journée de travail
Pendant la preview, Qwen 4 Max consomme les crédits à 20 % du tarif standard. Entre 22h00 et 08h00 heure de Pékin, tu as 60 % de réduction supplémentaire, donc 8 % du tarif standard.
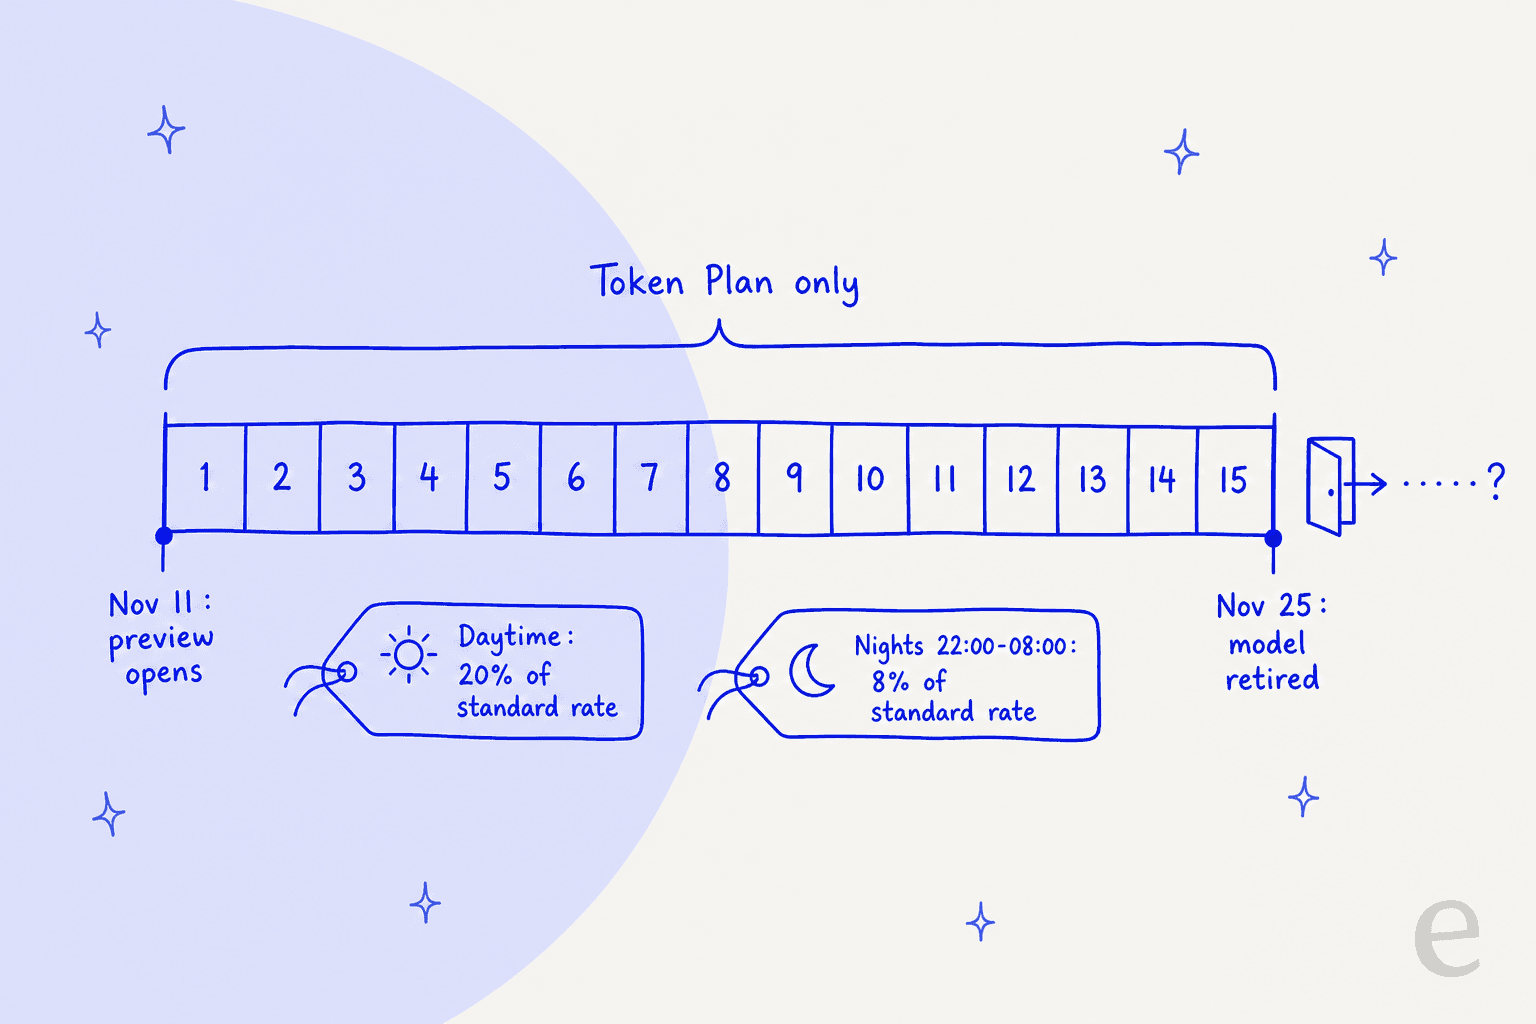
Le détail que presque tout le monde manque : 22h00 à 08h00 à Pékin, c'est 14h00 à 00h00 UTC. Ça fait 9h à 19h sur la côte est des États-Unis. Si tu es dans les Amériques, le tarif le plus bas couvre toute ta journée de travail. Un testeur précoce sur Hacker News a fait la même remarque :
"By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!"
Peux-tu construire sur Qwen 4 Max ?
Non, et c'est la partie de l'avis qui compte le plus si tu diriges un produit ou une équipe de support. Deux choses l'excluent.
D'abord, le modèle est temporaire. La documentation d'Alibaba dit qu'"aucun changement ne sera apporté pendant cette période, et le modèle sera retiré à la fin de la preview". Tout ce que tu construis sur qwen4-max-preview cesse de fonctionner après le 25 novembre.
Ensuite, le Token Plan interdit justement l'usage dont tu aurais besoin. Les conditions d'abonnement disent que le plan est "prévu uniquement pour un usage interactif au sein d'outils de code et d'agents", et qu'il "ne doit pas être utilisé pour des scripts d'automatisation, des backends d'application maison, ni aucun scénario d'appels par lots non interactifs". Les appels hors de ce cadre peuvent faire suspendre l'abonnement ou bannir la clé API.
Donc un chatbot de support, un classificateur de tickets ou toute API de service client IA branchée sur cette clé enfreindrait les règles dès le premier jour. Ce que le plan autorise, c'est d'utiliser le modèle dans Claude Code, Cursor, Qwen Code, OpenAI Codex, Cline, OpenCode ou OpenClaw, tous listés comme outils supportés.
Faut-il toucher à Qwen 4 Max cette semaine ?
Ouvre celle qui te ressemble.
Je code dans Claude Code, Cursor ou Qwen Code tous les jours
Oui. Un plan Lite à 3-6 $ te donne deux semaines avec un contexte de 1M à 20 % du tarif de crédits standard. Teste-le sur une vraie tâche dont tu connais déjà la réponse, et compare-le à ton modèle habituel.
Je veux le mettre derrière mon app ou un bot de support
Non. Le Token Plan interdit les backends d'app, et le modèle est retiré le 25 novembre. Utilise maintenant un modèle au paiement à l'usage comme Qwen 3.8 Max, et regarde à nouveau Qwen 4 Max quand une version complète avec un prix sortira.
Je choisis un modèle pour la feuille de route de mon entreprise
Attends. Sans benchmarks ni grille tarifaire, il n'y a rien à mettre dans un modèle de coûts. Note la limite de sortie de 393 216 tokens et le nouveau comportement de max_tokens, et reviens quand Alibaba publiera des chiffres.
J'héberge moi-même des modèles Qwen
Passe ton tour. Il n'y a pas de poids ouverts pour la preview. Ce qu'il faut surveiller, ce sont les modèles Qwen 4 plus petits, car ce sont généralement ceux qui atteignent Hugging Face.
Qu'est-ce qui a changé pour les développeurs ?
Deux changements techniques méritent d'être connus avant de pointer un outil vers ce modèle.
Le plus important est le fonctionnement de max_tokens. À partir de qwen4-max-preview, l'avis de compatibilité d'Alibaba dit que max_tokens équivaut désormais à max_completion_tokens, limitant donc la réflexion et la réponse finale ensemble. La réflexion est activée par défaut en xhigh. Si ta configuration a dimensionné max_tokens pour la réponse seule, un raisonnement long peut consommer le budget et couper ta réponse. Les anciens modèles Qwen gardent l'ancien comportement, donc ça pique au changement.
Le deuxième est la réflexion multi-tours. Chat Completions active preserve_thinking par défaut, et la documentation demande de renvoyer la réflexion précédente dans le champ reasoning_content, pas collée dans content. Les outils conçus pour les formats Anthropic ou OpenAI ne le font peut-être pas automatiquement, ce qui vaut la peine d'être vérifié si de longues sessions d'agents déraillent.
Le plafond de sortie lui-même est un vrai saut : 393 216 tokens, trois fois les 131 072 de Qwen 3.8 Max. Pour une génération de code longue ou de grosses refactorisations en une seule passe, c'est la spécification que je testerais en premier.
Quel est le ressenti à l'usage ?
Les premiers retours sont mitigés et portent surtout sur la vitesse, ce qui correspond à un modèle dont la réflexion est en xhigh par défaut. Le testeur Hacker News cité plus haut a dit que "avec xhigh thinking la vitesse est correcte, ça semble un peu plus lent que Terra", en référence au GPT-6.1 Terra d'OpenAI. Sur X, le lancement a pris un tour sceptique en quelques heures :
"Qwen-4-max is live it seems. From what I've heard so far (rumors), Qwen 4 is disappointing."
Remarque le mot "rumors" (rumeurs). Une réponse sous ce post a répliqué avec un usage réel :
"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
Les deux sont précoces, et aucun n'est un benchmark. Ma lecture honnête : personne hors d'Alibaba ne sait encore à quel point Qwen 4 Max est bon, et la fenêtre de 14 jours plus le "aucun changement pendant la preview" signifie que le modèle que tu testes est figé. Si tu l'essaies, essaie-le sur ton propre travail, avec une tâche déjà résolue avec Claude Fable 5.2 ou GPT-6.1 Sol, pour avoir quelque chose de réel à comparer.
Comment se compare-t-il aux autres modèles ?
Voici comment la preview se positionne face aux modèles auxquels les gens la compareront vraiment. Les prix viennent de la page propre de chaque fournisseur, et j'ai marqué ce qui n'est pas publié.
| Modèle | Statut | Prix | Sortie max | Scores indépendants |
|---|---|---|---|---|
| Qwen 4 Max preview | Preview, retrait le 25 nov. | Crédits Token Plan uniquement | 393 216 | Aucun pour l'instant |
| Qwen 3.8 Max | Publié | 2 $ / 6 $ par 1M | 131 072 | Oui |
| Kimi K3 | Publié | Tarifs Kimi K3 | Voir fournisseur | Oui |
| DeepSeek V4.1 Flash | Publié, aussi sur Token Plan | Tarifs DeepSeek V4.1 Flash | Voir fournisseur | Oui |
| GLM 5.3 Flash | Publié | Tarifs GLM 5.3 Flash | Voir fournisseur | Oui |
Le tableau dit ce que dit le reste de cet avis. Chaque autre ligne est quelque chose que tu peux chiffrer et vérifier. Qwen 4 Max est celui que tu peux seulement essayer.
Qu'est-ce que ça veut dire pour une équipe de support ?
Pour une équipe de support, Qwen 4 Max est un modèle à surveiller, pas un à brancher sur ton helpdesk. La question qui revient chaque semaine de lancement est de savoir s'il faut basculer le bot de support sur le nouveau modèle. Avec celui-ci, la réponse est facile, car les règles et la date de retrait la décident pour toi.
Mais le point le plus large vaut pour chaque lancement. Un modèle brut, quelle que soit sa force, n'est pas un agent de support. L'agent, c'est tout ce qui l'entoure : ton centre d'aide, les tickets passés, les macros, les règles sur quand transférer à une personne, et des tests avant que quoi que ce soit n'atteigne un client. C'est la couche que le coéquipier IA d'eesel pour le helpdesk est conçu pour être. Il rejoint ta file existante sur Zendesk ou Freshdesk, apprend de tes tickets passés, et est simulé contre des conversations historiques avant de répondre à qui que ce soit.
Deux de nos clients montrent à quoi ça ressemble en pratique :
- smava, un comparateur de prêts allemand, fait tourner eesel sur Zendesk pour deux marques. En un mois, il a traité 27 000 tickets, catégorisé 14 600 et préparé 15 300 brouillons de réponse en allemand, à partir de 820 macros et articles de centre d'aide synchronisés.
- SamCart fait tourner un agent sur les tickets Freshdesk et un autre sur le chat de son site, répondant à partir de 280 articles de centre d'aide.
Aucun de ces montages ne dépend du fait que le modèle de la semaine gagne un classement. Si tu veux voir ce qu'un modèle peut faire avec ton propre contenu de support, mes guides sur connecter Claude à ton helpdesk et arrêter les hallucinations IA dans le support sont un meilleur usage de ton après-midi qu'une preview qui est retirée dans deux semaines.
Mon verdict sur Qwen 4 Max
La preview de Qwen 4 Max est un essai, pas un produit. Les spécifications confirmées sont solides, surtout le plafond de sortie de 393 216 tokens, et la réduction preview rend un test de deux semaines bon marché. Mais sans benchmarks, sans prix au token, avec une interdiction d'usage en backend et un arrêt net le 25 novembre, il n'y a encore rien ici sur quoi construire.
Essaie-le si tu vis dans un agent de code et veux tester un Qwen à contexte long à 20 % (ou 8 %) du tarif de crédits. Passe ton tour si tu as besoin d'un modèle pour une app, un bot de support ou un modèle de coûts. Utilise maintenant Qwen 3.8 Max, et reviens quand Alibaba sortira la version complète.
Essaie eesel pour un support qui n'attend pas les lancements de modèles
Si ton vrai objectif est de répondre plus vite aux clients, eesel est un coéquipier IA pour le helpdesk qui se branche sur le helpdesk que tu utilises déjà, apprend de tes tickets passés et de ton centre d'aide, et est testé sur des conversations historiques avant de toucher une conversation réelle. smava l'utilise pour rédiger des réponses en allemand sur 27 000 tickets Zendesk par mois. Tu peux voir les tarifs ou essayer eesel gratuitement.
Questions fréquentes
Qwen 4 Max est-il déjà disponible ?
qwen4-max-preview (alias qwen4.0-max-preview), ouverte le 11 novembre 2026 à 10h00 heure de Pékin. Alibaba dit que la preview tourne jusqu'au 25 novembre 2026, puis le modèle est retiré. Une sortie complète de Qwen 4 Max n'a pas encore été annoncée. Pour le modèle sur lequel il s'appuie, voir mon avis sur Qwen 3.8 Max.Combien coûte Qwen 4 Max ?
Existe-t-il des benchmarks pour Qwen 4 Max ?
Puis-je utiliser l'API Qwen 4 Max dans mon app ?
Quelle est la différence entre Qwen 4 Max et Qwen 3.8 Max ?
max_tokens limite désormais la réflexion et la réponse ensemble. Voir mon détail des tarifs de Qwen 3.8 Max.Qwen 4 Max fonctionne-t-il avec Claude Code ?
qwen4-max-preview. Mon guide de sélection de modèle dans Claude Code explique comment fonctionne le changement de modèle.