

Voxtral 3 est l'ensemble vocal au meilleur rapport qualité-prix que l'on puisse acheter aujourd'hui auprès d'un laboratoire européen, et je lui donnerais 3,5 sur 5 : excellent pour la transcription par lots, prometteur mais encore jeune comme agent téléphonique. Voxtral Small Transcribe 3 égale Microsoft AI Transcribe 2 avec un taux d'erreur de mots de 4,0 % sur le test de 45 langues de Mistral et coûte $0.004 la minute. La voix coûte $13 par million de caractères, et l'API d'agents vocaux tout-en-un coûte $0.04 la minute.
Trois choses le freinent. Tous les modèles sont en préversion publique, les poids sont fermés cette fois (Voxtral 1 et 2 étaient ouverts), et les appels téléphoniques via SIP sont réservés aux entreprises au lancement. Le graphique de Mistral lui-même montre aussi Gemini 3.5 Realtime devant en transcription en direct à tous les réglages de latence.
Si vous gérez un support, la couche vocale est la moitié facile. Chez eesel, nous répondons à 27,000 tickets Zendesk par mois en allemand pour smava, et ce qui le permet, c'est l'entraînement sur les anciens tickets, pas un meilleur micro. Un modèle vocal donne des oreilles et une voix à votre agent ; il doit tout de même connaître votre activité.
Qu'est-ce que Voxtral 3 ?
Voxtral 3 est la famille vocale de Mistral, lancée le 20 octobre 2026. Elle réunit trois choses qui s'achetaient séparément : des modèles de reconnaissance vocale, un modèle de synthèse vocale et un SDK d'agents vocaux qui les enchaîne avec un modèle de chat au milieu.
Je construis des intégrations et des API pour vivre, donc je lis ce lancement comme je lirais la documentation de n'importe quel fournisseur : que fait réellement chaque identifiant de modèle, combien coûte-t-il par unité, et qu'est-ce qui casse quand je le branche ? Voici la gamme :
| Modèle | Rôle | Prix | Remarques |
|---|---|---|---|
| Voxtral Small Transcribe 3 | Transcription par lots, modèle phare | $0.004/min | 50 langues, diarisation, fait aussi de la traduction et des questions-réponses sur la parole |
| Voxtral Mini Transcribe 3 | Transcription par lots, économique | $0.0035/min | 4B paramètres, assez petit pour du matériel contraint |
| Voxtral Mini Transcribe Realtime 3 | Transcription en direct | $0.008/min | Réglage de latence de 80 ms à 2 400 ms, détection de fin de tour |
| Voxtral TTS 3 | Synthèse vocale | $13/1M chars | 35+ langues, 50+ dialectes, clonage de voix |
| API d'agents vocaux (Mistral Small 4) | Chaîne d'appel complète | $0.04/min | Parole en entrée, raisonnement, parole en sortie |
| API d'agents vocaux (modèle plus grand) | Chaîne d'appel complète | $0.08/min | Pareil, avec un modèle de raisonnement plus grand |
Les prix proviennent de l'article de lancement et de la page de documentation de chaque modèle, comme la fiche de Voxtral Small Transcribe 3. Chacune de ces pages classe le modèle en Public Preview, ce qui compte plus qu'il n'y paraît si vous prévoyez un déploiement en production ce trimestre.
Quelle est la précision de la transcription de Voxtral 3 ?
Très bonne, pour de l'audio enregistré. C'est la partie du lancement en laquelle j'ai le plus confiance, car les chiffres tiennent même quand on lit les graphiques de Mistral plus attentivement que le texte de Mistral.
Sur le benchmark FLEURS couvrant 45 langues, Voxtral Small Transcribe 3 obtient 4.0% de taux d'erreur de mots lorsqu'il détecte lui-même la langue. Voici comment les sept modèles du graphique de Mistral se classent :
| Modèle | Taux d'erreur, langue indiquée | Taux d'erreur, langue détectée |
|---|---|---|
| Voxtral Small Transcribe 3 | 4.1% | 4.0% |
| Microsoft AI Transcribe 2 | 4.1% | 4.0% |
| Voxtral Mini Transcribe 3 | 4.6% | 4.5% |
| Gemini 3.5 Transcribe | 6.1% | 4.5% |
| Scribe v2 | 4.9% | 4.9% |
| GPT Transcribe | 6.3% | 5.6% |
| Whisper large-v3 | 16.0% | 14.9% |
Remarquez que la première ligne est une égalité. Le texte de lancement dit que Small « surpasse Whisper, Scribe v2 et Gemini 3.5 Transcribe », ce qui est vrai, et omet Microsoft AI Transcribe 2, qui l'égale à la décimale près. Sur le graphique propre à Mistral de l'indice d'erreur de mots d'Artificial Analysis, Voxtral Small Transcribe 3 apparaît troisième, derrière Fun-Realtime-ASR-preview et Microsoft AI Transcribe 2. C'est un excellent résultat. Ce n'est simplement pas le grand chelem que laisse entendre le titre.
Le modèle Mini est le gagnant discret ici. Avec 4.5%, il égale Gemini 3.5 Transcribe sur l'audio à langue détectée, et la fiche du modèle Mini indique qu'il est assez petit pour des déploiements à ressources limitées. Si vous transcrivez des appels enregistrés pour l'assurance qualité, Mini à $0.0035 la minute est celui par lequel je commencerais.
Qui a dit quoi : la diarisation
La diarisation (étiqueter quel locuteur a dit chaque ligne) est le point où Voxtral domine son graphique. Sur le benchmark combiné de diarisation de Mistral, qui mêle enregistrements de réunions et appels téléphoniques, les taux d'erreur sont :
- Voxtral Small Transcribe 3 :
18.4% - Voxtral Mini Transcribe 3 :
18.6% - Pyannote Orchestrator :
19.0% - Microsoft AI Transcribe 2 :
20.3% - Scribe v2 :
23.0% - Voxtral Mini Transcribe 2 :
30.9% - Gemini 3.5 Transcribe :
38.4%
Ce passage de 30.9% pour l'ancien Mini à 18.6% pour le nouveau est la plus grande amélioration isolée du lancement. Pour les équipes de support, la diarisation transforme l'enregistrement d'un appel en transcription exploitable : il faut savoir quelles lignes venaient du client et lesquelles de l'agent avant de noter l'appel ou d'en extraire la réclamation. Elle compte aussi si vous prévoyez de masquer les données personnelles des transcriptions, puisque les règles de masquage diffèrent souvent selon le locuteur.
Noms de produits et jargon : le biais de contexte
Le biais de contexte permet de donner au modèle une liste de termes (noms de produits, références, personnes) pour qu'il les écrive correctement. Sur le test de phrases clés Earnings-22, Voxtral Small atteint 94.6% de rappel avec contexte et 81.4% sans. Scribe v2 obtient 94.3% avec contexte et 84.0% sans.
Avec une liste de termes, les deux sont donc à égalité, et sans elle, Scribe v2 retrouve en fait plus de phrases clés. La lecture pratique : si vous utilisez Voxtral, envoyez toujours une liste de termes. Le guide de migration ajoute que les entrées peuvent désormais être des expressions de plusieurs mots, mais qu'elles partagent la fenêtre de contexte avec l'audio, si bien qu'une longue liste peut déclencher une erreur 400.
Voxtral 3 est-il bon pour les appels en direct ?
Bon, pas le meilleur. C'est ici que mon verdict s'adoucit, et c'est le graphique de Mistral lui-même qui l'adoucit.
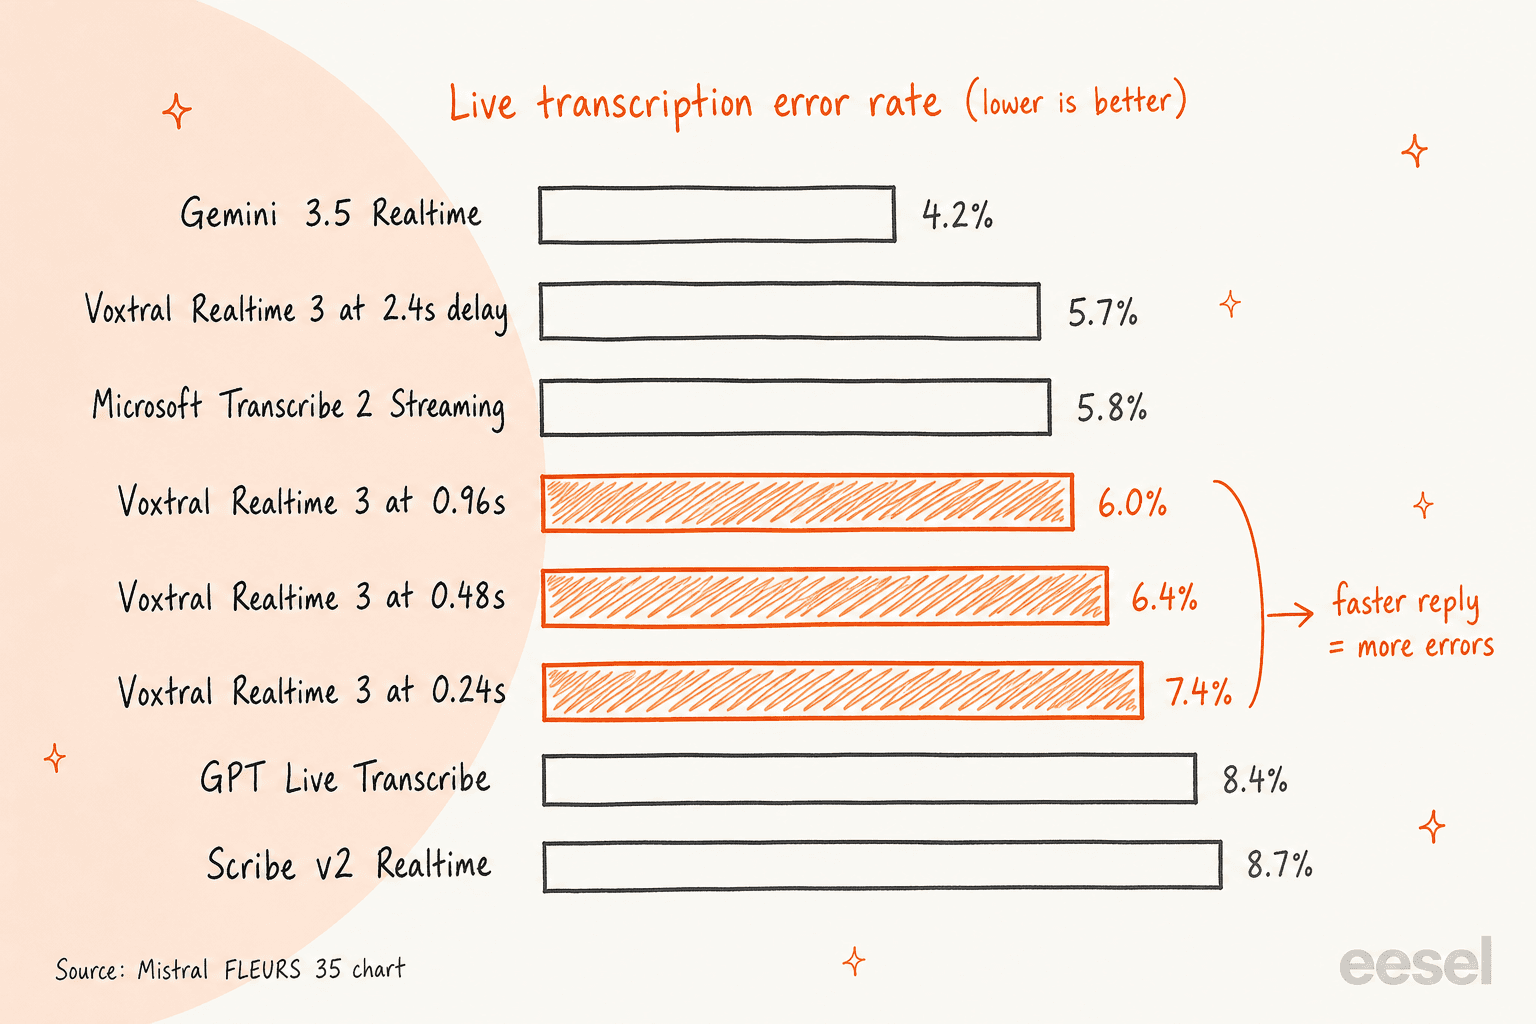
Voxtral Mini Transcribe Realtime 3 possède un réglage de latence : vous choisissez combien de temps il attend avant de figer les mots, de 80 ms à 2 400 ms. Attendre plus longtemps donne plus de contexte et moins d'erreurs. Sur le test temps réel de 35 langues de Mistral :
| Réglage | Taux d'erreur |
|---|---|
| Gemini 3.5 Realtime Transcribe | 4.2% |
| Voxtral Realtime 3 à 2 400 ms | 5.7% |
| Microsoft AI Transcribe 2 Streaming | 5.8% |
| Voxtral Realtime 3 à 960 ms | 6.0% |
| Voxtral Realtime 3 à 480 ms | 6.4% |
| Voxtral Realtime 3 à 240 ms | 7.4% |
| GPT Live Transcribe | 8.4% |
| Scribe v2 Realtime | 8.7% |
Deux choses ressortent. D'abord, Gemini 3.5 Realtime bat tous les réglages de Voxtral sur le graphique de Mistral lui-même. Ensuite, le réglage que vous utiliseriez réellement pour un agent téléphonique réactif (environ 240 à 480 ms) est celui où Voxtral cède le plus de précision. Il bat tout de même GPT Live Transcribe et Scribe v2 Realtime à tous les réglages, c'est donc un choix solide. Simplement pas le plus précis.
Un petit point à vérifier avant de construire dessus : les pages de Mistral ne s'accordent pas sur le nombre de langues couvertes par le modèle temps réel. L'article de lancement dit plus de 35, la fiche tarifaire dit 40+, et le graphique teste 35. Testez vos langues exactes plutôt que de vous fier au plus grand chiffre.
La bonne nouvelle, c'est la détection de fin de tour. Le modèle temps réel prédit quand un appelant a fini de parler en s'appuyant à la fois sur le son et sur le sens de ce qu'il a dit, ce qui évite qu'un agent vocal parle par-dessus quelqu'un qui a marqué une pause en pleine phrase. Quiconque a subi un bot qui coupe la parole pendant qu'on dicte un numéro de carte sait pourquoi c'est important.
La voix de Voxtral 3 sonne-t-elle naturelle ?
Assez naturelle, et très économique pour ce qu'elle offre. Voxtral TTS 3 est la brique qui a le plus progressé en ressenti, sinon en chiffre phare.
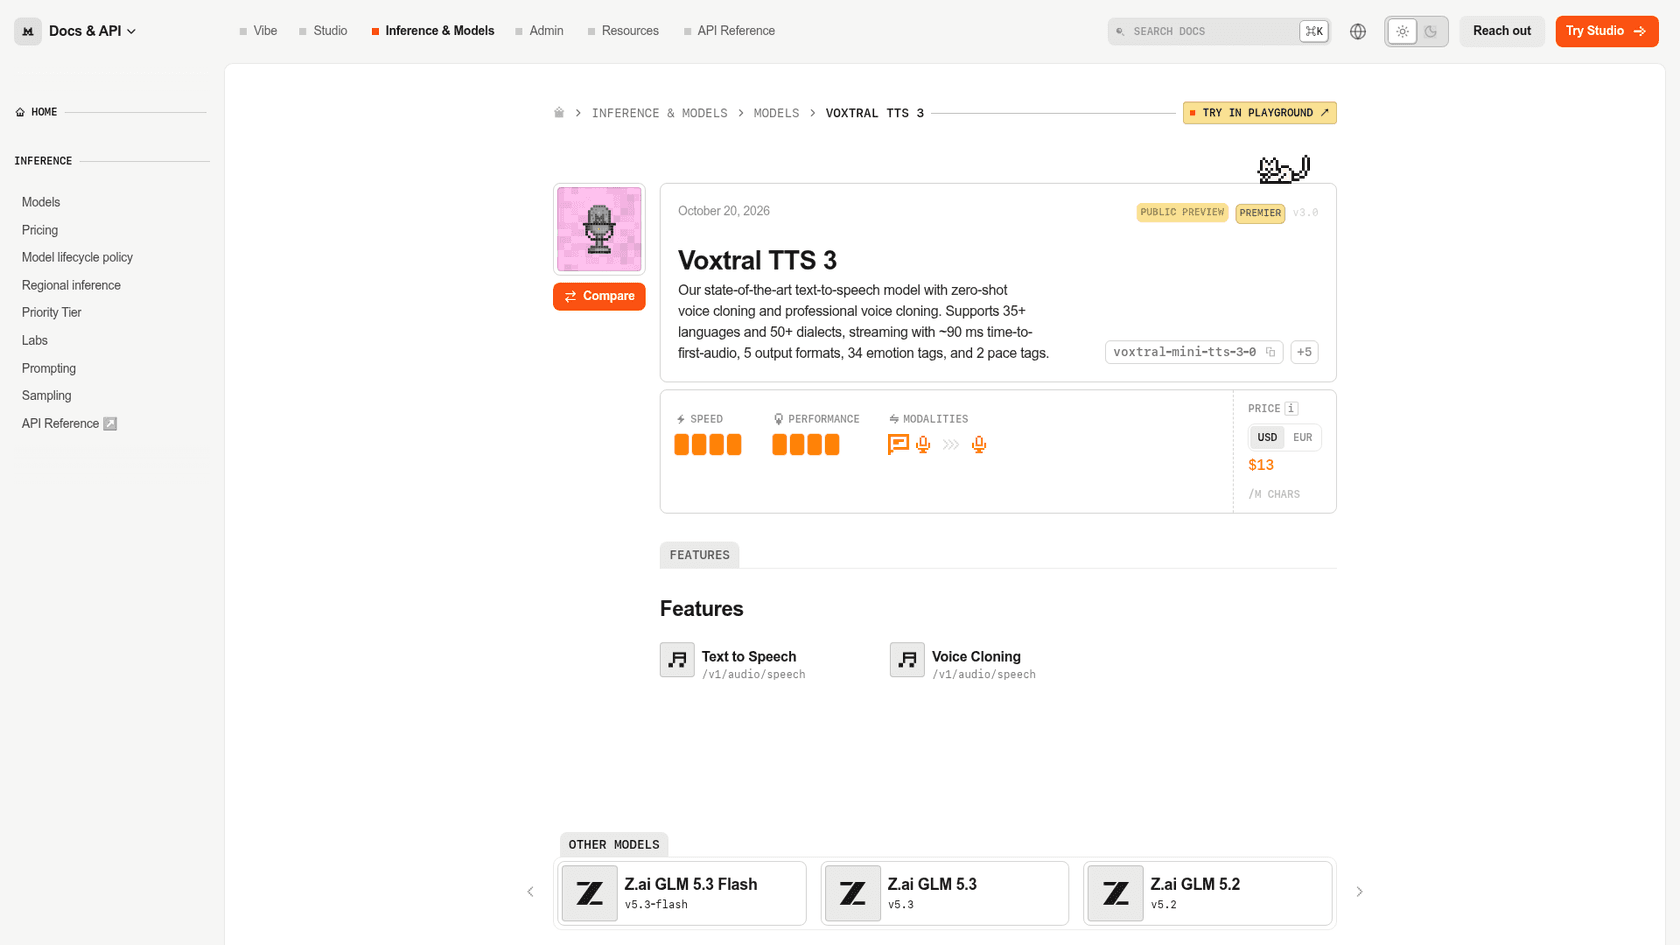
La fiche technique du modèle :
- 35+ langues et 50+ dialectes, avec des voix prédéfinies dans 18 langues
- Environ
90 msavant le premier audio en streaming - 34 balises d'émotion et 2 balises de rythme à insérer dans le texte, comme
[emotion=...] - Clonage de voix zero-shot, plus une option « Pro Voice » entraînée sur environ 30 minutes d'audio
- 5 formats de sortie
Les exemples de la page de lancement valent le coup d'oreille, car ils visent précisément là où les voix de support échouent. Dans l'un, Voxtral 1 lit un horaire de vol comme « 21,000pm on 10 over 10 ». Voxtral 3 le lit comme « 21pm on October 10th ». Un autre relit proprement une adresse e-mail à un appelant. Ce sont les moments où une voix bon marché vous met dans l'embarras sur une ligne de support.
Sur le prix, Mistral affirme que 13 $ par million de caractères coûtent moins cher à exploiter qu'OpenAI TTS-1, Deepgram, ElevenLabs Flash et Gemini Flash, et ses graphiques de qualité par dollar (construits sur le Voice Code Bench de BeSimple AI, qui teste les nombres et les noms inhabituels dans des scripts de support) placent Voxtral TTS à l'extrémité économique du marché. Ce sont des graphiques réalisés par le fournisseur avec un modèle Gemini comme juge, alors considérez-les comme une présélection, pas un verdict. Si vous comparez sérieusement, placez-le à côté d'ElevenLabs, de Cartesia Sonic 3 et de Gemini 3.8 Flash TTS avec vos propres scripts, ou parcourez la liste des alternatives à ElevenLabs.
Une remarque du guide de migration : les instructions de style, le contrôle en texte libre du type « dis-le chaleureusement », sont indiquées comme non disponibles au lancement. Vous avez aujourd'hui les balises d'émotion et de rythme.
Comment fonctionne le SDK d'agents vocaux de Voxtral 3 ?
Le SDK est la partie la plus intéressante du lancement pour qui construit un agent vocal pour le support client, et la plus restreinte.
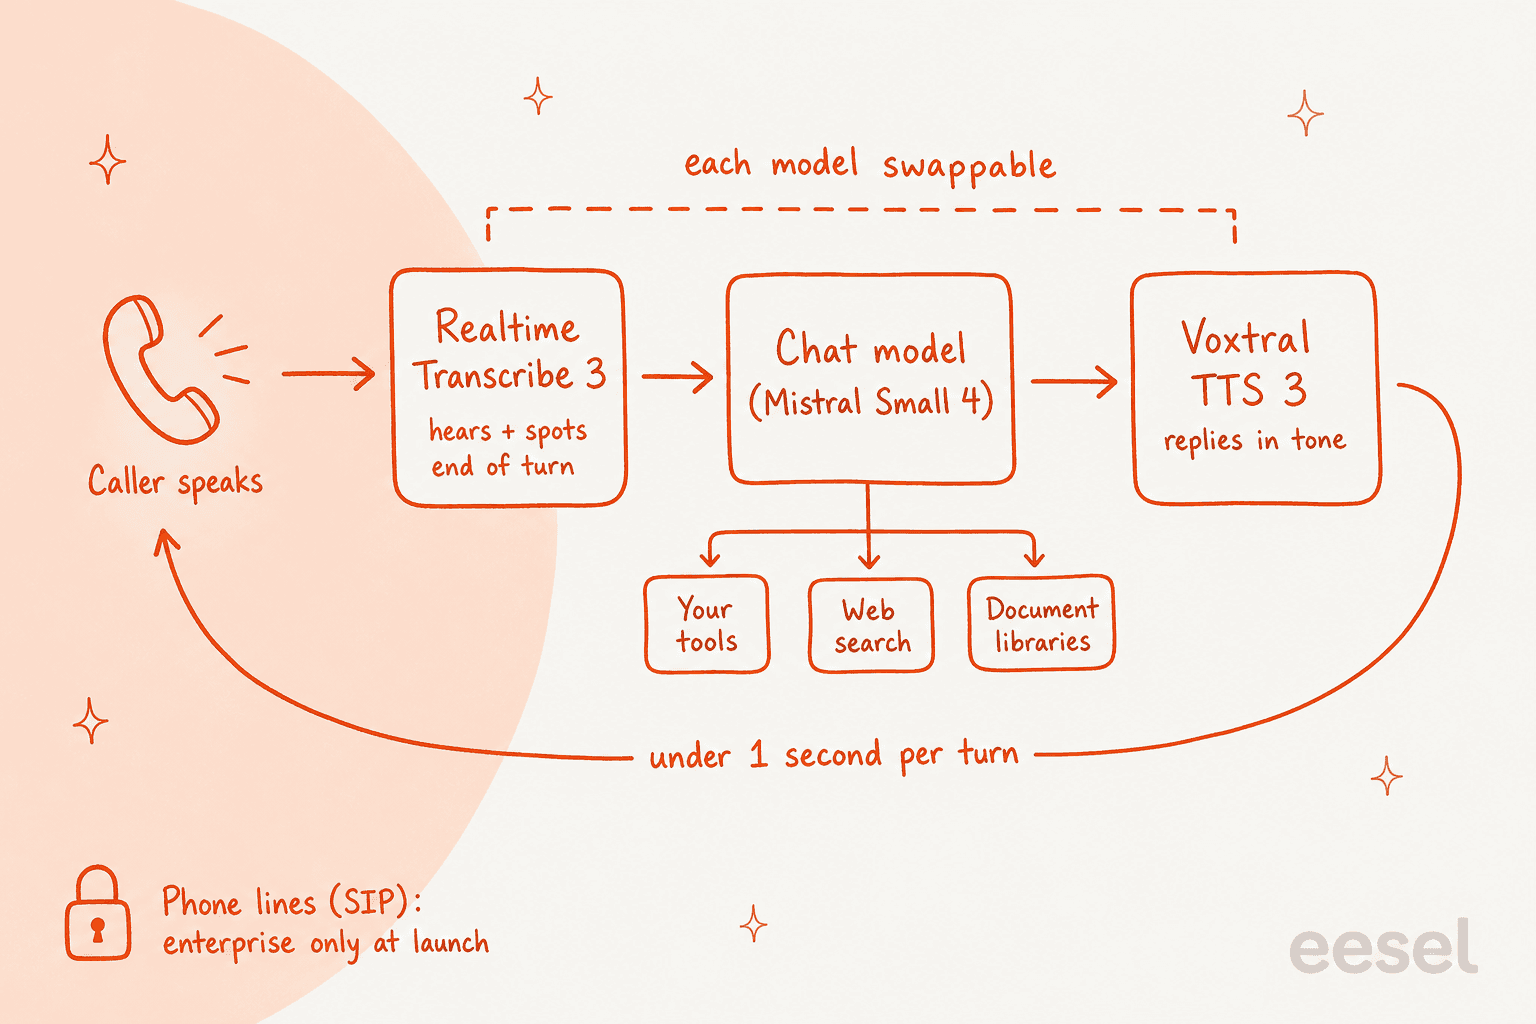
Selon la documentation des agents vocaux, chaque tour de conversation passe par trois étapes : le modèle temps réel transcrit et repère la fin du tour, un modèle de chat comme Mistral Small 4 rédige la réponse et appelle des outils, et Voxtral TTS la prononce. Mistral indique que les étapes se transmettent en continu l'une dans l'autre, si bien que chaque tour se termine en moins d'une seconde, et que l'appelant peut interrompre.
Ce que j'aime en tant que développeur :
- Chaque étape est un modèle distinct. Vous pouvez remplacer le modèle de raisonnement par un plus grand, ou changer la voix ou la langue, sans réécrire l'agent.
- Les agents sont versionnés. Vous enregistrez une configuration d'agent, chaque modification crée une nouvelle version, et vous pouvez figer la production sur une version connue pendant que vous testez la suivante. C'est la bonne conception pour tout ce qui parle à des clients.
- Des webhooks se déclenchent quand un appel démarre, se termine ou échoue, ce qui permet de stocker chaque transcription dans votre propre système de référence.
- Il repose sur LiveKit pour le transport audio, avec des liaisons Python et TypeScript, mais vous n'avez pas besoin de connaître LiveKit pour l'utiliser.
Ce qui me fait hésiter :
- Les lignes téléphoniques sont réservées aux entreprises au lancement. La documentation indique que la téléphonie via SIP est « disponible pour les clients entreprise au lancement, via votre équipe commerciale ». La voix dans le navigateur et les applications (via WebRTC) est ouverte à tous. Pour une équipe de support dont les clients appellent un numéro de téléphone, c'est la ligne décisive.
- Les outils côté client échouent sur les appels téléphoniques. La documentation précise que sur une ligne téléphonique, aucun de vos codes ne s'exécute pendant l'appel, donc tout ce dont un agent téléphonique a besoin (rechercher une commande, vérifier une facture) doit être un outil côté serveur.
- Les outils sont la recherche web, les bibliothèques de documents, les connecteurs d'espace de travail et vos propres fonctions. Il n'existe aucune notion intégrée de votre helpdesk ni de vos anciens tickets. Dans nos appels commerciaux chez eesel, la capacité la plus demandée est l'entraînement sur les anciens tickets, car c'est là que vivent les vraies réponses d'une entreprise. Avec Voxtral, c'est un travail d'intégration que vous feriez vous-même.
Il y a aussi la question de sécurité soulevée par un commentateur de Hacker News sur le fil du lancement, qui a atteint 770 points et 202 commentaires. Un agent vocal relié à des systèmes internes est une cible d'injection de prompt que n'importe qui avec un téléphone peut atteindre :
"I see companies hooking this up direct to the company intranet, and then users calling up and saying "Can you check this website for me?""

Ce n'est pas tant un défaut de Voxtral que la définition de poste de tout agent vocal qui appelle des outils. Mais c'est une bonne raison de limiter les agents téléphoniques à des outils étroits, côté serveur, avec des limites claires sur ce qu'ils peuvent modifier. Si vous définissez ce qu'un agent IA de centre d'appels doit et ne doit pas pouvoir faire, partez de là.
Combien coûte Voxtral 3 en pratique ?
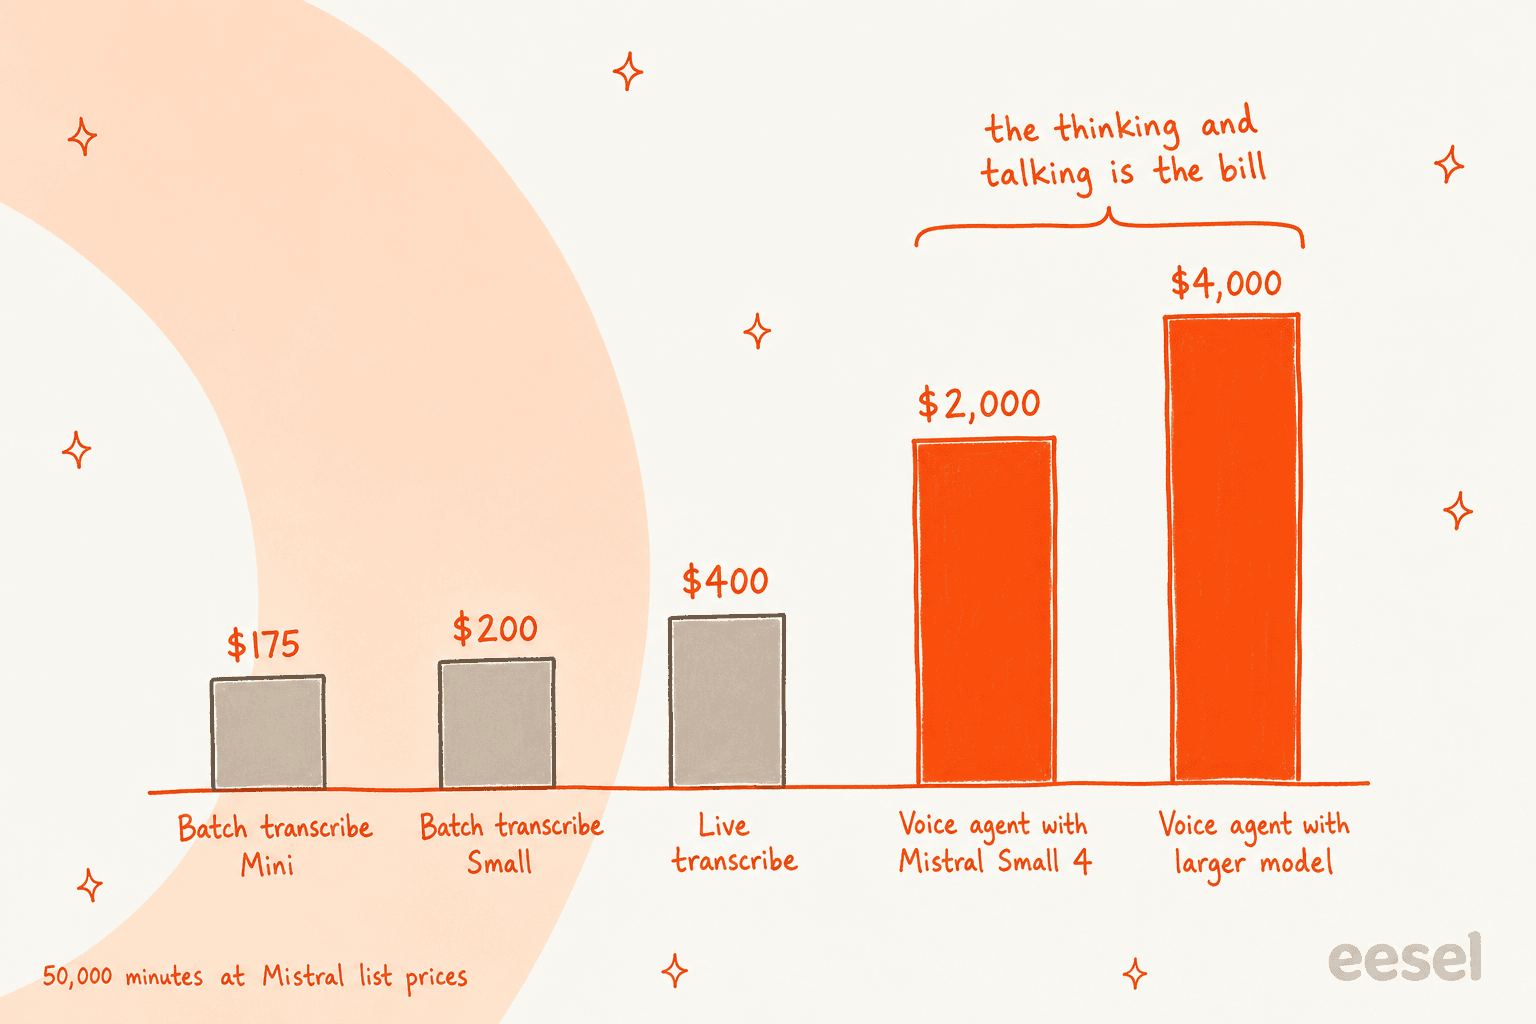
Les prix à la minute sont minuscules jusqu'à ce qu'on ajoute la réflexion. Voici ce que coûtent 10 000 appels de cinq minutes (50 000 minutes) aux tarifs publics de Mistral :
| Ce que vous utilisez | Tarif | 50 000 minutes |
|---|---|---|
| Transcription par lots, Mini | $0.0035/min | $175 |
| Transcription par lots, Small | $0.004/min | $200 |
| Transcription en direct | $0.008/min | $400 |
| API d'agents vocaux avec Mistral Small 4 | $0.04/min | $2,000 |
| API d'agents vocaux avec un modèle plus grand | $0.08/min | $4,000 |
Le schéma est la partie utile. Transcrire tous les appels que vous prenez déjà pour l'assurance qualité coûte quelques centaines de dollars par mois. Faire répondre un agent IA à ces appels coûte 10 à 20 fois plus, car le raisonnement et la voix font la facture. Un seul appel de support de cinq minutes via l'API d'agents revient à $0.20 avec Mistral Small 4. C'est ce chiffre qu'il faut mettre dans votre modèle de ROI du centre d'appels, pas les $0.004.
Le tarif d'agent de $0.04 est aussi compétitif à première vue. Pour mémoire, mon avis sur Grok Voice en août portait sur un concurrent à $0.08 la minute. Vérifiez les derniers tarifs sur la page de chaque fournisseur avant de vous engager, car les prix de la voix ont bougé vite cette année. Le détail complet des tarifs de Mistral AI couvre les modèles de chat qui se trouvent derrière l'agent.
Pourquoi les poids de Voxtral 3 sont-ils fermés ?
C'est le changement qui a suscité la réaction la plus vive, et elle est légitime. Les premiers modèles Voxtral (Mini 3B et Small 24B, juillet 2025) et le modèle Voxtral Mini 4B Realtime de janvier 2026 ont tous été publiés avec des poids ouverts sur Hugging Face. Ce seul modèle temps réel affiche plus de 2 millions de téléchargements. Voxtral 3 n'a pas de poids publics.
Le lancement dit que Voxtral 3 est disponible « pour un déploiement autonome sur votre propre infrastructure », ce qui a dérouté les lecteurs jusqu'à ce qu'un commentateur clarifie :
"You have to call sales to get access for on-prem deployment and the models. If it were open weights, it would be on Huggingface and they would have put a link in the post"
Le commentaire en tête du fil a exprimé la déception sans détour :
"Closed model unfortunately, continues the theme of TTS / STT being really not great for local deployments."
Pour être juste envers Mistral, elle n'a pas arrêté les publications ouvertes, comme le montre sa série de nouveaux modèles. Des commentateurs ont cité Timestral la semaine précédente et les poids promis de Mistral Large 4. Et un praticien a avancé l'argument commercial : les bons modèles vocaux avec diarisation sont plus rares que les bons modèles de texte, et les acheteurs les paient plus cher. Pour une équipe de support en entreprise, des poids fermés avec un déploiement sur site par contrat constituent un parcours d'achat normal. Pour un amateur qui monte un assistant domestique, c'est une impasse.
Qu'est-ce qui casse si vous êtes sur Voxtral 2 ?
Si vous appelez déjà Voxtral 2, lisez le guide de migration avant de changer les identifiants de modèle. Il est bien écrit et honnête sur ce qui casse.
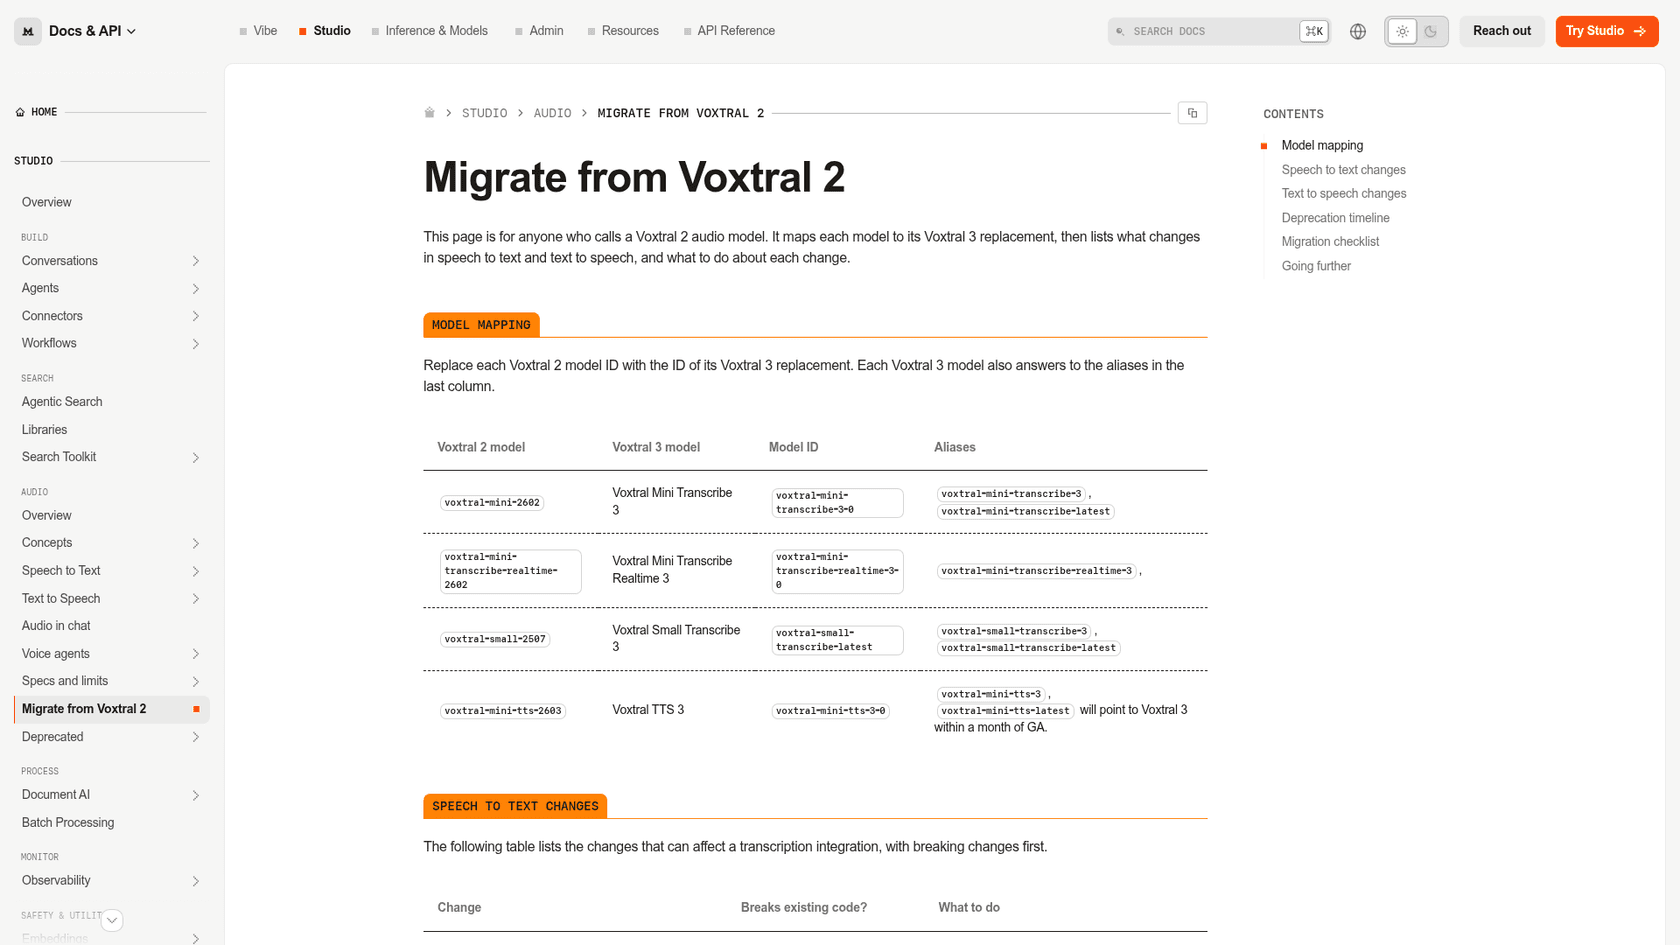
Les changements incompatibles, dans l'ordre où je les vérifierais :
- Les horodatages par mot disparaissent.
timestamp_granularitiesn'accepte quesegment; demanderwordrenvoie une erreur400. Si vous surlignez les mots pendant la lecture de l'audio, celui-ci fait mal. - Les sessions temps réel verrouillent leurs paramètres à l'arrivée du premier bloc audio. Un
session.updateultérieur renvoie une erreur, envoyez donc tous les paramètres dès le départ. - Les segments diarisés peuvent désormais se chevaucher quand deux personnes parlent en même temps. Si votre affichage suppose que ce n'est jamais le cas, il faudra le corriger.
Le côté TTS est plus doux : les anciennes voix prédéfinies comme gb_jane_sad fonctionnent toujours, et le clonage par ref_audio aussi. L'alias voxtral-mini-tts-latest passera à Voxtral 3 dans le mois suivant la disponibilité générale, alors figez des identifiants de modèle explicites si vous ne voulez pas de surprise.
Qui devrait utiliser Voxtral 3 ?
Voici où j'atterris, par profil d'acheteur :
| Si vous... | Verdict |
|---|---|
| Transcrivez des appels enregistrés pour la QA ou l'analyse | Oui. Précision proche du sommet, la meilleure diarisation de son graphique et $0.0035 à $0.004 la minute. |
| Êtes une équipe de l'UE qui doit traiter l'audio en Europe | Oui. API hébergée dans l'UE et déploiement sur site par contrat. Associez-le à une lecture des règles du règlement européen sur l'IA pour le support. |
| Construisez un assistant vocal pour navigateur ou application | Probablement. Le SDK est bien conçu et le prix de l'agent est bas, mais c'est une préversion. |
| Voulez mettre une IA sur votre ligne téléphonique de support ce mois-ci | Pas encore, sauf si vous êtes client entreprise. Le SIP est restreint pour le support téléphonique par IA, et l'intégration au helpdesk est à votre charge. |
| Voulez des poids pour tourner en local | Non. Regardez les alternatives à Mistral ou les anciens modèles Voxtral ouverts. |
Globalement, je donnerais à Voxtral 3 3,5 sur 5. Les modèles de transcription valent un 4,5, la voix un 4, et le SDK d'agents un prometteur 3 freiné par le statut de préversion et la restriction téléphonique. Si Mistral ouvre le SIP à tous et que les modèles sortent de préversion à ces prix, cette note monte.
Si vous comparez avec le marché au sens large, mon comparatif de la meilleure IA pour le support vocal et la liste des entreprises de voix IA couvrent les autres options. Et si vous hésitez encore à automatiser le support téléphonique, l'automatisation de centre d'appels est le point de départ.
Où eesel se place à côté de Voxtral 3
Voxtral 3 est une infrastructure : de très bonnes oreilles et une voix bon marché et expressive. eesel, c'est l'employé. Notre coéquipier IA de helpdesk rejoint le helpdesk que vous utilisez déjà (Zendesk, Freshdesk, Gorgias et d'autres), apprend de vos anciens tickets, de votre centre d'aide et de vos macros, et est testé sur votre véritable historique de tickets avant de répondre à un seul client.
C'est la moitié du support que Voxtral vous laisse. smava, un comparateur allemand de prêts, fait traiter par eesel 27,000 tickets Zendesk par mois en allemand, en catégorisant 14,600 d'entre eux et en rédigeant 15,300 réponses à partir de 820 macros et articles du centre d'aide. Koffer.ch, un magasin suisse de bagages, l'utilise pour rédiger des réponses Freshdesk en allemand, français, anglais ou italien, selon la langue du client, avec l'orthographe suisse. C'est du support multilingue sans étape de traduction. Aucun des deux n'a eu besoin d'un modèle vocal pour y arriver, et tous deux auraient besoin exactement de cette connaissance des tickets s'ils mettaient un jour un agent au téléphone.
Si votre file est aujourd'hui faite d'e-mails et de chats, c'est là que j'automatiserais en premier. Essayez eesel sur vos propres anciens tickets, gratuitement, et voyez ce qu'il aurait répondu.
Comment Voxtral 3 se compare-t-il à ElevenLabs ?