

Mon verdict en un coup d'œil
Je travaille chaque jour sur la file de support d'eesel, donc quand un modèle sort, je le lis avec une question en tête : le client attend-il moins ou reçoit-il une meilleure réponse ? Haiku 5.5 est le premier petit Claude pour lequel la réponse est un oui net sur une grosse part des tickets, et la fiche d'évaluation complète est ci-dessous.
| Ce que j'ai vérifié | Verdict | Le chiffre derrière |
|---|---|---|
| Prix sous 100k tokens | Excellent | $0.10 entrée / $0.50 sortie, 90% sous Haiku 4.5 |
| Prix au-delà de 100k tokens | Médiocre | $0.50 / $2.50, Luna reste moins cher ici |
| Intelligence | Meilleur de sa catégorie | 43 chez AA, contre 38 pour GPT-6 Luna |
| Vitesse | Excellente | 137-243 tokens/s chez AA, selon le niveau d'effort |
| Codage agentique | Faible | 39,2% sur Terminal-Bench 4.0 contre 70,6% pour Sonnet 5.5 |
| Efficacité en tokens | Mauvaise à effort élevé | ~162k tokens de sortie par tâche AA en Max, ~3x Luna |
| Hallucination | Mieux que les rivaux, toujours réelle | 40% sur AA-Omniscience contre 77% pour Luna |
| Effort de migration | Moyen | 6 changements incompatibles, dont temperature et prefill |
Ce qu'est Claude Haiku 5.5
Claude Haiku 5.5 est le petit modèle rapide d'Anthropic, sorti le 7 octobre 2026 sous l'ID de modèle claude-haiku-5-5. Anthropic le destine aux « high-volume, cost-sensitive tasks » comme les résumés, la compaction, la classification et les requêtes de base de données, et comme sous-agent pour Opus 5.5 et Sonnet 5.5 sur le travail de codage.
La fiche technique est un grand bond par rapport à Haiku 4.5. La fenêtre de contexte passe de 200k à 1M de tokens, la sortie maximale de 64k à 128k, et la date limite de connaissances avance à juin 2026. C'est aussi le premier Haiku avec effort réglable et thinking adaptatif, et ce thinking est activé par défaut à Medium.
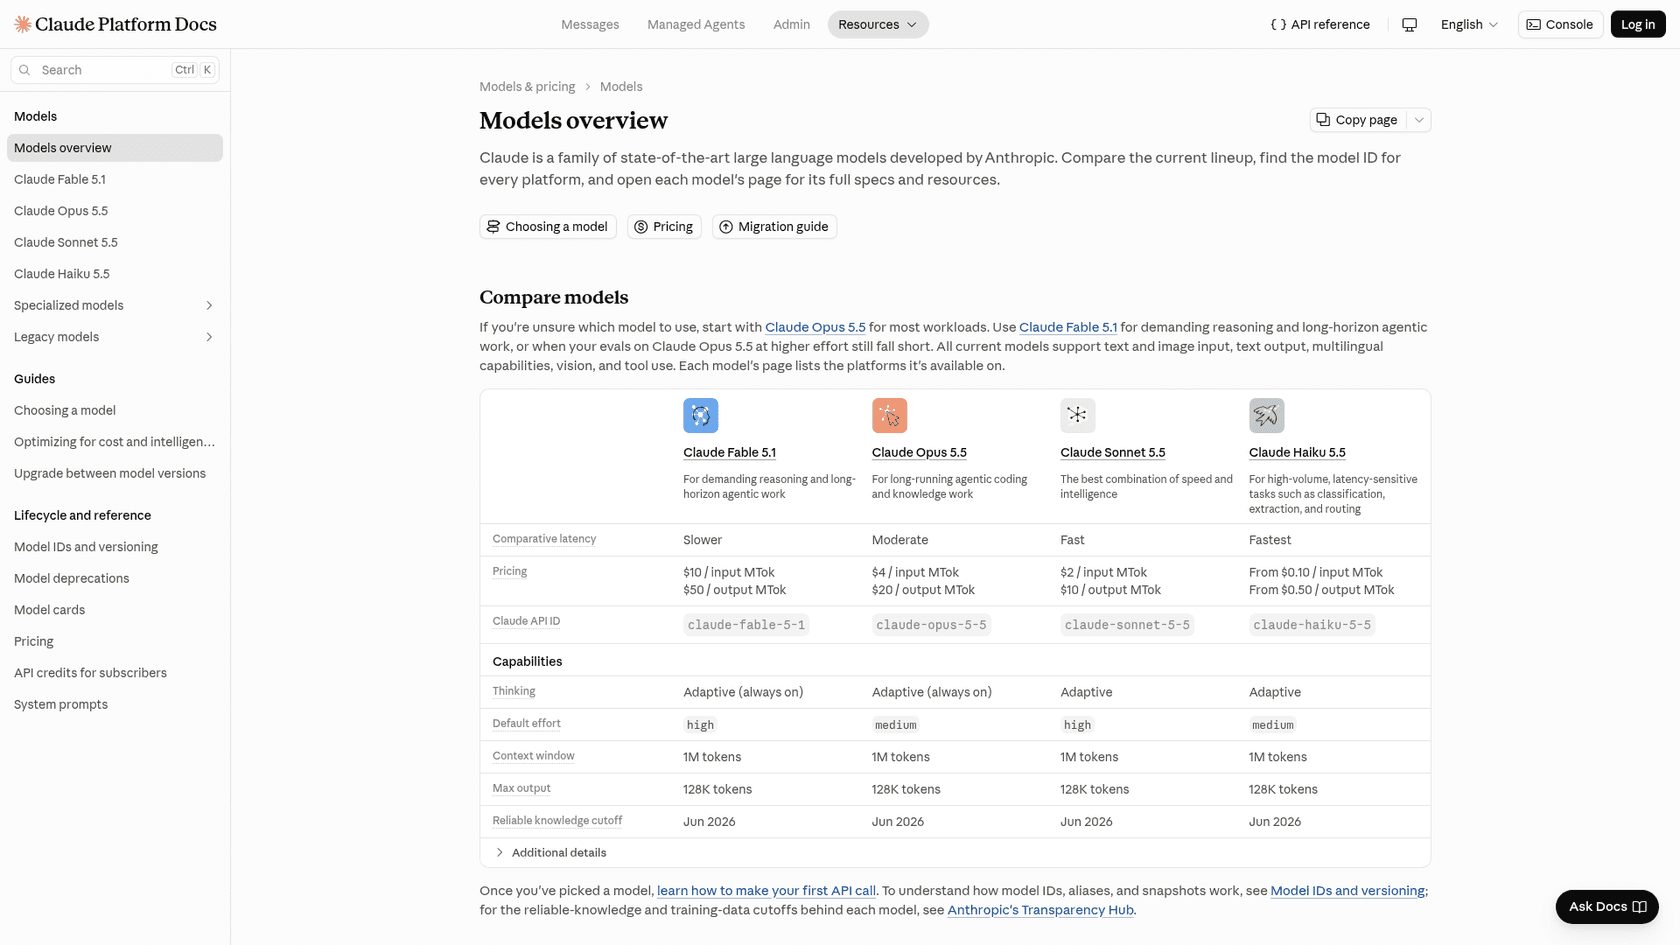
L'aperçu des modèles le décrit comme le modèle « for high-volume, latency-sensitive tasks such as classification, extraction, and routing. » Cette phrase résume bien, je pense, où il brille et où il ne brille pas.
Où Claude Haiku 5.5 est fort
Il y a beaucoup à aimer ici, et les gains par rapport à Haiku 4.5 ne sont pas minces, voici donc où il mérite sa place.
Il est proche de Sonnet 5.5 sur la plupart des tâches
Sur les benchmarks de lancement d'Anthropic, Haiku 5.5 atteint 1620 sur GDPval-AA contre 1840 pour Sonnet 5.5, et 72,4% sur OSWorld 2.1 contre 83,9%. Pour un modèle qui coûte un vingtième du prix d'entrée de Sonnet, c'est un résultat frappant.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (travail de connaissance) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 (utilisation d'ordinateur) | 72,4% | 15,7% | 48,9% | 83,9% |
| Humanity's Last Exam, sans outils | 45,9% | 10,2% | n/a | 56,9% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 16,4% | 70,6% |
| FrontierCode 1.1 | 46,4% | n/a | 42,4% | 52,1% (Xhigh) |
| Chartography, sans outils | 46,4% | 6,4% | 29,1% | 61,6% |
Le schéma devient plus clair quand on divise chaque score de Haiku par celui de Sonnet, ce que fait le graphique ci-dessous.
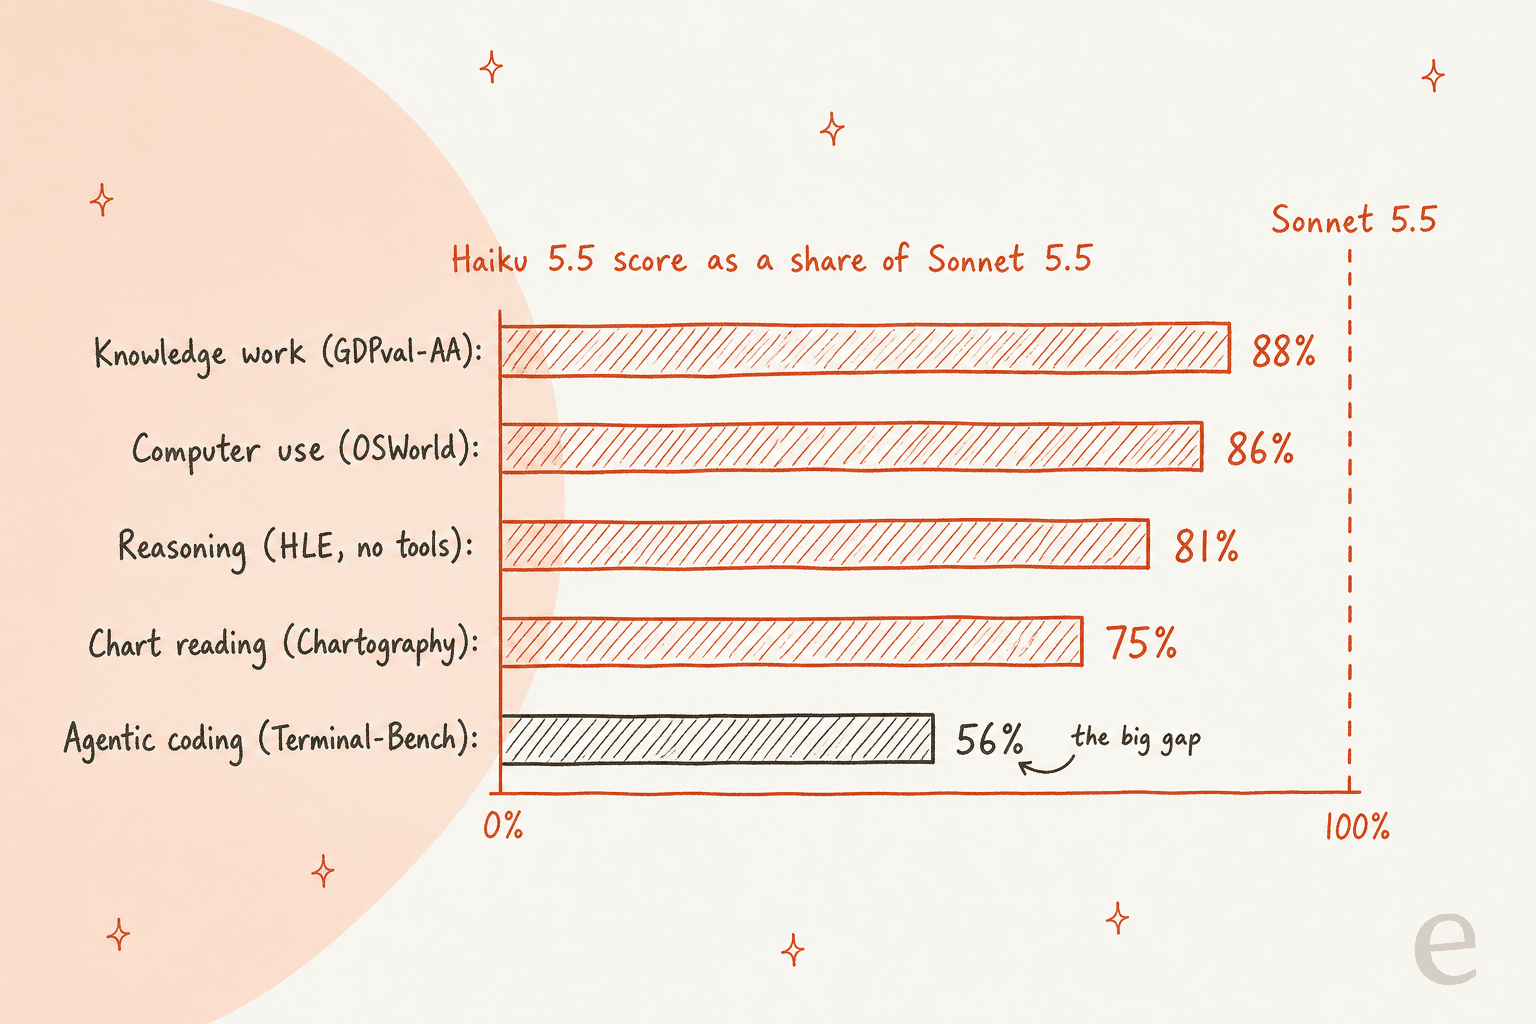
En travail de connaissance et en utilisation d'ordinateur, Haiku 5.5 vous donne 86-88% de Sonnet 5.5. En codage agentique, il vous en donne 56%. Cet écart indique exactement quelles tâches lui confier.
Il bat GPT-6 Luna en intelligence et en hallucination
Artificial Analysis place Haiku 5.5 à 43 sur son Intelligence Index en effort Max, devant GLM-5.3 Flash (42), Gemini 3.8 Flash (41) et GPT-6 Luna (38). Elle a aussi constaté que Haiku est plus enclin à dire qu'il ne sait pas, avec un taux d'hallucination de 40% sur AA-Omniscience contre 77% pour Luna.
"Haiku 5.5 is noticeably smarter than GPT-6 Luna, so I can see their pricing strategy here. For a while Anthropic has lacked a cost effective "cheap" LLM for summarisation, compacting, RAG helpers, etc."

Il est rapide
Anthropic l'appelle « our fastest model to date » à vitesse standard. Artificial Analysis a mesuré de 137 à 243 tokens de sortie par seconde selon l'effort, contre 128 pour Luna en Max et 90 pour Haiku 4.5. Les retours de clients concordent : Asana a vu « over a 30% reduction in latency for task completions » dans ses évaluations AI Teammates, et Box a mesuré 11 points de plus que Haiku 4.5 « at about half the latency. »
La vitesse n'est pas une métrique de vanité dans le support. Un acheteur à qui j'ai parlé a mené une évaluation méthodique de 67 tests sur une solution de chat IA, a trouvé les réponses solides, et est quand même parti parce que le widget de chat était, selon ses mots, « slow and often gets stuck. » Une excellente réponse qui arrive tard donne simplement l'impression d'un produit cassé.
Il est fort sur le travail court et ancré
Les meilleures citations de clients du lancement portent toutes sur des tâches étroites et répétées. HubSpot a rapporté 92,8% sur sa suite d'évaluation CRM, « the best score we've seen on this suite yet », avec le taux de faux positifs le plus bas sur un audit d'enregistrements obsolètes. AlphaSense a vu un bond statistiquement significatif sur son Q&A documentaire à 8M d'appels par semaine, de 0,76 à 0,84.
La communauté a constaté la même chose sur le travail riche en récupération d'information.
"Tested on my RAG system containing all of cloudflare docs (more than 3000 A4 sized highly technical documents): best
quality*speed/priceratio of any other model. And I have tested more than a 100 different models."
C'est la forme de la plupart des tickets de support : on lit quelques articles d'aide et le ticket, puis on répond à la question. C'est aussi pourquoi je pense que Haiku 5.5 compte davantage pour la classification de tickets par IA et le résumé de tickets que pour le codage.
Il fonctionne comme modèle de second
L'argument d'Anthropic elle-même est Haiku comme sous-agent d'un modèle plus grand, et les premiers retours le confirment. Rogo utilise un sous-agent Haiku 5.5 pour extraire une ligne de chiffre d'affaires d'un 10-K pendant qu'un modèle plus grand construit la présentation. Cognition dit que son dispositif Devin Fusion, avec Opus 5.5 en chef et Haiku 5.5 en second, « holds a top-tier FrontierCode score of 66.2 while cutting cost and latency. »
Un testeur de Hacker News l'a même vu déléguer de lui-même une construction d'interface complexe à Opus, notant qu'il « at least knows what it isn't good at. » Si vous utilisez déjà les sous-agents Claude Code, la configuration Haiku dans Claude Code est l'endroit évident pour l'essayer d'abord.
Où Claude Haiku 5.5 déçoit
Aucun de ces points n'est rédhibitoire seul, mais ensemble ils décident si Haiku 5.5 vous fait économiser ou vous coûte discrètement plus que prévu.
Le précipice de prix à 100k tokens
C'est le gros point. Haiku 5.5 est le seul modèle Claude actuel sans tarification fixe sur toute sa fenêtre de contexte. Selon la documentation des prix, un prompt de plus de 100 000 tokens paie le tarif supérieur sur chaque ligne : entrée, sortie et cache.
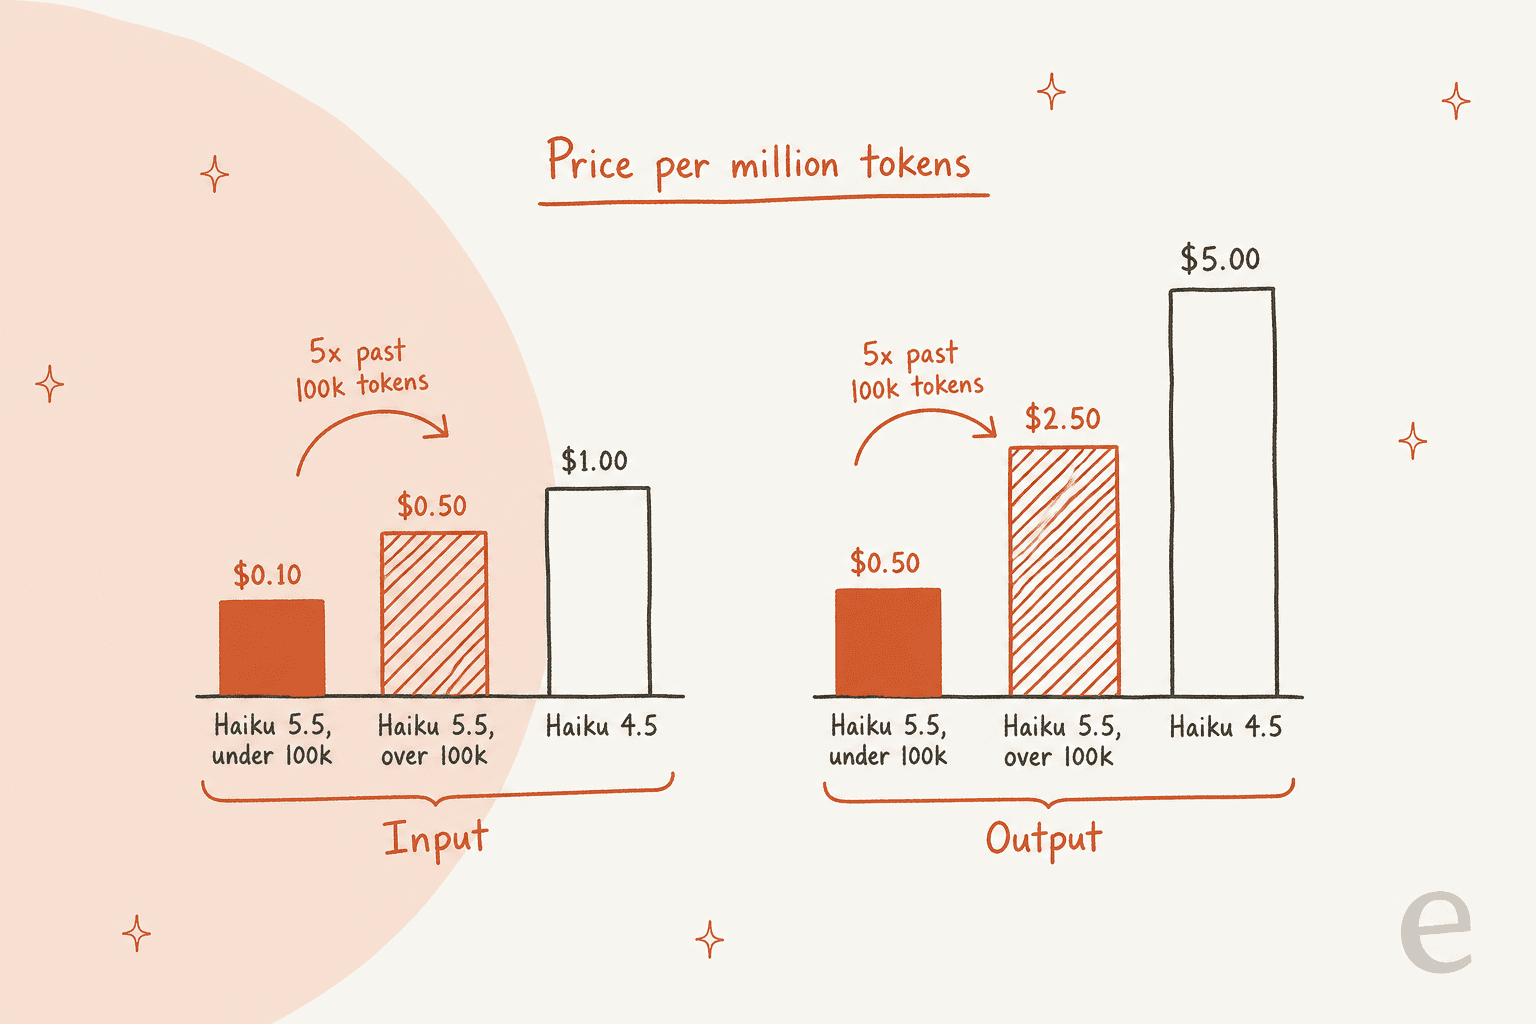
Anthropic dit que les prompts sous 100k représentent environ 90% des requêtes vers le Haiku précédent, donc la plupart des tâches Haiku classiques tombent dans la tranche bon marché. Les boucles d'agent, c'est une autre histoire, car l'historique de conversation s'accumule vite.
"100k tokens is an absurdly low cutoff and it is only applicable to Haiku and not Sonnet or Opus. It's a low enough cutoff that it will be quickly exceeded if you are doing anything with Agents; for typical generation or Jev-like classifiers, it's a good value"
L'article de lancement de Simon Willison présente bien le compromis : sous 100k, Haiku égale le prix de Luna avec de meilleurs scores, mais « Above 100,000 tokens, Luna looks like a much better deal. » Le palier de prix de Luna intervient à 272k tokens et ne monte qu'à $0.20/$0.75.
Un nouveau tokenizer ajoute discrètement des tokens
Le guide de migration dit que le même texte produit « approximately 30% more tokens than on Haiku 4.5. » Simon Willison a mesuré environ 1,25x sur un long prompt et l'a qualifié de « a hidden price increase. » Cela signifie aussi que vous atteignez le seuil de 100k plus tôt que ne le suggère le nombre brut de caractères.
Un testeur a donné des chiffres réels avec une tâche de classification.
| Modèle | Tokens d'entrée | Tokens de sortie | Coût en batch | Coût synchrone |
|---|---|---|---|---|
| Haiku 5.5 | 11,893,643 | 240,451 | $0.21 | $0.42 |
| GPT-6 Luna | 7,903,468 | 177,602 | $0.16 | $0.31 |
Ces chiffres viennent de Farmadupe sur Hacker News. Même prix par token, mais Luna est revenu environ 26% moins cher sur la même tâche car il a eu besoin de moins de tokens pour lire et écrire la même chose.
L'effort Max est une fournaise à tokens
Les réglages d'effort sont nouveaux chez Haiku, et le haut de l'échelle est cher. Artificial Analysis a constaté que Haiku 5.5 en Max utilise environ 162k tokens de sortie par tâche de l'Intelligence Index, soit environ 3x Luna en Max. Son délai avant le premier token en Max était de 415 secondes.
| Effort | AA Intelligence Index | Coût pour exécuter l'index | Tokens de sortie | Délai avant le premier token |
|---|---|---|---|---|
| Low | 29.4 | $34.31 | 32M | 13.6s |
| Medium (par défaut) | 34.5 | $56.36 | 54M | 14.2s |
| High | 37.8 | $94.07 | 97M | 26.2s |
| Xhigh | 41.2 | $157.58 | 180M | 86.8s |
| Max | 43.4 | $330.25 | 440M | 415.3s |
Passer de Medium à Max ajoute 9 points pour près de 6 fois le coût. Artificial Analysis note aussi que ces coûts n'incluent pas encore le palier de prix à 100k, donc les longues tâches coûteront plus cher que le tableau ne le dit. Le test du pélican de Simon Willison illustre la même chose en miniature : Low a pris 7 secondes et coûté 0,0936 centime, et Max a pris 5 minutes 9 secondes.
Pour le chat en direct, le délai avant le premier token à Medium sur ce benchmark (environ 14 secondes) vaut la peine d'être testé sur vos propres tickets, puisque le thinking adaptatif s'exécute avant le début de la réponse. La documentation dit qu'un effort plus faible permet au modèle de sauter le thinking sur les requêtes simples, et le thinking peut encore être désactivé à High ou en dessous.
Il se trompe encore sur les faits quand il n'a rien à lire
La system card d'Anthropic est franche sur ce point. Sur le test à livre fermé AA-Omniscience, Haiku 5.5 a répondu correctement à 44%, incorrectement à 32% et s'est abstenu à 24%. C'est mieux que Haiku 4.5 en net, mais un taux d'erreur d'environ un sur trois sur des questions qu'il ne peut pas consulter est précisément la raison pour laquelle un modèle de support a besoin de votre base de connaissances devant lui.
La system card signale aussi qu'il a refusé à tort plus que tout autre modèle dans l'audit automatisé de comportement, et Artificial Analysis dit que son score AutomationBench de 35% est « likely understated » à cause d'un problème de refus excessif avant la sortie qu'Anthropic corrige.
Vos propres évaluations peuvent diverger
Tout le monde n'a pas eu de bons tests le premier jour, et je pense que cela vaut la peine d'être entendu avant de basculer un interrupteur en production.
"At work we use haiku 4.5 for a handful of latency sensitive tasks that are fairly simple. It performs well. Just started testing 5.5 as I've been anticipating a nice improvement since it was teased. Results so far are trash. Prompt leakage even. And it's slower."
Un second commentateur a répondu que ses évaluations et ses tests humains par paires plaçaient aussi Haiku 4.5 en tête, et qu'il retravaillait ses prompts en conséquence. Haiku 4.5 est toujours listé comme actif, avec un retrait pas avant le 15 octobre 2026, il y a donc une fenêtre pour faire tourner les deux côte à côte.
Ce qui casse à la migration
La page des nouveautés liste plusieurs changements incompatibles. Pour les bots de support et les classifieurs, ce sont ceux qui mordent.
| Changement | Ce qui se passe maintenant | La correction |
|---|---|---|
| Budgets de thinking manuels | budget_tokens renvoie une 400 | Utiliser le thinking adaptatif plus effort |
| Paramètres d'échantillonnage | Tout top_k, ou temperature autre que 1, renvoie une 400 | Les retirer ; guider par le prompt |
| Prefill de l'assistant | Renvoie une 400, même avec le thinking désactivé | Terminer messages par un tour utilisateur |
| Historique en ajout seul | Modifier system, les outils ou les tours précédents, puis rejouer le thinking, renvoie une 400 | Garder l'historique en ajout seul |
| Outil d'utilisation d'ordinateur | computer_20250124 est rejeté sur l'API et Google Cloud | Passer à computer_toolset_20260801 |
| Tokenizer | ~30% de tokens en plus pour le même texte | Recalculer max_tokens et les budgets |
Le changement de temperature est le plus sournois pour le support. Beaucoup de pipelines de tri de tickets tournent à temperature 0 pour des étiquettes cohérentes, et cette requête échoue désormais purement et simplement. Le prefill est l'autre astuce courante (souvent utilisée pour forcer une accolade ouvrante JSON), et il a disparu aussi.
Le tool_choice forcé fonctionne toujours, ce qui est une bonne nouvelle après que Sonnet 5.5 l'a supprimé. Le hic, c'est qu'un appel d'outil forcé revient sans bloc de thinking, selon le guide de migration. Si vous voulez que le modèle raisonne avant d'appeler votre outil de remboursement ou de routage, utilisez auto et dites-le dans le prompt.
Les prix de Claude Haiku 5.5 en un tableau
Voici la grille tarifaire complète de la documentation des prix de Claude, avec Haiku 4.5 et Sonnet 5.5 en référence. Tous les prix sont par million de tokens.
| Tarif | Haiku 5.5, jusqu'à 100k | Haiku 5.5, au-delà de 100k | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|---|
| Entrée | $0.10 | $0.50 | $1.00 | $2.00 |
| Sortie | $0.50 | $2.50 | $5.00 | $10.00 |
| Écriture en cache 5 minutes | $0.125 | $0.625 | $1.25 | $2.50 |
| Écriture en cache 1 heure | $0.20 | $1.00 | $2.00 | $4.00 |
| Lecture du cache | $0.01 | $0.05 | $0.10 | $0.10 |
| Batch entrée / sortie | $0.05 / $0.25 | $0.25 / $1.25 | $0.50 / $2.50 | $1.00 / $5.00 |
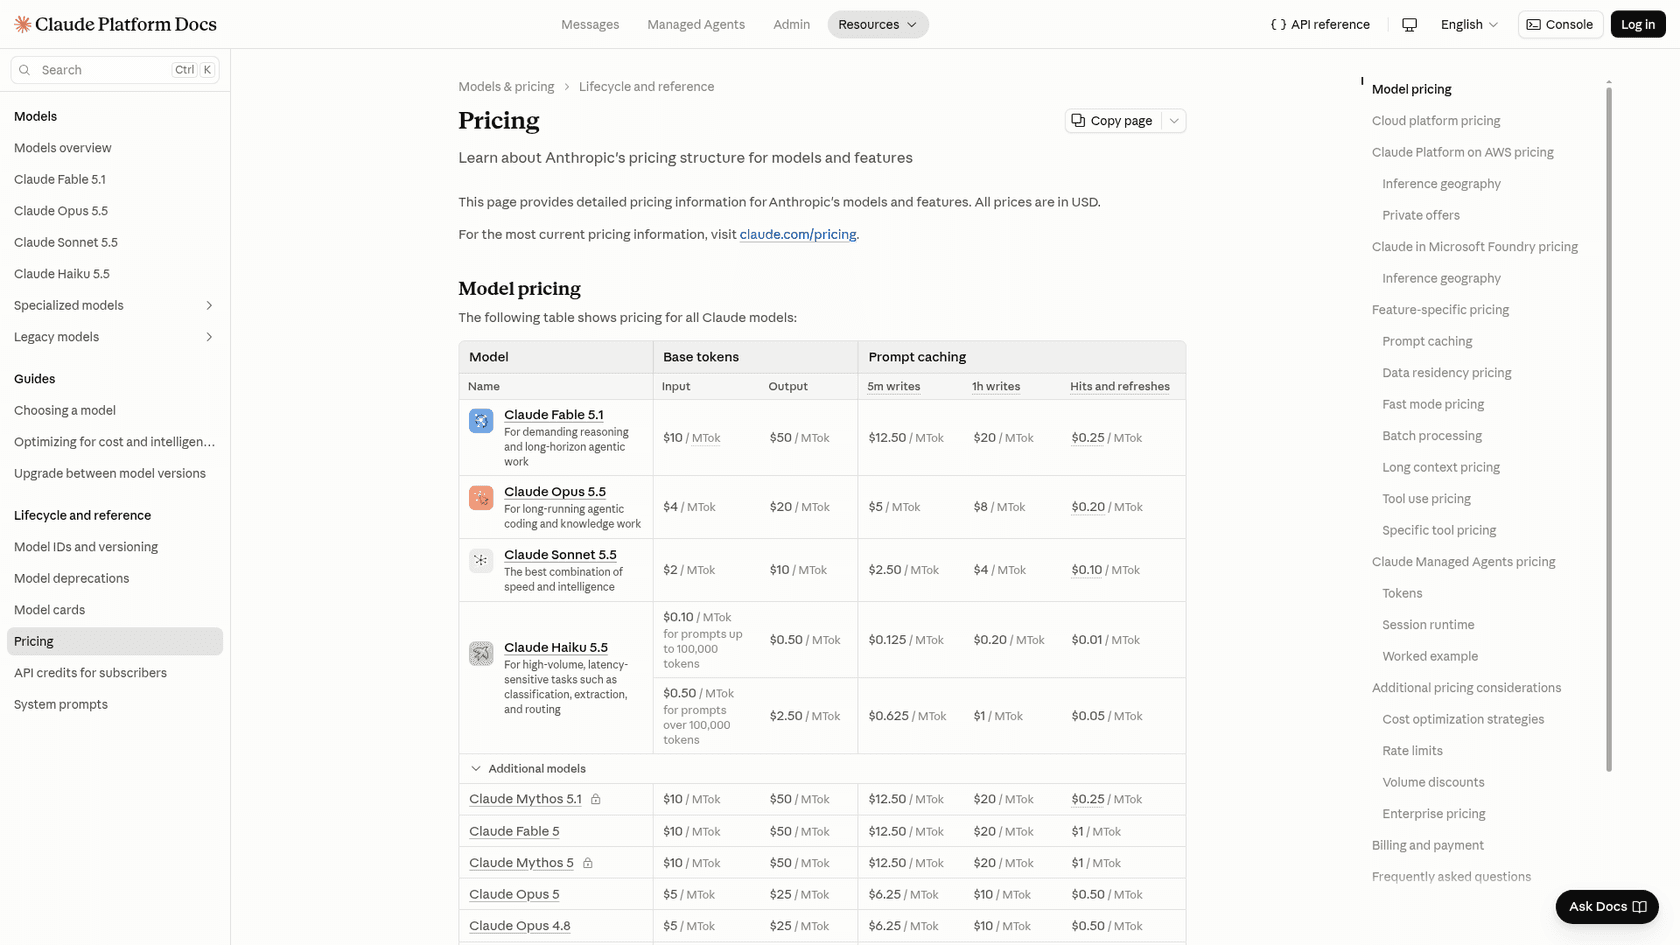
Pour rendre cela concret, prenons une réponse de support avec un prompt de 8 000 tokens (instructions, quelques articles d'aide et le ticket) et 600 tokens de sortie, thinking compris. Sur Haiku 5.5, cela fait environ $0.0011 par ticket, soit à peu près $11 pour 10 000 tickets. Si la même conversation grossit jusqu'à un prompt de 150 000 tokens, l'entrée seule coûte $0.075, cinq fois ce qu'elle coûterait sous le seuil. Il n'y a pas de mode Fast pour Haiku 5.5, et Anthropic a aussi divisé par deux les lectures de cache de Sonnet 5.5 à $0.10 le même jour, ce qui réduit l'écart pour les agents qui utilisent beaucoup le cache. Mon guide des prix de Sonnet 5.5 couvre ce côté.
Comment je l'utiliserais sur une file de support
La façon dont je ferais tourner Haiku 5.5 dans le support découle assez directement des forces et des précipices ci-dessus. Laissez-le faire le travail rapide, court et à gros volume sur chaque ticket, et remontez les difficiles.
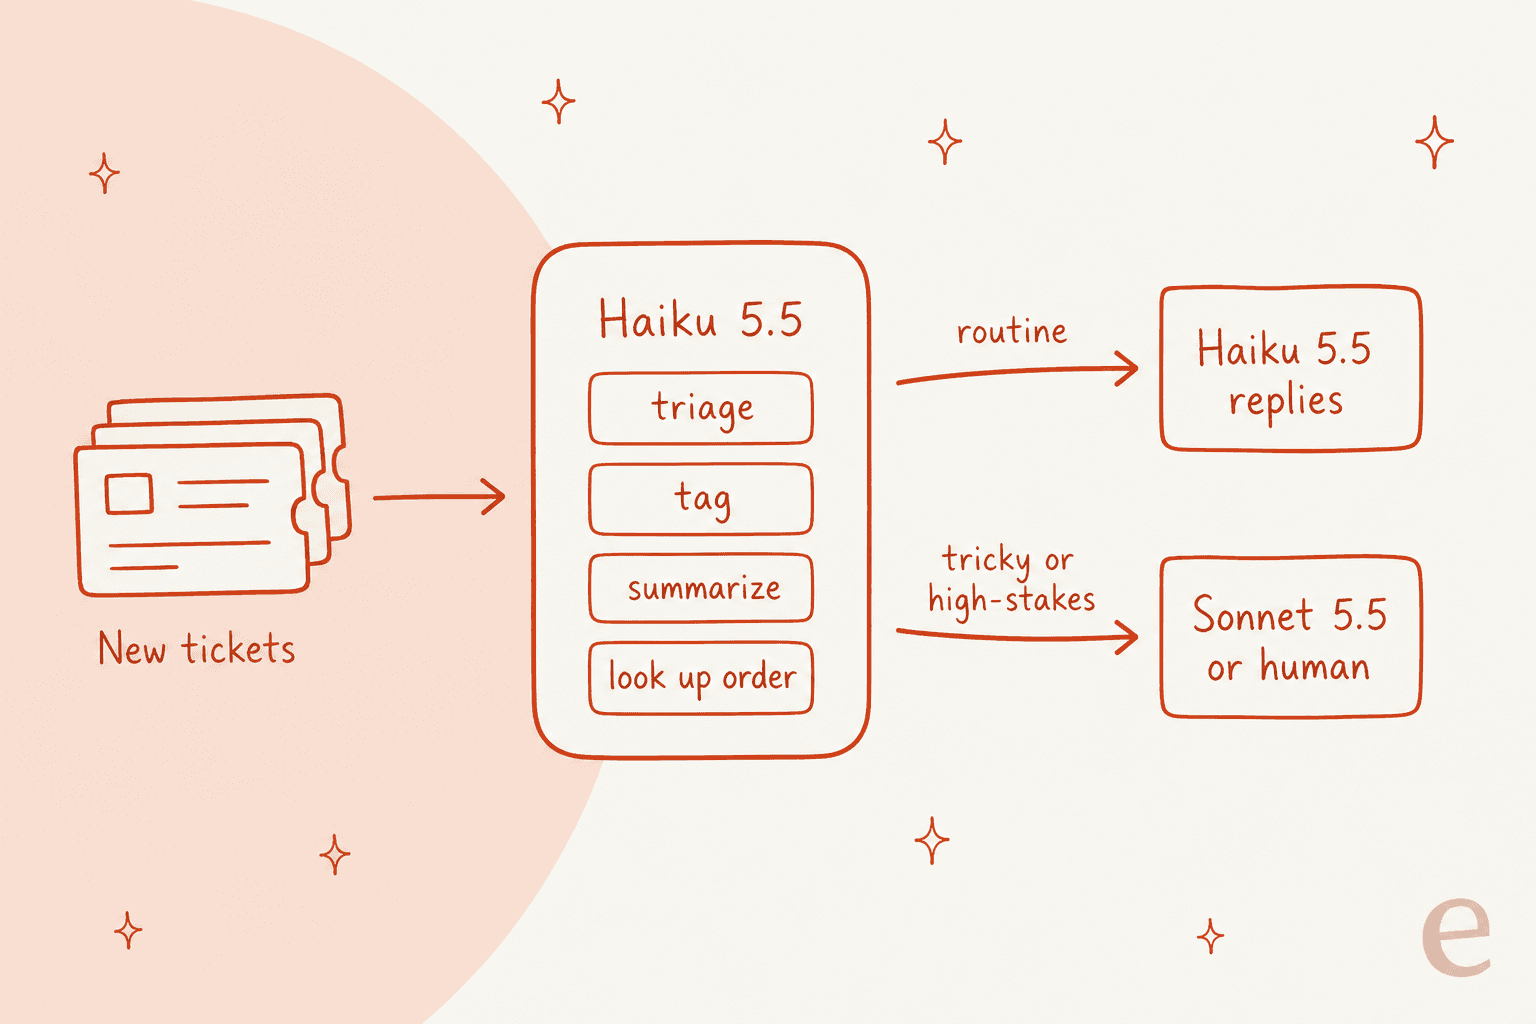
En pratique, cela donne :
- Tri et étiquetage en effort Low. Prompts courts, une liste d'étiquettes fixe, pas d'historique long. C'est le travail pour lequel la tranche 100k a été conçue, et cela convient aussi à la priorisation de tickets.
- Résumés et notes de passation en Medium. Assez rapide pour tourner sur chaque ticket sans que personne ne remarque le coût.
- Réponses de routine, ancrées dans votre centre d'aide. Statut de commande, réinitialisation de mot de passe, délais de retour. Gardez le contexte récupéré réduit pour que le prompt reste sous 100k.
- Escaladez le reste. Litiges de remboursement, dépannage en plusieurs étapes et tout ce qui a un long fil vont à Sonnet 5.5 ou à une personne.
C'est aussi à peu près ce à quoi ressemble un vrai essai quand il se passe bien. Dans un essai e-commerce sur du trafic Zendesk réel, le tri était la tâche où l'IA était la plus forte, avec 93% de précision et 100% de détection du spam, tandis que les brouillons complets avaient besoin de plus d'aide venant des réponses passées de l'équipe. Un petit modèle rapide convient bien à cette première tâche, je pense.
Ce que disent les développeurs
Le fil de lancement sur Hacker News a dépassé 770 points et 380 commentaires, et la réaction s'est partagée selon une ligne : ceux qui avaient des tâches courtes et bien délimitées l'ont adoré, et ceux qui faisaient tourner de longues sessions d'agent ont fait le calcul du précipice des 100k.
"Ran our DataAnalyticsBench benchmark on it: 9x cheaper than Haiku 4.5 and 2 letter grades better. It's also now the fastest model (using the default speeds, not trying any of the other models "Fast" mode) to complete the exam."
Le même testeur a ajouté qu'il a traité toutes les questions d'analyse simples mais est resté en deçà sur celles qui demandaient un travail statistique plus poussé, et que GPT-6 Luna a fait un peu mieux, pour environ 30% du coût.
"With that said, the real reason to use Haiku is that it's faster than all of these models. OpenRouter is showing an average so far of 93 tokens/sec, and AA got at least 137 in each of their benchmarks. So it might be valuable for speed at lower thinking levels."
"noticeably smarter remains to be seen in practice. For now, Haiku is a bit more expensive than Luna on < 100k token, but I just don't have any agentic work below 100k, so this is going to be 5x more expensive than shown on these charts."
L'équipe d'Artificial Analysis a résumé cela par « notably fast, however very verbose », ce qui correspond à tout ce qui précède.
Qui devrait changer, et qui devrait attendre
Voici comment je déciderais, d'après la tâche plutôt que d'après le graphique de benchmarks.
| Vous faites tourner | Mon avis | Pourquoi |
|---|---|---|
| Classification, étiquetage, routage | Changez, après une courte évaluation | Tranche la moins chère, modèle le plus rapide, petits prompts |
| Réponses RAG sur un centre d'aide | Changez, gardez les prompts sous 100k | Bons résultats ancrés, fenêtre de 1M si besoin |
| Sous-agents sous un chef Sonnet ou Opus | Changez | Le cas d'usage qu'indiquent Anthropic et les premiers clients |
| Longues boucles d'agent au-delà de 100k tokens | Attendez ou choisissez Luna | Palier de prix 5x plus le tokenizer plus lourd |
| Codage agentique complexe | Restez sur Sonnet 5.5 | 39,2% contre 70,6% sur Terminal-Bench 4.0 |
| Pipelines reposant sur temperature 0 ou le prefill | Prévoyez du temps de migration | Les deux renvoient désormais une erreur 400 |
Si vous le comparez à des options extérieures, mes articles sur les alternatives à GPT-6 Luna, Gemini 3.8 Flash et Kimi K3 couvrent le reste du champ des modèles petits et moyens.
Pour le support en particulier, le guide sur quel LLM convient au support va plus loin.
Un modèle plus rapide ne corrige pas une mauvaise réponse
Une chose qu'un avis sur un modèle ne peut pas montrer, c'est que la plupart des échecs de bots de support que je vois n'ont rien à voir avec le modèle. Une équipe B2B de télématique automobile a découvert que son bot disait aux clients qu'il prenait en charge des marques de voitures absentes de leur base de données. Le modèle n'inventait rien, pour être juste. Leur base de connaissances disait qu'ils géraient « all models », et le bot l'a cru. Haiku 5.5 aurait donné la même mauvaise réponse, simplement plus vite et pour moins cher.
C'est pourquoi chaque déploiement d'eesel est simulé sur des tickets historiques avant que le coéquipier ne parle à un client. Cette étape est celle où vous repérez les lacunes de connaissances qu'aucune mise à niveau de modèle ne peut corriger, et avec un modèle qui se trompe sur 32% des faits à livre fermé, cela compte encore plus.
Essayez eesel avec des modèles Claude rapides sur votre file
Si c'est la vitesse de Haiku 5.5 que vous voulez sur vos tickets, eesel est le raccourci. Son coéquipier helpdesk IA s'intègre à votre helpdesk existant, comme Zendesk, Freshdesk ou Gorgias, apprend de vos anciens tickets et de votre centre d'aide, et fait le tri, l'étiquetage et les réponses avec un modèle de pointe en dessous. Le précipice des 100k, le réglage de l'effort, les changements incompatibles ci-dessus, tout cela devient le problème d'eesel et non le vôtre.

Si vous vivez dans un terminal, la CLI eesel opère le même coéquipier et le même espace de travail que le tableau de bord. Vous pouvez la scripter, ou laisser un agent de codage comme Claude Code la piloter, ce qui est le même schéma chef-et-second de cet avis appliqué à votre configuration de support.
Mes articles sur la CLI d'agent IA et les serveurs MCP vont plus loin.
Les forfaits payants commencent à $299 pour 500 crédits, et vous pouvez d'abord l'essayer gratuitement sur une partie de vos vrais tickets. Essayez eesel et voyez si un modèle plus rapide se traduit réellement par des réponses plus rapides pour vos clients.
Claude Haiku 5.5 vaut-il le coup ?
Oui, si votre travail est court et répétitif. Sous 100k tokens de prompt et en effort Low ou Medium, Claude Haiku 5.5 est le meilleur petit modèle que j'aie vu chez Anthropic : plus intelligent que GPT-6 Luna au même prix affiché et plus rapide que tout ce qu'Anthropic vend d'autre, et il est assez proche de Sonnet 5.5 en travail de connaissance pour absorber une grande part d'une file de support.
Au-delà de l'une ou l'autre limite, le calcul s'inverse : les longues sessions d'agent paient 5x, l'effort Max brûle des tokens, et le nouveau tokenizer fait arriver les deux plus tôt. Lancez votre propre évaluation contre Haiku 4.5 tant qu'il est disponible, gardez les prompts réduits, et laissez les modèles plus grands gérer ce que Haiku 5.5 leur remonte.