

Pourquoi on cherche des alternatives à Claude Haiku 5.5
Commençons par la bonne nouvelle, car Haiku 5.5 la mérite. Claude Haiku 5.5 est sorti le 7 octobre 2026, il obtient 43 à l'Intelligence Index d'Artificial Analysis, devant tous les autres petits modèles de cet article, il sort 243 tokens par seconde et, sous 100 000 tokens de prompt, il coûte $0.10 en entrée et $0.50 en sortie par million. J'ai tout couvert dans mon test de Haiku 5.5.
Chez eesel, j'écris la plomberie d'API, donc je lis ce genre de lancement du côté de l'intégration. Mes questions sont : qu'est-ce qui casse, combien ça coûte sur une charge réelle et qu'est-ce que je dois réécrire. D'après ces vérifications, je vois quatre raisons pour lesquelles une équipe pourrait décider que Haiku 5.5 n'est pas son modèle.
- Le gouffre des 100k. D'après la documentation tarifaire de Claude, un prompt de plus de 100 000 tokens paie $0.50 en entrée et $2.50 en sortie, plus 5x sur les lectures et écritures de cache. Haiku 5.5 est le seul modèle Claude actuel sans tarif fixe sur toute sa fenêtre de 1M.
- Le tokenizer. La page des nouveautés indique que le même texte produit "approximately 30% more tokens" que sur Haiku 4.5. Vous payez plus de tokens et vous atteignez plus tôt la ligne des 100k.
- Des changements d'API cassants. Tout
temperature,top_poutop_knon par défaut renvoie maintenant une erreur, tout comme le prefill de l'assistant. Beaucoup de classifieurs ont été construits précisément sur ces deux astuces, c'est pourquoi celui-ci fait mal. - La verbosité. Artificial Analysis a compté 440M de tokens générés sur son index pour Haiku 5.5 contre 140M pour GPT-6 Luna. Même prix affiché, puis une facture environ 3x plus élevée pour le même travail.
Pour être juste, Hacker News a fait le calcul des prompts longs dans l'heure qui a suivi le lancement.
"noticeably smarter remains to be seen in practice. For now, Haiku is a bit more expensive than Luna on < 100k token, but I just don't have any agentic work below 100k, so this is going to be 5x more expensive than shown on these charts."

La bonne alternative dépend donc de celui de ces quatre points qui vous a touché, et voici la carte que j'utilise.
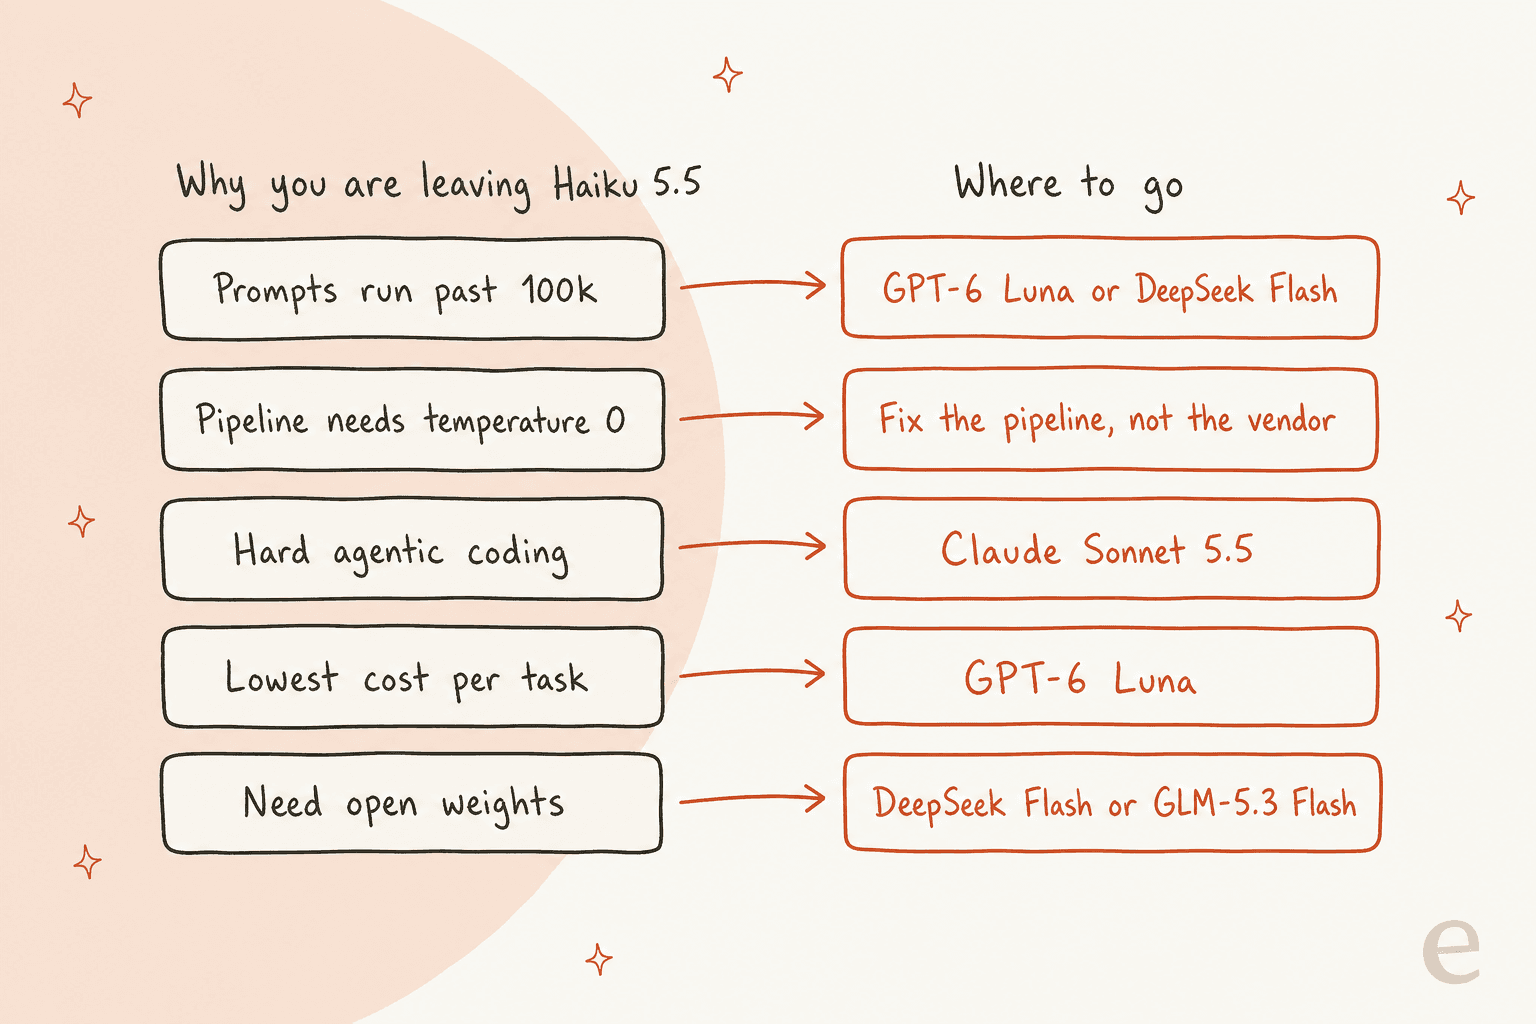
Alternatives à Claude Haiku 5.5 en un coup d'œil
Chaque prix ci-dessous est par million de tokens aux tarifs standard, vérifié sur la page tarifaire de chaque fournisseur le 8 octobre 2026. Les colonnes d'Artificial Analysis (AA) utilisent leur Intelligence Index v4.3.2 au niveau d'effort que AA indique.
| Modèle | Entrée / sortie | Règle de prompt long | Contexte | Indice AA | Coût AA par tâche | Vitesse de sortie | Temperature 0 | Poids ouverts | Idéal pour |
|---|---|---|---|---|---|---|---|---|---|
| Claude Haiku 5.5 (référence) | $0.10 / $0.50 | 5x sur chaque ligne au-delà de 100k | 1M | 43 | $0.21 | 243 tok/s | Erreur | Non | Tâches courtes, intelligentes et rapides |
| GPT-6 Luna | $0.10 / $0.50 | 2x entrée, 1.5x sortie au-delà de 272k | 1.05M | 38 | $0.07 | 128 tok/s | Seulement à l'effort none | Non | Coût le plus bas par tâche |
| Claude Haiku 4.5 | $1 / $5 | Fixe | 200k | n/d | n/d | n/d | Fonctionne | Non | Gagner du temps sur d'anciens prompts |
| Claude Sonnet 5.5 | $2 / $10 | Fixe | 1M | 56 (max) | $7.60 (max) | n/d | Erreur | Non | Raisonnement et programmation difficiles |
| DeepSeek V4.1 Flash | $0.30 / $1.20 en pointe, moitié hors pointe | Fixe | 1M | 39 | $0.27 (pointe) | n/d | Ignoré en mode thinking | Oui, MIT | Prompts longs à budget serré |
| GLM-5.3 Flash | $0.15 / $0.50 | Fixe | 1M | 42 | $0.25 | 51 tok/s | Thinking toujours actif | Oui | Poids ouverts proches du score de Haiku |
| Gemini 3.5 Flash-Lite | $0.30 / $2.50 | Fixe | 1M | 22 | $0.19 | 346 tok/s | Google conseille 1.0 | Non | Débit brut |
| Gemini 3.8 Flash | $0.75 / $3.75 (double le 1er janv. 2027) | Fixe | 1M | 41 (high) | $1.24 | n/d | Google conseille 1.0 | Non | Longues tâches d'agents dans l'écosystème Google |
Une remarque sur la colonne de vitesse : "n/d" signifie que je n'avais pas de mesure AA du jour en laquelle j'ai confiance, pas que le modèle est lent.
Comment je les ai choisies
J'ai limité la liste aux modèles vers lesquels un utilisateur de Haiku 5.5 pourrait réellement migrer cette semaine : en disponibilité générale, à prix public et dans la même catégorie petit et rapide, plus un cran au-dessus (Sonnet 5.5) et un cran en arrière (Haiku 4.5). J'ai vérifié chaque prix sur la page du fournisseur, chaque comportement d'API dans la documentation du fournisseur et chaque benchmark sur Artificial Analysis plutôt que sur des graphiques de lancement.
La métrique sur laquelle je m'appuie le plus est le coût par tâche terminée, pas le prix au token. Haiku 5.5 et Luna ont des prix au token identiques mais des factures très différentes, ce qui résume toute l'histoire de cette catégorie.
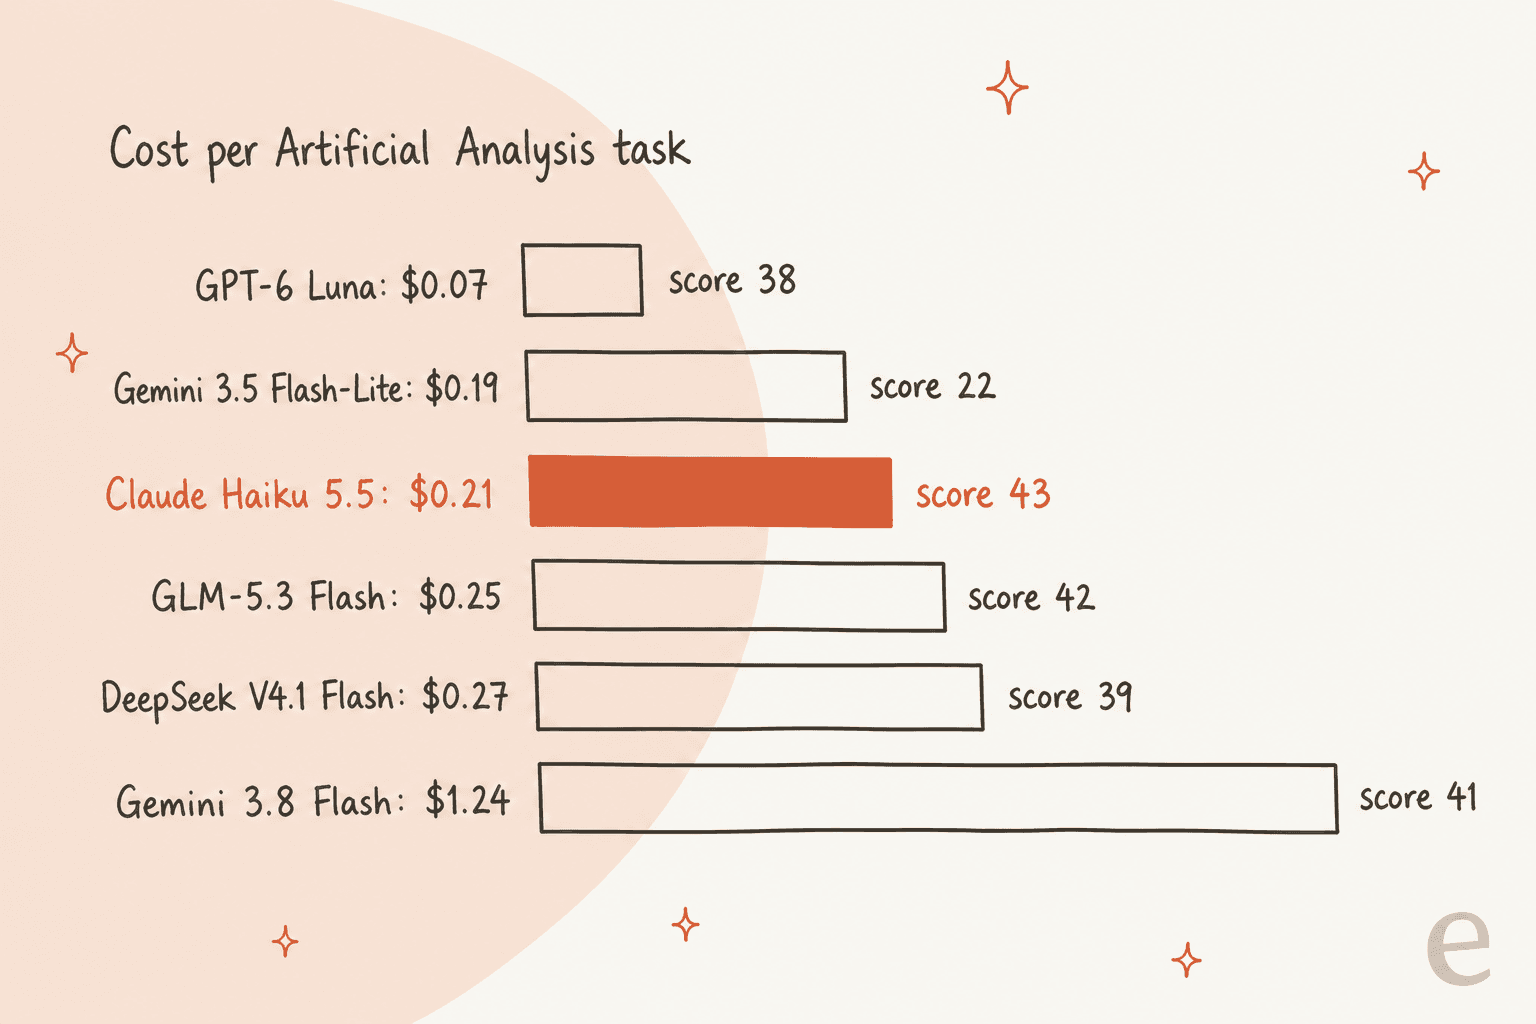
Lisez ce graphique comme un compromis, pas comme un classement. Haiku 5.5 vous apporte 5 points d'indice de plus que Luna pour 3x le coût par tâche. Savoir si cela vaut le coup dépend de si votre tâche est de celles où ces 5 points se voient.
1. GPT-6 Luna
Idéal pour : les équipes qui veulent des prix de Haiku sans le gouffre des 100k, et la facture la plus basse par tâche terminée.
Ce qu'il fait mieux que Haiku 5.5
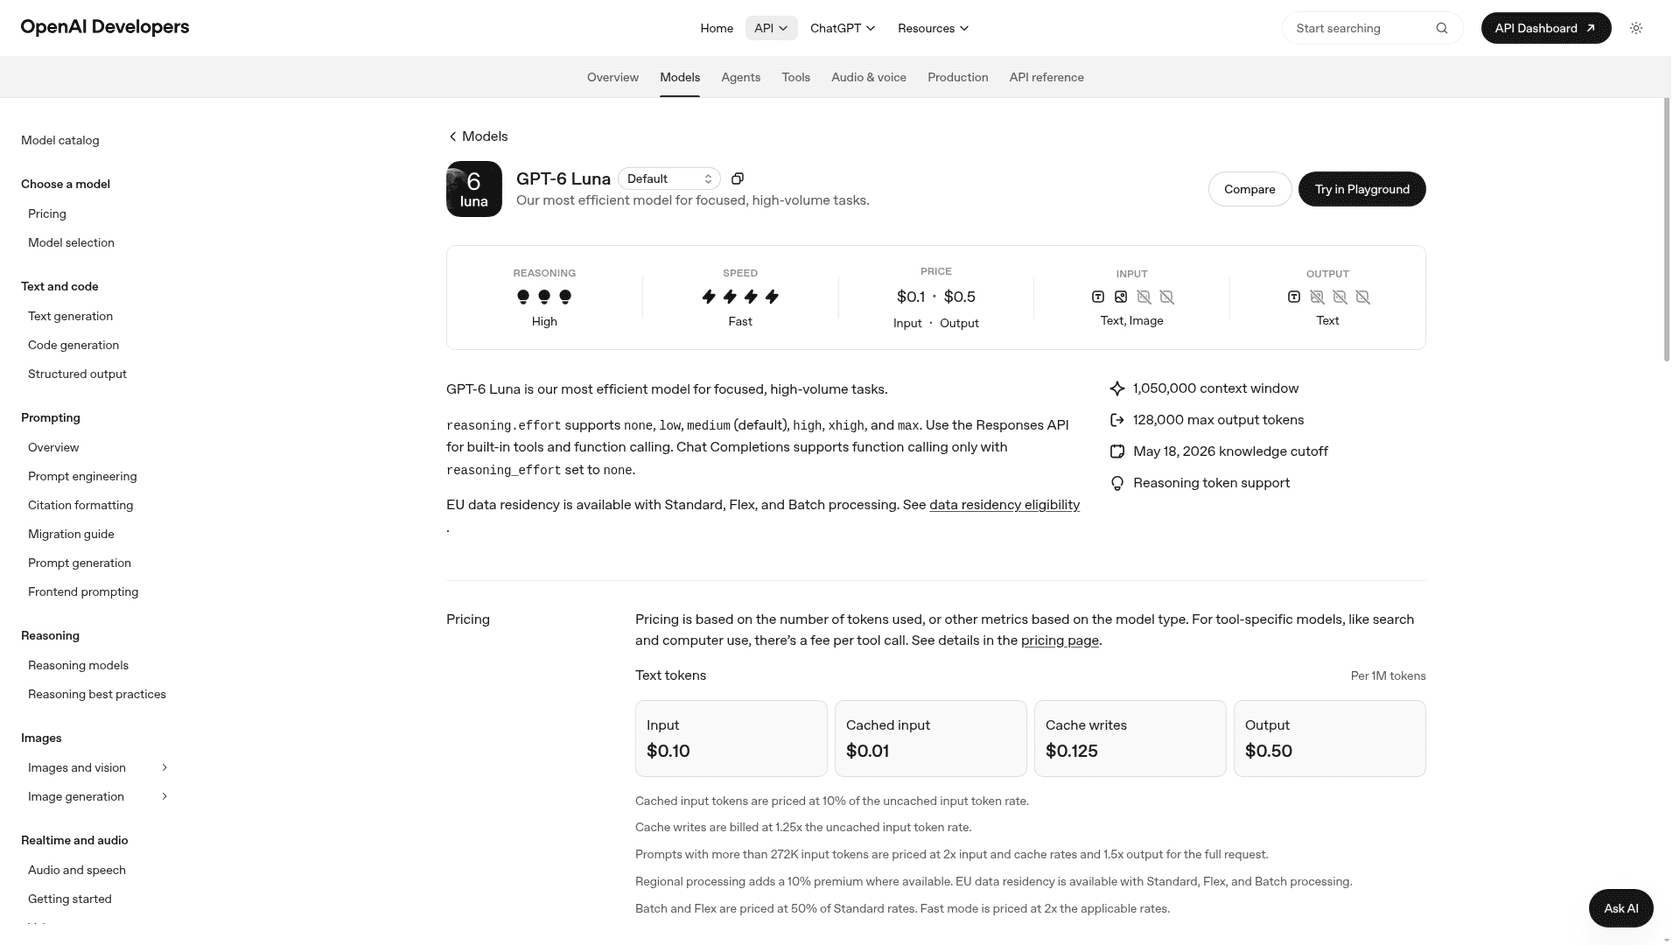
Luna est le modèle dont Haiku 5.5 a été aligné sur le prix, et il gagne sur deux points qui comptent pour les vraies factures. D'abord, sa règle de contexte long est bien plus douce. La page du modèle indique que les prompts de plus de 272K tokens d'entrée paient 2x sur l'entrée et le cache et 1.5x sur la sortie, soit $0.20 en entrée et $0.75 en sortie. Haiku 5.5 monte dès 100k, et de 5x.
Ensuite, il écrit moins, ce qui se voit vite sur la facture. AA a placé Luna à 140M de tokens sur son index contre 440M pour Haiku, et à $0.07 par tâche contre $0.21. Un testeur de Hacker News a lancé la même tâche de classification sur les deux et a trouvé Luna environ 26% moins cher à prix au token identique. Les tokenizers comptent aussi :
"There's also a tokenizer efficiency difference: modern Claude's 100K tokens are about ~60-65K modern GPT tokens, so in reality the Luna cutoff is much further away than the Haiku one."
Là où il est en retrait
Luna obtient 38 sur AA contre 43 pour Haiku, et le test d'hallucination d'AA montre l'écart le plus large : 77% pour Luna contre 40% pour Haiku 5.5, d'après mon test de Haiku. Il est aussi plus lent, à 128 tokens de sortie par seconde, ce qui compte en usage en direct. Et l'API a son propre piège. Le guide du dernier modèle d'OpenAI indique que lorsque l'effort de raisonnement n'est pas none, il faut retirer temperature et top_p, et Chat Completions ne prend en charge le function calling qu'à l'effort none. Pour des outils avec raisonnement, on utilise la Responses API.
Tarifs
| Tarif | Jusqu'à 272K d'entrée | Au-delà de 272K d'entrée |
|---|---|---|
| Entrée | $0.10 | $0.20 |
| Entrée en cache | $0.01 | $0.02 |
| Sortie | $0.50 | $0.75 |
| Batch / Flex entrée / sortie | $0.05 / $0.25 | $0.10 / $0.375 |
Source : tarifs de l'API OpenAI. Le guide des tarifs de Luna détaille le mode Fast et les tarifs régionaux.
Mon avis
Honnêtement, c'est le changement par défaut. Si votre usage de Haiku 5.5 dépasse régulièrement 100k tokens, ou si le coût par tâche compte plus pour vous que les derniers points de qualité, passez ici. Restez sur Haiku si vos évaluations montrent que ces 5 points de plus (ou le taux d'hallucination plus faible) se voient sur votre tâche réelle. Mon article sur les alternatives à GPT-6 Luna mène la comparaison dans l'autre sens.
2. Claude Haiku 4.5
Idéal pour : les pipelines qui dépendent de temperature: 0, du prefill ou de budgets de thinking manuels, le temps de les réécrire.
Ce qu'il fait mieux que Haiku 5.5
Rien sur les benchmarks, mais ce qu'il fait mieux, c'est ne pas casser votre code. Haiku 4.5 accepte toujours les paramètres d'échantillonnage, le prefill et budget_tokens que Haiku 5.5 rejette, son tarif est fixe sur toute sa fenêtre de 200k et son ancien tokenizer compte moins de tokens pour le même texte. Certaines équipes aiment aussi simplement sa sortie sur leur tâche précise.
"Not really. We use Haiku 4.5 to turn users' natural language queries and requests into fairly complex structured specs for interior design and construction. It has near perfect accuracy."
Là où il est en retrait
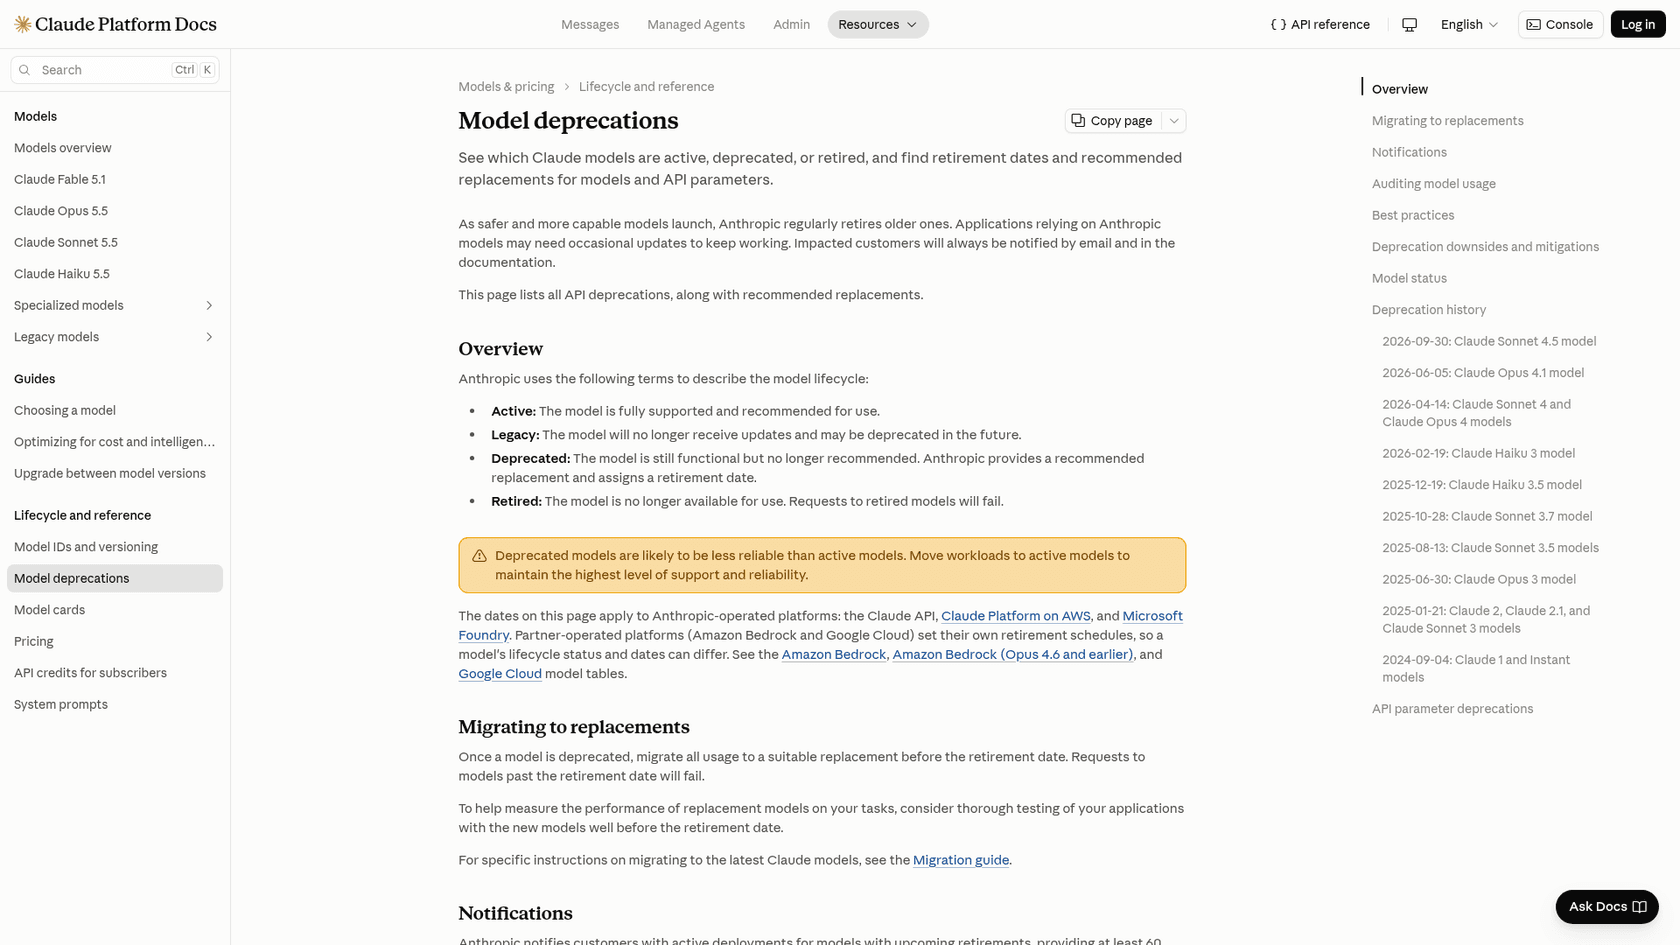
Il coûte 10x le prix au token de Haiku 5.5 sous 100k ($1 / $5 contre $0.10 / $0.50), et l'écart de capacité est énorme : OSWorld 2.1 est passé de 15.7% à 72.4% entre les deux. Le plus gros problème est le temps. La page des retraits liste claude-haiku-4-5-20251001 comme Active, avec un retrait "Not sooner than October 15, 2026". C'est un plancher, pas une date programmée, et Anthropic dit prévenir les clients avant un retrait. Construire quoi que ce soit de neuf dessus est donc un pari contre le calendrier.
Tarifs
| Tarif | Claude Haiku 4.5 |
|---|---|
| Entrée / sortie | $1 / $5 |
| Écriture de cache 5 minutes / 1 heure | $1.25 / $2 |
| Lecture de cache | $0.10 |
| Batch entrée / sortie | $0.50 / $2.50 |
Source : documentation tarifaire de Claude. Le guide des tarifs de l'API Anthropic couvre toute la gamme.
Mon avis
Utilisez-le comme un pont : gardez l'ancien pipeline sur 4.5 pendant que vous passez les étiquettes aux sorties structurées, puis faites tourner les deux modèles côte à côte sur les mêmes tickets. Ne démarrez rien de neuf ici.
3. Claude Sonnet 5.5
Idéal pour : les tâches que Haiku 5.5 remonte, surtout la programmation agentique et le travail long en plusieurs étapes.
Ce qu'il fait mieux que Haiku 5.5
L'écart est le plus large exactement là où Haiku est le plus faible, c'est-à-dire la programmation. Sur les benchmarks de lancement d'Anthropic, Sonnet 5.5 obtient 70.6% sur Terminal-Bench 4.0 contre 39.2% pour Haiku 5.5. Sur le travail de connaissance, l'écart est faible (1840 contre 1620 sur GDPval-AA), ce qui indique où Sonnet vaut son prix. Claude Sonnet 5.5 a aussi un tarif fixe sur toute sa fenêtre de 1M, et Anthropic a divisé par deux ses lectures de cache à $0.10 le jour du lancement de Haiku.
Là où il est en retrait
Il coûte 20x Haiku 5.5 au token sous 100k ($2 / $10), et il a les mêmes restrictions d'échantillonnage et de prefill, plus quelques-unes de son cru, comme le rejet d'un tool_choice forcé. Côté coût, le niveau d'effort compte aussi beaucoup : AA a mesuré $7.60 par tâche à effort maximal, c'est pourquoi mon test de Sonnet 5.5 recommande Medium pour la plupart des usages.
Tarifs
| Tarif | Claude Sonnet 5.5 |
|---|---|
| Entrée / sortie | $2 / $10 |
| Écriture de cache 5 minutes / 1 heure | $2.50 / $4 |
| Lecture de cache | $0.10 |
| Batch entrée / sortie | $1 / $5 |
Source : documentation tarifaire de Claude. L'article sur les tarifs de Sonnet 5.5 calcule des factures réelles par niveau d'effort.
Mon avis
Ne remplacez pas Haiku par Sonnet, orientez vers lui. Gardez le travail court et à gros volume sur un petit modèle et envoyez la programmation, le dépannage long et tout ce qui est à fort enjeu un cran au-dessus. Si ce sont les particularités propres de Sonnet 5.5 qui bloquent, mon article sur les alternatives à Sonnet 5.5 couvre cette catégorie.
4. DeepSeek V4.1 Flash
Idéal pour : les prompts longs et les traitements par lots à budget serré, avec des poids ouverts en solution de repli.
Ce qu'il fait mieux que Haiku 5.5
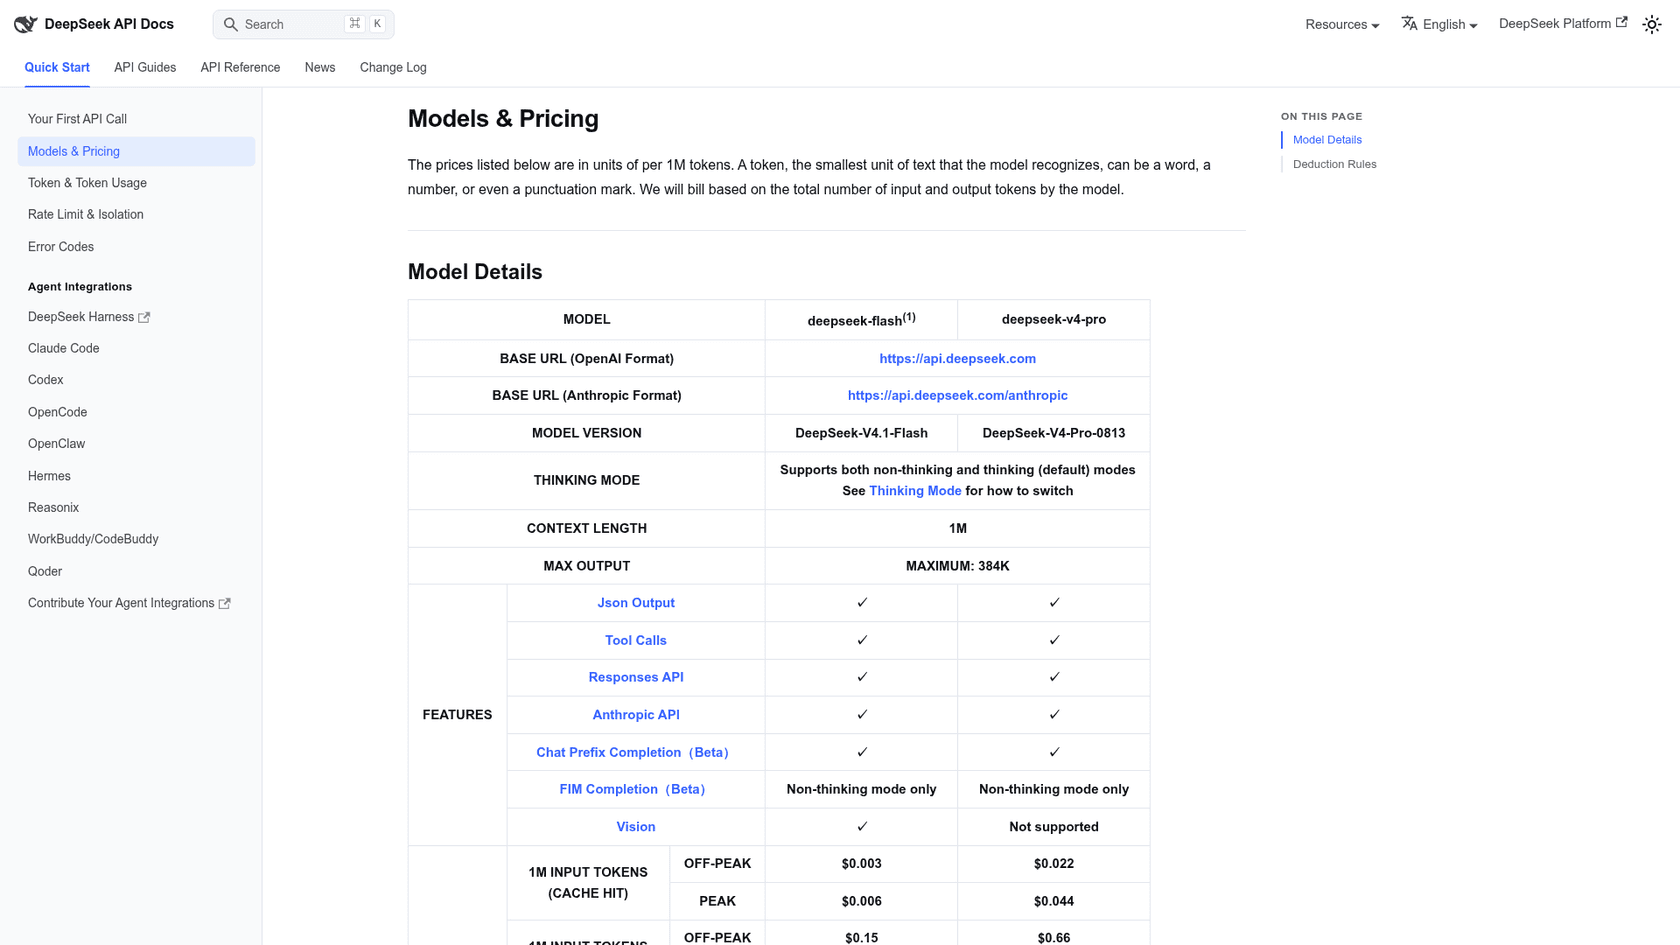
Pas de gouffre tarifaire. DeepSeek V4.1 Flash facture le même tarif du premier au millionième token, et hors pointe c'est $0.15 en entrée et $0.60 en sortie. Les hits de cache coûtent $0.003 hors pointe, un tiers des $0.01 de Haiku. Ainsi, sur un prompt de 150 000 tokens, l'entrée DeepSeek hors pointe coûte $0.0225 tandis que Haiku 5.5 coûte $0.075.
Il parle aussi le format d'API d'Anthropic, ce qui veut dire que pointer une intégration Claude existante vers lui revient surtout à changer l'URL de base, et il prend en charge le chat prefix completion (le prefill, dans le vocabulaire d'Anthropic) en bêta. Les poids sont sur Hugging Face sous licence MIT.
Là où il est en retrait
Deux pièges. Le tarif de pointe est le double, et les heures de pointe sont de 01:00 à 04:00 et de 06:00 à 10:00 UTC en semaine, soit la matinée de travail européenne. Et en mode thinking, le guide du mode thinking de DeepSeek dit que temperature "will not trigger an error but will also have no effect", donc le même problème d'étiquettes déterministes vous suit ici, mais en silence. AA lui donne 39, quatre points sous Haiku.
Tarifs
| Tarif | Hors pointe | Pointe |
|---|---|---|
| Entrée, cache miss | $0.15 | $0.30 |
| Entrée, cache hit | $0.003 | $0.006 |
| Sortie | $0.60 | $1.20 |
Source : tarifs DeepSeek. Mon article sur les tarifs de V4.1 Flash couvre le calcul des heures de pointe.
Mon avis
Le choix pour le traitement par lots en contexte long, là où le gouffre des 100k fait le plus mal, comme résumer de longs historiques de tickets pendant la nuit. Vérifiez d'abord la résidence des données et les règles fournisseurs de votre entreprise, car certaines équipes ne peuvent pas envoyer de données clients à une API basée en Chine, et l'auto-hébergement des poids ouverts est la solution de contournement.
5. GLM-5.3 Flash
Idéal pour : les équipes qui veulent un modèle à poids ouverts à un point de Haiku 5.5.
Ce qu'il fait mieux que Haiku 5.5
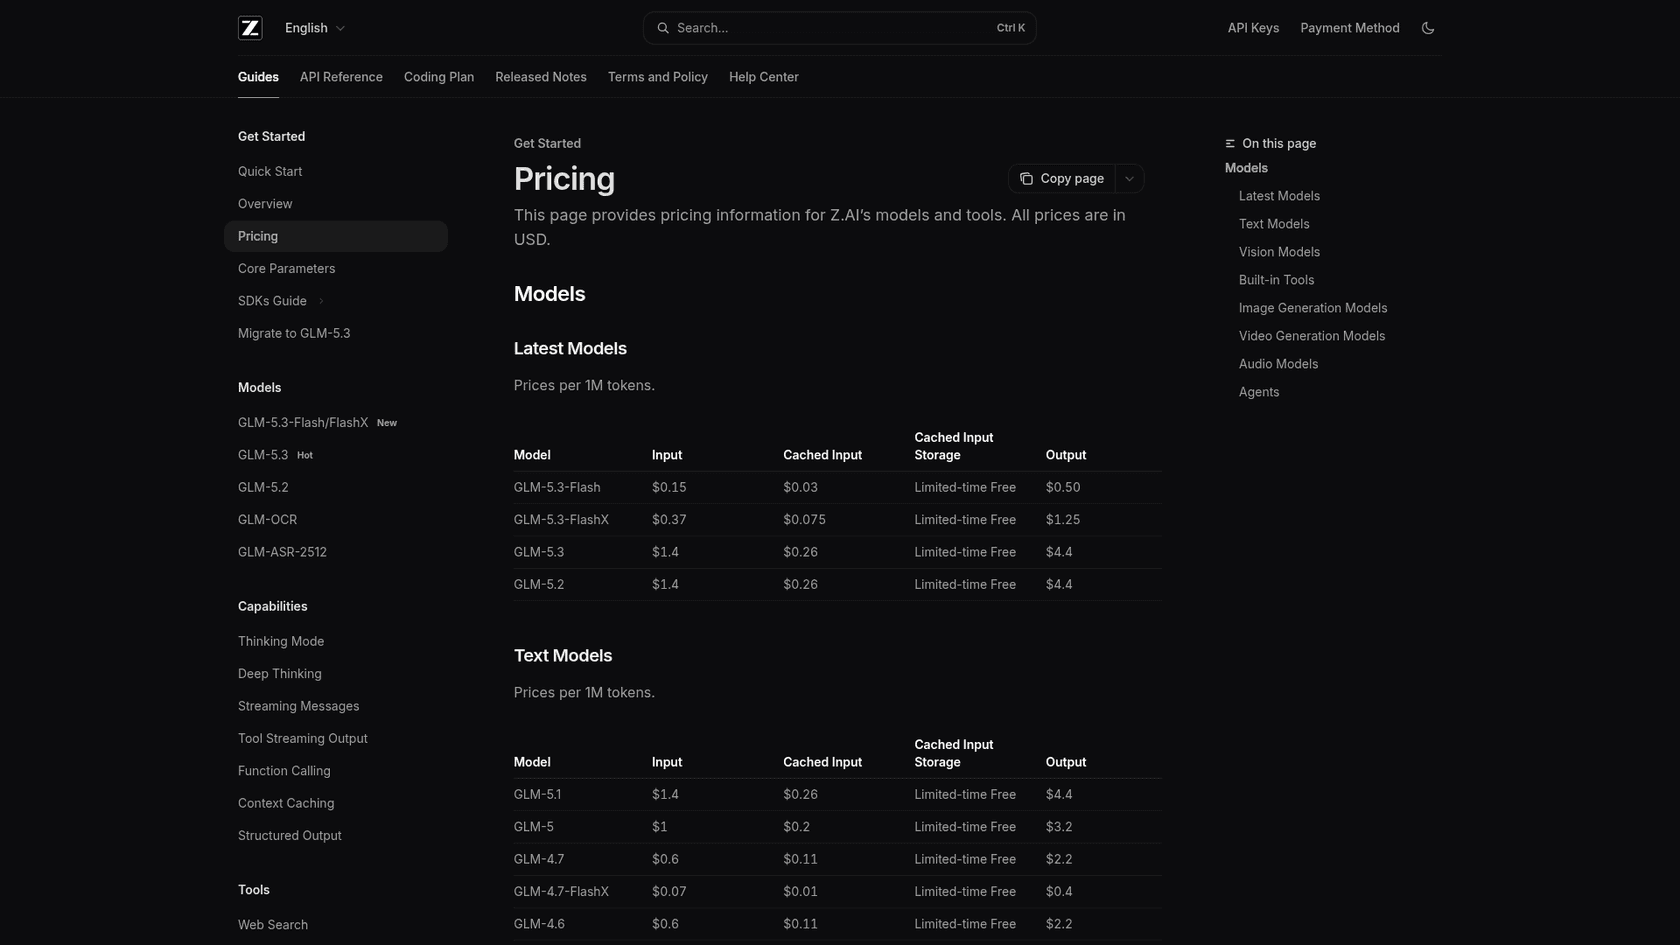
Le score par dollar sans gouffre. GLM-5.3 Flash obtient 42 sur Artificial Analysis, un point sous Haiku 5.5, à $0.15 en entrée et $0.50 en sortie fixes sur une fenêtre de 1M. Le prix de sortie égale le palier économique de Haiku, et vous ne payez jamais le saut de 5x. Les poids sont publics sur Hugging Face, vous pouvez donc le faire tourner sur votre propre matériel ou via un hébergeur tiers.
Certains développeurs l'utilisent déjà comme modèle bon marché de tous les jours :
"Not me, I use GLM-5.3-Flash for almost everything (the subscription-subsidized pricing on a legacy Z.ai plan makes it the best value model by a wide margin), along with some MiMo and DeepSeek."
Là où il est en retrait
La vitesse est le problème. AA mesure 51 tokens de sortie par seconde sur l'API directe, contre 243 pour Haiku 5.5, il convient donc mal à tout ce qu'une personne attend. Le thinking ne peut pas non plus être désactivé : la page du modèle indique "thinking.type only supports enabled", et Z.ai recommande temperature: 1. L'entrée est aussi à $0.15 contre $0.10 pour Haiku, donc les prompts très courts et lourds en entrée coûtent un peu plus.
Tarifs
| Tarif | GLM-5.3 Flash | GLM-5.3 FlashX |
|---|---|---|
| Entrée | $0.15 | $0.37 |
| Entrée en cache | $0.03 | $0.075 |
| Sortie | $0.50 | $1.25 |
Source : tarifs Z.AI. Mon test de GLM-5.3 Flash et l'article sur les tarifs vont plus loin.
Mon avis
La meilleure réponse à poids ouverts à Haiku 5.5 sur la qualité, et un choix solide pour les tâches de fond, même si je l'éviterais pour le chat en direct, où sa vitesse se remarque. L'article sur les alternatives à GLM-5.3 Flash couvre ses voisins.
6. Gemini 3.5 Flash-Lite
Idéal pour : les tâches simples à très gros volume où le débit compte plus que l'intelligence.
Ce qu'il fait mieux que Haiku 5.5
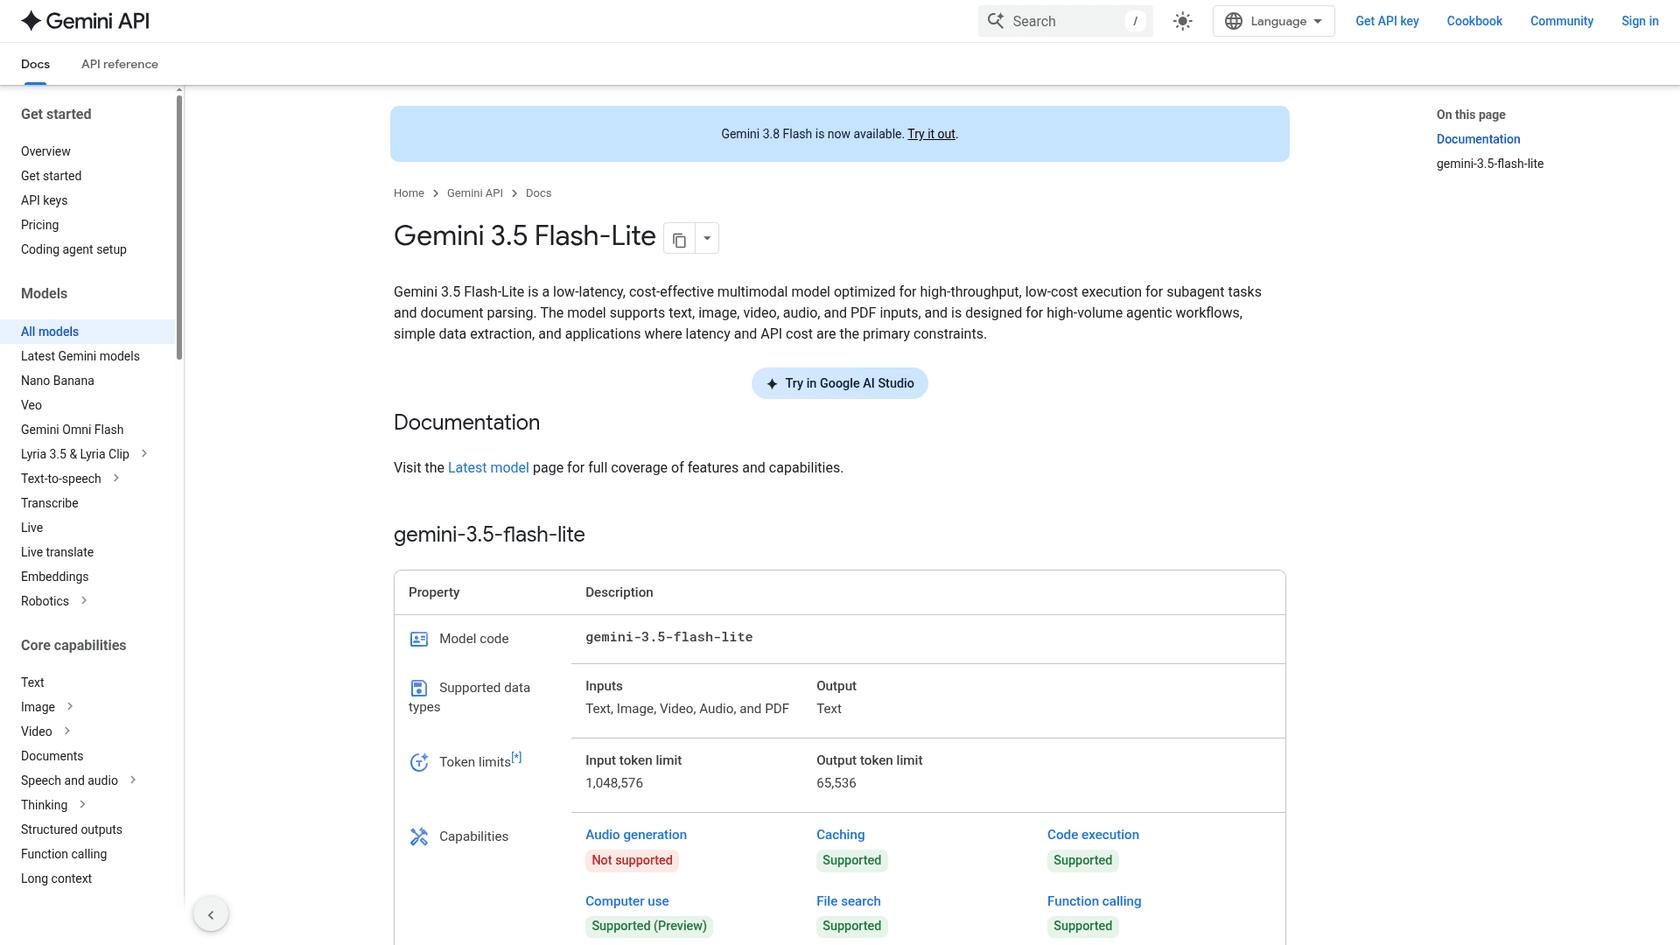
C'est le modèle le plus rapide ici, à 346 tokens de sortie par seconde sur Artificial Analysis, et le moins bavard : 59M de tokens sur l'index AA contre 440M pour Haiku. Le tarif est fixe sur sa fenêtre de 1M, il accepte texte, image, vidéo, audio et PDF en entrée, et Google propose aussi un palier gratuit pour tester. Gemini 3.5 Flash-Lite est conçu pour l'analyse, l'étiquetage et le routage à grande échelle.
Là où il est en retrait
L'intelligence est l'écart. Il obtient 22 sur AA, environ la moitié des 43 de Haiku 5.5, et son coût par tâche ($0.19) atterrit quand même près de celui de Haiku parce que son prix de sortie est de $2.50, cinq fois le palier économique de Haiku. La sortie maximale est de 65 536 tokens. Et le guide Gemini 3 de Google recommande vivement de garder temperature à 1.0 pour tous les modèles Gemini 3, avertissant que des valeurs plus basses peuvent provoquer du "looping or degraded performance".
Tarifs
| Tarif | Gemini 3.5 Flash-Lite |
|---|---|
| Entrée / sortie | $0.30 / $2.50 |
| Cache de contexte | $0.03, plus stockage |
| Palier gratuit | Oui |
Source : tarifs de l'API Gemini. L'article sur les tarifs de Flash-Lite couvre les paliers batch et prioritaire.
Mon avis
Utilisez-le pour l'étape la plus bête et au plus gros volume d'un pipeline, comme la détection de langue ou le filtrage de spam, et tenez-le loin de tout ce qui demande du jugement. Honnêtement, pour la plupart des utilisateurs de Haiku 5.5, c'est un pas en arrière, pas un pas de côté.
7. Gemini 3.8 Flash
Idéal pour : les longues tâches d'agents pour les équipes déjà sur Google Cloud, où le raisonnement supplémentaire du modèle est rentable.
Ce qu'il fait mieux que Haiku 5.5
Un tarif fixe sur une fenêtre de 1M et de bons résultats sur le travail agentique long, ainsi que toute la boîte à outils Google (ancrage par recherche, palier gratuit, Vertex AI). Gemini 3.8 Flash obtient 41 sur AA à effort élevé, proche de Haiku 5.5, et c'est le choix naturel si vos données et vos contrats vivent déjà dans Google Cloud.
Là où il est en retrait
Coût et temps d'attente, surtout. AA le place à $1.24 par tâche, environ 6x Haiku 5.5, et le prix sur la page tarifaire de Google double le 1er janvier 2027, de $0.75/$3.75 à $1.50/$7.50. AA a aussi mesuré 13.3 secondes jusqu'au premier token au lancement, ce que mon test de Gemini 3.8 Flash signale comme un problème pour tout ce qu'un client regarde. Le conseil sur temperature est le même que pour Flash-Lite : laissez-la à 1.0.
Tarifs
| Tarif | Jusqu'au 31 déc. 2026 | À partir du 1er janv. 2027 |
|---|---|---|
| Entrée | $0.75 | $1.50 |
| Sortie, thinking inclus | $3.75 | $7.50 |
| Lecture de cache | $0.075 | $0.15 |
| Batch entrée / sortie | $0.375 / $1.875 | $0.75 / $3.75 |
Source : tarifs de l'API Gemini. L'article sur les tarifs de Gemini 3.8 Flash détaille le palier prioritaire.
Mon avis
Pas un remplaçant équivalent de Haiku. C'est un modèle plus cher pour du travail d'agent plus lourd, ce qui veut dire que le changement de prix de janvier en fait un moins bon rapport qualité-prix l'an prochain. Si vous voulez l'option Google, budgétez dès maintenant au tarif 2027. L'article sur les alternatives à Gemini 3.8 Flash couvre cette catégorie.
Le problème de temperature 0 vous suit
C'est la raison que je vois le plus souvent quand les équipes expliquent pourquoi elles changent, d'où sa section à part. Haiku 5.5 renvoie une erreur pour tout temperature non par défaut, et beaucoup de pipelines de tri de tickets ont été construits sur temperature 0 pour des étiquettes cohérentes, plus du prefill pour forcer une accolade ouvrante JSON.
Le plus inconfortable, c'est que le reste de la catégorie économique a bougé dans le même sens.
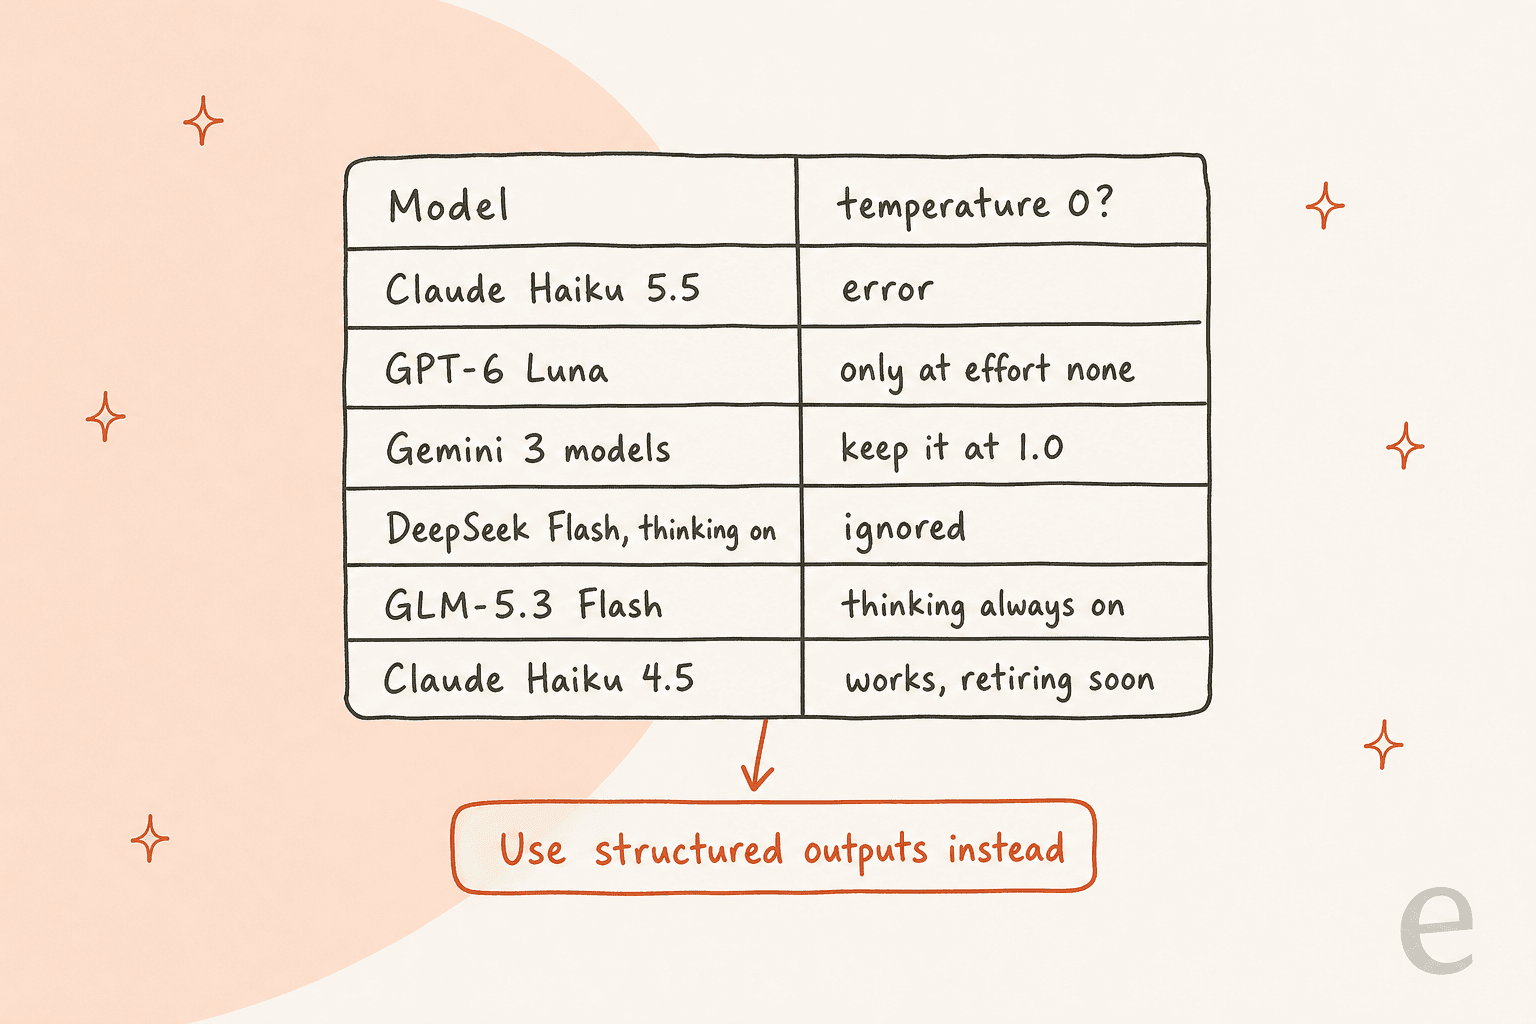
Les modèles de raisonnement échantillonnent leur réflexion, et les fournisseurs ont décidé que les basses températures nuisent plus qu'elles n'aident. Donc changer de fournisseur pour garder temperature 0 vous fait gagner quelques mois tout au plus. La solution durable consiste donc à ne plus compter sur l'échantillonnage pour la cohérence.
- Utilisez des sorties structurées ou des schémas d'outils stricts pour imposer un ensemble fixe d'étiquettes. Le modèle ne peut répondre qu'avec l'une de vos catégories, quelle que soit sa temperature.
- Abandonnez le prefill. Terminez vos messages par un tour utilisateur et mettez la règle de format dans le prompt ou le schéma.
- Utilisez un effort faible pour la classification. Moins de thinking, c'est moins d'occasions de divaguer et aussi une facture plus basse.
- Mesurez la cohérence, ne la présumez pas. Passez les mêmes 200 tickets deux fois et comptez les changements d'étiquette. Ce chiffre en dit plus que n'importe quel réglage de temperature.
Il y a une leçon connexe tirée des appels commerciaux d'eesel. Un responsable CX d'une marque DTC de compléments alimentaires, qui traite environ 7 000 tickets par mois, a dit à l'équipe ce qu'il voulait vraiment :
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
C'est le vrai but derrière la plupart des configurations à temperature 0. Pas une formulation identique, mais savoir quand le modèle est sûr de lui. Le routage fondé sur la confiance, où l'IA répond à ce dont elle est sûre et laisse le reste à un humain, y mène plus fiablement que n'importe quel réglage d'échantillonnage, et fonctionne de la même façon sur tous les modèles de cette liste.
Quelle alternative à Claude Haiku 5.5 pour quel travail
Voici comment je trancherais, par tâche plutôt que par benchmark.
| Vous faites tourner | Mon choix | Pourquoi |
|---|---|---|
| Classification courte, étiquetage, routage | Rester sur Haiku 5.5, ou Luna si le coût par tâche l'emporte | Tous deux $0.10/$0.50 sous 100k ; Luna écrit moins de tokens |
| Boucles d'agents qui dépassent 100k tokens | GPT-6 Luna | Le palier arrive à 272k et seulement de 2x / 1.5x |
| Résumés par lots en contexte long | DeepSeek V4.1 Flash, hors pointe | $0.15 / $0.60 fixes jusqu'à 1M de tokens |
| Pipelines à temperature 0 ou prefill | Haiku 4.5 à court terme, sorties structurées à long terme | Tout modèle de raisonnement restreint l'échantillonnage |
| Programmation agentique | Claude Sonnet 5.5 | 70.6% contre 39.2% sur Terminal-Bench 4.0 |
| Poids ouverts ou auto-hébergement | GLM-5.3 Flash ou DeepSeek V4.1 Flash | AA 42 et 39, tous deux sur Hugging Face |
| Filtrage simple à très gros volume | Gemini 3.5 Flash-Lite | 346 tok/s, le moins bavard |
Un dernier point pratique avant de migrer. La plupart des équipes finissent avec deux modèles, pas un : un économique pour le gros du volume et un plus malin pour les escalades. Ce schéma marche avec n'importe quelle paire ici, vous n'êtes donc pas lié à un fournisseur. Pour le support, mon guide sur quel LLM convient au support et la liste des meilleurs modèles d'IA pour les tickets vont plus loin.
Essayez eesel plutôt que de reconstruire votre pipeline de tickets
Si vous cherchez une alternative à Haiku 5.5 pour faire tourner une file de support, le modèle est honnêtement la plus petite moitié du problème. eesel est un coéquipier de helpdesk IA qui rejoint le helpdesk que vous utilisez déjà, comme Zendesk, Freshdesk ou Gorgias, apprend de vos anciens tickets et de votre centre d'aide, et gère la classification des tickets, les résumés et les réponses. Quand un fournisseur ajoute un gouffre tarifaire ou se met à rejeter un paramètre, c'est à eesel de migrer, pas à vous.

Avant de répondre à un seul client, chaque déploiement est simulé sur vos tickets historiques, pour que vous voyiez quels tickets il résoudrait et lesquels il passerait à votre équipe. Cela vous donne le routage fondé sur la confiance que demandait le responsable CX aux 7 000 tickets, sans réglage de temperature en vue.
Si vous travaillez depuis un terminal, la CLI d'eesel pilote le même coéquipier et le même espace de travail que le tableau de bord. Vous pouvez la scripter ou la brancher à la CI, et aussi laisser un agent de programmation comme Claude Code la lancer. Mon article sur la CLI d'agent IA couvre cette configuration.
Les forfaits payants commencent à $299 pour 500 crédits, et vous pouvez d'abord l'essayer gratuitement sur une tranche de vos vrais tickets. Essayez eesel.