

Qu'est-ce que Claude Haiku 5.5 ?
Claude Haiku 5.5 est le petit modèle de la gamme actuelle d'Anthropic. On le choisit quand une tâche tourne des milliers de fois par jour et que chaque exécution est courte. L'annonce de lancement d'Anthropic le qualifie de "the cheapest, fastest, and most capable small model we've ever released" et nomme les tâches pour lesquelles il a été conçu : résumés, compactions, requêtes de base de données, classification, support client en direct et utilisation du navigateur.
Je construis des agents IA chez eesel et, franchement, l'essentiel de ce que font ces agents toute la journée n'est pas du raisonnement difficile. Ils lisent un ticket et décident où il va, ils extraient un numéro de commande d'un message, parfois ils écrivent un résumé de trois lignes pour que la personne suivante n'ait pas à faire défiler. Pendant des années, ce travail était dans une position inconfortable : un bon modèle coûtait trop cher pour cela, et un modèle bon marché n'arrêtait pas de le rater. Haiku 5.5 vise exactement cet endroit.
Il y avait aussi un trou dans la gamme d'Anthropic, et ceci le comble. Avant ce lancement, le Claude actuel le moins cher était Sonnet 5.5 à $2/$10, et Haiku 4.5 à $1/$5 avait pris un net retard sur des concurrents moins chers comme GPT-6 Luna. Comme l'a dit un développeur sur X une semaine avant le lancement, l'espace des petits modèles pas chers était "mostly chinese labs", avec Luna comme seule exception.
Les spécifications de Claude Haiku 5.5 en un coup d'œil
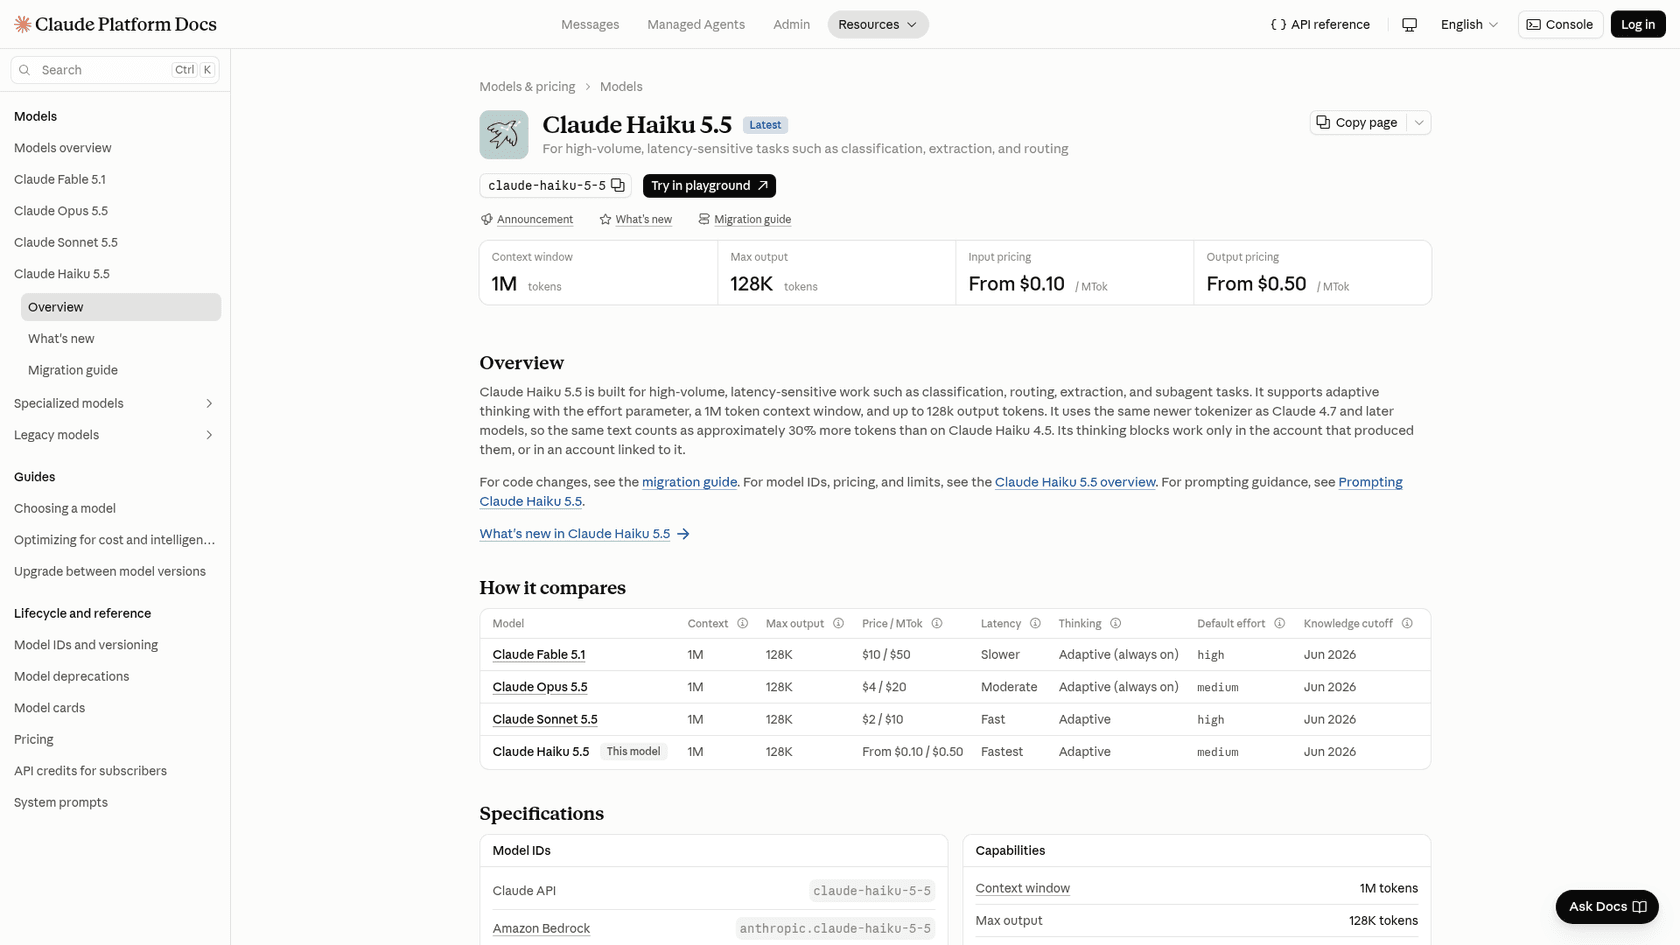
Voici la fiche technique telle qu'elle est aujourd'hui, tirée de la page de présentation de Haiku 5.5 dans la documentation d'Anthropic.
| Spécification | Claude Haiku 5.5 |
|---|---|
| ID de modèle API | claude-haiku-5-5 (pas de suffixe de date, pas d'alias séparé) |
| ID Amazon Bedrock | anthropic.claude-haiku-5-5 |
| Sortie | 7 octobre 2026 |
| Fenêtre de contexte | 1M de tokens |
| Sortie maximale | 128K tokens (300K sur la Batch API, en bêta) |
| Réflexion | Adaptative, activée par défaut |
| Effort par défaut | medium |
| Entrée / sortie | Texte et images en entrée, texte en sortie |
| Date limite des connaissances | Juin 2026 |
| Plateformes | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS |
| Retrait | Pas avant le 7 octobre 2027 |
Quelques détails de ce tableau passent inaperçus. D'abord, l'ID du modèle n'a pas de snapshot daté, donc claude-haiku-5-5 est le nom fixe et non un alias qui se déplacera plus tard. Ensuite, avec un en-tête bêta, la Batch API peut renvoyer jusqu'à 300K tokens en sortie, ce qui est pratique si vous utilisez Haiku pour écrire de longs fichiers structurés pendant la nuit.
Où se situe Haiku 5.5 dans la gamme Claude
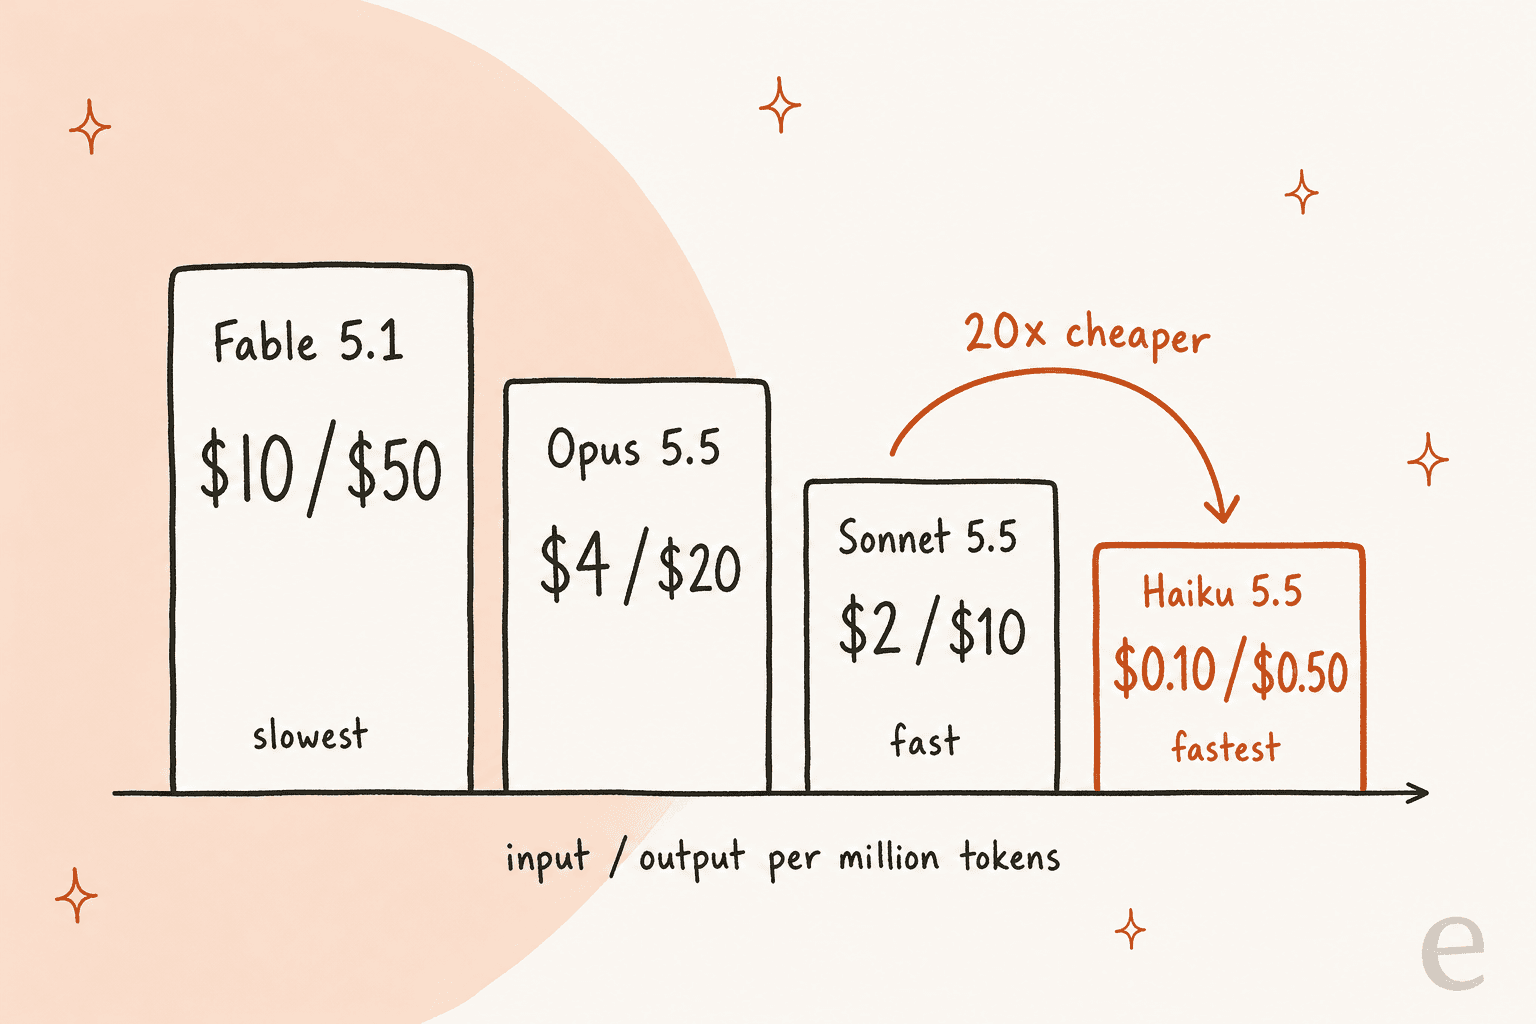
Anthropic propose désormais quatre modèles actuels. Haiku 5.5 se trouve en bas de l'échelle, qui est ici l'extrémité rapide et bon marché.
| Modèle | Idéal pour | Latence | Prix entrée / sortie par 1M | Effort par défaut |
|---|---|---|---|---|
| Claude Fable 5.1 | Raisonnement exigeant, agents à long horizon | Plus lent | $10 / $50 | high |
| Claude Opus 5.5 | Programmation agentique de longue durée et travail de connaissance | Modérée | $4 / $20 | medium |
| Claude Sonnet 5.5 | Meilleur mélange de vitesse et d'intelligence | Rapide | $2 / $10 | high |
| Claude Haiku 5.5 | Classification, extraction, routage, sous-agents | La plus rapide | À partir de $0.10 / à partir de $0.50 | medium |
Les quatre partagent la même fenêtre de contexte de 1M, la même limite de sortie de 128K et la même date limite de connaissances de juin 2026, d'après l'aperçu des modèles. La fenêtre n'est plus une raison de choisir un modèle plutôt qu'un autre. Ce qui reste à trancher, c'est le prix et la vitesse, ainsi que la difficulté réelle de la tâche.
Anthropic ne prétend pas non plus que Haiku est un Sonnet pas cher. Son annonce dit que Sonnet 5.5 et Opus 5.5 "remain better choices for complex agentic coding tasks", et que Haiku 5.5 convient aux travaux bien délimités comme la compaction, le résumé et les tâches de sous-agents. Pour moi, cette phrase vaut plus que tout le reste de l'annonce, et je la garde en tête pour chaque décision ci-dessous.
Ce qui est nouveau par rapport à Haiku 4.5
Haiku 4.5 est sorti un an avant celui-ci. D'après le numéro de version, on attendrait un petit pas, mais le saut est bien plus grand.
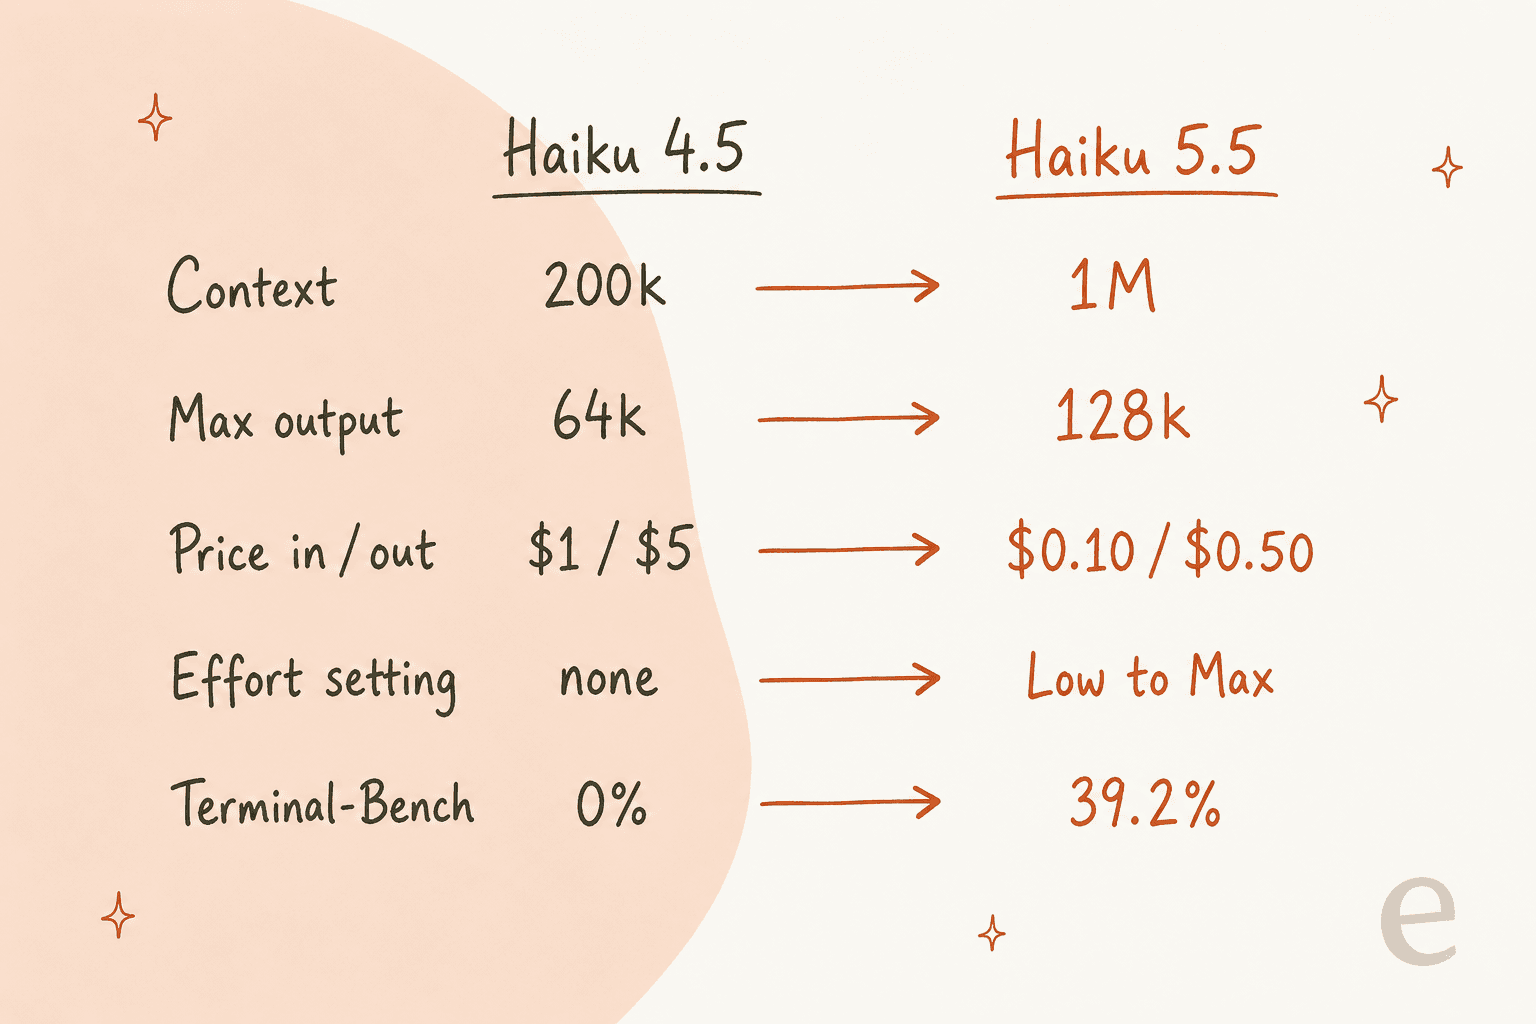
La page des nouveautés d'Anthropic liste 13 changements : 4 nouvelles capacités, 5 changements cassants et 4 changements de comportement. Ci-dessous, je ne passe en revue que ceux qui changent la façon dont vous utilisez réellement le modèle.
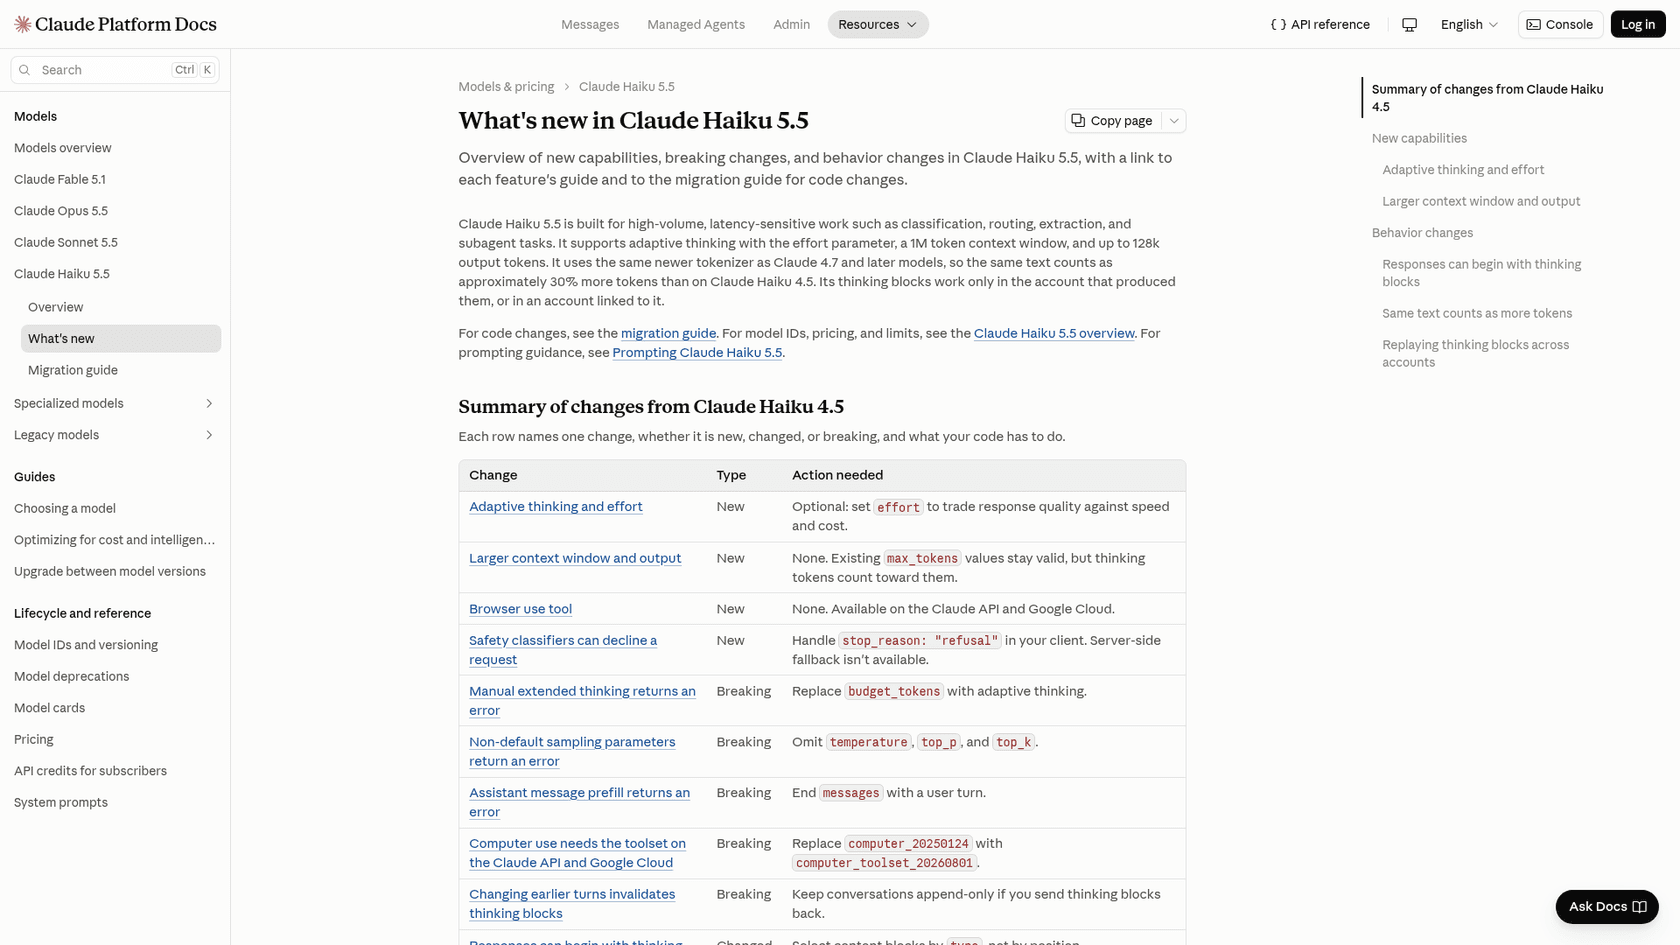
Réflexion adaptative et réglage d'effort
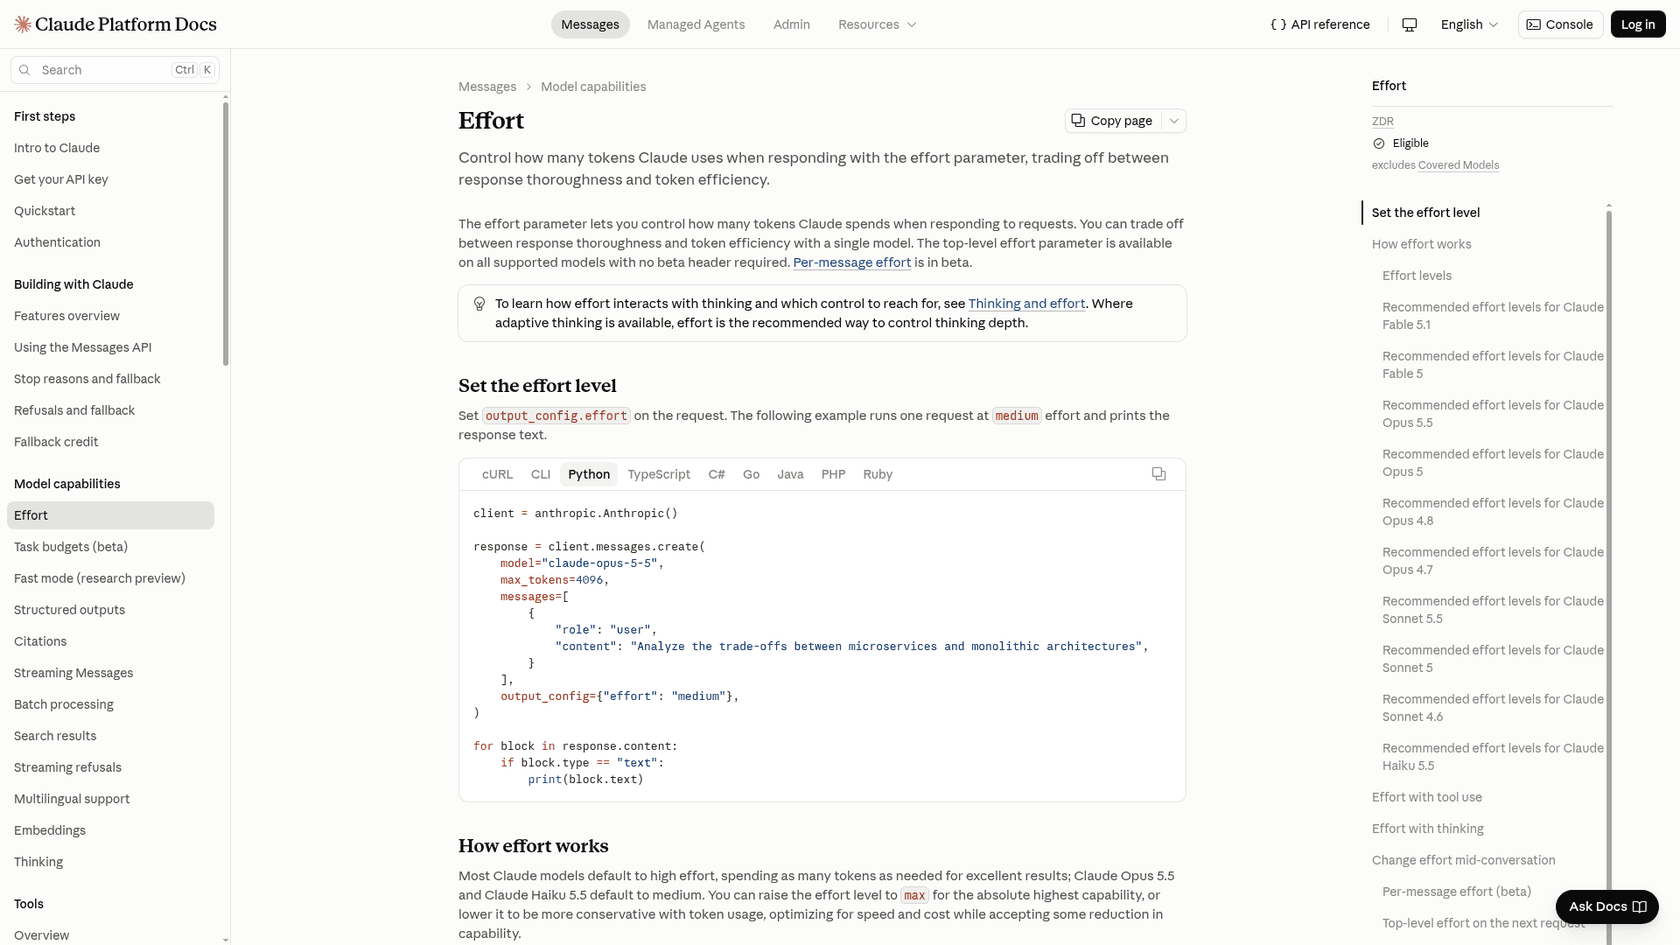
Haiku 5.5 est le premier modèle de la classe Haiku avec un réglage d'effort ajustable. La réflexion est adaptative et activée par défaut. En pratique, le modèle décide lui-même quand réfléchir et pendant combien de temps, et votre levier est effort plutôt qu'un budget de réflexion fixe. À un effort plus faible, une demande simple peut n'avoir aucune réflexion. Ce que fait chaque niveau, je le détaille plus bas.
Une fenêtre de 1M et des sorties de 128K
Le contexte est passé de 200k à 1M de tokens et la sortie maximale de 64k à 128K. Attention ici : les tokens de réflexion comptent dans max_tokens. Si vous avez réglé cette limite au plus juste pour Haiku 4.5, la réponse peut maintenant s'arrêter juste après le bloc de réflexion, avant qu'un texte ne sorte.
Utilisation du navigateur et de l'ordinateur
Haiku 5.5 prend en charge l'outil d'utilisation du navigateur sur la Claude API et Google Cloud, et Anthropic a publié le même jour un SDK d'utilisation du navigateur et de l'ordinateur pour Python et TypeScript. Selon Anthropic, Haiku 5.5 est "especially well-suited" à ces tâches grâce à sa vitesse et son prix. Le score de 72,4 % sur OSWorld 2.1 (contre 15,7 % pour Haiku 4.5) étaye cette affirmation.
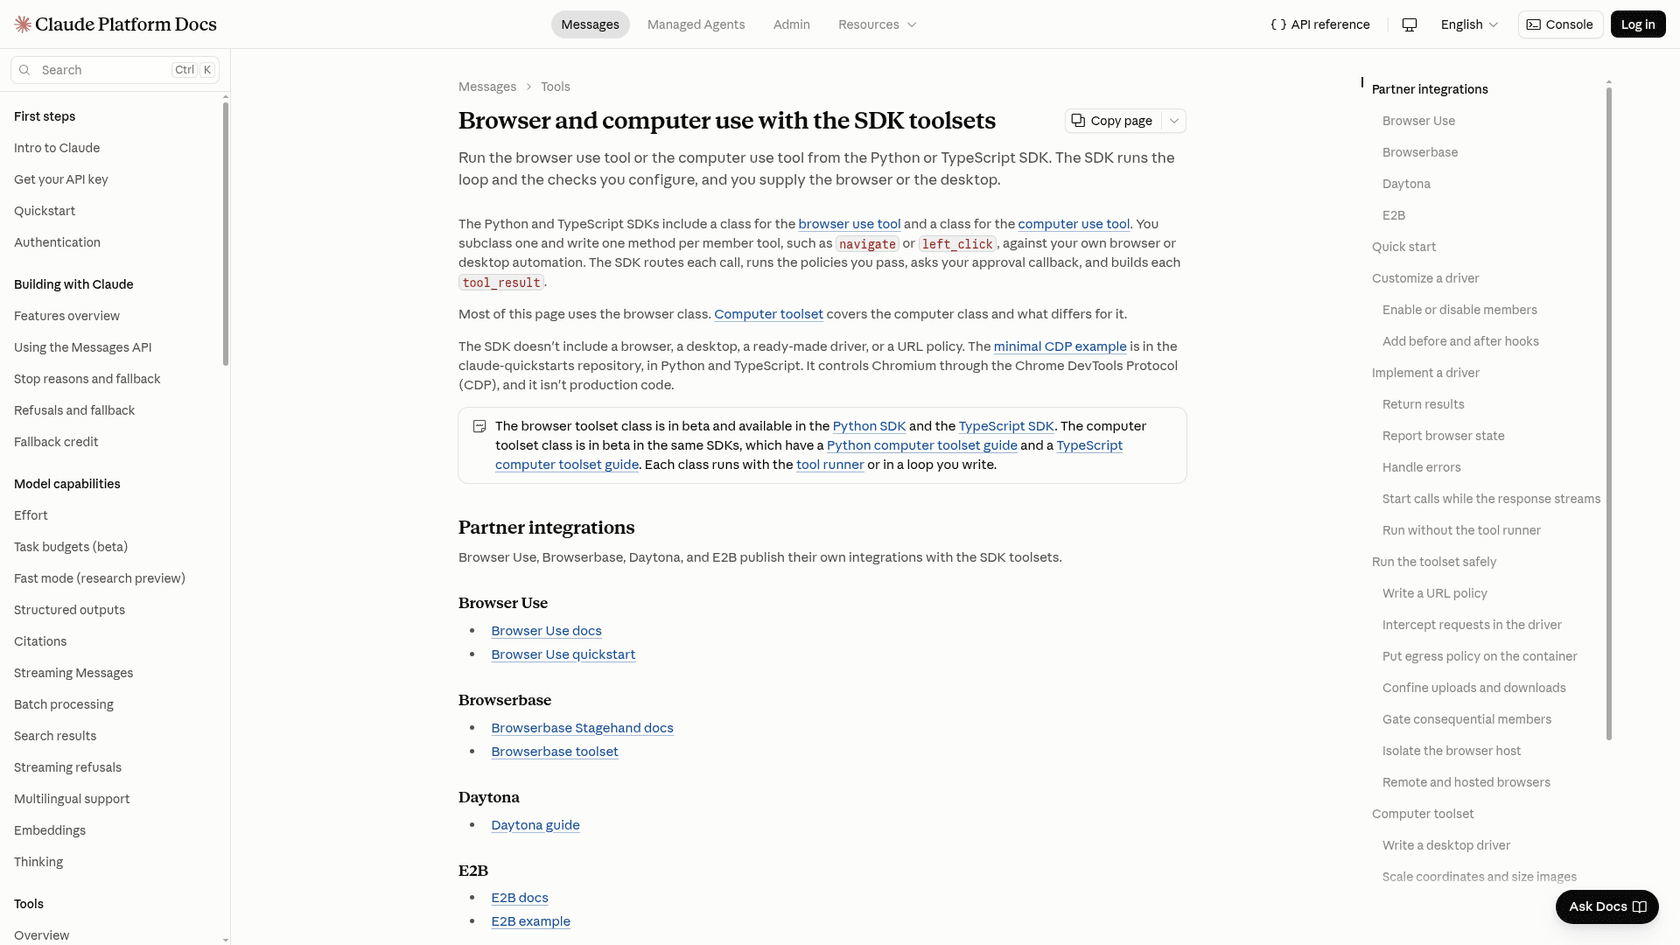
À savoir avant de vous enthousiasmer : le SDK est livré sans navigateur, sans bureau et sans aucune politique d'URL. Le pilote est à apporter vous-même, et les exemples de démarrage de la documentation portent la mention "not production code". Si en écrire un ne vous tente pas, Browser Use, Browserbase, Daytona et E2B publient déjà des intégrations prêtes à l'emploi.
Un nouveau tokenizer
Haiku 5.5 utilise le même tokenizer plus récent que Sonnet 5.5 et Opus 5.5, et le guide de migration indique que le même texte produit environ 30 % de tokens en plus que sur Haiku 4.5. Cela explique pourquoi le chiffre phare d'Anthropic dit "around 75% less to run" et non 90 %. Par token, le prix a baissé de 90 %, mais chaque tâche consomme désormais plus de tokens.
Comment le réglage d'effort change Haiku 5.5
Si je ne devais consacrer mon temps qu'à une seule partie de Haiku 5.5, ce serait celle-ci, car rien d'autre ne modifie autant le comportement du modèle. La documentation sur l'effort décrit cinq niveaux, et Haiku utilise medium par défaut là où la plupart des modèles Claude utilisent high.
Artificial Analysis a fait tourner Haiku 5.5 à chaque niveau, et le compromis constaté n'a rien de subtil. Son score de l'Intelligence Index passe de 29,4 en Low à 43,4 en Max, mais le délai avant le premier morceau de sortie, réflexion comprise, passe d'environ 14 secondes à 415 secondes.
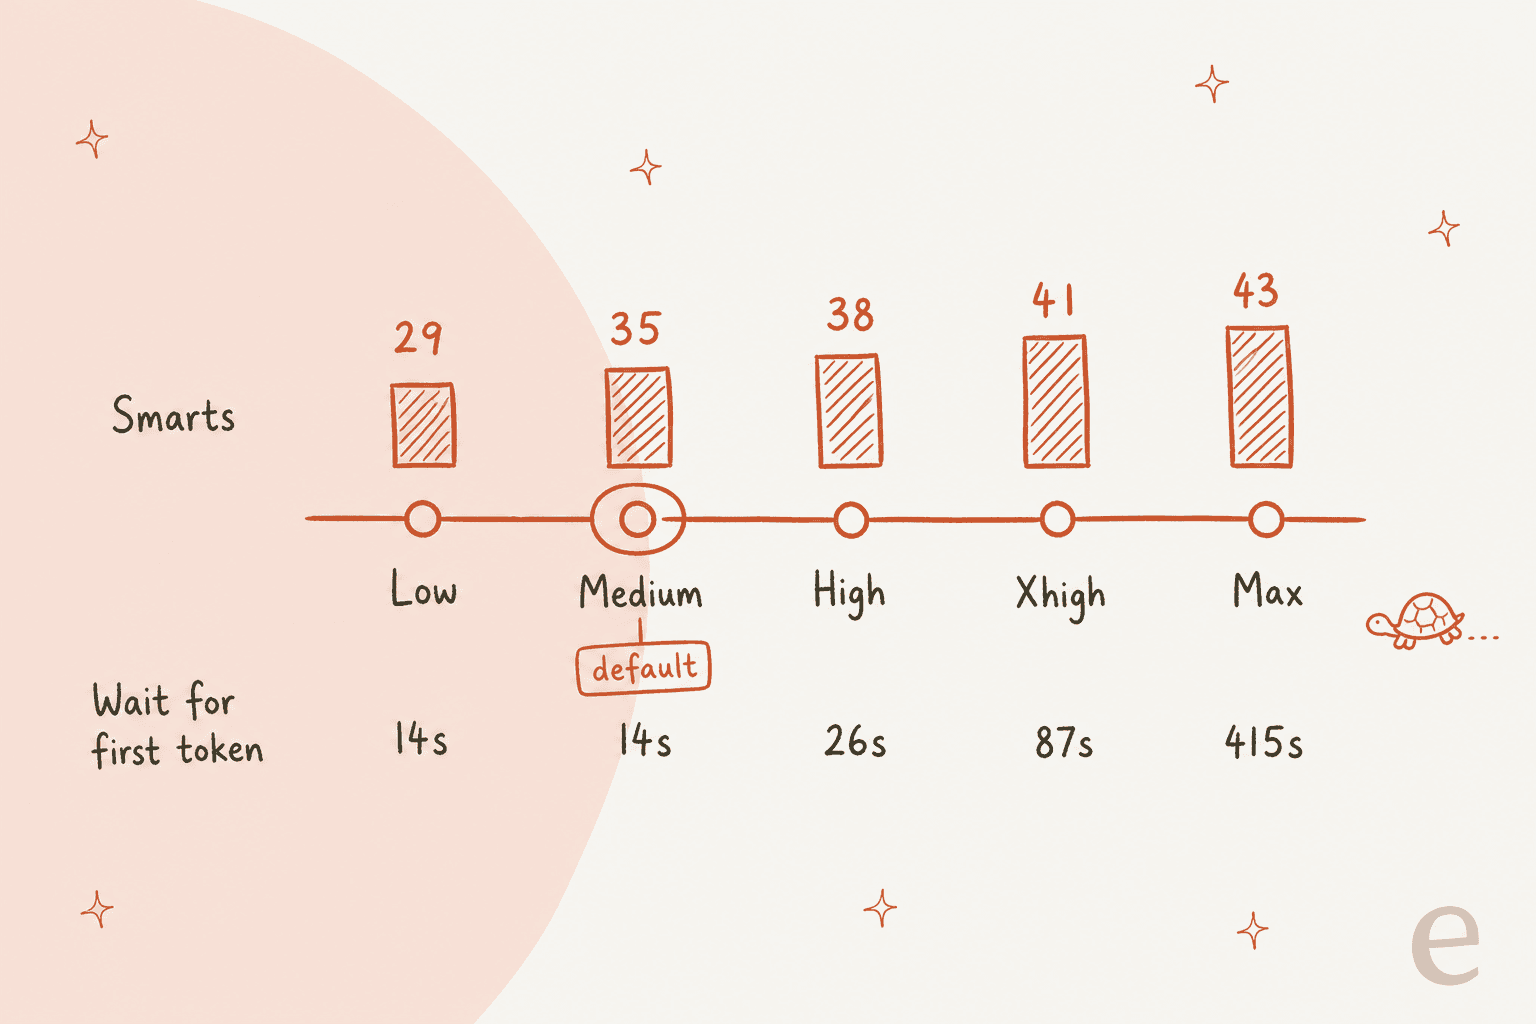
| Effort | AA Intelligence Index | Tokens de sortie pour exécuter l'index | Vitesse de sortie | Délai avant le premier morceau |
|---|---|---|---|---|
| Low | 29.4 | 32M | 181 tokens/s | 13.6 s |
| Medium (par défaut) | 34.5 | 54M | 137 tokens/s | 14.2 s |
| High | 37.8 | 97M | 173 tokens/s | 26.2 s |
| Xhigh | 41.2 | 180M | 188 tokens/s | 86.8 s |
| Max | 43.4 | 440M | 243 tokens/s | 415.3 s |
Je lis ce tableau plutôt comme une grille de prix déguisée. Passer de Medium à Max achète 9 points, que vous payez avec environ 8 fois plus de tokens de sortie. Artificial Analysis a aussi noté dans son post de lancement sur X que passer de Xhigh à Max "adds 2 points for ~1.8x the tokens".
Sur une toute petite tâche, le test du pélican de Simon Willison dessine la même courbe :
"Low messes up the bicycle frame, but medium/high/xhigh/max all get the bicycle frame right. The max one took 5 minutes 9 seconds and cost 3.3826 cents. The cheapest one (low) cost 0.0936 cents and took 7 seconds."

La règle empirique à laquelle je suis arrivé en construisant des agents est la suivante. Tout ce qui a un ensemble de réponses fixe, comme des étiquettes ou du routage, démarre en Low. Tout ce qui rédige de la prose qu'un client va lire démarre en Medium. Et quand une tâche ne sort correctement qu'en High ou au-dessus, cela indique généralement que c'était une tâche pour Sonnet depuis le début.
Claude Haiku 5.5 est-il bon ?
Pour sa taille, il est très bon, même si l'on sent encore que c'est un petit modèle. Voici les benchmarks publiés par Anthropic à leurs réglages phares.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (travail de connaissance, Elo) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 (travail de connaissance, Elo) | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 (utilisation de l'ordinateur) | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity's Last Exam (sans outils) | 45.9% | 10.2% | n/a | 56.9% |
| Terminal-Bench 4.0 (programmation agentique) | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1 (programmation agentique) | 46.4% | n/a | 42.4% | 52.1% |
| Chartography (raisonnement visuel, sans outils) | 46.4% | 6.4% | 29.1% | 61.6% |
Le schéma se confirme sur toute la ligne. Partout où il a été testé, Haiku 5.5 bat GPT-6 Luna, et il se situe près de Sonnet 5.5 sur le travail de connaissance et l'utilisation de l'ordinateur. La programmation agentique longue est le domaine où il décroche nettement par rapport à Sonnet.
Sur la page de lancement, les premiers retours de clients racontent à peu près la même histoire, en mots plus simples. HubSpot a dit avoir obtenu "the best score we've seen on this suite yet, at 92.8%" sur ses tâches CRM. AlphaSense a mesuré 0,84 contre 0,76 pour Haiku 4.5 sur une charge de questions-réponses sur documents d'environ 8M d'appels par semaine. Box a rapporté 11 points de plus que Haiku 4.5 avec environ la moitié de la latence.
Une mise en garde d'Artificial Analysis mérite d'être gardée en tête. Haiku 5.5 connaît moins de faits que les plus gros modèles, avec 36 % de précision à son test AA-Omniscience, mais il dit plus volontiers "I don't know", si bien que son taux d'hallucination est de 40 %, contre 77 % pour GPT-6 Luna. Quand un client va lire la sortie, ce chiffre m'importe plus que le score de l'index. La leçon pratique : donnez à Haiku votre centre d'aide, ne comptez pas sur ce dont il se souvient.
Tarifs de Claude Haiku 5.5
Parmi les modèles Claude actuels, seul Haiku 5.5 a deux paliers de prix. Celui que vous payez dépend de la longueur du prompt, et la page des tarifs liste chaque ligne.
| Prix par 1M de tokens | Prompts jusqu'à 100 000 tokens | Prompts au-delà de 100 000 tokens | Haiku 4.5 (tarif unique) | Sonnet 5.5 |
|---|---|---|---|---|
| Entrée | $0.10 | $0.50 | $1.00 | $2.00 |
| Sortie | $0.50 | $2.50 | $5.00 | $10.00 |
| Lecture du cache | $0.01 | $0.05 | $0.10 | $0.10 |
| Écriture du cache 5 minutes | $0.125 | $0.625 | $1.25 | $2.50 |
| Écriture du cache 1 heure | $0.20 | $1.00 | $2.00 | $4.00 |
| Batch API | 50 % de réduction sur l'entrée et la sortie | 50 % de réduction | 50 % de réduction | 50 % de réduction |
Anthropic a placé la barre à 100 000 tokens parce que, selon son annonce de lancement, environ 90 % des requêtes vers Haiku 4.5 restaient en dessous. Avec une charge de cette forme, Haiku 5.5 égale le prix catalogue de $0.10/$0.50 de GPT-6 Luna. Avec une autre forme, eh bien, le fil HN a vite fait le calcul :
"100k tokens is an absurdly low cutoff and it is only applicable to Haiku and not Sonnet or Opus. It's a low enough cutoff that it will be quickly exceeded if you are doing anything with Agents; for typical generation or Jev-like classifiers, it's a good value and as noted in this article, that is apparently the vast majority of Haiku use."
Il y a aussi un écart plus discret entre les tokens de Claude et ceux d'OpenAI. Un autre commentateur a souligné que "modern Claude's 100K tokens are about ~60-65K modern GPT tokens", donc le même document atteint la barre de Haiku plus tôt que celle de Luna. J'approfondis le côté coûts dans mon test de Claude Haiku 5.5 et dans les tarifs de GPT-6 Luna.
Saisissez vos propres chiffres ci-dessous pour voir ce que coûte un mois d'appels et où la barre des 100k commence à se faire sentir. Utilisez les décomptes de tokens tels que Haiku 5.5 les compte.
À titre d'exemple, essayez 50 000 requêtes avec 6 000 tokens de prompt et 800 tokens de sortie. Sur Haiku 5.5, cela fait $50 par mois, contre $1 000 pour Sonnet 5.5. Poussez ensuite le prompt à 120 000 tokens et vous verrez Haiku bondir de 5 fois.
Comment accéder à Claude Haiku 5.5 et l'utiliser
Haiku 5.5 est disponible sur toutes les plateformes par lesquelles Anthropic vend : la Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry et Claude Platform on AWS. Vous pouvez aussi l'utiliser dans les applications claude.ai, où Anthropic publie son prompt système.
Voici un appel d'API minimal. L'effort est défini explicitement et il n'y a aucun paramètre d'échantillonnage :
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[
        {"role": "user", "content": "Tag this ticket as billing, shipping, bug or other: ..."}
    ],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
Quelques habitudes qui m'ont fait gagner du temps de débogage par la suite :
- Sélectionnez les blocs de contenu par
type. Une réponse peut s'ouvrir sur un bloc de réflexion même si vous n'en avez jamais demandé, donc ne supposez pas que le premier bloc est la réponse. - Omettez
temperature,top_pettop_k. Sur Haiku 5.5, toute valeur non par défaut renvoie une erreur 400. - Gérez
stop_reason: "refusal". Haiku 5.5 exécute des classificateurs de sécurité qui refusent parfois une demande, et d'après le guide de migration aucun modèle de repli côté serveur ne la rattrape.
Les personnes ayant un forfait Claude ont désormais un moyen de l'essayer à peu près gratuitement. Dès la semaine du lancement, Anthropic accorde des crédits d'API mensuels aux abonnés Max et Team : $100 par mois pour Max 5x, $200 pour Max 20x et jusqu'à $500 mutualisés pour Team. Vous pouvez dépenser ces crédits sur n'importe quel modèle. Ils ne couvrent pas les sessions interactives de Claude Code.
Dans Claude Code lui-même, Haiku est un choix courant pour les sous-agents, et mon guide sur la sélection de modèle dans Claude Code explique quand changer.
Ce qui casse quand on passe de Haiku 4.5
Parler de Haiku 5.5 comme d'un remplacement direct n'est vrai que si votre code était déjà écrit pour les modèles Claude plus récents. Le guide de migration contient une liste de 10 étapes, et ces cinq renvoient des erreurs :
| Ce que fait votre code aujourd'hui | Ce qui se passe sur Haiku 5.5 | La correction |
|---|---|---|
Envoie thinking avec budget_tokens | Erreur 400 | Utilisez {"type": "adaptive"} et réglez effort |
Définit temperature, top_p ou top_k | Erreur 400 | Supprimez-les |
Termine messages par un tour de l'assistant (prefill) | Erreur 400 | Terminez par un tour utilisateur, utilisez les sorties structurées |
Utilise computer_20250124 sur la Claude API ou Google Cloud | Rejeté | Passez à computer_toolset_20260801 |
| Modifie des tours précédents et renvoie des blocs de réflexion | Blocs de réflexion invalidés | Gardez la conversation en ajout seul |
Parmi ces points, le changement de température est celui que je planifierais. Beaucoup de pipelines de classification fixent la température à 0 pour obtenir une sortie reproductible, et sur Haiku 5.5 cette requête échoue tout simplement. Si vous voulez de la cohérence maintenant, les sorties structurées avec un schéma fixe sont la meilleure voie. Une dernière chose : le Priority Tier n'est pas proposé sur Haiku 5.5, donc une équipe ayant un engagement Priority sur 4.5 doit planifier sa capacité autrement.
À quoi sert Claude Haiku 5.5 ?
Quand j'évalue un petit modèle, je pose d'abord la question de la tâche. Le prompt est-il court, y a-t-il une bonne réponse claire, et tourne-t-elle à fort volume ? Haiku 5.5 est conçu pour les tâches où la réponse à tout cela est oui.
| Tâche | Adéquation | Pourquoi |
|---|---|---|
| Classification de tickets et étiquetage | Forte | Prompts courts, étiquettes fixes, l'effort Low suffit |
| Résumés de tickets et notes de passation | Forte | Rapide en Medium, assez bon marché pour tourner sur chaque ticket |
| Routage et priorisation | Forte | La vitesse compte plus que la profondeur |
| Réponses du centre d'aide (RAG) | Forte, si les prompts restent sous 100k | Taux d'hallucination plus bas que Luna, fenêtre de 1M si besoin |
| Sous-agents sous un chef Sonnet ou Opus | Forte | Anthropic et Cognition pointent tous deux cet usage |
| Utilisation du navigateur et de l'ordinateur | Bonne | 72,4 % sur OSWorld 2.1, le Claude le plus rapide |
| Longues boucles d'agents et programmation difficile | Faible | 39,2 % contre 70,6 % pour Sonnet 5.5 sur Terminal-Bench 4.0 |
On sous-estime la vitesse. Dans une évaluation d'eesel, un acheteur a soumis le bot de support d'eesel à une revue minutieuse de 67 tests et a trouvé les réponses de connaissance solides. Il est parti quand même, parce que le widget de chat semblait lent et se bloquait. De bonnes réponses n'ont pas pu sauver une expérience lente. Haiku 5.5 est le modèle le plus rapide d'Anthropic à vitesse standard, et une mesure OpenRouter partagée sur HN le place à environ deux fois le débit de Luna, il répond donc directement à ce genre de vente perdue.
Sur Hacker News, les développeurs qui l'ont le plus apprécié étaient ceux qui faisaient précisément ce type de travail court et ancré :
"Tested on my RAG system containing all of cloudflare docs (more than 3000 A4 sized highly technical documents): best
quality*speed/priceratio of any other model. And I have tested more than a 100 different models."
Un autre testeur lui a donné une tâche trop grosse pour lui, et il a semblé connaître ses propres limites :
"One interesting thing is it took a look at the job at hand, and immediately delegated it to Opus 5.5. It at least knows what it isn't good at. Very fast though, and likely best used for small subagent tasks / tightly scoped work."
Ce que disent les développeurs
Le fil de lancement sur Hacker News était surtout positif sur le prix et la vitesse. Les vraies plaintes se résumaient à deux : la barre des 100k et les équipes dont les propres évaluations ne concordaient pas avec les graphiques d'Anthropic.
"It's absolutely better than Luna. It feels closer to a "sonnet 5.2" if that makes sense. Of course it's not as big, and hence falls-off quicker."
"At work we use haiku 4.5 for a handful of latency sensitive tasks that are fairly simple. It performs well. Just started testing 5.5 as I've been anticipating a nice improvement since it was teased. Results so far are trash. Prompt leakage even. And it's slower."
Je prendrais ce second commentaire au sérieux. Haiku 4.5 tournait sans réflexion par défaut, donc un prompt réglé pour lui peut se comporter différemment sur un modèle qui réfléchit à effort Medium dès la sortie de boîte. Anthropic a publié un guide de prompting pour Haiku 5.5 précisément pour cela. Si un prompt migré devient plus lent, mon premier réflexe serait de baisser l'effort à Low.
Le paysage plus large des petits modèles est couvert dans mes articles sur les alternatives à Claude Haiku 5.5, Gemini 3.8 Flash et GLM-5.3 Flash.
Des réponses rapides façon Haiku dans votre file de support avec eesel
Si c'est à cause d'une file de support que vous vous intéressez à Haiku 5.5, alors le modèle est la partie facile. La partie difficile, c'est tout ce qui l'entoure : quels tickets reçoivent le modèle rapide, comment les prompts restent sous la barre des 100k, à quel niveau d'effort tourne chaque tâche, et comment les mauvaises réponses sont interceptées avant qu'un client n'en voie une.
C'est ce travail que le coéquipier IA pour helpdesk d'eesel vous enlève. Il rejoint le helpdesk que vous utilisez déjà, comme Zendesk, Freshdesk ou Gorgias, apprend de vos anciens tickets et de votre centre d'aide, puis trie, étiquette, résume et répond. Chaque déploiement est simulé sur vos tickets historiques avant de parler à un seul client, ce qui vous permet de voir d'abord comment il aurait traité la file du mois dernier.

Si vous préférez le piloter depuis un terminal, la CLI d'eesel fait tourner le même coéquipier et le même espace de travail que le tableau de bord, de sorte qu'un script ou un agent de programmation comme Claude Code peut le configurer et vérifier son travail. C'est en gros le schéma chef et second qu'Anthropic recommande pour Haiku, dirigé vers votre configuration de support. Mes articles sur la CLI d'agent IA et les serveurs MCP vont plus loin.
Les forfaits commencent à $299 pour 500 crédits, mais vous pouvez l'exécuter gratuitement sur un échantillon de vrais tickets avant de payer quoi que ce soit. Essayez eesel et voyez si des réponses plus rapides arrivent vraiment jusqu'à vos clients.
Questions fréquentes
Qu'est-ce que Claude Haiku 5.5 ?
claude-haiku-5-5. Il offre une fenêtre de contexte de 1M de tokens, jusqu'à 128K tokens en sortie, une réflexion adaptative avec un réglage d'effort, et il est conçu pour les tâches à fort volume comme la classification, le routage, l'extraction, les résumés et les tâches de sous-agents.Combien coûte Claude Haiku 5.5 ?
Claude Haiku 5.5 est-il meilleur que Haiku 4.5 ?
Quelle est la différence entre Claude Haiku 5.5 et Sonnet 5.5 ?
Claude Haiku 5.5 convient-il au support client ?
Qu'est-ce qui casse quand je passe à Claude Haiku 5.5 ?
budget_tokens, une temperature, un top_p ou un top_k non par défaut, le prefill de message de l'assistant, l'ancien outil computer_20250124 sur la Claude API et Google Cloud, et les modifications de tours précédents quand vous renvoyez des blocs de réflexion. Le nouveau tokenizer compte aussi environ 30 % de tokens en plus pour le même texte. L'article sur les alternatives à Claude Haiku 5.5 indique où aller si ces changements ne vous conviennent pas.
Comment utiliser Claude Haiku 5.5 ?
model: "claude-haiku-5-5", ou utilisezanthropic.claude-haiku-5-5sur Amazon Bedrock. Omettez temperature, top_p et top_k, et réglezoutput_config.effortsur low, medium, high, xhigh ou max. Il est aussi disponible sur Google Cloud, Microsoft Foundry et Claude Platform on AWS. Pour les équipes de support, le coéquipier IA pour helpdesk d'eesel exécute des modèles rapides dans votre helpdesk sans aucun code.