Mon verdict en un coup d'œil
Le lendemain du lancement, j'ai lu l'annonce d'Anthropic et la documentation du modèle, puis le guide de migration, ainsi que le fil de lancement sur Hacker News et ses quelque 550 commentaires. Mon métier est de construire des agents IA pour le coéquipier helpdesk d'eesel, donc j'ai tout lu avec une seule question en tête : mettrais-je ce modèle sous une vraie file de support dès demain ?
Voici la version courte, notée sur ce qui compte une fois en production :
| Ce que j'ai vérifié | Note | Pourquoi |
|---|---|---|
| Qualité du code | 9/10 | 70,6 % sur Terminal-Bench 4.0, au-dessus d'Opus 5.5 |
| Travail de connaissance | 8/10 | GDPval-AA 1844, deux points derrière les 1846 d'Opus 5.5 |
| Efficacité en tokens | 9/10 en Low/Medium, 4/10 en Max | ~121k contre 497k tokens par réponse chez Balyasny, mais 193k par tâche en Max |
| Vitesse | 8/10 | Sortie 30 %+ plus rapide que Sonnet 5 |
| Difficulté de migration | 5/10 | Cinq changements cassants, dont un vicieux pour les bots de support |
| Adéquation au support | 8/10 | Zendesk a vu des tickets traités 20 % plus vite |
| Global | 8/10 | Meilleur rapport qualité-prix de la gamme, avec un réglage coûteux à éviter |
Un mot rapide sur la méthode, pour que l'on sache sur quoi reposent ces notes. Je n'ai pas mené d'essai de plusieurs mois en production, puisque le modèle a un jour. Les notes s'appuient sur les chiffres publiés par Anthropic et les résultats de clients nommés dans l'annonce de lancement, sur des benchmarks indépendants que des gens ont publiés, puis sur ma propre lecture de la documentation de l'API au regard de la façon dont eesel intègre les modèles dans les flux de tickets. Quand un chiffre vient d'Anthropic, je le précise.
Ce qu'est Claude Sonnet 5.5
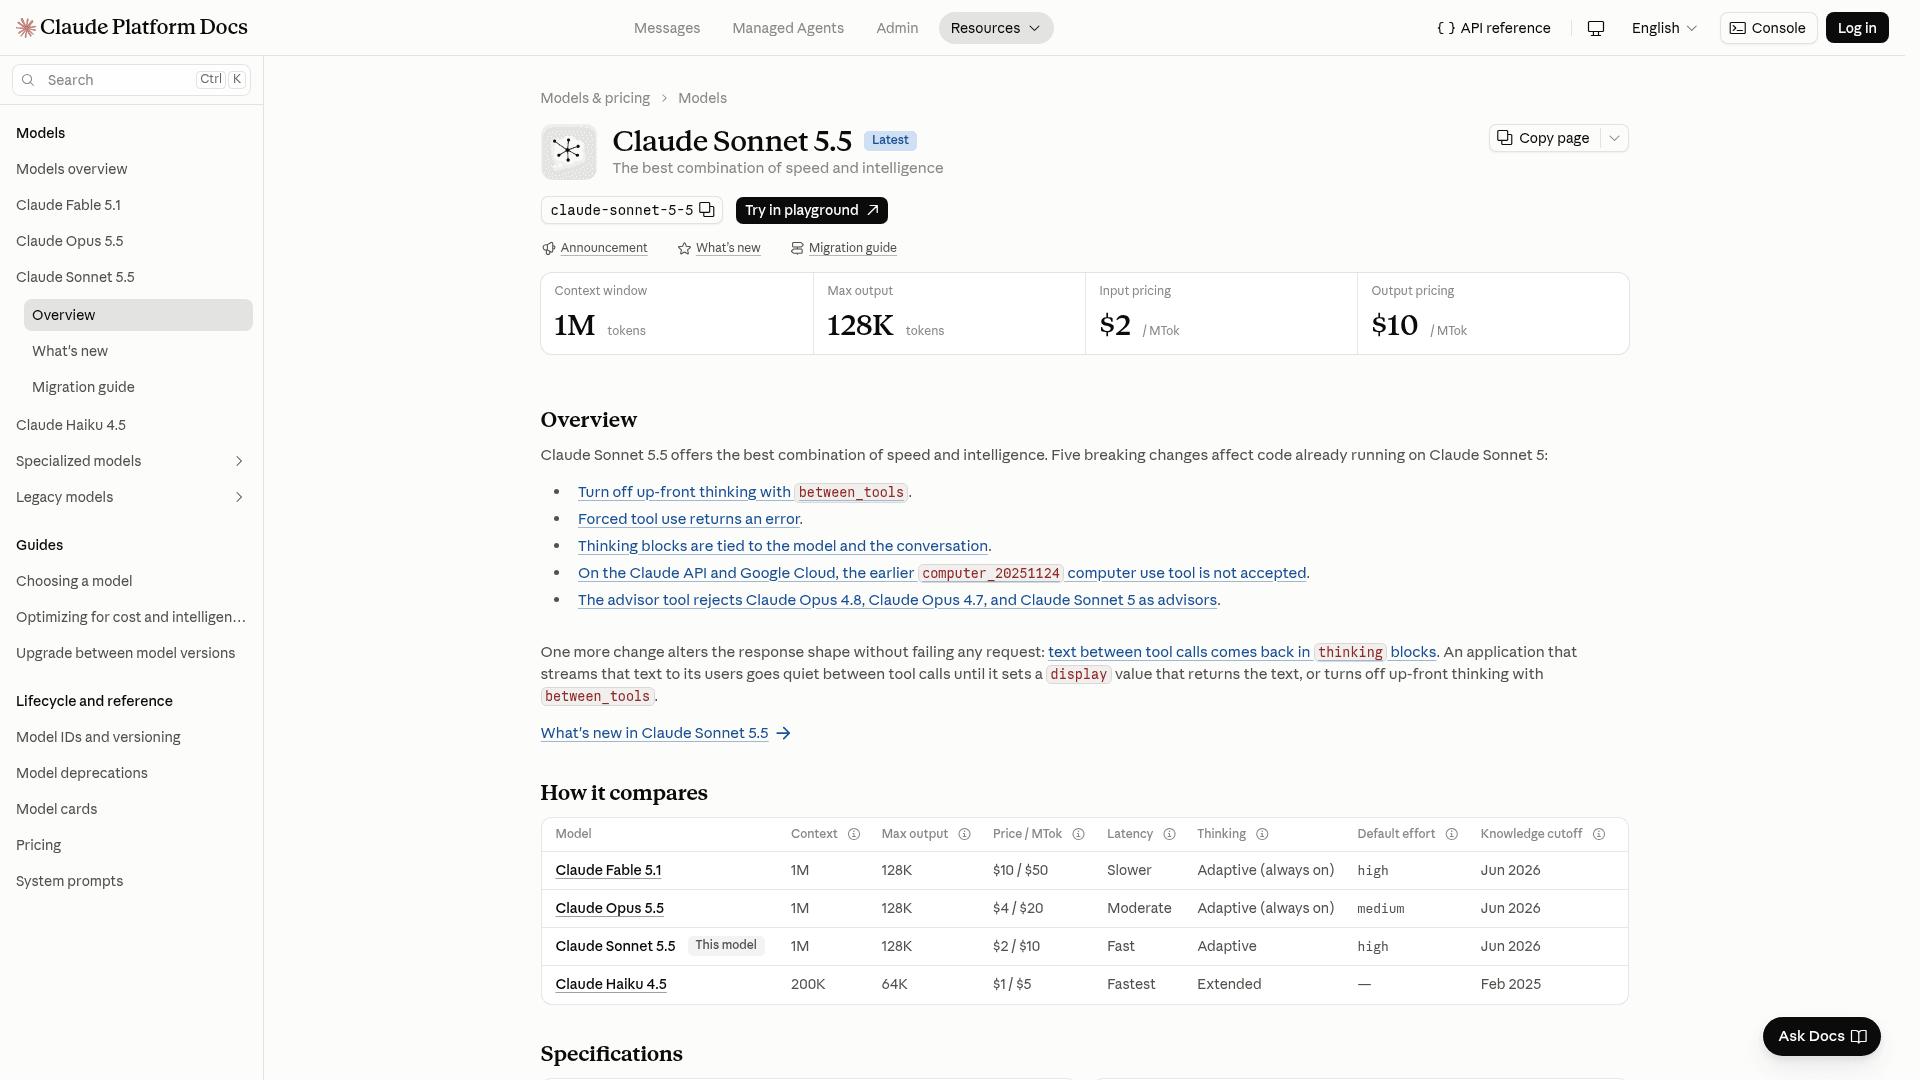
Claude Sonnet 5.5 est le modèle de milieu de gamme de la famille Claude 5.5 d'Anthropic, sorti le 28 septembre 2026. Il se place sous Claude Opus 5.5 et au-dessus de Haiku 4.5, tandis que Claude Fable 5.1 occupe le sommet de la gamme. Anthropic le présente comme "a faster, lower-cost complement" d'Opus, le plus fort sur "well-scoped everyday tasks, fixing bugs, and creating polished documents, slides, and spreadsheets."
Côté caractéristiques, la présentation du modèle indique une fenêtre de contexte de 1M de tokens et 128K de sortie maximale (300K en Batch), avec une date limite de connaissances en juin 2026 et le même tokenizer que Claude Sonnet 5. Pour le tour complet du lancement, la présentation de Sonnet 5.5 de mon collègue le couvre bien. Cet article est plutôt le verdict.
Là où Claude Sonnet 5.5 est fort
Trois choses ressortent des données de lancement, et toutes trois apparaissent dans des résultats de clients nommés, pas seulement dans les graphiques d'Anthropic.
Il code comme un modèle Opus
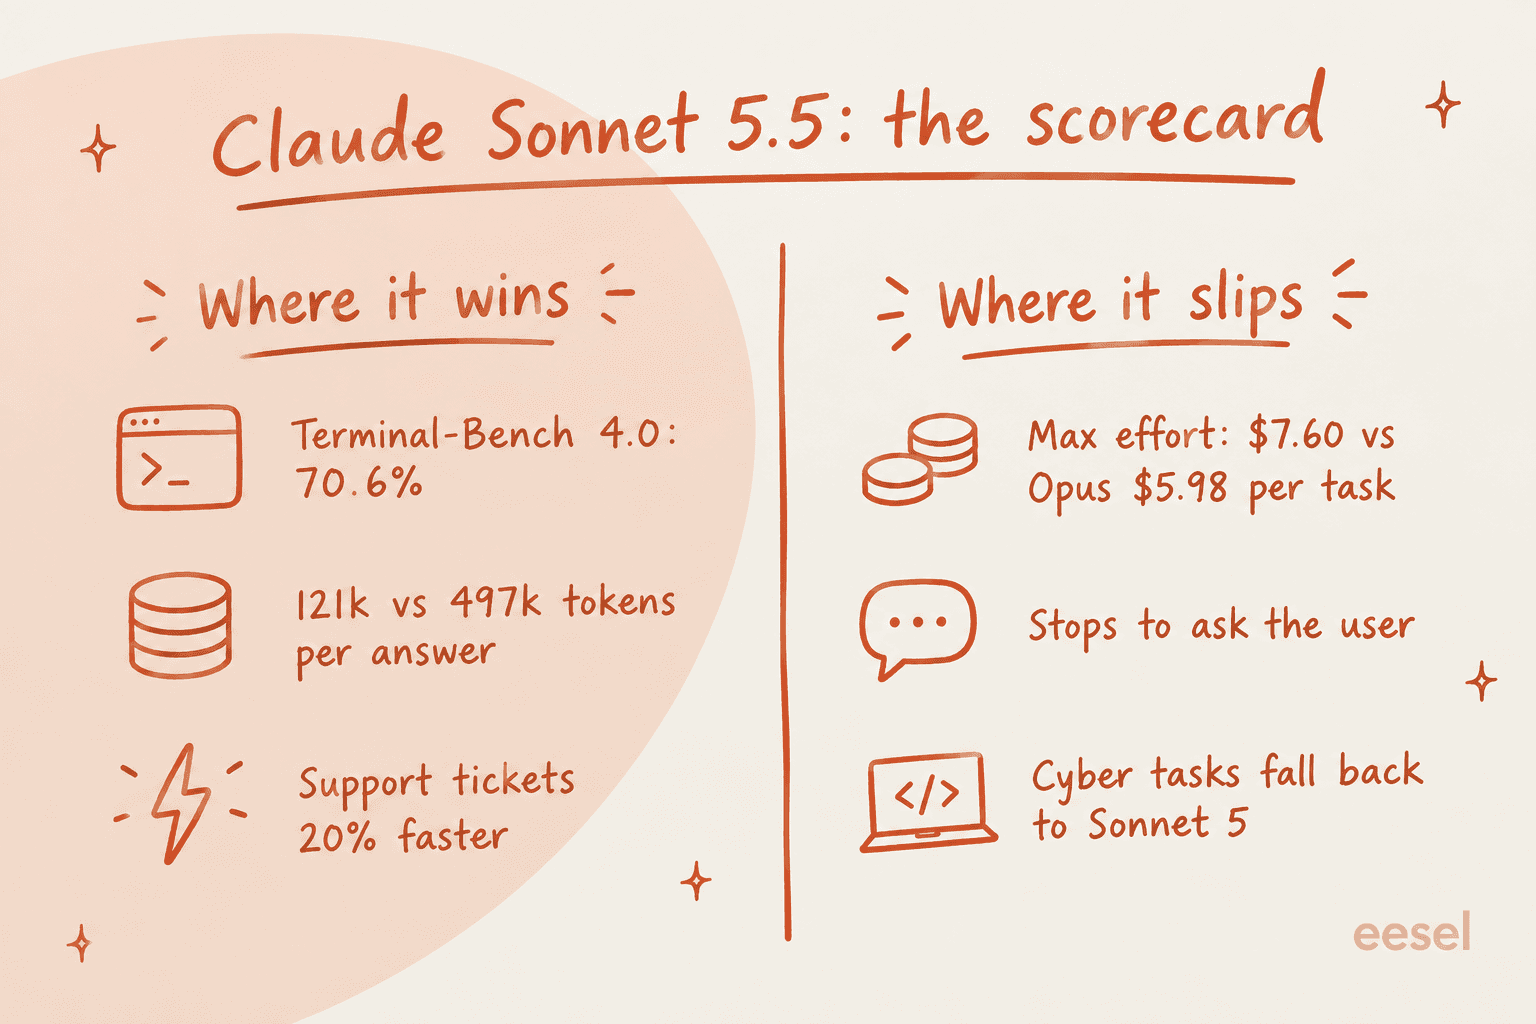
Le chiffre phare est Terminal-Bench 4.0, un test de codage agentique exécuté en ligne de commande. Sonnet 5 y obtenait 10,3 %, et Sonnet 5.5 obtient 70,6 %, au-dessus des 66,4 % d'Opus 5.5. Ce n'est pas une coquille. C'est le plus gros saut d'une génération à l'autre que j'aie vu sur un modèle Sonnet.
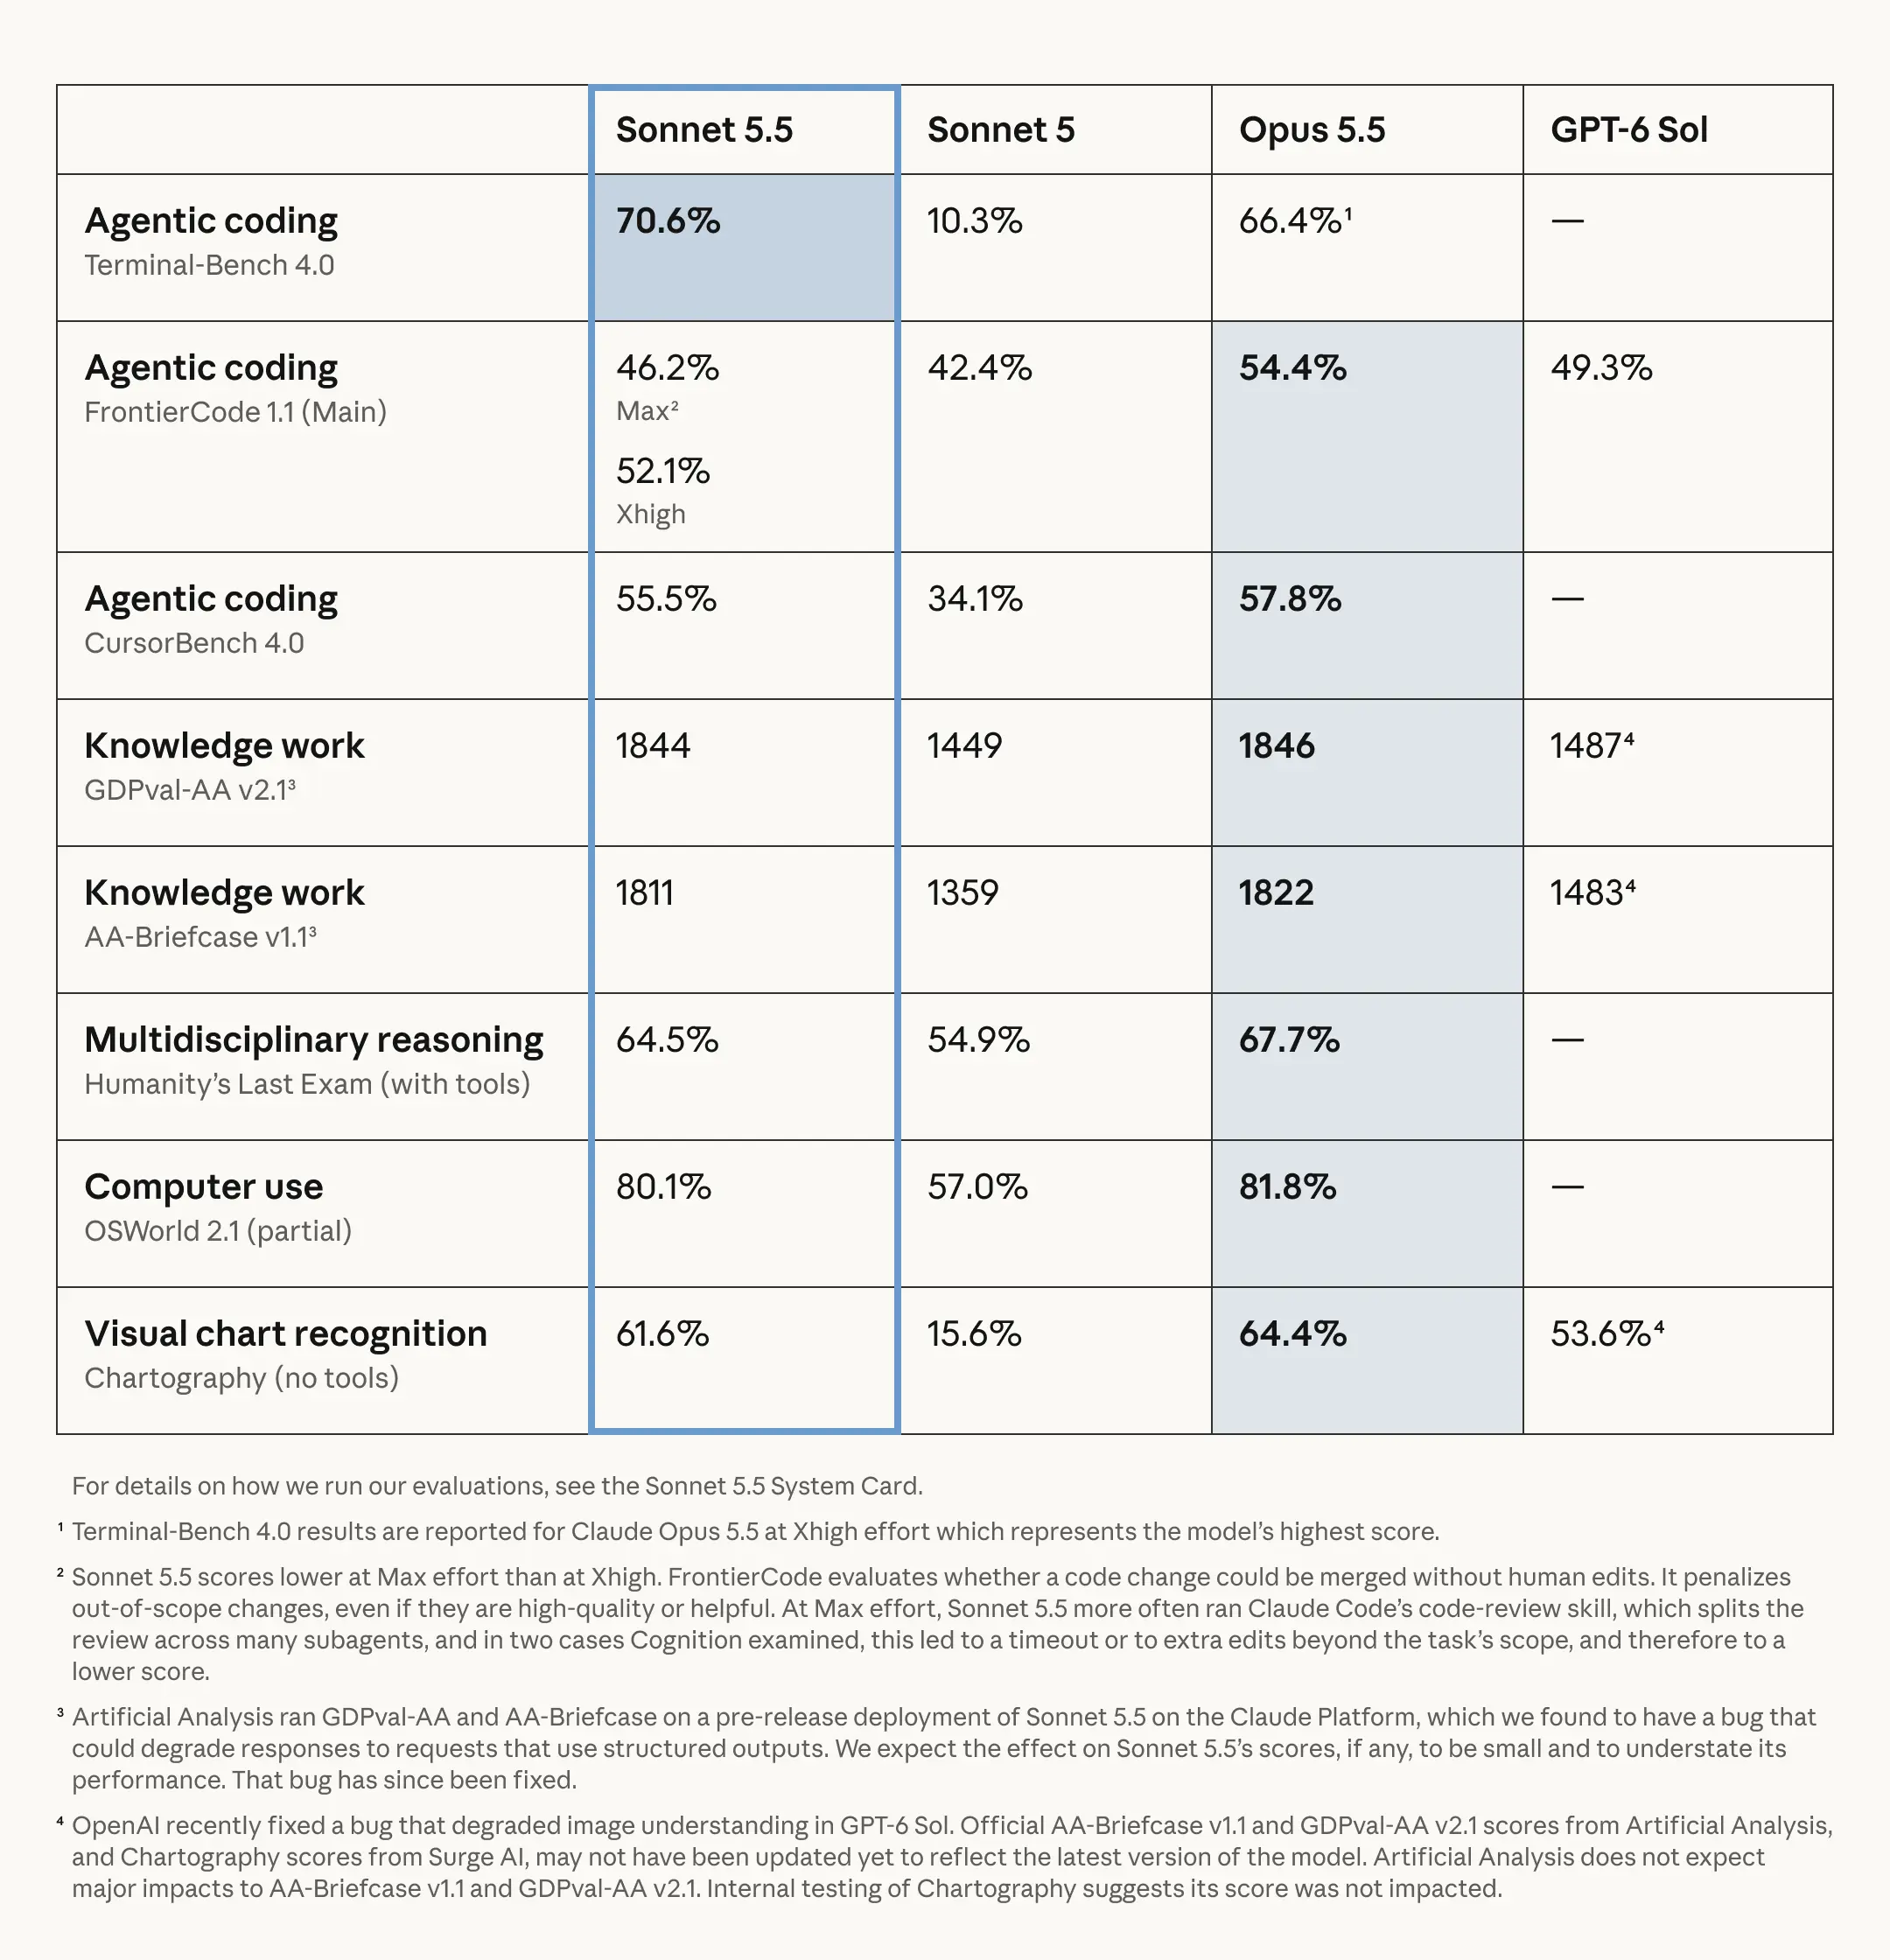
Sur les autres tests de code, il est un peu derrière Opus : CursorBench 4.0 est à 55,5 % contre 57,8 %, et FrontierCode à 52,1 % en Xhigh contre 54,4 %. Pour un modèle à moitié prix par token, un écart de deux points est franchement une bonne affaire. C'est aussi la raison pour laquelle, dans le débat Opus contre Sonnet, les gens ont surtout cessé de se disputer sur la qualité pour se disputer sur le coût.
Les chiffres clients le confirment aussi. Base44 a dit que sur 118 constructions d'apps réelles, Sonnet 5.5 "produced apps that scored level with Opus 5" en 3,6 itérations par build, là où Opus 5 en demandait 7,7. Unity affirme qu'il a mené à bien 90 % des tâches de son benchmark d'éditeur multi-étapes. Et si vous codez dans Claude Code, c'est désormais le modèle que vous verrez par défaut en effort Medium.
Il y arrive avec bien moins de tokens
Le prix par token n'a pas changé ; ce qui a changé, c'est le nombre de tokens. Balyasny Asset Management a exécuté 2 441 tâches financières et constaté que Sonnet 5.5 a utilisé environ 121k tokens par réponse, là où Sonnet 5 en utilisait 497k. Sur ses évaluations Slackbot, Slack a observé environ 14 % de tokens de sortie en moins sans changement de prompt, et Lovable a de son côté rapporté un tiers d'appels d'outils en moins.
La démo d'Anthropic va dans le même sens. Sur un prompt "wind shaping sand dunes", Sonnet 5 était encore en train d'écrire du code quand Sonnet 5.5 avait déjà une animation qui tournait :
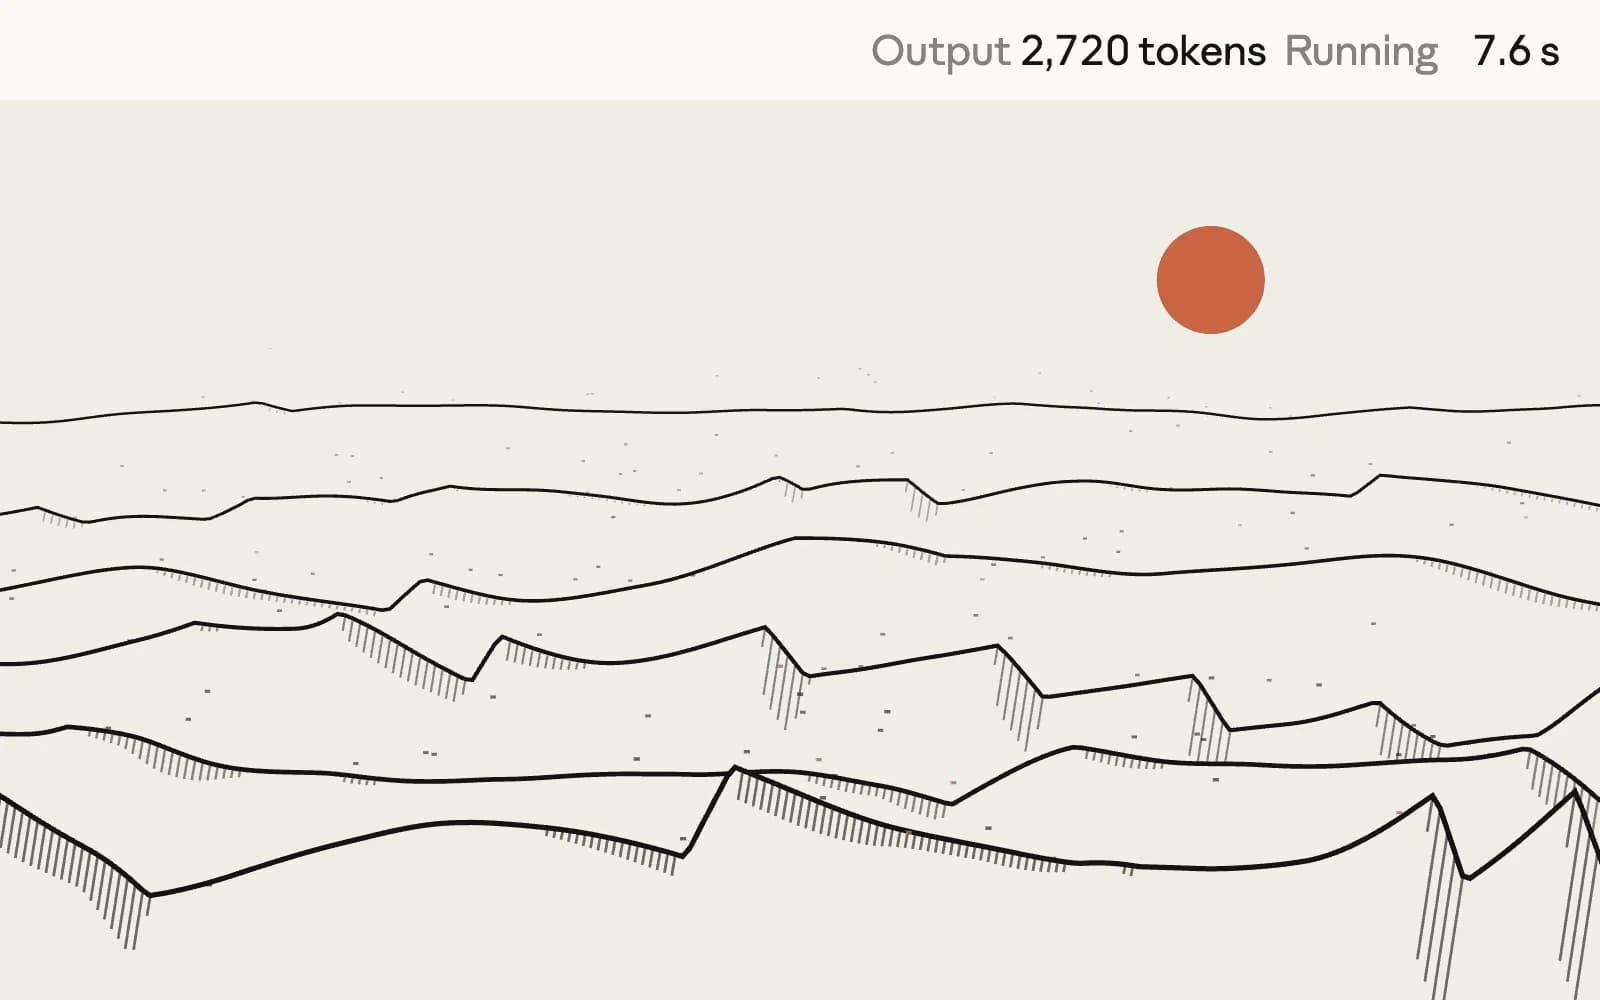
Cette efficacité est en réalité le produit. Selon Anthropic, le résultat est "up to 30% less per task" que Sonnet 5. Avec les équipes à qui je parle, moins de tokens veut aussi dire moins de secondes d'attente pour un client, et cela compte plus pour elles que la facture.
Il gère bien les tickets de support
C'est la partie qui m'importe le plus. Le Director of AI de Zendesk a dit dans l'annonce de lancement qu'ils avaient "fed Claude Sonnet 5.5 hundreds of real support use cases across replies and escalation requests. It made fewer wrong decisions," et que les tickets étaient traités 20 % plus vite. Du côté d'Atlassian, l'entreprise dit que les agents Rovo tourneront jusqu'à 30 % plus vite qu'avec Sonnet 5.
Pour un travail de type Zendesk AI, ces deux chiffres sont ceux qui décident si un modèle est bon : moins de mauvaises décisions d'escalade, et moins d'attente. Les deux vont dans le bon sens.
Là où Claude Sonnet 5.5 déçoit
Les points faibles sont plus étroits que ne le suggèrent les sceptiques, mais l'un d'eux change la façon dont vous devriez utiliser le modèle.
L'effort Max coûte plus cher qu'Opus
Voici la découverte qui a changé mon verdict. L'annonce de lancement d'Anthropic admet elle-même que Sonnet 5.5 "complements Opus 5.5 best when running at lower effort settings" et qu'"at higher settings, it can perform comparably at a similar cost." Les tests indépendants vont un cran plus loin.
Sur Artificial Analysis, comme l'a signalé un utilisateur de Reddit, Sonnet 5.5 en Max coûte 7,60 $ par tâche contre 5,98 $ pour Opus 5.5 en Max, parce qu'il a utilisé 193k tokens par tâche là où Opus en a utilisé 119k. Simon Willison a exécuté le jour du lancement le même prompt SVG à chaque niveau d'effort. Low a coûté 1,6 centime et pris 10 secondes. Max a coûté 1,28 $ et duré 15 minutes 40 secondes, consommant ses 128 000 tokens de réflexion complets avant d'échouer à produire l'image.
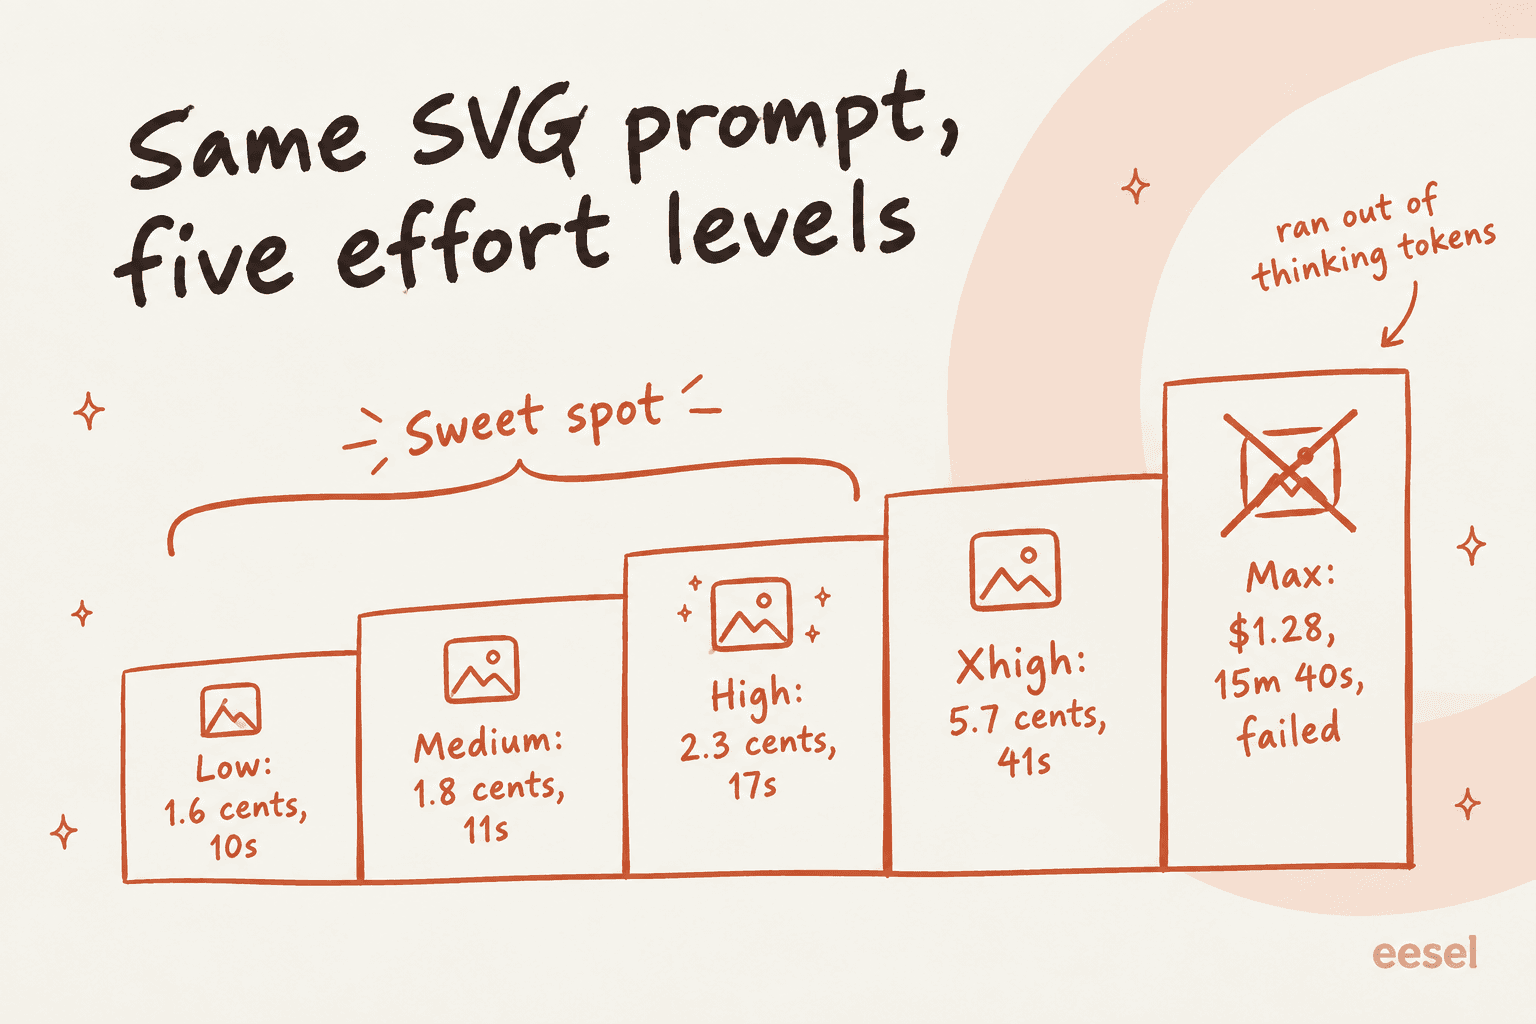
Même la note de bas de page FrontierCode d'Anthropic a la même allure. Sonnet 5.5 obtient 52,1 % en Xhigh mais seulement 46,2 % en Max, car en Max il "more often ran Claude Code's code-review skill", ce qui a provoqué des délais dépassés ou des modifications hors du périmètre de la tâche. Plus de réflexion, ici, a dégradé le résultat.
La règle est donc simple : considérez Max comme interdit pour Sonnet 5.5. Une tâche qui demande autant de raisonnement est une tâche pour Opus 5.5, qui y arrive avec moins de tokens.
Opus reste meilleur sur le jugement ouvert
Anthropic est assez franche sur ce point : "Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment." Les premiers retours d'usage concordent.
"Tried Sonnet 5.5 but worse than OPUS for thinking for sure, less error/inconsistency check. I used Opus 5.5 med vs. Sonnet 5.5 High on hermes with the same agent.md, and soul.md"

Traduit en support, c'est le client entreprise en colère avec un litige de facturation et trois tickets précédents. Ce ticket, je ne le confierais pas à Sonnet 5.5 sans supervision. La réinitialisation de mot de passe, la vérification du statut d'une commande ou la question "comment exporter mes données", je les lui confierais toute la journée.
Il s'arrête pour poser des questions
Un développeur fait tourner un benchmark adversarial construit sur un langage de programmation ésotérique. Dessus, Sonnet 5.5 a obtenu 7,4 % contre 17,8 % pour Sonnet 5, et son explication était qu'il "is more reluctant to keep going to get an answer, instead it returns to ask the user questions whether to keep going." Base44, à l'inverse, a dit qu'il "rarely stopped mid-build to ask the user a question."
Ma lecture : en travail interactif, faire une pause pour vérifier est souvent ce que l'on veut de toute façon. Dans un pipeline sans surveillance, c'est différent : un modèle qui s'arrête pour demander peut bloquer un job toute la nuit. Testez-le donc sur votre propre boucle d'agent avant de lui faire confiance sans supervision.
Garde-fous cyber et cinq changements cassants
Sonnet 5.5 est le premier Sonnet lancé avec des garde-fous cyber comme ceux d'Opus 5.5, si bien que "higher-risk cybersecurity tasks will visibly fall back to Sonnet 5." La correction de bugs courante n'est pas concernée. Malgré tout, le plus gros sous-fil de Hacker News venait de personnes faisant du travail de sécurité autorisé et qui ont été signalées quand même.
Le guide de migration recense cinq changements cassants, dont chacun renvoie désormais une erreur 400 :
| Changement | Ce qui casse | Correctif |
|---|---|---|
thinking: disabled | Requêtes avec la réflexion totalement coupée | Utiliser le nouveau réglage between_tools |
tool_choice forcé (any ou tool) | Bots qui forcent un outil de classification | Laisser le modèle choisir, puis valider |
| Historique modifié avant un bloc de réflexion | Apps qui réécrivent les tours passés | Garder un historique en ajout seul |
computer_20251124 | Ancien outil d'utilisation d'ordinateur sur l'API et Google Cloud | Utiliser computer_toolset_20260801 |
| Certains appariements de l'outil advisor | Un advisor Sonnet 5 ou Opus 4.8 avec un exécuteur Sonnet 5.5 | L'associer à Opus 5.5 ou Sonnet 5.5 |
Pour les équipes support, le piège est le tool_choice forcé. Beaucoup d'intégrations helpdesk IA forcent un outil "classer ce ticket" à chaque requête pour le tri des tickets ; si vous changez l'ID du modèle sans corriger cela, chaque ticket part en erreur. Il y en a aussi un plus discret : le texte entre les appels d'outils arrive désormais dans des blocs de réflexion, ce qui signifie qu'un widget de chat qui diffuse "Vérification de votre commande..." peut se taire. Pourquoi ce silence compte pour les clients est expliqué dans mon guide sur les passages de relais entre agents IA.
Ce que disent les développeurs
L'accueil le jour du lancement a été mitigé, mais de façon utile. Personne ne conteste les benchmarks ; le débat porte plutôt sur la place de Sonnet 5.5 à côté d'Opus.
"It appears, at least from a quick look, to be noticeably faster than Opus. If true, and you don't need xhigh/max reasoning for your use case (like a well-defined set of code changes), Sonnet might get the job done much more quickly."
Les sceptiques se concentrent sur le prix, en particulier sur le fait que les lectures de cache coûtent les mêmes 0,20 $ qu'Opus 5.5 :
"I feel like sonnet is priced too close to opus right now. If Sonnet 5.5 were half its current price it would make sense to use."
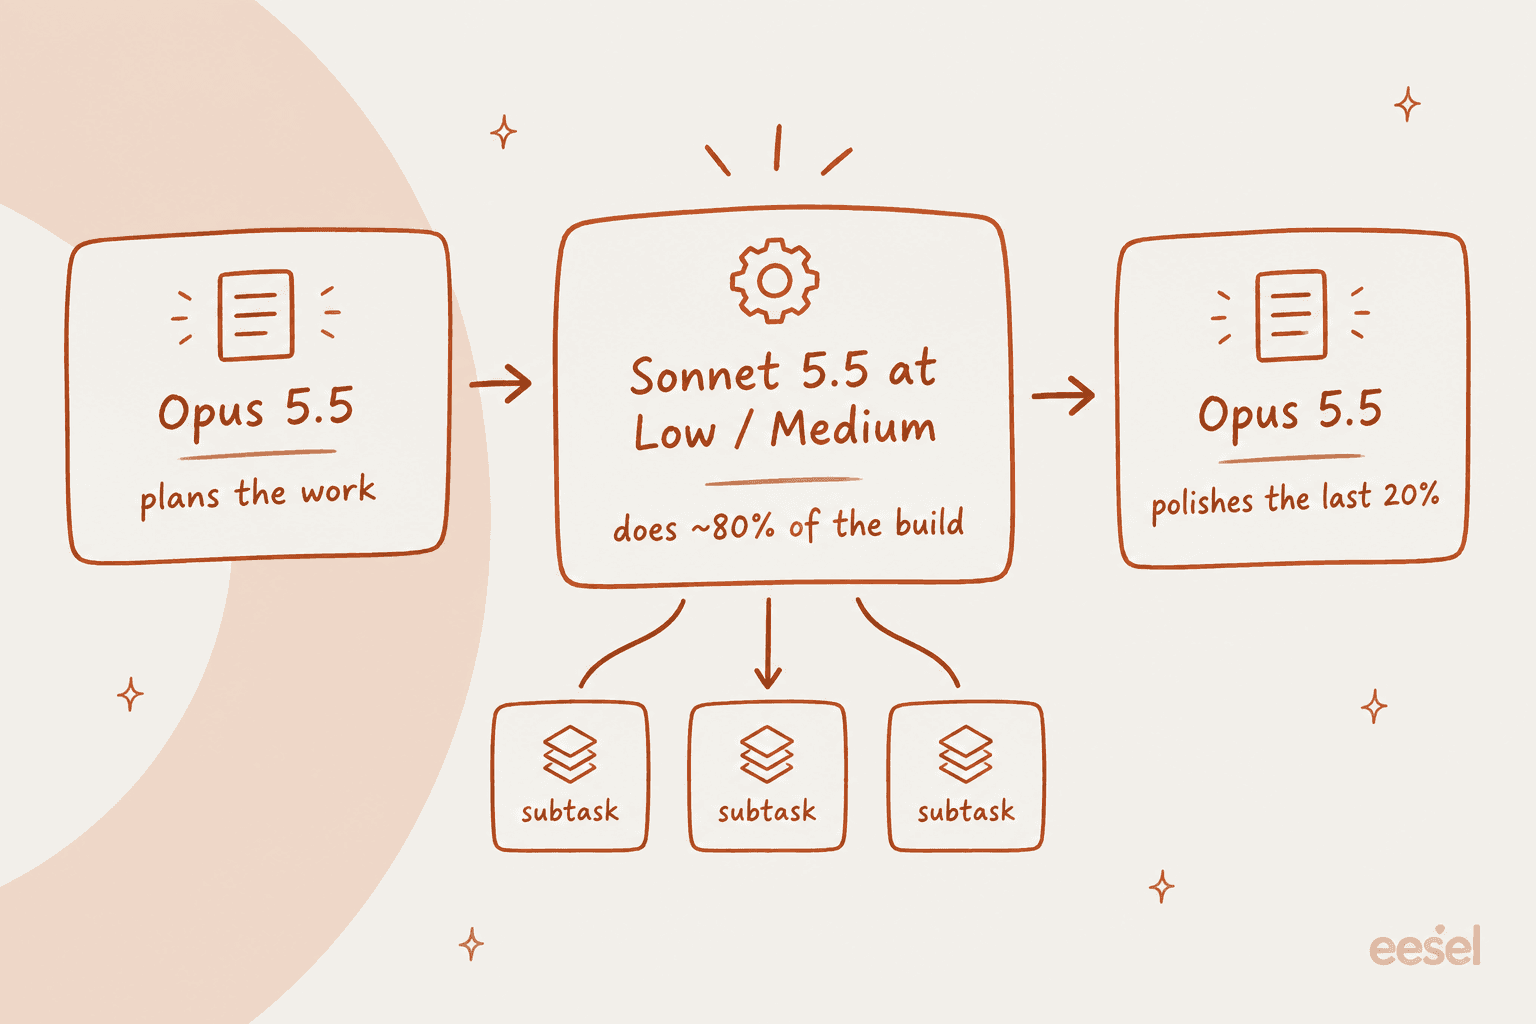
Le cas d'usage auquel les gens reviennent sans cesse est Sonnet comme exécutant rapide, sous un planificateur Opus :
"Firmly places itself as a solid subagent for opus, great work from anthropic, for once I'm interested in what haiku turns out as."

Un autre commentateur a décrit sa propre répartition comme "80% Sonnet 5.5, Opus 5.5 to finish the last 20%." Ce schéma correspond bien aux sous-agents Claude Code, et c'est la configuration que je copierais pour moi.
Les tarifs de Claude Sonnet 5.5 en un tableau
Les tarifs, par million de tokens, viennent de la documentation tarifaire d'Anthropic :
| Prix par 1M de tokens | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | Haiku 4.5 |
|---|---|---|---|---|
| Entrée | $2 | $2 | $4 | $1 |
| Sortie | $10 | $10 | $20 | $5 |
| Écriture de cache 5 minutes | $2.50 | $2.50 | $5 | $1.25 |
| Lecture de cache | $0.20 | $0.20 | $0.20 | $0.10 |
| Batch entrée / sortie | $1 / $5 | $1 / $5 | $2 / $10 | $0.50 / $2.50 |
| Fenêtre de contexte | 1M | 1M | 1M | 200K |
Les tokens de réflexion sont facturés comme de la sortie, et c'est pourquoi le réglage d'effort compte autant. Une réponse de support en Medium peut réfléchir quelques centaines de tokens, alors que la même réponse en Max peut réfléchir des dizaines de milliers, tous à 10 $ le million. La ligne du modèle est rarement le plus gros poste du coût d'un agent de support IA, mais le curseur d'effort est le moyen le plus rapide d'en faire un.
L'accès grand public est la partie la plus simple. Anthropic dit que tout le monde peut discuter avec Sonnet 5.5 sur Claude.ai, et les offres payantes sont dans mon guide des tarifs de Claude Pro. Dès le premier jour, il est aussi sur Amazon Bedrock et Google Cloud, ainsi que Microsoft Foundry. Si vous comparez des fournisseurs, commencez par la comparaison à trois des API. Pour le face-à-face avec OpenAI, lisez l'analyse GPT-6 Sol contre Opus 5.5.
Qui devrait passer, et qui devrait attendre
Voici comment je déciderais, selon ce que vous utilisez aujourd'hui :
| Vous utilisez... | Ma décision | Réglage d'effort |
|---|---|---|
| Sonnet 5 en production | Passez cette semaine, après les correctifs de migration | Medium |
| Opus 5.5 pour le codage courant | Déplacez les tâches routinières vers des sous-agents Sonnet 5.5 | Low ou Medium |
| Opus 5.5 pour la planification ouverte | Restez sur Opus | n/a |
| Un bot de support avec des appels d'outils forcés | Attendez d'avoir corrigé tool_choice | Medium |
| Des flux de sécurité ou de pentest | Attendez, et candidatez au Cyber Verification Program | n/a |
| Étiquetage et routage à gros volume | Restez sur Haiku 4.5 jusqu'à la sortie de Haiku 5.5 | n/a |
Anthropic dit que Claude Haiku 5.5 rejoindra la famille "in the coming weeks", donc si le coût par ticket est votre principale préoccupation, celui-là vaut l'attente. Pour un panorama plus large des options, mon comparatif des alternatives à Claude pour le service client couvre des options propres au support. Pour les changements de modèle en général, voyez la liste des alternatives à Sonnet.
Un modèle plus malin ne corrige pas une base de connaissances erronée
Il y a une chose qu'un test de modèle ne peut pas montrer : la plupart des échecs de bots de support que j'ai vus n'ont rien à voir avec le modèle. Une équipe B2B de télématique automobile, avec environ 200 tickets Zendesk par mois, a découvert que son bot disait aux clients qu'il prenait en charge des marques de voitures absentes de leur base de données. Le modèle n'hallucinait pourtant pas. Leur base de connaissances disait qu'ils géraient "tous les modèles", et le bot l'a simplement cru. Passer de Sonnet 5 à Sonnet 5.5 aurait donné la même mauvaise réponse, simplement 30 % plus vite.
C'est pourquoi je ne juge jamais un modèle pour le support sur les seuls benchmarks. Chez eesel, chaque déploiement est simulé sur des tickets historiques avant que le coéquipier ne parle à un client, car c'est là qu'on repère les problèmes de connaissances qu'un meilleur modèle ne peut pas corriger.
Essayer eesel avec des modèles de classe Claude sur votre file
Si vous voulez la vitesse de Sonnet 5.5 sur vos tickets sans gérer la migration vous-même, eesel est le raccourci. Son coéquipier helpdesk IA rejoint le helpdesk que vous avez déjà, comme Zendesk, apprend de vos anciens tickets et de votre centre d'aide, puis rédige ou envoie des réponses avec un modèle de pointe en dessous. Tout le réglage d'effort et les changements cassants de cet avis deviennent le travail d'eesel plutôt que le vôtre.

Si vous aimez travailler dans un terminal, la CLI eesel pilote le même coéquipier et le même espace de travail que le tableau de bord. Vous pouvez la scripter, ou laisser un agent de code comme Claude Code la piloter, ce qui est en gros le même schéma "Opus planifie, Sonnet construit" vu plus haut, appliqué à votre setup de support. Mon article sur la CLI d'agent IA va plus loin, et celui sur les serveurs MCP couvre le côté connecteurs.
L'offre gratuite comprend 100 crédits sans carte, et les offres payantes démarrent à 299 $ pour 500 crédits. Essayez eesel sur une tranche de vos vrais tickets et voyez si le modèle plus rapide se traduit vraiment par des réponses plus rapides.
Claude Sonnet 5.5 en vaut-il la peine ?
Oui, avec une règle. En effort Low ou Medium, Claude Sonnet 5.5 vous donne du codage et du travail de connaissance proches d'Opus à moitié prix par token, et il est 30 %+ plus rapide avec bien moins de tokens. C'est ce qui en fait le nouveau choix par défaut pour le travail bien délimité et les sous-agents, ainsi que pour les réponses de support courantes.
En Max, il coûte plus cher qu'Opus et échoue parfois quand même, ne l'utilisez donc pas là. Gardez Opus 5.5 pour les décisions difficiles et ouvertes, et corrigez vos appels d'outils forcés avant de migrer. Ensuite, laissez le curseur d'effort décider de votre facture, pas le nom du modèle.
Questions fréquentes
Claude Sonnet 5.5 est-il bon ?
Claude Sonnet 5.5 est-il meilleur que Sonnet 5 ?
Claude Sonnet 5.5 vaut-il mieux qu'Opus 5.5 ?
Combien coûte Claude Sonnet 5.5 ?
Quel niveau d'effort utiliser avec Claude Sonnet 5.5 ?
Claude Sonnet 5.5 est-il adapté au support client ?
Quels sont les inconvénients de Claude Sonnet 5.5 ?
Quelles sont les alternatives à Claude Sonnet 5.5 ?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.