

En bref
Mistral Large 4 est le plus gros bond que j'aie vu chez Mistral : 38,4 sur l'Artificial Analysis Intelligence Index, contre 9,3 pour Large 3. Il est aussi rapide, bon marché au token pendant sa promotion de preview à moitié prix, et le seul modèle de classe frontière dont le créateur promet, le même mois, un hébergement européen et des poids ouverts.
Mais les chiffres indépendants le placent en milieu de peloton, pas en tête. Il est derrière Kimi K3 et Qwen 3.8 Max, obtient à peu près le même score que des modèles quatre fois moins chers par tâche, et il a halluciné sur 41,9 % des questions auxquelles il a mal répondu dans le test de connaissances d'Artificial Analysis. Les graphiques de lancement de Mistral mettent en avant des tests de cybersécurité et de droit, et ces victoires semblent réelles mais étroites.
Mon verdict : choisissez-le si vous avez besoin d'un fournisseur de l'UE ou de travail de sécurité sans refus. Passez votre chemin si vous voulez simplement la meilleure réponse par dollar. Et si vous songez à le mettre face à des clients, le choix du modèle compte moins que les garde-fous autour, ce que fait déjà le coéquipier helpdesk IA d'eesel sur Zendesk, Freshdesk et Gorgias.
Qu'est-ce que Mistral Large 4 ?
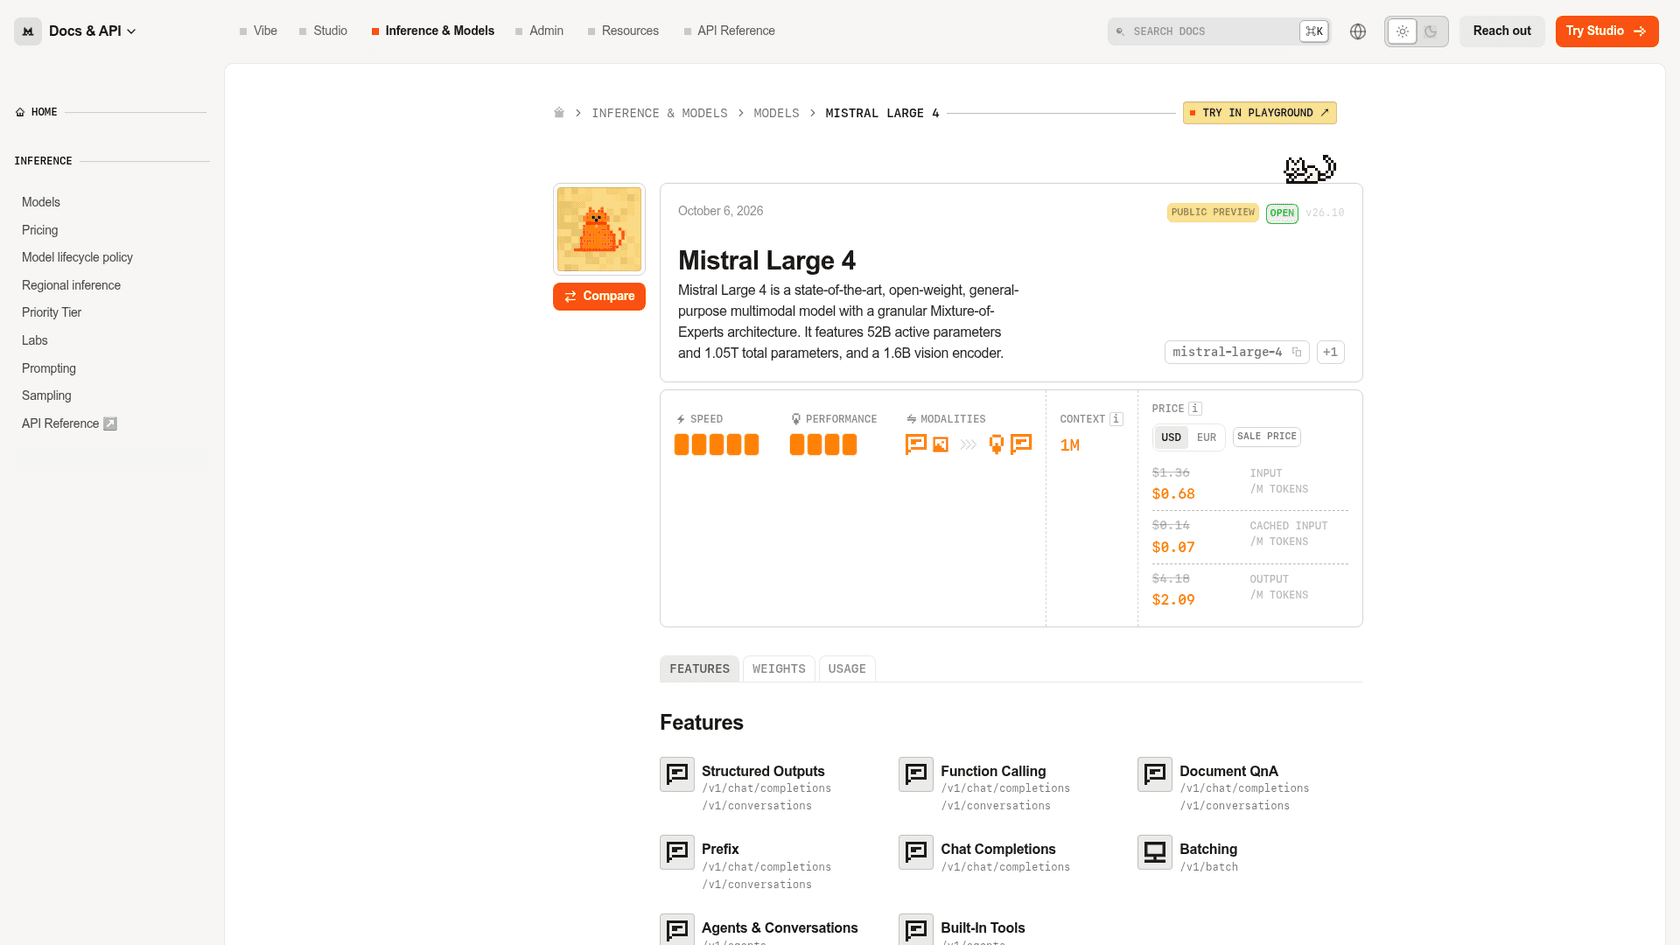
Mistral Large 4 est le nouveau modèle phare de Mistral, lancé le 6 octobre 2026 en preview publique et surnommé "Le Chonk". D'après sa fiche modèle, c'est un LLM à mélange d'experts avec 1,05 billion de paramètres au total, 52 milliards actifs par token, un encodeur de vision de 1,6 milliard et une fenêtre de contexte de 1 million de tokens. C'est un modèle hybride : vous pouvez lui demander de raisonner d'abord avec le réglage reasoning_effort, ou de répondre directement.
Un mot sur mon point de départ. J'écris et je pilote le SEO du blog d'eesel, et ceux qui cherchent "avis Mistral Large 4" sont rarement curieux du nombre de paramètres. Leur question est plus étroite : est-il assez bon pour changer, et pour quoi faire ? C'est la question à laquelle répond cet avis. Pour la fiche technique complète, voir mon aperçu de Mistral Large 4, et pour tous les niveaux de prix, mon détail des tarifs de Mistral Large 4.
Je n'ai pas fait tourner le modèle moi-même, donc mes avis s'appuient sur ceux qui l'ont fait : les tests indépendants d'Artificial Analysis, la documentation de Mistral et les retours d'usage sur Hacker News, Reddit et X durant les trois premiers jours.
Avis sur Mistral Large 4 en un coup d'œil
Voici la version courte, avant le détail.
| Ce que j'ai vérifié | Résultat | Source |
|---|---|---|
| Intelligence globale | 38,4 sur l'AA Intelligence Index (médiane de sa gamme de prix : 26) | Artificial Analysis |
| Bond par rapport à Large 3 | 9,3 à 38,4, environ 4,1x | AA : Large 3 |
| Rang parmi ses rivaux proches | Derrière Kimi K3 (43,6) et Qwen 3.8 Max (45,4) | AA |
| Prix (promotion de preview) | 0,68 $ en entrée / 2,09 $ en sortie par million de tokens | Tarifs Mistral |
| Coût par tâche AA | 1,13 $ au tarif public, environ 0,57 $ en promotion | Artificial Analysis |
| Taux d'hallucination | 41,9 % sur AA-Omniscience | Artificial Analysis |
| Vitesse de sortie | 116,1 tokens/s ; ~18,7 s avant le premier token de réponse | Artificial Analysis |
| Verbosité | 200 M de tokens pour exécuter l'index contre 81 M de médiane | Artificial Analysis |
| Poids ouverts | Promis pour fin octobre 2026, pas encore publiés | Mistral |
| Meilleur pour | Tâches cyber sans refus, agents juridiques, ancrage visuel | Graphiques de lancement de Mistral |
Qu'est-ce que Mistral a réellement corrigé ?
Le titre honnête, c'est que Mistral est de retour dans la course. En décembre dernier, Mistral Large 3 obtenait 9,3 sur le même index, très loin de la frontière. Large 4 obtient 38,4. C'est la différence entre un modèle pour des résumés bon marché et un sur lequel on pourrait faire tourner un agent IA.
L'équipe de Plotly l'a passé dans son benchmark d'analyse de données le jour du lancement et a vu le même bond sous un autre angle :
"Il est 10x moins cher que Mistral Medium 3.5 d'avril et passe de 58 % à 74 % de réponses correctes. Clairement un changement de génération."

Le hic, c'est d'où vient ce bond. Large 4 est un modèle de raisonnement et Large 3 n'en était pas un, donc une bonne partie du gain s'est payée en tokens de réflexion.
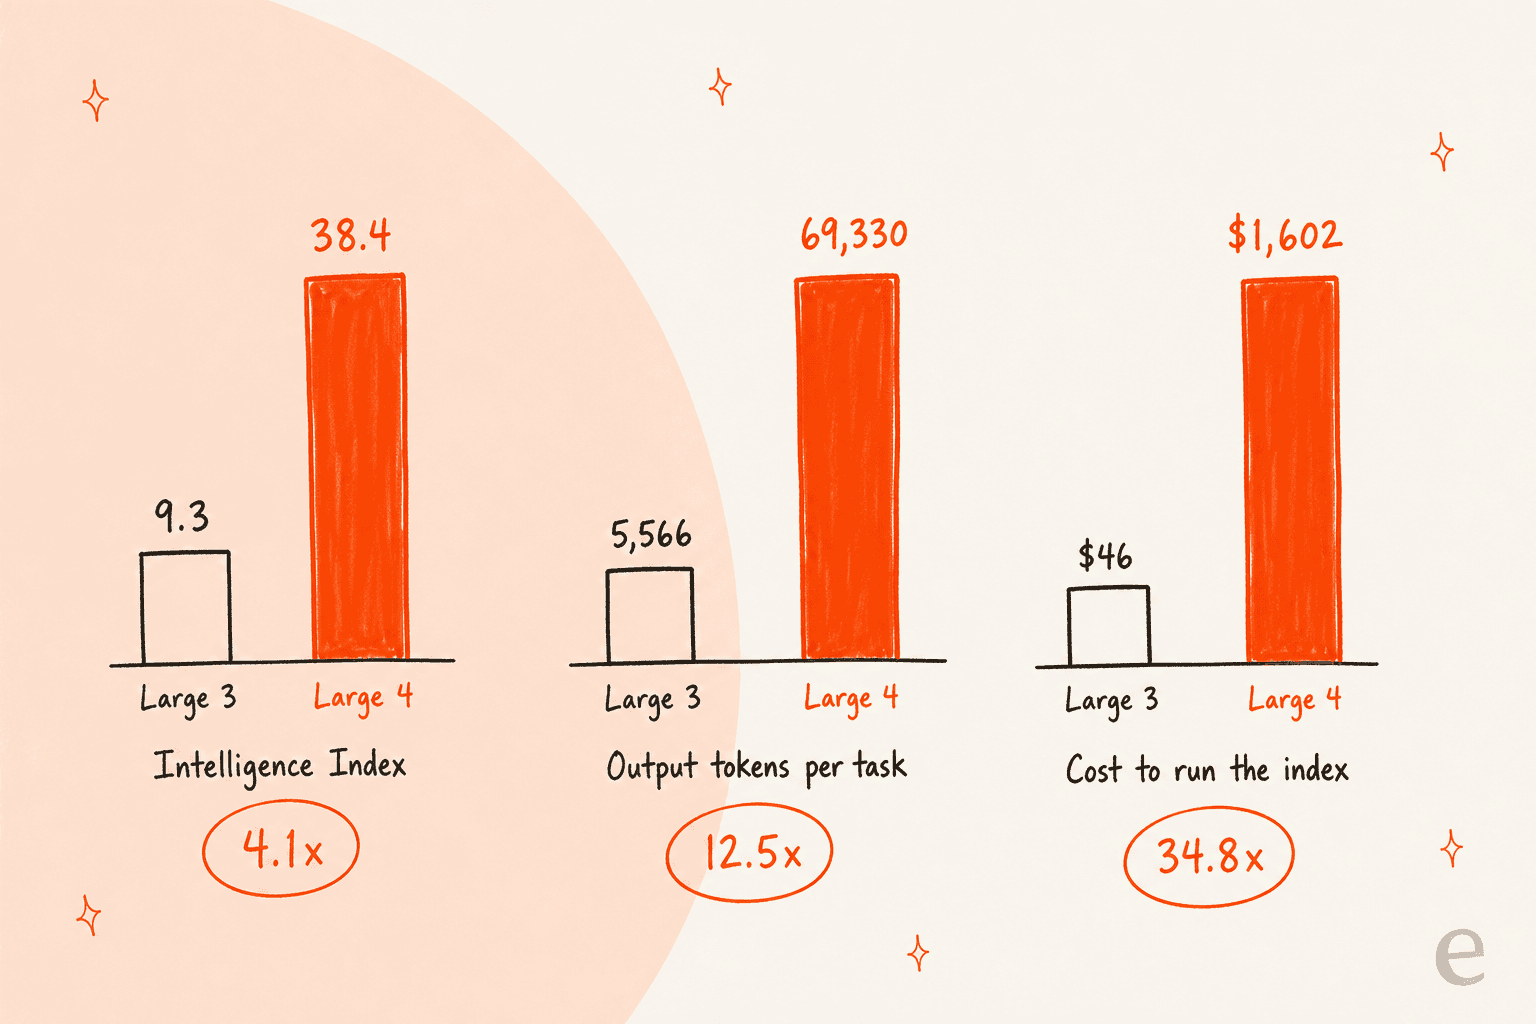
Le score a été multiplié par environ 4,1. Les tokens écrits par tâche ont été multipliés par 12,5, et le coût d'exécution de l'index complet au tarif public par 34,8, de 46 $ à 1 602 $, selon Artificial Analysis. Ce n'est pas une critique du modèle ; tous les laboratoires ont payé le même péage pour le raisonnement. Mais cela signifie que le prix par token est un mauvais indicateur de ce que Large 4 vous coûtera. Artificial Analysis le juge "très verbeux" : 200 M de tokens pour terminer l'index contre une médiane de 81 M.
Comment Mistral Large 4 se compare sur les benchmarks indépendants
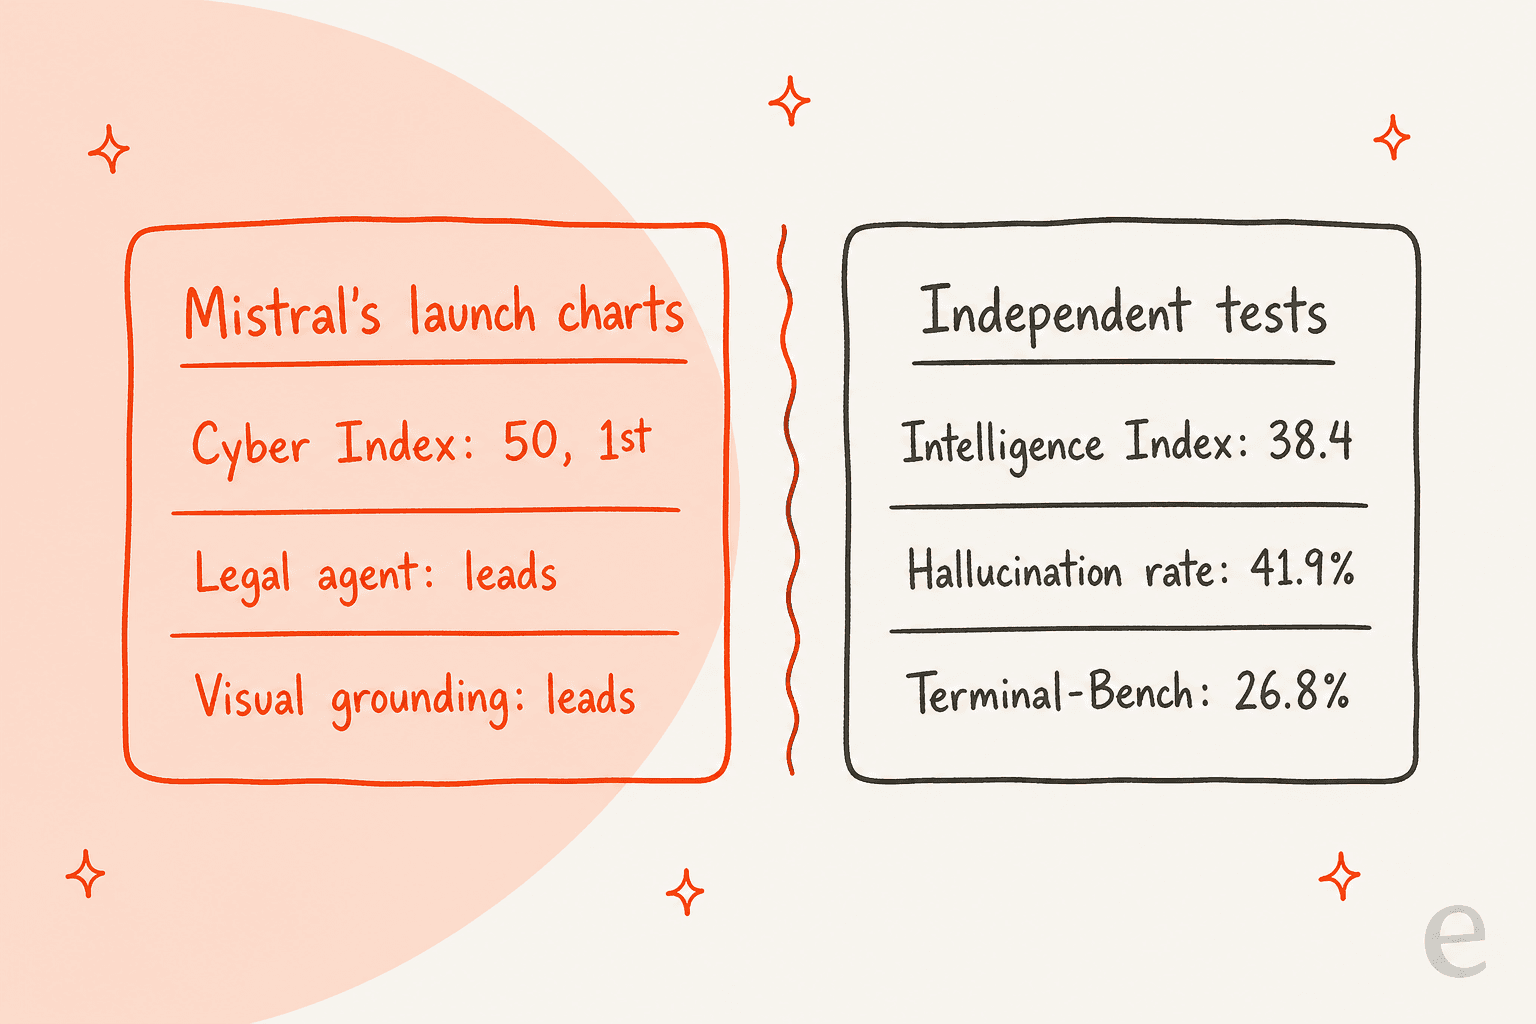
C'est là que l'avis devient moins flatteur. L'annonce de lancement de Mistral regorge de graphiques, et la plupart montrent Large 4 gagnant. Le tableau indépendant est plus nuancé.
Sur l'index v4.3.2 d'Artificial Analysis, qui combine 10 évaluations, voici où se situe Large 4 parmi les modèles auxquels on le compare :
| Modèle | Index AA | Prix entrée / sortie par M (public) | Coût par tâche AA | Vitesse de sortie |
|---|---|---|---|---|
| Claude Sonnet 5.5 (Xhigh) | 51,9 | 2 $ / 10 $ | 2,01 $ | 100,7 t/s |
| Qwen 3.8 Max | 45,4 | 2 $ / 6 $ | 5,41 $ | 37,6 t/s |
| Kimi K3 | 43,6 | 3 $ / 15 $ | 2,00 $ | 41,7 t/s |
| Gemini 3.8 Flash | 40,9 | 0,75 $ / 3,75 $ | 1,24 $ | 125,2 t/s |
| DeepSeek V4.1 Flash | 39,5 | 0,30 $ / 1,20 $ | 0,27 $ | 216,1 t/s |
| Mistral Large 4 Preview | 38,4 | 1,36 $ / 4,18 $ | 1,13 $ | 116,1 t/s |
| GPT-5.6 Luna | 37,3 | 0,20 $ / 1,20 $ | 0,18 $ | 117,0 t/s |
Tous les chiffres proviennent des pages modèles d'Artificial Analysis, consultées le 8 octobre 2026. Le coût par tâche de Large 4 est à peu près divisé par deux au prix promotionnel actuel.
Deux choses ressortent. D'abord, Large 4 est moins cher par tâche que tous les modèles au-dessus et génère plus vite que Kimi K3 et Qwen 3.8 Max. Ensuite, DeepSeek V4.1 Flash et GPT-5.6 Luna sont à environ un point et coûtent une fraction par tâche, même après la promotion de 50 % de Mistral. Si votre besoin est "des réponses correctes, en grand nombre", ces deux-là sont la concurrence la plus rude.
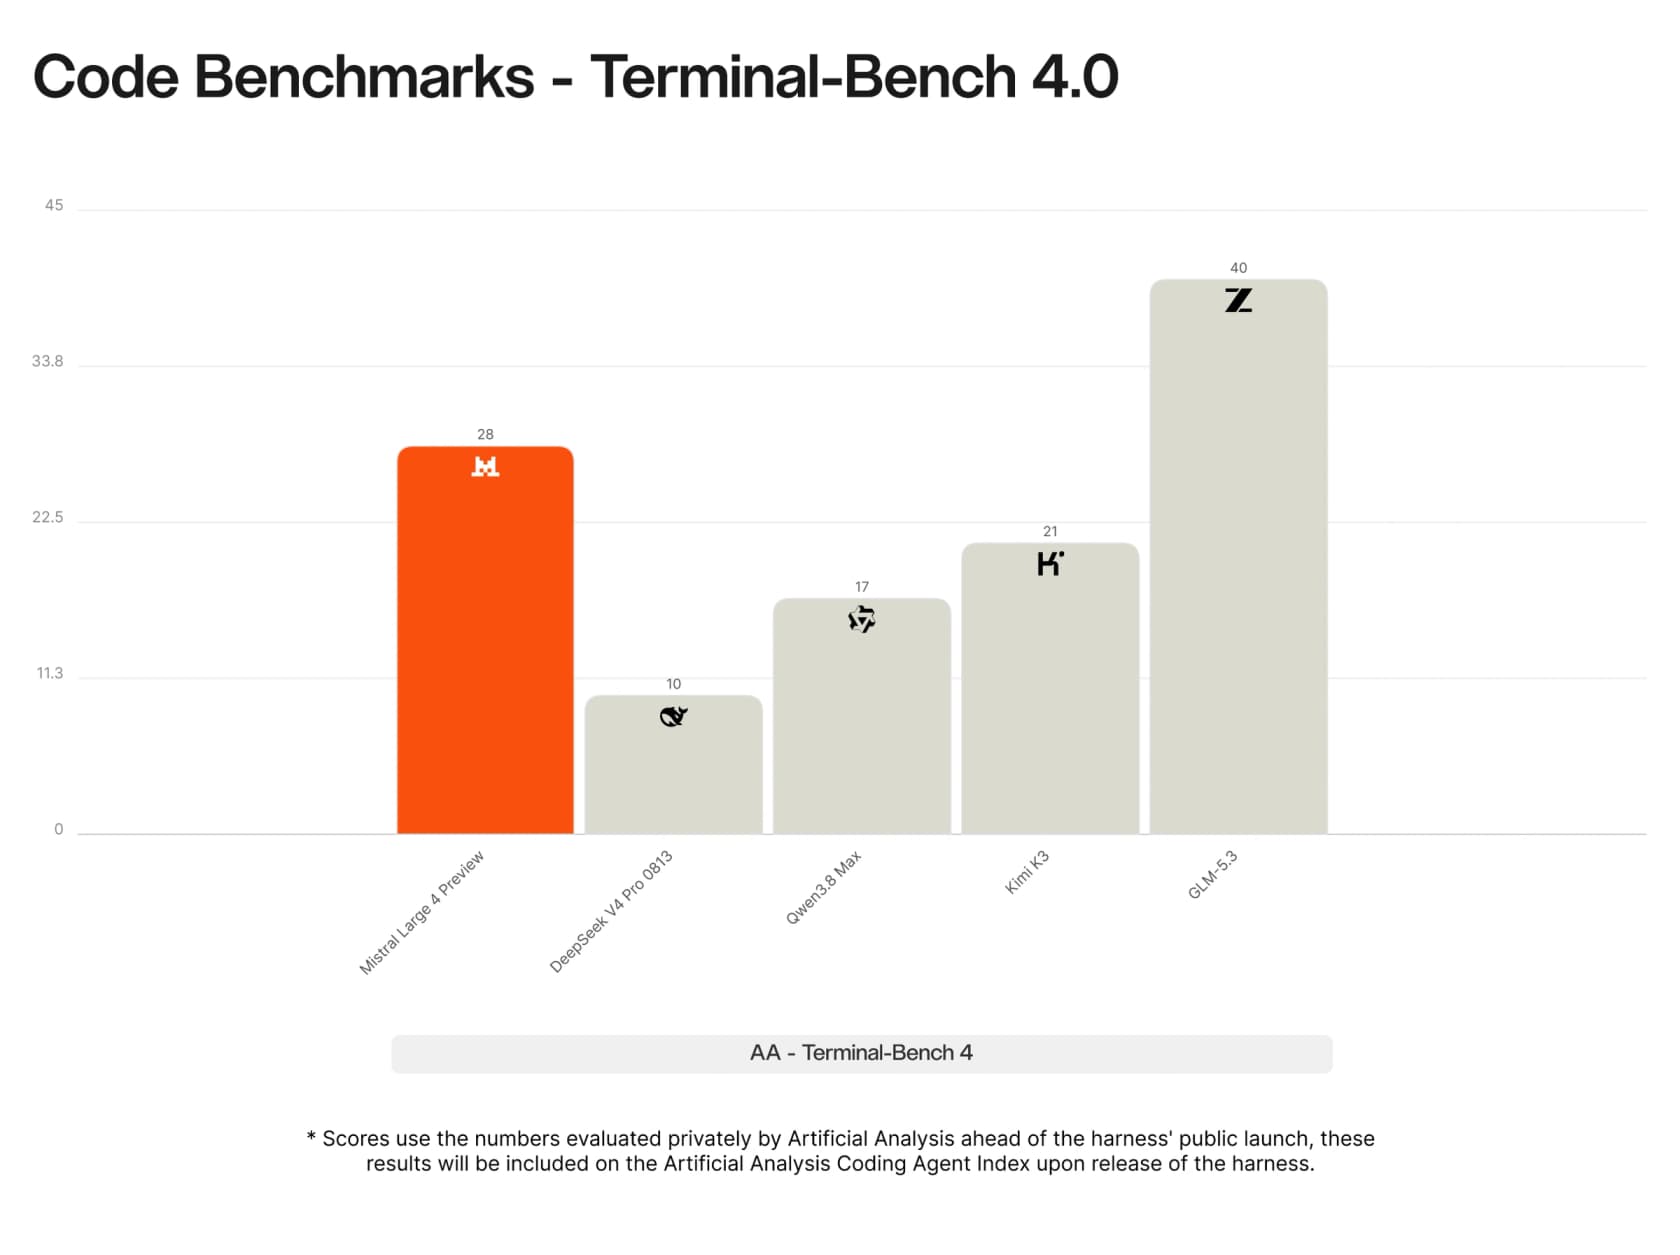
Le graphique Terminal-Bench 4.0 de Mistral est un bon exemple de l'importance du cadrage. Il montre Large 4 à 28, devant Qwen 3.8 Max et Kimi K3, mais bien derrière GLM-5.3 à 40.
Certains lecteurs de Hacker News ont été plus directs sur le choix des graphiques. Un commentateur a comparé un graphique multimodal aux chiffres publics d'Artificial Analysis et a relevé un écart :
"Je ne connais pas ce benchmark, mais la liste GDP.pdf d'AA place Sol 5.6 Max à 27, même sans raisonnement il bat les 12,8. C'est très étrange de choisir Sol 5.6 de façon sélective et en plus de mentir sur le score publié du benchmark tiers."
Je n'irais pas jusqu'à dire "mentir". Les versions et réglages des benchmarks diffèrent, et les graphiques de Mistral peuvent utiliser une autre exécution. Mais c'est une bonne raison de lire les graphiques des fournisseurs comme le meilleur cas et de prendre la page d'Artificial Analysis comme référence.
Là où Mistral Large 4 est vraiment fort
Être en milieu de peloton globalement ne veut pas dire l'être partout. Trois domaines résistent à l'examen.
Travail de sécurité sans refus. Sur le Cyber Index d'Artificial Analysis, tel que présenté par Mistral, Large 4 obtient 50, devant Kimi K3 et DeepSeek V4.1 Flash à 41. Le plus intéressant dans le graphique, ce sont les barres grises : chez d'autres modèles de pointe, une grande part des tentatives a été stoppée par des blocages de sécurité.
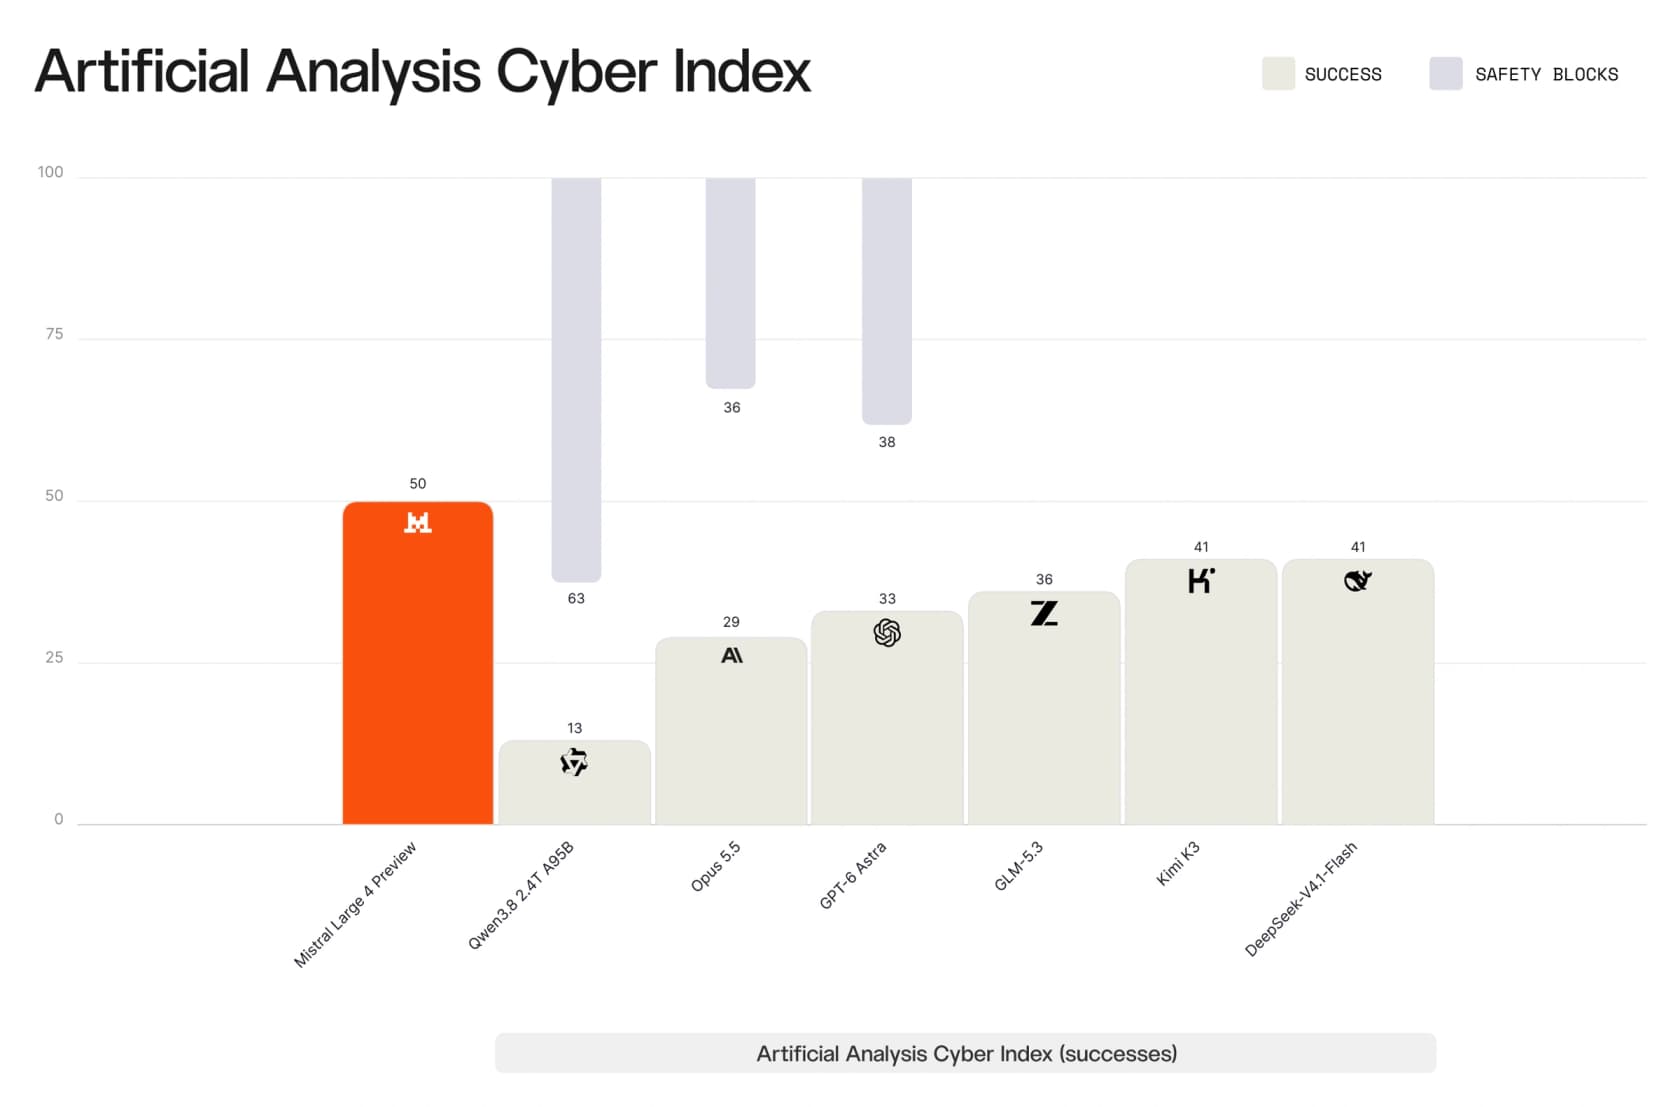
Le cofondateur de Mistral Guillaume Lample a défendu exactement cet angle le jour du lancement, en disant que les modèles ouverts "ne refusent pas d'aider". Si vous dirigez une équipe sécurité et que votre modèle actuel refuse sans cesse d'examiner du code d'exploit dans votre propre stack, c'est une vraie raison de tester Large 4.
Travail juridique et documentaire. Le graphique de Mistral issu de Vals.ai place Large 4 en tête du benchmark d'agent juridique de Harvey, et Artificial Analysis lui donne 81,3 % sur AA-LCR, son test de raisonnement sur contexte long. Les contrats longs vont bien avec une fenêtre de 1 M de tokens.
Vitesse une fois qu'il se met à parler. À 116,1 tokens par seconde sur l'API de Mistral, il génère nettement plus vite que Kimi K3 et Qwen 3.8 Max. Un des premiers testeurs sur Hacker News l'a apprécié comme outil quotidien pour cette raison :
"Il est très rapide via OpenRouter (nettement mieux que Kimi K3) sur webui. Très verbeux et il semble oublier les consignes au bout d'un moment, mais il m'a donné beaucoup de bonnes infos pendant une demi-heure de discussion sur le C et la programmation embarquée."
Notez le milieu de cette citation. "Oublie les consignes" compte bien plus en production que dans une fenêtre de chat.
Là où Mistral Large 4 déçoit
Les points faibles sont tout aussi précis.
Mémoire factuelle et hallucination. C'est le chiffre que je marquerais en rouge si je l'évaluais pour un usage tourné vers le client. Sur AA-Omniscience, qui pose des questions de connaissances et récompense un modèle qui dit "je ne sais pas" plutôt que de deviner, Large 4 a eu 25,8 % de bonnes réponses et un taux d'hallucination de 41,9 %, pour un score global de -5,3, selon Artificial Analysis. Un testeur de Hacker News a constaté la même chose dans un jeu de devinettes :
"Mistral Large 4 n'est pas très bon. Il peut parfois résoudre un jeu en ~40 essais alors que les meilleurs modèles comme Gemini 3.8 Flash ou Grok 4.7 résolvent la plupart des énigmes du premier coup. Mon benchmark concorde avec AA Omniscience."
Délai avant la première réponse. C'est un modèle de raisonnement, il réfléchit donc avant de parler. Artificial Analysis a mesuré environ 18,7 secondes avant le premier token de réponse sur un prompt long et 28,4 secondes à 100 000 tokens. C'est acceptable pour un agent de back-office et pénible pour un widget de chat en direct.
Codage agentique. Il est derrière GLM-5.3 sur Terminal-Bench et a obtenu 26,8 % sur l'exécution propre d'Artificial Analysis. Certains retours d'usage ont été encore plus sévères :
"J'ai un peu joué avec, pour l'analyse de code, la classification d'images et le jeu d'échecs. Il paraît assez daté et très en retard par rapport à ce que j'utilise d'habitude."

Pour être juste envers Mistral, c'est une preview. Lample a dit sur X que l'entraînement par renforcement "est toujours en cours", et une version finale est prévue avec les poids. Les scores peuvent bouger avant fin octobre.
Les "poids ouverts" sont-ils une raison de le choisir aujourd'hui ?
Pas encore. La fiche modèle porte un badge "Open", mais le champ de licence est vide, et au 9 octobre la page Hugging Face de Mistral n'a pas de dépôt Large 4. Artificial Analysis le classe comme propriétaire tant que les poids ne sont pas publiés.
Même une fois publiés, un modèle de 1,05 billion de paramètres n'est pas quelque chose que la plupart des équipes feront tourner sur un GPU de rechange. La réponse la plus aimée au tweet de lancement de Mistral l'a le mieux dit :
"moi avec 12 Go de VRAM en lisant 'poids ouverts, 1,05T de paramètres'"
L'intérêt pratique des poids ouverts ici concerne les grandes entreprises et les gouvernements qui veulent héberger un modèle performant sur leur propre matériel en Europe. Pour tous les autres, c'est l'API, et l'API est une preview avec un préavis de dépréciation d'un mois, pas les six mois d'un modèle en disponibilité générale. Bâtir un flux de production sur une preview, c'est accepter qu'il puisse changer avec quatre semaines de préavis.
Qui devrait utiliser Mistral Large 4 ?
Après tout cela, ma réponse tient en deux questions : vos données doivent-elles rester en Europe (ou sur vos propres serveurs), et la précision brute est-elle ce qui compte le plus pour votre cas d'usage ?
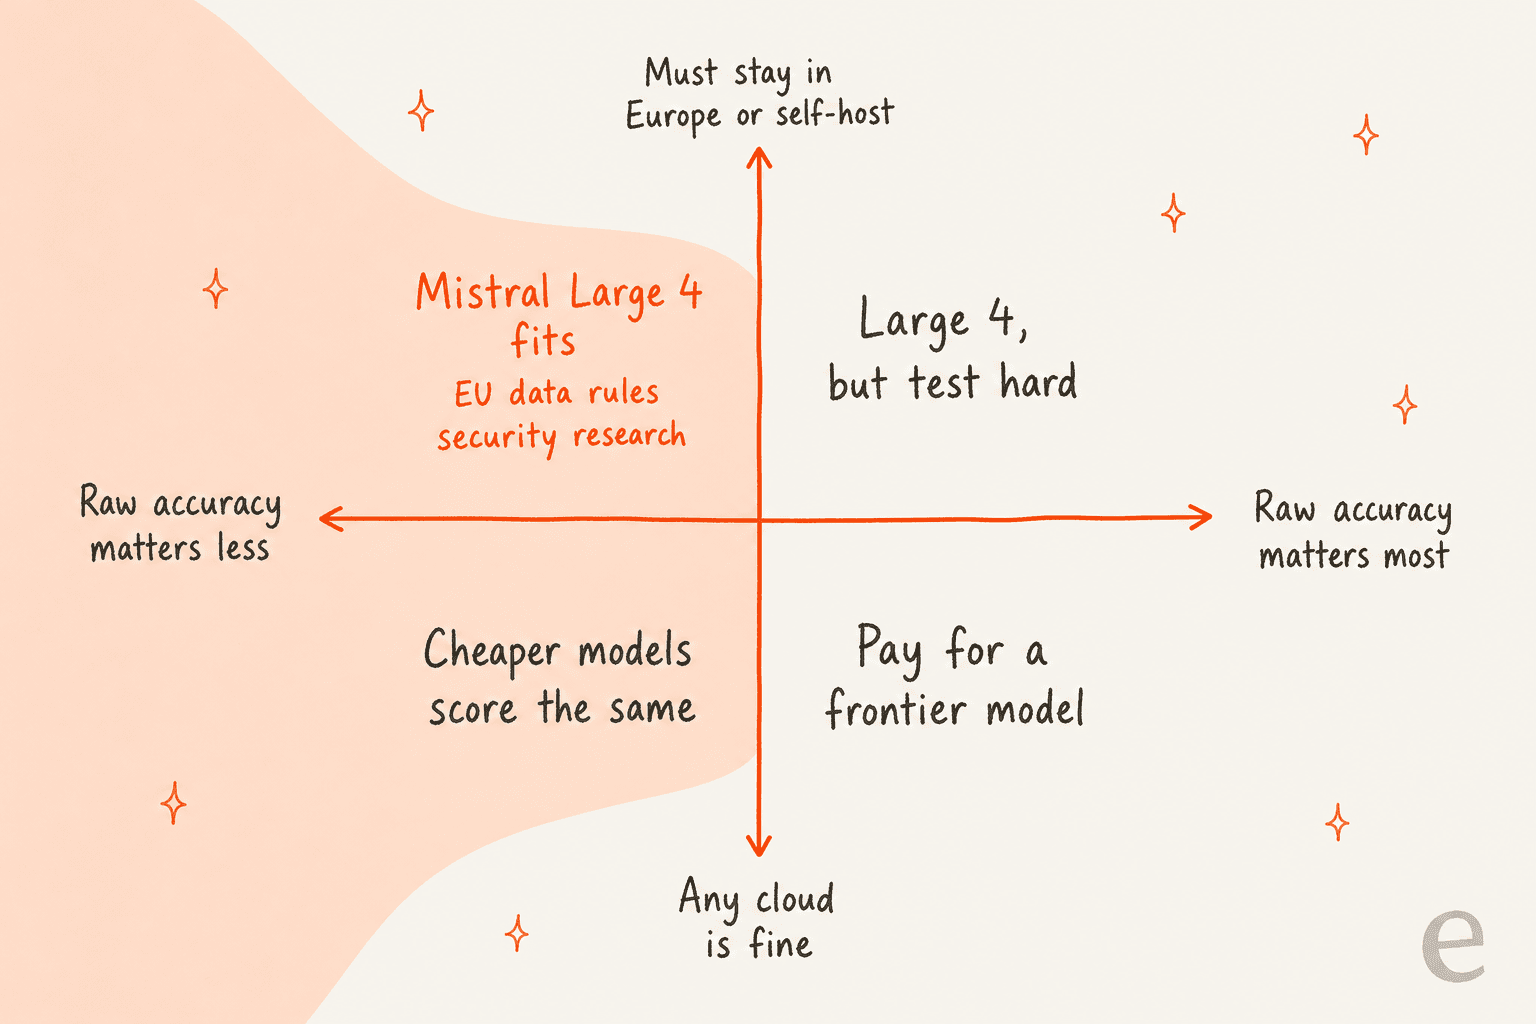
L'argument de la souveraineté est réel, et de nombreux commentateurs l'ont dit clairement :
"Dans la plupart des workflows d'entreprise, il est probablement suffisant. Et on n'a pas à vendre son âme à Xi ou à Trump. En tant qu'Européen, je craignais bien pire."
Essayez le test d'adéquation ci-dessous pour voir où se situe votre cas d'usage.
Qu'est-ce qui compte le plus pour votre charge de travail ?
Choisissez une option pour voir mon verdict.
Ce que cela signifie si vous dirigez une équipe de support
Beaucoup de lecteurs d'avis sur les modèles se demandent en ce moment si un modèle européen moins cher pourrait alimenter leur bot. Je comprends. Mais le chiffre d'hallucination est celui sur lequel je m'attarderais.
J'ai vu ce qui se passe quand un bot de support répond à partir de la mémoire du modèle plutôt que de vos documents. Plus tôt cette année, quelques clients payants d'eesel avaient un bot qui, lorsque la recherche dans la base de connaissances ne renvoyait rien, comblait le vide avec ses données d'entraînement au lieu de passer la main. L'un a envoyé à de vrais clients des détails d'abonnement inventés. Un autre a répondu à une question de support par "Oxygène", l'élément du tableau périodique. C'était un problème de solution de repli, pas de modèle, et un modèle plus gros ne l'aurait pas réglé. C'est pourquoi chaque déploiement eesel est désormais simulé sur des tickets passés avant de toucher un client.
Une responsable CX d'une marque de compléments alimentaires, gérant environ 7 000 tickets, a formulé le vrai besoin mieux que n'importe quel benchmark :
"J'ai besoin d'une IA qui ne traite que les tickets qu'elle est sûre de pouvoir traiter et qui laisse tous les autres tranquilles."
C'est d'abord un problème de routage et de score de confiance, et ensuite un problème de modèle. Un modèle à 41,9 % d'hallucination rend cette couche plus importante, pas moins. Si vous construisez le vôtre sur Large 4, mes guides sur le RAG pour le support, l'arrêt des hallucinations et le meilleur LLM pour le support sont un bon point de départ. Et si votre raison de choisir Mistral tient aux règles de données de l'UE, vérifiez d'abord ce que SOC 2 et RGPD exigent réellement du fournisseur ; le pays d'origine du modèle n'en est qu'une partie.
Alternatives à Mistral Large 4 qui valent un essai
Si cet avis vous fait hésiter, voici où je regarderais à la place, selon votre besoin :
| Vous voulez | Regardez | Pourquoi |
|---|---|---|
| Plus de précision, encore abordable | Sonnet 5.5 ou Kimi K3 | 51,9 et 43,6 sur l'index AA |
| Même score, coût plus bas | Famille DeepSeek V4 Flash, GPT-5.6 Luna | 39,5 et 37,3 à 0,18 $ à 0,27 $ par tâche |
| Des poids ouverts utilisables aujourd'hui | DeepSeek V4.1 Flash, GLM-5.3 | Tous deux listés comme open-weight à côté de Large 4 dans cette comparaison AA |
| Un Mistral moins cher | Large 3 ou Small 4 (voir les tarifs Mistral AI) | 0,50 $/1,50 $ et 0,15 $/0,60 $ par million |
Pour une liste plus longue, mon tour d'horizon des alternatives à Mistral et les duels Claude vs Mistral et ChatGPT vs Mistral vont plus loin.
Le verdict
Mistral Large 4 est un vrai retour d'un laboratoire qui semblait avoir calé. Le bond de score est réel, le prix est correct tant que la promotion dure, et la vitesse est bonne. Si vous avez besoin d'un fournisseur européen ou d'un modèle qui aide vraiment sur le travail de sécurité, c'est celui que je testerais en premier.
Pour tous les autres, les chiffres ne justifient pas encore le changement. Il est à peu près au niveau de modèles quatre fois moins chers par tâche, il hallucine plus que ce que j'accepterais pour du travail face au client, et la version que vous testez aujourd'hui est une preview qui peut changer avec un mois de préavis. Je reviendrais après la version finale et les poids de fin octobre, puis je déciderais.
Essayer eesel
Si vous êtes venu ici parce que vous choisissez un modèle pour un bot de support, voici le raccourci : le modèle est l'infrastructure, et eesel est l'employé. Le coéquipier helpdesk IA d'eesel se branche sur Zendesk, Freshdesk ou Gorgias, apprend de vos tickets passés et de votre centre d'aide, et lance une simulation sur des centaines de vos vrais tickets pour que vous voyiez ses réponses avant un client. Le choix du modèle, l'ancrage et la solution de repli "je ne sais pas, je passe la main à un humain" sont gérés pour vous, et vous payez par ticket traité, donc un modèle verbeux n'apparaît jamais sur votre facture. Les forfaits commencent gratuitement sur la page des tarifs.

Essayez eesel et rejouez votre dernier mois de tickets avant de décider quoi que ce soit.