

Voxtral 3 est toute la pile vocale de Mistral en une seule version : trois modèles qui transforment la parole en texte, un qui transforme le texte en parole, et un SDK d'agents vocaux qui les relie à un modèle de chat pour qu'une IA puisse tenir une conversation par téléphone ou dans un navigateur. Il est sorti le 20 octobre 2026, et tous les modèles sont encore en préversion publique.
Les prix sont bas. La transcription coûte de 0,0035 $ à 0,008 $ la minute, la voix 13 $ le million de caractères, et toute la chaîne de l'agent revient à 0,04 $ la minute avec Mistral Small 4 pour le raisonnement. Deux bémols : les poids sont fermés cette fois, et les lignes téléphoniques via SIP sont réservées aux clients enterprise au lancement.
Pour les équipes de support, l'enseignement est que Voxtral résout l'écoute et la parole, pas le savoir. Chez eesel, je construis les agents IA qui répondent à de vrais tickets, et ce qui les rend utiles, c'est d'apprendre les anciennes réponses d'une entreprise, comme les 27 000 tickets Zendesk en allemand par mois que nous traitons pour smava. Voxtral donne à un agent des oreilles et une voix. Les réponses doivent toujours venir de quelque part.
Qu'est-ce que Voxtral 3 ?
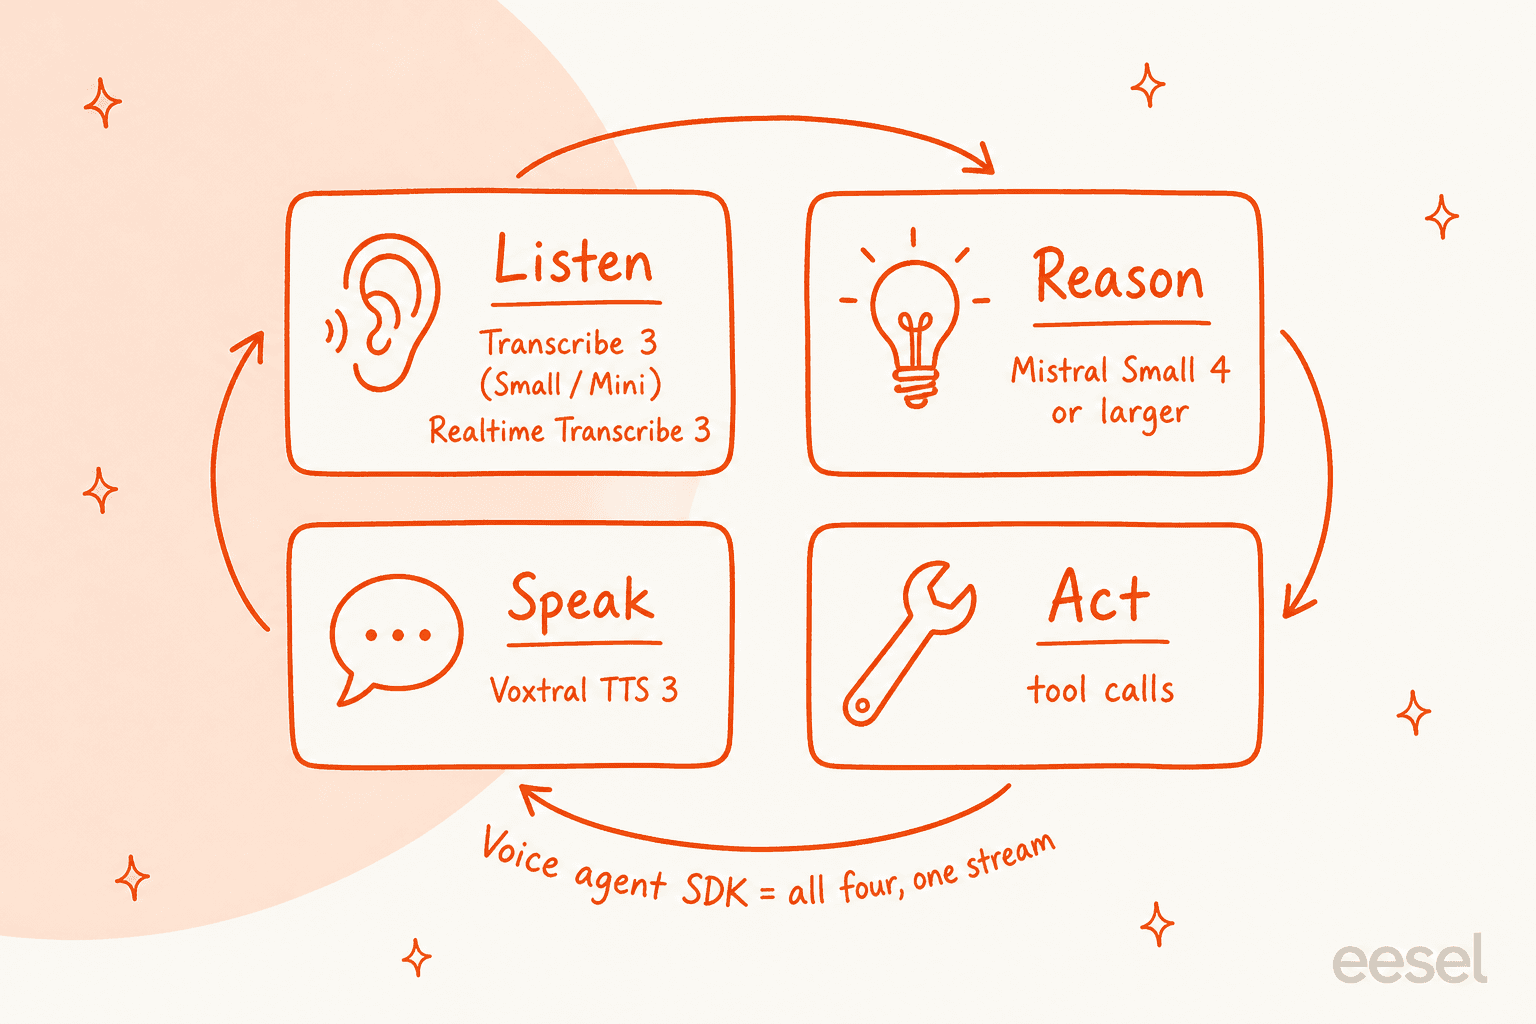
Voxtral 3 est une famille de modèles vocaux de Mistral AI, le laboratoire parisien derrière les modèles de chat Mistral et Magistral. L'argument de Mistral est qu'un agent vocal qui fonctionne doit accomplir quatre tâches à la fois : écouter avec précision, comprendre ce que veut dire l'appelant, parler naturellement et agir dans d'autres systèmes. Voxtral 3 est la première version de Voxtral qui fournit une brique pour chacune.
Je travaille sur le fonctionnement interne des agents d'eesel, donc ce que je trouve le plus intéressant dans ce lancement n'est aucun benchmark en particulier. C'est que Mistral a découpé le travail en modèles séparés que l'on peut remplacer, plutôt qu'un seul modèle qui fait tout. Ce choix explique l'essentiel de ce qui est bon et de ce qui est maladroit dans Voxtral 3.
Quels modèles contient Voxtral 3 ?
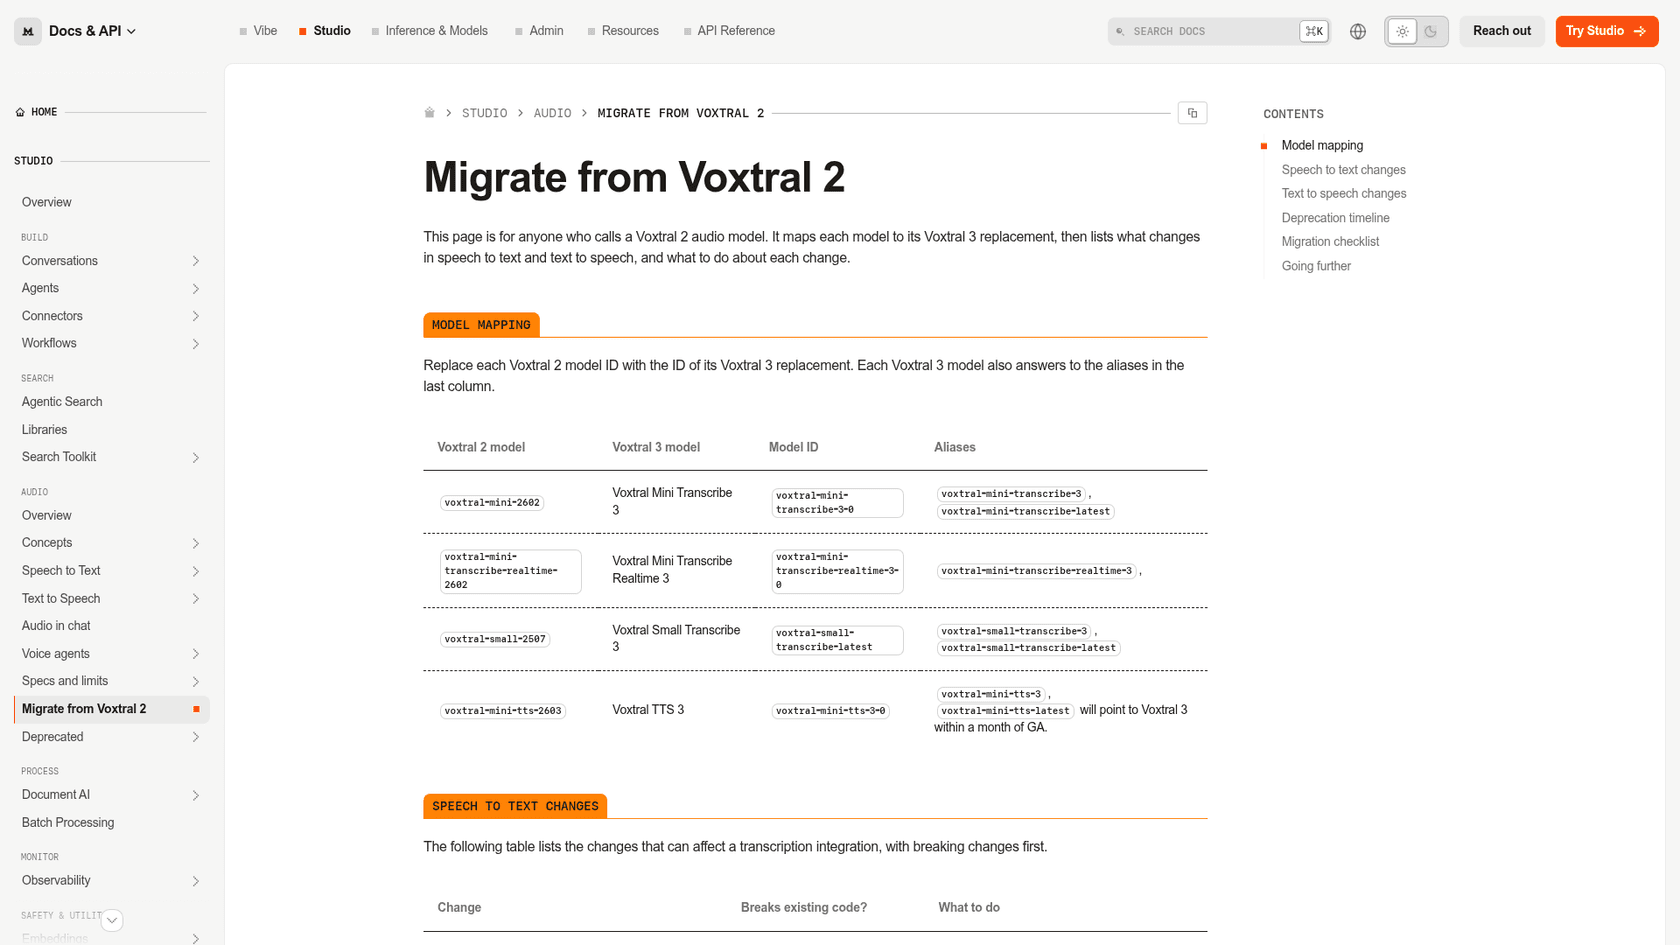
Il y a quatre modèles et un produit d'API. Voici la gamme avec les identifiants de modèle que vous appelleriez réellement, tirés du guide de migration et des tarifs de lancement :
| Modèle | Identifiant du modèle | Ce qu'il fait | Prix |
|---|---|---|---|
| Voxtral Small Transcribe 3 | voxtral-small-transcribe-3-0 | Transcription par lots phare, diarisation, traduction, questions-réponses sur la parole | $0.004/min |
| Voxtral Mini Transcribe 3 | voxtral-mini-transcribe-3-0 | Modèle de transcription par lots plus petit, de 4B | $0.0035/min |
| Voxtral Mini Transcribe Realtime 3 | voxtral-mini-transcribe-realtime-3-0 | Transcription en direct avec détection de fin de tour | $0.008/min |
| Voxtral Mini TTS 3 | voxtral-mini-tts-3-0 | Synthèse vocale, plus de 35 langues, clonage de voix | $13/1M chars |
| API d'agent vocal | n/a | Transcription en temps réel + modèle de chat + TTS dans un seul flux | $0.04/min (Mistral Small 4), $0.08/min (modèle plus grand) |
Chaque modèle a aussi des alias courts, comme voxtral-mini-transcribe-latest. Un point à surveiller : Mistral indique que l'alias voxtral-mini-tts-latest ne basculera vers Voxtral 3 que dans le mois suivant la disponibilité générale. Si vous voulez un comportement prévisible, figez l'identifiant complet du modèle.
Tout est disponible via l'API de Mistral sur des points d'accès européens, américains et mondiaux, et vous pouvez essayer la transcription, la parole et les agents vocaux dans le playground Studio avant d'écrire du code.
Les modèles de transcription
Voxtral Small Transcribe 3 est celui à connaître. Mistral l'appelle son modèle phare de transcription et de diarisation (la diarisation consiste à indiquer qui a dit chaque ligne). Il gère 50 langues, dont les 24 langues officielles de l'UE (pratique pour le support multilingue), et sa fiche de modèle indique qu'il fait aussi de la traduction, du résumé et des appels de fonctions à partir de l'audio. La fenêtre de contexte est de 32k tokens.
Sur le test FLEURS à 45 langues de Mistral, Small obtient un taux d'erreur de mots de 4,0 % lorsqu'il détecte lui-même la langue, à égalité avec Microsoft AI Transcribe 2 et très loin devant Whisper large-v3 à 14,9 %. Le modèle Mini obtient 4,5 % pour un peu moins cher. Je détaille chaque graphique, y compris là où Voxtral n'est pas en tête, dans mon test de Voxtral 3.
Les deux modèles par lots prennent en charge le context biasing : vous envoyez une liste de termes (noms de produits, personnes, références) et le modèle les orthographie correctement sans aucun fine-tuning. Sur le test de phrases clés de Mistral, cette liste fait passer le rappel de Small de 81,4 % à 94,6 %, donc considérez-la comme un réglage par défaut, pas comme un bonus.
Le modèle en temps réel est celui qu'utilise un agent en direct. Vous choisissez combien de temps il attend avant de valider des mots, et des attentes plus longues donnent moins d'erreurs. Il prédit aussi quand un locuteur a fini, à partir du son et du sens des mots, ce qui évite qu'un bot vocal coupe la parole en pleine phrase. C'est important pour le support téléphonique par IA, où les appelants marquent des pauses pour lire des numéros de commande.
Le modèle de voix
Voxtral Mini TTS 3 transforme le texte en parole dans plus de 35 langues et plus de 50 dialectes, avec des voix prédéfinies dans 18 langues. La fiche du modèle indique environ 90 ms avant le premier audio en streaming, 34 balises d'émotion et 2 balises de rythme à écrire en ligne, et le clonage de voix à partir d'un court extrait. Pour les voix de marque, « Pro Voice » construit une copie plus fidèle à partir d'environ 30 minutes d'audio.
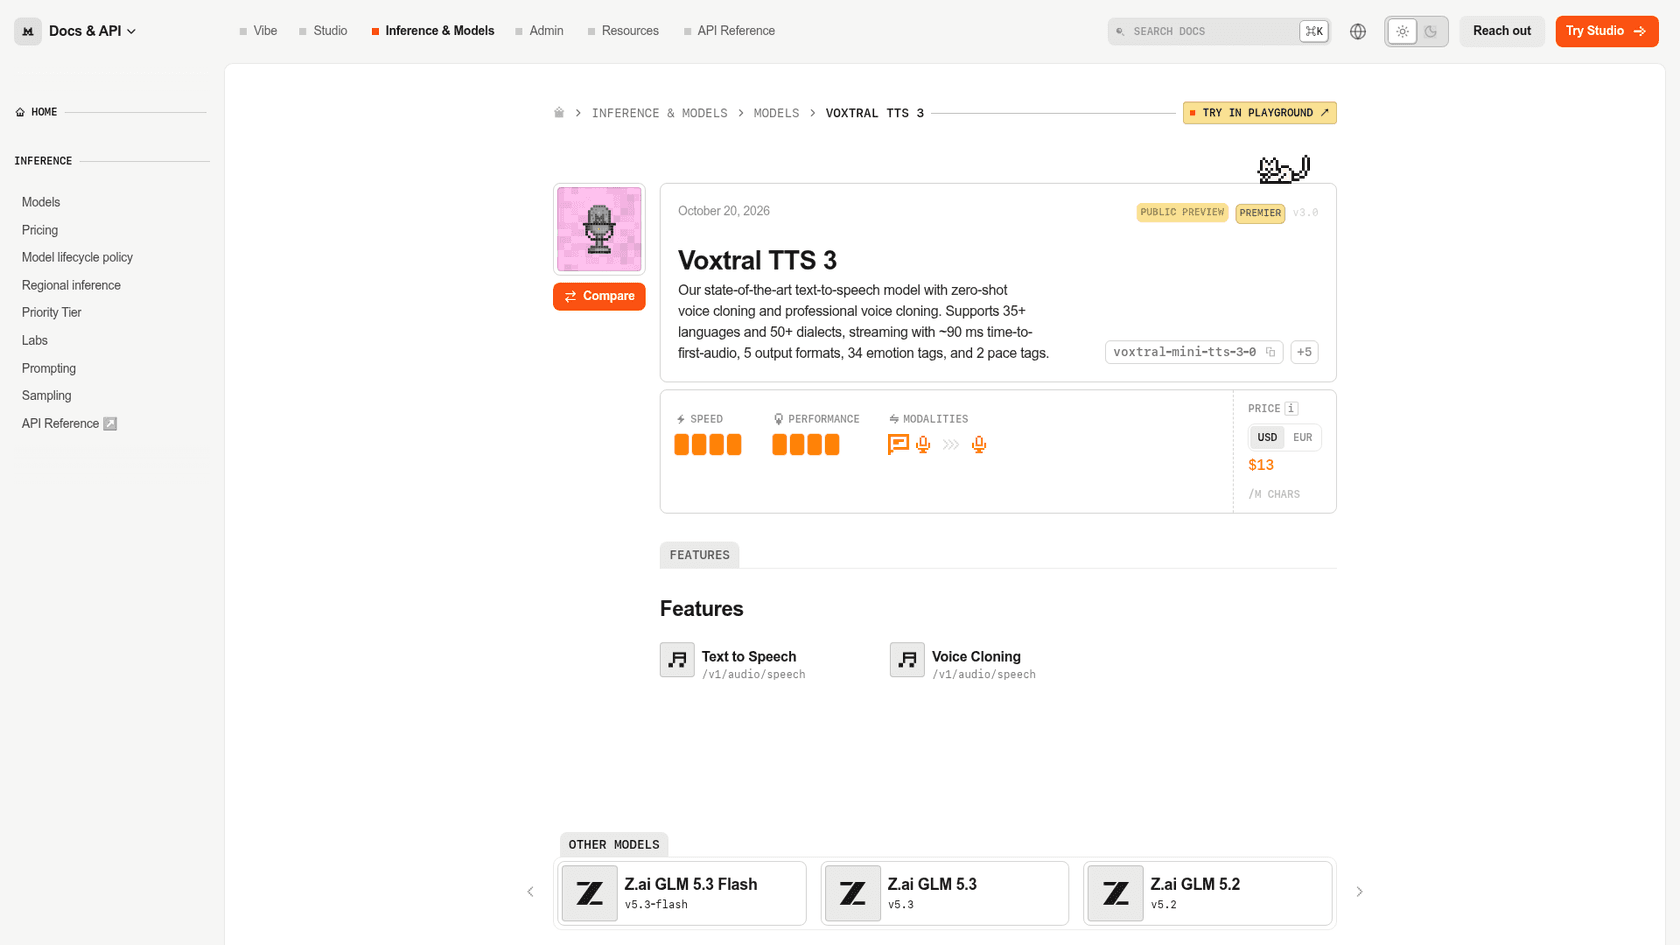
Les échantillons sonores de la page de lancement visent précisément ce qui fait trébucher les voix de support : lire une adresse e-mail, une heure de vol, un prix en livres. Mistral affirme aussi que 13 $ le million de caractères est moins cher que ElevenLabs Flash, OpenAI TTS-1, Deepgram et Gemini Flash. Tout le monde n'aime pas le nouveau rendu pour autant :
"The examples they give of how they "improved" the voices aren't great. Version 1 sounded like actual people, while this version sounds like generic AI slop voice."

C'est un seul auditeur, et les goûts en matière de voix sont personnels. C'est tout de même une bonne raison de générer des échantillons avec vos propres scripts avant de choisir une voix.
Comment fonctionne l'agent vocal de Voxtral 3 ?
L'agent vocal exécute une boucle en trois étapes à chaque tour de conversation. D'après la documentation des agents vocaux, le modèle en temps réel transcrit l'appelant et repère quand il a fini, un modèle de chat comme Mistral Small 4 décide quoi dire et appelle les outils, et Voxtral TTS prononce la réponse. Les étapes s'alimentent en continu au lieu d'attendre, donc Mistral indique que chaque tour se termine en moins d'une seconde, et l'agent cesse de parler quand l'appelant l'interrompt.
Pendant un appel, l'agent peut utiliser les appels de fonctions, la recherche web, des bibliothèques de documents et vos propres fonctions, par exemple pour vérifier un appelant ou réserver un rendez-vous. Il fonctionne dans les navigateurs et les applications via WebRTC, et sur les lignes téléphoniques via SIP. Le SDK s'appuie sur LiveKit pour le transport audio.
Un commentateur de Hacker News a bien résumé pourquoi c'est la partie intéressante de cette version :
"I think the special sauce of this isn't the STT/TSS (although it does appear to be quite good) - it's the integration of a real-time reasoning model to actually do something with the raw text of the conversation, and whatever they're doing to hide tool call latency if the model needs to search for something."
Je suis d'accord, et c'est aussi là que le travail retombe sur vous. Les outils sont génériques : il n'y a aucune notion intégrée de votre helpdesk, de votre système de commandes ou de vos anciens tickets. Lors de nos appels commerciaux chez eesel, la demande la plus fréquente de loin est un agent qui apprend des anciens tickets, parce que c'est là que se trouvent les vraies réponses d'une entreprise. Avec Voxtral, brancher cela est un travail d'intégration qui vous incombe. Si vous définissez ce qu'un agent IA de centre d'appels doit pouvoir toucher, décidez-le avant de brancher les outils.
Deux limites du lancement comptent surtout pour le support. Les appels téléphoniques via SIP sont réservés aux clients enterprise au lancement, organisés par l'équipe commerciale de Mistral, tandis que la voix web et applicative est ouverte à tous. Et les outils qui s'exécutent dans le navigateur de l'utilisateur ne fonctionnent pas lors des appels téléphoniques, donc tout ce dont un agent téléphonique a besoin doit s'exécuter sur votre serveur.
Quoi de neuf par rapport à Voxtral 2 ?
La version courte : plus de langues, une bien meilleure diarisation, une nouvelle couche d'agents et des poids fermés.
Ce qui s'est amélioré :
- Diarisation. Le taux d'erreur du modèle Mini sur le benchmark de diarisation de Mistral est passé de
30,9 %pour Voxtral Mini Transcribe 2 à18,6 %pour Mini Transcribe 3. Pour les enregistrements d'appels, savoir quelles lignes étaient celles du client représente la moitié de la valeur. - Langues. La transcription par lots couvre désormais 50 langues, avec l'ajout de langues asiatiques et indiennes peu dotées.
- Context biasing. Les termes peuvent maintenant être des expressions de plusieurs mots, et une phrase de contexte libre fonctionne hors ligne.
- Fonctions en temps réel. La diarisation, les références de locuteur et la détection de tours fonctionnent désormais dans les sessions en temps réel.
- Contrôle de la voix. L'émotion passe de voix prédéfinies distinctes (comme
gb_jane_sad) à des balises en ligne[emotion=...], et les voix clonées peuvent être enregistrées une fois et réutilisées par identifiant.
Ce qui casse, d'après le guide de migration :
- Les horodatages par mot ont disparu. Demander la granularité
wordrenvoie une erreur400, passez donc aux horodatages par segment. - Les sessions en temps réel verrouillent leurs paramètres au premier bloc audio, envoyez donc tous les paramètres d'emblée.
- Les segments diarisés peuvent se chevaucher quand deux personnes parlent en même temps.
Une fonction est listée mais pas livrée : les instructions de style, le contrôle en texte libre du type « dis ça chaleureusement », sont barrées dans la documentation comme indisponibles au lancement.
Pourquoi les poids fermés comptent
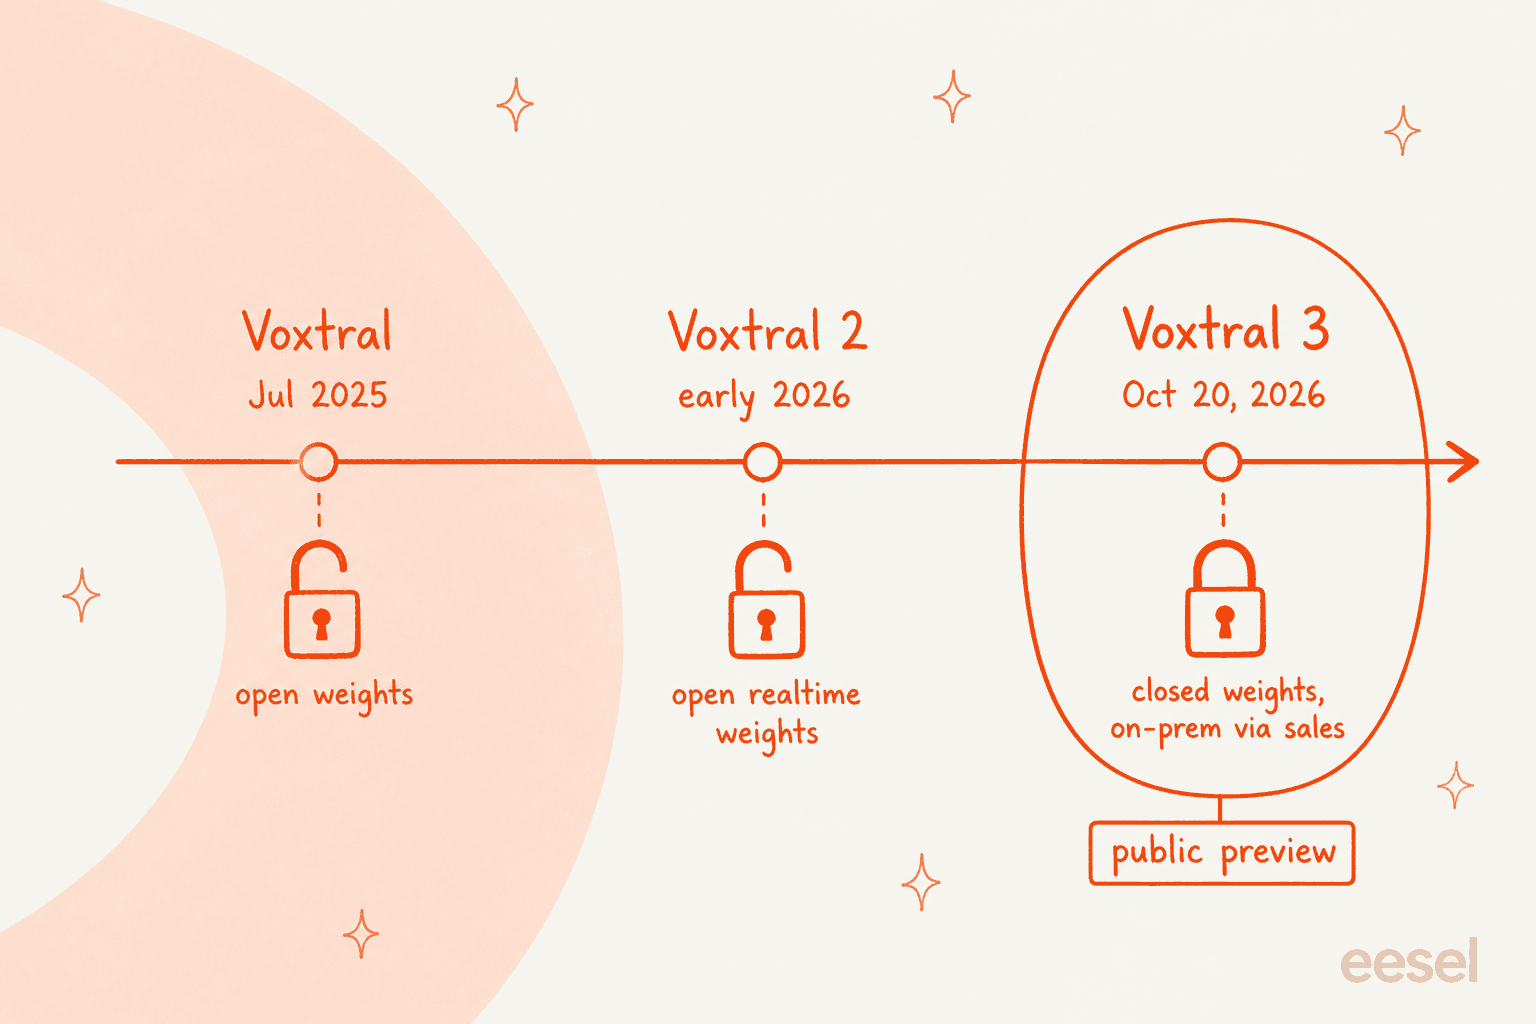
Les premiers modèles Voxtral de juillet 2025 et le modèle Voxtral Mini 4B Realtime avaient des poids ouverts sur Hugging Face. Pas Voxtral 3. Le lancement mentionne l'« auto-déploiement », mais cela signifie un contrat : les configurations on-prem et cloud privé passent par l'équipe commerciale de Mistral.
"You have to call sales to get access for on-prem deployment and the models. If it were open weights, it would be on Huggingface and they would have put a link in the post"
Pour un amateur qui fait tourner la voix sur un portable, c'est une vraie perte. Pour une équipe de support enterprise, une API hébergée dans l'UE plus de l'on-prem par contrat est un achat normal et, sans doute, la voie la plus sûre pour l'audio des appels au regard de l'AI Act européen. Mistral publie toujours des modèles ouverts ailleurs, comme le montrent ses plans pour Mistral Large 4.
Combien coûte Voxtral 3 ?
Voxtral 3 est facturé à la minute d'audio pour la transcription et l'agent, et au caractère pour la voix. Voici les tarifs catalogue de lancement de Mistral :
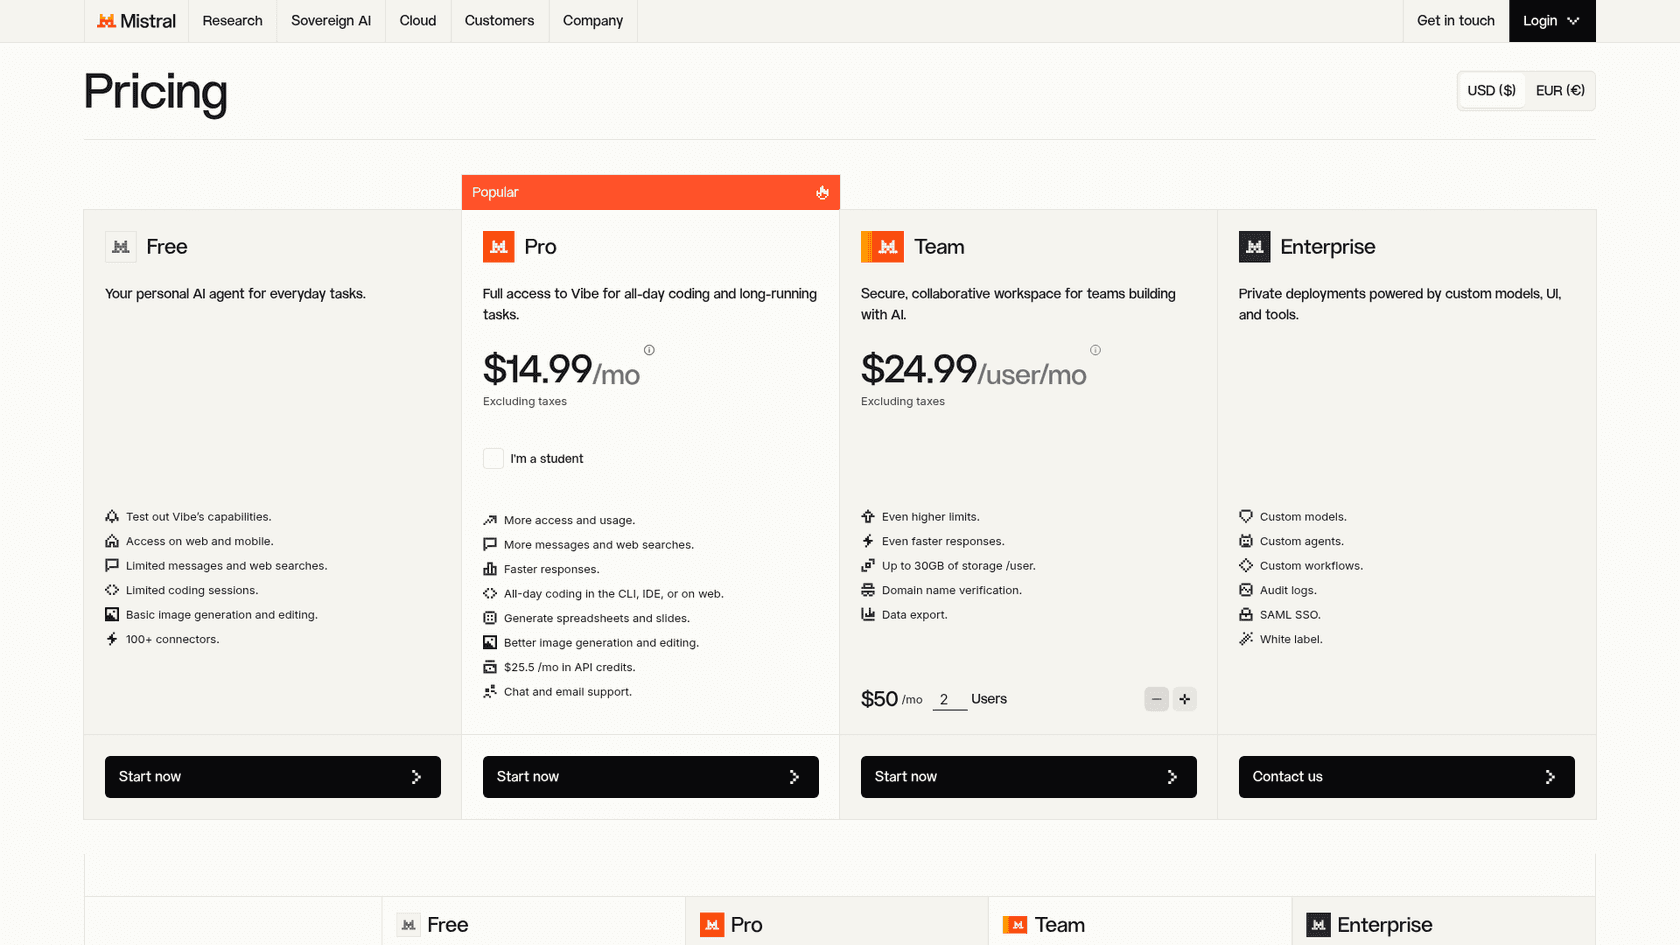
| Charge de travail | Tarif | 1 000 appels de cinq minutes |
|---|---|---|
| Transcrire des enregistrements avec Mini | $0.0035/min | $17.50 |
| Transcrire des enregistrements avec Small | $0.004/min | $20 |
| Transcription en direct | $0.008/min | $40 |
| Agent vocal avec Mistral Small 4 | $0.04/min | $200 |
| Agent vocal avec un modèle plus grand | $0.08/min | $400 |
Le schéma est la partie utile. Transcrire chaque appel que vous prenez déjà pour le contrôle qualité coûte trois fois rien. Faire prendre les appels par une IA coûte 10 à 20 fois plus, parce que le raisonnement et la parole sont là où se trouve la facture. Un appel de cinq minutes via l'API d'agent revient à 0,20 $. C'est le chiffre à intégrer à vos calculs de ROI du centre d'appels.
Pour un détail plus poussé des coûts des modèles de chat derrière l'agent, voir les tarifs de Mistral AI. Pour situer les piles vocales concurrentes, comparez GPT Realtime et Grok Voice Think Fast 2 sur les pages de leurs propres fournisseurs, car les prix de la voix ont beaucoup bougé cette année.
Quel modèle Voxtral 3 devriez-vous utiliser ?
Choisissez selon la tâche, pas selon le plus gros modèle. Voici comment je les associerais :
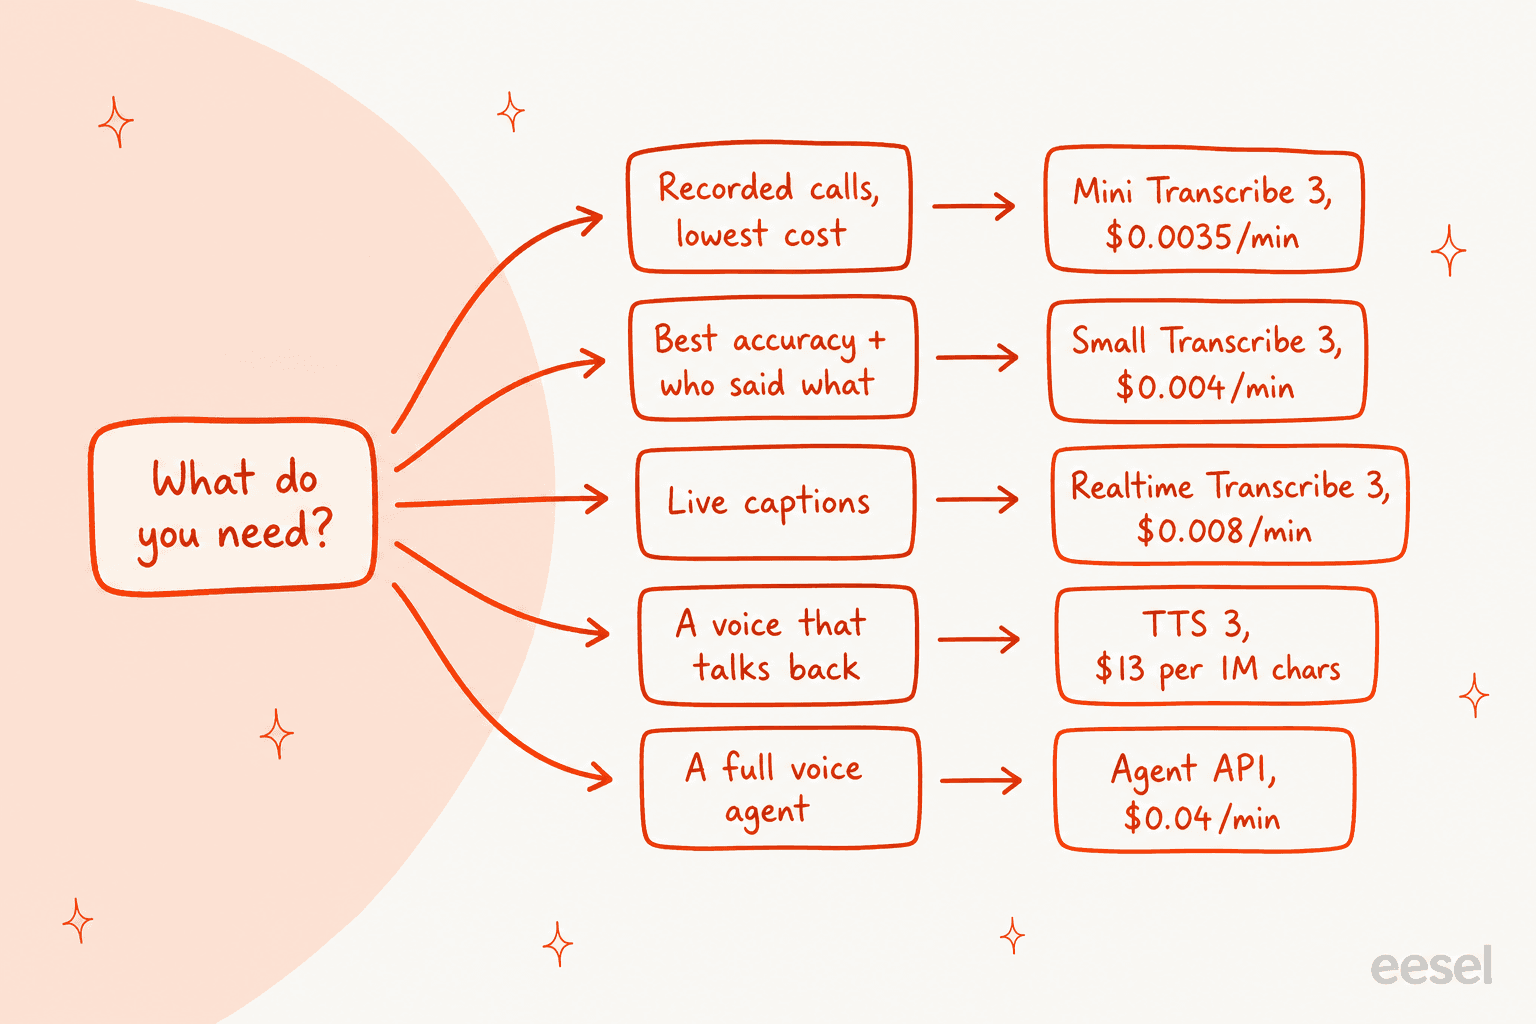
- Analyse d'appels et contrôle qualité : Mini Transcribe 3. Il est à un demi-point de Small sur le test de Mistral et c'est la ligne la moins chère de la liste. Associez-le à la suppression des données personnelles avant que les transcriptions n'aillent dans un espace partagé.
- Réunions et enregistrements multi-locuteurs : Small Transcribe 3, pour la meilleure diarisation du graphique de Mistral.
- Un assistant vocal dans un navigateur ou une application : l'API d'agent vocal. Elle est bien conçue, mais tenez compte de son statut de préversion.
- Une IA sur votre numéro de support téléphonique : attendez, sauf si vous êtes un client enterprise pouvant obtenir l'accès SIP, et prévoyez un budget pour l'intégration au helpdesk.
- Parole locale, hors ligne : pas Voxtral 3. Regardez les alternatives à Mistral ou les anciens poids ouverts de Voxtral.
Si vous comparez Voxtral à d'autres modèles vocaux, Gemini 3.5 Transcribe, MAI-Transcribe 2 et Cartesia Sonic 3 sont les plus proches.
Pour des produits complets plutôt que des modèles, mes sélections d'entreprises de voix IA et de la meilleure IA pour le support vocal couvrent le secteur.
Ce que Voxtral 3 change pour les équipes de support
Voxtral 3 rend la partie vocale d'un agent de support bon marché et bonne. Il ne fait pas pour autant connaître votre métier à l'agent. C'est dans cet écart que la plupart des projets vocaux calent : le bot entend parfaitement l'appelant puis donne une réponse assurée mais fausse sur la politique de remboursement.
Chez eesel, nous passons des années à placer des agents IA sur de vraies files de support, et la leçon se répète à chaque déploiement. La précision vient de ce que l'agent apprend (anciens tickets, articles du centre d'aide, macros) et de son test sur de vraies conversations avant qu'il ne parle à un client. C'est pourquoi chaque déploiement d'eesel est d'abord simulé sur des tickets historiques. Un meilleur micro ne change pas cet ordre de travail.
Donc, si vous planifiez l'automatisation du centre d'appels, je séquencerais ainsi : automatisez d'abord les canaux écrits avec un agent IA pour le support client, là où les réponses sont construites et testées, puis donnez une voix à ce même savoir. Voxtral 3 est un solide candidat pour la couche vocale une fois que SIP s'ouvrira.
Essayez eesel pour les réponses derrière la voix
Voxtral est une infrastructure ; eesel est l'employé. Notre coéquipier IA de helpdesk rejoint le helpdesk que vous utilisez déjà, comme Zendesk ou Freshdesk, apprend de vos anciens tickets et répond dans la langue dans laquelle le client a écrit.
Cet aspect multilingue est ce que la liste de langues de Voxtral ne peut pas faire seule. Koffer.ch, une boutique suisse de valises, fait rédiger par eesel des réponses Freshdesk en allemand, français, anglais ou italien, selon le client, avec l'orthographe suisse. smava l'utilise sur 27 000 tickets Zendesk en allemand par mois.
Si votre support passe aujourd'hui par e-mail et chat, commencez par là. Essayez eesel gratuitement sur vos propres anciens tickets et voyez ce qu'il aurait répondu.