

TorchTPU est le backend PyTorch open source de Google pour les Cloud TPU, conçu avec l'équipe PyTorch de Meta et publié en open source le 20 octobre 2026. Il enregistre la TPU comme un device PyTorch ordinaire appelé tpu, si bien que pour la plupart des codes, le portage commence par device="cuda" qui devient device="tpu". Il remplace PyTorch/XLA, que Google qualifie désormais d'obsolète.
La bibliothèque est gratuite sous Apache 2.0, et vous payez le temps TPU : $12.00 par heure de puce Ironwood à la demande, $6.00 avec flex-start, et $2.70 pour Trillium. Google indique que 98 % de près de 5,000 modèles Hugging Face tournent sans modification. Le hic : c'est la version 0.2.0, torch.compile impose encore des formes statiques, et Google dit clairement que « ça tourne » et « ça tourne vite » représentent deux quantités de travail différentes.
Si vous entraînez ou servez vos propres modèles PyTorch, c'est la première fois que les TPU méritent un pilote sans avoir à apprendre JAX. Si vous voulez juste une IA qui fait un travail, comme répondre aux tickets, passez la question de la puce : un coéquipier IA eesel gère la couche modèle, et SamCart en fait tourner quatre sur Freshdesk et le chat du site.
Qu'est-ce que TorchTPU ?
TorchTPU est un backend PyTorch natif pour les Google Cloud TPU, les puces d'IA sur mesure que Google utilise pour entraîner et servir Gemini. Google a lancé le projet mi-2025 avec l'équipe PyTorch de Meta, l'a décrit sur le Google Developers Blog en avril 2026, et l'a publié en open source à la PyTorch Conference 2026 le 20 octobre. Le code se trouve sur google-pytorch/torch_tpu sous Apache 2.0, et la version actuelle est la 0.2.0 sur PyPI.
Je construis des fonctionnalités et des agents IA chez eesel, et je passe l'essentiel de ma semaine sur la partie de la pile située au-dessus de la puce. Alors quand un lancement dit « changez une ligne », je vais lire comment cette ligne est réellement exécutée. En bref : bonne nouvelle avec un astérisque. La ligne fait bien tourner votre modèle, et la documentation est étonnamment honnête sur le travail qui vient après.
L'annonce de Google Cloud présente l'objectif simplement : les TPU rejoignent les GPU et les CPU comme option native pour PyTorch. Meta est le partenaire principal, et son directeur de l'ingénierie PyTorch explique pourquoi dans l'article de lancement :
"We cannot be constrained by a single hardware architecture."
Jana van Greunen, Director of PyTorch Engineering at Meta, sur le blog Google Cloud
Quand j'ai capturé le dépôt le 28 octobre, il comptait 782 étoiles, 105 contributeurs et 4,677 commits, avec des commits qui arrivent toutes les heures. Selon le blog PyTorch, il est déjà "used in production for both inference and training workloads for some of the largest Google Cloud customers."
Ce qui est vraiment nouveau : adieu PyTorch/XLA
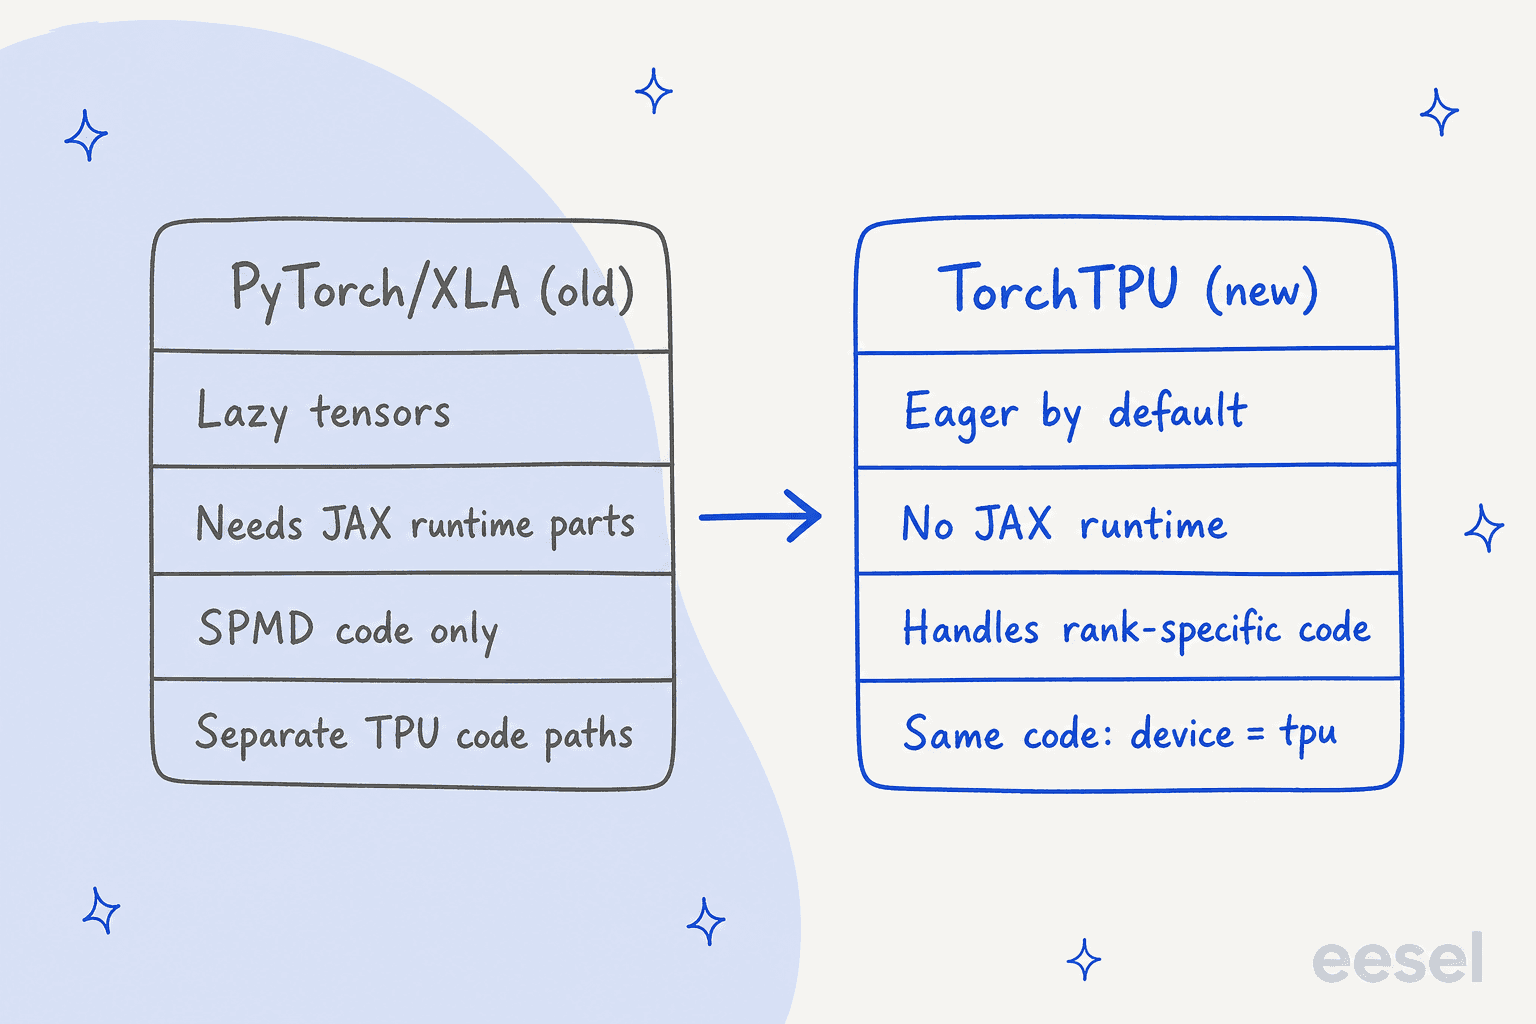
PyTorch tourne sur TPU depuis 2020 via PyTorch/XLA, on peut donc se demander ce qui a changé. La réponse de Google dans le blog PyTorch est franche : PyTorch/XLA utilisait des lazy tensors, exigeait des changements de code intrusifs pour marquer les régions compilables, avait une latence de compilation sévère et n'avait pas de vrai mode eager. La FAQ de TorchTPU dit désormais que PyTorch/XLA est obsolète et remplacé par TorchTPU.
Ceux qui ont vécu avec l'ancienne pile s'en souviennent de la même façon. Extrait du fil Hacker News sur l'aperçu d'avril :
"I did trained some research models using the existing PyTorch/XLA on TPUs, and it was a mess of undocumented behavior and bugs (silently hanging after 8 hours of training!)."

TorchTPU se branche sur PrivateUse1, l'emplacement officiel de PyTorch pour le matériel hors arbre, si bien qu'un tenseur TPU est un tenseur PyTorch ordinaire. Il n'a aucune dépendance au runtime JAX, suit le modèle PyTorch d'un processus par device, et gère le code où le rank 0 fait un peu de travail en plus, ce que l'ancienne pile uniquement SPMD ne savait pas faire.
L'autre changement notable est l'écosystème autour. Google a livré TorchTPU avec des backends pour vLLM (avec Inferact), SGLang (avec RadixArk), TorchTitan, Ray (avec Anyscale), TorchRec, et une prise en charge native dans Transformers v5 et Diffusers de Hugging Face. Hugging Face dit que son wrapper Optimum TPU n'est plus nécessaire.
Le calendrier mérite aussi qu'on s'y arrête. AWS a lancé TorchNeuron, son backend PyTorch natif pour Trainium, le même jour à la même conférence. Les deux clouds sont arrivés à la même conclusion : PyTorch est l'endroit où vit le code, donc la puce doit ressembler à un device PyTorch.
Comment fonctionne TorchTPU
Sous le capot, TorchTPU a deux chemins, qui aboutissent tous deux au compilateur XLA de Google. Le chemin eager est un backend C++ enregistré auprès du dispatcher PyTorch. Le chemin compilé est un backend TorchDynamo qui transforme un graphe FX entier en un seul programme StableHLO, au lieu de passer par TorchInductor comme sur GPU.
Le mode eager propose trois réglages, selon la documentation d'introduction de TorchTPU :
- Strict (par défaut) envoie une opération ATen à la fois à la TPU, de façon asynchrone, comme PyTorch sur un GPU.
- Debug (
TORCH_TPU_LAUNCH_BLOCKING=1) exécute chaque opération de façon synchrone avec des contrôles de bornes, la version TPU deCUDA_LAUNCH_BLOCKING. - DeferAndFuse (
TORCH_TPU_DEFER_AND_FUSE=1) retient les opérations jusqu'à ce que quelque chose comme.cpu()ou.item()ait besoin d'une valeur, puis les fusionne et les compile ensemble. Google dit qu'il peut être 50 % ou plus plus rapide que Strict et utilise moins de mémoire HBM.
Les trois partagent un cache de compilation à trois niveaux : par processus, partagé entre processus sur un même hôte, et un niveau persistant optionnel sur Cloud Storage pour qu'une flotte ne recompile pas les mêmes graphes après chaque redémarrage.
torch.compile(model, backend="tpu") est le chemin de production. La contrepartie est la rigueur : TorchTPU règle actuellement dynamic=False pour vous, car XLA veut des formes statiques. Google construit le « bounded dynamism », où vous donnez une taille maximale et le graphe se compile une seule fois. Lors de tests précoces, il a donné des résultats corrects sur 834 des 839 LLM causaux, mais le tableau des fonctionnalités le classe encore comme expérimental.
Il y a aussi une différence de précision à connaître avant de comparer des courbes de perte. Les unités matricielles des TPU multiplient en bfloat16 et accumulent en FP32, donc TorchTPU utilise par défaut la précision « medium », alors que PyTorch sur CUDA utilise par défaut le FP32 complet. Vous pouvez demander « high » ou « highest », mais elles coûtent environ 3x et 6x le calcul matriciel.
Pour les kernels personnalisés, TorchTPU prend en charge Pallas (le langage de kernels de Google, issu de JAX) et la bibliothèque de kernels Tokamax comme prêts pour la production, ainsi que Helion, le DSL de kernels portable de PyTorch, comme expérimental. Les kernels CUDA personnalisés ne se transposent pas.
Pour voir ce que pèse chaque couche, le blog PyTorch fait passer un modèle d'images FLUX par la pile étape par étape :
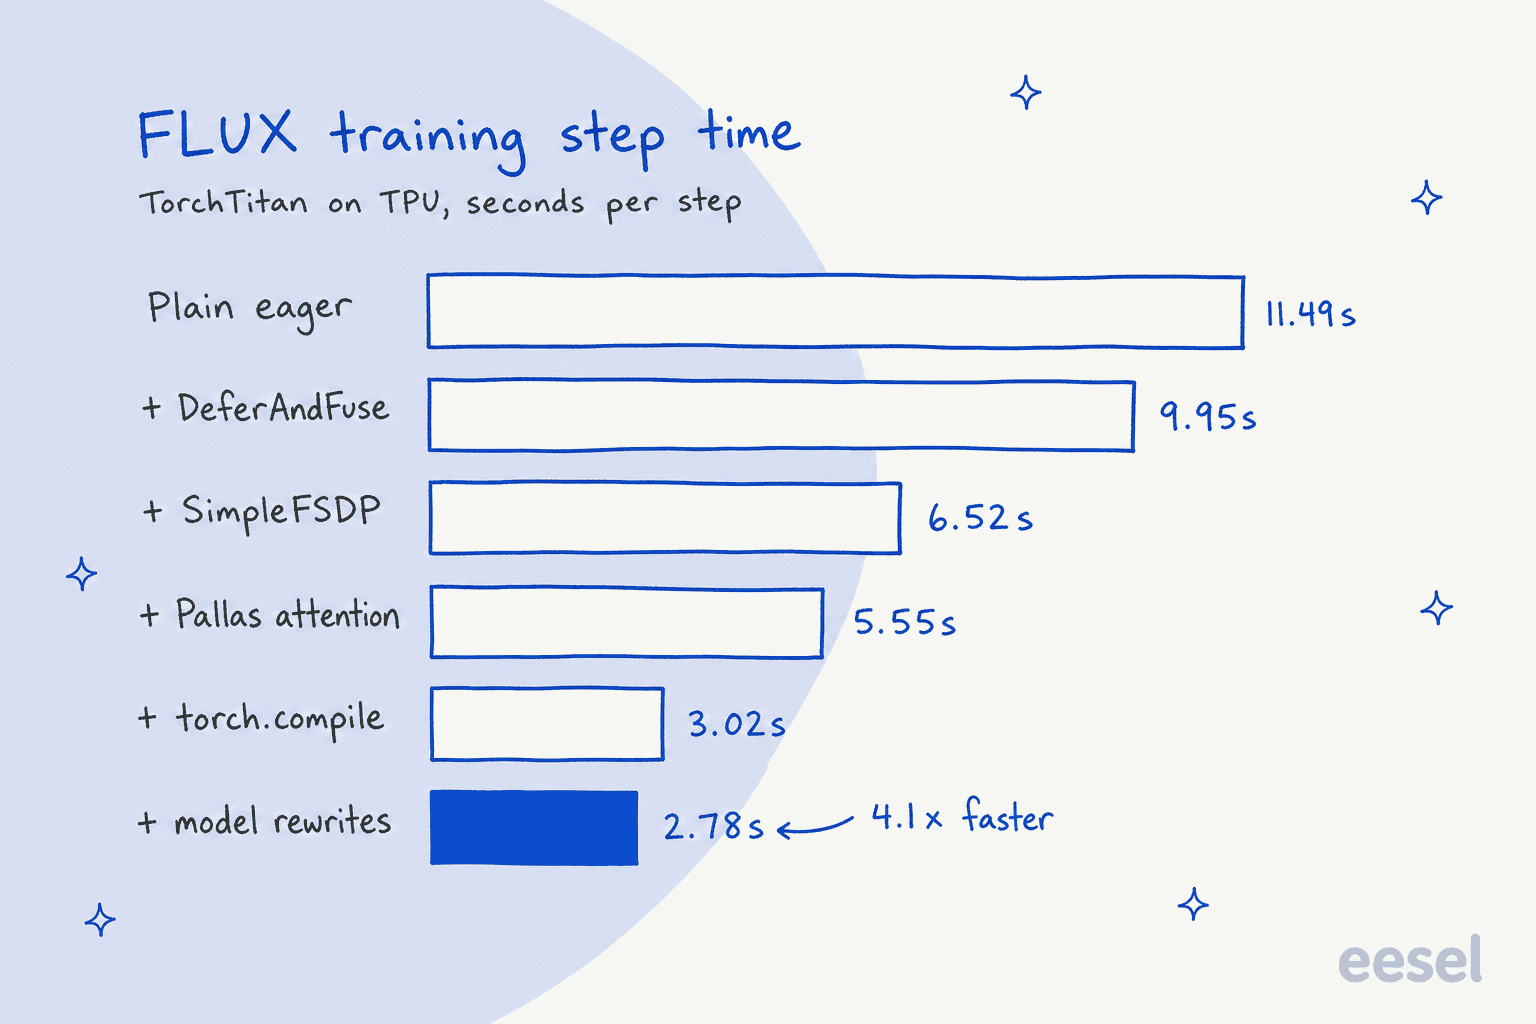
Pour moi, ce graphique est la version honnête de la promesse « une ligne ». La ligne unique vous donne l'étape à 11.49 secondes. L'étape à 2.78 secondes demande cinq tours de travail de plus, et torch.compile à lui seul est le plus gros bond.
À quoi ressemble le changement de code
Le guide de démarrage s'exécute sur une VM TPU (une v6e est la plus simple), avec Python 3.11 ou plus récent :
pip install torch_tpu==0.2.0 --extra-index-url https://download.pytorch.org/whl/cpu
Gardez l'index supplémentaire : sans lui, pip récupère la version CUDA de PyTorch, beaucoup plus volumineuse et inutile sur une TPU. Ensuite, le changement de device :
import torch
device = torch.device("tpu")          # was "cuda"
model = MyModel().to(device)
compiled = torch.compile(model, backend="tpu")   # optional, for speed
Pour les jobs distribués, il y a une deuxième modification. dist.init_process_group(backend="nccl") devient backend="tpu_dist", et TorchTPU a besoin de deux réglages propres aux TPU (la topologie du slice et les adresses des puces) que torchrun ne connaît pas. Une commande les affiche pour vous :
eval $(python -m torch.tpu.distributed | sed 's/^/export /')
torchrun --nproc_per_node=8 train.py
Pour les modèles Hugging Face, c'est encore plus court. Selon l'article de lancement de Hugging Face, AutoModelForCausalLM.from_pretrained(model_id, device_map="tpu") charge les poids directement sur la TPU, et un pipeline Diffusers n'a besoin que de pipe.to("tpu").
Cela veut dire que la plupart des modèles ouverts que j'ai couverts, comme Qwen, Gemma 4 ou DeepSeek V4 Flash, sont à un device_map d'une TPU.
Google a aussi publié en aperçu une suite d'agents TPU : des skills qui s'installent dans des agents de code (Claude Code et Antigravity aujourd'hui, Codex et Cursor "coming soon") pour gérer l'intégration, le profilage et le réglage de l'inférence. C'est un signe de la direction que prend ce type de portage. Un échange mécanique comme celui-ci est exactement ce que Claude Code ou OpenAI Codex gèrent bien, à condition de lire vous-même les journaux de compilation.
Combien coûte TorchTPU ?
La bibliothèque est gratuite. TorchTPU est sous Apache 2.0 et s'installe depuis PyPI. Ce que vous payez, c'est le temps TPU, que Google facture par heure de puce sur sa page de tarifs Cloud TPU. La facturation court tant qu'un nœud TPU est à l'état READY, donc un nœud inactif oublié continue de coûter.
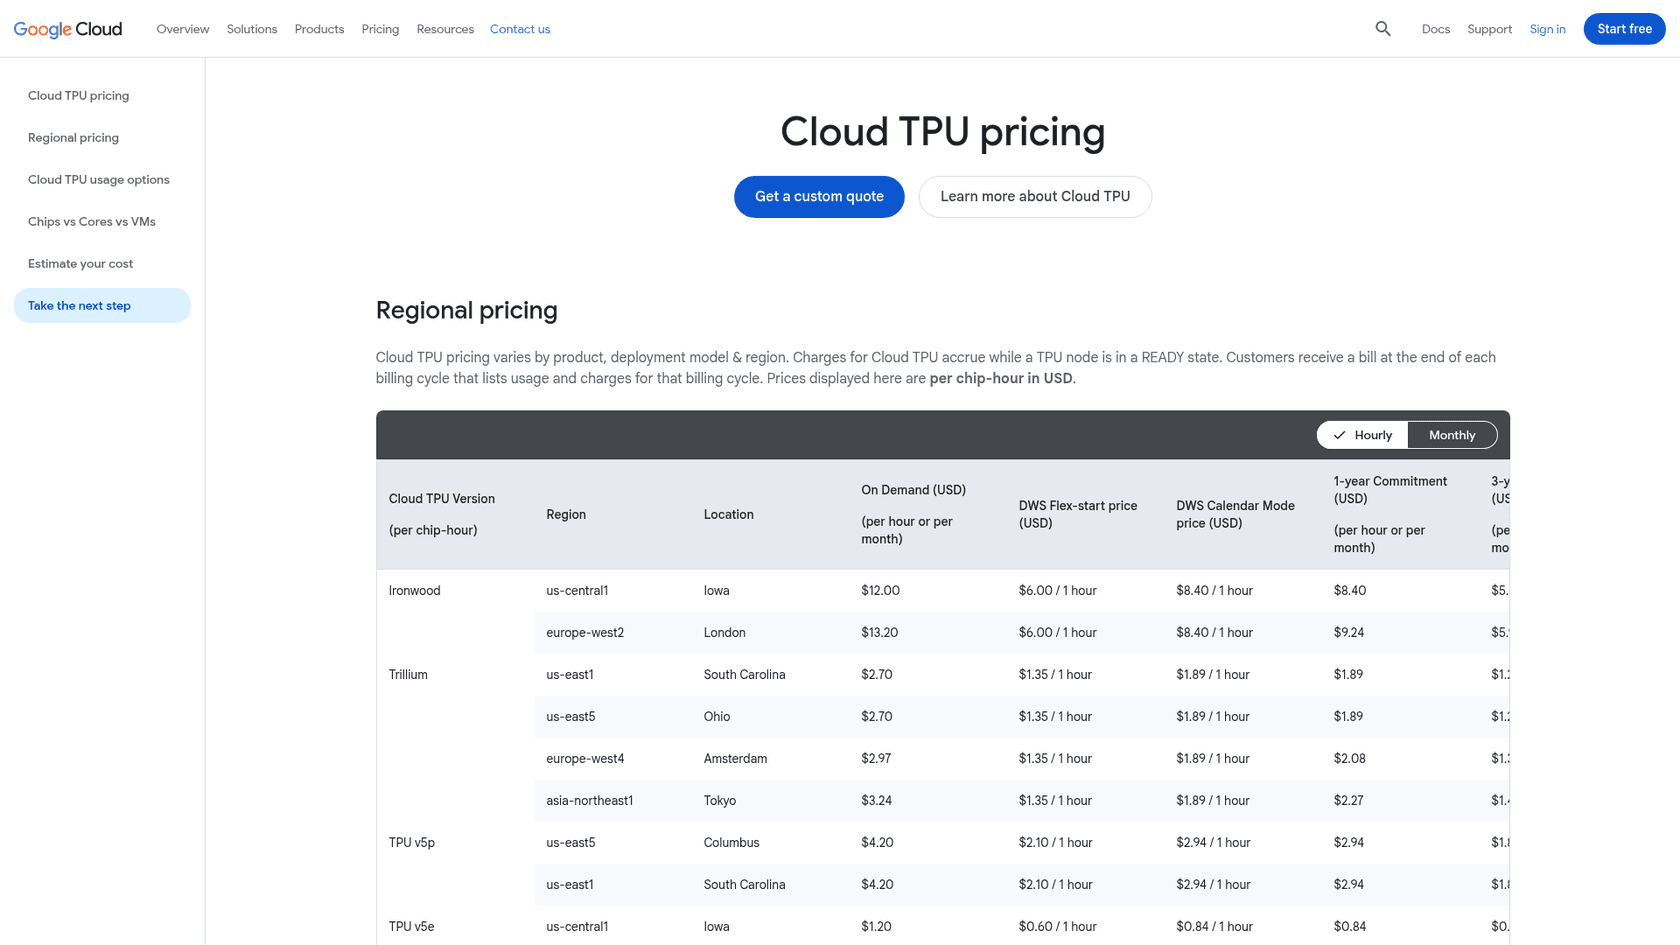
Voici les tarifs américains pour les quatre générations prises en charge par TorchTPU, vérifiés le 28 octobre 2026 :
| TPU | Région | À la demande | DWS Flex-start | Engagement 1 an | Engagement 3 ans |
|---|---|---|---|---|---|
| Ironwood (v7) | us-central1 | $12.00 | $6.00 | $8.40 | $5.40 |
| Trillium (v6e) | us-east1 | $2.70 | $1.35 | $1.89 | $1.22 |
| TPU v5p | us-east5 | $4.20 | $2.10 | $2.94 | $1.89 |
| TPU v5e | us-central1 | $1.20 | $0.60 | $0.84 | $0.54 |
Flex-start (qui fait partie du Dynamic Workload Scheduler de Google) coûte la moitié du tarif à la demande pour chaque génération, en échange d'une attente jusqu'à ce que de la capacité se libère. La console Google Cloud facture en heures de VM, pas en heures de puce, donc une VM à plusieurs puces affiche un chiffre plus élevé que le tableau. Les régions d'Europe et d'Asie coûtent plus cher : Ironwood est à $13.20 à la demande à Londres.
Une heure de puce n'est pourtant pas une unité de travail, et c'est la partie que les gens sautent. Une puce Ironwood expose deux devices PyTorch, et un GPU, une puce Trainium2 et une TPU accomplissent chacun une quantité de travail différente par heure. Le seul chiffre tiers que Google cite vient du benchmark InferenceX de SemiAnalysis, où la TPU v7 avec vLLM-TorchTPU a servi Qwen 3.5 à 2.01 cents par million de tokens sur le test 8K/1K. Voyez-y une raison de benchmarker votre propre modèle, pas votre prix.
Pour comparer les prix par puce entre les backends PyTorch natifs qui existent désormais, choisissez un accélérateur :
Choisissez une puce pour comparer les prix catalogue et les backends. Les prix viennent des pages de tarifs Google Cloud TPU et AWS Capacity Blocks ; une heure de puce produit une quantité de travail différente sur chacune.
Pour le côté GPU de la comparaison, mes analyses des tarifs CoreWeave et des tarifs Lambda couvrent les neoclouds, et le guide des tarifs AWS couvre la maison de Trainium.
Benchmarks et couverture des modèles
Google a publié plus de chiffres avec ce lancement qu'AWS avec TorchNeuron, et la plupart sont vraiment utiles. Commençons par la couverture, car pour une version 0.2.0, « mon modèle tourne-t-il seulement ? » compte plus que la vitesse. Selon le blog PyTorch, Google teste en continu environ 5,000 modèles Hugging Face populaires en modes eager et compilé :
| Test | Résultat |
|---|---|
| Modèles testés de bout en bout | 4,917 sur plus de 500 familles d'architectures |
| Tournent sans planter | 98 % (4,821 sur 4,917) |
| Les chiffres correspondent au GPU | 97 % (638 sur 657 modèles représentatifs) |
| Bounded dynamism, numérique correcte | 99 % (834 sur 839 LLM causaux) |
La ligne sur la parité numérique est celle que je regarderais en premier. Chez eesel, j'ai appris à mes dépens que « ça tourne » et « ça donne la bonne réponse » sont des tests différents : un agent de support peut briller en démo et pourtant donner des réponses fausses avec assurance sur de vrais tickets, c'est pourquoi chaque déploiement est d'abord simulé sur l'historique de tickets d'un client. Que Google compare la sortie à une référence GPU, et pas seulement les plantages, est la version compilateur de la même habitude.
Côté vitesse, trois résultats ressortent :
- PyTorch pur, sans kernels personnalisés. Un Muse Glimmer 30B écrit en PyTorch pur avec des modules standard a atteint 59 % de MFU en prefill sur une puce TPU v7 et 38 % de MFU à l'entraînement sur quatre. Une version écrite pour GPU par l'équipe TorchTitan, portée a minima, a atteint 36 %.
- Proche de JAX. Qwen3 MoE 235B dans TorchTitan a tourné à 1,828 tokens par seconde sur 64 puces TPU v7, contre 1,937 pour le même modèle en JAX sur MaxText. Cela représente environ 94 % du framework maison de Google.
- Passage à l'échelle. Le même modèle est passé de 1,024 à 8,192 puces Ironwood avec une MFU qui n'a bougé que de 28.8 % à 27.1 %. Le blog Google Cloud cite aussi jusqu'à 52 % de MFU sur Qwen 3 8B.
Les modèles de recommandation ont eu leur propre résultat : un DLRM v2 sur 32 puces TPU v7x a égalé la version JAX optimisée de Google avec un temps d'étape de 18.3 ms, en utilisant les SparseCores des TPU pour les recherches d'embeddings. Ce sont tous des chiffres de Google sur le matériel de Google, donc je les traiterais comme une borne supérieure jusqu'à ce que des résultats indépendants apparaissent.
Ce que TorchTPU ne fait pas encore
Google est direct sur les lacunes. Le tableau des fonctionnalités range tout en « Validated » et « Experimental », et le blog PyTorch liste les aspérités en détail.
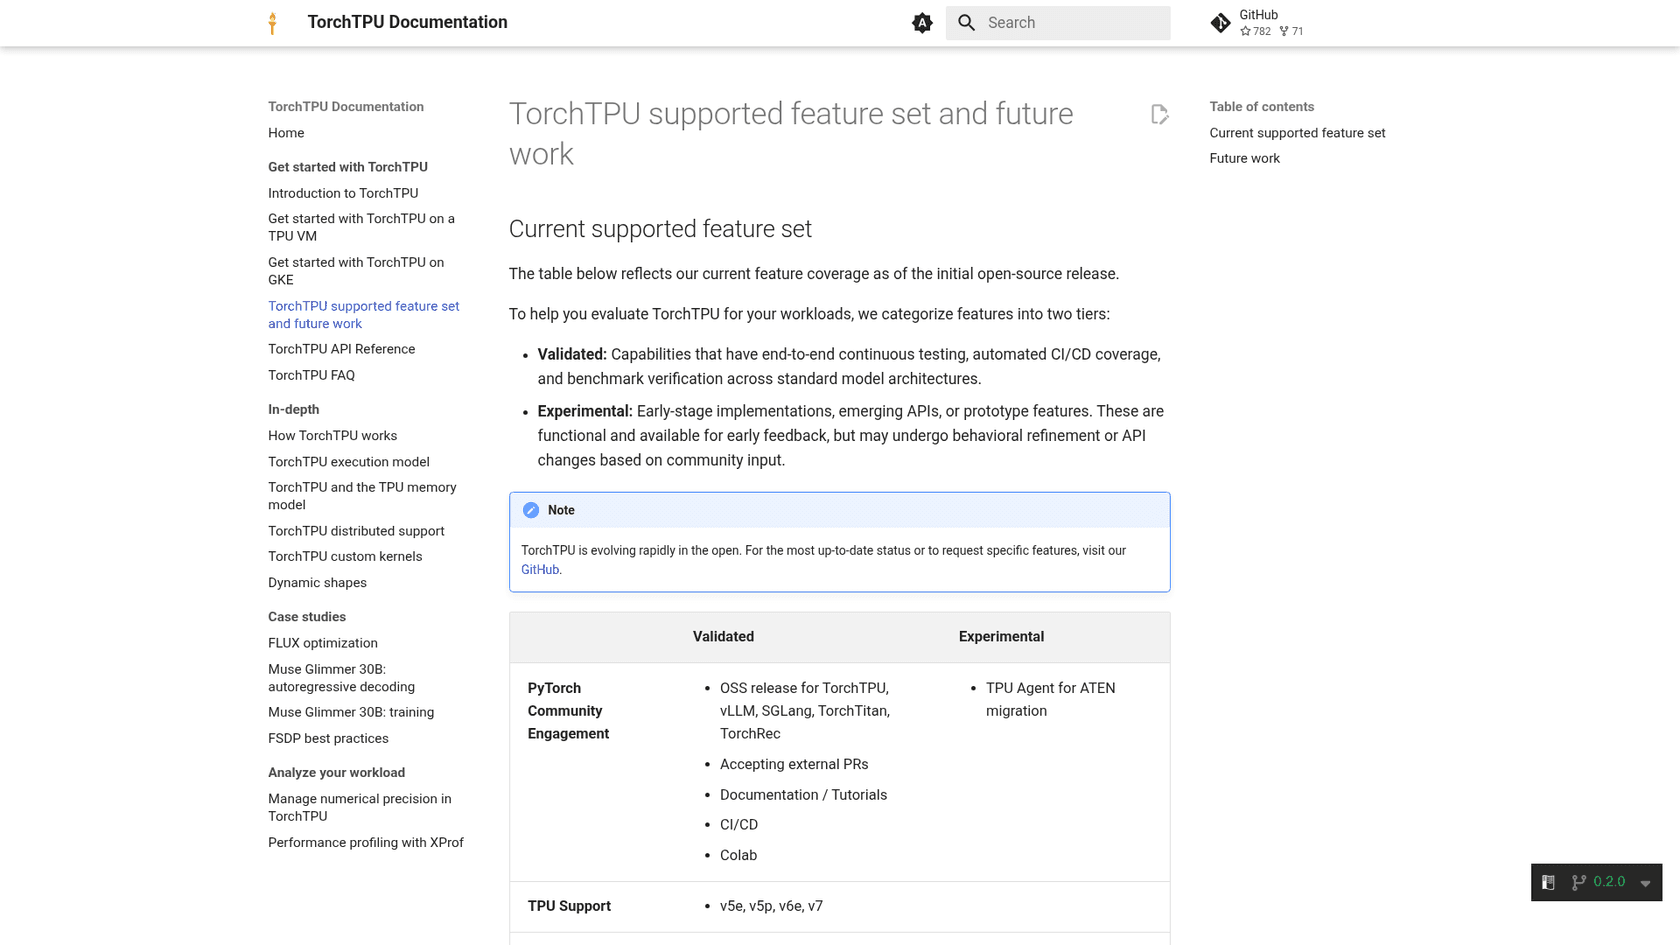
- Formes dynamiques sous compile.
torch.compiletourne aujourd'hui avecdynamic=False. Des tailles de lot ou des longueurs de séquence variables impliquent du padding, du bucketing ou des recompilations jusqu'à l'arrivée du bounded dynamism. - FlexAttention. Pas encore pris en charge ; Google l'a remplacé par
F.scaled_dot_product_attentionlors du portage d'un modèle GPU. - Cas limites en distribué. FSDPv2 et le code qui diffère selon le rank (MPMD) fonctionnent, mais sont marqués « low perf ». Les « skinny collectives » par défaut peuvent coûter 30-40 % de bout en bout ; on les récupère avec un décorateur
@spmd_safeou SimpleFSDP. - Un processus par device TPU. Une TPU ne peut être ouverte que par un seul processus, donc les configurations RL qui placent un entraîneur et un échantillonneur sur les mêmes puces ne fonctionnent pas d'emblée.
- Modèles taillés pour GPU. Les unités matricielles des TPU aiment les dimensions de 128 ou 256. Les modèles qui fixent les têtes d'attention à 64, ce qui est courant, tournent mais laissent de la vitesse sur la table.
- Familles de modèles encore en réglage. GLM, Kimi, DeepSeek, GPT OSS, Mamba et LSTM/GRU sont listés comme expérimentaux. Le pré-entraînement à pleine échelle relève de « future exploration » ; l'inférence et le fine-tuning sont les tâches prêtes pour la production.
La limite la plus grande n'est pas dans le code. Les TPU sont des puces Google Cloud (plus des accords sur site pour de très gros clients), et le fil de lancement sur Hacker News, avec 379 points et 93 commentaires, y revenait sans cesse :
"TPUs are unobtanium so while I appreciate Google's effort here I also recognize that it is not something that will be useful to me."
Un autre commentateur, d'une équipe qui avait évalué des TPU sur site, a résumé le point de vue de l'acheteur en une ligne :
"We've evaluated them but decided to stick with Nvidia, at least for one more generation."
Et à propos de l'aperçu d'avril, une réponse a formulé la promesse plus précisément que le marketing : « just change one line and it works » n'a jamais été la même promesse que « just change one line and you will get peak performance on the TPU » (xrikcus, Hacker News). Cela correspond à la documentation de Google elle-même, ce qui est bon signe.
Comment TorchTPU se compare aux autres façons d'exécuter des modèles
Pour une équipe qui entraîne ou sert ses propres modèles PyTorch, les options ressemblent maintenant à ceci :
| Option | Ce que vous gérez | Changements de code | Idéal pour |
|---|---|---|---|
| TorchTPU sur Cloud TPU | VM TPU ou GKE, cache de compilation, formes | "tpu", tpu_dist, formes statiques pour compile | Équipes Google Cloud avec de gros jobs réguliers |
| TorchNeuron sur AWS Trainium | Instances, cache de compilation, formes | "neuron", formes statiques pour compile | Équipes engagées chez AWS |
| GPU NVIDIA (CoreWeave, hyperscalers) | Instances ou clusters | Aucun pour le code CUDA | Kernels CUDA personnalisés, démarrage le plus rapide |
| GPU serverless (Modal, Baseten) | Votre code de modèle | Petits wrappers | Inférence par pics sans planification de capacité |
| API de modèles hébergés (Groq, Fireworks AI) | Rien | Appels d'API uniquement | Modèles ouverts sans toucher au matériel |
Les deux premières lignes disaient autrefois « réécrivez en JAX » et « réécrivez votre pile d'entraînement ». Elles ressemblent maintenant beaucoup aux lignes GPU, ce qui est tout l'intérêt des deux lancements. Pour choisir entre elles, cela dépend surtout du cloud que vous payez déjà, et aussi de la puce disponible quand vous en avez besoin.
Si votre objectif final est un agent sur Google Cloud plutôt que votre propre pile de service, l'Agent Development Kit de Google et l'API Gemini se situent une couche au-dessus de tout cela, et Gemini lui-même est entraîné et servi sur des TPU.
À qui s'adresse TorchTPU
TorchTPU s'adresse aux équipes qui écrivent déjà du PyTorch, peuvent obtenir de la capacité TPU sur Google Cloud et dépensent assez en accélérateurs pour qu'un pilote se rentabilise. Les équipes de recherche profitent le plus du mode eager et du réglage Debug, puisque les TPU se comportent enfin comme n'importe quel autre device dans un débogueur. Les équipes d'inférence profitent le plus de vLLM-TorchTPU et SGLang-TorchTPU, qui gardent les mêmes serveurs et API tout en changeant le matériel dessous.
Ce n'est pas pour vous si votre code dépend de kernels CUDA personnalisés, si vous avez besoin de formes dynamiques en mode compilé dès aujourd'hui, ou si vous ne pouvez pas obtenir de quota TPU. Et ce n'est pas pour vous si vous ne touchez jamais aux poids d'un modèle. La plupart des entreprises avec lesquelles je parle chez eesel font partie de ce dernier groupe : elles veulent que l'IA fasse un travail, et la puce sur laquelle elle tourne est la décision de quelqu'un d'autre.
Où eesel s'insère : ceci est de l'infrastructure, eesel est l'employé
TorchTPU rend la couche matérielle moins chère à essayer et plus facile à changer. C'est bon pour tous ceux qui construisent des modèles et, avec le temps, cela réduit le coût d'exploitation des produits d'IA. Mais il ne répond pas à un ticket et n'écrit pas un article de blog à votre place. Ce sont des travaux, et les travaux demandent du contexte : votre centre d'aide, vos tickets passés, vos règles de remboursement.
C'est la couche sur laquelle travaille eesel. eesel est une plateforme de coéquipiers IA : vous recrutez des coéquipiers prêts à travailler pour des tâches précises, aujourd'hui un coéquipier IA de helpdesk et un rédacteur de blog IA. Le coéquipier de helpdesk rejoint votre file existante, apprend de votre centre d'aide et de vos tickets passés, et est testé sur vos conversations historiques avant de répondre à un vrai client.
SamCart montre ce que cela donne en pratique. L'entreprise fait tourner eesel sur Freshdesk et le chat du site, avec un agent distinct par canal qui répond à partir d'environ 280 articles du centre d'aide. L'agent Freshdesk n'envoie que la première réponse jusqu'à ce qu'une personne prenne le ticket, et un forfait de 8,000 interactions par mois couvre le tout.
OroSoft, qui fabrique des logiciels de trading pour les négociants en lingots, l'utilise de façon prudente : le personnel du support mentionne eesel dans un ticket Freshdesk et obtient un brouillon fondé sur environ 6,100 tickets résolus, avec la source citée. Quand rien n'étaye une réponse, il laisse une note demandant une personne au lieu de deviner. C'est la même discipline que les contrôles de parité numérique de Google, appliquée aux réponses clients.
Si vous êtes le genre de lecteur qui vient d'installer un backend depuis un index pip épinglé, vous voudrez probablement aussi configurer cela depuis un terminal. La CLI eesel pilote le même coéquipier et le même espace de travail que le tableau de bord. npx @eesel/cli init chat-bubble --site https://your-site.com crée un agent, ajoute une bulle de chat au site et commence à lire votre site sans compte, et eesel login conserve l'espace de travail ensuite. À partir de là, eesel integrations connect freshdesk branche le helpdesk, eesel files upload ajoute des connaissances, eesel chat parle à l'agent et eesel approvals vous permet d'approuver les actions retenues.
Cette conception explique pourquoi cela fonctionne avec des agents de code, de la même façon que la suite d'agents TPU de Google s'y branche. Un agent comme Claude Code ou Cursor peut lancer la configuration, lire les résultats et corriger ce qui a échoué. Chaque espace de travail est aussi un serveur MCP, donc le même agent peut interroger eesel directement ; voyez ma référence de la CLI Claude Code si vous mettez cela en place.

Le journal ci-dessus est ce qu'affiche eesel activity dans le terminal, du plus récent au plus ancien. Les prix sont en unités que les équipes de support comptent déjà : sur la page des tarifs, un ticket ou un chat vaut 1 crédit, les forfaits commencent à $299 par mois pour 500 crédits, et l'offre gratuite vous donne 100 crédits pour tout essayer.
Essayer eesel
TorchTPU vous permet de choisir la puce la moins chère pour vos propres modèles. eesel vous permet d'éviter cette décision pour le travail de support : un coéquipier de helpdesk qui se branche sur Freshdesk, Zendesk ou Gorgias, apprend de vos tickets passés et fait ses preuves sur des conversations historiques avant de toucher une conversation réelle. Pour les équipes SaaS avec des questions techniques, l'API de helpdesk IA et la CLI permettent de scripter toute la configuration. Essayez eesel gratuitement, ou démarrez depuis le terminal avec npx @eesel/cli.
Questions fréquentes
Qu'est-ce que TorchTPU ?
tpu à PyTorch standard, de sorte que le mode eager, torch.compile et torch.distributed fonctionnent sur TPU v5e, v5p, Trillium et Ironwood. Il a été publié en open source le 20 octobre 2026. C'est la couche de la puce ; si vous voulez une IA qui fait un travail, un coéquipier IA se trouve à l'autre bout de la pile.TorchTPU est-il gratuit ?
torch_tpu. Vous payez le temps TPU sur lequel il tourne, de $1.20 par heure de puce pour TPU v5e à $12.00 pour Ironwood à la demande dans us-central1. Mon guide des tarifs Gemini couvre la partie modèles de la facture de Google si vous ne voulez pas gérer de puces.TorchTPU remplace-t-il PyTorch/XLA ?
torch.compile. AWS a fait le même choix pour Trainium avec TorchNeuron.TorchTPU demande-t-il vraiment de ne changer qu'une seule ligne de code ?
"cuda" par "tpu" et backend="nccl" par backend="tpu_dist". Pour que ça tourne vite, non. La documentation de Google dit elle-même que les formes, le sharding et les opérations d'un modèle peuvent être réglés pour les GPU, donc la vitesse maximale demande du travail de compilation, des têtes d'attention plus larges ou des kernels Pallas. Des agents de code comme Claude Code peuvent faire une bonne partie de ce portage, et Google fournit une suite d'agents TPU pour cela.Quelles générations de TPU TorchTPU prend-il en charge ?
TorchTPU fonctionne-t-il avec Hugging Face Transformers ?
device_map="tpu", et Diffusers fonctionne avec pipe.to("tpu"). Google indique que 98 % de 4,917 modèles Hugging Face testés tournent sans planter, et Hugging Face dit qu'Optimum TPU n'est plus nécessaire. Plus de détails sur la plateforme dans mon aperçu de Hugging Face.
Comment TorchTPU se compare-t-il à TorchNeuron sur AWS Trainium ?
torch.compilepour la vitesse, formes statiques pour l'instant. TorchTPU couvre quatre générations de TPU et se réduit vers XLA ; TorchNeuron couvre Trainium2 et Trainium3 et se réduit vers le compilateur Neuron. Une heure de puce Trainium2 coûte $2.235 en EC2 Capacity Blocks, entre Trillium et v5p à la demande. Voir mon détail des tarifs AWS pour le reste de cette facture.