Les 7 meilleures alternatives à Gemini 4 Neon en 2026, classées par coût par tâche

Kira

Katelin Teen
Dernière modification 19 novembre 2026
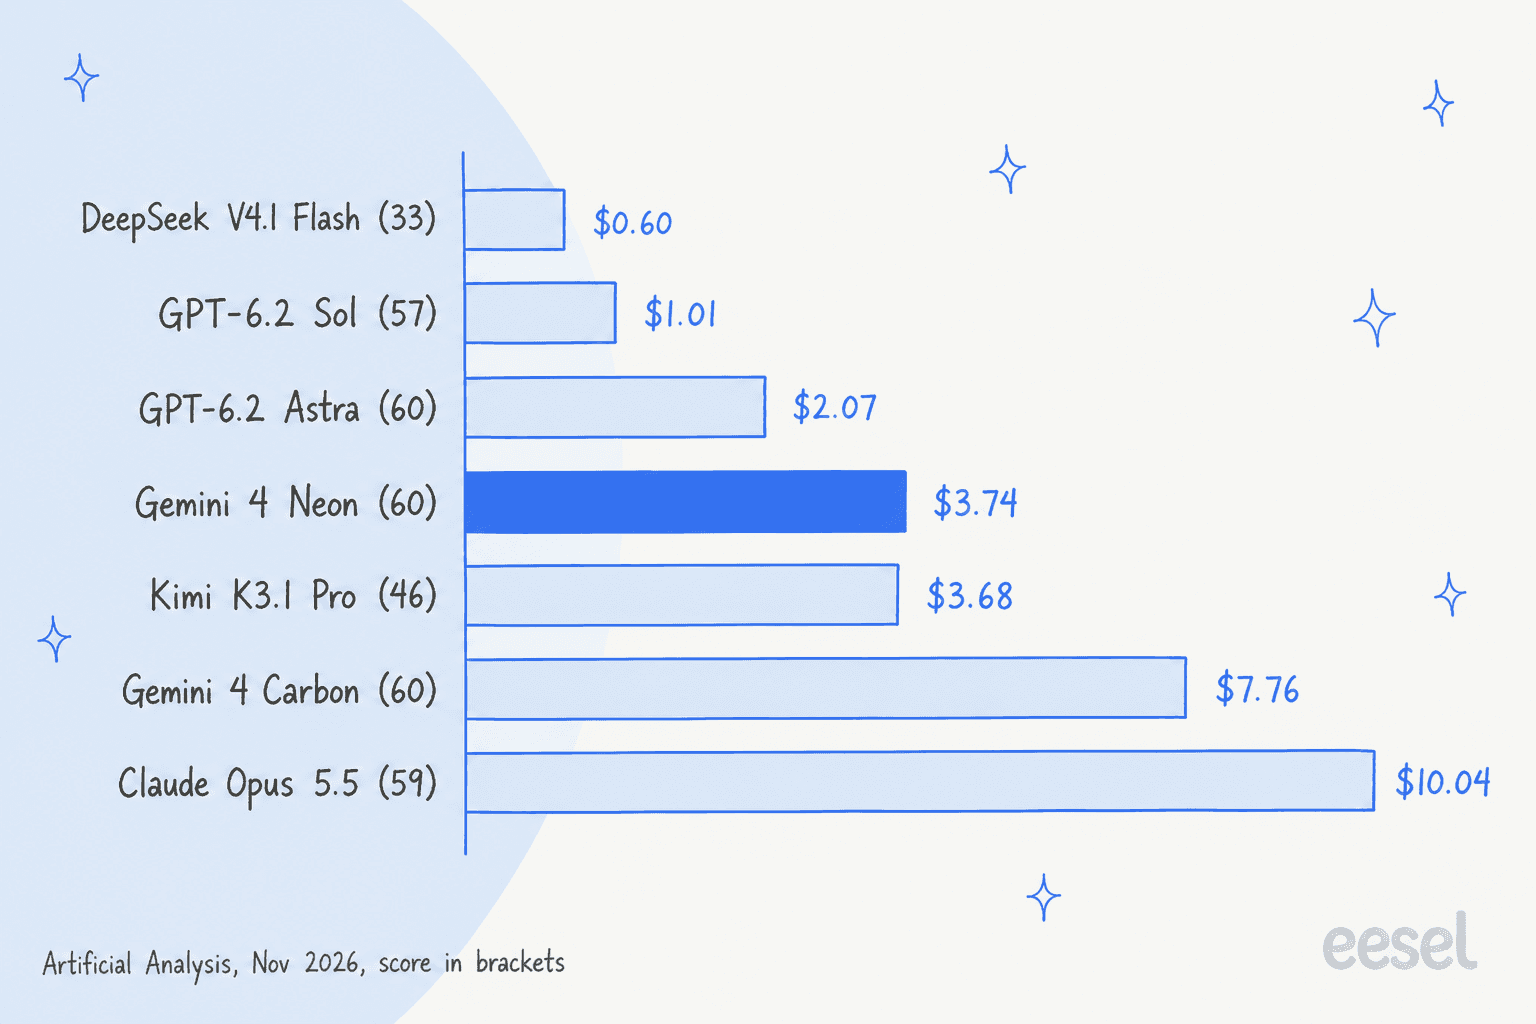
La meilleure alternative à Gemini 4 Neon est GPT-6.2 Sol : Artificial Analysis lui donne 57,3 pour $1,01 par tâche, contre 59,6 pour Neon à $3,74. Astra égale le score de Neon pour $2,07, Opus 5.5 coûte $10,04, et Carbon, Kimi K3.1 Pro et DeepSeek gagnent en honnêteté, en poids ouverts ou en prix de masse. L'avantage de Neon est qu'il se trompe sur 14 % des questions sans réponse, pas 55 %. Pour un bot de support, un coéquipier helpdesk eesel fait ce choix à votre place et le teste sur vos anciens tickets.
Pourquoi cherche-t-on des alternatives à Gemini 4 Neon ?
Gemini 4 Neon est le modèle intermédiaire de la famille Gemini 4 de Google, sorti le 18 novembre 2026. Il coûte $3 en entrée et $15 en sortie par million de tokens, a une fenêtre de contexte de 1 048 576 tokens, et n'a pas de palier gratuit. Mon test de Neon l'a trouvé solide : environ la moitié du coût de Carbon par tâche, et inhabituellement disposé à dire « je ne sais pas ».
Les raisons de regarder ailleurs tournent toutes autour de la facture et de la pile technique. Neon écrit beaucoup de tokens, il coûte donc plus cher par tâche que les modèles d'OpenAI, et un lecteur de Hacker News l'a relevé le jour du lancement :
"That looks to me like OpenAI equals or beats everything Google offers at half the price."

D'autres veulent un fournisseur qui ne soit pas Google, des poids ouverts à héberger eux-mêmes, ou un modèle plus rapide en chat en direct. Ce sont des usages différents, j'ai donc classé les alternatives par usage et placé un seul chiffre sous chacune : le coût par tâche.
Si vous voulez tester l'un de ces modèles sur des questions de support sans construire votre propre banc d'essai, le CLI eesel permet à un agent de code de charger des articles d'aide et des macros approuvés dans un coéquipier helpdesk eesel, puis de poser des questions de test et de vérifier les réponses avant que quoi que ce soit ne passe en direct. Connecter le helpdesk lui-même demande toujours l'approbation d'un administrateur.
Comment j'ai choisi ces alternatives
Je suis parti de ce que voit un acheteur. J'ai demandé à ChatGPT, dans une conversation vierge, quelles alternatives comparer à Gemini 4 Neon pour une application. Il en a cité six, dans cet ordre : GPT-6.2 Astra, Claude Opus 5.5, GPT-6.2 Sol, Gemini 4 Carbon, Kimi K3 et DeepSeek V4.1 Flash. Il a aussi conseillé à la personne de comparer le « coût par tâche réussie », les appels d'outils, la validité du JSON, la latence et les nouvelles tentatives, pas le prix par million de tokens. J'ai suivi ce cadre et ajouté Claude Sonnet 5.5, car il partage le tarif de Sol mais se comporte très différemment.
Pour chaque modèle, j'ai utilisé trois sources, toutes vérifiées le 19 novembre 2026 :
- Les pages propres du fournisseur : tarifs, page du modèle, fenêtre de contexte et prise en charge des outils, chacune liée dans sa section ci-dessous. Chaque prix de cet article vient de ces pages, pas d'un tiers.
- Artificial Analysis : ses résultats par réglage pour le score, le coût par tâche, les minutes par tâche et le taux d'hallucination. Une « tâche » est une tâche de référence de son Intelligence Index, pas l'un de vos tickets.
- Hacker News : les fils de lancement de Neon, Astra et Sol, où des développeurs ont publié leurs propres coûts et temps.
Je n'ai pas testé Neon moi-même, car je n'ai pas de clé Google pour lui. J'ai fait un test de 90 passages sur Astra et Sol en support la semaine dernière, et j'utilise ces résultats là où ils s'appliquent. Considérez le classement comme une présélection, puis utilisez la section de test pour le vérifier sur votre travail.
Que disent les coûts par tâche sur les alternatives de Neon ?
Le prix au token n'est que la moitié de l'histoire. La facture est le prix multiplié par le nombre de tokens écrits par le modèle, et les tokens de réflexion comptent comme de la sortie. Artificial Analysis publie les deux moitiés, voici donc le tableau par lequel je commencerais :
| Modèle et réglage | Score de l'index | Coût par tâche | Minutes par tâche | Tokens de sortie par tâche | Se trompe quand incertain |
|---|---|---|---|---|---|
| Gemini 4 Neon high (par défaut) | 59,6 | $3,74 | 14,8 | 90 188 | 14 % |
| Gemini 4 Neon medium | 54,9 | $1,90 | 8,3 | 50 000 | 16 % |
| GPT-6.2 Astra max | 62,1 | $4,00 | 13,7 | 41 029 | 59 % |
| GPT-6.2 Astra high | 60,1 | $2,07 | 5,9 | 17 828 | 58 % |
| GPT-6.2 Sol max | 57,3 | $1,01 | 8,5 | 40 360 | 55 % |
| GPT-6.2 Sol high | 54,9 | $0,56 | 4,6 | 20 160 | 60 % |
| Claude Opus 5.5 max | 59,1 | $10,04 | 24,5 | 173 313 | 50 % |
| Claude Opus 5.5 medium (API par défaut) | 48,2 | $2,45 | 6,9 | 43 817 | 67 % |
| Claude Sonnet 5.5 max | 54,5 | $10,02 | 32,6 | 285 387 | 43 % |
| Claude Sonnet 5.5 high (API par défaut) | 41,5 | $1,64 | 7,2 | 58 421 | 64 % |
| Gemini 4 Carbon high | 60,0 | $7,76 | 37,2 | 122 768 | 11 % |
| Kimi K3.1 Pro | 46,5 | $3,68 | 39,4 | 72 239 | 37 % |
| DeepSeek V4.1 Flash 1017 max | 32,6 | $0,60 | 13,7 | 138 962 | 64 % |
Tout dans le tableau a été relevé le 19 novembre 2026 sur Artificial Analysis. « Se trompe quand incertain » est son taux d'hallucination AA-Omniscience, où plus bas est meilleur. Les pages des modèles :
- Gemini 4 Neon et Gemini 4 Carbon
- GPT-6.2 Astra
- Claude Opus 5.5
- Claude Sonnet 5.5
- Kimi K3.1 Pro
- DeepSeek V4.1 Flash 1017
Quatre choses se détachent :
- Même score, facture différente. Astra en high atteint 60,1 pour
$2,07, soit45 %de moins que les$3,74de Neon pour 59,6. Opus 5.5 au maximum coûte$10,04pour 59,1, environ 2,7 fois Neon. - Sol en high égale Neon en medium. Les deux obtiennent 54,9, mais Sol coûte
$0,56et Neon$1,90. - DeepSeek n'est pas bon marché par tâche. Son prix d'entrée est 13 fois plus bas que celui de Sol, pourtant une tâche coûte
$0,60contre les$0,56de Sol high, avec un score de 32,6 contre 54,9. Il écrit 138 962 tokens pour y arriver. - Neon est le modèle honnête. À
14 %, seul Carbon le dépasse parmi les modèles ci-dessus qui approchent 60. Sol, Astra et Opus se trompent sur 50 % à 59 % des questions sans réponse.
La raison est la verbosité, et c'est la partie du mécanisme que les gens négligent. Les tokens de sortie sont le côté coûteux de toute grille tarifaire, et chaque modèle a sa propre habitude du nombre qu'il écrit avant de répondre :
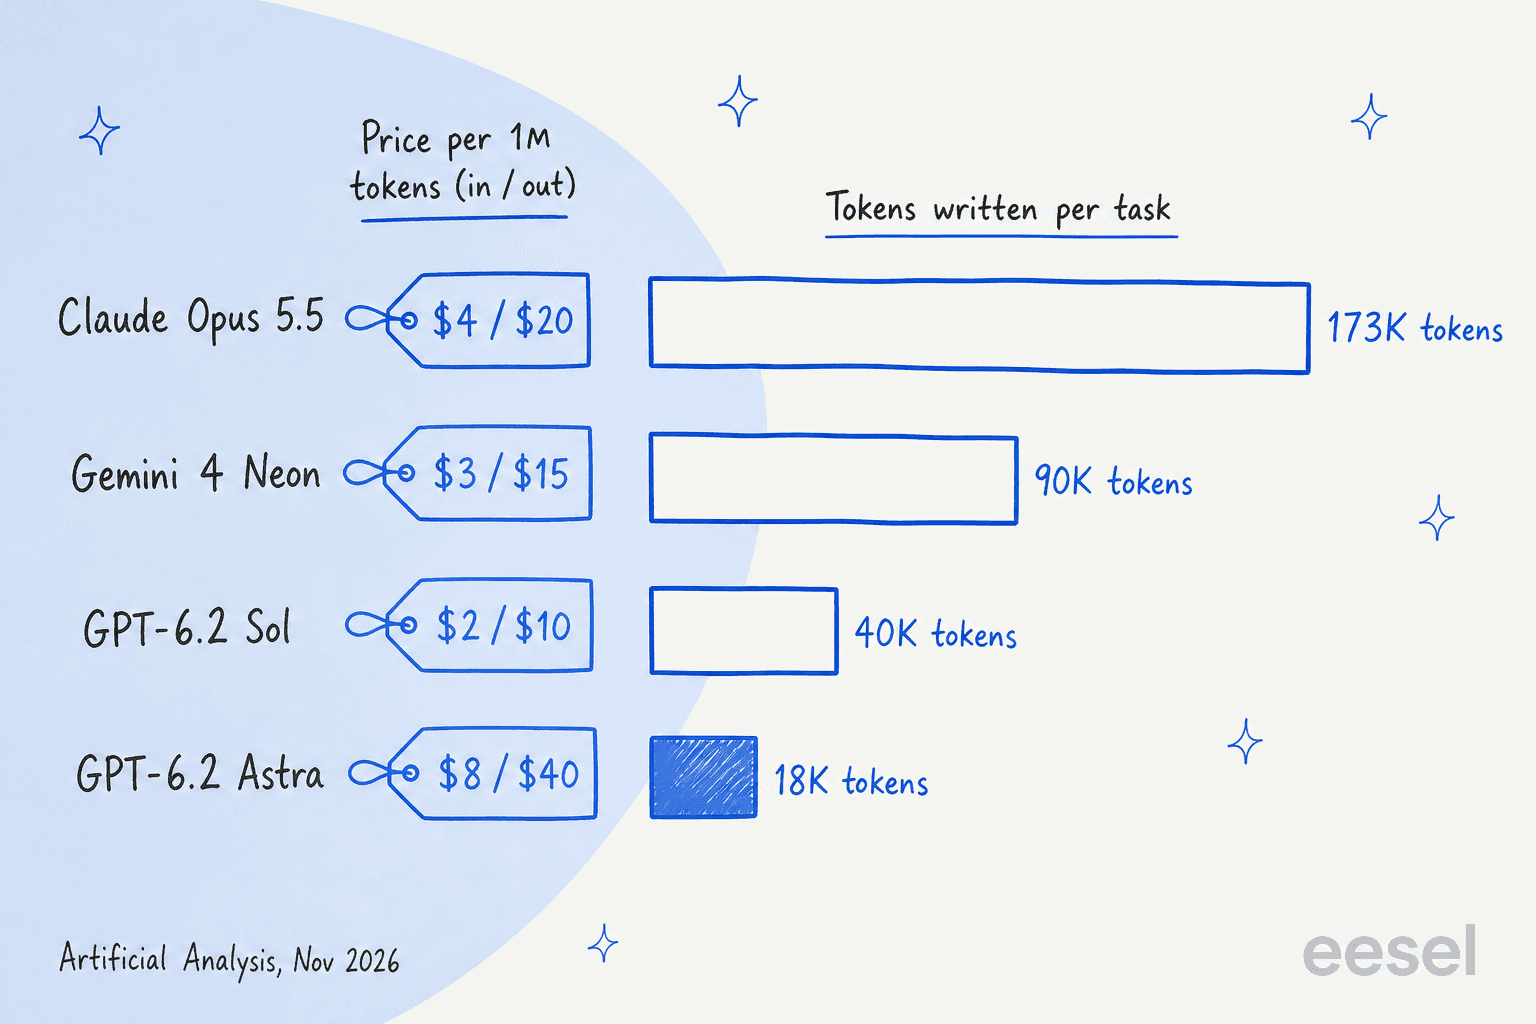
Le graphique utilise le réglage au meilleur score de chaque modèle pour Opus et Sol, et le réglage par défaut high pour Neon et Astra. Astra a l'étiquette la plus chère des quatre et l'habitude la moins chère : il écrit environ un cinquième de ce qu'écrit Neon pour le même score. C'est pour cela que je dis aux gens de ne pas comparer les grilles tarifaires.
Les alternatives à Gemini 4 Neon en un coup d'œil
Voici tout ce qu'un acheteur demande d'autre, tiré de la propre documentation de chaque fournisseur :
| Modèle | Prix par 1M (entrée/sortie) | Entrée en cache | Contexte | Meilleur score (réglage) | Palier API gratuit | Poids ouverts | Option de résidence des données |
|---|---|---|---|---|---|---|---|
| Gemini 4 Neon (référence) | $3 / $15 | $0,15, implicite seulement | 1 048 576 | 61,4 (xhigh) | Aucun | Non | Région global, us ou eu sur la plateforme entreprise de Google |
| GPT-6.2 Astra | $8 / $40 | $0,40 | 1 050 000 | 62,1 (max) | Aucun listé | Non | Points de terminaison régionaux, +10 % |
| GPT-6.2 Sol | $2 / $10 | $0,10 | 1 050 000 | 57,3 (max) | Aucun listé | Non | Points de terminaison régionaux, +10 % |
| Claude Opus 5.5 | $4 / $20 | $0,20 | 1M | 59,1 (max) | Crédits de test gratuits pour les nouveaux utilisateurs | Non | Inférence aux États-Unis uniquement, +10 % |
| Claude Sonnet 5.5 | $2 / $10 | $0,10 | 1M | 54,5 (max) | Crédits de test gratuits pour les nouveaux utilisateurs | Non | Inférence aux États-Unis uniquement, +10 % |
| Gemini 4 Carbon | $2 / $10 jusqu'au 30 nov., puis $4 / $20 | $0,10, puis $0,20, implicite seulement | 1 048 576 | 60,0 (high) | Aucun | Non | Non vérifiée pour Carbon (le guide Neon liste global, us, eu) |
| Kimi K3.1 Pro | $2 / $10 | $0,20 | 1 048 576 | 46,5 | Aucun listé | Oui, sous la licence propre de Moonshot | Non documentée sur la page de tarifs |
| DeepSeek V4.1 Flash | $0,15 / $0,60 hors pointe, $0,30 / $1,20 en pointe | $0,003 hors pointe, $0,006 en pointe | 1M | 32,6 (max) | Aucun listé | Oui, MIT | Non documentée sur la page de tarifs |
Deux remarques. « Aucun listé » signifie que la page de tarifs du fournisseur ne mentionne pas de palier API gratuit, pas que j'ai confirmé qu'il n'y en a pas. Et le prix de Carbon double le 1er décembre, ce qui compte parce qu'Artificial Analysis calcule son coût par tâche au prix de décembre, plus élevé.
Combien coûterait chaque alternative par mois ?
Le coût par tâche est un chiffre de référence, et votre tâche est plus petite. Ce calculateur met à l'échelle le coût par tâche d'Artificial Analysis selon la taille de votre tâche par rapport à une tâche de référence, le multiplie par votre volume, et ne garde que les réglages qui atteignent le score dont vous avez besoin. C'est une estimation, utilisez-la donc pour voir l'ordre de grandeur de l'écart, puis mesurez votre propre travail.
Avec les valeurs par défaut, 10 000 courtes réponses de ticket par mois et une barre de score de 55, Sol max coûte environ $505 par mois et Neon high environ $1 870. Déplacez la barre de score à 60 et Sol sort du classement, ce qui est l'échange honnête : vous payez pour les cinq derniers points.
1. GPT-6.2 Astra
Idéal pour : les équipes qui veulent le score de Neon et acceptent de payer une facture plus basse pour l'obtenir.
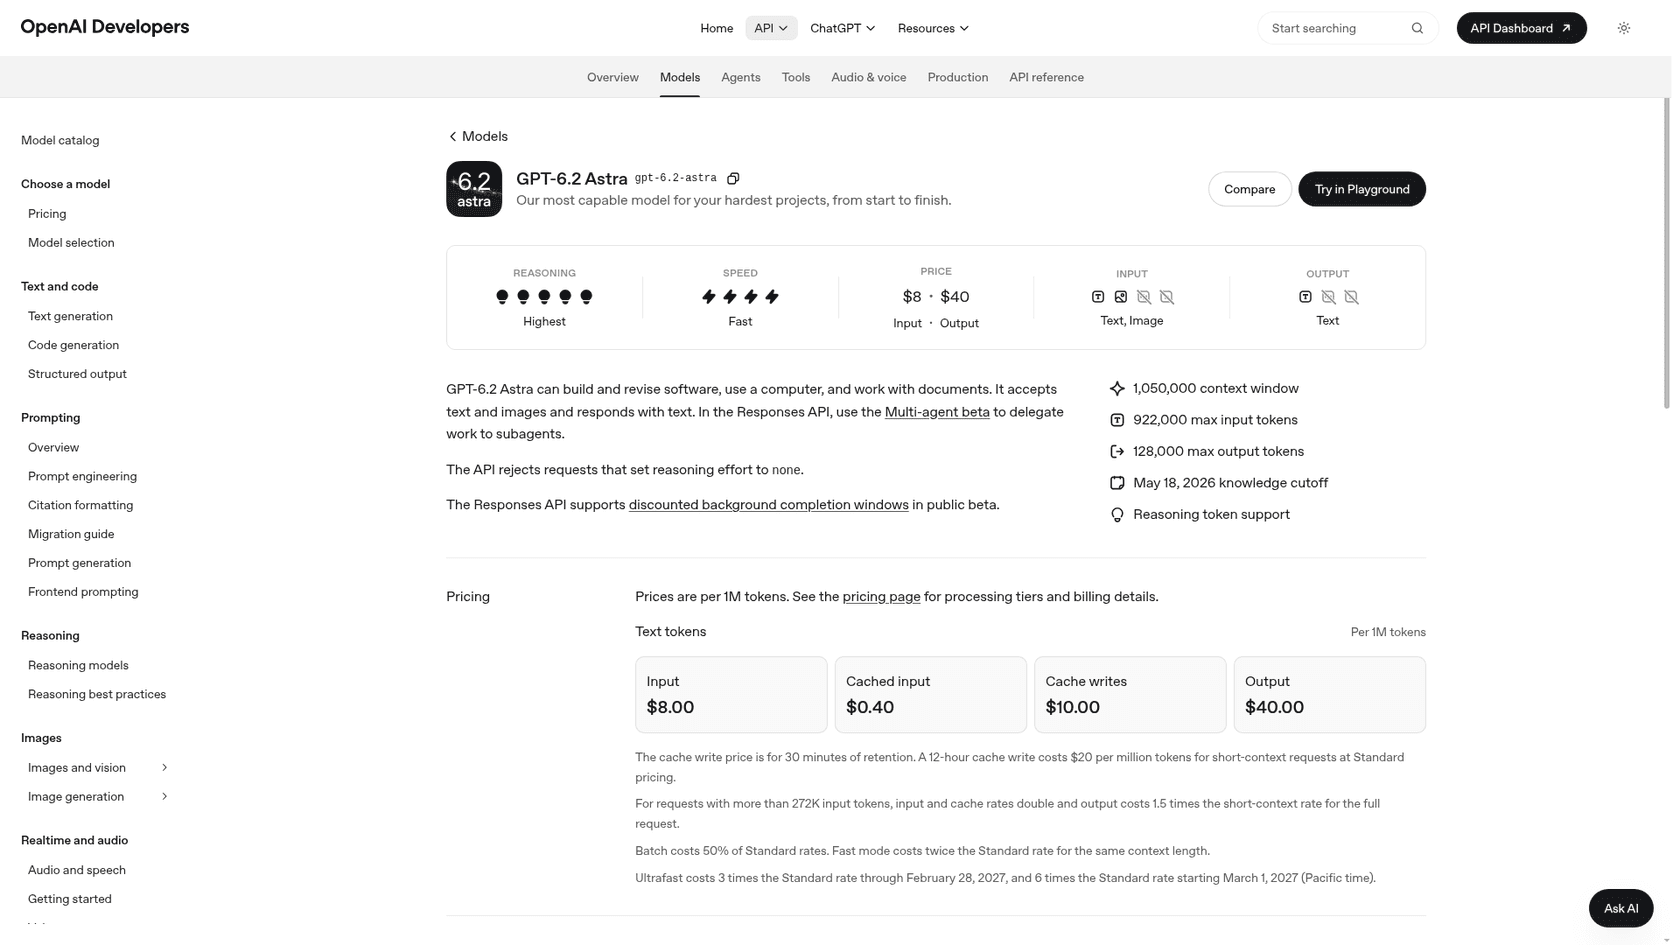
GPT-6.2 Astra est le modèle haut de gamme d'OpenAI, sorti le 17 novembre 2026, un jour avant Neon. Il a une fenêtre de contexte de 1 050 000 tokens, 128 000 tokens de sortie maximum et une date limite de connaissances de mai 2026, et l'API rejette l'effort de raisonnement none. Son prix est élevé, à $8 en entrée et $40 en sortie par million de tokens, soit 2,7 fois le tarif d'entrée de Neon.
Sur la facture, cependant, Astra est le modèle qui bat Neon sur son propre terrain. En effort élevé, il obtient 60,1 pour $2,07 par tâche et termine en 5,9 minutes, contre 14,8 pour Neon. Il y arrive en écrivant 17 828 tokens là où Neon en écrit 90 188. Au maximum, il grimpe à 62,1, juste au-dessus du meilleur score de Neon de 61,4, pour $4,00. Mon propre test de 90 passages en support dans le guide des alternatives à Astra a trouvé la même habitude : le niveau d'effort a à peine bougé le coût sur les tickets courts, de $5,75 à $6,57 par 1 000 tickets du plus bas au plus élevé.
Un lecteur de Hacker News a fait un benchmark maison qui montre comment cela se traduit en pratique :
"GPT-6.2 Astra scored 92 in 6.6 min for $2.04, vs Kimi K3.1 Pro (93 in 11.5 min for $0.68)"
Avantages
- Égale le score de Neon pour environ 45 % de moins par tâche, et plus de deux fois plus rapide
- Même fenêtre de 1 050 000 tokens et l'API Responses que beaucoup d'équipes utilisent déjà
- Entrée en cache à
$0,40, avec le batch à moitié du tarif standard
Inconvénients
- S'est trompé sur 58 % des questions sans réponse dans AA-Omniscience, contre 14 % pour Neon, il a donc besoin d'une règle de transfert qui ne repose pas sur le fait que le modèle refuse lui-même
- Les requêtes de plus de 272K tokens d'entrée doublent le tarif d'entrée et portent la sortie à 1,5 fois le tarif standard
- Le prix affiché paraît cher dans toute feuille de calcul qui ignore les tokens par tâche
Tarifs : $8 en entrée, $0,40 en cache et $40 en sortie par million de tokens au niveau standard, selon la page de tarifs d'OpenAI. Le traitement régional ajoute 10 %. Voyez les tarifs de GPT-6.2 Astra pour les paliers.
Verdict : le modèle que j'essaierais en premier si vous voulez des scores au niveau de Neon et que votre facture compte. Évitez-le si vous avez besoin que le modèle lui-même refuse quand il est incertain, car c'est là que Neon est meilleur.
2. GPT-6.2 Sol
Idéal pour : la facture la plus basse qui reste dans les 50 points élevés.
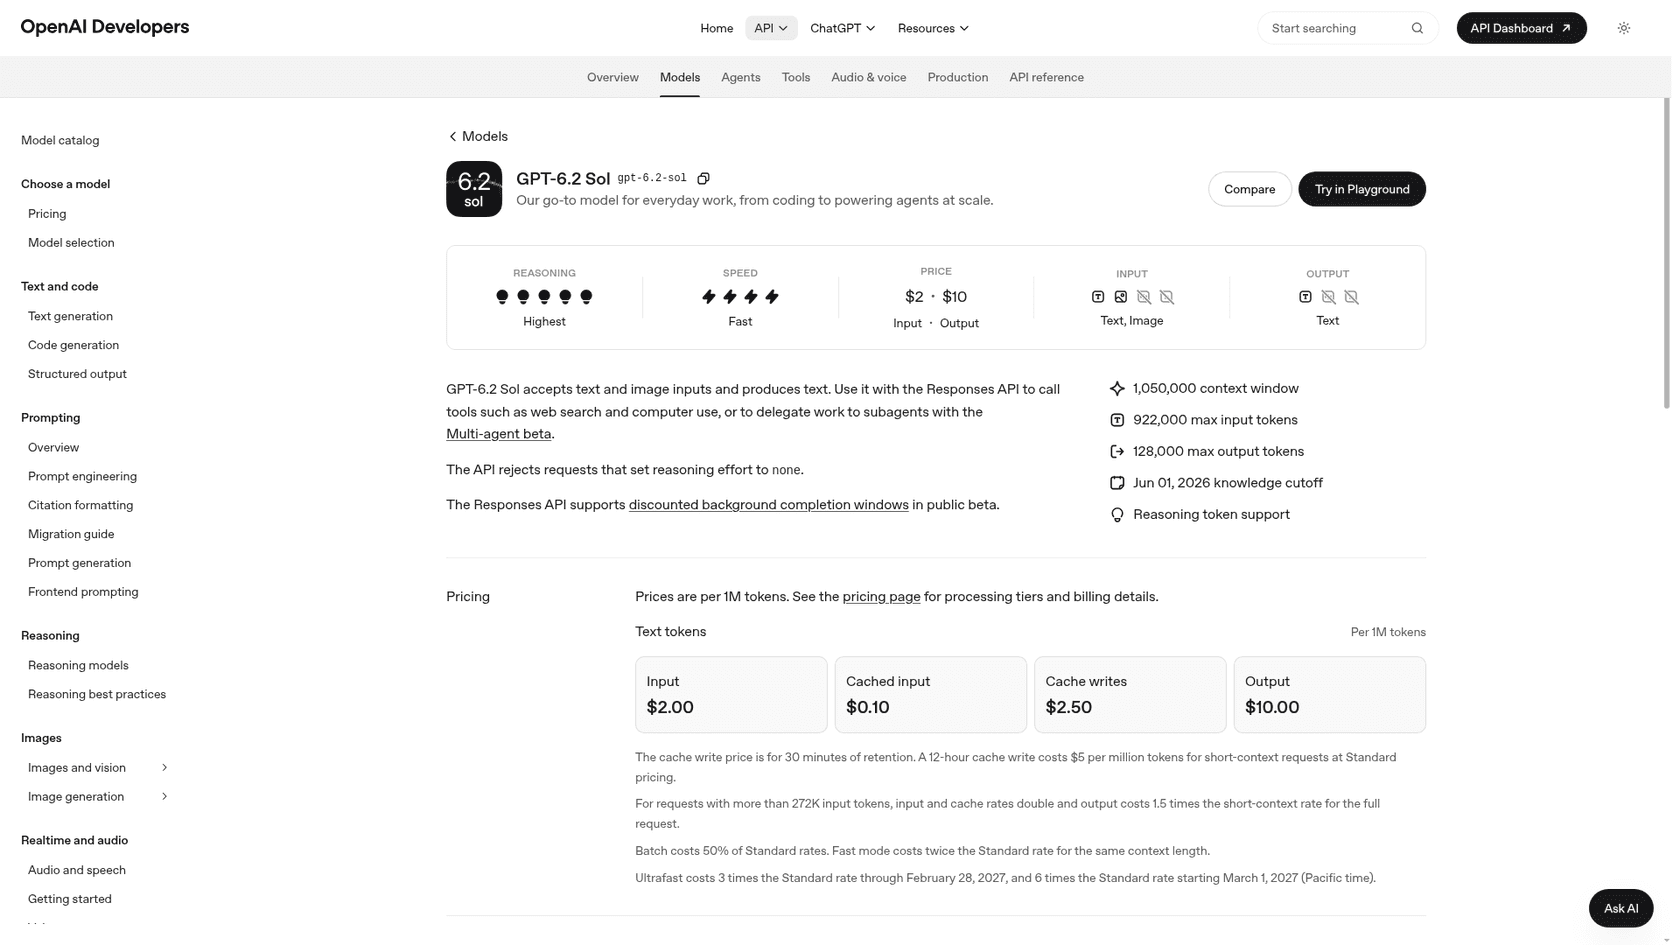
GPT-6.2 Sol est le modèle du quotidien d'OpenAI, avec la même fenêtre de 1 050 000 tokens qu'Astra, une date limite de connaissances de juin 2026, et $2 en entrée et $10 en sortie par million de tokens. Artificial Analysis le note à 57,3 à l'effort maximal pour $1,01 par tâche, et 54,9 en effort élevé pour $0,56. Ce second chiffre est celui vers lequel je reviens sans cesse : le même score que Neon en medium, pour moins d'un tiers du coût.
Dans mon propre test, Sol a répondu correctement aux 45 passages, du faible au moyen au élevé, incluant un remboursement proportionnel qui donnait $990 à chaque fois, une injection de prompt qui a reçu un refus poli, et des tickets en espagnol et en allemand répondus dans la langue du client. Le coût était de $1,42, $1,40 et $1,54 par 1 000 tickets, environ un quart de celui d'Astra. L'opinion sur le terrain est partagée sur les cas les plus difficiles :
"OpenAI's models require constant reprompting for me."
Ce lecteur préférait Sonnet 5.5, et c'est un avertissement juste : un modèle bon marché demande plus à votre prompt.
Avantages
- De
$0,56à$1,01par tâche, le modèle le moins cher ici qui dépasse 54 au score - Rapide : de 4,6 à 8,5 minutes par tâche sur Artificial Analysis
- Même surface d'API qu'Astra, vous pouvez donc router entre les deux
Inconvénients
- Se trompe sur 55 % à 60 % des questions sans réponse, il répondra donc quand il devrait transférer
- Les écritures en cache sont facturées séparément à
$2,50par million de tokens pour une rétention de 30 minutes, le tarif en cache n'est donc pas de l'argent gratuit - L'API rejette l'effort de raisonnement
none
Tarifs : $2 en entrée, $0,10 en cache et $10 en sortie par million de tokens, selon la page de tarifs d'OpenAI. Le batch divise ça par deux. Le guide des tarifs de Sol a le détail.
Verdict : mon choix par défaut pour la plupart des charges de travail. Commencez ici, et passez à Astra ou à Neon seulement pour les tâches où il échoue visiblement.
3. Claude Opus 5.5
Idéal pour : les longues sessions de code et d'agents sur une pile Anthropic.
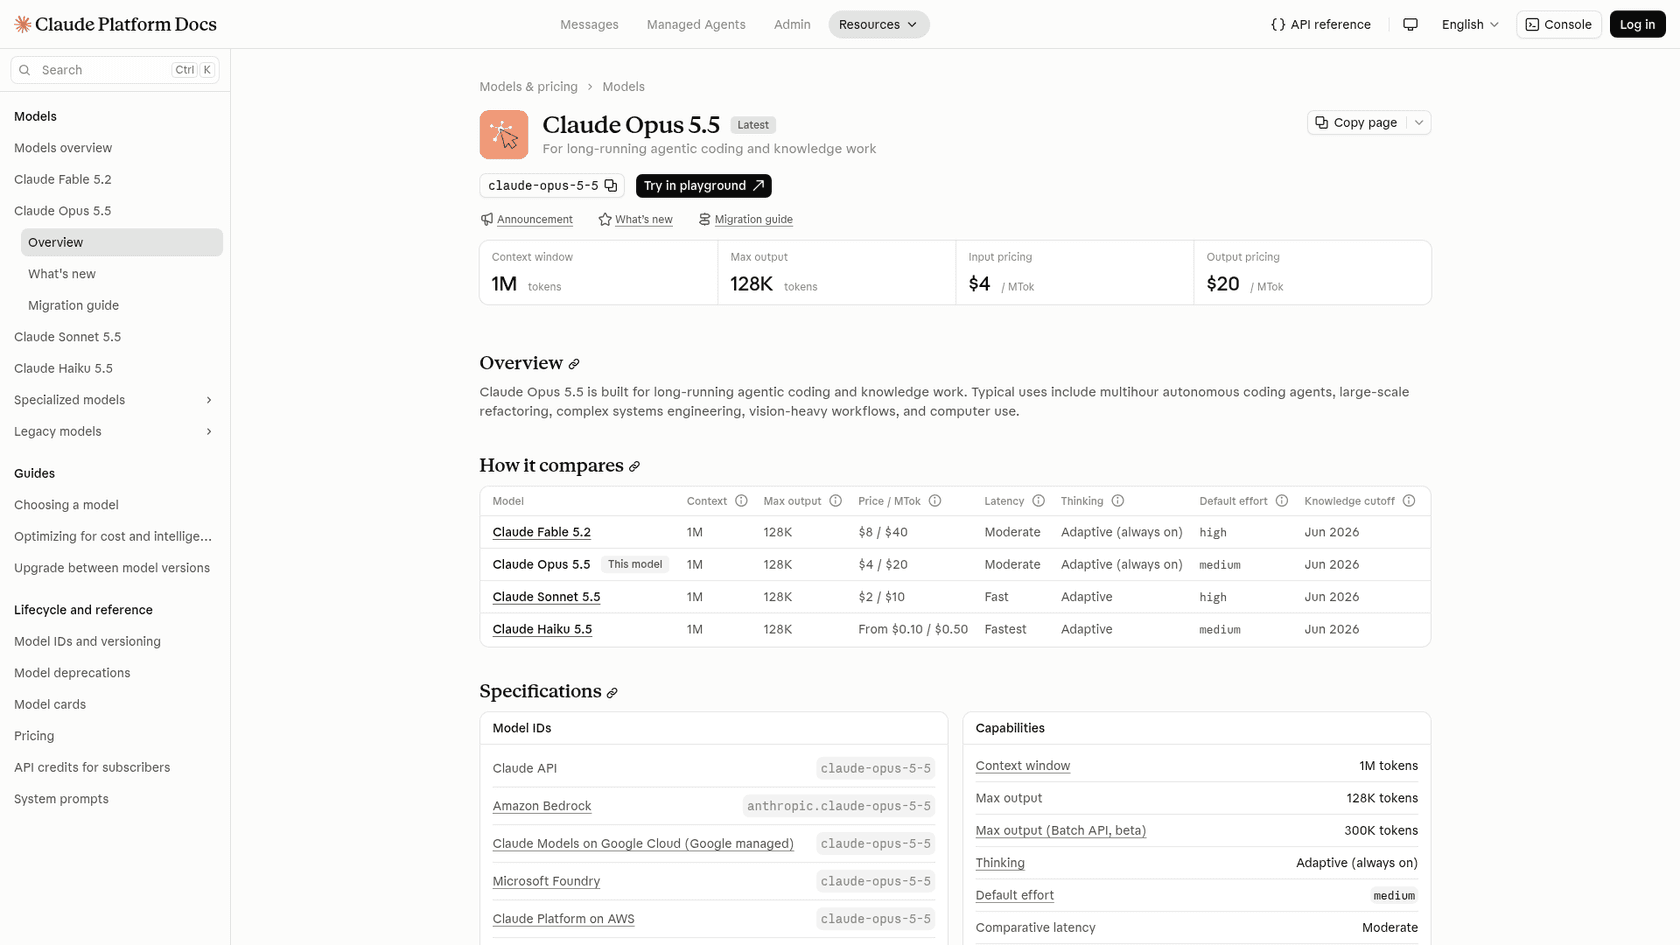
Claude Opus 5.5 est sorti le 22 septembre 2026 à $4 en entrée et $20 en sortie par million de tokens, avec une fenêtre de 1M de tokens, 128K de sortie maximum, une réflexion adaptative toujours active et un effort par défaut de medium. Il fonctionne sur l'API Claude, Amazon Bedrock, Google Cloud et Microsoft Foundry. Le propre tableau comparatif de Google dans la fiche du modèle Neon place Opus légèrement devant Neon sur Terminal-Bench 4.1 et FrontierCode 2.0, c'est donc le rival le plus solide en code de la liste.
Le piège est l'habitude que j'ai décrite plus haut. À l'effort maximal, Opus écrit 173 313 tokens par tâche, ce qui transforme une étiquette à moitié prix en la ligne la plus chère du tableau : $10,04 par tâche pour 59,1, contre $3,74 pour Neon à 59,6. Au défaut de l'API, medium, c'est $2,45 pour 48,2, un score plus faible que les 54,9 de Neon medium pour un coût plus élevé. Un lecteur de Hacker News le place pourtant toujours en tête deux mois plus tard :
"Every day I'm just more and more amazed at Opus 5.5 and how ahead it was."
Avantages
- Entrée en cache à
$0,20, et le batch à moitié prix - La page de tarifs d'Anthropic ne liste que l'inférence aux États-Unis via
inference_geopour un supplément de 10 % - Solide en longues sessions de code, où le propre tableau de Google lui donne l'avantage
Inconvénients
$10,04par tâche au maximum, environ 2,7 fois Neon pour le même score- La page de tarifs d'Anthropic ne liste que
autoetnonecomme choix d'outil pour Opus 5.5, testez donc tout agent qui force un outil précis - Se trompe sur 50 % des questions sans réponse au maximum, et 67 % en medium
Tarifs : $4 en entrée, $0,20 en lecture de cache et $20 en sortie par million de tokens, selon la page de tarifs d'Anthropic. Le mode rapide coûte $8 et $40. Voyez les tarifs d'Opus 5.5.
Verdict : choisissez-le si vous êtes déjà chez Anthropic et que vos tâches sont de longues sessions de code. Évitez-le si le coût par tâche est votre contrainte, et lisez d'abord mon test d'Opus 5.5.
4. Claude Sonnet 5.5
Idéal pour : les équipes Anthropic qui font tourner de courts cycles d'outils à faible effort.
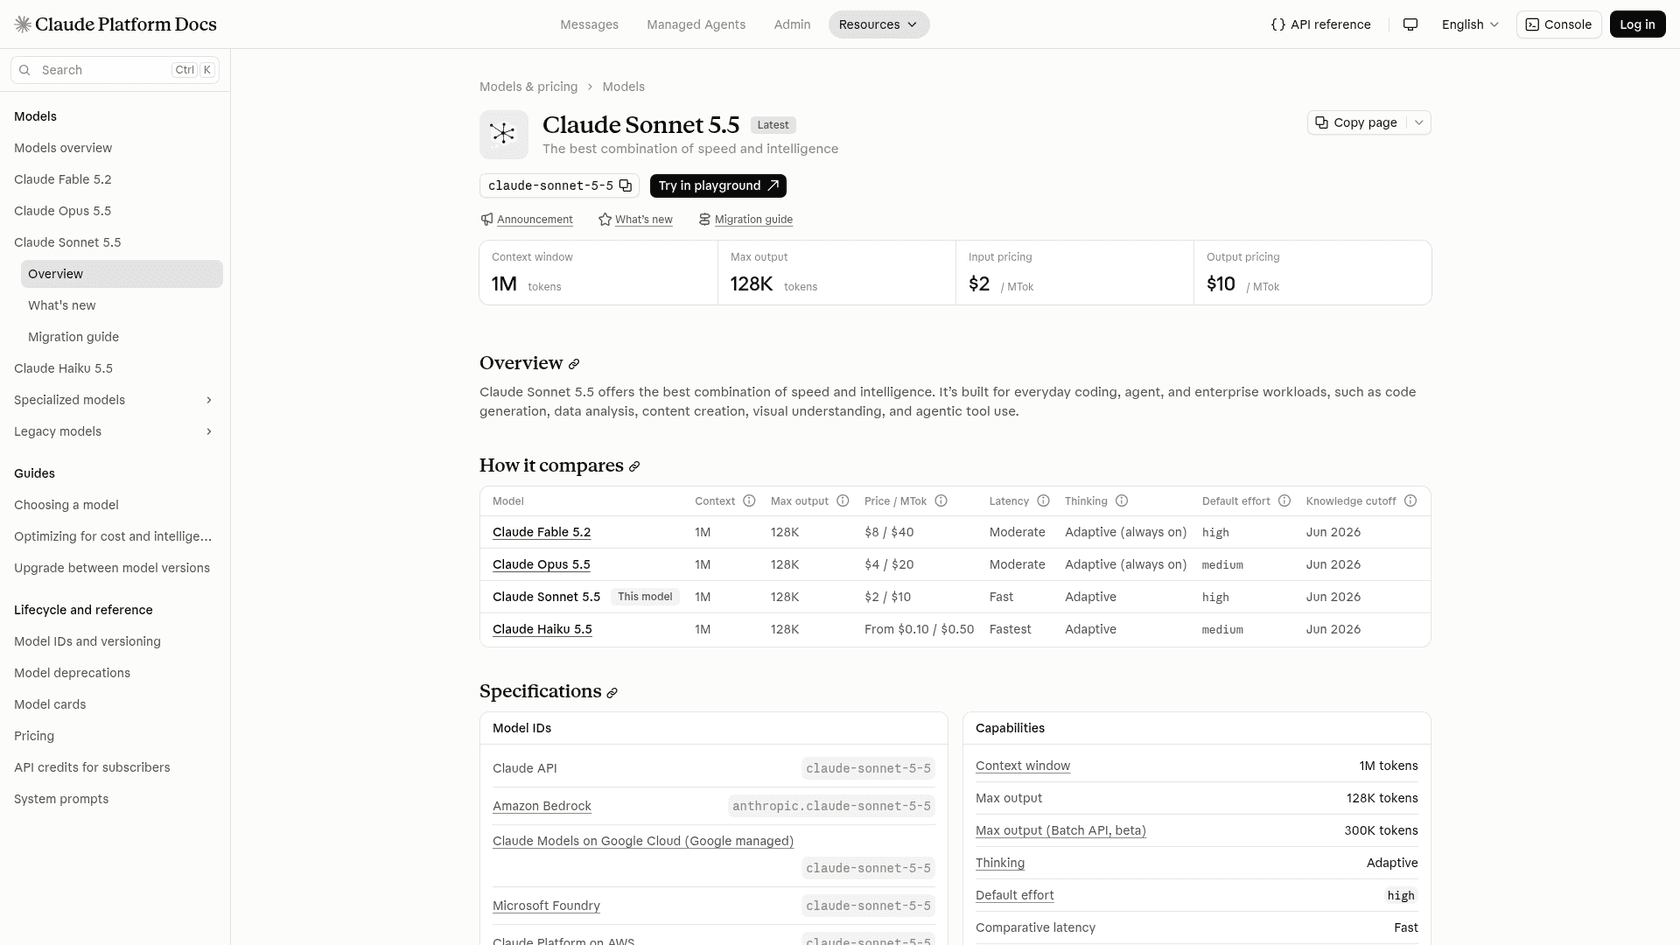
Claude Sonnet 5.5 a la même étiquette à $2 et $10 que Sol, une fenêtre de 1M de tokens, une date limite de connaissances de juin 2026 et un effort par défaut de high sur l'API. C'est le piège. Sur Artificial Analysis, il coûte $10,02 par tâche au maximum pour 54,5, dix fois Sol, car il écrit 285 387 tokens et prend 32,6 minutes. Au défaut high, c'est $1,64 pour 41,5, et Neon low le bat sur les deux plans avec $0,75 pour 44,1.
Il y a un point positif. Sonnet 5.5 s'est trompé sur 43 % des questions sans réponse au maximum, mieux que Sol, Astra ou Opus, mais loin derrière Neon.
Avantages
- Entrée en cache à
$0,10, et un taux d'hallucination plus bas que le duo OpenAI - Contexte de 1M de tokens, 128K de sortie maximum, et les mêmes plateformes qu'Opus
- Convient aux équipes déjà construites autour des outils d'Anthropic
Inconvénients
- Le score oscille de 41,5 en high à 54,5 en max, tandis que le coût oscille de
$1,64à$10,02 - Même liste
autoetnonecomme choix d'outil qu'Opus sur la page de tarifs d'Anthropic - Le plus lent des modèles grand public au maximum, à 32,6 minutes par tâche
Tarifs : $2 en entrée, $0,10 en lecture de cache et $10 en sortie par million de tokens, selon la page de tarifs d'Anthropic. Le batch est à $1 et $5. Voyez les tarifs de Sonnet 5.5.
Verdict : choisissez-le seulement si Anthropic est une contrainte fixe et que vous le faites tourner en effort faible ou moyen. Sinon, Sol fait le même travail pour moins cher, et mon test de Sonnet 5.5 explique le piège de l'effort.
5. Gemini 4 Carbon
Idéal pour : les équipes qui veulent le moins de réponses inventées et qui sont prêtes à payer pour ça.
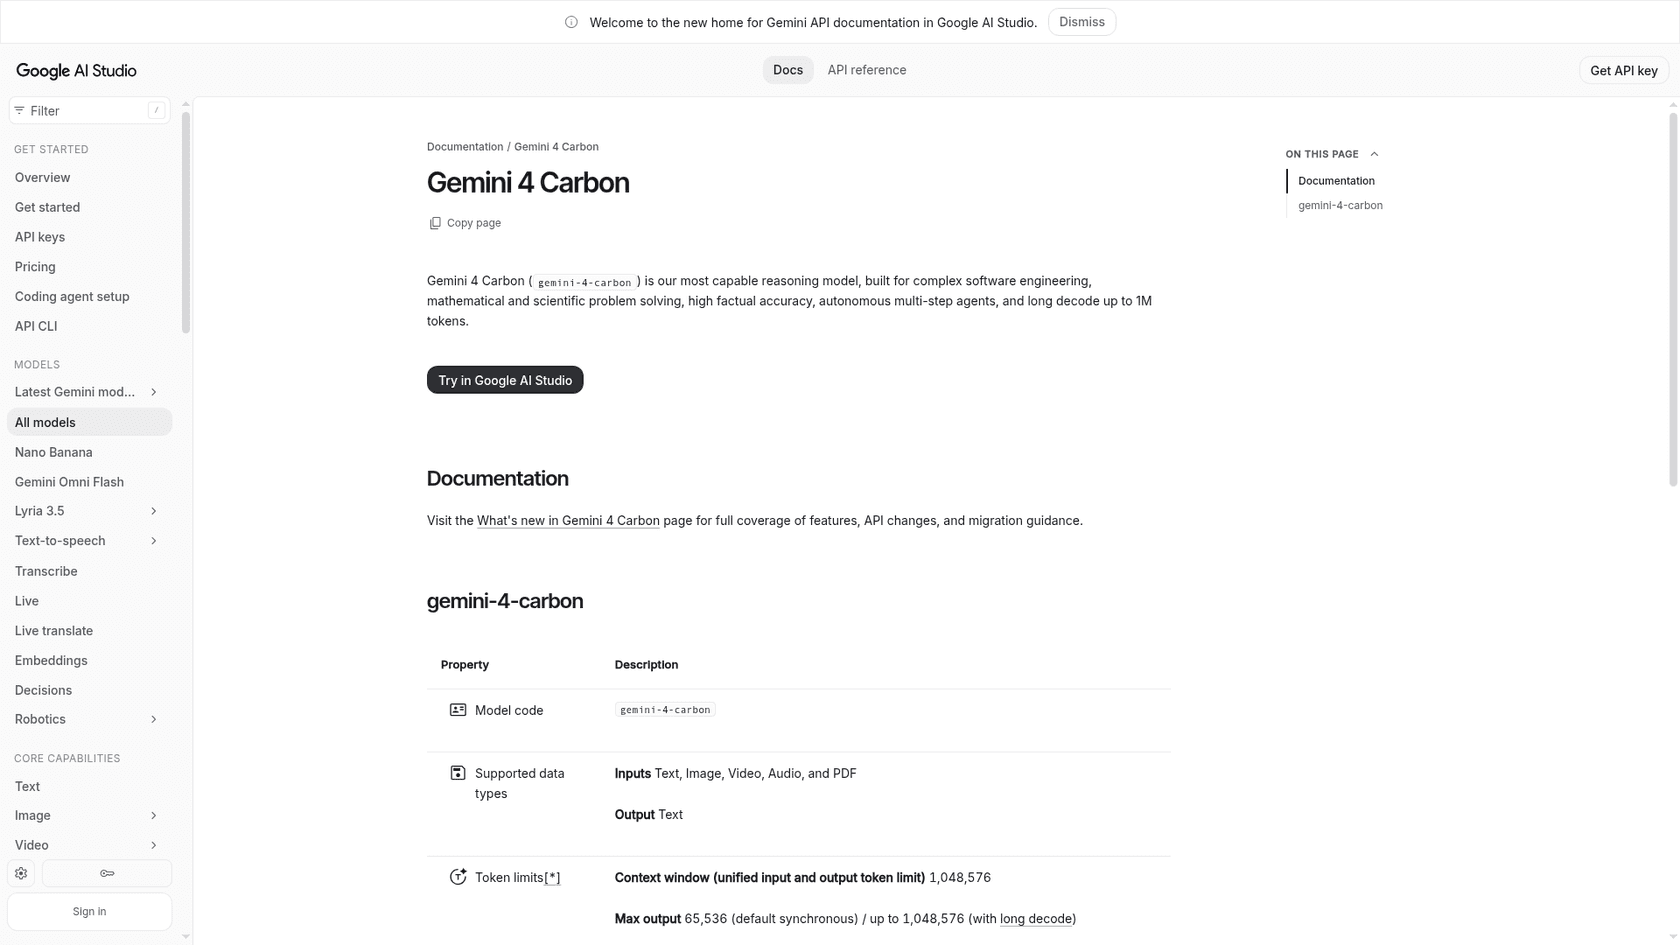
Gemini 4 Carbon est le modèle dont Neon a été adapté, et Google le décrit comme son modèle de raisonnement le plus capable, conçu pour l'ingénierie logicielle, la science et les longs agents à plusieurs étapes. Il est désormais sur l'API Gemini avec une tarification uniquement payante : $2 en entrée et $10 en sortie jusqu'au 30 novembre 2026, puis $4 et $20 à partir du 1er décembre, avec une entrée en cache à $0,10 qui monte à $0,20.
Le point fort de Carbon est l'honnêteté. À effort moyen, il s'est trompé sur 4 % des questions sans réponse, et à effort élevé sur 11 %, contre 14 % pour Neon. Son problème, c'est le coût. En high, il obtient 60,0 pour $7,76 par tâche, plus du double des $3,74 de Neon pour le même score, et il prend 37,2 minutes. Un testeur de Hacker News a mesuré la même lenteur sous un autre angle :
"I've tested 75 models so far, and Gemini 4 Carbon is 68th/75 in terms of slowness"
Avantages
- Le taux d'hallucination le plus bas de la liste : 4 % en medium, 11 % en high
- Fenêtre de 1 048 576 tokens et décodage long jusqu'à environ 1M de tokens de sortie
- Même pile Google que Neon, la migration n'est donc qu'un changement de nom de modèle
Inconvénients
$7,76par tâche en high, le double de Neon pour le même score, une fois la promotion terminée- Lent : de 29,6 à 37,2 minutes par tâche, avec une longue traîne constatée par le testeur HN
- Pas de palier gratuit
Tarifs : $2 en entrée et $10 en sortie jusqu'au 30 novembre, puis $4 et $20, selon la page de tarifs de Google. Comparez avec mon panorama des alternatives à Carbon.
Verdict : choisissez-le si les mauvaises réponses vous coûtent plus que le temps, et budgétez au prix de décembre. Sinon, Neon vous donne le même score pour moitié moins cher.
6. Kimi K3.1 Pro
Idéal pour : les équipes qui veulent des poids ouverts d'un fournisseur non américain.
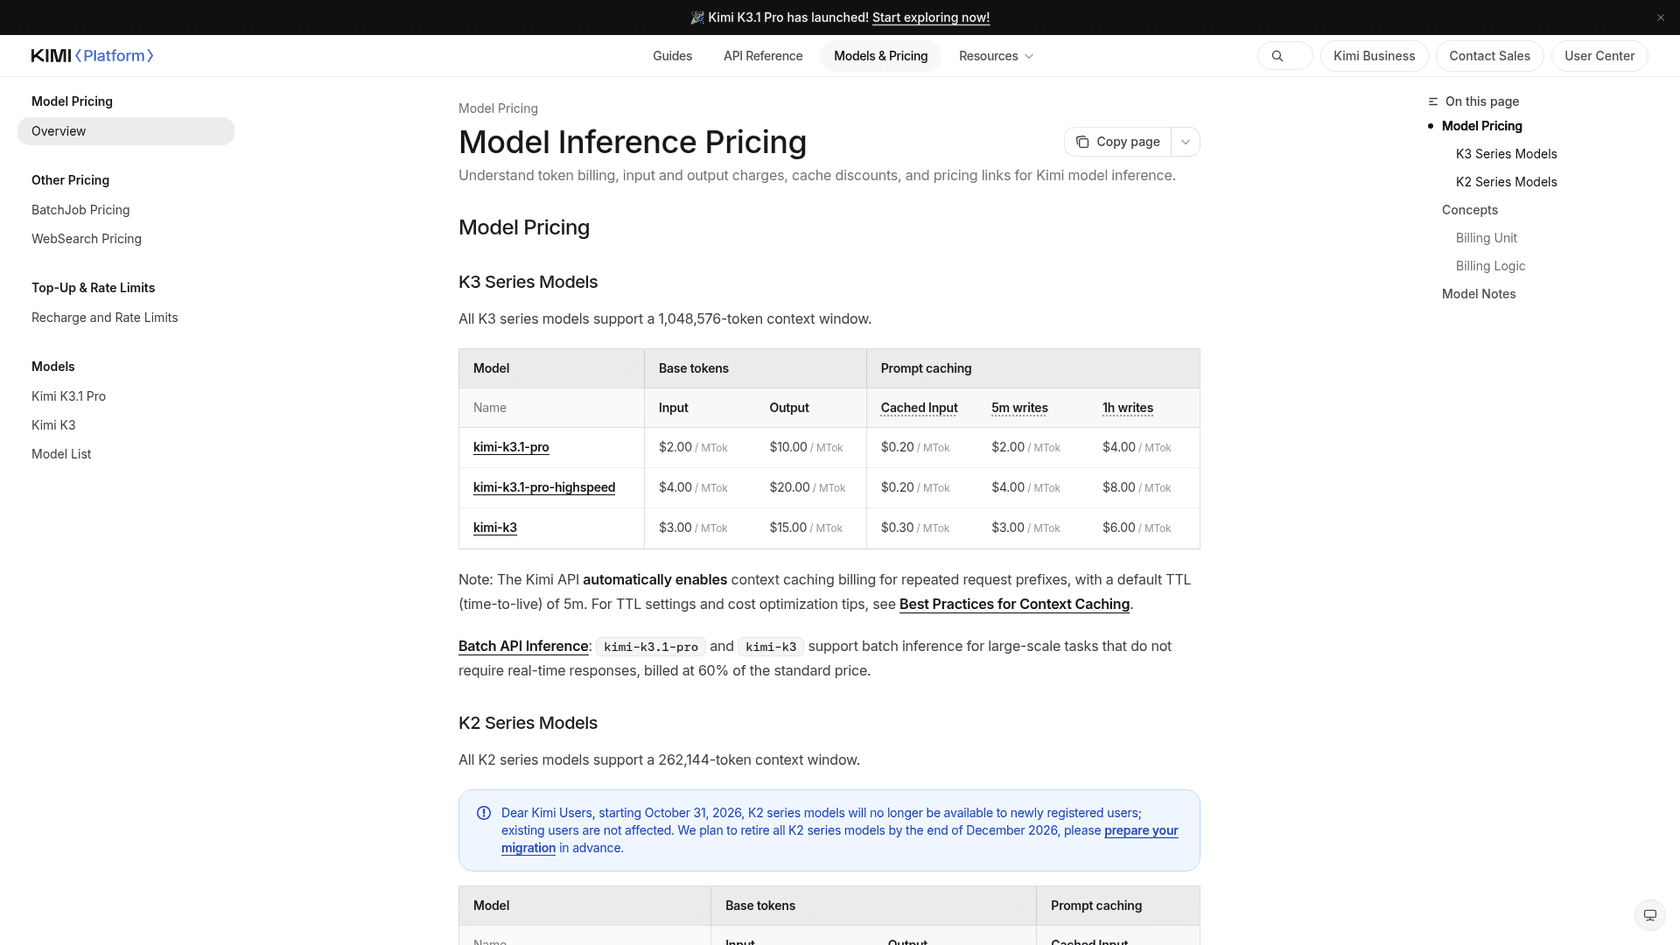
ChatGPT a cité Kimi K3, mais le modèle que je testerais aujourd'hui est Kimi K3.1 Pro, qui coûte moins cher que l'ancien Kimi K3, à $2 en entrée et $10 en sortie par million de tokens, avec une entrée en cache à $0,20. K3 reste à $3 et $15. K3.1 Pro a une fenêtre de 1 048 576 tokens, et une version highspeed à $4 et $20. Artificial Analysis le classe en poids ouverts avec 2,8T de paramètres et 104B actifs.
Il accuse un retard sur le score : 46,5, contre 54,9 pour Neon medium. Il prend aussi 39,4 minutes par tâche et coûte $3,68, Neon medium le bat donc sur le score, le coût et la vitesse. L'argument du prix repose sur un autre type de tâche. Le résultat PacBench cité plus haut donnait Kimi à $0,68 contre les $2,04 d'Astra sur un petit test de code, il peut donc être beaucoup moins cher que ne le suggère le classement sur des tâches ciblées.
Avantages
$2/$10par million de tokens et poids ouverts sous la licence propre de Moonshot- Inférence par lots à 60 % du tarif standard, selon la page de tarifs de Kimi
- S'est trompé sur 37 % des questions sans réponse, mieux que Sol, Astra et Opus
Inconvénients
- 46,5 sur l'index, bien en dessous de Neon, Astra et Opus
- 39,4 minutes par tâche, le modèle le plus lent de mon tableau
- Aucun point de terminaison régional documenté sur la page de tarifs
Tarifs : $2 en entrée, $0,20 en cache et $10 en sortie par million de tokens pour kimi-k3.1-pro, selon la page de tarifs de Kimi. Mon article sur les tarifs de Kimi K3.1 Pro couvre les plans.
Verdict : choisissez-le si les poids ouverts ou la diversité des fournisseurs sont le point important. Évitez-le pour le raisonnement complexe, et lisez d'abord mon test de Kimi K3.1 Pro.
7. DeepSeek V4.1 Flash
Idéal pour : la classification et le routage en masse au prix affiché le plus bas.
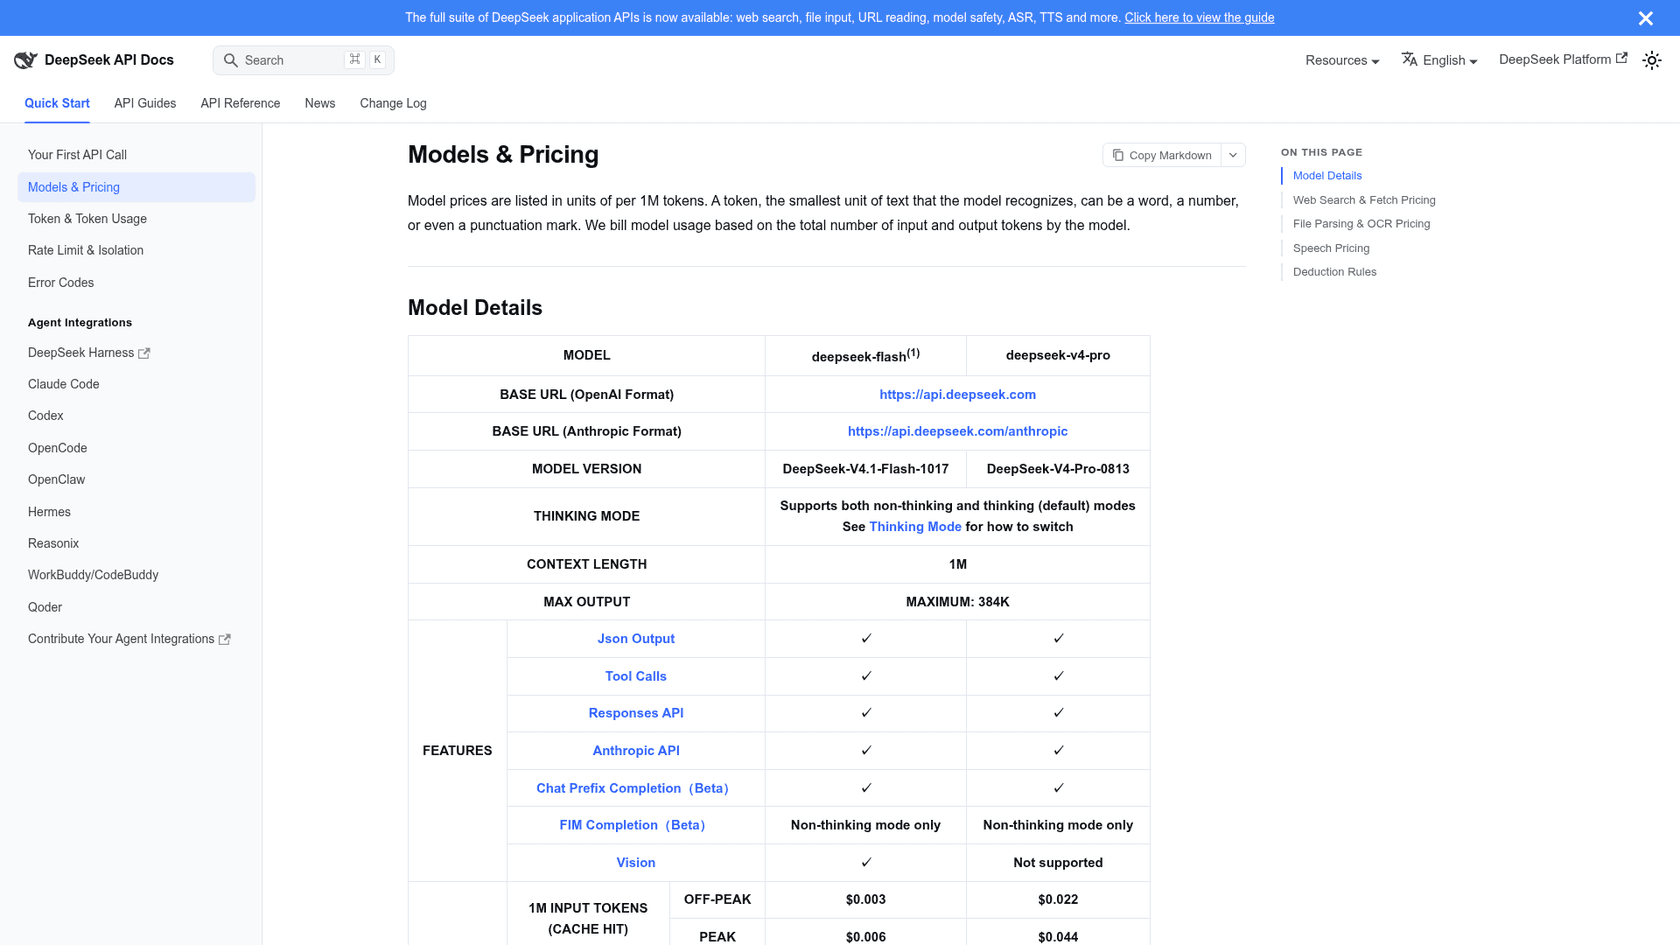
Le modèle actuel est DeepSeek V4.1 Flash, que la documentation de DeepSeek liste comme deepseek-flash exécutant DeepSeek-V4.1-Flash-1017. Il coûte $0,15 en entrée sur un échec de cache et $0,60 en sortie par million de tokens hors pointe, et le double en pointe (de 01h00 à 04h00 et de 06h00 à 10h00 UTC les jours ouvrés). Les succès de cache coûtent $0,003. Il a une fenêtre de 1M de tokens, 384K de sortie maximum, une sortie JSON, des appels d'outils, de la vision et une limite de concurrence de 2 500.
Artificial Analysis le note à 33 au maximum pour $0,60 par tâche, calculé au tarif de pointe, donc hors pointe c'est environ la moitié selon mes calculs. La surprise, c'est que des tokens bon marché n'ont pas donné une tâche bon marché : il écrit 138 962 tokens, Sol high à 54,9 coûte donc à peu près la même chose. Un commentateur du fil de lancement avait un autre budget en tête :
"I don't think it beats Deepseek v4.1 Flash 1017 at cost per task."
Il a raison sur les prix au token et, pour le travail léger, sur les factures. Les poids sont sous licence MIT, vous pouvez donc l'héberger vous-même.
Avantages
$0,15/$0,60hors pointe, et$0,003pour les succès de cache- Poids ouverts sous licence MIT, 552B au total et 16B actifs selon Artificial Analysis
- Sortie JSON et appels d'outils listés sur sa page de tarifs
Inconvénients
- Score à l'index de 32,6, c'est donc un modèle de tri, pas de raisonnement
- Se trompe sur 64 % des questions sans réponse au maximum
- Aucun point de terminaison régional ni conditions de traitement des données sur la page de tarifs, demandez donc avant d'envoyer des données clients
Tarifs : $0,15 en entrée (échec de cache), $0,003 pour un succès de cache et $0,60 en sortie hors pointe, selon la page de tarifs de DeepSeek. Voyez les tarifs de DeepSeek V4.1 Flash pour le calcul en pointe et hors pointe.
Verdict : choisissez-le pour la classification et le routage, où un score de 33 suffit largement. Évitez-le pour tout ce qui est face au client sans humain dans la boucle.
Quelle alternative à Gemini 4 Neon choisir ?
Voici la décision telle que je la prendrais, par usage :
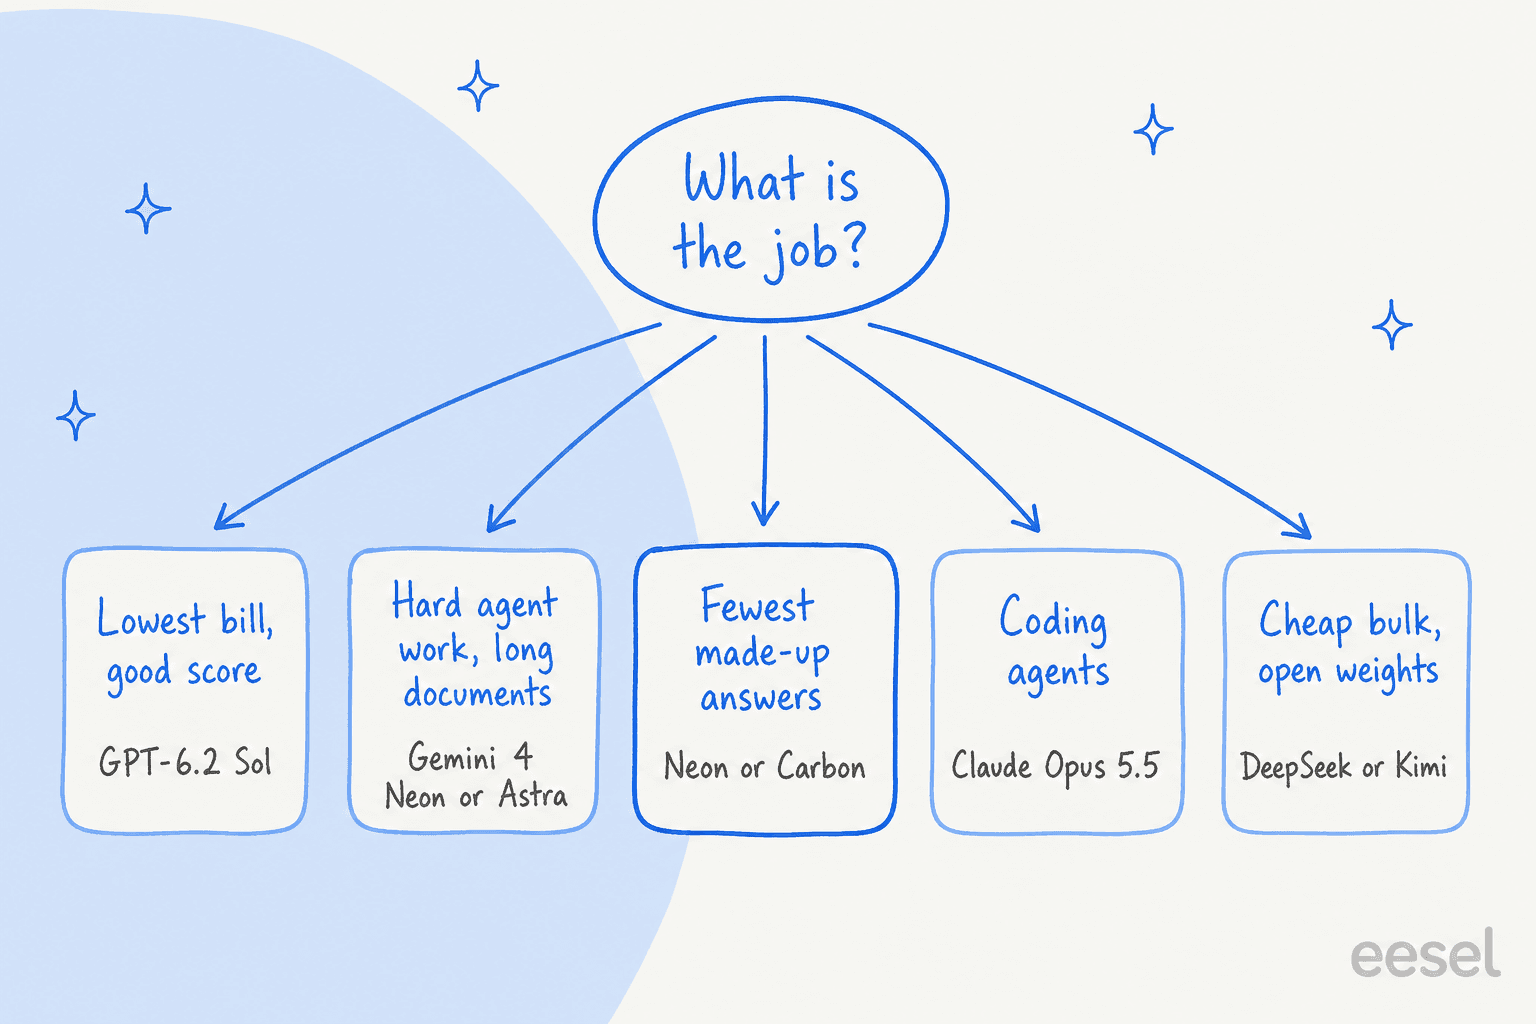
| Si votre tâche est... | Mon choix | Pourquoi |
|---|---|---|
| la facture la plus basse avec un score dans les 50 élevés | GPT-6.2 Sol | de $0,56 à $1,01 par tâche |
| le score de Neon à moindre coût | GPT-6.2 Astra high | 60,1 pour $2,07 |
| agents difficiles et documents très longs | Neon en high, ou Astra | les lignes de long contexte de Neon dominent dans le propre tableau de Google |
| un modèle qui refuse quand il est incertain | Neon ou Carbon | 14 % et de 4 % à 11 % d'erreurs en situation d'incertitude |
| longues sessions de code sur Anthropic | Claude Opus 5.5 | code solide, mais $10,04 par tâche au maximum |
| poids ouverts ou fournisseur non américain | Kimi K3.1 Pro | $2/$10, score 46,5 |
| tri et routage en volume | DeepSeek V4.1 Flash | $0,60 par tâche, poids MIT |
| chat en direct | Neon medium ou Hydrogen | 8,3 minutes, pas 14,8 |
Mon avis général : router, ne pas changer. Envoyez la plupart des tâches à Sol, envoyez celles qui demandent un modèle plus puissant à Astra ou Neon, et gardez un palier plus bas pour le tri. Si vous hésitez encore entre familles, ma comparaison ChatGPT contre Gemini va plus loin. Le panorama des alternatives à Gemini couvre le reste de la gamme de Google, et le guide API OpenAI contre API Gemini couvre les plateformes.
Comment tester les alternatives sur votre propre charge de travail ?
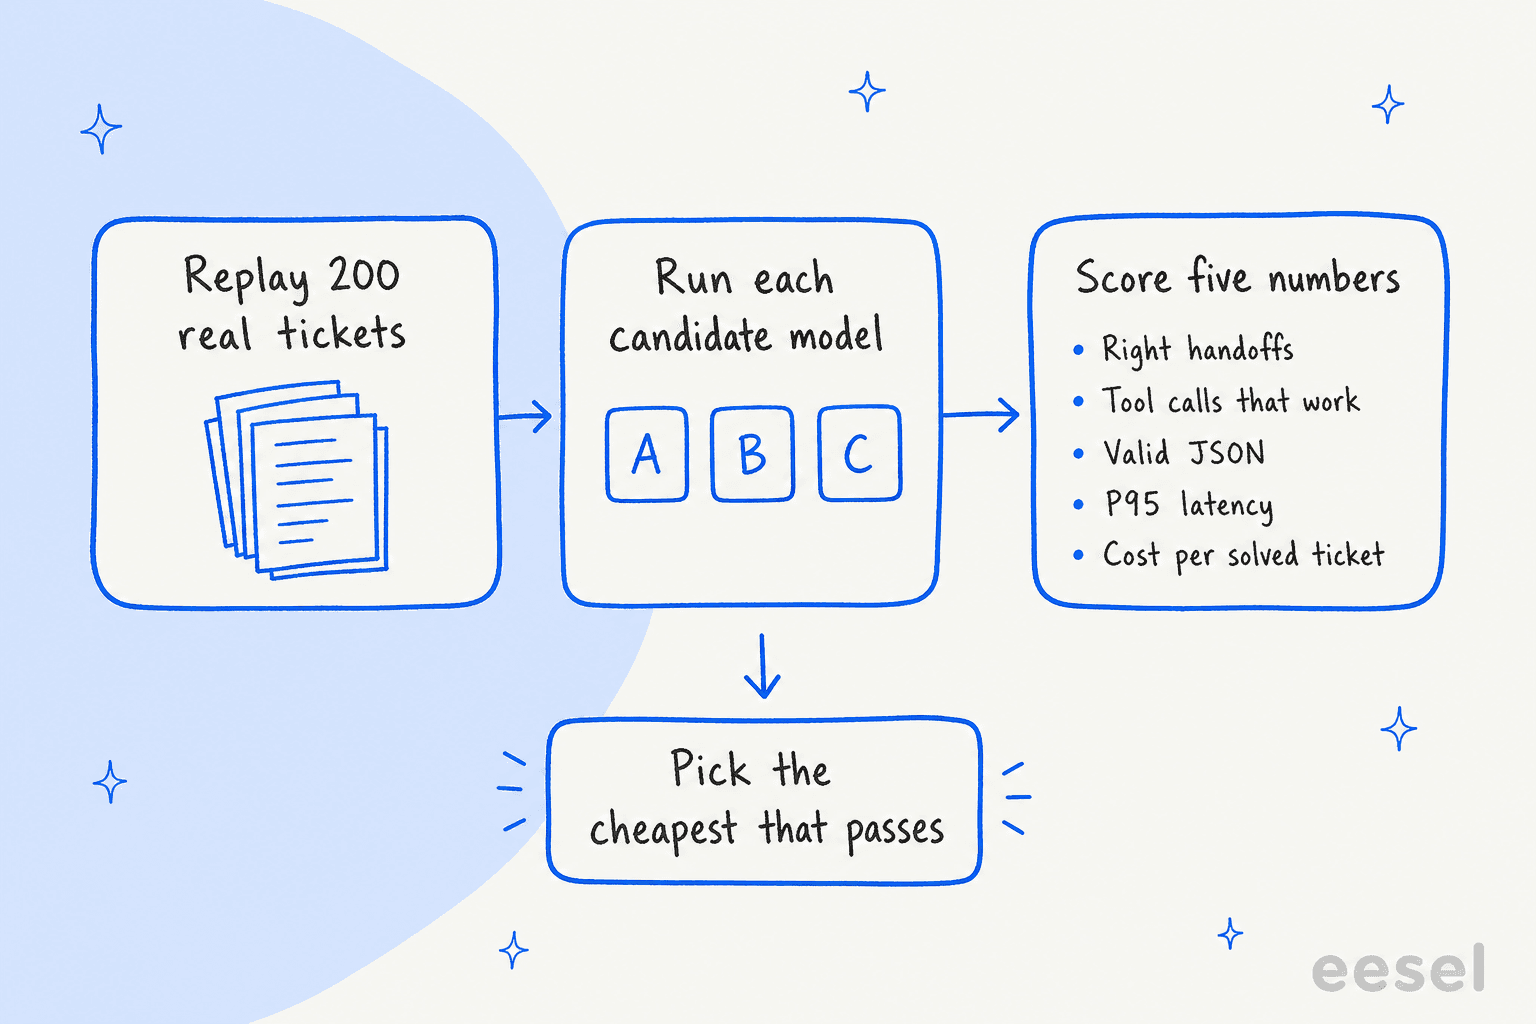
Une tâche de classement n'est pas votre tâche. Voici les cinq vérifications que je ferais avant de déplacer du trafic réel, dans l'ordre où je les ferais :
- Appels d'outils. Rejouez des tâches avec vos définitions d'outils réelles, et comptez trois choses : le bon outil choisi, des arguments qui valident, et aucun appel quand aucun n'est nécessaire. Si votre agent force un outil précis, testez ce mode en premier. La page de tarifs d'Anthropic ne liste que
autoetnonecomme choix d'outil pour Opus 5.5 et Sonnet 5.5, un design qui dépend du forçage d'un outil demande donc une vérification avant une migration. Mon guide sur les appels de fonction OpenAI couvre le côté OpenAI. - Sortie structurée. Mesurez la part des réponses qui s'analysent par rapport à votre schéma sans étape de réparation. La page de tarifs de DeepSeek liste la sortie JSON comme prise en charge, et le mode JSON d'OpenAI a ses propres règles, passez donc le même schéma sur chaque candidat. Une réponse invalide sur cinquante devient une nouvelle tentative et un coût.
- Latence, aux extrêmes. Enregistrez la médiane et le P95 du temps jusqu'au premier token et jusqu'à la fin. Le testeur HN cité plus haut a mesuré Carbon avec une médiane de 5 secondes pour démarrer, avec un appel à 50 secondes et un timeout. Les médianes cachent cela, et les clients ressentent l'extrême. Artificial Analysis a aussi mesuré 56,5 secondes jusqu'au premier token de réponse pour Neon en xhigh, mesurez donc chaque niveau d'effort que vous prévoyez d'utiliser.
- Nouvelles tentatives. Comptez les timeouts, les erreurs de limite de débit et les sorties mal formées pour 100 appels, puis utilisez
coût par tentative x (1 + taux de nouvelles tentatives)comme votre coût réel. C'est le chiffre qui relie un modèle bon marché à un modèle cher. - Mauvaises réponses contre transferts. Semez environ 20 tickets dont la réponse n'est pas dans vos documents, et comptez combien de fois chaque modèle répond quand même. C'est le même comportement que suggèrent les chiffres AA-Omniscience, mesuré sur votre propre contenu.
Mettez ensuite tout sur une ligne : coût par ticket résolu = dépense totale / tickets résolus correctement sans correction humaine. C'est le chiffre selon lequel classer, et c'est la version au niveau du modèle du coût par ticket. Exécutez chaque candidat sur les mêmes 200 tickets, à deux niveaux d'effort, deux fois. Mon test de 90 passages sur Astra et Sol a montré que l'effort bougeait à peine le coût sur les tickets courts, ce qui a changé le niveau d'effort que j'utiliserais en production.
Qu'est-ce que cela signifie pour un agent de support ?
Si votre objectif est un bot de support, ces sept modèles sont le moteur, pas l'agent. Ce que l'agent sait, quand il doit transférer et si quelqu'un l'a testé avant qu'il ne soit lancé déterminent son comportement, et une réponse sûre d'elle mais fausse à une question de remboursement coûte plus qu'un transfert. eesel met des agents IA sur des files de support en direct depuis des années, et la leçon qui est restée est de simuler chaque déploiement sur des tickets historiques avant que l'agent ne réponde à un client.
C'est ainsi que smava, une entreprise allemande de comparaison de crédits, fait tourner eesel dans un seul Zendesk. Entre le 8 août et le 8 septembre 2026, trois agents ont traité environ 27 000 tickets : l'un en a catégorisé environ 14 600, un autre a rédigé environ 15 300 réponses à partir de 820 macros et articles d'aide, et des agents par marque ont préparé des réponses prêtes pour le client. Chaque agent a une seule mission et une liste de choses qu'il ne doit jamais faire, et une personne approuve le brouillon avant que quoi que ce soit ne soit envoyé. SamCart répartit le travail par canal : un agent pour les tickets Freshdesk et un autre pour le chat du site, tous deux répondant à partir des mêmes 280 articles du centre d'aide.
Aucune des deux histoires ne consiste à choisir le meilleur modèle. Elles montrent que le modèle est un réglage à l'intérieur d'une conception, et cette conception comprend les connaissances, les règles de transfert et les tests. Si vous voulez comparer des modèles sur votre propre file, simulez l'agent sur des tickets passés, et surveillez le taux de transfert plus attentivement que la précision. Mon guide de benchmarking des agents de support IA liste les chiffres que je suis, et le coût du service client avec l'IA montre ce que coûte une file au total.
Essayer eesel
Si vous choisissez un modèle parce que vous voulez de meilleures réponses dans votre file, le coéquipier helpdesk IA d'eesel est l'employé qui se place au-dessus du modèle que vous choisissez. Il apprend de vos anciens tickets et de votre centre d'aide, transfère à une personne quand vos documents n'ont pas la réponse, et peut être testé sur votre véritable historique de tickets avant de répondre à qui que ce soit. Il fonctionne dans Zendesk et Freshdesk, et c'est par là que je commencerais si la vraie question pour un déploiement de support est « quel modèle ».
La tarification est un plan de crédits mensuel fixe, avec un plan gratuit de 100 crédits et sans carte bancaire, un changement de prix sur un modèle ne bouge donc pas votre facture. Essayez eesel sur une partie de votre file.
Comment comparer Gemini 4 Neon à ses alternatives sur ma propre charge de travail ?