Alternatives à GPT-6 Cyber : 8 options et comment obtenir l'accès pour de vrai

Rama Adi

Katelin Teen
Dernière modification 6 novembre 2026
La meilleure alternative à GPT-6 Cyber pour la plupart des équipes de sécurité est Claude Opus 5.5 via le Cyber Verification Program d'Anthropic. Son niveau Red Team a terminé 34 des 50 tâches offensives sans blocage, à égalité avec le modèle dont les garde-fous sont désactivés, pour 4 $/20 $ par 1M de tokens, un cinquième des 20 $/100 $ de GPT-6 Cyber. Si vous ne faites que réviser votre propre code, le conseil d'OpenAI lui-même reste valable : commencez sur Daybreak Blue, pas sur Red. GPT-6 Cyber n'est le bon choix que si vous avez besoin d'exploits qui fonctionnent contre des cibles distantes et pouvez attendre une seconde validation.
Pourquoi cherche-t-on des alternatives à GPT-6 Cyber ?
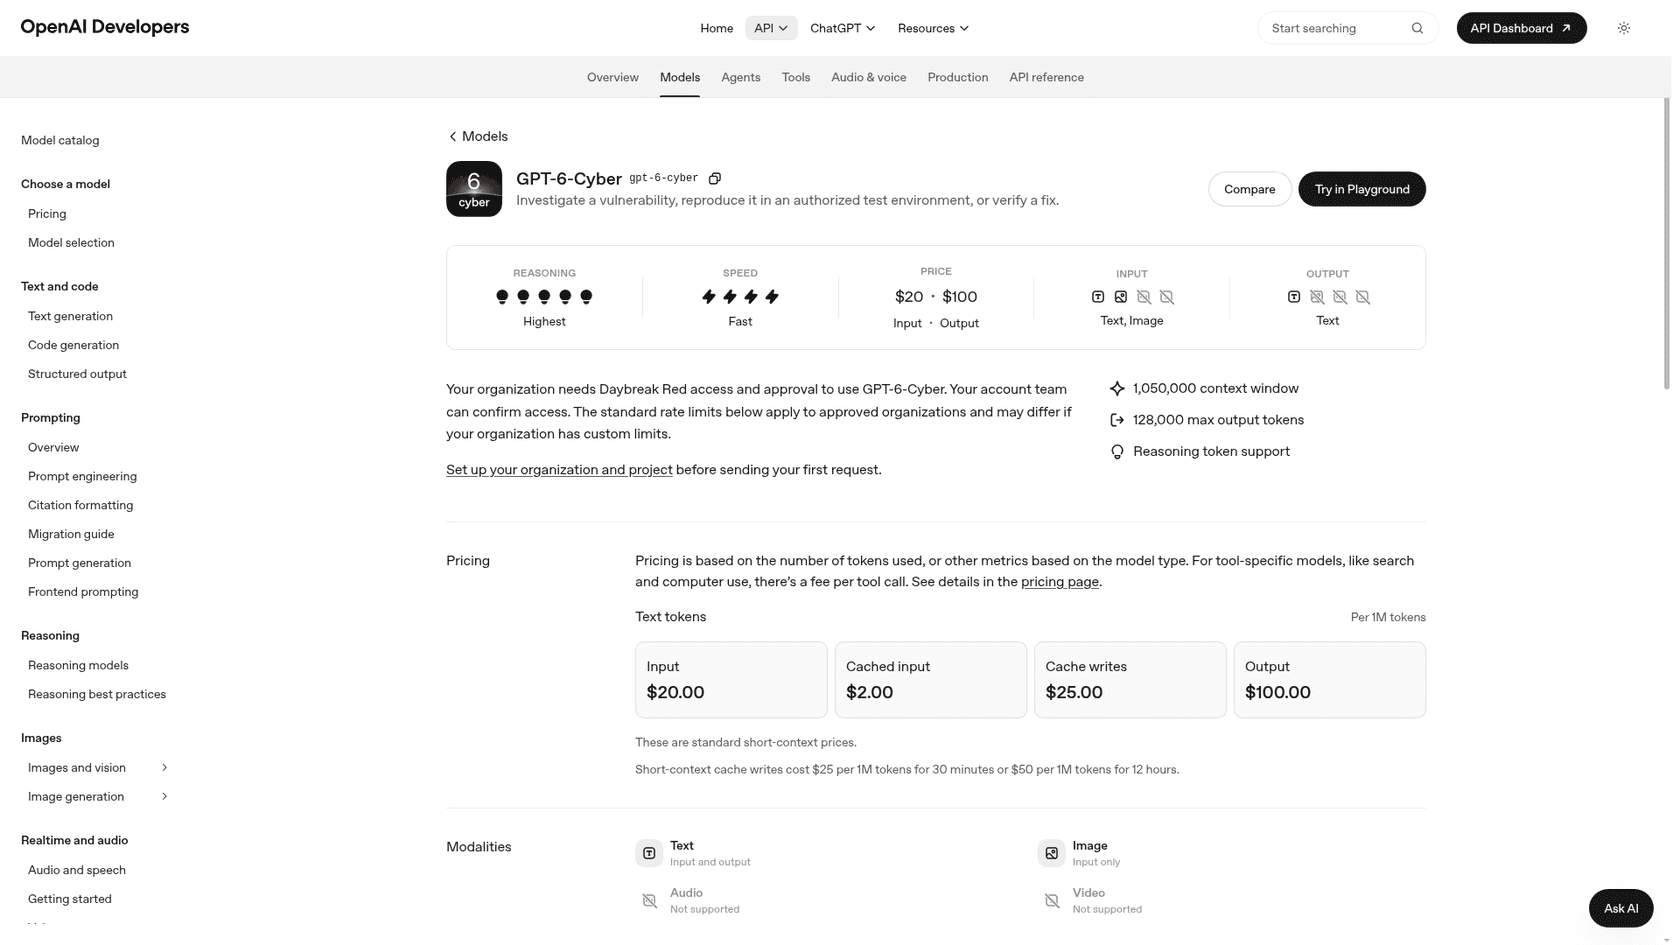
OpenAI a lancé GPT-6 Cyber le 5 novembre 2026, et sur le papier c'est le modèle cyber le plus puissant pour lequel quelqu'un ait publié des chiffres. Sur ExploitGym, il obtient 48,5 %, contre 32,1 % pour GPT-5.6 Cyber. Sur le nouveau RemoteExploitBench d'OpenAI, GPT-6 Astra sous Daybreak Blue a refusé toutes les tâches, tandis que GPT-6 Cyber en a complété 95 %.
Trois choses poussent les gens à chercher ailleurs le jour même :
- La barrière est double. Le guide d'accès Daybreak indique que GPT-6 Cyber nécessite Daybreak Red plus une validation séparée de GPT-6 Cyber, et l'annonce de lancement précise que ça démarre avec "un groupe restreint" de clients Red.
- Le prix a doublé. La grille tarifaire de l'API d'OpenAI indique que
gpt-6-cybercoûte 20 $ en entrée et 100 $ en sortie par 1M de tokens. C'est le double de GPT-6 Astra, qui était déjà le tarif standard le plus cher de la grille. - Il est classé Critical. OpenAI classe le modèle comme Critical en cybersécurité selon son Preparedness Framework, et l'accès à l'API Red exige une liste blanche d'IP par défaut.
Je suis Rama, et je construis les intégrations et API derrière les coéquipiers IA d'eesel. La majeure partie de ma semaine consiste à connecter des modèles à des systèmes réels, et d'après mon expérience, la paperasse d'accès prend généralement plus de temps que le code. C'est l'angle de cette liste. Un modèle que vous ne pouvez pas faire valider ce trimestre ne vous aide pas, peu importe son score. C'est la même raison pour laquelle eesel propose le eesel CLI : un agent de codage IA peut charger des connaissances validées dans un coéquipier eesel et tester ses réponses depuis un terminal, tandis que la connexion du helpdesk lui-même attend encore la validation d'un administrateur.
La réaction de la communauté le jour du lancement disait la même chose :
"What's the point of delaying Daybreak Blue availability, when high-impact CVEs are being dropped several times a week?"

Comment j'ai choisi ces alternatives à GPT-6 Cyber
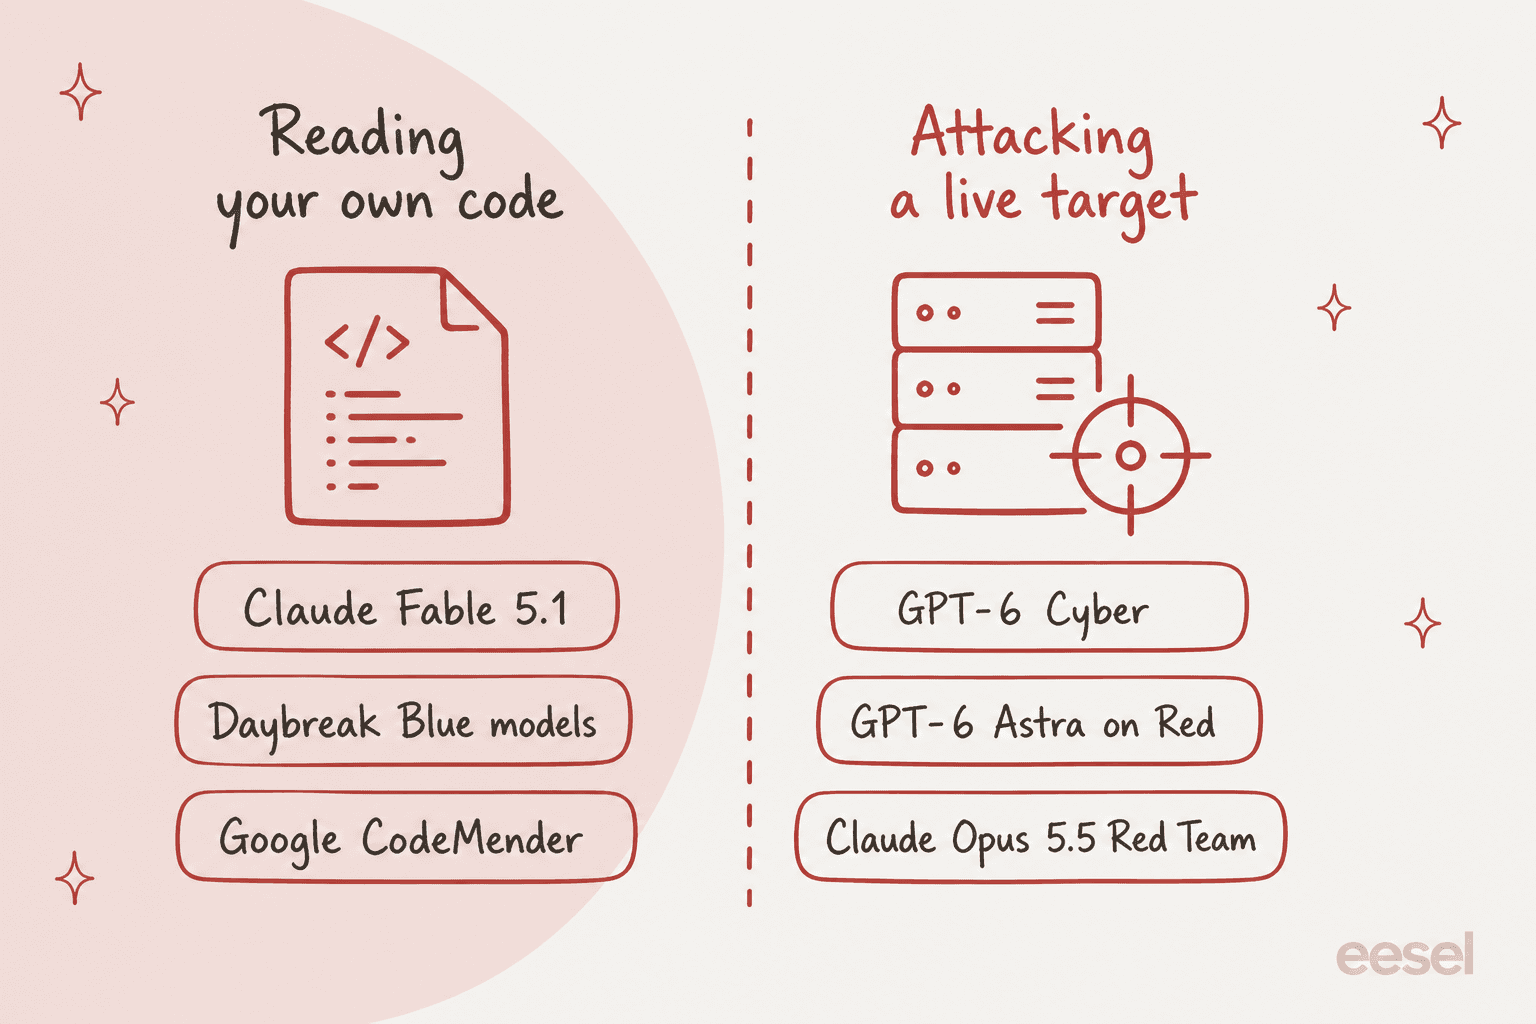
Avant d'écrire, j'ai posé à ChatGPT la question qu'un responsable sécurité poserait, et j'ai vérifié quelles pages il avait lues. Il est allé directement au Cyber Verification Program d'Anthropic, à Claude Mythos et à Google CodeMender. Il a aussi divisé la tâche en deux : lire votre propre code source, et attaquer des systèmes déjà en production. J'ai conservé cette séparation parce qu'elle décide quelle barrière vous devez franchir.
Chaque option ci-dessous a été vérifiée sur les propres pages du fournisseur le 6 novembre 2026. Je les ai notées sur :
- Accès : qui peut postuler, et combien de temps dure l'examen.
- Prix : le tarif publié par token ou par poste, depuis la propre page du fournisseur.
- Adéquation à la tâche : revue de code source, ou exploits contre des cibles en direct.
- Preuves : benchmarks publiés par le fournisseur, avec la réserve que les laboratoires testent surtout sur leurs propres benchmarks.
- Conditions sur les données : règles de conservation, parce que tout programme cyber en exige désormais.
Alternatives à GPT-6 Cyber comparées
| Option | Fournisseur | Barrière d'accès | Attente typique | Prix par 1M de tokens (entrée / sortie) | Exploits contre des cibles en direct ? | Auto-hébergeable | Règle de conservation des données | Idéal pour |
|---|---|---|---|---|---|---|---|---|
| GPT-6 Cyber (référence) | OpenAI | Daybreak Red + validation séparée | D'abord clients sélectionnés | 20 $ / 100 $ | Oui (95 % sur RemoteExploitBench) | Non | Les utilisateurs ZDR doivent utiliser Private Safety Processing | Développement d'exploits distants |
| Claude Opus 5.5 + CVP | Anthropic | CVP Defense ou Red Team Access | Jours (Defense), semaines (Red Team) | 4 $ / 20 $ | Oui, au niveau Red Team | Non | Conservation obligatoire | La plupart des équipes de sécurité |
| Claude Mythos 5.1 | Anthropic | CVP Specialized Access | Examen approfondi avec le gouvernement américain | 10 $ / 50 $ | Oui | Non | Conservation de 30 jours | Testeurs d'infrastructures critiques |
| GPT-6 Astra sur Daybreak Red | OpenAI | Daybreak Red | Examen Red | 10 $ / 50 $ | Partiellement (42,4 % ExploitGym) | Non | Conditions standards OpenAI | Option OpenAI à moitié prix |
| GPT-5.6 Cyber | OpenAI | Daybreak Red uniquement | Examen Red | Non répertorié par son nom | Oui (32,1 % ExploitGym) | Non | Conditions standards OpenAI | Organisations Red en attente de GPT-6 Cyber |
| Modèles Daybreak Blue | OpenAI | Daybreak Blue | Clé matérielle pour les particuliers | GPT-6 Luna 0,10 $ / 0,50 $ | Non | Non | Conditions standards OpenAI | Revue défensive et triage |
| Claude Fable 5.1 | Anthropic | Aucune | Instantané | 10 $ / 50 $ | Non (redirigé vers Opus) | Non | Conditions standards Claude | Revue de code source, sans démarche |
| Google CodeMender | Google Cloud | Ventes ; modèles cyber via Fairwind | Cycle de vente | Contacter les ventes | Preuve de concept dans votre propre sandbox | Les exploits s'exécutent localement | Le code reste dans votre environnement | Pipeline de découverte, preuve et correction |
| GLM-5.3 | Z.ai | Aucune | Instantané | Poids gratuits | Oui, sans supervision d'aucun laboratoire | Oui | À vous de définir | Recherche en air gap |
Quelle alternative à GPT-6 Cyber convient à votre équipe ?
Répondez à deux questions. Chaque chemin se termine par une recommandation et l'étape d'accès pour démarrer aujourd'hui.
Je révise du code qui appartient à mon équipe, ou je triage des rapports de vulnérabilités
Je ne peux attendre aucune candidature
Je peux attendre quelques jours
Je veux un pipeline géré de découverte et de correction
Je mène des pen tests autorisés ou des exercices red team
Nous sommes une organisation et pouvons attendre quelques semaines
Nous avons déjà Daybreak Red
Nous testons des réseaux électriques, des télécoms ou des systèmes aériens
Rien ne peut quitter notre labo en air gap
1. Claude Opus 5.5 avec le Cyber Verification Program
Ce que vous obtenez
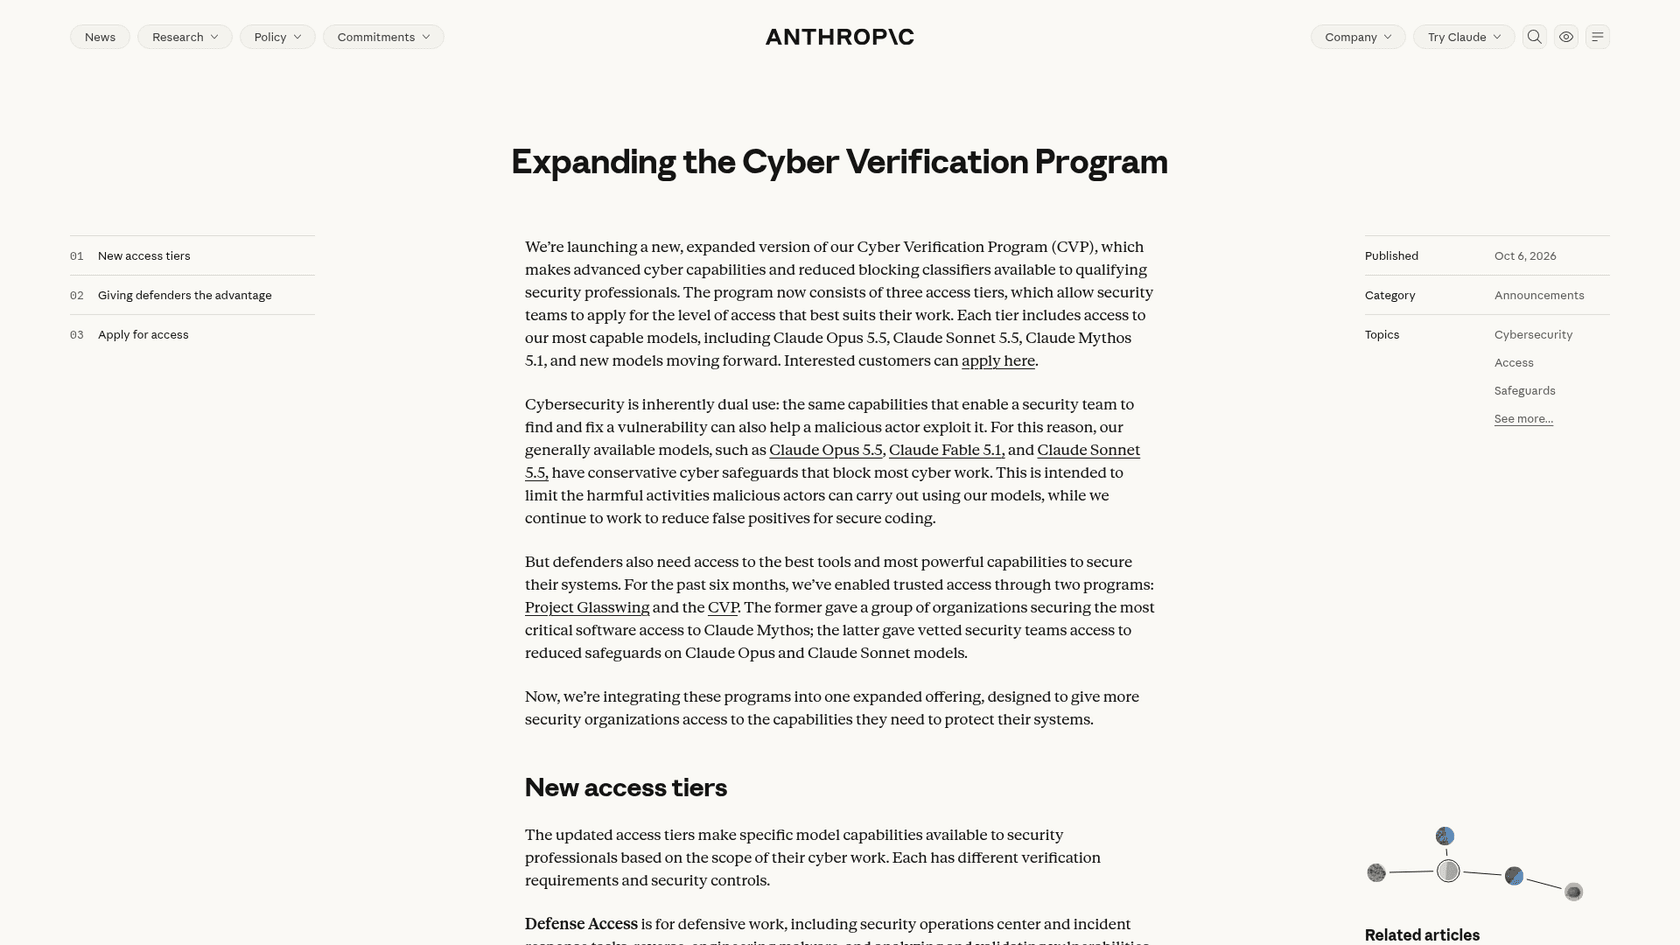
Le 6 octobre 2026, Anthropic a fusionné Project Glasswing et son ancien programme de vérification en un seul Cyber Verification Program à trois niveaux. Claude Opus 5.5 est le modèle que la plupart des équipes y feront tourner. Anthropic a testé les niveaux sur CyScenarioBench, qui mesure des opérations cyber en plusieurs étapes :
- Sans CVP : chaque tâche a été bloquée dès le premier prompt.
- Defense Access : 46 des 50 essais ont été bloqués à un moment donné.
- Red Team Access : aucun blocage, et 34 des 50 tâches complétées, à égalité avec le taux de réussite de 67,6 % d'Opus 5.5 garde-fous désactivés.
Cette dernière ligne est celle qui compte. Au bon niveau, les garde-fous ne coûtent rien de mesurable sur ce benchmark.
Comment obtenir l'accès
Defense Access couvre le travail SOC, la réponse aux incidents, la rétro-ingénierie de malware et la validation de vulnérabilités. Anthropic vise à répondre à ces demandes "en quelques jours". Red Team Access ajoute le pen testing autorisé et prend quelques semaines, et vous êtes placé sur Defense Access en attendant. Red Team Access est réservé aux organisations, les chercheurs individuels ne peuvent pas l'obtenir.
Prix
Opus 5.5 coûte 4 $ en entrée et 20 $ en sortie par 1M de tokens sur la page de tarifs de Claude. C'est un cinquième du tarif de GPT-6 Cyber, aussi bien en entrée qu'en sortie. Voyez les tarifs d'Opus 5.5 pour les tarifs cache et batch.
Ses limites
La conservation des données est obligatoire pour chaque membre du CVP, donc une configuration sans conservation de données doit attendre les Enterprise Frontier Safeguards d'Anthropic, qui selon elle arrivent "plus tard cet automne". Le CVP fonctionne sur Claude Platform, Vertex AI et Microsoft Foundry, mais sur Amazon Bedrock seulement pour les équipes éligibles à ces garde-fous. Et CyScenarioBench est le benchmark propre d'Anthropic, donc il ne se compare pas directement à l'ExploitGym d'OpenAI.
Choisissez cette option si
vous êtes une organisation qui a besoin de tests offensifs et ne peut pas attendre la seconde validation d'OpenAI. Pour un face-à-face sur les modèles généraux, voyez GPT-6 Sol contre Opus 5.5.
2. Claude Mythos 5.1
Ce que vous obtenez
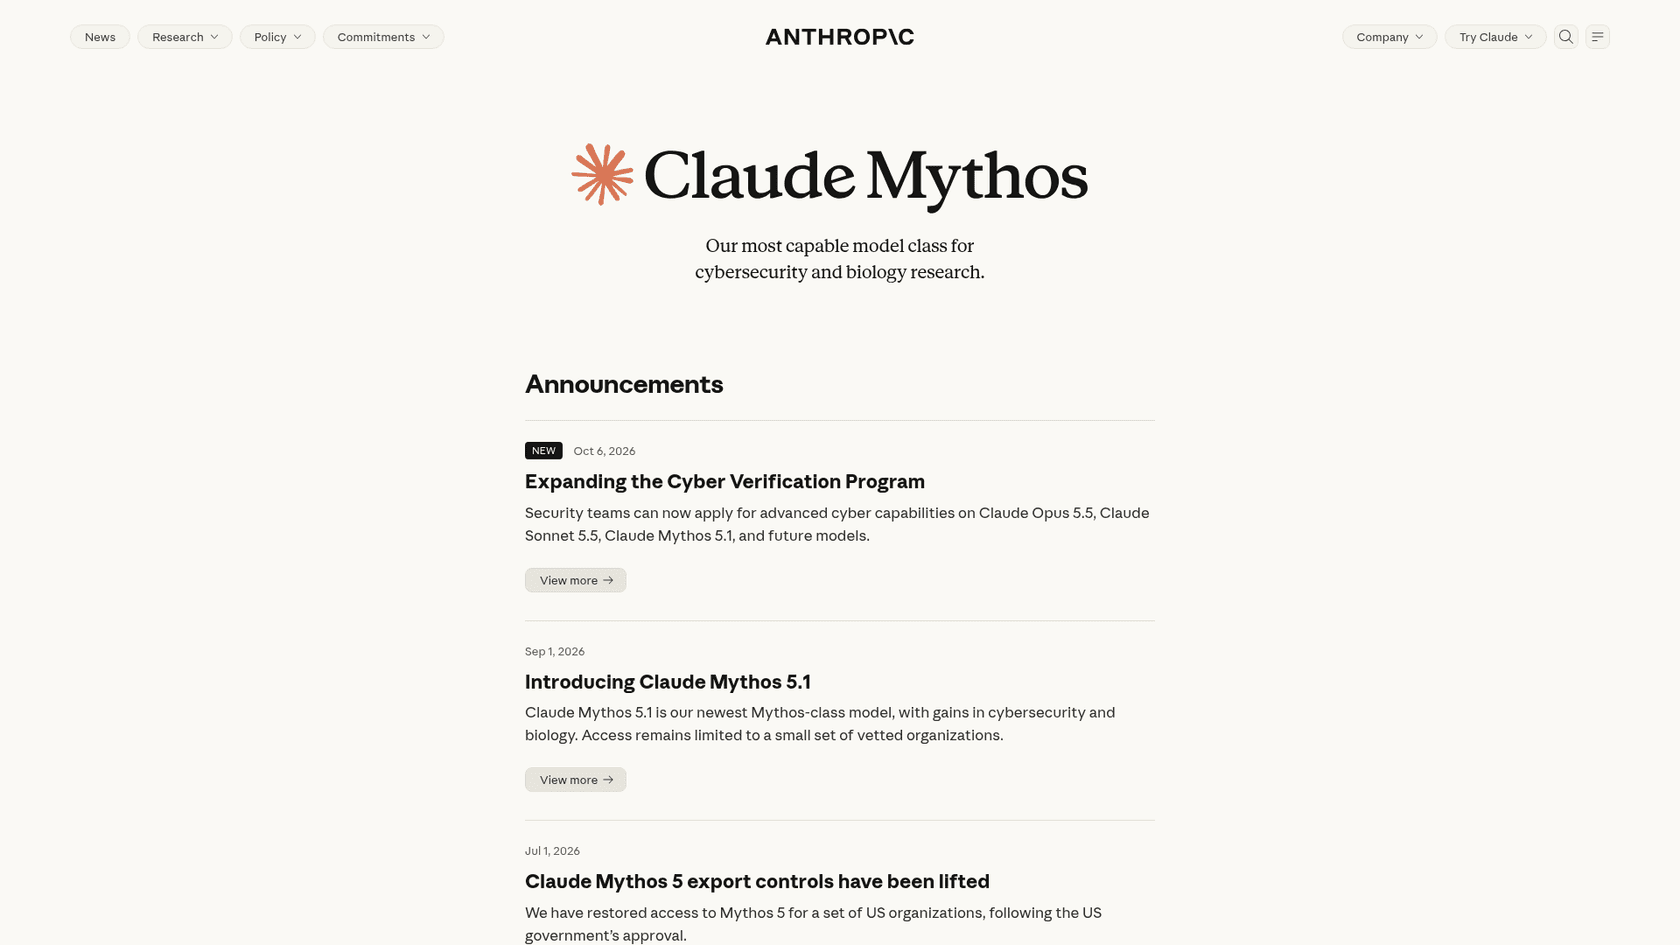
Claude Mythos 5.1 est la correspondance directe la plus proche de GPT-6 Cyber : la "classe de modèle la plus capable d'Anthropic pour la recherche en cybersécurité et en biologie". C'est le même modèle de base que Claude Fable 5.1, avec les garde-fous cyber assouplis pour les utilisateurs validés. Anthropic indique que les partenaires Glasswing utilisant les modèles Mythos ont trouvé au moins 129 000 vulnérabilités vérifiées entre avril et juillet 2026. Elle appelle cela une borne basse, tirée de 33 rapports de partenaires. Le produit de scan et correction d'Anthropic, Claude Security, fonctionne aussi désormais sur Mythos 5.1.
Comment obtenir l'accès
Via le niveau Specialized Access du CVP. Il est réservé aux organisations testant des systèmes "susceptibles d'affecter la vie des personnes ou de perturber des marchés", comme les réseaux électriques, les réseaux télécoms et les transferts interbancaires. Anthropic examine chaque cas en profondeur avec le gouvernement américain. Les membres Glasswing existants sont passés sans nouvelle validation.
Prix
10 $ en entrée et 50 $ en sortie par 1M de tokens, autant que GPT-6 Astra et la moitié de GPT-6 Cyber. Plus de détails dans les tarifs de Mythos 5.1.
Ses limites
La plupart des équipes ne seront pas éligibles. Utiliser Mythos 5.1 signifie aussi accepter par défaut une politique de conservation des données de 30 jours pour la surveillance de sécurité. Si vous ne testez pas d'infrastructures critiques, Opus 5.5 sur Red Team Access est la voie Anthropic la plus réaliste.
Choisissez cette option si
vous défendez des systèmes de la catégorie infrastructure critique et voulez la classe de modèle qu'OpenAI visait. Mon test de Mythos 5.1 couvre l'écart de benchmark avec Fable.
3. GPT-6 Astra sur Daybreak Red
Ce que vous obtenez
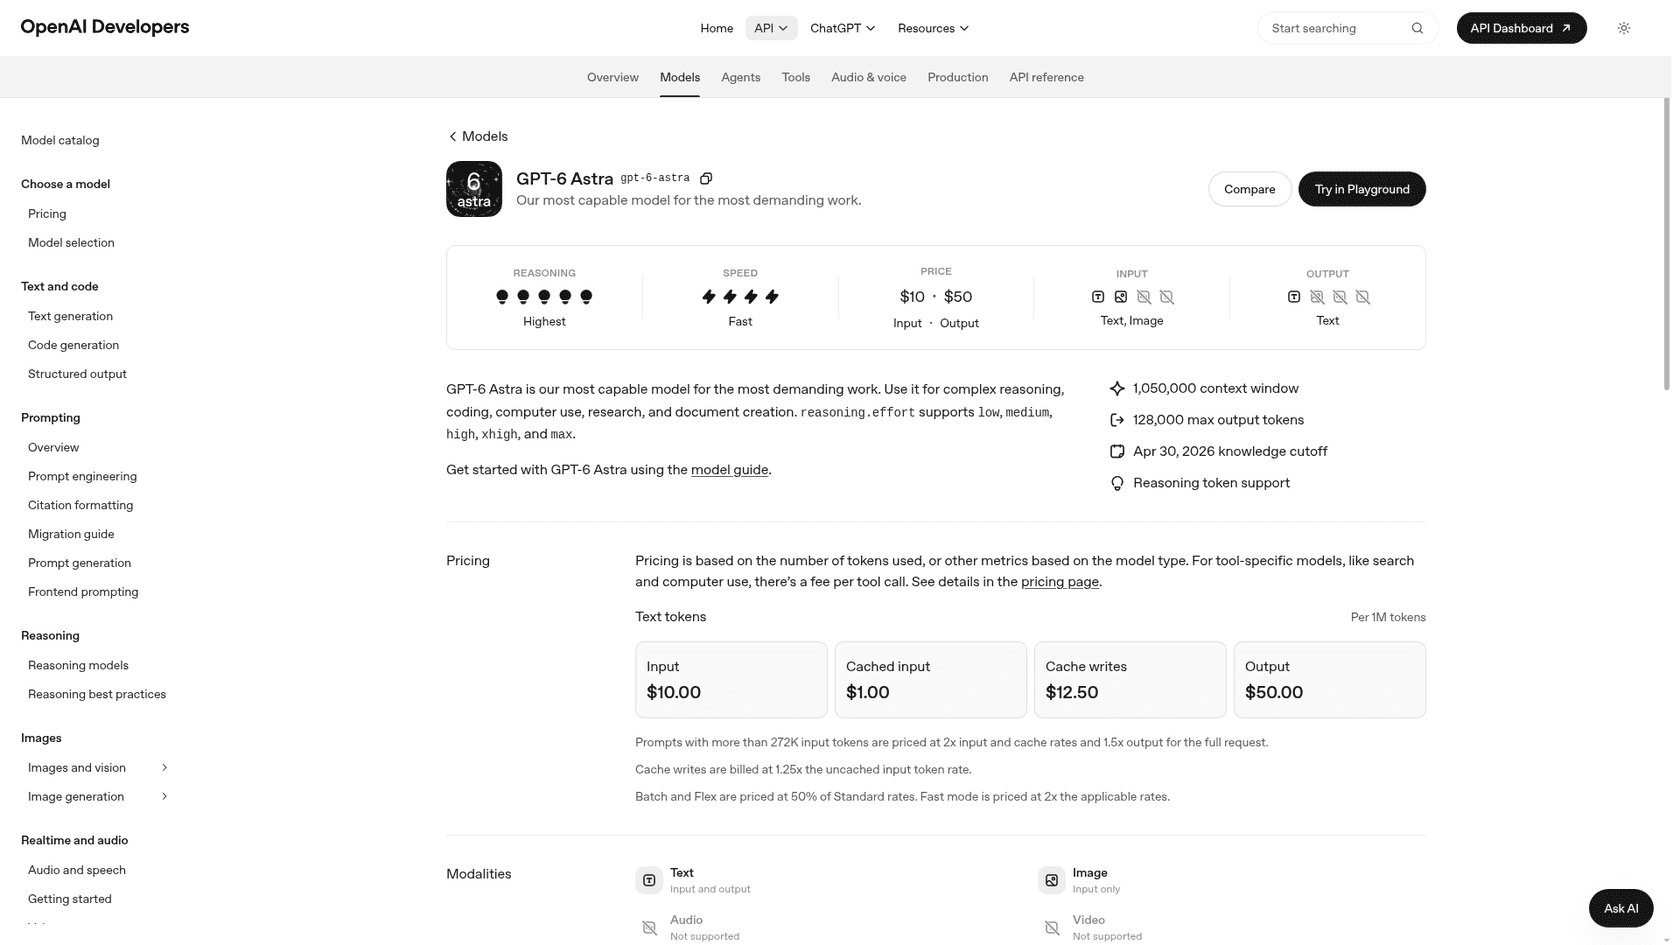
GPT-6 Cyber est "une variante spécialisée en cyber de GPT-6 Astra", selon sa system card. Le modèle de base est donc déjà solide. Dans le propre tableau ExploitGym d'OpenAI, Astra sous Daybreak Blue obtient 42,4 % contre 48,5 % pour GPT-6 Cyber. C'est environ 87 % du score pour la moitié du prix par token. Sur l'évaluation de pen testing web, Astra a trouvé 32,0 % des vulnérabilités contre 40,3 % pour Cyber.
Comment obtenir l'accès
Le guide d'accès liste les refus réduits sur Astra comme une fonctionnalité de Daybreak Red. Sur Blue, Astra garde les garde-fous standards, même si OpenAI indique qu'elle élargit une alpha Blue pour Astra. Notez l'avertissement dans les chiffres : avec les garde-fous standards activés, Astra a obtenu 0,0 % sur ExploitGym.
Prix
10 $ en entrée et 50 $ en sortie par 1M de tokens, avec une entrée en cache à 1 $. Voyez les tarifs de GPT-6 Astra.
Ses limites
Astra sous Blue a refusé 100 % des tâches de RemoteExploitBench, donc l'exploitation à distance est exactement là où il laisse la place à GPT-6 Cyber. Et il vous faut tout de même Red pour les refus réduits.
Choisissez cette option si
vous avez déjà Daybreak Red, que votre travail est surtout du développement d'exploits locaux, et que vous préférez ne pas payer le double. Mon test de GPT-6 Astra le couvre comme modèle général.
"for code review and security checks I think Astra-6 is really great like it'd go so deep and find bugs so small everybody missed that too with using external skills for review."
4. GPT-5.6 Cyber
Ce que vous obtenez
La génération précédente, sortie en août. Avec le lancement de GPT-6 Cyber, OpenAI a rendu GPT-5.6 Cyber disponible pour chaque client Daybreak Red, sans validation de modèle séparée. Il obtient 32,1 % sur ExploitGym, donc vous perdez environ 16 points par rapport à GPT-6 Cyber. Côté alignement, GPT-5.6 Cyber est resté dans le cadre dans 94,49 % des tests honeypot d'OpenAI, contre 99,93 % pour GPT-6 Cyber.
Comment obtenir l'accès
Seulement la validation Daybreak Red. Si vous êtes déjà sur Red, c'est la version que vous pouvez utiliser dès aujourd'hui.
Prix
La grille tarifaire d'OpenAI ne liste pas de ligne gpt-5.6-cyber nommément. Mon article sur les tarifs de GPT-5.6 Cyber suit comment cette ligne a changé.
Ses limites
Le taux hors cadre compte plus que l'écart de benchmark. Environ 5 tests honeypot sur 100 ont visé des services que le modèle n'était pas censé toucher, donc gardez-le dans un sandbox avec revue des actions.
Choisissez cette option si
vous détenez Red et voulez démarrer cette semaine pendant que votre validation GPT-6 Cyber est en attente. L'ancienne liste alternatives à GPT-5.6 Cyber montre à quel point le terrain a bougé en trois mois.
5. Modèles Daybreak Blue (GPT-6 Sol, GPT-6 Luna)
Ce que vous obtenez
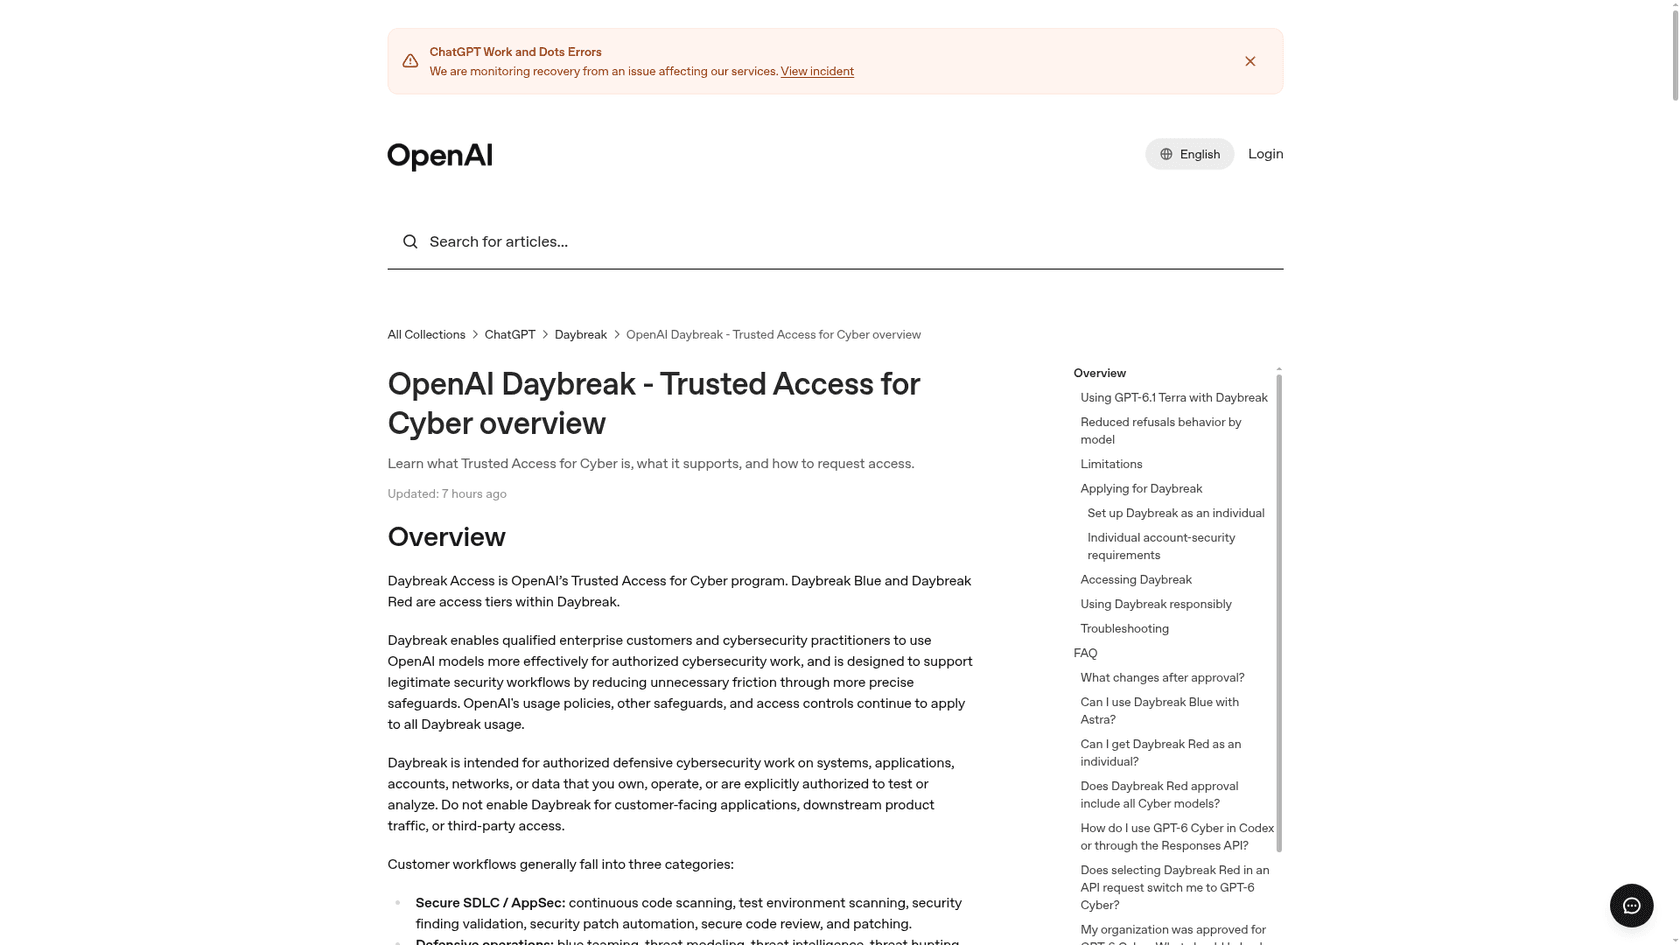
Daybreak Blue donne des refus réduits sur les modèles principaux pris en charge, dont GPT-5.5, GPT-5.6 Sol, GPT-6 Sol et GPT-6 Luna. Il couvre la revue de code sécurisée, le triage de vulnérabilités, l'ingénierie de détection, la réponse aux incidents, l'analyse de malware et la validation de correctifs. OpenAI le présente comme le point de départ recommandé pour la plupart des équipes de sécurité.
Comment obtenir l'accès
Les organisations postulent via le formulaire Daybreak. Les particuliers postulent sur chatgpt.com/cyber, et ont besoin d'un plan payant éligible, d'Advanced Account Security, et d'au moins une clé de sécurité matérielle FIDO2. Une passkey synchronisée ne compte pas. Autre piège du guide : la validation seule n'active rien. Vous définissez access_programs.cyber dans la Responses API, ou vous activez le commutateur Daybreak dans Codex.
Prix
GPT-6 Luna coûte 0,10 $ en entrée et 0,50 $ en sortie par 1M de tokens. GPT-6.1 Sol est à 2 $ / 10 $, mais notez que 6.1 Sol garde les garde-fous standards sur Blue et n'obtient des refus réduits que sur Red.
Ses limites
Aucun modèle spécialisé en cyber, et aucun exploit contre des cibles distantes. Astra garde ici les garde-fous standards.
Choisissez cette option si
votre travail est défensif et que vous vivez dans les outils d'OpenAI, en particulier Codex ou Codex Security.
"For defensive purposes, do I only need Daybreak Blue? I assume it's much easier to get Daybreak Blue access than Daybreak Red."
Selon le guide d'OpenAI, la réponse est plutôt oui.
6. Claude Fable 5.1 (sans candidature)
Ce que vous obtenez
Claude Fable 5.1 est le même modèle de base que Mythos 5.1, livré avec des garde-fous cyber et biologie. Depuis septembre, ces garde-fous sont plus étroits : Fable 5.1 peut désormais identifier des vulnérabilités logicielles dans du code source. L'article CVP d'Anthropic indique aussi que ses modèles en disponibilité générale peuvent toujours faire de la revue de code, corriger des problèmes connus et trouver des bugs dans votre propre code source.
Comment obtenir l'accès
Une clé API normale. Pas de formulaire, pas d'examen.
Prix
10 $ en entrée et 50 $ en sortie par 1M de tokens, avec des lectures de cache à 0,25 $. Détails dans les tarifs de Fable 5.1.
Ses limites
Le pen testing, la génération d'exploits et le scan de vulnérabilités basé sur des binaires sont toujours délégués à un modèle Opus quand les garde-fous se déclenchent. Pour tout ce qui vise une cible en direct, vous revenez à une demande de CVP.
Choisissez cette option si
vous voulez qu'un modèle de pointe révise votre code cet après-midi même. Si votre équipe travaille déjà dans Claude Code, voyez la sécurité de Claude Code pour les permissions.
7. Google CodeMender
Ce que vous obtenez
CodeMender est un agent, pas un modèle. Il scanne, puis prouve, puis corrige. Il construit votre code et exécute un exploit de preuve de concept dans un sandbox géré par le client pour confirmer qu'une découverte est réelle. Il écrit ensuite un correctif, vérifie le patch avec un juge LLM, et remet aux développeurs un diff à valider. Il prend en charge C/C++, Java, Python, TypeScript/JavaScript, Go, Rust et Ruby, et fonctionne avec les découvertes de Wiz.
Comment obtenir l'accès
CodeMender fonctionne sur la Gemini Enterprise Agent Platform de Google, via les ventes. Les propres modèles cyber de Google sont plus restreints. La page CodeMender indique que Gemini 3.8 Flash Cyber est exclusif aux clients et gouvernements du Fairwind Program. Fairwind liste plus de 650 partenaires, et un sous-ensemble d'entre eux obtient Gemini 4 Argon à l'intérieur de CodeMender.
Prix
Non publié. La page propose seulement "Contact sales".
Ses limites
Il est conçu pour votre propre base de code, pas pour faire du pen testing sur le réseau de quelqu'un d'autre. Et sans Fairwind, vous vous retrouvez sur les modèles généraux, pas sur les modèles cyber de Google.
Choisissez cette option si
vous préférez que la boucle découverte, vérification et correction soit gérée pour vous, plutôt que de construire votre propre harnais autour d'un modèle brut.
8. GLM-5.3 (poids ouverts)
Ce que vous obtenez
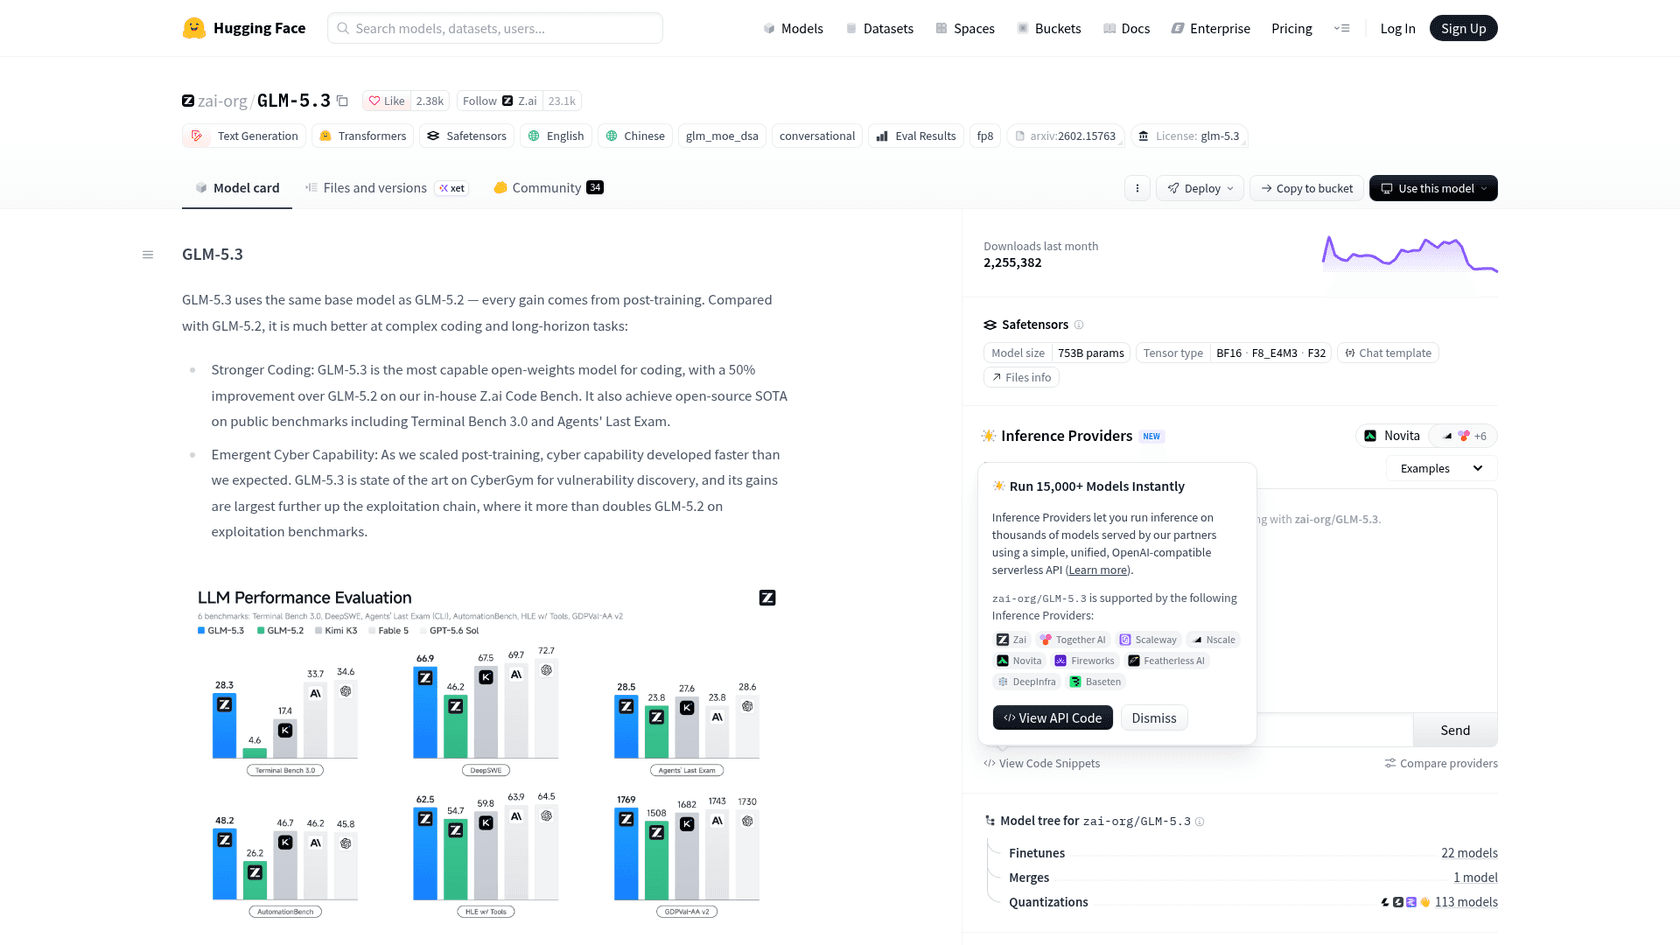
GLM-5.3 de Z.ai est le modèle le plus puissant que vous puissiez télécharger. Sa fiche modèle indique que la compétence cyber "s'est développée plus vite que prévu" pendant le post-entraînement. Dans le propre tableau de Z.ai, GLM-5.3 domine CyberGym avec 84,5, mais sur ExploitBench il obtient 54,4 contre 76,5 pour GPT-5.6 Sol. Le CAISI du NIST l'a qualifié de modèle à poids ouverts le plus capable en cyber publié à ce jour, environ quatre mois derrière la frontière américaine, comme cité dans l'analyse d'Anthropic.
Comment obtenir l'accès
Téléchargez les poids depuis Hugging Face. Personne n'examine votre cas d'usage.
Prix
Les poids sont gratuits. Votre facture, c'est le matériel pour faire tourner un modèle de cette taille.
Ses limites
Aucun laboratoire ne surveille les mauvais usages, et ça joue dans les deux sens. Anthropic a découvert que les refus intégrés de GLM-5.3 pouvaient être contournés 64 % du temps avec une fausse histoire, 92 % avec un raisonnement pré-rempli, et 100 % une fois abliteré. Pour une équipe de sécurité, le problème est le contrôle du périmètre, pas l'éthique. GPT-6 Cyber est resté dans le cadre dans 99,93 % des tests honeypot d'OpenAI. Avec GLM-5.3, c'est votre propre sandbox et vos propres règles d'engagement qui font ce travail.
Choisissez cette option si
votre travail ne peut pas quitter un labo en air gap, ou que vous avez besoin de rétro-ingénierie sans aucun refus. Le plus petit GLM-5.3 Flash fonctionne avec moins de matériel.
"Full 5.3 has a scary-good grasp of debugging assembly, QEMU and hex dumps in my experience, it would make for a good “sleuth” model to find potential vulns."
Que coûte vraiment chaque option ?
Les prix par token ne se comparent qu'entre choses comparables. Voici les tarifs de sortie publiés, côte à côte :
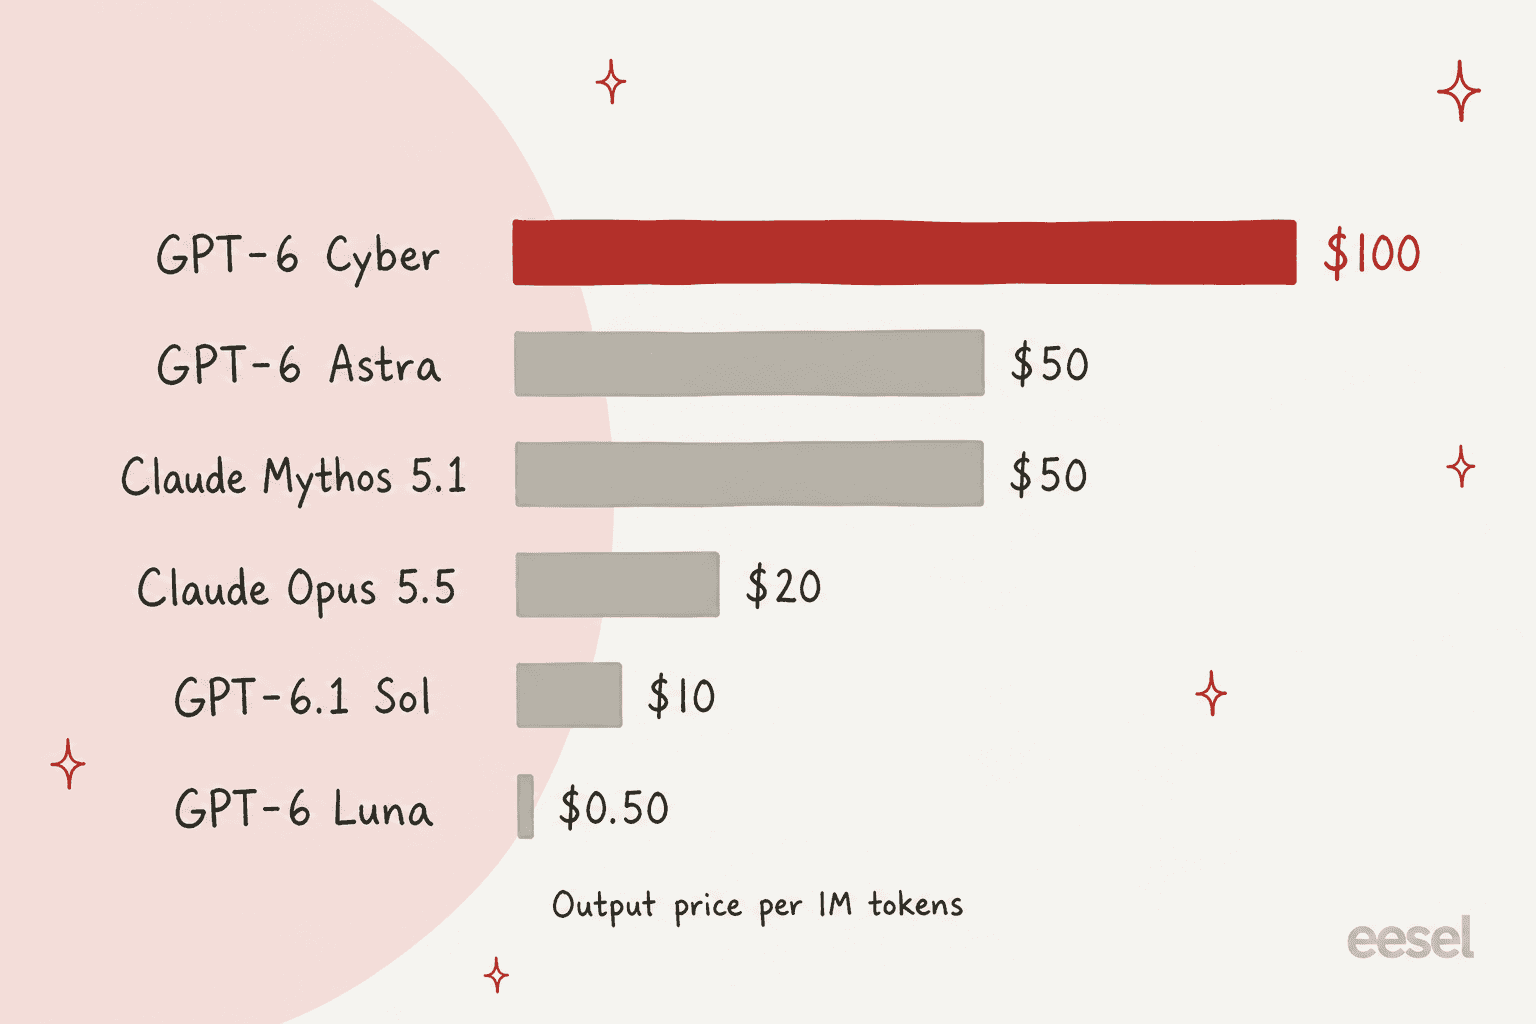
Le graphique cache deux choses. D'abord, le travail cyber consomme beaucoup de sortie, parce que le modèle écrit du code d'exploit et des rapports, donc c'est la colonne sortie qui fait mal. Ensuite, un modèle moins cher qui refuse la moitié de vos tâches n'est pas moins cher. C'est pour ça que le niveau d'accès compte autant que le tarif.
Si vous préférez acheter un produit plutôt qu'un modèle, quelques outils de sécurité publient leurs prix sur leurs propres sites :
| Produit | Prix publié | Ce que c'est |
|---|---|---|
| Strix | Pro 29 $ par poste et par mois, les pentests facturés par test | Agent de pentest et de revue de PR, essai de 7 jours |
| MindFort | Starter 499 $/mois (250 crédits), Scale 999 $/mois (800 crédits) | Agents de pentest continu |
| GitHub security | Secret Protection 19 $, Code Security 30 $ par committer actif et par mois | Scan et autofix dans le dépôt |
| XBOW | Demander un devis | Pentesting autonome |
| Anthropic OSS Scanner | Gratuit pour les projets acceptés | Scans périodiques pour des projets open source critiques |
Les mainteneurs open source disposent d'une seconde voie gratuite via Patch the Planet d'OpenAI, menée avec Trail of Bits, Calif et HackerOne.
Quelle est la difficulté pour ouvrir chaque porte ?
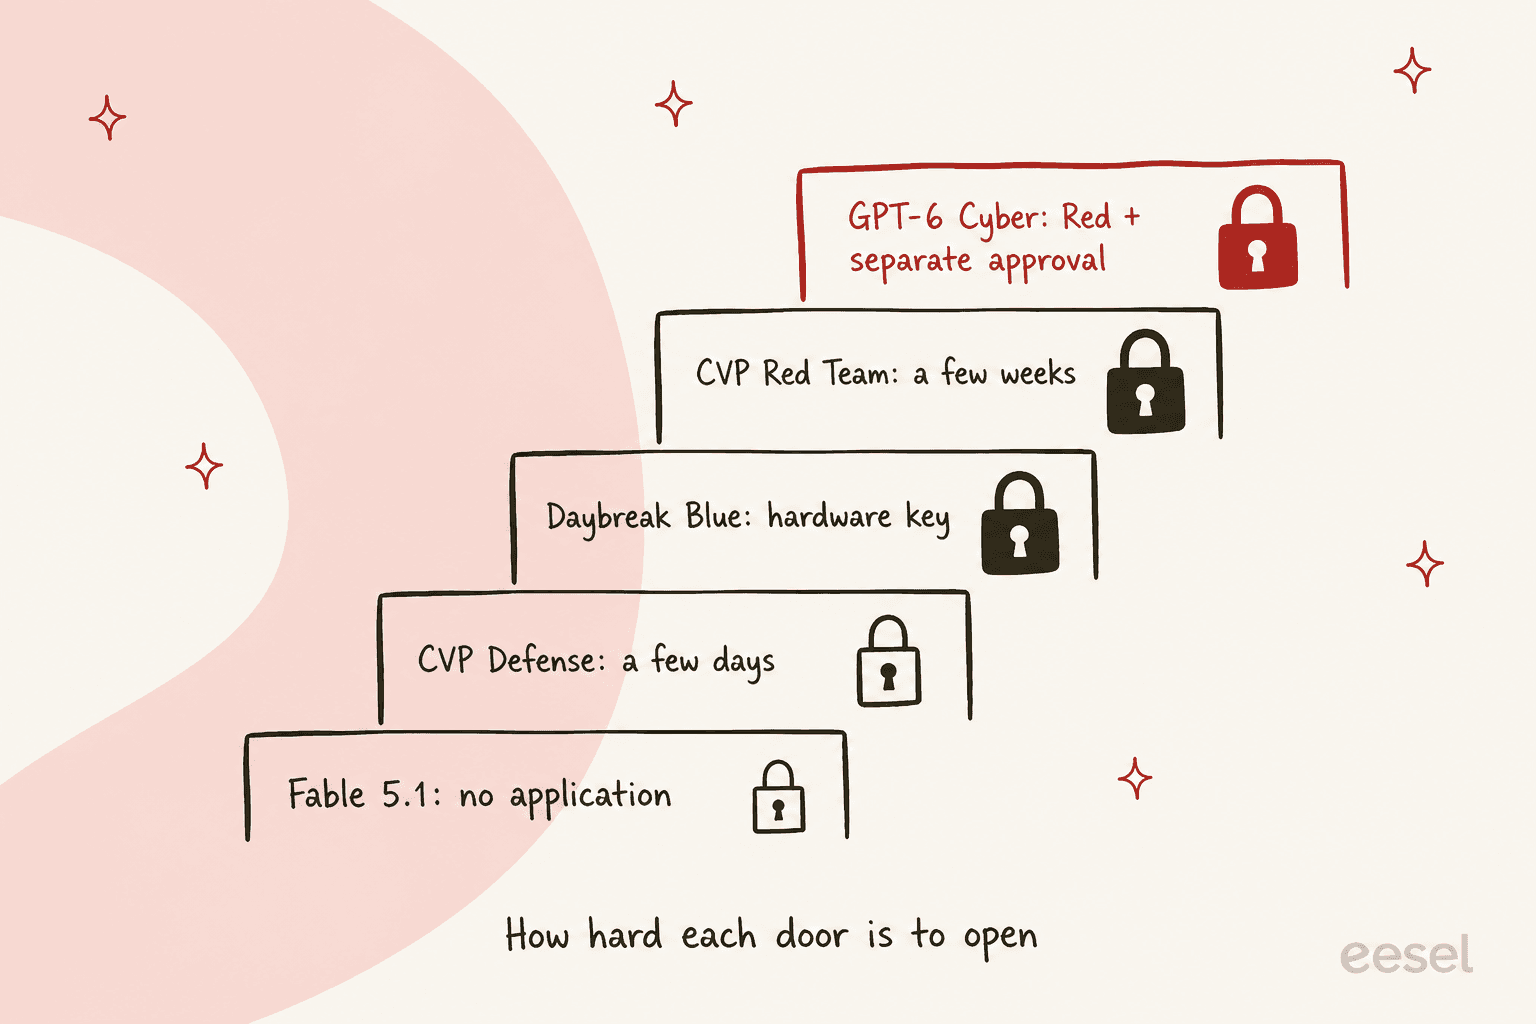
Mon conseil, c'est de postuler en parallèle. Lancez le Defense Access d'Anthropic et le Daybreak Blue d'OpenAI le même jour, puis montez en gamme quand votre travail l'exige. Les deux laboratoires demandent désormais des preuves de contrôles de sécurité et une certaine conservation des données. C'est le même examen que je vois du côté support : la checklist de sécurité fournisseur IA qu'un client fait passer à eesel ressemble beaucoup à ce qu'Anthropic demande à un candidat Red Team.
Que se passe-t-il une fois la vulnérabilité trouvée ?
Les modèles cyber deviennent très bons sur la première moitié du travail. GPT-6 Cyber a produit des tests reproductibles pour 81 vulnérabilités Firefox de forte sévérité. Les partenaires Mythos en ont consigné 129 000. Chacune devient un avis de sécurité, puis un correctif, puis une vague d'e-mails "sommes-nous concernés ?" dans la boîte de support de quelqu'un.
C'est cette seconde moitié où je passe mon temps. Un modèle cyber, c'est de l'infrastructure. eesel est le coéquipier qui gère les conversations qui suivent. Le coéquipier IA helpdesk d'eesel rejoint votre helpdesk existant, apprend de vos tickets passés, de votre centre d'aide et de l'avis que vous venez de publier, et est testé sur des tickets historiques avant de répondre à qui que ce soit.
Timengo est un bon exemple. C'est une entreprise danoise d'e-mail sécurisé et de Digital Post qui fait tourner eesel sur Freshdesk. Le coéquipier rédige des réponses de support technique en danois à partir d'environ 5 300 tickets et articles d'aide passés, en a préparé 300 en un mois, et a écrit 180 brouillons, qu'un ingénieur support relit avant envoi. À plus grande échelle, SE Ranking fait tourner un agent par produit sur trois connexions Zendesk et a traité 4 650 conversations en un mois.
Pendant un incident, ça compte, parce que le nouvel avis et sa FAQ peuvent entrer comme connaissance dans l'heure, et vous pouvez poser des questions test au coéquipier avant que les clients ne le fassent. Il y a un guide dans gérer des agents IA depuis le terminal.

Vous sortez un correctif cette semaine ? Essayez eesel sur votre centre d'aide et voyez comment il répond aux questions sur la faille avant que vos clients ne commencent à demander. Plus de détails sur le fonctionnement de ces coéquipiers dans coéquipiers IA.
Alors, quelle alternative à GPT-6 Cyber choisir ?
- La plupart des équipes de sécurité : demandez dès aujourd'hui CVP Defense Access et faites tourner Claude Opus 5.5. Passez à Red Team Access si vous faites du pen testing.
- Entreprises OpenAI pour du travail défensif : Daybreak Blue sur GPT-6 Sol ou Luna, comme le recommande OpenAI elle-même.
- Déjà sur Daybreak Red : GPT-5.6 Cyber maintenant, Astra pour du travail d'exploitation à moitié prix, GPT-6 Cyber une fois validé.
- Infrastructure critique : Mythos 5.1 via CVP Specialized Access, ou Daybreak Red for Critical Infrastructure.
- En air gap ou sans candidature : Fable 5.1 pour le code source, GLM-5.3 si rien ne peut quitter le labo.
GPT-6 Cyber est le bon outil quand votre travail consiste à faire fonctionner des exploits contre des cibles distantes et que vous pouvez attendre la seconde validation d'OpenAI. Pour tout le reste, la porte que vous pouvez ouvrir cette semaine vaut mieux que le modèle que vous ne pouvez pas.