Alternatives à GPT-5.6-Cyber : 9 options utilisables en 2026

Kira

Katelin Teen
Dernière modification August 10, 2026
Si vous êtes ici parce que GPT-5.6-Cyber se trouve derrière une barrière que vous ne pouvez pas franchir, la première chose à savoir est que ce n'est pas une particularité d'OpenAI. C'est le schéma du secteur, et OpenAI n'a même pas été le premier. Project Glasswing d'Anthropic a été lancé le 7 avril 2026, plus de deux mois avant Daybreak. Gemini 3.5 Flash Cyber de Google est encore plus fermé, réservé aux "governments and trusted partners" dans un pilote limité.
Le geste le plus utile pour la plupart des défenseurs est le Cyber Verification Program d'Anthropic. Il est gratuit, tranché sous deux jours ouvrés, et il ajuste le blocage des usages duels à haut risque qui entrave le travail de sécurité légitime sur Claude Opus 5. Un prix publié de $5 et $25 par million de tokens, disponible maintenant, face à une candidature de durée inconnue pour un modèle au prix non publié.
En dessous, le tableau réel est meilleur que ce que le débat laisse croire. Il existe de vrais outils de sécurité IA achetables avec des prix publiés : Strix à $29 par siège, MindFort à partir de $199 par mois, GitHub Code Security à $30 par committer. Et si vous ne voulez aucun fournisseur, DeepSeek V4 Flash est sous licence MIT et publie un score Cybergym de 76,7.
Si vous cherchez la comparaison générale de modèles plutôt que l'angle cyber, GPT-5.6 alternatives est la meilleure page.
Tout le monde a verrouillé le modèle cyber
Je construis des agents IA pour gagner ma vie, donc la première chose que j'ai remarquée dans le lancement de GPT-5.6-Cyber n'était pas l'affirmation sur la capacité. C'était à quel point le schéma était familier.
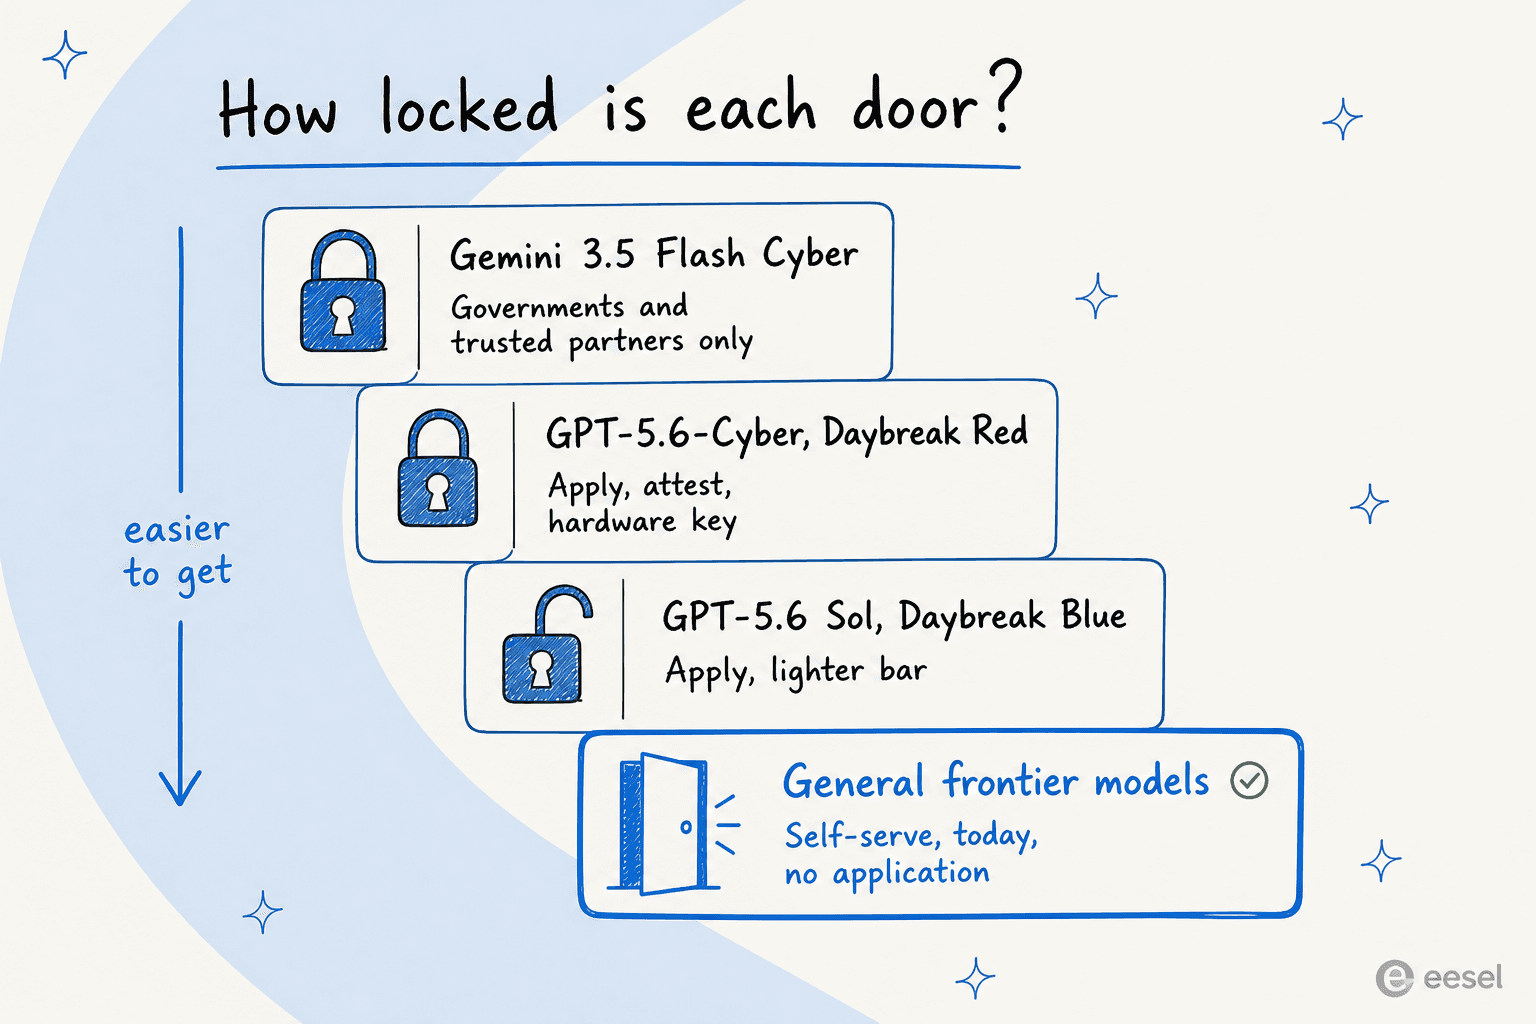
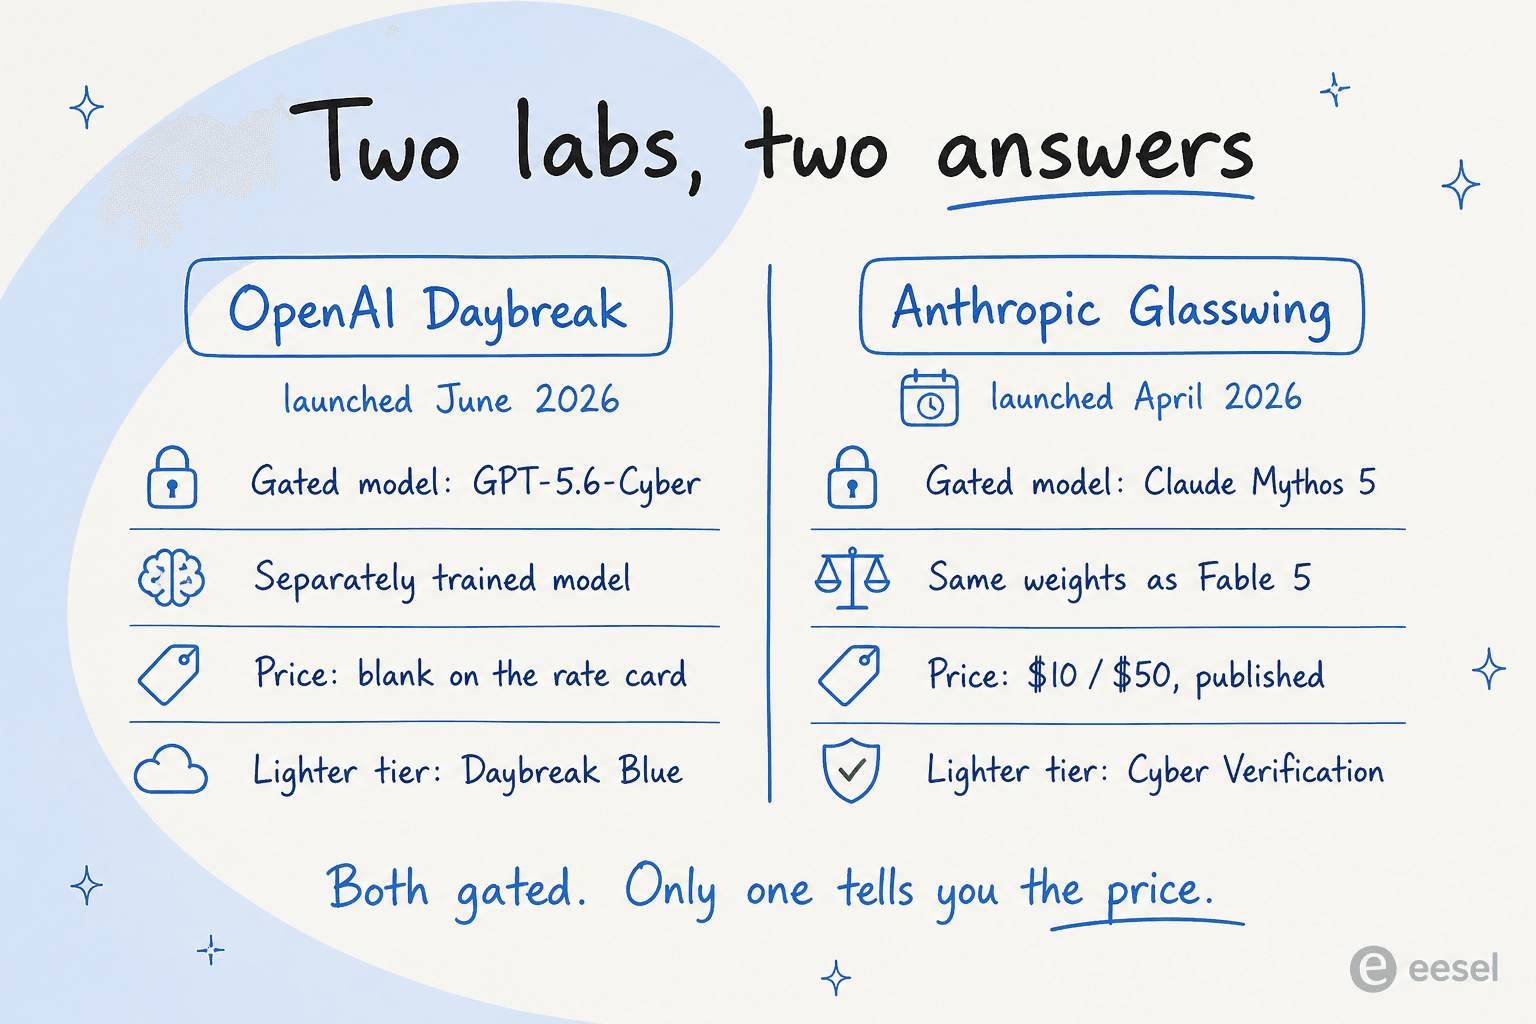
Chaque laboratoire de pointe a désormais construit la même chose : un modèle cyber spécialisé et verrouillé, avec un niveau plus léger en dessous pour tous les autres. Les différences sont dans les détails, et c'est dans les détails que se trouve le vrai conseil.
Deux d'entre elles comptent assez pour être énoncées clairement avant la liste.
L'architecture d'Anthropic est plus propre. Claude Mythos 5 et Claude Fable 5 reposent sur les mêmes poids, selon la page produit d'Anthropic ; seuls les garde-fous diffèrent. OpenAI a entraîné GPT-5.6-Cyber séparément, c'est pourquoi il bat Sol sur la découverte de zero-days et lui cède sur la rédaction de rapports. Une approche donne un modèle différent avec des compromis différents. L'autre donne le même modèle, freins relâchés.
Un seul vous dit le prix. Anthropic publie Mythos 5 à $10 et $50 par million de tokens. La grille tarifaire d'OpenAI comporte une ligne Cyber avec des tirets littéraux, que nous avons examinée dans l'analyse du prix de Cyber.
Comment j'ai choisi ces neuf options
Trois filtres, appliqués honnêtement.
Elle doit être accessible. Soit vous pouvez la payer aujourd'hui, la télécharger aujourd'hui, ou candidater via un processus avec un délai publié. "Contact sales" sans prix ni calendrier n'a pas été retenu comme recommandation, même si j'ai nommé ceux qui fonctionnent ainsi pour que vous sachiez les écarter.
Le prix doit être vérifiable. Chaque chiffre ci-dessous provient de la page de tarifs, de la fiche de modèle ou de la fiche marketplace du fournisseur lui-même, vérifiées le 11 août 2026.
L'affirmation de capacité doit venir du fournisseur. Je ne les ai pas comparées entre elles. Là où un benchmark cyber existe, je l'ai cité en nommant la source ; là où il n'en existe pas, je le dis plutôt que d'en laisser entendre un.
Le tableau comparatif
| # | Option | Type | Libre-service ? | Prix d'entrée | Prix publié ? | Auto-hébergement ? | Score cyber du fournisseur | Idéal pour |
|---|---|---|---|---|---|---|---|---|
| 1 | Daybreak Blue | Niveau de modèle verrouillé | Candidature | Sol à $5 / $30 par 1M | Oui, le tarif de Sol | Non | ExploitBench 73,5 % | Rester sur OpenAI |
| 2 | Anthropic CVP | Programme d'accès gratuit | Candidature, 2 jours ouvrés | Opus 5 à $5 / $25 par 1M | Oui | Non | Cyber fallbacks en baisse de 85 % par rapport à Fable 5 | La plupart des défenseurs |
| 3 | Claude Mythos 5 | Modèle verrouillé | Sur invitation uniquement | $10 / $50 par 1M | Oui | Non | ExploitBench Cap% 78 | Partenaires Glasswing |
| 4 | Gemini 3.6 Flash | Modèle généraliste | Oui | $1,50 / $7,50 par 1M | Oui | Non | Non publié | Le quasi-frontière le moins cher |
| 5 | DeepSeek V4 Flash | Poids ouverts, MIT | Oui | $0,14 / $0,28 par 1M | Oui | Oui, ~167 Go | Cybergym 76,7 | Aucun fournisseur |
| 6 | Strix | Pentest autonome | Oui, carte | $29 / siège / mois | Partiellement | Oui, Apache-2.0 | Non publié | Petites équipes |
| 7 | MindFort | Pentest continu | Oui | $199 / mois | Oui | Non | Non publié | Plancher publié le plus bas |
| 8 | GitHub Advanced Security | Scan et autofix | Oui | $30 / committer / mois | Oui | Non | Non publié | Déjà sur GitHub |
| 9 | Horizon3 NodeZero | Pentest autonome | Via AWS Marketplace | $25 000 / 12 mois | Sur la marketplace uniquement | Non | Non publié | Achats en entreprise |
Interactif
Qu'est-ce qui vous bloque vraiment ?
Choisissez la contrainte qui pèse le plus. Le reste de la liste n'est que du bruit tant que celle-ci n'est pas résolue.
La catégorie des usages duels à haut risque est exactement ce qui vous bloque, et c'est celle que CVP ajuste. Gratuit, tranché sous deux jours ouvrés, sur Opus 5 à $5 et $25 par 1M.
Candidatez aussi à : Daybreak Blue, si vous êtes déjà sur OpenAI. Autre fournisseur, même solution, aucune raison de ne pas mener les deux candidatures en parallèle.
À vérifier d'abord : CVP exige la conservation des données activée, n'est pas disponible sur Google Vertex AI, et n'est pas disponible sur Opus 5 via Amazon Bedrock.
<div class="altpick-card ap-b">
  <span class="altpick-tag">Choisissez : GitHub, Strix ou MindFort</span>
  <p>Tous trois publient un chiffre que vous pouvez citer dès aujourd'hui : $30 par committer, $29 par siège, $199 par mois. Pas d'appel, pas de réunion de cadrage.</p>
  <p class="altpick-alt"><strong>Le changement réel le moins cher :</strong> GitHub Code Security, car le code est déjà là et CodeQL ainsi que Copilot Autofix sont gratuits sur les dépôts publics.</p>
  <p class="altpick-warn"><strong>Attention :</strong> Strix facture les pentests au test en plus du tarif par siège, et ce tarif par test n'est pas publié.</p>
</div>

<div class="altpick-card ap-c">
  <span class="altpick-tag">Choisissez : DeepSeek V4 Flash</span>
  <p>Licence MIT, environ 167 Go sur disque, servable sur un seul nœud GB300 à 4 voies. Aucune politique d'utilisation acceptable, aucune restriction de domaine d'usage, rien sur l'usage dual nulle part dans la licence.</p>
  <p class="altpick-alt"><strong>À envisager aussi :</strong> GLM-5.2 sur un nœud H200 à 8 voies, également MIT. La CLI Apache-2.0 de Strix s'exécute en local avec votre propre clé de modèle.</p>
  <p class="altpick-warn"><strong>Le piège :</strong> la licence ne vous libère que si vous hébergez vous-même. Les API hébergées de plusieurs de ces laboratoires interdisent purement et simplement le scan de vulnérabilités, sans exception pour les tests autorisés.</p>
</div>

<div class="altpick-card ap-d">
  <span class="altpick-tag">Choisissez : GitHub Advanced Security</span>
  <p>Votre goulot d'étranglement est la correction, pas la découverte. Copilot Autofix génère des correctifs pour 90 % des types d'alertes en JavaScript, TypeScript, Java et Python, et les livre sous forme de changements relisables.</p>
  <p class="altpick-alt"><strong>Option gratuite :</strong> Buttercup de Trail of Bits est sous AGPL-3.0 et ne coûte rien de plus que vos propres factures de modèle.</p>
  <p class="altpick-warn"><strong>Pas ça :</strong> un modèle de pointe plus permissif. Plus de découvertes, c'est l'opposé de ce dont vous avez besoin en ce moment.</p>
</div>

<div class="altpick-card ap-e">
  <span class="altpick-tag">Choisissez : MindFort ou Strix</span>
  <p>Tous deux font du pentest autonome avec preuve d'exploitation, et tous deux vous laissent démarrer sans appel commercial. MindFort publie jusqu'à 2 pentests par mois à $199 ; Strix facture au test sur un siège à $29.</p>
  <p class="altpick-alt"><strong>À l'échelle de l'entreprise :</strong> Horizon3 NodeZero coûte $25 000 pour douze mois à 500 actifs sur AWS Marketplace, un vrai prix de contrat publié.</p>
  <p class="altpick-warn"><strong>À écarter pour l'instant :</strong> XBOW, RunSybil et Terra Security. Tous compétents, aucun ne vous donnera un prix sans réunion.</p>
</div>
Une remarque sur cette colonne "score cyber du fournisseur", car c'est ce qui se lit le plus facilement de travers ici. Ces chiffres ne sont pas comparables entre eux. Ce sont des benchmarks différents, exécutés par des laboratoires différents, avec des réglages de garde-fous différents. Le Cap% 78 d'Anthropic, en particulier, est une échelle de capacité à 16 flags, pas un taux de réussite, et il a été mesuré avec tous les garde-fous désactivés. Anthropic le dit lui-même et prévient que les résultats "may not be directly comparable to public leaderboard entries." Utilisez la colonne pour voir si un fournisseur publie quoi que ce soit, pas pour les classer.
1. Daybreak Blue (GPT-5.6 Sol)
Idéal pour : les équipes déjà standardisées sur OpenAI qui veulent supprimer la friction sans changer de fournisseur.
Ce que c'est. L'autre moitié du même programme. Daybreak Blue vous donne des modèles de pointe généralistes, Sol compris, avec les garde-fous cyber au niveau système retirés. OpenAI l'appelle "the recommended starting point for most defenders" et nomme les charges de travail : découverte de vulnérabilités, revue de code sécurisée, analyse de malware, réponse aux incidents, validation de correctifs.
Accès. Les particuliers vérifient leur identité sur la page cyber de ChatGPT ; les organisations utilisent le formulaire entreprise. Aucun délai publié. Les clés de sécurité matérielles deviennent obligatoires pour les comptes individuels le 1er septembre 2026.
Tarifs. Le tarif standard de Sol, $5 en entrée et $30 en sortie par million de tokens en contexte court, doublant à $10 et $45 en contexte long. Le batch les divise par deux. Détail complet dans notre guide des prix de GPT-5.6, et le modèle phare seul dans l'article sur les prix de Sol. Des niveaux moins chers existent si la charge le permet : Terra à $2 et $12, Luna à $0,20 et $1,20.
Verdict. À prendre si vous restez sur OpenAI, en comprenant ce que cela change et ce que cela ne change pas. Sur le jeu de prompts cyber avancés d'OpenAI, Blue fait passer le taux d'achèvement de 1,5 % à 2,0 %, il ne débloquera donc pas le travail sur les chaînes d'exploits. Ce qu'il débloque, c'est le travail défensif ordinaire qui se faisait attraper par la couche de filtrage. C'est un vrai problème résolu, simplement plus petit que le nom du niveau ne le suggère.
2. Anthropic Cyber Verification Program
Idéal pour : presque tous ceux qui lisent ceci. C'est la recommandation.
Ce que c'est. Anthropic répartit le travail cyber bloqué en deux catégories. Prohibited use couvre des choses "almost always used maliciously and have little to no legitimate defensive application such as mass data exfiltration or ransomware code development", et n'est pas ajustable. High Risk Dual use couvre le travail ayant des "legitimate defensive applications, such as vulnerability exploitation or offensive security tooling development", et cette catégorie est ajustable via le Cyber Verification Program.
Accès. Candidature gratuite auprès de votre organisation existante, avec une décision par e-mail "within 2 business days". Il couvre les modèles de classe Opus et Sonnet, pas Mythos 5. Anthropic publie aussi une voie de recours et admet franchement le taux d'erreur : "We expect to occasionally decline eligible applications incorrectly, and approved users may still experience blocks on legitimate work."
Tarifs. Le programme est gratuit. Vous payez le tarif normal du modèle : Claude Opus 5 à $5 en entrée et $25 en sortie par million de tokens, ou Sonnet 5 à $2 et $10. Une date à noter : le tarif de Sonnet 5 est promotionnel et passe à $3 et $15 après le 31 août 2026. Notre test d'Opus 5 détaille ce que vous obtenez réellement.
Verdict. C'est la réponse pour la plupart des gens, et sans comparaison. Deux jours ouvrés contre une revue Daybreak sans échéance, une candidature gratuite et un prix publié sur un modèle déjà excellent. Anthropic indique aussi que le trafic Opus 5 "ran into cyber fallbacks 85% less than Fable 5", ce qui se rapproche le plus de ce que quiconque publie à côté du tableau des taux d'achèvement d'OpenAI. Les vrais pièges sont des trous de couverture à vérifier d'abord : CVP exige la conservation des données activée, n'est pas disponible du tout sur Google Vertex AI, et n'est pas disponible sur Opus 5 via Amazon Bedrock.
3. Claude Mythos 5 via Project Glasswing
Idéal pour : les organisations assez grandes pour être invitées, ce qui est la formulation honnête.
Ce que c'est. Le véritable équivalent de Daybreak Red, et celui qui a été lancé en premier. Glasswing a démarré le 7 avril 2026 avec 12 partenaires nommés dont AWS, Apple, Cisco, CrowdStrike et la Linux Foundation, et s'est élargi en juin à environ 150 organisations supplémentaires. Les partenaires ont trouvé "more than 10,000 high- or critical-severity security flaws".
Accès. Sur invitation uniquement. Il n'existe pas de voie en libre-service, ce qui en fait une barrière plus dure que la voie individuelle d'OpenAI.
Tarifs. $10 en entrée et $50 en sortie par million de tokens, indiqués à la fois dans l'article de lancement et sur la page produit de Mythos. Mythos Preview était à $25 et $125, le modèle cyber verrouillé est donc devenu 60 % moins cher entre avril et juin.
Verdict. À comprendre même si vous ne pouvez pas y accéder, car cela recadre tout le débat. Anthropic verrouille un modèle dont il publie le prix et dont les poids sont identiques à ceux d'un modèle disponible pour tous. C'est une décision de politique habillée de très peu, et elle rend plus difficile à soutenir l'idée que "la capacité est le secret". Si vous comparez les deux laboratoires en général, Claude contre GPT-5.6 couvre le versant hors cyber.
4. Gemini 3.6 Flash
Idéal pour : les équipes qui veulent un modèle généraliste capable, au comportement de refus réglé pour le cyber, sans aucune candidature.
Ce que c'est. Le modèle de travail de Google, sorti le 21 juillet 2026. Le détail pertinent se trouve dans sa note de sécurité : 3.6 Flash est livré avec des garde-fous Frontier Safety renforcés contre le mésusage offensif en cyber, et Google dit que "the model has been trained to minimize refusals for beneficial uses." C'est le même problème que résout Daybreak, traité dans le modèle de base plutôt que derrière une candidature.
Accès. Entièrement en libre-service via Google AI Studio et l'API Gemini. Pas de formulaire, pas d'attestation.
Tarifs. $1,50 en entrée et $7,50 en sortie par million de tokens, ce qui est inférieur de plus de moitié à Sol en entrée. L'analyse de Gemini 3.6 Flash donne le tableau complet, et GPT-5.6 contre Gemini 3 couvre le face-à-face.
Verdict. La meilleure option sans friction si vous ne voulez candidater à rien. Deux limites honnêtes. Google ne publie aucun benchmark cyber pour 3.6 Flash, vous faites donc confiance à l'affirmation sur les refus sans chiffre à l'appui. Et le modèle spécialisé, Gemini 3.5 Flash Cyber, est réservé aux gouvernements et aux partenaires de confiance au sein de CodeMender, une barrière plus étroite que tout ce qu'exploitent OpenAI ou Anthropic. À savoir aussi : la fiche de modèle de Gemini 3.1 Pro indique elle-même que le cyber "has reached the alert threshold" et que Google continue de "deploy mitigations in this domain", la friction pourrait donc augmenter plutôt que diminuer.
5. DeepSeek V4 Flash
Idéal pour : les équipes qui ne veulent aucune relation avec un fournisseur, aucune politique d'utilisation acceptable, et personne qui lise leurs prompts.
Ce que c'est. Le seul modèle de cette liste qui soit bon marché, téléchargeable, sous licence MIT et accompagné d'un chiffre cyber publié par le fournisseur. Sa fiche de modèle indique Cybergym 76,7, contre 83,1 pour Claude Opus 4.8 sur la même ligne.
Accès. Téléchargez les poids. Environ 167 Go sur disque, servable sur un seul nœud GB300 à 4 voies avec la commande publiée par DeepSeek elle-même.
Tarifs. $0,14 en entrée et $0,28 en sortie par million de tokens sur l'API hébergée, soit environ 107 fois moins cher que le tarif de sortie de Sol. Un avertissement qui change le calcul : la page de tarifs de DeepSeek annonce désormais une "significant increase", sans date. Tout budget bâti sur ces chiffres a une date d'expiration annoncée.
Verdict. La plus solide des vraies échappatoires ici, avec une grande réserve sur la porte que vous empruntez. MIT veut dire MIT : aucune restriction de domaine d'usage, aucune politique d'utilisation acceptable, rien sur l'usage dual nulle part dans la licence. C'est catégoriquement différent de toutes les options hébergées ci-dessus. Mais cette liberté n'existe que si vous hébergez vous-même. Passez par l'API de DeepSeek et vous êtes de retour sous des conditions d'utilisation, et les 6,4 points d'écart sur Cybergym avec Opus 4.8 sont la mesure honnête de ce à quoi vous renoncez.
Notre test de DeepSeek V4 Flash couvre le tableau général des capacités, et le face-à-face avec GPT-5.6 est la comparaison la plus équivalente que quiconque ait publiée.
6. Strix
Idéal pour : les petites équipes de sécurité qui veulent du pentest autonome dès aujourd'hui pour le prix d'un déjeuner.
Ce que c'est. Du pentest autonome sur les API, les applications web, le code et les pull requests, l'infrastructure et le cloud, avec preuve d'exploitation pour chaque découverte et des pull requests d'autofix prêtes à fusionner. Il embarque une vraie boîte à outils offensive : un proxy d'interception HTTP, de l'exploitation navigateur pour le XSS et le contournement d'authentification, l'exécution de shell et un bac à sable Python pour les exploits de preuve de concept.
Accès. Les deux portes sont ouvertes. Paiement par carte avec 7 jours d'essai gratuit, ou clonage. Le dépôt Strix est sous Apache-2.0, avec 50 707 étoiles et un dernier push le 10 août 2026. Exécuter la CLI en local exige Docker et votre propre clé de modèle.
Tarifs. Pro est à $29 par siège et par mois avec "pentests billed separately, pay per test". Enterprise est sur mesure et ajoute un déploiement VPC ou on-prem ainsi que la prise en charge de votre propre modèle.
Verdict. Le produit le plus authentiquement en libre-service de la catégorie, et la voie open source permet de l'évaluer sans aucune conversation avec le fournisseur. Soyez lucide sur le prix, cependant : le prix par test n'est pas publié, donc $29 est un tarif par siège, pas la facture. C'est une vraie lacune dans une fiche par ailleurs exceptionnellement transparente, et c'est la première question à poser pendant l'essai.
7. MindFort
Idéal pour : les équipes qui veulent un chiffre mensuel publié à inscrire sur une ligne de budget sans passer d'appel.
Ce que c'est. Des agents IA qui réalisent du pentest continu, de la revue de code de sécurité, de la revue de pull requests et du patching, chaque découverte étant livrée sous forme de PR validée, retestée et prête à fusionner. Il place aussi des agents de sécurité dans Slack.
Accès. Inscription en libre-service sur les deux niveaux payants, avec une évaluation initiale offerte. Seul Enterprise passe par une démo.
Tarifs. Growth démarre à $199 par mois pour 400 crédits et jusqu'à 2 pentests. Scale démarre à $999 par mois pour 800 crédits et jusqu'à 4 pentests. Les packs de crédits offrent des remises de volume jusqu'à 30 %, et la facturation du dépassement est optionnelle pour que les évaluations continuent au-delà de zéro.
Verdict. Le plancher publié le plus bas de la catégorie, et la réponse la plus claire à "que puis-je obtenir pour moins de $250 par mois". Deux réserves. Les affirmations de la page d'accueil, moins de 1 % de faux positifs et premiers résultats en quelques heures, sont des affirmations du fournisseur, non vérifiées de manière indépendante. Et la description même du niveau Growth dit "scope and usage are tailored in the demo", l'inscription en libre-service peut donc encore déboucher sur une conversation. Le prix est publié, ce qui le place déjà devant la plupart du secteur.
8. GitHub Advanced Security
Idéal pour : quiconque a déjà son code sur GitHub, soit la plupart des gens.
Ce que c'est. Désormais scindé en deux modules complémentaires facturés séparément. Code Security couvre CodeQL et Copilot Autofix sur les dépôts privés, la revue des dépendances et les règles de tri automatique de Dependabot. Secret Protection couvre les contrôles de validité, l'analyse de secrets par Copilot pour les secrets non structurés comme les mots de passe, et les contrôles de push protection.
Accès. Entièrement en libre-service. Activez-le depuis les paramètres du dépôt, sans appel, avec un essai de 30 jours disponible.
Tarifs. $30 par committer actif et par mois pour Code Security, $19 pour Secret Protection. CodeQL et Copilot Autofix sont gratuits sur les dépôts publics, quel que soit le forfait, et GitHub affirme qu'Autofix génère des correctifs pour 90 % des types d'alertes en JavaScript, TypeScript, Java et Python.
Verdict. La correction de vulnérabilités assistée par IA crédible la moins chère de cette liste, et celle avec le moins de friction d'adoption puisque le code est déjà là. Ce n'est pas un produit de pentest et il ne poursuivra pas une chaîne d'exploits, il résout donc une autre partie du problème que Strix ou MindFort. Si votre lacune est "nous trouvons des choses et ne les corrigeons jamais", c'est la réponse directe, et elle démarre à zéro sur le code public.
9. Horizon3.ai NodeZero
Idéal pour : les entreprises qui ont besoin d'un vrai contrat et ont du budget AWS Marketplace à consommer.
Ce que c'est. Du test d'intrusion autonome à l'échelle de l'entreprise, vendu par actifs plutôt que par sièges.
Accès. Verrouillé par une démo sur son propre site, mais entièrement tarifé sur AWS Marketplace. Cette porte dérobée mérite d'être connue en général, car c'est là que plusieurs fournisseurs de cette catégorie publient des chiffres qu'ils ne mettent pas sur leurs propres sites.
Tarifs. D'après la fiche marketplace : $25 000, $32 500 et $42 500 pour douze mois de Core, Pro et Elite à 500 actifs, plus $15 000 pour un test Flex ponctuel.
Verdict. À inclure dans une présélection seulement si votre problème est l'échelle d'entreprise et les achats, pas l'accès. Il mérite sa place pour le schéma qu'il illustre : quand le site d'un fournisseur dit "contact sales", vérifiez les marketplaces cloud avant de supposer que le prix est un secret. XBOW publie de la même façon $50 000 pour douze mois de crédits d'attaque Enterprise.
Le récit édifiant : XBOW
Il mérite une section à part, car c'est l'illustration la plus nette de la direction que prend ce marché.
XBOW est le fournisseur qui a publiquement plaidé contre le verrouillage des capacités cyber de pointe. Son article d'avril 2026 sur GPT-5.5 le dit sans détour : "Capability doesn't vanish when you gate it. It gets rediscovered, leaked, replicated." Il qualifie l'accès restreint de "private club" et nomme ceux qui en sont exclus : "the mom-and-pop business, the regional hospital, the mid-market company with a part-time security lead."
En novembre 2025, XBOW a lancé Pentest On-Demand explicitement comme "self-serve, on-demand, self-explanatory", avec "no scoping meeting required" et un prix entre $4 000 et $6 000 selon celle de ses deux pages d'annonce que vous lisez.
Aujourd'hui, l'URL vers laquelle ces deux articles renvoient comme lieu d'achat redirige vers un formulaire de prospection pour démo, et la page de tarifs est un formulaire "Request Pricing" dont le seul langage tarifaire est "Pricing is scoped to your environment."
Je veux être équitable, car l'argument de XBOW est bon et l'entreprise fait un vrai travail : elle revendique plus de 14 000 zero-days découverts dans des applications clientes et une première place au classement HackerOne. Mais le fournisseur qui plaidait le plus fort pour un accès démocratisé a supprimé son propre niveau en libre-service en neuf mois. Cela vous en dit sur l'économie de cette catégorie plus qu'aucune prise de position ne le changera.
Ce que les gens comprennent de travers : "utilisez simplement Kimi K3"
C'est le conseil le plus courant dans les fils Hacker News sur le verrouillage cyber, et il est à moitié juste d'une manière qui compte.
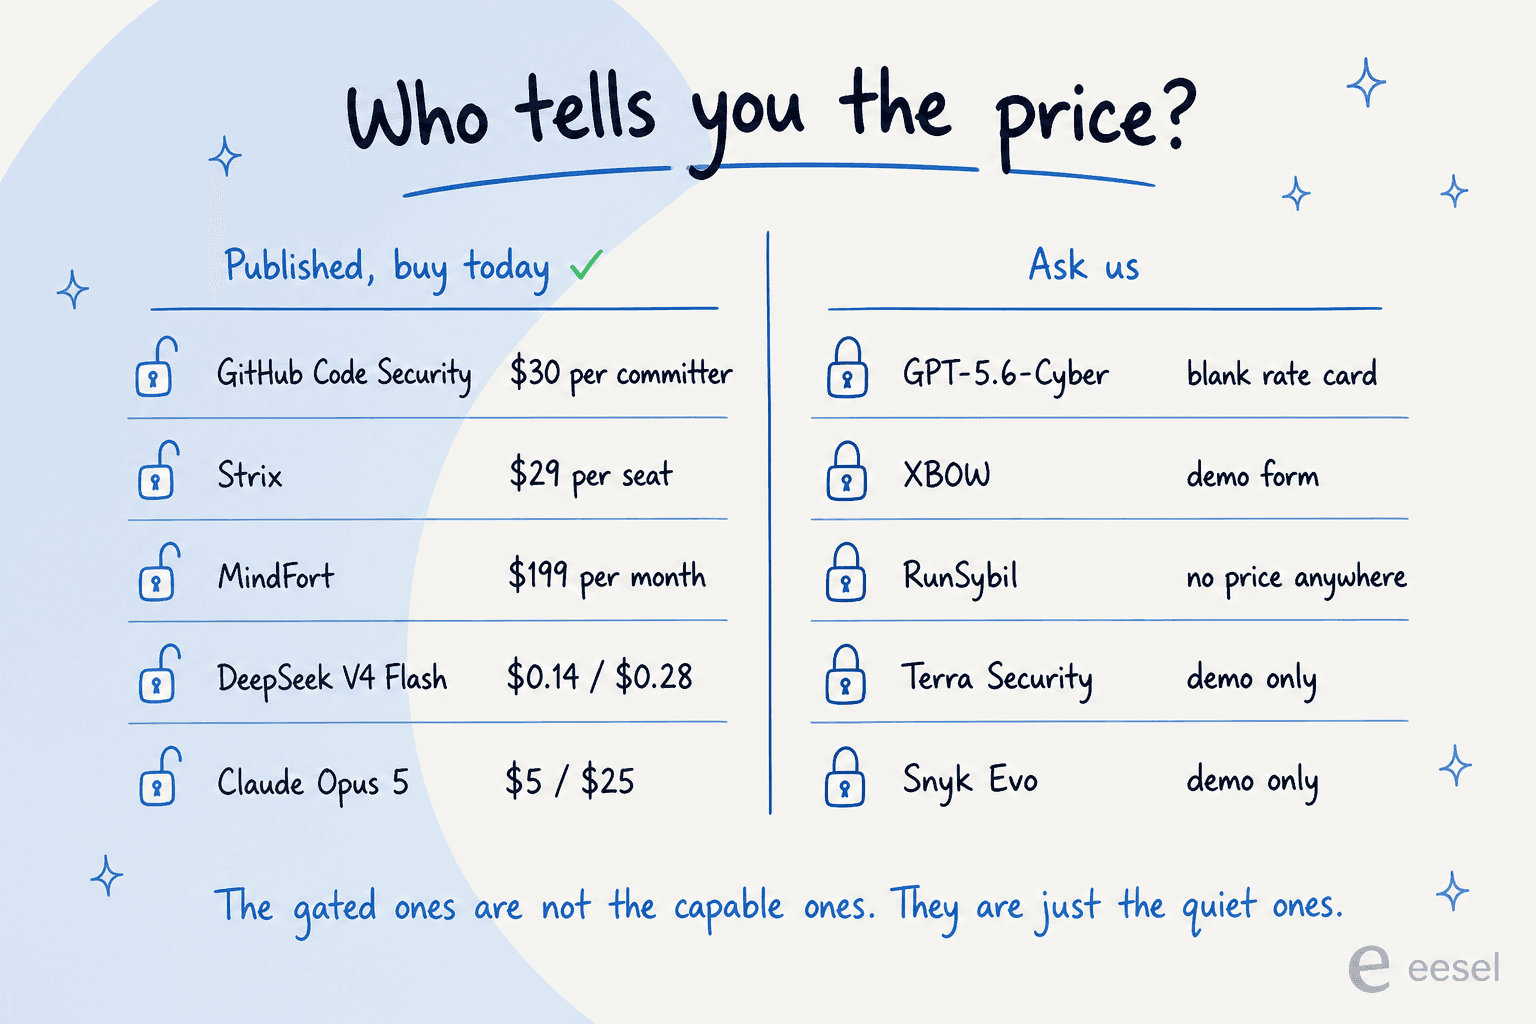
L'argument de la licence est entièrement juste. La licence personnalisée de Kimi K3, la MIT de DeepSeek V4 et la MIT de GLM-5.2 ne contiennent aucune politique d'utilisation acceptable, aucune restriction de domaine d'usage, et aucune mention du cyber ou de l'usage dual. Le seul langage de conduite dans tout le fichier de licence de Kimi K3 est "must comply with applicable laws." Face à un modèle hébergé avec analyse des prompts et revue humaine du contenu signalé, c'est une différence catégorique, pas marginale.
Le conseil d'exécution est faux sur deux points précis.
Premièrement, la licence ne vous libère que si vous hébergez réellement vous-même, et la voie de l'API hébergée est pire que ce que vous avez quitté. Les conditions de Moonshot interdisent "providing programs or tools specifically designed for engaging in activities that endanger network security, such as network intrusion", sans exception pour les tests autorisés. Les conditions de QwenCloud d'Alibaba interdisent toute tentative de "probe, test, or scan the vulnerability of any System", également sans exception. Les deux sont plus strictes sur l'outillage offensif que la politique de Google. Résilier un abonnement ChatGPT pour des crédits d'API Moonshot ne vous fait échapper à rien.
Deuxièmement, Kimi K3 est le mauvais modèle à citer. À $3 et $15 par million de tokens, c'est l'option à poids ouverts la plus chère, deux fois Gemini 3.6 Flash en sortie et dans la fourchette de Sol. Ses poids pèsent 1,56 To, et la propre recette de service de Moonshot exige "at least 8x GB300. Multi-node for real production traffic." Il est recommandé parce qu'il est le plus récent, pas parce qu'il est pratique, comme le confirment notre test de Kimi K3 et l'article sur les prix de K3. DeepSeek V4 Flash, avec ses 167 Go, est la version de cet argument qui survit au contact d'un budget matériel.
Troisièmement, et c'est le plus inconfortable : personne ne peut réellement mesurer l'écart avec GPT-5.6-Cyber, car OpenAI n'a publié aucune system card pour lui. Toute affirmation du type "les poids ouverts sont proches maintenant" est mesurée par rapport à Sol, pas par rapport au modèle derrière la barrière.
Ce que je ferais réellement
Classé par ordre, en supposant que vous avez un vrai programme de sécurité et un cycle budgétaire qui n'attendra pas.
- Candidatez dès aujourd'hui au Cyber Verification Program d'Anthropic. Gratuit, deux jours ouvrés, prix du modèle publié. Aucune raison de ne pas l'avoir en route pendant que vous décidez du reste.
- Candidatez à Daybreak Blue en parallèle si vous êtes déjà sur OpenAI. Également gratuit, et il retire la couche de filtrage qui bloque le travail défensif ordinaire.
- Activez GitHub Code Security si votre code est sur GitHub. À $30 par committer, c'est la chose la moins chère de cette liste qui change quoi que ce soit, et c'est gratuit sur les dépôts publics.
- Essayez Strix ou MindFort selon que vous préférez le tarif par siège ou par mois. Les deux sont en libre-service, les deux publient un plancher, et Strix offre une voie Apache-2.0 si vous voulez évaluer sans aucun fournisseur.
- Ensuite seulement, envisagez l'auto-hébergement. DeepSeek V4 Flash ou GLM-5.2 sont de vraies options avec des licences permissives, mais c'est une décision d'investissement et de personnel, pas un changement d'abonnement.
Ce qui ne figure pas sur cette liste, c'est d'attendre Daybreak Red. Si votre travail en a vraiment besoin, candidatez. Mais n'en faites pas le plan, car c'est une candidature sans délai publié pour un modèle sans prix publié et sans system card.
Essayer eesel
Autre problème, même leçon. Je passe mes journées à construire des agents IA qui touchent des données clients réelles, et le schéma de cet article est celui que je rencontre constamment : la capacité est rarement le goulot d'étranglement, c'est la surface de contrôle.
C'est autour de cela qu'eesel est construit. Avant qu'un agent IA ne réponde à un seul vrai client, vous le simulez sur des milliers de vos propres tickets passés et voyez exactement ce qu'il aurait dit. Puis vous le limitez aux types de tickets en lesquels vous avez confiance et escaladez le reste.
Chaque action d'outil est journalisée, et les plus sensibles passent par une approbation humaine, la version file de support de la discipline de bac à sable et de périmètre que recommande chaque laboratoire de cet article. C'est aussi ce qui rend une revue de sécurité surmontable, et la même logique monte en puissance jusqu'au travail de niveau HIPAA quand vous en avez besoin.
Pas de candidature, pas d'attestation, pas de liste d'attente. Vous pouvez avoir une simulation en cours cet après-midi.
