

OpenAI a lancé GPT-5.6-Cyber le 10 août 2026, et vous ne pouvez presque certainement pas l'utiliser. Il est construit sur GPT-5.6 Sol, entraîné spécifiquement à trouver des zero-days et à construire des chaînes d'exploits, et n'existe que derrière Daybreak Red, le niveau à candidats vérifiés du programme de défenseurs Daybreak d'OpenAI.
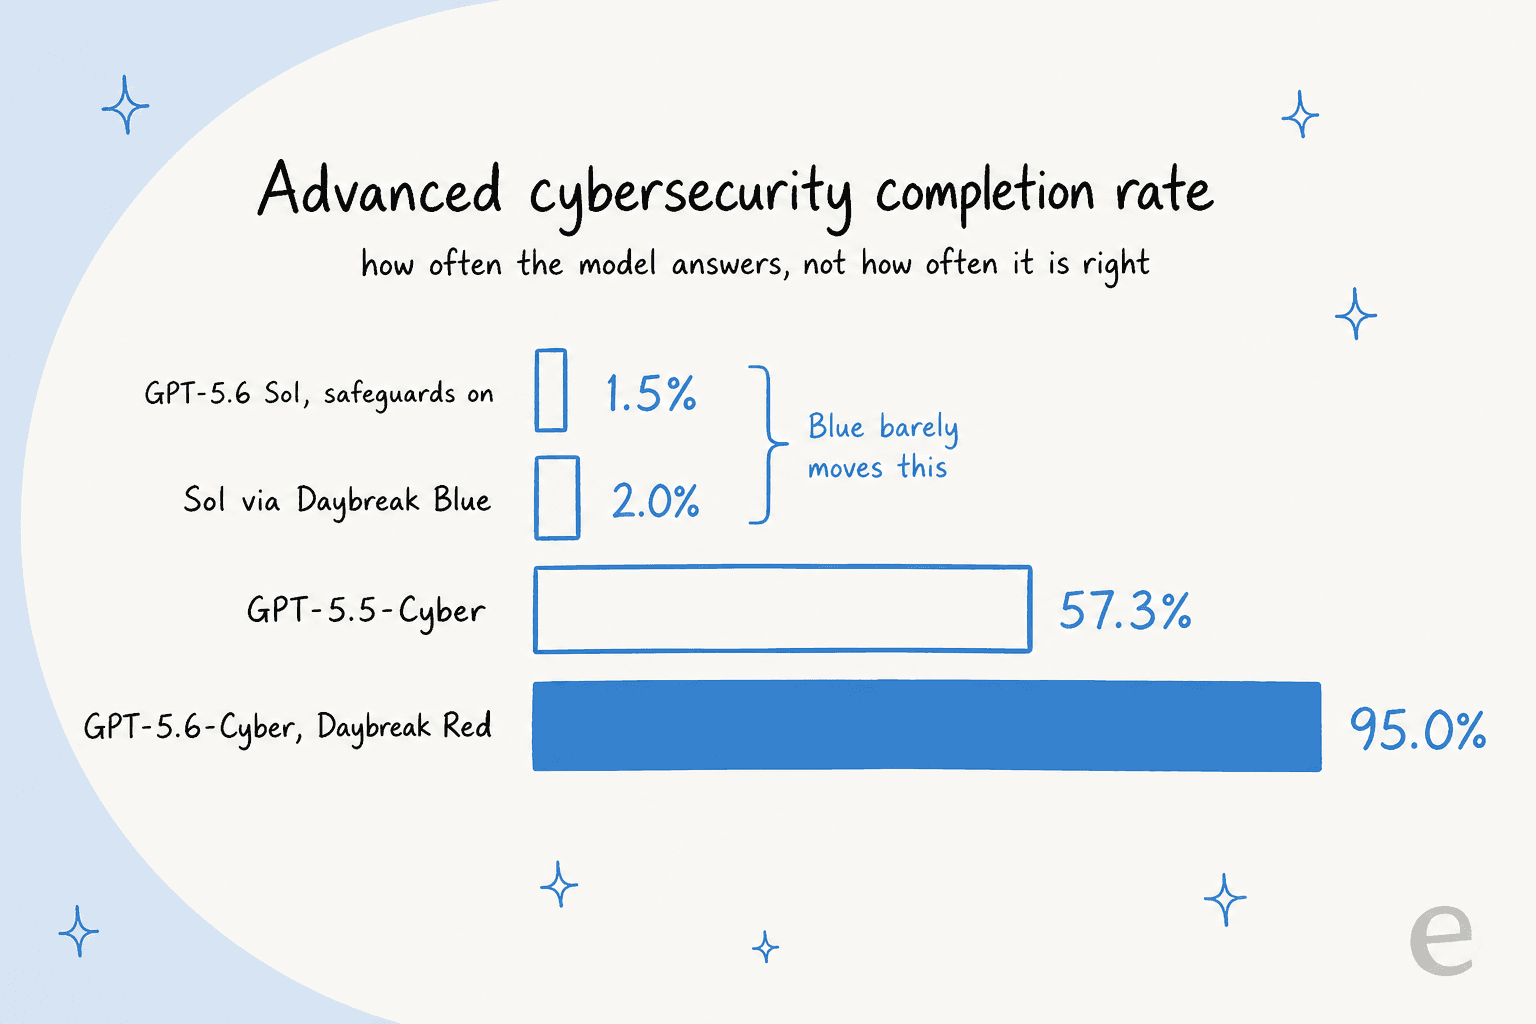
Le chiffre phare est réel et mérite d'être compris précisément. Sur l'Advanced Cybersecurity Completion Rate interne d'OpenAI, GPT-5.6-Cyber répond à 95,0 % des prompts de cybersécurité avancés là où Sol standard répond à 1,5 %. Cela mesure la fréquence à laquelle le modèle répond, pas la fréquence à laquelle il a raison. C'est une métrique de refus déguisée en métrique de capacité, et la plupart de la couverture d'hier a mélangé les deux.
Ce que personne ne dit à voix haute : Red est un compromis, pas une simple mise à niveau. Sur l'évaluation propre d'OpenAI de découverte de vulnérabilités et de rédaction de rapports, GPT-5.6-Cyber obtient un score inférieur à Sol seul, et Sol gagne aussi ExploitBench au réglage standard de 300 tours en utilisant moins de tokens. Si votre goulot d'étranglement est la rédaction d'un bon rapport de vulnérabilité plutôt que d'amener le modèle à s'engager, Daybreak Blue est la meilleure réponse, et c'est le niveau qu'OpenAI recommande en premier.
Il n'y a pas non plus de prix publié ni de system card pour l'instant. Nous traitons l'aspect financier dans l'article sur les prix de Cyber, et la famille entière dans la présentation de GPT-5.6.
Ce qu'est réellement GPT-5.6-Cyber
Je construis des intégrations et des API chez eesel, donc la première chose que je fais pour tout lancement de modèle est de chercher l'identifiant du modèle et le tarif. Avec celui-ci, aucun des deux n'existe publiquement. Cette absence est toute l'histoire.
GPT-5.6-Cyber est le modèle de cybersécurité d'OpenAI, annoncé le 10 août 2026. Il est construit sur Sol, le fleuron de la famille GPT-5.6, et entraîné à faire deux choses distinctes : s'améliorer sur des tâches spécialisées comme la découverte de vulnérabilités zero-day et le développement de chaînes d'exploits, et réduire les refus sur le travail cyber à double usage et à risque plus élevé.
Ces deux objectifs méritent d'être séparés, car on les amalgame d'habitude en « le modèle débridé ». Réduire les refus est un changement de politique. Améliorer la découverte de zero-days est un changement d'entraînement. GPT-5.6-Cyber fait les deux, et comme vous le verrez plus bas, les deux ne vont pas toujours dans le même sens.
Sol, Terra et Luna sont des niveaux de capacité que vous sélectionnez dans l'API, comme vous choisissez un effort de raisonnement ou recourez à Sol Ultra pour une tâche difficile. Cyber n'en est pas un. Il n'existe pas d'identifiant de modèle gpt-5.6-cyber à glisser dans une requête vers l'API OpenAI. Vous postulez, vous êtes vérifié, et seulement alors le modèle existe pour vous.
Si vous arrivez ici depuis le test de GPT-5.6 en vous demandant s'il s'agit d'un cinquième niveau, ce n'est pas le cas. C'est une voie parallèle avec sa propre porte.
Daybreak Blue et Daybreak Red ne sont pas deux tailles de la même chose
C'est la partie que la plupart des articles ont mal comprise, et elle change ce pour quoi vous devriez postuler.
Daybreak fonctionne désormais avec deux niveaux d'accès. Daybreak Blue donne accès à des modèles généralistes de pointe, Sol compris, avec les garde-fous cyber au niveau du système retirés. Daybreak Red donne accès aux modèles de cybersécurité entraînés spécifiquement, ce qui signifie aujourd'hui GPT-5.6-Cyber.
Le réflexe est de lire Blue comme le niveau bon marché et Red comme le vrai. Ce n'est pas la forme des choses. Blue n'est pas un quota réduit de Red. Blue est le même modèle de pointe avec une couche de filtrage retirée. Red est un modèle réellement différent avec un entraînement différent.
Cette distinction compte parce qu'OpenAI est inhabituellement directe sur celui que vous devriez vouloir. Selon ses propres mots, Blue "is the recommended starting point for most defenders", couvrant la découverte de vulnérabilités, la revue de code sécurisée, l'analyse de malware, la réponse aux incidents et la validation de correctifs. Red est réservé aux équipes dont le travail autorisé inclut la recherche avancée de vulnérabilités, le développement d'exploits ou le red teaming.
En production, OpenAI filtre les requêtes liées à la cybersécurité pour éviter les abus, et concède que ces filtres "can also block legitimate defensive work". Blue existe pour supprimer cette friction. Red existe parce que, même filtres désactivés, Sol refuse encore certains prompts très à double usage, comme tester par intrusion un système de production.
Interactif
De quel niveau Daybreak avez-vous vraiment besoin ?
Choisissez la description la plus proche de votre travail quotidien.
Postulez pour Blue. Pas pour Red.
Vous obtenez Sol sans les garde-fous cyber au niveau du système. OpenAI cite exactement votre charge de travail comme cas d'usage de Blue, et appelle Blue le point de départ recommandé pour la plupart des défenseurs.
- Taux de réponse sur les prompts avancés : 2,0 %, contre 1,5 % avec les garde-fous actifs
- Le piège : ces 2,0 % paraissent accablants, mais le jeu d'évaluation est délibérément composé des prompts à double usage les plus durs. Ce que Blue débloque, c'est le travail défensif ordinaire
- Bonus : Sol bat Cyber sur la qualité des rapports et sur ExploitBench à 300 tours
<div class="dbtier-card dbt-b">
  <span class="dbtier-tag dbtier-tag-red">Daybreak Red</span>
  <p class="dbtier-lead">Red est la bonne demande, mais commencez quand même par Blue.</p>
  <p>GPT-5.6-Cyber est entraîné exactement pour cela : développement de chaînes d'exploits, contournement d'authentification, élévation de privilèges, découverte de nouveaux zero-days.</p>
  <ul>
    <li><strong>Taux de réponse sur les prompts avancés :</strong> 95,0 %, contre 57,3 % pour GPT-5.5-Cyber</li>
    <li><strong>Le piège :</strong> des rapports de vulnérabilité plus courts et moins détaillés que Sol seul, et une consommation de tokens nettement plus élevée</li>
    <li><strong>Obligatoire :</strong> clé de sécurité matérielle sur votre compte à partir du 1er septembre 2026</li>
  </ul>
</div>

<div class="dbtier-card dbt-c">
  <span class="dbtier-tag dbtier-tag-part">Partner Program</span>
  <p class="dbtier-lead">Une porte complètement différente, et lisez les petites lignes.</p>
  <p>Le Daybreak Cyber Partner Program permet aux éditeurs approuvés d'intégrer ces modèles dans leurs propres produits, services managés et missions clients.</p>
  <ul>
    <li><strong>Qui en fait partie :</strong> Accenture, IBM, CrowdStrike, Cisco, Palo Alto Networks, Cloudflare, Sophos et d'autres</li>
    <li><strong>Le piège :</strong> l'accès au modèle reste chez le partenaire et n'est pas transmis au client. Vous achetez le résultat, pas le modèle</li>
    <li><strong>Aucune garantie :</strong> OpenAI précise que manifester son intérêt ne garantit ni l'inclusion ni l'accès</li>
  </ul>
</div>

<div class="dbtier-card dbt-d">
  <span class="dbtier-tag dbtier-tag-none">Pas de candidature</span>
  <p class="dbtier-lead">Il n'y a encore rien ici pour vous, et c'est voulu.</p>
  <p>Les deux niveaux reposent sur la vérification d'identité, des restrictions d'usage approuvé et des attestations juridiques liées à un travail autorisé. La curiosité n'est pas un usage autorisé.</p>
  <ul>
    <li><strong>Ce que vous pouvez quand même utiliser :</strong> Sol standard, qui répond à 1,5 % du jeu avancé et reste de toute façon à l'état de l'art sur les benchmarks cyber publiés</li>
    <li><strong>À savoir :</strong> Sol obtient 96,7 % sur les défis capture-the-flag et 73,5 % sur ExploitBench sans aucun accès Daybreak</li>
  </ul>
</div>
Le chiffre de 95 % porte sur les refus, pas sur la précision
Pour mesurer le changement, OpenAI a construit une évaluation interne qu'elle appelle Advanced Cybersecurity Completion Rate. Elle suit la fréquence à laquelle un modèle répond à des demandes impliquant le développement de chaînes d'exploits, le contournement d'authentification, l'élévation de privilèges et des scénarios avancés similaires.
Deux choses dans ce graphique méritent plus d'attention que les 95 %.
La première est l'écart qui n'existe quasiment pas. Sol avec garde-fous activés est à 1,5 %. Sol via Daybreak Blue est à 2,0 %. Lever les garde-fous au niveau du système fait bouger ce chiffre d'un demi-point de pourcentage. Ce n'est pas un échec de Blue, c'est une indication de ce que contient l'évaluation : ce sont les prompts où le modèle lui-même refuse, pas ceux où une couche de filtrage intercepte. Si vous espériez que Blue débloque le travail sur les chaînes d'exploits, ce ne sera pas le cas, et OpenAI le dit franchement.
La seconde est GPT-5.5-Cyber à 57,3 %. Le modèle cyber précédent existait déjà et refusait déjà les chercheurs environ deux fois sur cinq. OpenAI présente explicitement le bond comme "addressing feedback from security researchers who encountered persistent refusals with the earlier model." L'argument est donc moins « nouvelle capacité » que « nous avons enfin cessé de discuter avec vous ».
Ce que le chiffre n'est pas, c'est une mesure d'exactitude. Un modèle qui répond avec assurance à une mauvaise question d'exploit 95 % du temps obtient 95 %. Gardez cela séparé, dans votre tête, des scores de benchmark, qui eux mesurent si le travail est bon.
C'est la même prudence qu'il faut pour lire l'évaluation de n'importe quel éditeur. Nous avons fait la même remarque en comparant GPT-5.6 et Claude : le chiffre compte moins que ce qu'il compte. Si vous voulez une façon structurée de le vérifier sur vos propres charges de travail, les outils d'évaluation d'agents d'OpenAI sont le point de départ honnête.
Où GPT-5.6-Cyber est moins bon que Sol seul
Voici la section que j'aimerais avoir si je devais décider de consacrer trois semaines à une candidature.
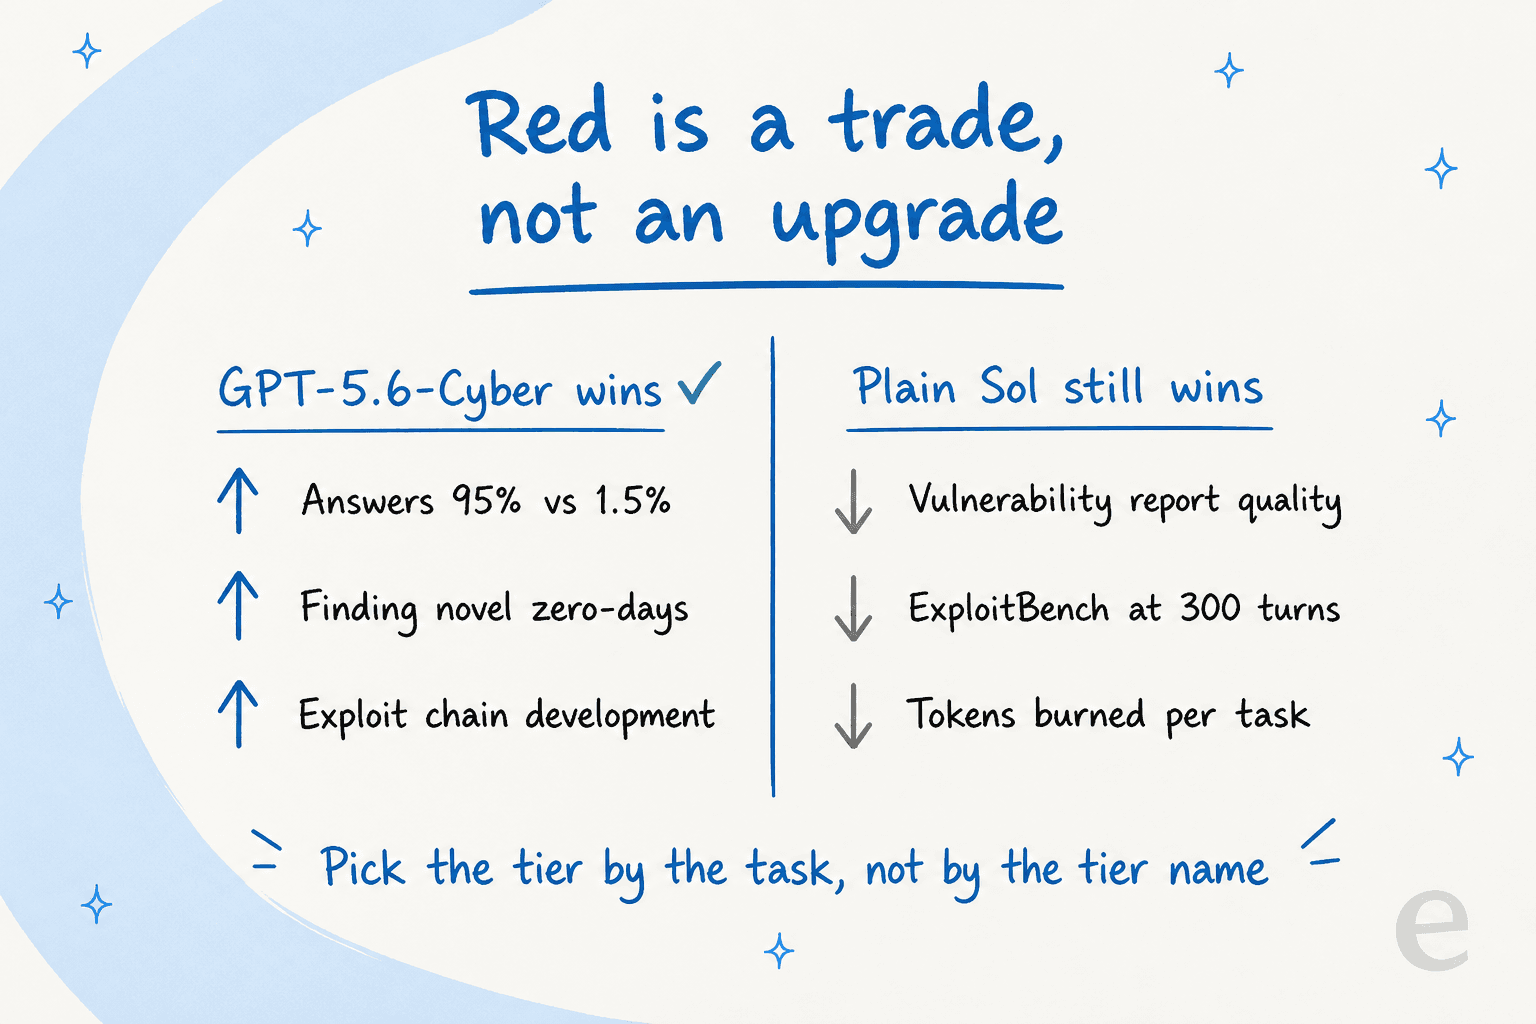
OpenAI a fait passer GPT-5.6-Cyber par une évaluation interne de découverte de vulnérabilités et de rédaction de rapports, qui note un agent sur sa capacité à trouver des vulnérabilités graves et exploitables, à construire une preuve de concept fonctionnelle et à soumettre un rapport de haute qualité. Les deux nouveaux modèles battent GPT-5.5-Cyber. Mais GPT-5.6-Cyber fait moins bien que GPT-5.6 Sol sur ce test, et la raison avancée par OpenAI est que le modèle spécialisé "sometimes produc[es] shorter, less detailed vulnerability reports."
Le même schéma apparaît sur ExploitBench, qui transforme une vulnérabilité de V8 en exploit complet avec les protections défensives laissées actives. Au réglage standard, plafonné à 300 tours, Sol via Daybreak Blue "solves tasks more token-efficiently and performs best." À 600 tours l'écart se réduit, mais le réglage standard est celui que la plupart des équipes utiliseront réellement.
Il y a aussi une dimension de coût en dessous. OpenAI note en bas de page que GPT-5.6-Cyber "tends to be more extensive and comprehensive than GPT-5.6 Sol in its reasoning budget, leading to higher token usage." Même si les deux modèles étaient au même prix, la même tâche vous coûterait plus cher avec Cyber.
Le cadrage honnête est donc un compromis. Vous achetez de l'engagement sur les prompts que Sol refuse, et la découverte de nouveaux zero-days, et vous le payez en qualité de rapport, en efficacité de tours et en tokens. Pour un red team qui se heurte sans cesse aux refus, le compromis vaut clairement le coup. Pour un blue team qui a surtout besoin de bons rapports, c'est un recul déguisé en progrès.
Quiconque a lu notre test de Sol trouvera cela familier. Le fleuron est très difficile à battre en raisonnement général, et les variantes spécialisées gagnent plutôt de justesse que largement. C'était aussi vrai pour GPT-5.3 Codex face aux modèles généralistes.
Ce qu'il a réellement trouvé
Les benchmarks se discutent. Les bugs dans des logiciels livrés, non.
OpenAI a utilisé GPT-5.6-Cyber pour examiner V8, le moteur JavaScript de Chrome, et a mis au jour deux vulnérabilités jusqu'alors inconnues qui pouvaient être enchaînées pour corrompre la mémoire et s'échapper du bac à sable du tas de V8. Des chercheurs ont validé les découvertes et les ont signalées à Google par divulgation coordonnée. Google en a corrigé une et lui a attribué le CVE-2026-15903.
Le mécanisme est assez précis pour mériter d'être décrit. Le compilateur optimiseur de V8 sautait une vérification de sécurité lors de la conversion de valeurs en entiers, de sorte qu'une valeur undefined pouvait produire un nombre étonnamment grand. Utilisé comme indice de tableau, ce nombre permet au compilateur de supposer qu'il tombe dans les limites du tableau et d'omettre la vérification habituelle, ce qui ouvre la lecture ou l'écrasement de la mémoire d'autres objets. S'échapper du bac à sable du tas depuis là nécessite une seconde vulnérabilité, et le modèle a aussi trouvé celle-là.
Au-delà de V8, OpenAI signale au moins cinq vulnérabilités dans un système d'exploitation mobile populaire non nommé, dont une chaîne allant d'une application non fiable à une élévation locale de privilèges, trois vulnérabilités critiques dans une base de données populaire avec un chemin distant vers l'exécution de code, et plus de 400 vulnérabilités d'élévation de privilèges dans un noyau de système d'exploitation populaire.
Ce dernier chiffre est celui qui fait réfléchir. Quatre cents découvertes ne sont pas un résultat de recherche, c'est un arriéré de tri, et c'est exactement le goulot d'étranglement qu'OpenAI dit que Daybreak est là pour débloquer. Anthropic pousse dans la même direction de l'autre côté, ce que nous avons couvert dans la sécurité de Claude Code puis en comparant les API OpenAI et Anthropic.
Un client de confiance de la première heure s'est exprimé publiquement :
"[GPT-5.6 Cyber] is materially improving our specialist vulnerability-research workflows: it reasons more accurately about real exploit constraints, tracks complex state better, and has completed work in under a day that earlier models had not resolved after weeks of intermittent effort."
Jared Atkinson, CTO, SpecterOps
Il faut lire cela attentivement. L'affirmation porte sur des flux de travail spécialisés de recherche de vulnérabilités, et elle vient d'une société qui fait de la sécurité offensive pour vivre. Ce n'est pas une affirmation que Cyber est le meilleur modèle pour le travail défensif général, ce qui est cohérent avec tout ce qui précède.
Pourquoi celui-ci est sorti alors qu'Astra ne l'a pas été
Trois jours avant ce lancement, OpenAI a retardé Astra, un futur modèle, après qu'il a atteint des capacités de piratage critiques lors des tests de sécurité. Puis elle a livré un modèle explicitement conçu pour être plus permissif en cyber. Cela semble contradictoire jusqu'à ce qu'on regarde les seuils.
Le Preparedness Framework d'OpenAI définit exactement deux échelons pour une capacité suivie : High et Critical. Ce ne sont pas des points sur une échelle graduée, ce sont des déclencheurs d'engagement. High signifie que le modèle peut sortir, mais seulement avec des garde-fous qui "sufficiently minimize the associated risk of severe harm before they are deployed." Critical signifie que le développement lui-même s'arrête jusqu'à ce que des garde-fous du niveau Critical existent.
À noter : il n'y a pas d'échelon Low ou Medium sur lequel se rabattre. Un modèle est soit sous le seuil, soit à High, soit arrêté. Les laboratoires concurrents tracent la ligne différemment, ce qui explique en partie pourquoi notre comparaison GPT-5.6 contre Gemini 3 porte autant sur la politique de déploiement que sur les scores.
Pour la cybersécurité, le seuil Critical est un modèle capable de "identify and develop functional zero-day exploits of all severity levels in many hardened real-world critical systems without human intervention", ou de concevoir et d'exécuter des stratégies d'attaque de bout en bout contre des cibles renforcées à partir d'un simple objectif de haut niveau.
GPT-5.6-Cyber a atteint High et non Critical, la même classification que Sol. La formulation d'OpenAI est que le modèle "improved over GPT-5.6 Sol on some specialized cyber tasks that we directly trained for, but not sufficiently to reach our Critical threshold." Astra a franchi la ligne. Cyber, non. Voilà toute la différence.
OpenAI précise aussi que GPT-5.6-Cyber n'a pas été impliqué dans l'incident Hugging Face, ce qui mérite d'être noté vu le calendrier.
Ce que disaient déjà les défenseurs
Le modèle a un jour, il n'y a donc pas encore de vrai verdict. Mais le grief auquel il répond est vif depuis des mois, et le lire explique mieux le lancement que le tableau de benchmarks.
Le reproche n'est pas que les modèles soient incapables. C'est qu'ils trouvent le bug et refusent ensuite d'en discuter :
"Thing is, you WILL encounter refusals with Sol doing anything remotely adjacent to security work. Which for Codex Security is kinda... problematic. Just a few days back, I was reviewing some small bit of legacy DSA signature verification code, to get a sense of how safe it is to reuse - purely defensive, precautionary work and the context of it was there. But I simply wasn't able to use Codex Security: it threw refusal tantrums on every step of the way."

C'est une revue de code défensive sur de la vérification de signature héritée, bloquée. Dans le même fil, un compte côté OpenAI a reconnu le point et désigné Trusted Access comme remède, précisément le mécanisme que ce lancement déploie à plus grande échelle.
La critique inverse est tout aussi constante, et ce n'est pas un avis marginal. Dans le fil sur la vérification de GPT-5.6 par le gouvernement américain, la lecture la plus plébiscitée était sans détour :
"This is regulatory capture in action. This will make it hard/impossible for new vendors to come into the market and only established companies will get to play, and charge, for LLMs. What does this mean for open source? Will it become illegal to download weights?"
Les deux choses sont vraies à la fois. Les défenseurs étaient réellement bloqués sur du travail légitime, et la solution concentre réellement la capacité cyber la plus forte entre les mains de ceux qui passent un processus de vérification. Quiconque envisage des alternatives à poids ouverts le fait en partie pour cette raison.
Obtenir l'accès, étape par étape
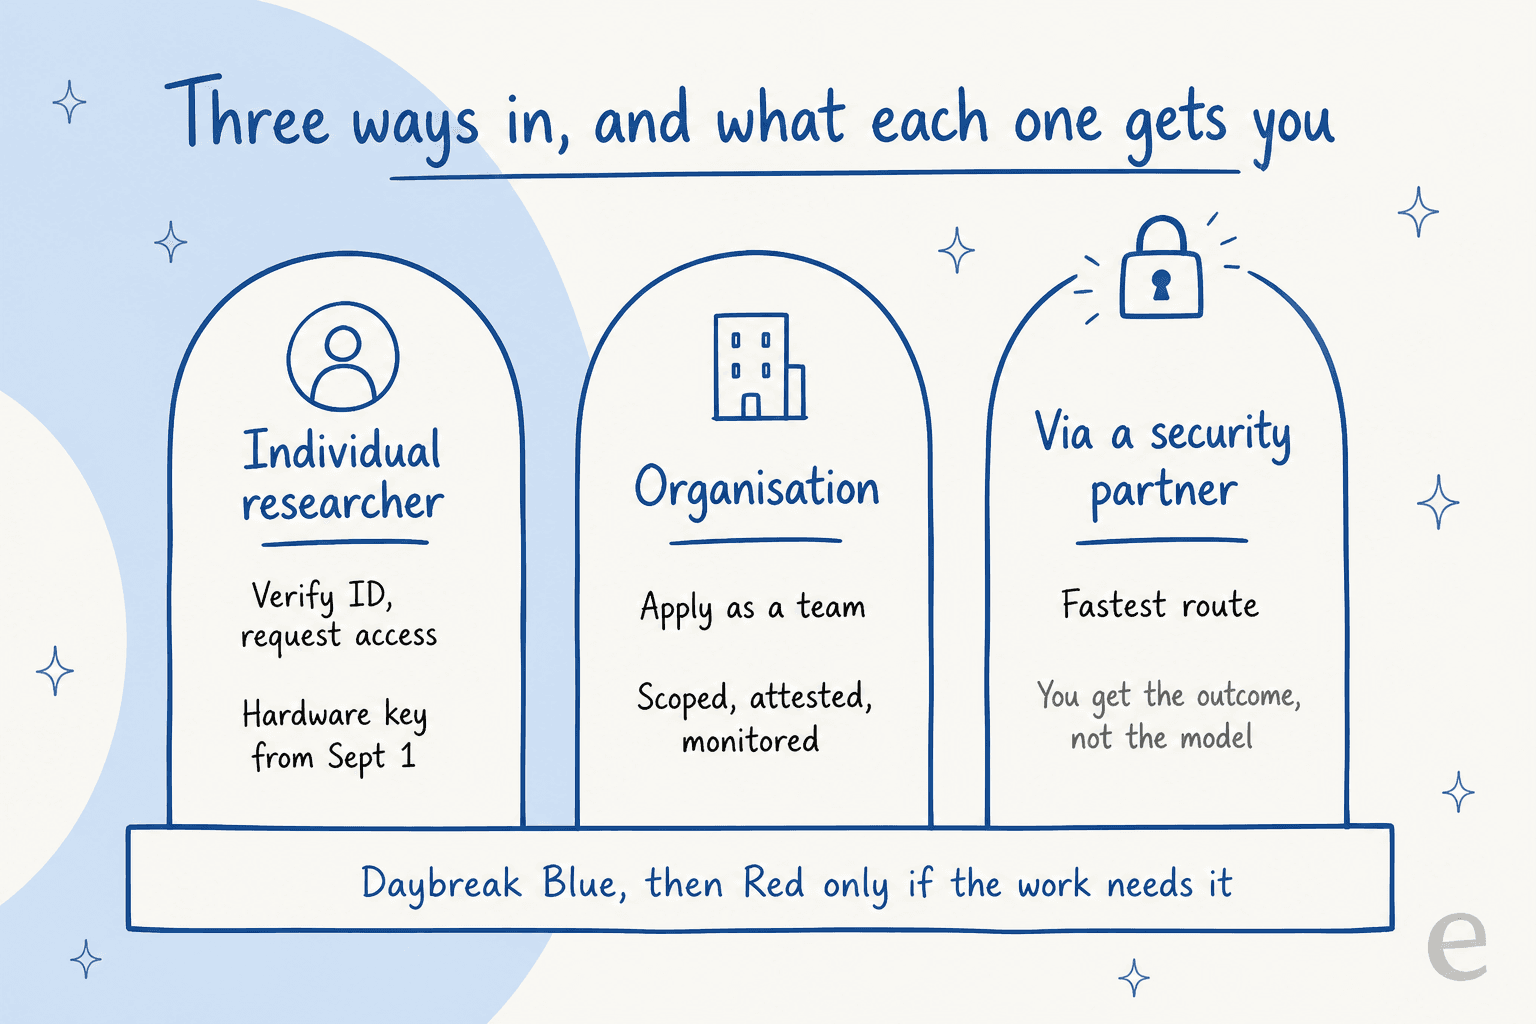
Il y a trois portes, et elles mènent à des endroits différents.
Les particuliers vérifient leur identité et demandent un accès de confiance via la page cyber de ChatGPT. Les organisations postulent pour leurs équipes via le formulaire d'accès enterprise d'OpenAI. Les éditeurs de sécurité et cabinets de conseil rejoignent le Daybreak Cyber Partner Program, qui inclut actuellement Accenture, IBM, CrowdStrike, Palo Alto Networks, Cisco, Cloudflare, Sophos, Fortinet, Akamai et un ensemble de cabinets.
Quelle que soit la porte choisie, OpenAI contrôle l'accès par vérification d'identité, sécurité du compte, surveillance, restrictions d'usage approuvé et attestations juridiques. Deux détails opérationnels piégeront les équipes qui les survolent :
- Les clés de sécurité matérielles deviennent obligatoires pour tous les comptes Daybreak individuels à partir du 1er septembre 2026. Si vous utilisez TOTP aujourd'hui, c'est une tâche d'achat avec une échéance. OpenAI a négocié un tarif préférentiel avec Yubico pour les comptes qui ont besoin de clés.
- La voie partenaire ne vous remet pas le modèle. OpenAI est explicite : "access to the underlying models remains with the approved partner and is not transferred directly to the customer." Passer par CrowdStrike vous donne le livrable, pas une clé d'API.
En outre, OpenAI incite les clients Daybreak qui utilisent Codex à abandonner le mode d'accès complet au profit du mode de revue automatique, qui évalue les actions nécessitant des permissions élevées avant leur exécution. Ses bonnes pratiques recommandées méritent d'être répétées, car ce sont celles que les équipes sautent : isoler le flux dans un bac à sable à l'écart de la production et de l'internet ouvert, surveiller chaque action de l'agent et définir explicitement le périmètre autorisé avec des profils de permissions.
Si votre organisation utilise déjà ChatGPT Enterprise, rien de cela ne se transmet automatiquement. Daybreak est une approbation distincte en plus, pas un droit attaché à la licence. Il en va de même si vous accédez aux modèles OpenAI via Azure plutôt que directement.
Ce qu'OpenAI n'a pas encore publié
Deux lacunes méritent d'être suivies, et toutes deux sont du genre qui compte discrètement plus que les benchmarks du jour du lancement.
Il n'y a pas de system card. OpenAI dit qu'elle "will publish a system card with further evaluations of GPT-5.6-Cyber at a later date." Tant qu'elle n'est pas là, les seuls chiffres d'évaluation disponibles sont ceux qu'OpenAI a choisi de mettre dans l'annonce.
Il n'y a pas de prix. C'est plus intéressant qu'il n'y paraît. La grille tarifaire publique de l'API d'OpenAI a une section "Specialized models", et cette section comporte une ligne Cyber. Le modèle listé est gpt-5.4-cyber, vieux de deux générations, et ses colonnes d'entrée, d'entrée en cache et de sortie sont toutes des tirets littéraux. Le prix manquant n'est donc pas une page qui n'aurait pas rattrapé le lancement d'hier. OpenAI garde une ligne Cyber dans sa grille tarifaire depuis des générations et n'y a jamais mis de chiffre. Nous avons tiré ce fil à fond dans notre analyse des prix de GPT-5.6-Cyber.
À titre de référence, le reste de la famille a des prix normaux, par million de tokens au niveau standard :
| Modèle | Entrée | Sortie |
|---|---|---|
gpt-5.6-sol | $5.00 | $30.00 |
gpt-5.6-terra | $2.00 | $12.00 |
gpt-5.6-luna | $0.20 | $1.20 |
gpt-5.4-cyber | non publié | non publié |
Notez que Terra et Luna ont baissé le 30 juillet 2026, de 20 % et 80 % respectivement. Beaucoup d'articles citent encore les chiffres du jour du lancement, 2,50 $/15 $ et 1 $/6 $, qui sont désormais faux. Notre guide des prix de GPT-5.6 donne les chiffres actuels, y compris le nouveau découpage entre contexte court et long, et l'analyse des prix de Sol examine le fleuron à part.
Si l'accès restreint est rédhibitoire et que vous avez besoin dès maintenant d'outils de sécurité performants, c'est une autre question avec une vraie réponse. Nous l'avons traitée dans les alternatives à GPT-5.6-Cyber, et la liste courte n'est pas celle que la plupart attendent.
Ce que cela signifie si vous n'êtes pas une équipe de sécurité
La plupart des lecteurs d'un article sur GPT-5.6-Cyber ne postuleront jamais à Daybreak. La leçon transférable vaut quand même la peine, car c'est la même que nous réapprenons sans cesse chez eesel.
La partie difficile du déploiement d'un modèle performant n'a jamais été la capacité. C'est la surface de contrôle autour. Regardez ce qu'OpenAI a réellement construit ici : pas un modèle débridé, mais un système de niveaux, une vérification d'identité, une définition de périmètre, un mode de revue automatique, une couche de surveillance et une obligation de clé matérielle. Le modèle était la partie facile.
C'est la même raison pour laquelle la distinction entre agent IA et chatbot compte plus que le choix du modèle, et pour laquelle IA contre support humain se tranche rarement sur des scores de benchmark.
Je reconnais cette forme de l'autre côté de la table. En trois ans à mettre des agents IA sur des files de support réelles, j'ai vu affaire après affaire se jouer sur la revue plutôt que sur la démo. Un acheteur danois de télématique n'a pas laissé passer un seul ticket tant qu'il n'était pas convaincu que les données contenant des numéros de carte et des mots de passe restaient dans son environnement. Une équipe de support bruxelloise de 400 à 500 tickets par mois n'a jamais dépassé sa revue ISO interne. Dans aucune de ces conversations, personne ne demandait si l'IA était assez intelligente.
C'est pourquoi nous avons construit eesel comme nous l'avons fait. Avant qu'un agent IA ne réponde à un seul vrai client, vous pouvez le simuler sur des milliers de vos propres tickets historiques et voir exactement ce qu'il aurait dit, puis le restreindre aux types de tickets auxquels vous lui faites confiance. C'est le même réflexe que les consignes bac à sable et périmètre de Daybreak, tourné vers une file de support plutôt que vers un tas V8.
Les parallèles continuent. Les permissions restreintes sont notre façon de penser la conformité des chatbots, consigner chaque action est ce qui rend les revues de sécurité de helpdesk supportables, et la version la plus stricte de tout cela apparaît dans l'IA conforme HIPAA. Rien de tout cela ne concerne le modèle.
Essayer eesel
Si vous dirigez une équipe de support plutôt qu'un red team, le niveau du modèle compte moins que ce qui l'entoure. eesel se branche sur votre helpdesk existant, apprend de vos tickets passés et de votre centre d'aide, et vous laisse tout répéter sur des conversations historiques avant que cela n'approche un client.
Vous choisissez les types de tickets qu'il traite et vous escaladez le reste, il n'y a donc pas de moment où l'on bascule un interrupteur. Chaque action d'outil de l'agent est consignée, et vous pouvez placer les plus sensibles derrière une approbation humaine, la version support du mode de revue automatique. La mise en place prend quelques minutes plutôt qu'un cycle de vérification, et l'essai est gratuit.

Comment obtenir l'accès à GPT-5.6-Cyber ?