

Gemini 4 Neon est le modèle de Google que j'utiliserais pour le travail agentique difficile et les longs documents, exécuté en high : Artificial Analysis le note à 59,6 pour $3,74 par tâche, environ la moitié des $7,76 de Carbon pour le même score. Ce n'est pas la voie la moins chère vers ce score. Astra d'OpenAI atteint 60,1 pour $2,07, et Neon écrit cinq à six fois plus de tokens par tâche. Son véritable atout, c'est l'honnêteté : il s'est trompé sur 14% des questions à laquelle il ne pouvait pas répondre, contre 54% à 61% pour Sol et Astra.
La CLI eesel permet à un agent de code de téléverser des articles d'aide approuvés vers un coéquipier helpdesk eesel et de tester ses réponses sur vos propres tickets, c'est ainsi que je vérifierais n'importe quel modèle avant qu'il ne réponde à un client.
Comment j'ai testé Gemini 4 Neon
Je n'ai pas encore fait passer Neon par ma propre suite de tests, donc chaque chiffre ci-dessous vient de trois sources que j'ai pu vérifier le jour du lancement, le 19 novembre 2026 :
- Les pages de Google elles-mêmes : le billet de lancement, la fiche du modèle et la page de tarifs.
- Artificial Analysis : j'ai lu les résultats par réglage pour Neon, Carbon, Hydrogen, Sol, Astra et Opus 5.5 sur leurs pages de modèle. Son indice est une suite de 9 évaluations, donc une "tâche" ci-dessous désigne une tâche de benchmark, pas un de vos tickets.
- Le fil de lancement sur Hacker News, qui a dépassé 460 points le jour de son ouverture.
J'ai essayé Reddit et X pour la voix des utilisateurs et aucun des deux n'a voulu charger, donc les citations de la communauté viennent toutes de Hacker News. Si votre propre charge de travail diffère d'un benchmark, considérez mon verdict comme une présélection, pas comme un résultat. Le guide explicatif de Neon couvre l'identifiant du modèle, l'accès et la migration, donc je reste bref ici.
Qu'est-ce que Gemini 4 Neon, en un paragraphe ?
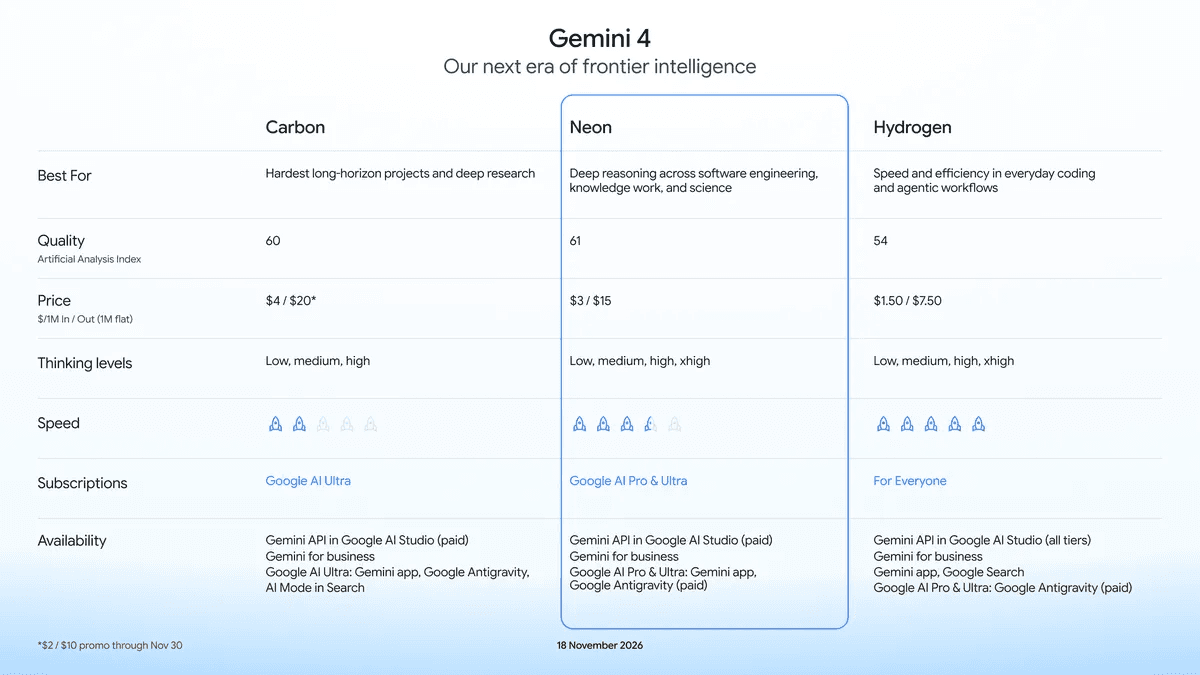
Neon est le modèle intermédiaire de la famille Gemini 4 de Google, sorti le 18 novembre 2026 sous le nom gemini-4-neon. Google indique qu'il est adapté de Carbon, qu'il partage sa fenêtre de 1 048 576 tokens, et qu'il a quatre niveaux de réflexion : low, medium, high (par défaut) et xhigh. Il coûte $3 par million de tokens en entrée et $15 par million de tokens en sortie, sans palier gratuit. Google le présente comme l'équilibre entre "profondeur et efficacité", et son propre graphique le place entre Hydrogen et Carbon :
Gemini 4 Neon est-il bon sur les tâches difficiles ?
Oui, et les preuves sont plus solides que pour la plupart des affirmations du jour de lancement, parce que le classement et le propre tableau de Google concordent. Artificial Analysis place Neon à 61,4 en xhigh et 59,6 en high, devant Opus 5.5 à 59,1 et Sol à 57,3 (leurs meilleurs réglages). Le tableau rapporté par le fournisseur lui-même montre d'où vient cette avance :
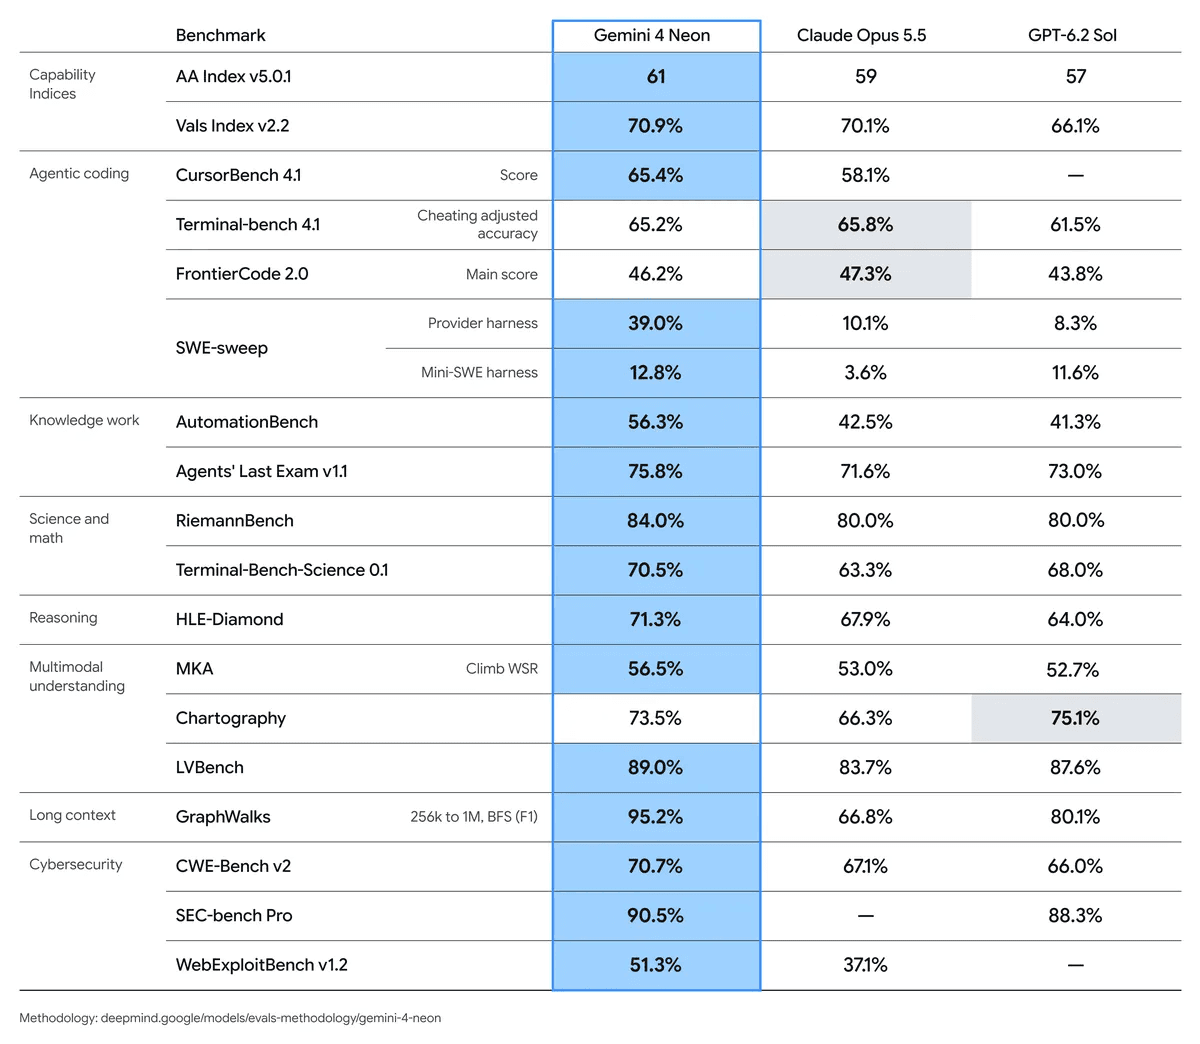
En lisant les colonnes plutôt que les cellules en gras :
- Agents de travail de connaissance : AutomationBench
56.3%contre42.5%pour Opus 5.5 et41.3%pour Sol. - Contexte long : GraphWalks de 256k à 1M tokens,
95.2%contre66.8%et80.1%. Si votre travail consiste à "lire un très long document et répondre avec précision", c'est la ligne qui compte. - Codage, mixte : Opus 5.5 est légèrement devant sur Terminal-Bench 4.1 (
65.8%contre65.2%) et FrontierCode 2.0 (47.3%contre46.2%). L'avance de Neon de39.0%sur SWE-sweep utilise le propre harnais de test d'Antigravity, je ne m'y appuierais donc pas.
Ce sont des chiffres de Google, choisis par Google. Les chiffres indépendants sont les lignes d'Artificial Analysis ci-dessous, et elles racontent une histoire plus intéressante que le score affiché.
Combien coûte Neon par tâche à chaque réglage ?
Le prix par token cache la plus grande partie de la facture, parce que les tokens de raisonnement sont facturés comme de la sortie. Voici les données d'Artificial Analysis par réglage pour Neon à côté de ses semblables, telles que je les ai lues le 19 novembre :
| Réglage | Score d'indice | Coût par tâche | Minutes par tâche | Tokens de sortie par tâche |
|---|---|---|---|---|
| Neon low | 44,1 | $0,75 | 3,7 | 21 726 |
| Neon medium | 54,9 | $1,90 | 8,3 | 50 000 |
| Neon high (par défaut) | 59,6 | $3,74 | 14,8 | 90 188 |
| Neon xhigh | 61,4 | $6,44 | 21,5 | 141 631 |
| Carbon high | 60,0 | $7,76 | 37,2 | 122 768 |
| Hydrogen xhigh | 53,9 | $3,16 | 15,2 | 154 406 |
| Opus 5.5 max | 59,1 | $10,04 | 24,5 | 173 313 |
| Astra high | 60,1 | $2,07 | 5,9 | 17 828 |
| Sol max | 57,3 | $1,01 | 8,5 | 40 360 |
Trois choses ressortent :
- Neon bat Carbon sur son propre terrain. En high, il égale le score de Carbon à un demi-point près pour 52% de coût en moins et 60% de temps en moins. Google revendique 32% de coût en moins par tâche face à Carbon, donc selon ces données l'écart réel est plus large que l'argument commercial.
- High est le point idéal. Passer de medium à high rapporte 4,7 points d'indice pour $1,84 de plus. Passer de high à xhigh rapporte 1,8 point pour $2,70 de plus et 6,7 minutes supplémentaires.
- Astra est le problème. Au même score, Astra coûte $2,07 par tâche et termine en 5,9 minutes. Le prix par token d'Astra est plus élevé ($8 en entrée, $40 en sortie), pourtant il est environ 45% moins cher par tâche parce qu'il écrit 17 828 tokens là où Neon en écrit 90 188.
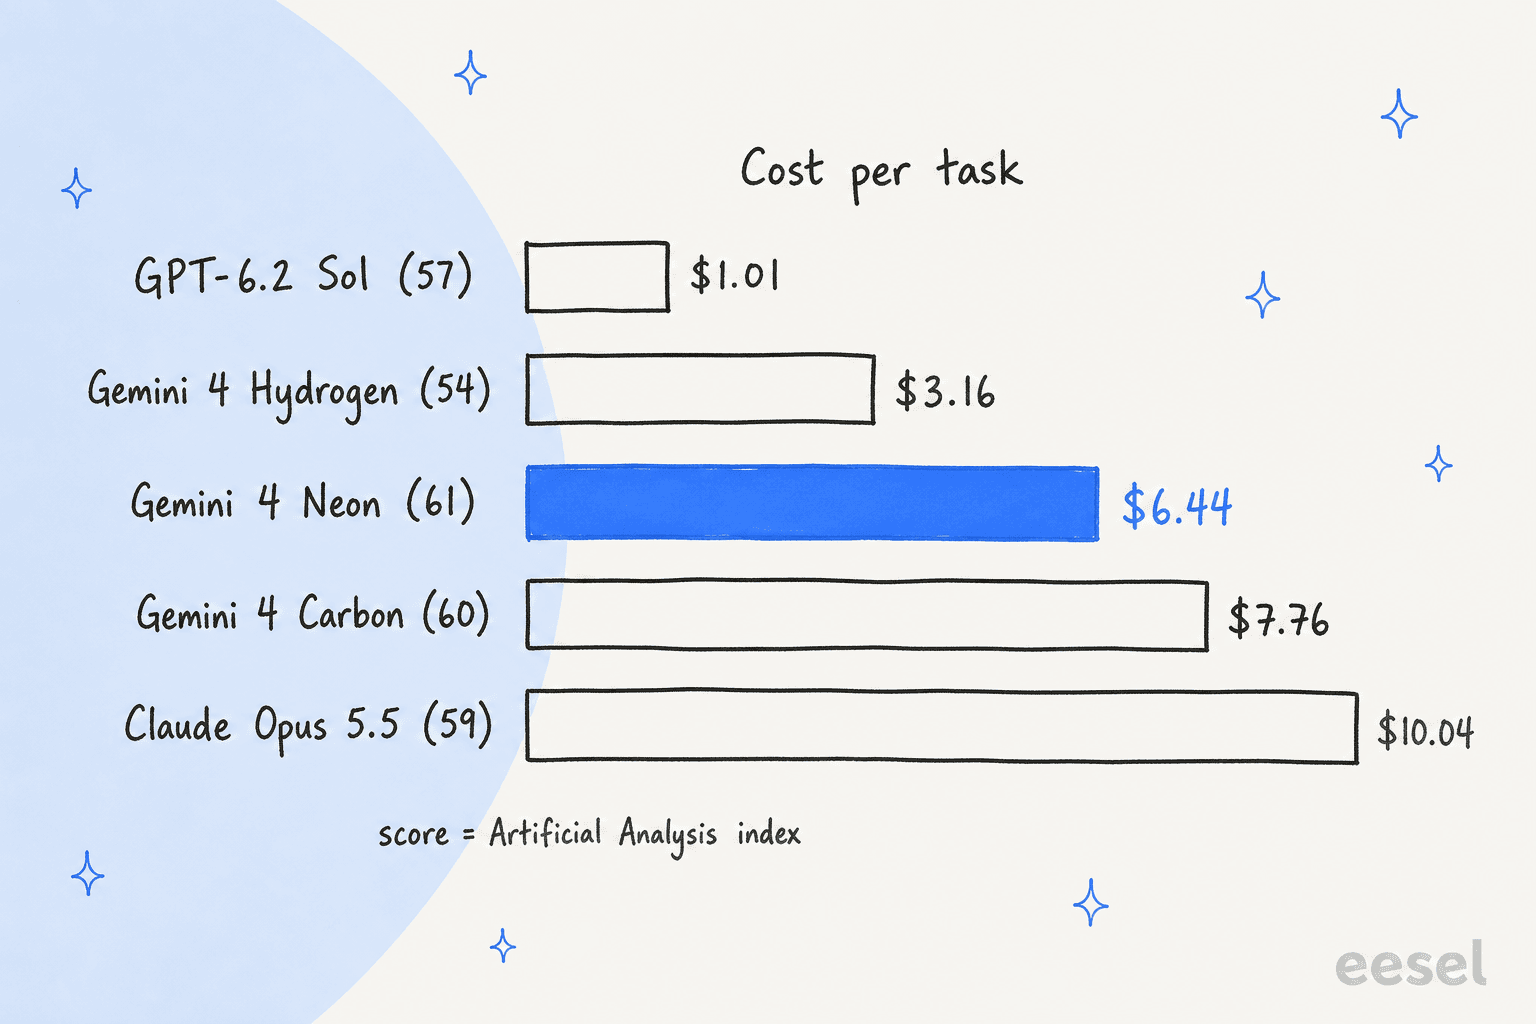
Le graphique utilise le meilleur réglage de chaque modèle, ce qui est la façon juste de comparer "ce que ce modèle peut faire au maximum" et la façon injuste de comparer "ce que je devrais payer". Pour la seconde question, utilisez le tableau.
Gemini 4 Neon hallucine-t-il moins que Sol et Opus ?
C'est le constat qui a changé ma vision du modèle. Sur le test AA-Omniscience d'Artificial Analysis, qui mesure à quelle fréquence un modèle donne une mauvaise réponse plutôt que de refuser quand il ne sait pas, la famille Gemini 4 se démarque nettement du reste :
| Modèle et réglage | Taux d'hallucination (plus bas est mieux) | Questions répondues correctement |
|---|---|---|
| Gemini 4 Argon high | 4% | 48% |
| Gemini 4 Carbon medium | 4% | 49% |
| Gemini 4 Hydrogen xhigh | 8% | 50% |
| Gemini 4 Carbon high | 11% | 58% |
| Gemini 4 Neon high | 14% | 59% |
| Gemini 4 Neon xhigh | 14% | 60% |
| Claude Opus 5.5 max | 50% | 66% |
| GPT-6.2 Sol max | 55% | 62% |
| GPT-6.2 Astra high | 58% | 66% |
| Claude Fable 5.2 high | 58% | 77% |
Neon dit "je ne sais pas" bien plus souvent qu'Opus, Sol ou Astra, et il en paie le prix en précision brute : 59% à 60% de bonnes réponses contre 66% pour Astra et 77% pour Fable 5.2. Parmi les modèles de Google, il est aussi plus enclin à deviner que Carbon medium, Argon ou Hydrogen.
Si ce compromis est bon dépend du travail. Pour un agent de recherche qui doit toujours produire une réponse, les refus supplémentaires sont une friction. Pour un agent orienté client qui doit transférer quand il n'est pas sûr, un modèle qui refuse est plus proche de ce que l'on veut, et c'est le comportement que je cherche en premier. Une réserve que je veux souligner haut et fort : AA-Omniscience est un test de culture générale. Il ne mesure pas comment un modèle se comporte avec votre centre d'aide, donc testez-le sur vos propres tickets avant de le croire.
Où Gemini 4 Neon est-il en retard ?
J'ai trouvé six limites réelles, classées par ordre de ce qui me dérangerait le plus :
- Il est bavard. En xhigh, il a écrit 283 millions de tokens de sortie sur l'ensemble de l'indice, contre 60,9 millions pour Sol. Les tokens de sortie sont ceux à $15, donc votre facture suit les habitudes du modèle, pas seulement la liste de prix.
- Le réglage le plus élevé est lent. Artificial Analysis a mesuré 56,5 secondes jusqu'au premier token de réponse en xhigh, puis 110 tokens par seconde après cela. Carbon a besoin de 73 secondes et de 55 tokens par seconde, donc Neon est plus rapide que Carbon, mais ce n'est pas un modèle de chat en direct au-dessus de
medium. - Astra et Sol sont moins chers par tâche. Par token, Neon est moins cher qu'Astra. Par tâche, non, comme le montre le tableau. Sol max obtient 57,3 pour $1,01, ce qui est 6,4 fois moins cher que Neon xhigh.
- Il est moins précis quand il devrait répondre. Voir le tableau d'hallucination : le compromis, c'est la prudence contre l'exactitude.
- L'accès a des conditions. Il n'y a pas de palier API gratuit, et la FAQ d'Antigravity, telle que citée par un lecteur de Hacker News, interdit aux outils tiers d'utiliser l'accès par abonnement. Ils ont qualifié cela de point de rupture :
"I'd like to keep my Gmail account, so Google can keep their model and will not get my business."

Un autre lecteur a signalé la solution de contournement, à savoir de simples clés API :
"You can't use subsidized tokens in 3rd party apps. Although they just suspend your Gemini account now, not your google account."
- Le rapport de sécurité est en attente. La fiche du modèle de Google indique que le rapport complet arrivera dans les prochains jours, donc je mettrais en attente toute charge de travail réglementée jusqu'à sa publication.
Quel modèle surpasse Neon pour votre tâche ?
Voici la décision que je prendrais aujourd'hui :
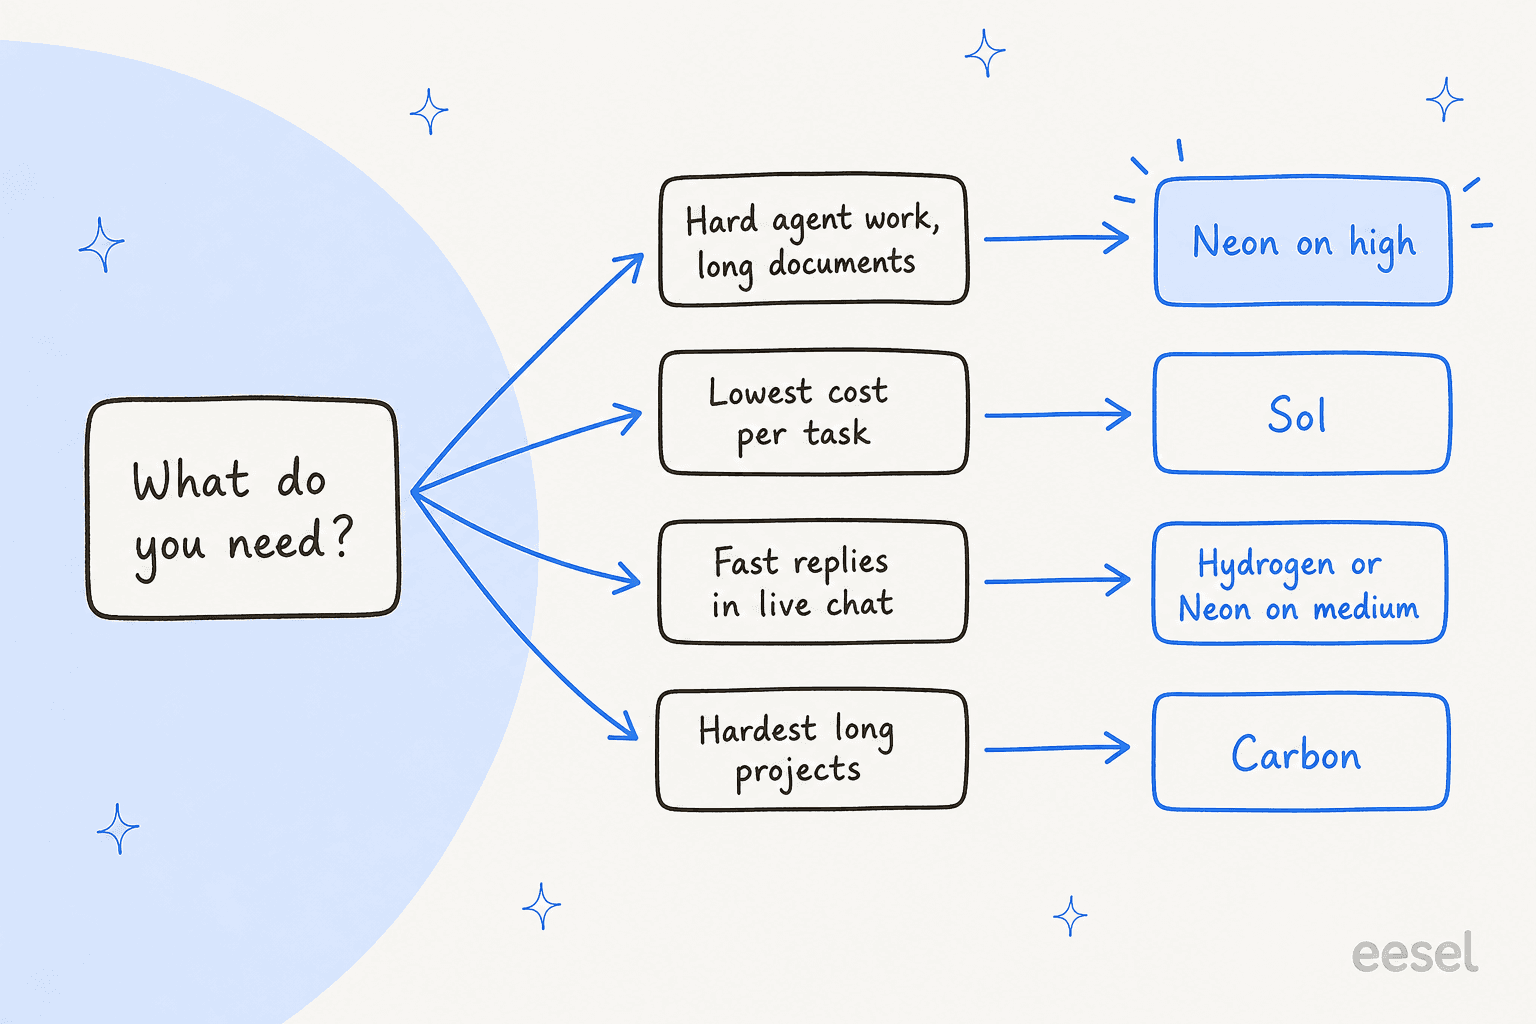
L'arbre cache la partie intéressante, à savoir que le coût et l'hallucination tirent dans des directions opposées. Voici donc les données dans un seul outil. Fixez le score d'indice le plus bas que vous acceptez et le taux d'hallucination le plus élevé que vous tolérez, et il liste chaque réglage Artificial Analysis que j'ai relevé qui franchit les deux barres, le moins cher en premier :
Essayez les extrêmes. Demandez un score de 55 sans limite d'hallucination et Sol xhigh gagne sur le prix à $0,65. Mettez un plafond proche de 20% au même score et Neon high est la réponse la moins chère à $3,74, avec Carbon medium comme option prudente à 4%. Faites baisser le score à 54 et Neon medium prend le relais à $1,90. La famille Gemini 4 est le seul endroit où obtenir un score élevé et un faible taux d'erreur ensemble, et c'est l'argument honnête en faveur de Neon.
Comment Neon se compare-t-il à Carbon, Hydrogen, Astra, Sol et Opus ?
| Modèle | Prix par 1M entrée/sortie | Meilleur score de réglage | Coût par tâche (meilleur) | Taux d'hallucination | Mon avis en une ligne |
|---|---|---|---|---|---|
| Gemini 4 Neon | $3 / $15 | 61,4 | $6,44 | 14% | Meilleur Gemini pour le travail difficile ; faites-le tourner en high |
| Gemini 4 Carbon | $4 / $20 après la promotion | 60,0 | $7,76 | 11% | Neon le remplace pour la plupart des tâches |
| Gemini 4 Hydrogen | $1,50 / $7,50 | 53,9 | $3,16 | 8% | Le choix par défaut pour les petites tâches |
| GPT-6.2 Astra | $8 / $40 | 62,1 | $4,00 | 59% | Score plus élevé, moins de tokens, devine plus |
| GPT-6.2 Sol | $2 / $10 | 57,3 | $1,01 | 55% | Le moins cher par tâche, de loin |
| Claude Opus 5.5 | $4 / $20 | 59,1 | $10,04 | 50% | Neon l'égale pour environ un tiers du coût |
Le prix catalogue de Carbon est $4/$20 à partir du 1er décembre et $2/$10 jusqu'au 30 novembre, ce qui le rend moins cher par token que Neon seulement pour quelques jours encore. Cela ne change rien au calcul par tâche, parce que Carbon réfléchit beaucoup plus longtemps.
Que disent les gens sur Gemini 4 Neon ?
Le fil de lancement sur Hacker News a dépassé 460 points. La réponse la plus utile a comparé Neon à ses rivaux sur Vals, puis a remis le prix en contexte :
"Latency is by far the best for the level of quality. It's about 2x more expensive than Sol 6.2, but significantly better and faster. You get what you pay for."
L'écart par token face à Sol est de 1,5 fois, pas de 2, et par tâche de benchmark il se situe entre 1,9 et 6,4 fois selon le réglage, donc "you get what you pay for" tient pour la qualité mais c'est plus cher que ça ne le laisse entendre. Un autre lecteur a lu le même tarif comme une perte :
"That looks to me like OpenAI equals or beats everything Google offers at half the price."
Selon les chiffres d'Artificial Analysis, c'est proche de la vérité sur le coût par tâche et faux sur l'hallucination, c'est pourquoi je sépare les deux dans ce test. Un troisième commentateur, qui teste de longs travaux agentiques, s'intéressait moins au score :
"Argon and Carbon both made such discoveries such as "it would seem that i need to be pointing at an enemy to shoot them". Its almost entertaining to read, its like its discovering the world on first principles."
Cet utilisateur démarrait la même tâche sur Neon au moment de son message, donc il n'y a pas encore de verdict. Et un lecteur a résumé ce que beaucoup attendent de Google :
"Hydrogen has already became my default for 80% of small tasks. If Neon is as fast but smarter that would honestly be very cool"
Selon les données, Neon est plus intelligent qu'Hydrogen de 8,8 points en high, mais il coûte deux fois plus cher par tâche ($3,74 contre $1,87). Ce sont des commentateurs isolés, pas un sondage, et je n'ai pu accéder ni à Reddit ni à X pour en avoir davantage.
Qui devrait utiliser Gemini 4 Neon ?
| Vous êtes... | Mon avis |
|---|---|
| Quelqu'un qui utilise Carbon ou Argon pour du codage ou des analyses difficiles | Passez à Neon en high et comparez. Même score, environ moitié moins de coût et de temps. |
| Quelqu'un qui paie pour Opus 5.5 en max | Testez Neon high. Le score est équivalent et la facture environ un tiers. |
| Quelqu'un qui construit un agent planificateur et un agent exécutant | Neon planifie, Hydrogen exécute. |
| Quelqu'un qui lit de très longs documents | Neon, selon la ligne GraphWalks de Google et les résultats de travail de connaissance d'AA. |
| Quelqu'un qui optimise le coût par tâche avant tout | Passez Neon. Utilisez Sol ou Astra. |
| Quelqu'un qui construit une réponse de chat en direct | Neon en medium au maximum, ou Hydrogen. |
| Quelqu'un qui a besoin d'un palier gratuit | Hydrogen. Neon n'en a aucun. |
| Quelqu'un sur Gemini 3.8 Flash pour des tâches simples | Restez-y. Neon est surdimensionné et plus bavard. |
Si vous choisissez entre familles, ma comparaison ChatGPT contre Gemini et le tour d'horizon des alternatives à Gemini vont plus loin. Ma lecture plus large de ce niveau se trouve dans l'article sur la frontier AI.
Que signifie ce test pour les équipes de support ?
Un agent de support est un endroit où le résultat "refuser plutôt que deviner" compte plus que le score affiché. Une mauvaise réponse donnée avec assurance à une question de remboursement coûte plus qu'une bascule vers une personne. Mais le modèle n'est qu'une partie. Ce que l'agent sait, quand il doit transférer, et si quelqu'un l'a testé avant le lancement décident de son comportement.
C'est le schéma selon lequel smava, une entreprise allemande de comparaison de prêts, fait fonctionner eesel dans un seul Zendesk. Entre le 8 août et le 8 septembre 2026, trois agents eesel ont traité environ 27 000 tickets : l'un en a catégorisé environ 14 600, l'un a rédigé environ 15 300 réponses à partir de 820 macros et articles d'aide, et des agents par marque ont préparé des réponses prêtes pour le client. Chaque agent a une tâche et une liste de choses qu'il ne doit jamais faire, et des personnes approuvent chaque brouillon avant son envoi. SamCart répartit de la même façon : un agent pour les e-mails Freshdesk, un autre pour le chat du site, chacun avec son propre ton.
Le choix du modèle est un réglage à l'intérieur de cette conception, pas la conception elle-même. Si vous voulez comparer des modèles sur votre file d'attente, simulez l'agent sur des tickets passés et surveillez le taux de bascule, pas seulement la précision. Mon guide sur quel est le meilleur LLM couvre les vérifications que je ferais, et le coût du service client par IA montre ce que coûte une file d'attente au total.
Si votre équipe construit dans un terminal, la CLI eesel permet à un agent de code de faire les parties répétables : téléverser les articles d'aide et macros exportés, ajuster les instructions de l'agent et poser des questions de test avant la mise en production. Connecter le helpdesk lui-même nécessite toujours l'approbation d'un administrateur. Voir les CLI de codage agentique et le guide d'un serveur MCP pour agent IA pour voir comment ces outils fonctionnent avec des modèles comme Neon.
Mon verdict sur Gemini 4 Neon
Utilisez-le si vous alliez de toute façon payer pour Carbon ou Opus 5.5, faites-le tourner en high, et mesurez le coût par tâche, pas par token. Passez-le si le coût par tâche est votre seule contrainte, parce que Sol et Astra sont moins chers, ou si vous avez besoin d'un palier gratuit. Sa meilleure qualité n'est pas le score de 61,4. C'est qu'un modèle aussi capable se trompe si rarement, ce qui vaut la peine d'être testé avant de décider.
Essayer eesel
Si vous choisissez un modèle parce que vous voulez de meilleures réponses dans votre file d'attente, le coéquipier IA pour helpdesk d'eesel vous donne cela sans avoir à décider d'un modèle. Il apprend de vos tickets passés et de votre centre d'aide, transfère à une personne quand la réponse n'est pas dans votre documentation, et vous pouvez le tester sur un historique réel de tickets avant qu'il ne réponde à qui que ce soit. Il fonctionne dans Zendesk et Freshdesk, et c'est la première chose que j'essaierais pour un déploiement d'IA en support client.
La tarification est un plan de crédits mensuel fixe, avec un plan gratuit de 100 crédits et sans carte, donc un changement de prix d'un modèle ne modifie pas votre facture. Essayez eesel sur une partie de votre file d'attente.