

Gemini 4 Neon coûte $3.00 par 1M de tokens en entrée et $15.00 par 1M de tokens en sortie, sans palier gratuit, et les tokens de réflexion sont facturés comme de la sortie. Le prix affiché cache la vraie facture : sur Artificial Analysis une tâche coûte $0.75 en low, $1.90 en medium, $3.74 en high par défaut et $6.44 en xhigh. Batch et Flex divisent le tarif par deux, Priority ajoute 80%, et un hit de cache réduit l'entrée à $0.15. Le prix de lancement de Carbon à $2/$10 se termine le 30 novembre, donc l'argument pour Neon plutôt que Carbon commence le 1er décembre.
La CLI eesel permet à un agent de code de téléverser des articles d'aide approuvés vers un coéquipier de helpdesk eesel et de tester ses réponses sur des tickets passés, ce qui est comment je vérifierais le coût et le comportement de n'importe quel modèle avant qu'il ne réponde à un client.
Comment j'ai tarifé Gemini 4 Neon
Tout ce qui porte un signe dollar vient de la page de tarifs de Google, que j'ai lue le 19 novembre 2026, le lendemain du lancement, y compris les onglets Batch, Flex et Priority. Les règles de cache viennent de la documentation de cache de Google, et les définitions des paliers de sa page d'inférence Flex. Le coût par tâche vient d'Artificial Analysis, où une "tâche" est une tâche de référence de son index, pas un de vos tickets ou pull requests.
Je n'ai pas fait tourner Neon sur ma propre charge de travail. Les exemples mensuels ci-dessous utilisent des comptages de tokens que j'ai choisis et notés comme des hypothèses, mettez donc les vôtres dans le calculateur. Le premier article d'explication sur Neon est ici, et le test du jour de lancement couvre le côté qualité. Cet article ne parle que d'argent.
Combien coûte Gemini 4 Neon par million de tokens ?
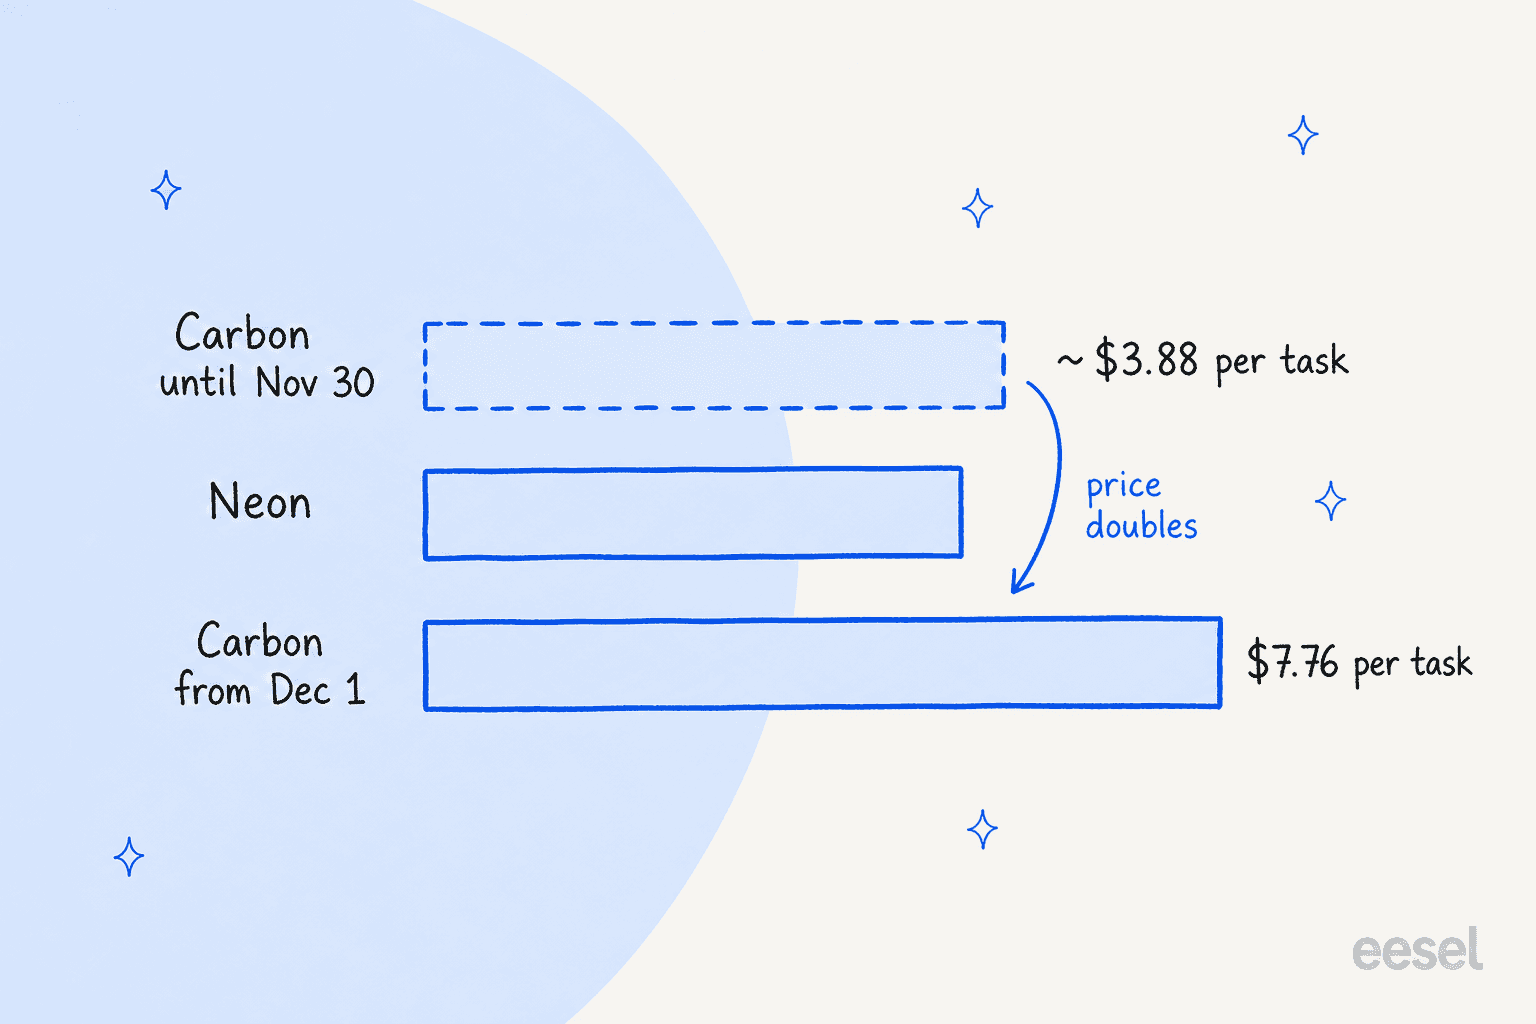
Neon est facturé par million de tokens sur quatre paliers de service. La page de Google indique un seul prix pour toute la fenêtre de contexte de 1,048,576 tokens, sans tarif plus élevé pour les prompts longs.
| Palier | Entrée | Sortie (réflexion incl.) | Entrée en cache | Vitesse et fiabilité |
|---|---|---|---|---|
| Batch | $1.50 | $7.50 | $0.075 | Asynchrone, jusqu'à 24 heures |
| Flex (aperçu) | $1.50 | $7.50 | $0.075 | Synchrone, cible 1 à 15 minutes, best effort |
| Standard | $3.00 | $15.00 | $0.15 | Secondes à minutes |
| Priority | $5.40 | $27.00 | $0.27 | Secondes, non délestable |
Trois détails que je ne passerais pas sous silence :
- Pas de palier gratuit. La colonne Free indique "Not available", et Google déclare que chaque token est compté et facturé. Gemini 4 Hydrogen en a bien un, c'est donc l'endroit le moins cher pour prototyper.
- Priority est le plus cher. Google le décrit comme 75 à 100% plus cher que Standard. Sur Neon, la page affiche
$5.40et$27.00, soit80%de plus. - Flex est une bonne affaire avec un piège. Il coûte le même
$1.50/$7.50que Batch, mais c'est une fonctionnalité en aperçu avec une disponibilité best effort. Google indique que ses économies ciblent "non-production evals, background agents, and data enrichment", et je n'y adosserais pas une réponse visible par les clients.
Vous pouvez accéder à Neon via l'API Gemini payante ou, selon la page des nouveautés de Google, via les forfaits Google AI Pro et Ultra dans AI Studio. L'accès par abonnement, comme Google AI Ultra, est une facture distincte de l'API, je le laisse donc hors du calcul ici.
Combien coûte vraiment une tâche sur Gemini 4 Neon ?
Les prix par token vous donnent le tarif, pas la facture, parce qu'un modèle qui réfléchit plus longtemps écrit plus de tokens de sortie. Voici les données d'Artificial Analysis par réglage pour Neon :
| Niveau de réflexion | Score d'index | Coût par tâche | Minutes par tâche | Tokens de sortie par tâche |
|---|---|---|---|---|
| low | 44.1 | $0.75 | 3.7 | 21,726 |
| medium | 54.9 | $1.90 | 8.3 | 50,000 |
| high (par défaut) | 59.6 | $3.74 | 14.8 | 90,188 |
| xhigh | 61.4 | $6.44 | 21.5 | 141,631 |
Le score par dollar chute vite. De medium à high, vous payez $1.84 de plus pour 4.7 points d'index. De high à xhigh, vous payez $2.70 de plus pour 1.8 points et attendez 6.7 minutes de plus. La recommandation de Google elle-même est de faire tourner vos évaluations aux quatre niveaux et de "pick the lowest thinking_level that meets your quality bar", ce qui est la bonne façon de lire ce tableau.
Voici la partie que j'ai trouvée la plus utile. Multipliez les tokens de sortie par $15 et high arrive à environ $1.35 des $3.74, soit environ 36%. Les $2.39 restants, c'est l'entrée, le contexte qu'un agent relit à chaque tour. Je suppose qu'Artificial Analysis facture au tarif public, traitez donc cette répartition comme un repère approximatif. Mais elle va dans le même sens à chaque niveau : dans le travail d'agents, le côté entrée est la plus grosse facture, et le taux de cache compte plus que le prix de sortie.
Gemini 4 Neon est-il moins cher que Carbon ?
À partir du 1er décembre, oui, environ de moitié. Avant, c'est presque une égalité.
Gemini 4 Carbon et Argon portent un prix de lancement sur la page de Google : $2.00 en entrée et $10.00 en sortie "through November 30, 2026", puis $4.00 et $20.00 à partir du 1er décembre. La ligne de Neon n'a ni date de fin ni palier.
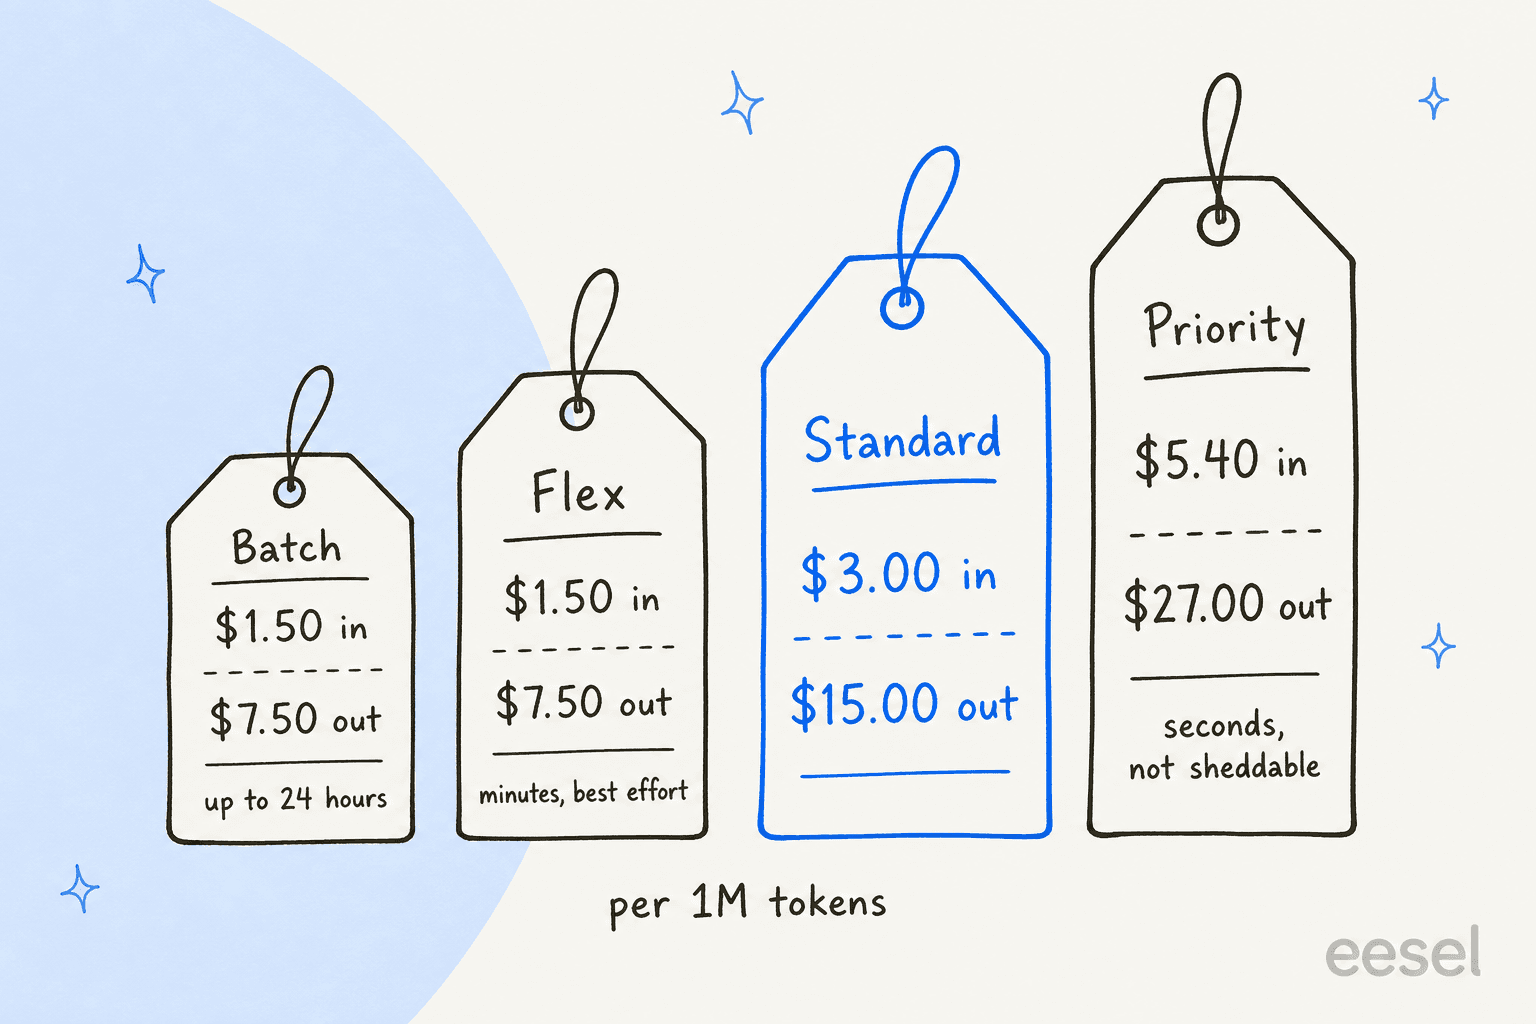
Le coût Artificial Analysis pour Carbon, $7.76 par tâche, est calculé au tarif de décembre. Sa page Carbon dit que Carbon "costs $4.00 per 1M input tokens and $20.00 per 1M output tokens". Les deux tarifs doublent le 1er décembre, donc le même travail coûte moitié moins jusque-là. Selon mon calcul, cela fait environ $3.88 par tâche jusqu'au 30 novembre, contre $3.74 pour Neon.
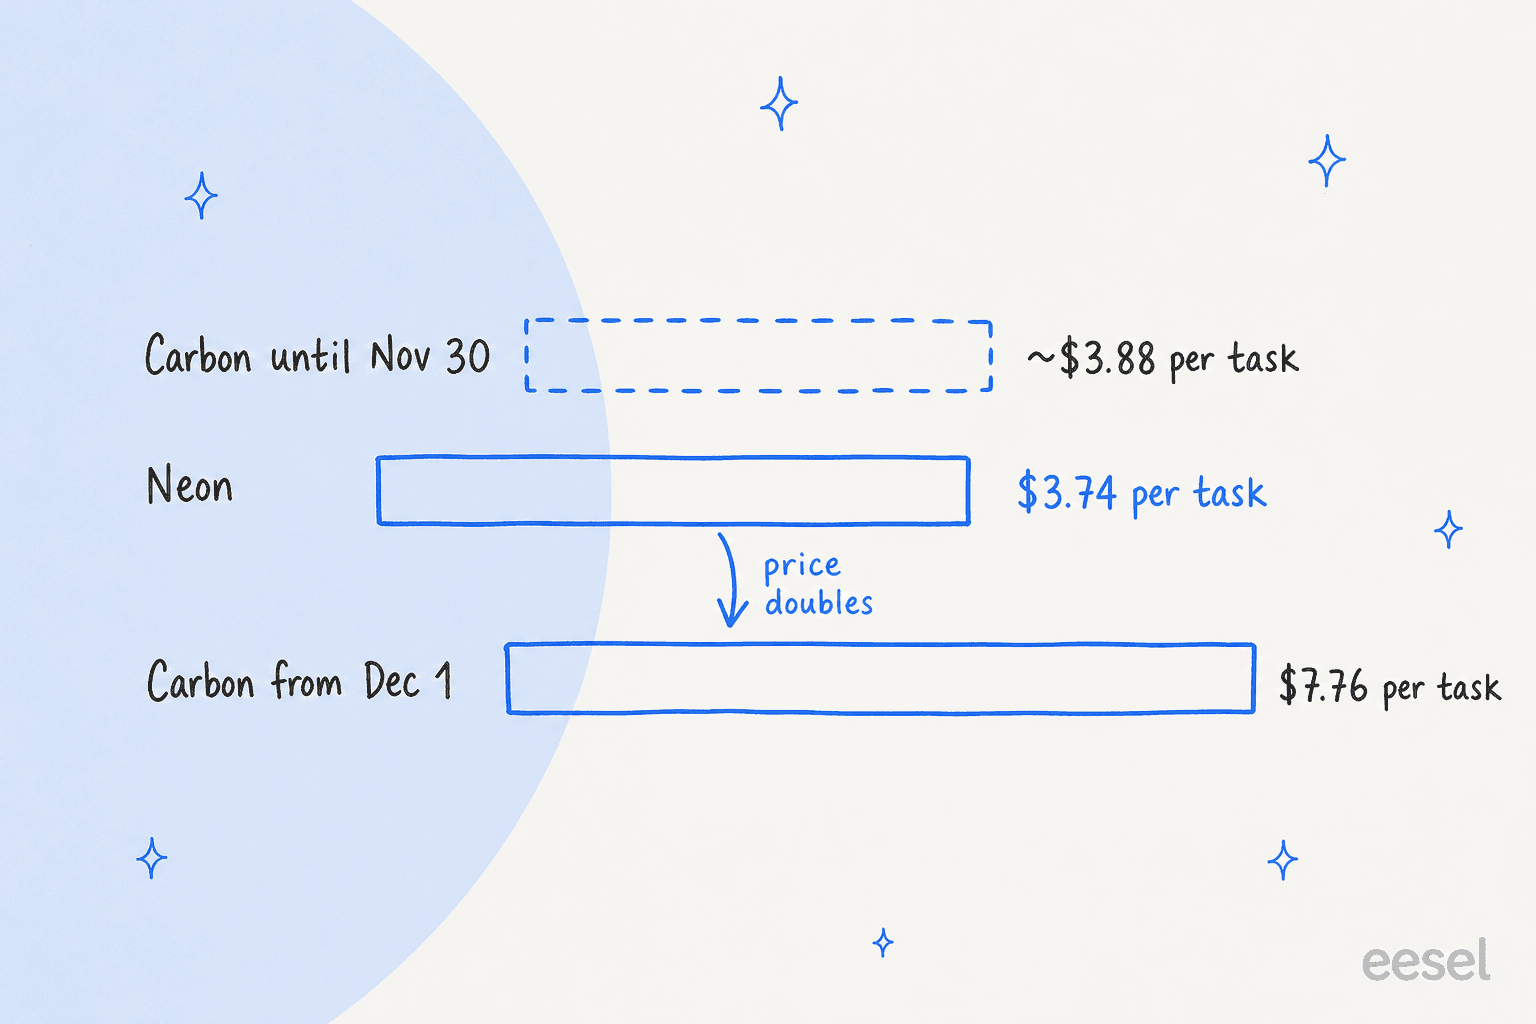
Les $3.88 sont mon estimation, pas un chiffre venant de l'une ou l'autre entreprise. Cela suppose que Carbon écrit le même nombre de tokens par tâche avant et après le changement de prix, ce qui devrait être le cas puisque le modèle est inchangé. L'affirmation de lancement de Google elle-même est un coût par tâche inférieur de 32% à Carbon, et le tarif public de décembre rend l'écart encore plus large que cela.
Ce que je ferais : si vous testez Carbon maintenant, budgétez au tarif de décembre, pas à la promo. Un lecteur de Hacker News a repéré le positionnement gênant le jour du lancement :
"So it's better and cheaper than the recently released Carbon? So Carbon is already deprecated, or?"

Il n'est pas déprécié. Il est tarifé pour être une promo jusqu'à la fin du mois, et Neon est le modèle au prix stable. Mon test de Carbon couvre où Carbon gagne encore, et l'article sur les tarifs d'Argon montre qu'il partage les paliers de prix de Carbon.
Comment Neon se compare-t-il à Astra, Sol et Opus en coût ?
Pas bien en prix. Par tâche, Neon est plus cher que les modèles d'OpenAI et moins cher que le réglage le plus poussé d'Anthropic, dont les tarifs sont dans le guide tarifs de l'API Anthropic. Voici les mêmes données d'Artificial Analysis, au réglage le mieux noté ou par défaut de chaque modèle :
| Modèle et réglage | Score d'index | Coût par tâche |
|---|---|---|
| GPT-6.2 Sol max | 57.3 | $1.01 |
| GPT-6.2 Astra high | 60.1 | $2.07 |
| Gemini 4 Neon high | 59.6 | $3.74 |
| Gemini 4 Hydrogen xhigh | 53.9 | $3.16 |
| Gemini 4 Carbon high (tarif de décembre) | 60.0 | $7.76 |
| Claude Opus 5.5 max | 59.1 | $10.04 |
Le prix par token d'Astra est plus élevé que celui de Neon, pourtant il est moins cher par tâche parce qu'il écrit environ 17,800 tokens là où Neon en écrit environ 90,200. Une grille tarifaire moins chère ne veut pas dire un modèle moins cher, et un lecteur de Hacker News a résumé le point de vue de l'acheteur sans détour :
"That looks to me like OpenAI equals or beats everything Google offers at half the price."
Sur le coût seul, je suis d'accord. L'argument de Neon, c'est son faible taux d'hallucination, que j'ai couvert dans le test. Si votre question est le prix, le test de GPT-6.2 Sol, mon panorama plus large des alternatives à Gemini et la comparaison OpenAI contre l'API Gemini sont de meilleurs points de départ.
Combien le cache économise-t-il sur Neon ?
Un hit de cache est facturé à $0.15 par million de tokens au lieu de $3.00, soit 95% moins cher sur ces tokens. Le piège, c'est que vous ne pouvez ni l'activer ni le diriger. La documentation de Google dit que le cache explicite n'est pas supporté pour les modèles Gemini 4, et que le cache implicite "is enabled by default". Trois règles décident si vous obtenez la remise :
- Le minimum est 4,096 tokens. Les prompts plus courts n'atteignent jamais le cache.
- L'ordre compte. Google dit de mettre "large and common contents at the beginning of your prompt" et d'envoyer des préfixes similaires rapprochés dans le temps.
- Les boucles d'agents ont un plancher. En usage multi-tours, Gemini ne met en cache toute la requête précédente que si la nouvelle requête ajoute au moins 2,050 tokens. Pour des ajouts plus petits, il "re-processes the last 2,050 tokens of the previous request at the standard input rate". La plupart des tours d'agents passent cette barre, mais un bot bavard avec des réponses courtes peut ne pas y arriver.
Voici ce que cela vaut sur un long document. Disons que vous chargez un ensemble de contrats de 500,000 tokens et posez 100 questions, chacune répondue en 2,000 tokens. Ce sont mes hypothèses, tarifées au taux Standard :
| Scénario | Coût d'entrée | Coût de sortie | Total pour 100 questions |
|---|---|---|---|
| Chaque question sans cache | $150.00 | $3.00 | $153.00 |
| Première sans cache, 99 hits de cache | $1.50 + $7.43 | $3.00 | $11.93 |
C'est une économie de 92%, mais seulement si chaque question suivante touche le cache, ce que le cache implicite ne garantit pas. Lisez usage.total_cached_tokens sur vos premières exécutions pour voir ce que vous obtenez vraiment avant de planifier autour de ça.
Combien coûte un mois réaliste ?
Cela dépend de trois chiffres que vous contrôlez : tokens en entrée, tokens en sortie et part de cache. J'ai construit un calculateur pour que vous puissiez mettre les vôtres. Il tarife la même charge de travail sur Neon, Hydrogen et les deux tarifs de Carbon.
Les valeurs par défaut sont ma charge de travail illustrative de tickets de support : 5,000 requêtes par mois, 6,000 tokens d'entrée chacune avec un préfixe en cache à 75%, et 1,500 tokens de sortie réflexion incluse. En Standard, cela fait environ $0.028 par requête et $138 par mois sur Neon. Le même ticket coûte environ $0.014 sur Hydrogen et, à partir de décembre, environ $0.037 sur Carbon.
Trois autres charges de travail, avec la même méthode :
| Charge de travail (mes hypothèses) | Neon, Standard | Pareil sur Batch ou Flex |
|---|---|---|
| 5,000 réponses de support, 6,000 en entrée (75% en cache), 1,500 en sortie | $138 | $69 |
| 5,000 réponses de support, aucun hit de cache | $202 | $101 |
200 tâches d'agent en high, aux $3.74 d'Artificial Analysis | $748 | $374 (ma division par deux) |
La ligne sans cache est celle à regarder. C'est la même logique que le coût par ticket, où l'unité par laquelle vous divisez compte plus que le tarif affiché. Perdre le cache ajoute 46% à la facture de support, et cela arrive en silence si votre prompt fait moins de 4,096 tokens ou si votre prompt système change à chaque requête.
Qu'est-ce qui apparaît d'autre sur une facture Neon ?
Quatre choses se situent hors du tarif par token.
- Grounding de recherche. Google donne 5,000 requêtes de recherche gratuites par mois, partagées entre tous les modèles Gemini 3 et plus récents, puis facture
$14pour 1,000 requêtes, avec un plafond quotidien de 1,500 requêtes. Google indique aussi qu'un prompt peut déclencher plusieurs recherches, et chacune est facturée. Il en va de même pour le grounding Maps. - Surcoût des outils. Google dit que chaque token traité par le modèle est facturé, "including thinking tokens and internal tool system instructions and function declarations when using grounding". Les longues listes d'outils sont aussi des tokens d'entrée.
- Sortie que vous n'avez pas lue. Les tokens de réflexion sont facturés même quand vous ne voyez qu'une réponse courte. Fixez
max_output_tokenssuffisamment haut pour que la limite ne coupe pas une exécution de raisonnement, mais surveillez les champs d'usage. - Décodage long. La sortie peut dépasser 65,536 tokens jusqu'à la fenêtre complète, et chacun de ces tokens coûte
$15par million.
Quel palier et quel niveau de Neon choisir ?
Choisissez la combinaison la moins chère qui atteint votre barre de qualité, puis mesurez pendant une semaine. Mes points de départ :
- Chat client en direct ou outil de code interactif : Standard en
medium. Priority coûte80%de plus et n'achète que de la fiabilité. - Évaluations de nuit, backfills, enrichissement de données : Batch pour tout ce qui peut attendre un jour, Flex pour tout ce qui a besoin de la réponse en minutes. Les deux sont
50%moins chers. - Une tâche d'agent difficile où
highne suffit pas :xhigh, pour 1.8 points d'index de plus et72%de coût par tâche en plus. Testez d'abord. - La qualité ne compte pas vraiment : utilisez Gemini 3.8 Flash ou Hydrogen. Neon n'est pas le modèle pour le travail bon marché.
Si vous choisissez un modèle pour un agent IA de support, la facture de tokens est la décision la moins importante. Mon guide sur le coût du service client par IA place la ligne du modèle juste à côté du logiciel, des personnes et du temps de relecture qui dominent généralement. Swiftreg, un vendeur britannique de plaques d'immatriculation privées, a fait tourner deux agents eesel sur Zendesk et traité environ 2,100 tickets entre le 8 août et le 8 septembre 2026, en envoyant 1,494 réponses publiques. Ses agents répondent à partir de recherches de commandes en direct écrites par l'équipe et portent des règles strictes sur ce qui doit aller à une personne. C'est cette configuration, pas le modèle, qui décide si une réponse est correcte, et cela vaut la peine de simuler sur des tickets passés avant de payer pour un meilleur modèle. Ma liste des meilleurs modèles IA pour les tickets de support est la prochaine étape.
Si votre équipe travaille dans un terminal, la CLI eesel permet à un agent de code de téléverser des articles d'aide et des macros exportés, d'ajuster les instructions de l'agent et de poser des questions de test avant la mise en production. Connecter le helpdesk lui-même nécessite toujours quelqu'un avec un accès admin pour l'approuver. Le schéma plus large est dans mon article sur les CLI de code agentique.
Mon verdict sur les tarifs de Gemini 4 Neon
Neon est tarifé de façon juste et n'est pas bon marché. Son tarif est stable, ses paliers sont clairs, et une voie Batch ou Flex à moitié prix est utile pour le travail en arrière-plan. Mais son coût par tâche dépend du niveau de réflexion que vous choisissez et du fait que vos prompts touchent le cache, mesurez donc les deux avant de vous engager. Si vous le comparez à Carbon, attendez le 1er décembre pour comparer les tarifs publics, et si le coût par tâche est votre seule contrainte, GPT-6.2 Astra et Sol sont moins chers. Pour la vue d'ensemble, commencez par le panorama des tarifs de Gemini, puis la comparaison ChatGPT contre Gemini.
Essayer eesel
Si vous tarifez un modèle parce que vous voulez de meilleures réponses dans votre file, le coéquipier IA de helpdesk d'eesel vous donne cela sans décision de modèle. Il apprend de vos tickets passés et de votre centre d'aide, passe la main à une personne quand la réponse n'est pas dans vos docs, et vous pouvez le tester sur un vrai historique de tickets avant qu'il ne réponde à qui que ce soit. Il fonctionne dans Zendesk, Freshdesk et d'autres helpdesks, comme dans l'exemple Zendesk ci-dessous.
Le tarif est un forfait de crédits mensuel fixe, avec un forfait gratuit de 100 crédits et sans carte, donc un changement de prix d'un modèle ne bouge pas votre facture. Essayez eesel sur une partie de votre file.
Comment fonctionne le cache de contexte sur Gemini 4 Neon et qu'économise-t-il ?