Les 8 meilleures alternatives à Meta Muse Spark Open en 2026, comparées sur la licence, le prix et le matériel

Rama Adi

Katelin Teen
Dernière modification October 18, 2026
En bref
La meilleure alternative à Muse Spark Open pour la plupart des équipes est GLM 5.3 : il obtient 45 dans le tableau comparatif de Meta contre 39 pour Muse Spark Open, pour 15 centimes de plus par million de tokens. Sa licence demande une mention de copyright et rien d'autre, sauf si vous dirigez une entreprise d'hébergement de modèles avec plus de 10 milliards de dollars de chiffre d'affaires.
Si le coût est la raison de votre recherche, DeepSeek V4.1 Flash est sous licence MIT et environ 7 fois moins cher en sortie (0,60 $ contre 4,25 $ par million de tokens, en heures creuses). Si c'est le matériel, gpt-oss-120b tourne sur un seul GPU de 80 Go. Si vous voulez les meilleurs scores en code et en vision, Kimi K3 domine, à 15 $ par million de tokens en sortie.
Restez sur Muse Spark Open si vous avez besoin du meilleur score d'usage d'outils (89,2 sur MCP-Atlas) et de la meilleure résistance au jailbreak de sa catégorie. Et si le modèle sert une file de support, le modèle est la décision la moins importante : le coéquipier IA helpdesk d'eesel gère déjà l'ancrage dans vos sources, les tests sur vos anciens tickets et les passages de relais, ce qu'aucun modèle open-weight ne propose.
Pourquoi on regarde au-delà de Muse Spark Open
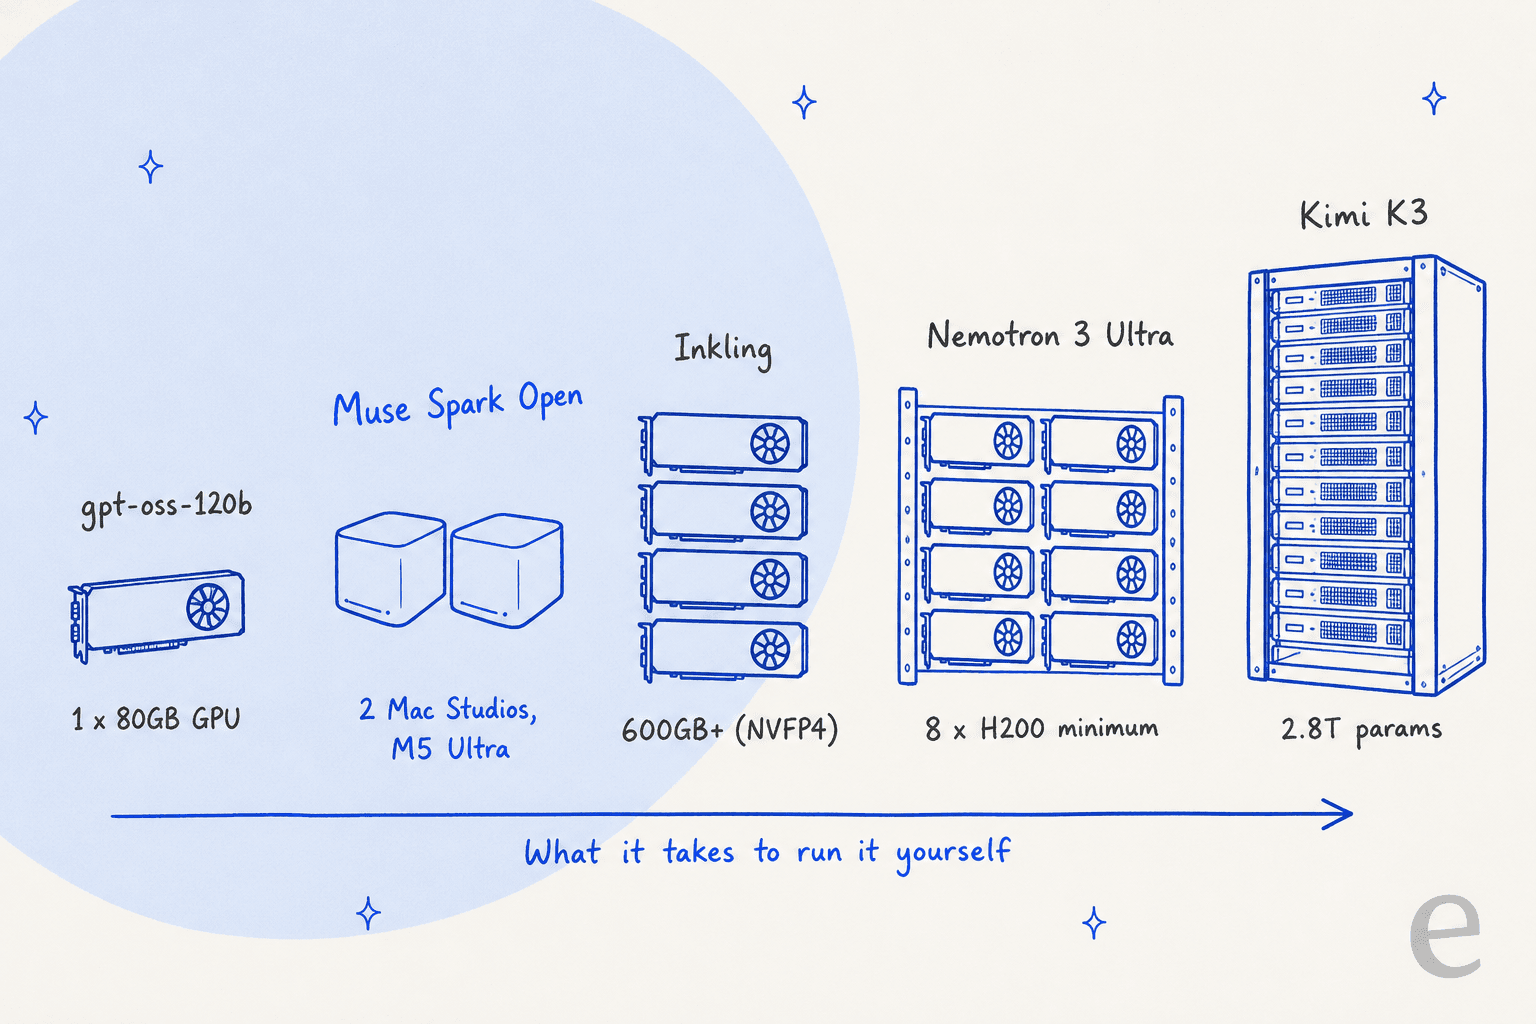
Meta a publié Muse Spark Open le 15 octobre 2026, et c'est un modèle sérieux. C'est un mixture-of-experts de 816B paramètres avec 42B actifs par token, une fenêtre de contexte de 1M de tokens et une entrée native texte, image, audio et vidéo, selon le blog de recherche de Meta. C'est aussi le premier modèle de sa catégorie qui tient sur un bureau : deux Mac Studio M5 Ultra, avec MLX d'Apple à 24,99 tokens par seconde.
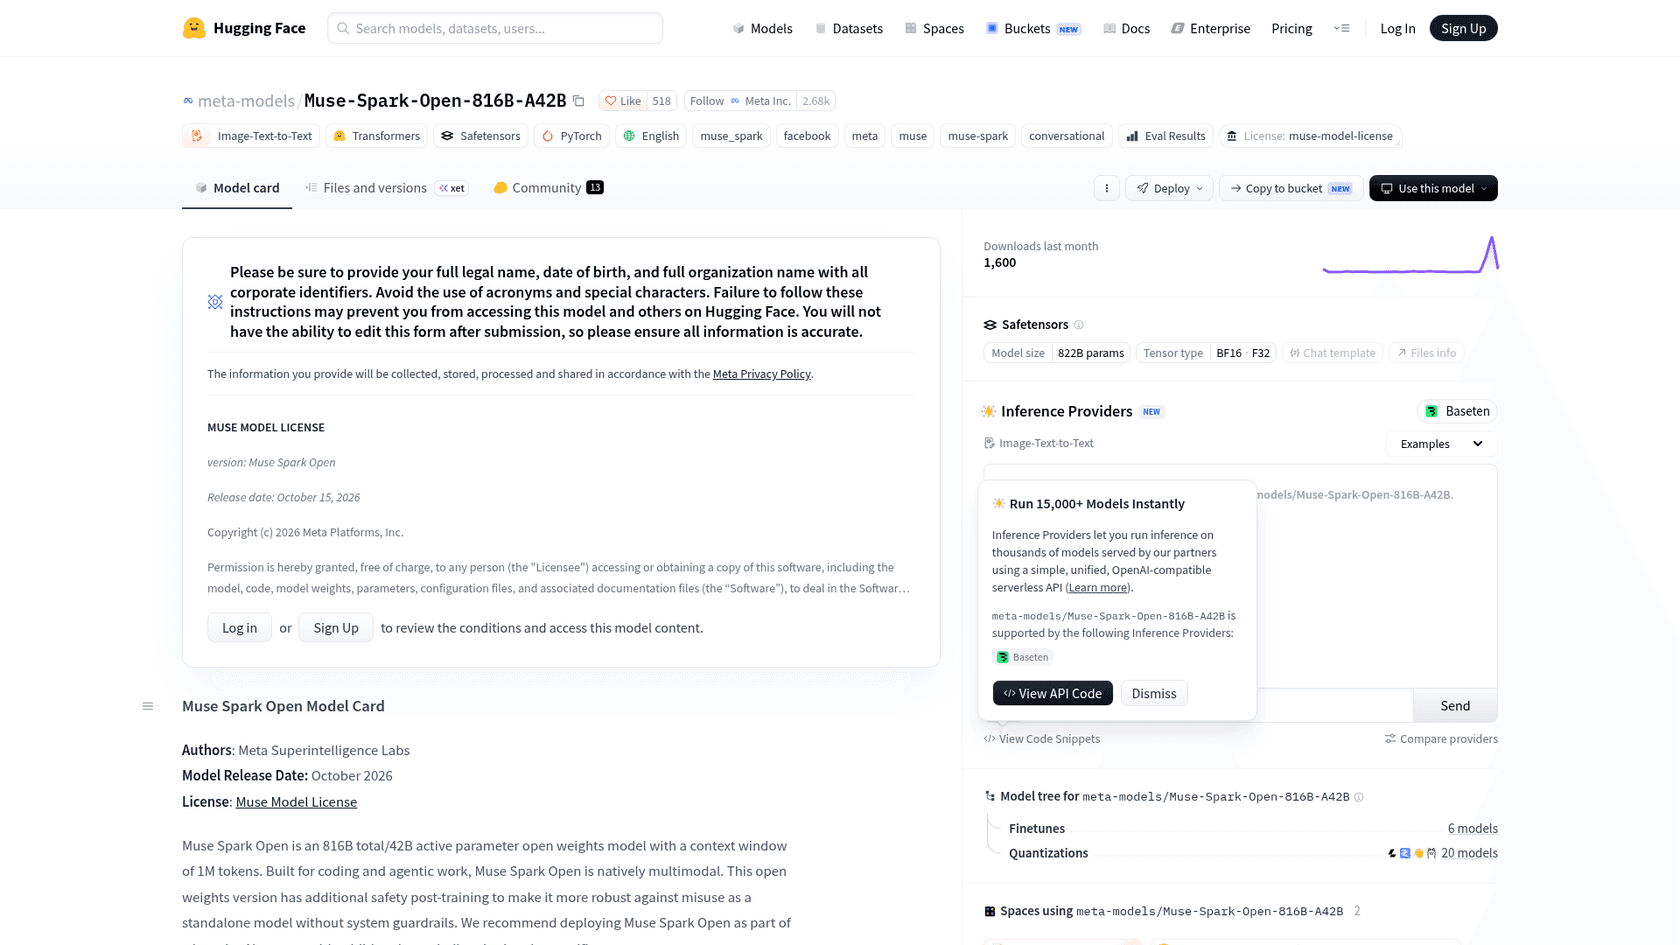
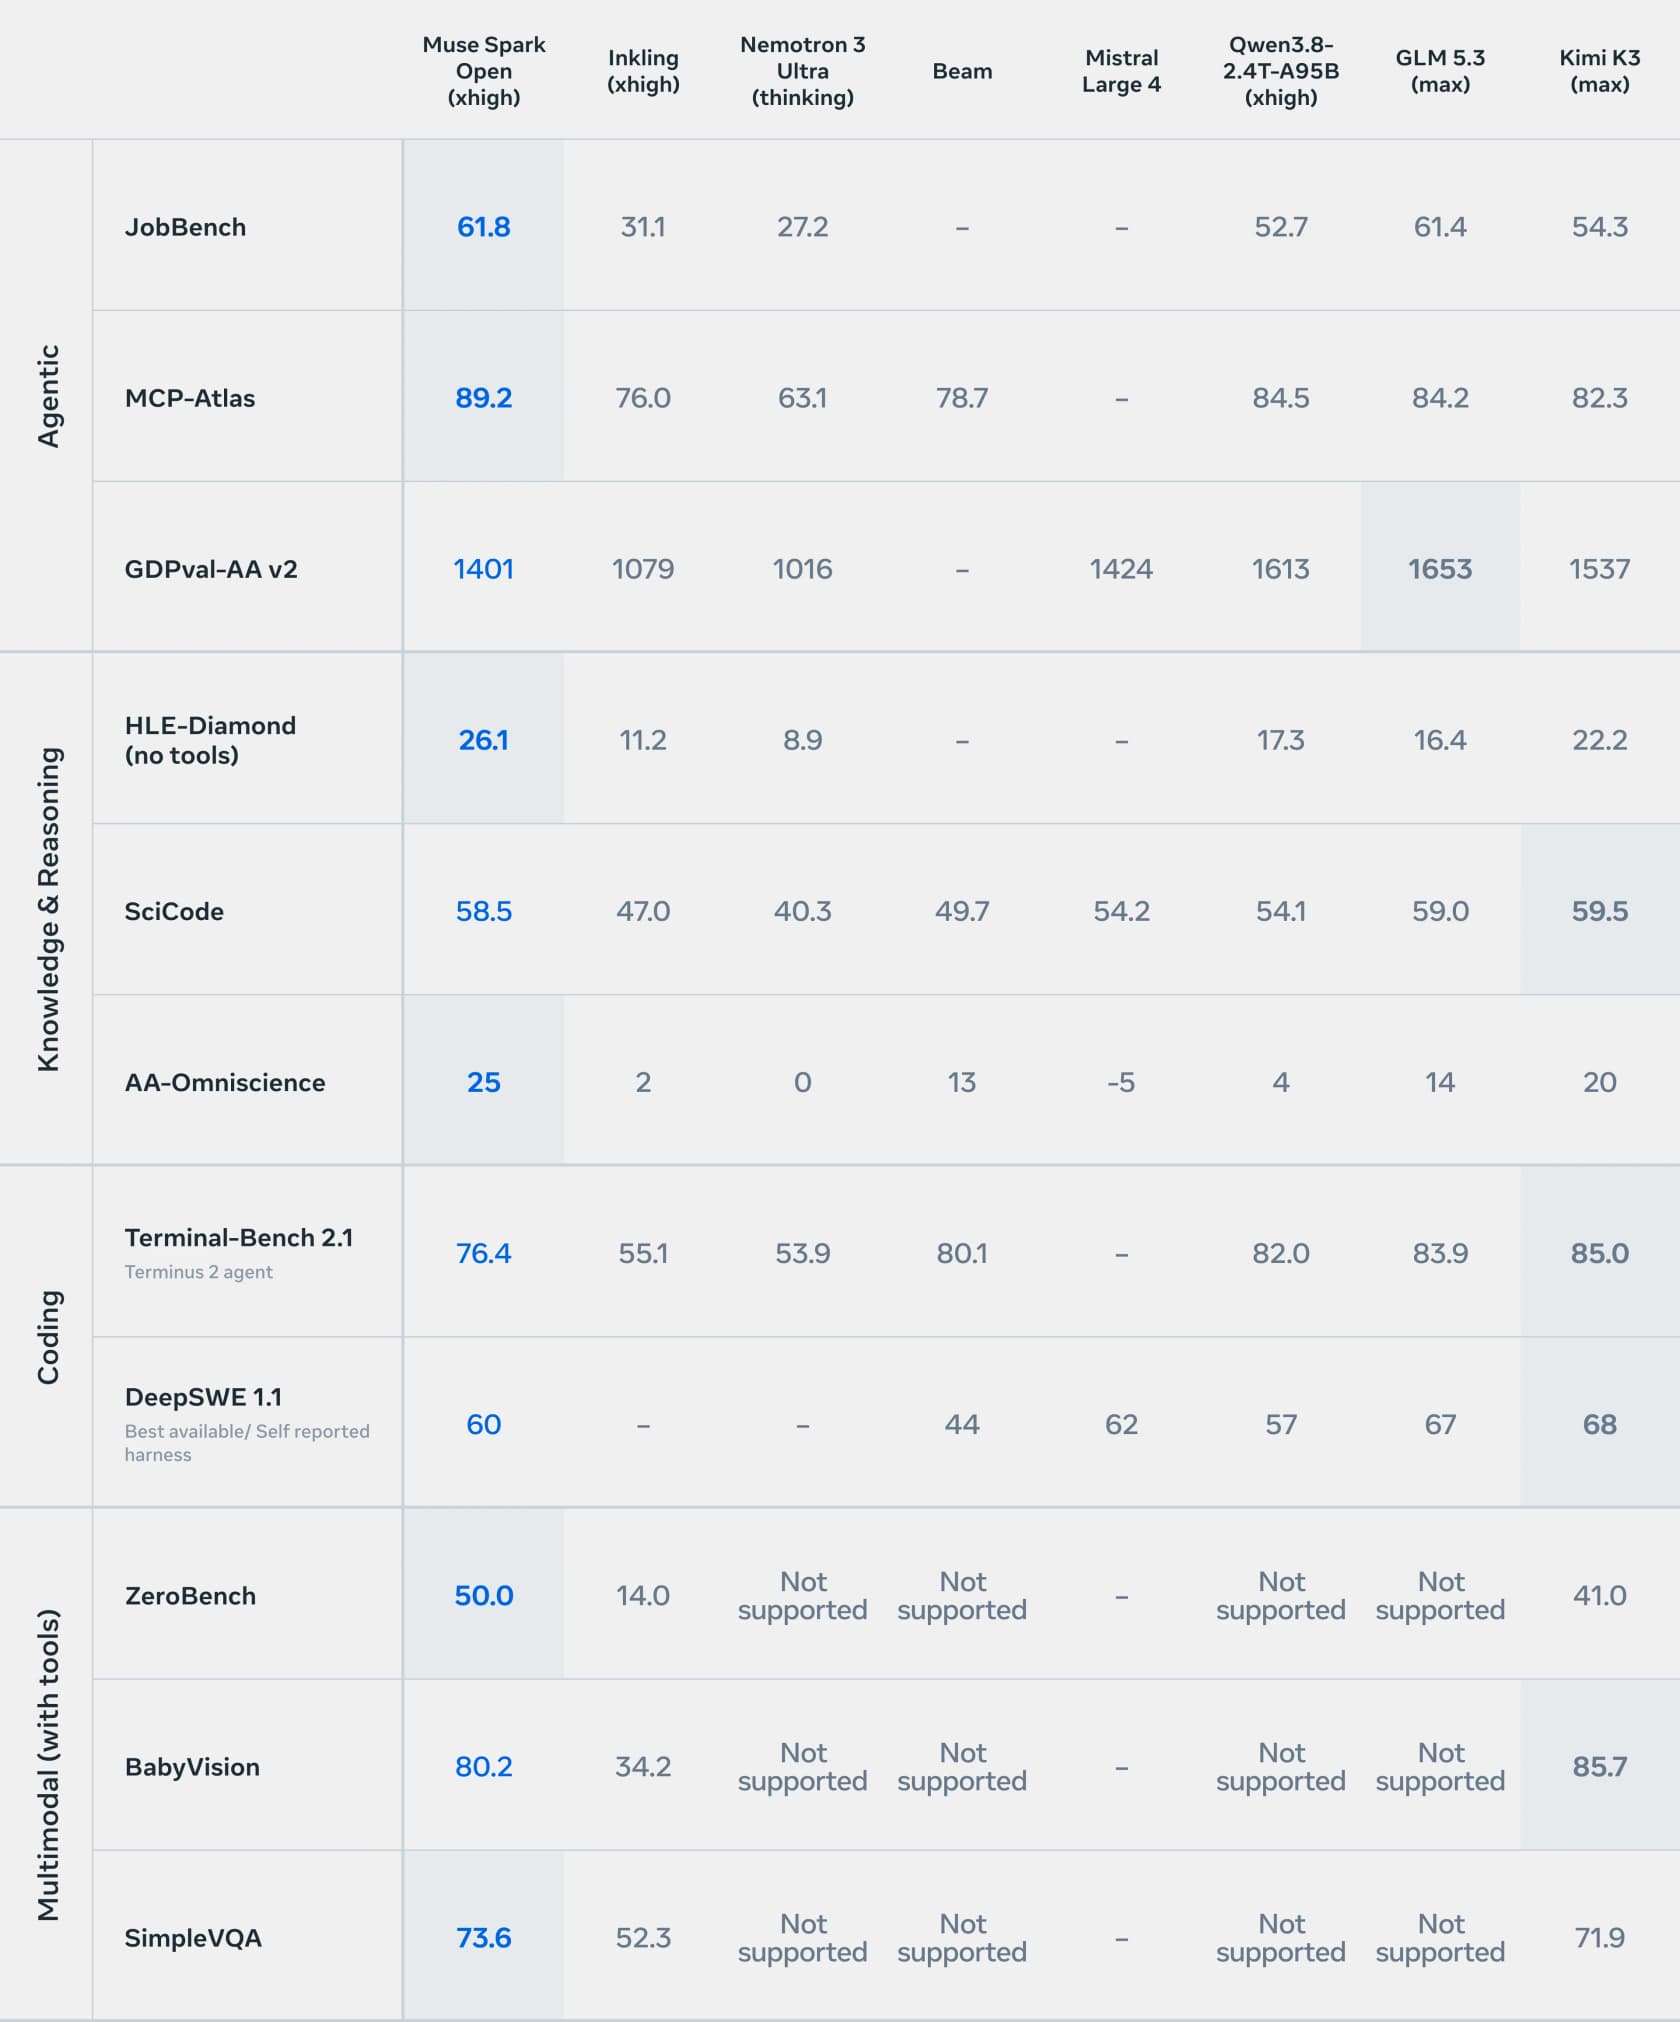
Je construis des intégrations et des API chez eesel, donc la première chose que je fais avec un nouveau modèle est de lire la licence et la grille tarifaire avant le graphique de benchmark. Muse Spark Open a de vraies forces sur ces points. Dans la fiche de modèle de Meta, il devance ses pairs sur MCP-Atlas (89,2), JobBench (61,8) et HLE-Diamond (26,1), et il affiche 0,5 sur StrongREJECT, là où tous les autres modèles du tableau se situent entre 62,9 et 86,4. Pour un agent qui appelle des outils toute la journée et doit refuser les mauvaises demandes, c'est une avance significative.
Mais quatre points reviennent sans cesse quand les gens décident de regarder ailleurs :
- Le score. Le tableau de Meta place Muse Spark Open à 39 sur l'Artificial Analysis Intelligence Index, derrière GLM 5.3 (45), Kimi K3 (44) et Qwen3.8 (40). Il est aussi distancé en code : 60 sur DeepSWE contre 68 pour Kimi K3.
- La licence. La Muse Model License vous impose d'afficher « prominently display 'Built with Muse Spark Open' » dans chaque produit qui l'utilise, quelle que soit sa taille. Les entreprises d'hébergement de modèles au-delà de 20 millions de dollars de chiffre d'affaires ont aussi besoin d'un accord distinct avec Meta.
- Le prix. Tous les hébergeurs sur OpenRouter facturent 1,25 $ en entrée et 4,25 $ en sortie par million de tokens, la même grille que le Muse Spark 1.3 fermé. Les poids ouverts font généralement baisser les prix hébergés. Ici, ce n'est pas le cas.
- Les sur-refus. Sur FORTRESS, le score de sur-refus de Muse Spark Open est de 17,4, contre 2,7 pour Kimi K3 et 3,2 pour GLM 5.3. L'entraînement à la sécurité qui le rend difficile à jailbreaker lui fait aussi refuser davantage de demandes inoffensives.
Le fil de lancement sur Hacker News est arrivé aux deux mêmes constats :
"The model license requires large inference providers to contact Meta separately to obtain a license to serve the model. I know we've seen this before with other large models, but it's still a bit irritating. The usual effect of separate licensing is decreased price competition from public providers (like we saw with Kimi K3)."

"Well, this is much better than nothing -- we should be grateful that whatever the market conditions and corporate incentives, a major lab is releasing a capable open-weight model. But still very far behind DeepSeek and GLM. Even on consumer hardware, Qwen 3.8 27B is going to compare favorably to this."
Comment j'ai choisi ces alternatives
Avant d'écrire cet article, j'ai demandé à ChatGPT avec quoi un développeur devrait comparer Muse Spark Open, et j'ai noté les recherches qu'il a lancées. Il est allé droit à « best open-weight language models 2026 Qwen DeepSeek Kimi GLM » et est revenu avec six noms : GLM 5.3, Kimi K3, Qwen3.8, DeepSeek V4, Mistral Large 4 et gpt-oss-120b. Je les ai tous gardés et j'ai ajouté les deux autres modèles ouverts du tableau comparatif de Meta, Nemotron 3 Ultra et Inkling.
Chaque alternative devait respecter trois règles :
- Les poids sont téléchargeables dès aujourd'hui, ou l'éditeur a pris un engagement public daté (seul Mistral Large 4 entre dans cette catégorie, et je le signale).
- Les prix viennent de la page de l'éditeur, ou de la page tarifaire d'un hébergeur nommé quand le laboratoire ne vend pas le modèle directement.
- Les scores viennent d'une seule source quand c'est possible. J'utilise le tableau comparatif de Meta, parce qu'il a fait passer tous les modèles dans le même banc d'essai, et je le précise quand un chiffre vient d'ailleurs.
J'ai comparé chacun sur les quatre mêmes questions : ce qu'il fait mieux que Muse Spark Open, où il est en retrait, ce qu'il coûte et ce que la licence vous demande.
Les alternatives à Muse Spark Open en un coup d'œil
| Modèle | Éditeur | Paramètres totaux / actifs | Contexte | Types d'entrée | Licence | Contreparties | Score dans le tableau de Meta | Prix hébergé, entrée / sortie par 1M | Matériel minimal pour l'auto-hébergement | Raisonnement désactivable |
|---|---|---|---|---|---|---|---|---|---|---|
| Muse Spark Open (référence) | Meta | 816B / 42B | 1M | Texte, image, audio, vidéo | Muse Model License | Mention « Built with » sur chaque produit ; accord pour les hébergeurs de modèles au-delà de 20 M$ de chiffre d'affaires | 39 | 1,25 $ / 4,25 $ | 2 Mac Studio (M5 Ultra) | Non |
| GLM 5.3 | Z.ai | 744B / 40B | 1M | Texte uniquement | GLM-5.3 License (de type MIT) | Revue de sécurité uniquement pour les hébergeurs de modèles au-delà de 10 Md$ de chiffre d'affaires | 45 | 1,40 $ / 4,40 $ | Non précisé | Non |
| Kimi K3 | Moonshot AI | 2,8T / 104B | 1M | Texte, image, vidéo | Kimi K3 License (de type MIT) | Afficher « Kimi K3 » au-delà de 100 M d'utilisateurs ou 20 M$/mois ; accord pour les hébergeurs de modèles au-delà de 20 M$ | 44 | 3,00 $ / 15,00 $ | Non précisé (2,8T paramètres) | Non |
| Qwen3.8 2.4T | Alibaba | 2,4T / 95B | 262K natif, jusqu'à 1M | Texte uniquement (base ouverte) | Qwen3.8 License | Afficher le nom au-delà de 100 M d'utilisateurs ou 20 M$/mois ; licence pour les hébergeurs de modèles au-delà de 50 M$ | 40 | 2,00 $ / 6,00 $ (Qwen3.8 Max) | Non précisé | Non (base ouverte) |
| DeepSeek V4.1 Flash | DeepSeek | 552B (8B / 16B actifs) | 1M | Texte, image | MIT | Conserver la mention de copyright | Absent du tableau | 0,15 $ / 0,60 $ en heures creuses | Non précisé | Oui |
| gpt-oss-120b | OpenAI | 117B / 5,1B | 128K | Texte uniquement | Apache 2.0 | Mentions lors de la redistribution | Absent du tableau | 0,15 $ / 0,60 $ (Together) | 1 GPU de 80 Go | Non (low / medium / high) |
| Mistral Large 4 | Mistral AI | 1,05T / 52B | 1M | Texte, image | Pas encore nommée | Poids attendus fin octobre | 38 | 0,68 $ / 2,09 $ (promotion) | Non précisé | Modèle hybride |
| Nemotron 3 Ultra | NVIDIA | 550B / 55B | Jusqu'à 1M (262K en configuration) | Texte uniquement | OpenMDW-1.1 | Mentions lors de la redistribution | 23 | 0,50 $ / 2,20 $ (DeepInfra) | 8 x H200 | Oui |
| Inkling | Thinking Machines Lab | 975B / 41B | 1M | Texte, image, audio | Apache 2.0 + politique d'usage | Politique d'usage (information sur l'IA) | 26 | 1,00 $ / 4,05 $ | 600 Go+ (NVFP4) | Contrôle de l'effort |
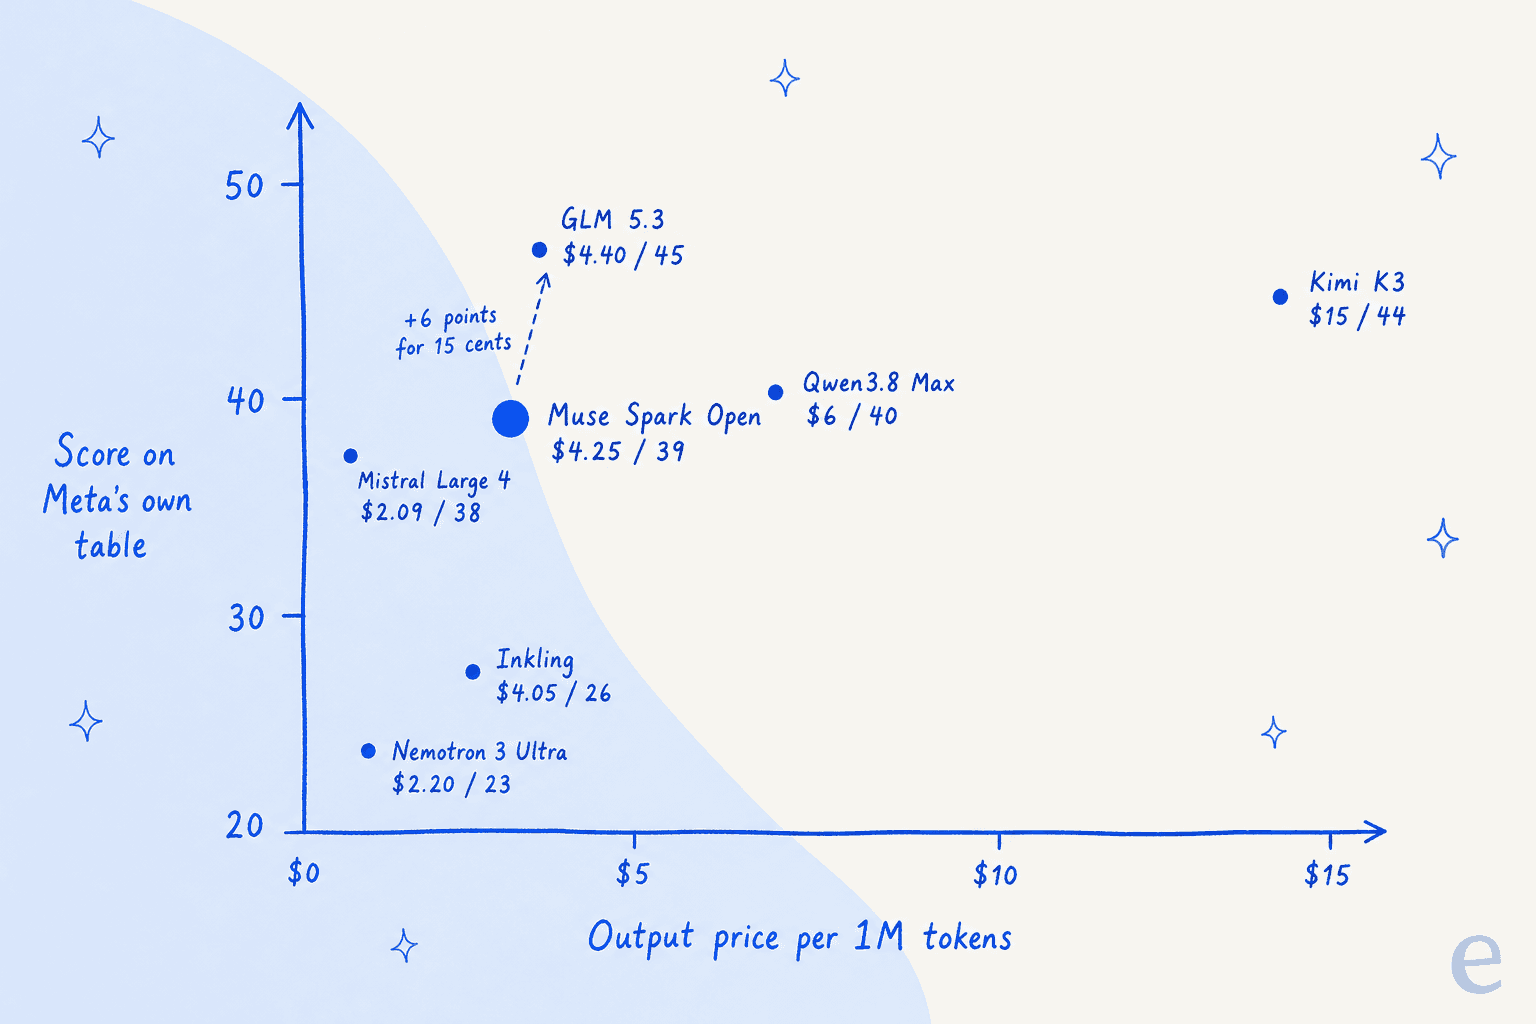
Le graphique résume tout l'argument en une image. Muse Spark Open se situe au milieu du peloton en prix et en score. GLM 5.3 est presque juste au-dessus. Kimi K3 achète quelques points avec une facture bien plus lourde, et Mistral Large 4 est moins cher pour à peu près le même score, mais seulement sur une API en préversion pour l'instant.
Quelle alternative correspond à votre raison de partir ?
La plupart des gens ne quittent pas Muse Spark Open pour « un meilleur modèle » en général. Ils partent pour une raison précise. Choisissez la vôtre et la recommandation correspondante s'affiche ci-dessous.
Choisissez la raison qui vous pousse à quitter Muse Spark Open pour voir l'alternative que je testerais en premier. Tous les chiffres viennent des pages des éditeurs et du tableau de Meta cités ci-dessous.
1. GLM 5.3
Idéal pour : les équipes qui veulent une montée en gamme directe par rapport à Muse Spark Open, à peu près au même prix, avec une licence plus légère.
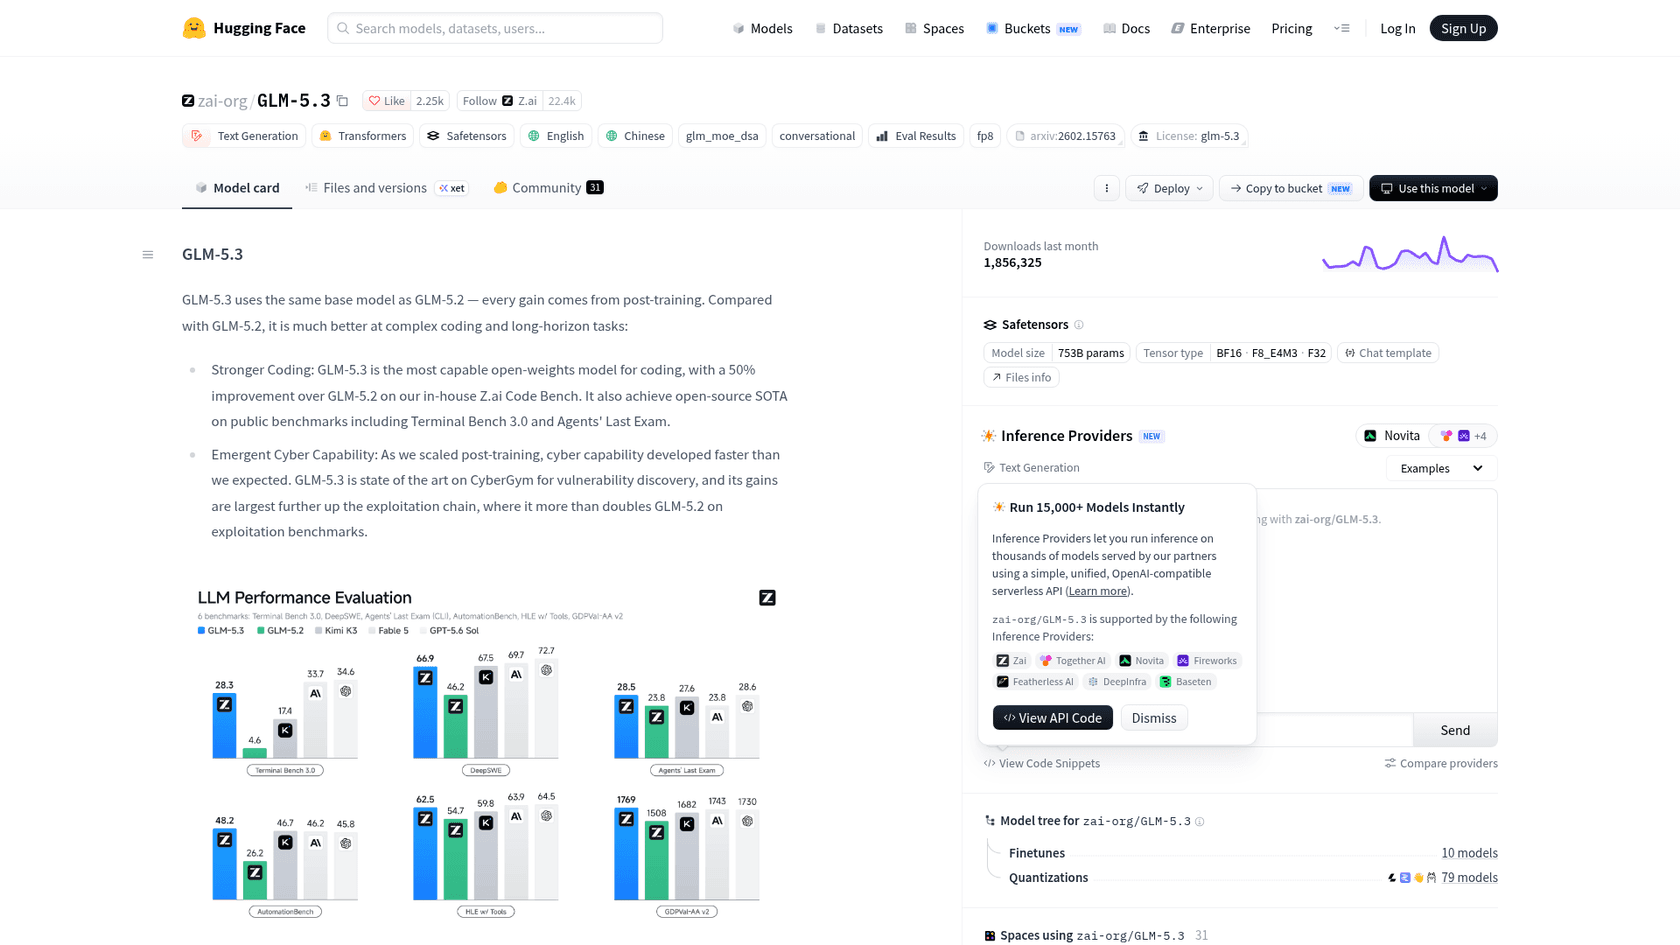
GLM 5.3 est le modèle phare de Z.ai, lancé le 14 août 2026. C'est un mixture-of-experts de 744B paramètres avec 40B actifs, selon le tableau de téléchargement GLM-5 de Z.ai, avec un contexte de 1M de tokens et jusqu'à 128K tokens en sortie. C'est le même modèle de base que GLM-5.2, et la fiche de modèle indique « every gain comes from post-training ». Ne le confondez pas avec le plus petit GLM 5.3 Flash, qui repose sur une autre base de 320B.
Ce qu'il fait mieux que Muse Spark Open. Dans le tableau de Meta lui-même, GLM 5.3 a le meilleur score d'Intelligence Index de tous les modèles ouverts (45 contre 39), le meilleur score GDPVal-AA v2 (1653 contre 1401), et mène sur HLE avec outils (62,5 contre 61,0), DeepSWE (67 contre 60) et Terminal-Bench 2.1 (83,9 contre 76,4). Il refuse aussi bien moins de demandes inoffensives (sur-refus FORTRESS 3,2 contre 17,4).
Où il est en retrait. Il est limité au texte, donc pas d'entrée image, audio ou vidéo. Le raisonnement ne peut pas être désactivé ; la documentation de Z.ai dit « disabling reasoning is no longer supported », et les niveaux d'effort sont low, high et max. Il perd face à Muse Spark Open sur MCP-Atlas (84,2 contre 89,2) et il est bien plus facile à jailbreaker (StrongREJECT 62,9 contre 0,5).
"Feels dumber than GLM 5.3 (only open model I use extensively). But is really fast (fireworks.ai)."
Prix et licence. La page tarifaire de Z.ai affiche GLM 5.3 à 1,40 $ par million de tokens en entrée, 0,26 $ en cache et 4,40 $ en sortie, sans changement depuis le lancement. C'est 15 centimes de plus que Muse Spark Open en entrée comme en sortie. La GLM-5.3 License est de type MIT avec une seule condition : une entreprise d'hébergement de modèles dont le chiffre d'affaires du groupe dépasse 10 milliards de dollars doit passer la revue de sécurité de Z.ai. Les produits qui intègrent le modèle dans une fonctionnalité sont exclus de cette définition, et il n'y a pas de règle d'affichage.
| Offre | Entrée par 1M | Entrée en cache par 1M | Sortie par 1M |
|---|---|---|---|
| GLM 5.3 | 1,40 $ | 0,26 $ | 4,40 $ |
| GLM 5.3 FlashX | 0,37 $ | 0,075 $ | 1,25 $ |
| GLM 5.3 Flash | 0,15 $ | 0,03 $ | 0,50 $ |
Verdict : c'est l'alternative que je testerais en premier. Si vous n'avez pas besoin d'entrée multimodale, GLM 5.3 vous offre un meilleur score, moins de refus et une licence plus souple pour 15 centimes de plus par million de tokens. Passez votre chemin seulement si les images, l'audio ou la précision des appels d'outils sont au cœur de votre usage.
2. Kimi K3
Idéal pour : les agents de code et le travail multimodal où la qualité compte plus que la facture de tokens.
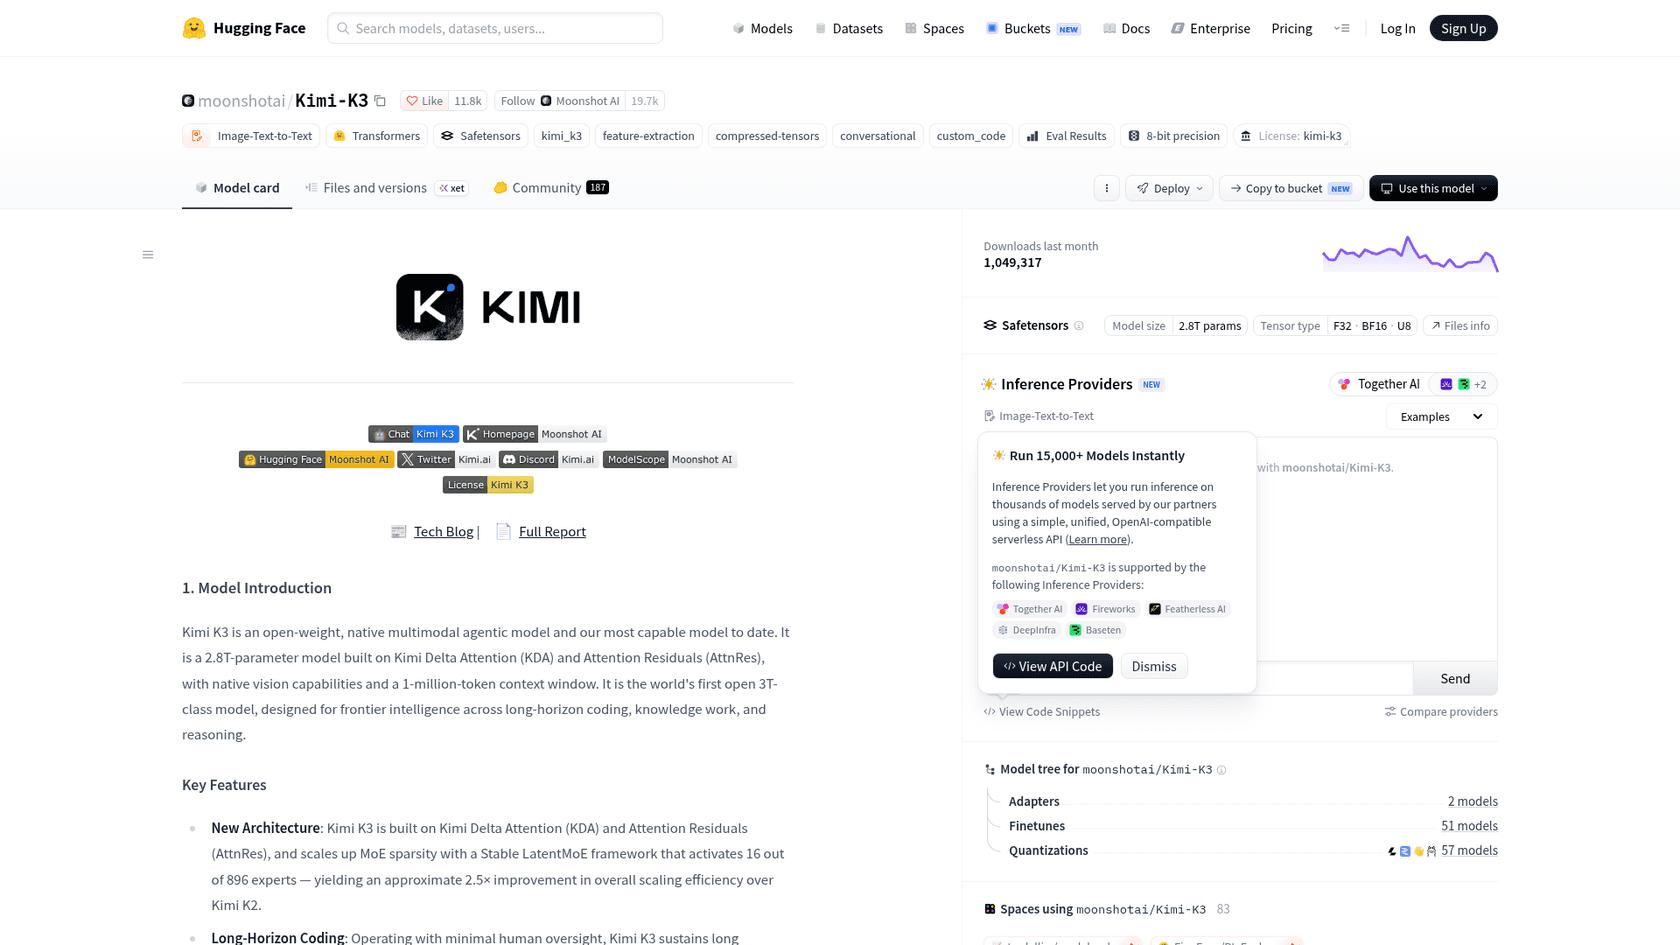
Kimi K3 est le modèle phare de Moonshot AI, sorti en juillet 2026 avec des poids sur Hugging Face. C'est le plus gros modèle de cette liste : 2,8T paramètres au total, 104B actifs, 896 experts dont 16 sélectionnés par token. Il lit nativement le texte, les images et la vidéo et gère 1M de tokens de contexte, avec une sortie configurable jusqu'à 1 048 576 tokens selon le guide de démarrage de K3.
Ce qu'il fait mieux que Muse Spark Open. Kimi K3 est le leader en code dans le tableau de Meta : DeepSWE 68 contre 60, SWE-Atlas-QnA 66 contre 58, Terminal-Bench 2.1 85,0 contre 76,4. Il gagne aussi sur OSWorld Verified (84,8 contre 80,4), Toolathlon (76,5 contre 72,8) et le benchmark vidéo VideoMMEv2 (65,4 contre 61,5). Il a le score de sur-refus le plus bas de l'ensemble, à 2,7.
Où il est en retrait. Muse Spark Open le bat sur MCP-Atlas (89,2 contre 82,3), JobBench (61,8 contre 54,3) et la sécurité. La fiche de Meta indique que Kimi K3 n'a refusé que 75,5 % des jailbreaks sur le benchmark cyber interne de Meta, contre 99,2 % pour Muse Spark Open. Le raisonnement ne peut pas être désactivé, et l'API n'accepte pas les URL d'images publiques, seulement du base64 ou des identifiants de fichiers téléversés.
Prix et licence. La page tarifaire de Moonshot affiche 3,00 $ par million de tokens en entrée, 0,30 $ en cache et 15,00 $ en sortie, tarif fixe sur tout le contexte de 1M. Un détail récent : les écritures en cache sont désormais facturées à part, à 3,00 $ par million pour un cache de 5 minutes et 6,00 $ pour un cache d'une heure. La Kimi K3 License est proche de celle de Muse Spark Open côté hébergement (un accord distinct pour les entreprises d'hébergement de modèles au-delà de 20 millions de dollars par an), mais sa règle d'affichage ne s'applique qu'au-delà de 100 millions d'utilisateurs mensuels ou de 20 millions de dollars de chiffre d'affaires mensuel.
"I believe it's because they are below $20 Million revenue limit (which Kimi K3's license has) So we won't see any price decrease unless Kimi changes the license of K3"
Verdict : Kimi K3 est le bon choix quand les scores en code décident du projet. Il coûte 3,5 fois le prix de sortie de Muse Spark Open, donc je n'y recourrais que pour les tâches qui l'exigent, en routant tout le reste vers quelque chose de moins cher. Mon analyse des tarifs de Kimi K3 détaille le calcul.
3. Qwen3.8
Idéal pour : les équipes qui veulent une seule famille de modèles allant d'un simple Mac à un modèle phare hébergé.
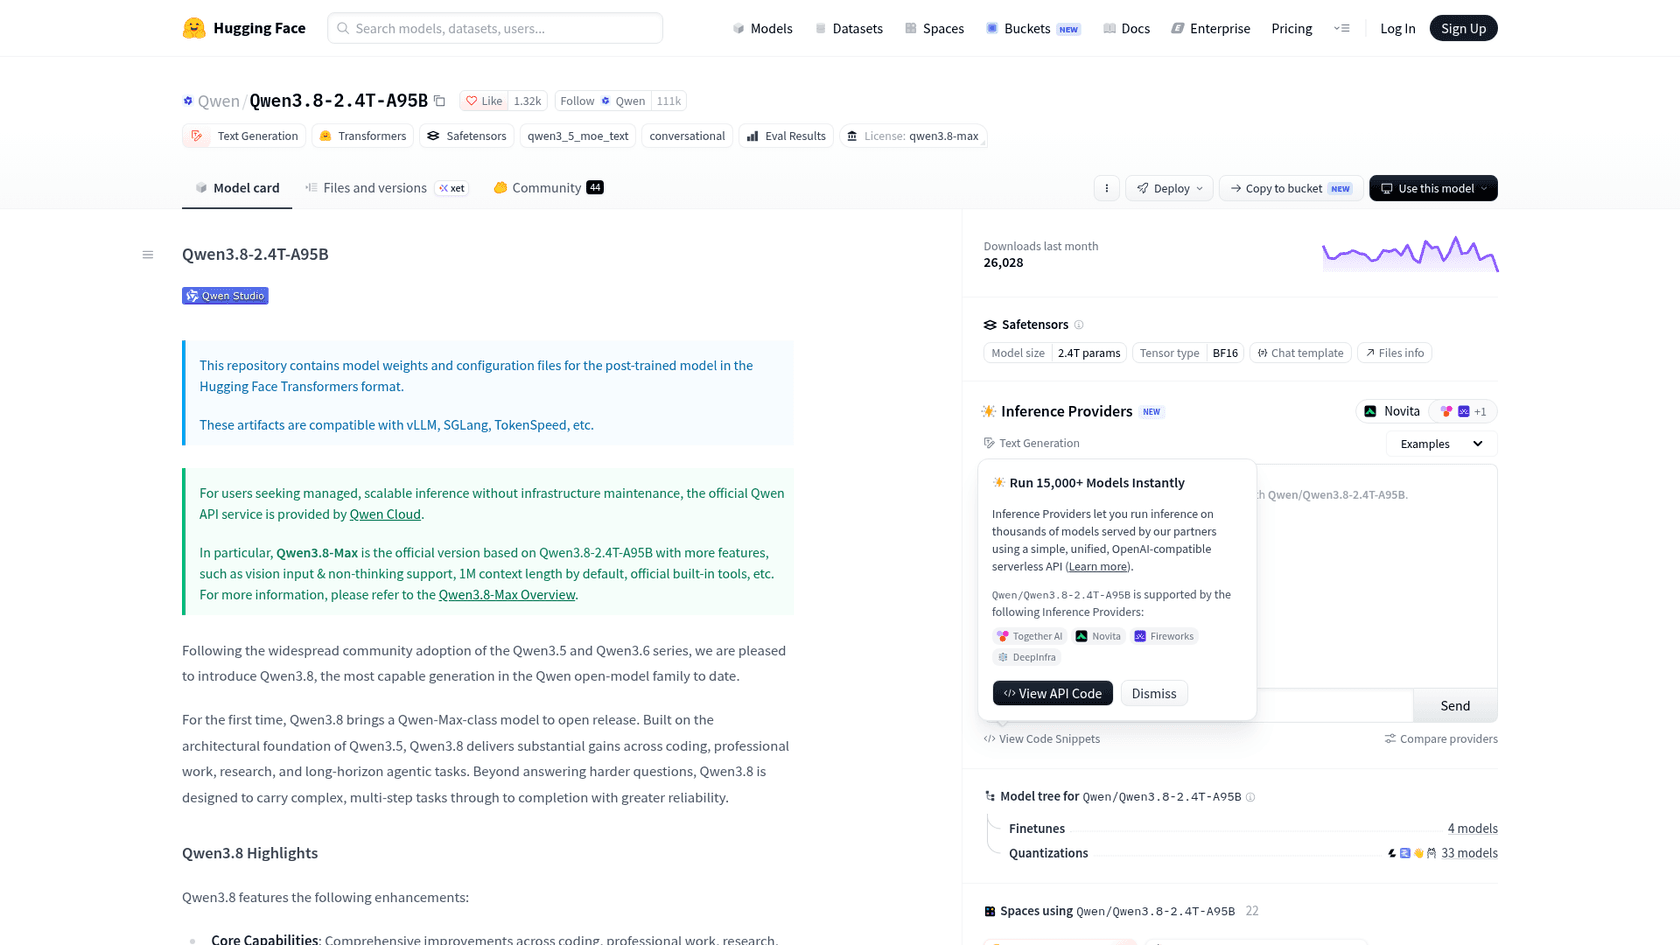
Qwen3.8 regroupe en réalité deux publications ouvertes. Le gros, Qwen3.8-2.4T-A95B, est un mixture-of-experts de 2,4T paramètres avec 95B actifs. Son contexte est de 262 144 tokens en natif, extensible jusqu'à environ 1M. Le petit, Qwen3.8-27B, est un modèle dense de 27B qui lit les images et la vidéo et permet de désactiver la réflexion à chaque requête. Le Qwen3.8 Max hébergé repose sur la grande base, avec en plus la vision, un mode sans réflexion et des outils intégrés.
Ce qu'il fait mieux que Muse Spark Open. Dans le tableau de Meta, la base ouverte 2.4T obtient 40 sur l'Intelligence Index (un point d'avance), égale Kimi K3 pour le meilleur score GPQA Diamond (93,5 contre 89,0), et bat Muse Spark Open sur Terminal-Bench 2.1 (82,0 contre 76,4), SWE-Atlas-QnA (62 contre 58) et GDPVal-AA v2 (1613 contre 1401). Le 27B est la vraie surprise : les benchmarks MLX d'Apple montrent qu'il tient sur un seul Mac Studio en utilisant jusqu'à 68 Go de mémoire avec un contexte de 65 536 tokens.
Où il est en retrait. La base ouverte 2.4T est plus limitée qu'on ne le croit. La fiche de modèle indique qu'elle « is a text-only model that requires thinking mode for all interactions », donc la vision et le mode sans réflexion sont réservés au Max hébergé. Elle est derrière Muse Spark Open sur MCP-Atlas (84,5 contre 89,2), JobBench (52,7 contre 61,8) et HLE-Diamond (17,3 contre 26,1).
"From running small models like Qwen3.8-27B to large models like Qwen3.8-2.4T. I can tell you that small models will never be enough or match up. Everyone will want the smartest model, not just a good enough model."
Prix et licence. Alibaba ne vend pas directement la base ouverte. La voie hébergée est Qwen3.8 Max sur QwenCloud, à 2 $ en entrée et 6 $ en sortie par million de tokens, avec des hits de cache implicite à 0,25 $. Le 27B a désormais sa propre page hébergée à 0,50 $ en entrée et 3 $ en sortie. La base 2.4T est livrée sous la Qwen3.8 License, avec une règle d'affichage au-delà de 100 millions d'utilisateurs mensuels ou de 20 millions de dollars de chiffre d'affaires mensuel, et une licence distincte pour les entreprises d'hébergement de modèles ou d'assistants de travail IA au-delà de 50 millions de dollars. Le 27B est sous Apache 2.0 pur.
| Modèle | Entrée par 1M | Entrée en cache par 1M | Sortie par 1M | Licence |
|---|---|---|---|---|
| Qwen3.8 Max (hébergé) | 2,00 $ | 0,25 $ (implicite) | 6,00 $ | Hébergé uniquement |
| Qwen3.8-27B (hébergé) | 0,50 $ | 0,10 $ (implicite) | 3,00 $ | Apache 2.0 |
| Qwen3.8-2.4T-A95B | Auto-hébergement ou tiers | n/a | n/a | Qwen3.8 License |
Verdict : Qwen3.8 est le choix de la famille. Utilisez le 27B là où vous auriez utilisé un petit modèle Muse sur un portable ou un seul Mac, et le Max hébergé quand il vous faut le gros. Si vous voulez le 2.4T pour ses poids ouverts, rappelez-vous qu'il est limité au texte. Pour des comparaisons directes, voyez Qwen3.8 Max contre Kimi K3.
4. DeepSeek V4.1 Flash
Idéal pour : les charges à gros volume où le coût des tokens décide de tout.
DeepSeek V4.1 Flash a été lancé le 10 septembre 2026 et a reçu une mise à jour le 17 octobre : DeepSeek-V4.1-Flash-1017, que DeepSeek décrit comme offrant « stronger benchmark performance, faster task completion, and shorter outputs than the previous version ». C'est un mixture-of-experts de 552B paramètres avec une répartition inhabituelle : 8B de paramètres actifs pour lire l'entrée et 16B pour écrire la sortie, selon les notes de lancement. Il a un contexte de 1M, jusqu'à 384K tokens en sortie et l'entrée vision.
Ce qu'il fait mieux que Muse Spark Open. Le prix, de très loin. Et sur la fiche de DeepSeek pour la version 1017, DeepSWE v1.1 monte à 77,0, ce qui battrait tous les modèles du tableau de Meta, même s'il s'agit d'un chiffre de l'éditeur issu d'un autre banc d'essai. DeepSeek n'apparaît pas dans la comparaison de Meta. Un commentateur du fil de lancement de Muse Spark Open a signalé qu'Artificial Analysis place la version précédente de V4.1 Flash au même score que Muse Spark Open :
"Crucially, it's about the same as DeepSeek v4.1 Flash, and about 10x more expensive to run...
No thanks..."
Où il est en retrait. Les tokens de raisonnement sont facturés comme de la sortie, et la réflexion est activée par défaut, donc un tarif bas peut quand même se transformer en grosse facture sur les longues réponses. Les conditions de l'API payante ne disent rien sur un éventuel entraînement de DeepSeek sur vos entrées, sans option de rétention zéro publiée, ce qui compte si vous comptez envoyer des données clients à l'API de l'éditeur. Héberger vous-même les poids MIT ou passer par un hébergeur tiers évite cette question.
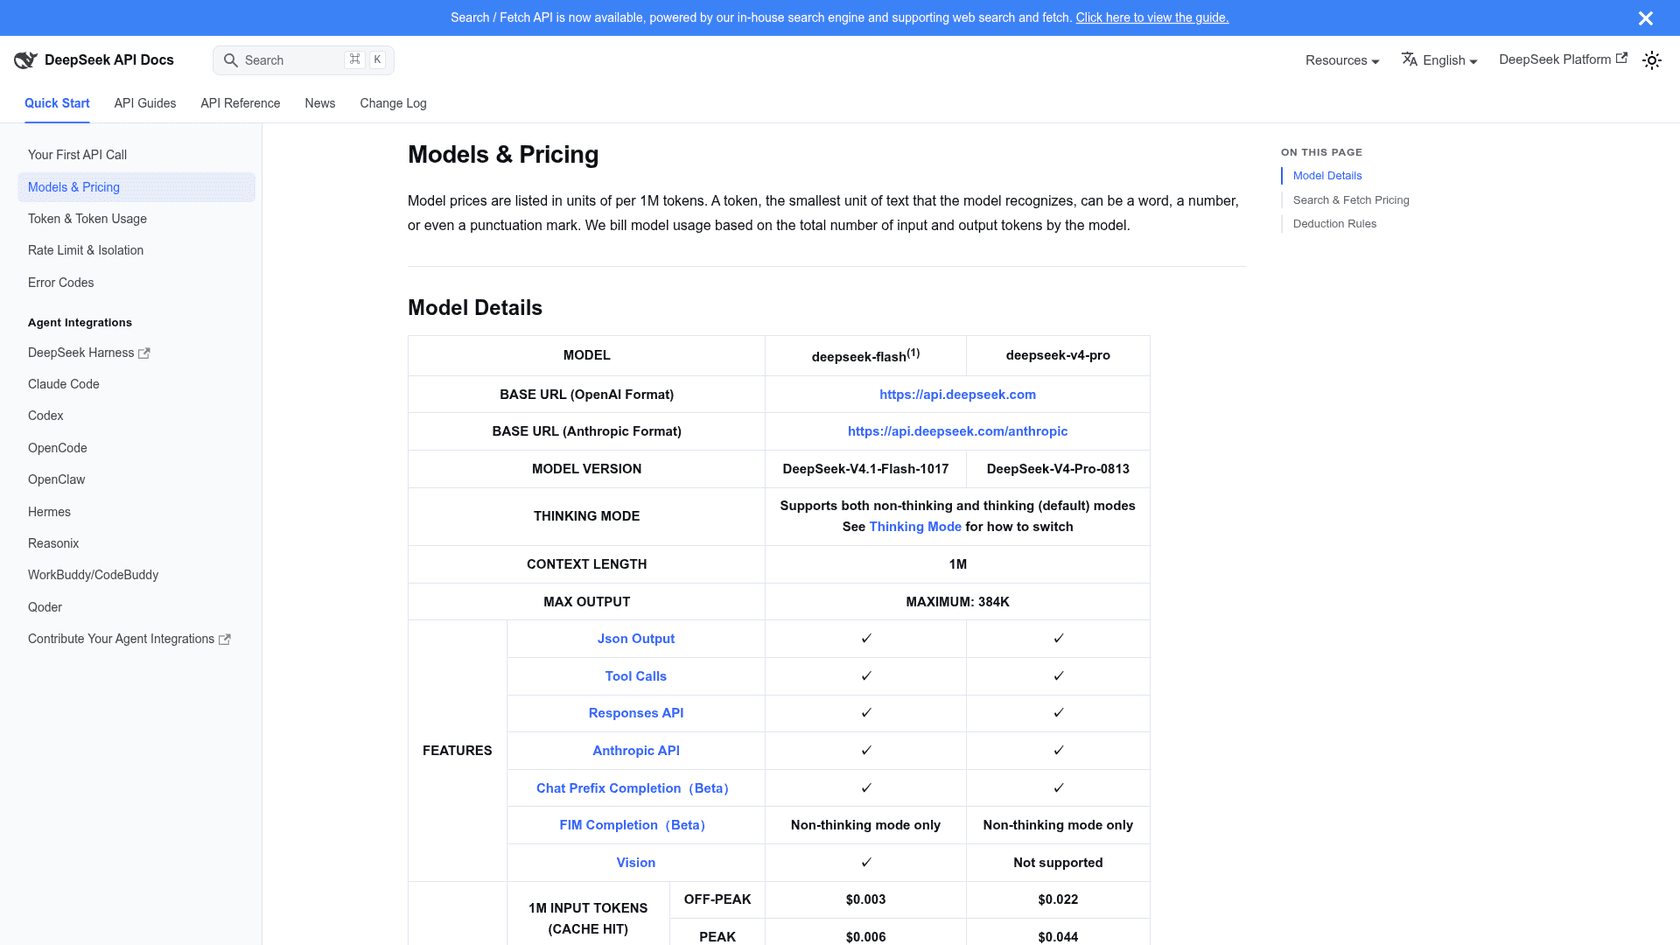
Prix et licence. La page tarifaire de DeepSeek comporte deux tarifs. Les heures de pointe sont 01h00-04h00 et 06h00-10h00 UTC en semaine ; tout le reste est en heures creuses à moitié prix.
| Tarif | Entrée avec cache par 1M | Entrée sans cache par 1M | Sortie par 1M |
|---|---|---|---|
| Heures creuses | 0,003 $ | 0,15 $ | 0,60 $ |
| Heures de pointe | 0,006 $ | 0,30 $ | 1,20 $ |
Les poids sont sous licence MIT : conservez la mention de copyright, et c'est tout. Pas de seuil de chiffre d'affaires, pas de règle d'affichage.
"I've been using DS v4.1 Flash daily for nearly a month now on Agent Swarm experiments. I've tested it against GLM-5.3-flash and Opus 5.5. DS 4.1 comes out tops for me. Opus 5.5 is still the smartest, but DS 4.1's speed and price more than make up for the "intelligence" gap."
Verdict : si vous comptiez appeler Muse Spark Open des millions de fois par jour, passez d'abord le même jeu de tests sur DeepSeek V4.1 Flash. À 0,60 $ par million de tokens en sortie en heures creuses, il est environ 7 fois moins cher sous la licence la plus permissive de cette liste. Voyez les tarifs de DeepSeek V4.1 Flash pour le calcul des heures de pointe.
5. gpt-oss-120b
Idéal pour : les équipes qui doivent s'auto-héberger sur un seul GPU, et tous ceux qui veulent une référence bon marché pour tester de plus gros modèles.
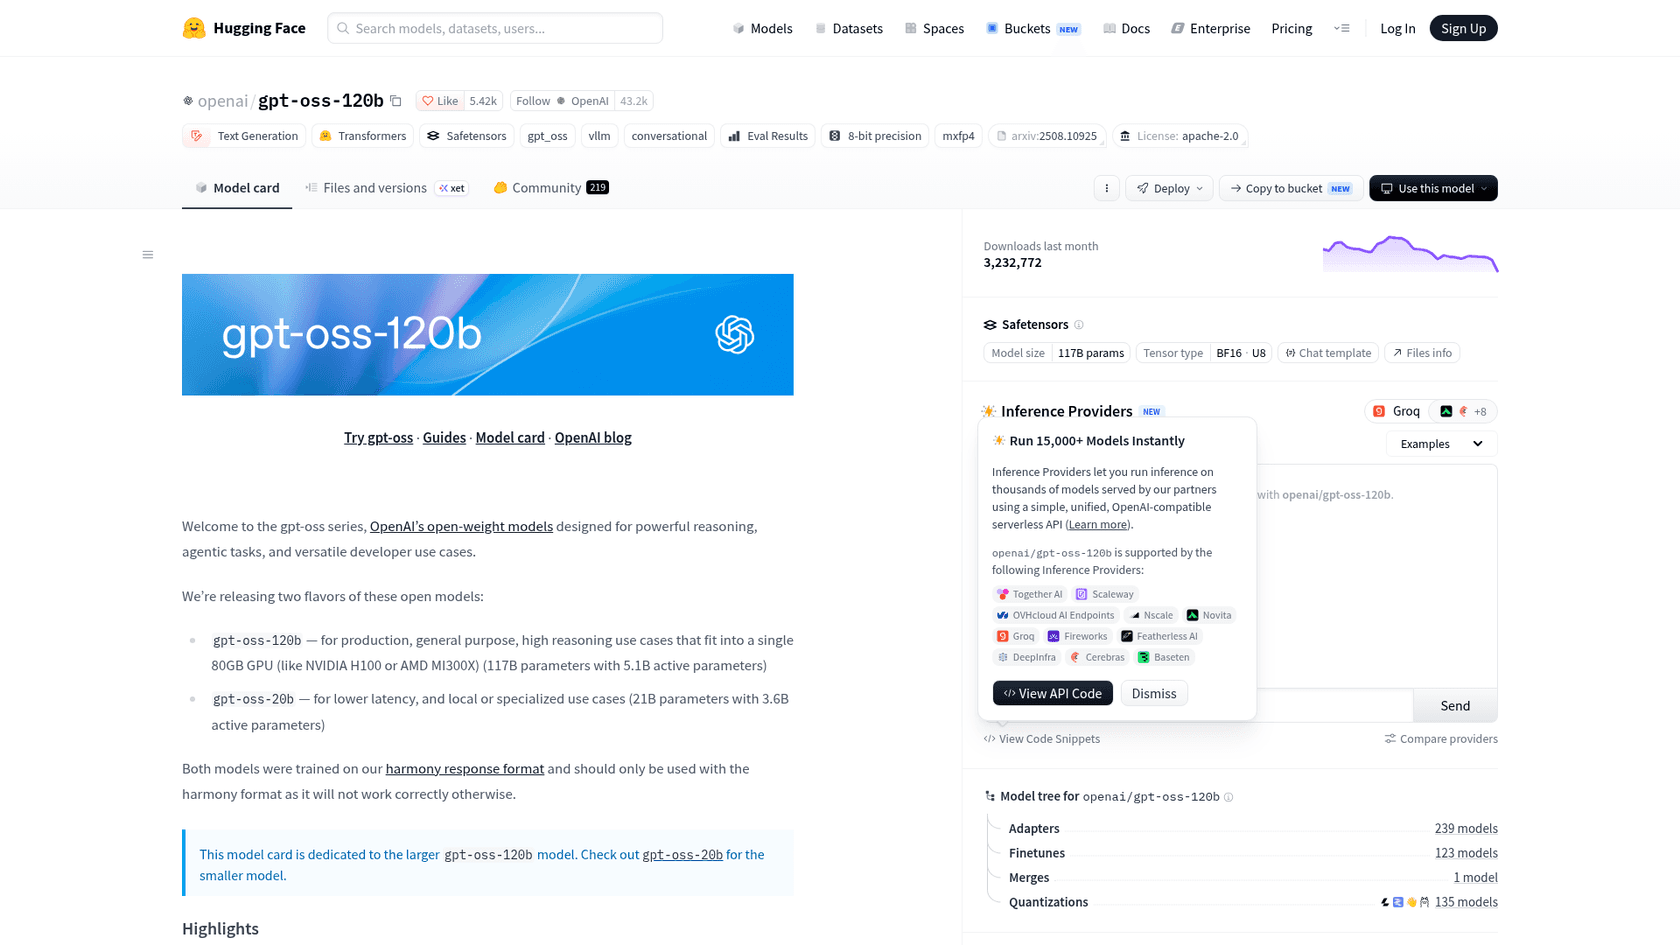
gpt-oss-120b est le modèle open-weight d'OpenAI d'août 2025. Il compte 117B paramètres au total avec seulement 5,1B actifs par token, quantifié pour tourner « on a single 80GB GPU (like NVIDIA H100 or AMD MI300X) », selon la fiche de modèle. Il est limité au texte, avec un contexte de 128K et trois niveaux de raisonnement (low, medium, high) définis dans le prompt système.
Ce qu'il fait mieux que Muse Spark Open. Le matériel et le coût. Muse Spark Open demande deux Mac Studio avec jusqu'à 512 Go de mémoire chacun, selon Apple ; gpt-oss-120b demande une seule carte. C'est la seule alternative de cette liste qu'une petite équipe peut raisonnablement faire tourner sur son propre serveur ou dans un compte cloud privé.
Où il est en retrait. Il a 14 mois, et OpenAI n'a pas sorti de nouveau modèle gpt-oss depuis ; les versions suivantes sont des classificateurs de sécurité. Il n'est pas dans le tableau comparatif de Meta, et son contexte de 128K est un huitième de celui de Muse Spark Open. Il ne fonctionne aussi correctement qu'avec le format de réponse harmony d'OpenAI ; la fiche dit qu'il « will not work correctly otherwise ».
"The finding that flips the usual story is the sparse-MoE reversal: on gpt-oss-120b the A100 comes in cheaper per output token than the H100, because the workload is latency-tolerant and the MXFP4 experts fit in 80GB."
Prix et licence. OpenAI ne le vend pas, donc les prix hébergés viennent des fournisseurs. La page tarifaire de Together AI affiche 0,15 $ en entrée et 0,60 $ en sortie par million de tokens, comme le tarif en heures creuses de DeepSeek. La licence est Apache 2.0, et la politique d'usage tient en une ligne : respecter la loi.
Verdict : gpt-oss-120b n'égalera pas Muse Spark Open sur les tâches d'agent difficiles, et je ne ferai pas semblant du contraire. Mais c'est le bon modèle témoin : passez-y d'abord votre évaluation, et vous saurez quelle part de la taille supplémentaire de Muse Spark Open vous utilisez vraiment. Des hébergeurs comme Together AI et Groq le proposent tous les deux.
6. Mistral Large 4
Idéal pour : les équipes européennes qui veulent un modèle entraîné et hébergé dans l'UE et peuvent attendre quelques semaines les poids.
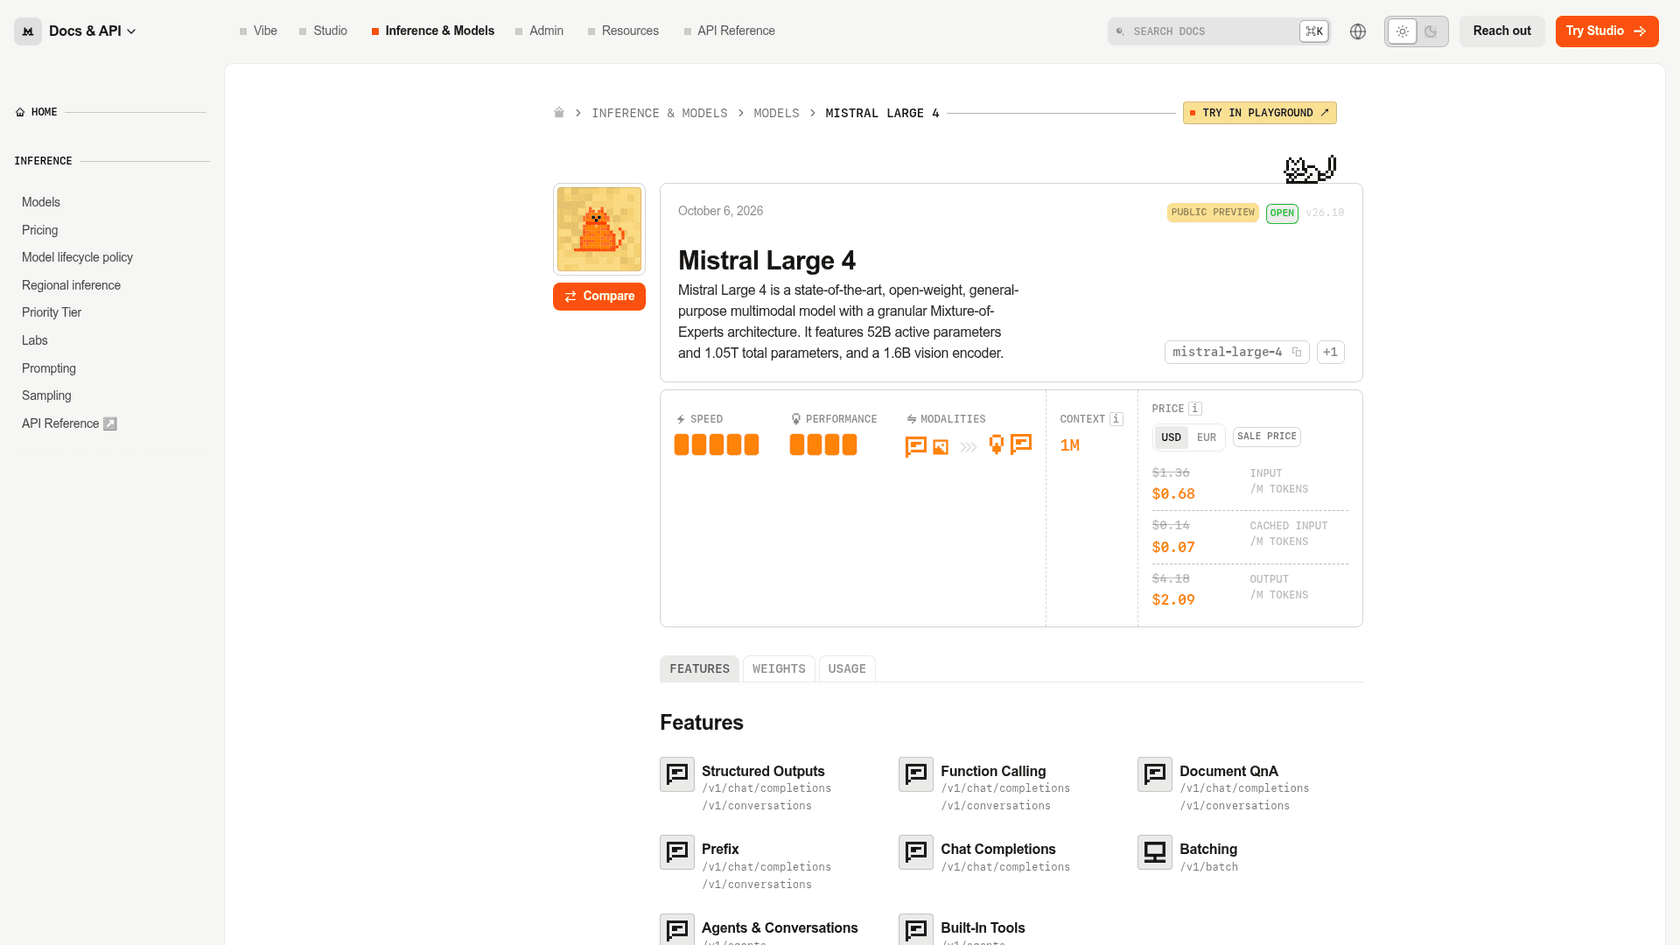
Mistral Large 4 est passé en préversion publique le 6 octobre 2026. La fiche de modèle indique 1,05T paramètres au total, 52B actifs et un encodeur de vision de 1,6B, avec un contexte de 1M. Mistral l'a entraîné sur 3 800 GPU NVIDIA Grace Blackwell dans ses propres centres de données européens, selon l'annonce de lancement.
Ce qu'il fait mieux que Muse Spark Open. Le prix, et l'angle européen. Il obtient 38 dans le tableau de Meta, un point derrière Muse Spark Open, à la moitié du prix de sortie pendant la promotion. Il le devance aussi légèrement sur DeepSWE (62 contre 60), SWE-Atlas-QnA (59 contre 58) et GDPVal-AA v2 (1424 contre 1401).
Où il est en retrait. Au 18 octobre, les poids ne sont pas sortis. Il n'existe pas de dépôt Mistral Large 4 sur Hugging Face, et l'annonce de lancement dit toujours « we will release the weights by the end of the month ». Aucune licence n'a été nommée, donc je ne présumerais pas de l'Apache 2.0. Son score AA-Omniscience dans le tableau de Meta est de -5, le seul score négatif de l'ensemble, contre 25 pour Muse Spark Open.
"I created a brand new programming language to test LLM models on. It looks like Mistral Large 4 fares about as well as Kimi K3 and Claude Sonnet 5.5. Though it is much slower than Sonnet 5.5 and more expensive than both of those."
Prix et licence. La page tarifaire de Mistral montre une promotion de 50 % sans date de fin : 0,68 $ en entrée, 0,07 $ en cache et 2,09 $ en sortie par million de tokens, contre un prix catalogue de 1,36 $, 0,14 $ et 4,18 $. La licence n'est pas annoncée.
Verdict : un choix correct si l'entraînement et l'hébergement dans l'UE sont une exigence, et le prix promotionnel bat aujourd'hui Muse Spark Open. Mais ce n'est pas encore une alternative open-weight. Revenez après le 31 octobre avant de bâtir un plan d'auto-hébergement autour. Mon article sur les tarifs de Mistral Large 4 suit la promotion.
7. Nemotron 3 Ultra
Idéal pour : les équipes qui ont besoin des données d'entraînement et de la recette, pas seulement des poids, sous une licence américaine permissive.
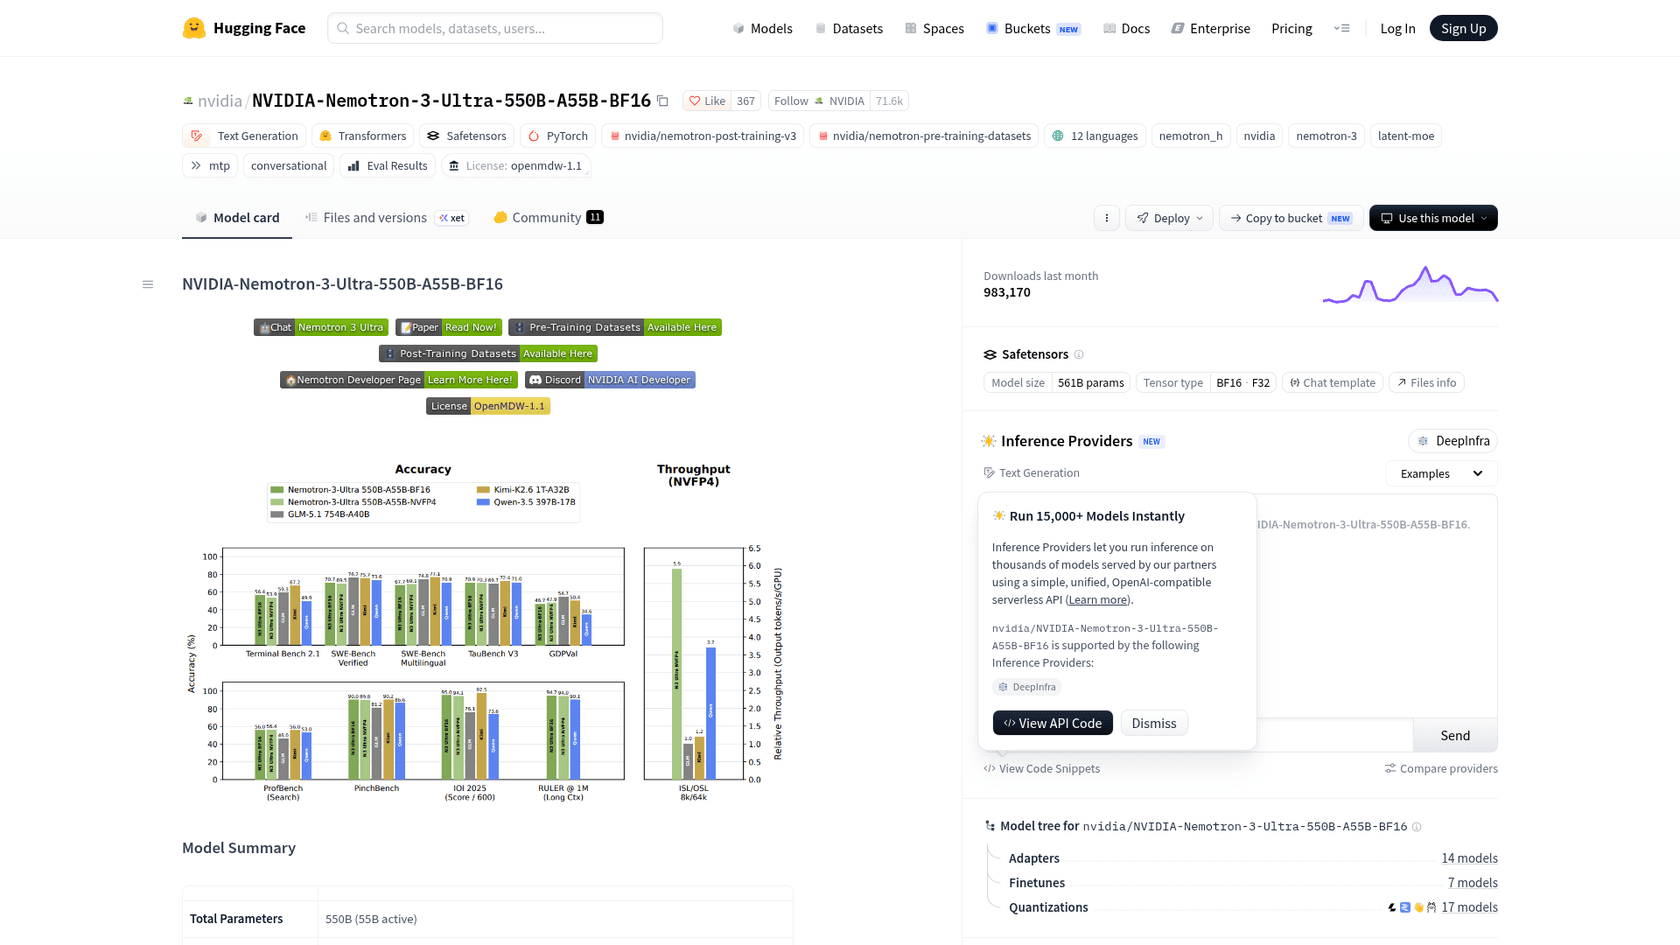
Nemotron 3 Ultra est le plus gros modèle ouvert de NVIDIA, sorti le 4 juin 2026. Il compte 550B au total avec 55B actifs, un hybride de couches Mamba-2, d'attention et de mixture-of-experts. Il est limité au texte, et le raisonnement s'active ou se désactive dans le modèle de conversation.
Ce qu'il fait mieux que Muse Spark Open. L'ouverture. NVIDIA publie les jeux de données de pré-entraînement et de post-entraînement, les environnements RL et un rapport technique. Si vous devez expliquer à un auditeur ce qui est entré dans un modèle, c'est le seul de la liste où vous le pouvez. La licence est aussi plus légère.
Où il est en retrait. La capacité. Il obtient 23 dans le tableau de Meta, le plus bas ici, et il est derrière Muse Spark Open sur tous les benchmarks où les deux apparaissent, dont MCP-Atlas (63,1 contre 89,2) et Terminal-Bench 2.1 (53,9 contre 76,4). La fiche annonce « up to 1M tokens », mais la configuration livrée est fixée à 262 144. Le matériel minimal est 8 x H200 ou 16 x H100.
"Each of the Nemotron 3 models were briefly competitive when they launched, but never exceptional, and less competitive with each scale up. The fact that it took so long for Nemotron 3 Ultra to launch really hampered its competitiveness. The Nemotron 3 series is extremely open about training recipes and training data, far more open than most open weight models, and that is valuable."
Prix et licence. La page build de NVIDIA propose un point d'accès d'essai sans prix par token. DeepInfra affiche 0,50 $ en entrée, 0,10 $ en cache et 2,20 $ en sortie par million de tokens. La licence est OpenMDW-1.1 : conservez la licence et les mentions lors de la redistribution, et elle « does not impose any restrictions or obligations » sur les sorties.
Verdict : choisissez Nemotron 3 Ultra pour la transparence, pas pour un modèle plus intelligent. Si votre équipe juridique ou de recherche doit connaître les données d'entraînement, c'est le choix évident. Si vous voulez simplement les meilleures réponses, ce n'est pas lui.
8. Inkling
Idéal pour : les produits audio et texte qui veulent un modèle Apache 2.0 d'un laboratoire américain.
Inkling est le premier modèle de Thinking Machines Lab, sorti le 15 juillet 2026. C'est un mixture-of-experts de 975B paramètres avec 41B actifs, un contexte de 1M selon la fiche de modèle, et une entrée en texte, images et audio 16 kHz. Un Inkling Small plus petit (276B, 12B actifs) a suivi le 30 juillet.
Ce qu'il fait mieux que Muse Spark Open. La clarté de la licence : les poids sont sous Apache 2.0, sans mention sur le produit et sans clause de chiffre d'affaires. Thinking Machines gère aussi Tinker, une plateforme de fine-tuning hébergée, donc l'adapter à vos propres données est une voie prise en charge plutôt qu'un projet de week-end.
Où il est en retrait. Il obtient 26 dans le tableau de Meta, et Muse Spark Open le bat sur chaque benchmark commun, souvent largement (JobBench 61,8 contre 31,1, MCP-Atlas 89,2 contre 76,0). Et même si les poids sont sous Apache 2.0, la fiche Hugging Face renvoie à une politique d'utilisation acceptable distincte qui dit s'imposer à quiconque télécharge. Elle exige d'informer les utilisateurs qu'ils parlent à une IA lorsque c'est pertinent, ce que la plupart des équipes de support font déjà.
"Very nice, multi modal, largest open weight model that supports audio. Would be interesting to see how good the audio capability is."
Prix et licence. Le prix a baissé. La bêta d'inférence serverless de Thinking Machines affiche désormais Inkling à 1,00 $ en entrée, 0,17 $ en cache et 4,05 $ en sortie par million de tokens, au 14 octobre, avec la mention « not yet recommended for intensive production use ». Together AI facture la même chose. Inkling Small est à 0,30 $ en entrée et 1,20 $ en sortie.
Verdict : Inkling est le choix si vous avez besoin de l'entrée audio sous Apache 2.0. Muse Spark Open accepte aussi l'audio et score bien plus haut, donc le facteur décisif est de savoir si la mention « Built with Muse Spark Open » convient à votre produit. Pour un examen plus poussé, voyez mon avis sur Inkling.
Les petits caractères des licences, côte à côte
La plupart des comparatifs s'arrêtent aux benchmarks. Pour les poids ouverts, la licence décide si vous pouvez livrer ou non, alors voici chaque obligation en une seule vue.
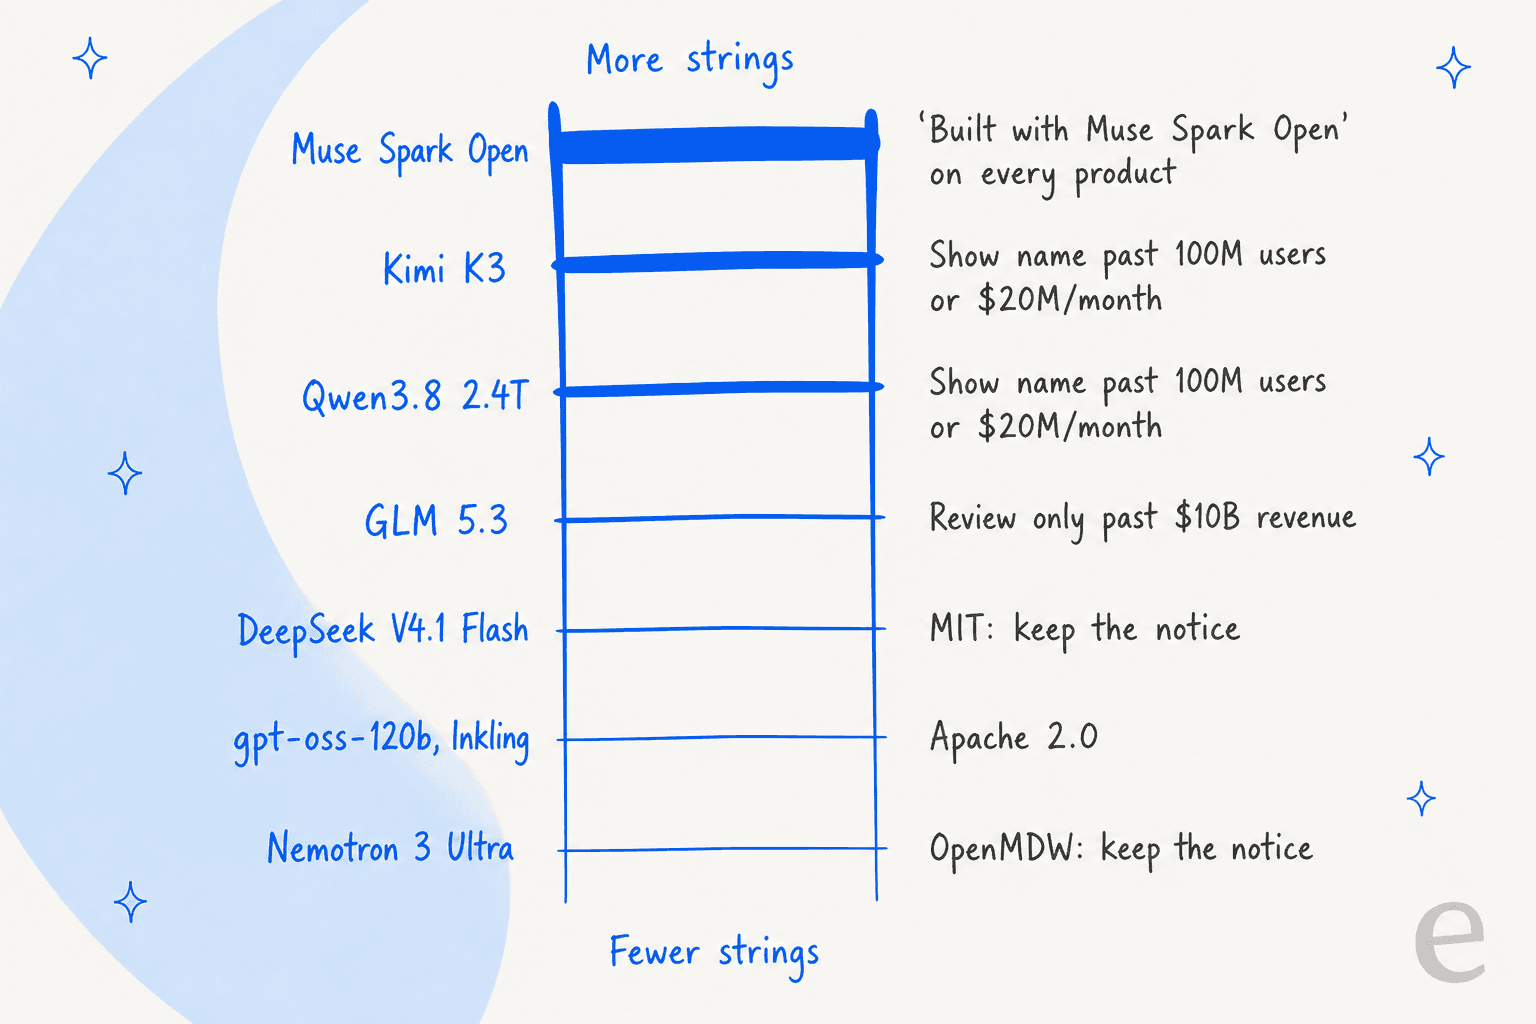
Ce qui m'a surpris, c'est à quel point la règle d'affichage de Meta est inhabituelle. Kimi K3 et Qwen3.8 demandent aussi d'afficher le nom du modèle, mais seulement au-delà de 100 millions d'utilisateurs mensuels ou de 20 millions de dollars de chiffre d'affaires mensuel. Muse Spark Open est le seul modèle ici qui demande une mention dans chaque produit, dès le premier jour. Sa clause d'hébergement est proche de celle de Kimi K3 (20 millions de dollars par an), tandis que GLM 5.3 place la barre à 10 milliards de dollars et ne demande qu'une revue de sécurité.
Rien de tout cela n'est rédhibitoire pour un produit typique. Une ligne « Built with Muse Spark Open » dans votre documentation ou votre menu de paramètres satisfait la clause de Meta. Mais si vous faites du marque blanche pour des clients, ou revendez de l'inférence, lisez la clause avec votre avocat avant de choisir.
Comment choisir entre eux
Après avoir passé les huit en revue, voici l'ordre dans lequel je testerais, pour la plupart des équipes :
- Commencez par GLM 5.3 comme remplaçant direct. Même gamme de prix, meilleur score, licence plus légère.
- Ajoutez DeepSeek V4.1 Flash comme test de coût. S'il réussit votre évaluation, vous venez de réduire votre facture d'environ 7 fois.
- Ajoutez gpt-oss-120b comme plancher. S'il réussit aussi, vous n'avez probablement pas besoin d'un modèle de plus de 700B pour cette tâche.
- Faites appel à Kimi K3 seulement pour les tâches de code ou de vision que les autres ratent.
- Gardez Muse Spark Open pour les agents riches en outils où son avance sur MCP-Atlas et sa résistance au jailbreak comptent, surtout pour tout ce qui est face au client et doit refuser proprement.
L'étape que la plupart des équipes sautent est l'évaluation elle-même. Les benchmarks sont des moyennes ; votre charge de travail n'en est pas une. Passez 100 de vos vraies tâches dans chaque candidat sur un hébergeur comme Fireworks AI ou Baseten avant de vous engager, et notez-les de la même façon.
Si le modèle sert au support client, le modèle est la décision la moins importante
Beaucoup de gens qui évaluent des poids ouverts en 2026 le font pour un bot de support. Je dirais la même chose à tous : le modèle est de l'infrastructure. L'employé, c'est tout ce qui est construit par-dessus.
eesel fait tourner de l'IA sur de vraies files de support depuis des années, et l'échec qui a le plus marqué n'avait rien à voir avec le choix du modèle. Quelques clients payants avaient un bot qui, lorsqu'il ne trouvait rien de pertinent dans leur base de connaissances, comblait le vide avec les données d'entraînement générales du modèle et envoyait des réponses assurées mais fausses à de vrais clients. Passer à un modèle mieux noté ne règle pas cela. Un repli strict, l'ancrage dans vos propres sources et des tests sur de vrais tickets avant le lancement, si. C'est pourquoi chaque déploiement d'eesel est désormais simulé sur des tickets historiques avant de répondre à qui que ce soit.
Donc si vous hésitez entre GLM 5.3 et Muse Spark Open pour un helpdesk, il y a un chemin plus court. Le coéquipier IA helpdesk d'eesel se branche sur Zendesk, Freshdesk ou Gorgias, apprend de vos anciens tickets et de votre centre d'aide, et vous montre comment il aurait répondu aux tickets du mois dernier avant d'être mis en ligne. Une limite honnête : eesel fonctionne sur des modèles de pointe hébergés d'OpenAI, Anthropic et Google (listés sur la page sécurité), pas sur ces poids ouverts, donc si l'auto-hébergement du modèle est une exigence stricte, eesel ne convient pas.
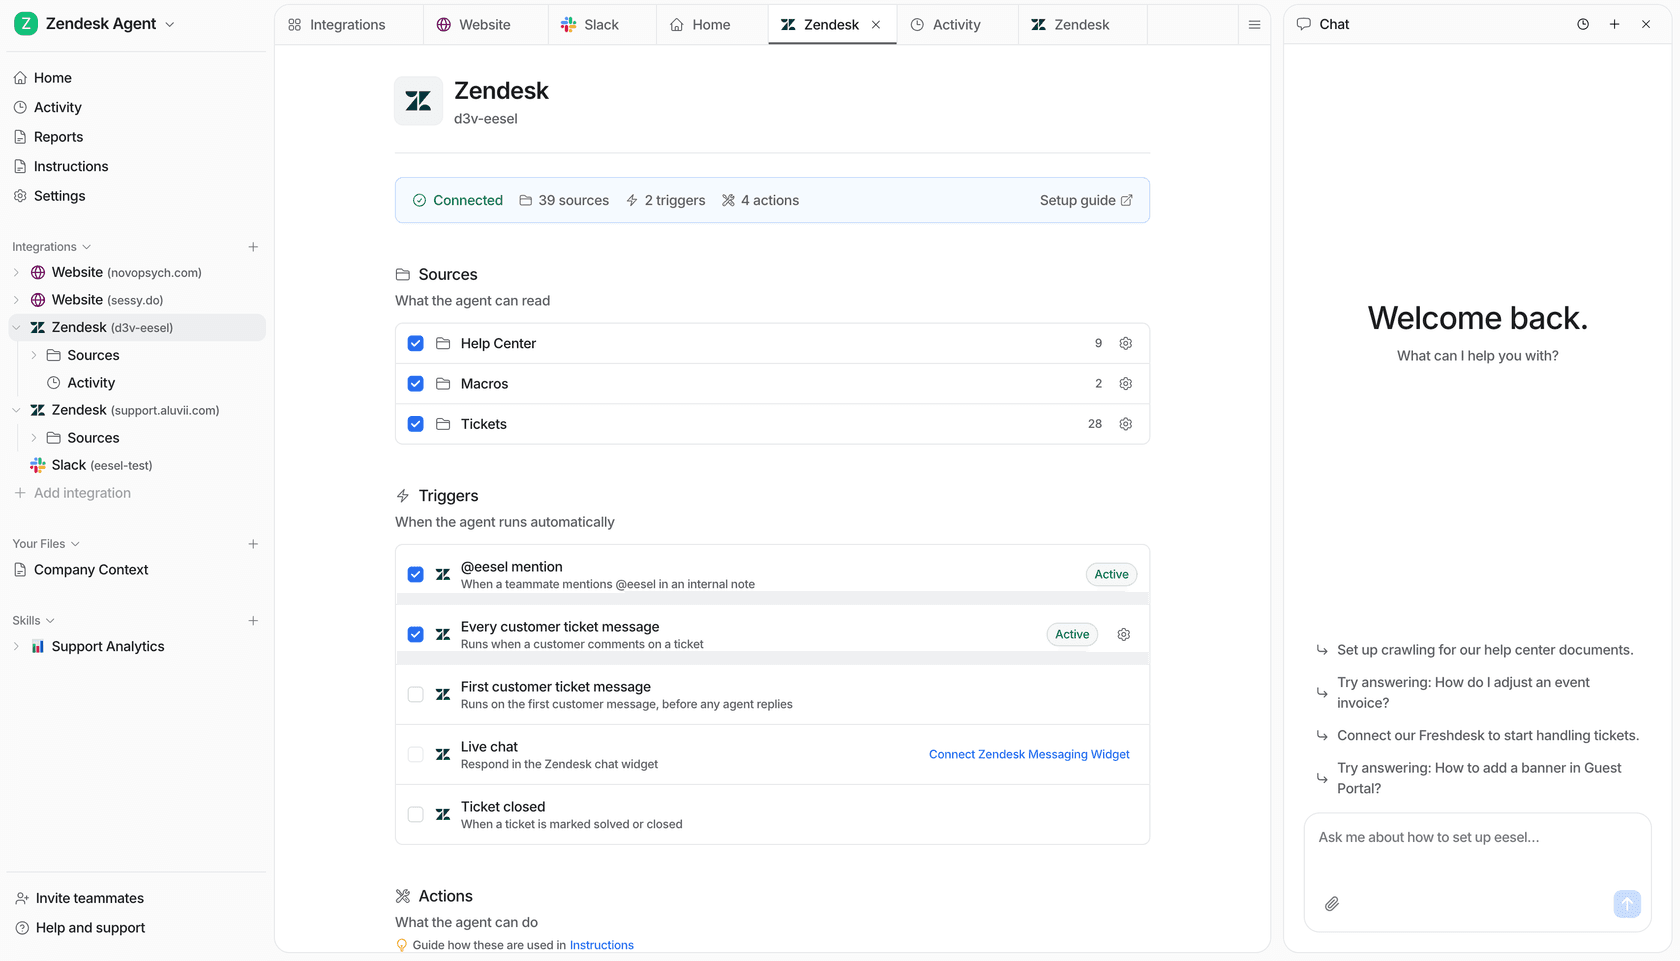
Si vous êtes le genre d'équipe qui compare les licences de modèles, vous voudrez probablement aussi le piloter depuis du code. La CLI eesel (@eesel/cli sur npm) fait tourner le même coéquipier et le même espace de travail depuis un terminal : connectez un helpdesk avec eesel integrations connect, lisez et modifiez ses instructions permanentes avec eesel instructions, approuvez ou refusez les actions en attente avec eesel approvals, et passez en revue ce qu'il a fait avec eesel activity. Chaque commande affiche du JSON, les commandes d'écriture prennent en charge --dry-run, et les jetons sans interface fonctionnent en CI, donc un script ou un agent de code comme Claude Code peut l'utiliser aussi facilement que vous. Chaque espace de travail est aussi un serveur MCP, que je traite dans MCP pour le support client.
Et si votre projet open-weight porte sur le contenu plutôt que sur les tickets, l'autre coéquipier d'eesel est un rédacteur de blog IA qui fait des recherches, rédige et illustre des articles comme celui-ci.
Essayer eesel
Muse Spark Open, GLM 5.3 et les autres sont des moteurs. Si ce qu'il vous faut vraiment est une IA qui répond à vos clients, eesel est un coéquipier de support qui connaît déjà votre centre d'aide et vos anciens tickets, rejoint votre helpdesk existant en quelques minutes et fait ses preuves sur les tickets du mois dernier avant de toucher un ticket en direct. Essayez eesel gratuitement, ou voyez comment les équipes le comparent dans mon comparatif des meilleurs agents IA de support client.