9 meilleures alternatives à llama.cpp en 2026, selon le matériel

Rama Adi

Katelin Teen
Dernière modification 14 novembre 2026
Les meilleures alternatives à llama.cpp sont vLLM ou SGLang pour de nombreux utilisateurs sur un serveur GPU, MLX-LM sur un Mac avec Apple Silicon, et ExLlamaV3 pour faire entrer le plus de modèle sur une seule carte NVIDIA. Ollama, LM Studio, Jan et LocalAI sont plus conviviaux, mais ils font toujours tourner llama.cpp en dessous, donc ils changent l'appli, pas le moteur. Avec llama.cpp en v1.0.0, une seule personne sur une seule machine a souvent intérêt à rester. Si l'objectif est l'IA sur les tickets de support, eesel fait cela avec des modèles hébergés, et sa CLI permet à un agent de code d'envoyer des articles d'aide et de tester les réponses d'abord.
Pourquoi cherche-t-on des alternatives à llama.cpp ?
Surtout parce qu'on a dépassé la tâche pour laquelle llama.cpp a été construit, pas parce qu'il est devenu moins bon. llama.cpp est le moteur en C/C++ qui a rendu normal de faire tourner des modèles sur du matériel ordinaire, et il reste le plus large : le README du projet liste des backends pour CUDA, Metal, HIP, Vulkan, SYCL, le CPU seul et plus d'une douzaine d'autres, avec une quantization GGUF de 1,5 bit à 8 bits et un offload CPU plus GPU pour des modèles plus gros que votre VRAM. Il affiche 135 056 étoiles GitHub sous licence MIT, et le 13 novembre 2026 il a sorti v1.0.0, sa première version semver, avec des caches KV FP8, un cache en mémoire hôte pour les modèles mixture-of-experts et une interface web repensée.
Je travaille sur les intégrations et les API d'eesel, donc la majeure partie de mon temps avec les moteurs locaux passe sur les parties ennuyeuses : l'API qu'ils exposent, leur comportement avec plusieurs requêtes à la fois, et ce qui casse quand on change de modèle. Cela façonne cette liste. J'ai lu la documentation, les notes de version et les dépôts de chaque projet, et j'ai récupéré des retours de la communauté sur Hacker News, mais je n'ai pas benchmarké les neuf sur une seule machine, donc traitez toute affirmation de vitesse ci-dessous comme la leur, pas la mienne.
Les raisons que les gens donnent pour changer se regroupent en quatre :
- Beaucoup d'utilisateurs à la fois. llama.cpp est excellent pour une personne et correct pour quelques-unes. Une équipe qui frappe le même serveur, c'est là que les moteurs avec batching prennent l'avantage.
- Vitesse sur Mac. Sur Apple Silicon, le propre framework MLX d'Apple est souvent la voie la plus rapide.
- Vitesse maximale sur un GPU précis. Les moteurs avec des kernels écrits pour le matériel d'un fabricant peuvent battre un moteur portable sur ce matériel.
- Une appli plutôt qu'une compilation. Tout le monde ne veut pas compiler avec CMake et passer des flags.
Les trois premières sont de vrais changements de moteur. La quatrième, généralement pas, et c'est la partie que la plupart des articles comparatifs sautent.
"While I think that llama.cpp is an outstanding project - a one-stop-shop to get almost any model to run on almost any hardware, you get a lot more speed from specialised inference engines with kernels made for your hardware."

Ollama est-il vraiment une alternative à llama.cpp ?
Pas au niveau du moteur. Ollama, LM Studio, Jan et LocalAI font tous tourner llama.cpp en dessous pour les modèles GGUF, et plusieurs d'entre eux ajoutent MLX sur Mac. Ils changent la façon d'installer, de télécharger et de gérer les modèles. Ils ne changent pas la façon dont les tokens sont générés.
La preuve est sur leurs propres pages. Les notes de version v0.40.16 d'Ollama listent "Updated llama.cpp". La page d'accueil de LM Studio dit qu'il tourne "with MLX and llama.cpp under the hood." La documentation de l'API de Jan décrit "local models powered by llama.cpp or MLX." LocalAI liste llama.cpp comme l'un de ses plus de 80 backends, juste à côté de vLLM et MLX. Et l'équipe de llama.cpp propose maintenant sa propre appli de bureau Llama, un téléchargement de 1 Mo pour Mac et Windows.
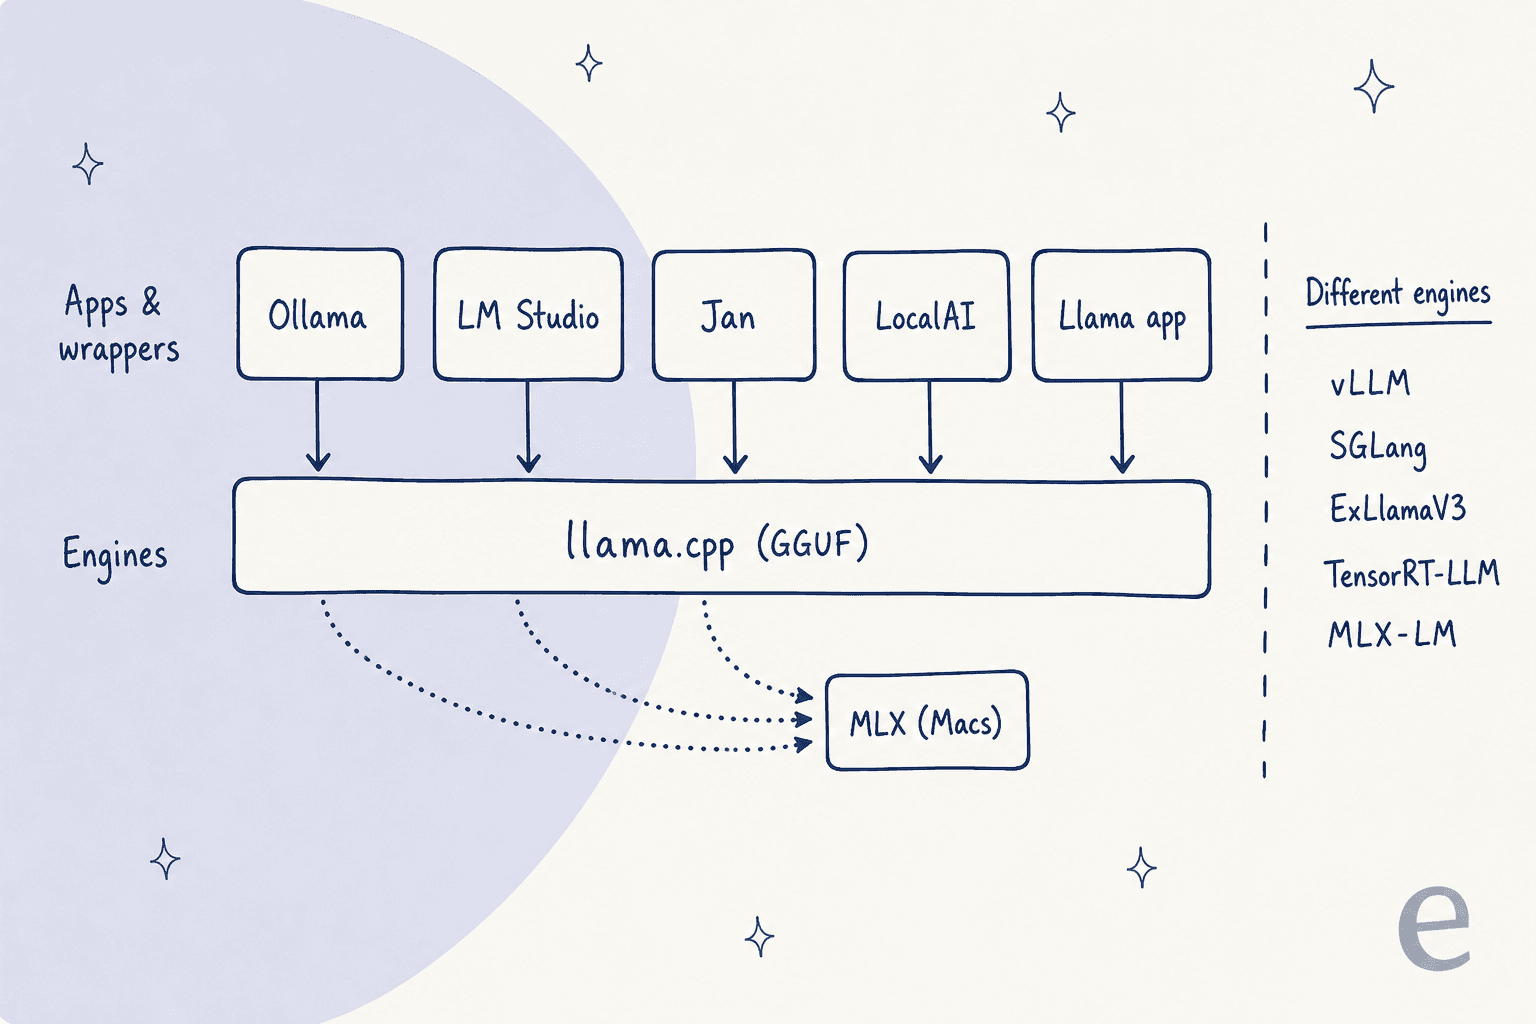
Cette répartition décide où regarder. Si vous quittez llama.cpp parce que les compilations et les flags vous épuisent, une appli par-dessus est la bonne solution, et vous gardez tout ce qui fonctionne déjà. Si vous partez parce que c'est trop lent pour votre charge de travail, une appli sur le même moteur n'aidera pas, et vous voulez l'un des cinq de la colonne de droite.
"There's also been some controversy over not giving proper credit to llama.cpp which ollama is/was a wrapper around."
Comment j'ai choisi ces alternatives
Je suis parti de ce que les acheteurs demandent vraiment. Quand j'ai posé "What are the best llama.cpp alternatives?" à ChatGPT dans un nouveau chat, il a cité neuf projets et les a répartis entre moteurs d'inférence et plateformes LLM locales, donc les neuf sont ici. Ensuite j'ai vérifié chacun sur cinq points :
- Moteur ou wrapper. Remplace-t-il l'inférence de llama.cpp, ou l'enveloppe-t-il ?
- Matériel et OS. NVIDIA, AMD, Apple Silicon, CPU ; Linux, Windows, macOS.
- Format de modèle. GGUF, poids MLX, EXL3 ou safetensors Hugging Face.
- Service. Une API compatible OpenAI, et si ça regroupe bien beaucoup de requêtes.
- Entretien. Date de la dernière version, licence et étoiles du dépôt GitHub de chaque projet au 15 novembre 2026.
Voici comment ils se classent :
| Outil | Type | Fait tourner llama.cpp en dessous ? | Matériel | OS | Format de modèle principal | API compatible OpenAI | Beaucoup d'utilisateurs à la fois | Licence | Étoiles GitHub | Dernière version | Palier payant |
|---|---|---|---|---|---|---|---|---|---|---|---|
| vLLM | Moteur | Non | NVIDIA, AMD, Intel, CPU, TPU via plugin | Linux (WSL sur Windows) | Safetensors ; GGUF expérimental | Oui, plus API Anthropic | Fort | Apache-2.0 | 96 936 | v0.33.0 | Aucun |
| SGLang | Moteur | Non | NVIDIA, AMD, TPU, Intel, Ascend, Mac via MLX | Surtout Linux | Safetensors ; GGUF sur NVIDIA | Oui | Fort | Apache-2.0 | 38 874 | v0.5.23 | Aucun |
| MLX-LM | Moteur | Non | Apple Silicon uniquement | macOS | Poids MLX | Type OpenAI, basique | Léger | MIT | 7 656 | v0.32.2 | Aucun |
| ExLlamaV3 | Moteur | Non | NVIDIA ; AMD 7900 et plus récent | Linux, Windows | EXL3 | Via TabbyAPI | Batching dynamique | MIT (TabbyAPI AGPL) | 1 825 | v1.6.7 | Aucun |
| TensorRT-LLM | Moteur | Non | GPU NVIDIA de datacenter | Linux | Safetensors, FP8/FP4 | Oui | Fort | Open source NVIDIA | ~15 100 | v1.2.1 stable | Aucun |
| Ollama | Appli + serveur | Oui, plus MLX | NVIDIA, AMD, Apple | macOS, Windows, Linux | GGUF | Sous-ensemble, plus API Anthropic | Modéré | MIT | 186 973 | v0.40.16 | Cloud à partir de 20 $/mois |
| LM Studio | Appli de bureau | Oui, plus MLX | NVIDIA, AMD, Apple Silicon | macOS (série M), Windows, Linux | GGUF, MLX | Oui, plus API Anthropic | Modéré | Appli fermée ; outils MIT | 5 427 (CLI lms) | Bionic 1.2.0 | Cloud à partir de 20 $/mois |
| Jan | Appli de bureau | Oui, plus MLX | NVIDIA, AMD, Apple | macOS, Windows, Linux | GGUF | Oui | Léger | Apache 2.0 | ~45 700 | v0.8.8 | Aucun |
| LocalAI | Serveur API | Oui, parmi plus de 80 backends | CPU, NVIDIA, AMD, Intel, Apple, Jetson | Linux, macOS, Docker, Kubernetes | GGUF et plus | Oui, plus API Anthropic | Modéré | MIT | ~50 400 | v4.12.1 | Aucun |
Quelle alternative à llama.cpp correspond à votre matériel ?
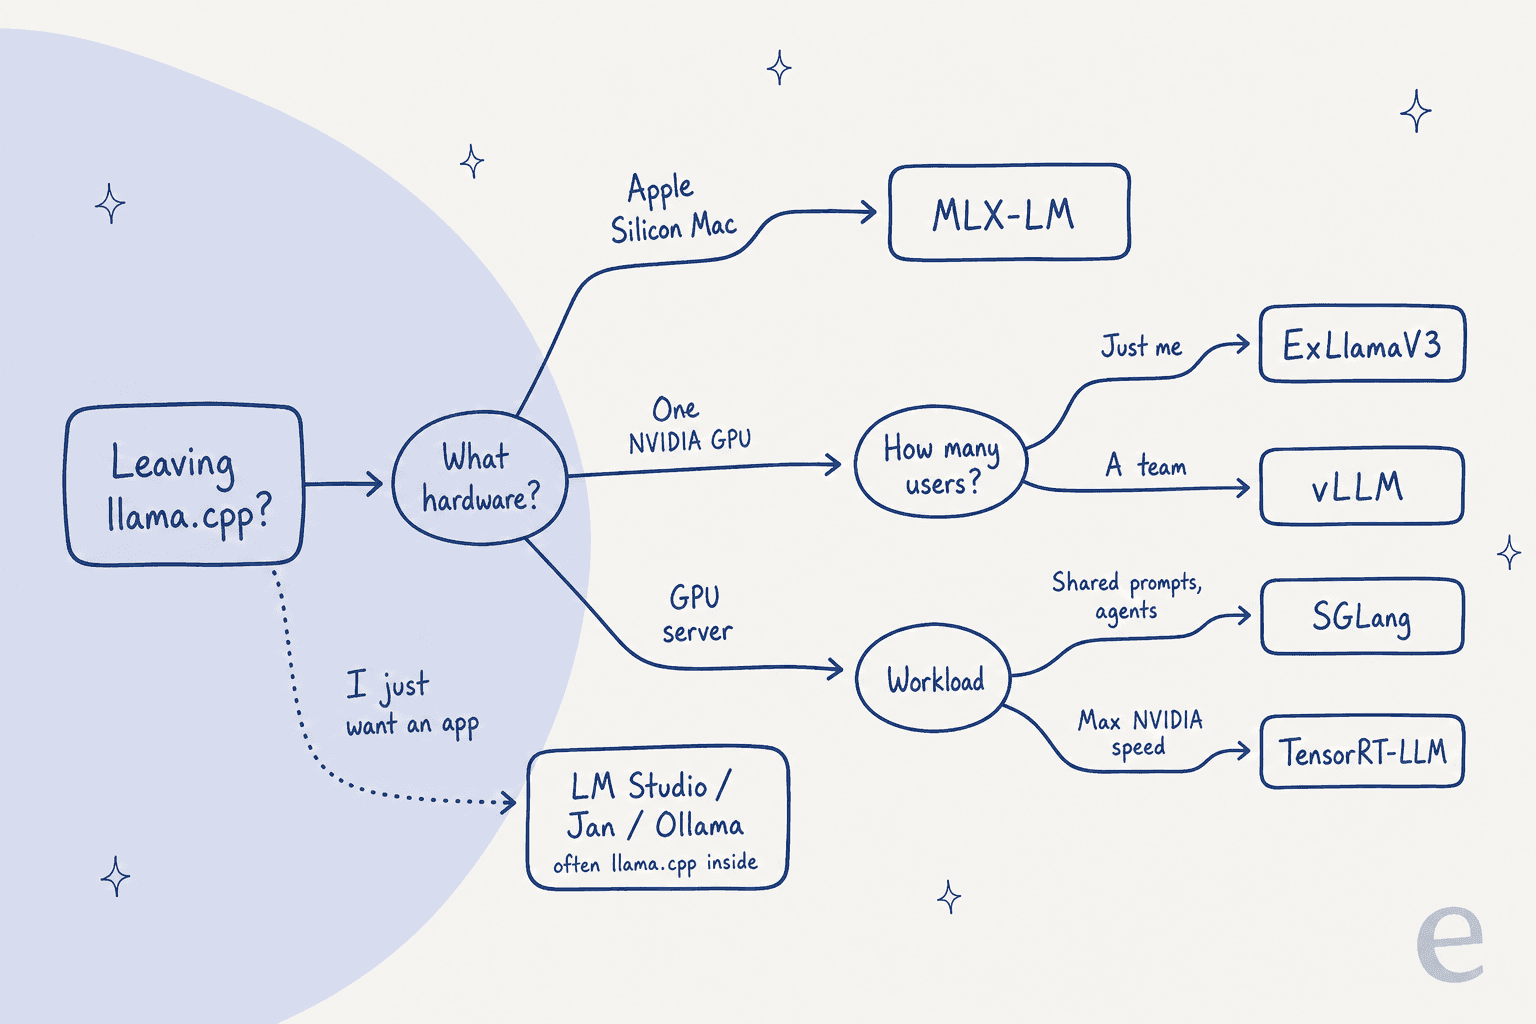
Partez de la machine, puis du nombre de personnes qui l'utilisent. Un Mac pointe vers MLX-LM. Une seule carte NVIDIA pointe vers ExLlamaV3 pour vous seul ou vLLM pour une petite équipe. Un serveur GPU pointe vers SGLang pour des charges d'agents avec des prompts partagés, ou vers TensorRT-LLM si vous voulez le dernier gain de vitesse sur du matériel NVIDIA. Si vous voulez juste une appli plus agréable, prenez LM Studio, Jan ou Ollama et acceptez que llama.cpp fasse toujours le travail.
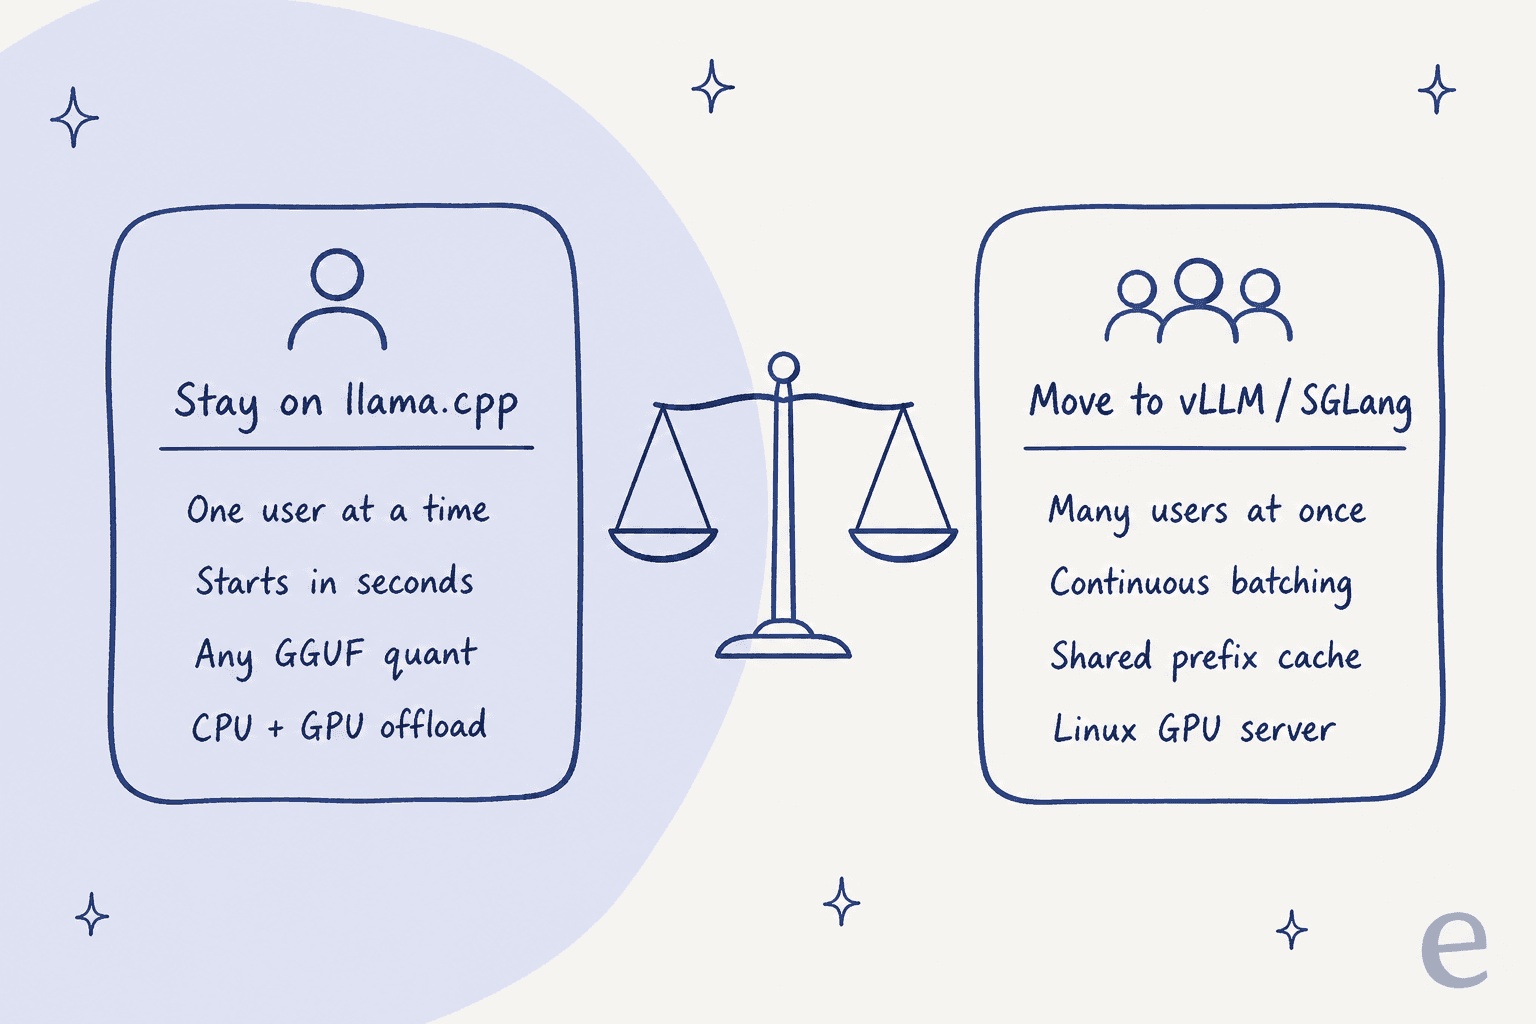
La question la plus utile est de savoir combien de personnes touchent le modèle en même temps. llama.cpp a des slots parallèles et un llama-server compatible OpenAI, mais les moteurs construits autour du continuous batching maintiennent le débit quand les requêtes simultanées s'accumulent, au prix d'un démarrage plus lent et de moins de flexibilité avec les fichiers quantifiés.
"IME vLLM is quite a bit faster than llama.cpp but where it really wipes the floor with it is in batching concurrent load. The downside is that it is dramatically less flexible in terms of tweaking. It gives you very few options for running quantized weights."
1. vLLM
Le mieux pour : servir un modèle à de nombreux utilisateurs depuis un serveur GPU Linux.
vLLM se décrit comme "a fast and easy-to-use library for LLM inference and serving." Il a débuté au Sky Computing Lab de UC Berkeley et compte aujourd'hui plus de 2 000 contributeurs. Si vous avez entendu un nom dans la conversation "llama.cpp pour les serveurs", c'est celui-là.
Ce qu'il fait mieux que llama.cpp
- Trafic simultané. PagedAttention, continuous batching, chunked prefill et prefix caching sont tous construits pour beaucoup de requêtes à la fois.
- Gros déploiements. Parallélisme de tensor, de pipeline, de données, d'experts et de contexte pour répartir un modèle sur plusieurs GPU et machines.
- Couverture API. Un serveur compatible OpenAI, plus une API Messages Anthropic et gRPC, pour que des outils comme Claude Code puissent s'y connecter.
- Large éventail de matériel pour serveurs. NVIDIA, AMD ROCm 6.3+, Intel XPU et CPU, avec TPU, Gaudi et Ascend via des plugins.
Où il montre ses limites
- Linux uniquement. Le guide d'installation GPU dit "vLLM does not support Windows natively" et renvoie à WSL. Apple Silicon ne tourne que via un plugin communautaire vLLM-Metal.
- GGUF est une porte dérobée. La documentation GGUF la qualifie de "highly experimental and under-optimized", et elle nécessite maintenant un plugin séparé. Si votre bibliothèque de modèles est en GGUF, prévoyez de télécharger des versions safetensors.
- Démarrage lent. Il compile des graphes CUDA optimisés au chargement, ce qui pénalise si vous changez souvent de modèle.
"We use all kinds of different models other than Qwen3, and vLLM startup when switching models is prohibitively slow (several times slower than llama.cpp, which is already 5 sec)"
Coût
Gratuit sous Apache-2.0. Installez avec uv pip install vllm et servez avec vllm serve <model>. Le vrai coût, c'est une machine Linux avec un GPU compatible et quelqu'un pour la gérer.
Verdict
Choisissez vLLM quand une équipe, une appli ou une flotte d'agents partagent un modèle et que le débit compte plus que le temps de démarrage. Passez votre tour si vous êtes sur Windows ou sur Mac, ou si vous changez de modèles GGUF toute la journée.
2. SGLang
Le mieux pour : les charges d'agents qui renvoient les mêmes prompts longs.
SGLang est un framework d'inférence open source "optimized for agentic workloads, large-scale serving, and RL rollouts," hébergé par l'organisation à but non lucratif LMSYS. Sa documentation commence avec "low-latency, high-throughput inference with RadixAttention, prefix caching, and multi-GPU parallelism."
Ce qu'il fait mieux que llama.cpp
- Réutilisation des préfixes partagés. RadixAttention garde en cache les préfixes de prompt partagés, ce qui paie quand un agent envoie le même prompt système et la même liste d'outils à chaque appel.
- Recettes de modèles dès le premier jour. La documentation a des pages cookbook pour les nouvelles sorties comme Kimi K3.1 Pro, plus une recette jour 1 pour Qwen3.8-Flash-Next.
- Large liste d'accélérateurs. NVIDIA, des cartes RTX 30 jusqu'au GB300, AMD Instinct, Google TPU, Intel Arc et Xeon, Huawei Ascend, et Mac via MLX.
- Compatible OpenAI. La documentation dit qu'il est "compatible with Hugging Face and OpenAI APIs."
Où il montre ses limites
- CUDA 13 requis. La page d'installation dit que les wheels CUDA 12 ont été retirées après 0.5.19, donc les piles de drivers plus anciennes doivent être mises à jour.
- Linux d'abord. Le guide d'installation principal vise Linux avec des GPU NVIDIA ; la voie Mac nécessite macOS 14+ et un flag d'environnement.
- Offload mémoire. Les utilisateurs signalent que l'offload des poids et du cache KV vers la RAM système est plus faible que sur llama.cpp.
"My own experience shows that both weight and KV cache offload to ram on sglang and vllm is unavailable or unusable."
Coût
Gratuit sous Apache-2.0. uv pip install --prerelease=allow sglang ou l'image Docker lmsysorg/sglang.
Verdict
Choisissez SGLang plutôt que vLLM quand votre trafic est fait d'agents et de pipelines RAG avec des préfixes longs et répétés. Si vous construisez des agents IA avec MCP, c'est la plus grande part de votre trafic. Passez votre tour pour un seul GPU de bureau où le modèle ne rentre pas sans offload.
3. MLX-LM
Le mieux pour : faire tourner et affiner des modèles sur un Mac avec Apple Silicon.
MLX-LM est le "Python package for generating text and fine-tuning large language models on Apple silicon with MLX" d'Apple. Il s'appuie sur MLX, le framework de tableaux d'Apple construit autour de la mémoire unifiée.
Ce qu'il fait mieux que llama.cpp
- Vitesse Mac sur de nombreux modèles. Les utilisateurs de Hacker News traitent MLX comme la base à battre sur Apple Silicon. Un utilisateur a mesuré environ 50 tokens par seconde avec MLX contre environ 41 avec llama.cpp sur le même modèle 8B dans LM Studio.
- Fine-tuning intégré. LoRA, QLoRA et fine-tuning complet, même sur des modèles quantifiés, plus de l'inférence distribuée sur plusieurs Mac.
- Une grande bibliothèque déjà prête. Des milliers de modèles convertis dans la MLX Community sur Hugging Face, et
mlx_lm.convert -qpour quantifier les vôtres.
"On a Mac the baseline I'd want is MLX, not llama.cpp. llama.cpp isn't the fast path on Apple Silicon for most models people run locally, so a speedup over llama.cpp could still be slower than mlx_lm."
Où il montre ses limites
- Mac uniquement. Pas de voie GPU Linux ou Windows dans ce package.
- Serveur basique.
mlx_lm.serverparle une API type OpenAI, mais ses propres notes de serveur disent que c'est "not recommended for production as it only implements basic security checks." - Pas de GGUF. Vous utilisez des poids au format MLX, donc votre dossier GGUF existant ne se transfère pas.
- Pas toujours plus fiable. Un utilisateur est revenu à llama.cpp après qu'une configuration MLX s'est mise à se répéter en boucle.
Coût
Gratuit sous MIT. pip install mlx-lm, puis mlx_lm.chat.
Verdict
Choisissez MLX-LM si vous êtes sur un Mac série M et voulez de la vitesse ou du fine-tuning local. Si vous voulez le même moteur avec une interface graphique, LM Studio, Ollama et Jan utilisent tous MLX sur Mac. Passez votre tour pour tout ce qui doit tourner sur des serveurs Linux.
4. ExLlamaV3
Le mieux pour : faire entrer le plus de modèle possible sur un seul GPU grand public NVIDIA.
ExLlamaV3 est "an inference library for running local LLMs on modern consumer GPUs, with flexible quantization and parallel inference." Il remplace ExLlamaV2, dont le README est maintenant marqué archivé et renvoie vers V3. TabbyAPI est le serveur officiel au-dessus.
Ce qu'il fait mieux que llama.cpp
- Qualité par gigaoctet. Son format EXL3, basé sur QTIP, prend en charge des débits de bits fractionnaires et une quantization du cache de 2 à 8 bits, pour ajuster un modèle qui remplit exactement votre VRAM.
- Multi-GPU à la maison. Parallélisme de tensor et d'experts sur des cartes grand public, plus offload CPU pour les gros modèles mixture-of-experts.
- Actif. v1.6.7 est sorti le 13 novembre 2026, avec des commits presque tous les jours.
"ExllamaV3 4.0bpw fits in 12.5G of VRAM and beats IQ4_XS according to the measurements here"
Où il montre ses limites
- NVIDIA d'abord. Il a besoin de CUDA 12.4 ou plus récent. Le support AMD est nouveau et se concentre sur la série Radeon RX 7900. Il n'y a pas de voie Mac.
- Conversion nécessaire. Les modèles doivent être convertis en EXL3 ; il ne charge pas le GGUF.
- Échelle serveur amateur. Le README de TabbyAPI dit que ce n'est "not meant to run on production servers", et c'est de l'AGPL-3.0.
Coût
Gratuit. ExLlamaV3 est en MIT, TabbyAPI en AGPL-3.0. Des wheels précompilées sur la page des releases évitent d'avoir besoin du CUDA toolkit pour pip install exllamav3.
Verdict
Choisissez ExLlamaV3 si vous avez une ou deux cartes RTX et voulez le plus gros modèle qui rentre, pour vous seul. Passez votre tour pour du service de production partagé ou tout ce qui n'est pas NVIDIA.
5. TensorRT-LLM
Le mieux pour : un débit maximal sur des GPU NVIDIA de datacenter.
TensorRT-LLM est la bibliothèque open source de NVIDIA "for accelerating and optimizing inference performance of the latest large language models (LLMs) on NVIDIA GPUs", maintenant construite sur PyTorch avec une API Python de LLM.
Ce qu'il fait mieux que llama.cpp
- Formats basse précision sur les cartes récentes. FP4 natif sur B200 et FP8 sur H100 et plus récent, qui selon NVIDIA "can double performance and halve memory consumption compared to 16-bit floating point".
- Fonctionnalités de service. In-flight batching, cache KV paginé avec réutilisation des blocs, décodage spéculatif (EAGLE, MTP, NGram), LoRA et service désagrégé en bêta.
- La pile NVIDIA. La documentation dit qu'il se connecte à NVIDIA Dynamo et à Triton Inference Server, et
trtllm-serveexpose un endpoint compatible OpenAI.
Où il montre ses limites
- Matériel de datacenter NVIDIA. Les GPU pris en charge vont d'Ampere A100 à Hopper et Blackwell. Ce n'est pas un outil pour ordinateur portable.
- Rythme des sorties. La dernière version stable est v1.2.1 du 20 avril 2026, et la documentation est déjà sur des candidates 1.4.0.
- Configuration plus lourde. La voie la plus rapide est le conteneur NGC de NVIDIA.
"Some GPUs are still better than others like Nvidia GPUs are still the best for token throughput (via TensorRT-LLM), but AMD GPUs are competitive (via vLLM) and even CPUs can run LLMs at decent speeds (via Llama.cpp)."
Coût
Gratuit, aucun palier payant. Le coût, c'est le matériel de classe H100 ou B200 pour lequel il est construit, ou les heures de cloud. Les équipes qui n'ont besoin que de débit trouvent parfois un moteur hébergé comme Groq moins cher que de gérer le leur.
Verdict
Choisissez TensorRT-LLM si vous possédez des GPU NVIDIA de datacenter et que le coût de service par token est votre chiffre principal. Passez votre tour sur du matériel grand public, où vLLM ou ExLlamaV3 sont plus simples.
6. Ollama
Le mieux pour : l'installation locale la plus simple, avec des modèles cloud optionnels.
Ollama se présente comme "the most popular way to build with open models", et ses chiffres soutiennent la partie popularité : 186 973 étoiles GitHub et, selon sa propre page d'accueil, plus de 9 millions d'installations par mois.
Ce qu'il fait mieux que llama.cpp
- Zéro compilation. Un script d'installation ou un installeur sur macOS, Windows et Linux, plus une image Docker.
- Bibliothèque de modèles.
ollama runtélécharge depuis ollama.com/library, avec des modèles comme Kimi K3 et DeepSeek V4 Flash. - Connexion aux agents.
ollama launchbranche un modèle local sur Claude Code, Codex, OpenCode et d'autres, et il a des endpoints compatibles OpenAI et Anthropic. - MLX sur Mac. Son dépôt contient maintenant un runner MLX à côté de llama.cpp.
"When I read the llama.cpp repo and see I have to build it, vs ollama where I just have to get it, the choice is already made."
Où il montre ses limites
- Le même moteur. Pour les modèles GGUF, c'est toujours llama.cpp, donc ça ne résoudra pas un problème de débit.
- API OpenAI partielle. La documentation de compatibilité dit qu'il "supports a subset of the OpenAI API."
- Moins de réglages. Certains utilisateurs reviennent à llama.cpp dès qu'ils veulent un contrôle plus fin, maintenant que c'est plus facile à installer.
Coût
Gratuit en local. Les plans cloud sur la page de tarifs d'Ollama sont ci-dessous.
| Plan | Prix | Ce que vous obtenez |
|---|---|---|
| Pay as you go | Abonnement 0 $ | Usage cloud par token, 3 requêtes simultanées |
| Pro | 20 $/mois (200 $/an) | 60 $ de crédits d'usage par mois, modèles Pro plus grands |
| Max | 100 $/mois | 300 $ de crédits d'usage par mois, 10 requêtes simultanées |
| Team (accès anticipé) | 500 $/mois | Utilisateurs illimités, 1 000 $ de crédits partagés |
| Enterprise | Sur mesure | Contrôles d'accès aux modèles, budgets par utilisateur et par clé |
Verdict
Choisissez Ollama si vous voulez des modèles locaux qui tournent en cinq minutes et prévoyez de les connecter à des agents de code. Passez votre tour si votre raison de quitter llama.cpp était la vitesse, car vous garderiez le même moteur.
7. LM Studio
Le mieux pour : une appli de bureau soignée qui vous laisse aussi choisir les modèles selon le VRAM.
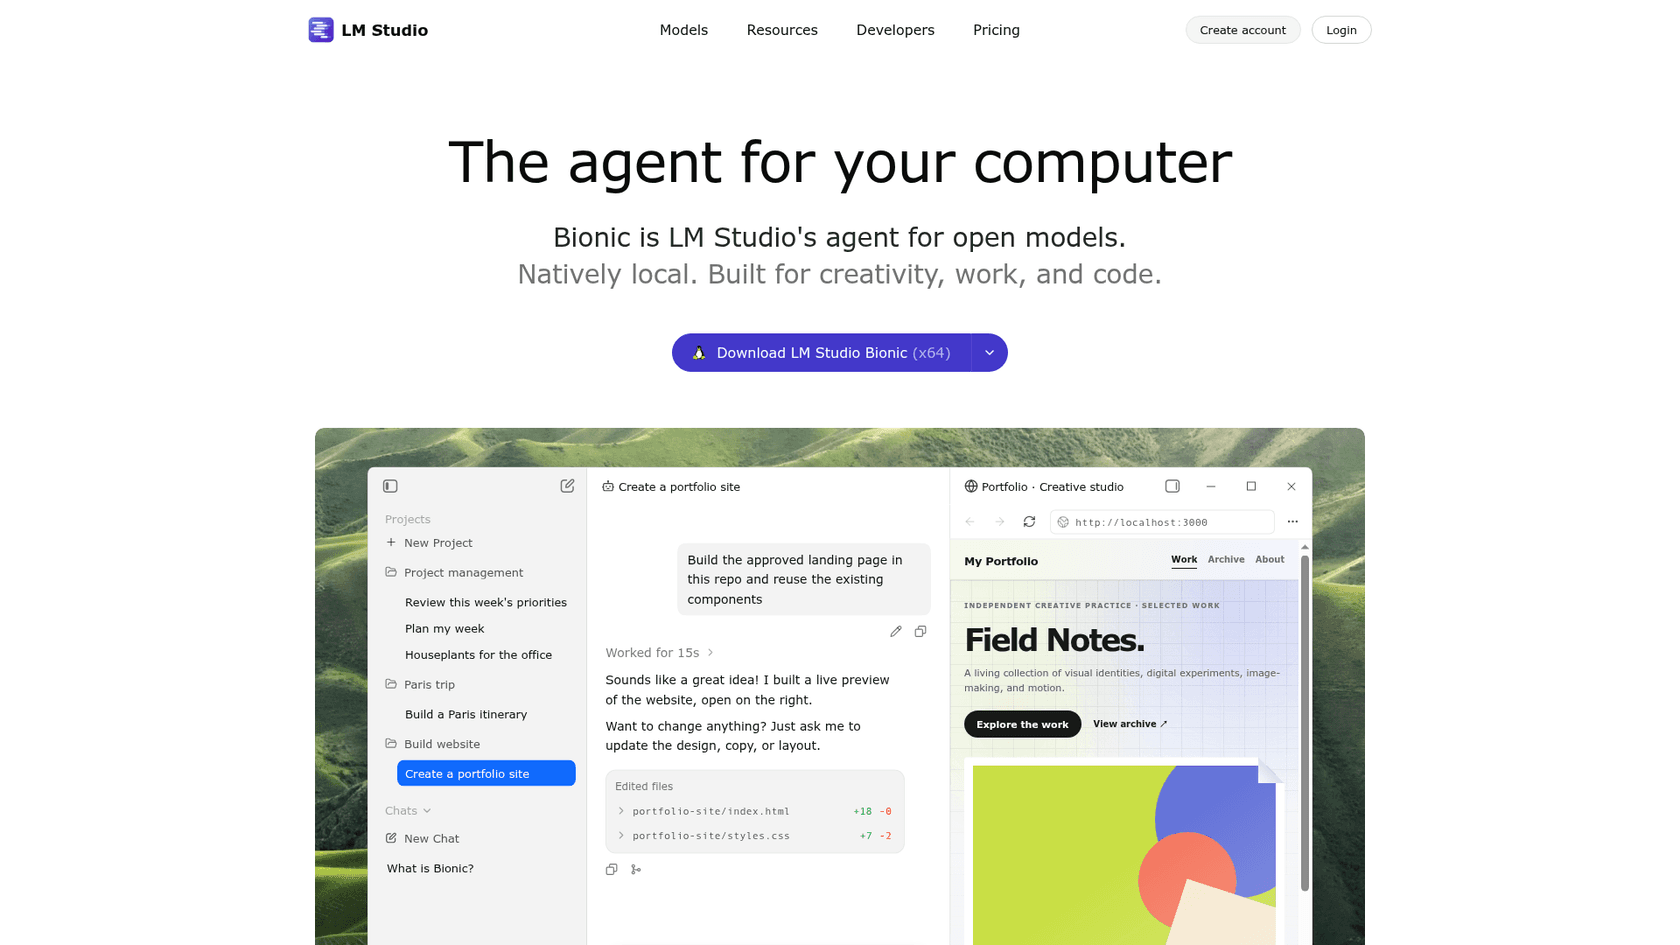
LM Studio est passé d'une appli de chat de modèles à "Bionic", qu'il appelle "LM Studio's agent for open models. Natively local." En dessous, dans ses propres mots, il tourne "with MLX and llama.cpp under the hood."
Ce qu'il fait mieux que llama.cpp
- Découverte de modèles. La recherche montre ce qui rentre dans votre matériel avant de télécharger.
- Les deux moteurs sur un Mac. GGUF via des packs d'extension llama.cpp et MLX via son propre moteur oMLX, choisi par modèle.
- Surface développeur. Endpoints compatibles OpenAI et Anthropic, SDK TypeScript et Python, la CLI
lms, etllmster, un daemon sans interface pour serveurs et CI qui tourne sans la GUI.
"LM Studio's model search is pretty good at showing what models will fit in your VRAM."
Où il montre ses limites
- Appli à code fermé. L'appli de bureau est sous les conditions propres à LM Studio ; seules la CLI et les SDK sont en MIT sur GitHub.
- En retard sur llama.cpp. Il regroupe des packs de moteur précompilés, donc le support des modèles tout neufs peut arriver quelques jours plus tard.
- Pas de Mac Intel. macOS a besoin d'Apple Silicon et de macOS 14+.
Coût
Gratuit en local. Selon LM Studio Pricing, Bionic+ coûte 20 $/mois pour des modèles ouverts hébergés aux États-Unis et la recherche web, Pro coûte 100 $/mois pour 5 fois les limites d'usage, et la facturation d'équipe n'a pas de prix affiché.
Verdict
Choisissez LM Studio si vous voulez la meilleure interface graphique pour les modèles locaux, surtout sur un Mac, où il bascule entre GGUF et MLX pour vous. Passez votre tour si vous avez besoin d'une appli open source ou de la toute dernière build de llama.cpp le jour même.
8. Jan
Le mieux pour : une appli de bureau open source façon ChatGPT qui reste locale.
Jan est une appli de bureau open source pour macOS, Windows et Linux. Sa documentation dit "the llama.cpp engine is built into Jan and updates together with the app", avec MLX utilisé sur Apple Silicon.
Ce qu'il fait mieux que llama.cpp
- Open source et convivial. Apache 2.0, environ 45 700 étoiles, une interface de chat, et un hub de modèles qui télécharge un modèle par défaut au premier lancement.
- Local plus cloud dans une seule fenêtre. Ajoutez des clés OpenAI, Anthropic ou Google à côté des modèles locaux, plus des serveurs MCP et la recherche web.
- Une API locale. Un serveur compatible OpenAI sur
127.0.0.1:1337/v1.
"its open source, has a simple chat interface, it uses llama.cpp, it lets you search for models and downloads them, and it supports .gguf so youre not locked in if you want to use the models with another program later on"
Où il montre ses limites
- Le même moteur. Comme Ollama et LM Studio, il ne change pas la vitesse d'inférence.
- Mac Intel. Son moteur llama.cpp intégré ne charge plus de modèles sur Mac Intel depuis la v0.8.5.
- Fonctionnalités récentes en preview. Cowork, le mode tâche autonome, est encore marqué preview.
Coût
Gratuit. Aucun palier payant ; sa plateforme hébergée est listée comme à venir.
Verdict
Choisissez Jan si vous voulez le confort de LM Studio avec une licence open source. Passez votre tour si vous avez besoin d'un service de niveau serveur.
9. LocalAI
Le mieux pour : une seule API auto-hébergée qui couvre le texte, l'image, la voix et plus.
LocalAI est un moteur auto-hébergé sous licence MIT pour les modèles de texte, de vision, de voix, d'image et de vidéo, avec "more than 80 backends", dont llama.cpp, vLLM, MLX et whisper.cpp.
Ce qu'il fait mieux que llama.cpp
- Une API pour de nombreux types de modèles. Compatible OpenAI, plus les formats Anthropic et ElevenLabs, une API temps réel et des grammaires contraintes.
- Backends enfichables. Chaque backend est sa propre image, chargée seulement quand un modèle en a besoin, et l'équipe en construit certains elle-même, comme vllm.cpp.
- Large éventail matériel. CPU, NVIDIA CUDA 12 et 13, AMD ROCm, Intel, Apple Metal, Vulkan et Jetson.
Où il montre ses limites
- Surtout un routeur. Pour les modèles de texte GGUF, llama.cpp reste le moteur qui fait le travail.
- Fonctionnalités récentes en builds de dev. Agents, fichiers, sandbox et logins d'équipe ne sont qu'en builds de développement à partir de la v4.12.1.
- Plus de pièces mobiles. Un conteneur par backend est flexible, mais plus lourd qu'un seul binaire.
"And if you want to use WSL, then I'd suggest using something like LocalAI which gives you a lot more control and support for additional formats (GGML, GGUF, GPTQ, ONNX, etc)."
Coût
Gratuit. Installation par script, Docker, une appli macOS ou Kubernetes.
Verdict
Choisissez LocalAI si vous voulez un seul endpoint type OpenAI pour un home lab ou une plateforme interne qui sert plus que du chat. Passez votre tour si tout ce que vous faites tourner, ce sont des modèles de texte, où le moteur pur est plus simple.
Quand devriez-vous rester sur llama.cpp ?
Quand vous êtes une seule personne sur une seule machine, et surtout sur du matériel mixte ou inhabituel. Aucune alternative de cette liste ne couvre autant de backends, de Vulkan sur les portables AMD à Snapdragon et Huawei Ascend. Les nouvelles architectures de modèles ont aussi tendance à y arriver d'abord : v1.0.0 a ajouté Kimi-K3.1-Pro et Ripple-65B le jour de sa sortie, et llama-server vous donne déjà une API compatible OpenAI, une interface web et des outils MCP. Le guide llama.cpp de mon collègue couvre la configuration de v1.0.0 en détail.
Les deux plus grosses plaintes sont aussi plus petites qu'avant. Les compilations sont maintenant optionnelles avec l'appli Llama et les installations Homebrew ou Winget, et le nouveau cache MoE de v1.0.0 a doublé la vitesse dans un test de la release, de 24,2 à 47,6 tokens par seconde sur Qwen3.8-Flash-Next, avec la plupart des ratés d'experts gérés sur le CPU (PR #30966).
"I have been using llama.app, which is the desktop interface built on top of llama.cpp by the same people. It is an alternative to Ollama that might interest people who want to switch given Ollama's reputation and previous decisions."
Si vous faites tourner des modèles surtout pour piloter des agents de code, restez, sauf si vous avez mesuré un goulot d'étranglement. Un agent qui attend des appels d'outils a rarement besoin du batching d'un moteur serveur. Pareil pour les agents open source que vous faites tourner chez vous.
Que coûte vraiment un changement depuis llama.cpp ?
Chaque moteur de cette liste est un logiciel libre, donc le prix c'est le matériel et les heures. Quelques règles générales tirées de la documentation ci-dessus :
- vLLM, SGLang et TensorRT-LLM veulent dire un serveur GPU Linux et quelqu'un qui maintient CUDA, les drivers et les conteneurs à jour. SGLang exige déjà CUDA 13.
- MLX-LM ne coûte rien de plus si vous avez déjà un Mac série M avec assez de mémoire unifiée.
- ExLlamaV3 veut dire convertir des modèles en EXL3 et garder un dossier de modèles séparé de vos fichiers GGUF.
- Ollama et LM Studio sont gratuits en local, et ne font payer que pour leurs modèles cloud, à partir de 20 $/mois.
Si vous préférez ne rien gérer de tout cela, l'inférence hébergée comme Together AI transforme la facture matérielle en facture au token. Suivez-la quand même avec un outil de suivi LLM, parce que les modèles locaux ne sont moins chers que si la machine reste occupée.
Où eesel se place-t-il si vous voulez de l'IA sur les tickets de support ?
Beaucoup de gens arrivent sur llama.cpp parce qu'ils veulent une IA qui répond aux clients sans envoyer de données partout. Un moteur d'inférence est l'infrastructure pour cela, pas le travail fini. Vous devriez tout de même construire la connexion au helpdesk, la synchronisation des connaissances, les tests, la transmission aux personnes et le reporting. C'est le travail que fait eesel : un moteur fait tourner un modèle ; eesel est le coéquipier qui fait le travail de support.
Le coéquipier IA pour helpdesk d'eesel rejoint votre file existante dans Zendesk ou Freshdesk, répond à partir de votre centre d'aide et des tickets passés, et est testé sur des conversations historiques avant de répondre à un vrai client. SE Ranking fait tourner un agent eesel par produit sur trois produits sur Zendesk, traitant 4 650 conversations par mois à partir d'environ 16 800 pages de connaissances, avec les remboursements et les demandes de transfert vers une personne confiés à l'équipe. Orosoft, qui construit des logiciels pour l'industrie des métaux précieux, l'utilise plutôt comme copilote : le personnel de support mentionne eesel sur un ticket Freshdesk et reçoit un brouillon basé sur environ 6 100 tickets passés.
Si vous êtes déjà à l'aise dans un terminal, la CLI d'eesel est la partie que vous allez aimer. Un agent de code comme Claude Code ou Codex peut l'utiliser pour envoyer des connaissances approuvées comme des articles d'aide exportés et des macros, ajuster les instructions de l'agent, et poser des questions de test pour vérifier les réponses avant que quoi que ce soit passe en ligne. Connecter le helpdesk lui-même a encore besoin de quelqu'un avec un accès admin pour l'approuver.
Essayer eesel
Si le modèle sur votre bureau était destiné à finir par répondre à des clients, eesel vous y mène sans choisir de moteur ni acheter de GPU. Il se connecte à votre helpdesk en quelques minutes, apprend de vos tickets passés, et est testé d'abord sur d'anciennes conversations, comme SE Ranking le fait tourner sur trois produits. Regardez les tarifs d'abord si vous voulez. Quand vous êtes prêt, essayez eesel gratuitement.