

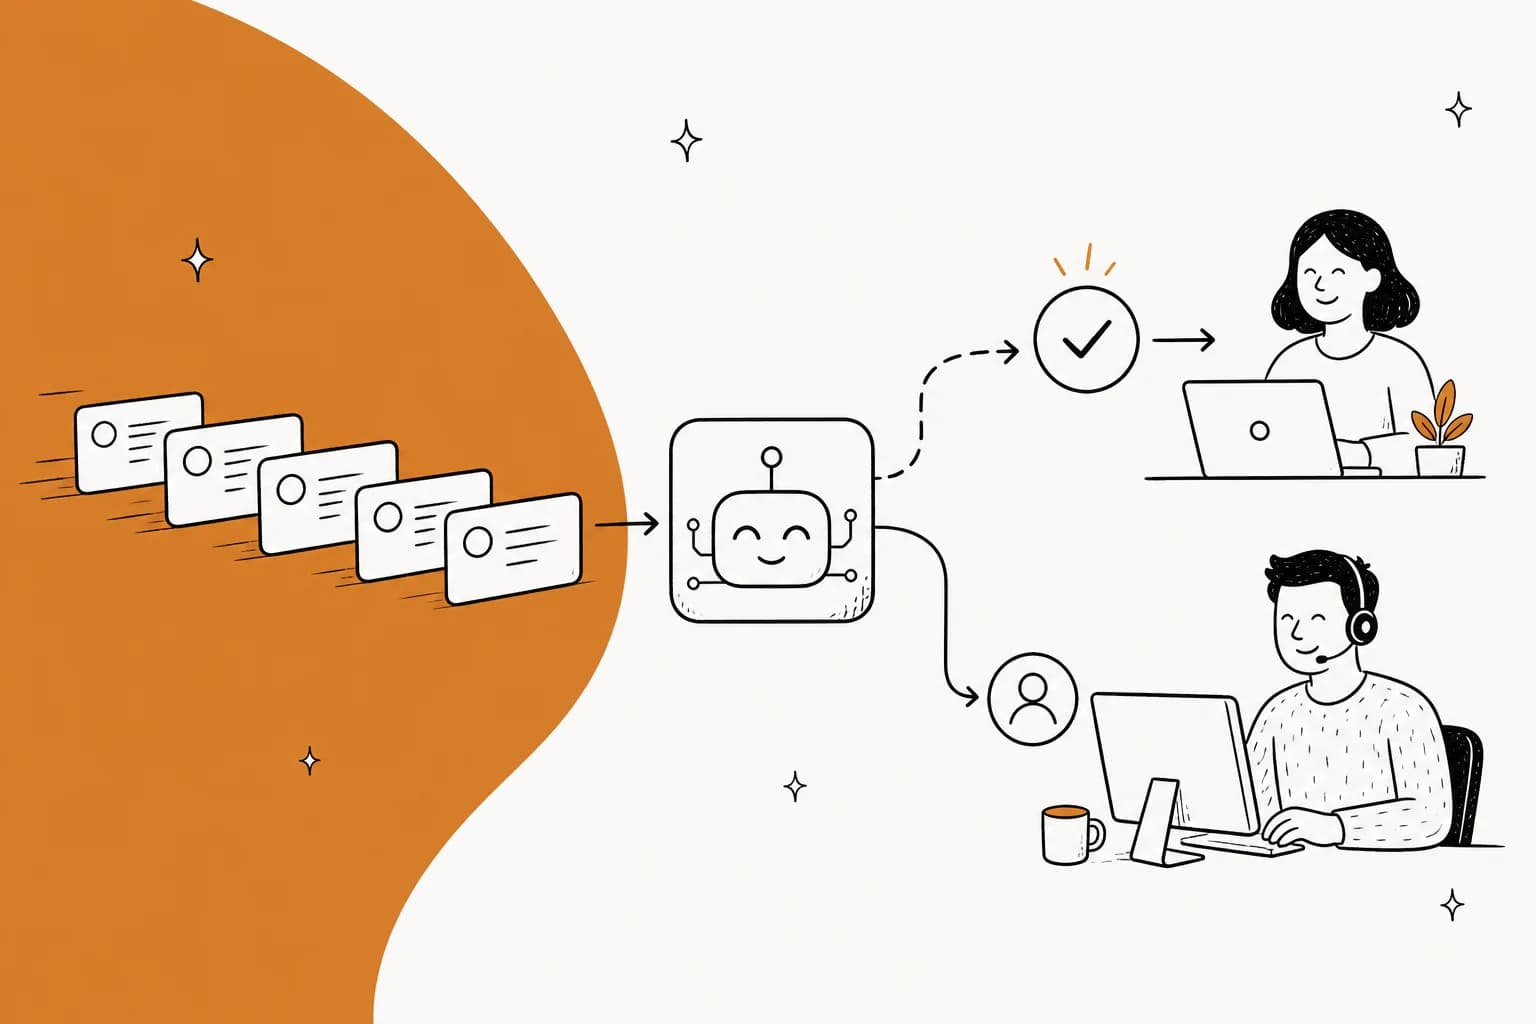
Le support client avec l'IA est un logiciel qui lit un message entrant, cherche la réponse dans vos propres documents et tickets passés, puis répond ou transmet la conversation à une personne. La partie intéressante n'est pas de répondre. C'est la transmission. La plupart des déploiements qui déçoivent ont bien fait la recherche et mal fait l'escalade.
La règle de périmètre qui tient sur des files réelles : automatisez les tickets à fort volume et faible jugement, et mettez de côté tout ce dont une erreur coûte cher ou est difficile à inverser. Là où les équipes se brûlent, c'est au milieu, et la solution est un seuil de confiance qui laisse l'IA décliner plutôt que deviner.
Un déploiement réaliste prend deux à quatre semaines, pas deux jours, et la partie lente est votre base de connaissances, pas le logiciel. Commencez en mode brouillon, où une personne appuie encore sur envoyer, laissez exactement un type de ticket s'envoyer automatiquement, puis élargissez. Je construis de l'IA de support chez eesel depuis des années, et le schéma est constant : le premier mois vaut le coup juste pour la vitesse de rédaction, bien avant que quoi que ce soit ne se résolve tout seul.
Si eesel est l'outil que vous essayez, un agent de codage IA peut gérer la première configuration. Dès que vous approuvez l'accès, il connecte votre helpdesk, ajoute les documents à partir desquels l'IA doit répondre, et démarre en mode brouillon, de sorte qu'une personne appuie toujours sur envoyer. Cela vous donne la vitesse de rédaction dès la première semaine, pendant que vous décidez quel type de ticket envoyer automatiquement en premier. Voir le guide de configuration avec un agent de codage.
Ce qu'est vraiment le support client avec l'IA
Si on enlève le marketing, ce sont quatre étapes. Un message arrive. Le système cherche dans votre centre d'aide, vos tickets passés et tout ce que vous avez connecté d'autre. Il décide s'il connaît assez bien la réponse pour en envoyer une. Puis il répond, rédige quelque chose pour qu'une personne le vérifie, ou escalade.
C'est tout. Tout le reste, chaque "agentique" et "autonome" et "intelligent", est une affirmation sur la qualité d'exécution de chacune de ces quatre étapes.
Les mots se mélangent constamment, voici donc la distinction qui survit à une démo. Trois questions vous disent à quelle catégorie vous avez affaire : qui lit la sortie, peut-elle écrire dans un système d'enregistrement, et décide-t-elle en raisonnant ou en suivant un script.
| Qui lit la sortie | Peut-elle changer vos systèmes | Comment elle décide | |
|---|---|---|---|
| Chatbot basé sur des règles | Le client | Non | Un arbre de décision que vous avez dessiné |
| Agent IA | Le client | Oui, si vous le permettez | Raisonne sur votre contenu |
| Copilote | Votre agent | Seulement quand un humain envoie | Raisonne, l'humain approuve |
Un chatbot basé sur des règles se casse dès qu'un client formule quelque chose comme le ferait une vraie personne. Un agent de support IA raisonne sur votre contenu et peut agir. Un copilote rédige et laisse votre agent appuyer sur envoyer. La différence entre agents IA et chatbots ne tient pas au modèle en dessous, elle tient à savoir si cette chose est autorisée à terminer une tâche.
Une autre expression qui mérite d'être décortiquée, parce qu'elle apparaît sur presque toutes les pages de fournisseur : "entraîné sur vos données". Cela couvre trois mécanismes complètement différents.
- Le fine-tuning cuit votre contenu dans les poids du modèle. Lent à mettre à jour, et vos données ont déjà quitté la maison.
- Le retrieval indexe vos documents et les cite au moment de répondre. C'est ce que signifie le RAG, et c'est ce que presque tout le monde fait en réalité. Modifiez un article, et la prochaine réindexation le prend en compte.
- Les appels d'outils en direct interrogent votre API de commandes sur le moment. Le seul des trois capable de répondre à "où est ma commande", parce que la réponse n'existait pas quand l'index a été construit.
Demandez à un fournisseur lequel des trois il entend. Cela change la vitesse à laquelle un changement de politique se propage, la quantité de vos données qui quitte vos systèmes, et si la chose peut même répondre à des questions propres à un compte. Le compromis entre RAG et fine-tuning pour les centres d'aide vaut la peine d'être compris avant de s'asseoir pour une démo, et si vous voulez la couche du dessous, la recherche vectorielle pour le support couvre la mécanique du retrieval.
Comment ça marche, ticket par ticket
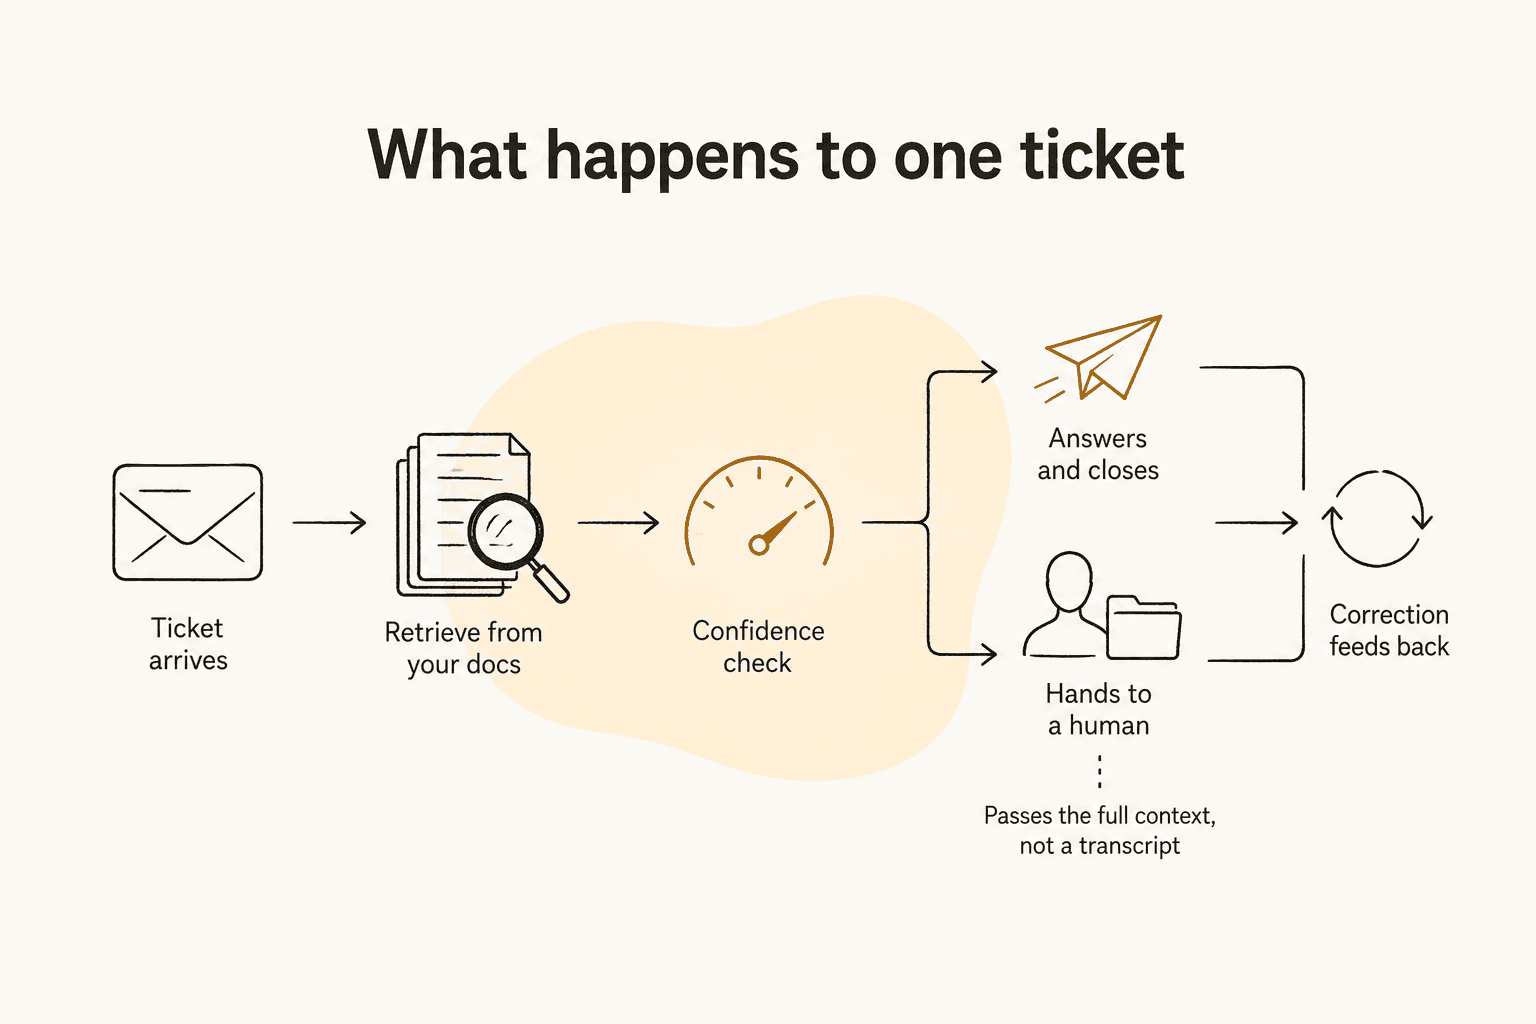
Suivez un ticket, et le mécanisme n'est plus mystérieux.
Il lit le ticket et détermine ce qui est demandé. Pas une correspondance de mots-clés. La classification d'intention plus l'extraction d'entités plus une lecture du sentiment, de sorte que "c'est la troisième fois que je demande à propos de la commande 44182 et je perds patience" se résout en une question de statut de commande, un numéro de commande, et un client en colère. Ce dernier signal compte plus qu'on ne l'attend, et l'analyse de sentiment est souvent ce qui décide si l'IA répond du tout.
Il cherche dans tout ce que vous avez connecté, en même temps. Articles du centre d'aide, tickets passés résolus, macros, un wiki interne, des PDF téléversés. Les bons systèmes regroupent tout cela plutôt que de l'isoler par intégration, de sorte qu'une réponse peut s'appuyer à la fois sur vos documents publics et sur votre runbook interne. Le grounding est le terme qui désigne le fait d'attacher la réponse au texte récupéré plutôt qu'à la mémoire du modèle, et c'est le plus gros levier unique de précision.
Il vérifie s'il devrait parler. C'est l'étape du score de confiance, et c'est là que les bons déploiements se séparent des mauvais. Une confiance élevée envoie une réponse. Une confiance faible écrit à la place une note interne pour une personne. Chez eesel, ce comportement est quelque chose que vous configurez en langage simple plutôt qu'un seuil que vous ajustez numériquement, et la documentation de l'agent helpdesk énonce le repli sans détour : s'il ne sait pas, il le dit, ou il escalade.
Il agit, ou il transmet. Agir signifie écrire dans un système : étiqueter le ticket, mettre à jour un champ, consulter une commande, émettre un remboursement, clore la conversation. Transmettre signifie un vrai transfert avec le contexte attaché. Plus de détails plus bas, parce que c'est la partie dans laquelle tout le monde sous-investit.
Les corrections reviennent dans la boucle. Votre agent réécrit le brouillon, ou dit au système qu'il était trop formel, et cela devient un changement d'instruction plutôt que de s'évaporer. Sans cette boucle, vous réenseignez la même leçon chaque semaine.

Ce qu'il devrait traiter, et ce qu'il ne devrait pas
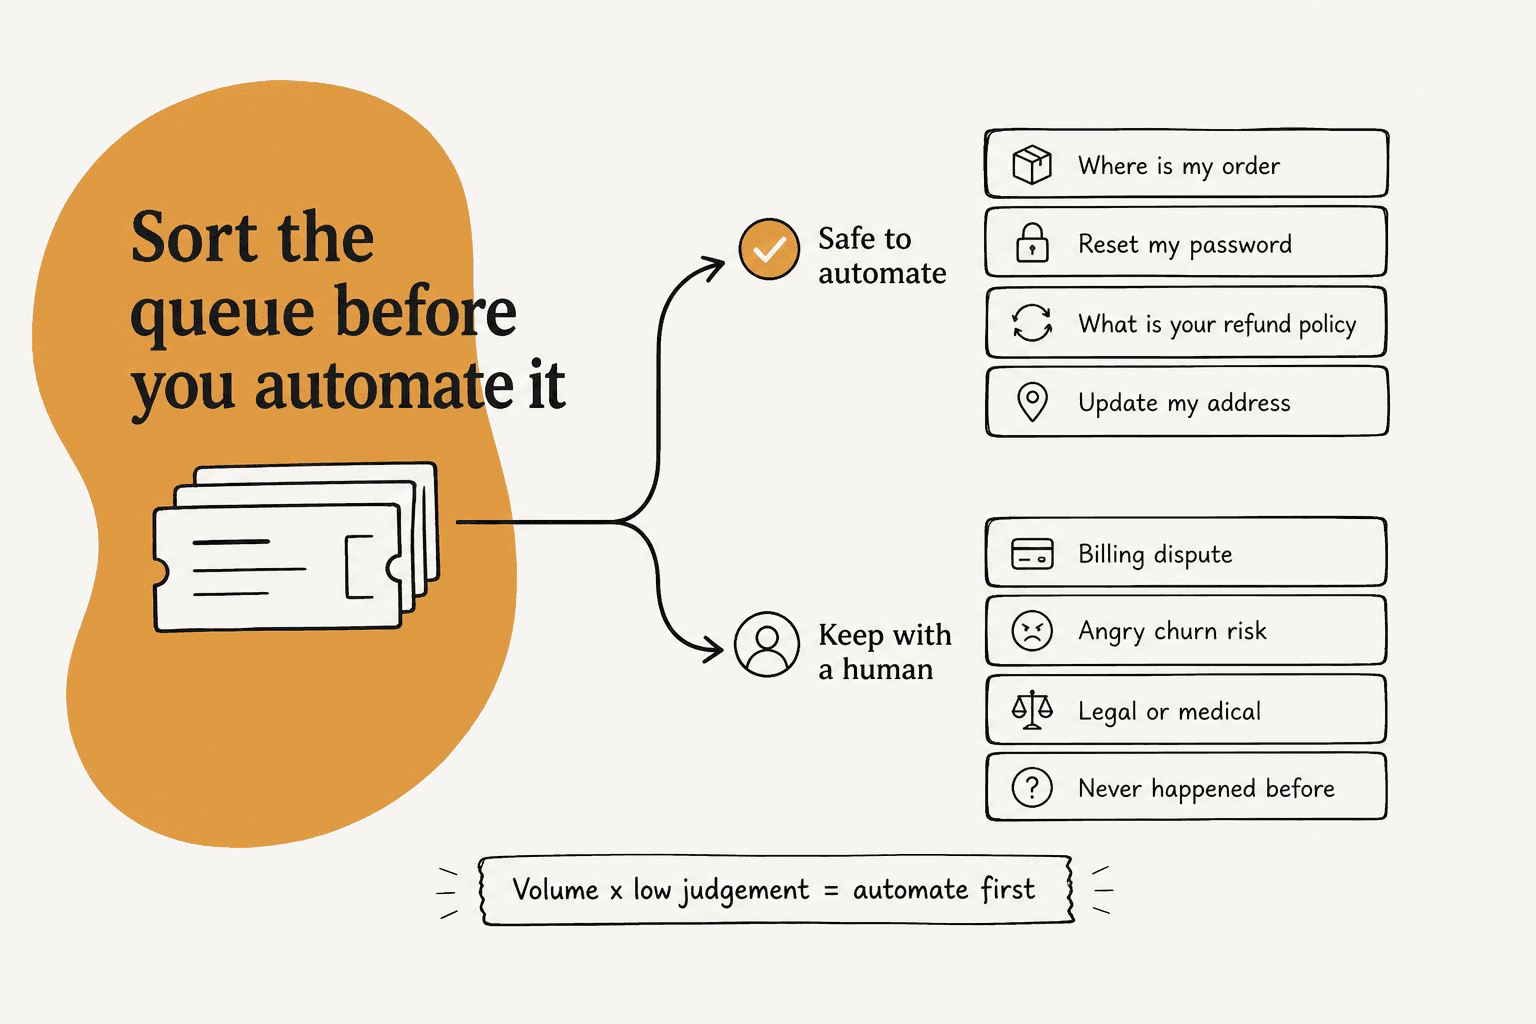
La règle de périmètre à laquelle je reviens toujours est volume multiplié par faible jugement. Un volume élevé seul ne suffit pas, parce que mille litiges de facturation identiques restent mille litiges de facturation. Un faible jugement seul ne suffit pas non plus, parce qu'automatiser une question que vous recevez deux fois par mois n'en vaut pas la peine.
À automatiser en premier : le statut de commande et le WISMO. Les réinitialisations de mot de passe. Les questions de politique avec une réponse documentée. Les changements d'adresse et d'abonnement. Le triage des tickets et le routage. La traduction. Ils partagent une propriété : la bonne réponse existe déjà par écrit quelque part, et envoyer la mauvaise coûte un e-mail de suivi plutôt que de l'argent.
Le spam appartient aussi à cette liste, et il est sous-estimé. Dans un vrai test sur lequel je reviendrai plus tard, 22 % de la file entrante était du courrier indésirable, et l'intercepter avant qu'une personne ne lise un seul mot a été une victoire du premier jour, sans aucun risque pour le client.
À laisser à une personne : tout ce dont une erreur coûte cher ou est difficile à inverser.
- Les exceptions de politique. Le jour 35 d'une fenêtre de retour de 30 jours est une question de jugement, pas une recherche. L'IA devrait le signaler et l'escalader, pas décider.
- L'argent au-dessus d'un plafond que vous fixez. Écrivez le chiffre. L'agent peut émettre un crédit jusqu'à X $ ; au-delà, une personne signe. Presque personne ne publie cette règle, et tout vrai déploiement en a une.
- Les conversations réglementées. Conseils médicaux, juridiques, financiers. La conformité n'est pas un badge sur une page tarifaire, c'est une contrainte sur ce que l'agent est autorisé à dire.
- Les clients déjà en colère. Une bonne transmission au premier message vaut mieux qu'une excellente réponse au quatrième.
- Tout ce qui n'est jamais arrivé avant. S'il n'y a aucun précédent dans votre historique de tickets et rien dans vos documents, le retrieval ne renvoie rien, et c'est exactement dans cette condition que les modèles commencent à inventer.
Ce dernier point mérite qu'on s'y arrête, parce que j'ai vu en direct comment ça a mal tourné sur notre propre produit. Quand le retrieval revient vide, un modèle auquel on n'a pas dit de s'arrêter remplit le vide avec des données d'entraînement. Nous avons eu des clients payants, dont un fournisseur danois d'énergie solaire, dont le bot a inventé des affirmations sur les produits et les a envoyées à de vraies personnes, parce que la base de connaissances n'avait aucune correspondance et que personne ne lui avait dit de décliner. La solution n'a jamais été un meilleur modèle. C'était un seuil strict et un repli consistant à décliner de répondre.
Il existe une version plus simple du même test que j'écrirais sur un tableau blanc avant tout déploiement : cette action peut-elle être annulée en un clic ? Si non, une personne approuve. Cela couvre les remboursements, les annulations, les suppressions de compte, et tout ce qui envoie un e-mail qu'un client va capturer en image.
L'affirmation la plus tranchante sur ce sujet que j'aie entendue venait d'une responsable CX d'une marque de compléments alimentaires DTC gérant environ 7 000 tickets Gorgias par mois contre 30 000 commandes :
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Nous avons probablement perdu cette affaire pour cette raison, qui est exactement pourquoi je continue à la citer. "Leave them alone" est une exigence produit plus dure que "répondre à tout", et c'est celle à laquelle les acheteurs tiennent vraiment.
Les bénéfices qui tiennent, et les limites que personne n'imprime
La liste honnête des bénéfices est plus courte que celle du marketing, mais chaque élément est vérifiable.
Couverture hors de vos horaires. C'est le gain le moins contestable. Une file qui restait en souffrance toute la nuit reçoit maintenant un premier contact à 3 heures du matin, et la couverture hors horaires est souvent ce qu'une petite équipe ressent en premier.
Une portée linguistique sans traduire votre centre d'aide. Un ticket en français reçoit une réponse en français à partir d'une documentation en anglais. Un client eesel, la plateforme de comparaison de prêts Smava, exploite un agent Zendesk entièrement automatisé qui traite plus de 100 000 tickets en allemand par mois, un chiffre publié sur la page de l'agent helpdesk. Le support multilingue était autrefois un problème d'effectifs et ne l'est plus la plupart du temps.
De la vitesse sur le niveau ennuyeux. Le temps de première réponse chute fortement sur les types de tickets que vous avez délimités, parce qu'il n'y a plus de file devant eux.
De la cohérence. Chaque agent répond à la question sur la politique de remboursement de la même manière, ce qui n'est pas glamour, mais c'est ce que votre responsable qualité réclame depuis trois ans.
Maintenant les limites, dites clairement, parce que je préfère que vous les rencontriez ici plutôt qu'en production.
Elle n'est aussi bonne que vos connaissances écrites, et les vôtres ont probablement la mauvaise forme. Un responsable support dans un service de suivi de bus nous a dit que toute leur base de connaissances était écrite pour des administrateurs, alors que chaque ticket venait de voyageurs. Le retrieval fonctionnait parfaitement et les réponses restaient confuses. Le contenu obsolète du centre d'aide est l'autre moitié du même problème : la politique a changé en mars, l'article non, et l'IA cite en août avec assurance une politique morte.
Un taux de déviation élevé peut cacher un déploiement qui échoue. Si les tickets se ferment et que les contacts répétés montent, vous déviez au lieu de résoudre. Suivez-les ensemble, ou le tableau de bord vous mentira.
La sur-escalade est un vrai mode d'échec et elle ressemble à de la sécurité. Un agent qui transmet tout à une personne ne casse rien, ne contrarie personne, et en silence ne livre jamais de retour sur investissement.
Le ton est un problème distinct de la précision. Cela nous a surpris avec des chiffres réels, et c'est le cœur de l'exemple chiffré plus bas.
Les clients peuvent le détester même quand vous le construisez bien. C'est la limite que personne n'écrit sur une page tarifaire, et la version la plus honnête que j'en aie lue venait de quelqu'un qui a dirigé le projet :
"This is so true. I led the implementation of an AI customer service agent and even though management thinks it's a great success the metrics tell a totally different story. Our customers hated it. I haven't seen anything in tech that is hated more. Before you think we did a bad job with our solution, I can tell you we went with some of the best and did our own intensive testing and worked on latencies etc., I actually thought the final version was pretty good but our customers just hated it."

La raison pour laquelle ce commentaire est difficile à balayer est la défense préventive en son milieu. Ma lecture est que l'écart est presque toujours dans le positionnement : une IA qui est un outil que le client peut contourner, ça va, et une IA qui est une porte qu'il doit franchir, ça ne va pas.
Elle ne supprime pas le travail opérationnel, elle le déplace. Quelqu'un possède la base de connaissances, vérifie les escalades, et lit le rapport hebdomadaire. Sur 24 comptes eesel qui ont churné, notre co-fondateur Amogh Sarda a trouvé le même fil conducteur : "zero proactive outreach for 6+ months. No 30/60/90 day check-ins on any tier." Les déploiements ne tournent pas tout seuls, d'aucun côté.
Où les équipes l'utilisent vraiment
Cinq schémas couvrent la plupart de ce que je vois sur des files réelles.
Statut de commande et expédition. La question à plus fort volume et plus faible jugement dans l'e-commerce, et celle qui a le plus besoin d'un appel d'outil en direct plutôt que d'une recherche documentaire, parce que la réponse vit dans Shopify, pas dans votre centre d'aide. Cela vaut la peine de lire sur l'automatisation du suivi de commande avant de le délimiter.
Retours et remboursements, avec un plafond. L'IA peut gérer les remboursements, dans le cadre d'une politique documentée. Fixez la limite en dollars, mettez tout ce qui est au-dessus derrière une approbation, et vous aurez couvert le volume sans transmettre les clés du coffre. La mécanique de l'automatisation des remboursements tient plus à la conception de l'approbation qu'à l'IA.
Triage de niveau 1. Même quand l'IA ne répond jamais à un client, classer, étiqueter, prioriser et router est un vrai gain. La déviation de niveau 1 fait les gros titres, mais le routage des tickets est le plus discret, celui que les agents remarquent en premier.
L'assistance à l'agent, dans le helpdesk qu'ils utilisent déjà. Le schéma copilote : le brouillon attend quand l'agent ouvre le ticket. Zéro nouvelle habitude, ce qui explique une adoption élevée et un risque presque nul.
Le support IT interne et le support employés. L'endroit le plus sûr pour commencer, parce que votre public est constitué de collègues plutôt que de clients. Le responsable IT d'InDebted a placé eesel comme premier répondant sur sa file Jira Service Management et l'a décrit comme se comportant "just like an agent would". Ils sont à 15 % de déviation en visant 55 %, et ce chiffre me plaît plus que les chiffres clinquants, parce qu'il montre honnêtement à quoi ressemble le troisième mois.
Si vous êtes sur la même pile technique, l'IA pour Jira Service Management couvre la configuration, et le même schéma s'étend au-delà de l'IT vers le helpdesk RH et le support employés en général.
La profondeur technique n'est pas non plus automatiquement hors périmètre, ce qui m'a surpris. L'une des déviations les plus fortes que j'aie vues dans nos propres journaux était un technicien de terrain chez un fournisseur d'automatisation industrielle signalant une panne matérielle avec des codes d'erreur et des symptômes réseau. L'agent a lancé six recherches dans des manuels PDF, en a lu deux en entier, et a rédigé un ensemble structuré de tests d'isolement. La profondeur n'est pas la barrière. Que la réponse soit écrite quelque part, voilà la barrière.
Concevoir l'escalade, la partie que tout le monde saute
Voici mon opinion réelle après des années là-dessus : la conception de l'escalade, c'est le produit. Répondre est désormais la base. Ce qui distingue un déploiement que votre équipe défend d'un déploiement qu'elle rejette, c'est ce qui se passe dans les 20 % des conversations que l'IA ne devrait pas conclure.
La confirmation extérieure la plus claire de cela que j'aie vue venait d'un opérateur de centre de contact décrivant ce qui est réellement arrivé à ses chiffres après le lancement :
"AHT question nobody wants to answer lol. shipped a billing/tracking bot, decent containment, but AHT on escalated calls went up. agents had to read the transcript, figure out what the bot already tried, re-ask half of it anyway. fixed by forcing a structured handoff summary instead of raw transcript dump (saved more time than the automation itself). CSAT fine on deflected stuff, tanked on anything that bounced back after a failed bot attempt"

Lisez deux fois cette dernière proposition. Le CSAT allait bien sur les conversations que le bot concluait, et s'effondrait sur celles qui revenaient en rebond. L'automatisation fonctionnait. La transmission était le défaut produit, et la corriger a économisé plus de temps que l'automatisation elle-même.
Trois échecs que j'ai vu arriver, tous pires qu'une mauvaise réponse.
La transmission qui ne fait que s'annoncer elle-même. Le bot dit au client qu'il le transfère à une personne, puis ne le fait pas. Une entreprise d'hébergement néerlandaise sur Zendesk a rencontré cela à répétition, avec en plus le nom et l'e-mail du client qui ne se transféraient pas lors du passage de relais, et a fini par construire son propre outil. La phrase d'Amogh sur cette classe de bug m'est restée : "If hard-fail it's silent-failure class (worst class for trust)." Une erreur visible est récupérable. Une conversation qui s'est éteinte en silence ne l'est pas.
L'escalade dans le vide. Un déploiement escaladait par e-mail, et l'e-mail d'escalade était fermé automatiquement par une règle dont personne ne se souvenait l'avoir écrite. Aucun humain ne l'a jamais vu. Le tableau de bord montrait que les escalades se déclenchaient correctement.
L'IA qui se fait passer pour une personne. Même déploiement : l'agent avait récupéré le nom d'un agent humain dans l'historique des tickets et avait commencé à signer de son nom. Les clients pensaient avoir atteint une personne. Donnez un nom à votre bot, et faites-lui dire ce qu'il est.
Donc, concrètement, ce qu'une bonne conception d'escalade précise avant la mise en production :
- Les déclencheurs. La demande explicite d'une personne. La même question posée deux fois. Une lecture de sentiment au-delà d'une ligne que vous fixez. Une intention sur votre liste noire. Un compte à forte valeur nommé. Plus celui que presque personne n'écrit : les conditions de non-escalade, où vous avez décidé que l'IA devrait continuer plutôt qu'abandonner.
- La charge utile. L'historique complet de la conversation, un résumé clair de ce que l'IA a essayé et pourquoi elle s'est arrêtée, la lecture de sentiment, et chaque enregistrement qu'elle a récupéré. Une simple transcription force la personne à tout relire, ce qui est l'opposé d'une aide. Les bonnes pratiques de transmission approfondissent ce point.
- La route. Quelle file, quelle priorité, et si la lecture de sentiment de l'IA peut la faire monter. La gestion des escalades est autant un problème de routage qu'un problème conversationnel.
- Ce qu'on dit au client. Citez-vous un temps d'attente ? La transcription reste-t-elle visible ? Bien faire la conception de la conversation de transmission coûte peu cher, et la différence se ressent immédiatement.
- Ce qui se passe quand personne n'est là. Les nuits, les week-ends, une file à 200 %. C'est l'échec d'escalade réel le plus courant et le moins documenté. La réponse est généralement un schéma d'attente qui fixe une vraie attente, pas une fausse promesse.
Ce dernier point a une version plus élégante que "s'excuser et attendre". Une fintech avec laquelle nous travaillons, avec 7 000 à 8 000 tickets escaladés par mois en attendant des partenaires de paiement tiers, utilise l'IA pour maintenir les tickets escaladés au chaud avec des mises à jour de statut honnêtes. Pas besoin de base de connaissances, juste des instructions. Escalader ne doit pas forcément signifier que la conversation s'arrête.
Toute transmission n'est pas compliquée non plus. En voici une tirée de nos propres journaux, sur le chat du site web d'un outil SEO : le client a demandé comment supprimer des mots-clés d'un projet, a obtenu une réponse, a demandé comment supprimer des moteurs de recherche, a obtenu une autre réponse, puis a demandé "Puis-je parler à une personne ?" et a été transféré immédiatement. Deux questions résolues en libre-service, une sortie propre. Voilà à quoi ressemble de l'extérieur un système qui fonctionne, et c'est complètement banal, ce qui est le but.
Si vous êtes spécifiquement sur Zendesk, les règles d'escalade Zendesk couvrent le côté natif de cela, et la transmission humaine dans le chat couvre la version canal en direct, où les secondes comptent vraiment.
Comment le déployer, semaine après semaine
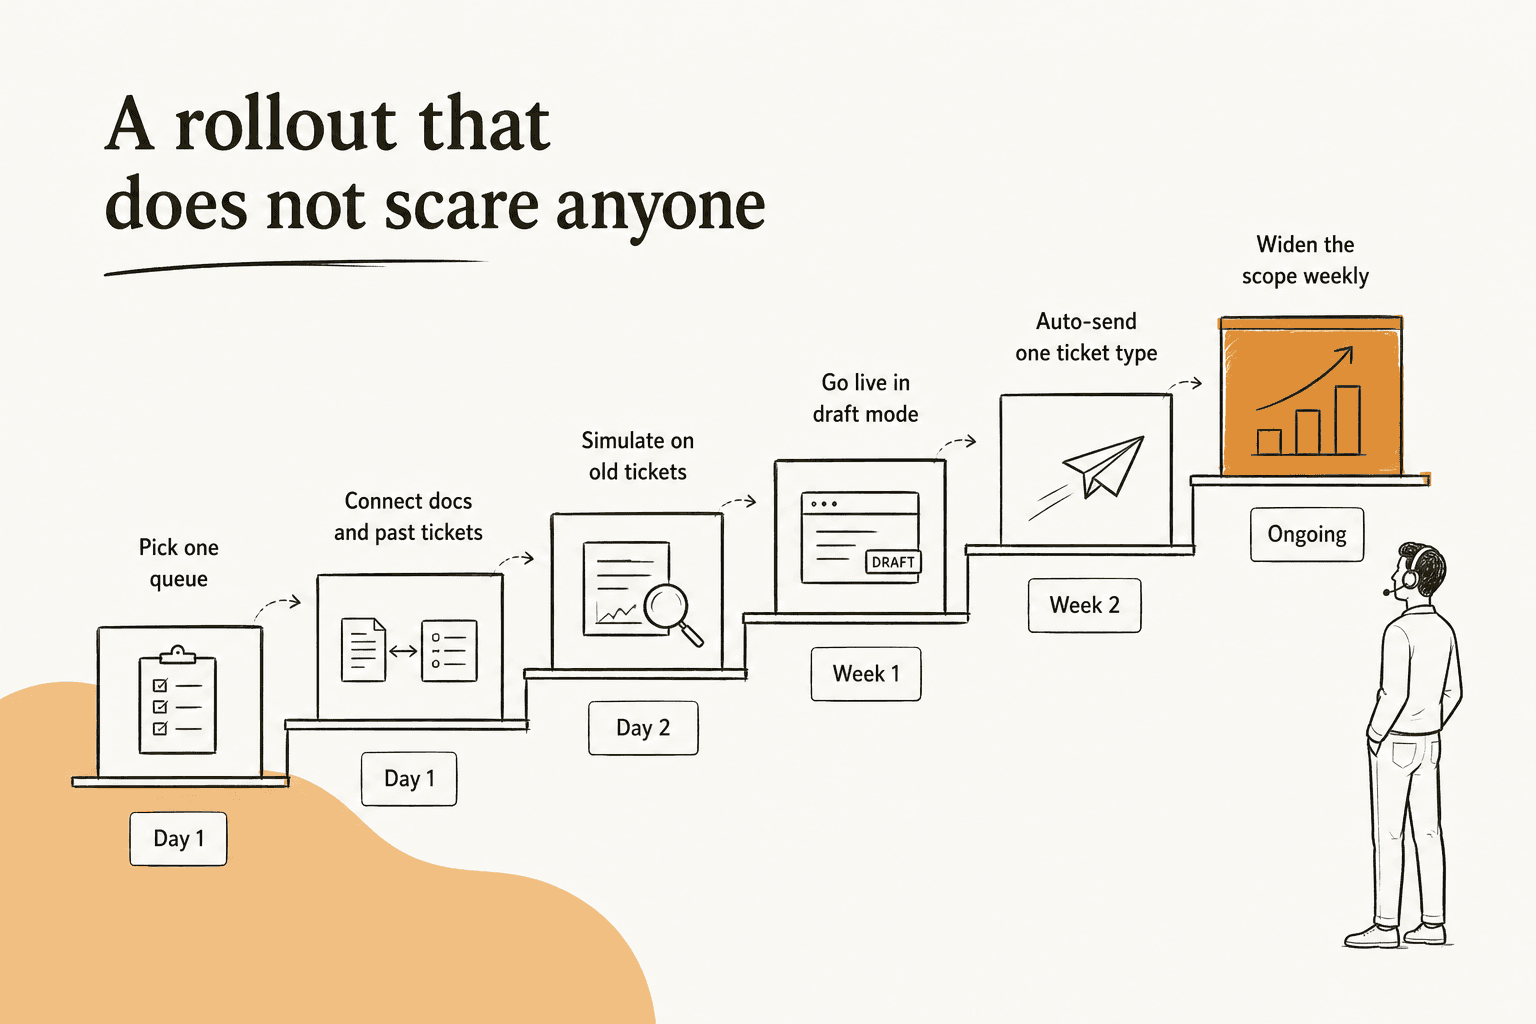
Connecter un helpdesk et obtenir une première réponse prend environ une demi-heure. Atteindre un déploiement auquel votre équipe fait confiance prend deux à quatre semaines, et la partie lente n'est jamais le logiciel.
Jour 1 : choisissez une file, pas le helpdesk. Un canal, un type de ticket, une langue. L'échec que je vois le plus est que les équipes pointent l'IA sur tout le jour un, obtiennent des résultats médiocres partout, et concluent que la catégorie ne fonctionne pas.
Jour 1 : connectez les connaissances, y compris les tickets passés. Documents, centre d'aide, macros, et votre historique de tickets résolus. Ce dernier point est ce que les acheteurs demandent avant tout le reste, et la note d'Amogh là-dessus est directe : "past ticket training strikes again. Classic. People really, really, really want to train on past tickets." C'est aussi d'où vient un ton réaliste, parce que votre centre d'aide est écrit avec une voix de politique et vos tickets avec une voix humaine. Vous n'avez pas non plus besoin d'une base de connaissances parfaite pour démarrer. Une équipe britannique sur Zendesk a obtenu 56 tâches résolues à partir de neuf macros synchronisées, et l'utilisait encore 38 jours après l'expiration de son essai.
Jour 2 : simulez contre des tickets déjà répondus. C'est l'étape que presque aucune page de fournisseur ne décrit, et celle que je refuserais de sauter. Rejouez un lot de tickets passés, laissez l'agent rédiger ce qu'il aurait dit, et notez ces brouillons par rapport à ce que votre équipe a réellement envoyé. La simulation d'eesel s'exécute en mode bac à sable et rapporte la couverture par thème, donc vous obtenez "politique de remboursement 28 %, erreurs de connexion SSO 35 %" plutôt qu'un seul chiffre de précision sans signification. Ensuite, vous comblez la lacune précise et relancez.
Fixez un seuil de réussite avant de regarder les résultats, sinon vous rationaliserez ce que vous obtenez. Le mien est : sur un échantillon d'au moins 100 vrais tickets, des erreurs factuelles sous les 5 % sur les intentions que vous avez délimitées, et aucune erreur dans les catégories que vous avez clôturées.
Semaine 1 : passez en direct en mode brouillon. De vrais tickets, de vrais clients, et chaque réponse sort encore via une personne. Vous mesurez l'écart entre ce que l'IA a rédigé et ce que votre agent a envoyé, et cet écart est le diagnostic le plus utile que vous obtiendrez jamais. Cela signifie aussi que votre pire résultat possible en semaine une est un brouillon gaspillé.
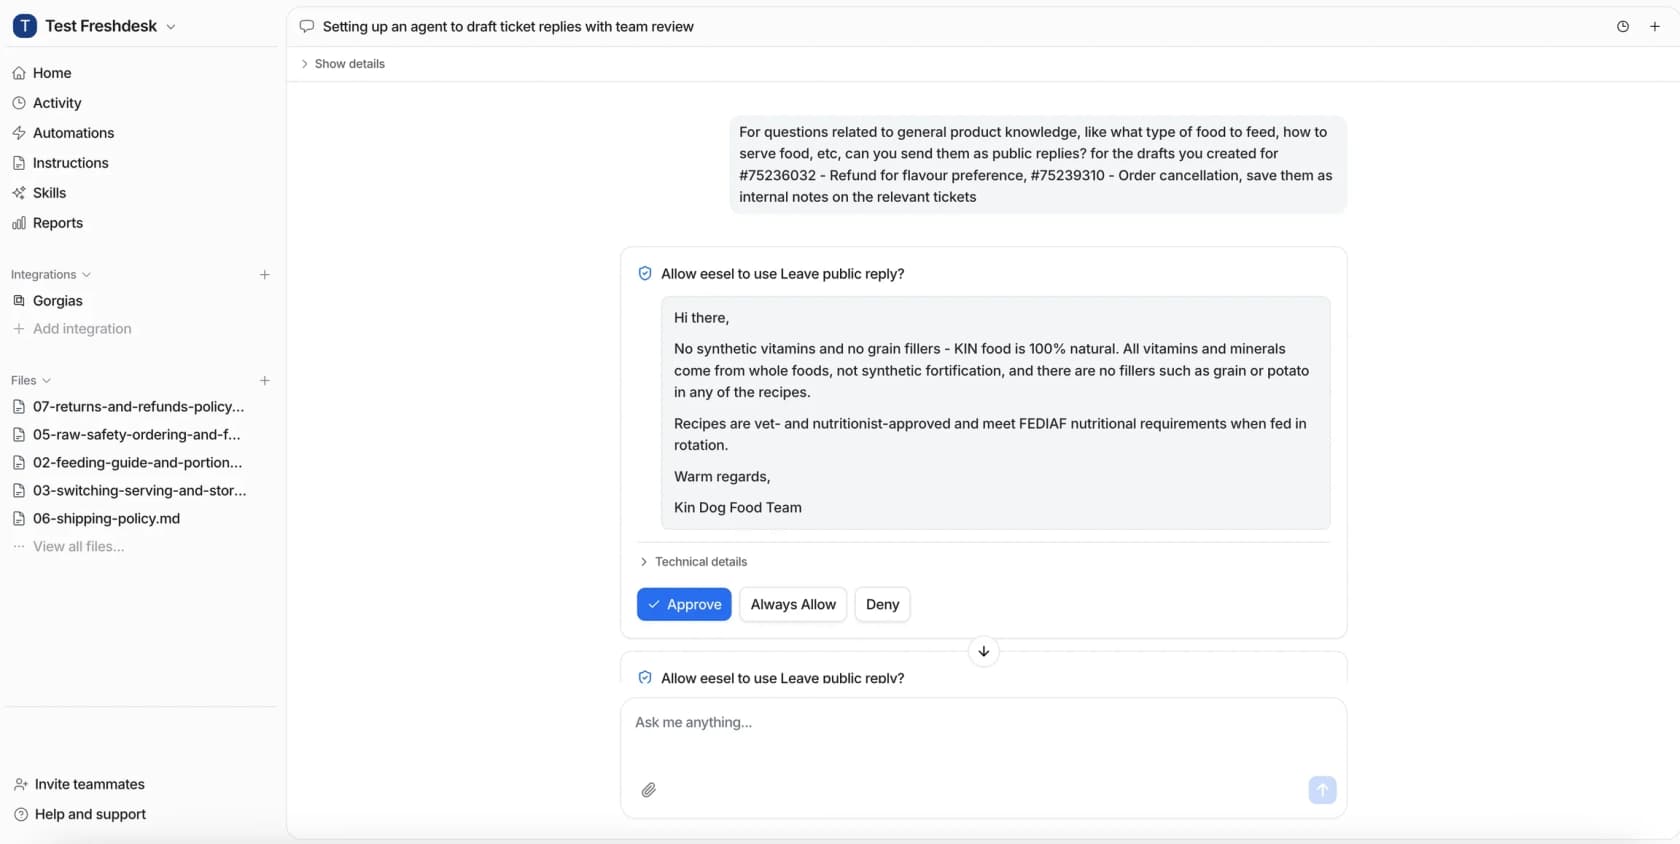
Semaine 2 : envoyez automatiquement exactement un type de ticket. Le plus étroit, le plus documenté, le plus réversible que vous ayez. Le statut de commande est le choix habituel. Surveillez-le pendant une semaine, avec une personne qui lit chaque conversation.
Semaine 3 et après : élargissez par périmètre, jamais par pourcentage. Ajoutez une intention à la fois, et gardez les chiffres de déviation des tickets à côté des chiffres de contact répété. Tout ce qui touche à l'argent ou à l'état du compte reste derrière une approbation bien plus longtemps que ce qui semble nécessaire.
Si vous voulez la même séquence de quelqu'un qui ne vous vend rien, voici qui se rapproche de la version que j'écrirais :
"The safest rollout I have seen is: let the agent draft, tag confidence plus reason, require approval for refunds or account changes, and review every reopened conversation for the first month. That review log is usually where the real automation boundary shows up."
La revue des conversations réouvertes est le détail que je lui emprunterais. Votre document de périmètre dit ce que l'IA devrait traiter. Le journal de réouvertures vous dit ce qu'elle peut vraiment traiter.
Deux choses qui vont vraiment faire exploser votre calendrier, et aucune ne figure sur la feuille de route d'un fournisseur. La première est le nettoyage de la base de connaissances, qui représente de vraies heures de vrai travail humain. La deuxième est les identifiants d'intégration, parce que la personne avec les droits admin sur votre helpdesk est en vacances. Budgétez pour les deux.
Et il y a un mode d'échec au-delà de tout cela que nous voyons plus souvent que tout problème technique, et qui n'a rien à voir avec la qualité des réponses. Certains essais sont entièrement configurés, l'intégration se connecte, les documents se synchronisent, et puis personne ne câble de déclencheur, donc aucune tâche ne se déclenche jamais. D'autres font tout correctement et bloquent quand même : nous avons observé une cohorte où neuf essais activés sur dix avaient des conversations fonctionnelles notées à 96 % de qualité, et exactement un seul a converti. Dans aucun des cas l'IA n'était le problème. La configuration n'est pas le déploiement, et le déploiement n'est pas l'adoption. Quelqu'un doit l'allumer et en être propriétaire.
Notre guide d'implémentation complet a la version plus longue de cette séquence, et implémenter le support avec l'IA couvre le côté gestion du changement que j'ai laissé de côté ici.
L'arithmétique mois par mois, avec vos chiffres
La plupart des modèles de coût sautent directement à un taux de déviation mature, c'est pourquoi le premier mois ressemble à une déception. Mettez votre propre volume, et la forme de la montée devient évidente.
L'unité facturée est l'autre moitié de cela, et c'est le mot indéfini le plus coûteux de la catégorie. Les coûts par siège pour les personnes. Les coûts par résolution seulement quand quelque chose se conclut. Les coûts par ticket pour chaque conversation que l'IA touche. Cela produit des factures radicalement différentes à volume identique, donc la question à poser à un fournisseur n'est pas "combien", mais quel événement incrémente le compteur. La réponse d'eesel, sur sa page tarifaire, est 1 crédit par ticket ou chat traité (plans à partir de 299 $/mois pour 500 crédits), quel que soit le nombre de messages échangés, ce qui est délibérément l'unité dans laquelle les équipes de support pensent déjà. Notre analyse du coût par résolution fait bien la comparaison, et le coût du support avec l'IA met les modèles côte à côte.
Ce qu'il faut mesurer, et les trois mots que les fournisseurs confondent

Trois indicateurs sont utilisés de manière interchangeable sur presque chaque page de fournisseur, et ils mesurent des choses différentes. La raison pour laquelle cela compte n'est pas de la pédanterie, c'est que l'un d'eux peut avoir l'air formidable pendant que vos clients vivent pire. Le responsable support de PostHog a mieux formulé le décalage que je ne pourrais le faire :
"Most companies don't realize the frustration they're creating. They look at the numbers, see fewer tickets coming in, and read it as a good sign: customers must be doing fine. Companies call it "deflection." Customers call it being ignored."
Il vaut la peine de noter que PostHog vend de l'analytique produit, pas de l'IA de support, et que ce post argumente contre le fait de mettre de l'IA devant une file de support, point. Je ne suis pas entièrement d'accord, mais la distinction qu'ils tracent entre l'IA comme outil et l'IA comme porte est la bonne, et un chiffre de déviation ne peut pas vous dire lequel des deux vous avez construit.
| Indicateur | Numérateur | Dénominateur | Ce qu'il cache |
|---|---|---|---|
| Taux de déviation | Contacts qui n'ont jamais atteint une personne | Tous les contacts | Si le problème a été résolu |
| Taux de résolution | Problèmes réellement résolus sans une personne | Conversations dans lesquelles l'IA s'est engagée | Rien, si vous mesurez aussi le contact répété |
| Taux de contention | Conversations restées dans le canal | Conversations qui y sont entrées | Si le client a abandonné |
Tout pourcentage de cette famille ne veut rien dire sans son dénominateur, et les fournisseurs citent le cadrage qui donne le plus gros chiffre. La question qui le récupère chaque fois : pourcentage de quoi, sur combien, sur quelle période ?
Ce que je surveillerais vraiment chaque semaine :
- Le taux de résolution couplé au taux de contact répété. Aucun des deux seul ne vous dit rien. Ensemble, ils vous disent tout. Notre guide pour améliorer le taux de résolution est la suite une fois que les chiffres sont honnêtes.
- Le taux d'escalade et les raisons derrière lui. Une escalade saine n'est pas un échec. Une escalade qui s'est déclenchée parce que le retrieval n'a rien trouvé est un ticket pour la base de connaissances, pas un problème d'IA.
- Le taux de lacune de connaissances : les questions que l'agent a marquées comme sans réponse. C'est le chiffre le plus actionnable de tout l'ensemble, parce que c'est une liste de tâches à faire.
- Le CSAT découpé en trois : sur les conversations résolues par l'IA, sur les escaladées, et mélangé. Ce sont trois chiffres différents, et le chiffre mélangé est le moins utile.
- Le coût par ticket, y compris vos propres heures. Le prix du logiciel est la partie facile. Mesurer correctement le ROI du support avec l'IA signifie compter aussi le nettoyage de la base de connaissances et le temps de revue.
Pour la liste plus complète, notre article sur les indicateurs de support va plus loin que je ne peux ici. Si vous voulez le côté qualité de l'escalade spécifiquement, le taux de contention est la prochaine lecture.
Un vrai flux de travail, du début à la fin
Voici le test auquel je renvoie sans cesse les gens, parce que le résultat n'était pas celui que quiconque attendait.
Un bijoutier en ligne allemand, environ 1 000 tickets par mois sur Zendesk avec Shopify derrière, n'a pas juste allumé quelque chose et espéré. Ils ont fait tourner l'agent pour de vrai sur leur boîte de réception en direct : 284 chats plus une validation croisée de 100 tickets, de sorte que chaque chiffre venait de tickets que leur propre équipe avait déjà traités.
La boîte de réception se divisait à peu près en 38 % de support direct aux consommateurs, 22 % de spam, et 21 % de B2B interne. Le triage est arrivé à 93 % de précision, et la détection de spam à 100 % sans faux positifs, ce qui, sur une boîte de réception où presque un quart du volume est du courrier indésirable, est une vraie victoire du premier jour avant même qu'une seule réponse côté client n'existe.
La qualité des brouillons était la plus forte exactement là où vit une politique bien documentée : 96,4 % de brouillons utiles sur les réclamations de garantie, 93,8 % sur les retours et remboursements, 100 % sur les demandes produit et le statut de remboursement.
Et puis le chiffre qui a fait que tout le monde s'est arrêté. Seuls 12 % de ces brouillons ont été envoyés tels quels.
Le réflexe est de lire cela comme un problème de précision. Ça ne l'était pas. Quand nous avons décomposé les raisons pour lesquelles les agents réécrivaient les brouillons, environ 65 % des modifications étaient de la pure longueur et du ton, parce que les agents compressaient des brouillons de 8 à 15 phrases en réponses de 1 à 3 phrases. Environ 20 % avaient besoin de données auxquelles l'IA n'était pas connectée, des systèmes ERP et logistiques. Seulement environ 5 % des modifications ont été faites parce que l'IA avait les faits faux. Évaluée séparément contre l'échantillon entier plutôt que contre les modifications, le taux d'erreur factuelle est sorti à 7 %.
Cette distinction est la chose la plus utile que j'aie apprise en exécutant ces déploiements. "L'IA a tort" et "l'IA ne nous ressemble pas" sont des problèmes différents avec des solutions différentes, et seul l'un des deux se résout par une meilleure connaissance. La recommandation issue de ce test était concrète : entraîner sur 200 réponses récentes d'agents, et l'adoption telle quelle devrait passer de 12 % à 30-40 %.

Pour comparaison, deux chiffres publiés à l'autre bout de la montée. Gridwise a résolu 73 % des demandes de niveau 1 le premier mois après un essai de sept jours, ce qu'eesel publie sur sa page produit. Global Pay a rapporté jusqu'à 80 % de temps économisé pour trouver des réponses dans sa documentation. Les deux sont réels, les deux sont publiés, et aucun n'est ce à quoi ressemblera votre premier mois. Le test du bijoutier, lui, l'est.
Essayez eesel pour le support client avec l'IA
Si quoi que ce soit de ce qui précède ressemble à votre file, c'est la forme du problème pour lequel eesel a été construit. Il se connecte au helpdesk que vous exploitez déjà au lieu de le remplacer, sur Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot et Jira Service Management. Il lit vos documents et vos tickets résolus, et il démarre en mode brouillon, de sorte que rien n'atteint un client sans qu'une personne ne l'ait vu d'abord.
La partie vers laquelle je vous pousserais vraiment est la simulation. Avant de décider si quoi que ce soit de tout cela fonctionne pour votre équipe, faites tourner l'agent sur vos propres tickets passés et lisez ce qu'il aurait dit à côté de ce que votre équipe a réellement envoyé. Cette comparaison répond à la question qu'une démo ne peut pas répondre. Une fois que vous passez en direct, c'est un prix mensuel fixe (à partir de 299 $/mois pour 500 crédits) sans frais de plateforme ni coût par siège, et les 100 premiers crédits sont gratuits, ce qui représente plus de simulation que la plupart des équipes n'en ont besoin pour trancher.

Essayez eesel, ou si vous préférez le voir sur vos propres tickets avec quelqu'un qui vous guide, la page de l'agent helpdesk avec l'IA est l'endroit par où commencer.
Questions fréquentes
Qu'est-ce que le support client avec l'IA ?
Le support client avec l'IA est un logiciel qui lit un message entrant d'un client, trouve la réponse dans votre propre documentation et votre historique de tickets, puis répond ou transmet la conversation à une personne. La distinction utile est celle entre un chatbot basé sur des règles scripté, qui suit un arbre de décision, et un agent de support IA, qui raisonne sur votre contenu et peut agir dans votre helpdesk.
Que ne devrait jamais traiter le support client avec l'IA ?
Tout ce dont une erreur coûte cher ou est difficile à annuler : les exceptions de politique, les litiges de facturation, les conseils juridiques, médicaux et financiers, et tout ticket d'un client déjà contrarié. Une bonne règle est le test de l'irréversibilité. Si l'action ne peut pas être annulée en un clic, une personne l'approuve. Nos notes sur les garde-fous expliquent comment ces limites sont codées. Pour ce qui se passe quand elles manquent, lisez prévenir les hallucinations.
Combien coûte le support client avec l'IA ?
Cela dépend entièrement de l'unité facturée, le chiffre qui décide de votre facture. Les prix par siège facturent pour les agents, les prix par résolution facturent seulement quand l'IA conclut quelque chose, et les prix par ticket facturent pour chaque conversation que l'IA touche. La page tarifaire d'eesel fixe un prix mensuel unique par crédits (à partir de 299 $/mois pour 500 crédits, 1 crédit par ticket ou chat), sans frais de plateforme ni coût par siège. Notre analyse du coût par résolution détaille le calcul.
Combien de temps faut-il pour déployer le support client avec l'IA ?
Connecter un helpdesk et obtenir qu'un premier agent réponde prend environ 30 minutes. Atteindre un déploiement auquel vous faites confiance prend deux à quatre semaines, et ce qui prend le plus de temps est presque toujours la base de connaissances, pas le logiciel. Notre guide d'implémentation couvre la séquence, et le contenu obsolète du centre d'aide couvre l'audit que vous faites d'abord.
Le support client avec l'IA peut-il fonctionner avec mon helpdesk existant ?
Oui, et l'ajouter par-dessus est généralement le choix le plus sûr plutôt que de remplacer le helpdesk. eesel se connecte à Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot et Jira Service Management, donc votre file, vos macros et vos rapports restent où ils sont. La liste complète se trouve sur la page des intégrations. Pour voir à quoi cela ressemble en pratique sur une pile donnée, consultez l'IA pour Zendesk.
Le support avec l'IA va-t-il remplacer les agents de support ?
Sur des files réelles, ce qui arrive en pratique, c'est que le niveau répétitif disparaît et que le travail humain devient plus difficile et plus précieux. Les tickets qui atteignent une personne sont les ambigus. Notre comparaison du coût d'un agent IA par rapport à un agent humain et nos notes sur la déviation de niveau 1 couvrent toutes deux où se situe la limite.
Comment mesurer si le support client avec l'IA fonctionne ?
Observez trois chiffres ensemble, jamais un seul : le taux de déviation couplé au taux de résolution et au taux de contact répété. Un taux de déviation qui monte en même temps qu'un taux de contact répété qui monte signifie que les tickets sont fermés, pas résolus. Notre guide des indicateurs de support liste le reste des valeurs qu'il vaut la peine de suivre chaque semaine.