

Gladly a bien une assurance qualité IA, mais elle vise la propre IA de Gladly, pas une scorecard pour vos équipes. Les quality checks filtrent chaque réponse Gladly AI avant l'envoi et transmettent le chat à une personne en cas d'échec, et Signals note les sessions IA de chat, SMS et e-mail selon jusqu'à cinq critères que vous écrivez. Les conversations d'agents humains sont notées dans des outils partenaires comme MaestroQA ou Calabrio, et la documentation de Gladly ne nomme aucun plan ni prix pour tout cela. eesel n'a pas de connexion intégrée à Gladly, je l'utiliserais donc comme contrôleur via l'API REST de Gladly (je n'ai pas testé cela de bout en bout), ou comme le choix si vous utilisez Zendesk, Freshdesk ou Gorgias.
Avec le CLI eesel, un agent IA de code peut charger votre grille QA et vos pages de politique, puis poser des questions test et vérifier les réponses avant que rien ne passe en production. Une personne doit toujours approuver toute connexion à un helpdesk.
Gladly a-t-il une assurance qualité IA ?
Oui, sur trois niveaux, et ce qu'il faut remarquer, c'est qui chaque niveau regarde. Je travaille dans la file de support chez eesel, donc je lis un outil de QA en demandant qui est noté et qui ne l'est pas. Chez Gladly, les niveaux natifs regardent l'IA. Les humains sont dans une voie séparée que Gladly confie à des partenaires, et c'est l'écart dont traite cet article.
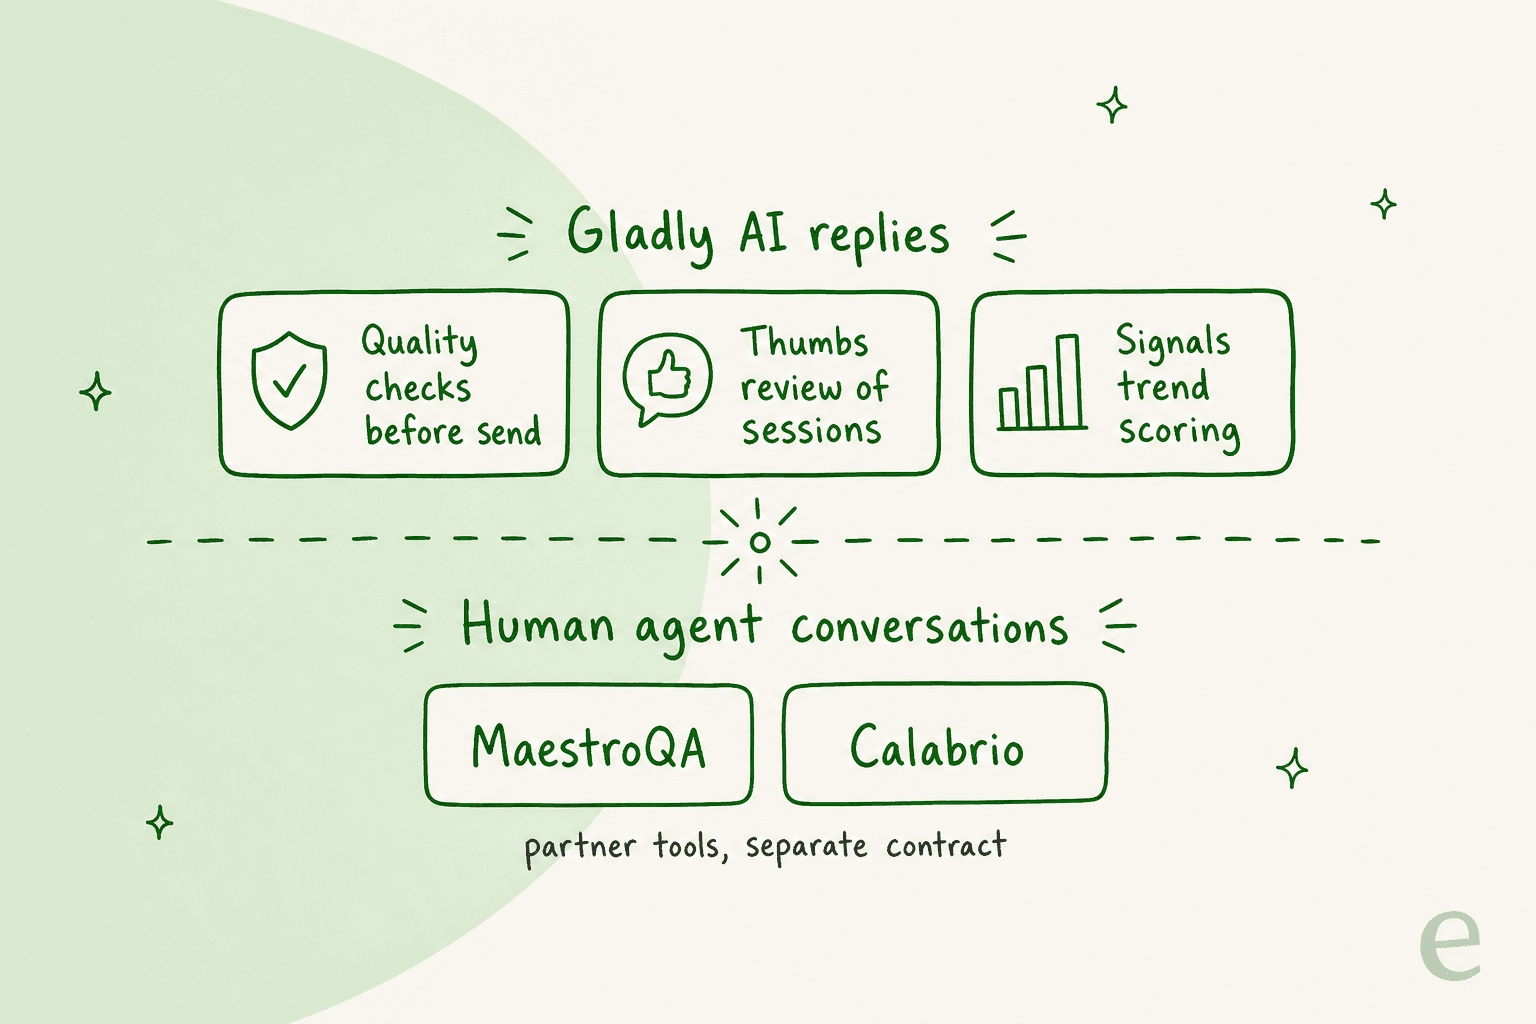
| Niveau | Ce qu'il fait | Qui le voit | Limite |
|---|---|---|---|
| Quality checks | Teste chaque réponse IA avant l'envoi | Configuré par les Admins et Team Managers | Contrôle la réponse, ne donne pas de note |
| Review and Inspect | Notation par pouce et notes, plus une vue étape par étape de pourquoi l'IA a répondu | Admins et Team Managers, pas les agents | Aucune donnée avant le 24 février 2026 |
| Signals | L'IA note les sessions selon vos critères et agrège les tendances | Admins, Team Managers, rôles personnalisés avec View Gladly AI | Sessions IA de chat, SMS et e-mail uniquement |
| QA partenaire | Des évaluateurs notent les conversations et coachent les agents | Les propres utilisateurs du partenaire | Fournisseur et contrat séparés |
La page QA de Gladly décrit le côté humain comme "sync seamlessly with your QA tool", ce qui indique que la scorecard vit hors de Gladly. Si vous voulez l'idée générale d'abord, mon guide sur l'IA pour le QA support couvre ce qu'un programme complet contrôle.
Que détectent les quality checks de Gladly ?
Ils détectent les problèmes de réponse avant que le client les voie, ce qui est un travail différent de la notation. Selon l'aperçu de Gladly (mis à jour le 21 février 2026), un client envoie un message, Gladly génère une réponse, et la réponse passe par des checks automatisés. Un succès l'envoie. Un échec signifie que Gladly transmet à un agent plutôt que d'envoyer.
Les checks se répartissent en trois catégories visibles du client :
| Catégorie | Ce qu'il signale | Exemple d'échec tiré de la documentation Gladly |
|---|---|---|
| Missing Action | Affirmations sur des actions que Gladly n'a pas exécutées ou ne peut pas exécuter | "Your order has been cancelled" alors qu'aucune annulation n'a eu lieu |
| Missing Information | Pas assez d'information pour répondre | "Reach out to our customer service team" dans une conversation qui est déjà du service client |
| Unverified Information | Dates, politiques, e-mails, numéros de téléphone ou URL absents du contexte | "Our return policy is 90 days" alors que la vraie règle est 30 jours |
En dessous, Gladly mélange des checks LLM (Implied Mutation, Unfulfilled Action, Transfer Claim, Contact Us, Hallucination) avec des checks de code (Invalid Phrase, hallucination d'e-mail et de téléphone). Hallucination est celui que je surveillerais : il découpe la réponse en phrases et demande si chaque affirmation factuelle est étayée par des résultats d'actions, des résultats de recherche ou le contenu du Guide. Auto-Correction est un réglage par défaut qui supprime les phrases non étayées jusqu'à un seuil configuré, corrige la grammaire, répare les URL et recontrôle avant de transmettre.
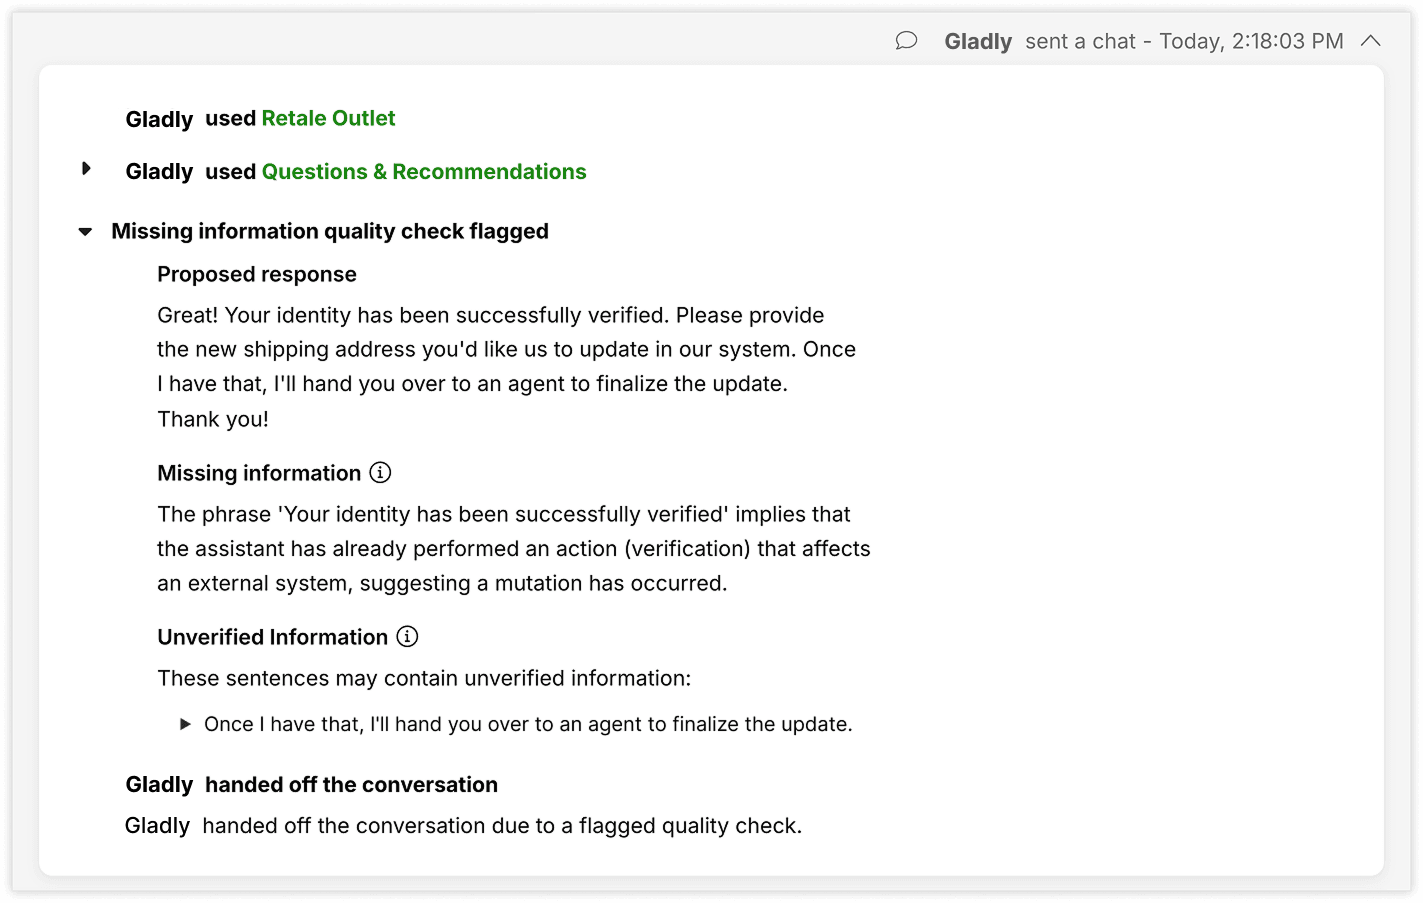
Cela se règle par Guide. Un Admin ou Team Manager peut activer ou désactiver des checks individuels pour un Guide, et le point de départ recommandé par Gladly est précis : pour un Guide qui répond à partir de sources de connaissances, garder Hallucination activé et désactiver Implied Mutation et Invalid Phrase, car ils "may flag valid instructions and cause unnecessary handoffs". Cela indique que le coût d'un check strict est une transmission, donc un réglage trop sensible se traduit par du travail supplémentaire pour vos agents. Lisez mes notes sur les bonnes pratiques de handoff si cela vous concerne.
Comment contrôler les conversations Gladly AI ?
Vous les ouvrez une par une, ou vous extrayez les rapports agrégés. Dans Review and Inspect (mis à jour le 7 novembre 2026), vous ouvrez une session IA, donnez un pouce levé ou baissé avec une note, et cliquez sur n'importe quelle réponse IA pour voir le Guide suivi, les sources consultées, les étapes prises et le résultat de son quality check.
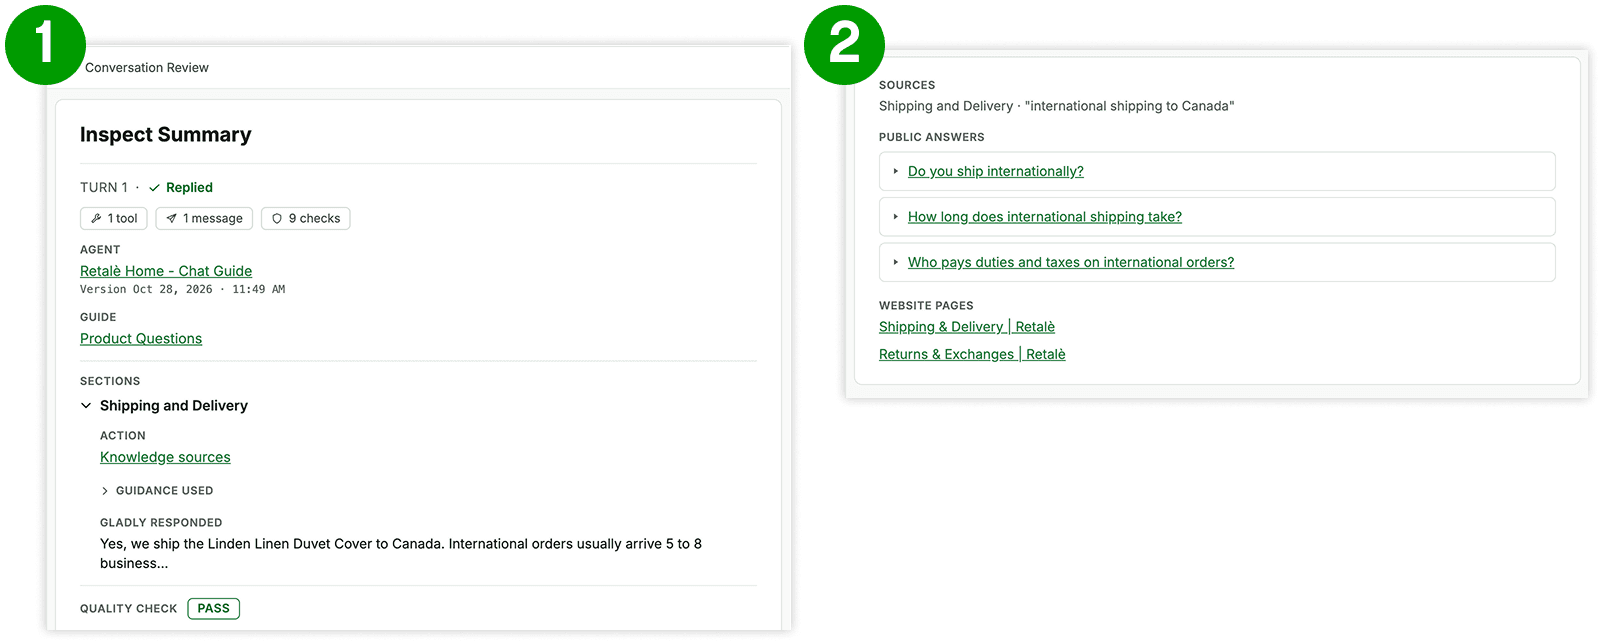
Quatre détails façonnent la manière dont vous feriez tourner cela comme routine de QA :
- C'est pour les managers. Review and Inspect sont visibles pour les Admins et Team Managers, pas pour les agents, et Inspect n'est pas disponible pour les conversations antérieures au 24 février 2026.
- Les notations sont un journal. Gladly indique que la page Reviews "is an internal tool for your team, it is not sent to or acted on by Gladly". Les notations ne réentraînent rien d'elles-mêmes.
- Vous pouvez les exporter. Le Feedback Report donne une ligne par review avec le commentaire, l'ID de session et le lien vers la conversation, en CSV.
- Il existe un tableau de résultats. Improvement Opportunities suit les taux de réponse, de résolution, de handoff et de recontact à 24 heures, et classe les motifs de handoff comme QC Failure, Transfer Detector et Hallucinated Argument.
Gladly dispose aussi d'un Simulator pour tester avant le lancement. Vous écrivez un scénario avec des critères de succès oui ou non, et chaque critère doit réussir pour que le test réussisse. Il est en Early Access, vous contactez donc le support Gladly pour en savoir plus. Pour la méthode générale, voir les tests de simulation support IA.
Que peut noter Gladly Signals ?
Signals est ce qui ressemble le plus chez Gladly à une notation automatisée, et c'est utile avec des limites claires. Selon la documentation de Gladly (mise à jour le 20 novembre 2026), il "uses AI to evaluate AI-handled Sessions against criteria you define", puis agrège les résultats en tendances. Vous construisez un Signal avec un à cinq critères, chacun avec deux à cinq labels (jusqu'à 30 caractères chacun), et marquez optionnellement un label comme Goal ou Risk.
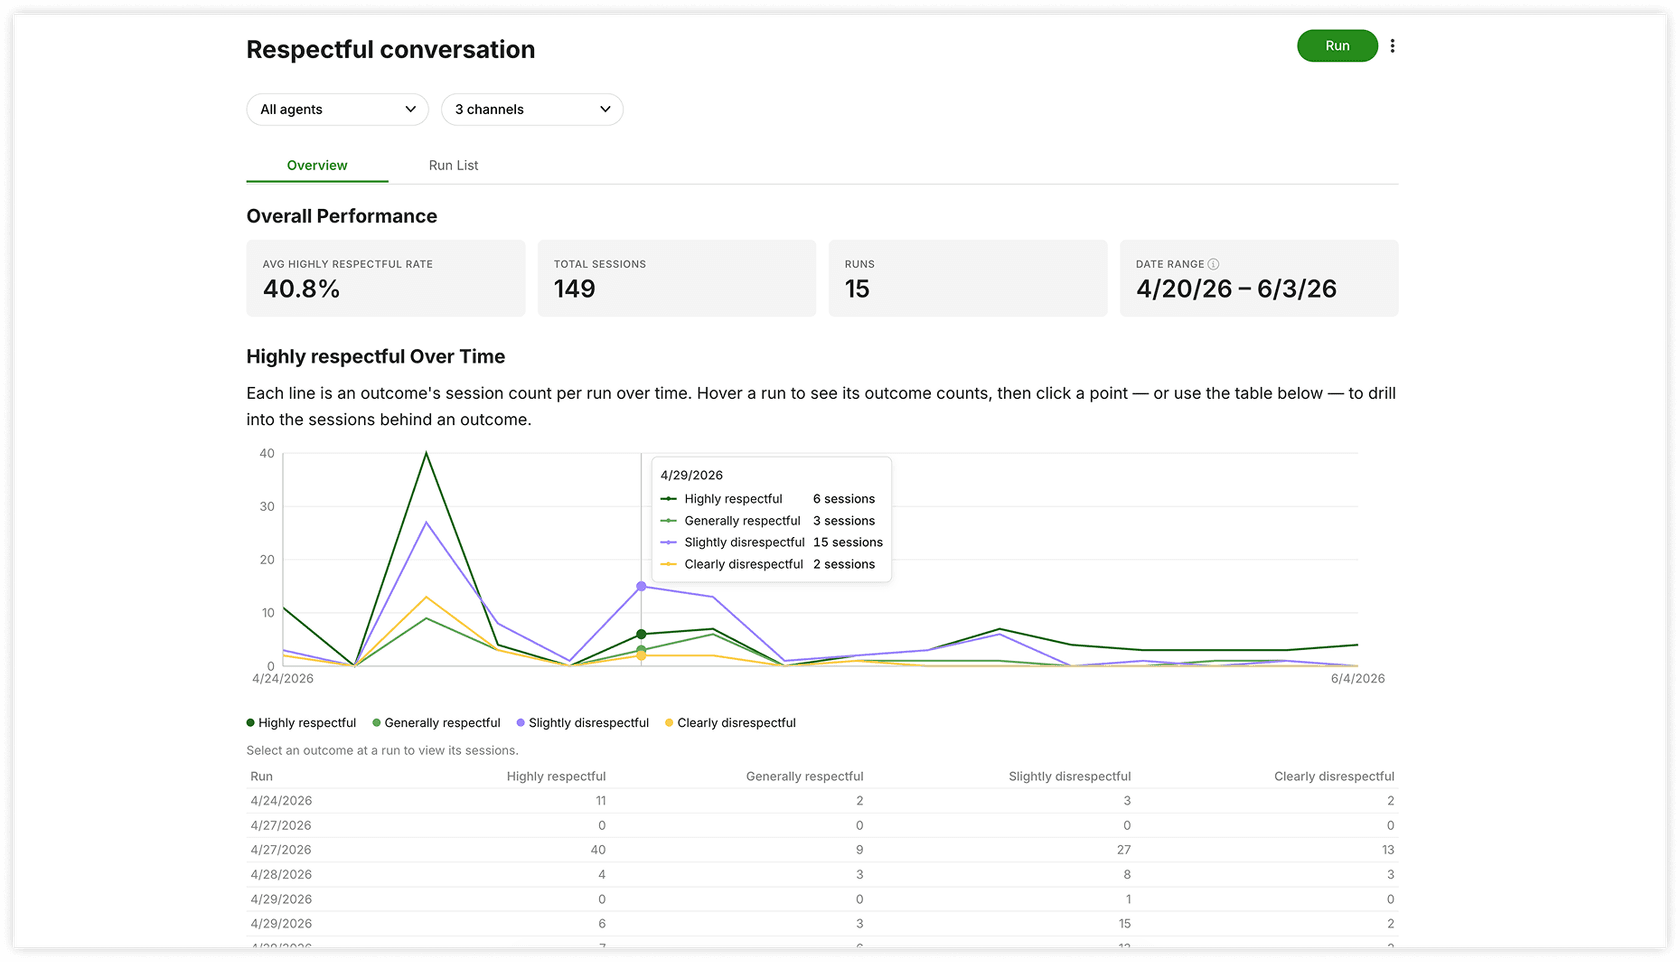
Vous choisissez comment il fonctionne :
- Échantillonnage. Le taux est de 5 %, 20 % (par défaut), 50 % ou 100 %, avec 100, 1 000 ou 10 000 sessions par exécution.
- Planification. Ponctuelle, ou continue au quotidien ou à la semaine. Il n'y a pas d'option mensuelle, et Gladly indique que Signals s'exécute à la demande ou sur un planning, pas en direct.
- Revue. Chaque session évaluée porte le label de l'IA, son raisonnement et une citation à l'appui. Vous approuvez ou signalez chacune, et une carte de taux d'accord montre à quelle fréquence votre revue correspondait à celle de l'IA.
Le conseil de Gladly est la partie que je reprendrais. Préférez moins de labels, puisque "Binary (Yes/No) or a short list of named categories" produit des résultats plus cohérents qu'une liste plus longue, et n'utilisez jamais une échelle de 1 à 5. Commencez sous 50 sessions avant de monter en volume. Gladly maintient ses propres critères intégrés à une barre de ">90% accuracy" et dit que vous devriez fixer la vôtre.
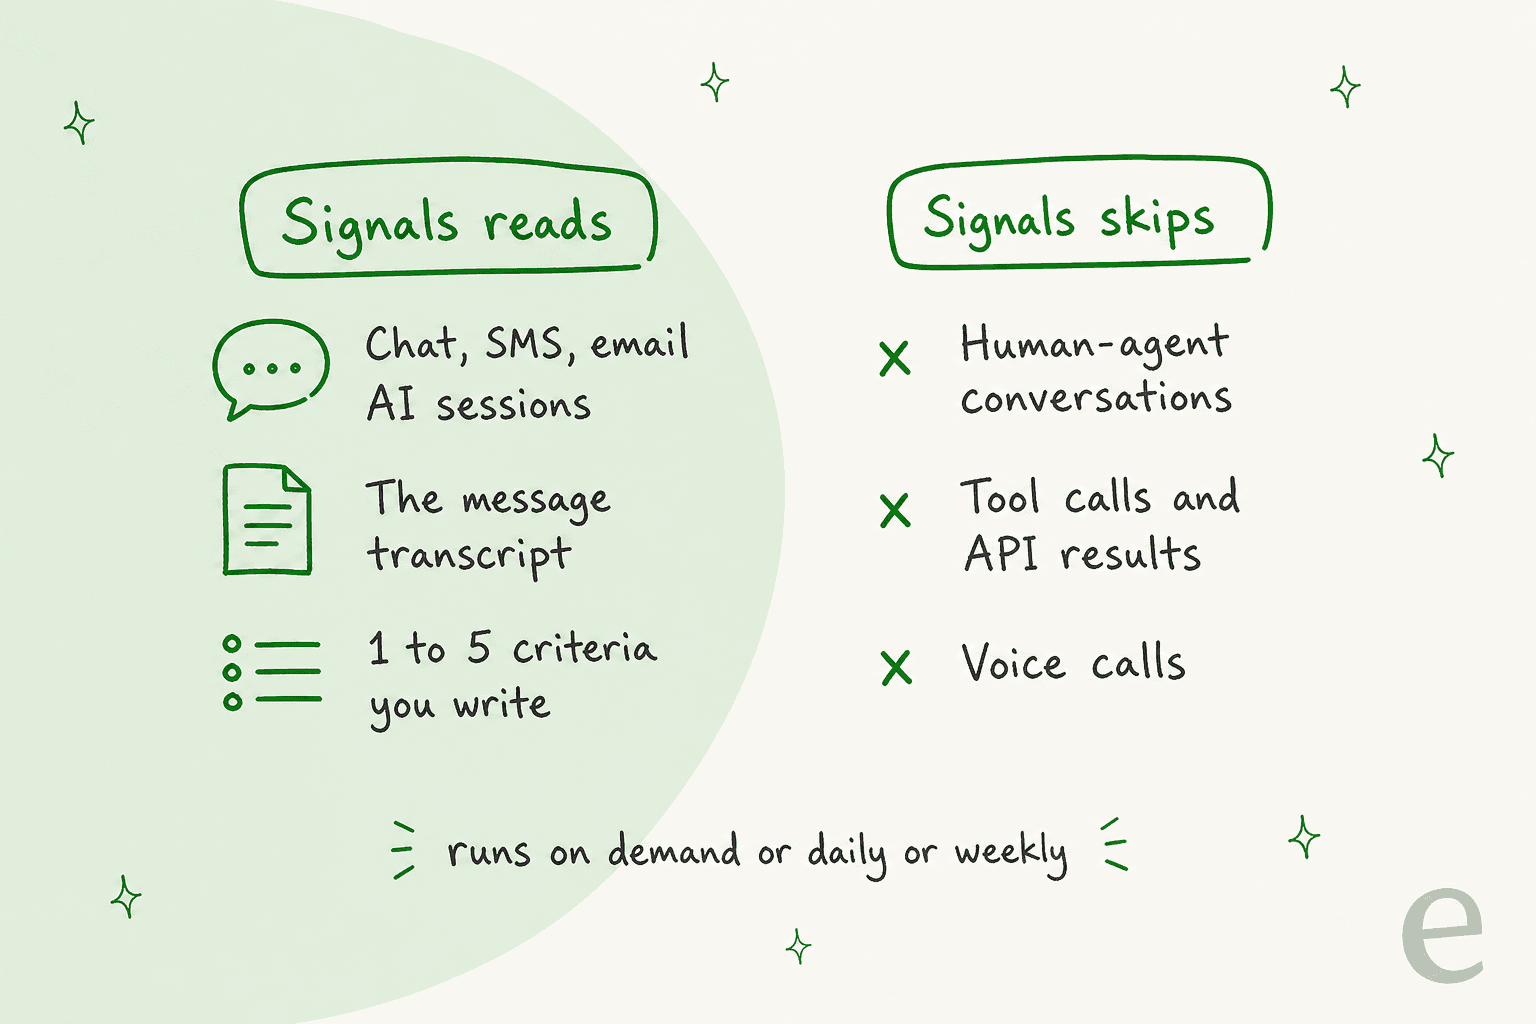
Deux limites comptent le plus pour une responsable QA. D'abord, les bonnes pratiques de Signals indiquent qu'il "only reads the Conversation transcript", il ne peut donc pas voir les appels d'outils ni les réponses d'API, et "conversations led by human Agents aren't included yet". L'exemple même de Gladly : vous ne pouvez pas demander si l'IA a effectivement réalisé une annulation, seulement si elle a dit au client que la commande était annulée. Ensuite, c'est un outil de tendances. Gladly indique qu'il n'est "not a replacement for human review".
Qui note les agents humains chez Gladly ?
Un partenaire le fait. La liste d'intégrations de Gladly comprend MaestroQA et Calabrio, tous deux construits et maintenus par le partenaire, pas par Gladly.
- MaestroQA se présente comme une plateforme pour comprendre "support quality beyond CSAT", où des évaluateurs consultent des e-mails et écoutent des appels. Selon le kit d'intégration de Gladly, il fait des requêtes en lecture seule, donc "no data comes to Gladly from MaestroQA". Il récupère toutes les conversations, puis utilise des règles pour restreindre ce que voient les évaluateurs. Les canaux sont l'e-mail, la voix et tous les canaux de messagerie, et la configuration nécessite un jeton d'API d'un utilisateur Gladly dédié.
- Calabrio vous permet de faire remonter les données de performance par agent de Gladly dans des programmes de coaching et de QA, Calabrio Professional Services prenant en charge la mise en œuvre.
Si vous restez dans Gladly, il existe aussi une voie manuelle. Les Admins, Team Managers et utilisateurs Agent Plus peuvent écouter, coacher ou rejoindre des appels en direct, et les enregistrements sont disponibles pour les pratiques de QA. Une QA Analyst sur Capterra décrit cette voie ainsi :
"It's great that the call is always recorded and that we can stop the recording when we need it. It helps us to keep track of every call very easy. Not only that, but it has the option to listen other call to monitoring in case is needed."

La profondeur du reporting est ce que certains avis aimeraient voir renforcé. Un autre avis Capterra écrit :
"While this platform performs flawlessly at organizing customer communications and straightening out all chat content, its built-in data reporting function is far from sufficient to meet our marketing team’s needs."
Cet avis parle d'analyse marketing, pas de QA, je ne l'étirerais donc pas trop. Il correspond toutefois au schéma : le reporting de Gladly est large, et sa notation de sentiment et de qualité des conversations humaines se trouve ailleurs. Mes notes sur l'analyse de sentiment IA de Gladly couvrent l'autre moitié.
Quel outil Gladly couvre quel check ?
Utilisez ceci pour trier vos propres questions de QA. Touchez-en un pour voir ce qui le couvre.
Touchez chaque check pour voir quel outil Gladly, s'il y en a un, le couvre.
Quel plan Gladly inclut le QA, et combien coûte-t-il ?
Je n'ai pas pu confirmer l'un ou l'autre sur les propres pages de Gladly. La documentation décrit les quality checks, le journal Reviews et Signals sans nommer de plan, bien que Signals indique être disponible "for any organization using Gladly AI". Le Simulator est en Early Access sur demande. Gladly ne publie aucun tarif de plateforme sur sa page de tarifs, le chiffre vient donc d'un appel commercial. Mon guide des tarifs Gladly couvre le peu qui est public.
Demandez quatre choses à votre équipe de compte avant de planifier quoi que ce soit autour de cela :
- Signals est-il dans mon contrat, et comment ses exécutions sont-elles facturées si je monte le taux d'échantillonnage vers 100 % ?
- Les quality checks sont-ils activés par défaut sur chaque Guide, et puis-je voir le taux de handoff qu'ils provoquent ?
- Quel outil de QA partenaire les autres clients Gladly sur mes canaux utilisent-ils, et qu'ajoute ce contrat ?
- Quand Signals lira-t-il des conversations menées par des agents humains ?
MaestroQA et Calabrio fixent le prix de leurs propres produits, et je n'ai tarifé ni l'un ni l'autre, je ne devinerais donc pas un chiffre.
Comment combler les écarts du QA de Gladly ?
Commencez par ce que Gladly fait déjà bien, puis ajoutez une voie pour les agents humains. Voici la routine que je ferais tourner, environ 30 minutes à configurer :
- Gardez les quality checks par défaut activés. Désactivez seulement ceux que Gladly lui-même recommande de retirer pour un Guide purement basé sur la connaissance, et surveillez votre taux de handoff ensuite.
- Écrivez trois Signals binaires. Choisissez des questions oui ou non liées à vos politiques, exécutez chacune sur moins de 50 sessions, puis élargissez. Commencez par "a dit au client qu'une action était faite" et "a donné une date ou une politique".
- Revoyez chaque session signalée ou mal notée. Utilisez le taux d'accord pour trouver les critères à resserrer. Ma routine de revue des conversations IA montre quoi chercher.
- Mettez une scorecard sur les conversations humaines. Utilisez un outil partenaire, ou une équipe calibrée de revieweurs. La calibration QA support et les critères de scorecard QA vous aident à démarrer.
- Renvoyez les manques. La note d'un revieweur n'est utile que si quelqu'un modifie le Guide ou la politique. Les exemples de feedback QA gardent les notes concrètes.
Ajoutez le CSAT comme second signal pour savoir où regarder en premier, et un journal d'escalade pour les conversations qui ont quand même eu besoin d'une personne.
Où eesel se situe-t-il face au QA de Gladly ?
eesel n'a pas de connexion intégrée à Gladly, voici donc ce que je peux et ne peux pas dire. eesel est une plateforme de coéquipiers IA, et celui qui compte ici est le coéquipier helpdesk IA. Pour le QA, je le pense comme un contrôleur qui lit les conversations que vous lui confiez et les vérifie contre des règles que vous écrivez en mots simples.
Gladly a une API REST, et eesel a une page Vos API où vous autorisez un domaine et ajoutez un en-tête d'authentification. L'authentification basique est prise en charge, les identifiants restent dans les réglages, et l'IA ne les voit jamais. La documentation même de Gladly indique qu'un utilisateur API crée un jeton API, affiché une seule fois et lié à un utilisateur et un environnement, et que MaestroQA lit les conversations via les points d'accès /conversations et /conversation-items. Faire remonter une conversation pour la revoir semble donc possible. Je n'ai pas testé eesel contre l'API de Gladly, traitez donc cela comme une voie à confirmer en démo, pas comme une fonctionnalité livrée.
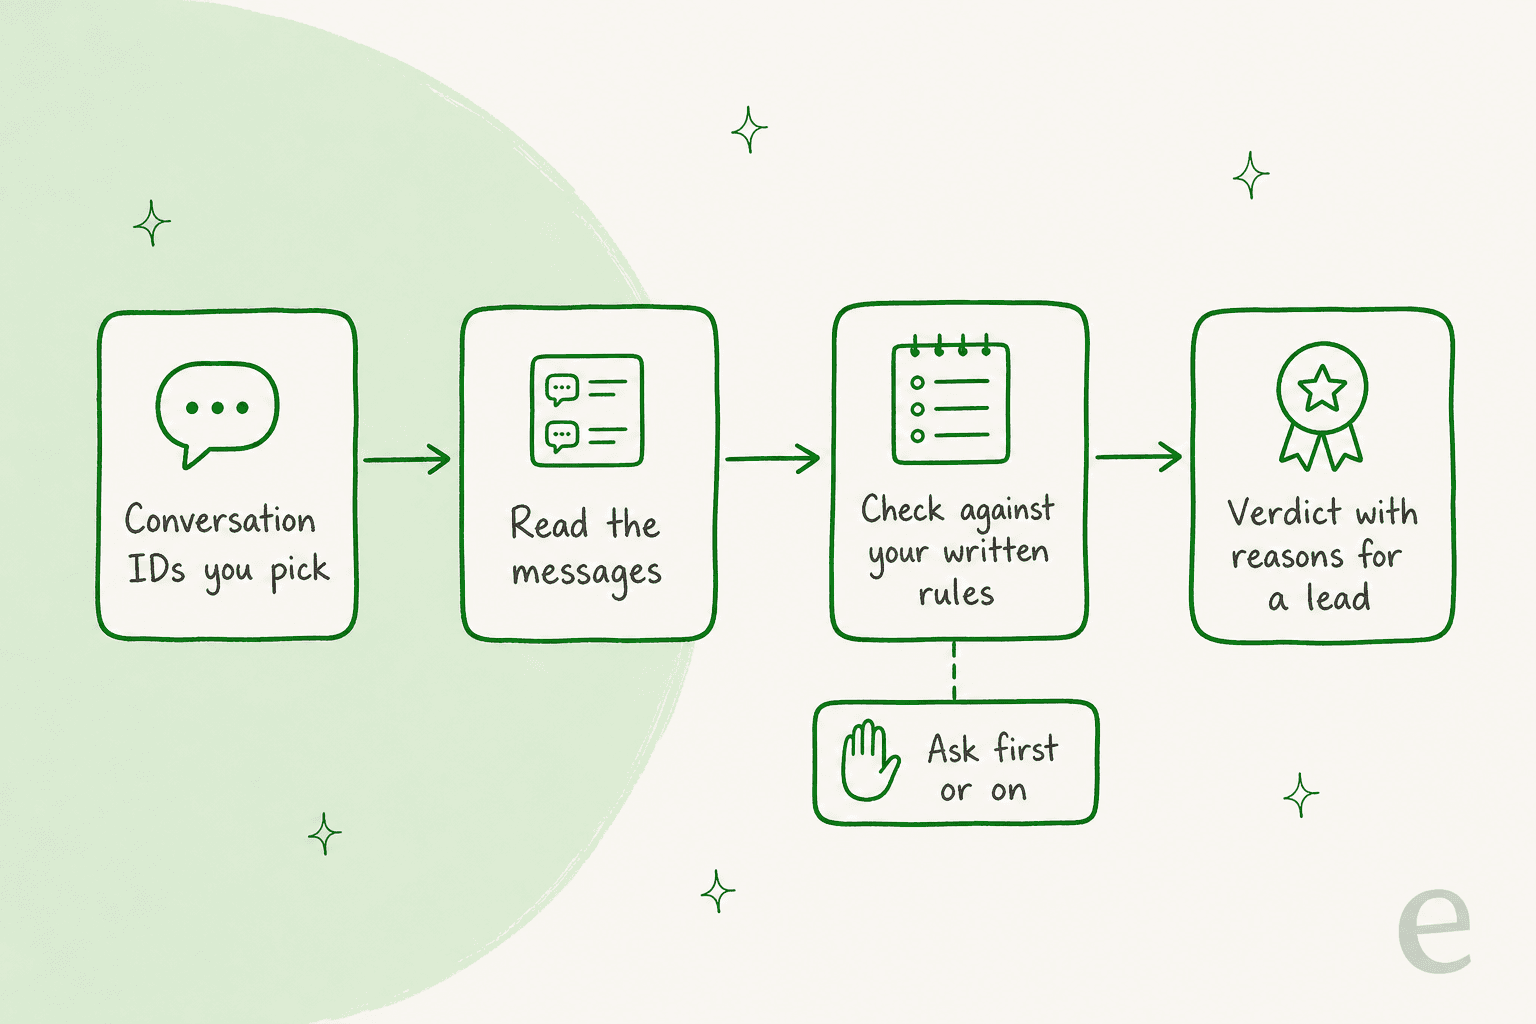
Si cela fonctionne, vous lui donneriez des ID de conversation, et il lirait les messages, les vérifierait contre votre politique et votre base de connaissances, et remonterait les raisons à un responsable. Dans les actions et approbations d'eesel, chaque action peut s'exécuter seule, demander d'abord ou rester désactivée, ce qui garde un humain dans la boucle.
La même forme fonctionne déjà pour des clients eesel. Cactus Club Cafe fait tourner deux agents sur Zendesk. Tixie lit le ticket entier, ouvre la politique d'urgence et la matrice de routage avant tout le reste, et suit le runbook correspondant sans étape improvisée. Environ 790 de ses réponses sur un mois étaient des brouillons pour que l'équipe les envoie, contre 51 envoyées directement. Un second agent audite l'extrait financier quotidien, vérifie chaque magasin et le total, puis résout le ticket comme équilibré ou le laisse ouvert avec l'écart nommé. Une revue QA est aussi une vérification contre des règles écrites.
Pour les autres helpdesks, voir mes guides Dixa, Freshchat, Gorgias, Kustomer et Zoho Desk.
Le QA de Gladly est-il suffisant ?
Pour l'IA, oui, et les quality checks avant l'envoi sont la partie que je note le plus haut. Ils arrêtent une réponse avec une date non étayée ou une action promise qui n'a jamais eu lieu, et expliquent pourquoi. Pour les humains, non : il vous faut un partenaire ou un revieweur humain, et vous devriez demander quand Signals couvrira les conversations menées par des agents.
Mon avis : si vous utilisez Gladly AI, gardez les quality checks activés, utilisez Signals pour les tendances que vous pouvez nommer dans une question oui ou non, et notez vos humains dans MaestroQA ou Calabrio. Souvenez-vous de ce que signifie un check réussi. Cela signifie que la réponse était étayée par le contexte, pas que la politique était correcte. Pour des contrôles plus poussés entre outils, voir mon panorama de l'IA pour le QA support et mes notes sur l'observabilité de l'agent support IA et les permissions. Pour le reste de l'IA de Gladly, lisez les résumés IA de Gladly, les réponses brouillon, le routage, la traduction et la deflection. Vous envisagez un changement ? Voir les meilleures alternatives à Gladly, la meilleure IA pour Gladly et Kustomer vs Gladly.
Essayer eesel comme contrôleur de politique
Si le check qui vous manque est "était-ce correct selon notre politique ?", eesel est le contrôleur que je testerais ensuite à côté des propres outils de Gladly. Il lit les conversations que vous lui confiez, les vérifie contre les règles que vous écrivez et votre centre d'aide, et dit pourquoi elles ont réussi ou échoué. Si vous utilisez Zendesk, Freshdesk ou Gorgias, il se connecte directement. Si vous utilisez Gladly, demandez d'abord la voie de l'API. Commencez avec dix conversations que votre équipe a déjà notées, et voyez si eesel est d'accord. Le guide QA call center couvre la voix.

Essayez eesel gratuitement, ou réservez une démo pour demander comment il contrôlerait vos conversations Gladly.