

Freshchat a bien un contrôle qualité IA : le Post Resolution Quality Coach de Freddy note chaque conversation résolue selon six paramètres fixes, lui attribue le label Good, Neutral ou Bad, et alimente un Quality Score Report, en add-on à Freddy AI Copilot (29 $ par agent et par mois) sur Pro et Enterprise. Ce qu'il note, c'est comment l'agent a écrit et comment le client s'est senti, pas si la réponse correspondait à votre politique, si le chat est allé dans le bon groupe, ou toute règle que vous ajouteriez vous-même. Freshworks ne documente aucun critère personnalisé. Pour ces vérifications, lisez un échantillon hebdomadaire à la main ou laissez un coéquipier IA comme eesel lire les chats que vous lui indiquez selon vos règles écrites et laisser ses raisons dans un commentaire interne. Avec la CLI eesel, un agent de code comme Claude Code peut connecter Freshdesk, vérifier les automatisations et rédiger des instructions de chat en direct ; un admin Freshchat doit tout de même entrer le token API et le webhook.
Freshchat a-t-il un contrôle qualité IA ?
Oui (mon analyse de Freddy AI couvre l'ensemble de l'outil). Freshworks documente deux fonctions Freddy avec "Quality Coach" dans le nom, plus le reporting CSAT que toute équipe a déjà. Voici ce que chacune dit à un responsable QA.
| Fonction Freshchat | Plan | Ce qu'elle dit à un responsable QA | Ce qu'elle ne dit pas |
|---|---|---|---|
| Post Resolution Quality Coach | Pro et Enterprise, en add-on à Freddy AI Copilot | Une note et un label Good, Neutral ou Bad pour chaque conversation résolue, par agent et par groupe | Si la réponse a suivi votre politique |
| Proactive Quality Coach | Pro et Enterprise, en bêta, partie de Copilot | Des corrections suggérées à une réponse avant son envoi | Tout ce qui se passe après l'envoi |
| Chat Conversations Overview, onglets CSAT et Overall | Reporting | Notes, nombre de satisfaits et insatisfaits, tendances, chats rouverts (le CSAT par IA explique comment les lire) | Quelle réponse a mal tourné, ou pourquoi |
Que note Post Resolution Quality Coach ?
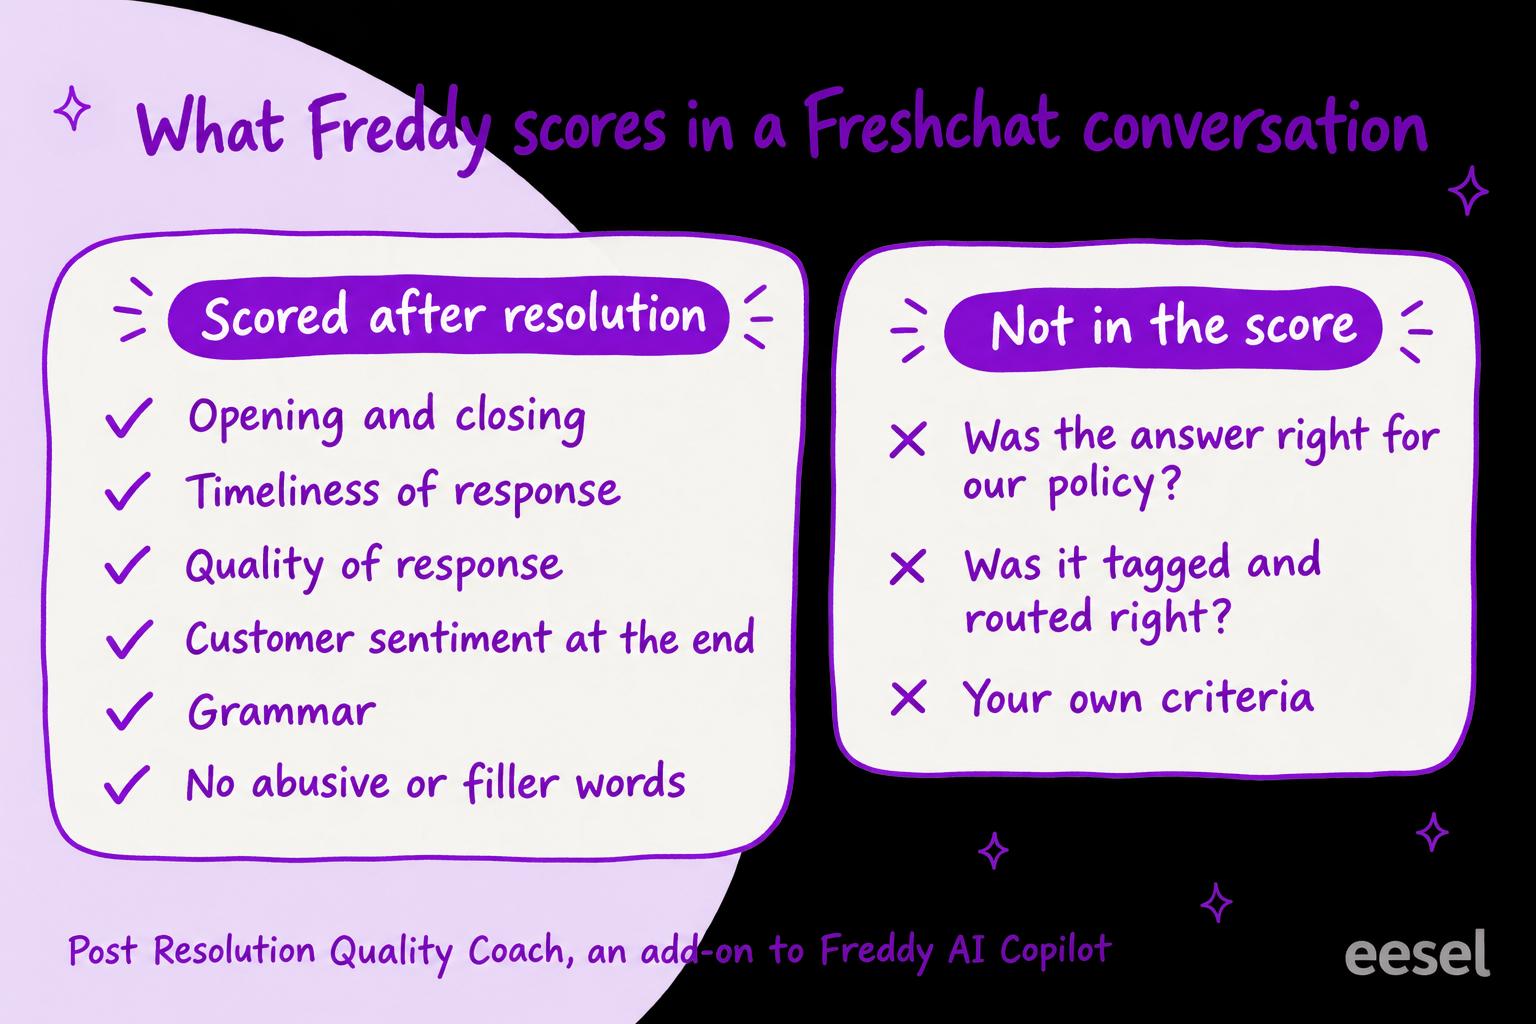
L'article Quality Coach de Freshworks dit que la note "is calculated based on six different parameters" :
- Début et fin de la conversation : "The effectiveness and professionalism demonstrated in initiating and concluding the conversation."
- Rapidité de la réponse : la vitesse de réponse de l'agent.
- Qualité de la réponse : "The level of detail, relevance, and helpfulness of the agent's response to the customer's query or concern."
- Sentiment du client : si le ton reste positif ou neutre jusqu'à la fin.
- Grammaire de la réponse : grammaire, usage de la langue et clarté.
- Absence de mots injurieux ou de remplissage : si le langage de l'agent reste respectueux et professionnel.
Une fois la conversation résolue, l'agent ouvre le troisième volet de la boîte de réception et voit des insights sur le déroulement, des conseils d'amélioration, et un label Good, Bad ou Neutral. Il peut noter la note avec un pouce vers le haut ou le bas, ce qui selon Freshworks permet aux admins d'"assess the effectiveness of the feature for agents". L'article ne décrit aucune étape de relecture : un agent peut mettre un pouce vers le bas sur une note, mais personne ne la remplace.
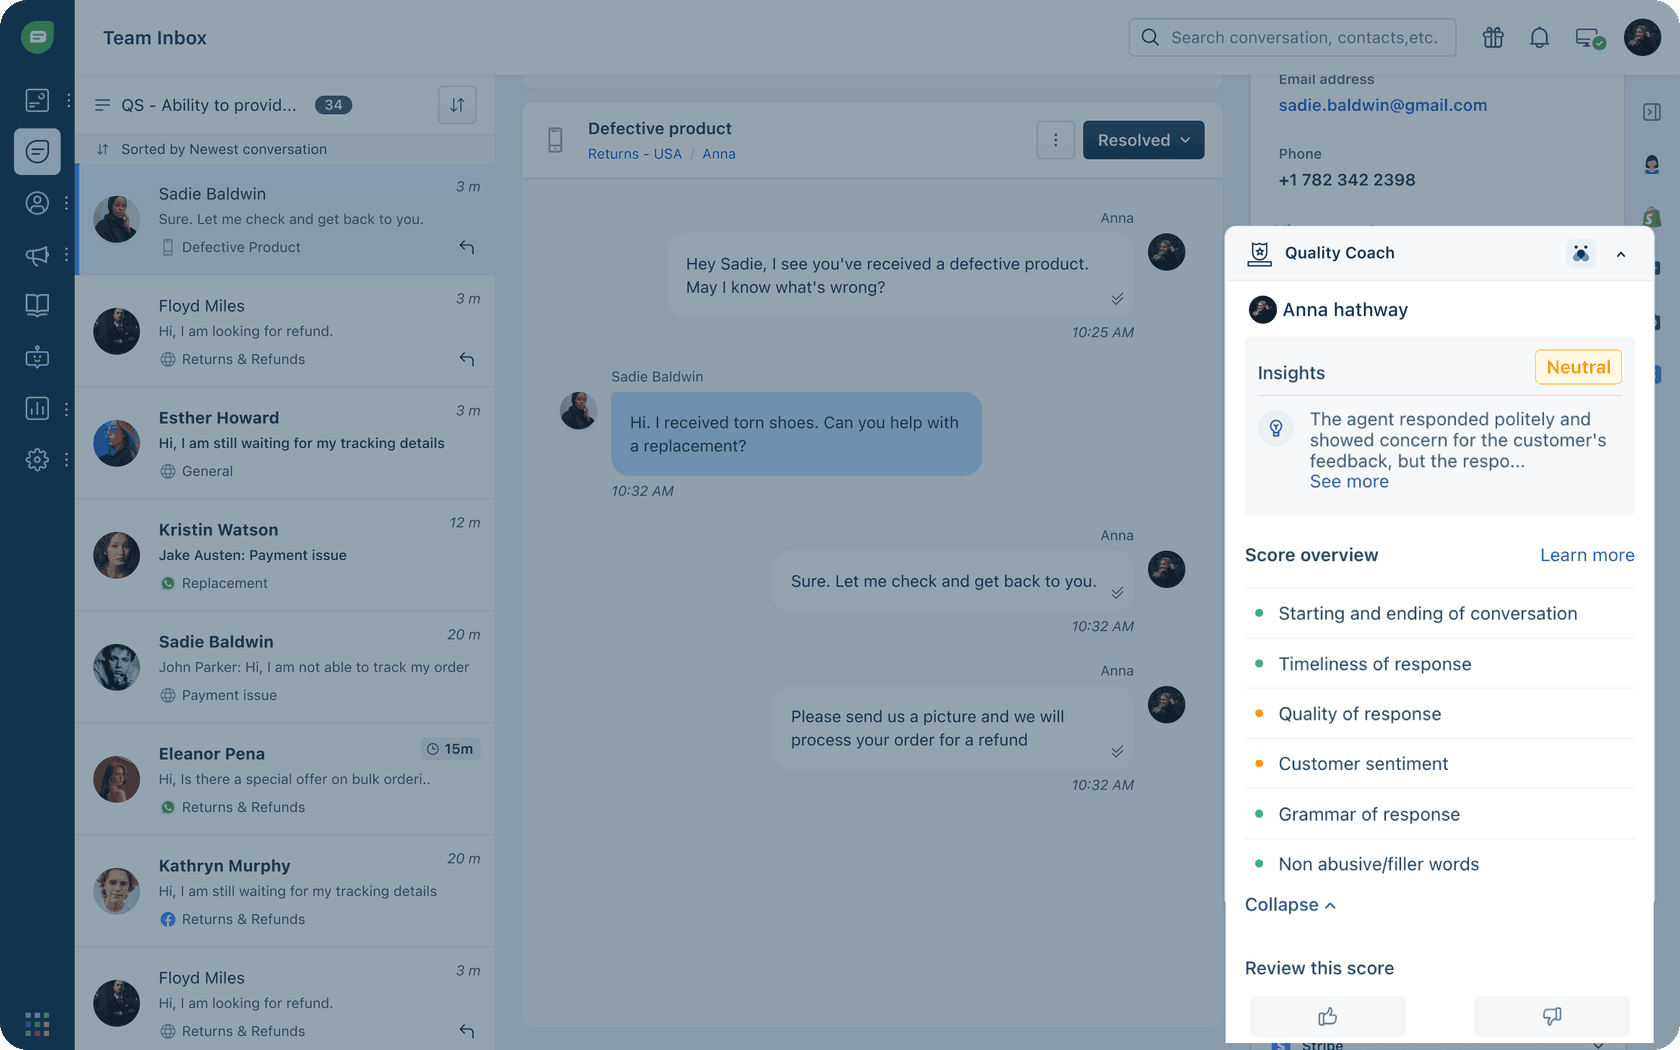
Le screenshot de Freshworks lui-même mérite une lecture attentive. Le client demande un remplacement pour des chaussures déchirées, l'agent répond "Please send us a picture and we will process your order for a refund", et le coach marque la conversation Neutral avec Quality of response et Customer sentiment en orange. Freddy a marqué ici Quality of response en orange. Ce qu'il ne peut pas savoir, c'est si votre politique de retour prévoit un remplacement, un remboursement, ou une photo d'abord pour des chaussures déchirées. Ce jugement a besoin de vos règles, et les six paramètres n'en acceptent aucune.
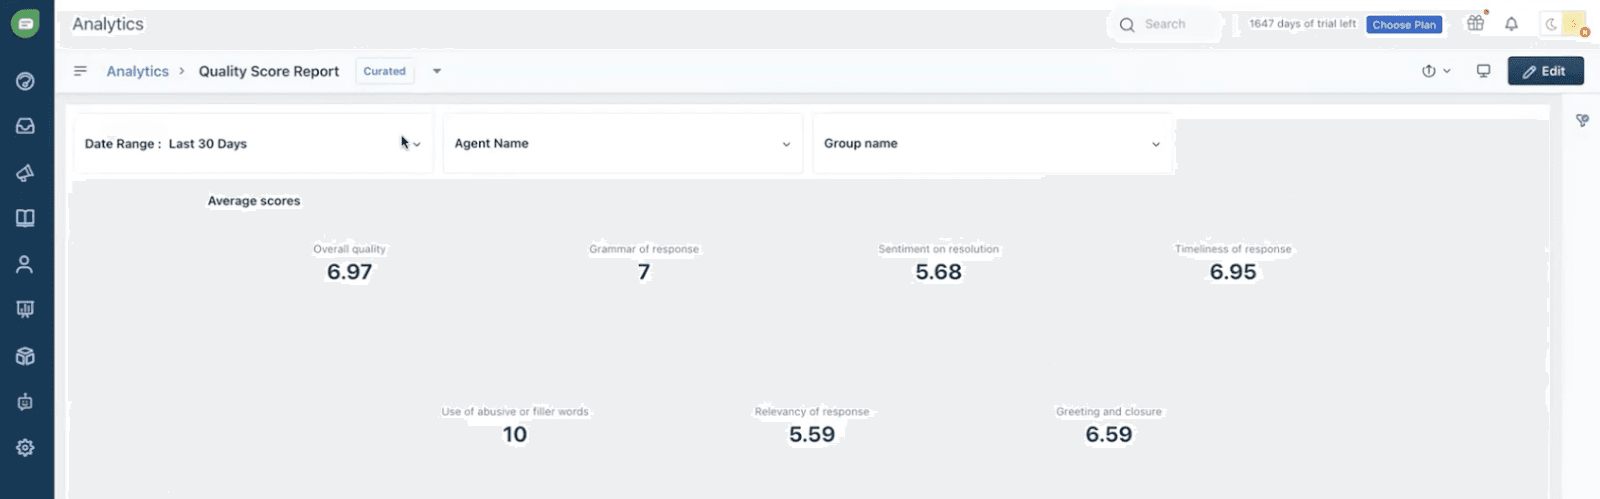
Les admins trouvent le Quality Score Report sous Reports, dans la catégorie Chat Analytics. Il affiche les notes hebdomadaires ou mensuelles, au niveau groupe et agent, avec une tendance dans le temps et une répartition par agent. Freshworks note que Freddy "could take couple of minutes to generate the Quality Score".
Deux choses à savoir avant d'acheter pour cela. Freshworks a mis à jour l'article pour la dernière fois le 27 juin 2024, et il dit que la fonction "is currently available as an add-on for Freddy Copilot", confirmez donc le packaging actuel avec votre account manager. Et Copilot est un add-on flexi acheté par agent, vérifiez donc les conversations de quels agents sont notées avant de budgétiser pour un sous-ensemble ; l'article ne le dit pas.
Que fait Proactive Quality Coach ?
Proactive Quality Coach agit avant l'envoi de la réponse. Quand un agent clique sur Send, Freddy vérifie le message selon sept paramètres dans cet ordre : "Abusive Words > Spelling Check > Grammar > Too long > Filler words > Tone > Relevancy". Il peut distinguer cinq bons tons (comme empathique et orienté solution) de cinq mauvais (comme défensif et sarcastique), met en évidence chaque problème dans sa propre couleur, et laisse l'agent accepter ou ignorer chaque suggestion.
Il est désactivé par défaut, peut être activé par rôle, et Freshworks le liste comme "available in Beta for all customers on Pro and Enterprise plan, as part of the Freddy AI Copilot addon". Les admins voient combien de suggestions ont été montrées, acceptées et rejetées dans les rapports Freddy.
Combinez les deux et vous avez un coach des deux côtés du bouton Send. Les deux agissent sur la façon dont la réponse est écrite. Aucun ne la vérifie par rapport à ce que votre équipe a décidé. Pour une lecture complète des chats passés, voyez mon guide pour relire des conversations de support IA.
Que ne peut pas vérifier le Quality Coach de Freshchat ?
Quatre vérifications manquent à ce que documente Freshworks :
- Votre politique. Aucun des six paramètres ne lit votre centre d'aide ou vos règles, donc une mauvaise réponse polie et bien écrite peut bien noter sur la plupart d'entre eux.
- Champs, sujets et acheminement. Les paramètres portent tous sur les messages. Rien ne vérifie qu'un chat de facturation est allé dans le groupe Billing ou a reçu le bon champ de conversation.
- Vos propres critères. L'article liste six paramètres fixes et aucun moyen d'en ajouter un septième, comme "toujours proposer d'abord la vérification de garantie".
- Le côté du bot. L'article parle des conversations des agents. Il ne dit pas si les chats gérés seuls par le Freddy AI Agent reçoivent une note, ne le supposez donc pas.
C'est la lacune pour laquelle existent la plupart des programmes de QA. La rapidité, le ton et la grammaire sont visibles pour les clients, mais une mauvaise promesse de remboursement est celle qui coûte de l'argent.
Combien coûte la QA IA de Freshchat ?
La page de tarifs de Freshchat liste ces plans au 22 novembre 2026, par agent et par mois facturé annuellement. Les tarifs de Freddy AI Copilot viennent de l'article de Freshworks Freddy AI features and pricing.
| Plan | Par agent et par mois, facturé annuellement | Ce qu'il ajoute pour la QA |
|---|---|---|
| Free | 0 $, jusqu'à 10 agents | Non listé pour Quality Coach |
| Growth | 19 $ | Non listé pour Quality Coach |
| Pro | 49 $ | Peut acheter Freddy AI Copilot à 29 $ par agent et par mois, qui apporte les deux fonctions Quality Coach |
| Enterprise | 79 $ | Le même add-on Copilot |
Copilot coûte 35 $ par agent en facturation mensuelle. Pour une équipe de 10 agents passant de Growth à Pro avec Copilot pour tous, facturé annuellement : Pro coûte 10 x 49 $ = 490 $, Copilot 10 x 29 $ = 290 $, soit 780 $ par mois contre 190 $ sur Growth. Copilot apporte aussi des brouillons de réponse, des résumés et le reste, couverts dans mon article sur les tarifs de Freddy AI, la QA est donc rarement la seule raison de l'acheter.
Comment couvrir ce que Freshchat laisse de côté ?
Il y a deux façons de couvrir le reste.
Noter un échantillon à la main
La voie la moins chère ne nécessite rien de nouveau. Chaque semaine, un responsable prend dix ou vingt chats résolus, en commençant par les notes CSAT insatisfaisantes, les conversations rouvertes et les labels Bad de Quality Coach, lit chacun, et le note selon une grille courte : bonne réponse pour la politique, bon groupe et champs, process suivi. Mettez-vous d'abord d'accord sur ce que signifie chaque note pour que deux relecteurs notent le même chat de la même façon : la calibration QA du support aide, et ce guide sur la QA support avec l'IA montre où l'IA accélère.
La limite est celle qu'on devine : une personne lit un échantillon, et les résultats vivent dans une feuille de calcul, pas sur le chat.
Laissez un coéquipier IA réviser selon vos règles
La deuxième voie est un agent IA qui lit les chats et laisse son verdict dans Freshchat. C'est ce que je ferais avec eesel. eesel rejoint Freshchat comme canal de son intégration Freshdesk. Quand quelqu'un de votre équipe le demande, dans le chat du tableau de bord, une mention Slack ou une exécution planifiée, il peut lire les messages de n'importe quel chat, son groupe, son assigné, son statut et ses champs personnalisés, ainsi que les chiffres CSAT et de temps de réponse de Freshchat. Il lit votre centre d'aide, vos réponses prédéfinies et les tickets Freshdesk passés, une politique que vous avez publiée est donc quelque chose qu'il a lu.
Donnez-lui les chats à vérifier (collez par exemple les liens des chats les moins bien notés de la semaine) et il :
- Lit chaque conversation avec ses propriétés.
- La vérifie selon les règles que vous avez écrites en mots simples ("les articles endommagés reçoivent d'abord un remplacement, pas un remboursement", "les questions de facturation vont au groupe Billing", "ne jamais promettre une date de livraison").
- Laisse son verdict et ses raisons sous forme de commentaire interne, que l'équipe voit et que le client ne voit jamais.
- Liste les chats qu'un responsable devrait lire, avec la raison de chacun.
Vous écrivez les règles, donc les vérifications d'acheminement, de process et de politique ne sont que des lignes supplémentaires, modifiées chaque fois que vos politiques changent. Connaissez d'abord la limite : eesel n'a aucune commande pour lister chaque chat résolu dans Freshchat, il relit donc les chats que vous lui donnez plutôt que de parcourir seul la boîte de réception. Si votre équipe traite aussi l'e-mail dans Freshdesk, le même agent peut vérifier aussi ces tickets.
Des vérifications quotidiennes comme celle-ci tournent déjà pour des clients d'eesel. Cactus Club Cafe fait tourner un deuxième agent eesel sur son helpdesk Zendesk qui audite chaque matin l'extrait financier quotidien : il vérifie chaque magasin et résout le ticket comme équilibré, ou le laisse ouvert en nommant l'écart. Entre le 8 août et le 8 septembre 2026, il a tourné environ 60 fois. Une revue QA a la même forme : une vérification par rapport à des règles écrites, avec le résultat laissé là où l'équipe travaille.
Le Quality Coach de Freshchat suffit-il pour la QA ?
Pour le coaching, c'est un bon début. Une note sur chaque conversation résolue, montrée à l'agent qui l'a traitée, avec des conseils, est une vraie avance, et le Quality Score Report donne à un responsable une tendance par agent sans que personne ne lise une transcription. Proactive Quality Coach corrige le ton et la grammaire avant que le client ne les voie.
Mon avis : si vous êtes déjà sur Pro et achetez Copilot pour les brouillons et les résumés, activez les deux fonctions Quality Coach et utilisez les labels Bad et les notes CSAT insatisfaisantes comme liste de lecture hebdomadaire. Ne traitez pas un label Good comme "correct" : il signifie bien écrit et bien reçu. Si votre question QA est "était-ce correct selon notre politique ?", Freshchat vous laisse ça : un échantillon noté à la main si votre volume est petit, un relecteur IA s'il ne l'est pas. Les réponses d'autres helpdesks à la même question sont dans mes articles sur le contrôle qualité IA dans Gorgias, le contrôle qualité IA dans Front et le contrôle qualité IA dans Help Scout, et mon tour d'horizon des outils IA pour la QA support compare des options dédiées. Pour le reste de Freddy dans le chat, voyez l'analyse de sentiment IA dans Freshchat et les brouillons de réponse IA dans Freshchat, et les résumés de conversation pour les transferts. Vous envisagez plutôt un changement ? Voyez les alternatives à Freshchat.
Essayez eesel comme relecteur de politique pour Freshchat
Si la vérification qui vous manque est "cette réponse était-elle correcte selon notre politique ?", eesel est le relecteur que j'ajouterais à côté de Quality Coach. Il se connecte via votre compte Freshdesk, lit votre centre d'aide et les tickets passés, et vérifie les conversations Freshchat que vous lui indiquez selon les règles que vous écrivez, en laissant ses raisons dans un commentaire interne. Commencez avec dix des chats les moins bien notés de la semaine dernière dans le chat du tableau de bord, lisez ce qu'il signale, et conservez les règles qui détectent de vraies erreurs.

Essayez eesel gratuitement, ou réservez une démo pour voir comment il révise vos propres conversations Freshchat.