

Le contrôle qualité IA de Front, c'est Smart QA : sur le plan Enterprise (105 $ par poste et par mois, facturé annuellement), l'IA de Front note chaque conversation résolue ou archivée dans les boîtes partagées que vous choisissez selon une grille que vous construisez à partir de 15 critères par défaut et de vos propres critères personnalisés. Les notes apparaissent dans un panneau latéral et un rapport Smart QA, et un admin peut annuler n'importe laquelle. Cela va plus loin qu'une simple vérification du ton, avec deux réserves. Ses critères ne lisent que les messages de la conversation, donc Front indique que les tags, les horodatages et l'acheminement ne peuvent pas être notés, et il est passé à un modèle plus strict le 20 novembre 2026, donc les moyennes baissent à partir de cette date sans que votre équipe ait réellement baissé de niveau. Pour vérifier ce que Smart QA ne peut pas (le bon tag, la bonne boîte, la politique de votre centre d'aide), un responsable peut lire un échantillon hebdomadaire, ou un coéquipier IA comme eesel peut relire chaque conversation archivée selon des règles que vous écrivez et laisser ses raisons dans un commentaire interne. Un agent de code comme Claude Code peut mettre en place cette relecture via le CLI eesel, même si quelqu'un autorisé à valider des applications dans Front doit toujours approuver la connexion.
Front a-t-il un contrôle qualité IA ?
Oui. Front l'appelle Smart QA, et l'argument de sa page produit est que "quelqu'un doit relire chaque ticket", mais ce n'est pas obligé d'être vous. Je construis les intégrations d'eesel, donc je lis une fonctionnalité comme celle-ci pour ce qu'elle lit et écrit vraiment, pas pour ce que dit la page produit.
Smart QA n'est pas le seul signal de contrôle qualité de Front. Voici ce qu'obtient un responsable support, d'après la propre documentation de Front et sa page de tarifs :
| Fonctionnalité Front | Plan | Ce que ça dit à un responsable QA | Ce que ça ne dit pas |
|---|---|---|---|
| Smart QA | Enterprise | Comment chaque coéquipier et chaque agent IA a noté selon vos critères, avec raisons et extraits cités | Rien sur les tags, horodatages ou acheminement |
| Smart CSAT | Enterprise | À quel point le client était probablement satisfait, d'après le sentiment, l'effort et la résolution | Quelle part relevait du conseiller |
| Simulations Compass | Avec un agent Autopilot | Si l'agent IA réussit vos critères sur de vraies conversations passées avant sa mise en service | Comment se comportent les coéquipiers humains |
| AI Topics | Tous les plans | Pourquoi les clients écrivent | S'ils ont eu une bonne réponse |
Comment fonctionne Front Smart QA ?
L'IA de Front lit chaque conversation une fois résolue ou archivée, note chaque coéquipier qui a répondu selon les critères de votre grille, et écrit une raison courte pour chaque note. La mise en place tient en deux parties :
- Une grille. Dans les paramètres de l'entreprise, ouvrez Front AI, puis l'onglet Smart QA, et cliquez sur Create scorecard. Cochez les critères par défaut souhaités, ajoutez-en des personnalisés, et modifiez comment l'un d'eux est noté. Vous pouvez garder plusieurs grilles.
- Une règle. Dans les Rules and macros d'un workspace, créez une règle à partir du modèle Review conversations with Smart QA. Il demande quels types de conversation, quelles boîtes partagées, quelles réponses de coéquipiers, combien de temps attendre après l'archivage ou la résolution d'une conversation, et quelle grille utiliser.
Les 15 critères par défaut se répartissent en trois groupes. Communication comprend Brevity, Empathy, Friendliness, Grammar and spelling, Greeting offered, Information gathering, Personalization, Professionalism, Readability et Tone. Solution comprend Comprehension et Solution offered. Proactivity comprend Adaptability, Demo offered et Upsell. Certains ne s'appliquent que si le moment s'est présenté (Upsell, quand "une opportunité claire d'upsell/cross-sell est apparue") ; sinon le critère affiche N/A et ne compte pas.
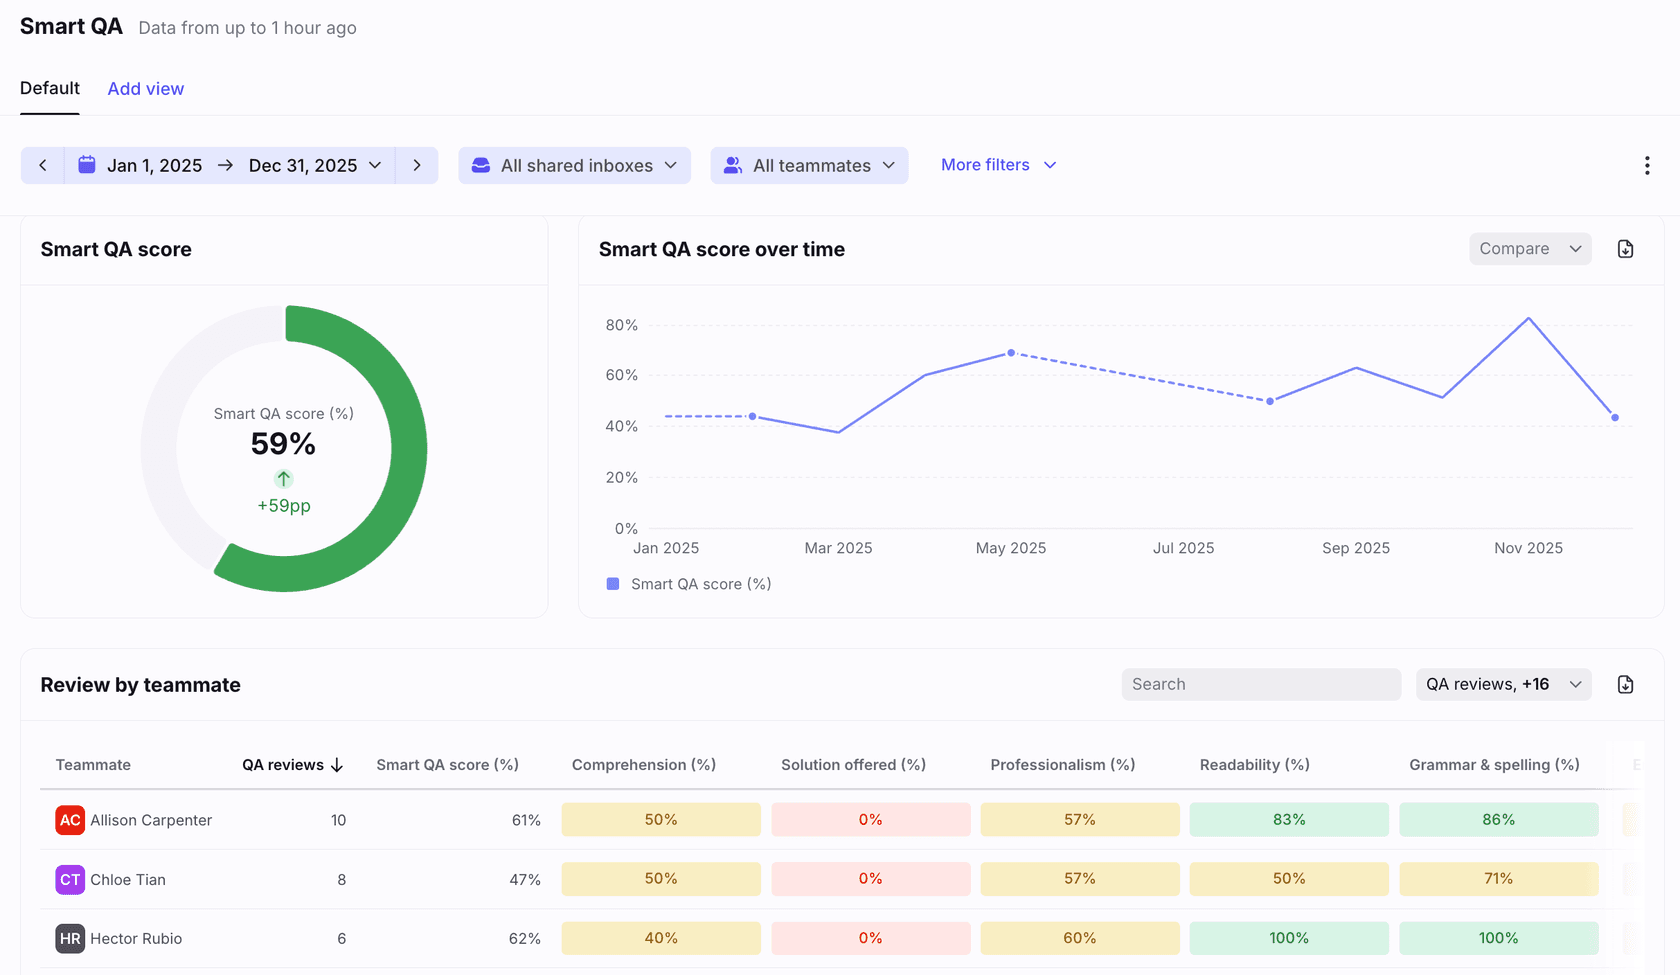
Chaque critère est noté sur une échelle de 1 à 5 ou en binaire réussite/échec. Les échelles deviennent des pourcentages (un 1 vaut 0 %, un 4 vaut 75 %), et le rapport fait la moyenne, donc un coéquipier avec un 1 et un 4 sur Tone affiche 38 %.
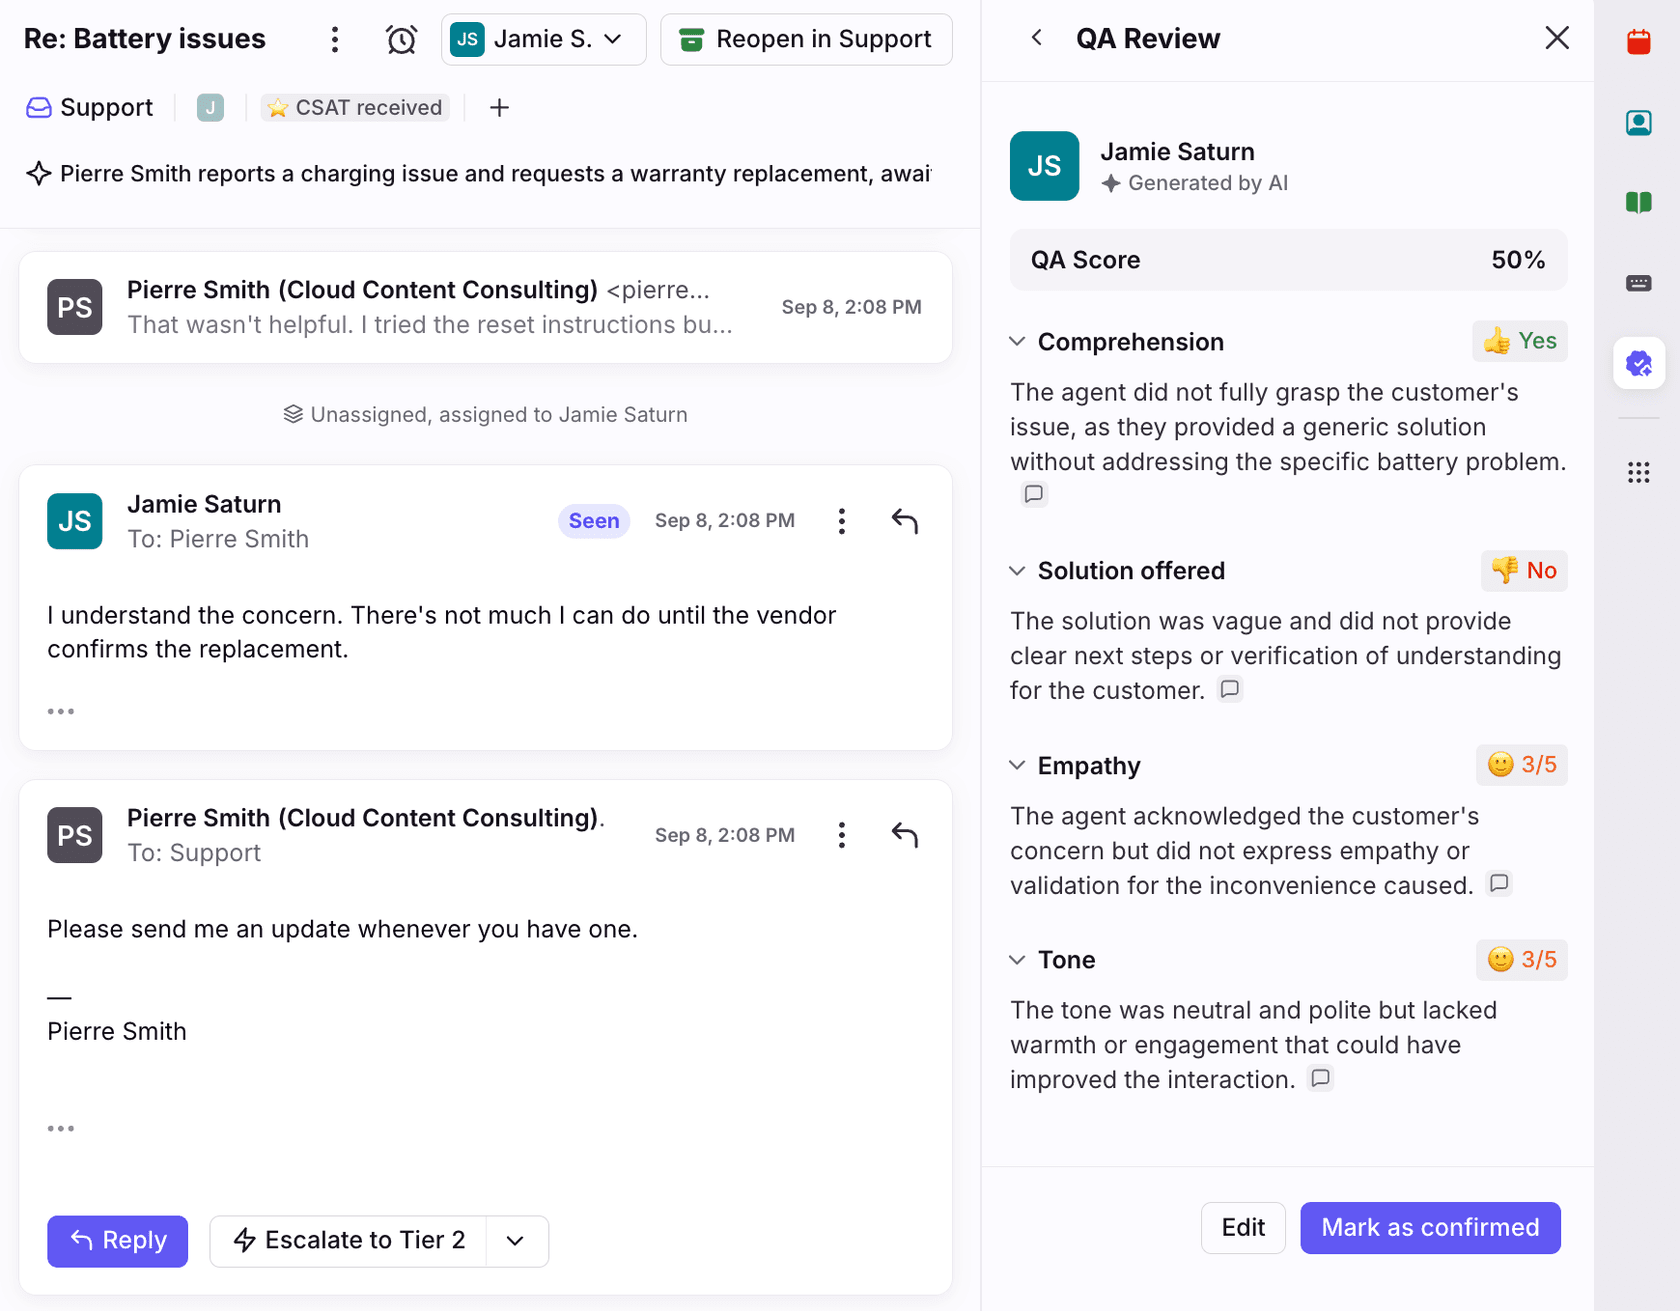
Les résultats apparaissent à deux endroits, à côté de Smart CSAT si vous l'utilisez. Le panneau Smart QA and CSAT dans la barre latérale de la conversation affiche la relecture, et pour les conversations notées après le 6 septembre 2026, chaque raison cite jusqu'à trois extraits sur lesquels vous pouvez cliquer pour y aller directement. Le rapport Smart QA dans Analytics fait la moyenne de chaque critère par coéquipier, trie les conversations par note et exporte vers un fichier.
Les règles à connaître avant de faire confiance aux chiffres :
- Les admins peuvent annuler. Modifiez une note depuis le panneau ou le rapport, ajoutez un commentaire, et cliquez sur Save & mark as reviewed. Le nom de l'admin remplace "Generated by AI", et le rapport se met à jour en une heure.
- Les conseillers ne voient que les leurs. Les admins avec des permissions analytics voient tout. Front vous demande aussi d'informer les conseillers quand Smart QA s'applique à leurs conversations.
- Les agents IA sont notés aussi. Tout coéquipier qui répond avant que la conversation soit résolue ou archivée est évalué, "coéquipiers humains comme agents IA". L'évaluation des agents IA couvre les tests d'un agent avant sa mise en service.
- Front dit de ne pas s'y fier seul. Son article vous demande de "vous appuyer sur votre propre évaluation et analyse, ou celle d'experts, pour les décisions importantes".
Pourquoi les notes Front Smart QA ont-elles baissé en novembre 2026 ?
Parce que Front a changé le modèle. Le 20 novembre 2026, Smart QA est passé à un modèle amélioré qui, selon Front, note de façon plus proche des évaluateurs humains experts. Ce qu'un responsable va ressentir : "Avant la mise à niveau, environ deux tiers des notes étaient des 5. Maintenant, environ 1 conversation sur 4 obtient un 5." Front vous dit de vous attendre à des moyennes plus basses et de considérer la date de mise à niveau comme une nouvelle base.
Donc si la note Smart QA de votre équipe a baissé cette semaine, n'ouvrez pas encore de plan de coaching. Comparez les semaines après le 20 novembre entre elles, et si vous reportez la QA à la hausse, marquez la rupture sur le graphique. Je verrais ça comme une bonne nouvelle : une échelle où deux tiers des conversations obtiennent la meilleure note ne peut pas distinguer votre meilleur conseiller d'un moyen.
Comment fonctionnent les critères personnalisés dans Front Smart QA ?
Vous décrivez la vérification en mots simples et Front en fait une échelle. Sous le bouton Criteria de l'onglet Smart QA, cliquez sur Create criteria, donnez-lui un nom et une description, et la documentation de Front suggère de préciser "ce que le critère évalue, ce qu'il n'évalue pas". Generate en écrit une échelle de 1 à 5 ou réussite/échec, que vous pouvez modifier, et Applicability détermine si ça s'applique à chaque conversation ou seulement à celles que vous décrivez. Un validateur signale "Too vague" ou "Not a condition", mais vous laisse enregistrer malgré tout.
Le propre exemple de Front est un critère appelé Solution accuracy :
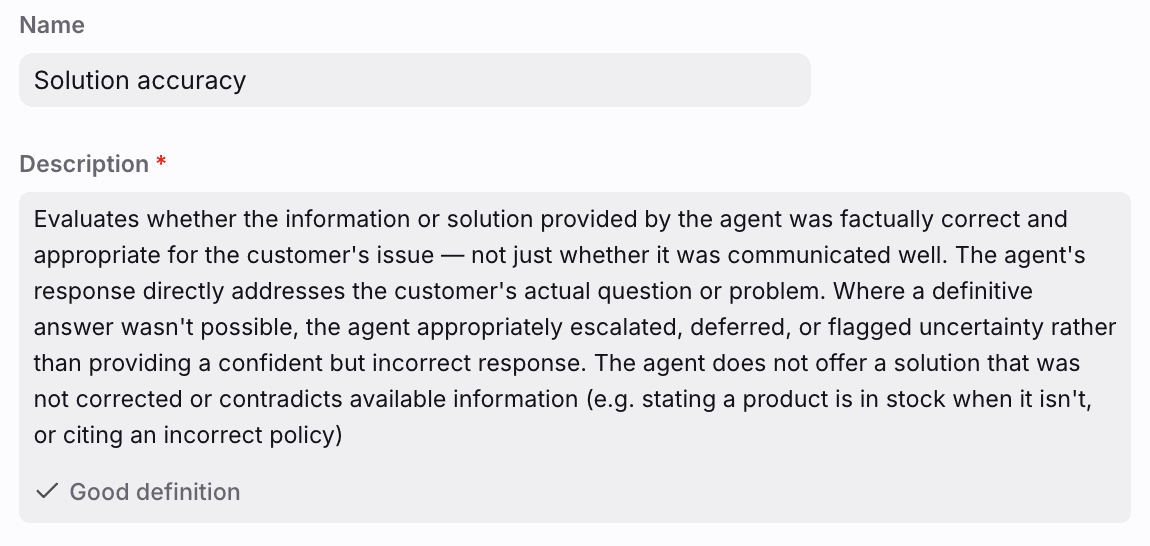
C'est le critère que la plupart des équipes veulent en premier, et il montre aussi la limite. La description demande si la réponse contredit des "informations disponibles (par exemple dire qu'un produit est en stock quand il ne l'est pas, ou citer une politique incorrecte)". L'article de Front précise ce qu'un critère évalue : les réponses du coéquipier relu, avec "tous les autres messages de la conversation comme contexte". Il ne liste ni votre centre d'aide, ni vos niveaux de stock, ni vos documents de politique comme entrées. Donc une vérification de politique fonctionne quand la règle est dans le critère lui-même ("les remboursements après 30 jours ont besoin de l'accord d'un responsable") ou dans la conversation, et je la testerais sur quelques conversations dont vous connaissez déjà la réponse avant de lui faire confiance.
Que ne peut pas voir Front Smart QA ?
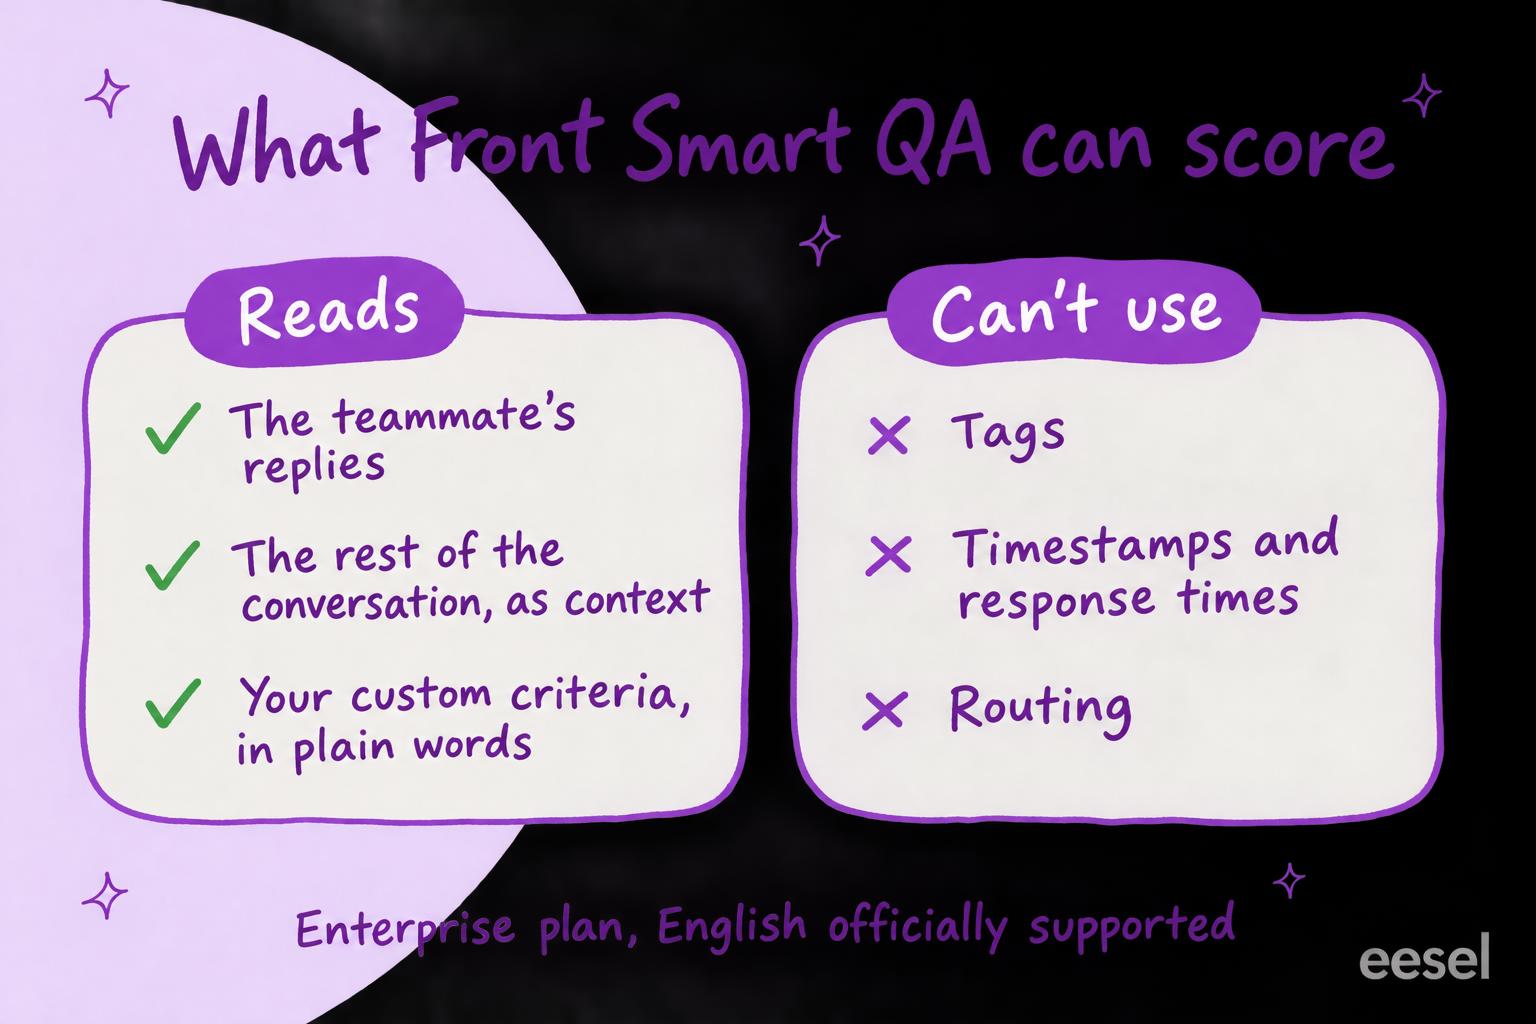
Le dossier autour de la conversation. L'article de Front est explicite : "Conversation metadata such as tags, time between responses, and other information is not able to be used in the evaluation." Donc aucun critère ne peut vérifier qu'une demande de remboursement a reçu le tag Refund, qu'une question de facturation a été déplacée vers la boîte Billing, ou qu'une réponse est partie dans votre SLA. Si votre reporting repose sur les tags, un mauvais tag est une erreur QA que Smart QA ne détectera pas. Les règles de statut de ticket et les règles d'attribution de Front doivent être vérifiées autrement.
Les autres limites, tirées du même article :
- Boîtes partagées seulement. Les boîtes personnelles ne sont pas relues, sauf si un admin les reflète vers une boîte partagée avec une règle.
- Résolue ou archivée, avec une réponse. Une conversation a besoin d'au moins un message entrant et un sortant.
- Pas rétroactif. Une règle note les conversations archivées ou résolues après sa création, donc le trimestre dernier reste non noté.
- Anglais. "Only English is officially supported at this time" ; les autres langues peuvent donner des "unexpected results". Le contrôle qualité multilingue couvre les options.
- Les exclusions se règlent dans la règle. Elle restreint par boîte, type de conversation et coéquipier ; tout le reste est une annulation manuelle après coup.
Combien coûte la QA IA de Front ?
Smart QA vient avec Enterprise. Le centre d'aide de Front indique qu'il est "included with the latest Enterprise plan at no additional cost", et la page de tarifs liste "AI Copilot, QA, and CSAT included" sous Enterprise. Le mot "latest" compte si vous avez un contrat Enterprise plus ancien : demandez à Front si le vôtre l'inclut. Tarifs vérifiés le 21 novembre 2026, facturés annuellement :
| Plan | Par poste et par mois | Limite de postes | Ce que ça ajoute pour la QA |
|---|---|---|---|
| Starter | 25 $ | Jusqu'à 10 | Analytics basique, AI Topics |
| Professional | 65 $ | Jusqu'à 50 | Analytics avancé ; Copilot est une option à 20 $ par poste |
| Enterprise | 105 $ | Aucune limite indiquée | Smart QA, Smart CSAT et Copilot inclus, rapports personnalisés |
Pour une équipe de 10, Professional coûte 650 $ par mois et Enterprise 1 050 $, donc Smart QA arrive avec un saut de 400 $ par mois. Si vous achèteriez Copilot de toute façon (200 $ par mois pour 10 postes sur Professional), l'écart tombe à 200 $, qui donnent aussi Smart CSAT, l'acheminement et le tagging par IA, et des règles illimitées. Pour essayer d'abord, le modèle de règle a un bouton Start free trial qui démarre 30 jours d'Enterprise. Le détail des tarifs Front d'eesel a le reste, y compris le tarif Autopilot.
De quoi un programme QA a-t-il besoin que Smart QA vous laisse faire ?
La plupart des programmes QA vérifient trois choses que Smart QA n'atteint pas complètement : si la réponse correspondait à une politique qui vit dans un document, si la conversation a été taguée et acheminée comme vos rapports l'attendent, et comment ça s'est passé pour les conversations dans une autre langue ou dans une boîte personnelle. Choisissez ce que vous voulez vérifier et voyez ce qui le couvre :
Choisissez un point à vérifier pour voir ce qui le couvre dans Front, et ce qui le couvre si rien ne le fait.
Il y a deux façons de couvrir le reste.
Noter un échantillon à la main
La voie la moins chère ne demande rien de nouveau, et c'est là que commencent la plupart des guides de QA support avec l'IA. Chaque semaine, un responsable filtre les conversations archivées de la semaine précédente dans une boîte, en lit dix ou vingt (les notes Smart QA les plus basses en premier, si vous les avez), et vérifie chacune selon une grille courte dans une feuille de calcul : bonne réponse pour la politique, bon tag, bonne boîte. Mettez-vous d'accord d'abord sur ce que signifie chaque note pour que deux évaluateurs notent la même conversation de la même façon : la calibration QA aide, ainsi que ces exemples de feedback QA.
La limite est la plus évidente : une personne lit un échantillon, et les résultats vivent en dehors de Front.
Faire relire par un coéquipier IA selon vos règles
La deuxième voie est un agent IA qui fait la relecture seul et laisse le résultat dans Front. C'est ce que je ferais avec eesel. L'intégration Front d'eesel peut démarrer une exécution quand une conversation est archivée, et l'exécution a déjà les tags, le responsable assigné, les champs personnalisés, la boîte et le fil de la conversation, commentaires internes inclus (sur une conversation très longue, la page la plus récente de messages). Il apprend de votre centre d'aide Front à l'avance, donc une politique que vous avez publiée est quelque chose qu'il a déjà lu.
Configurez une automatisation sur ce déclencheur et, pour chaque conversation archivée, elle :
- Lit le fil avec ses tags et sa boîte.
- Le vérifie selon les règles que vous avez écrites en mots simples ("les remboursements après 30 jours ont besoin de l'accord d'un responsable", "les questions de facturation reçoivent le tag Billing", "ne jamais promettre une date d'expédition").
- Laisse son verdict et ses raisons comme commentaire interne sur la conversation.
- Ajoute un tag que vous avez créé dans Front, comme qa-review, à celles qu'un responsable devrait lire, pour qu'une vue ou un filtre analytics les trouve.
Vous écrivez les règles, donc le tagging, l'acheminement et la politique ne sont que d'autres lignes, modifiées chaque fois que vos politiques changent. Une chose à savoir d'abord : eesel n'ajoute que des tags qui existent déjà dans Front, un à la fois, donc une personne crée le tag de relecture avant de commencer. Le même agent eesel peut aussi trier les nouveaux emails et rédiger des réponses comme commentaires internes, si vous le souhaitez.
Des vérifications quotidiennes comme celle-ci tournent déjà pour les clients d'eesel. Cactus Club Cafe fait tourner un deuxième agent eesel sur son helpdesk Zendesk qui audite chaque matin l'extraction financière quotidienne : il vérifie chaque magasin et résout le ticket comme équilibré, ou le laisse ouvert en nommant l'écart. Entre le 8 août et le 8 septembre 2026, il s'est exécuté environ 60 fois. Une relecture QA a la même forme : une vérification contre des règles écrites, avec le résultat laissé sur la conversation.
Front Smart QA suffit-il ?
Reconnaissons ce qui le mérite : Smart QA couvre beaucoup. Des critères personnalisés en mots simples, une option réussite/échec, des extraits cités, des annulations manuelles qui alimentent le rapport, et des agents IA notés sur la même grille que les humains. Le propre exemple de Front, Solution accuracy, montre qu'il sait ce que les équipes veulent de la QA au-delà du ton.
Mon avis : sur Enterprise, activez-le, commencez avec cinq ou six critères (Solution offered, Comprehension, Tone, et un critère personnalisé qui écrit en entier votre politique la plus souvent enfreinte), et utilisez les notes les plus basses comme liste de lecture. Repartez de zéro à partir du 20 novembre. Ne le traitez pas comme tout le programme : un conseiller peut bien noter sur chaque critère tout en taguant mal la conversation, et Smart QA ne le saura jamais. Si vous êtes sur Professional, Enterprise représente un saut de 400 $ par mois pour 10 postes où la QA n'est qu'une chose parmi d'autres qu'il ajoute, et un relecteur qui vérifie vos règles et vos tags sur chaque conversation couvre davantage ce qu'une grille est censée faire. eesel a le même détail pour Help Scout et le score QA HubSpot, et son tour d'horizon des outils QA support couvre aussi les noteurs dédiés.
Essayer eesel à côté de Front
Gardez Smart QA pour ce qu'il fait bien. Ce qu'eesel peut faire dépend de qui demande, et vous choisissez quelles actions tournent seules, lesquelles demandent d'abord et lesquelles restent désactivées ; pour une exécution de relecture, laissez les commentaires et les tags tourner seuls et gardez les réponses désactivées. Laissez-le lire vos conversations Front archivées selon le reste de votre grille (vos politiques publiées, vos tags et boîtes), écrite en mots simples et modifiée chaque fois que vos politiques changent. Il laisse ses raisons dans un commentaire interne et tague les conversations qu'un responsable devrait lire.
Essayer eesel dans votre boîte Front, en commençant par les conversations archivées d'hier.