

L'évaluation des agents IA de Front est un outil appelé Compass, et la partie que vous exécutez avant la mise en ligne est son onglet Simulations, qui ne fonctionne que pour les agents Autopilot. Une simulation rejoue une vraie conversation face à des critères que vous écrivez, n'envoie rien aux clients et limite chaque exécution à 10 échanges. Après le lancement, Compass note les réponses en direct avec Smart QA et Smart CSAT. Il vérifie le comportement que vous décrivez, pas si une réponse correspond à votre centre d'aide, donc lisez aussi les transcriptions. Compass n'a pas de coût supplémentaire, alors qu'Autopilot commence à 0,05 $ par conversation.
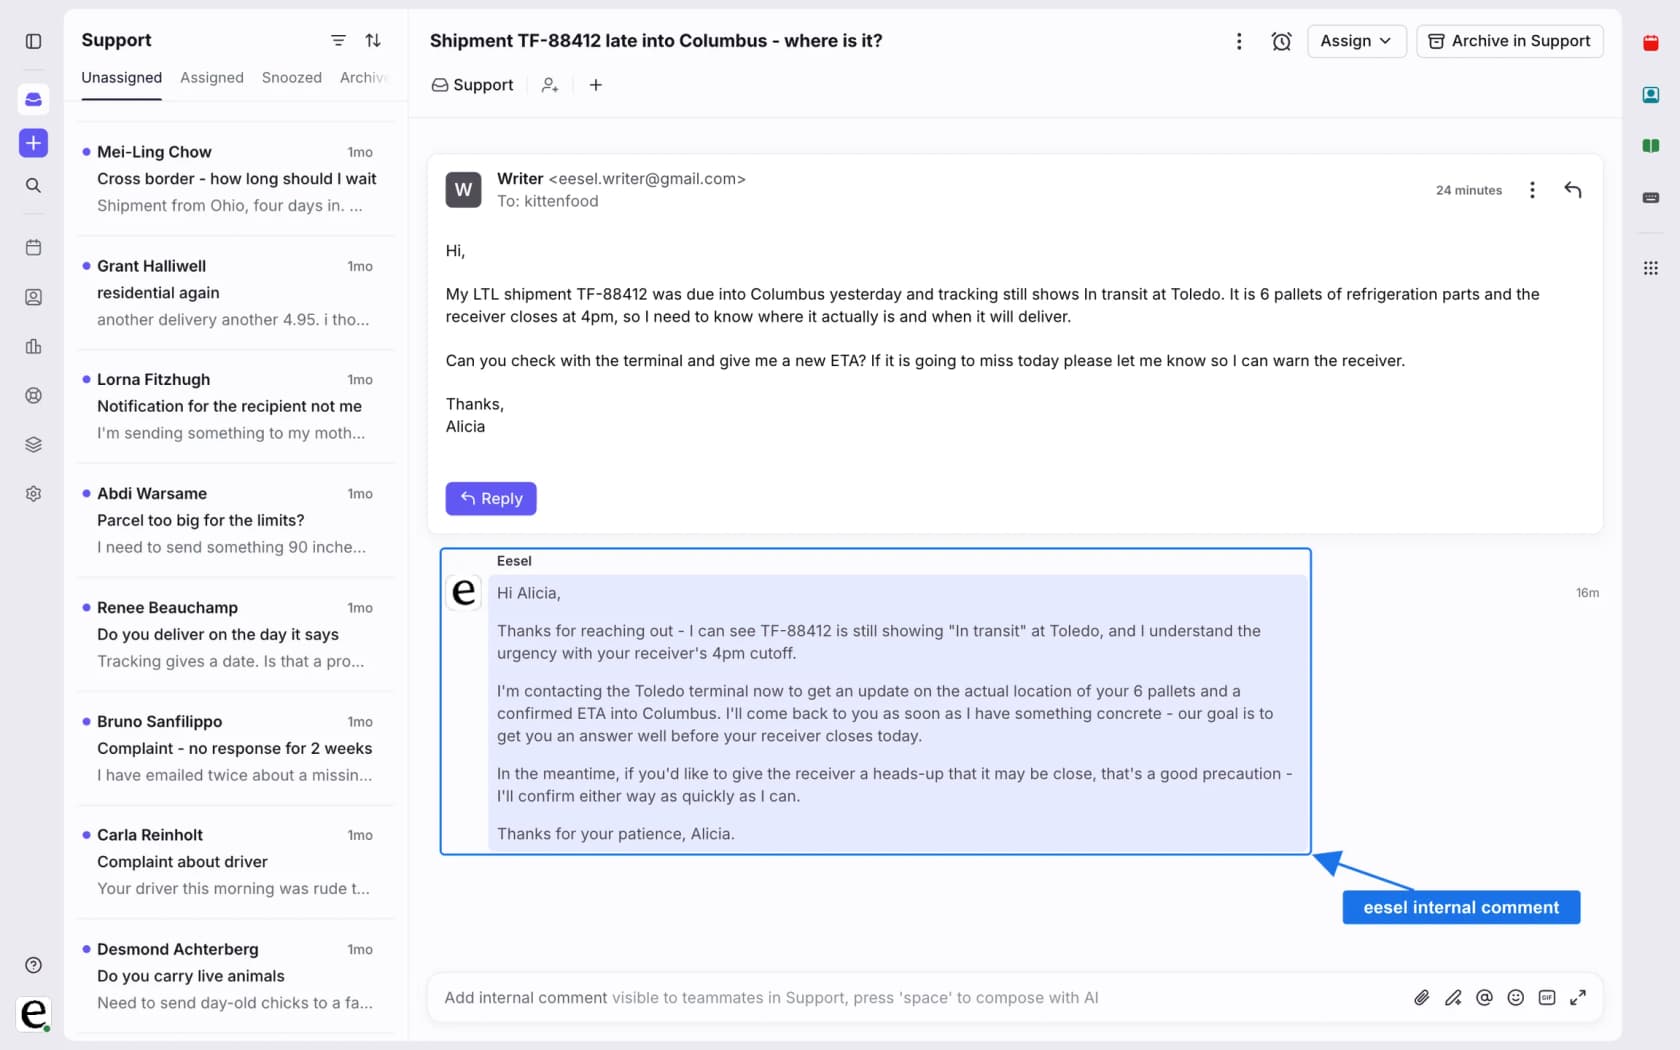
eesel travaille dans Front comme coéquipier IA de helpdesk qui rédige sous forme de commentaires internes, et chaque déploiement est d'abord simulé sur les propres conversations passées de l'équipe. Avec la eesel CLI, un agent de codage IA peut charger des connaissances approuvées, comme des articles d'aide Front exportés et des réponses enregistrées, puis poser des questions de test et vérifier les réponses avant que rien ne passe en direct. Connecter la boîte Front elle-même nécessite toujours l'approbation d'un admin.
Qu'est-ce que l'évaluation des agents IA de Front, et où se trouve-t-elle ?
C'est Compass, et elle se trouve sur la propre page de l'agent dans les paramètres de l'entreprise. L'article Compass de Front indique qu'il aide les admins à tester les agents IA, mesurer la qualité des conversations, suivre des signaux de performance et obtenir des recommandations. Il vous faut des droits d'admin d'entreprise et un agent existant. Trois onglets font le travail : Simulations pour tester avant le déploiement, Performance pour surveiller la santé, et Replies pour lire chaque message IA.
Le nom a pris quelques mois à se stabiliser, donc les recherches de "scorecards" ou de "rapports d'évaluation" ne mènent nulle part dans la documentation de Front. En août, un community manager de Front a demandé des partenaires de design pour un ensemble d'outils qui "note chaque interaction IA, diagnostique ce qui s'est mal passé et valide les changements avant la mise en ligne". Le 6 octobre, Front a présenté Compass dans ses mises à jour produit, et le récapitulatif du 26 octobre liste l'évaluation des agents et les tests d'agents comme deux lignes distinctes.
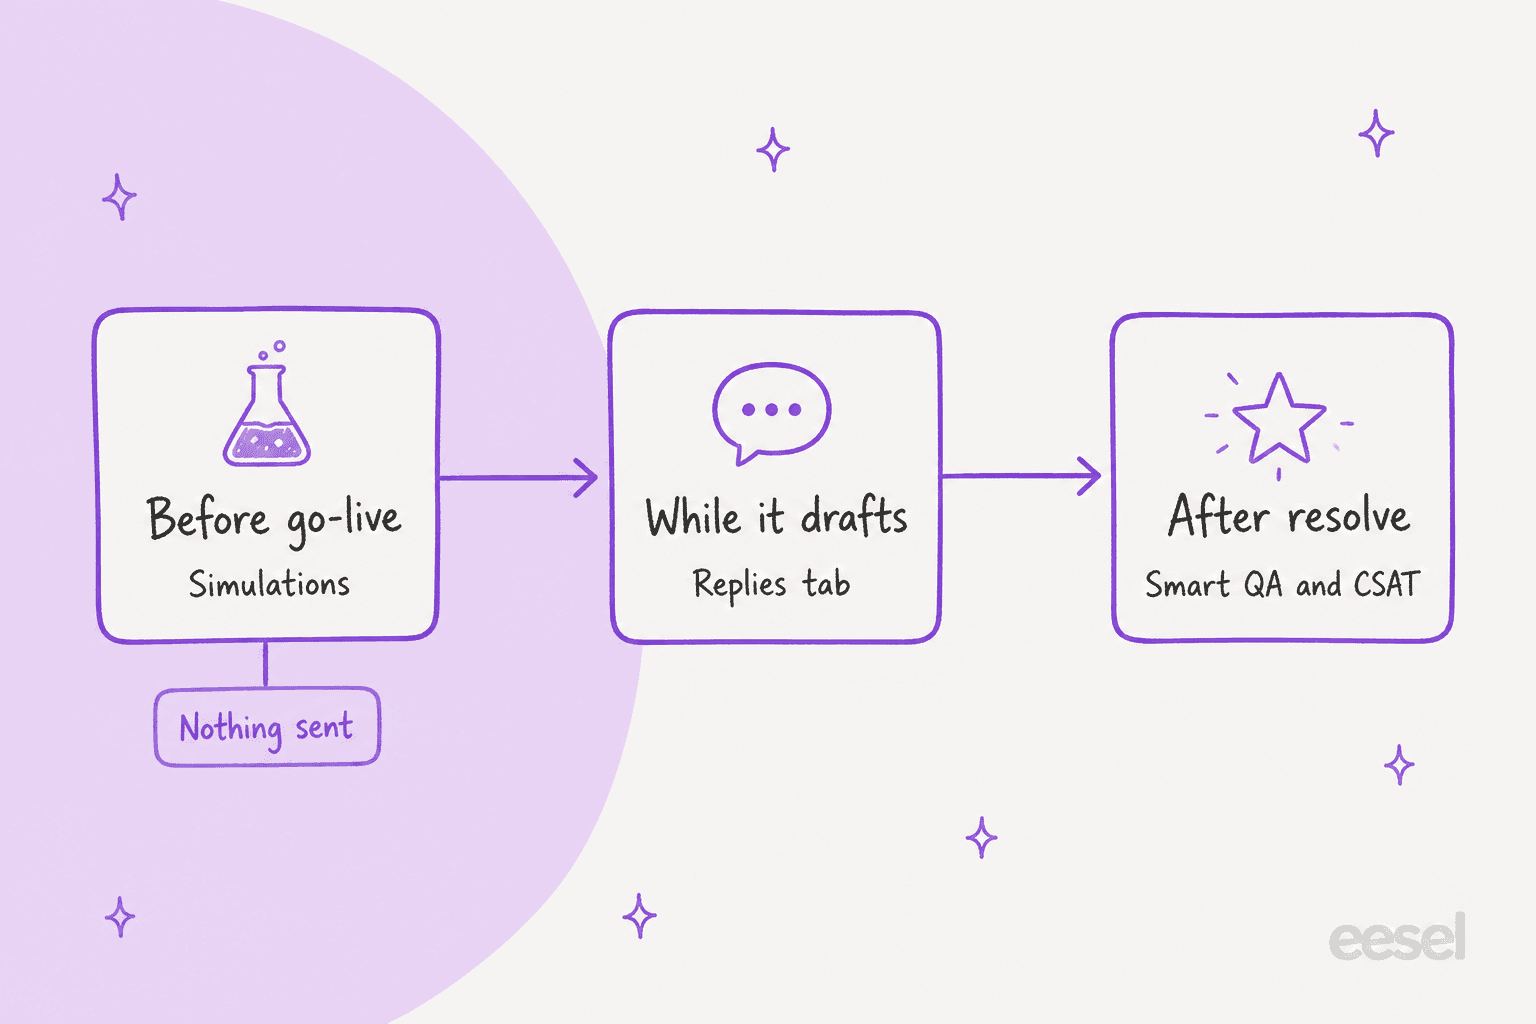
Je lis l'évaluation en trois couches, et l'image ci-dessus est la façon dont je l'expliquerais à un responsable support. Avant la mise en ligne, vous exécutez des simulations, pendant que l'agent rédige vous lisez l'onglet Replies, et après qu'une conversation est résolue, Smart QA et Smart CSAT la notent. Chaque couche répond à une question différente, ce qui compte pour le widget plus bas.
De quels plans et modules Front a-t-elle besoin ?
Compass lui-même est gratuit, mais ce qu'il évalue ne l'est généralement pas. Le billet de lancement de Front indique que les agents externes sont disponibles sur tous les plans, qu'Autopilot est un module à l'usage sur tous les plans, et que Compass fonctionne pour les deux sans frais supplémentaires. Utiliser Compass avec Autopilot nécessite le module Autopilot.
| Élément | Ce que dit Front | Source |
|---|---|---|
| Agents externes (Claude, Codex, Sierra et autres) | Disponibles sur tous les plans | billet de lancement de Front |
| Agents Autopilot | Module à l'usage sur tous les plans, à partir de 0,05 $ par conversation | tarifs de Front |
| Compass (Simulations, Performance, Replies) | Pas de frais supplémentaires, module Autopilot nécessaire pour les agents Autopilot | article Compass |
| Smart QA et Smart CSAT | Inclus dans le dernier plan Enterprise sans surcoût | article Smart QA |
| Siège Enterprise | 105 $ par siège et par mois, facturé annuellement | tarifs de Front |
L'article Smart QA ajoute un essai Enterprise de 30 jours pour les équipes sur d'autres plans, lancé depuis le modèle de règle. Ce que la documentation ne dit pas, c'est si un client Professional qui ajoute Autopilot obtient des notes Smart QA sur les réponses de l'IA. L'article Compass dit que Smart QA s'active automatiquement pour les agents IA, et l'article Smart QA dit que c'est une fonctionnalité Enterprise, donc demandez à Front avant de budgéter autour de ça. Mon billet tarifs de Front a les chiffres par siège, et Front AI couvre la gamme de produits plus large.
Comment fonctionnent les simulations Front ?
Vous construisez un set de conversations de test, donnez des critères à chacune, puis les exécutez. Un set est un groupe nommé de simulations liées que vous réexécutez comme référence après chaque changement, selon l'article Compass. Les étapes :
- Ouvrez l'agent, sélectionnez Simulations et cliquez sur Create set. Nommez-le et choisissez éventuellement une grille Smart QA.
- Cliquez sur Create simulation. Choisissez une conversation ouverte récente dans les boîtes sélectionnées, ou saisissez un ID de conversation ou de ticket.
- Ajoutez des critères de simulation, puis cliquez sur Create and run.
- Pour de nombreuses conversations à la fois, collez des ID séparés par des virgules. Chacun devient sa propre simulation, et Run set les exécute toutes.
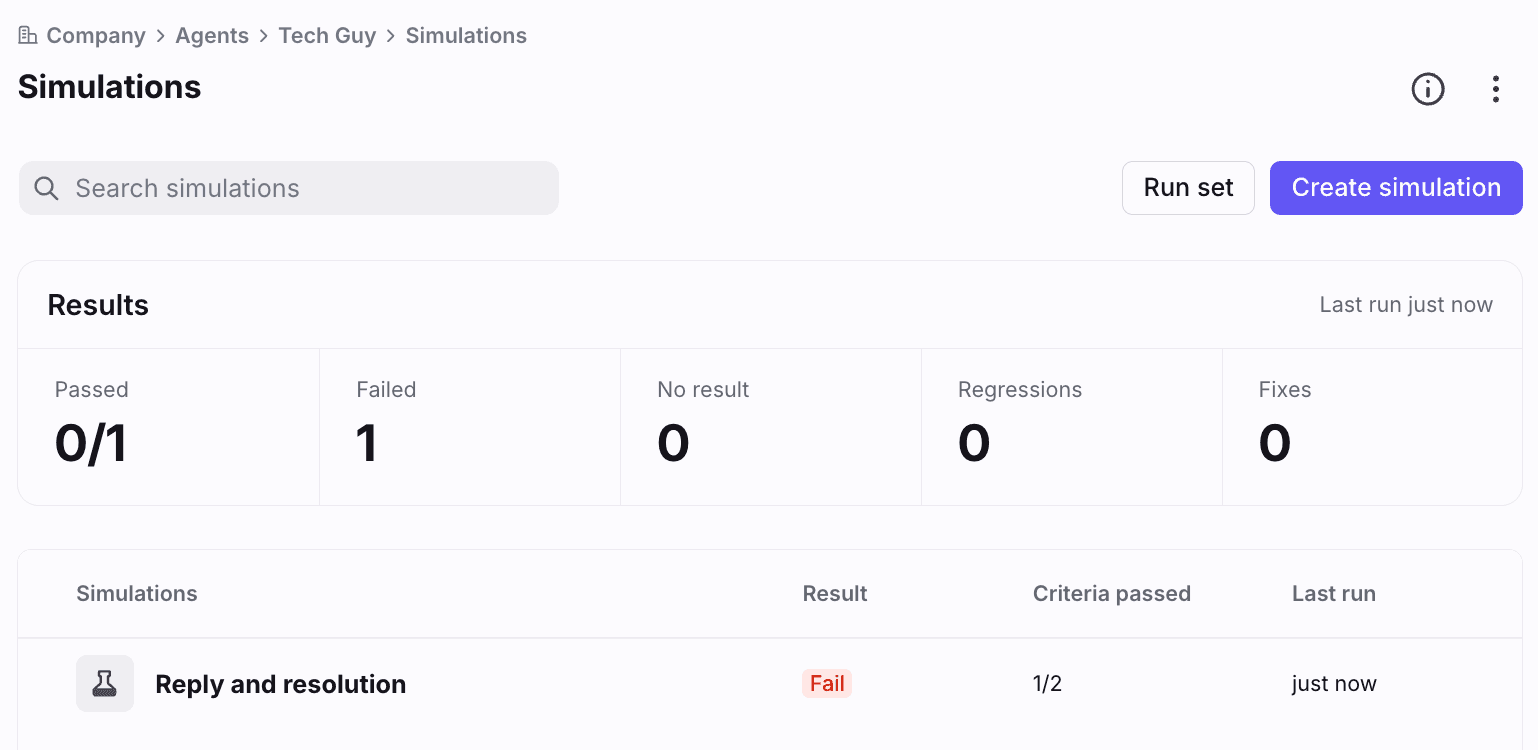
Le panneau de résultats ci-dessus compte les réussites, les échecs, l'absence de résultat, les régressions et les corrections. L'article d'aide de Front indique que chaque conversation s'exécute contre l'agent avec un client simulé, limitée à 10 échanges, et que les exécutions sont illimitées. Rien n'atteint un vrai client, aucune conversation en direct ne change, et les analyses restent intactes.
Les critères sont là où se trouve le travail. Vous écrivez un nom et une description du comportement attendu, cliquez sur Generate scale pour obtenir des conditions de réussite et d'échec, et un validateur signale tout ce qui est vague, regroupé ou invérifiable jusqu'à ce que ça devienne "Good definition". Front suggère trois critères de départ : l'agent n'affirme jamais avoir fait une action qu'il n'a pas faite, il escalade quand il le faut, et il n'escalade pas quand il ne le faut pas. Ce sont les trois mêmes défauts que je mettrais dans le premier set de test de n'importe quel agent de support.
Que peut voir une simulation Front, et que ne peut-elle pas voir ?
C'est la limite qui compte le plus. Une simulation juge le comportement à partir de preuves visibles, et l'article Compass liste ce que sont ces preuves. Le validateur peut voir les messages envoyés, les notes internes, les tags, les déplacements de boîte, l'attribution, le statut du ticket, les appels de connecteur et comment la conversation s'est terminée. Il ne peut pas voir le contenu ou l'ordre d'un Playbook, le corps d'un article de connaissance, les champs personnalisés, les fiches de contact, les brouillons ou les pièces jointes.
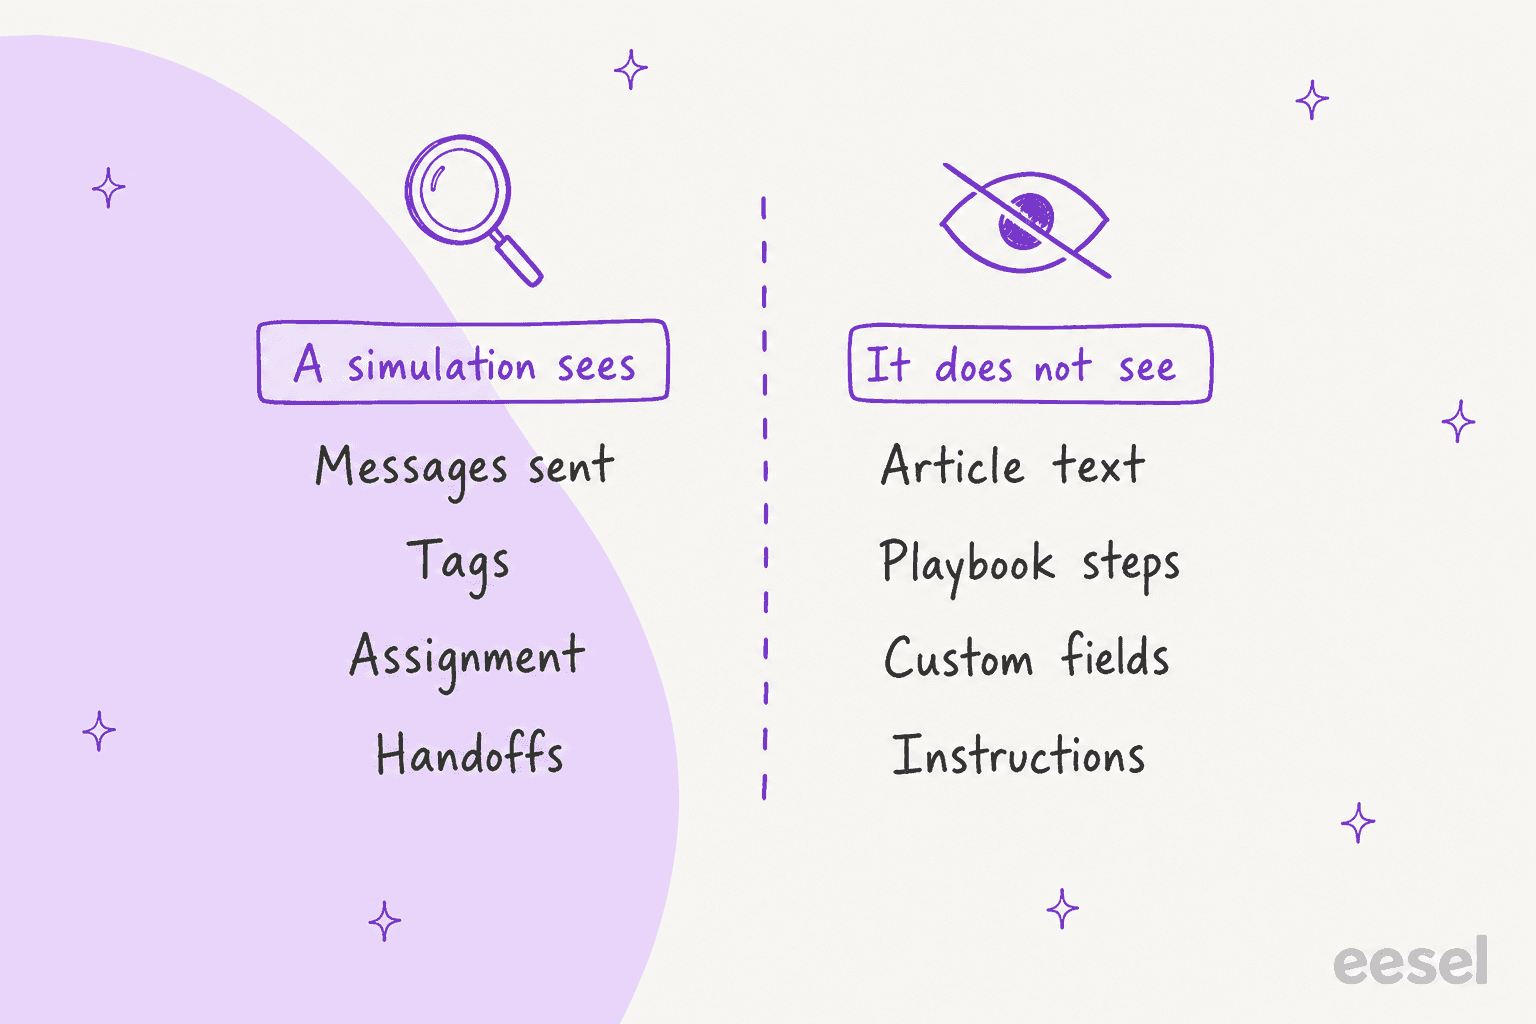
Les instructions de l'agent, les lignes directrices et les réglages de ton sont aussi cachés, sauf si l'agent s'y réfère sans les énoncer. La FAQ de Front dit clairement que les critères ne peuvent pas vérifier les réponses contre des sources de connaissance ou des Playbooks, donc son conseil est d'écrire des critères basés sur le comportement et de lire la transcription pour l'exactitude. Une simulation réussie prouve que l'agent s'est comporté comme vous l'avez décrit, pas que sa réponse était correcte. L'article classe le ton et le formatage comme le travail de la grille Smart QA et dit de les garder hors des critères.
Pour une question de remboursement, cela veut dire que "escalade vers une personne quand le client demande un remboursement" est un bon critère, et que "cite la bonne fenêtre de 30 jours" n'est pas testable, parce que le texte de l'article est invisible pour le validateur. Le second, vous le repéreriez en lisant la transcription, et mon guide sur l'adversarial testing ainsi que les entrées du glossaire sur AI hallucination et AI grounding expliquent pourquoi cette lecture compte.
Comment lire le résultat d'une simulation ?
Vous ouvrez une simulation, et vous obtenez la transcription, les critères et un verdict. L'article de Front indique que la vue détaillée montre un aperçu de conversation et des résultats, avec l'historique des exécutions et des réexécutions dans le menu à trois points, et des flèches qui comparent l'exécution actuelle aux précédentes pour montrer progrès ou régressions.
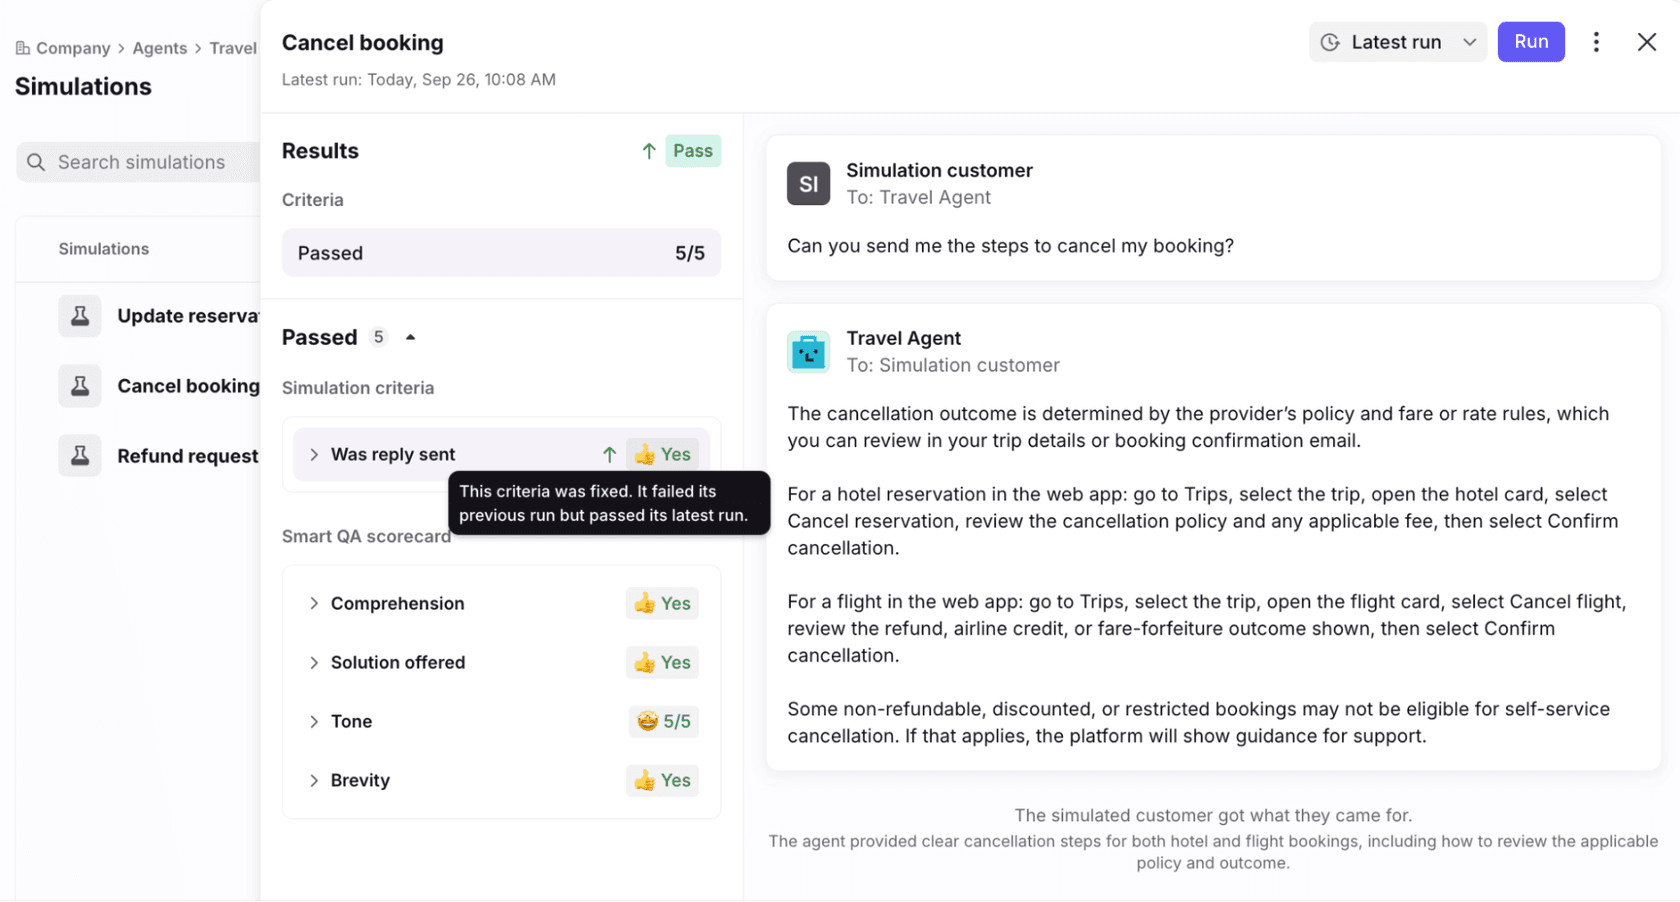
Sur la capture, un critère qui a échoué à la dernière exécution et réussi à celle-ci porte une infobulle disant qu'il a été corrigé, et la grille Smart QA est attachée en dessous. C'est la boucle pour laquelle Front conçoit : changer les instructions ou la connaissance, réexécuter le même set, et surveiller à la fois les régressions et les corrections. Smart QA n'évalue que les réponses, donc si l'agent reste correctement silencieux et escalade, la grille ne s'applique pas, mais vos critères si.
Que mesure Compass une fois l'agent en direct ?
Compass note chaque réponse comme Pas de signal, Bonne, Correcte ou Mauvaise, construite à partir de cinq signaux. L'article Compass les nomme :
- Smart CSAT. S'exécute automatiquement sur les réponses IA dans les conversations résolues et déduit la satisfaction. Les coéquipiers humains ne sont pas évalués par cette voie.
- Smart QA. S'exécute 24 heures après la résolution sur les réponses IA, avec une grille par défaut de Concision, Ton, Solution proposée et Compréhension.
- Niveau d'édition du brouillon. Détecte si un brouillon IA a été envoyé tel quel, légèrement édité, fortement édité ou abandonné.
- Retour des coéquipiers. Pouce levé ou baissé sur les brouillons et les réponses, avec des détails optionnels que seuls les admins peuvent voir.
- Retour déduit. L'IA de Front déduit un signal à partir des corrections ou des éditions lourdes.
L'onglet Performance réunit tout cela avec des métriques de résolution et d'implication et une liste appelée Opportunities. Front dit que cela aide à juger si un agent est assez sain pour élargir sa couverture ou passer des brouillons aux réponses automatiques, et ce qu'il faut corriger en premier.
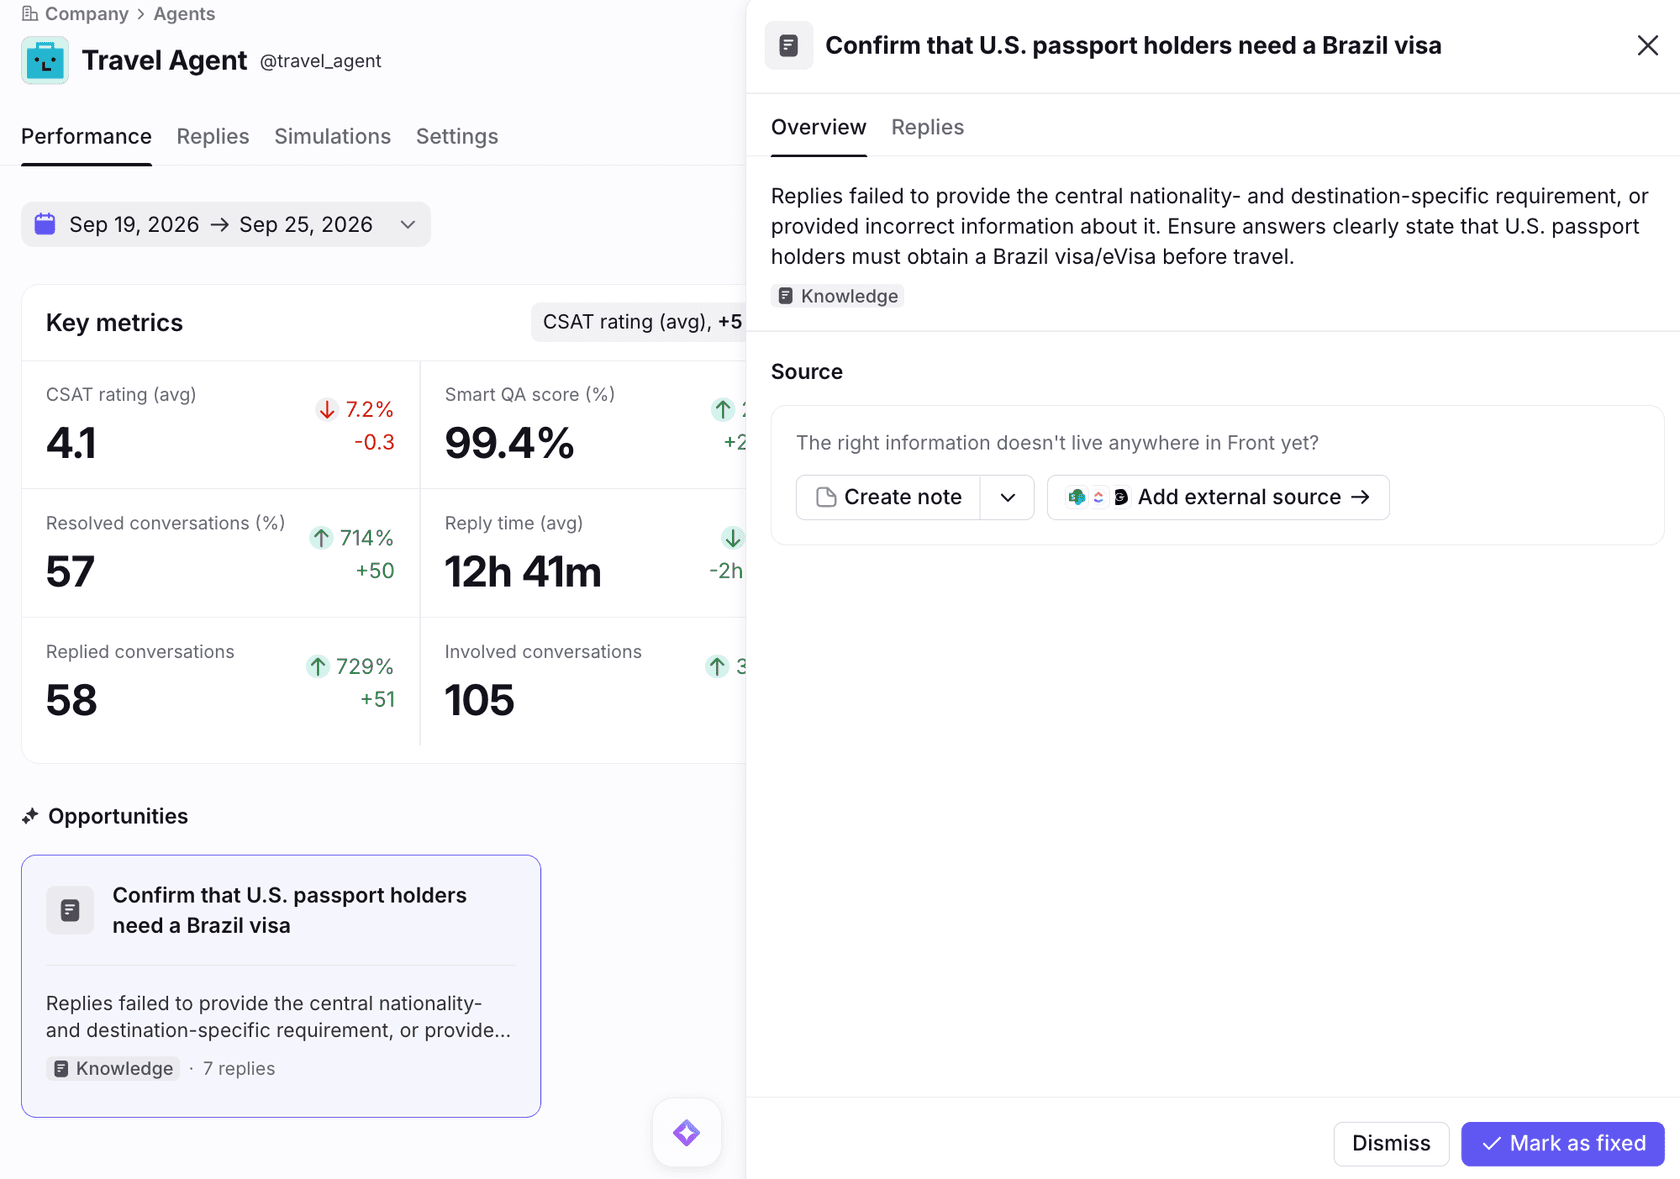
Une Opportunity montre un résumé, un type de lacune et le nombre de réponses concernées, et la correction suggérée pointe en général vers la connaissance ou les instructions de l'agent. Dans l'exemple de Front, les réponses sur une exigence de visa pour le Brésil étaient fausses, et le panneau propose de créer une note ou d'ajouter une source externe. L'onglet Replies liste chaque brouillon et réponse automatique avec des filtres par boîte, type de réponse, sujet et signal, et montre les sources derrière chacun. Si vous vous appuyez sur CSAT comme métrique principale, rappelez-vous qu'il est déduit ici, et mon billet AI CSAT explique jusqu'où lui faire confiance.
Les articles Smart QA et Smart CSAT de Front fixent les limites. Seules les conversations de boîte partagée comptent, chacune nécessite au moins un message entrant et un sortant, et la conversation doit être Resolved ou Archived. L'anglais est la seule langue officiellement prise en charge. Les règles ne sont pas rétroactives, donc l'historique antérieur à l'existence d'une règle n'est pas noté. Front rapporte environ 99 % de précision sur le contenu factuel pour Smart QA et environ 90 % d'alignement avec le CSAT client pour Smart CSAT, qui sont les propres chiffres de Front.
L'évaluation fonctionne-t-elle pour des agents externes comme Claude ou Sierra ?
En partie. Le billet de lancement de Front dit que Compass évalue chaque conversation traitée par des agents sur Autopilot ou chez un autre fournisseur, et que Compass est gratuit pour les deux. L'article Compass dit que le test des agents, l'onglet Simulations, est réservé aux agents Autopilot, et pour les agents externes les sources de l'onglet Replies sont la connaissance transmise via le MCP. Un agent externe obtient donc une notation en direct, mais vous le testez avec votre propre système avant de le connecter. Le billet de lancement de Front cite un client, Next Level Sports, disant que Compass donne à ses équipes support et ingénierie un seul endroit pour revoir les réponses IA et mesurer la qualité.
Quel outil Front répond à quelle question ?
Choisissez la question que vous essayez de répondre, et l'outil change. Ce widget est mon propre résumé des articles de Front, donc la dernière ligne de chaque panneau indique où lire le détail.
Rule testing est l'exception, c'est pour ça que je le liste. L'article rule testing de Front vérifie si une conversation passe les conditions et actions d'une règle, sur n'importe quel plan, avec l'option de construire une conversation simulée de zéro. Cela vaut la peine de l'exécuter sur la règle qui assigne les conversations à votre agent, comme l'explique mon billet Front load balancing pour les limites d'attribution.
Comment déployer un agent IA Front avec ces outils ?
Commencez par des brouillons, testez par sets, et n'élargissez que quand les signaux s'accordent. L'article sur les agents Autopilot de Front décrit un agent rédacteur qui crée des brouillons sur les nouvelles conversations, configuré avec des consignes de rédaction uniquement et une règle construite à partir du modèle Assign to AI agent. À partir de là :
- Construisez un set de 15 à 20 conversations. Mélangez des questions simples, des demandes de remboursement, des clients fâchés et des choses que l'agent devrait refuser. Front dit qu'un échantillon varié donne une couverture plus large, et je puiserais dans votre dernier mois de trafic réel.
- Ajoutez les trois critères de départ. N'affirme jamais avoir fait une action qu'il n'a pas faite, escalade quand il le faut, n'escalade pas quand il ne le faut pas.
- Exécutez, lisez chaque transcription, corrigez, réexécutez. Surveillez les flèches de régression après chaque changement d'instructions ou de connaissance.
- Passez en direct comme agent rédacteur. Vérifiez l'onglet Replies pour le niveau d'édition du brouillon et les pouces des coéquipiers, pas seulement le score moyen.
- Faites passer les sujets aux réponses automatiques un par un. Utilisez l'onglet Performance et la liste Opportunities pour décider, et gardez règles et objectifs de temps comme tableau de bord. Mes billets Front time goal rules et SLA best practices couvrent ce volet.
Le comportement de transfert mérite ses propres critères. Si l'agent escalade, la conversation doit arriver à la bonne personne avec du contexte, ce que mes billets AI agent handoff best practices et AI escalation détaillent. Le glossaire a des entrées sur escalation rate et AI guardrails.
Que ne dit pas la documentation de Front sur l'évaluation des agents IA ?
Pas mal de choses, et chaque lacune est quelque chose que je demanderais à Front ou que je testerais avant de m'y fier.
- Restriction de plan pour Smart QA sur les réponses IA. Inclus dans Enterprise selon un article, activé automatiquement selon un autre, et aucune page ne réconcilie cela pour un client Professional avec Autopilot.
- Si les simulations appellent des systèmes en direct. Le validateur peut voir les appels de connecteur, mais la documentation ne dit pas si une exécution simulée touche de vrais outils ou des outils isolés.
- Un seuil de réussite. Il n'y a pas de taux de réussite ou de taille de set suggérée au-delà de "utiliser un échantillon varié".
- Comparaison avec ce qu'a envoyé votre équipe. Les critères décrivent le comportement. L'article ne décrit pas de notation contre la réponse qu'une personne a réellement écrite sur cette conversation.
- Langues dans Compass. L'article Compass n'en dit rien. Les articles Smart QA et Smart CSAT disent que seul l'anglais est officiellement pris en charge.
- Export ou accès API. Je n'ai trouvé aucune mention d'export des résultats de simulation ni d'exécution de sets via l'API.
- Voix extérieures. Le billet Compass de Front dans la communauté avait 0 réponse et 122 vues quand je l'ai lu, donc je n'ai pas encore d'avis de praticien à citer.
Rien de tout cela ne fait de Compass un outil faible. Un simulateur basé sur des critères avec validateur, historique d'exécutions et flèches de régression est un vrai système de test. C'est une conception différente du rejeu de l'historique, qui est la comparaison qui m'intéresse ensuite.
Comment eesel teste-t-il un agent IA avant qu'il ne réponde aux clients Front ?
eesel teste contre vos propres conversations passées, et Front teste contre des critères que vous écrivez. Les deux sont complémentaires, et je ne choisirais pas l'un pour cette seule raison. La simulation eesel rejoue des tickets passés avec l'envoi désactivé, rédige une réponse pour chacun, la compare à ce que votre équipe a réellement envoyé, regroupe les résultats par thème et classe les corrections par impact. Le rapport sépare les correspondances, les correspondances partielles, les transferts corrects et les échecs nets. L'exemple de la propre documentation d'eesel compte 20 tickets résolus, dont 17 correspondent à la qualité de réponse de l'équipe.
| Simulations Front Compass | Simulation eesel | |
|---|---|---|
| Ce qui est testé | Comportement contre des critères que vous écrivez | Réponses contre ce que votre équipe a réellement envoyé |
| Entrée de test | ID de conversation de vos boîtes | Tickets passés, ou cas générés sans helpdesk |
| Côté client | Client simulé, 10 échanges maximum | Une réponse rédigée par ticket passé |
| S'applique à | Agents Autopilot uniquement | L'agent eesel |
| Envoie aux clients | Non | Non |
| Après une exécution | Réexécuter le set, lire les flèches | Corrections enregistrées comme règles en phrases simples, puis réexécuter |
Le client simulé multi-tours de Front est ce que le rejeu d'eesel ne reproduit pas, et la propre page de simulation d'eesel dit que les chats multi-tours avec des personas joués par IA sont mieux servis par le propre simulateur d'un helpdesk. À l'inverse, l'article de Front ne décrit pas de vérification d'une réponse contre une réponse de référence, ce qui est là où le rejeu de l'historique aide.
La partie gagnée, pour moi, est l'ordre du déploiement. eesel fait tourner de l'IA sur des files de support en direct depuis des années, et l'habitude qui est restée, c'est que rien ne répond à un client avant d'avoir été rejoué sur le propre historique de cette équipe puis rédigé sur des tickets en direct pendant une à deux semaines. Norden-Frisia, une compagnie de ferries allemande, a utilisé une semaine d'essai avec les trois derniers mois de tickets et de macros avant de s'abonner. Textla a commencé par un essai où eesel ne laissait que des notes internes pour que l'équipe voie ce qu'il aurait dit, et Innr vérifie encore chaque brouillon et travaille vers des réponses autonomes pour un ensemble choisi de sujets. Aucun des trois n'utilise Front, donc lisez cela comme la même méthode sur d'autres helpdesks.
Sur Front, les documents d'intégration d'eesel listent des déclencheurs pour un message client, un premier message, une mention @eesel et une conversation archivée, avec des actions pour répondre, laisser un commentaire interne, taguer, assigner, mettre à jour des champs et archiver. La documentation recommande de commencer par des commentaires internes et ne décrit pas de simulation spécifique à Front, donc j'exécuterais le rejeu sur un petit lot et je lirais le rapport. La CLI aide dans cette boucle. eesel files upload ./refund-policy.pdf ajoute de la connaissance approuvée, eesel chat "what's our refund policy?" teste une réponse, eesel approvals liste les actions en attente, et --dry-run montre un aperçu d'une écriture. La documentation de la CLI ne mentionne pas de simulations, donc ces exécutions se font dans le dashboard.
Essayez eesel dans votre boîte Front
Si vous voulez la version de ce processus centrée sur le rejeu, eesel rejoint votre boîte partagée Front comme coéquipier IA de helpdesk. Il lit votre centre d'aide et vos conversations passées, rédige des réponses sous forme de commentaires internes, et peut taguer et assigner, donc votre équipe revoit de vrais brouillons avant que rien ne soit envoyé. Exécutez la simulation sur votre propre historique, gardez vos règles et objectifs de temps comme tableau de bord, et élargissez vers des réponses directes une fois que les brouillons correspondent à ce qu'écrirait une personne. Les plans payants commencent à 299 $ par mois pour 500 crédits, et il existe un plan gratuit avec 100 crédits pour l'essayer sur quelques vraies conversations (tarifs eesel).
Pour la configuration, voir mon guide adding AI to Front, le comparatif best AI for Front et Front vs eesel. Pour comparer les outils, voir mon Front review et Front alternatives. Pour le reste de la configuration Front, Front ticket status rules, Front shared inbox ownership et Front required resolution fields montrent où atterrit le travail d'un agent, et le glossaire explique shared inbox, support quality assurance et resolution rate. Try eesel sur quelques vraies conversations avant de décider.
Comment évaluer l'agent IA de Front avant sa mise en ligne ?