

Pourquoi un audit de préparation à l'IA n'est pas un nettoyage de contenu
Je construis les agents IA chez eesel, donc je lis les centres d'aide comme le fait l'agent : comme un tas de texte découpé en morceaux et recherché par le sens. Zendesk décrit clairement le processus dans sa documentation. Le contenu de connaissances est découpé en fragments, chaque fragment est stocké avec un vecteur numérique, et les fragments qui correspondent le mieux servent à rédiger la réponse. Le modèle ne lit jamais votre centre d'aide comme le ferait une personne. Il lit les fragments qui ont obtenu le meilleur score pour cette question précise.
Cela change le sens de « bon contenu ». Une personne passe devant l'article périmé parce qu'elle sait qu'un plus récent existe. Un système de recherche n'a pas ce jugement : si les deux correspondent, les deux peuvent être utilisés. C'est le cœur de la génération augmentée par récupération, et c'est pourquoi un centre d'aide qui fonctionne bien pour les personnes peut tout de même produire une mauvaise réponse d'IA.
J'ai vu cela mal tourner sur de vrais comptes. Une équipe de support technique B2B m'a dit que son centre d'aide indiquait « nous prenons en charge tous les modèles », et que son bot avait déjà répondu oui pour une marque absente de sa base de données. Des clients payants ont aussi vu des bots répondre à partir de connaissances générales lorsque la recherche ne trouvait rien de pertinent. Ce sont des problèmes de connaissances avant d'être des problèmes de modèle, et il est moins coûteux de les trouver avant la mise en production. Cet article couvre la vérification de préparation à l'IA. Pour le nettoyage général garder, fusionner ou archiver, j'ai écrit un guide séparé sur l'audit de la base de connaissances du support.
Les quatre façons dont une base de connaissances fait mal répondre une IA
Chaque mauvaise réponse que je remonte aboutit à l'une de quatre causes. Les nommer accélère l'audit, car chacune a un test différent et une correction différente.
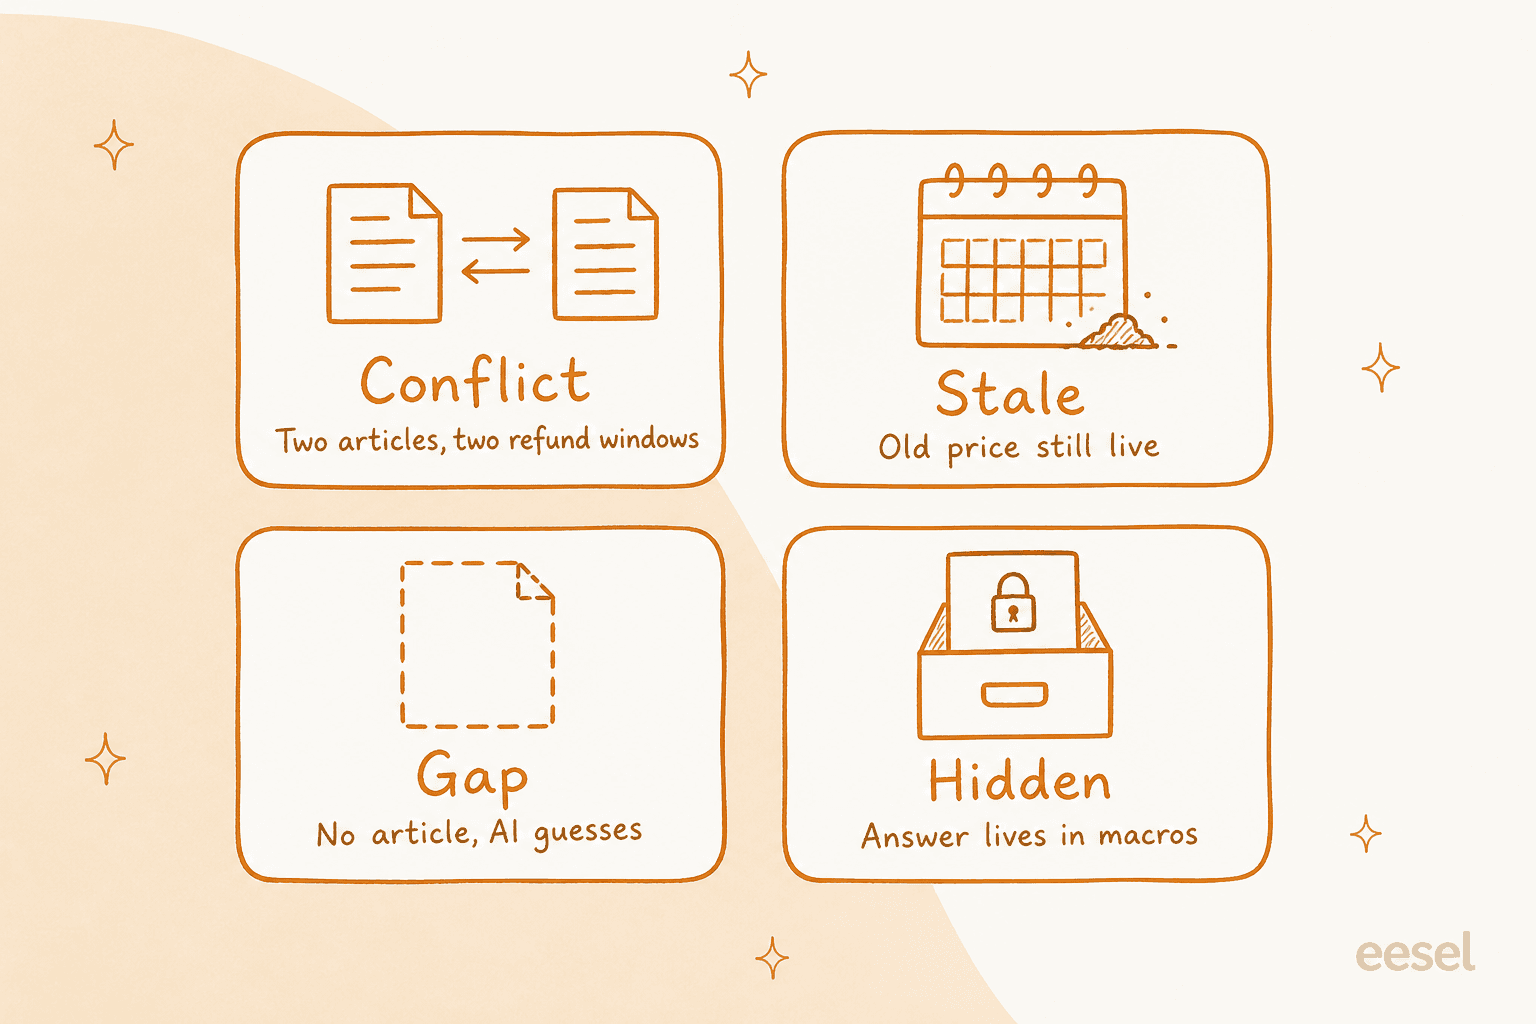
Les quatre défaillances, dans l'ordre où je les vérifie : deux articles en désaccord, un fait qui a vieilli, un sujet sans article et une réponse qui se trouve là où l'IA ne peut pas la lire.
Conflit. Deux articles donnent des réponses différentes. Gorgias utilise un exemple dans sa propre documentation : si un article du centre d'aide indique un délai de retour de 30 jours et qu'une entrée de guidance indique 14, l'agent peut ne pas répondre de la même façon à chaque fois (documentation de Gorgias). L'IA n'est pas perdue. Elle a récupéré les deux, et rien ne lui a dit lequel l'emporte.
Périmé. L'article a été juste un jour. Les prix, noms de forfaits, heures limites d'expédition et noms de fonctionnalités vieillissent le plus vite, et une ligne périmée est répétée avec une confiance totale. Les règles de vérification des articles de Zendesk existent pour cela : jusqu'à 20 règles qui remettent les articles à « non vérifié » selon un calendrier, pour qu'un responsable doive les reconfirmer.
Lacune. Aucun article ne couvre la question. Un agent bien configuré transmet. Un agent mal configuré comble le silence avec des connaissances générales. Gorgias note que lorsqu'un sujet n'est pas couvert, l'agent transmet souvent la conversation à votre équipe, ce qui est sûr mais coûteux si le sujet est à fort volume.
Caché. Votre équipe connaît la réponse, mais elle se trouve dans des macros, un wiki interne, une vidéo Loom ou dans la tête d'un agent expérimenté. Je l'ai entendu d'une marque DTC qui voulait automatiser environ la moitié de son volume d'e-mails alors que ses connaissances se trouvaient dans des outils de SOP, des vidéos non transcrites et d'anciennes macros. Une IA ne peut répondre qu'à partir de ce que vous connectez, et la partie connectée était la plus mince.
Utilisez le widget ci-dessous sur n'importe quel article dont vous doutez. Il indique à quoi ressemble la défaillance, comment la trouver et la règle que j'applique avant la mise en production.
Quelle défaillance est cet article ?
Choisissez le type de défaillance pour voir comment la trouver et la règle de mise en production que j'utilise.
Cliquez sur chaque type de défaillance pour voir à quoi elle ressemble, comment la trouver et la règle que je vérifie avant la mise en production.
Auditez par ordre de risque, pas par ordre alphabétique
L'erreur habituelle est d'auditer tout le centre d'aide de façon uniforme. Une mauvaise réponse sur les horaires du magasin et une mauvaise réponse sur les remboursements ne coûtent pas la même chose, donc je classe les sujets selon deux critères : combien de tickets ils génèrent et ce que coûte une mauvaise réponse. Je place les remboursements, retours, résiliations et paiements dans le niveau supérieur.
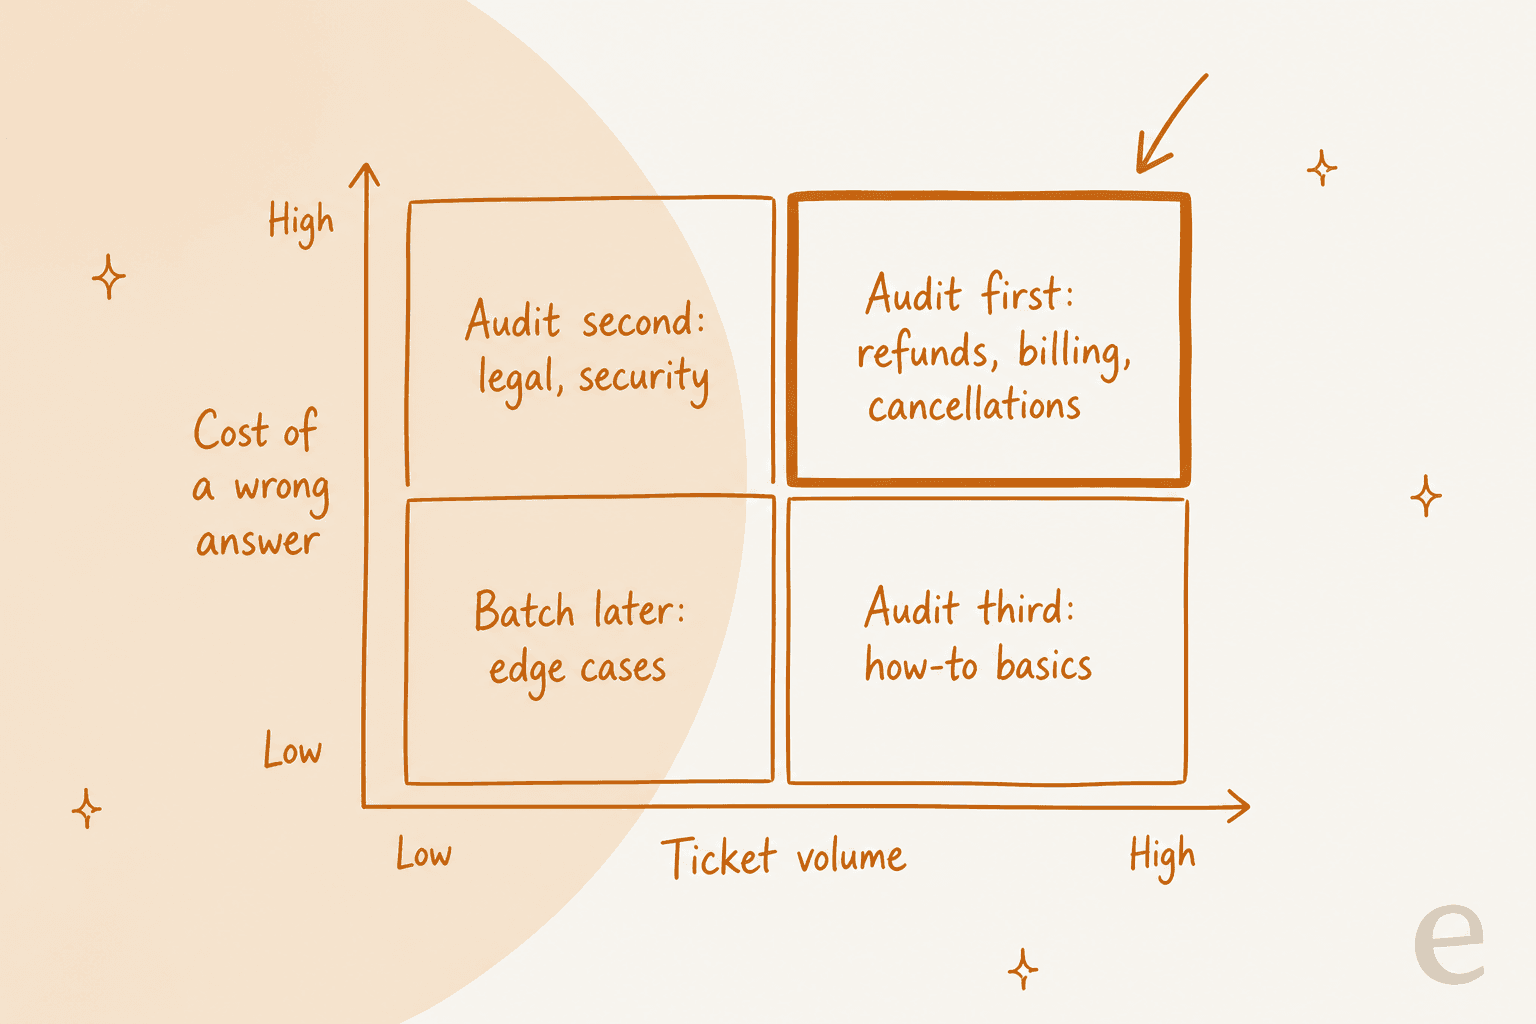
Ordre d'audit selon le coût d'une mauvaise réponse et le volume de tickets : les sujets d'argent d'abord, le juridique et la sécurité ensuite, les bases pratiques en troisième, les cas limites regroupés plus tard.
| Niveau | Sujets | Ce que je vérifie | Seuil typique de mise en production |
|---|---|---|---|
| 1 : argent | Remboursements, retours, résiliations, facturation, échecs de paiement | Conflits, chiffres périmés, exceptions, qui peut approuver | Zéro mauvaise réponse en test |
| 2 : risque | Conditions légales, sécurité, confidentialité, accès au compte | Formulation validée par le bon responsable, transmission claire | Zéro mauvaise réponse, escalade en cas de doute |
| 3 : volume | Expédition, abonnements, bases pratiques, dépannage | Exactitude, exhaustivité, langage simple | La plupart des réponses correctes, le reste escalade proprement |
| 4 : queue | Cas limites, questions rares sur le produit | Regrouper plus tard, utiliser la transmission en attendant | La transmission est acceptable |
Pour le niveau 1, je lis aussi les règles de remboursement comme le ferait un agent. Qui peut approuver une exception, à partir de quel montant, et quelle est la formulation exacte ? Mon article sur la matrice d'approbation des remboursements l'explique, et le guide sur l'IA pour les demandes de remboursement couvre ce qu'il faut automatiser. Si une réponse de niveau 1 demande un jugement, réglez le sujet sur transmission plutôt que réponse. Rúngne fait exactement cela : son équipe choisit les sujets auxquels l'IA répond directement, comme la politique et le suivi, et garde les résiliations, articles endommagés et colis perdus pour les humains. Déplacer un sujet d'un côté à l'autre est une modification de liste, pas un projet. Leur configuration est décrite dans l'histoire de Rúngne.
Comment l'IA de chaque helpdesk lit vos connaissances
C'est la partie que la plupart des audits sautent. Avant de corriger un article, vous devez savoir si l'IA peut le voir et à quel point sa copie est récente. J'ai lu la documentation de chaque éditeur pour cela (toutes les pages modifiées ou mises à jour en septembre et octobre 2026), et les différences comptent.
| IA du helpdesk | Ce qu'elle lit | Fraîcheur | Ce qu'il faut vérifier |
|---|---|---|---|
| Zendesk AI agents | Centres d'aide Zendesk, crawler web, connecteurs de connaissances (jusqu'à 50 sources externes) | Centre d'aide interrogé en direct. Sources externes telles qu'à la dernière synchronisation, généralement toutes les 24 heures. Le crawler se rafraîchit toutes les 30 minutes, Confluence toutes les 24 heures | Les articles restreints n'atteignent que les clients authentifiés. Trop de sources peuvent réduire la précision et ajouter de la latence |
| Freshdesk Freddy AI Agent | URL, fichiers, articles de solutions publics, Q&R personnalisées, applications Google Drive et SharePoint | Resynchronisation manuelle, horodatage de la dernière synchronisation. Modifications SharePoint environ toutes les 15 minutes | Articles publics uniquement. Les URL protégées, articles privés et textes dans des images ou tableaux sont ignorés |
| Gorgias AI Agent | Guidance, articles du centre d'aide, site de la boutique, URL publiques, documents | La resynchronisation du site web et des URL est manuelle, une fois toutes les 24 heures | Pages publiques uniquement. Les PDF intégrés, vidéos et images ne sont pas extraits. Les brouillons ne sont pas utilisés dans les réponses en direct |
| Help Scout Scout | Site Docs, pages web, PDF, fichiers Word et Excel, sources texte | Docs reste synchronisé. Les sites web nécessitent une resynchronisation manuelle | Choisissez des pages précises, pas des sites entiers. Les fichiers Google doivent être partagés par lien |
| HubSpot Customer Agent | Articles et pages HubSpot, URL publiques (jusqu'à 5 000 liées), fichiers | Les articles HubSpot se resynchronisent à la modification. Autres sources chaque semaine | Les sources privées ne sont pas citées mais peuvent tout de même influencer les réponses |
Zendesk. La documentation de Zendesk indique qu'un centre d'aide connecté est interrogé au moment de la question, tandis que les sources externes sont telles qu'à la dernière synchronisation, généralement toutes les 24 heures. La leçon pratique est qu'une modification dans un wiki externe n'est pas en ligne avant un jour, et que le crawler web tourne bien plus souvent que le connecteur Confluence. Les articles restreints du centre d'aide ne sont utilisés que lorsque le client est authentifié, et la documentation précise que vous ne pouvez pas tester les réponses à contenu restreint dans le widget de test. Si vos meilleures réponses sont derrière une connexion, votre test de lancement ne vous le montrera pas. Plus de détails dans mon aperçu de Zendesk AI.
Freshdesk. Le guide des connaissances de Freddy énumère des limites à lire avant de connecter quoi que ce soit : 10 URL par agent, jusqu'à 3 000 pages par site, 200 fichiers par agent de 35 Mo chacun, et des articles de solutions uniquement lorsqu'ils sont visibles par tous les utilisateurs. Les articles privés ou restreints sont exclus. Il propose aussi un outil d'audit utile : après une conversation, le panneau de détails indique de quelles sources l'agent a tiré ses informations. Pour Confluence, Freshdesk conseille un compte de service dédié, car si l'administrateur qui a fait la configuration perd son accès, ces articles sont traités comme supprimés. Voir les sources de connaissances de Freddy et l'intégration eesel pour Freshdesk.
Gorgias. Gorgias indique que la guidance a le plus de poids parmi ses types de connaissances, ce qui en fait le premier endroit où chercher des conflits avec votre centre d'aide. Les synchronisations du site de la boutique et des URL ne concernent que les pages publiques, ne se rafraîchissent pas automatiquement et peuvent être relancées une fois toutes les 24 heures. Les extraits tirés d'un site web ne peuvent pas être modifiés, mais peuvent être désactivés s'ils contiennent un contenu périmé. Sa fonction Opportunities (bêta) fait remonter des lacunes et conflits à partir de vraies conversations, un raccourci pratique. Plus de détails dans l'analyse de Gorgias AI Agent 2.0.
Help Scout. Scout, l'agent issu d'AI Answers, reste synchronisé en permanence avec votre site Docs, mais les sources de sites web nécessitent une resynchronisation manuelle lorsque les tarifs ou un processus changent. Help Scout conseille aussi de le pointer vers les pages précises contenant vos meilleures informations plutôt que vers un site entier, et précise que les images et vidéos ne doivent pas porter seules les étapes clés. Détails dans l'IA pour Help Scout et l'intégration eesel pour Help Scout.
HubSpot. Le Customer Agent resynchronise les articles de la base de connaissances lorsqu'ils sont modifiés et les autres sources chaque semaine. La ligne à lire deux fois concerne le contenu privé : les sources privées ne seront pas citées, mais leur contenu peut tout de même apparaître dans les réponses. Cela fait du « caché » un risque plus subtil, car un document interne que vous avez connecté comme référence peut quand même laisser fuiter sa formulation. Voir HubSpot AI agent pour une vue plus large.
Vérifiez la couverture sur de vrais tickets
Lire les articles vous dit s'ils sont justes. Les tickets vous disent si ce sont les bons articles. Je récupère les tickets des 90 derniers jours et je les regroupe par sujet, puis j'attribue à chaque sujet l'une de quatre marques.
- Couvert. Un article existe, est à jour et concorde avec ce que les agents répondent réellement.
- Partiel. Un article existe mais répond à une question voisine, ou omet l'exception que les agents mentionnent toujours.
- En conflit. Deux sources se contredisent, ou l'article contredit ce que les agents envoient en pratique.
- Manquant. Pas d'article. Les agents répondent de mémoire ou avec une macro.
La réponse de l'agent est la preuve la plus utile ici. Lorsque vos meilleurs agents ajoutent systématiquement une phrase que l'article n'a pas, cette phrase est la lacune. Une responsable du support à qui j'ai parlé avait un centre d'aide entièrement rédigé pour des administrateurs alors que les tickets venaient d'utilisateurs finaux. Aucune lecture article par article ne le repère. La comparaison avec les tickets, si.
Classez les résultats par volume. Les sujets de niveau 1 marqués partiel ou manquant passent en haut de la liste de corrections. Côté méthodes, j'ai écrit sur le rapprochement des requêtes et des lacunes et sur le flux d'analyse des lacunes de connaissances dans Zendesk, et le déploiement plus large relève de mon guide sur les erreurs de mise en œuvre.
Constituez un jeu de tests et fixez les règles de mise en production
Fixez le seuil de réussite avant de lancer le test. Si vous le décidez après, tous les résultats paraissent acceptables.
Constituez le jeu à partir de vraies questions. Prenez 50 à 100 vrais messages de clients, pondérés vers les niveaux 1 et 2, et incluez-en quelques-uns auxquels l'IA ne devrait pas répondre : un remboursement hors politique, une question juridique, une demande nécessitant une consultation de compte. Pour chacun, écrivez à quoi ressemble une réponse correcte ou une transmission correcte, et nommez l'article source dont elle devrait provenir.
Notez quatre choses par réponse. A-t-elle récupéré la bonne source ? La réponse était-elle correcte ? Était-elle complète, exceptions comprises ? A-t-elle escaladé quand il le fallait ? Ce dernier point est le plus souvent oublié, et il se rattache à votre taux d'escalade et à votre taux de résolution autonome une fois en production.
Utilisez les outils de test de l'éditeur, dans leurs limites. Help Scout a une zone Test, et Gorgias vous permet de tester des brouillons avant publication. Le widget de test de Zendesk ne peut pas tester les réponses à contenu restreint.
Rejouez d'anciens tickets si votre outil le permet. La compétence Simulation d'eesel récupère d'anciens tickets, génère des réponses d'IA, les compare à ce que des humains ont réellement envoyé, note la correspondance et produit un rapport de lacunes. C'est ce que je connais de plus proche d'un test sur vos propres données sans qu'un client voie une mauvaise réponse. Mon article sur les tests d'agents de support IA détaille un plan plus complet.
Règles de mise en production que je recommande. Ce sont mes propres seuils, pas une norme d'éditeur, ajustez-les donc à votre niveau de risque :
- Sujets des niveaux 1 et 2 : zéro mauvaise réponse dans le jeu de tests, et chaque cas incertain est transmis.
- Niveau 3 : au moins neuf réponses sur dix correctes, et chaque erreur transmise plutôt que devinée.
- Aucun conflit ouvert au niveau 1, et chaque article de niveau 1 vérifié au cours des 90 derniers jours.
- Chaque sujet à fort volume est soit couvert, soit réglé sur l'escalade.
- Un responsable nommé pour la revue hebdomadaire après le lancement.
La boucle hebdomadaire après la mise en production
Un audit de lancement vieillit aussi vite que vos politiques. Pendant le premier mois, je fais tourner la même courte boucle chaque semaine, puis je la garde mensuelle et à chaque changement de politique.
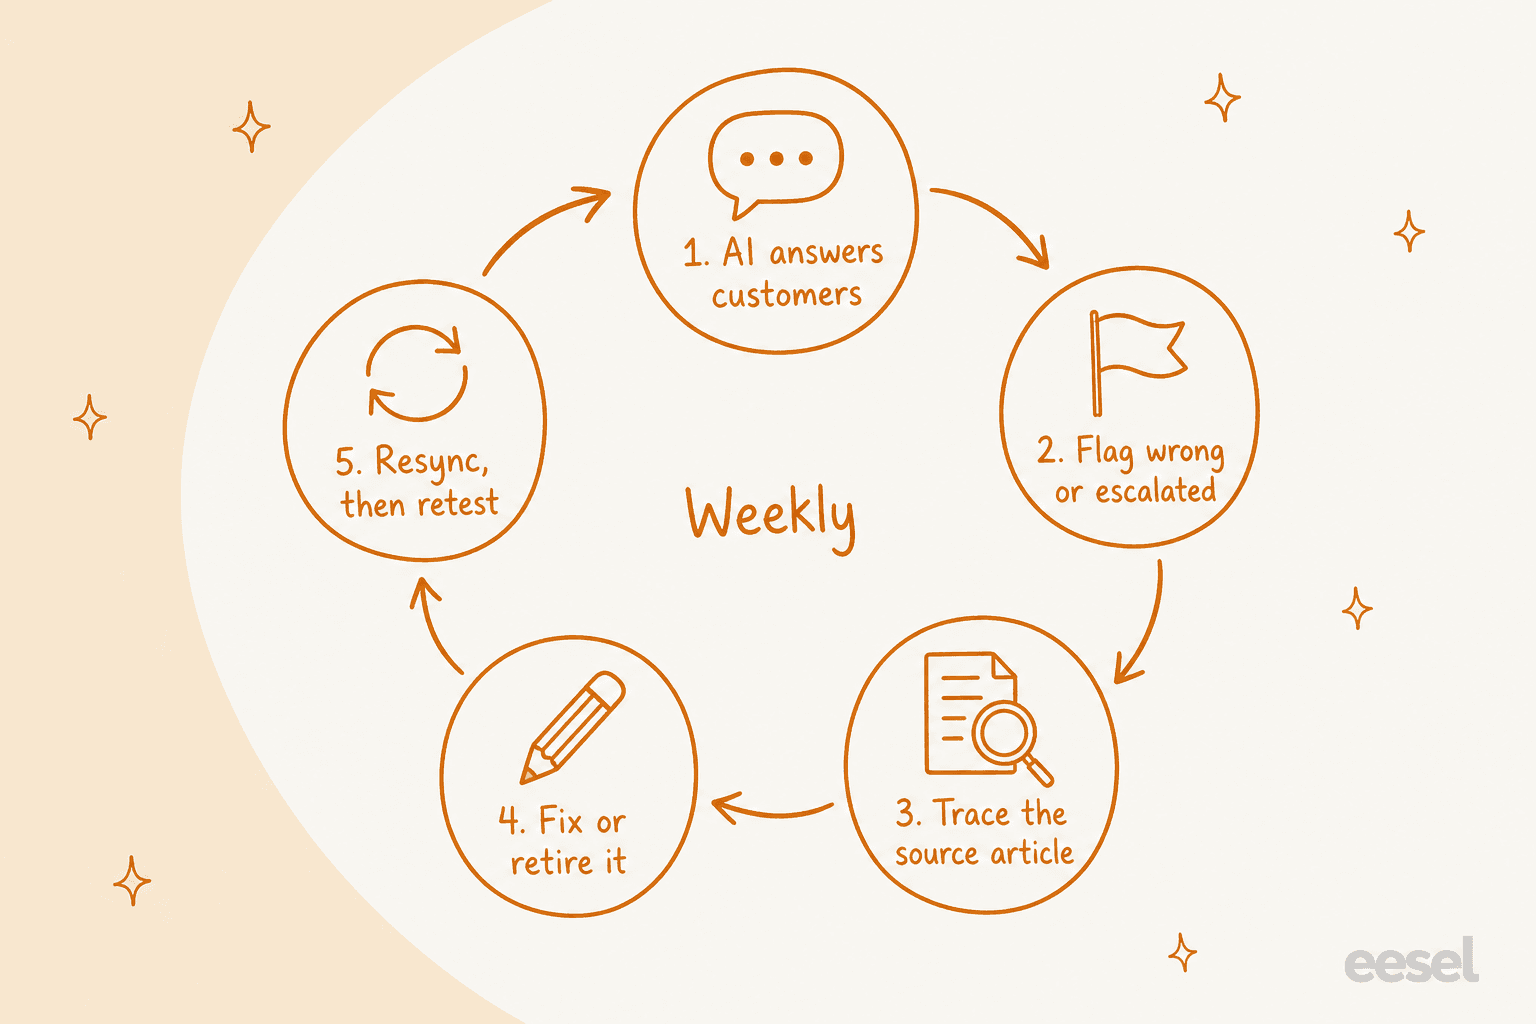
La boucle hebdomadaire : lire ce que l'IA a mal traité ou escaladé, remonter à une source, la corriger, resynchroniser, puis retester.
- Récupérez les conversations erronées et escaladées. Dans Help Scout, trier Reports > Scout par résolution fait remonter celles où les clients n'ont pas été aidés. Dans Freshdesk, les détails de la conversation montrent quelles sources ont été utilisées.
- Remontez chacune à une source. S'agissait-il d'un conflit, d'un fait périmé, d'une lacune ou d'une réponse cachée ? Utilisez les mêmes quatre étiquettes pour que le schéma apparaisse.
- Corrigez ou retirez la source. Retirer vaut mieux que rafistoler quand deux articles se chevauchent.
- Resynchronisez. C'est l'étape que l'on oublie. Une source de site web Gorgias, une source de site web Help Scout et une URL Freshdesk nécessitent toutes un rafraîchissement manuel avant que l'IA ne voie la modification.
- Retestez. Relancez les questions qui ont échoué, plus quelques-unes du niveau 1.
Les indicateurs à suivre sont dans mon guide des indicateurs du service client IA.
Comment eesel gère l'audit en pratique
Le coéquipier helpdesk IA d'eesel apprend de votre centre d'aide, de vos anciens tickets et de documents comme Confluence et Google Docs, puis travaille dans votre helpdesk existant. Deux clients nommés montrent à quoi ressemble l'audit sur le terrain.
- SamCart fait tourner des agents eesel distincts sur les tickets e-mail Freshdesk et le chat du site web, tous deux répondant à partir d'environ 280 articles du centre d'aide. Les agents ont pour consigne de ne lier que des articles publics, de sorte que d'anciens contenus internes puissent nourrir une réponse sans être envoyés à un vendeur. Lorsqu'un article décrit quelque chose qui n'est plus disponible, l'équipe ajoute une correction et l'agent cesse de le proposer. C'est la correction du périmé, sans réécrire tout l'article.
- Rúngne fait tourner trois agents sur Gorgias, répartis par tâche. L'un trie et étiquette, un autre rédige des réponses que des personnes envoient, et un troisième répond lui-même aux questions simples de politique et de suivi. Les résiliations, dommages et colis perdus restent à l'équipe. La liste des sujets est le curseur.
Le schéma est le même : décider à quels sujets l'IA peut répondre, garder l'argent et les décisions de jugement entre les mains de personnes, et faire des corrections une habitude. Mon article sur l'entraînement d'un agent de support IA et le guide de la base de connaissances IA couvrent la partie construction.
Essayer eesel
L'audit décide si votre centre d'aide est prêt. Le test décide s'il l'est assez. Si vous voulez faire ce test sur vos propres tickets, le coéquipier helpdesk IA d'eesel se connecte à Zendesk, Freshdesk, Gorgias, Help Scout ou HubSpot, apprend de votre centre d'aide et de vos anciens tickets, et peut être rejoué sur d'anciennes conversations avant de répondre à un client. La tarification dépend du forfait, et vous pouvez voir les forfaits et démarrer gratuitement.
Essayez eesel gratuitement, ou réservez une démo et je vous montrerai comment il traite vos propres tickets.
Comment auditer ma base de connaissances avant d'activer un agent IA ?