

Re:amaze n'a pas de grille d'assurance qualité IA : je n'ai rien trouvé dans son centre d'aide, sa page de tarifs ou ses actualités produit qui note une conversation selon des critères QA, et ce qui s'en rapproche le plus est la liste des réponses récentes dans l'Individual Staff Report sur Plus (69 $ par membre d'équipe et par mois). Ce qu'il offre à une responsable support, ce sont des rapports sur la rapidité et sur la fréquence à laquelle une réponse a réglé le problème (tous les plans), des rapports d'équipe et des enquêtes de satisfaction (aussi sur Plus), et une série d'outils pour vérifier les réponses de son propre Agent IA. Aucun ne vérifie si une réponse était correcte selon votre politique ou bien taguée, et le Success Rate du rapport IA compte les requêtes API réussies, pas les bonnes réponses. Pour vérifier cela, une responsable peut noter à la main un échantillon hebdomadaire, ou une coéquipière IA comme eesel peut vérifier les conversations récemment archivées selon un horaire, par rapport à des règles que vous écrivez, et laisser ses raisons dans une note interne. Un agent de code comme Claude Code peut mettre en place cette vérification via le CLI eesel, même si quelqu'un doit encore copier le jeton API de Re:amaze pour le connecter.
Re:amaze a-t-il une assurance qualité IA ?
Pas sous ce nom, et pas sous forme de grille. Je travaille dans l'équipe support d'eesel, donc en lisant les fonctions QA d'un helpdesk, je me pose une seule question : cela intercepterait-il une mauvaise réponse avant qu'un client ne le fasse ? Chez Re:amaze, la réponse honnête est "seulement après qu'un client se plaint". (Pour le reste du produit, voir mon avis sur Re:amaze.)
Voici ce que Re:amaze propose pour l'assurance qualité, selon son aperçu des rapports, son guide des outils IA et sa page de tarifs, vérifiés le 22 novembre 2026 :
| Fonction Re:amaze | Plan | Ce qu'elle dit à une responsable QA | Ce qu'elle ne dit pas |
|---|---|---|---|
| Response Time, First Response Resolve Rate, Average Thread Size | Basic | À quelle vitesse les réponses sont parties et la fréquence à laquelle une réponse a réglé le cas | Si la réponse était correcte |
| Rapports Appreciations, Tags et Satisfaction Ratings | Pro, selon l'aperçu des rapports | Quelles réponses les clients ont aimées, quels tags sont utilisés, ce que les clients ont noté | Quel tag aurait dû être utilisé |
| Staff Summary et Individual Staff Reports, enquêtes de satisfaction | Plus | Les réponses, temps de réponse, notes et réponses récentes de chaque agent | Si ces réponses ont suivi votre process |
| Sources de l'Agent IA, corrections, tests et Learned Answers | Avec l'Agent IA | D'où vient une réponse IA, et un endroit pour la corriger | Comment se comportent les agents humains |
| Ask About This Conversation | Outils IA | Une réponse à une question que vous saisissez sur un fil | Quoi que ce soit à travers de nombreuses conversations |
Que disent les rapports de Re:amaze sur la qualité ?
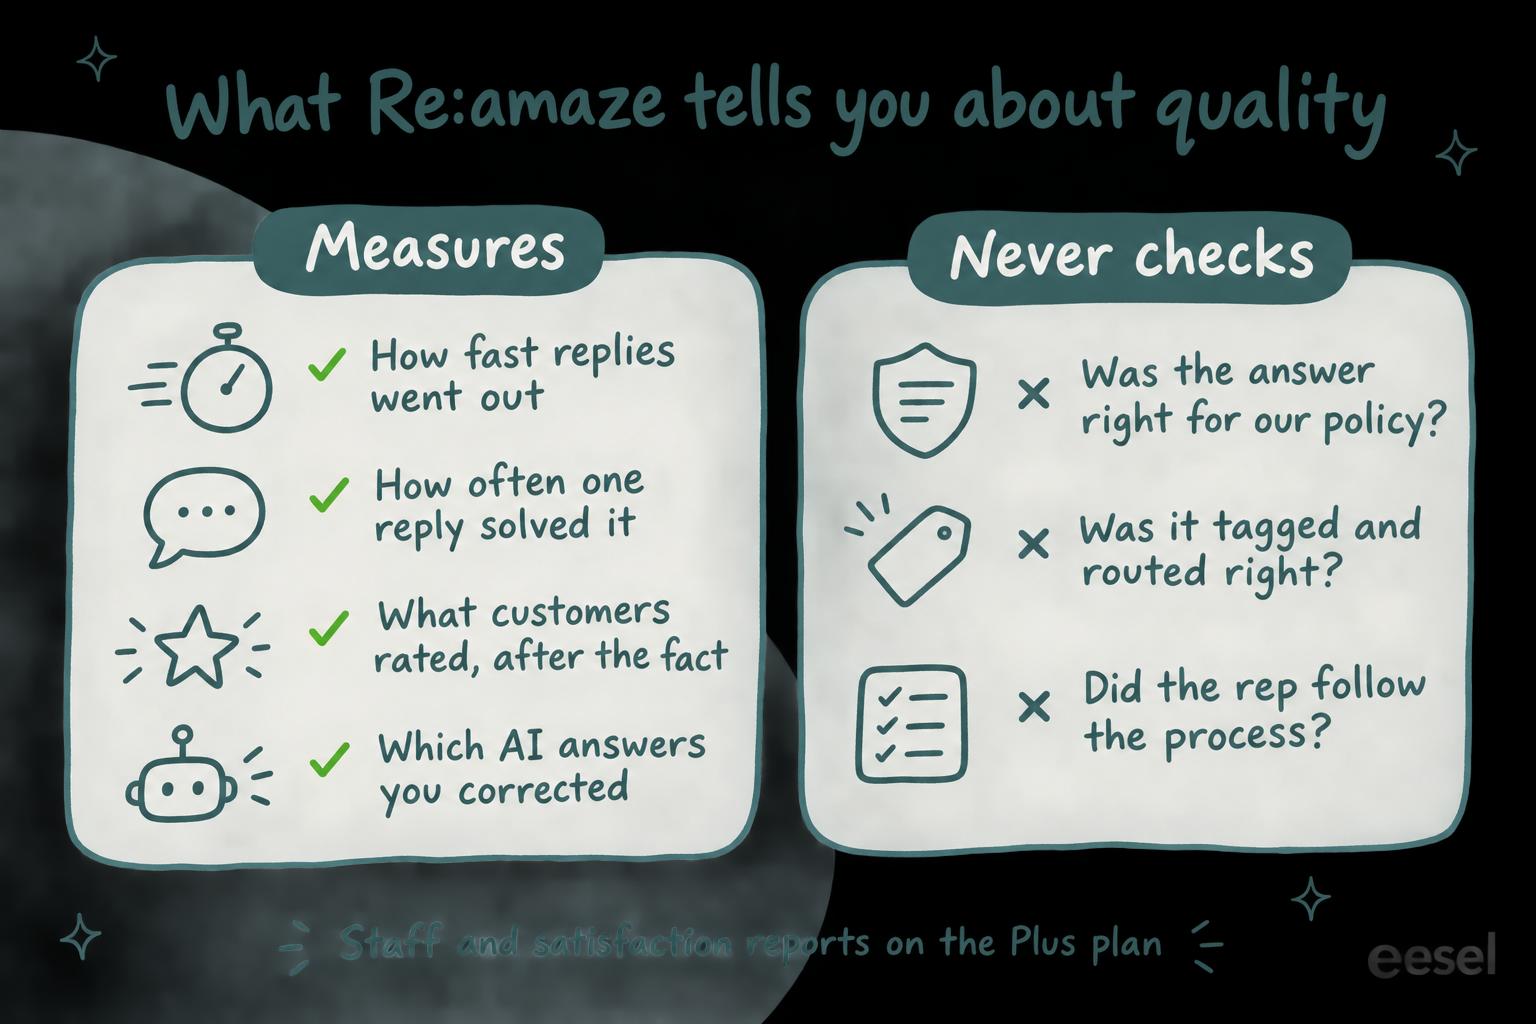
Ils en disent beaucoup sur la rapidité et peu sur le résultat. Tous les plans ont le rapport Response Time (l'entrée de glossaire first response time explique la métrique par laquelle la plupart des équipes commencent) et le First Response Resolve Rate, que Re:amaze décrit comme "une métrique de qualité qui reflète l'efficacité des réponses de votre équipe" : la fréquence à laquelle une réponse a réglé le problème du client, proche de ce que la plupart des équipes appellent first contact resolution. Le rapport Average Thread Size est son partenaire, et le propre guide de Re:amaze dit qu'un nombre élevé "peut indiquer qu'un problème est difficile à résoudre ou que les agents ne donnent pas de réponses suffisamment complètes."
Sur Plus, l'Individual Staff Report détaille cela par agent : réponses, temps de réponse moyen, appreciations, conversations résolues ou archivées, taille moyenne de fil et, si vous envoyez des enquêtes, la note moyenne de l'agent. Vous pouvez comparer un agent à la moyenne de l'équipe ou à un département. En bas se trouve "une liste continue de ses réponses récentes", que les responsables peuvent utiliser selon Re:amaze "pour surveiller la qualité du support au niveau individuel."
Cette dernière ligne est ce qui s'approche le plus de la QA chez Re:amaze. Elle vous donne une liste de lecture ; quelqu'un doit encore ouvrir chaque réponse et la juger.
Deux choses à savoir avant de faire confiance aux chiffres :
- Les conversations sont datées selon leur début. Re:amaze attribue les métriques de conversation "au moment où la conversation a été créée", donc une conversation ouverte le 9 décembre et rouverte puis archivée le 11 décembre compte une fois, le 9 décembre. Les chiffres de la semaine dernière peuvent encore bouger une fois la semaine terminée.
- Les réponses sont comptées par message. Re:amaze dit que le compteur Response "est un meilleur indicateur d'activité" que les compteurs Resolved et Archived.
Qu'apportent les enquêtes de satisfaction de Re:amaze ?
Le verdict du client lui-même, tardif. Les enquêtes de satisfaction automatisées sont sur Plus : sous Settings, puis Email Channels, activez Satisfaction Surveys, choisissez un délai en heures et les statuts de conversation qui envoient une enquête (choisir Resolved n'en envoie une qu'une fois la conversation résolue). L'enquête peut utiliser des smileys, des libellés descriptifs ou 1 à 5 étoiles, et le rapport Satisfaction Ratings affiche la moyenne, l'écart d'Abysmal à Great, et les derniers commentaires.
Il y a une subtilité de plan. La page de tarifs et le guide des enquêtes placent les notes de satisfaction sur Plus, mais l'aperçu des rapports liste le rapport Satisfaction Ratings sous Pro. Si vous êtes sur Pro, vérifiez auprès de Re:amaze avant de planifier autour de cela.
Une note vous dit comment le client a vécu le résultat. Elle ne vous dit pas quelle réponse l'a causé, et elle ne vient que des clients qui répondent. Un score bas vous dit par où commencer à lire. Mes notes sur le CSAT avec IA vont plus loin sur la lecture du CSAT à côté de la QA.
Comment vérifier les réponses de l'Agent IA de Re:amaze ?
C'est là que Re:amaze a fait le plus de travail. En juin 2026, il a sorti une série d'outils pour vérifier ce que dit son Agent IA :
- Sources sur chaque réponse. Un décompte de sources apparaît sur chaque réponse IA ; cliquez pour voir quelles sources de connaissance elle a utilisées, "un moyen rapide de repérer si l'IA s'est appuyée sur quelque chose de dépassé ou l'a pris au mauvais endroit."
- Improve Response. Soumettez une correction sur n'importe quelle réponse IA, et elle est enregistrée pour que l'IA l'utilise la prochaine fois. Re:amaze dit que les corrections sont conservées dans un seul endroit où vous pouvez les modifier ou les supprimer, et les paramètres IA ont un onglet AI Agent Corrections.
- Test AI Agent. Posez-lui les questions que posent les clients et lisez les réponses complètes avant qu'un client ne le fasse. Re:amaze suggère d'y revenir chaque fois que vous modifiez un article, un modèle ou une Learned Answer.
- Learned Answers. Quand l'Agent IA escalade et qu'une personne termine la conversation, Re:amaze rédige une réponse à partir de ce qui s'est passé et la met en file pour révision. Rien n'est ajouté avant que vous ne l'enregistriez, et les suggestions non enregistrées expirent après 14 jours.
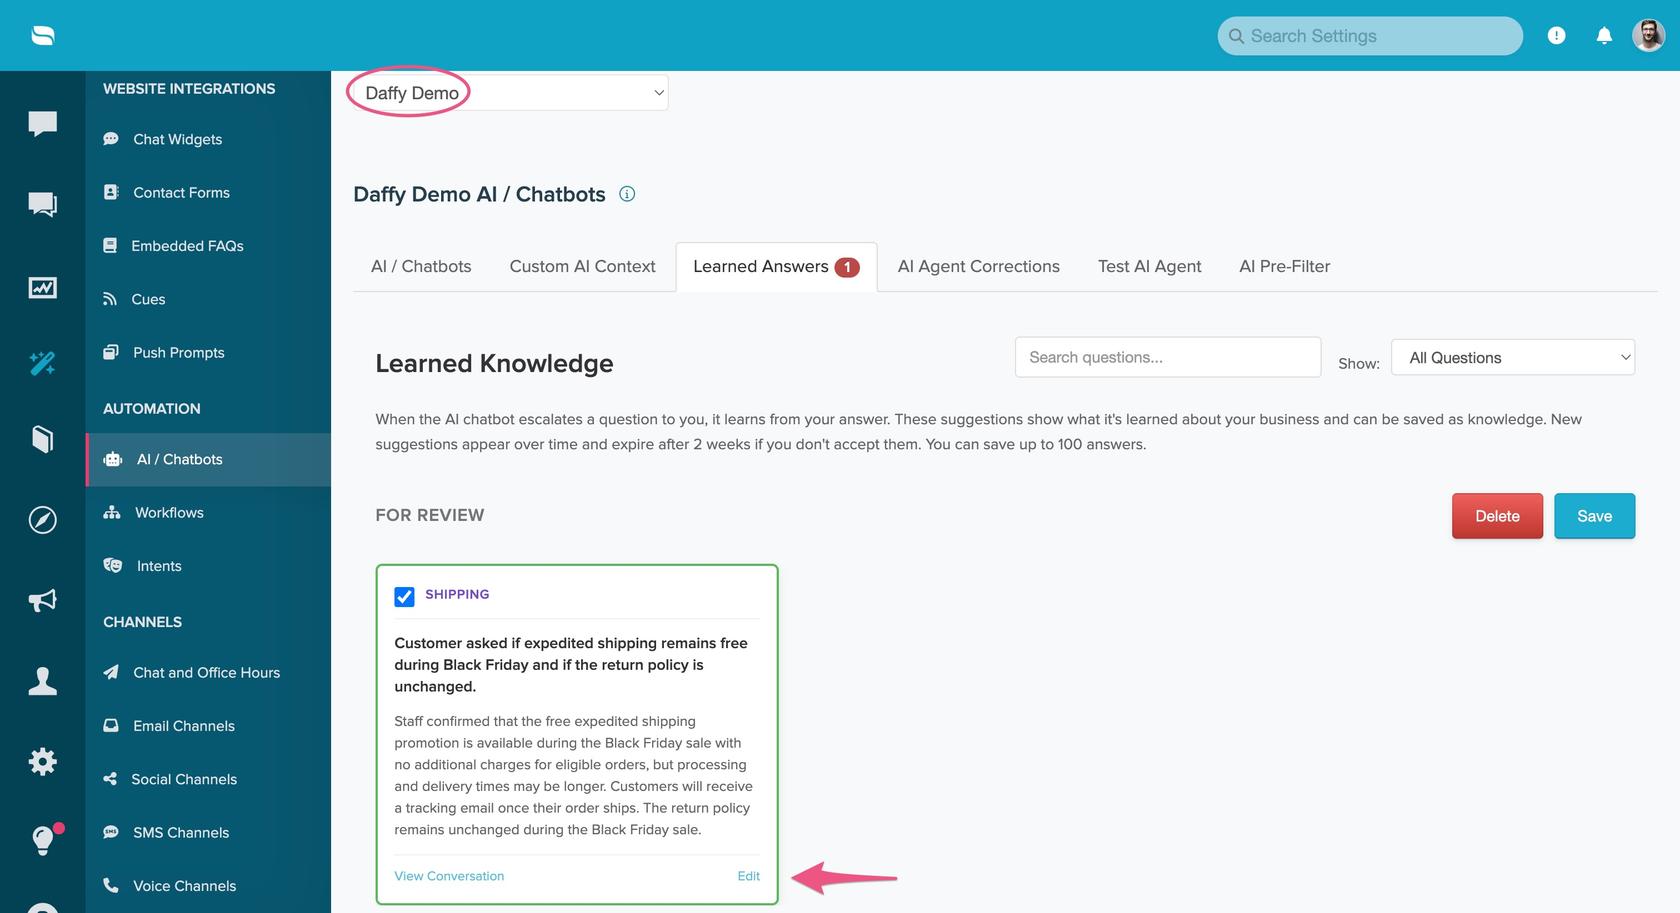
Ce sont de bons outils pour garder l'Agent IA honnête, et je les utiliserais tous. Mais remarquez ce qu'ils ont en commun : une personne trouve d'abord la mauvaise réponse. Rien ne note les conversations de l'Agent IA à votre place.
Surveillez aussi les rapports IA. L'AI Productivity Report a un Success Rate, qui "mesure le nombre de requêtes API IA réussies", et un Content Score, une liste de configuration (+20 % pour la création de 20 articles FAQ, +20 % pour la mise en place de Custom AI Context). Un Success Rate de 100 % signifie que l'IA s'est exécutée à chaque fois, pas qu'elle a eu raison à chaque fois.
Que ne peut pas vérifier Re:amaze ?
Les trois choses pour lesquelles existent la plupart des programmes QA :
- La réponse était-elle correcte selon notre politique ? Aucun rapport ni outil IA ne compare une réponse à vos règles de remboursement, d'expédition ou de garantie. Ask About This Conversation répondra à une question que vous saisissez sur un fil, mais c'est une conversation à la fois, à la main.
- A-t-elle été bien taguée et acheminée ? AI Pre-Filter et Workflows appliquent des tags aux conversations, et le rapport Tags compte les tags les plus souvent appliqués, mais rien ne les vérifie après. Aucun ne vous dit qu'une demande de remboursement est partie avec le tag expédition, et si vos rapports s'appuient sur les tags, cette erreur se propage dans chaque graphique.
- L'agent a-t-il suivi le process ? Avoir demandé le numéro de commande, proposé l'étiquette de retour, escaladé une menace de rétrofacturation : rien de tout cela n'est noté.
Si vous envisagez plutôt un outil QA dédié, vérifiez qu'il se connecte à Re:amaze avant de l'acheter.
Combien coûte Re:amaze pour la QA ?
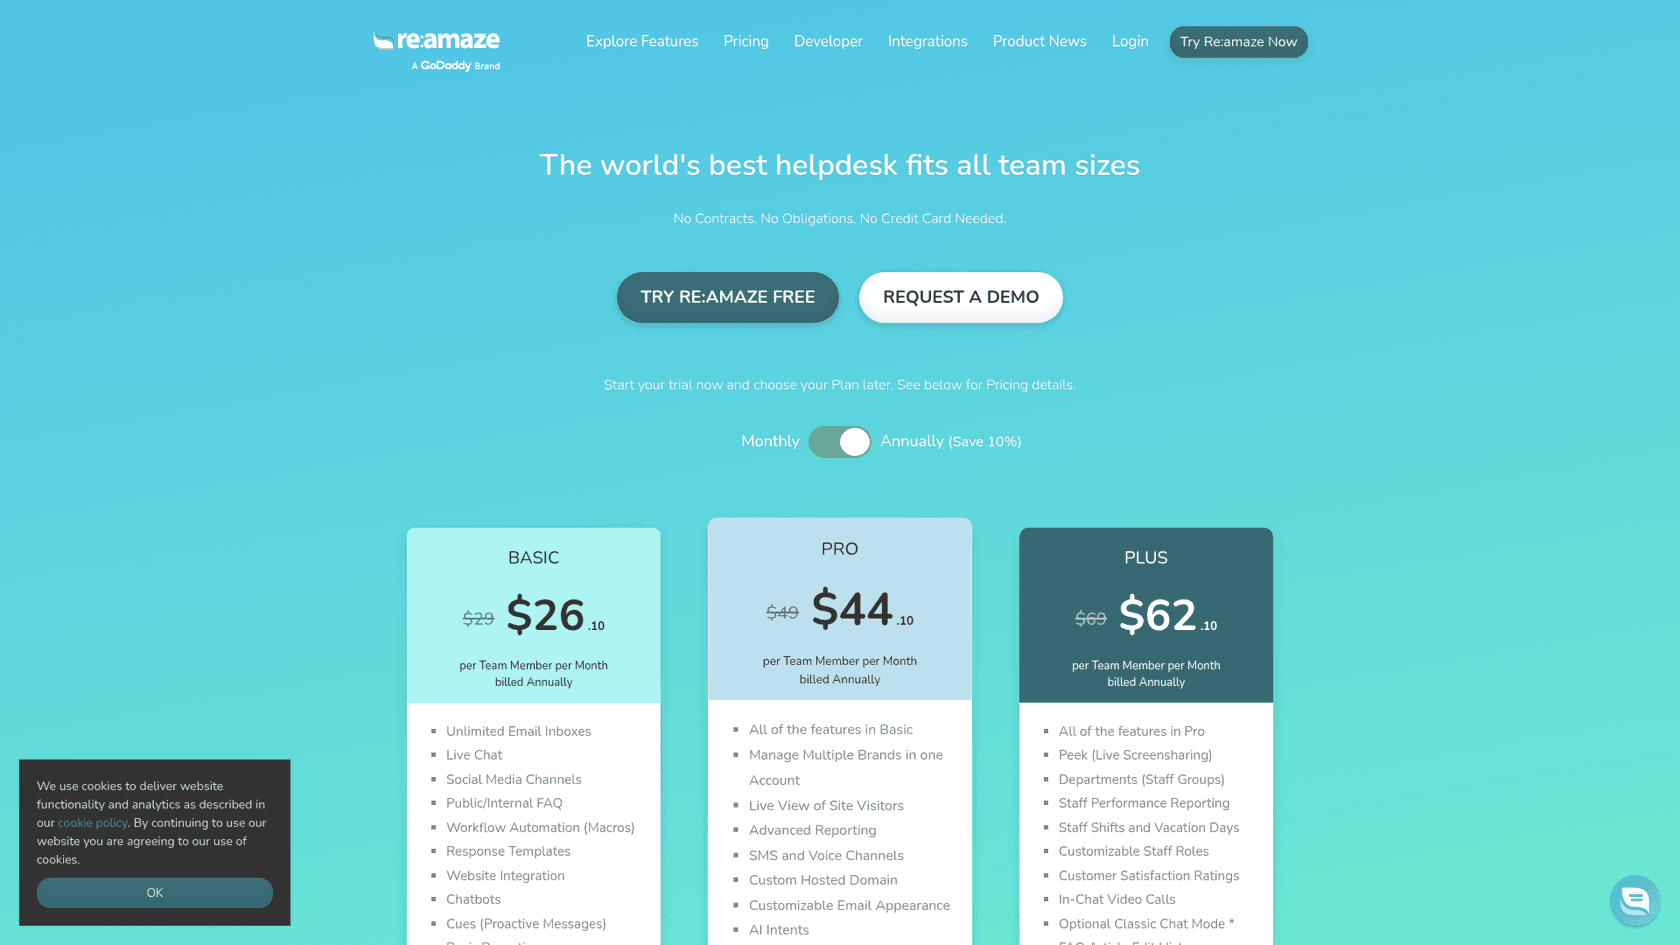
Les rapports et enquêtes pertinents pour la QA sont inclus dans le plan, donc le coût est le passage à Plus. Tarifs de la page de tarifs, vérifiés le 22 novembre 2026 :
| Plan | Par membre d'équipe et par mois | Facturation annuelle | Ce qu'il ajoute pour la QA |
|---|---|---|---|
| Basic | 29 $ | 26,10 $ | Response Time, First Response Resolve Rate, Average Thread Size ; Agent IA avec 5 résolutions par utilisateur et par mois |
| Pro | 49 $ | 44,10 $ | Advanced Reporting (Tags, Appreciations, Workflow) ; 10 résolutions d'Agent IA par utilisateur |
| Plus | 69 $ | 62,10 $ | Staff Performance Reporting, Customer Satisfaction Ratings ; 20 résolutions d'Agent IA par utilisateur |
| Starter | 59 $ fixes par mois | Non indiqué | Les fonctions de Basic pour un nombre illimité de membres d'équipe, jusqu'à 500 conversations répondues par mois |
Les résolutions supplémentaires d'Agent IA coûtent 0,85 $ chacune. Pour une équipe de 10 personnes payant au mois, Pro coûte 490 $ et Plus 690 $, donc les rapports et enquêtes par agent arrivent avec un saut de 200 $ par mois. Mon détail des tarifs de Re:amaze et mon guide des coûts de Re:amaze couvrent d'autres tailles d'équipe.
Comment couvrir ce que Re:amaze laisse de côté ?
Choisissez ce que vous voulez vérifier et voyez ce qui le couvre :
Choisissez une vérification pour voir ce qui la couvre dans Re:amaze, et ce qui la couvre si rien ne le fait.
Il existe deux façons de couvrir le reste.
Noter un échantillon à la main
La solution la moins chère ne demande rien de nouveau, et c'est là que démarrent la plupart des guides sur la QA support avec l'IA. Chaque semaine, une responsable prend dix ou vingt conversations récemment archivées (d'abord les fils les plus longs et les notes les plus basses, si vous les avez), lit chacune et la note selon une grille courte dans une feuille de calcul : bonne réponse pour la politique, bon tag, process suivi. Sur Plus, la liste des réponses récentes de chaque Individual Staff Report est une liste de lecture prête à l'emploi. Mettez-vous d'abord d'accord sur ce que signifie chaque note pour que deux réviseurs notent la même conversation de la même façon : la calibration QA support aide, tout comme ces exemples de feedback QA.
La limite est évidente : une personne lit un échantillon, et les résultats vivent hors de Re:amaze.
Faire vérifier par une coéquipière IA selon vos règles
La deuxième solution est un agent IA qui exécute la revue de lui-même et laisse le résultat dans Re:amaze. C'est ce que je ferais avec eesel. L'intégration Re:amaze d'eesel s'exécute selon un horaire, aussi fréquent que toutes les dix minutes, ou toutes les heures, chaque jour ou chaque semaine, et peut lister les conversations archivées et les restreindre par tag. Pour chacune, elle lit les 40 messages les plus récents avec leurs auteurs, notes internes incluses, plus les tags, le statut et l'assigné de la conversation. Elle apprend à l'avance de vos modèles de réponse et de vos conversations passées, et lit en direct les articles de votre centre d'aide, donc une politique que vous avez publiée est quelque chose qu'elle a lu.
Définissez un horaire quotidien et, à chaque exécution, elle prend les conversations archivées les plus récemment modifiées et :
- Lit le fil avec ses tags.
- Le vérifie selon les règles que vous avez écrites en mots simples ("les remboursements après 30 jours ont besoin de l'approbation d'une responsable", "les questions de facturation reçoivent le tag facturation", "ne jamais promettre une date d'expédition").
- Laisse son verdict et ses raisons en note interne.
- Ajoute un tag comme qa-review à celles qu'une responsable devrait lire, pour qu'une responsable puisse les filtrer.
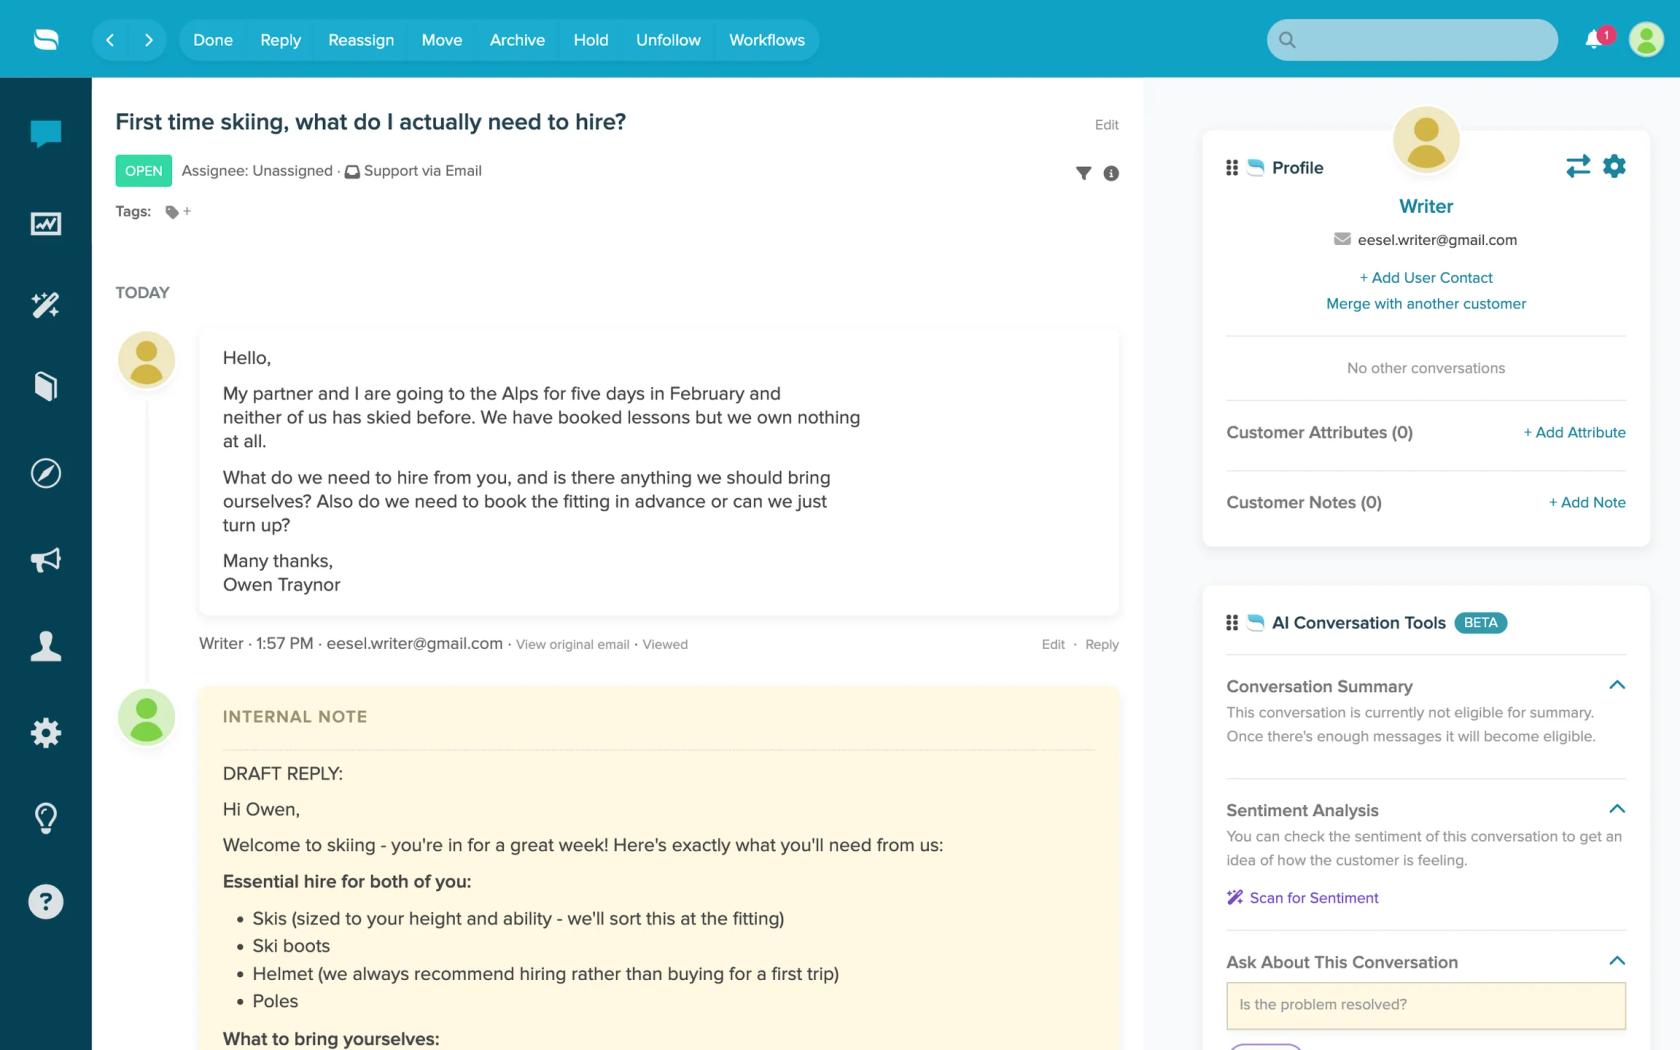
Vous écrivez les règles, donc les vérifications de tagging, de process et de politique ne sont que des lignes supplémentaires, modifiées chaque fois que vos politiques changent. Connaissez d'abord les limites : elle ne voit pas les pièces jointes ni les champs personnalisés, et sur un fil de plus de 40 messages, elle ne lit que les 40 plus récents. Elle s'exécute selon un horaire plutôt qu'au moment où une conversation se ferme, parce que Re:amaze n'a pas de déclencheurs d'événements dans eesel. Le même agent eesel peut aussi rédiger des réponses sous forme de notes internes, si vous le souhaitez.
Des vérifications quotidiennes comme celle-ci s'exécutent déjà pour des clients d'eesel. Cactus Club Cafe fait tourner un second agent eesel sur son helpdesk Zendesk qui audite l'extrait financier quotidien chaque matin : il vérifie chaque magasin et résout le ticket comme équilibré ou le laisse ouvert avec l'écart nommé. Entre le 8 août et le 8 septembre 2026, il s'est exécuté environ 60 fois. Une revue QA a la même forme : une vérification par rapport à des règles écrites, avec le résultat laissé sur la conversation.
Re:amaze suffit-il pour la QA ?
Pour la rapidité et le résultat, oui. First Response Resolve Rate et Average Thread Size sont des signaux honnêtes que la plupart des petites équipes sous-utilisent, et sur Plus, le rapport par agent avec les notes et réponses récentes donne à une responsable une liste de lecture hebdomadaire sensée. Les outils de l'Agent IA sont meilleurs que la plupart : sources sur chaque réponse, corrections enregistrées et un environnement de test sont exactement ce qu'il faut pour empêcher un agent IA de dériver.
Mon avis : commencez par les rapports que vous avez déjà. Surveillez First Response Resolve Rate et Average Thread Size dans chaque Individual Staff Report, lisez les fils les plus longs chaque semaine, et utilisez Test AI Agent chaque fois que vous modifiez un article. Ne confondez pas le Success Rate du rapport IA avec la justesse. Et si la question QA de votre équipe est "était-ce correct ?", pas "était-ce rapide ?", Re:amaze vous laisse cela : un échantillon noté à la main si votre volume est petit, une réviseuse IA sinon. Les réponses d'autres helpdesks à la même question sont dans mes articles sur l'assurance qualité IA de Gorgias, l'assurance qualité IA de Help Scout et l'assurance qualité IA de Front, et mon panorama des outils IA pour la QA support compare des options dédiées.
Essayez eesel comme votre réviseuse QA pour Re:amaze
Si la vérification qui vous manque est "cette réponse était-elle correcte selon notre politique ?", eesel est la réviseuse que j'ajouterais à Re:amaze. Elle se connecte avec un jeton API, lit votre centre d'aide et les conversations passées, et selon un horaire quotidien vérifie chaque conversation récemment archivée par rapport aux règles que vous écrivez, en laissant ses raisons dans une note interne et en taguant celles qui méritent le temps d'une responsable. Commencez en lui demandant dans le chat du tableau de bord de vérifier vos conversations archivées les plus récentes, lisez ce qu'elle signale, et n'activez l'horaire qu'ensuite.
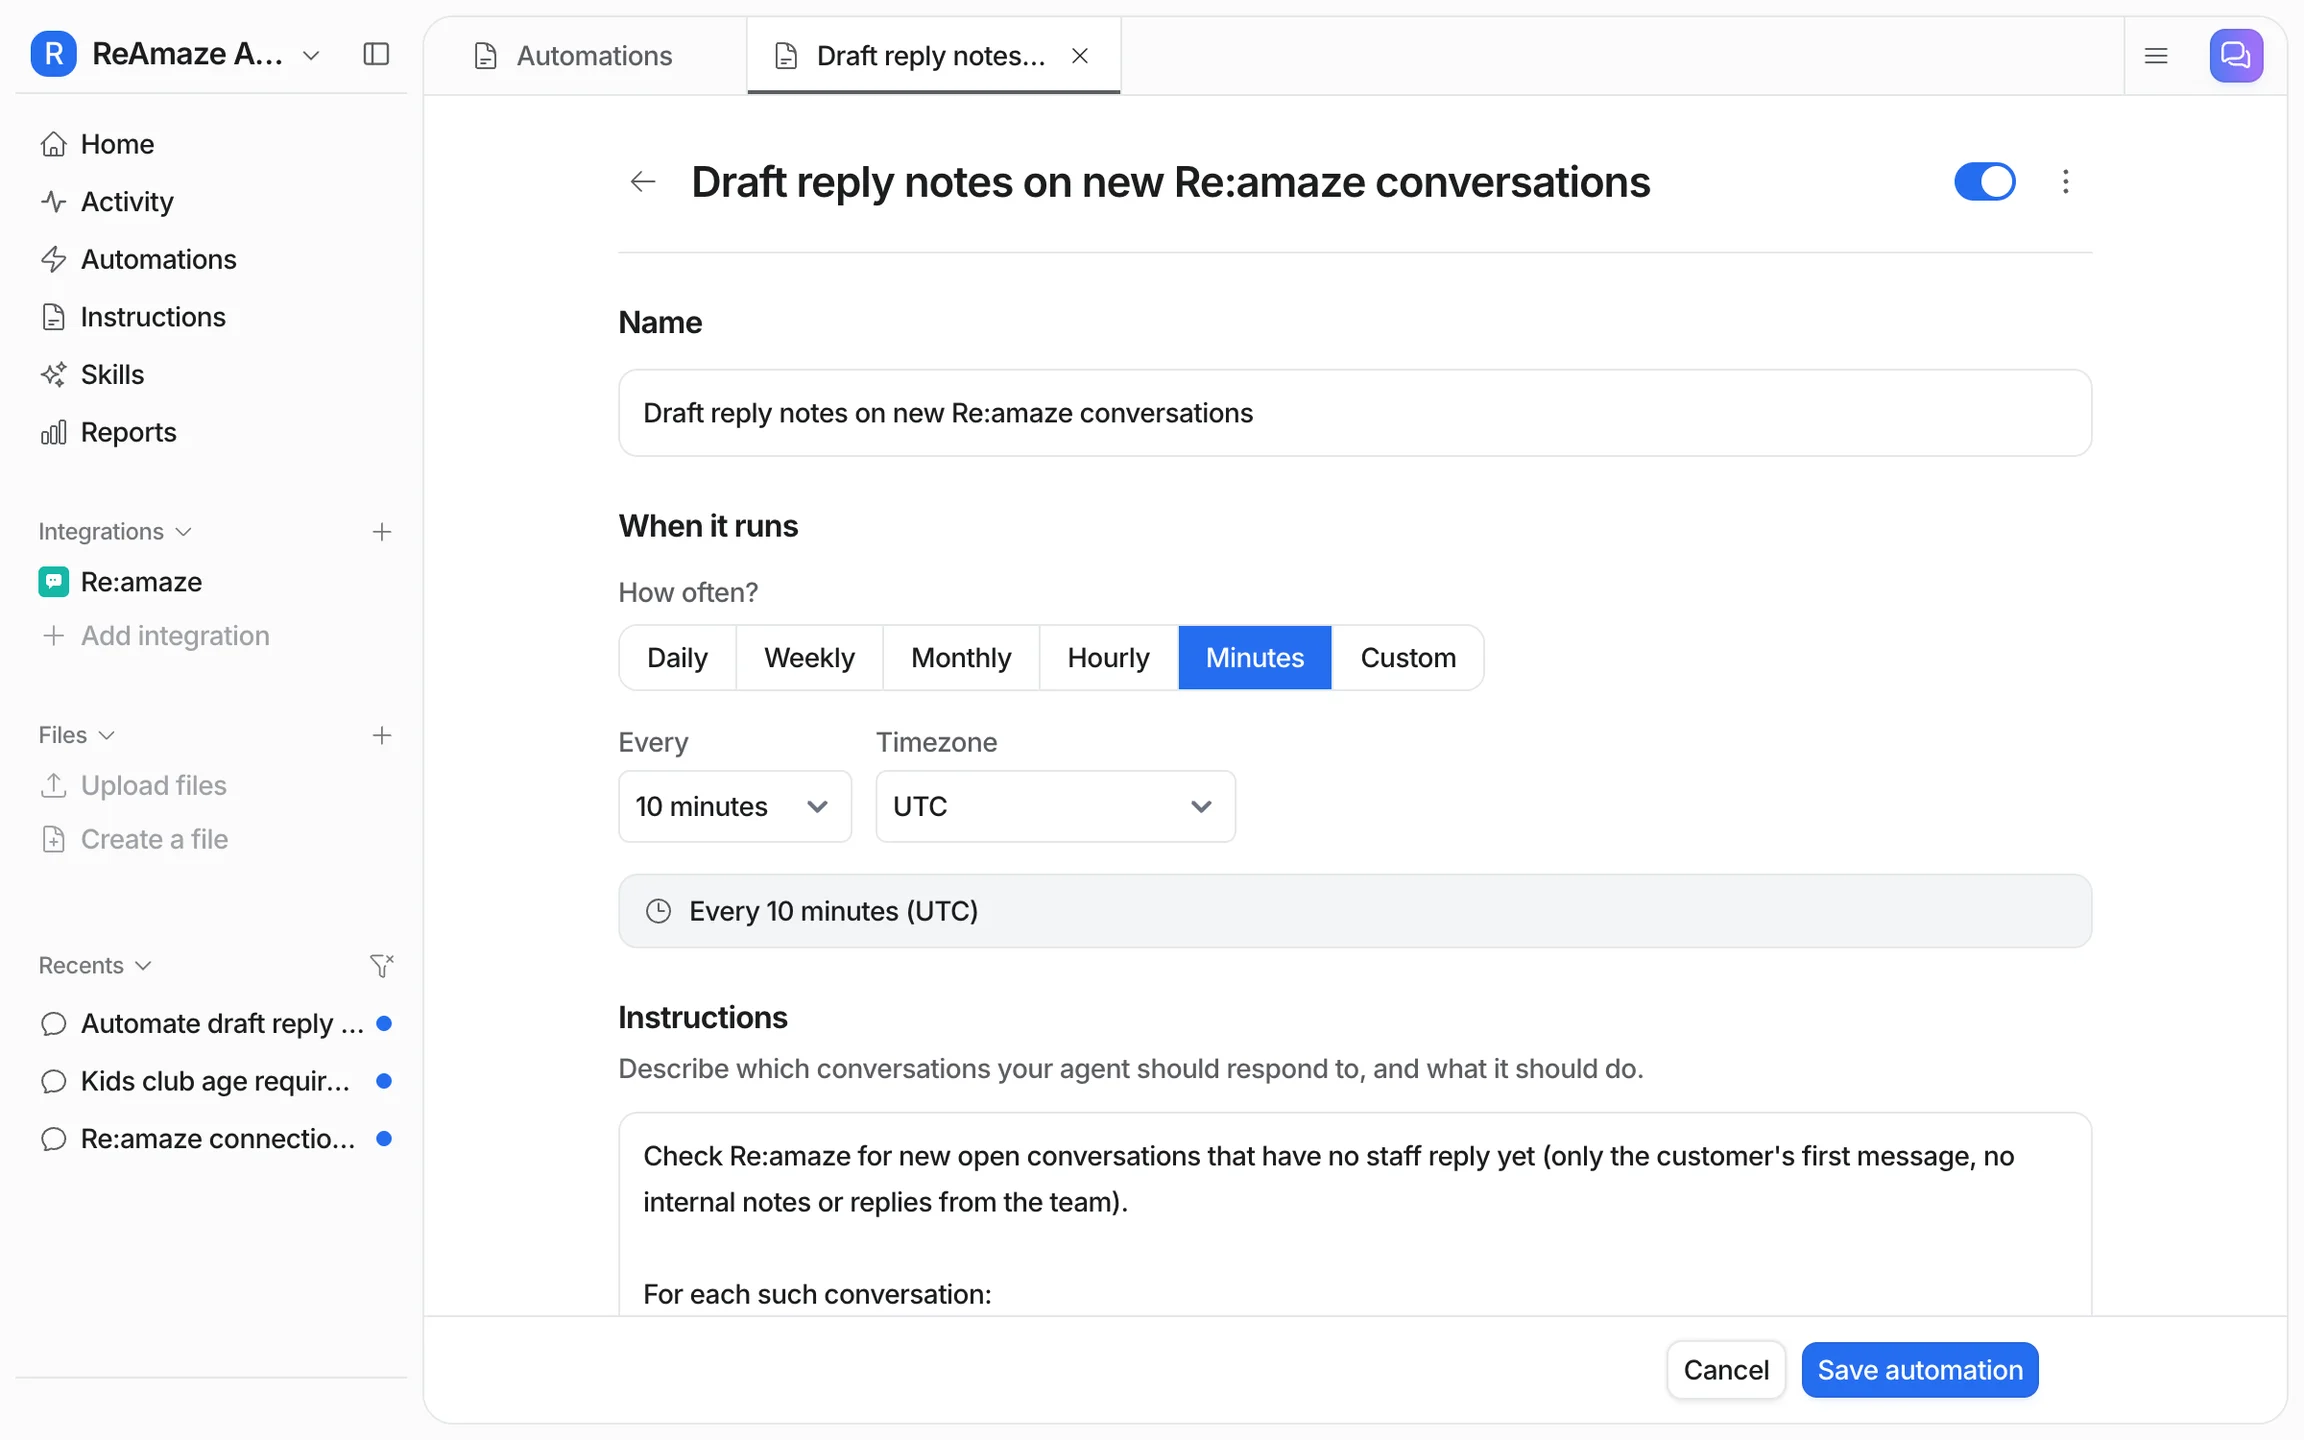
Essayez eesel gratuitement, ou réservez une démo pour voir comment elle vérifie vos propres conversations Re:amaze.
Comment vérifier les réponses de l'Agent IA de Re:amaze ?