

Cinq tickets évalués par agent et par mois donnent un score de qualité qui peut être faussé d'environ 31 points, donc la solution n'est pas un meilleur tableur : c'est de noter chaque ticket avec l'IA et de traiter le résultat comme un signal qu'une personne vérifie. Zendesk, Gorgias, Front, HubSpot et Freshdesk proposent chacun une version de ce principe, et ils couvrent des parties très différentes d'un ticket (Gorgias note 3 critères avec l'IA, HubSpot en note 3, Zendesk vous laisse écrire les vôtres).
Ce que la plupart des guides oublient : une fois qu'un agent IA prend les tickets répétitifs, les tickets qui restent à vos humains sont plus difficiles, donc le temps de traitement augmente, le volume par agent baisse, et une scorecard conçue avant l'IA pénalisera vos meilleures personnes. Chez Question Beauty, eesel a clos environ 280 des 990 tickets Gorgias de façon autonome en un mois et en a assigné environ 250 à une personne avec une note, de sorte que la file humaine est un autre métier que celui pour lequel les anciens objectifs avaient été fixés. Je détaille le calcul de la taille d'échantillon, la scorecard repondérée que je prendrais comme point de départ et la façon de garder des scores d'IA équitables.
Combien d'évaluations faut-il vraiment pour le score d'un agent ?
Bien plus que cinq. Un score issu de cinq tickets évalués relève surtout de la chance, et le calcul est le calcul standard pour n'importe quel taux de réussite.
Prenons un agent qui réussit réellement un critère 85 % du temps. Avec 5 évaluations par mois, la marge d'erreur à 95 % est d'environ 31 points : le tableau de bord pourrait afficher 55 % ou 100 % pour la même personne le même mois. Avec 20 évaluations, elle est d'environ 16 points, avec 100 d'environ 7, et avec 500 (tous les tickets) d'environ 3. C'est mon propre calcul, avec l'approximation normale, et une correction de population finie dans le widget ci-dessous.
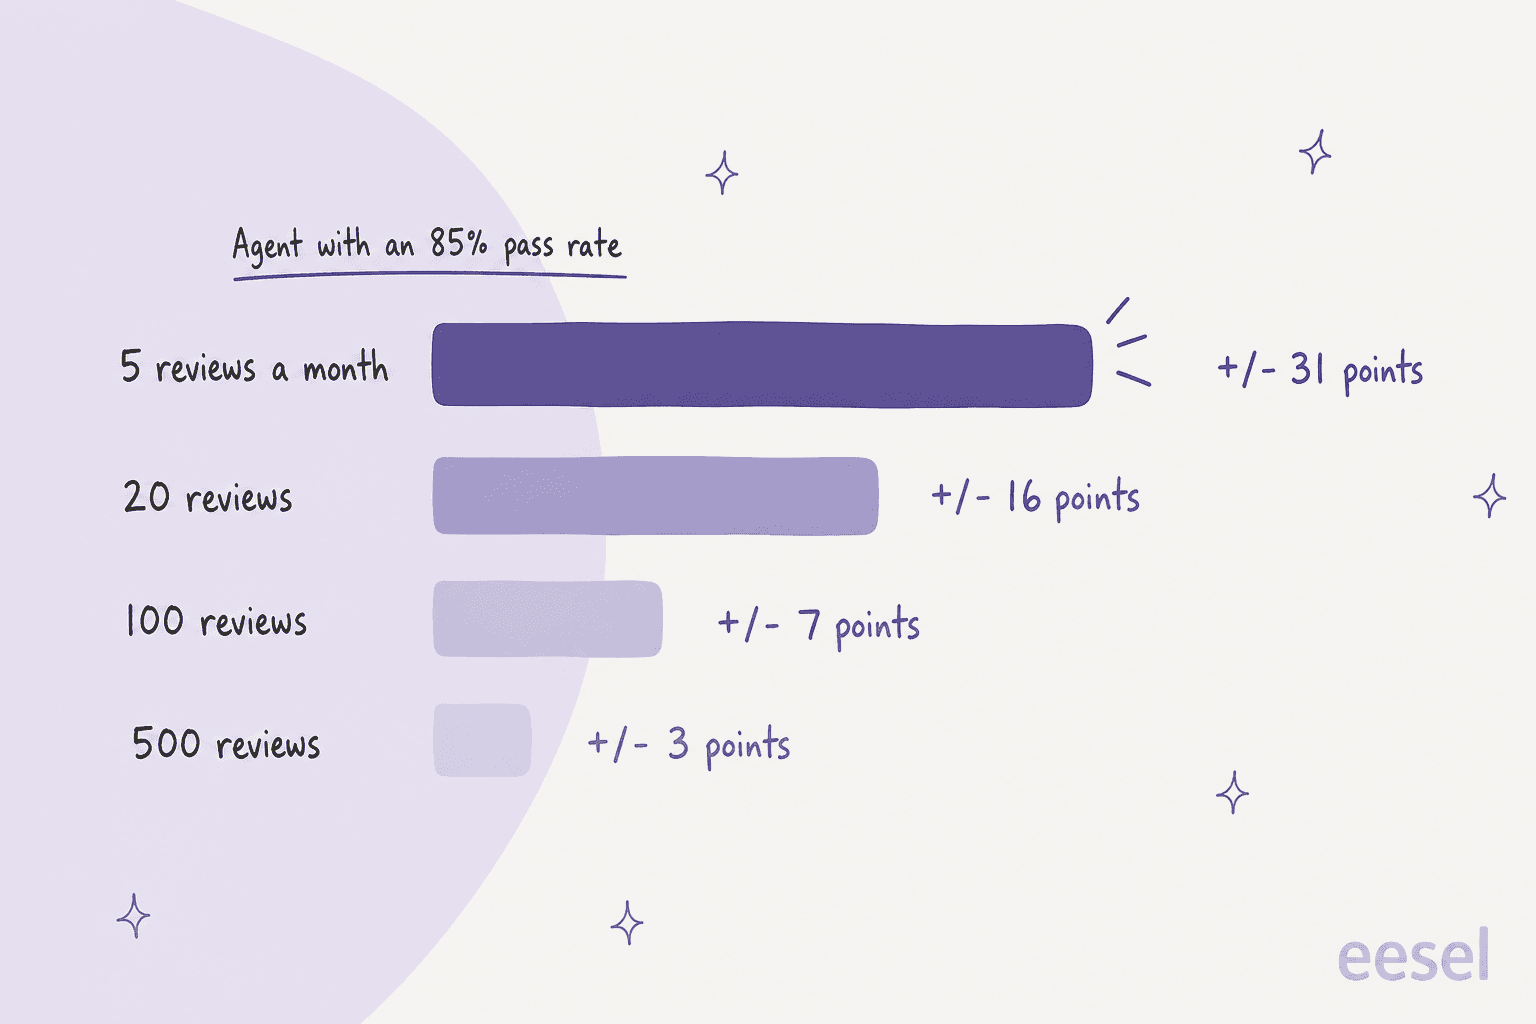
Cela empire quand on compare des personnes. Pour distinguer avec confiance un agent à 85 % d'un agent à 75 %, il faut environ 120 tickets notés chacun. Un responsable d'équipe qui relit 5 à 10 tickets par semaine sur les quelque 500 tickets mensuels d'un agent n'y arrive jamais. Leo Gasperin a décrit exactement cela dans son ancienne équipe, et un commentateur lui a donné un nom :
"sampling creates confidence, but not clarity."

Essayez avec vos propres chiffres. Le widget ci-dessous utilise votre volume de tickets et votre nombre d'évaluations.
Saisissez votre propre volume de tickets et votre nombre d'évaluations pour voir l'étendue de la plage. La dernière carte indique le nombre d'évaluations nécessaire pour distinguer deux agents séparés de 10 points.
J'ai présenté l'argument plus large pour abandonner l'échantillonnage dans l'assurance qualité de centre d'appels, et la version pratique dans la QA du support avec l'IA. En résumé : la notation par IA vaut l'achat rien que pour le dénominateur.
Que doit mesurer la scorecard de performance d'un agent ?
Quatre choses, dont aucune n'est la vitesse seule : la qualité, le résultat, le point de vue du client et l'efficacité par type de ticket. Le conseil habituel est un score pondéré (par exemple qualité 40, productivité 25, expérience client 25, fiabilité 10), et cette structure est correcte. C'est dans les pondérations que les équipes se trompent.
| Catégorie | Exemple de mesure | Ce que cela vous apprend | Le piège |
|---|---|---|---|
| Qualité | Empathie, exactitude, résolution notées par l'IA | La réponse a-t-elle fait son travail ? | Un critère que l'IA ne peut pas juger (Gorgias laisse l'exactitude et le ton de la marque aux humains) |
| Résultat | Taux de réouverture, résolution au premier contact | Le problème est-il resté réglé ? | Des agents qui clôturent vite et rouvrent plus tard |
| Point de vue du client | CSAT | Le client s'est-il senti aidé ? | Peu de réponses à l'enquête par agent, donc le même problème de bruit |
| Efficacité | Temps de traitement moyen par type de ticket | Le travail est-il bien organisé ? | Un seul chiffre mélangeant tickets faciles et difficiles |
Pour la liste complète des métriques, mes articles sur les KPI du service client et la productivité des agents de centre d'appels vont plus loin. Si vous rédigez des critères d'évaluation de zéro, les exemples de feedback QA vous donnent une formulation qui coache au lieu de noter.
Que change l'arrivée d'un agent IA qui prend les tickets faciles ?
Votre file humaine devient plus difficile, et chaque chiffre par agent fixé avant l'IA mesure désormais un autre métier. L'IA répond aux questions de suivi de commande et de type « comment faire », donc ce qui arrive à une personne, c'est la décision de remboursement, le client en colère et ce que le bot n'a pas su résoudre.
Un agent de centre d'appels sur Reddit l'a décrit après l'installation d'un agent vocal IA devant les téléphones :
"At this point, it's handling a lot of "routine" calls. Which means the calls that come through to us humans are more complicated, or people who are upset about the AI messing something up."

Les chiffres confirment ce ressenti. Chez Question Beauty, eesel a traité environ 990 tickets Gorgias en un mois (du 8 août au 8 septembre 2026), envoyé environ 960 réponses, clos environ 280 tickets seul et assigné environ 250 à une personne avec une note interne. Les remboursements, les réclamations et les demandes de vente en gros vont toujours à un humain. Les agents de cette équipe ne sont pas plus lents qu'avant ; ils ne voient simplement plus jamais « où est ma commande ». Le temps de traitement par ticket augmente et le nombre de tickets par agent baisse, et ni l'un ni l'autre n'est un problème de performance.
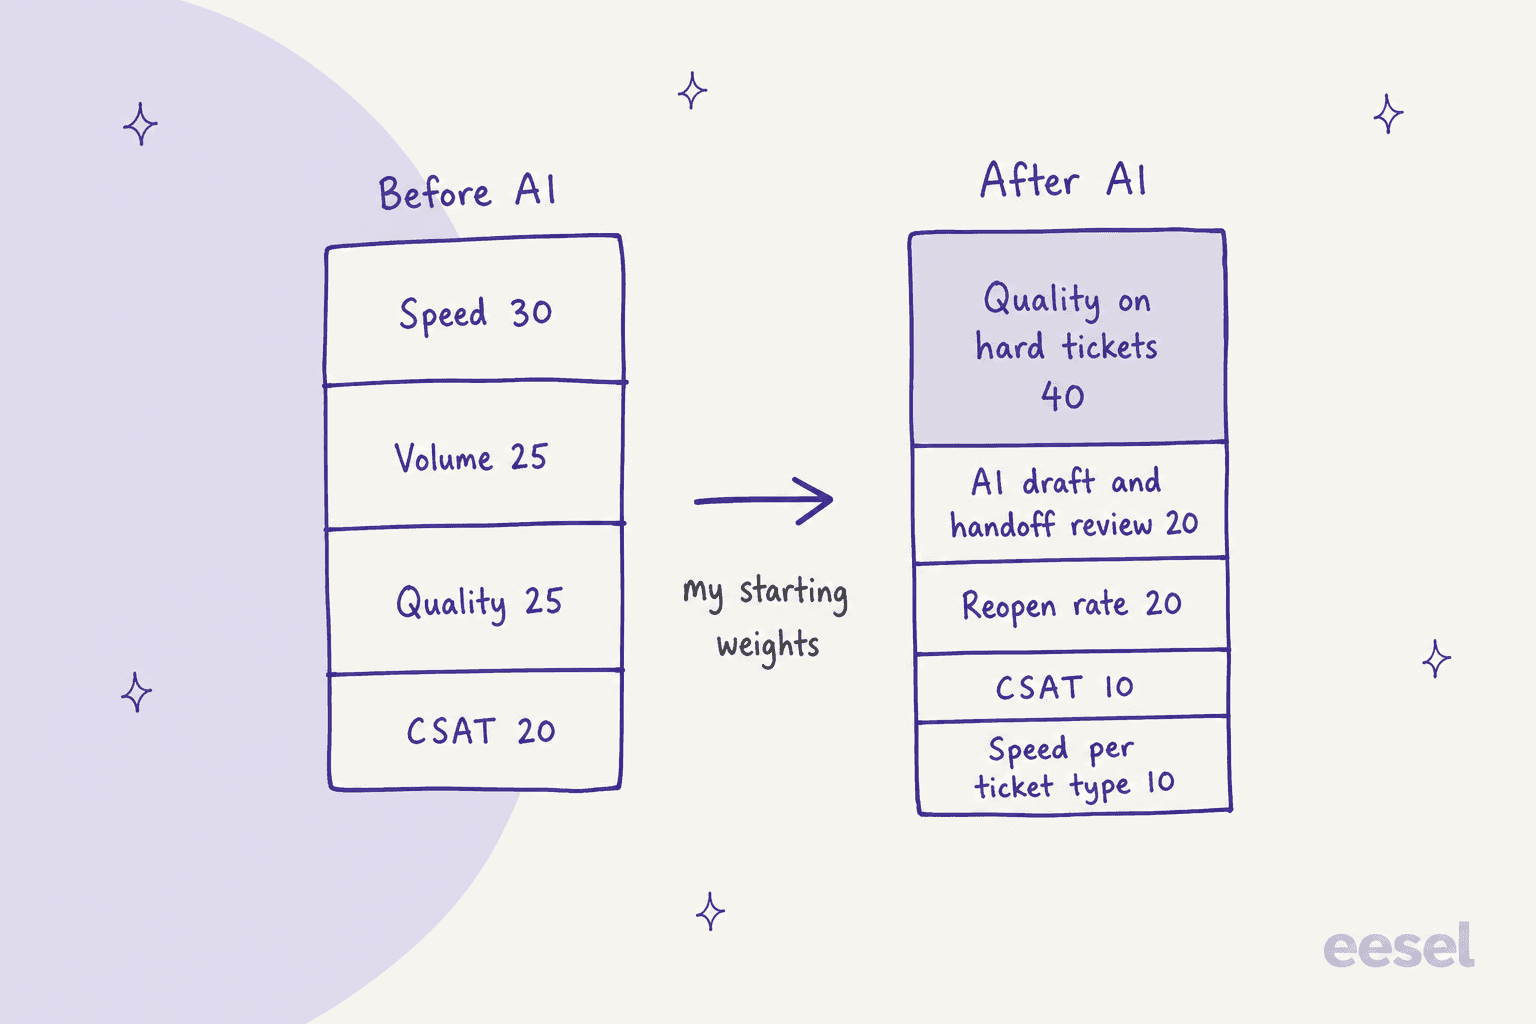
C'est la repondération dont je partirais. Ce sont mes pondérations de départ, pas une référence du secteur, alors ajustez-les après votre premier tour de calibrage. Voici ce qui change :
- Supprimez les objectifs de volume individuels. Le nombre de tickets clos par agent baisse par conception dès que l'IA détourne les plus faciles. Suivez plutôt le total d'heures d'agent sur la file, comme je l'explique dans l'IA pour réduire le temps de traitement.
- Mesurez la vitesse par type de ticket. Un ticket de remboursement et une réinitialisation de mot de passe ne devraient jamais partager la même référence. Gorgias calcule déjà le temps de traitement des tickets uniquement sur ceux qu'un humain a traités, et exclut les tickets résolus par son AI Agent. Copiez cette règle dans n'importe quel helpdesk.
- Ajoutez une ligne pour le travail avec l'IA. Les agents approuvent, modifient ou rejettent désormais des brouillons et reçoivent des transferts. Chez smava, eesel a préparé environ 15 300 brouillons de réponses en un mois sur un Zendesk partagé, et un agent approuve un brouillon ou écrit @eesel dans une note pour demander une autre macro. Bien relire ces brouillons est une compétence : un score pour « a repéré un mauvais brouillon » et « a laissé une note de transfert utile » a sa place sur la carte.
- Évaluez le transfert, pas seulement la réponse. Si l'IA transmet le ticket avec la commande déjà vérifiée, c'est de la qualité de transfert, et cela influence les chiffres de l'agent plus que sa vitesse de frappe.
Un commentateur sur Reddit, avec près de 30 ans dans le support, a résumé sans détour le coût de l'ignorer :
"Except now imagine an eight-hour shift where practically EVERY conversation you receive is an escalation, an angry customer, an unusual problem or something the AI already couldn't solve."
C'est aussi une question de coaching et de planning, et je traite le volet effectifs dans l'IA pour les effectifs du support et le volet relève dans l'IA pour la passation de poste.
Quels outils de helpdesk notent la qualité des agents avec l'IA ?
Cinq helpdesks proposent une solution native, et ils diffèrent plus que le marketing ne le laisse croire. J'ai lu la documentation et la page de tarifs de chaque éditeur, donc le tableau ci-dessous reprend uniquement leurs formulations et leurs prix.
| Helpdesk | Ce qui est noté | Part du ticket jugée par l'IA | Prix indiqué |
|---|---|---|---|
| Zendesk QA | Chaque interaction, humaine et agent IA ; catégories intégrées comme Empathie ou Solution, plus vos propres catégories basées sur des prompts | Tout ce que vous écrivez dans la scorecard | Module QA sur chaque forfait Suite, prix non indiqué ; le Workforce Engagement Bundle coûte 50 $ par agent et par mois facturé annuellement |
| Gorgias Auto QA | Tickets clos, notés 12 heures après la clôture | 3 critères (complétude de la résolution, communication, langage) ; 4 autres (exactitude, efficacité, conformité interne, ton de la marque) uniquement manuels | Activé par défaut avec un abonnement AI Agent, à 1,50 $ par interaction automatisée au-delà de la limite du forfait |
| Front Smart QA | Chaque ticket selon des scorecards personnalisables, plus Smart CSAT | Les critères que vous définissez | Indiqué comme inclus dans Enterprise, 105 $ par siège et par mois facturé annuellement |
| Score QA de HubSpot | Tickets clos du help desk, de 1 à 5 | 3 critères (ton, clarté, empathie) ; bêta | Service Hub Enterprise, 150 $ par siège et par mois |
| Freshdesk Quality Coach | Conversations résolues, affichées aux agents dans leur boîte de réception, plus un rapport administrateur Quality Score | 6 paramètres (ouverture et clôture, rapidité, qualité de la réponse, sentiment, grammaire, mots parasites) | Activé dans les paramètres Freddy Copilot ; Freddy AI Copilot coûte 29 $ par agent et par mois sur Pro et Enterprise |
Quelques remarques en les lisant côte à côte :
- Zendesk est le plus flexible et le moins transparent sur le prix. Vous écrivez les critères, et Spotlight signale les risques de départ et les boucles bloquées. Son AI Agent QA compare aussi côte à côte les scores des bots et des humains. Le coût, c'est une conversation avec les ventes. Je détaille la configuration dans les critères de scorecard Zendesk QA et Zendesk QA pour les agents IA.
- Gorgias est le plus honnête sur ses limites. Sa documentation dit clairement que l'exactitude et le ton de la marque ne peuvent être notés que manuellement, que les critères personnalisés ne sont pas disponibles pour le moment, et que les tickets de moins de 250 caractères, les tickets sociaux et les appels téléphoniques sont ignorés. C'est utile : vous savez quelle moitié de votre scorecard nécessite encore un humain. Voir les tarifs de Gorgias AI Agent pour le côté coût.
- Front associe la QA à l'inférence de CSAT, ce qui vous donne une vue de la qualité et une vue de la satisfaction déduite par l'IA au même endroit. Les tarifs de Front détaillent les forfaits.
- Celui de HubSpot est le plus prudent. Il est en bêta et réservé à Enterprise ; savoir si cela vaut le prix du siège est une question que j'aborde dans HubSpot Service Hub AI.
- Celui de Freshdesk est le plus ancien, et l'article d'aide date de 2024, donc vérifiez-le par rapport à votre forfait avant de bâtir un processus dessus. Les forfaits figurent dans les tarifs de Freshdesk.
Si vous n'utilisez aucun de ces outils ou si vous voulez une vue indépendante des éditeurs, les outils d'assurance qualité du support client comparent les plateformes QA autonomes.
Comment garder des scores d'IA équitables envers les agents ?
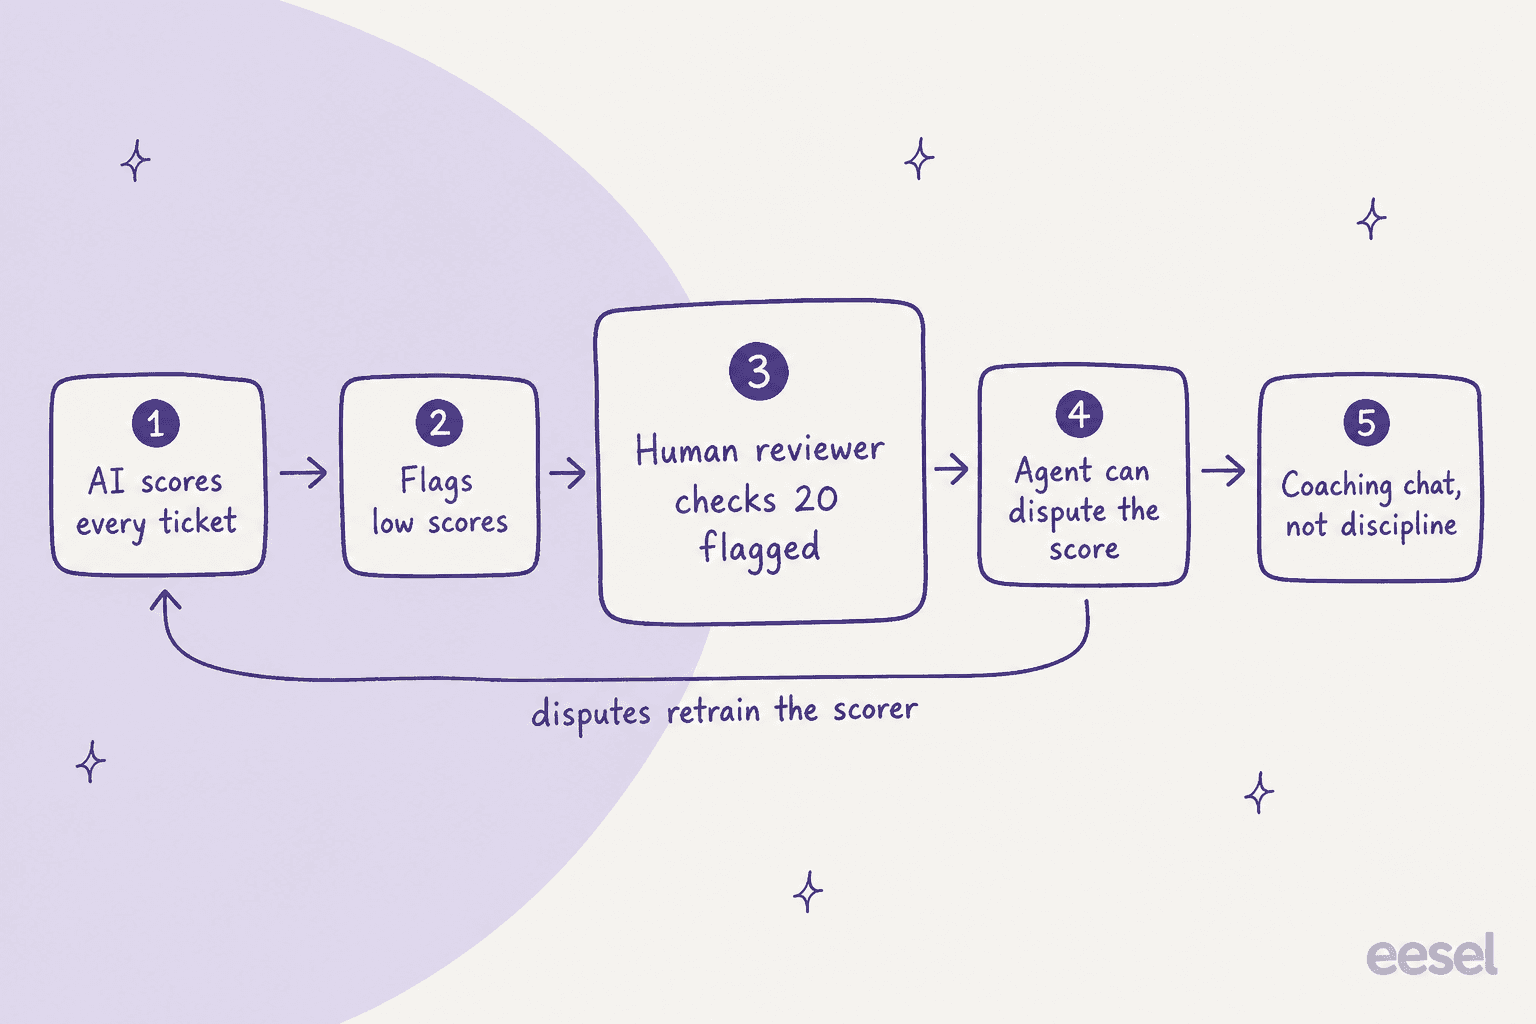
Traitez chaque score comme un signal qui choisit les tickets qu'un humain doit lire, jamais comme un verdict. Les éditeurs le disent eux-mêmes : l'article d'aide de HubSpot avertit que ses scores QA peuvent être inexacts et ne doivent pas être la seule base de décisions de coaching, de performance, de rémunération, de discipline ou autres concernant une personne.
La boucle que je mettrais en place :
- Notez chaque ticket avec l'IA. C'est la correction du dénominateur de la première section.
- Lisez vous-même les tickets signalés. Vingt tickets signalés par semaine et par équipe valent mieux que cinq tickets aléatoires par agent, car vous lisez là où se trouve le signal.
- Calibrez. Faites noter les mêmes 20 tickets par deux humains, puis comparez avec l'IA. Là où ils divergent, corrigez la formulation du critère, pas les personnes. Un fil de discussion G2 demande justement comment les équipes maintiennent un calibrage humain à côté de la notation par IA, et la réponse habituelle est que l'IA fait la première passe et les sessions humaines restent.
- Laissez les agents contester. Gorgias permet à un relecteur de modifier n'importe quelle partie d'un score et utilise ces modifications pour affiner le modèle. Même si votre outil ne le permet pas, un agent qui peut dire « ce score est faux, voici pourquoi » rend le système plus précis et plus digne de confiance.
- Ne sanctionnez jamais sur le seul sentiment. Les scores de sentiment et de ton pénalisent les personnes qui reçoivent les clients les plus en colère, c'est-à-dire, après le détournement par l'IA, tout le monde.
Mon article sur l'analyse de sentiment par IA pour le support explique pourquoi le sentiment est un mauvais juge d'un agent individuel. L'équité est aussi la raison pour laquelle je testerais un notateur avant de lui faire confiance, comme on simule un agent IA.
Comment transformer les scores en coaching ?
Choisissez un comportement par agent et par mois, montrez-lui deux tickets et convenez d'un changement. Les scores trouvent les tickets ; c'est la conversation qui fait le travail.
Un plan sur 30 jours, dans l'ordre où je le ferais :
- Semaine 1, fixer le dénominateur. Activez l'IA QA de votre helpdesk et laissez-la noter chaque ticket clos. Ne regardez pas encore les classements par agent.
- Semaine 2, calibrer. Lancez la vérification sur 20 tickets décrite plus haut et réécrivez tout critère que les humains et l'IA lisent différemment.
- Semaine 3, repondérer. Passez à la scorecard post-IA : pas d'objectif de volume individuel, vitesse par type de ticket, une ligne pour la relecture des brouillons et les transferts.
- Semaine 4, lancer les entretiens individuels. Un point fort et une habitude par agent, avec les deux tickets comme preuve. Coacher les agents avec l'IA et les logiciels de coaching du support client couvrent les outils, et le coaching d'agent IA pour le support couvre le coaching de l'IA elle-même.
Pour les nouvelles recrues, la même boucle fonctionne plus vite, puisque les brouillons de l'IA servent d'exemples travaillés : voir l'intégration des agents du support client.
Comment eesel s'intègre-t-il dans la performance des agents ?
eesel ne note pas vos agents humains. Il change ce sur quoi ils travaillent. eesel est un coéquipier IA de helpdesk qui s'installe dans votre helpdesk existant, répond aux tickets répétitifs ou en rédige les brouillons, et transmet le reste à une personne avec une note, de sorte que le score que vous construisez pour votre équipe reflète le travail restant. eesel fait tourner l'IA sur des files de support en production depuis des années, et chaque déploiement est d'abord simulé sur des tickets historiques, ce qui vous donne la vue avant et après de la file humaine dont une scorecard équitable a besoin.
Trois témoignages clients publiés montrent le schéma sur différents helpdesks :
- Gorgias : chez Question Beauty, eesel a envoyé environ 960 réponses et clos environ 280 des 990 tickets en un mois ; environ 250 sont allés à une personne avec la recherche de commande déjà jointe.
- Zendesk : smava traite environ 27 000 tickets par mois sur un seul Zendesk pour deux marques. eesel en a catégorisé environ 14 600 et préparé environ 15 300 brouillons, et des personnes approuvent ou redirigent chaque brouillon.
- Freshdesk : chez SamCart, eesel répond sur les tickets uniquement tant qu'aucun agent n'est assigné, et un coéquipier qui prend le ticket met fin à la partie de l'agent IA, ce qui trace une ligne nette pour décider quels tickets appartiennent à quelle scorecard.

Pour juger l'IA elle-même, utilisez la scorecard de pilote de support IA, le guide du taux de résolution par IA et le taux de confinement et la qualité de l'escalade. Pour le côté coût, le coût d'un agent IA par rapport à un agent humain propose la comparaison.
Essayez eesel pour les tickets sur lesquels votre équipe ne devrait pas être notée
Si vos agents sont notés sur des réinitialisations de mot de passe et des questions de suivi de commande, confiez-les d'abord à eesel et repondérez la scorecard autour de ce qui reste. Il se connecte à Zendesk, Freshdesk, Gorgias, HubSpot et Front, et il apprend à partir de votre centre d'aide et de vos anciens tickets.
Les tarifs d'eesel reposent sur des forfaits de crédits fixes : un ticket ou un chat vaut 1 crédit quelle que soit sa durée, le forfait gratuit offre 100 crédits pour essayer toutes les fonctionnalités, et les forfaits payants commencent à 299 $ par mois pour 500 crédits. Essayez eesel avec vos propres tickets et voyez quelle part de votre file est du type facile.
Comment l'IA peut-elle aider à mesurer la performance des agents du support ?