

Pourquoi le QA du support multilingue échoue en silence
La plupart des programmes de QA du support sont construits en anglais puis étirés. La grille d'évaluation est copiée, le groupe de relecteurs reste le même, et quelqu'un active un bouton de traduction pour que les relecteurs anglophones puissent « lire » la file allemande. Les scores reviennent avec une bonne allure. C'est là le problème.
J'ai vu cela mal tourner de l'intérieur. eesel fait tourner de l'IA sur des helpdesks en production en allemand, néerlandais, français, espagnol, roumain et plus encore depuis des années, et le pire bug multilingue que j'ai vu eesel livrer n'était pas une mauvaise traduction. Début 2026, des brouillons de réponses en allemand et en néerlandais sont partis avec des variables brutes comme {{ticket.requester.first_name}} et [Employee Name], sur des helpdesks belges, allemands et néerlandais. Un correcteur de grammaire aurait bien noté ces brouillons. Un locuteur natif lisant la réponse une fois l'aurait repéré en deux secondes.
Voilà le schéma. Les erreurs qui comptent dans une seconde langue ne sont, pour la plupart, pas des fautes d'orthographe.
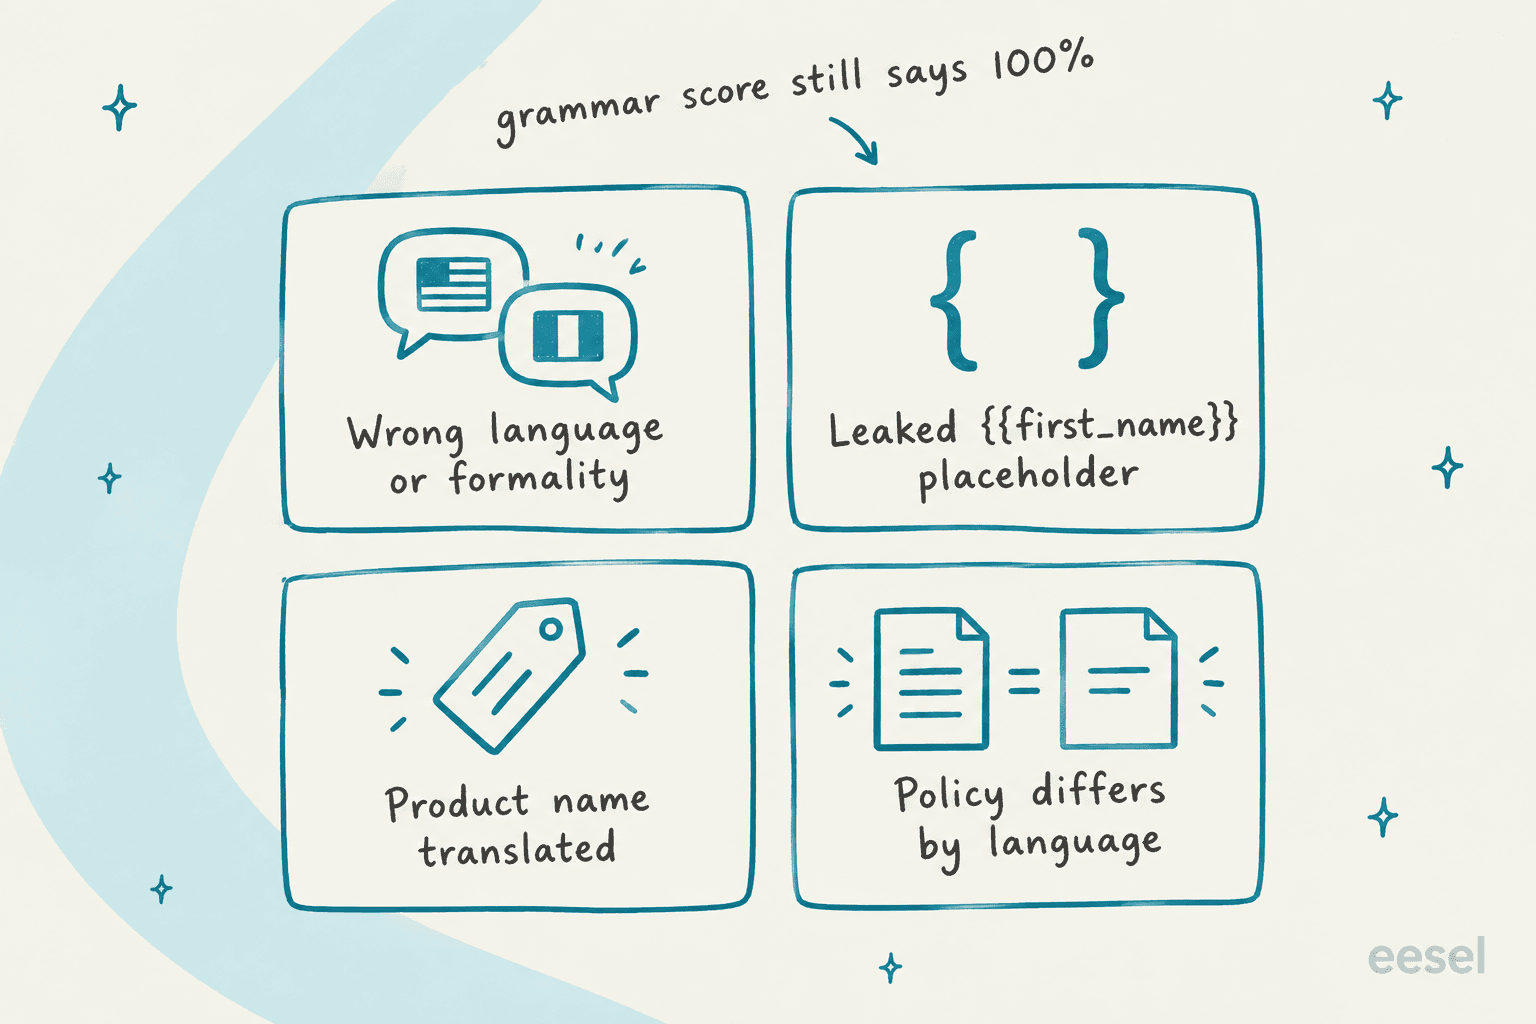
Voici ce qui passe à travers quand le QA hors anglais n'est que du QA anglais avec un bouton de traduction :
- Registre et formalité. Allemand du contre Sie, français tu contre vous, niveaux de politesse du japonais. La traduction automatique les aplatit, si bien qu'un relecteur qui lit la version anglaise ne voit jamais que l'agent s'est adressé à un client B2B de 60 ans comme à un adolescent.
- Fuites de mécanique. Variables, fragments anglais oubliés dans une macro, une formule de politesse anglaise dans une réponse espagnole. Cela se lit comme « personne ici ne parle ma langue ».
- Terminologie. Le nom de votre produit traduit en nom commun, ou trois mots différents pour la même fonctionnalité dans une seule réponse. J'ai écrit tout un guide sur les glossaires de traduction pour le support parce qu'aucun helpdesk ne fournit aujourd'hui de glossaire au niveau du ticket.
- Dérive des politiques. La macro anglaise dit retours sous 30 jours, la macro française a été traduite il y a deux ans et dit toujours 14. Chaque réponse est grammaticalement parfaite et l'une d'elles est fausse.
Quoi noter dans une réponse qui n'est pas en anglais
Gardez une seule grille pour toutes les langues. Séparer une « grille allemande » et une « grille anglaise » est le moyen de rendre les scores non comparables. Ce qui change selon la langue, c'est qui peut noter chaque ligne et à quoi ressemblent les exemples.
Je répartis les catégories avec une seule question : est-ce que cela survit à la traduction ? Si un relecteur qui lit une traduction automatique peut le noter de façon fiable, n'importe quel relecteur formé peut le noter. Si le signal se trouve dans la formulation d'origine, seule une personne qui lit la langue devrait le noter.
| Ligne de la grille | Ce qu'elle vérifie | Peut-on la noter sans risque à partir d'une traduction ? |
|---|---|---|
| Solution et exactitude | Bonne réponse, bonne politique, bonne prochaine étape | Oui, si la traduction est fidèle |
| Processus | Étiqueté, lié, escaladé correctement | Oui |
| Compréhension | L'agent a-t-il compris la vraie question | Plutôt oui |
| Correspondance de langue | A répondu dans la langue du client, sans fragments anglais | En partie (nécessite la vue d'origine) |
| Orthographe et grammaire | Mécanique dans la langue d'origine | Non |
| Formalité et ton | Sie vs du, niveau de politesse, chaleur | Non |
| Terminologie | Noms de produit intacts, termes approuvés utilisés | Non |
| Variables et fuites | Pas de jetons {{ }}, pas de notes internes, pas de formule de politesse dans la mauvaise langue | Oui, mais seulement dans l'original |
Les quatre lignes « Non » sont l'endroit où doivent aller vos heures de relecture native. Tout le reste peut être noté par vos relecteurs actuels avec une traduction, ce qui garde le programme abordable. Pour la grille générale derrière ces lignes, mon guide sur la qualité linguistique du support client détaille grammaire, clarté et ton, et le guide du ton en service client explique comment écrire des règles de ton sur lesquelles on peut réellement noter.
Une règle de plus pour la grille : faites de « la politique diffère de la source anglaise » une erreur critique. MQM, le cadre que les équipes de traduction professionnelles utilisent pour noter la qualité, traite une seule erreur critique comme un échec automatique, quelle que soit la qualité du reste (MQM values and scores). Le QA du support devrait s'en inspirer. Une politique de remboursement fausse et superbement rédigée reste une politique de remboursement fausse.
Empruntez les types d'erreurs que les traducteurs utilisent déjà
Inutile d'inventer des catégories. MQM classe les erreurs de traduction en sept groupes : terminologie, exactitude, conventions linguistiques, style, conventions locales, adéquation au public, et conception et balisage (MQM error typology). Ses pénalités par défaut sont de 0 pour neutre, 1 pour mineure, 5 pour majeure et 25 pour critique (MQM values and scores). La norme ISO 5060:2024 est le standard formel construit sur la même approche type d'erreur plus pénalité.
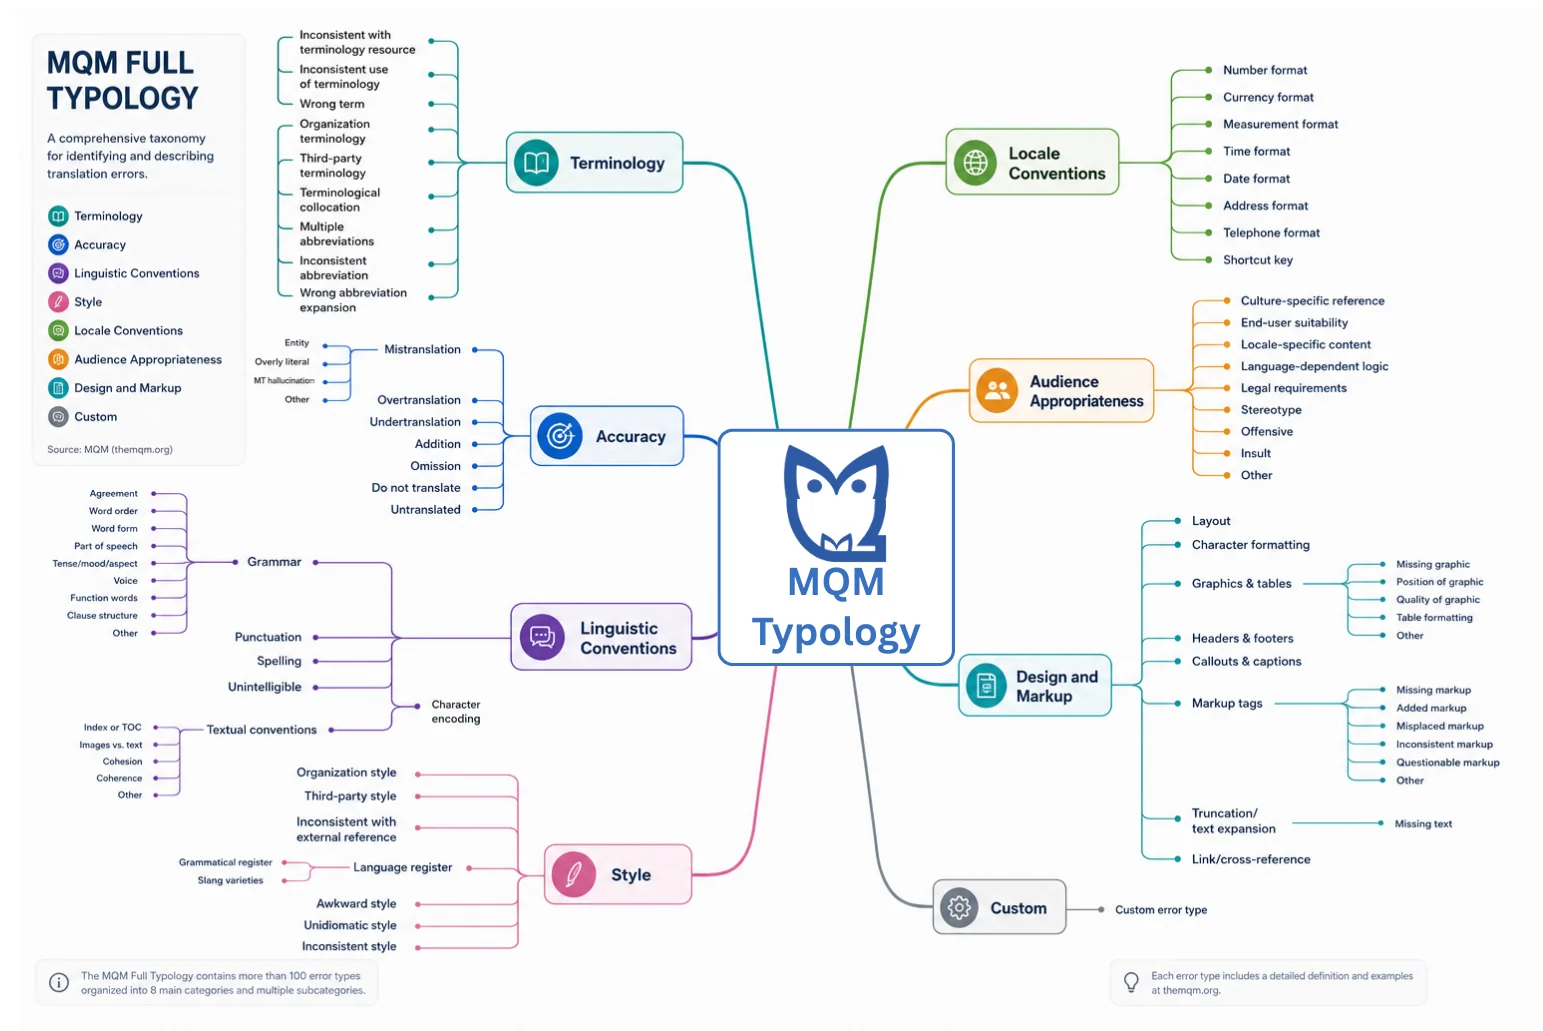
Deux branches correspondent bien au travail de support. Les « conventions locales » couvrent les formats de date, de devise, de nombre et d'adresse, précisément là où un agent formé aux États-Unis écrit 10/05 à un client allemand qui le lit comme le 10 mai. « Conception et balisage » couvre le balisage manquant ou cassé, la famille à laquelle appartient la fuite de variable. Je ne ferais pas tourner le scoring MQM complet sur des tickets de support (il est conçu pour des documents traduits et compte les erreurs pour 1 000 mots), mais utiliser ses noms de catégories comme étiquettes d'erreur rend vos données de QA bien plus exploitables.
Comment échantillonner les tickets quand une langue pèse 84 % du volume
L'échantillonnage aléatoire est équitable entre les tickets et injuste entre les langues. Si l'anglais représente 84 % de votre volume, l'allemand 12 % et le néerlandais 4 %, un échantillon aléatoire de 50 relectures par semaine donne 42 en anglais, 6 en allemand et 2 en néerlandais. Deux relectures ne peuvent pas dire si votre agent néerlandais a une habitude ou a eu un mauvais mardi. Les équipes téléphoniques ont le même problème, c'est pourquoi les programmes de QA de centre d'appels stratifient aussi généralement les échantillons.
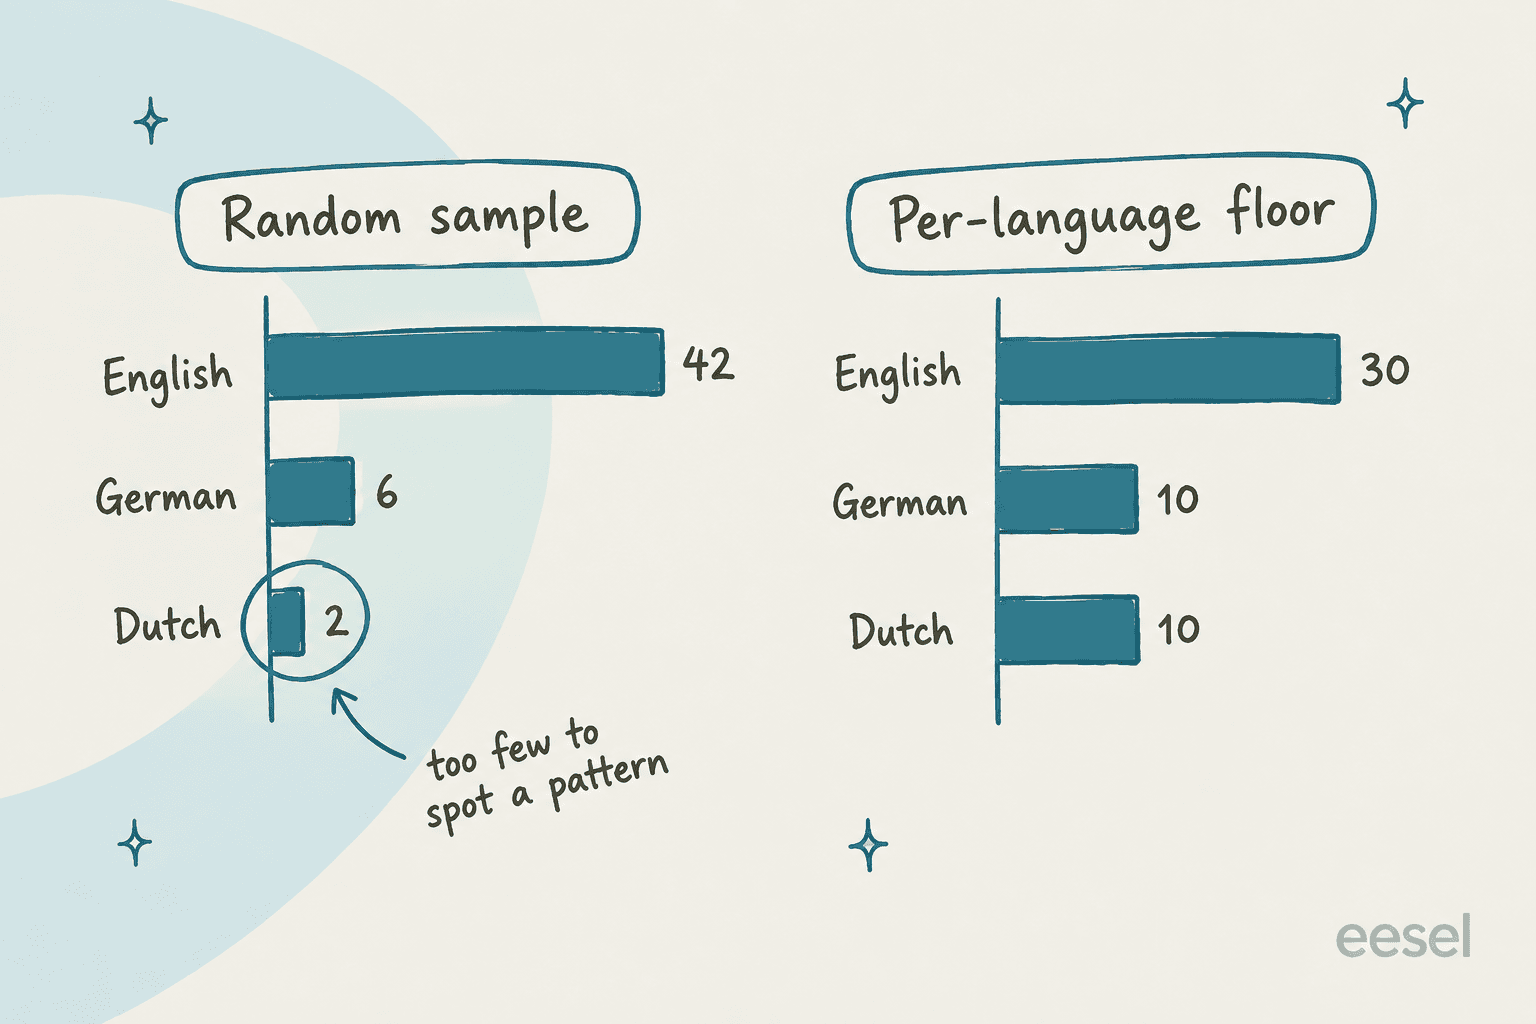
La solution est un plancher : chaque langue obtient au moins N relectures par semaine, et ce qui reste du budget va aux grandes langues proportionnellement au volume. Avec un plancher de 10, les mêmes 50 relectures deviennent 30 en anglais, 10 en allemand et 10 en néerlandais. L'anglais reçoit toujours le plus d'attention. Le néerlandais en reçoit enfin assez pour voir une tendance.
Saisissez ici vos propres chiffres :
Un plancher d'environ 10 par langue et par semaine est le plus petit nombre pour lequel je ferais confiance à une tendance. Si votre budget ne couvre pas cela pour chaque langue, relisez les petites langues une semaine sur deux à 20 plutôt que chaque semaine à 5. Moins de lots, mais plus gros, valent mieux qu'un filet d'eau.
Deux filtres rendent l'échantillon plus intelligent, pas seulement plus grand :
- Suréchantillonnez les nouveaux agents et les nouvelles langues. Le premier mois d'un nouveau marché ou d'une nouvelle recrue est le moment où les erreurs coûtent le moins cher à corriger. Mon guide d'intégration des agents explique comment concentrer la relecture sur les nouveaux arrivants.
- Suréchantillonnez les CSAT bas dans les petites langues. Un client néerlandais en colère, c'est 1 ticket néerlandais sur 25, pas 1 sur 625 au total. Récupérez-les à chaque fois. Les outils de CSAT par IA peuvent les faire remonter automatiquement.
Qui relit quoi : relecteurs natifs ou relecture traduite
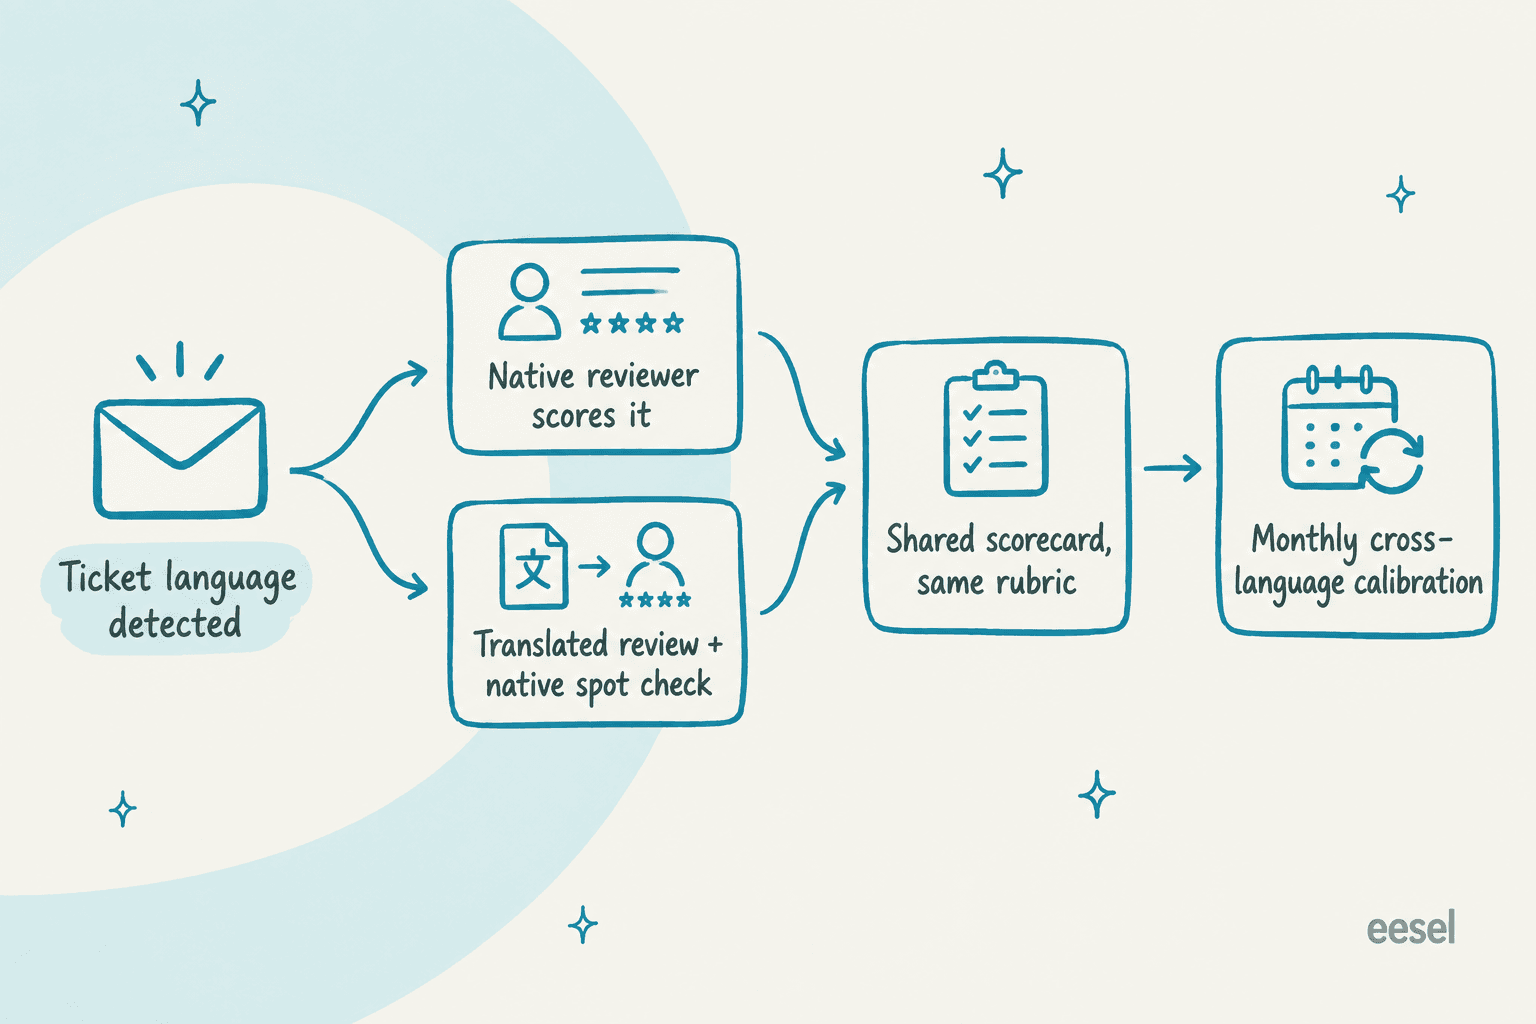
Il y a trois façons de doter le QA hors anglais en personnel, et la plupart des équipes finissent par utiliser les trois.
1. Relecteurs natifs dans chaque langue. La référence, et la plus coûteuse. Généralement un agent senior de cette équipe de langue, avec quelques heures par semaine de temps de relecture. Pour les équipes offshore, c'est souvent le responsable d'équipe de ce site. Ils se chargent des quatre lignes « Non » de la grille.
2. Relecture traduite par votre équipe QA centrale. Vos relecteurs actuels notent la solution, le processus et la compréhension via une traduction intégrée à l'outil. Peu coûteux, et cela garde un même regard sur l'exactitude dans chaque marché. Les équipes en support follow-the-sun s'appuient le plus là-dessus.
3. Contrôles natifs par sondage sur les relectures traduites. Une fois par mois, un locuteur natif re-note une poignée de conversations que l'équipe centrale a déjà notées via la traduction. Si les scores divergent, la relecture traduite manque quelque chose et vous déplacez plus de volume vers l'option 1. C'est aussi là que vous trouvez des lacunes de connaissances qui n'existent que dans une langue.
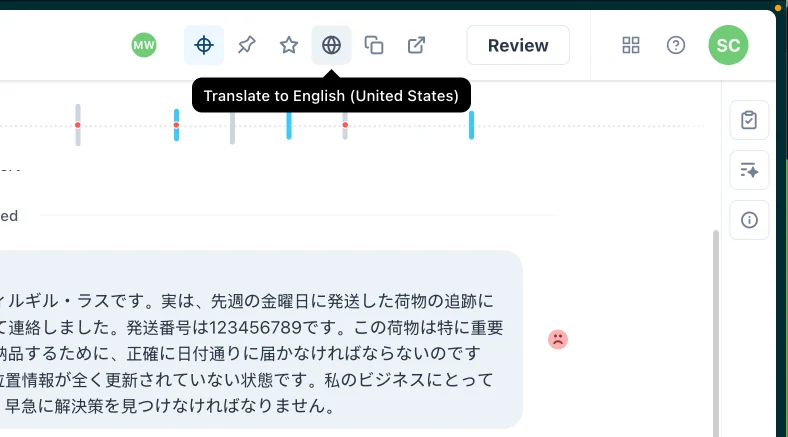
L'acheminement est la partie que les outils gèrent désormais bien. Dans Zendesk QA, les relecteurs peuvent traduire une conversation dans la langue de leur profil en cliquant sur une icône de globe et revenir à l'original (Using the Conversations view). Cela couvre 29 langues principales, et l'arabe, l'hébreu et l'ukrainien ne figurent pas sur la liste du QA alors que la traduction en direct de Support les couvre (Zendesk language support by product).
Pour l'acheminement, Zendesk QA propose un filtre de conversation Language (AI) avec des conditions « est » / « n'est pas » (conversation filter types), et les groupes peuvent organiser les relecteurs « selon des caractéristiques comme la langue » pour les affectations (groups in Zendesk QA). Je n'ai pas trouvé de commutateur unique « échantillonner N par langue ». Vous construisez le plancher en créant une affectation par langue avec une condition Language (AI) et un nombre fixe.
Un piège côté Zendesk Support : le champ Language du tri intelligent est lu à partir de l'objet et du premier commentaire public et « n'est pas mis à jour à chaque réponse de l'utilisateur final » (intelligent triage). Un client qui commence en anglais puis passe à l'allemand reste un ticket « anglais ». Utiliser les valeurs de tri dans les workflows exige aussi le module complémentaire Copilot (triage workflows). Plus de détails sur cette configuration dans mon guide du tri intelligent Zendesk.
Voilà ce qui arrive sans cela. Un responsable QA de centre d'appels l'a dit sans détour sur Reddit :
"I was responsible for QA on a team taking Spanish calls. Don't speak a word myself. Yea, plenty of 100's were given."

Des notes parfaites d'un relecteur qui ne peut pas lire la conversation ne sont pas des données de qualité. C'est un angle mort avec un chiffre dessus.
Ce que le QA automatisé peut et ne peut pas noter dans d'autres langues
Le QA automatisé comble l'écart de couverture, mais sa liste de langues est plus courte que la plupart des équipes ne le supposent. Voici la couverture d'AutoQA dans Zendesk QA, qui exige le module QA ou Workforce Engagement (autoscoring categories) :
| Catégorie AutoQA | Langues avec l'option LLM activée | Avec elle désactivée |
|---|---|---|
| Orthographe et grammaire | 9 variantes : anglais (US, UK), allemand, français, polonais, espagnol, portugais (BR, PT), néerlandais | Les mêmes 9 |
| Lisibilité | Anglais, espagnol | Anglais, espagnol |
| Salutation, clôture | Toutes | 8 langues |
| Ton, empathie, compréhension, solution proposée | Toutes | Non disponible |
Relisez cette première ligne. Un agent italien, japonais ou suédois ne reçoit aucun score automatique d'orthographe et de grammaire, même avec l'option LLM activée. Si la moitié de votre équipe écrit dans ces langues, votre tableau de bord « 100 % de couverture » les note sur tout sauf sur ce qu'un client natif remarque en premier.
Les paramètres par langue comptent aussi. Les exceptions d'orthographe (jusqu'à 300) et les salutations approuvées (jusqu'à 200) sont chacune associées à une langue, et « les salutations ne sont pas traduites » (customizing AutoQA). L'exemple de Zendesk lui-même : approuvez « Bom dia » pour toutes les langues et un agent qui écrit « Buenos días » dans une conversation en espagnol reçoit un vote négatif.
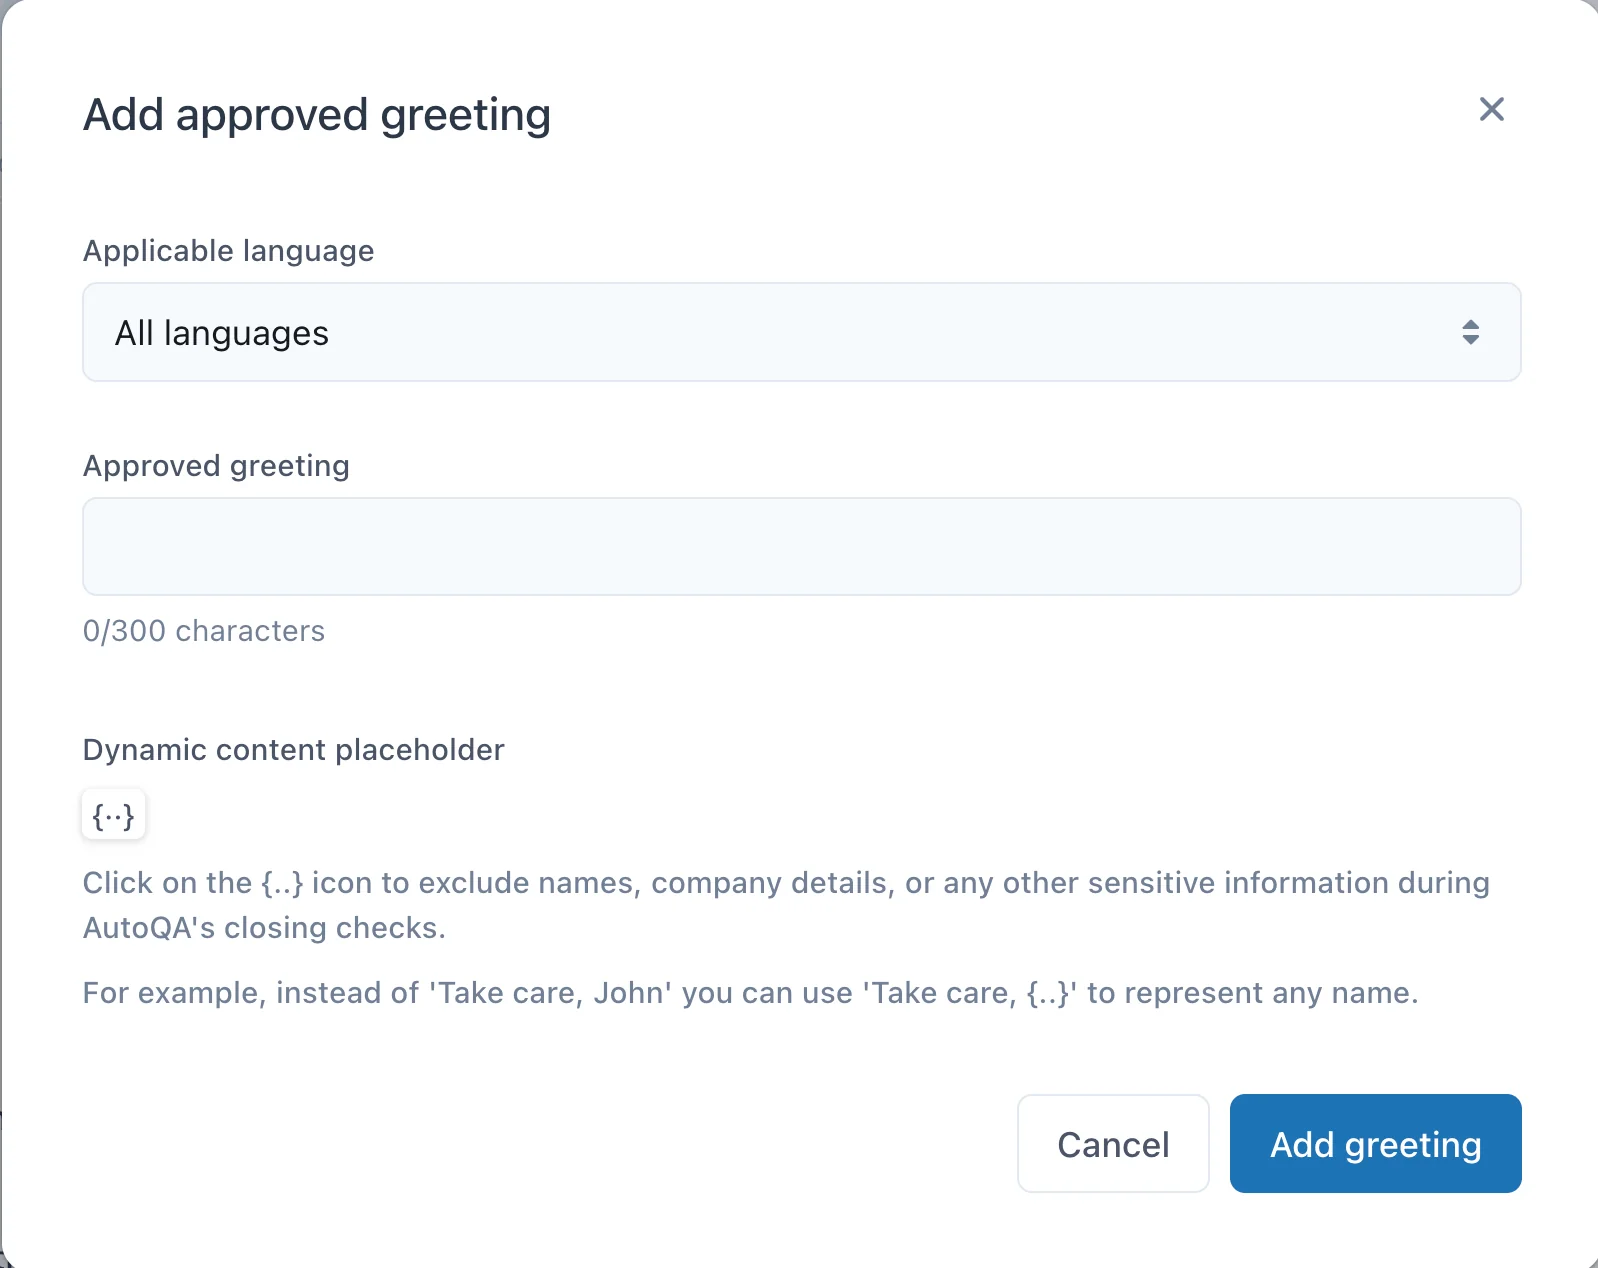
Configurez donc les salutations et les clôtures par langue dès le premier jour, sinon vos scores automatiques pénaliseront précisément les agents qui font bien le travail de localisation. Zendesk dit aussi que ses évaluations automatiques sont « à titre indicatif seulement » et ne doivent pas piloter seules les décisions de performance (Zendesk QA account settings), ce qui est la bonne posture pour toute langue où l'auto-score a des trous.
D'autres plateformes de QA documentent moins. evaluagent permet d'écrire des lignes de QA par IA générative dans votre propre langue et détecte automatiquement la langue parlée lors des appels. Rippit (le nouveau nom de MaestroQA) note 100 % des conversations avec des agents en langage courant (Rippit announcement), mais je n'ai pas trouvé de fonctions documentées de traduction ou de filtre par langue. Si la couverture linguistique compte pour vous, demandez la liste par écrit avant d'acheter.
Les outils de QA par IA que j'ai comparés varient beaucoup ici, et mon tour d'horizon des outils de QA couvre le champ plus large.
Ce que votre helpdesk offre d'office aux relecteurs
L'outil de QA n'est que la moitié du tableau. Les relecteurs travaillent souvent dans le helpdesk, et ce qu'ils peuvent y voir dépend de la fonction de traduction que vos agents utilisent.
| Helpdesk | Détection de la langue | Traduction qu'un relecteur peut voir | Offre ou limite |
|---|---|---|---|
| Zendesk | Champ Language du tri, ~150 langues, premier message seulement | Traduction des conversations sur tous les canaux sauf la voix ; les traductions des chats entrants ne sont pas enregistrées et se relancent au rechargement | Traduction des tickets à partir de Team+ ; le tri dans les workflows exige Copilot |
| Freshdesk | Détectée par ticket, les agents peuvent la modifier | Live Translate avec « See original », 43 langues | Pro/Enterprise, 100 tickets traduits par licence Copilot et par mois |
| Gorgias | Jusqu'à 54 langues, corps du message seulement | Traduction entrante et sortante, survol pour voir l'original | Toutes les offres helpdesk |
| Front | Détectée automatiquement en entrant et en sortant | La traduction reste visible pour tous les collègues du fil | À partir de Starter, 1 500 requêtes par collègue et par jour |
| Help Scout | Non documentée pour l'entrant | AI Assist ne traduit que le texte sortant | Plus/Pro, ou offres par contact |
Deux lignes de ce tableau causent de vrais maux de tête en QA. Les traductions des chats entrants de Zendesk « se relancent à chaque mise à jour ou rechargement d'un ticket, de sorte que les résultats de la traduction peuvent varier » (Zendesk), donc l'anglais que lit un relecteur n'est peut-être pas celui que l'agent a vu. Et Freshdesk compte de nouveau un ticket quand un autre agent le traduit (Freshdesk), si bien qu'un relecteur QA qui ouvre la traduction peut entamer le plafond mensuel des agents. Sur Freshdesk, faites utiliser aux relecteurs la traduction de l'outil de QA, pas celle des agents.
Pour approfondir outil par outil, voir les options de traduction natives de Zendesk, Front AI Translate et Freddy AI Copilot.
Si vous utilisez une couche de traduction, lisez son rapport de qualité
Les équipes sous Unbabel ou Language I/O ont déjà un second signal de QA et l'ignorent souvent. Unbabel exécute une estimation de qualité sur chaque traduction, en prédisant le score MQM qu'un relecteur humain donnerait. Ses rapports classent les traductions en cinq tranches, de Best (98 et plus) à Weak (moins de 60), et une paire de langues échoue à son seuil quand plus de 10 % tombent dans le rouge (Unbabel quality reporting).
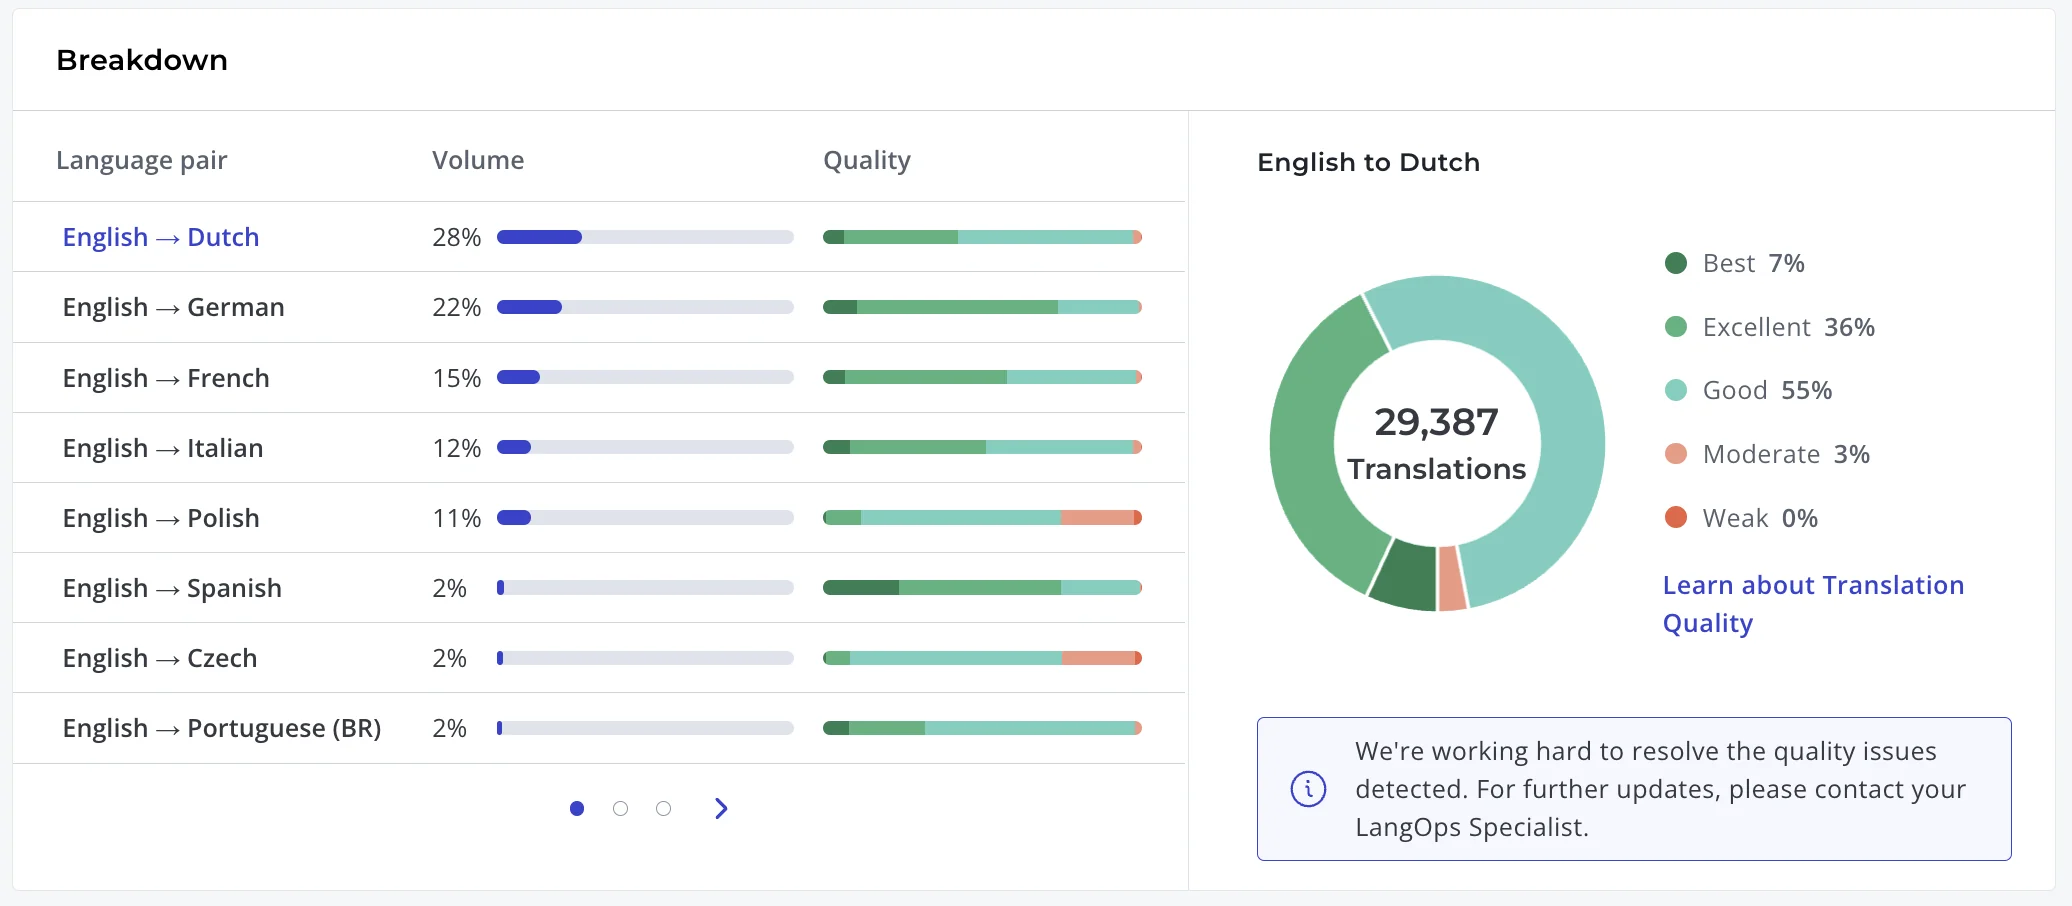
Cette vue par paire est utile pour l'échantillonnage. Si l'anglais vers le polonais a nettement plus de traductions Moderate que l'anglais vers l'allemand, consacrez davantage de vos heures de relecture native au polonais le mois suivant. Language I/O décrit une surveillance de la qualité en temps réel par rapport aux résultats passés et aux règles de glossaire, et permet aux agents de signaler et de régénérer une mauvaise traduction, mais ne publie pas d'échelle de notation.
Ce que ces rapports ne peuvent pas dire : si la réponse source était juste. Une traduction parfaite d'une mauvaise réponse obtient Best. La qualité de la traduction et la qualité du support sont deux contrôles différents, et il vous faut les deux.
Comment calibrer entre équipes de langues
La calibration est ce qui fait que les programmes de QA multilingue tiennent ensemble ou se scindent en îlots. L'objectif est simple : un « 4 sur 5 » de votre relecteur espagnol doit signifier la même chose qu'un « 4 » de votre relecteur anglais.
Ce qui marche, d'après mon expérience :
- Choisissez 5 à 8 conversations par mois, au moins une par langue. Prenez un mélange : une réponse propre, une avec une erreur de politique, une avec un problème de ton.
- Tout le monde note les mêmes conversations indépendamment, via la traduction si nécessaire. Les relecteurs natifs notent aussi les lignes purement linguistiques pour leur langue.
- Comparez les scores ligne par ligne, pas les totaux. Un total identique peut cacher un relecteur strict sur le ton et laxiste sur l'exactitude.
- Notez chaque désaccord résolu comme exemple dans la grille et faites remonter les problèmes récurrents vers le coaching. « Utiliser du avec un client B2B = échec de ton, voir ticket 4821 » vaut plus qu'un paragraphe de définition.
- Suivez l'écart par langue dans le temps. Si les scores d'une équipe de langue dérivent sans cesse, cette équipe a besoin de sa propre session.
Le score d'exactitude de Zendesk QA est un bon modèle ici : il mesure l'accord entre AutoQA et les relecteurs humains, et Zendesk considère tout ce qui dépasse 75 % comme un accord élevé (AutoQA dashboard). Appliquez la même idée entre vos relecteurs humains. Pour donner le feedback qui en résulte aux agents, mes guides sur les exemples de feedback QA et le feedback aux agents de support couvrent la formulation.
L'échec inverse est tout aussi fréquent : noter une conversation non anglaise par rapport à la formulation anglaise. Un agent bilingue l'a décrit exactement :
"I got QA-ed that my Spanish questions were not close enough to the English script, deducted 7 points."
Il n'y avait pas de script espagnol. Les séances de calibration sont l'endroit où ce genre de règle est repéré et réécrit en « correspond à l'intention du script, en espagnol naturel ».
QA des réponses IA dans d'autres langues
Si un agent IA rédige ou envoie des réponses dans d'autres langues, tout ce qui précède s'applique toujours, plus une règle : testez chaque langue avant le lancement, pas seulement l'anglais.
L'IA est très bonne en support multilingue. Lors d'un essai eesel, une marque allemande de bijoux traitant environ 1 000 tickets par mois sur Zendesk et Shopify a vu son agent gérer l'allemand, l'anglais, le français, le néerlandais, l'espagnol, le polonais, le croate et le turc sans que personne ne configure une seule langue. C'est le bon côté. Le revers est que chaque langue devient une surface en production dont vous êtes responsable, y compris celles que personne dans votre équipe ne lit.
Le revers apparaît quand personne ne relit la sortie hors anglais. Un administrateur Zendesk a décrit son ancien bot de réponses multilingue :
"the translations were often times wrong and our customers got mixed languages during their chat with the bot, ID customers will sometimes get Portuguese, IN customers would sometimes get Indonesian, and so on and so forth."
Ce que je vérifierais par langue avant d'activer le pilote automatique :
- Les réponses viennent de vos connaissances, pas de connaissances générales. Le même article du centre d'aide doit produire la même politique en français qu'en anglais. Si votre base de connaissances multilingue a des trous, l'IA les hérite.
- La formalité correspond à votre marque dans chaque marché. Écrivez-la comme une règle (« utiliser Sie avec tous les clients allemands ») plutôt que d'espérer.
- Les noms de produit restent non traduits. Une liste de termes à ne pas traduire a sa place dans vos instructions. Mon guide du glossaire de traduction montre comment.
- Pas de variables, pas de fragments anglais, pas de formule de politesse dans la mauvaise langue. C'est celle que je vérifierais en premier, pour les raisons données au début.
Puis rejouez l'historique. La simulation d'eesel rejoue de vrais tickets passés, note chaque réponse et suggère des corrections (eesel skills). Filtrez cette exécution sur vos tickets allemands et néerlandais et vous obtenez une lecture par langue avant qu'un seul client ne voie un brouillon. Zendesk QA note aussi automatiquement les agents IA de Zendesk et vous permet de signaler d'autres bots pour relecture (AI agents in Zendesk QA), ce qui couvre l'après-lancement. Mon guide du QA Zendesk pour les agents IA va plus loin.
Erreurs courantes du QA du support multilingue
- Relire uniquement via la traduction. Cela attrape les mauvaises réponses et rate tout ce à quoi un client natif réagit d'abord.
- Un seul relecteur anglais qui « possède » toutes les petites langues. Bien pour l'exactitude, aveugle au ton. Donnez à chaque langue un contrôleur natif, même à temps partiel.
- Copier les salutations anglaises dans chaque langue. Vos scores automatiques pénalisent alors les agents qui localisent correctement.
- Faire confiance au champ de langue détectée. Il est souvent défini à partir du seul premier message. Les tickets à langues mélangées finissent dans le mauvais groupe.
- Traiter la qualité de la traduction comme la qualité du support. Une traduction impeccable de la mauvaise politique laisse quand même tomber le client.
- Ne pas versionner les macros entre langues. La dérive des politiques commence le jour où quelqu'un met à jour la macro anglaise et oublie les cinq autres. Une procédure de support avec un responsable par langue l'évite.
Essayez eesel pour le support multilingue
Si vous assurez le support en trois ou quatre langues, la charge de QA grandit avec chaque marché ajouté. C'est pourquoi j'ai mis eesel dans ma liste des meilleures IA pour le support multilingue.
Le coéquipier IA pour helpdesk d'eesel se branche sur Zendesk, Freshdesk et le reste de votre stack, répond dans la langue du client sans que vous ayez à traduire votre centre d'aide, et accepte des règles en langage courant comme « utiliser Sie avec les clients allemands » ou « ne jamais traduire les noms de nos produits ». Avant la mise en production, vous rejouez vos propres tickets passés dans chaque langue et voyez où il se serait trompé.

La plupart des équipes commencent avec des brouillons en notes internes, pour que vos relecteurs natifs voient chaque réponse hors anglais avant un client, puis passent à l'envoi automatique par langue quand les scores se maintiennent. Les offres démarrent à 299 $ par mois pour 500 crédits, avec un essai gratuit (eesel pricing). Essayez eesel d'abord sur une file d'une seule langue et voyez comment il se note.
Comment faire le QA de tickets dans une langue que les relecteurs ne parlent pas ?