

En bref
Le seul benchmark d’agent de support IA sur lequel vous pouvez vraiment vous appuyer consiste à évaluer votre agent et votre équipe sur les mêmes tickets, avec une seule définition de « résolu ». Les taux de résolution des fournisseurs ne sont pas comparables entre eux : Zendesk, Gorgias, HubSpot, Freshdesk, Salesforce et Help Scout utilisent chacun un critère différent, si bien que le même client silencieux compte comme une réussite dans un outil et comme un résultat incertain dans un autre. Les tests publics comme tau-bench classent les modèles, pas votre configuration. La simulation d’eesel fait précisément cela : elle rejoue vos tickets résolus, compare les réponses à celles que votre équipe a réellement envoyées et évalue chaque sujet avant que quoi que ce soit n’arrive à un client.
Que signifie vraiment « évaluer un agent de support IA » ?
Je développe des agents IA chez eesel, et la question que j’entends le plus souvent après un déploiement ressemble à « est-ce que 60 %, c’est bien ? ». La réponse honnête, c’est que tout dépend de ce que représentent ces 60 %. Quand quelqu’un parle de « benchmark », il désigne généralement l’une de trois choses différentes, et c’est en les confondant que les équipes se retrouvent avec un chiffre dont elles ne peuvent rien faire.
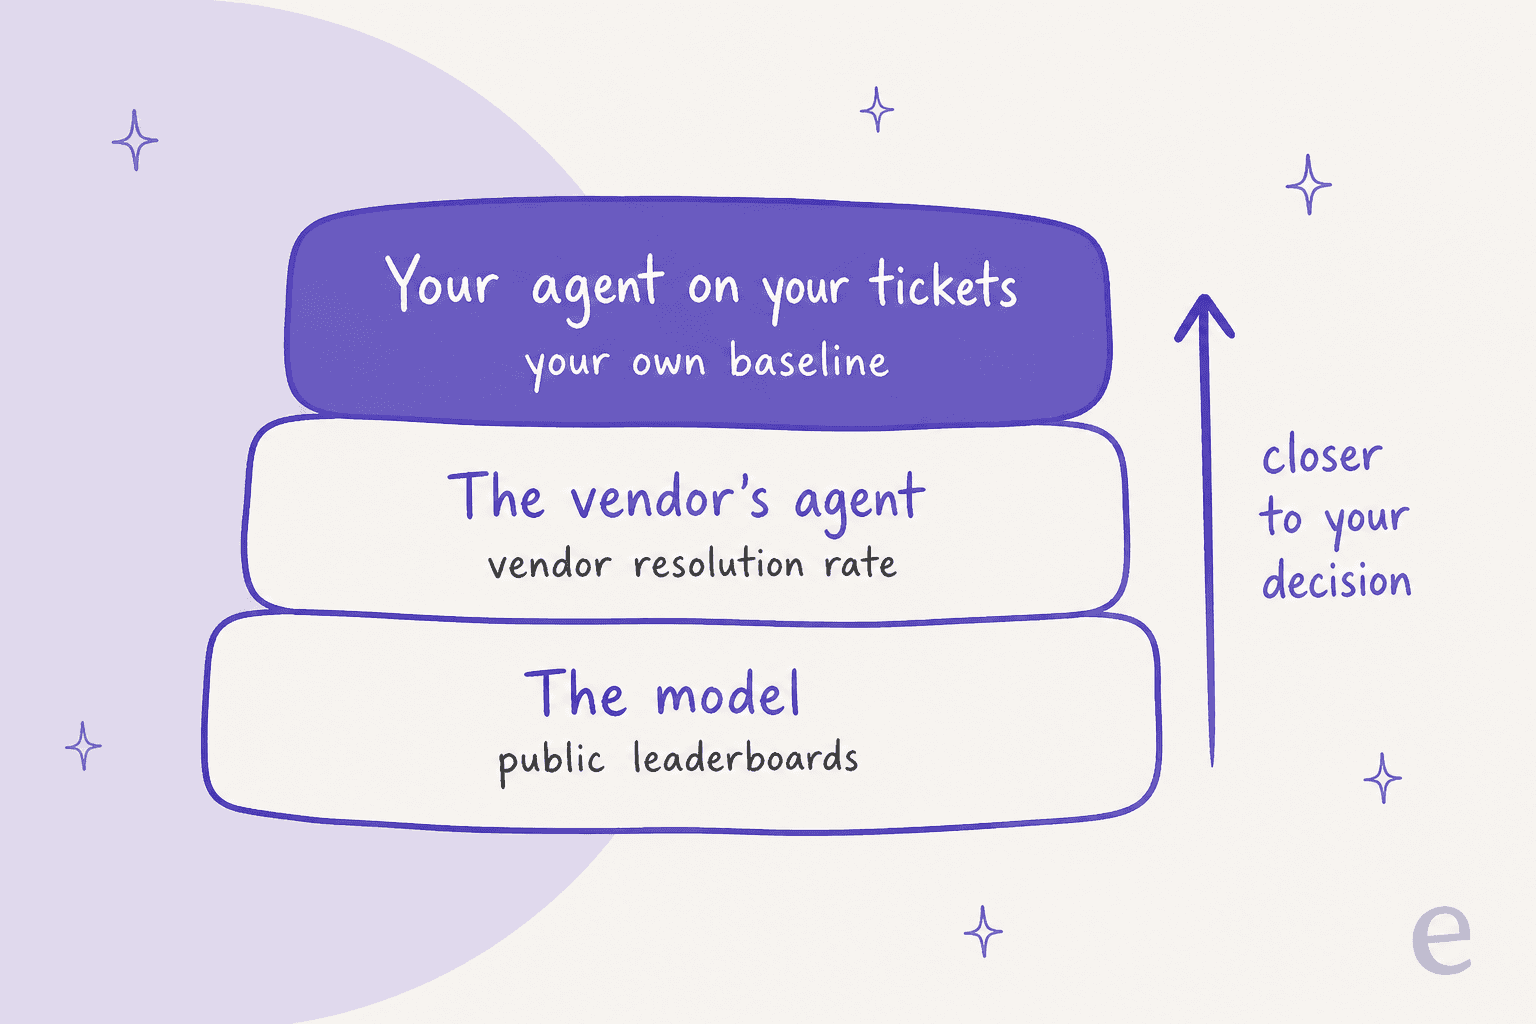
- Le modèle. Les classements publics comme tau-bench testent le grand modèle de langage sous-jacent sur des tâches de support simulées. Utile pour choisir un modèle, mais cela ne dit rien sur votre base de connaissances.
- L’agent du fournisseur. Le taux de résolution affiché par votre plateforme de support, ou la moyenne qu’un fournisseur met sur sa page d’accueil. Chacun est défini par ce fournisseur, pour sa propre facturation.
- Votre agent sur vos tickets. Votre configuration, vos documents, vos règles, évalués par rapport à la façon dont votre propre équipe a traité les mêmes questions. C’est ce qui vous indique s’il faut élargir le périmètre de l’IA.
Chaque niveau vous rapproche de la décision que vous devez réellement prendre. La suite de cet article passe en revue les trois, car l’erreur que je vois le plus souvent est une équipe qui cite le deuxième niveau comme s’il s’agissait du troisième.
Pourquoi ne peut-on pas comparer les taux de résolution des fournisseurs ?
Parce que chaque fournisseur comptabilise une résolution selon un critère différent, et que la plupart facturent selon ce même critère. J’ai parcouru la documentation d’aide de chaque fournisseur cette semaine, et aucun ne s’accorde avec un autre sur ce que signifie « résolu ».
| Fournisseur | Ce qui compte comme résolu | Délai | Facturé sur cette base ? | Prix par unité |
|---|---|---|---|---|
| Zendesk | L’IA a répondu, le client n’a rien demandé de plus et un LLM confirme que la demande a été résolue de manière satisfaisante. Échec du contrôle = "Contained", non facturé | 72h pour les e-mails, 2h par défaut pour la messagerie (jusqu’à 72h), à compter du premier message | Oui | $1.50 avec engagement, $2.00 à l’usage |
| Gorgias | Entièrement traité par l’IA ou une automatisation, sans intervention humaine nécessaire dans les 72 heures | 72h | Oui, plus les frais du ticket | $1.50 en dépassement sur la page des tarifs |
| HubSpot | L’agent a répondu avec une source de contenu ou une action, sans transfert demandé par le visiteur, ou un prospect a été marqué comme qualifié, partiellement qualifié ou non qualifié | 72h après le dernier message du visiteur | Oui | $0.50 (50 crédits) |
| Freshdesk Freddy | Rapports : clôturé sans intervention humaine. La facturation se fait par session, quel que soit le résultat | 24h pour le chat, 72h pour les e-mails par session | Non, facturé par session | $49 pour 100 sessions |
| Salesforce Agentforce | "Deflected" lorsqu’un LLM attribue à la session une note de 4 ou 5, ce qui signifie "mostly or fully resolved" | Délai d’abandon de 2h | Non, facturé par conversation | $2 par conversation |
| Help Scout | L’IA a répondu et le client n’a pas demandé d’aide supplémentaire ensuite | Non documenté | Oui | $0.75 |
Trois différences comptent plus que les autres.
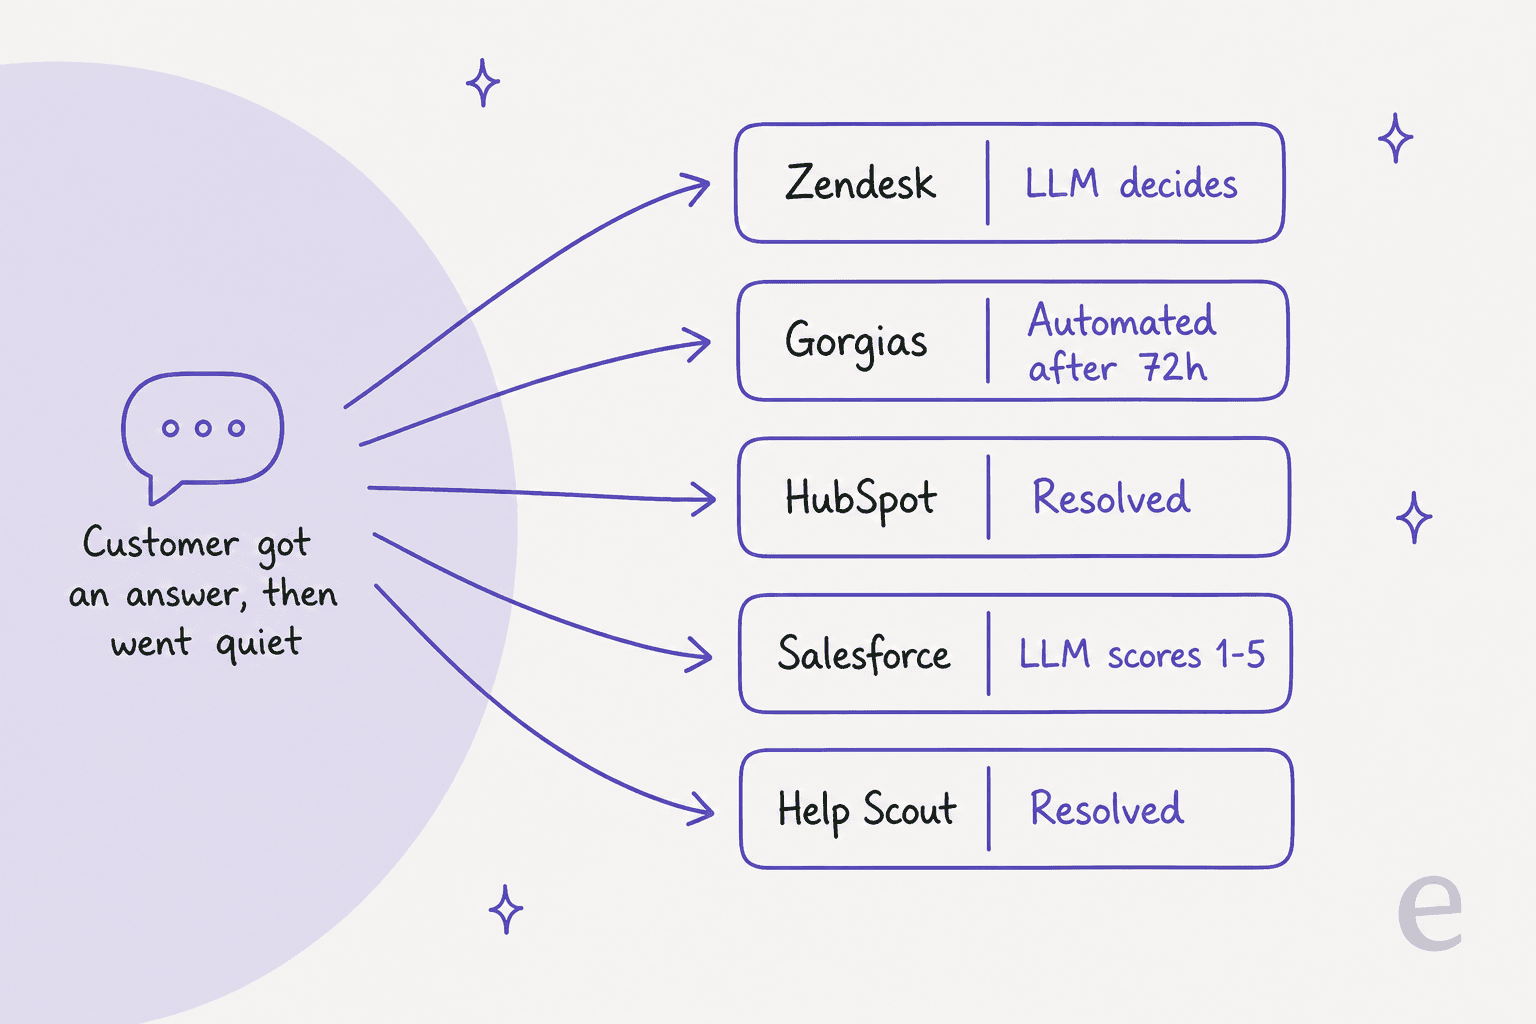
Qui décide que cela a fonctionné. Zendesk et Salesforce font évaluer la transcription par un LLM. Gorgias, HubSpot et Help Scout comptabilisent l’absence d’intervention humaine : personne n’a demandé à parler à quelqu’un, donc cela compte. Ce sont des questions différentes. « Le client a-t-il obtenu ce dont il avait besoin ? » et « le client a-t-il abandonné sans rien dire ? » donnent le même résultat dans un indicateur qui ne vérifie que le silence.
Ce qui empêche de comptabiliser une résolution. La documentation de HubSpot indique que seuls les transferts demandés par le visiteur sont pris en compte comme des échecs, et que les événements ultérieurs tels que "messages from a live agent, a transfer request, or negative feedback, will not change the resolution status". Un workflow qui oriente un ticket vers une personne après la réponse de l’agent n’annule pas la résolution.
Quel est le dénominateur. Gorgias affiche deux chiffres qui se ressemblent : un taux de réussite sur les tickets traités par l’IA, et un taux d’automatisation sur l’ensemble de votre volume facturable. Même mois, mêmes tickets, deux pourcentages très différents.
Voici ce que cela donne pour une conversation ordinaire : l’agent répond, et le client ne répond jamais.
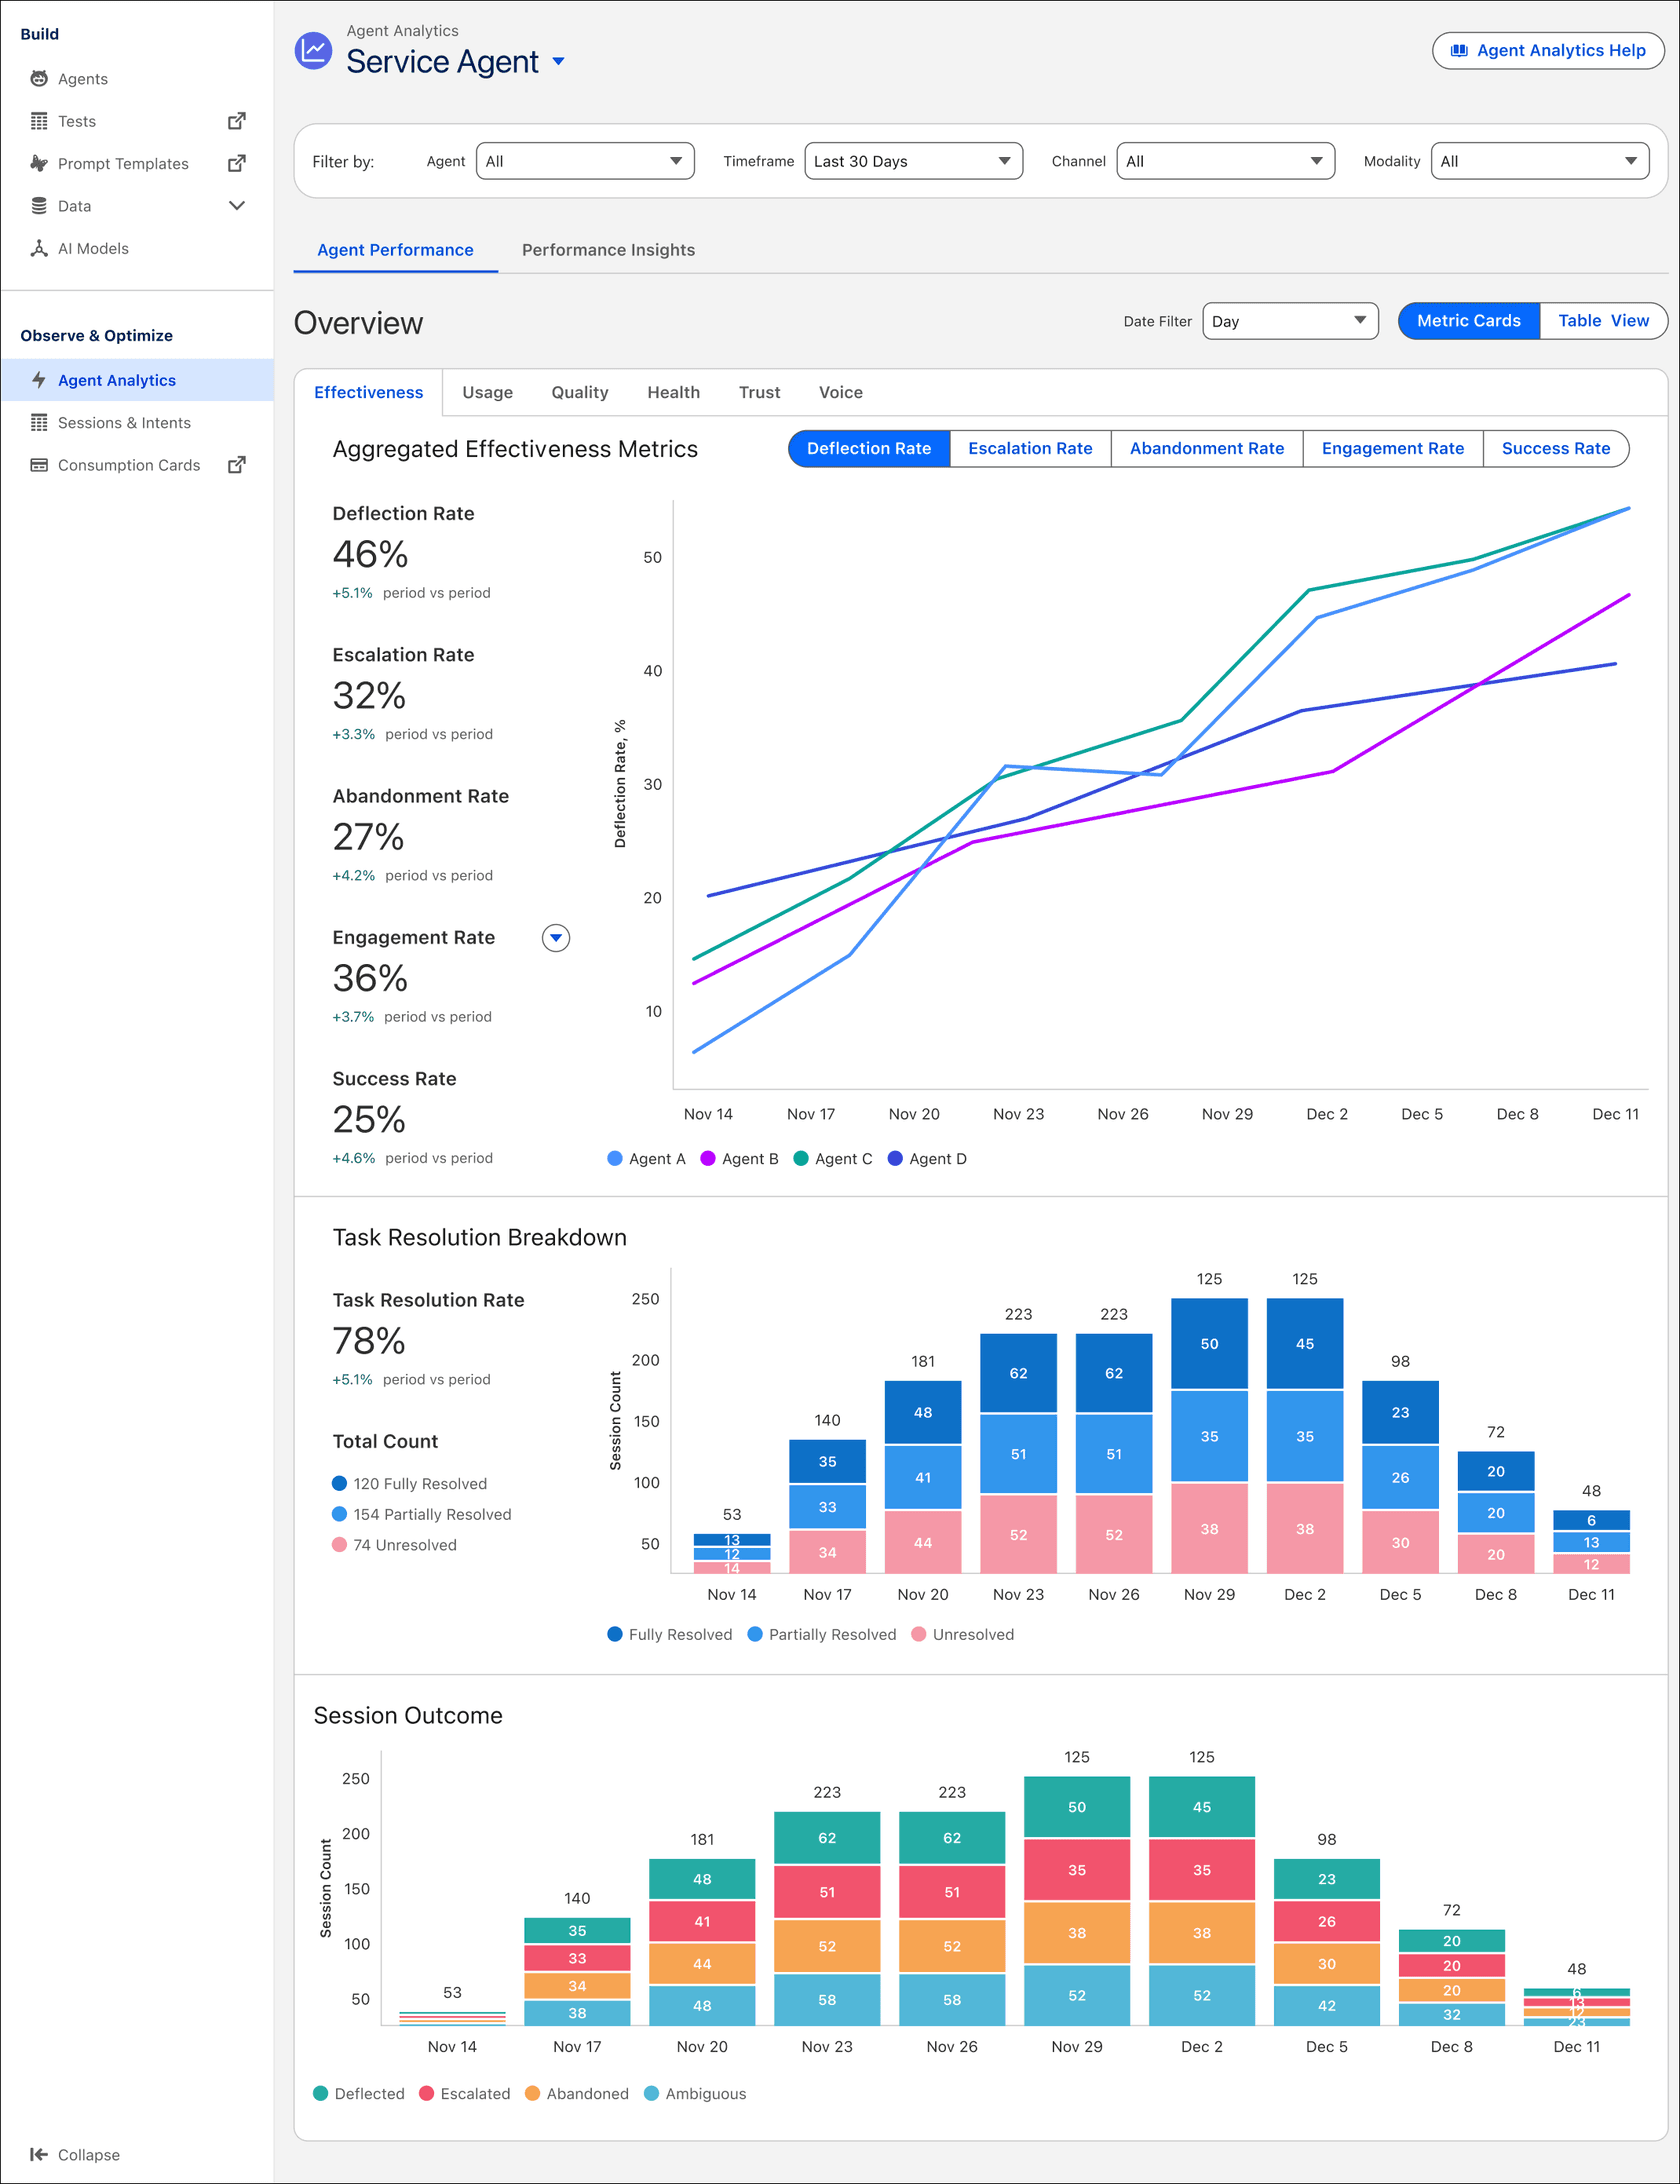
Même au sein d’un seul produit, le chiffre change selon l’indicateur choisi. L’exemple de tableau de bord Agent Analytics de Salesforce affiche, pour le même ensemble de sessions, un taux de déviation de 46 %, un taux de réussite de 25 % et un taux de résolution des tâches de 78 %.
Rien de tout cela ne rend les fournisseurs malhonnêtes. Chaque définition est documentée, et le blog de Zendesk lui-même prévient que "different tools may classify 'resolved' in different ways". Cela signifie simplement qu’une affirmation en page d’accueil comme les 65 % de conversations de HubSpot sur 8 000+ clients est un chiffre fondé sur la définition de HubSpot. Ce n’est pas un seuil auquel vous pouvez comparer votre agent Zendesk ou Gorgias.
Pour approfondir ces définitions, commencez par mon article sur le taux de déviation par rapport au taux de résolution. Les utilisateurs de Zendesk peuvent aller plus loin avec les indicateurs des agents IA Zendesk, et l’aspect tarifaire est traité dans le coût par résolution.
"For comparing vendors, the only fair test I know is to run them on the same slice of your own traffic and score it with your own definition. Their published numbers mostly just tell you which definition they chose."

Que vous apprennent les benchmarks publics comme tau-bench ?
Ils vous indiquent quels modèles gèrent bien les tâches de type support et, plus utilement, à quelle fréquence ils réussissent la même tâche deux fois. Le tau-bench de Sierra place un modèle face à un client simulé, avec de vrais outils et un document de règles, puis, selon l’article de recherche sur tau-bench, compare "the database state at the end of a conversation" à l’état attendu. Il n’évalue pas si la réponse était agréable à lire. Il vérifie si le remboursement a réellement été effectué, et s’il devait l’être.
L’idée à reprendre pour votre propre benchmark est pass^k. Les auteurs de l’article le définissent comme "the chance that all k i.i.d. task trials are successful" : exécutez la même tâche k fois avec un client qui la formule différemment à chaque fois, et ne la comptez comme réussie que si chaque essai aboutit. Dans l’article original, le meilleur agent réussissait plus de 60 % des tâches de commerce de détail en un seul essai, mais moins de 25 % lorsqu’il devait réussir la même tâche huit fois.
Le classement actuel raconte la même histoire. J’ai récupéré toutes les soumissions du dépôt public de résultats de Sierra :
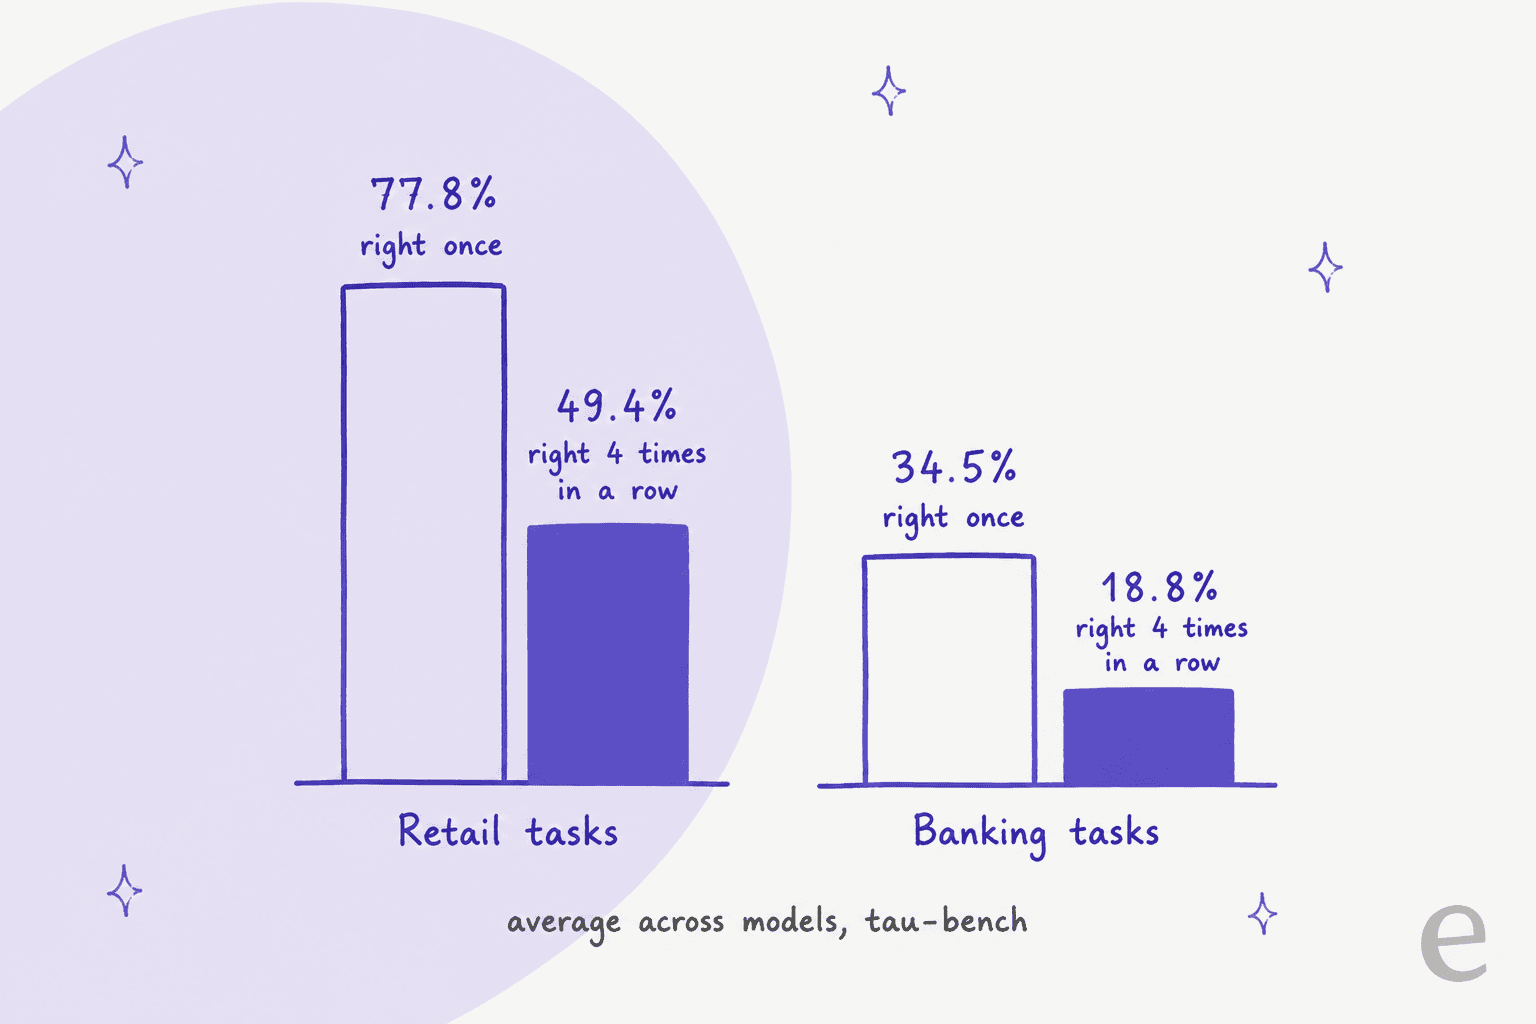
Le test bancaire est plus difficile, car la réponse se trouve dans 698 documents de règles plutôt que dans un outil, et les tâches nécessitent en moyenne 18.6 documents et 9.5 appels d’outils, selon la présentation de tau-Knowledge. C’est la situation de la plupart des véritables services de support : la réponse se trouve quelque part dans vos documents. Le meilleur modèle textuel dans ce test, Qwen 3.8 Max, obtient 55.2 en un essai et 35.1 sur quatre essais.
Si vous souhaitez une vue plus large, Fireworks publie un indice Customer Support qui présente cinq benchmarks côte à côte au lieu de les fusionner en un seul score :
| Benchmark (responsable) | Ce qu’il teste | Évaluation | En tête (novembre 2026) |
|---|---|---|---|
| τ³-Banking (Sierra) | Demandes bancaires soumises à des règles, avec des outils et un utilisateur simulé | Récompense moyenne par essai | Gemini 4 Argon 58.25%, Claude Opus 5.5 56.01% |
| Cresta-Bench (Cresta) | 181 appels simulés répartis entre 4 agents de centre de contact | pass^3, "a case counts only when all three runs pass" | Claude Opus 5.5 82.57%, Claude Haiku 5.5 en dernière position à 20.05% |
| DuetBench-Diagnosis (Decagon) | Conversations de diagnostic réelles rejouées, évaluation à l’aveugle | Classement Elo | Claude Opus 5 1034.9 |
| τ³-Voice (Sierra) | Agents vocaux en duplex intégral | Pass@1 | Pine Voice 1.0 87.33% |
| vCX (Retell AI) | Agents vocaux suivant des instructions et appelant des outils | Score | GPT-6.1 Sol 93.4% |
Deux réserves avant de vous appuyer sur ces résultats. D’abord, 27 des 29 soumissions textuelles sur tau-bench ont été exécutées par Sierra elle-même : il s’agit donc du dispositif de test d’un seul laboratoire, pas d’une compétition indépendante. Ensuite, et surtout, aucun de ces tests ne connaît votre politique de retour, vos macros ni les trois articles d’aide qui se contredisent. Un classement de modèles n’est pas un classement d’agents de support prêts à l’emploi. Utilisez ces résultats pour présélectionner un modèle, puis testez votre configuration. J’approfondis le choix du modèle dans mon comparatif des modèles pour le support.
Comment comparer votre agent IA à votre équipe humaine ?
Vous les évaluez tous deux sur les mêmes types de tickets, avec la même grille, sur la même période. Le piège, c’est la moyenne brute : l’IA reçoit les réinitialisations de mot de passe et les suivis de commande, votre équipe reçoit les litiges de remboursement avec des clients mécontents, et l’IA finit par paraître plus rapide et meilleure parce que ses tickets étaient plus faciles.
Voici la méthode que j’appliquerais, et celle que je transmettrais à toute équipe qui se lance.
- Choisissez une définition de « résolu » et consignez-la. Ma définition par défaut : le problème du client a été réglé, rien n’a enfreint les règles et le client n’est pas revenu pour le même problème dans les 7 jours. C’est plus strict que chaque ligne du tableau des fournisseurs ci-dessus, et c’est normal.
- Commencez par répartir vos tickets par sujet. Remboursements, suivi de commande, questions pratiques, facturation, bugs. Évaluez chaque sujet, jamais un chiffre global. Un 90 % sur les questions pratiques et un 40 % sur les remboursements donnent une moyenne qui ne veut rien dire.
- Rejouez des tickets résolus avant d’examiner les données en direct. Prenez des tickets que votre équipe a déjà clôturés, demandez à l’agent d’y répondre sans rien envoyer et comparez chaque réponse à ce que votre équipe a réellement écrit. La réponse de votre équipe est la référence. C’est là que vous repérez les pires échecs, sans entamer la confiance de vos clients. Mon guide des tests de simulation couvre l’évaluation et les tailles d’échantillon.
- Évaluez manuellement un échantillon à l’aveugle. Mélangez les réponses de l’IA et les réponses humaines sur les mêmes sujets, masquez leur origine et notez-les avec une seule grille : correcte, partiellement correcte, erronée, aurait dû être transférée. Une grille d’assurance qualité convient très bien ici.
- Comparez ensuite les chiffres en conditions réelles, par sujet, sur la même période. Taux de réouverture, CSAT, délai de résolution et coût par ticket résolu, IA contre humain, sujet par sujet.
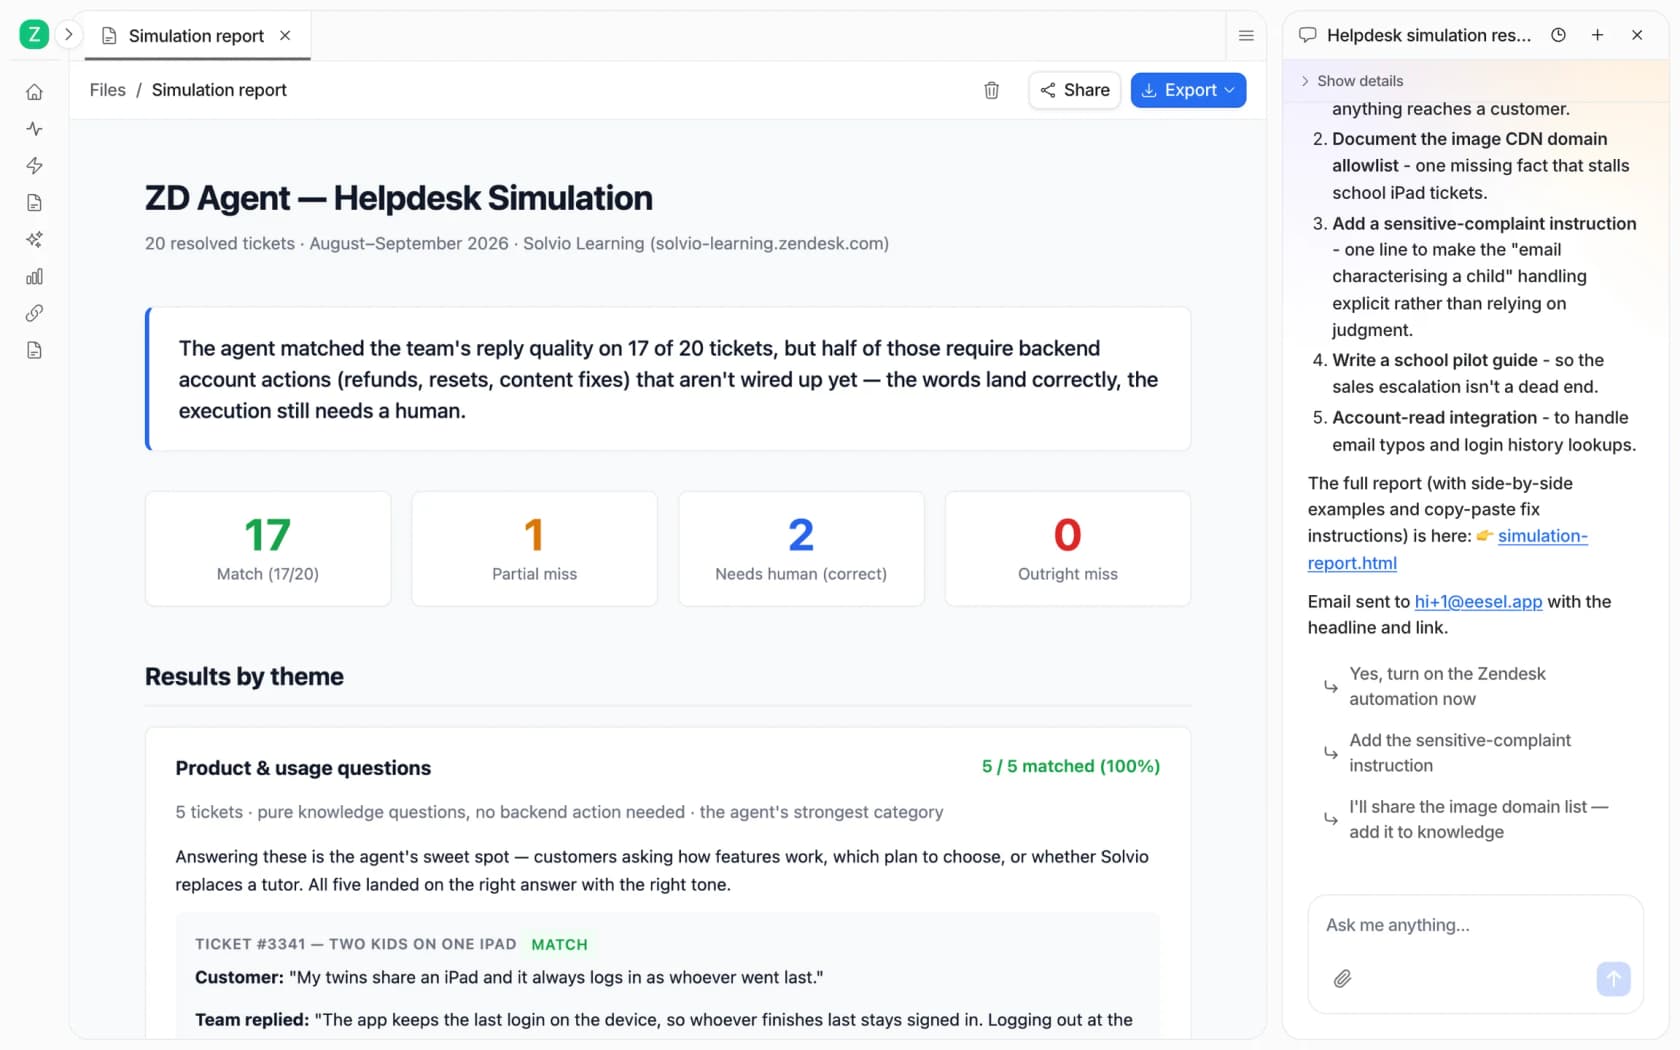
L’étape 4 compte plus qu’il n’y paraît. Lors d’un essai sur du trafic réel mené par eesel pour un bijoutier en ligne allemand sur Zendesk et Shopify, le même agent a obtenu 93% de précision dans le tri des tickets, avec un taux d’erreur factuelle de 7%, et pourtant seulement 12% de ses brouillons ont été envoyés tels quels. Trois chiffres vrais issus d’un seul essai, qui racontent trois histoires différentes. En examinant les réécritures, j’ai constaté qu’environ 65 % correspondaient à des brouillons raccourcis ou dont le ton avait été modifié par l’équipe, ce qui relève du style, pas de l’exactitude. Si je m’étais fondé uniquement sur le critère « envoyé tel quel », j’aurais considéré comme un échec un agent dont les réponses étaient majoritairement correctes.
Un autre échantillon m’a appris une deuxième leçon : testez sur de vrais tickets, pas sur les questions que vous poseriez pendant une démonstration. Sur un échantillon de 434 chats examiné par eesel, les chats IA ont obtenu 86 % de bons résultats au total, mais 79 % sur les chats issus de vrais tickets de support. Vos propres questions sont toujours plus faciles que celles de vos clients.
"I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Un responsable de l’expérience client d’une marque de compléments alimentaires vendus directement aux consommateurs, sur Gorgias et Shopify, lors d’un appel commercial avec eesel
Cette citation explique concrètement pourquoi il faut évaluer par sujet. Vous ne pouvez pas tout auditer, donc le véritable rôle du benchmark est de vous indiquer quels sujets l’IA peut prendre en charge et lesquels elle doit transférer.
Quels chiffres inclure dans votre grille d’évaluation de l’IA ?
Moins que ce qu’affiche votre tableau de bord. J’en garderais cinq, tous mesurés par sujet, tous calculés à partir de vos propres données plutôt que du champ de résolution du fournisseur.
| Indicateur | Comment le calculer | Pourquoi il figure dans la liste |
|---|---|---|
| Taux d’intervention | Tickets sur lesquels l’IA est intervenue ÷ tous les tickets | Vous indique quelle part de la file l’IA voit réellement |
| Taux de traitement sans humain | Tickets IA sans réponse humaine ÷ tickets IA | À peu près ce que la plupart des fournisseurs appellent la résolution. Utile, mais généreux |
| Taux de résolution vérifiée | Tickets traités sans humain, sans retour dans les 7 jours et ayant passé le contrôle qualité ÷ tickets IA | La version honnête du chiffre ci-dessus |
| Taux d’automatisation de bout en bout | Résolutions vérifiées ÷ tous les tickets | Celui qui intéresse la finance |
| Résolution au premier contact et CSAT, plus coût par résolution vérifiée, IA contre humain | Même formule pour les deux, mêmes sujets, même période | La véritable comparaison directe |
L’écart entre le traitement sans humain et la résolution vérifiée est le chiffre le plus utile que vous calculerez. S’il est faible, le chiffre du fournisseur est assez proche de la réalité pour être fiable. S’il est important, l’agent clôture des tickets qui ne sont pas vraiment réglés. Un professionnel sur Reddit l’a appris à ses dépens :
"i track cost per resolution with a 48 hour window for reopens, automation rate alone is basically useless we had a period where our "automation rate" looked incredible but half those customers were just giving up and calling in later, the dashboard was lying to us"
Saisissez les chiffres de votre propre mois pour voir l’écart :
Avec les chiffres par défaut, les mêmes 6 000 tickets IA affichent 70 % de traitement sans humain et 52 % de résolution vérifiée, et seulement 31 % de l’ensemble de la file est réellement automatisé. Les trois chiffres sont honnêtes. Un seul est celui que vous devriez présenter à votre responsable. Pour un ensemble plus large d’indicateurs, mon guide des indicateurs du service client IA va plus loin. L’article sur les KPI du service client couvre les objectifs des équipes humaines, et celui sur les benchmarks du coût par ticket traite du volet humain de la comparaison des coûts.
À quoi ressemble un bon résultat en pratique ?
Un bon résultat, c’est une part de sujets entièrement pris en charge par l’IA, qui augmente de façon délibérée, pas un gros pourcentage dès le premier jour. Les témoignages clients d’eesel le montrent plus clairement que n’importe quelle moyenne, car ils décrivent la répartition du travail plutôt qu’un taux unique.
- ClutchLoop, une marque d’accessoires pour téléphones sur Gorgias et Shopify, a enregistré environ
180réponses envoyées directement aux clients en un mois, "about seven in ten conversations, no person needed". - Question Beauty, une marque de cosmétiques sur Gorgias, a vu environ
280tickets clôturés par eesel et environ250attribués à une personne, sur990tickets traités. - SE Ranking, sur Zendesk, a enregistré
2,100chats en direct ayant reçu une première réponse d’eesel sur4,650conversations. L’entreprise teste désormais les réponses directes par e-mail sur des tickets de test sélectionnés selon leur objet, chaque fil étant marqué comme ouvert, résolu, escaladé ou pris en charge par une personne, et un fil ne compte comme résolu que "once the customer says it worked". C’est un critère plus strict que celui de n’importe quel fournisseur du tableau ci-dessus. - Cactus Club Cafe gère son support informatique interne sur Zendesk et a fait le choix inverse :
790brouillons de réponse pour l’équipe technique, "against 51 sent directly". Pour leurs tickets, garder une personne dans la boucle est le bon objectif d’évaluation.
"In the first month, eesel is resolving 73% of our tier 1 requests. eesel offers easy Zendesk implementation and setup. Our team implemented and achieved results quickly during our 7-day trial."

Notez le périmètre de cet avis : les demandes de niveau 1, pas tous les tickets. C’est exactement ainsi qu’un benchmark devrait être cité. Si quelqu’un vous donne un taux de résolution sans préciser quels tickets il couvre et comment le statut « résolu » a été déterminé, vous n’avez pas encore de benchmark. Pour savoir comment faire progresser ce chiffre une fois mesuré, consultez mon guide pour améliorer le taux de résolution.
Quelles sont les erreurs les plus courantes dans l’évaluation de l’IA ?
La plupart viennent du fait qu’on mesure ce qui est facile, parce que le tableau de bord l’affiche déjà.
- N’évaluer que des questions auxquelles il est possible de répondre. Si votre jeu de test ne contient que des questions couvertes par votre documentation, vous passerez à côté du pire échec : l’agent qui invente une réponse alors que la base de connaissances ne contient rien. Ajoutez des questions auxquelles vous savez ne pas pouvoir répondre et vérifiez qu’il passe le relais à la place. Mon article sur les hallucinations de l’IA dans le support traite de ce sujet.
- Compter les clôtures plutôt que vérifier l’exactitude. Une réponse erronée qui semble correcte peut tout de même entraîner une clôture comme résolu.
"The hardest ones are wrong answers that sound right. Nothing errors, the customer doesn't push back, and the ticket can close as resolved. If a refund window changes and the agent is still working from the old policy text, the resolution rate won't flag it, because that metric only counts closures."
- Se fier à un seul essai. tau-bench a montré que les scores baissaient d’environ un tiers à la moitié lorsque la même tâche devait être réussie quatre fois. Relancez votre jeu de test après chaque modification des instructions ou de la documentation et repérez les réponses qui changent.
- Trop peu de tickets par sujet. Un résultat de 85 % sur 20 tickets correspond à une plage de 64 % à 95 %. C’est un premier aperçu, pas un verdict.
- Omettre les entrées difficiles. Les clients collent des numéros de commande erronés, écrivent dans deux langues et essaient parfois de convaincre le bot de leur accorder une remise. Les tests adversariaux ont leur place dans le jeu de test.
- Se comparer à la moyenne d’un fournisseur. La moyenne d’un fournisseur découle de son propre portefeuille de clients et de sa propre définition. Votre référence, c’est votre équipe.
Si vous êtes encore en train de choisir un outil, ma checklist d’évaluation des fournisseurs intègre ce type de test sur tickets au processus d’achat. Mon modèle d’appel d’offres fait de même, pour que chaque fournisseur soit évalué sur les mêmes tickets.
Évaluez votre agent IA avec eesel
eesel est un coéquipier de support IA qui rejoint votre file existante, que ce soit sur Zendesk ou une autre plateforme de support, et l’évaluation fait partie intégrante de sa mise en route. Selon la documentation eesel, sa simulation "replays your real past tickets and compares its answers to what your team sent", puis évalue les résultats par thème et suggère des corrections aux instructions.
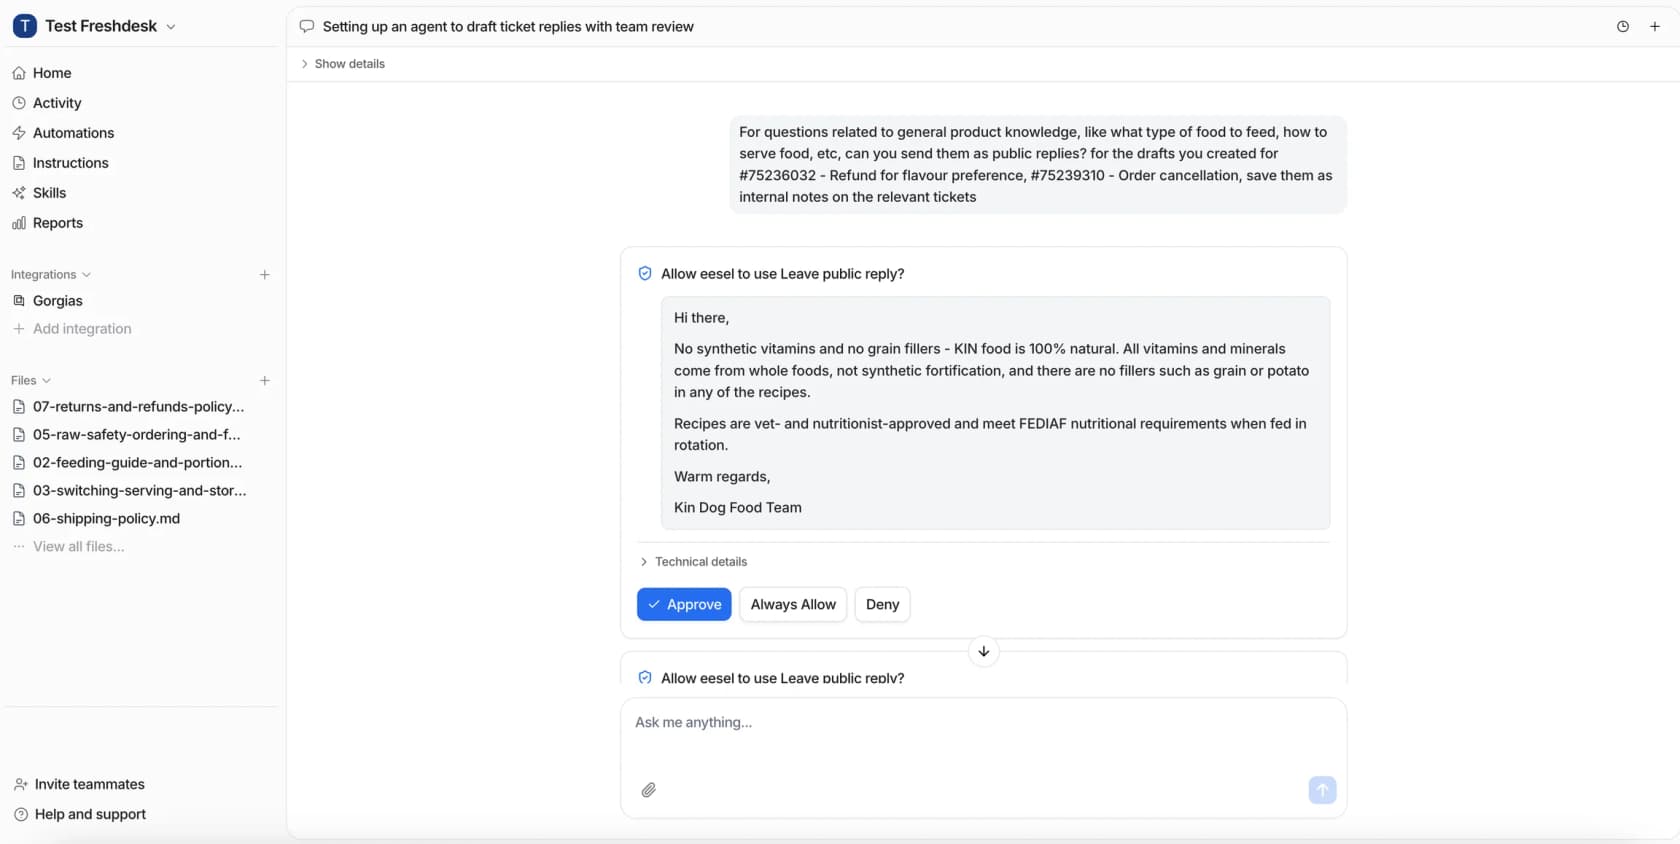
Le déploiement suit les mêmes étapes que la méthode ci-dessus : commencez par des brouillons, laissez l’agent répondre aux sujets faciles et activez-en davantage lorsque les scores le justifient. Cela fonctionne de la même manière sur les files Freshdesk, et l’intégration Gorgias suit le même déploiement.
Si vous voulez votre propre benchmark plutôt que la moyenne d’un fournisseur, lancez une simulation sur les tickets résolus le mois dernier et voyez, sujet par sujet, où l’IA atteint le niveau de votre équipe. Les forfaits payants commencent à 299 $ pour 500 crédits, et un ticket ou un chat consomme un crédit. Essayez eesel d’abord sur vos propres tickets.
Comment eesel aide-t-il à évaluer les performances d’un agent IA de support ?