

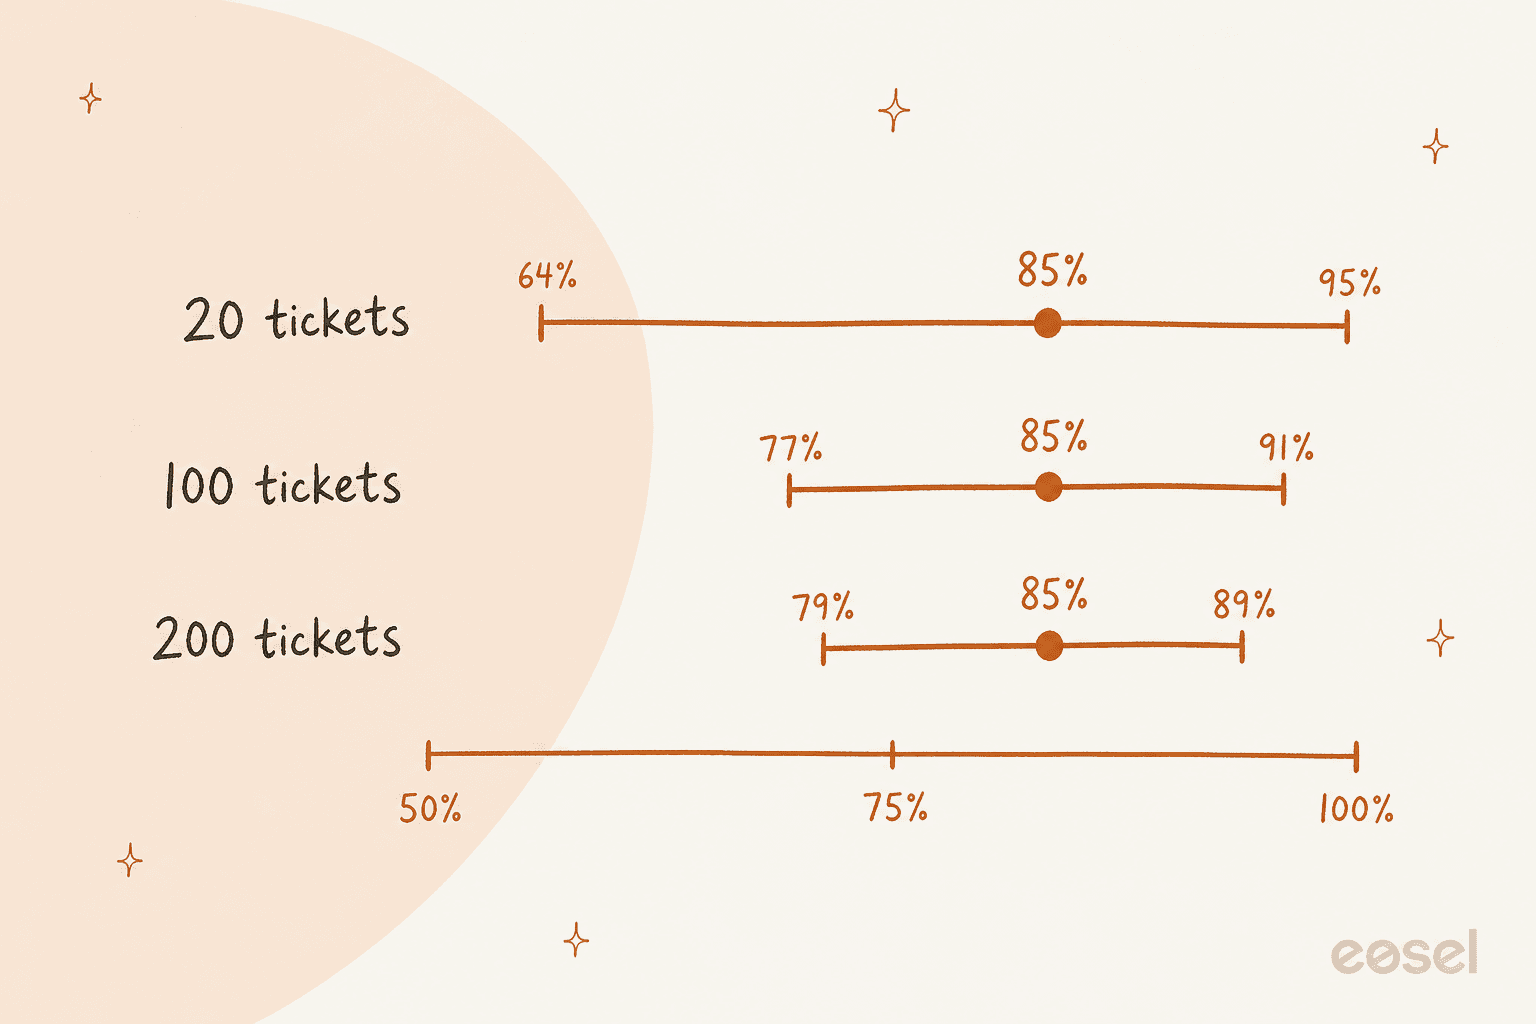
Le test de simulation du support IA consiste à rejouer, à travers l'agent IA, des tickets que votre équipe a déjà résolus, avec l'envoi désactivé, et à noter chaque réponse avant qu'un client n'en voie une. Le score ne vaut que ce que valent trois choses : combien de tickets vous avez rejoués par sujet, par rapport à quoi vous avez noté, et si le test pouvait toucher de vrais systèmes. Une correspondance de 85 % sur 20 tickets peut en réalité se situer n'importe où entre 64 % et 95 % ; lisez donc le résultat par sujet et traitez les petites exécutions comme un premier aperçu, pas comme un verdict.
Parmi les helpdesks que j'ai examinés, seuls l'agent e-mail de Freshdesk et eesel rejouent vos propres tickets résolus. Le simulateur de Zendesk fonctionne sur des scénarios fictifs, HubSpot génère des questions à partir de thèmes de conversations passées, Salesforce génère ou importe des cas de test, et Gorgias teste une conversation à la fois.
L'exécution la plus utile que j'aie vue, une vérification croisée de 100 tickets sur une vraie boîte de réception ecommerce, était 88 % juste dans la direction, mais seuls 12 % des brouillons seraient partis sans modification et 7 % contenaient une erreur factuelle. Même exécution, trois scores honnêtes. C'est pourquoi je commence chaque déploiement par une simulation, puis par une période de brouillons sur de vrais tickets. eesel fait les deux, et Norden-Frisia s'est abonné en quelques jours après une semaine d'essai menée sur ses propres anciens tickets.
Qu'est-ce que le test de simulation du support IA ?
Le test de simulation du support IA est une répétition générale d'un agent IA sur des messages clients réalistes, où chaque réponse est enregistrée et notée au lieu d'être envoyée. Il répond à une question avant le lancement : si cet agent avait travaillé sur votre file le mois dernier, combien de ses réponses auriez-vous été heureux d'envoyer ?
Il y a trois façons d'alimenter une simulation, et elles détectent des choses différentes.
| Type de simulation | D'où viennent les messages de test | Ce qu'elle détecte | Ce qu'elle manque |
|---|---|---|---|
| Rejeu de tickets passés | Tickets résolus de votre propre helpdesk, avec les mots de vos clients | Formulations réelles, répartition réelle des sujets, lacunes dans votre base de connaissances | Nouveaux problèmes que vous n'avez pas encore vus, insistance sur plusieurs messages |
| Scénarios générés | Une IA écrit des messages clients à partir de vos documents, de sujets ou d'un prompt | Couverture des sujets avec peu d'historique, cas limites que vous décrivez | La façon dont les clients formulent vraiment les choses, la part réelle de chaque sujet |
| Jeux de tests scénarisés | Questions que vous ou votre équipe écrivez à la main | Risques connus : remboursements, juridique, prompt injection | Tout ce que personne n'a pensé à noter |
Je commencerais toujours par le rejeu, car c'est le seul construit à partir de ce que les clients envoient réellement. Les tests générés et scénarisés comblent les trous que laisse le rejeu, surtout pour les sujets risqués qui reviennent trop rarement pour apparaître dans un échantillon. Mon guide précédent sur le test des agents de support IA range les trois dans un plan de lancement en quatre étapes, et la checklist de pré-lancement couvre les transferts, les actions et le bouton d'arrêt. Cet article va plus loin sur la simulation elle-même : comment en mener une et comment lire le score qu'elle donne.
Pourquoi un bon score de simulation peut-il quand même vous tromper ?
Je construis les intégrations qui importent l'historique de tickets dans eesel, et je passe donc beaucoup de temps à regarder ce qu'un rejeu lit vraiment. La leçon que je réapprends sans cesse est que « 85 % de réussite » ne veut rien dire tant qu'on ne sait pas ce que « réussi » signifiait.
Cette vérification croisée de 100 tickets du TL;DR est l'exemple le plus clair que j'aie. C'était un essai sur une vraie boîte de réception ecommerce d'environ 1 000 tickets par mois. Le tri était précis à 93 % et la détection du spam à 100 %. Les brouillons allaient dans le bon sens 88 % du temps. Mais seuls 12 % auraient été envoyés tels quels, et 7 % contenaient une erreur factuelle. Parmi les réécritures, environ 65 % concernaient la longueur et le ton, corrigeables en apprenant des réponses envoyées par l'équipe, et seulement environ 5 % étaient l'agent se trompant sur les faits. Si vous vous étiez arrêté à « 88 % », vous auriez lancé avec un taux d'erreur de 7 % que vous n'auriez jamais vu, le genre d'hallucination IA silencieuse que les clients découvrent avant vous.
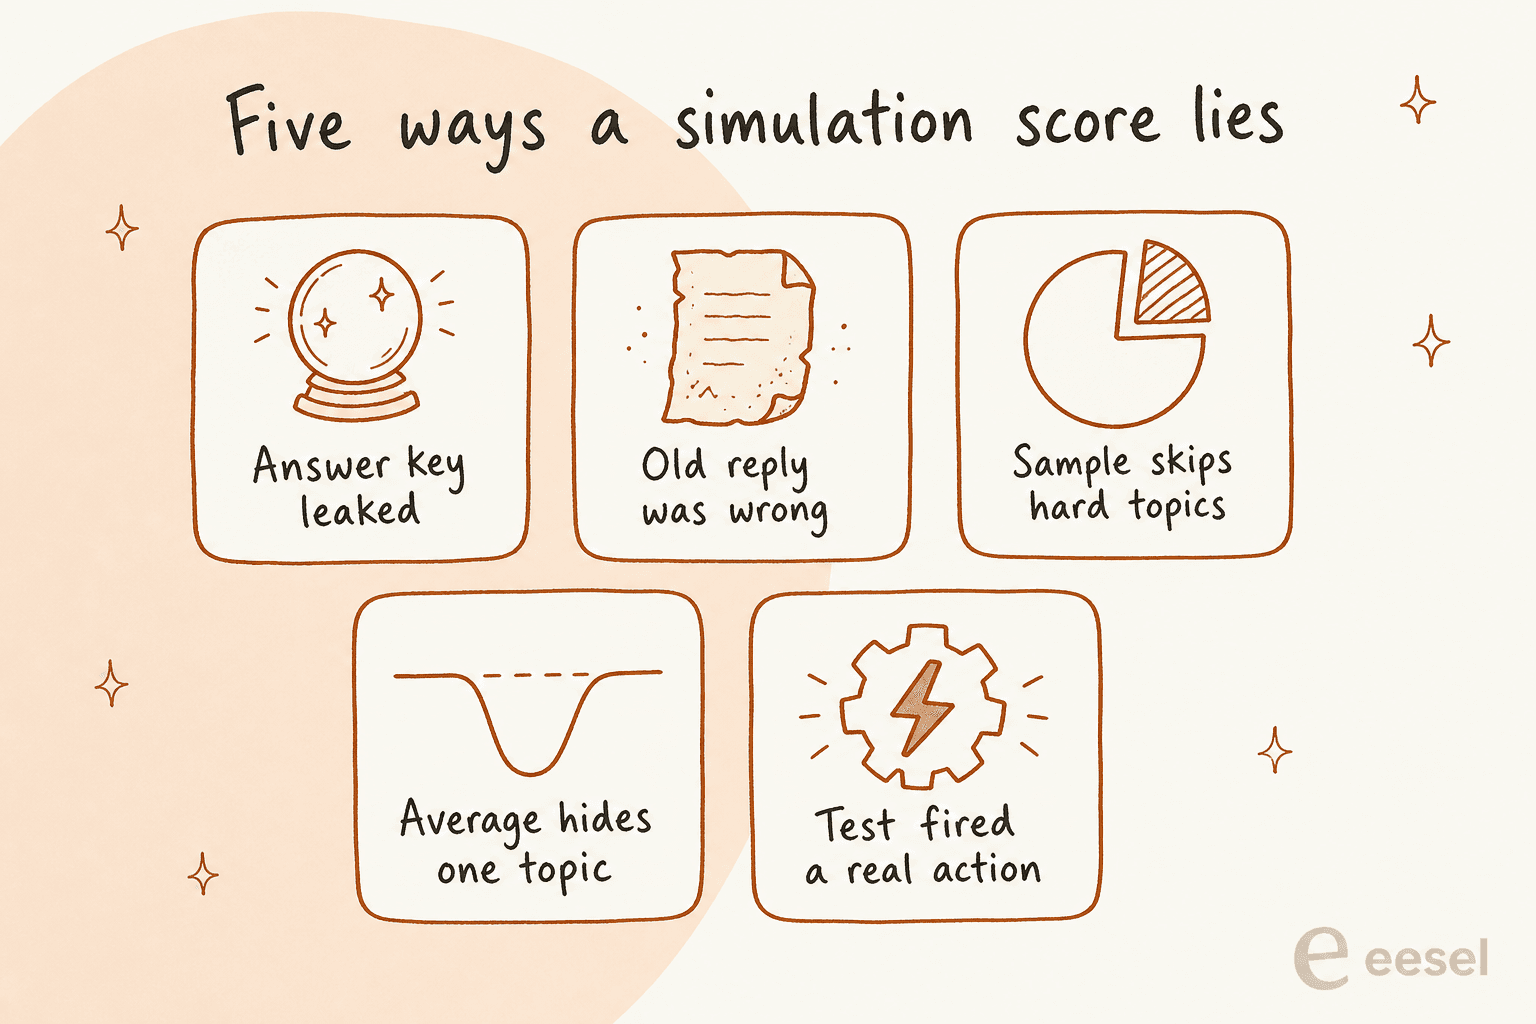
Voici les cinq façons dont j'ai vu un score de simulation s'éloigner de la réalité du jour du lancement :
- Le corrigé a fuité. Si l'agent peut lire le ticket même sur lequel on le teste, ou une macro écrite après la résolution de ce ticket, il se note avec les réponses en main. Choisissez des tickets dont l'agent n'a pas appris, ou désactivez cette source de tickets pour le test.
- L'ancienne réponse était fausse. Correspondre à ce que votre équipe a envoyé est un bon réglage par défaut, mais certaines de ces réponses appliquaient une règle que vous avez changée depuis, et d'autres étaient de simples erreurs. Notez par rapport à la règle d'aujourd'hui et traitez un « écart » sur un ticket périmé comme une réussite.
- L'échantillon saute les sujets difficiles. Vingt tickets récents d'une quinzaine calme peuvent ne contenir aucun litige de remboursement. Remplissez l'échantillon par sujet, puis ajoutez des cas écrits à la main pour les sujets rares et risqués.
- La moyenne cache un sujet. Un score global de 90 % peut reposer sur un sujet qui échoue à chaque fois. Un commentateur de Reddit l'a bien dit : "A clean average can still hide one common path that fails every time" (u/Bitter_Big4525).
- Le test a déclenché une vraie action. Une réponse qui n'est jamais envoyée est sans danger. Un remboursement, une annulation ou une mise à jour du CRM déclenchés pendant un test ne le sont pas. Plus à ce sujet à l'étape 3 ci-dessous.
"the biggest failure i've seen was an agent that kept pulling data from the wrong user's account because the session token wasn't being passed correctly to the api call, the text responses looked perfect so nobody caught it until a customer complained about seeing someone else's balance"

Ce dernier exemple explique pourquoi une simulation doit regarder ce que l'agent a fait, et pas seulement ce qu'il a dit.
De combien de tickets une simulation du support IA a-t-elle besoin ?
Pour un premier aperçu, 20 tickets suffisent. Pour décider de la mise en service d'un sujet, il vous en faut plutôt près de 100 sur ce sujet, car les petites exécutions donnent un score avec une très large marge d'erreur.
Voici le même score de 85 % pour trois tailles d'échantillon, avec un intervalle de confiance standard à 95 % (l'intervalle de Wilson, si vous voulez vérifier mes calculs) :
| Tickets rejoués | Réussis | Score | Le taux réel se situe probablement entre |
|---|---|---|---|
| 20 | 17 | 85 % | 64 % et 95 % |
| 50 | 42 | 84 % | 72 % et 92 % |
| 100 | 85 | 85 % | 77 % et 91 % |
| 200 | 170 | 85 % | 79 % et 89 % |
| 20 | 20 | 100 % | 84 % et 100 % |
Deux choses ressortent. Une exécution de 17 sur 20 ne peut pas vous dire si vous avez un agent à 65 % ou à 95 %. Et un 20 sur 20 parfait vous dit seulement que le taux réel d'échec est probablement inférieur à environ 16 %. C'est un excellent signe pour une première exécution, mais pas assez pour passer un sujet en pilote automatique complet.
Le remède est peu coûteux : lancez la simulation par sujet, et continuez à ajouter des tickets aux sujets que vous voulez automatiser jusqu'à ce que le bas de la fourchette dépasse votre seuil. Saisissez ici vos propres chiffres :
Si un sujet ne reçoit qu'une poignée de tickets par mois, vous n'aurez pas assez d'historique pour le prouver dans un sens ou dans l'autre. C'est un sujet pour les brouillons ou un transfert vers un humain, pas pour le pilote automatique, aussi bonne que paraisse la petite exécution.
Comment mener une simulation du support IA à laquelle vous pouvez vous fier ?
Six étapes, dans cet ordre. Elles fonctionnent de la même façon que vous utilisiez le testeur intégré de votre helpdesk, un tableur ou un agent IA de helpdesk dédié. La boucle complète prend un après-midi la première fois, et quelques minutes à chaque nouvelle exécution ensuite.
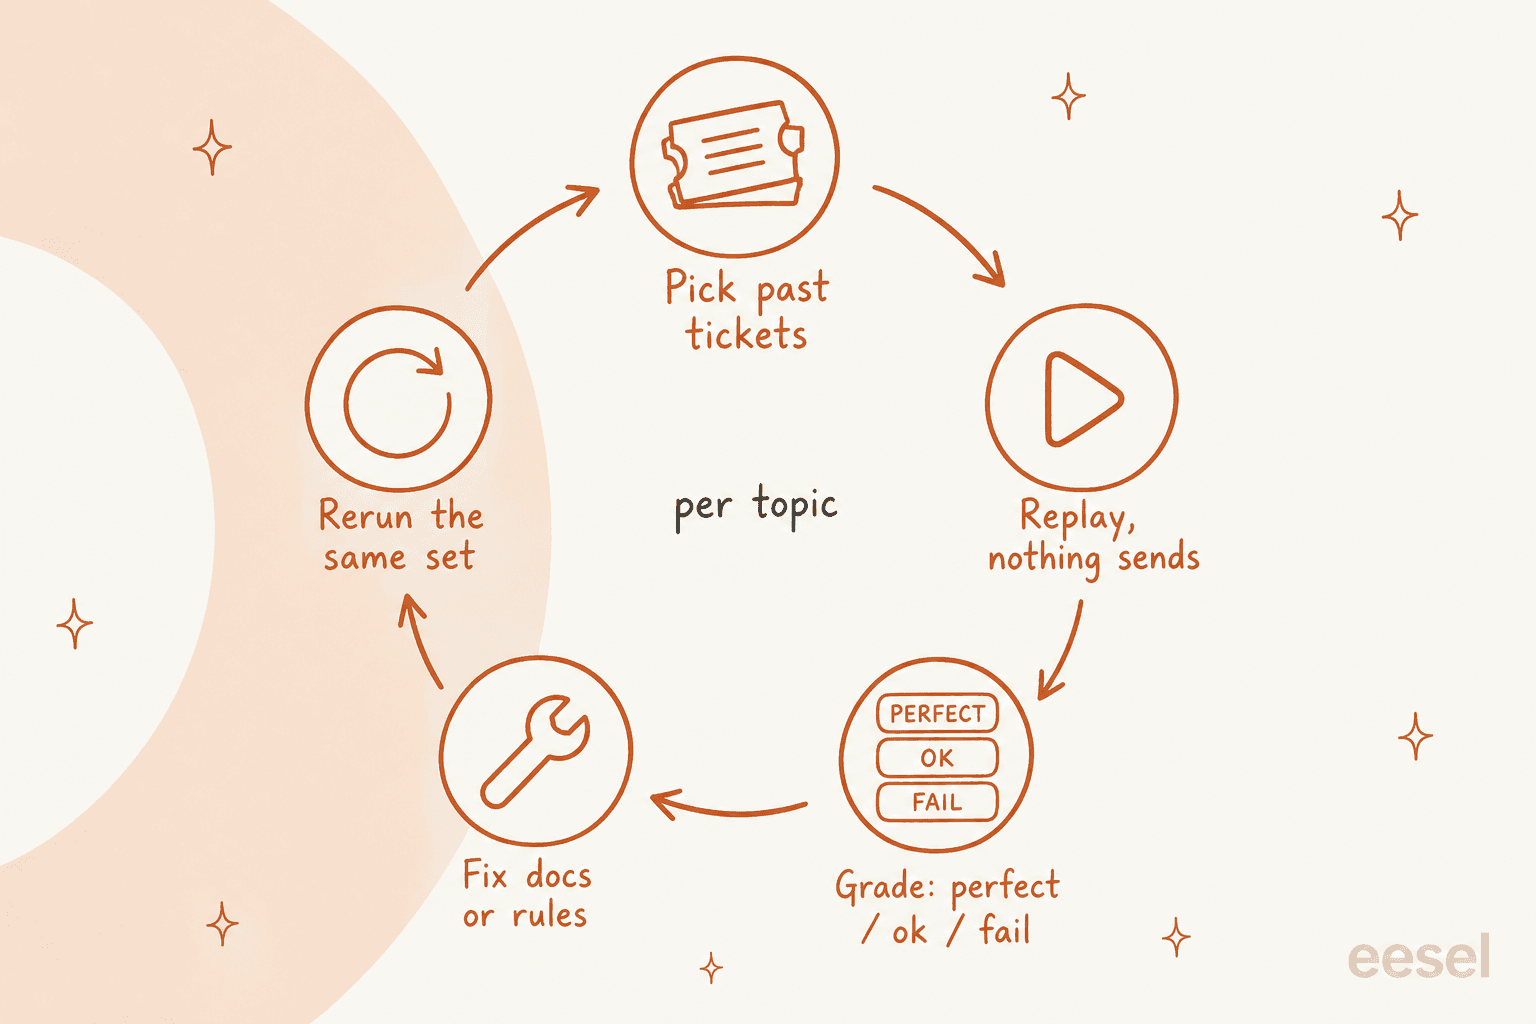
Étape 1 : choisir les tickets par sujet
Récupérez des tickets résolus des deux ou trois derniers mois, pour qu'ils reflètent vos produits et règles actuels. Regroupez-les par sujet (les tags de votre helpdesk ou les champs de ticket suffisent généralement) et prenez dans chaque sujet une part proche de sa fréquence d'arrivée. Ajoutez ensuite un petit jeu écrit à la main pour les cas rares et à fort enjeu : un remboursement hors délai, un client qui demande un responsable, un message qui tente de contourner les règles de l'agent, une question à laquelle vos documents ne répondent pas du tout.
Ce dernier type compte plus qu'il n'y paraît. Parmi les pires échecs précoces que j'ai vus dans l'historique client d'eesel, il y avait des bots qui inventaient des réponses quand la base de connaissances n'avait rien de pertinent. Un jeu de test sans question sans réponse ne peut pas le détecter, et c'est le cœur de la prévention des hallucinations dans le support.
"The one that worried me most was refund amounts. I ran AI models through support emails with a written refund policy, and 7 of them promised the wrong amount on the same email. The reply reads polite and confident, so nobody catches it until the customer quotes it back. On the easy emails they all looked great. It only showed up on hard emails I wrote and held back."
Étape 2 : figer ce que l'agent sait, et traquer les fuites
Dirigez l'agent vers le même centre d'aide, les mêmes macros et les mêmes instructions que ceux qu'il utilisera le premier jour, et rien d'autre. Chaque réponse doit être ancrée dans une source que vous pouvez montrer, pour que l'évaluateur puisse vérifier d'où elle vient. Vérifiez ensuite que le ticket que vous rejouez, et tout ce qui a été écrit pour y répondre, ne se trouve pas dans les connaissances de l'agent. Si l'agent apprend des tickets passés, choisissez des tickets dont il n'a pas appris ou excluez cette source pour l'exécution de test.
Étape 3 : désactiver toute action qui écrit
Désactivez l'envoi, puis vérifiez les actions. Les éditeurs sont clairs : ce n'est pas automatique :
- Gorgias avertit que lorsque son agent utilise une action dans une conversation de test, "it can affect real customer and order data (like cancelling an order)", et suggère un faux profil client (documentation Gorgias).
- Salesforce dit "Testing agents can modify CRM data" et vous demande de n'exécuter le Testing Center que dans un sandbox.
- Le panneau de test de HubSpot affiche désormais "any records that were created or updated" pendant un test (documentation HubSpot).
Ma règle : dans une simulation, l'agent peut lire tout ce qu'il lira en production, et n'écrire rien. Si vous voulez tester une action de remboursement, testez-la séparément sur une fausse commande, et encadrez-la avec des actions soumises à approbation une fois en production.
Étape 4 : noter sur trois niveaux, plus une catégorie « jamais »
Une note réussi/échec jette l'information la plus utile. Je note chaque réponse dans l'une de ces catégories :
- Parfaite : vous l'enverriez telle quelle.
- Acceptable : bonne réponse, qui demande une légère retouche de longueur ou de ton.
- Échec : fausse, incomplète, ou elle aurait dû être transférée et ne l'a pas été.
Je garde ensuite une catégorie « jamais » à part pour les échecs qui bloquent le lancement quelle que soit la moyenne : une règle inventée, un remboursement promis que la règle n'autorise pas, les données d'un autre client, un transfert manqué sur un ticket juridique ou de sécurité. Un commentateur de Reddit décrivait ses catégories comme "annoying", "bad" et "burn it down", et le niveau burn-it-down "has to be zero or we don't ship" (u/Evening_Event4634).
Laisser un évaluateur IA faire le premier passage est acceptable, et la plupart des outils le font désormais. Salesforce utilise un "LLM judge" qui compare chaque réponse à une réponse attendue, et même lui dit que ses scores de qualité "are not absolute measures of success or failure" (Salesforce). Je fais lire par une personne chaque échec, chaque candidat à « jamais » et une tranche aléatoire des réussites, ce qui garde un humain dans la boucle là où l'évaluateur est le plus faible. Les bonnes pratiques d'évaluation d'OpenAI disent la même chose sur la vérification d'un évaluateur modèle par des humains. C'est la même habitude qu'une séance de calibrage QA, simplement tournée vers l'agent.
Étape 5 : lire les résultats par sujet, et décider par sujet
C'est ici que l'exécution devient un plan de déploiement. Pour chaque sujet, faites l'un de ces trois choix :
| À quoi ressemble le résultat du sujet | Ce que je ferais |
|---|---|
| Le bas de la fourchette dépasse votre seuil, zéro échec « jamais » | Candidat pour répondre seul, après une semaine de brouillons sur de vrais tickets |
| Surtout parfait ou acceptable, quelques échecs que vous comprenez | Brouillons envoyés par une personne, corriger la cause, rejouer |
| Beaucoup d'échecs, ou le moindre échec « jamais » | Transférer à une personne, corriger d'abord les documents ou les règles |
Lancer par sujet, et non d'un coup, est la méthode de la plupart des clients d'eesel. Rúngne tient une liste de sujets qui décide ce qui reçoit une réponse directe et ce qui reçoit un brouillon, et déplacer un sujet d'un côté à l'autre revient à modifier la liste. smava marque environ 1 100 de ses 27 000 tickets mensuels comme éligibles à une réponse automatique, avec des brouillons pour le reste.
Étape 6 : corriger, puis rejouer les mêmes tickets
Quand un sujet échoue, la correction est généralement un article d'aide manquant ou vague, une instruction trop lâche ou une règle de transfert qui ne se déclenche pas. Faites le changement, puis rejouez exactement le même jeu et comparez. Gardez dans le jeu les tickets qui avaient déjà réussi, car la correction d'un sujet peut en casser un autre sans bruit. Rejouez dès que vous changez le modèle, les instructions, le seuil de confiance ou une grosse partie de la base de connaissances. Sauter le rejeu après un « petit changement » fait partie des erreurs de mise en œuvre que je vois le plus.
"I think the key is testing the decision separately from the conversation. An agent can have a perfectly polite chat and still issue a refund it wasn't allowed to. If it has to state which policy and limit it applied before it takes any action, you can check that against the rule instead of reading through transcripts."
Quels helpdesks permettent de simuler un agent IA sur d'anciens tickets ?
La plupart des agents IA proposent désormais une forme d'outil de test, mais ils entendent des choses très différentes par « simulation ». Si vous choisissez un outil, cela mérite sa place dans votre checklist d'évaluation des fournisseurs. J'ai consulté le centre d'aide de chaque éditeur le 30 octobre 2026 :
| Outil | Rejoue vos vrais anciens tickets ? | Entrée de test | Limite par exécution | Comment les réponses sont notées | Les tests peuvent-ils toucher de vraies données ? | Rejeux enregistrés |
|---|---|---|---|---|---|---|
| Simulateur de conversations Zendesk (accès anticipé) | Non, données fictives uniquement | Profils clients et scénarios que vous écrivez ou que l'IA génère | Non précisé | Statut par conversation, estimation de résolution | Non précisé ; le widget de test ignore les actions CRM | Scénarios versionnés, historique d'exécutions |
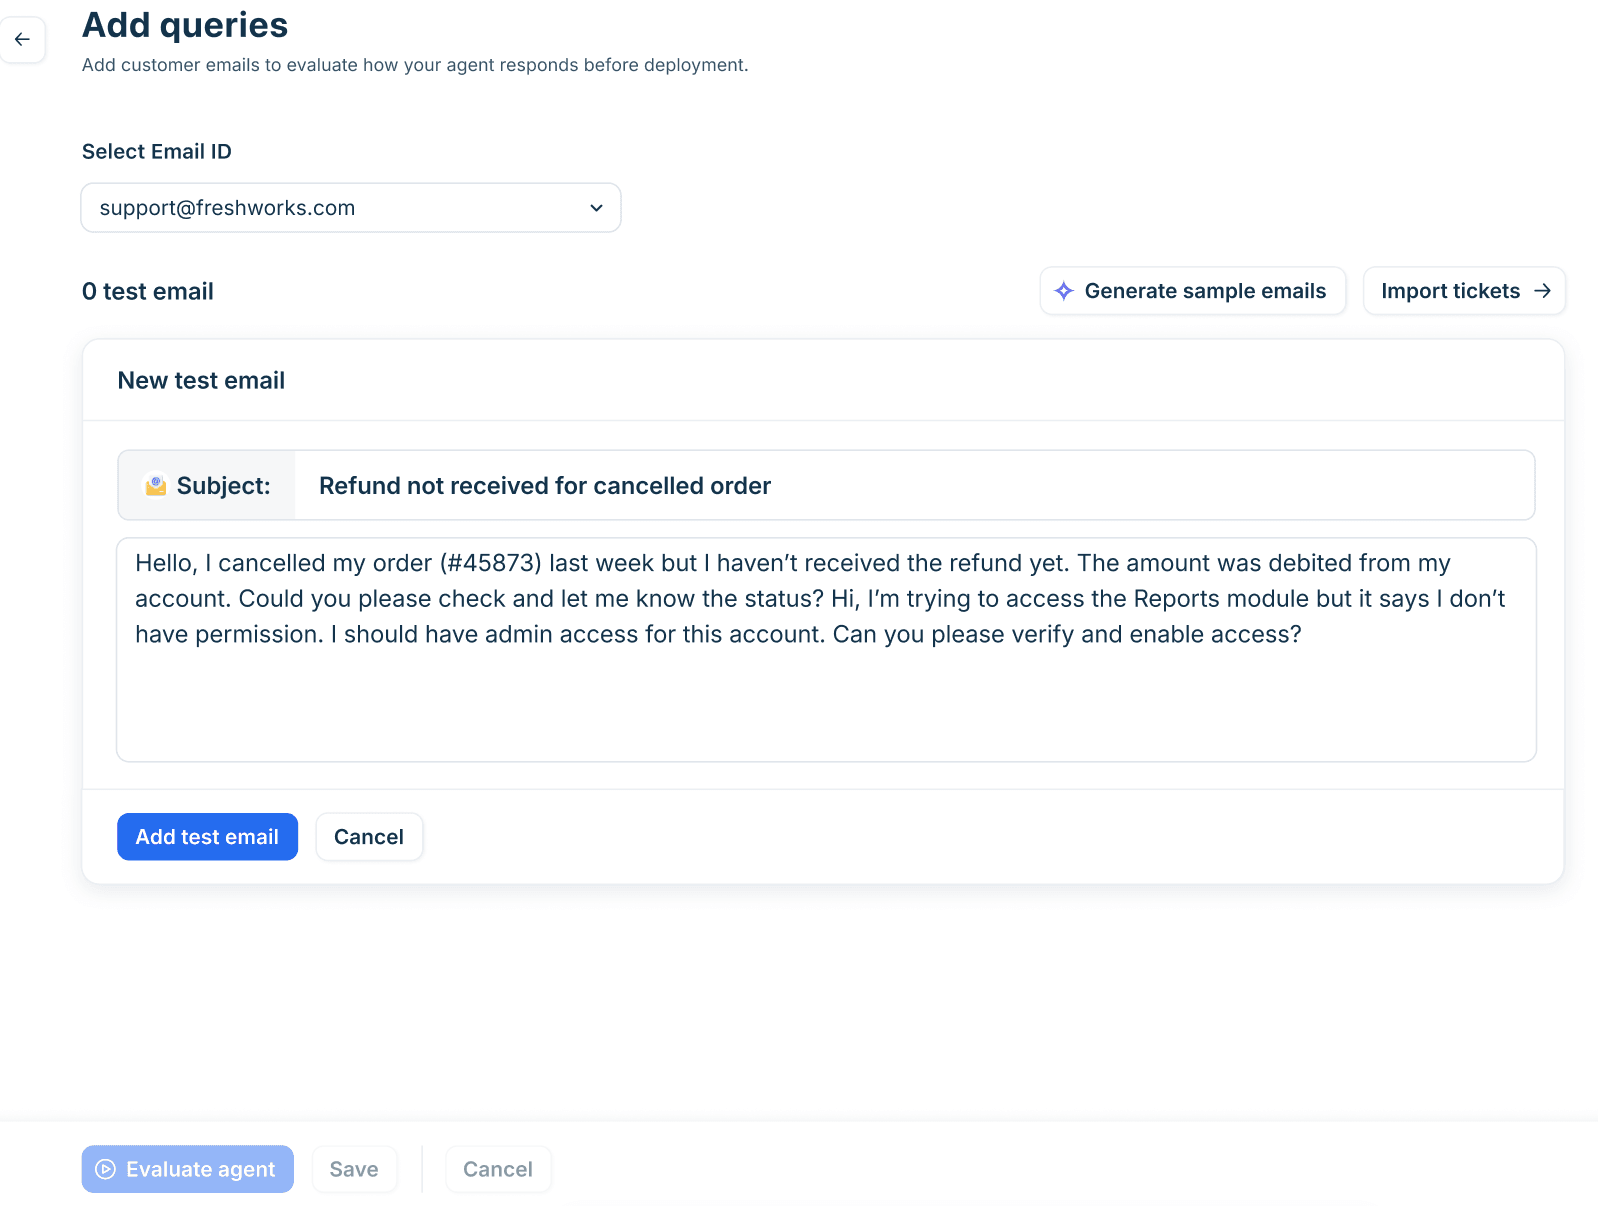
| Agent IA e-mail Freshdesk | Oui, tickets résolus | Tickets importés, e-mails saisis ou générés | 50 | Answered, Unanswered ou Error, plus votre évaluation | Les workflows se déclenchent ; non précisé si en production | Oui |
| Agent IA chat Freshdesk | Non | Questions saisies ou générées | 100 | Answered ou Unanswered, plus votre évaluation | Non précisé | Oui |
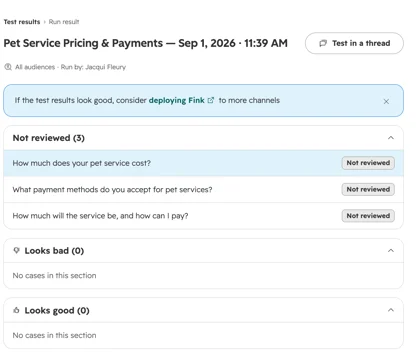
| Agent client HubSpot | Non, génère des questions à partir de thèmes de conversations passées | Questions générées ou saisies | 8 jeux de test | Vous marquez Looks good ou Looks bad | Des enregistrements peuvent être créés ou mis à jour | Oui |
| Gorgias AI Agent | Un ticket existant à la fois | Message saisi ou un ancien ticket | 1 conversation | Pas de score ; vous lisez son raisonnement | Oui, si les actions sont activées | Non |
| Testing Center Salesforce Agentforce | Non | Généré à partir de sujets, d'actions ou de connaissances, ou import CSV | 100 générés, 1 000 par CSV | Juge IA face à une réponse attendue, scores de qualité de 0 à 5 | Oui, sandbox conseillé | Oui |
| Atlassian Customer Service Management | Non précisé | Un jeu de questions | Non précisé | Résolu ou non, revu par une personne | Non précisé | Oui |
| eesel | Oui, tickets résolus | Anciens tickets, ou cas générés sans helpdesk | Exécution d'exemple de la doc : 20 tickets | Comparé à ce que votre équipe a envoyé, regroupé par thème | Non, "It sends nothing to customers" | Oui, peut s'exécuter selon un calendrier |
Quelques précisions sur chacun.
Zendesk. Le simulateur de conversations est dans un programme d'accès anticipé et ne fonctionne qu'avec un agent IA de messagerie. Vous écrivez un scénario (contexte, problème initial, résultat attendu, valeurs fictives) et choisissez un profil client, et l'IA joue le client. Zendesk dit qu'il est "designed for testing with fictional data", donc fort pour les chats sur plusieurs messages et faible pour « comment aurait-il géré le mois dernier ». Tester dedans ne consomme pas de résolutions automatisées, ce qui compte avec la tarification à la résolution de Zendesk. Après le lancement, les journaux de conversations et Zendesk QA prennent le relais pour la notation.
Freshdesk. L'étape Evaluate de l'agent e-mail est ce qui se rapproche le plus d'un vrai rejeu parmi les outils intégrés : vous pouvez "Import tickets to use solved historical tickets", jusqu'à "50 queries per evaluation run" (Freshdesk). Le seuil de Freshdesk lui-même est "at least 20 representative queries before deploying", que, d'après le tableau ci-dessus, je traiterais comme un plancher. Le score indique si l'agent a répondu, pas si la réponse correspondait à ce que votre agent humain avait envoyé : vous lisez donc quand même chacune. Il est disponible sur Freshdesk Omni Growth, Pro et Enterprise, et il existe un sandbox si vous voulez une copie entièrement séparée.
HubSpot. Le test par lots peut "generate them from existing customer conversations", ce qui veut dire qu'il écrit des questions courantes par thème, et un thème a besoin de "5 or more conversations on a similar topic" pour apparaître. La notation est manuelle, réponse par réponse, et les jeux de test sont enregistrés pour être rejoués. Les tests ne consomment pas de HubSpot Credits.
Gorgias. Le Playground peut rejouer "an existing ticket", ce que Gorgias recommande pour "re-simulating a conversation where AI Agent did not initially respond as expected" (Gorgias). C'est parfait pour vérifier une correction sur un ticket, mais il n'y a pas d'exécution par lots, donc pas de score sur 100 tickets. Gorgias mise plutôt sur la relecture en production : son guide de mise en service vous demande de relire "at least 10 tickets" la première semaine.
Salesforce et Atlassian. Agentforce Testing Center offre la notation la plus détaillée du groupe : vérifications que le bon sujet et la bonne action ont été choisis, plus un juge IA et des évaluateurs de qualité optionnels, sur les éditions Enterprise, Performance, Unlimited et Developer avec une licence agent complémentaire (voir les tarifs d'Agentforce). Il ne rejoue cependant pas les cas passés : vous générez des tests ou importez un CSV. Les évaluations d'Atlassian sont plus simples : un jeu de questions, chacune marquée résolue ou non, avec un rejeu après chaque correction.
Si vous êtes sur Zendesk, Gorgias ou HubSpot et voulez un rejeu de vos tickets réellement résolus, c'est un vide à combler hors du helpdesk, soit avec un tableur et beaucoup de copier-coller, soit avec un outil qui lit directement votre historique de tickets.
Que ne peut pas vous dire une simulation ?
Une simulation vous dit comment l'agent traite le premier message d'un ticket dont il a déjà vu la forme. Elle ne peut pas vous renseigner pleinement sur quatre choses :
- Comment les clients insistent. Un rejeu comporte un message client et une réponse. Les vrais clients répondent « c'est faux », redemandent ou s'énervent. Les tests scénarisés sur plusieurs messages aident ; les brouillons en production aident davantage.
- Ce qui est nouveau cette semaine. Un lancement de produit, une panne ou un changement de règle créent des tickets que votre historique n'a pas.
- Ce que les clients en ressentent. Un commentateur de Hacker News qui a piloté un déploiement de support IA a dit avoir "did our own intensive testing" et pourtant constaté que "our customers just hated it" (victor106). Le ton, la rapidité et la possibilité de joindre une personne comptent autant que la précision.
- Si vos documents restent vrais. Une simulation est un instantané. Si une page de règles change le mois prochain, le score est périmé. Planifiez un rejeu.
"Shipped a customer service agent for a mid-size e-commerce client last year, manual testing looked clean across every flow we ran. First week in production, users started interrupting mid-response to rephrase their question, agent would drop the original context entirely and answer the new phrasing with confident, wrong information. Support tickets spiked, client was fielding churn risk conversations by day ten. We caught exactly zero of that in manual testing because we were too polite during QA."
C'est pourquoi je traite la simulation comme le passage vers les brouillons, pas vers le pilote automatique. L'étape suivante dure une à deux semaines pendant lesquelles l'agent rédige des brouillons sur de vrais tickets et une personne envoie. Innr en est exactement à ce stade sur Freshdesk : chaque réponse est aujourd'hui un brouillon, et l'équipe fait passer des sujets choisis en réponses autonomes un par un. SE Ranking teste des réponses directes par e-mail sur des tickets de test choisis par objet avant d'élargir. Surveillez le taux de résolution et le taux de réouverture par sujet pendant cette période (pas la déflexion, qui compte les tickets qui ne vous sont jamais parvenus), et servez-vous-en pour décider de ce qui devient autonome. Mon article sur le calendrier de mise en œuvre montre combien de temps cette étape dure en général.
Comment eesel mène une simulation sur vos anciens tickets
Je vais être précis sur le fonctionnement dans eesel, car c'est la partie du produit sur laquelle je vois le plus de questions.
Vous la demandez dans le chat. Avec un helpdesk connecté, la simulation helpdesk d'eesel "replays your past tickets and scores its answers against what your team actually sent" (documentation eesel). Sans helpdesk, elle écrit à la place des cas de test réalistes. L'exécution rédige une réponse pour chaque ticket, la compare à la réponse de votre équipe, regroupe les résultats par thème et liste les corrections classées par impact. Dans l'exécution d'exemple de la documentation, 17 tickets résolus sur 20 correspondaient à la qualité de réponse de l'équipe, avec une ventilation par thème en dessous. Considérez-le comme un exemple de rapport, pas comme une prévision pour votre file.
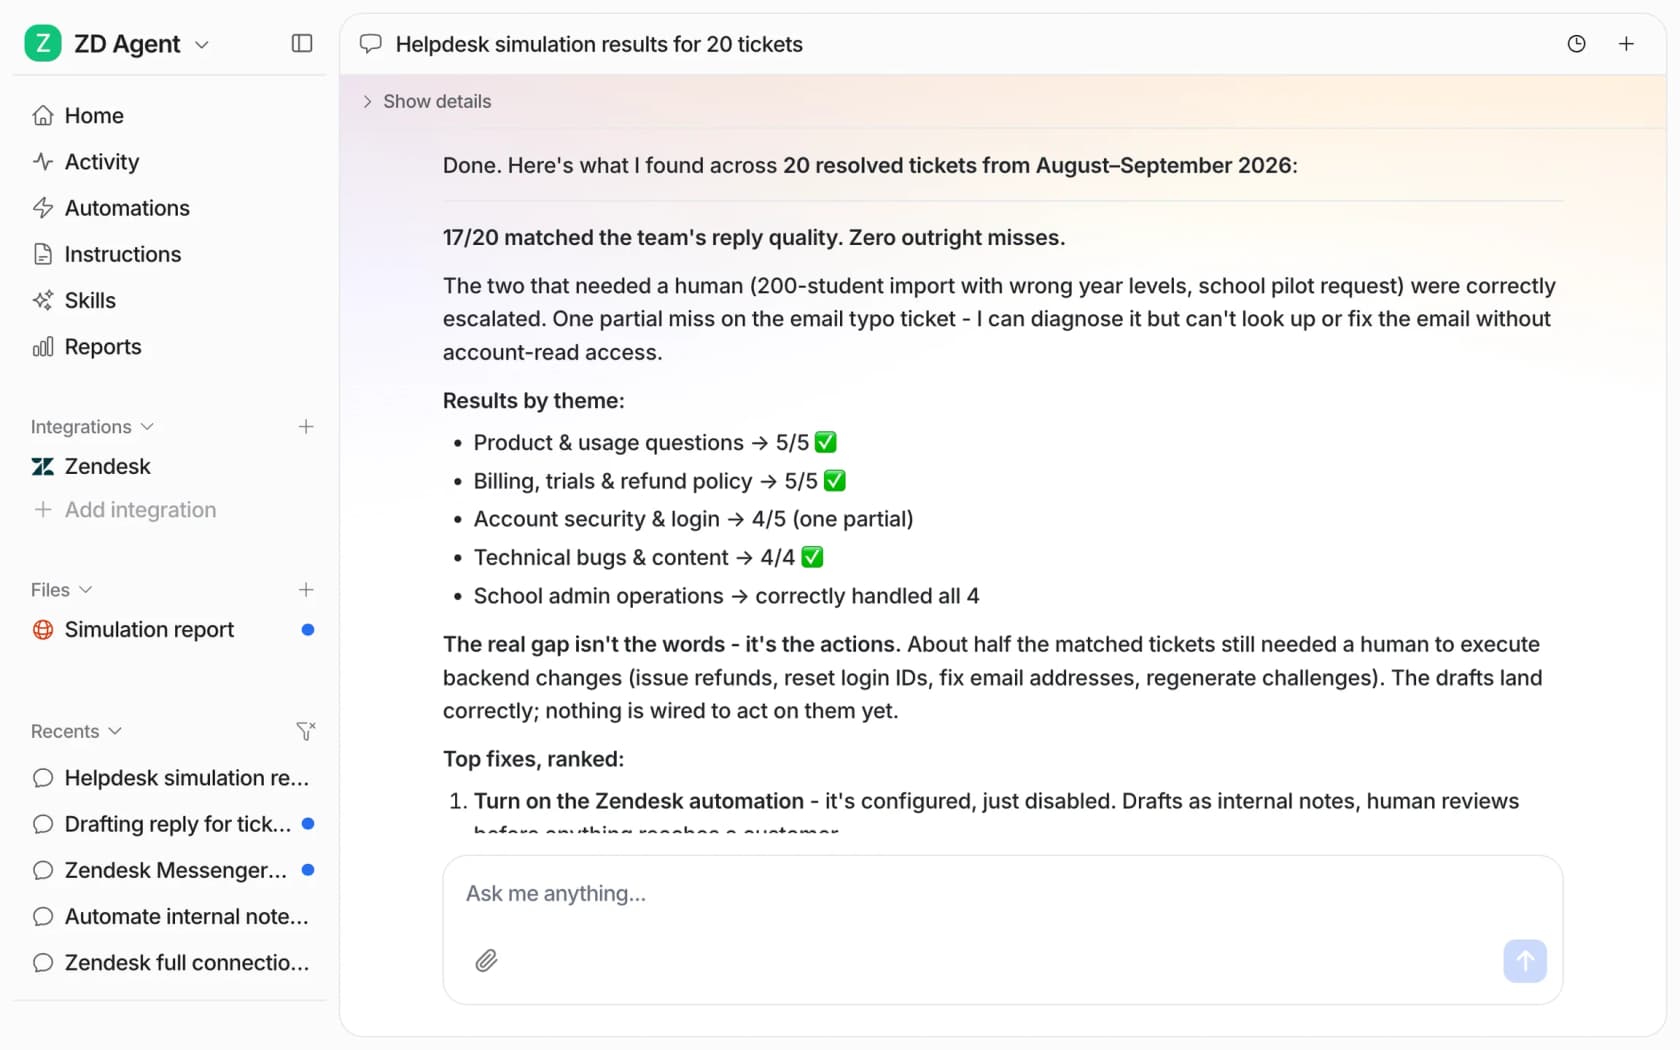
Le rapport complet s'ouvre à côté du chat, ticket par ticket : ce que le client a demandé, ce que votre équipe a répondu et comment la réponse de l'agent se compare. Les deux exemples de rapports de simulation dans la documentation Skills se terminent de la même façon : "It sends nothing to customers". Cela couvre l'étape 3.
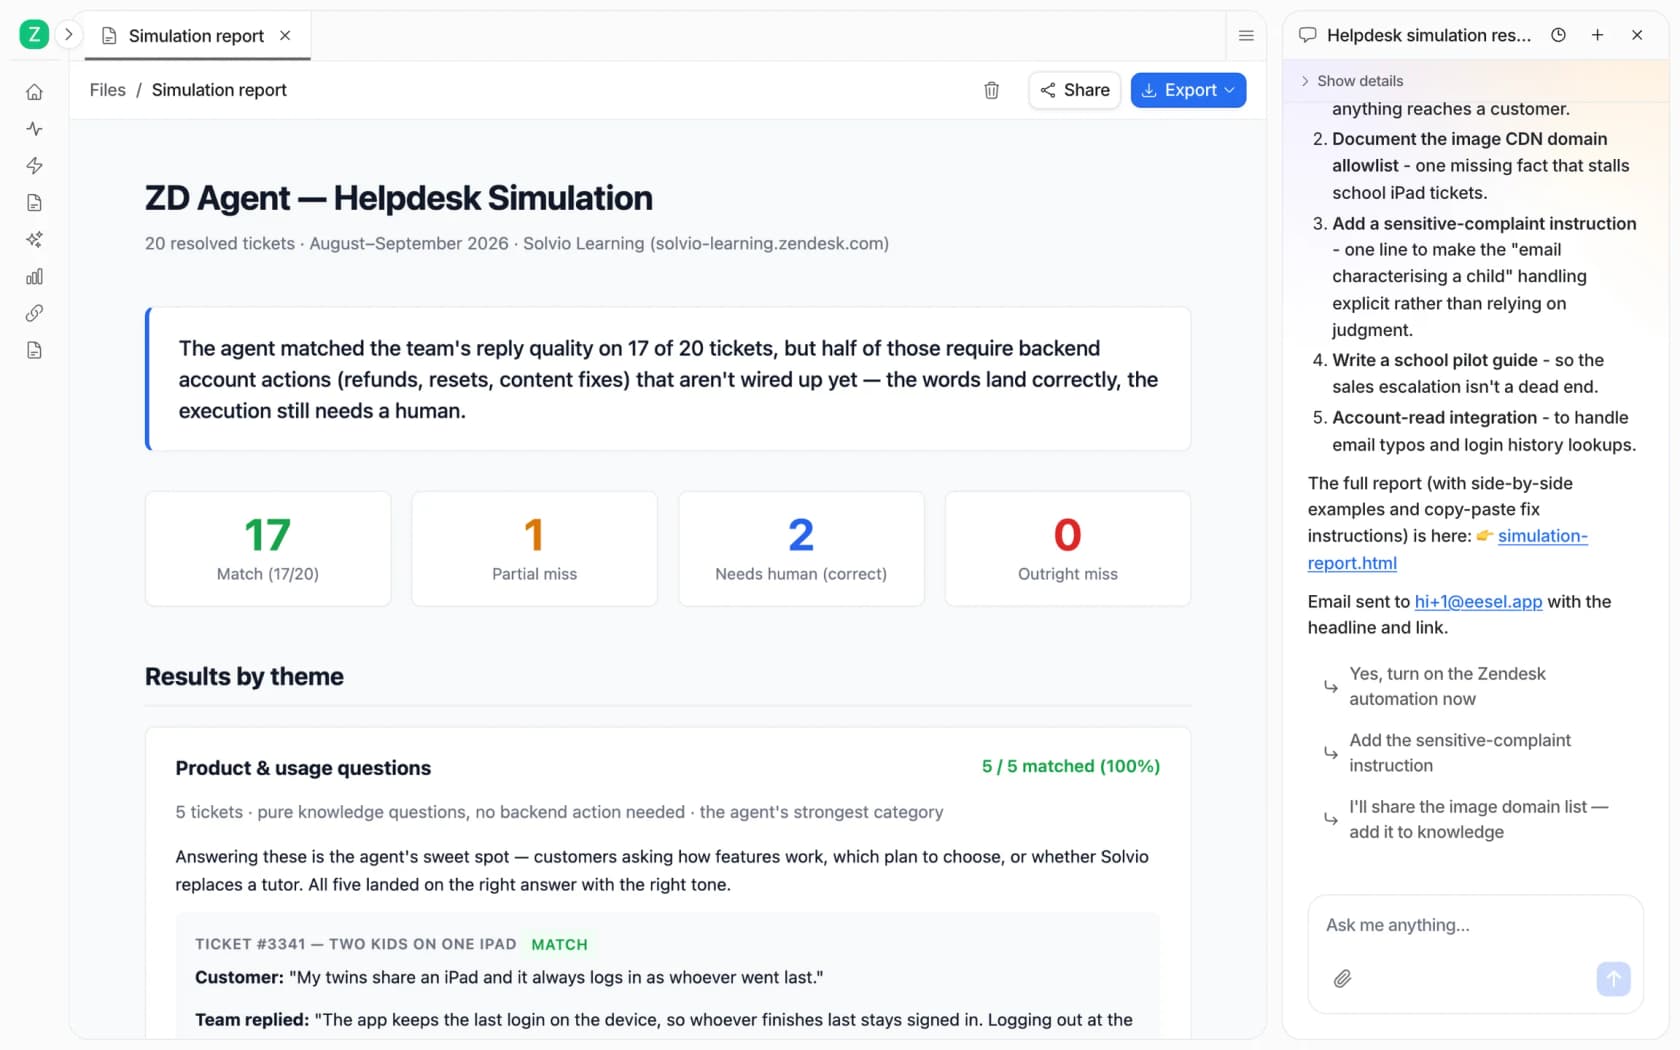
Remarquez que le rapport ne s'arrête pas à « correspond ». Il distingue les échecs partiels et les tickets qui nécessitaient à juste titre un humain, soit la notation sur trois niveaux de l'étape 4, intégrée. Quand vous corrigez l'agent dans le chat, il écrit la correction dans ses propres instructions sous forme de règle en une phrase simple, de sorte que le rejeu suivant teste la correction. Vous pouvez aussi rattacher la simulation à une automatisation pour l'exécuter selon un calendrier, ce qui règle l'étape 6 sans que personne ait à y penser.
Après la simulation, chaque réponse commence comme un brouillon ou une note interne, et vous faites passer les sujets en « répondre seul » quand vous êtes prêt. Tout ce qui coûte de l'argent reste derrière une approbation. Si vous préférez travailler dans un terminal, la CLI d'eesel vous permet de tester le même agent avec eesel chat "what's our refund policy?", de voir ce qui attend avec eesel approvals et de prévisualiser toute écriture avec --dry-run avant son exécution. Des agents de codage comme Claude Code ou Cursor peuvent piloter ces mêmes commandes.
Là où eesel n'est pas le bon choix : si vous avez besoin de simulations de chat sur plusieurs messages avec des personas clients joués par l'IA dans Zendesk, son propre simulateur est conçu pour cela. La simulation d'eesel porte sur la façon dont l'agent aurait répondu à votre historique réel.
Simulez votre agent IA sur vos propres tickets avec eesel
Si vous êtes sur le point d'activer un agent IA et voulez d'abord un score issu de votre propre file, eesel se connecte à Zendesk, Freshdesk, Gorgias et HubSpot en quelques minutes, rejoue des tickets que votre équipe a déjà résolus et vous dit, sujet par sujet, où il est prêt et où vos documents ont des lacunes, sans rien envoyer. Norden-Frisia a mené sa semaine d'essai sur trois mois d'anciens tickets et de macros, et s'est abonné en quelques jours. Le forfait gratuit inclut 100 crédits pour essayer toutes les fonctionnalités, et les forfaits payants démarrent à 299 $/mois pour 500 crédits.
Essayez eesel et lancez votre première simulation cet après-midi.
Comment noter les réponses dans une simulation du support IA ?