

En bref
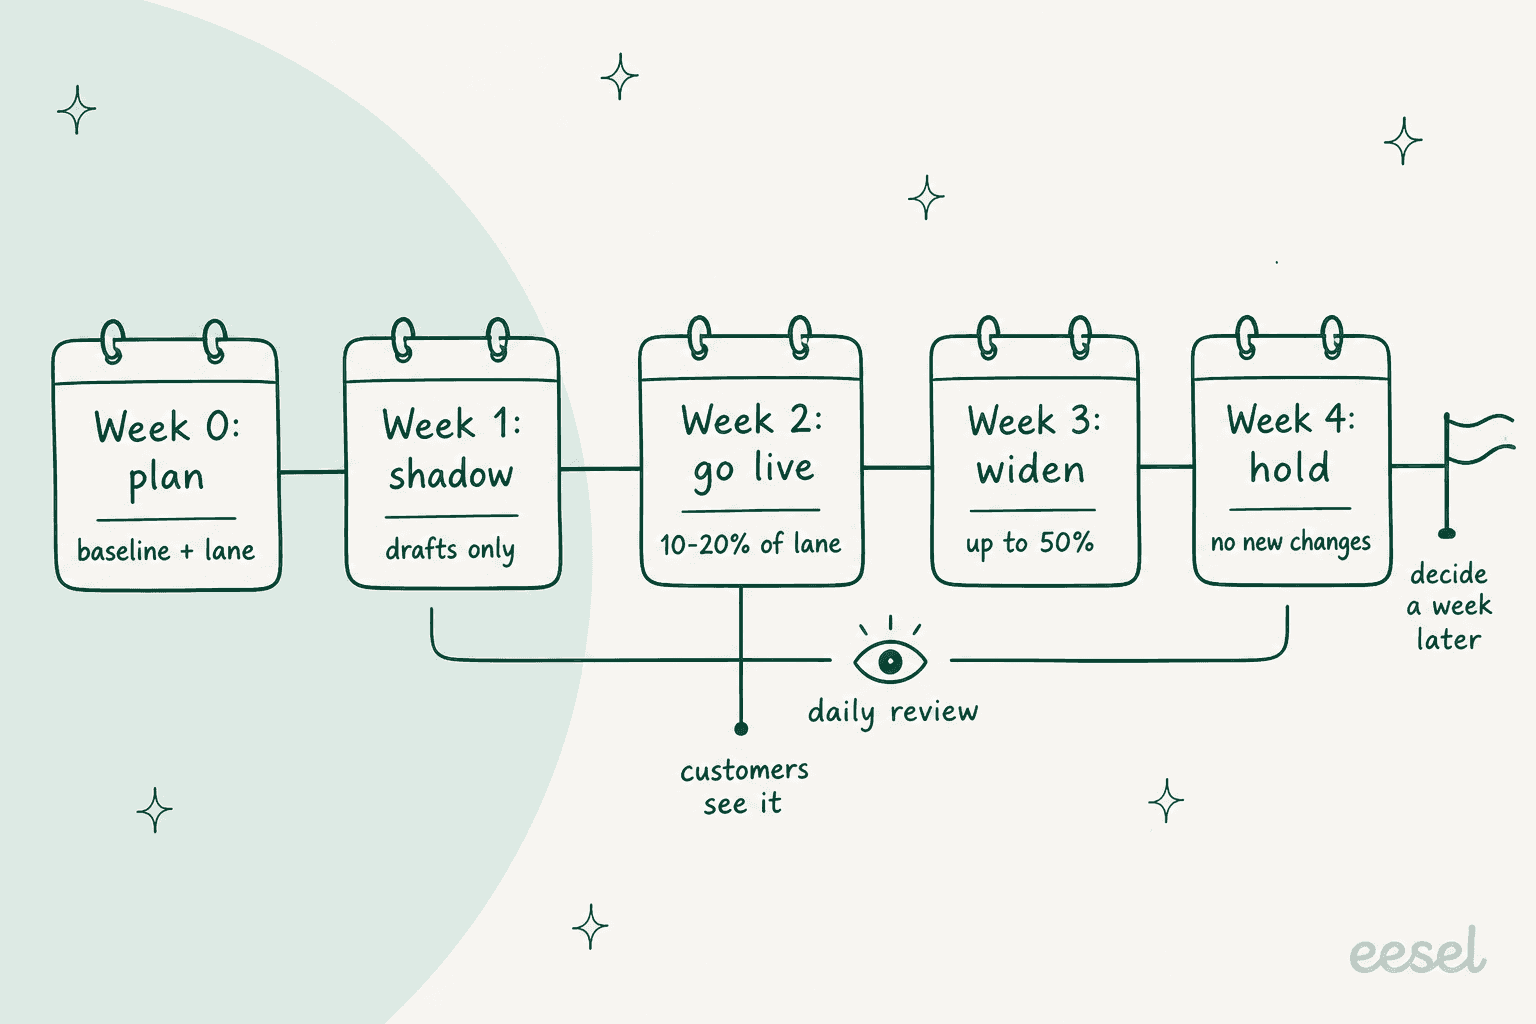
Pour mener un pilote de support par IA, donnez-lui quatre semaines et une voie étroite. La semaine 0 est une semaine de préparation : choisissez deux ou trois types de tickets auxquels l'IA peut répondre directement à partir de vos documents, notez votre référence de départ et vos seuils de réussite, et mettez en place une file IA à côté d'une file de contrôle uniquement humaine pour les mêmes tickets. La semaine 1 est le mode fantôme, où l'IA ne fait que rédiger des brouillons que votre équipe note. En semaine 2, elle répond aux clients sur 10 à 20 % de la voie. En semaine 3, vous élargissez à environ la moitié. En semaine 4, vous ne changez rien et laissez les chiffres se stabiliser, puis vous décidez une semaine plus tard : étendre, corriger et retester, ou arrêter.
La partie que les équipes sautent, c'est la revue quotidienne. Quinze minutes par jour à lire les tickets IA de la veille, chaque action effectuée et chaque conversation rouverte, c'est là que se gagnent les pilotes. Chaque erreur remonte à l'une de quatre causes (une lacune de connaissance, une instruction, des données manquantes ou le routage), et chacune appelle une correction différente. Remboursements, annulations et modifications de compte restent hors du pilote, ou derrière une validation humaine, jusqu'à ce que la voie de simple réponse soit propre.
Si vous voulez un pilote qui fonctionne déjà ainsi : eesel rejoue vos anciens tickets pour vous donner un score avant le premier jour, démarre en brouillons dans Zendesk, Freshdesk, Gorgias ou HubSpot et journalise chaque action pour votre revue quotidienne. XAP a commencé par une seule tranche, des tickets de réorientation rédigés comme notes internes, et élargit le filtre à partir de là. Le plan gratuit vous donne 100 crédits pour l'essayer sur votre propre file.
Pourquoi la plupart des pilotes de support par IA déraillent en semaine deux
Je m'occupe de la file de support d'eesel, donc je vois les pilotes de l'intérieur : les questions de configuration en semaine un, puis les messages « est-ce normal ? » en semaine deux. Les pilotes qui calent le font rarement parce que l'IA est mauvaise. Le plus souvent, personne n'est responsable de la lecture quotidienne de ce que l'IA a fait, le périmètre s'élargit avant que la première voie soit propre, puis trois changements arrivent le même après-midi et personne ne sait lequel a cassé les réponses sur les retours.
En voici un cas réel. Une équipe danoise de télématique automobile sur Zendesk a découvert que son bot disait aux clients « oui, nous prenons en charge votre modèle de voiture » pour des marques qui n'étaient pas dans sa base. Le modèle n'inventait pas de nulle part. Un article d'aide disait que le produit prenait en charge tous les modèles, et l'IA l'a cru. Leur propre résumé de la configuration était « trial and error in the beginning », ce qui est honnête et correspond exactement au rôle d'un pilote : trouver les phrases de votre base de connaissances qui sont fausses d'une manière qu'un agent humain contourne discrètement.
C'est pourquoi je planifierais un pilote comme un projet d'exploitation, pas comme un test logiciel. Le schéma qui fonctionne, chez la plupart des équipes avec lesquelles je parle, est celui que l'on demande de toute façon : commencer par une IA qui rédige des réponses pour les agents, puis la laisser répondre seule aux clients une fois les brouillons corrects.
"The safest rollout I have seen is: let the agent draft, tag confidence plus reason, require approval for refunds or account changes, and review every reopened conversation for the first month. That review log is usually where the real automation boundary shows up."

Cet article est un guide pratique pour ces quatre semaines. Pour le volet mesure (ce qui figure sur la scorecard et comment la noter), consultez la scorecard du pilote de support par IA. Pour la séquence de tests avant lancement plus en détail, voir tests d'un agent de support IA.
Ce qu'il faut préparer avant la semaine un
La semaine 0 représente quelques heures de travail étalées sur quelques jours, et c'est elle qui décide si le reste du pilote sera lisible. Cinq choses doivent être vraies avant que l'IA voie un seul ticket réel.
- Un responsable, nommé. La personne qui fait la revue quotidienne, valide les changements et peut déclencher une pause. Dans les petites équipes, c'est généralement le responsable du support. Ce ne devrait pas être la même personne que celle qui a construit la configuration, pour la même raison que le guide de test de Zendesk vous dit de « select testers who aren't the same people who built your conversation flows ».
- Une référence de départ. Les chiffres du dernier trimestre pour les types de tickets concernés : volume hebdomadaire, délai de première réponse, taux de réouverture ou de recontact, et aussi ce que vous coûte un ticket traité par un humain. Le guide des KPI du service client explique comment les extraire.
- Des seuils de réussite, écrits. Ce qui doit être vrai à la fin pour que vous élargissiez. Je reprendrais les seuils et objectifs de la scorecard du pilote plutôt que d'en inventer, puis je les enverrais à l'éditeur avant le premier jour.
- Un plan de routage. Quels tickets vont dans la file IA, quels tickets identiques restent dans une file de contrôle uniquement humaine, et comment vous étiquetez les deux pour pouvoir les extraire plus tard. Plus de détails ci-dessous.
- Un plan de pause. Qui peut éteindre l'IA, où se trouve l'interrupteur dans votre helpdesk et ce qui justifie de l'utiliser.
Dites ensuite à votre équipe de support ce qui se passe et quel est son rôle. Les agents qui apprennent l'existence du pilote par la plainte d'un client traiteront l'IA comme une menace pendant des mois. Les agents à qui l'on dit « vous êtes les relecteurs, et l'IA prend la pile des suivis de commande » deviennent votre meilleure source de signalements d'erreurs. Une procédure de support pour le pilote (qui relit, quand, où signaler une mauvaise réponse) s'écrit en dix minutes et évite beaucoup de fils Slack.
| Rôle dans le pilote | Qui | Temps nécessaire |
|---|---|---|
| Responsable du pilote | Responsable du support ou agent senior qui n'a pas construit la configuration | 15 à 20 minutes par jour, plus un point hebdomadaire |
| Relecteurs | 2 ou 3 agents, idéalement dont un plus récent | 10 minutes par jour chacun en semaine 1, moins ensuite |
| Correcteur de connaissances | La personne qui gère votre centre d'aide | Quelques corrections par semaine, surtout en semaines 1 et 2 |
| Contact d'escalade | Quelqu'un ayant autorité sur remboursements et comptes | Seulement quand une transmission exige une décision |
Comment choisir les tickets d'un pilote de support par IA
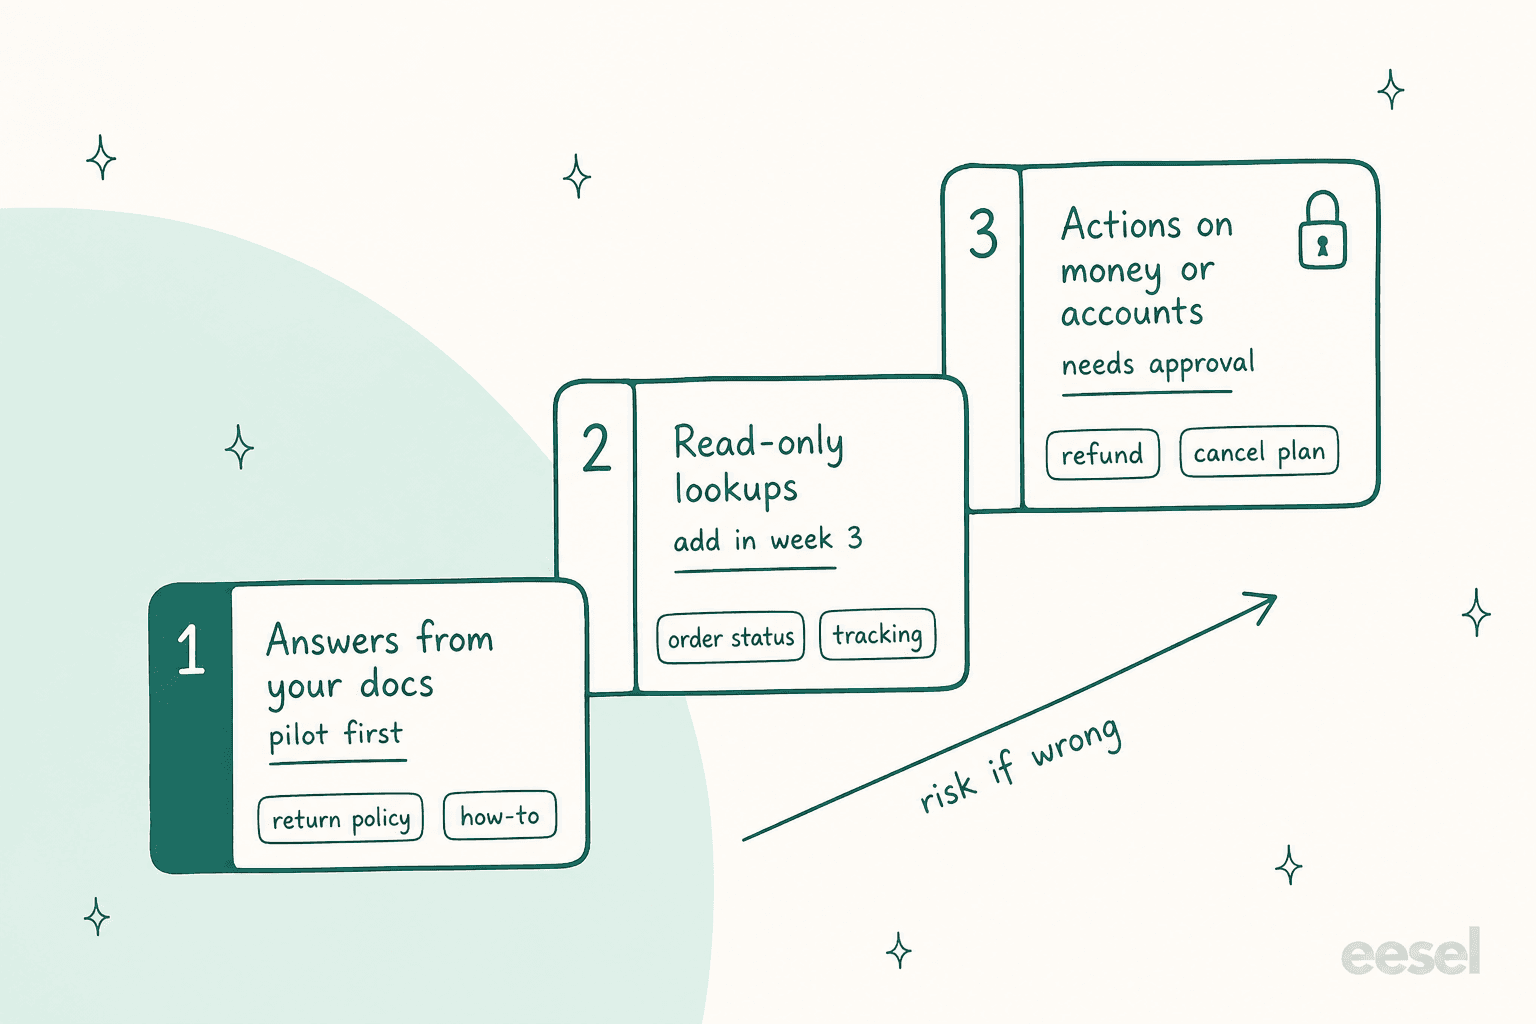
La plupart des équipes trient les candidats du pilote par sujet. Je préfère les trier selon ce que l'IA doit faire pour clore le ticket, car c'est là que se situe le risque. Il y a trois types :
- Réponses issues de vos documents. Politique de retour, délais de livraison, questions pratiques. Si l'IA se trompe, un client reçoit une mauvaise phrase, et la correction est généralement juste un article.
- Consultations en lecture seule. Suivi de commande, suivi de colis, détails d'abonnement. L'IA lit un système et rapporte ce qu'elle a trouvé. Se tromper ici, c'est lire la mauvaise commande ou le mauvais statut, ce qui est pire mais ne change toujours rien.
- Actions sur l'argent ou les comptes. Remboursements, annulations, changements d'adresse, modifications de compte. Se tromper ici signifie que quelque chose s'est déjà produit et qu'il faut maintenant l'annuler.
Le pilote commence par le premier type et ajoute le deuxième en semaine 3 si la revue quotidienne est propre ; le troisième attend la fin du pilote, derrière une approbation. Cette répartition correspond aussi à la façon dont les éditeurs configurent leurs propres tests : Gorgias, par exemple, garde les actions désactivées par défaut dans les conversations de test parce que, si elles sont activées, elles « can affect real customer and order data (like cancelling an order) ».
Deux filtres supplémentaires avant qu'un type de ticket soit retenu. Vos documents doivent déjà y répondre (sinon, c'est un travail d'analyse des lacunes de connaissance en semaine 0, pas une conclusion du pilote). Et il lui faut du volume, car une voie de 15 tickets par semaine ne vous apprendra presque rien en un mois. Les questions de suivi de commande sont la favorite habituelle pour cette raison : fort volume, une seule consultation, faible risque.
Les décisions de jugement (réclamations, rétrofacturations, clients en colère) restent aux humains pendant tout le pilote. Un praticien l'a bien formulé :
"Splitting it by impact makes more sense to me. A slightly awkward response is one thing but anything involving pricing, refunds or account changes should have a much higher bar."
Étroit, c'est très bien. XAP, qui développe des logiciels de préparation aux études et aux carrières, a démarré sa configuration eesel sur Freshdesk avec une seule tranche : les tickets où un étudiant pose une question qui relève de son établissement ou d'une agence d'État, et qui demandent une réorientation polie et exacte. Un filtre ne laisse passer que ces cas (plus les réinitialisations de mot de passe du portail), puis eesel rédige la réponse complète comme note interne à partir de la réponse type de l'équipe et une personne l'envoie. Dans son témoignage, l'agent de réorientation est appelé « the first slice », et le filtre s'élargit à mesure que l'équipe ajoute des cas de réorientation pour ses autres portails. C'est une voie de pilote bien faite : petite, répondable et facile à vérifier.
Saisissez votre propre répartition de tickets pour voir dans quelle voie tombe chaque type, et si la voie a assez de volume pour juger à la fin de la semaine 4.
Si la voie est trop courte, ajoutez un autre type de ticket de réponse avant d'étirer le calendrier. Un pilote plus long sur une voie maigre ne fait surtout que donner plus de temps au périmètre pour déraper.
Comment séparer une file IA et une file de contrôle dans votre helpdesk
Vous voulez les mêmes types de tickets, sur le même canal, traités de deux façons sur les mêmes semaines : certains par l'IA, d'autres uniquement par des humains. L'article sur la scorecard explique pourquoi la file de contrôle uniquement humaine compte pour les chiffres. Voici où se trouvent les réglages dans chaque helpdesk, vérifiés dans le centre d'aide de chaque éditeur le 20 octobre 2026.
| Helpdesk | Délimiter la voie IA avec | Garder une file de contrôle par | Mettre en pause par |
|---|---|---|---|
| Zendesk | Canaux par agent IA ; conditions de déclenchement d'un agent e-mail | Un trafficSplit aléatoire avec groupe de contrôle, activé par votre account manager (test A/B), ou une adresse de support distincte | Décocher le canal dans Manage channels |
| Freshdesk | Sources de tickets, « Deploy to internal teams » ou règles personnalisées jusqu'à cinq niveaux de ET/OU | Une règle personnalisée qui laisse de côté une partie de la voie (une boîte, un attribut client) | Un plafond Daily conversation limits, ou désactiver l'agent sur cette source |
| HubSpot | Un canal par déploiement, horaires de travail, listes d'inclusion et d'exclusion pour l'e-mail | Le pourcentage Conversation coverage (le reste va aux humains) | Désactiver l'attribution du customer agent |
| Gorgias | AI Agent > Deploy par canal, une skill à la fois | Laisser un canal ou une skill désactivé pour la voie et comparer | Désactiver une skill « without affecting others » |
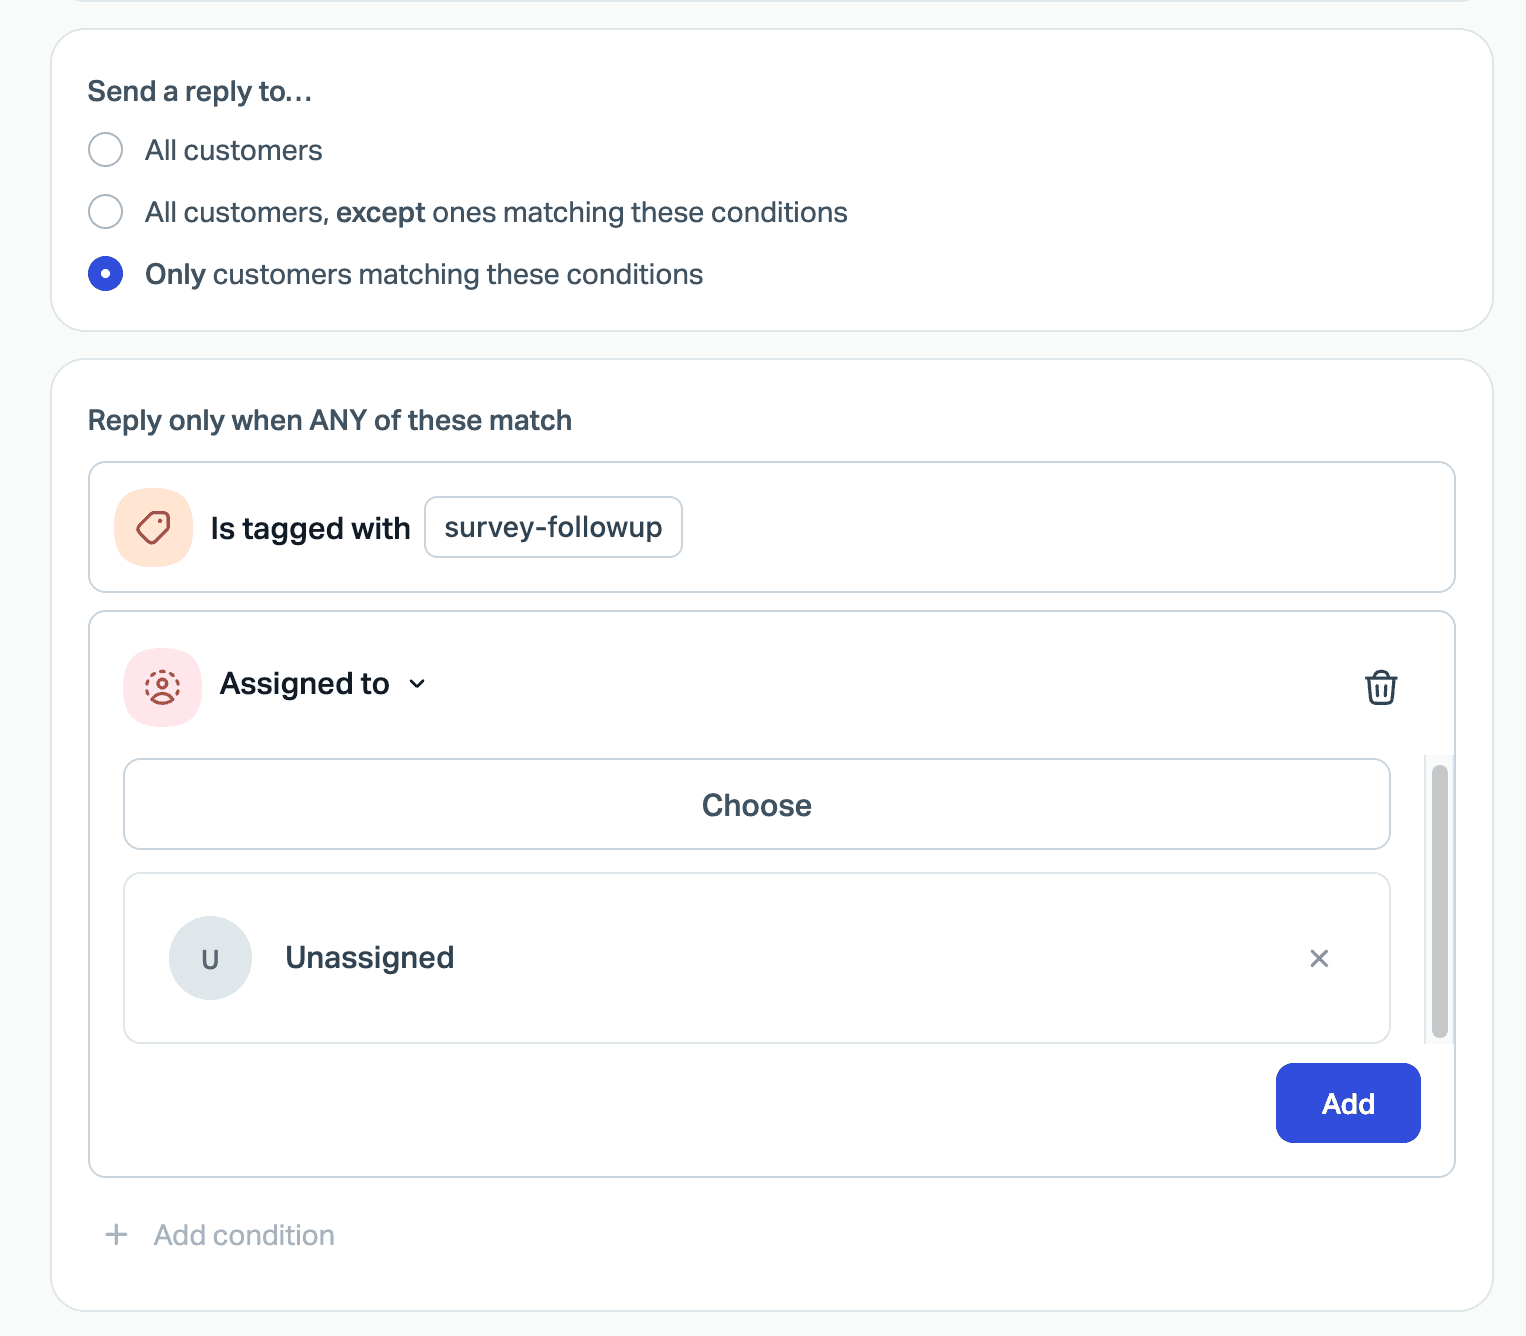
| Help Scout | Par Beacon et par boîte ; l'e-mail peut être limité à « Only customers matching these conditions » | Le périmètre « except ones matching these conditions » sur la même boîte | Le bouton Enable par Beacon ou par boîte |
Quelques détails de ces pages qui changent la façon de configurer :
- Zendesk ne permet qu'un seul agent IA à la fois par canal, et un agent conçu pour la messagerie ne peut pas être basculé plus tard vers l'e-mail. Décidez d'abord du canal, avant de construire.
- La mise en production de Freshdesk ne va que vers l'avant. Les tickets arrivés avant le déploiement « are not retroactively answered », ce qui veut dire que le jour un du pilote démarre propre.
- Le conseil de HubSpot correspond à la montée en charge ici : commencer par « a single channel or limit it to a small percentage of conversations », puis examiner les escalades et les lacunes de connaissance avant d'élargir. En pause, « it keeps existing chats but won't get new ones ».
- Gorgias fournit des vues de boîte pour les tickets que l'IA traite, ceux qu'elle a clos et ceux qu'elle a transmis, ce qui est en gros votre file de revue quotidienne déjà construite.
Le constructeur de conditions de Help Scout montre bien à quel point une voie peut être précise : l'IA ne répond qu'aux tickets qui correspondent à une étiquette ou à une règle d'attribution.
Quel que soit le helpdesk, étiquetez les deux files dès le premier jour (ai_pilot et ai_control conviennent). Le guide sur l'étiquetage du support par IA en dit plus sur le nommage. En semaine 4, vous voudrez extraire les deux ensembles dans un tableur sans dépendre du rapport de l'éditeur.
Semaine 1 : le mode fantôme avant qu'aucun client ne voie quoi que ce soit
Le mode fantôme signifie que l'IA traite de vrais tickets entrants dans votre voie, mais que tout ce qu'elle écrit est un brouillon ou une note interne. Une personne le lit et le note, puis l'envoie, le modifie ou l'ignore. Les clients ne voient aucune différence. Il n'y a aucun risque client, et c'est là que se révèlent la plupart des problèmes corrigeables.
Avant le début de la semaine fantôme, je ferais tourner l'IA sur vos anciens tickets pour que vous partiez avec un score plutôt qu'une intuition. La plupart des helpdesks offrent aujourd'hui un moyen de le faire sans payer :
- L'évaluation de l'AI Agent e-mail de Freshdesk peut Import tickets « to use solved historical tickets », jusqu'à 50 requêtes par exécution, et Freshworks recommande « at least 20 representative queries before deploying ». L'aperçu « does not affect live conversations or consume message limits ».
- Les tests par lots de HubSpot construisent des questions de test à partir des thèmes de vos conversations réelles, et l'aperçu ou le test ne consomme pas de HubSpot Credits.
- Les conversations de test de Gorgias « are free to use » et peuvent rejouer « an existing ticket », une à la fois.
- Le sandbox, le widget de test et le simulateur de conversation de Zendesk ne consomment pas de résolutions automatisées, mais un agent e-mail testé en production si. Le guide de configuration du sandbox Freshdesk couvre l'équivalent de ce côté.
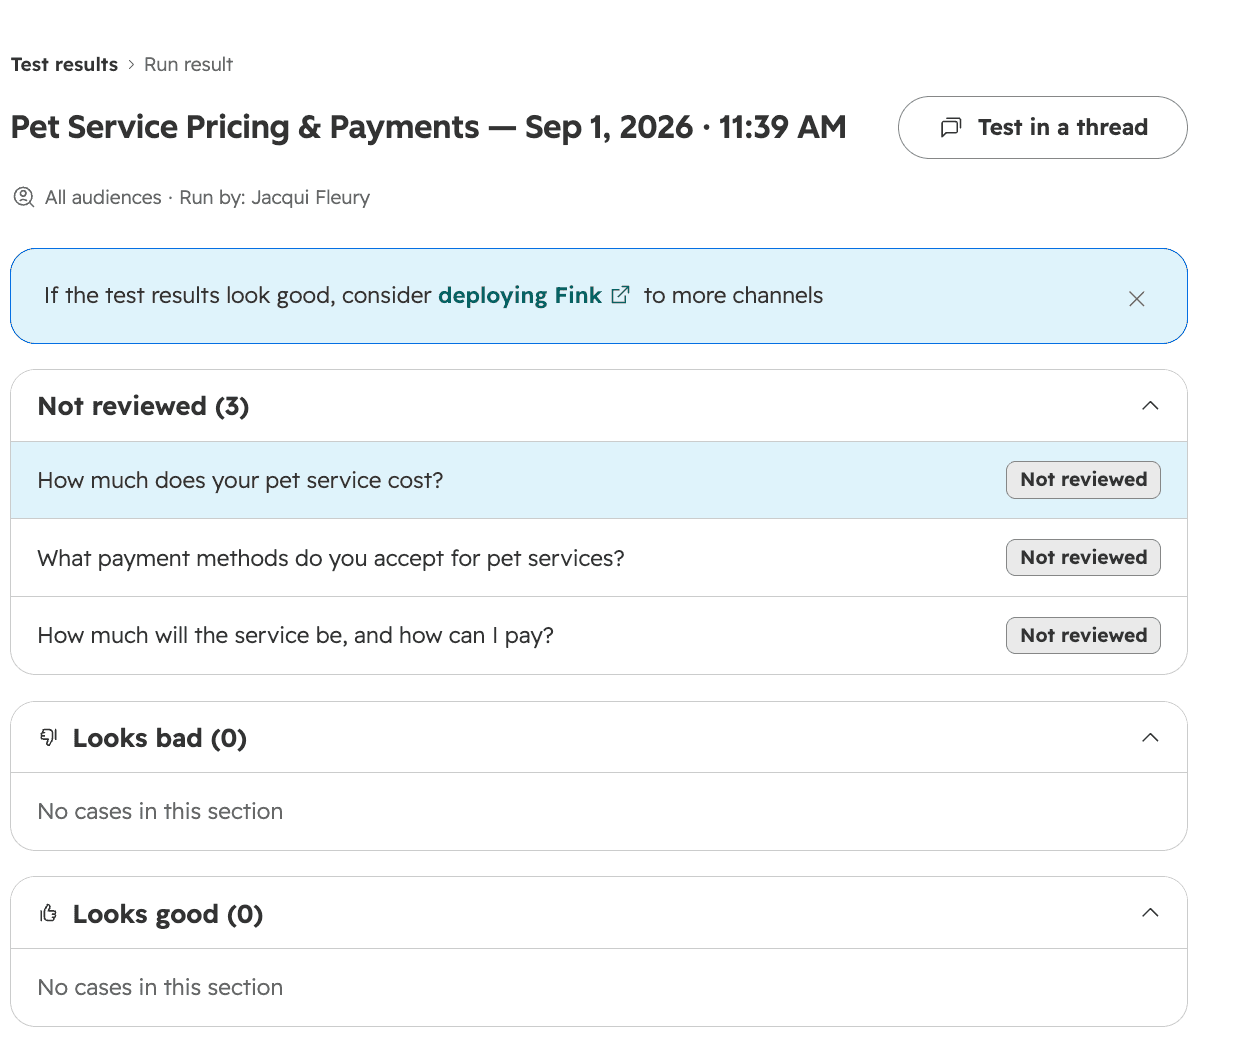
Pendant la semaine fantôme elle-même, demandez aux relecteurs de noter chaque brouillon de trois façons : envoyer tel quel, envoyer avec modifications, ou faux. Gardez une courte note sur chaque « faux ». Vendredi, vous aurez une liste, et cette liste est votre plan de correction de la semaine 2. Glissez aussi quelques tickets volontairement délicats, du genre insistant « vous avez tort, remboursez-moi » ; le guide sur les tests adverses propose un jeu à emprunter.
Attendez-vous à beaucoup de « envoyer avec modifications » au début, et ne paniquez pas. Dans l'essai d'un bijoutier sur eesel, la plupart des modifications que les agents ont faites aux brouillons portaient sur la longueur et le ton, le genre de chose qui s'améliore quand l'IA apprend des réponses envoyées par l'équipe. Les modifications qui corrigeaient une erreur factuelle ne représentaient qu'une petite part. C'est un constat très différent de « l'IA se trompe », et vous ne le voyez que si les relecteurs disent pourquoi ils ont modifié.
Le test de sortie de la semaine 1 est simple : la pile « faux » est petite, et chaque élément a soit une correction que vous avez faite, soit une raison pour laquelle ce type de ticket doit quitter la voie.
Semaines 2 et 3 : passer en production sur une tranche, puis élargir
En semaine 2, l'IA commence à répondre aux clients, mais seulement sur une partie de la voie. Je commencerais à 10 à 20 %. Le champ de couverture de HubSpot le fait directement ; sur les autres helpdesks, une règle sur un attribut client ou une boîte y parvient. Le reste de la voie reste aux humains, ce qui sert aussi de file de contrôle.
Trois règles pour ces deux semaines :
- N'élargissez qu'après une période propre. Si la revue quotidienne a été propre pendant trois ou quatre jours ouvrés, passez d'environ 20 % à environ la moitié en semaine 3. Sinon, restez où vous êtes et corrigez d'abord.
- Changez une seule chose à la fois et notez la date. Une voie élargie et une nouvelle instruction le même jour, et vous ne pouvez pas dire ce qui a fait bouger les chiffres. Swiftreg, qui vend des plaques d'immatriculation personnalisées au Royaume-Uni, tient ses instructions de support eesel sous forme de versions numérotées, déployées selon sa propre procédure plutôt que modifiées en direct. C'est plus de processus que ce dont la plupart des pilotes ont besoin, mais l'habitude (chaque changement a une version et une date) est la bonne.
- Ajoutez les consultations en lecture seule avant les actions. Si la semaine 2 a été propre sur les tickets de simple réponse, la semaine 3 est le moment où le suivi de commande et de colis peuvent s'ajouter. Les actions restent désactivées.
Rendez évident le chemin « parler à une personne » dès le premier jour de production. Les clients bloqués qui ne trouvent pas d'humain n'apparaissent pas comme des échecs dans la plupart des tableaux de bord ; ils apparaissent comme des conversations abandonnées ou des tickets furieux sur un autre canal. La liste sur la transmission d'un agent IA couvre ce qu'une transmission doit contenir pour que votre agent n'ait pas à reposer les questions.
Côté transparence, je dirais aux clients qu'ils parlent à une IA. Swiftreg termine chaque réponse publique de l'IA par un pied de message indiquant que l'AI Support Assistant l'a rédigée et qu'elle peut contenir des erreurs, et le chat en direct de HubSpot affiche « Powered by AI » dans l'en-tête tant que le customer agent est attribué. Cela fixe les attentes et rend aussi une mauvaise réponse plus facile à pardonner.
La revue QA quotidienne qui décide de votre pilote
C'est l'habitude qui sépare les pilotes qui se terminent par une décision claire de ceux qui se terminent en dispute. Quinze minutes, à la même heure chaque jour, de la semaine fantôme à la fin de la semaine 4.
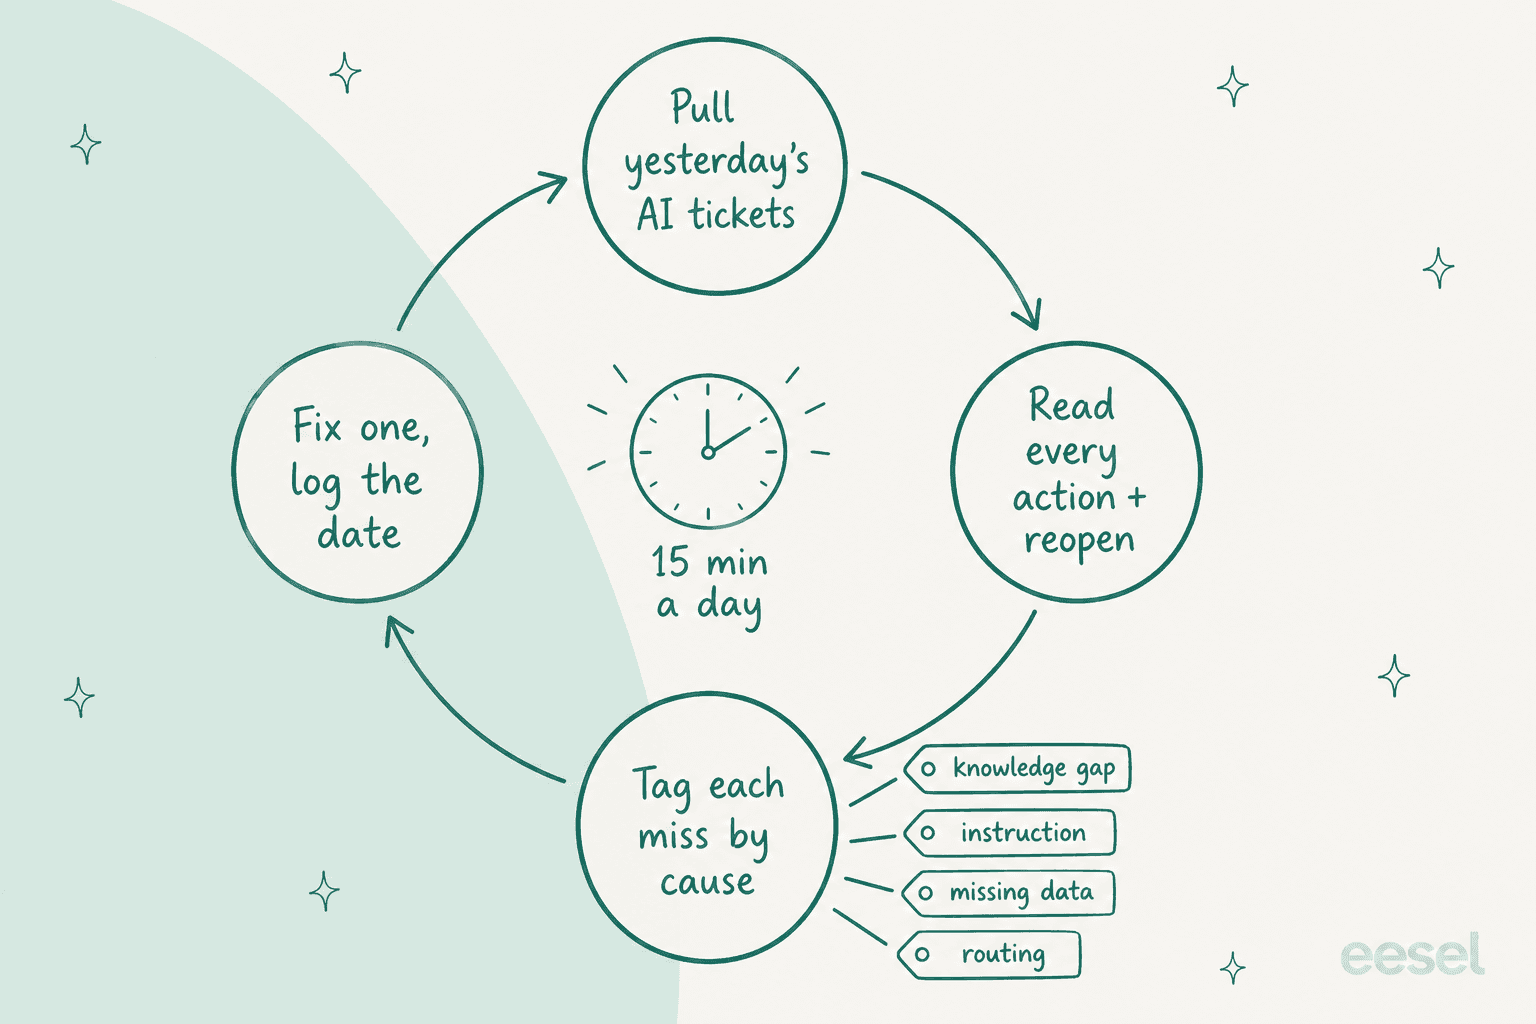
Ce qui entre dans ces quinze minutes :
- Chaque action effectuée par l'IA, si certaines sont activées. Lisez le journal, pas seulement la réponse. Une réponse peut se lire parfaitement et reposer sur le mauvais numéro de commande.
- Chaque conversation rouverte ou de recontact de la file IA. Ce sont les erreurs que le tableau de bord compte comme des réussites.
- Chaque transmission. L'humain a-t-il reçu assez d'éléments pour continuer sans reposer les questions ?
- Un échantillon de la pile « résolu », 10 à 20 par jour. Gorgias suggère de relire « at least 10 tickets that AI Agent handled » la première semaine dans le cadre de la mise en production ; je garderais ce rythme pendant tout le pilote.
Étiquetez ensuite chaque erreur par sa cause, car chaque cause a une correction différente et aussi un responsable différent :
| Cause de l'erreur | À quoi ça ressemble | La correction | Qui corrige |
|---|---|---|---|
| Lacune de connaissance | A répondu à partir d'un article périmé ou manquant (« we support all models ») | Modifier ou ajouter l'article ; retester le sujet | Responsable du centre d'aide (audit de la base de connaissances) |
| Instruction | Bons faits, mauvais comportement : trop long, mauvais ton, pas de transmission | Ajouter ou resserrer une règle | Responsable du pilote |
| Données manquantes | Avait besoin d'une commande, d'un compte ou d'un système qu'elle ne voit pas | Connecter la source, ou retirer le type de ticket de la voie | La personne responsable de l'intégration |
| Routage | Un ticket qui n'aurait pas dû être dans la voie y est arrivé | Resserrer le filtre ou le déclencheur | Administrateur du helpdesk |
Tenez un journal de changements partagé à trois colonnes : la date et ce qui a changé, puis pourquoi. Le guide de test de Zendesk suggère la même chose pour les testeurs, un fichier partagé pour « track whether a resolution has been implemented ». Quand un chiffre bouge en semaine 3, le journal vous dit si c'est l'article corrigé mardi ou la voie élargie mercredi. Si deux relecteurs ne sont pas d'accord sur le fait qu'une réponse était « fausse », une courte séance de calibrage QA règle la grille avant que le désaccord ne devienne du bruit dans vos résultats.
Le responsable de cette revue n'a pas besoin d'être technique. Chez Norden-Frisia, une compagnie de ferries allemande desservant les îles de la mer du Nord, la responsable du support Frauke Hagen gère seule la configuration eesel : elle consulte l'historique des conversations, pose la question quand une réponse contredit les FAQ et copie elle-même les corrections du bot Zendesk vers le chatbot. Leur essai n'a duré qu'une semaine, et c'est l'entraînement sur d'anciens tickets qui a décidé de l'abonnement.
"I think the key is testing the decision separately from the conversation. An agent can have a perfectly polite chat and still issue a refund it wasn't allowed to. If it has to state which policy and limit it applied before it takes any action, you can check that against the rule instead of reading through transcripts."
Quand mettre en pause un pilote de support par IA en cours de route
Écrivez les règles de pause en semaine 0 pour que personne n'ait à en débattre un mauvais mardi. Je mettrais la file IA en pause le jour même si l'un de ces cas se produit :
- Une mauvaise action a atteint un client : un remboursement sur la mauvaise commande, une modification sur le mauvais compte.
- L'IA a énoncé une politique qui n'existe pas, ou promis quelque chose que votre équipe ne peut pas tenir.
- La part de clients demandant une personne bondit par rapport aux jours précédents.
- Une politique a changé et les connaissances n'ont pas suivi. Un nouveau délai de retour, de nouveaux prix ou une panne. Pause jusqu'à la mise à jour des articles, puis retestez ce sujet. Le guide de gestion des changements de politique propose une liste de contrôle.
La pause coûte peu si vous savez où se trouve l'interrupteur. Sur Zendesk, elle se fait en décochant le canal, il n'y a pas de bouton de pause distinct.
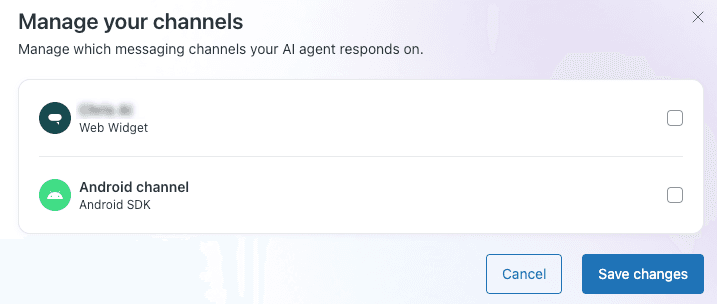
HubSpot vous laisse « manually pause customer agent assignment by turning it off », ce qu'il suggère « when updating or reviewing content sources or making changes to the agent's configuration ». Le plafond quotidien de Freshdesk est le frein plus doux : « Conversations continue to arrive but the AI stops replying once the limit is reached ». Quel que soit celui que vous utilisez, une pause ne signifie pas un pilote raté. Notez-la avec la date et le motif, faites une courte analyse d'erreurs de sa cause, puis relancez le chrono sur cette voie une fois corrigée.
Semaine 4 et après : étendre, retester ou arrêter
La semaine 4 est une semaine de maintien. Pas de nouveaux types de tickets ni de changement de couverture, pas de nouvelles instructions sauf si quelque chose est vraiment cassé. Vous laissez les derniers changements se stabiliser pour que la dernière semaine reflète une configuration stable. Fixez ensuite la réunion de décision une semaine après la fin du pilote, car les fenêtres de résolution des éditeurs et votre propre contrôle de recontact ont besoin d'un peu de temps pour finir de compter (la scorecard explique le calendrier).
La décision elle-même est l'une de trois, et chacune a des conséquences concrètes pour le mois suivant :
| Décision | Quand | Ce que vous faites ensuite |
|---|---|---|
| Étendre | Les seuils tiennent et les objectifs sont atteints sur la voie | Montez d'un cran : ajoutez le type de ticket de réponse suivant, ou les consultations en lecture seule, ou un canal de plus. Un à la fois, avec la même revue quotidienne |
| Corriger et retester | Sûr, mais sous l'objectif | Traitez les principales causes de votre journal de changements, relancez la relecture des anciens tickets, puis deux semaines de plus sur la même voie |
| Arrêter | Un seuil a échoué, ou les clients sont revenus plus souvent que dans la file de contrôle | Gardez les articles nettoyés et les étiquettes de tickets, notez pourquoi, et décidez si un autre outil ou une voie plus étroite vaut un second pilote |
« Étendre » est le moment où la plupart des équipes veulent sauter directement aux remboursements. Je garderais les actions un cycle de plus et les ferais d'abord passer par des workflows d'approbation : l'IA prépare le remboursement et une personne l'approuve, puis vous comptez à quelle fréquence la personne est en désaccord. Quand ce chiffre reste proche de zéro pendant quelques semaines, les actions courantes peuvent tourner seules. Les gros remboursements, les rétrofacturations et tout ce qui dépasse les limites de votre matrice d'approbation des remboursements restent aux humains.
Erreurs que je vois quand les équipes mènent un pilote IA
- Pas de responsable nommé. La revue quotidienne devient « celui qui a le temps », c'est-à-dire personne dès jeudi.
- Piloter les tickets les plus difficiles pour « vraiment la tester ». Vous apprendrez que les tickets difficiles sont difficiles. Commencez là où l'IA peut gagner et élargissez à partir de là.
- Tous les canaux à la fois. Une mauvaise semaine sur le chat et l'e-mail ensemble ne peut être attribuée à aucun des deux.
- Changer trois choses le même jour. Vous ne savez pas laquelle a aidé, ni laquelle a cassé les retours.
- Sauter la file de contrôle parce que l'avant et l'après semblent évidents. La répartition des tickets et la saisonnalité bougent aussi.
- Lire le tableau de bord de l'éditeur au lieu des tickets. Le tableau de bord vous dit combien de conversations se sont terminées, pas si elles étaient justes. La liste plus longue se trouve dans erreurs de mise en œuvre de l'IA en service client.
Menez votre pilote de support par IA avec eesel
eesel est un coéquipier IA de helpdesk qui rejoint votre file existante dans Zendesk, Freshdesk, Gorgias, HubSpot et d'autres, et il est conçu pour être piloté comme décrit dans cet article :
- Score de la semaine 0 à partir de votre propre historique. La skill Simulation fait tourner votre agent sur de vrais tickets passés et note chaque réponse par rapport à ce que votre équipe a envoyé, puis suggère des changements d'instructions. Elle n'envoie rien aux clients.
- Mode fantôme par défaut. Il démarre en brouillons : chaque réponse est un brouillon ou une note interne qu'une personne envoie. Vous le laissez répondre de bout en bout aux cas faciles quand vous êtes prêt, et vous pouvez tout désactiver à tout moment.
- Actions derrière approbation. Chaque action est Auto, Needs approval ou Disabled, et les approbations ne s'exécutent jamais d'elles-mêmes après un délai. Les remboursements peuvent rester sur Needs approval pendant tout le pilote.
- Une revue quotidienne déjà organisée. La page Activity liste chaque ticket traité, ce qu'il a recherché, chaque action et qui l'a approuvée, avec son raisonnement. Quand vous le corrigez dans le chat à côté d'une exécution, la correction devient une règle dans ses instructions, si bien qu'elle tient encore la semaine prochaine.

Les tarifs sont un plan mensuel fixe où un ticket ou un chat vaut 1 crédit : gratuit avec 100 crédits sans carte, puis à partir de $299/month pour 500 crédits. Le plan gratuit suffit pour voir ses brouillons sur vos propres tickets avant de vous engager. Si vous allez lancer un pilote avec n'importe quel éditeur, faites d'abord tourner la simulation d'eesel sur votre file et apportez le rapport à la comparaison. Essayer eesel.
Comment mener un pilote de support par IA ?