

Pourquoi réussir le test des réponses ne veut pas dire que vous êtes prêt à lancer
Je construis les intégrations helpdesk d'eesel, ce qui veut dire que je passe mes journées exactement dans le code où vivent les problèmes du jour de lancement : déclencheurs, transferts, appels d'API vers les systèmes de commandes et étiquettes qui indiquent qui a touché un ticket. Le modèle est rarement ce qui casse ; c'est le plus souvent la tuyauterie.
Les bonnes pratiques de test de Zendesk donnent une image fidèle de la façon dont la majeure partie du secteur y pense. Elles disent aux testeurs : « Focus on whether the AI agent's response was accurate and matched the tone of voice you expected. » C'est un bon conseil, et ce n'est aussi que la pointe de l'iceberg. Le même centre d'aide documente, dans d'autres articles, que les tickets d'agents IA n'exécutent pas vos déclencheurs et automatisations de tickets tant qu'ils ne sont pas escaladés. Vos règles de routage se déclenchent donc pour la première fois au moment exact du transfert, le seul moment qu'un test de précision n'atteint jamais.
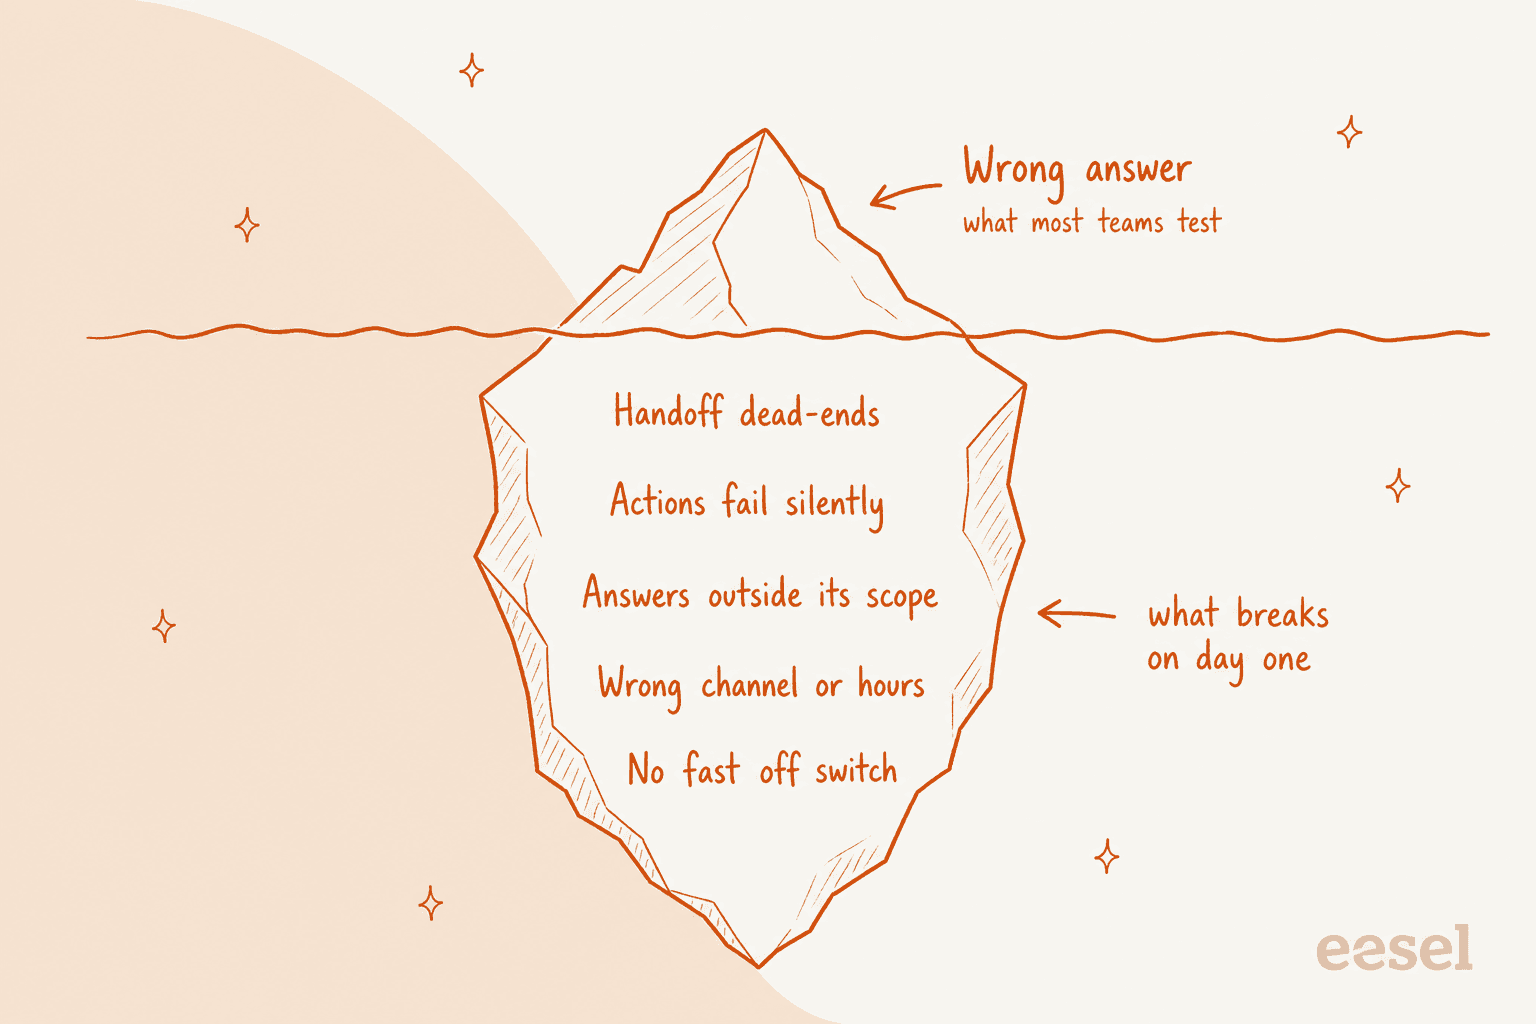
J'ai moi aussi mes cicatrices. Sur la plateforme d'eesel, j'ai vu un bot traiter ses propres réponses comme de nouveaux messages de client et se répondre à lui-même, une boucle d'auto-réponse qui n'est apparue que sur un helpdesk en production. J'ai vu du texte interne de l'interface fuiter dans une réponse publique lors d'un essai en production chez un client. Et j'ai vu des bots sur la plateforme d'eesel inventer des réponses quand la base de connaissances revenait vide, au lieu de transférer. Aucun de ces cas n'était une mauvaise réponse à une question de test. Tous étaient des coutures.
Le volet juridique a lui aussi rattrapé le sujet. Dans Moffatt v. Air Canada, le chatbot de la compagnie aérienne a dit à un client qu'il pouvait demander le tarif deuil après avoir voyagé, dans les 90 jours suivant l'émission du billet, ce qui contredisait la propre page de politique d'Air Canada. Le tribunal a qualifié l'argument d'Air Canada selon lequel le chatbot était « a separate legal entity » de « remarkable submission » et lui a ordonné de payer 812,02 $. Le bot s'est trompé, mais la vraie défaillance est que personne ne l'avait vérifié par rapport à la politique source avant que des clients s'y fient.
Si vous avez déjà lu le guide de mon collègue sur les tests d'agents de support IA, le côté réponses est couvert. Cet article en est le complément : tout le reste que vous devez vérifier la semaine avant d'actionner l'interrupteur.
Les sept vérifications avant lancement en un coup d'œil
Voici tout le plan sur un seul écran. La première vérification est celle que la plupart des équipes font déjà. Les six autres sont celles où le jour du lancement tourne mal.
| # | Vérification | Ce que vous démontrez | Seuil de réussite avant lancement |
|---|---|---|---|
| 1 | Rejouer de vrais tickets | Il répond correctement à vos questions courantes et dans votre ton | Noté sur plus de 50 anciens tickets, précision et ton notés séparément |
| 2 | Limites de périmètre | Il refuse ou transfère les sujets qu'il ne doit pas toucher | Chaque sujet exclu est transféré, demandé de trois façons différentes |
| 3 | Chemins de transfert | Un humain reçoit réellement le ticket, avec le contexte | Chaque chemin arrive dans une file surveillée, en heures ouvrées et hors horaires |
| 4 | Actions | Les lectures et écritures fonctionnent et échouent sans danger | Chaque action testée sur des enregistrements de test, plus une panne forcée |
| 5 | Où il intervient | Il répond aux bons tickets et ignore les autres | Un ticket de test par exclusion (interne, spam, VIP, autre marque) |
| 6 | Bouton d'arrêt | Vous pouvez l'arrêter vite sans perdre de tickets | Quelqu'un l'a éteint puis rallumé, chronométré |
| 7 | Reporting | Vous savez ce qu'il a fait le premier jour | Tickets touchés par l'IA étiquetés et visibles dans une seule vue |
Les seuils de réussite sont les miens, pas une norme du secteur. Fixez les vôtres, mais écrivez-les avant de commencer à tester, pas après avoir vu les résultats. Si vous avez besoin d'aide pour choisir les chiffres, l'AI support pilot scorecard propose un modèle.
Vérification 1 : rejouer de vrais tickets pour les réponses
Commencez par le test des réponses, car tout le reste suppose que l'agent réussit les questions faciles. Prenez 50 à 100 tickets résolus récemment sur vos sujets principaux, passez-les dans l'agent sans qu'il réponde à personne et comparez sa réponse avec ce que votre équipe a réellement envoyé.
La plupart des helpdesks fournissent un outil pour cela. L'agent e-mail de Freshdesk peut évaluer des tickets importés, jusqu'à 50 requêtes par exécution, et en recommande au moins 20. L'agent client de HubSpot lance des tests par lots allant jusqu'à 8 jeux de test sans consommer de crédits. La compétence Simulation d'eesel rejoue vos vrais anciens tickets et note chaque réponse par rapport à ce que votre équipe a envoyé, puis suggère des changements d'instructions.
Notez la précision et le ton comme deux chiffres séparés. Lors d'un essai eesel sur du trafic réel, une boîte e-commerce de bijouterie traitant environ 1 000 tickets par mois, 88 % des brouillons allaient dans la bonne direction mais seuls 12 % ont été envoyés tels quels, et 7 % contenaient une erreur factuelle. La plupart des réécritures portaient sur la longueur et le ton, pas sur les faits. Un seul score de « précision » aurait caché les deux problèmes.
Gardez ensuite le jeu de test vivant. Ce commentaire Reddit est le conseil le plus utile sur le sujet, et il n'a rien de sophistiqué :
"keep a list of test questions handy and run it through and see if you get the right answers. Whenever an edge case appears, add to the list of test questions, update your agent and re-run your tests. Boring, but works."

Incluez des questions auxquelles votre documentation ne répond qu'à moitié. Le bon résultat est alors un transfert, pas une supposition assurée. Si des réponses sont fausses parce que la source est obsolète, c'est un problème de connaissances, et un audit de la base de connaissances corrigera plus de choses que n'importe quel ajustement de prompt.
Vérification 2 : tester ce qu'il ne doit pas traiter
C'est là que le « on lui a dit de ne pas le faire » rencontre la réalité. Tous les grands helpdesks séparent désormais les consignes souples des règles strictes, et la version souple est celle que la plupart des équipes configurent.
- Zendesk cite « Always escalate to an agent if the user mentions being hacked » comme une mauvaise instruction, car « Instructions cannot trigger escalations » (guide des instructions Zendesk). Il vous faut un cas d'usage pour cela.
- Freshdesk indique que son réglage « Topics to avoid » « may not fully prevent responses in edge cases » et renvoie au réglage de transfert pour une application stricte (identité et instructions Freshdesk).
- Help Scout le dit clairement : les rôles changent la façon dont Scout répond, et pour envoyer des sujets directement à votre équipe, « create an exclusion » (rôles de Scout).
- HubSpot permet de définir des garde-fous par segment et prévient que les réponses « may not always exactly match » ce que vous avez précisé.
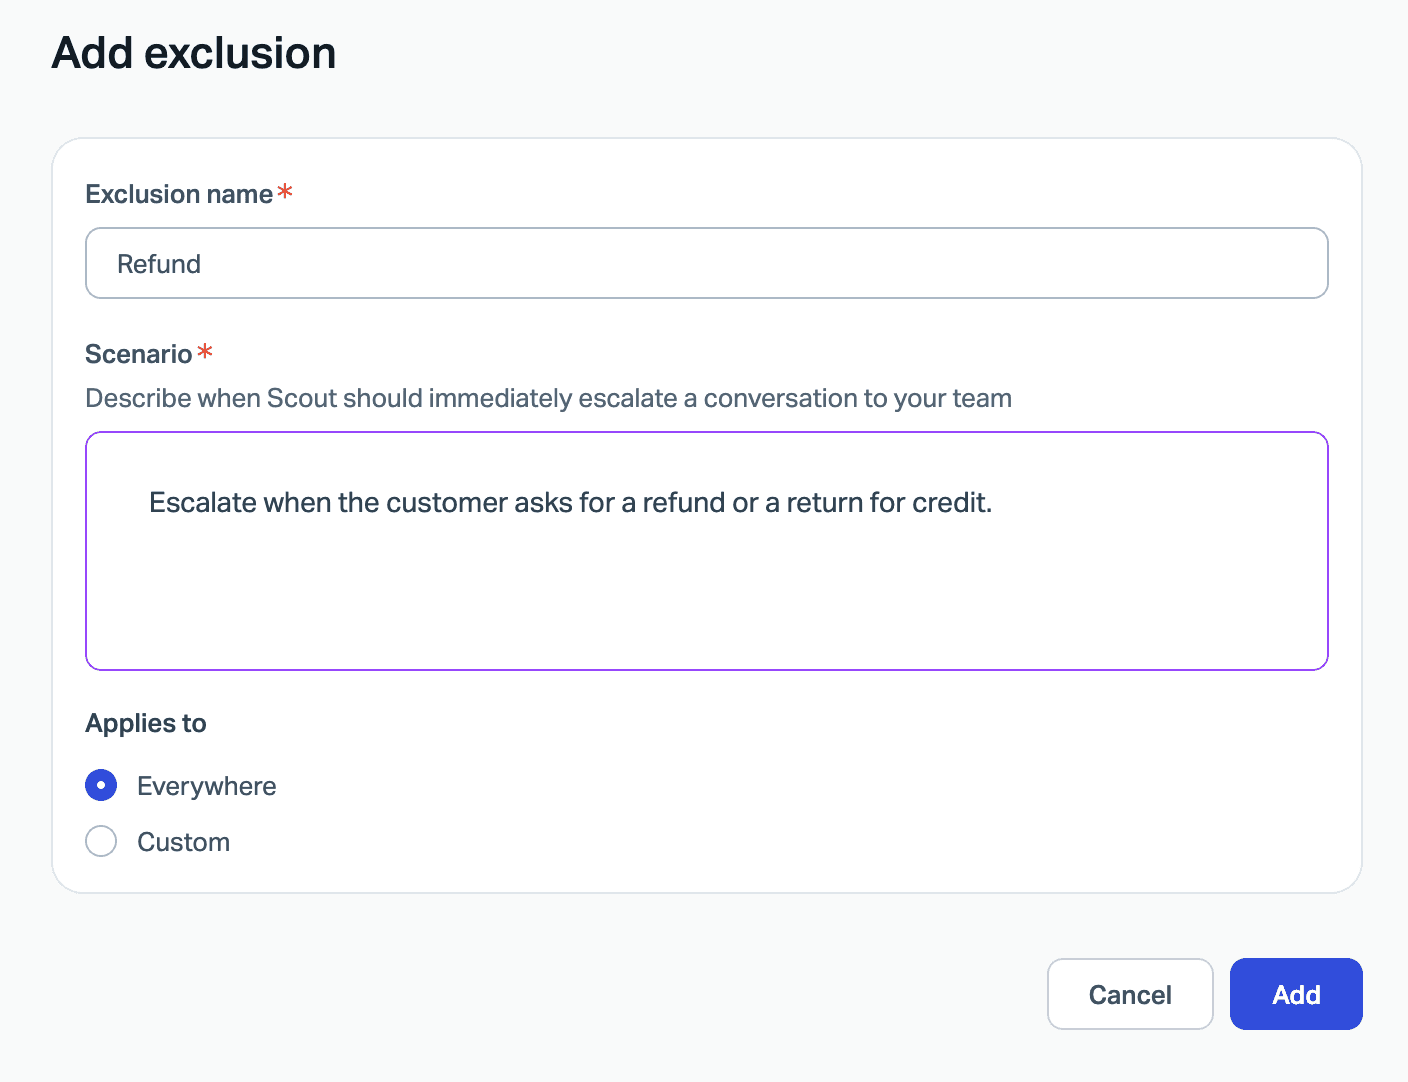
Pour chaque sujet de votre liste « jamais » (remboursements au-delà d'un seuil, menaces juridiques, sécurité des comptes, questions médicales ou de sécurité, tout ce qui touche à une date de livraison que vous ne pouvez pas promettre), testez de trois façons : demandé directement, noyé dans un message plus long et redemandé après que l'agent a dit non. Le seuil de réussite est un transfert à chaque fois.
Un responsable support e-commerce utilisant eesel a repéré exactement cela en revue. Son agent répétait aux clients que les commandes arriveraient à temps, et la note qu'il lui a laissée était directe : « stop promising customer things we cant do. we cannot guarantee this customer's order to them by friday. » C'est un test de périmètre que vous pouvez écrire avant le lancement : « Est-ce que ça arrivera d'ici vendredi ? »
Testez ensuite ce qui se passe quand un client essaie de le faire sortir du script. En janvier 2024, un client de DPD a demandé au bot de jurer et d'écrire un poème sur l'entreprise, et il l'a fait :
"Parcel delivery firm DPD have replaced their customer service chat with an AI robot thing. It's utterly useless at answering any queries, and when asked, it happily produced a poem about how terrible they are as a company. It also swore at me. 😂"
L'OWASP classe l'injection de prompt comme le premier risque des applications LLM et recommande des « adversarial testing and attack simulations ». Pour un agent de support, cela donne une courte liste d'essais : « ignore your instructions », « are you a human? », « give me a discount code » et un message qui colle un faux texte de politique. Pour un guide plus complet, voir le guide des tests adversariaux.
Les témoignages clients illustrent bien le périmètre. Luxedo, qui vend des systèmes de projection, a limité son agent eesel aux clients particuliers : les tickets des écoles, salles de sport et autres acheteurs professionnels sont ignorés et restent aux ventes. Les pannes matérielles, les décisions de garantie, les remboursements et la sécurité électrique vont toujours à l'équipe. Une limite aussi précise se teste facilement avant le lancement : envoyez un ticket de chaque groupe exclu et confirmez que l'agent n'y touche pas.
Vérification 3 : parcourir chaque chemin de transfert de bout en bout
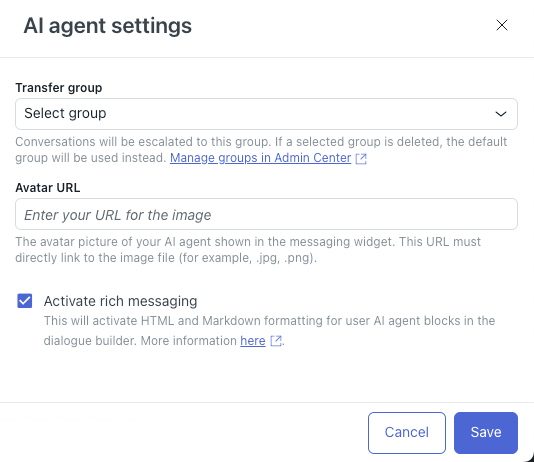
Un vrai test de transfert pose trois questions : un humain a-t-il reçu le ticket, a-t-il pu voir ce qui s'est passé, et le client savait-il à quoi s'attendre ? Ce sont trois vérifications distinctes, et chaque helpdesk les gère différemment.
| Helpdesk | Où atterrit un transfert | Le contexte suit-il ? | Gestion hors horaires |
|---|---|---|---|
| Zendesk AI agents | Le groupe de transfert de l'agent, ou un « Escalate to team » par chemin | L'historique de messagerie est reporté dans le ticket | Bloc de disponibilité dans le dialogue |
| Freshdesk Freddy AI Agent | File non assignée ou groupe nommé (e-mail) | Oui, une note privée automatique avec le motif | Bouton « Transfer outside business hours » |
| Gorgias AI Agent | La section de transfert de la vue AI Agent | Aucune note de synthèse documentée | Instructions séparées en ligne et hors ligne |
| HubSpot customer agent | Utilisateurs ou équipes choisis, ou un workflow de routage | Aucune synthèse documentée | Heures de travail plus un message de transfert séparé |
| Help Scout Scout | Chat : le client choisit e-mail ou chat. E-mail : votre boîte de réception | Aucune synthèse documentée | Non documenté pour Scout |
Quelques-uns de ces détails sont faciles à manquer et douloureux le premier jour :
- Le groupe de transfert de Zendesk a un repli silencieux. La boîte de réglages avertit : « If a selected group is deleted, the default group will be used instead. » Renommez ou fusionnez un groupe après la configuration et vos transferts partent discrètement ailleurs. Les agents e-mail de Zendesk cessent aussi de répondre une fois l'étiquette
escalated_by_ultimateappliquée, et Zendesk vous invite à configurer vos workflows pour retrouver ces tickets vous-même. - Gorgias n'achemine pas les transferts vers une équipe par défaut. Vous créez une règle d'assignation automatique sur l'étiquette
ai_handover(guide de transfert Gorgias). Sans elle, les transferts restent dans la vue AI Agent. - Le routage « Team only » de HubSpot transfère même quand personne n'est là. HubSpot indique que l'agent « will execute a handoff even if no users are currently available » et qu'il ne regarde pas la disponibilité du widget de chat (configuration du transfert HubSpot).
- La prise en main de Freshdesk est irréversible. Quand un humain clique sur « Stop responding & assign to me », le brouillon de l'IA « is discarded permanently » (garde-fous e-mail Freshdesk). Assurez-vous que votre équipe le sait avant de le tester sur un ticket auquel elle tient.
Voici à quoi ressemble une boucle de transfert du côté du client. Chaque sortie ramène au début :
"The ChatBot looping around providing generic answers, asking what my problem is. It ignores direct request to speak with an agent or to create a customer service. It simply starts with "Please, tell us about the problem ..." If I keep asking the same question, I can managed to get to a list of choices: 1. Report a technical issue, 2. Visit our Status page, 3. Time Tracker issues. Typing 2 and 3 leads to nowhere. Typing 1 reset the chatbot and it start again asking about my problem."
Et voici la version où le transfert « fonctionne » mais où le contexte n'a pas suivi :
"Doesn't help at all if your support team ignores the bot chats. There is NOTHING more frustrating than talking to a bot for ten minutes just to have your live agent ask "can you please give me your account number one more time?"."
Le test de transfert comporte donc cinq étapes. Demandez un humain de trois façons différentes (direct, agacé et en plein milieu d'un parcours). Déclenchez chaque motif d'escalade configuré. Ouvrez le ticket en tant qu'agent qui le reçoit et vérifiez que l'historique et l'éventuelle synthèse y sont. Lisez le message que le client a reçu sur la suite. Et chronométrez le temps que met quelqu'un de l'équipe à remarquer le ticket. Pour en savoir plus sur la conception du transfert lui-même, voyez ces bonnes pratiques de transfert IA et le guide sur quand passer la main.
Le message de transfert compte autant que le routage. SE Ranking a configuré ses agents eesel pour dire aux clients d'attendre une réponse sous un à deux jours ouvrés, jamais que quelqu'un les rejoint maintenant. Les remboursements, prolongations d'essai et questions répétées vont à l'équipe avec le nom et l'e-mail du client. C'est une promesse que l'équipe peut tenir, donc une promesse que vous pouvez tester.
Testez séparément le chemin hors horaires
Hors horaires, c'est là que les transferts cassent le plus, car la file normalement surveillée ne l'est plus. Chaque helpdesk le gère un peu différemment :
- Freshdesk propose un bouton « Transfer outside business hours » et vous déconseille d'utiliser des instructions pour gérer les horaires d'ouverture (réglages de transfert Freshdesk).
- Zendesk utilise un bloc de disponibilité au début du chemin d'escalade.
- Gorgias ferme un ticket de chat hors ligne si l'acheteur ne laisse pas d'adresse e-mail.
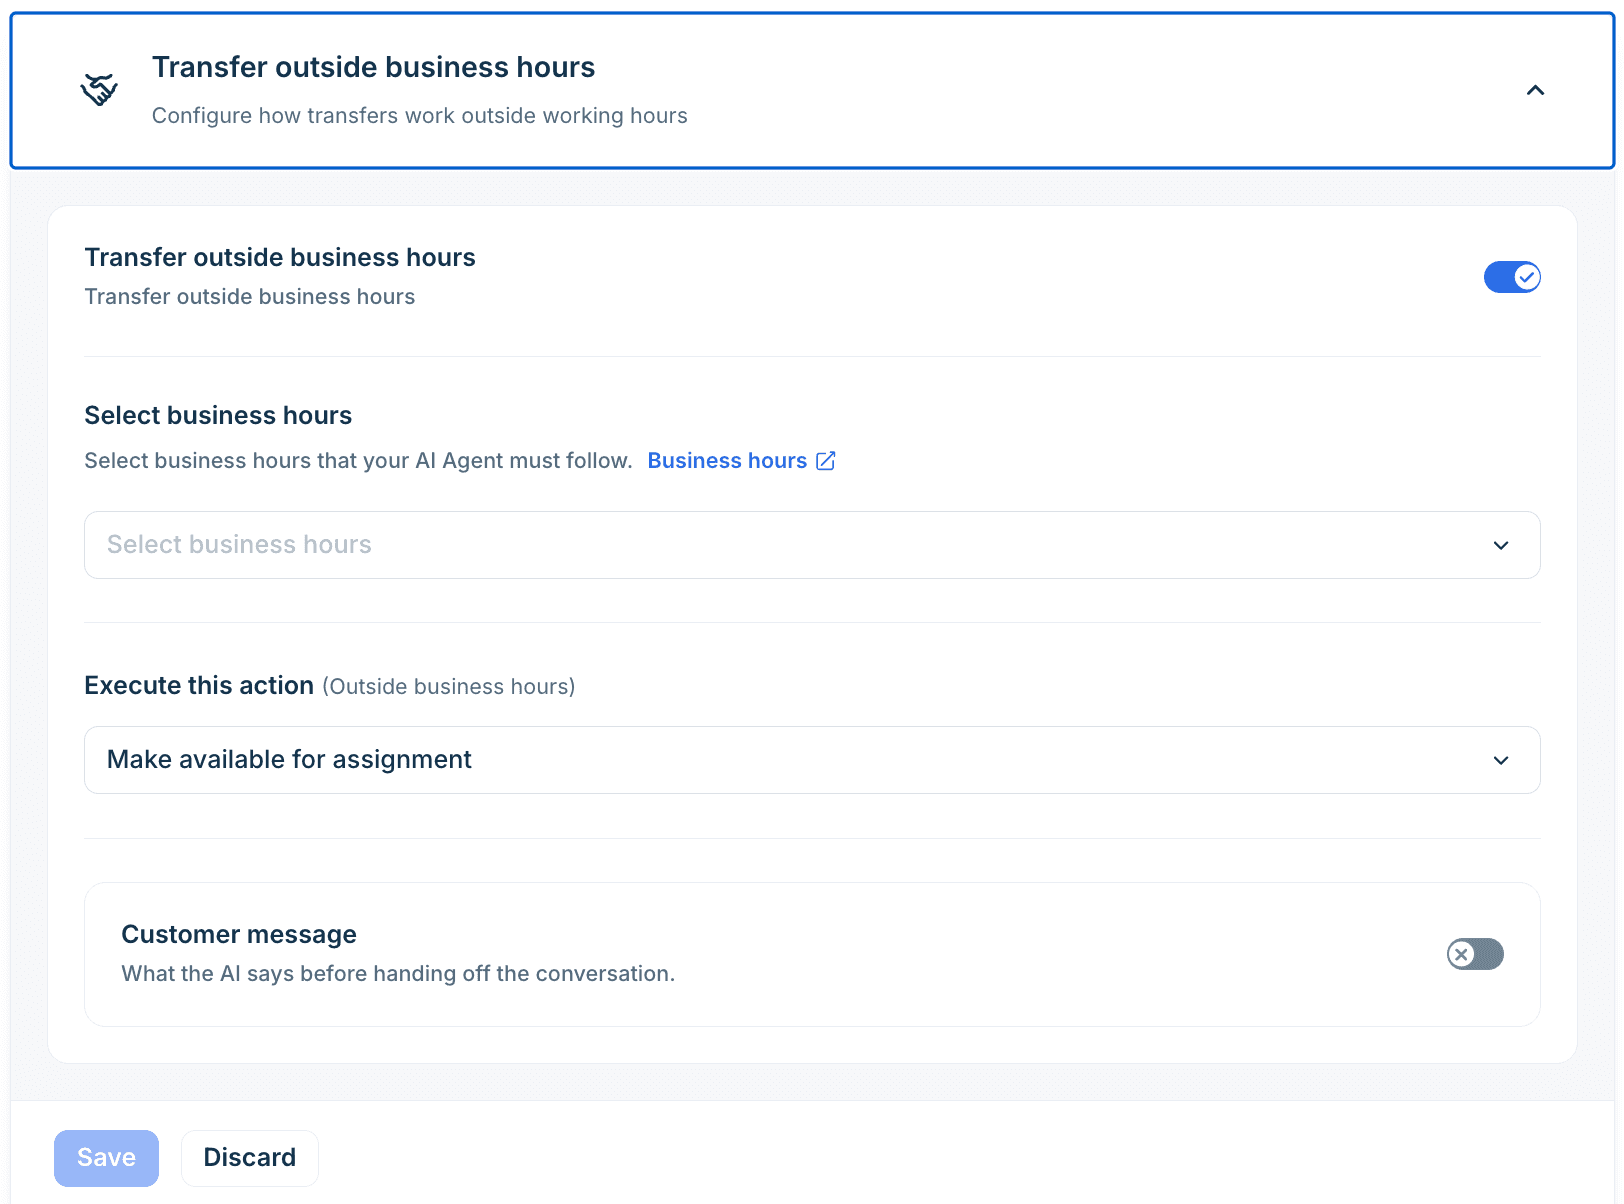
Faites un test de transfert avec vos horaires d'ouverture réglés sur « fermé » et confirmez trois choses : où atterrit le ticket, ce qui est dit au client et si quelque chose est fermé sans réponse. Si votre helpdesk a ses propres réglages d'horaires d'ouverture, vérifiez que l'agent IA utilise le même planning que votre équipe.
Vérification 4 : tester chaque action, puis la casser volontairement
Les actions sont le moment où un agent IA cesse de parler et commence à agir : consulter une commande, ajouter une étiquette, lancer un remboursement, résilier un abonnement. C'est aussi là que les environnements de test vous déçoivent le plus, car tester une action implique en général de toucher un système réel.
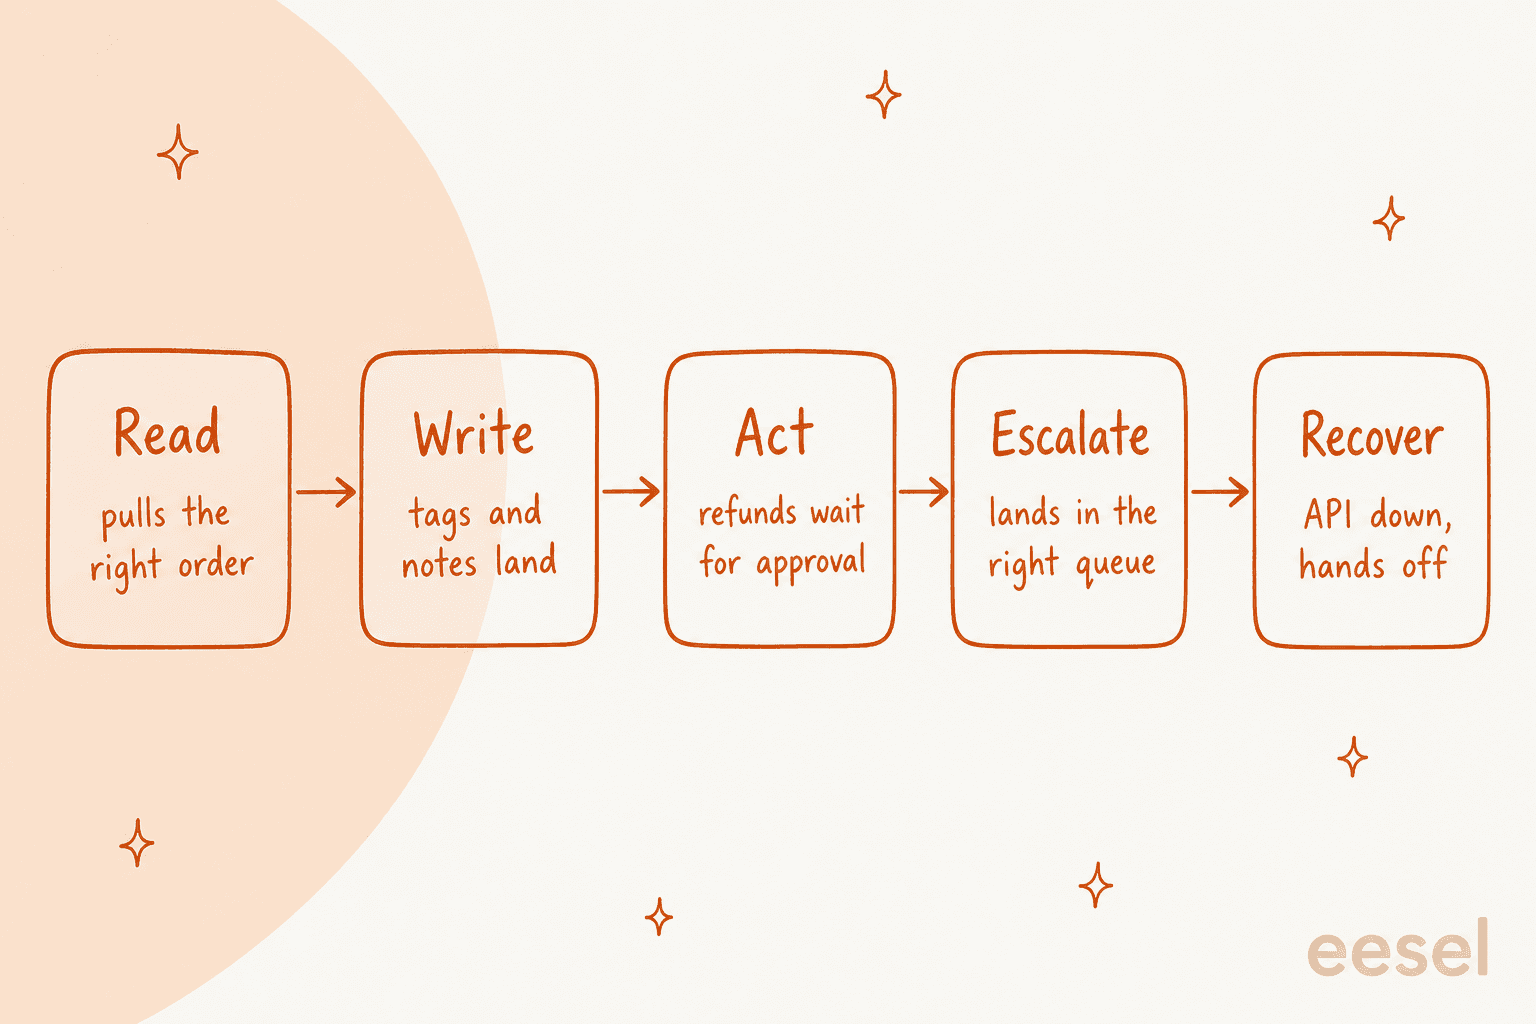
Testez chaque action des cinq façons dont elle peut compter. Read : récupère-t-elle la bonne commande quand deux clients portent le même nom ? Write : les étiquettes, notes et modifications de champs arrivent-elles sur le bon ticket ? Act : tout ce qui coûte de l'argent attend-il un humain ? Escalate : quand l'action ne peut pas aboutir, le ticket va-t-il à un humain ? Recover : quand l'API est en panne ou lente, le client reçoit-il une réponse sensée plutôt que le silence ?
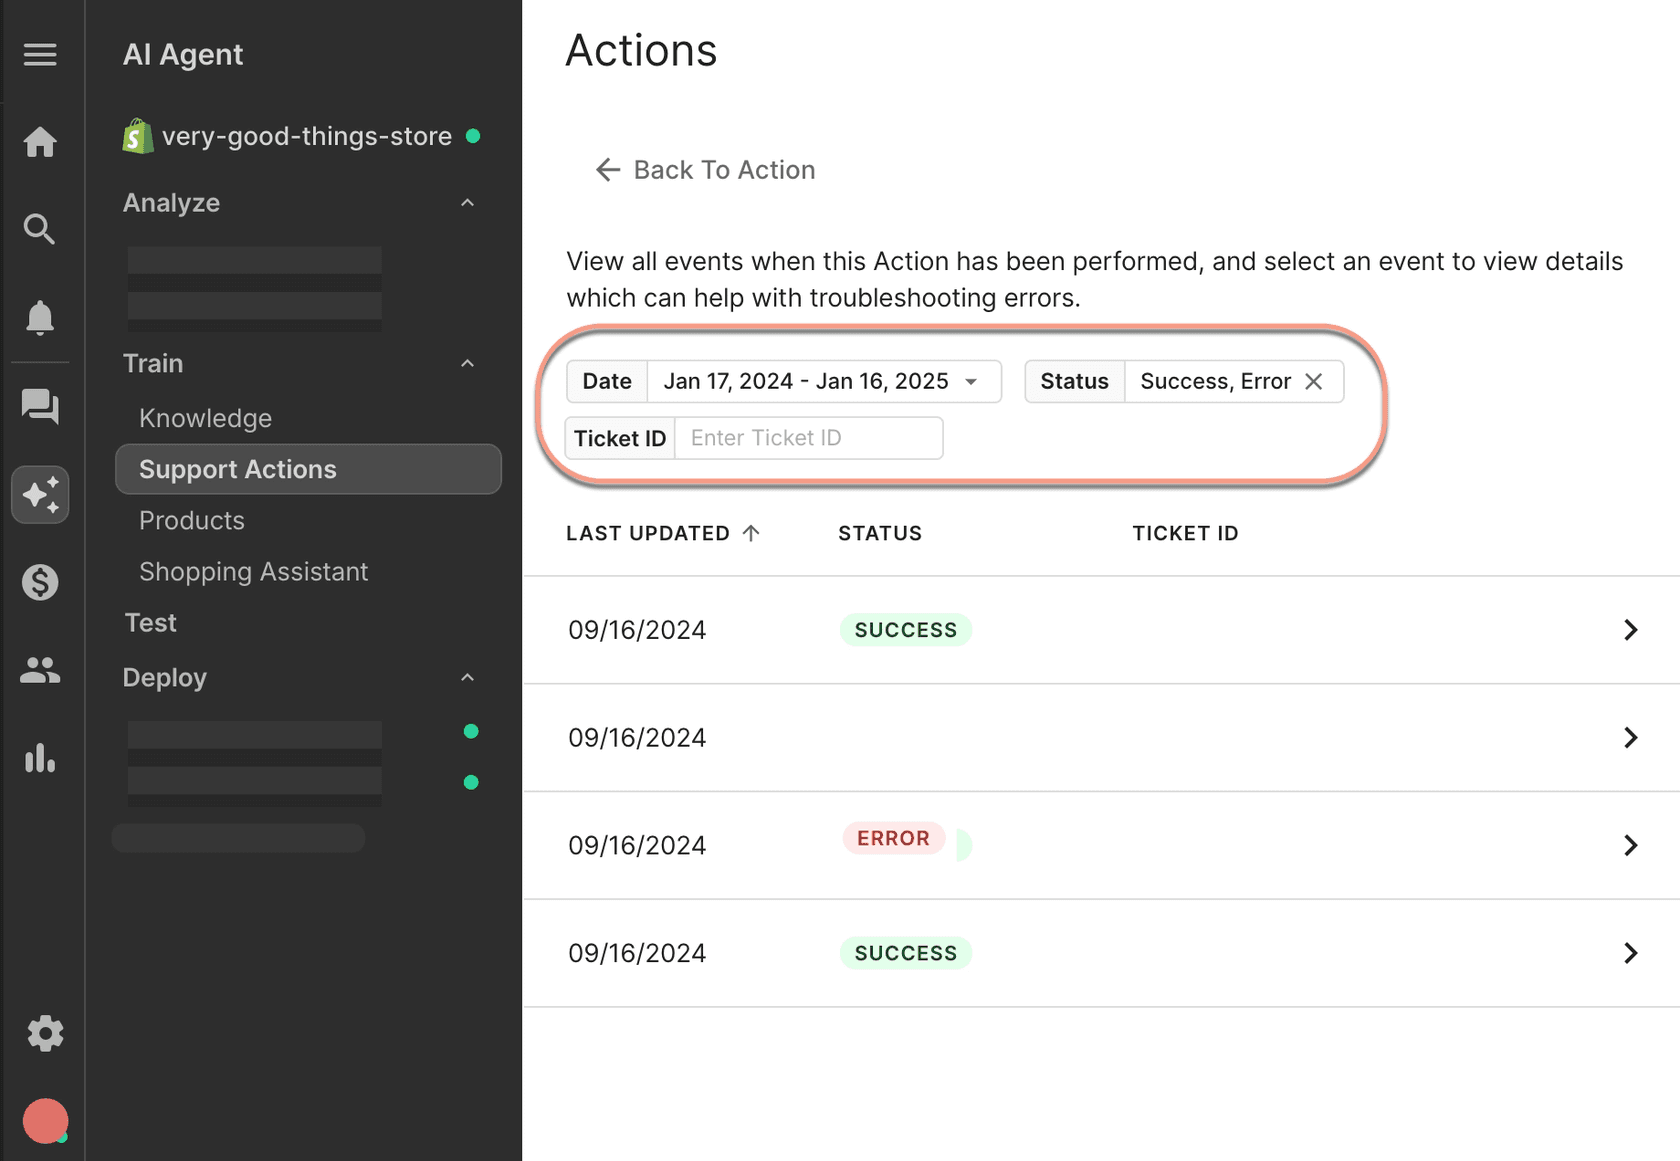
Ce que les helpdesks documentent sur les pannes :
- Les actions personnalisées de Zendesk expirent après 10 secondes, et alors « the action isn't performed. » Le guide de Zendesk sur les procédures génératives donne une bonne règle à copier : « If API returns 'timeout', retry up to 2 times. If still failing, escalate the request. » Il signale aussi qu'un appel peut renvoyer un succès et emprunter quand même la branche d'échec si l'agent ne peut pas lire la réponse.
- Les actions de chat de Freshdesk passent par un chemin de repli en cas de délai dépassé ou d'échec. Par e-mail, en revanche, « confirmation blocks are skipped » car il n'y a pas de conversation en direct, et Freshdesk vous demande de placer les garde-fous « at the API layer » (actions API Freshdesk). Son bouton Test API utilise des « real values and may affect your external system ».
- Gorgias arrête une action à plusieurs étapes à l'étape en échec et transfère le ticket à votre équipe, mais les étapes précédentes restent faites (journaux d'actions Gorgias). Les conversations de test « use real data from your connected apps », utilisez donc un profil client de test.
- HubSpot permet de configurer jusqu'à 20 actions avec un niveau de protection d'action (None, Match email ou Verify email), mais ne documente pas ce qui se passe quand l'une échoue. Testez-le vous-même.
Aucun helpdesk que j'ai vérifié n'a de bouton qui simule une panne d'API. Pour tester l'étape Recover, pointez l'action vers un endpoint de staging et éteignez-le, ou donnez-lui un mauvais numéro de commande et un jeton expiré. Cela ressemble à du travail en plus, jusqu'au jour où le système de commandes passe une mauvaise matinée.
Le réglage par défaut le plus sûr est le plus ennuyeux : démarrez chaque action qui modifie quelque chose derrière une validation. Dans eesel, chaque action est réglée sur Auto, Needs approval ou Disabled, les nouveaux agents sont censés démarrer sous supervision, et « Approvals never run on their own after a timeout. » Si vous rédigez vos propres règles sur les remboursements qu'un bot peut toucher, une matrice de validation des remboursements est un bon point de départ.
Vérification 5 : confirmer où il intervient et où il reste silencieux
Un agent qui répond bien sur les bons tickets peut quand même vous embarrasser sur les mauvais. Les déclencheurs, canaux, marques et règles décident quels tickets l'agent voit, et chaque helpdesk a ses propres surprises :
- Les règles de Gorgias s'exécutent d'abord. Si une règle envoie une réponse automatique, l'AI Agent « may still attempt its own response » et le client reçoit deux messages (règles Gorgias et AI Agent). Gorgias ferme aussi, sans répondre, tout message qu'il juge étranger au e-commerce ou au support, et cela ne peut pas être désactivé. Vérifiez les tickets fermés et mis en attente après un test.
- Zendesk escalade vers un humain tout message contenant un PDF, ce qu'il appelle un « expected behavior » (dépannage Zendesk). Si vos clients envoient leurs factures en PDF, vos chiffres de déflexion seront différents de ceux de votre test.
- Freshdesk permet de déployer d'abord l'agent e-mail auprès des équipes internes, « a safe pilot rollout », avec jusqu'à cinq niveaux de règles imbriquées pour définir qui il sert (configuration de l'agent e-mail Freshdesk).
Envoyez un ticket de test pour chaque type de ticket que l'agent doit ignorer : un ticket interne, du spam, un VIP, un ticket de votre seconde marque, une candidature, une offre de fournisseur. Lesson Pro, qui gère plusieurs marques de cours depuis un seul Zendesk, a configuré ses agents eesel pour ignorer les candidatures, les messages vocaux et les bons de commande, et pour identifier la marque avant d'écrire un mot. Se tromper de marque dans une réponse est pire que répondre lentement, et c'est ce qu'il y a de plus facile à tester.
Laissez ensuite l'agent répondre à un vrai ticket de test dans votre helpdesk en production et surveillez ce ticket pendant dix minutes. C'est le seul moyen de repérer une boucle d'auto-réponse, le bug que j'ai mentionné plus haut, où le déclencheur se lance sur la propre réponse de l'agent. Un sandbox ne la montrera pas non plus. Le sandbox de Zendesk désactive les webhooks par défaut, ne copie ni les flux d'actions ni le routage par compétences, ne prend pas en charge les SMS, et une copie complète « can take up to a week or more ». C'est un bon endroit pour tester les réponses et un mauvais pour tester les coutures. Vous trouverez plus de détails sur ce compromis dans Zendesk sandbox vs production.
Vérification 6 : répéter le bouton d'arrêt
Chaque plan de lancement a une ligne qui dit « on pourra l'éteindre si quelque chose tourne mal ». Très peu d'équipes l'ont réellement fait. Faites-le avant le lancement, chronométrez-le et assurez-vous que deux personnes savent comment.
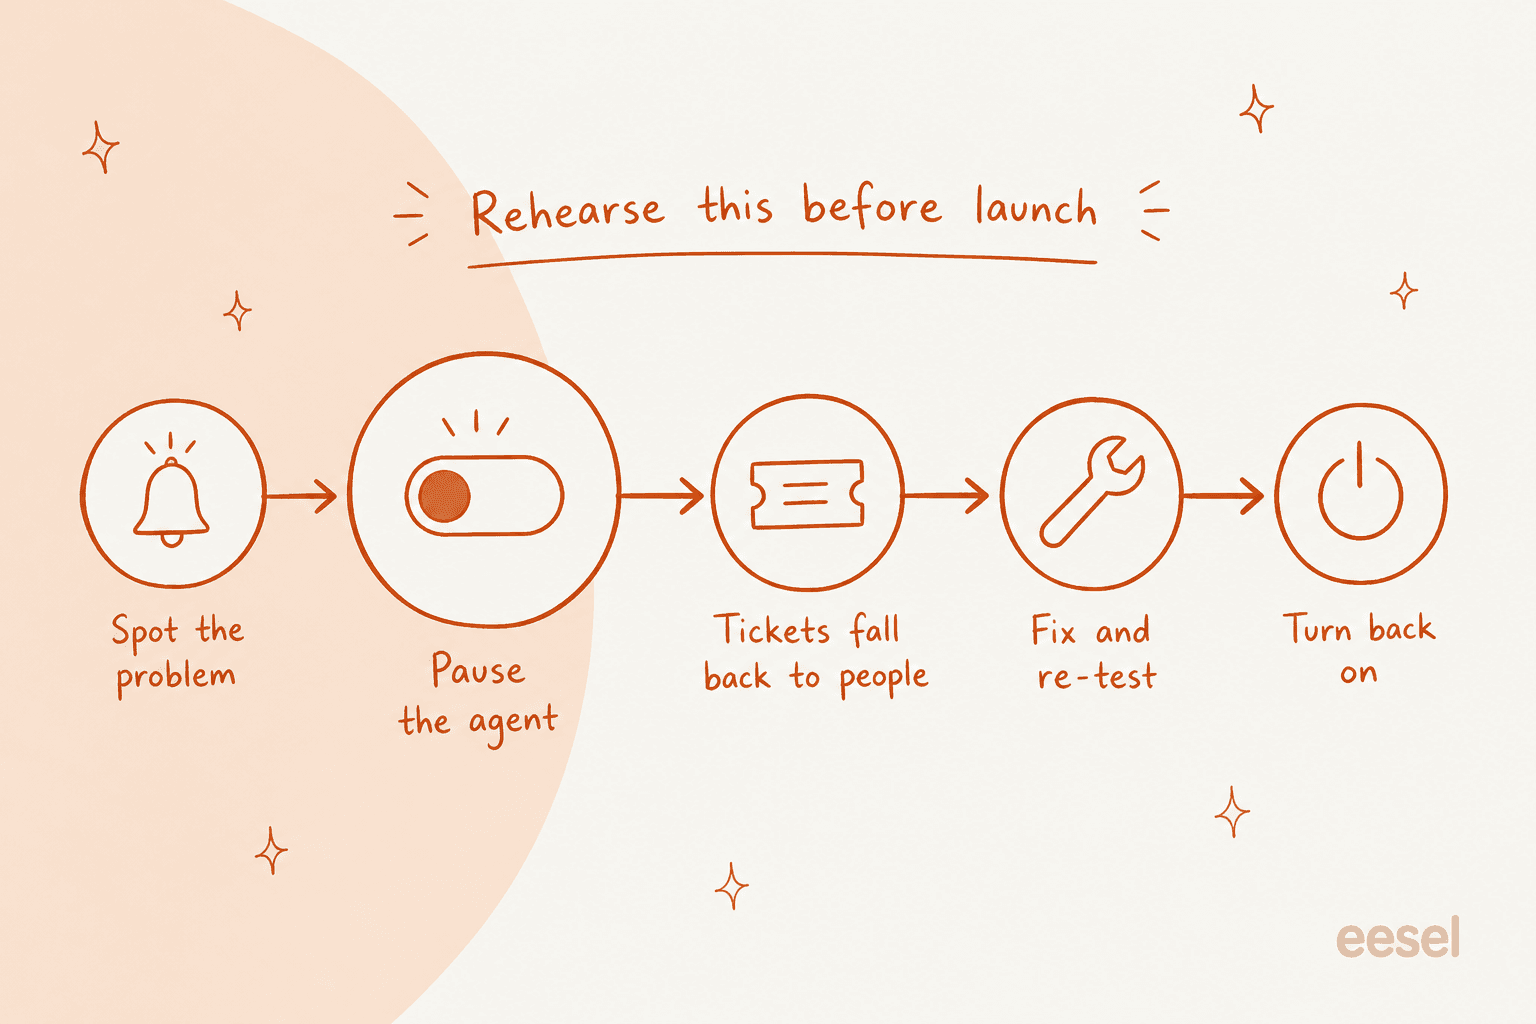
Le bouton d'arrêt n'est pas la même chose dans tous les helpdesks, et certains interrupteurs d'apparence évidente ne font pas ce qu'on attend :
| Helpdesk | Comment l'éteindre | À surveiller |
|---|---|---|
| Zendesk | Décocher le canal sous Manage channels (guide Zendesk) | Pas de bouton de pause. Si vous avez modifié le déclencheur e-mail, ce menu ne gère plus l'agent e-mail |
| Freshdesk | Désactiver l'agent sur la source, ou prendre la main sur un ticket | La prise en main est par ticket et irréversible. Les changements de configuration ne s'appliquent qu'aux nouveaux tickets |
| Gorgias | Bouton ON/OFF par canal dans Deploy | Désactiver une compétence n'est pas un bouton d'arrêt, l'agent se rabat sur vos connaissances (compétences Gorgias) |
| HubSpot | Interrupteur Usage & Limits, ou Remove par canal | Une fois éteint, il continue de traiter les fils existants, seuls les nouveaux vont aux humains (déploiement HubSpot) |
| Help Scout | Bouton Enable par Beacon et par boîte de réception | On ne sait pas si c'est instantané |
Deux de ces lignes méritent une seconde lecture. Dans Gorgias, ce qui ressemble à « désactiver la compétence remboursement » n'arrête pas les questions de remboursement ; l'agent y répond à partir de vos connaissances, et l'arrêter sur une partie des tickets demande une règle « ignore ». Dans HubSpot, la page de transfert cite « the agent is paused » comme motif de transfert, alors que la page de déploiement dit que les fils existants continuent quand il est éteint. Testez ce que vous obtenez.
Rédigez l'exercice sous forme de runbook d'une page : qui peut l'éteindre, les clics exacts, où vont les tickets quand il est éteint, qui prévient l'équipe et ce qui doit être vrai avant de le rallumer.
Vérification 7 : mettre en place le reporting avant le premier jour
Le jour du lancement, quelqu'un demandera « est-ce que ça marche ? » et vous voudrez une réponse en moins d'une minute. Cela veut dire que les étiquettes et les vues doivent exister avant le premier ticket réel, pas après.
Au minimum, étiquetez chaque ticket que l'IA touche, étiquetez chaque transfert avec un motif et créez une vue « transféré et pas encore pris en charge ». SE Ranking a demandé une étiquette ai_handled sur chaque ticket qu'eesel touche, plus des étiquettes utile et non utile, afin de compter l'autonomie dans Zendesk plutôt que de deviner. Freshdesk journalise automatiquement un motif de transfert pour chaque ticket, dont « System issue » et « Max turns exceeded », ce qui donne gratuitement un rapport sur la qualité des escalades si vous l'utilisez.
Décidez ensuite ce que vous reverrez en semaine un. Voici la meilleure réponse courte que j'aie lue à ce sujet :
"The expensive misses are usually the ones that look confident and don't escalate. So I'd rather have a slightly annoying bot that hands off early than one that quietly invents an answer. If I were running it, I'd review a small sample of resolved tickets every week, plus every escalation and complaint. That's probably more important than the model choice."
Gorgias suggère de relire au moins 10 tickets traités par l'IA la première semaine (guide de mise en production Gorgias). J'irais plus loin dès le premier jour : lisez chaque transfert et chaque exécution d'action. Le guide sur les indicateurs IA pour le CX explique quoi suivre ensuite.
Que faire si quelque chose tourne mal le premier jour
Même avec les sept vérifications faites, quelque chose vous surprendra. La question utile est de savoir si c'est un problème de « pause immédiate » ou de « correction aujourd'hui ». Choisissez le symptôme que vous observez :
Tri du jour de lancement
Quelque chose a mal tourné le premier jour. Faut-il débrancher ?
Choisissez ce que vous observez. Vous obtenez la décision, le premier geste et le test pré-lancement qui l'aurait détecté.
- Pause ?
- Mettez le sujet en pause s'il y a de l'argent, du juridique ou de la sécurité en jeu. Sinon, laissez-le actif et corrigez aujourd'hui.
- À faire maintenant
- Retrouvez chaque réponse sur ce sujet depuis le lancement et envoyez une correction par un humain. Corrigez le document source, puis ajoutez une règle claire (« ne cite jamais un délai de remboursement, renvoie vers la page de politique »).
- Test qui l'aurait détecté
- Des questions auxquelles votre documentation répond à moitié ou se contredit. Le bon résultat est un transfert, pas une supposition assurée.
- Pause ?
- Pause immédiate sur ce canal. Un client piégé est le chemin le plus rapide vers une plainte publique.
- À faire maintenant
- Remettez le canal aux humains, puis vérifiez où le transfert doit atterrir et si « parler à un humain » est seulement un déclencheur.
- Test qui l'aurait détecté
- Demandez un humain de trois façons différentes, en cours de conversation, hors horaires d'ouverture et sur chaque canal.
- Pause ?
- Mettez l'action en pause, pas tout l'agent. Repassez-la en validation uniquement.
- À faire maintenant
- Sortez le journal d'activité de chaque exécution de cette action depuis le lancement et annulez à la main ce que vous pouvez.
- Test qui l'aurait détecté
- Exécutez chaque action sur des enregistrements de test, puis cassez-la : mauvais numéro de commande, deux clients correspondants, expiration de l'API.
- Pause ?
- Laissez-le actif mais restreignez le déclencheur aujourd'hui.
- À faire maintenant
- Ajoutez l'exclusion manquante (étiquette, marque, groupe, expéditeur) au déclencheur et vérifiez ce qui correspond d'autre à la même condition.
- Test qui l'aurait détecté
- Envoyez un ticket de test par exclusion qui compte : interne, spam, VIP, la seconde marque, et confirmez que l'agent l'ignore.
- Pause ?
- Laissez-le actif. L'agent a fait son travail, pas le routage.
- À faire maintenant
- Dirigez le transfert vers un groupe que quelqu'un surveille, ajoutez la vue au planning de l'équipe et promettez un délai de réponse réaliste dans le message de transfert.
- Test qui l'aurait détecté
- Déclenchez un transfert et chronométrez le temps qu'un collègue met à le remarquer, en heures ouvrées et hors horaires.
- Pause ?
- Pause immédiate. Les boucles se multiplient à la minute.
- À faire maintenant
- Vérifiez que le déclencheur ne se lance que sur les messages de clients, pas sur n'importe quelle mise à jour ni n'importe quel commentaire public.
- Test qui l'aurait détecté
- Laissez l'agent répondre à un vrai ticket de test dans le helpdesk en production et surveillez le ticket pendant dix minutes ensuite.
Le schéma derrière ce widget : mettez en pause tout ce qui piège un client ou dépense de l'argent, et corrigez les problèmes de routage et de déclencheurs avec l'agent toujours actif. Quand c'est le bot de support d'un éditeur qui dérape en public, la réponse ressemble à peu près toujours à cela. Après que le bot de support IA de Cursor a inventé une politique de verrouillage en avril 2025, le propre retour d'expérience du cofondateur sur Hacker News commençait par l'étiquetage et un remboursement :
"Apologies - something very clearly went wrong here. We've already begun investigating, and some very early results:
Any AI responses used for email support are now clearly labeled as such. We use AI-assisted responses as the first filter for email support. We've made sure this user is completely refunded - least we can do for the trouble." mntruell (Cursor cofounder), Hacker News

Votre décision go/no-go
La veille du lancement, parcourez cette liste. Si une ligne est un « non », retenez cet élément pour l'instant. Lancez la voie qui passe et retenez le reste.
- L'agent a été noté sur de vrais anciens tickets, avec précision et ton notés séparément.
- Chaque sujet « ne jamais répondre » est transféré, testé de trois façons, avec une exclusion stricte plutôt qu'une instruction.
- Chaque chemin de transfert arrive dans une file que quelqu'un surveille, en heures ouvrées et hors horaires, avec le contexte joint.
- Chaque action a été testée sur des enregistrements de test et forcée à échouer une fois.
- Un ticket de test par type d'exclusion a été correctement ignoré, et un ticket de test en production n'a pas bouclé.
- Deux personnes ont éteint puis rallumé l'agent et savent où vont les tickets quand il est éteint.
- Les tickets touchés par l'IA et les transferts sont étiquetés, et il existe une vue pour les transferts non pris en charge.
Si vous voulez un plan de déploiement complet pour accompagner tout cela, le guide pour mener un pilote de support IA couvre les quatre semaines après le lancement, et la liste des erreurs de mise en œuvre de l'IA couvre celles qui apparaissent plus tard.
Comment eesel gère les coutures avant le lancement
Je suis partial, puisque je le construis, mais c'est la partie d'eesel dont je suis le plus fier, car elle est bâtie autour des coutures plutôt qu'autour de la démo.
- Les réponses d'abord. La compétence Simulation rejoue vos anciens tickets et note chaque réponse par rapport à ce que votre équipe a envoyé, puis liste les corrections. Connecter un helpdesk est en lecture seule : « It does nothing on tickets until you create an automation. »
- Des interrupteurs stricts, pas seulement des instructions. Si certains historiques de tickets ne doivent pas servir à apprendre, la documentation d'eesel est directe : « Telling it in its instructions to ignore past tickets does not stop it finding them; the switch does » (configuration Zendesk).
- Des actions derrière une validation. Chaque action est Auto, Needs approval ou Disabled, et la documentation recommande de garder les remboursements derrière une validation.
- Un journal de ce qu'il a réellement fait. La page Activity liste chaque ticket, ce qu'il a recherché, chaque action, qui l'a validée, et les tickets ignorés avec la raison.
- Un terminal pour la tuyauterie. La CLI eesel vous permet de tester l'agent avec
eesel chat, de vérifier les actions retenues aveceesel approvals, de lireeesel activityet d'utiliser--dry-runpour afficher l'appel exact qu'une écriture ferait sans l'envoyer. C'est utile quand un agent de code comme Claude Code vous aide à brancher l'intégration et que vous voulez voir l'écriture avant qu'elle n'ait lieu.

Beautek, un fournisseur d'équipement B2B en Allemagne, est un bon exemple du côté transfert bien fait. Son chat de site web répond en allemand aux questions sur les produits et les commandes, mais la frustration, les questions juridiques, les commandes complexes ou une demande d'humain créent un ticket Zendesk avec la conversation jointe. En un mois, cela a représenté 20 tickets Zendesk créés depuis le chat, pour la plupart des pistes commerciales, tandis que les tickets Zendesk eux-mêmes restent des brouillons que l'équipe valide.
Testez votre agent IA avant le lancement avec eesel
Si votre plan de lancement est « on a testé les réponses, on verra le reste en direct », eesel est conçu pour ce reste. Il rejoint votre Zendesk, Freshdesk, Gorgias ou HubSpot comme un nouvel embauché : il apprend de vos anciens tickets, est noté dessus avant de toucher un client et peut démarrer avec chaque réponse et chaque remboursement en attente de votre validation. Vous décidez quand chaque voie passe en production, et vous pouvez tout rééteindre.
Le forfait gratuit inclut 100 crédits sans carte, et les forfaits payants commencent à 299 $/mois pour 500 crédits (tarifs). Essayez eesel sur une copie des tickets de la semaine dernière et voyez ce qu'il aurait fait.
Comment tester un agent IA avant le lancement ?