

Pourquoi les déploiements d'IA tournent mal
Je travaille chaque jour dans la file de support d'eesel, donc je vois ce qui se passe après qu'une équipe active un agent IA. Le schéma qui m'inquiète le plus n'est pas un modèle cassé. C'est un modèle sûr de lui face à une lacune.
En voici un cas réel. Une équipe de support technique B2B sur Zendesk a demandé à son bot s'ils prenaient en charge le modèle de voiture d'un client. Le bot a répondu oui, pour des marques qui ne figuraient pas dans leur base, parce qu'un article d'aide disait "nous prenons en charge tous les modèles". Rien n'était cassé dans le modèle. C'est l'article qui l'était. D'autres clients payants ont vu leur bot répondre à partir de données d'entraînement générales quand la base de connaissances ne renvoyait rien, et dans un cas il a répondu à un client "Oxygen", tiré du tableau périodique.
Ce sont les raisons pour lesquelles eesel simule désormais chaque déploiement sur des tickets historiques avant qu'une IA n'envoie la moindre réponse. Un rejeu de vos propres anciens tickets repère la lacune dans la base de connaissances avant qu'un client ne le fasse.
Les erreurs ci-dessous viennent de cette file, des appels commerciaux où les responsables du support nous racontent ce qui a mal tourné avec leur outil précédent et de la documentation des éditeurs. Si vous voulez les étapes de configuration depuis zéro, le guide de mise en place de l'IA les couvre. Cet article est la liste de ce qu'il faut régler avant le jour du lancement.
Erreur 1 : compter la déflexion comme une résolution
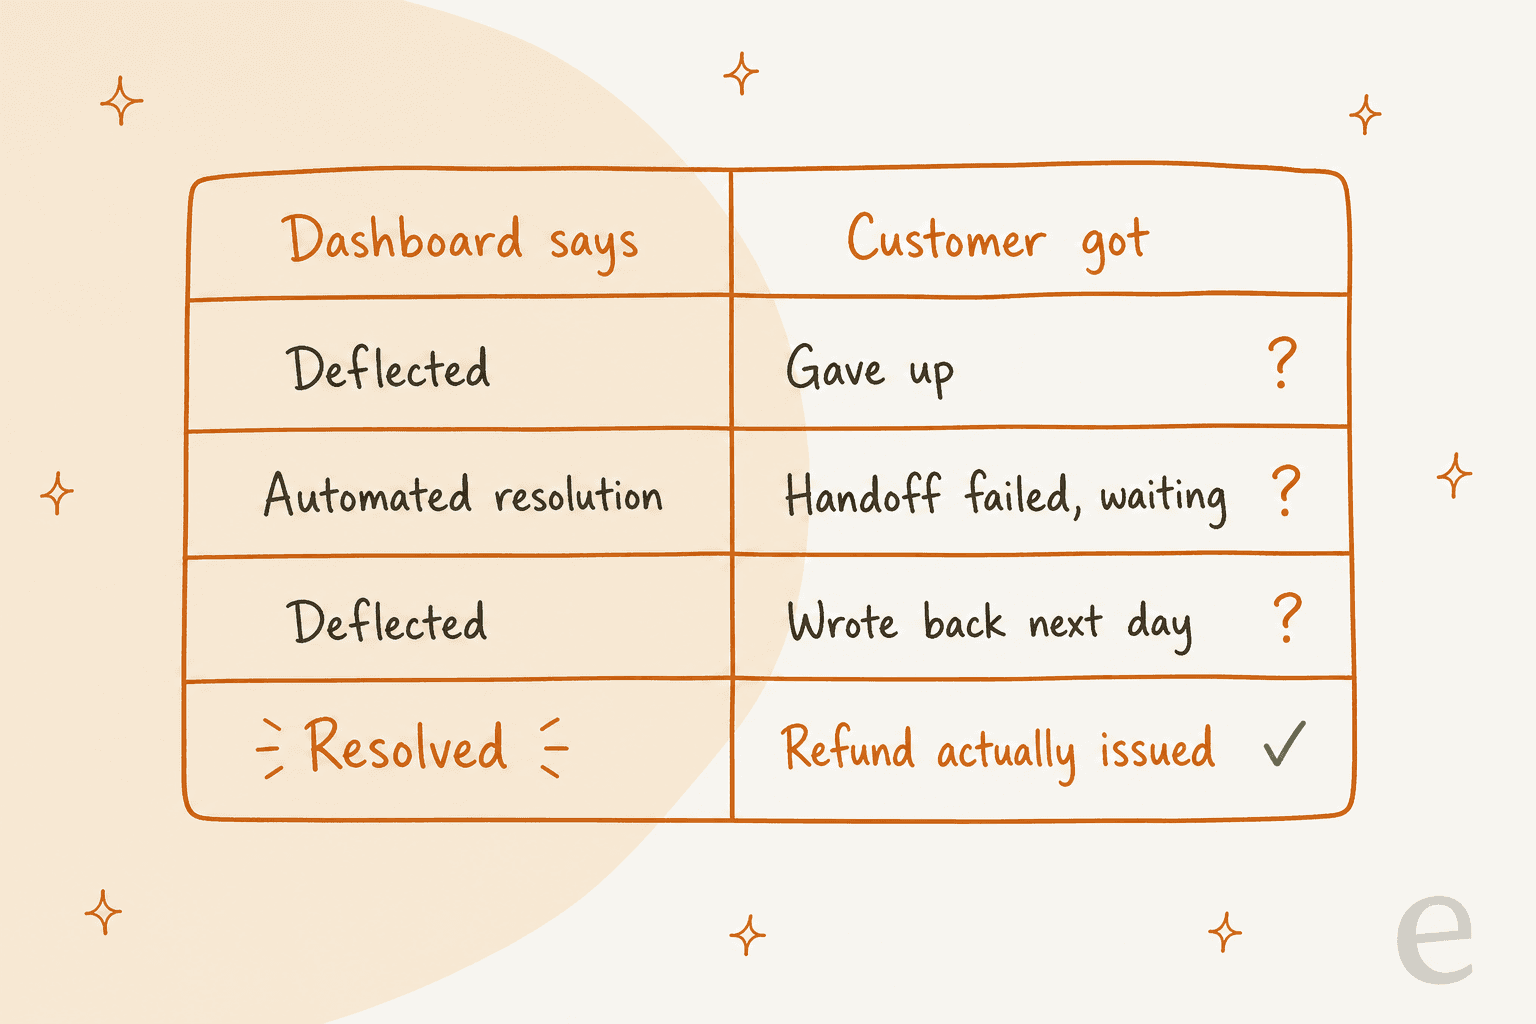
La déflexion signifie que le client n'a pas joint de personne dans cette conversation. Elle ne dit rien sur la résolution de son problème. Un client qui abandonne, un client qui réécrit le lendemain et un client qui a reçu un vrai remboursement se ressemblent tous dans un graphique de déflexion.
Le reporting des éditeurs peut aussi brouiller cela, et il vaut mieux savoir comment avant de bâtir un tableau de bord dessus. Zendesk documente un cas où un agent IA de messagerie a tenté d'escalader, n'a trouvé aucun agent disponible, a créé un ticket de suivi et a terminé la conversation lui-même. Le statut de la conversation indique alors Automated resolution tandis que le champ personnalisé indique Escalated to agent, selon l'explication de Zendesk elle-même. Le client attend toujours, et l'une des étiquettes dit que c'est résolu.
La facturation de Zendesk trace pourtant cette ligne avec soin. Dans les niveaux de résolution introduits le 18 mai 2026, une "assisted escalation" et une "contained resolution" ne comptent pas dans votre quota. Seule une "verified resolution", où un LLM vérifie la transcription et confirme que la demande a été résolue, compte. C'est un modèle de facturation équitable. Le point est que votre propre indicateur de succès demande la même rigueur.
Un praticien sur r/customerexperience a formulé la distinction clairement :
"Silence alone is a dangerous proxy for resolution. It's useful operationally, but it's not an experience signal. A bot answer + 72 hours of no follow-up mostly tells you the customer gave up or moved on, not that the problem was fixed."

Le correctif : décidez avant le lancement de ce que "résolu" signifie. Ma définition de travail est un résultat que l'on peut montrer (remboursement émis, adresse modifiée, réponse confirmée) ou aucun contact répété sur le même problème dans les 30 jours. Mes collègues approfondissent le taux de résolution de l'IA et le taux de déflexion si vous avez besoin des formules.
Erreur 2 : laisser l'IA combler les lacunes par des suppositions
Quand un agent IA ne trouve pas de réponse, il a deux options : le dire et transférer, ou produire quelque chose qui sonne juste. Si vous ne lui avez pas dit laquelle, supposez la seconde.
Les exemples publics sont bien connus. Sur Hacker News, la réponse d'un développeur de Cursor a été citée après que le bot de support de l'entreprise a parlé aux utilisateurs d'une politique de connexion qui n'existait pas :
"Hey! We have no such policy. You're of course free to use Cursor on multiple machines. Unfortunately, this is an incorrect response from a front-line AI support bot."

Et quand un tribunal canadien a obligé Air Canada à honorer une politique de remboursement inventée par son chatbot, un commentateur a formulé le coût comme devrait le faire un responsable du support :
"In this case this could have just been a $650 'bug bounty' had Air Canada issued a quick refund. A reasonable QA expense to find out that your AI agent is misleading your customers."
Les configurations auxquelles je fais confiance écrivent la règle noir sur blanc. Swiftreg, un vendeur britannique de plaques d'immatriculation, utilise eesel sur Zendesk avec des règles rédigées par l'équipe elle-même. Une consultation en direct prime sur la base de connaissances, les anciens tickets et tout ce que dit le client. eesel ne signale jamais un remboursement, une expédition ou un dépôt auprès du DVLA qu'une consultation n'a pas confirmé, un validateur vérifie chaque réponse par rapport aux résultats de la consultation avant l'envoi, et chaque réponse publique se termine par un pied de message indiquant que l'IA l'a rédigée et qu'elle peut contenir des erreurs.
Le correctif : donnez à l'agent une solution de repli explicite pour "aucune réponse trouvée" (transférer, ou dire qu'une personne confirmera), une règle selon laquelle les données en direct priment sur les documents et une courte liste de choses qu'il ne peut jamais promettre. Le guide de prévention des hallucinations liste les réglages, et cette explication détaille pourquoi les lacunes en causent la plupart.
Erreur 3 : rendre l'humain difficile à joindre
Certaines équipes cachent l'option "parler à une personne" pour protéger une file tendue. Je comprends la pression. Cela se retourne quand même contre elles, car le client qui ne peut pas sortir de la boucle du bot ne disparaît pas. Il revient plus en colère, sur un autre canal.
Les réglages existent sur tous les grands helpdesks, c'est pourquoi c'est un choix et non un accident. Dans les agents IA de Zendesk, l'onglet de comportement de la messagerie a une case "Add option to talk to a human" au début de la conversation, après des réponses utiles et inutiles, et quand l'IA ne peut pas répondre, selon l'article de Zendesk sur les réglages de transfert. Gorgias décrit son AI Agent qui transfère quand il ne peut pas répondre avec confiance, rencontre un sujet sensible ou détecte de la frustration, avec des règles de transfert que vous pouvez ajouter vous-même dans les réglages d'AI Agent.
Un fil sur r/CustomerSuccess demandait si un bot devait transférer quand quelqu'un tape "talk to a human". La réponse la mieux notée traçait la ligne que je tracerais :
"Deflection is the bot solving the issue so well the person never needs a human. Obstruction is hiding the exit to protect the queue. The first reduces volume sustainably, the second just moves the pain (and usually amplifies it, like you described)."
Le correctif : transférez à toute demande explicite, consignez chaque demande comme signal et surveillez le délai entre "je veux une personne" et la réponse effective d'une personne. Comme le note ce même commentateur, si 40 % des chats se terminent par une demande d'humain, le problème n'est pas le bot ; c'est le contenu ou la friction du produit derrière. Le pas à pas sur le transfert vers un humain montre le côté Zendesk, et l'escalade de chatbot couvre les schémas généraux.
Erreur 4 : l'alimenter avec une base de connaissances désordonnée ou périmée
Un agent IA n'est à jour que dans la mesure où quelqu'un a corrigé le centre d'aide. Le bot des modèles de voiture du début était un problème de base de connaissances : une phrase trop générale écrite pour le marketing, lue littéralement par une machine.
Les suspects habituels sont des articles en double qui se contredisent, des politiques qui ont changé sur Slack mais pas dans le centre d'aide et des articles écrits pour les agents ("vérifiez le panneau d'administration") qui sont cités aux clients. Le guide de mise en service de Gorgias lui-même dit qu'AI Agent a besoin d'au moins une source de connaissances avant de pouvoir être activé et suggère de commencer par des consignes écrites si vous partez de zéro, ce qui montre le poids du contenu.
Les anciens tickets aident beaucoup ici, car ils montrent comment votre équipe répond réellement, pas comment le centre d'aide dit qu'elle devrait le faire. Quand eesel se connecte à un helpdesk, il lit les tickets historiques en plus des articles ; chez Original Bootcamp, une entreprise allemande de fitness en plein air sur Freshdesk, eesel répond à partir d'environ 1 700 pages de site web et 1 100 tickets et articles Freshdesk.
Le correctif : avant le lancement, faites un court audit de la base de connaissances sur vos 20 sujets de ticket principaux, supprimez ou fusionnez les doublons et décidez qui met à jour les sources de l'IA quand une politique change. Le guide de gestion des changements de politique couvre ce dernier point, et de quelles données vous avez besoin couvre les sources.
Erreur 5 : une IA qui sait parler mais ne peut rien faire
Beaucoup de tickets de support ne sont pas des questions. Ce sont des demandes : annuler cette commande, changer cette adresse, renvoyer cette facture. Une IA qui ne peut que citer le centre d'aide répondra "voici comment demander un remboursement" à quelqu'un qui voulait le remboursement.
C'est la lacune qu'un test de rejeu expose le plus vite. Voici une exécution d'eesel Simulation sur 20 tickets Zendesk résolus : 17 sur 20 égalaient la qualité de réponse de l'équipe, et la principale conclusion ne portait pas du tout sur la formulation.
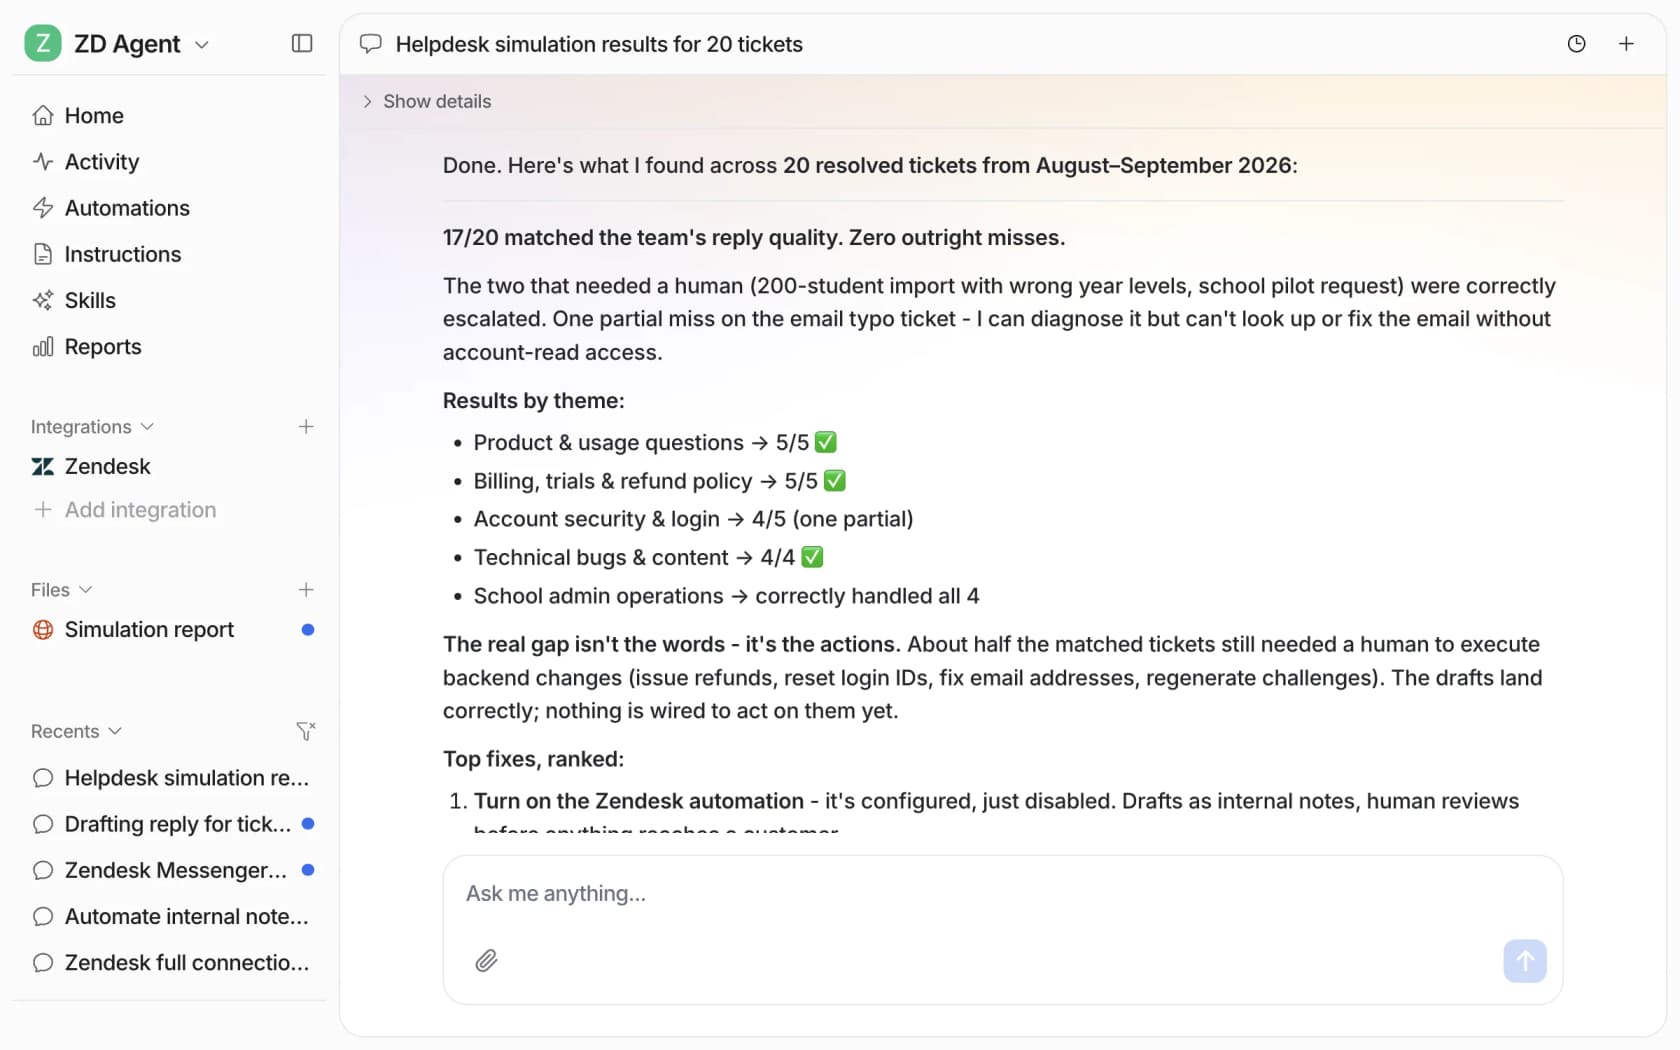
"La vraie lacune, ce ne sont pas les mots, ce sont les actions." Environ la moitié des tickets concordants nécessitaient encore une personne pour émettre un remboursement, réinitialiser une connexion ou corriger une adresse e-mail. C'est utile à apprendre en semaine un, pas au mois trois.
L'erreur inverse est tout aussi réelle : donner à l'IA un accès en écriture à l'argent et aux comptes avant de lui faire confiance. Un fondateur de SaaS en solo sur Reddit a laissé un agent répondre automatiquement aux tickets de support, a vu partir deux remboursements le premier jour qu'il n'avait jamais approuvés, a retiré la permission le soir même et a abouti à une règle simple : "If money moves, a human clicks the button" (r/SaaS). Gorgias prévient aussi dans sa documentation sur les conversations de test que lorsque AI Agent utilise une action dans un test, cela peut affecter de vraies données de clients et de commandes, donc dirigez les tests vers un faux profil client.
Original Bootcamp montre la voie du milieu. Tout ce qui touche une réservation, un paiement ou le compte du membre va aujourd'hui à une personne, parce qu'eesel ne peut pas encore voir ce système, et le filtre s'ouvrira une fois la nouvelle API de l'entreprise connectée.
Le correctif : listez les cinq demandes les plus courantes de votre file, et décidez lesquelles l'IA peut lire, lesquelles elle peut modifier et lesquelles vont toujours à une personne. Commencez par des consultations en lecture seule. Les articles sur les actions de Gorgias AI Agent et l'intégration d'API d'agents IA expliquent comment les actions sont branchées.
Erreur 6 : tester sur des questions inventées plutôt que sur vos vrais tickets
La plupart des équipes testent un agent IA en tapant dix questions dont elles connaissent déjà la réponse. L'IA réussit, parce que ce sont les questions pour lesquelles le centre d'aide a été écrit. Les vrais clients écrivent "hi my thing broke again??" avec une capture d'écran et sans numéro de commande.
Les éditeurs fournissent des outils de test utiles, et chacun teste quelque chose de différent :
| Outil | Ce contre quoi il teste | À savoir |
|---|---|---|
| Zendesk simulateur de conversation | Des conversations à plusieurs tours générées à partir de profils clients et de scénarios que vous écrivez, ou que l'IA écrit à partir de votre prompt | Programme d'accès anticipé, agents IA de messagerie uniquement, conçu pour des données fictives |
| Gorgias Playground | Tout message que vous tapez, comme nouveau client, client existant ou ticket existant | Gratuit, n'affecte pas les rapports ; la cible "ticket existant" rejoue une vraie conversation après un changement de réglages |
| eesel Simulation | Un lot de vos vrais anciens tickets ou de cas de test générés | Note chaque réponse par rapport à ce que votre équipe a envoyé et suggère des changements d'instructions |
L'option "ticket existant" de Gorgias est bonne et sous-utilisée. La différence avec un rejeu complet est la couverture : un scénario que vous écrivez teste ce que vous attendiez déjà, alors qu'un lot des tickets du mois dernier teste ce que les clients ont réellement envoyé. Les deux valent la peine d'être exécutés. Un seul vous parle de la question que personne n'a pensé à écrire.
Un bon résultat de rejeu montre aussi ce qu'il faut transférer, pas seulement ce que l'IA a réussi. Dans l'exécution ci-dessus, les deux tickets qui nécessitaient une personne (un import de 200 élèves avec de mauvais niveaux scolaires et une demande de pilote d'une école) ont été correctement escaladés. C'est une réussite.
Le correctif : rejouez au moins quelques semaines de tickets résolus, répartissez la note par sujet et corrigez le sujet le plus faible avant le lancement. Les tests adverses couvrent les cas limites hostiles, et les équipes sur Freshdesk peuvent aussi utiliser une configuration de sandbox pour les changements de configuration.
Erreur 7 : un transfert qui oblige le client à tout recommencer
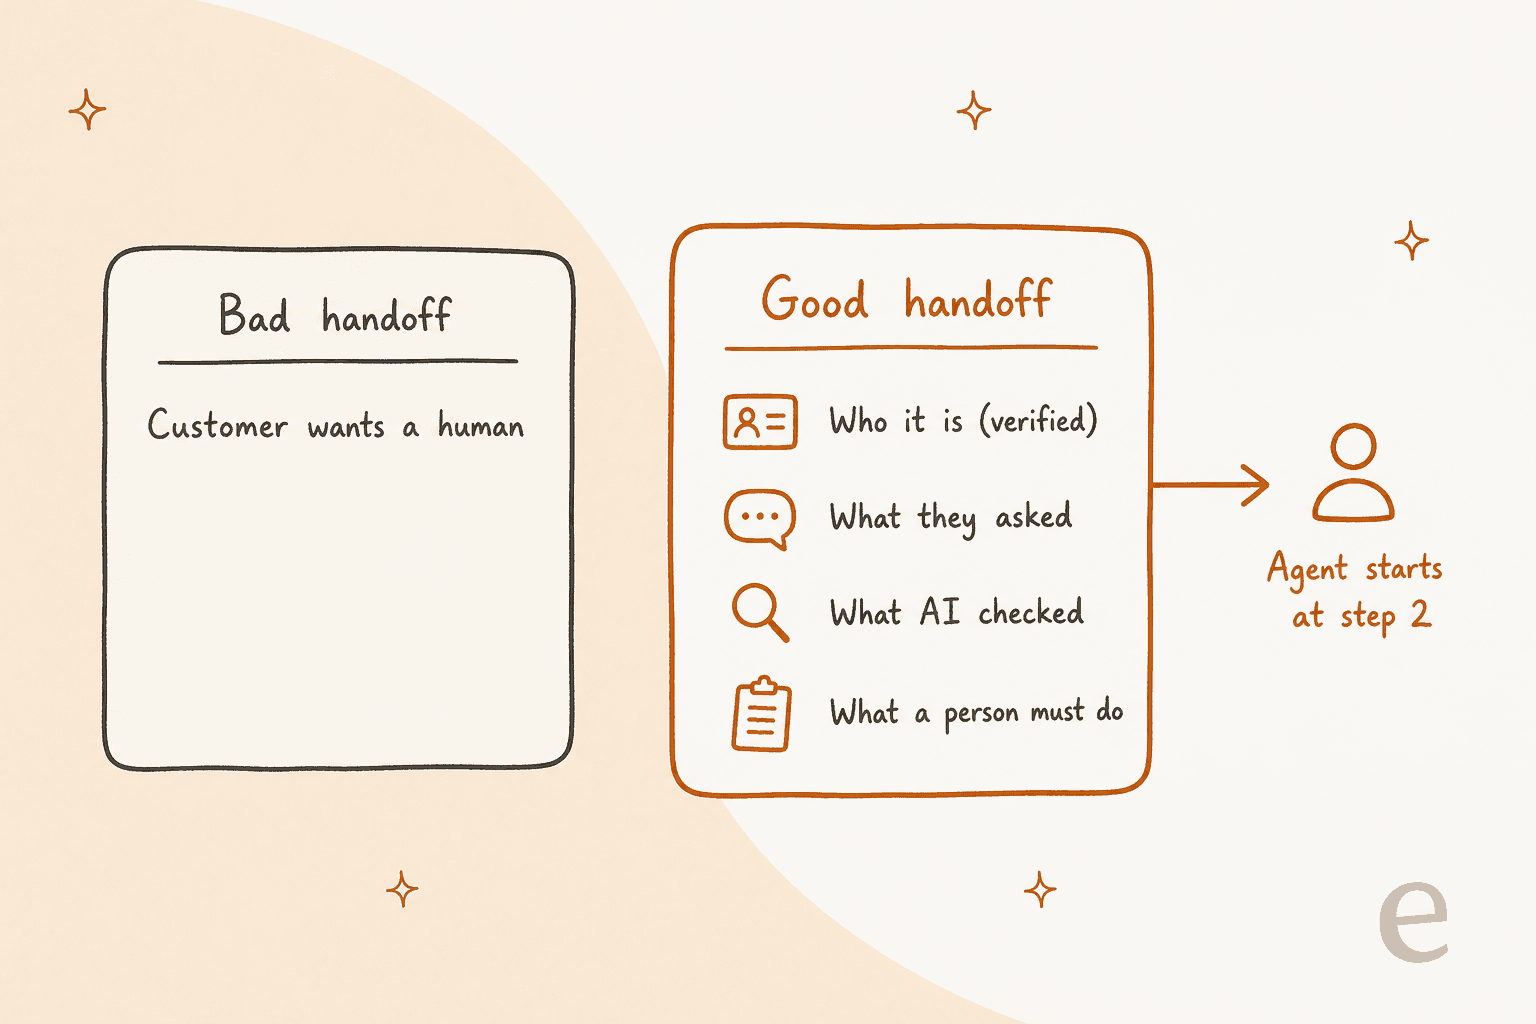
Un transfert qui dit seulement "le client veut une personne" n'en est presque pas un. Le client réexplique tout, l'agent revérifie ce que l'IA a déjà vérifié et toute la conversation dure plus longtemps que si l'IA n'avait jamais été là.
Le guide d'escalade de Zendesk recommande que l'IA recueille des informations comme le numéro de commande, le nom ou l'e-mail, ajoute des tags, mette à jour des champs et identifie les agents adaptés avant d'escalader. C'est la bonne liste.
"If someone explicitly asks for a human, blocking the transfer usually hurts more than it helps. The real challenge isn't deflection, it's routing with context so the human doesn't start from zero."
La configuration de Swiftreg le fait avec des notes internes. Quand une partie d'un ticket relève du personnel, eesel répond au reste et laisse une note interne sur la partie dont une personne est responsable. En un mois, il a envoyé 1 494 réponses publiques et laissé 1 055 notes internes sur environ 2 100 tickets Zendesk. Original Bootcamp ajoute une règle que j'aime : si un message mentionne une blessure ou une maladie, il va à une personne même si la question de réservation aurait pu recevoir une réponse.
Le correctif : rédigez un modèle de transfert à quatre champs (qui, ce qu'il a demandé, ce que l'IA a vérifié, ce qu'une personne doit faire) et testez-le sur votre lot de rejeu. Le guide du transfert d'agent IA contient des exemples de formulation, et les exemples de conception de conversation montrent des parcours complets.
Erreur 8 : activer l'autonomie totale dès le premier jour
La plus grande objection que j'entends lors des appels commerciaux n'est pas le prix. C'est le contrôle. Les responsables du support se sont généralement déjà brûlés une fois, et ils veulent que l'IA ne prenne que les tickets qu'elle peut gérer. Un responsable CX d'une marque de compléments DTC sur Gorgias, avec environ 7 000 tickets par mois, l'a dit ainsi :
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Responsable CX d'une marque de compléments DTC sur Gorgias + Shopify, appel commercial eesel
C'est l'argument en faveur d'un déploiement par étapes. D'abord le mode brouillon, où l'IA rédige et une personne envoie, puis des réponses automatiques sur un sujet restreint, puis le suivant.
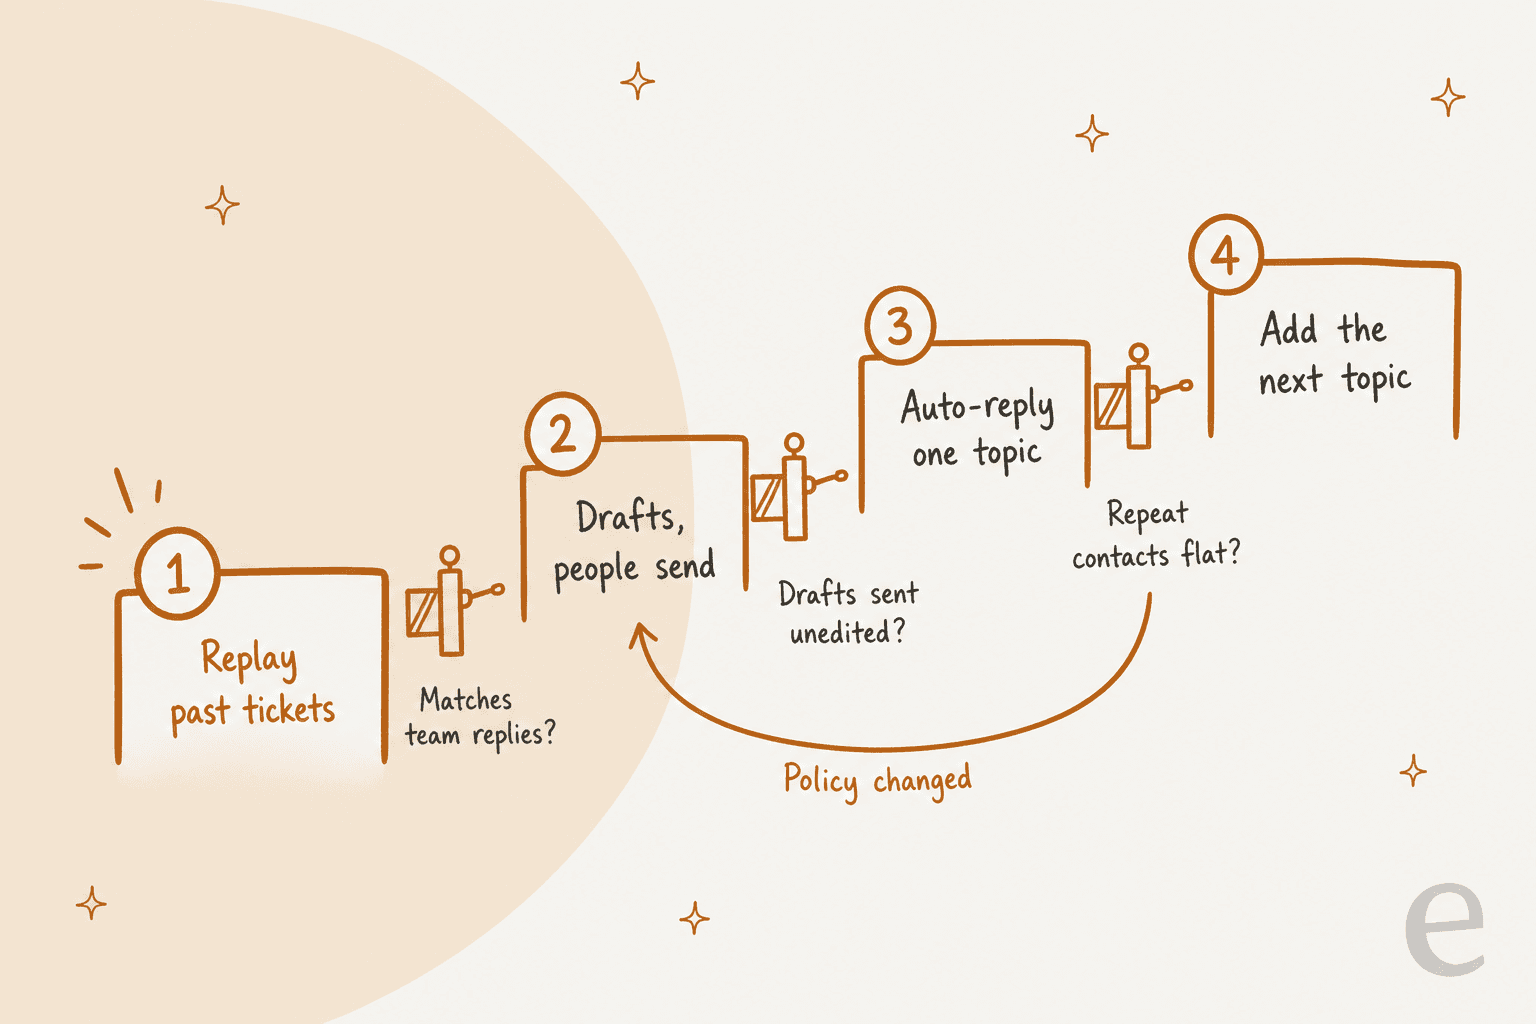
smava est l'exemple le plus clair que je puisse citer. L'entreprise utilise eesel sur Zendesk depuis décembre 2024, sur deux marques et environ 27 000 tickets par mois. Entre le 8 août et le 8 septembre 2026, l'agent de brouillons, dont la production attend l'approbation d'une personne, a tourné sur environ 12 200 tickets. Les agents de réponse qui préparent des réponses prêtes pour le client ne prennent que les tickets où le client n'a pas de conseiller assigné, environ 1 100. La règle des tickets éligibles tient en un seul champ, donc l'élargir est une modification de texte, pas un projet.
La liste de contrôle de mise en service de Gorgias va dans le même sens à plus petite échelle : la première semaine, examinez au moins 10 tickets traités par AI Agent et donnez un retour sur ceux qui ont raté.
Le correctif : faites tourner les brouillons pendant deux semaines et suivez la fréquence à laquelle les agents envoient un brouillon sans le modifier. N'activez les réponses automatiques que pour le sujet ayant le taux de brouillons non modifiés le plus élevé. Copilote IA pour le service client explique le mode brouillon, et brouillons de réponse IA sur Freshdesk le montre sur Freshdesk.
Erreur 9 : traiter le lancement comme la ligne d'arrivée
Votre politique de retour va changer. Un nouveau produit va sortir. Un transporteur va changer sa page de suivi. Chacun de ces changements rend fausses certaines réponses de l'IA du jour au lendemain, et personne ne le remarque jusqu'à ce que les contacts répétés s'accumulent.
Gorgias décrit l'amélioration d'AI Agent comme une boucle entraîner, tester, déployer et analyser, un type de conversation à la fois, avec l'exemple d'une compétence de retours dont le taux de transfert de 30 % devient l'objectif de la boucle suivante. Swiftreg va plus loin : ses instructions eesel sont conservées sous forme de versions numérotées, et la version suivante est étiquetée candidate et déployée selon la procédure propre à Swiftreg plutôt que modifiée en direct.
La confidentialité relève aussi de ce travail continu, pas seulement de la revue de sécurité avant la signature. Zendesk note que son simulateur de conversation est conçu pour des données fictives et demande d'éviter les vrais noms et e-mails dans les profils de test. Vos propres vérifications doivent demander ce que l'IA peut lire, ce qu'elle réécrit dans les tickets et qui peut voir les journaux. L'article sur la confidentialité des données de l'agent IA de Zendesk couvre les spécificités de Zendesk.
Le correctif : mettez une revue mensuelle au calendrier. Relancez le test de rejeu sur les tickets du mois dernier, lisez chaque ticket revenu sur le même problème et mettez à jour la base de connaissances avant de toucher aux instructions de l'IA. Analyse des erreurs du support client donne une méthode pour trier ce qui a mal tourné.
Votre agent IA est-il prêt à être lancé ?
Cochez les portes auxquelles vous pouvez honnêtement répondre oui. Chacune restée ouverte montre le correctif à apporter avant le lancement.
Que mesurer pendant les 30 premiers jours
Une fois l'IA en service, voici les chiffres que je mettrais sur une seule page. Aucun n'est la déflexion seule.
| Métrique | Ce qu'elle détecte | Comment la lire |
|---|---|---|
| Résolution appuyée par un résultat | Les abandons silencieux comptés comme des victoires | Remboursement émis, commande modifiée ou client ayant confirmé |
| Contact répété sur le même problème (7 et 30 jours) | Réponses fausses ou partielles | Une hausse sur un sujet signale un article périmé ou une action manquante |
| Taux de transfert par sujet | Sujets pour lesquels l'IA n'est pas prête | Élevé sur un sujet, c'est la prochaine chose à corriger, pas un échec |
| Délai entre la demande d'humain et la réponse humaine | Une sortie cachée ou en sous-effectif | De mauvais chiffres ici coûtent plus de confiance que n'importe quelle réponse du bot |
| Taux de brouillons non modifiés | Si un sujet est prêt pour les réponses automatiques | Promouvoir les sujets à taux élevé, garder les autres en brouillon |
| CSAT sur les conversations IA seule par rapport aux conversations humaines | Écarts de ton et de qualité | Comparer les deux, pas la moyenne combinée |
Un commentateur sur r/CustomerSuccess a nommé la métrique que j'ajouterais à tout tableau de bord de lancement :
"The metric I'd watch is request-for-human to human-response time. If that number is bad, or people keep reopening on another channel after the bot, you're not deflecting demand, you're just hiding queue pain."
Il est aussi utile de savoir ce que votre éditeur facture, car l'unité de facturation est ce que votre équipe financière regardera en premier :
| Éditeur | Unité de facturation de l'IA | Prix publié |
|---|---|---|
| Zendesk | Automated resolution (niveau vérifié uniquement, depuis le 18 mai 2026) | $1.50 avec engagement, $2.00 à l'usage, selon les tarifs Zendesk |
| Gorgias | Automated interaction, quand AI Agent résout sans transfert | $0.85 à $1.00 selon l'offre, selon les tarifs Gorgias |
| Freshdesk | Session Freddy AI Agent (une session e-mail est une fenêtre de 72 heures) | 500 premières sessions incluses une fois, puis $49 par 100, selon les tarifs Freshdesk |
| eesel | Crédit : un ticket ou un chat, quel que soit le nombre de réponses ou de consultations | À partir de $299/mois pour 500 crédits, selon les tarifs eesel |
Le guide des métriques du service client IA définit chaque métrique plus en détail, le CSAT de l'IA couvre le côté enquête et le coût par résolution détaille l'aspect financier.
Un plan de déploiement sur 30 jours
Voici l'ordre que je suivrais sur une file e-mail et chat typique. Connecter le helpdesk prend quelques minutes ; l'essentiel du mois sert à gagner la confiance un sujet à la fois.
- Jours 1 à 5 : connecter et nettoyer. Connectez le helpdesk et les sources de connaissances, auditez vos 20 sujets principaux et rédigez la règle de repli, la liste de ce qu'on ne promet jamais et le modèle de transfert.
- Jours 6 à 8 : rejouer. Faites tourner l'IA sur quelques semaines de tickets résolus. Corrigez le sujet le plus faible, puis rejouez.
- Jours 9 à 22 : brouillons. L'IA rédige sur chaque ticket éligible, les agents approuvent, modifient ou rejettent. Suivez le taux de brouillons non modifiés par sujet et ce que les agents changent.
- Jours 23 à 30 : un sujet en direct. Activez les réponses automatiques pour le sujet au meilleur taux de brouillons non modifiés. Gardez l'option humain visible et surveillez les contacts répétés chaque jour.
- À partir du jour 30 : la boucle. Ajoutez un sujet à la fois, relancez le rejeu chaque mois et renvoyez tout sujet en brouillon quand une politique change.
Le guide pour automatiser le support avec l'IA approfondit chaque étape, et si vous choisissez encore un outil, choisir un agent IA et critères d'achat d'un helpdesk IA couvrent le côté achat.
Déployez eesel sans les erreurs
eesel est un coéquipier de helpdesk IA qui rejoint la file que vous gérez déjà dans Zendesk, Freshdesk ou Gorgias, et son déploiement est construit autour de l'ordre ci-dessus. Avant d'envoyer quoi que ce soit, la compétence Simulation rejoue vos anciens tickets et note chaque réponse par rapport à ce que votre équipe a réellement envoyé. Puis il rédige des brouillons, vos agents approuvent, et les réponses automatiques ne s'activent que pour les sujets qui l'ont mérité, selon des règles que vous écrivez en langage courant.
C'est ainsi que smava traite environ 27 000 tickets Zendesk par mois avec des personnes qui approuvent la plupart des brouillons, et ainsi que Swiftreg répond aux commandes de plaques uniquement à partir de consultations en direct. Vous disposez de 100 crédits gratuits pour connecter votre helpdesk et voir de vrais brouillons sur vos propres tickets avant de payer quoi que ce soit. Essayez eesel et lancez votre premier rejeu cette semaine.
Comment tester un agent de support IA avant la mise en service ?