

En bref
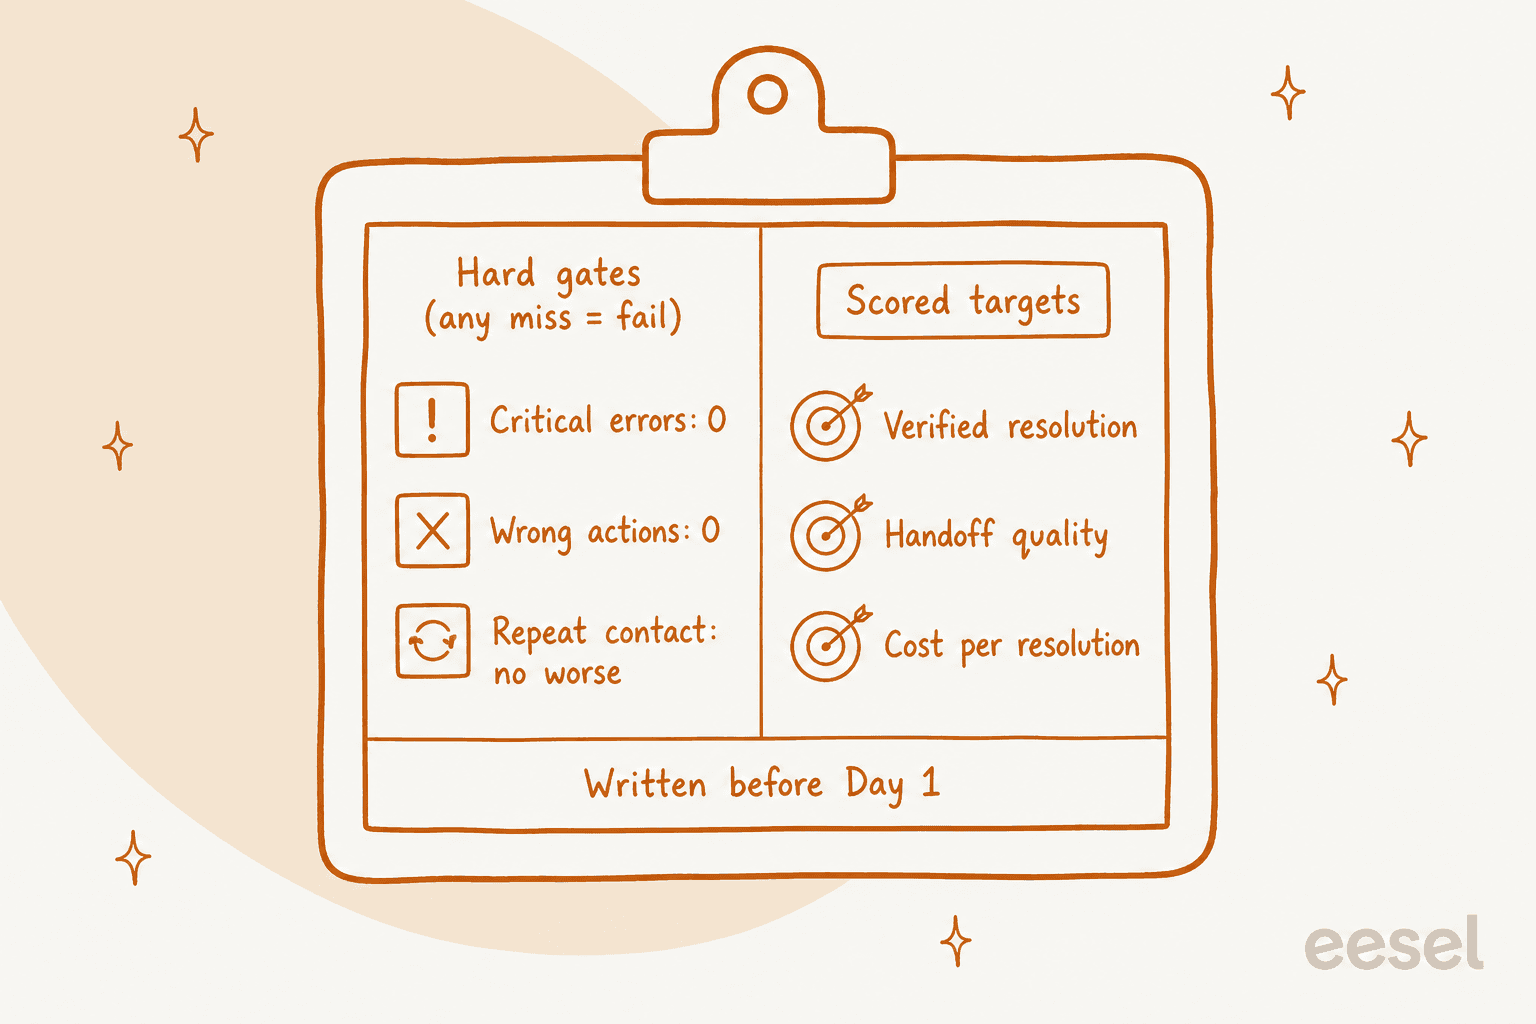
Une grille d'évaluation de pilote de support IA, ce sont six chiffres que vous notez avant le premier jour, et non après que le fournisseur vous a envoyé sa présentation de résultats. Trois d'entre eux sont des critères éliminatoires qui font échouer le pilote à eux seuls : zéro erreur critique (une politique inventée, une promesse que vous ne pouvez pas tenir), zéro action erronée (un mauvais remboursement, le compte de quelqu'un d'autre) et un taux de recontact pas pire que celui d'une voie témoin gérée uniquement par des humains. Les trois autres sont des objectifs notés : taux de résolution vérifié, qualité des transferts et coût par résolution durable.
Le piège dans lequel tombent la plupart des équipes, c'est de noter le pilote avec le tableau de bord du fournisseur. Zendesk, Gorgias et HubSpot comptent chacun une « résolution » différemment, et les décomptes de Gorgias et de HubSpot ne se stabilisent que 72 heures après la fin de la conversation. Sur un essai de 14 jours, cela signifie que les trois derniers jours ne sont pas encore comptabilisés quand on vous demande de signer. Menez le pilote pendant au moins trois semaines, vérifiez à la main un échantillon de conversations « résolues », et comptez comme non résolu tout client qui revient dans les 7 jours.
Si vous voulez un pilote qui fonctionne déjà de cette façon, eesel rejoue vos anciens tickets avant de toucher à un ticket réel, démarre en mode brouillon dans votre helpdesk et consigne chaque action pour que vous puissiez l'auditer. SE Ranking a demandé un tag ai_handled sur chaque ticket pour que le taux de confinement soit compté dans Zendesk, et non deviné. Le forfait gratuit vous donne 100 crédits pour l'essayer sur vos propres tickets.
Pourquoi la plupart des pilotes de support IA ne prouvent rien
Je travaille chaque jour dans la file de support d'eesel, et je passe beaucoup de temps de l'autre côté de ce processus : des équipes en plein essai, qui essaient de savoir si ce qu'elles voient est réel. Le schéma que je rencontre le plus souvent n'est pas celui d'une mauvaise IA. C'est celui d'un pilote sans seuil de réussite. L'essai démarre, le tableau de bord du fournisseur se remplit de vert, et trois semaines plus tard quelqu'un doit décider d'un contrat à partir de chiffres définis par l'entreprise qui vend le produit.
Ce n'est pas une attaque contre un fournisseur en particulier. Simplement, « résolu » veut dire autre chose sur chaque plateforme, et chaque définition est aussi l'unité de facturation :
- Zendesk compte une résolution automatisée (expliquée dans le guide Zendesk automated resolutions) uniquement lorsque le client ne relance pas et qu'un LLM lit la transcription et confirme que le problème est résolu. Les conversations qui échouent à cette vérification sont « contenues », pas résolues. La fenêtre est de
2 heuresà partir du premier message en messagerie (ajustable jusqu'à 72) et de72 heurespour l'e-mail. - Gorgias compte une interaction automatisée lorsque « the customer does not require the involvement of a human agent within 72 hours. »
- HubSpot définit le statut de résolution 72 heures après la dernière réponse du visiteur, et dit clairement que « deflections do not always indicate resolution », car un client qui a renoncé et est parti ressemble à un client qui a obtenu une réponse.
- Freshdesk facture le Freddy AI Agent par session,
49 $pour 100, que la session ait abouti à une résolution, une escalade ou un abandon.
Aucune de ces définitions ne vérifie si le même client réécrit la semaine suivante pour le même problème. C'est pourtant le chiffre qui vous dit si l'IA a réglé quelque chose ou simplement mis fin à une conversation, et c'est celui que vous devez mesurer vous-même.
""Deflection" in the customer service world means when you prevent a customer from talking to a human. It's a critical metric for CSR orgs. Often you improve deflection rates by putting hurdles between a customer and a rep."

J'ai creusé les définitions dans CX AI metrics ; cet article explique comment s'en servir pour prendre une décision d'achat.
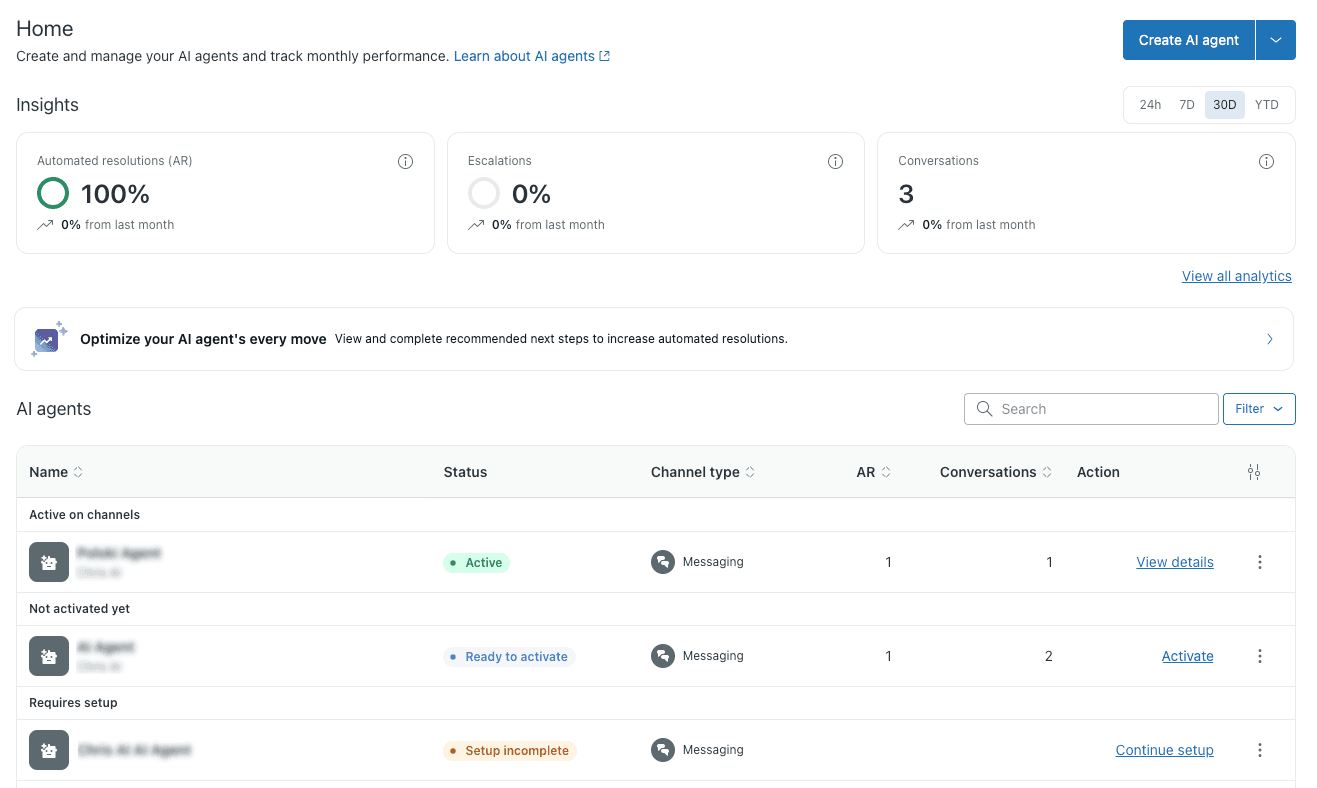
Cette capture d'écran est l'exemple du centre d'aide de Zendesk lui-même, et elle rappelle bien ce qu'un tableau de bord vous montrera sans broncher : 100 % de résolutions automatisées sur 3 conversations. Il n'y a rien de faux là-dedans. Mais cela ne prouve encore rien, et les chiffres du début de pilote ressemblent souvent exactement à cela.
Que faut-il mettre dans une grille d'évaluation de pilote IA ?
Six chiffres, répartis en deux catégories. Les critères éliminatoires sont de type réussite/échec et ne se compensent pas : un pilote qui résout 60 % des tickets mais a remboursé la mauvaise commande une seule fois a échoué. Les objectifs sont les chiffres que vous achetez réellement, et vous les fixez à partir de votre propre référence avant le début du pilote.
| Chiffre | Type | Comment le mesurer | Seuil de réussite à convenir à l'avance |
|---|---|---|---|
| Erreurs critiques | Critère éliminatoire | Chaque remboursement, annulation, modification de compte ou déclaration de politique du pilote, vérifié par une personne | 0 |
| Actions erronées | Critère éliminatoire | Le journal d'activité de l'IA comparé à ce que le client a réellement demandé (bonne commande, bon compte, bon montant) | 0 |
| Recontact sous 7 jours | Critère éliminatoire | Clients de tickets résolus par l'IA qui réécrivent à propos du même problème, comparés à la voie témoin | Pas pire que la voie témoin |
| Taux de résolution vérifié | Objectif | Résolutions ayant passé la vérification à 7 jours, divisées par tout ce que l'IA a traité dans sa voie | Votre chiffre, fixé à partir des types de tickets concernés |
| Qualité des transferts | Objectif | Un échantillon d'escalades : l'humain a-t-il reçu le numéro de commande, ce qui a été essayé et pourquoi le ticket a été transféré ? | L'agent n'a pas à redemander quoi que ce soit au client |
| Coût par résolution durable | Objectif | Dépenses d'IA du pilote divisées par les résolutions qui ont tenu | Inférieur à votre coût par ticket traité par un humain |
Je garderais le AI CSAT dans le rapport mais hors de la grille pendant un pilote. Les taux de réponse sur des essais courts sont faibles, et sur Zendesk l'enquête BSAT n'est pas envoyée sur les conversations escaladées, ce qui la biaise vers les cas faciles.
L'objectif de résolution est celui que l'on se trompe le plus souvent à fixer, dans les deux sens. Les études de cas des fournisseurs citent de gros chiffres issus de déploiements matures, et le premier mois y ressemble rarement. Fixez-le à partir de la part de votre volume qui est réellement concernée. Si les questions de suivi de commande représentent 30 % de vos tickets et que vous ne pilotez que celles-ci, un taux de résolution global de 25 % est un excellent résultat, pas une déception. Le guide AI resolution rate en dit plus sur ce à quoi ressemble un chiffre réaliste.
Comment organiser le pilote pour que les chiffres aient un sens
Une grille ne vaut que par la comparaison qui la sous-tend. Trois choix de mise en place décident si vos chiffres tiendront quand la finance posera des questions.
Choisir une voie, pas toute la boîte de réception
Choisissez deux ou trois types de tickets à fort volume, auxquels vos documents permettent de répondre et qui sont peu risqués si l'IA se trompe : suivi de commande, politique de retour, réinitialisation de mot de passe, questions pratiques. Ne retenez qu'un seul canal (e-mail ou chat, pas les deux dès le premier jour). Tout le reste reste chez votre équipe. Tous les fournisseurs prennent en charge une version de ce principe, et c'est ce qui sépare un pilote lisible d'un pilote où chaque mauvaise réponse déclenche un débat pour savoir si ce type de ticket aurait dû en faire partie.
Un responsable informatique sur Reddit a décrit le même schéma pour un bot de premier niveau :
"I'd be wary of making the bot the only front door, especially for a distributed user base. A good first-line flow should handle a small set of low-risk, high-volume requests and make escalation obvious when confidence is low or the user is stuck. Put a prominent "talk to a person" path beside the guided steps, not three screens deep. Measure containment together with reopen rate, time to resolution, transfer rate, and user satisfaction, because deflecting a ticket that comes back angry is not a win. I'd pilot it with one office or request category, review the transcripts with the service desk every week, and keep a human fallback for outages and accessibility issues."

La revue hebdomadaire des transcriptions est ce que les équipes abandonnent en premier, et c'est elle qui fait apparaître les problèmes.
Voici ce que chaque helpdesk offre pour délimiter une voie de pilote :
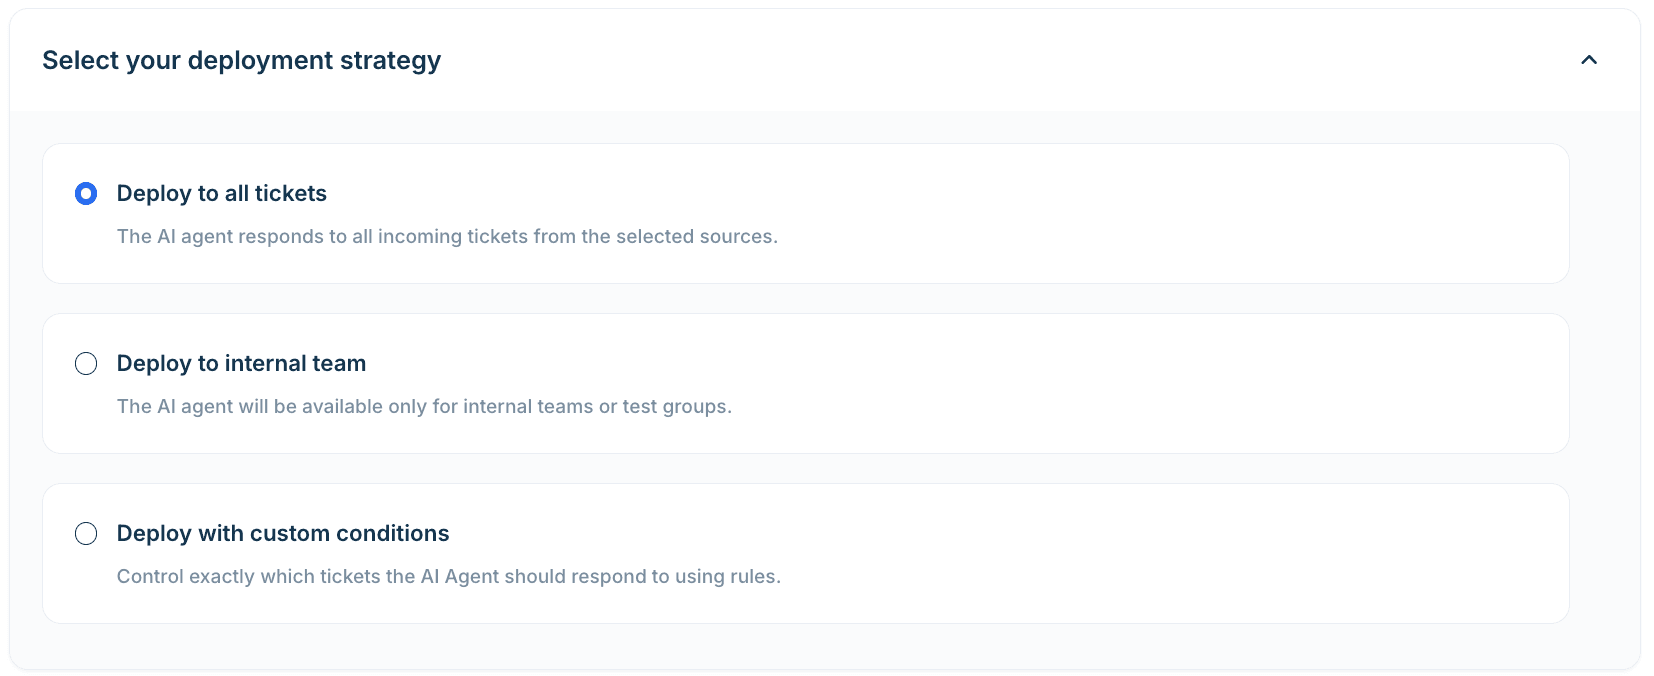
- Freshdesk : l'agent IA e-mail propose une option « Deploy to internal teams », que Freshworks décrit lui-même comme « a safe pilot rollout », ainsi que des règles personnalisées avec jusqu'à cinq niveaux de logique ET/OU, de sorte que vous pouvez cibler « les e-mails de retour sur la boîte principale » et rien d'autre.
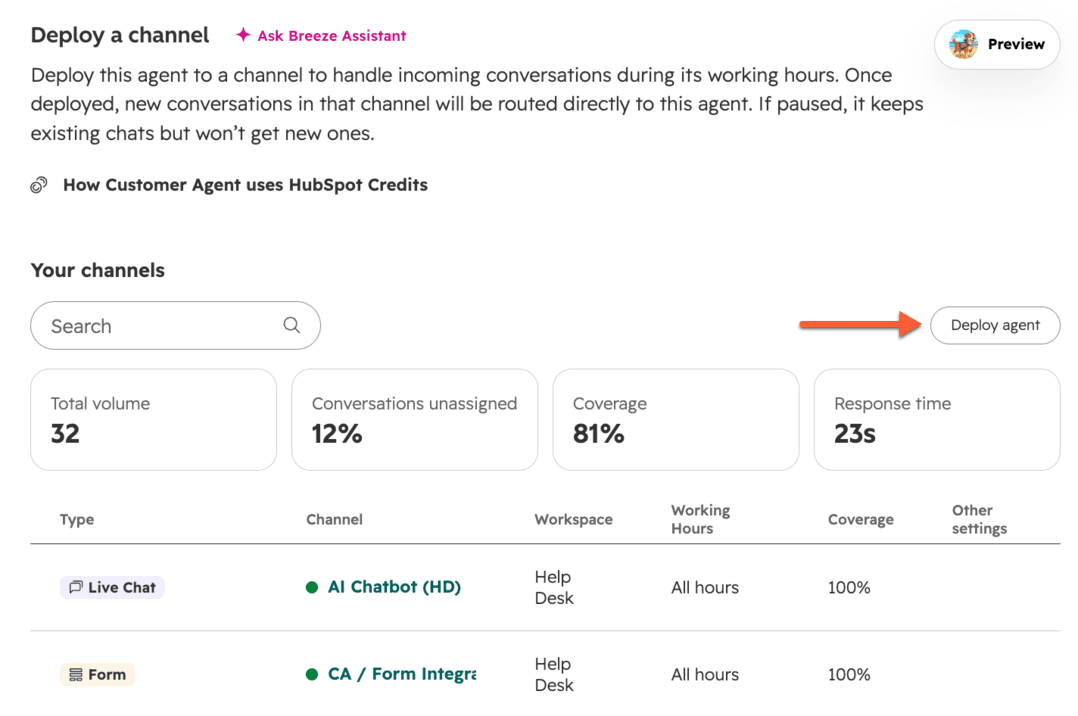
- HubSpot : chaque déploiement par canal comporte un pourcentage de « Conversation coverage », des horaires de travail et des listes de contacts à inclure ou exclure pour l'e-mail. HubSpot conseille de commencer bas et d'augmenter la couverture à mesure que l'agent progresse.
- Zendesk : vous choisissez les canaux par agent IA, et un agent e-mail est délimité par un déclencheur modifiable, par exemple une adresse de support distincte.
- Gorgias : l'AI Agent s'active par canal (e-mail, chat), et Gorgias présente le déploiement comme une compétence ou un type de conversation à la fois.
- Help Scout : Scout (le nouveau nom d'AI Answers, voir Help Scout pricing) peut être limité, par e-mail, à « Only customers matching these conditions ».
Garder une voie témoin
C'est l'étape que presque personne ne fait, et c'est elle qui fait fonctionner le critère de recontact. Acheminez les mêmes types de tickets, sur le même canal, vers des humains uniquement pour une tranche du trafic. C'est aussi ainsi que vous mesurez honnêtement la résolution au premier contact. Vous pouvez alors comparer à conditions égales : si des clients reviennent dans les 7 jours après 9 % des résolutions de l'IA et après 6 % de celles des humains, l'IA crée du travail, quel que soit son beau taux de résolution.
"And before-and-after is not evidence. Volume shifts, seasonality, ticket mix, and the agent itself changes which cases humans see, so the human baseline you're comparing against no longer exists. If you want to actually prove improvement rather than assert it, keep a holdout, route some percentage to the old path permanently. It costs a few percent of the gain and it's the difference between a number and an argument. Most teams skip it and then spend six months debating attribution."
Cette dernière phrase dit le coût réel d'une voie témoin : vous renoncez à quelques points de gain pendant le pilote, et en échange le résultat ne peut pas être balayé comme un simple mois calme.
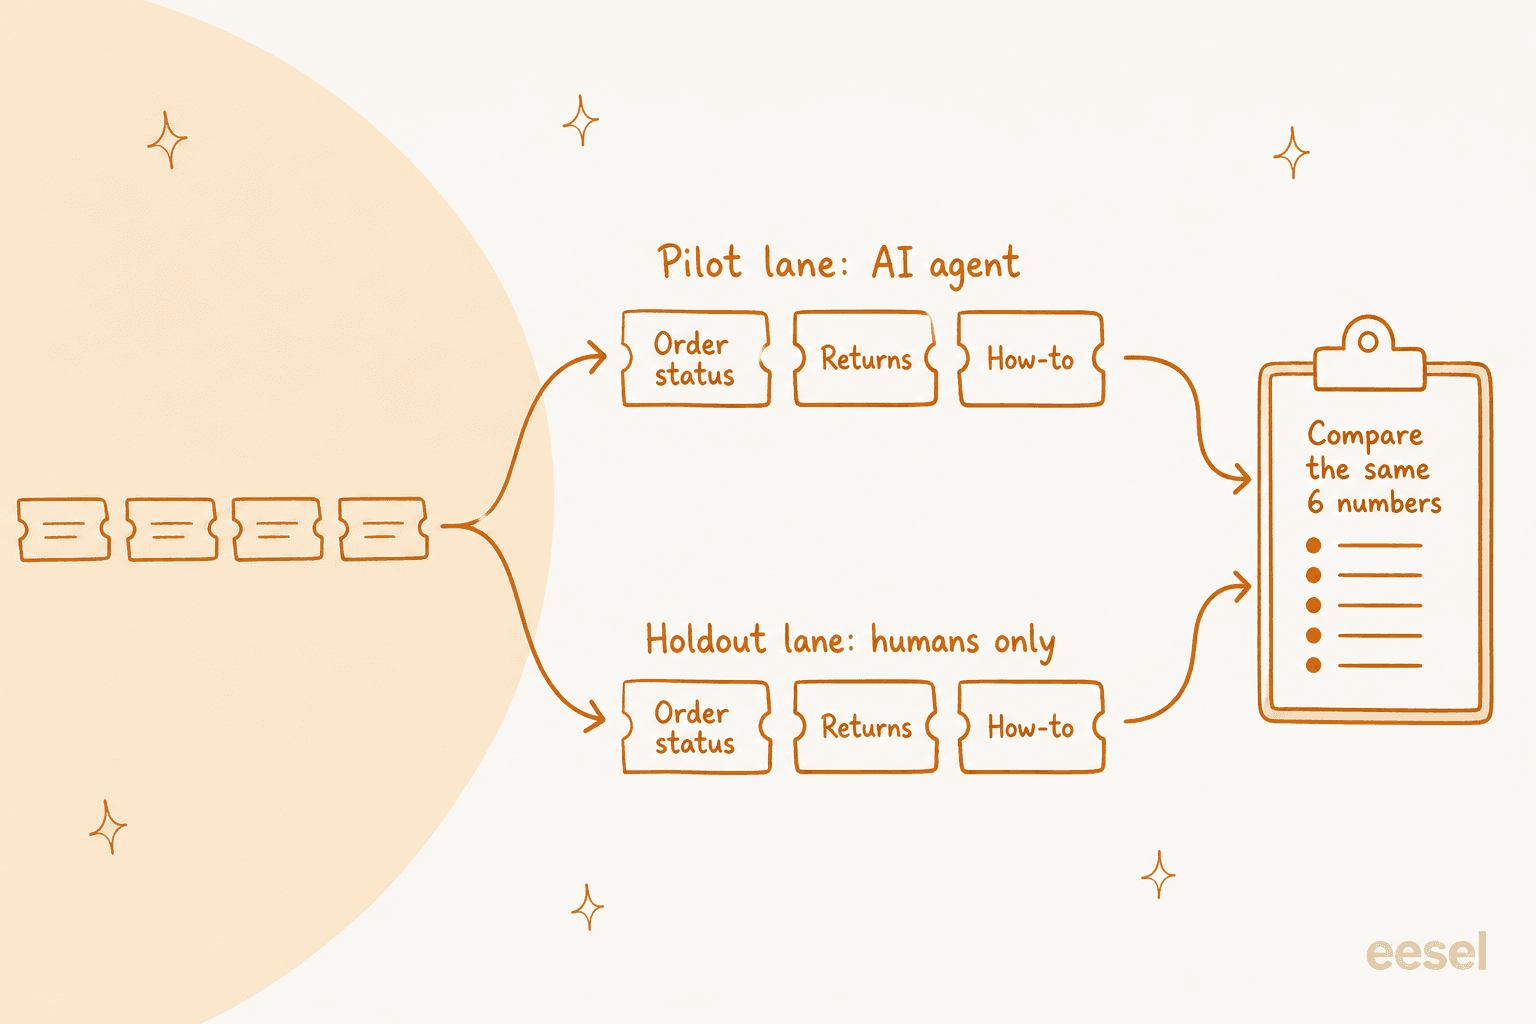
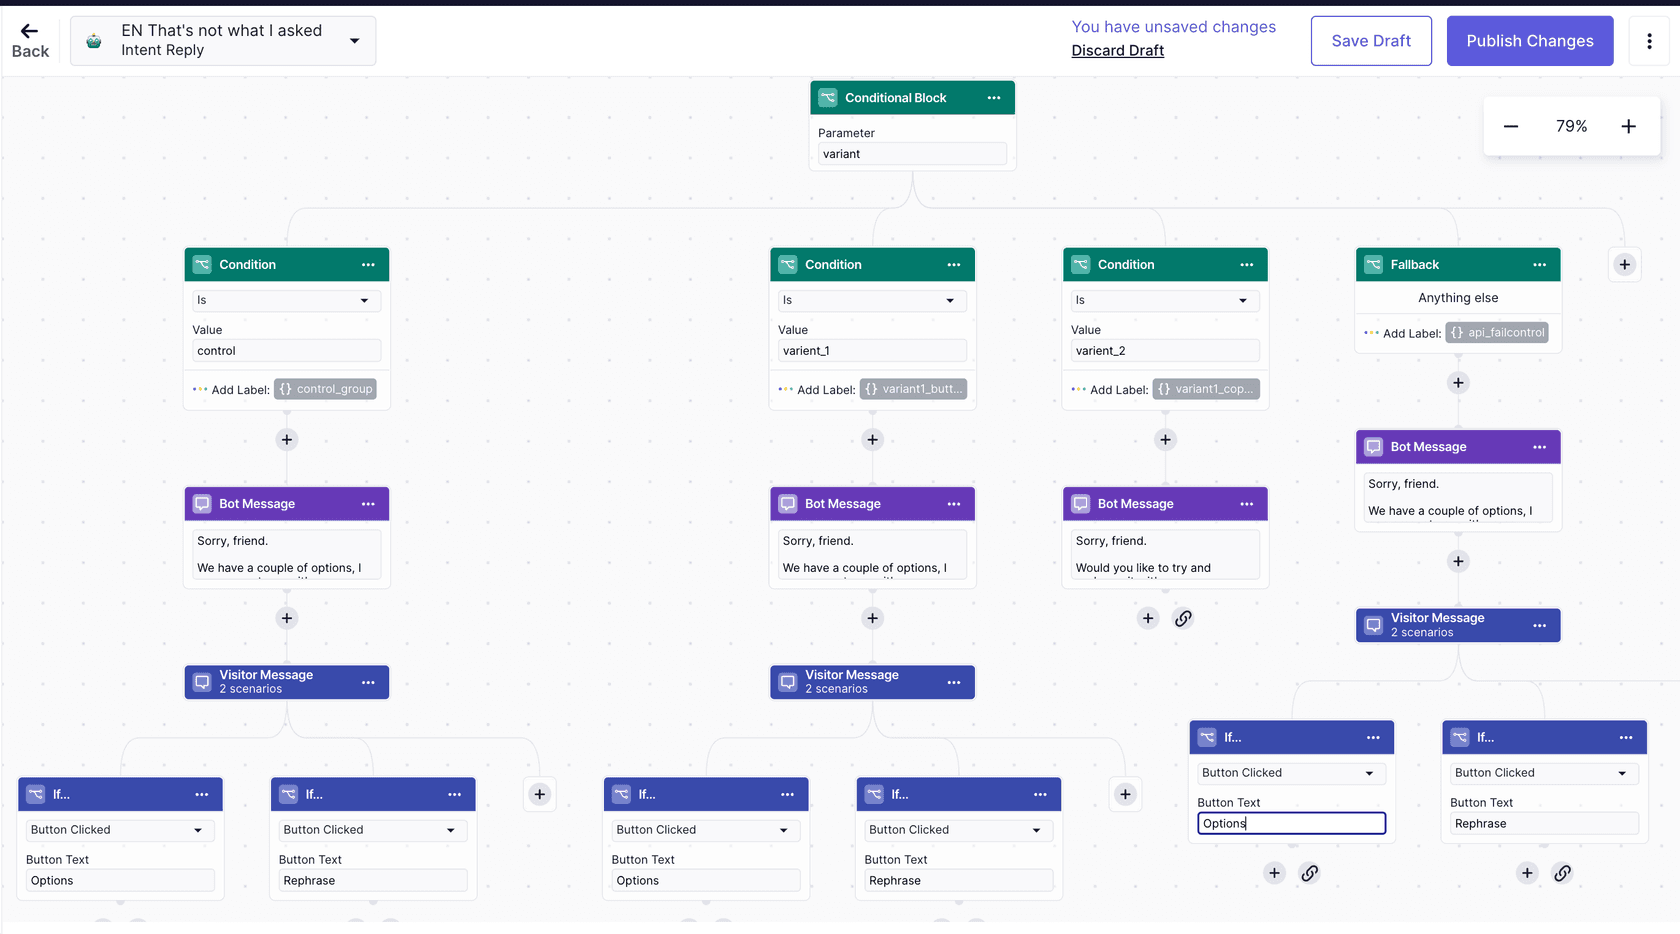
Un seul des grands helpdesks documente un véritable groupe de contrôle. Le guide d'A/B testing de Zendesk décrit une méthode trafficSplit qui affecte aléatoirement les conversations à des variantes (« 1,1 » donne une répartition 50/50, et « the first group will always be the [control] group »). Elle fonctionne dans les flux de messagerie, et vous devez demander à votre responsable de compte Zendesk de l'activer. Si l'une des variantes est un simple transfert vers une personne, vous avez votre voie témoin.
Partout ailleurs, vous construisez vous-même la voie témoin. Le pourcentage de couverture de HubSpot est le plus simple : à 50 % de couverture, la moitié des conversations du canal va à des personnes. HubSpot considère ce réglage comme une montée en charge plutôt qu'un groupe de contrôle, donc vous comparerez les deux moitiés dans votre propre rapport, mais la répartition existe.
Sur Freshdesk, Gorgias ou Help Scout, l'alternance des jours fonctionne (IA en semaine et humains le week-end est trop déséquilibré), tout comme une règle sur un attribut client, par exemple un identifiant client pair ou impair. Vous n'avez pas besoin d'un logiciel de statistiques. Il vous faut les mêmes types de tickets traités de deux façons sur les mêmes semaines.
Taguer tout ce que l'IA touche
Vous voudrez extraire plus tard les tickets du pilote de votre helpdesk sans dépendre du rapport du fournisseur. SE Ranking l'a bien fait : ils ont demandé un tag ai_handled sur chaque ticket touché par eesel, plus des tags utile et non utile, de sorte que le taux de confinement est compté dans Zendesk plutôt que deviné. Maintenant qu'ils testent les réponses directes par e-mail, les tickets de test sont repérés par leur objet et chaque fil reçoit un tag ouvert, résolu, escaladé ou avec une personne. C'est un pilote que vous pouvez auditer avec une vue enregistrée et un tableur.
Démarrer en mode brouillon la première semaine
Avant que l'IA ne réponde à qui que ce soit, laissez-la rédiger des réponses ou des notes internes sur de vrais tickets entrants pendant une semaine, et demandez à votre équipe de les évaluer. Cela ne coûte aucun risque côté client, et c'est là que la plupart des problèmes corrigeables apparaissent. J'ai détaillé la séquence complète avant lancement dans AI support agent testing, donc je reste bref : l'horloge de votre grille démarre quand l'IA passe en production sur sa voie, pas quand vous la connectez.
Combien de temps un pilote de support IA doit-il durer ?
Trois à quatre semaines de trafic réel, plus une semaine avant de lire les chiffres finaux. Voici pourquoi c'est plus long que la plupart des essais gratuits.
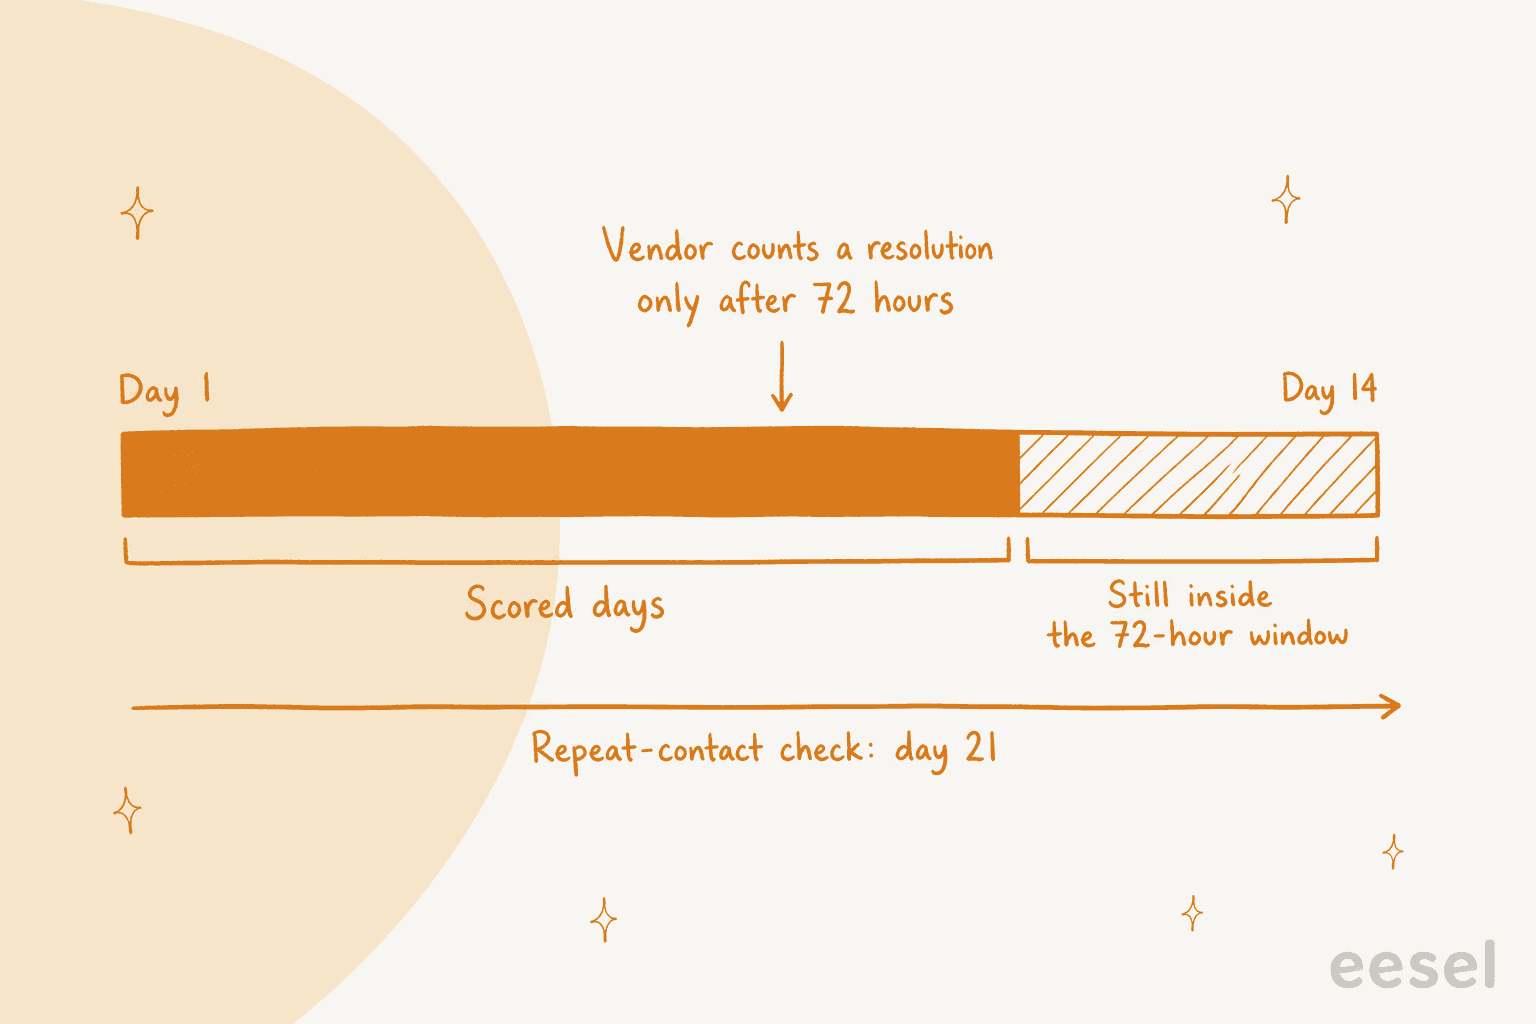
Les fenêtres de résolution repoussent vos données plus tard que ne le suggère le calendrier. Gorgias le dit sans détour : une interaction n'est facturée comme automatisée qu'après 72 heures sans transfert à un humain, « so the most recent 3 days aren't immediately reflected » dans la métrique. HubSpot définit le statut de résolution 72 heures après la dernière réponse du visiteur. La fenêtre e-mail de Zendesk est de 72 heures à partir du premier e-mail. Sur un essai de 14 jours, vous lisez au mieux 11 jours de données stabilisées.
Ajoutez ensuite votre propre vérification de recontact à 7 jours. Un ticket que l'IA a « résolu » au jour 13 ne peut être confirmé qu'au jour 20. Si l'essai du fournisseur se termine au jour 14 et que l'appel commercial a lieu au jour 15, vous signez sur des chiffres qui n'ont pas fini d'être comptés.
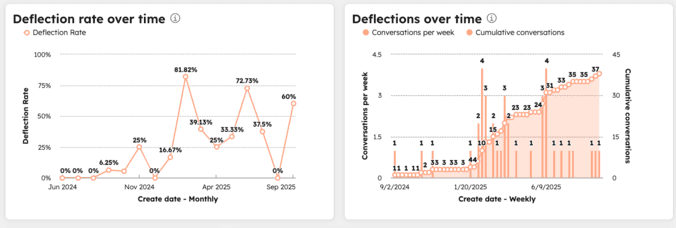
Le volume compte aussi. Une semaine avec 40 conversations d'IA fluctuera fortement. L'exemple du centre d'aide de HubSpot montre un taux de déviation qui passe de 0 % à 81,82 % d'un mois à l'autre sur une poignée de conversations par semaine :
Comme plancher approximatif, je voudrais quelques centaines de conversations traitées par l'IA dans la voie avant de faire confiance au taux à quelques points près. Si votre volume ne peut pas y arriver en trois semaines, élargissez la voie avant de prolonger la durée.
Les essais gratuits sont plus courts que le pilote dont vous avez besoin, alors vérifiez ce que chacun donne réellement avant de planifier :
| Helpdesk | Essai gratuit ou allocation | Tests facturés ? | Piège pour le pilote |
|---|---|---|---|
| Zendesk | 14 jours, sans carte, agents IA inclus | Le widget de test, le simulateur et le sandbox n'utilisent pas de résolutions automatisées. Un agent e-mail testé en production en utilise | La fenêtre de 72 heures de l'e-mail mange les 3 derniers jours |
| HubSpot | 14 jours d'accès gratuit, sur inscription, Professional ou Enterprise | L'aperçu, les tests et les tests par lots n'utilisent pas de crédits | L'agent « will automatically turn off » à la fin des 14 jours |
| Freshdesk | 500 sessions uniques | L'aperçu des agents de chat utilise des sessions ; l'aperçu de l'agent e-mail non | Pas de limite de durée, mais les sessions non utilisées ne sont pas reportées |
| Gorgias | Essai gratuit, sans carte (durée non publiée) | Les conversations de test sont gratuites et n'affectent pas les rapports | Les 3 derniers jours ne figurent pas encore dans le taux d'automatisation |
| Help Scout | Essai gratuit de 3 mois d'AI Answers | Non précisé | Assez long pour un vrai pilote |
| Salesforce (Agentforce) | Developer Edition gratuite | Testing Center non mesuré depuis Summer '26 | Le routage du pilote en production est un flux à construire |
Si l'essai dure 14 jours, demandez au fournisseur une prolongation par écrit avant le premier jour, avec la grille en pièce jointe. Un fournisseur sûr de son produit dira généralement oui, et sa façon de répondre vous renseigne dans les deux cas.
Comment noter chaque chiffre
Créez une feuille partagée avec une ligne par semaine et une colonne par chiffre de la grille. Remplissez-la à partir de l'export de votre helpdesk, pas du tableau de bord du fournisseur, et n'utilisez ce dernier que pour recouper.
Taux de résolution vérifié : vérifier à la main le tas des « résolus »
Chaque semaine, extrayez 30 à 50 conversations que la plateforme a marquées comme résolues et lisez-les. Classez chacune : réellement répondue, client qui a renoncé, ou répondue de travers. Si deux relecteurs ne sont pas d'accord sur un même ticket, faites un rapide calibrage QA avant de vous fier au décompte. C'est ainsi que vous repérez l'écart entre « la conversation s'est terminée » et « le problème a été résolu ». Lors d'une vérification sur 100 tickets dans la boîte de réception d'un bijoutier pendant un essai d'eesel, les brouillons étaient globalement justes 88 % du temps, mais seuls 12 % ont été envoyés sans modification et 7 % contenaient une erreur factuelle. Un seul chiffre de précision aurait masqué ces trois constats.
La liste de contrôle d'un opérateur va au-delà du chiffre du tableau de bord, exactement comme il faut :
"That's why I wouldn't measure this only by "tickets deflected." I'd also look at: Average human handling time after AI is involved Repeat contacts/reopens How often the customer has to repeat themselves after escalation Whether AI is actually removing repetitive work from the team And, obviously, whether customers are still getting the problem solved"
Recontact : la vérification à 7 jours
Pour chaque ticket résolu par l'IA, vérifiez si le même client a ouvert un autre ticket, sur n'importe quel canal, dans les 7 jours. Faites de même pour la voie témoin. La plupart des helpdesks le permettent via une recherche par demandeur ou un rapport filtré par client, et c'est le seul chiffre qu'aucun tableau de bord de fournisseur ne vous donne directement. Gorgias n'ouvre un nouveau ticket par e-mail que si la réponse arrive plus de 10 jours après le dernier message (3 jours pour le chat, le SMS et la voix), et sur HubSpot une réponse par e-mail après 72 heures rouvre la conversation et peut être facturée comme une seconde résolution. Un client qui revient atterrit donc soit sur le même ticket, soit sur un nouveau, et il faut chercher les deux.
Erreurs critiques et actions erronées : lire le journal, pas la réponse
Une réponse peut se lire parfaitement et reposer sur une action erronée : rembourser la commande 4417 alors que le client parlait de la 4471, citer un délai de retour que vous avez changé le mois dernier, promettre une date de livraison que personne ne peut garantir. Examinez chaque action de l'IA qui touche à l'argent ou à un compte, et chaque réponse qui énonce une politique. Quand vous en trouvez une, une courte analyse d'erreur remonte généralement à une règle manquante ou à un article périmé. Gardez les remboursements, annulations et modifications de compte derrière une approbation humaine pendant tout le pilote ; les workflows d'approbation vous coûtent quelques minutes par jour et retirent du test la défaillance la plus coûteuse.
Qualité des transferts : échantillonner les escalades
Extrayez 20 conversations transférées par semaine et posez une seule question à vos agents : avez-vous dû redemander quelque chose au client ? Si la réponse est souvent oui, l'IA fait gagner du temps sur les tickets qu'elle clôt et en fait perdre sur ceux qu'elle transmet. L'article handoff best practices propose une liste de contrôle de ce que doit contenir une bonne note de transfert.
Coût par résolution durable : le calculer sur les résolutions qui ont tenu
Prenez vos dépenses d'IA de la période du pilote et divisez-les par les résolutions vérifiées après le contrôle à 7 jours, pas par le nombre de résolutions du fournisseur. Comparez ensuite avec votre coût complet par ticket traité par un humain. Le guide chatbot ROI liste ce qui entre dans ce chiffre. L'unité de facturation change beaucoup le résultat, et c'est aussi pourquoi les AI customer service metrics s'alignent rarement d'un fournisseur à l'autre :
| Helpdesk | Ce qui est facturé | Ce que cela implique pour la grille |
|---|---|---|
| Zendesk | 1,50 $ engagé / 2,00 $ à l'usage par résolution automatisée vérifiée | La fenêtre se ferme à 2 heures (messagerie) ou 72 heures (e-mail), donc un client qui revient plus tard ne change pas le décompte |
| Gorgias | 0,85 $ à 1,00 $ par interaction automatisée, et un ticket entièrement résolu par l'IA peut aussi compter comme ticket de helpdesk | Deux frais peuvent s'appliquer à un même ticket avec la tarification actuelle |
| Freshdesk | 49 $ pour 100 sessions, quel que soit le résultat | Divisez les dépenses de sessions par les résolutions durables, pas par 0,49 $ |
| HubSpot | HubSpot Credits par résolution ; un fil e-mail rouvert peut être refacturé | Les crédits sont gratuits pendant la période d'accès de 14 jours, donc chiffrez le pilote au tarif plein |
| eesel | 1 crédit par ticket ou chat traité, à partir de 299 $/mois pour 500 | Tarif fixe par ticket, donc le coût par résolution durable baisse à mesure que la résolution s'améliore |
Pour le détail de Zendesk, voir Zendesk AI pricing ; Gorgias est détaillé dans Gorgias AI Agent pricing, et Freddy dans Freddy AI pricing.
Saisissez vos propres chiffres ici. Les valeurs par défaut montrent un résultat courant : un taux de résolution qui dépasse l'objectif, et un pilote qui échoue pourtant parce que les clients reviennent plus souvent qu'après une réponse humaine.
À quoi ressemblent de vraies données de pilote ?
Des données de pilote honnêtes sont plus irrégulières qu'une étude de cas. Voici quelques constats tirés de vrais essais sur eesel :
- La plupart des corrections précoces portent sur la connaissance, pas sur le modèle. Une analyse des lacunes de connaissance sur les erreurs de la première semaine est le moyen le plus rapide d'améliorer le chiffre de la deuxième. Dans l'essai du bijoutier, environ
65 %des modifications apportées par les agents aux brouillons concernaient la longueur et le ton, corrigeables en s'entraînant sur les réponses déjà envoyées par l'équipe. Environ20 %des modifications nécessitaient des données que l'IA n'avait pas encore (systèmes de commande et d'expédition), et seulement environ5 %corrigeaient une erreur factuelle. (Le taux d'erreur factuelle de7 %ci-dessus porte sur tous les brouillons ; cette répartition ne compte que les modifications.) - Les règles s'étoffent semaine après semaine. Stil Classics a son agent de rédaction sur Gorgias qui lit la commande Shopify avant d'écrire une ligne,
230consultations de commande pour320tickets en un mois, et ses instructions en sont à leur neuvième révision, chaque semaine de tickets ajoutant une règle. Un pilote est le moment où ces premières révisions ont lieu, alors donnez plus de poids à la dernière semaine qu'à la première. - Un essai court peut tout de même prouver quelque chose sur une voie étroite. Gridwise a configuré eesel sur Zendesk pendant un essai de 7 jours et a écrit ensuite : "In the first month, eesel is resolving 73% of our tier 1 requests." Remarquez la forme de cette affirmation : niveau 1, premier mois, après l'essai. C'est un chiffre circonscrit, ce qui le rend crédible.
Et l'avertissement de l'autre côté, venant d'une équipe SaaS qui a mesuré la mauvaise chose pendant un trimestre :
"We were excited about AI taking care of Level 1 support. The numbers looked great. Fifty percent of tickets were resolved without a human. Response times dropped to seconds, and support costs went down. Leadership loved the dashboard. Then Q3 renewal data came in. Net retention fell by 6 points."
Signer, prolonger ou arrêter : les règles de décision
Inscrivez ces trois règles dans le plan du pilote et faites-les valider par le fournisseur avant le premier jour. Cela change la conversation de fin, qui passe de « qu'en pensez-vous ? » à « dans quelle case est-il tombé ? »
- Arrêtez si un critère éliminatoire a échoué : une erreur critique ou une action erronée qui a atteint un client, ou un recontact pire que celui de la voie témoin. Demandez au fournisseur ce qui a changé pour l'empêcher, puis décidez si un second pilote en vaut la peine.
- Prolongez si les critères éliminatoires sont respectés mais qu'un objectif n'est pas atteint. Cela signifie généralement que la voie était trop étroite pour atteindre le volume, ou que les principales lacunes de connaissance n'ont pas été comblées (un audit de la base de connaissances aide ici). Deux semaines de plus, avec une liste écrite de ce qui change.
- Signez si les deux critères sont respectés et que les objectifs sont atteints sur des résolutions qui ont passé la vérification à 7 jours. Étendez ensuite un type de ticket à la fois, et gardez la même grille chaque mois après le lancement.
Le test que je préfère pour savoir si votre résultat est réel vient d'un opérateur sur Reddit :
"On a returns-triage agent we ran, the only number leadership cared about was human hours the process no longer consumed, measured before and after on the same queue. Same intake, fewer human hours per week, error rate no worse than baseline. Eval scores and resolution rates never moved them. Those are agent metrics. Execs stop trusting agent metrics after about a month. My rule of thumb now: if the vendor dashboard vanished tomorrow, could you still prove the value from your own systems? If yes, you have ROI. If no, you have a dashboard."
Deux points de contrat méritent d'être soulevés avant de signer, car le pilote vous aura montré pourquoi ils comptent : pouvez-vous exporter les données brutes des conversations (pas seulement le tableau de bord) si vous partez, et comment les résolutions sont-elles contestées quand une conversation « résolue » s'avère être un client qui a renoncé.
"The hour later example is what I'd put in the contract, because the hard part is the clock, not the words. Most vendor logs call that ticket closed and billable, since their resolution means their ticket status. So put the metric on events you can pull yourself, like a refund id or an appointment that stayed booked. Anything with no clean system event bills at base price only. Otherwise the agent just gets good at closing tickets."
Erreurs courantes dans un pilote IA
- Laisser le fournisseur choisir les types de tickets. Il choisira ceux où son IA est la meilleure. Choisissez ceux qui coûtent le plus de temps à votre équipe, comme les questions de suivi de commande.
- Comparer des fournisseurs sur des voies différentes. Si vous menez deux pilotes, utilisez les mêmes types de tickets et la même grille pour les deux, comme dans choosing an AI support agent.
- Piloter sur tous les canaux à la fois. Vous ne pourrez pas savoir si une mauvaise semaine venait du chat, de l'e-mail ou de la base de connaissances.
- Aucune référence. Si vous ne connaissez pas votre taux de recontact actuel ni votre coût par ticket, rien dans le pilote ne peut être comparé à quoi que ce soit. Récupérez les chiffres du dernier trimestre avant le premier jour. Le guide customer service KPIs explique comment.
- Corriger discrètement des problèmes en cours de pilote sans le noter. Corrigez-les, c'est le but. Mais consignez la date de chaque changement pour savoir quelles semaines correspondent à quelle configuration.
- Lire les résultats le dernier jour de l'essai. Les fenêtres de 72 heures et la vérification à 7 jours font que la dernière semaine n'est pas encore notée. Fixez la réunion de décision une semaine après la fin du pilote.
La liste plus longue des erreurs de déploiement se trouve dans AI customer service implementation mistakes.
Menez votre pilote de support IA avec eesel
eesel est un coéquipier IA qui rejoint votre helpdesk existant (Zendesk, Freshdesk, Gorgias, HubSpot et d'autres) et travaille la file comme une nouvelle recrue. Pour un pilote, trois choses facilitent le remplissage de la grille :
- Un score avant le premier ticket réel. Le Simulation skill rejoue vos vrais tickets passés, compare ses réponses avec ce que votre équipe a réellement envoyé et suggère des changements d'instructions. Il n'envoie rien aux clients.
- Mode brouillon et approbations par défaut. Il démarre avec chaque réponse en brouillon ou en note interne, et les actions comme les remboursements restent sur « Needs approval » jusqu'à ce que vous les changiez. Les approbations ne s'exécutent jamais seules après un délai.
- Un journal que vous pouvez auditer. La page Activity liste chaque ticket traité, ce qui a été recherché, chaque action, qui l'a approuvée et son raisonnement. Les tickets ignorés sont listés avec la raison, ce qui est exactement ce qu'il vous faut pour le critère des erreurs critiques.

La tarification est un forfait mensuel fixe où un ticket ou un chat vaut 1 crédit : gratuit pour 100 crédits sans carte, puis à partir de 299 $/mois pour 500 crédits. Le spam que vous lui dites d'ignorer ne compte pas. La ligne de coût de votre grille est donc simple à calculer, puisque vous ne payez pas par « résolution » telle que le fournisseur la définit. smava utilise eesel sur son Zendesk depuis décembre 2024, et sa configuration actuelle à trois agents, en production depuis juin 2026, traite 27 000 tickets par mois. Si vous êtes sur le point de lancer un pilote, essayez d'abord le forfait gratuit sur votre propre file et apportez le rapport de simulation à la comparaison des fournisseurs. Essayer eesel.
Comment calculer le coût par résolution dans un pilote IA ?