

Pourquoi « résolu par l'IA » veut dire cinq choses différentes
Je passe depuis deux ans du côté recherche du contenu de support, et le schéma dans ce que tapent les acheteurs est clair : ils demandent « qu'est-ce qu'un bon taux de résolution par l'IA ? » bien avant de demander « que compte mon fournisseur comme résolu ? ». La seconde question est celle qui compte, car le chiffre de votre tableau de bord n'est honnête que dans la mesure de sa définition.
Voici la cicatrice qui a appris cela à eesel. Lors d'un recoupement de 100 tickets sur la boîte Zendesk d'un détaillant allemand de bijoux en ligne (environ 1 000 tickets par mois), les brouillons de l'agent étaient justes dans la direction à 88 %, mais seulement 12 % ont été envoyés tels quels, et 7 % contenaient une erreur factuelle. Un seul chiffre de « précision » aurait caché les deux autres. La même boîte comptait 22 % de spam, c'est pourquoi la première question que je pose sur tout taux de résolution par l'IA cité est de savoir si le spam clos automatiquement y est inclus.
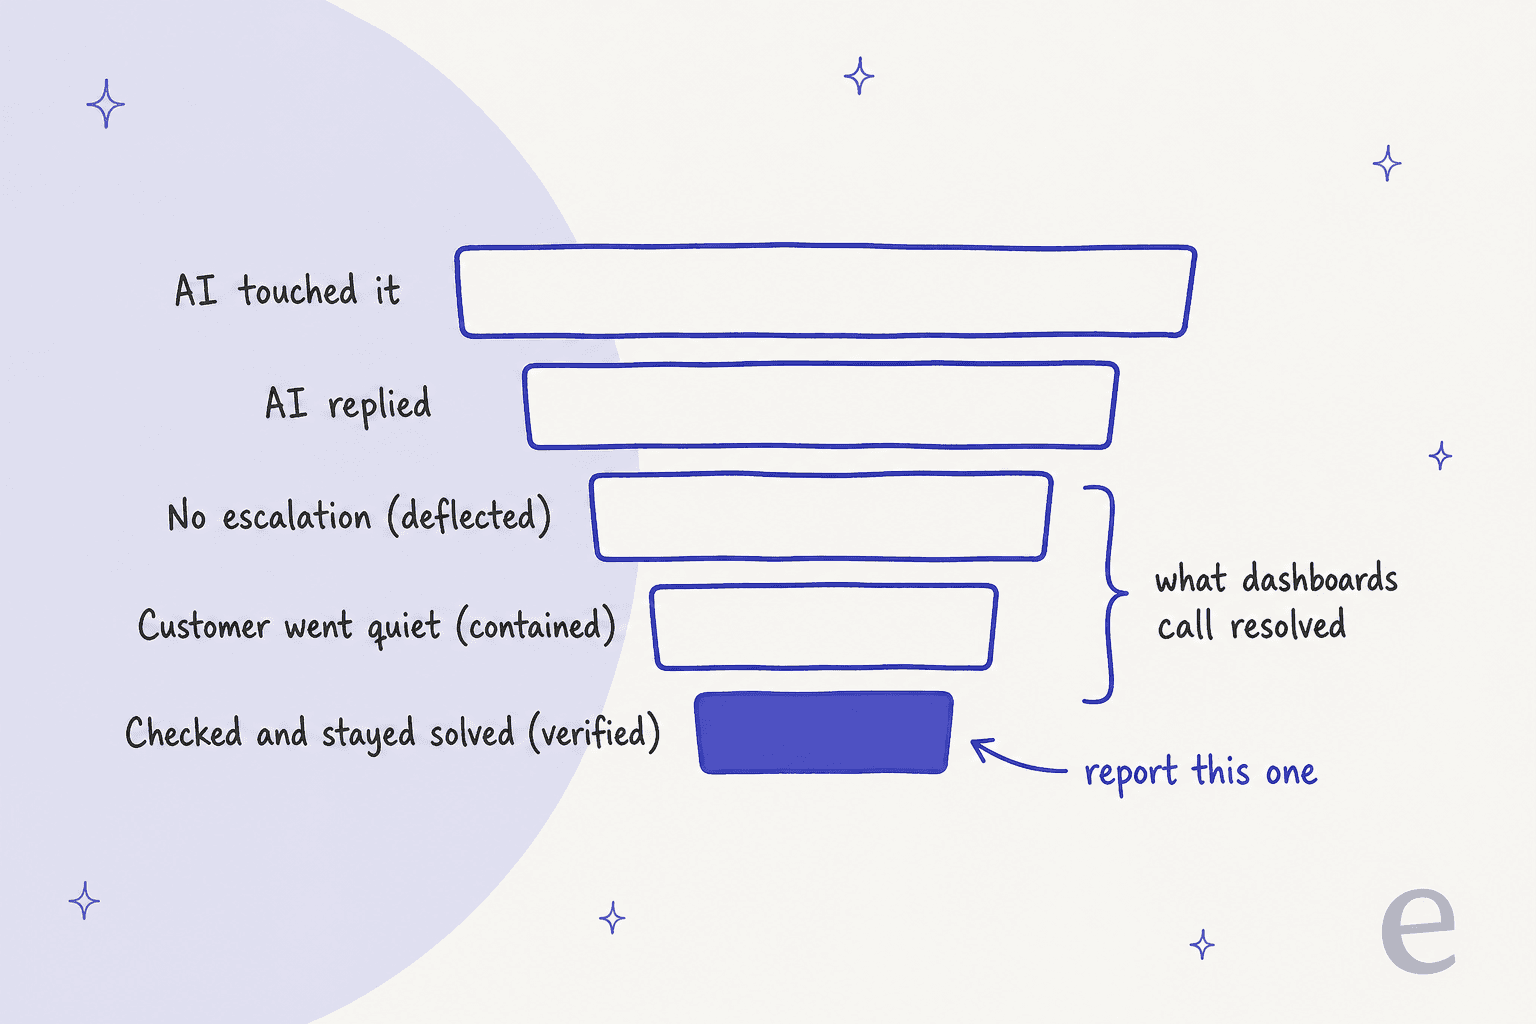
Chaque marche de cet entonnoir est une définition plus stricte, et chacune donne un chiffre plus petit :
- Touché : l'IA a vu la conversation. Gorgias appelle cela la couverture, HubSpot le handle rate.
- Répondu : l'IA a envoyé quelque chose. Facile à compter, ne dit rien du résultat.
- Dévié : personne n'a escaladé. La documentation même de Zendesk dit : « any conversation that doesn't end in escalation is considered deflected. »
- Confiné : le client s'est tu dans une fenêtre de temps. Se taire peut vouloir dire satisfait, ou avoir abandonné.
- Vérifié : quelque chose a contrôlé le résultat. Un modèle qui lit la transcription, un audit humain ou (le test le plus solide) aucun contact répété sur le même problème.
"execs loved our "automation success rate" - 40-something percent deflection, beautiful QBR slides. meanwhile i'm going through churn interviews and people are literally saying "i tried to get help and just gave up." that's not deflection, that's abandonment dressed up in a metric."

Si vous ne retenez qu'une chose : l'indicateur d'IA phare d'un fournisseur se situe généralement quelque part entre dévié et confiné, et l'écart entre cela et vérifié est l'endroit où votre CSAT fuit discrètement. Pour la liste plus large des chiffres du service client, je tiens un guide séparé sur les indicateurs du service client IA et sur les classiques KPI du service client.
Comment chaque helpdesk définit son indicateur d'IA
C'est la section que la plupart des articles sautent, et c'est celle qui décide si votre rapport signifie quelque chose. J'ai lu le centre d'aide et la page de tarifs de chaque fournisseur en octobre 2026. En bref : l'unité de facturation et l'indicateur phare sont généralement la même chose, ce qui vaut la peine d'être su avant de traiter cet indicateur comme neutre.
| Helpdesk | Nom de son « succès » IA | Ce qui compte | Fenêtre de temps | Ce que vous payez |
|---|---|---|---|---|
| Zendesk | Résolution vérifiée (l'un de trois niveaux) | Pas de relance du client, puis un LLM lit la transcription et confirme que c'était résolu | 2 heures en messagerie (jusqu'à 72), 72 heures en e-mail, à partir du premier message | $1.50 avec engagement, $2.00 en paiement à l'usage par résolution automatisée (tarifs) |
| Freshdesk (Freddy AI Agent) | Résolu / taux de déviation | « Conversations closed without human intervention » | Abandonnée après environ 24 heures sans réponse | $49 pour 100 sessions, facturées par session quel que soit le résultat (tarifs) |
| Gorgias | Interaction automatisée | Le client n'a pas besoin d'un humain sous 72 heures | 72 heures | $0.85 à $1.00 par interaction automatisée (tarifs) |
| HubSpot (customer agent) | Résolution | L'agent a partagé une source ou effectué une action, et aucun transfert initié par le visiteur | Fixé 72 heures après la dernière réponse du visiteur | 50 HubSpot Credits par conversation texte résolue |
| Salesforce (Agentforce) | Session déviée / résolution facturable | Session « ended by user », ou pour la facturation : 2+ échanges, retour final non négatif, pas d'escalade | Jusqu'à 2 heures par résolution de chat | $2 par conversation, ou Flex Credits à $500 pour 100 000 (tarifs) |
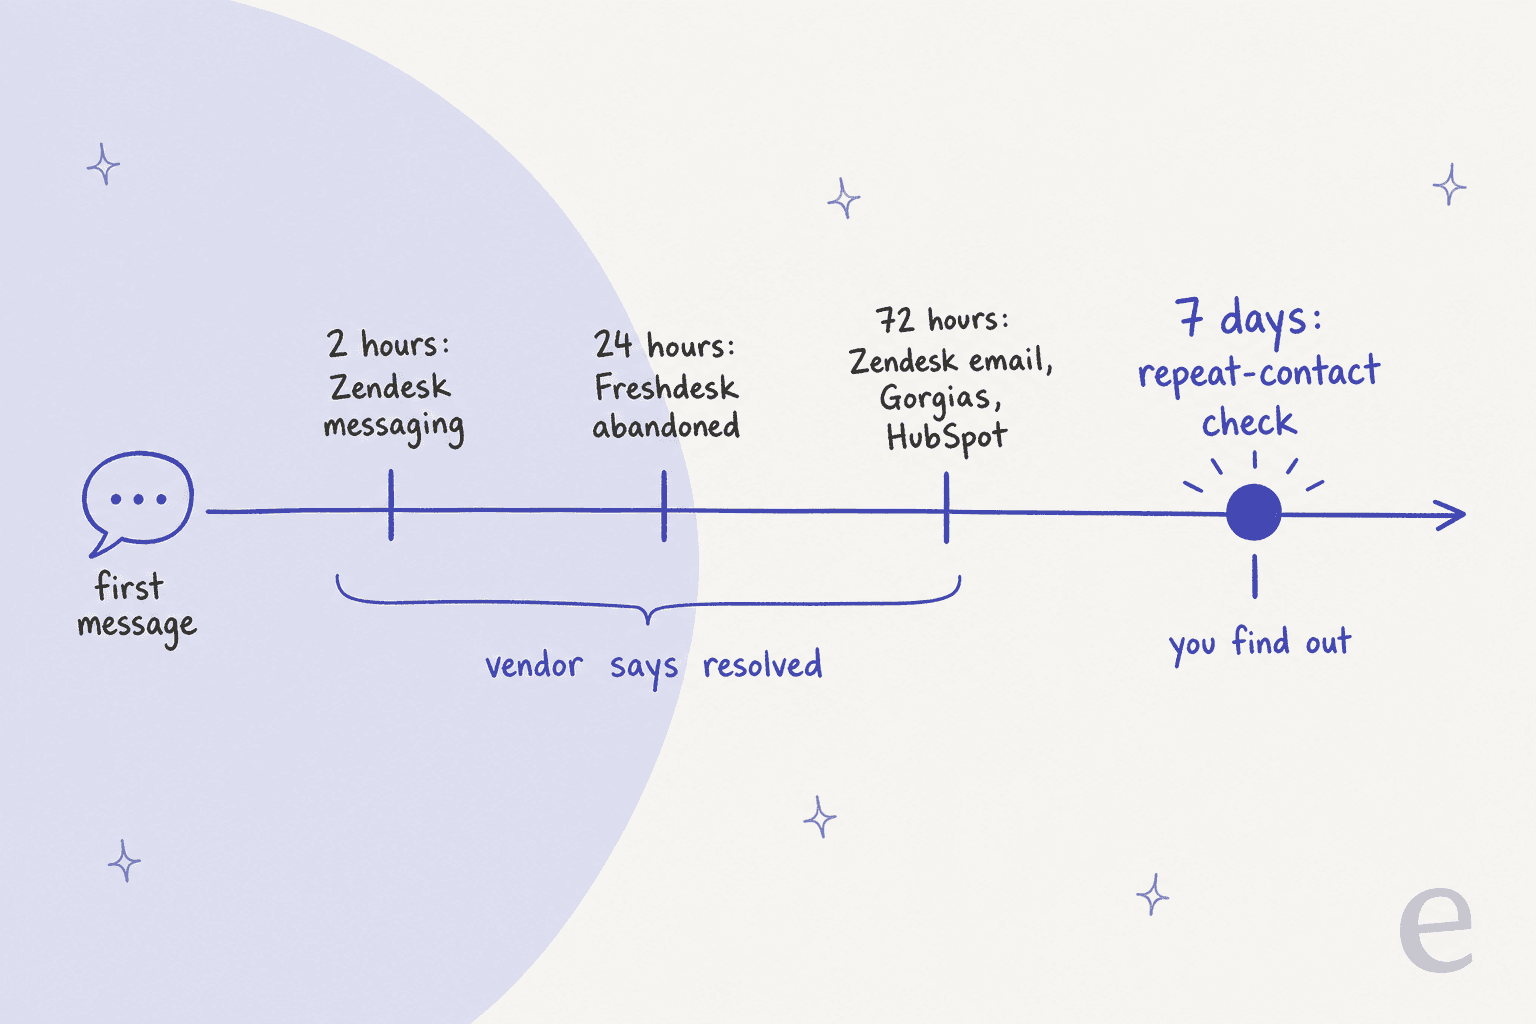
La chronologie est ce qui m'a le plus surpris. Chaque fournisseur décide de « résolu » en trois jours. Un client qui réécrit au jour quatre à propos de la même commande défectueuse apparaît comme une toute nouvelle conversation, et la première reste un succès. C'est pourquoi les tickets de support répétés ont leur place dans tout tableau de bord IA.
"The last one in the absence of feedback is only a very weak proxy for a resolved issue. If you consider customer support a cost center, you can guess how managers would optimize these numbers."

Zendesk : trois niveaux, et un seul est facturé
Depuis le 18 mai 2026, Zendesk répartit chaque résolution automatisée en trois niveaux. Escalade assistée signifie que l'IA a aidé mais qu'un humain a terminé. Résolution contenue signifie que le client n'a pas demandé de précision, ni donné de retour, ni demandé un humain, mais que la conversation a échoué au contrôle du LLM. Résolution vérifiée signifie qu'elle l'a réussi. Seules les résolutions vérifiées comptent dans votre quota.
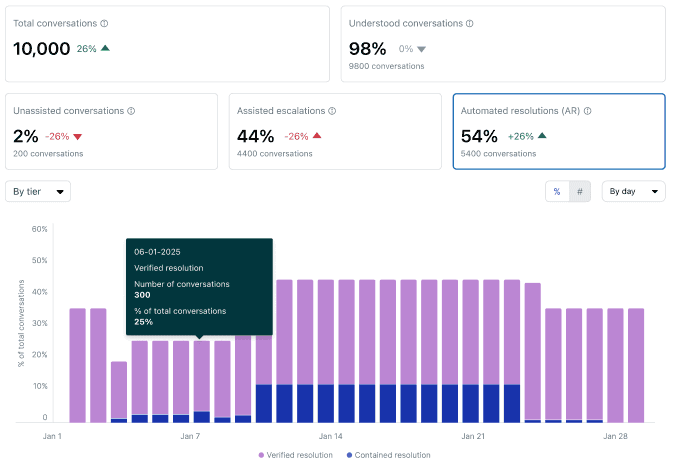
C'est une conception honnête, et c'est ce qui se rapproche le plus de « vérifié » chez un helpdesk. Trois choses à savoir avant de le citer à votre hiérarchie :
- La vérification est un modèle qui lit la transcription. Aucune étape de revue humaine n'est décrite.
- La fenêtre démarre au premier message, donc en messagerie le contrôle par défaut s'exécute 2 heures plus tard.
- Les résolutions sont « counted per conversation rather than per user », et les rapports actuels de l'agent IA n'ont ni indicateur de réouverture ni de contact répété. L'ancien « non-reopened resolution rate » n'existe que dans le jeu de données hérité.
Les acheteurs contestent les règles de comptage depuis un moment. Avant l'existence des niveaux, un administrateur Zendesk qui évaluait les tarifs écrivait :
"We're also finding the "resolution" logic really unclear, especially when a user clicks something passively (like "Yes" on an article) and it still counts as a full resolution. It feels risky to commit when the billing metric isn't tightly tied to actual customer outcomes."
Le niveau vérifié est un vrai pas vers la correction de ce problème. Le taux de résolution de Zendesk, ce sont les résolutions automatisées divisées par toutes les conversations, selon sa référence des indicateurs. Son CSAT de l'IA s'appelle BSAT : la part des notes 4 et 5 sur une échelle de 1 à 5, en messagerie uniquement. Un détail compte pour votre lecture. D'après la documentation du BSAT, les demandes de BSAT envoyées par un trigger « aren't sent for conversations that were escalated to a human agent. » Le BSAT note donc surtout les conversations qui s'étaient déjà bien passées.
J'ai couvert les tableaux de bord eux-mêmes dans analytique de l'agent IA Zendesk et le calcul de facturation dans tarifs Zendesk AI.
Freshdesk : surveillez où atterrissent les conversations abandonnées
L'AI Agent Studio de Freshdesk rapporte un entonnoir : Total, Unresolved, Escalated, Abandoned, Resolved, Closed. « Resolved » signifie « conversations closed without human intervention », et une conversation sans réponse pendant environ 24 heures est classée abandonnée. À son crédit, Freshdesk signale un taux de déviation « below 60% for a high-volume topic » comme un signal d'alerte, et avertit qu'un nombre en hausse n'est pas un taux en hausse.
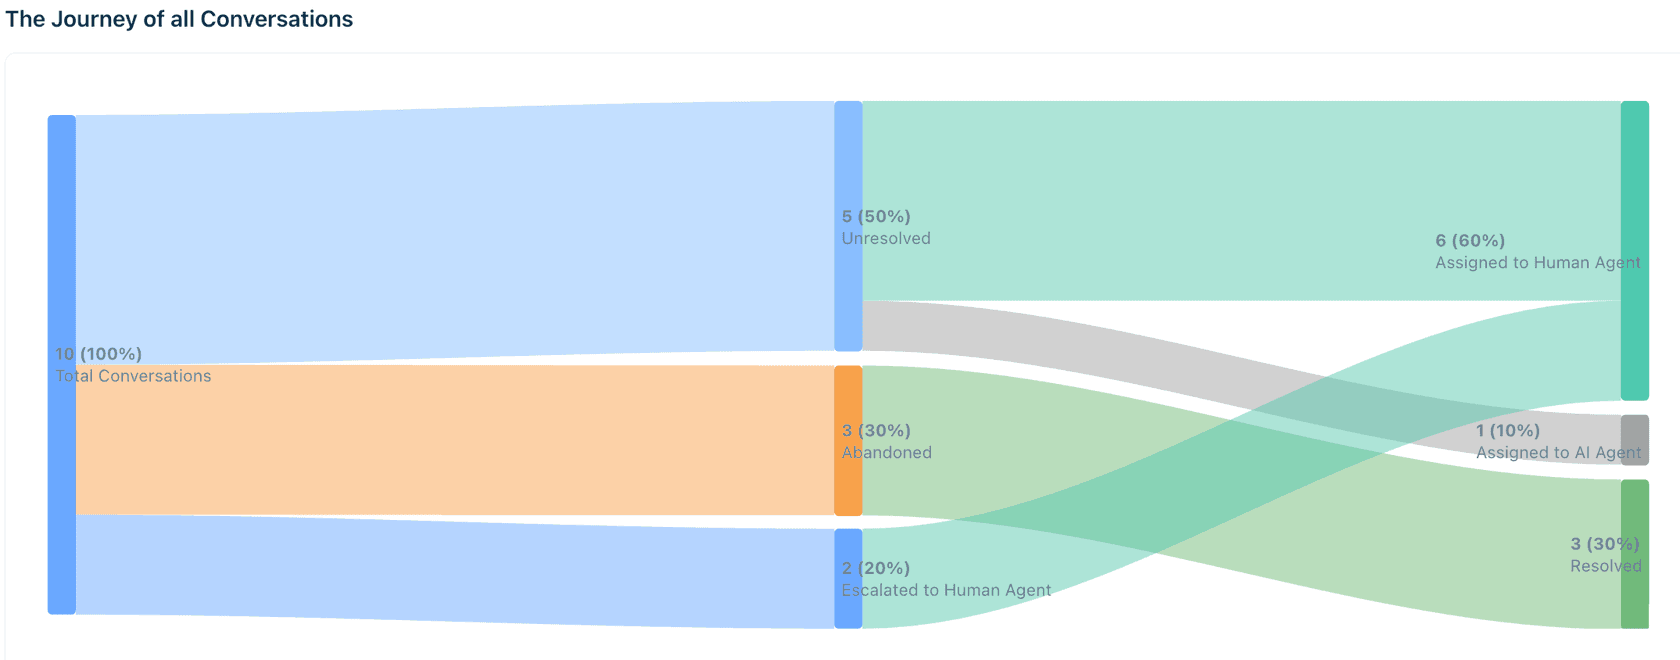
Regardez bien le graphique d'exemple dans la documentation même de Freshdesk : les 3 conversations abandonnées coulent dans la colonne Resolved à droite. C'est le problème du confinement en une image. L'agent e-mail est encore plus lâche, puisque sa tendance de déviation peut inclure « a ticket being closed by a human agent after the customer read an answer without further interaction. »
Le CSAT de l'IA de Freddy est un retour par pouces, pas une enquête, et je n'ai trouvé aucun indicateur de contact répété pour l'agent IA. La facturation est par session (« all interactions... within a 24-hour window », 72 heures en e-mail, selon la FAQ des sessions), donc votre coût par résolution est la dépense totale en sessions divisée par les conversations résolues, pas $0.49. Plus de détails sur le produit dans mon analyse des agents Freddy AI et dans le guide des tarifs Freddy AI.
Le benchmark 2026 de Freshworks, construit sur 33 889 comptes et 1,2 milliard de tickets d'après son rapport de benchmark, indique que « AI agents are delivering an average deflection rate of 83%. » C'est un vrai chiffre issu d'un grand jeu de données, mais les pages publiques ne définissent pas la déviation et ne publient aucun chiffre de contact répété ni de CSAT de l'IA à côté. Considérez-le comme un benchmark de déviation, pas de résolution.
Gorgias : le chiffre du tableau de bord est celui de la facture
Gorgias compte une interaction automatisée quand « the customer does not require the involvement of a human agent within 72 hours. » Son glossaire des indicateurs est l'un des plus clairs que j'aie lus :
- Automation rate = interactions automatisées divisées par toute la charge facturable (tickets automatisés plus tickets traités par des humains), spam exclu.
- Coverage rate = la part des tickets que AI Agent a « resolved, handled, or handed over ».
- Success rate = interactions IA facturables divisées par tous les tickets traités par AI Agent, transferts inclus.
- CSAT de l'IA = la moyenne de l'enquête de 1 à 5 sur tout ticket où AI Agent a envoyé au moins une réponse, y compris les transférés. C'est une lecture plus juste qu'une enquête envoyée seulement après les succès nets.
Deux choses à garder en tête. Selon la tarification actuelle, un ticket que l'IA résout entièrement peut porter à la fois des frais de ticket et des frais d'automatisation. Et la carte « coût économisé » suppose $3.10 de coût humain par ticket en plus de vos frais de ticket, ce qui peut correspondre ou non à votre équipe. Si vous êtes sur Gorgias, mon guide d'analytique Gorgias et l'analyse des tarifs Gorgias AI Agent vont plus loin.
HubSpot : le seul fournisseur qui le dit à voix haute
Le customer agent de HubSpot compte une résolution quand il a partagé une source de contenu ou effectué une action « and there is no qualifying handoff », avec le statut défini 72 heures après la dernière réponse du visiteur. Seuls comptent les transferts initiés par le visiteur. Un agent qui réassigne le ticket, ou un workflow qui le fait, n'empêche pas qu'il compte comme résolu.
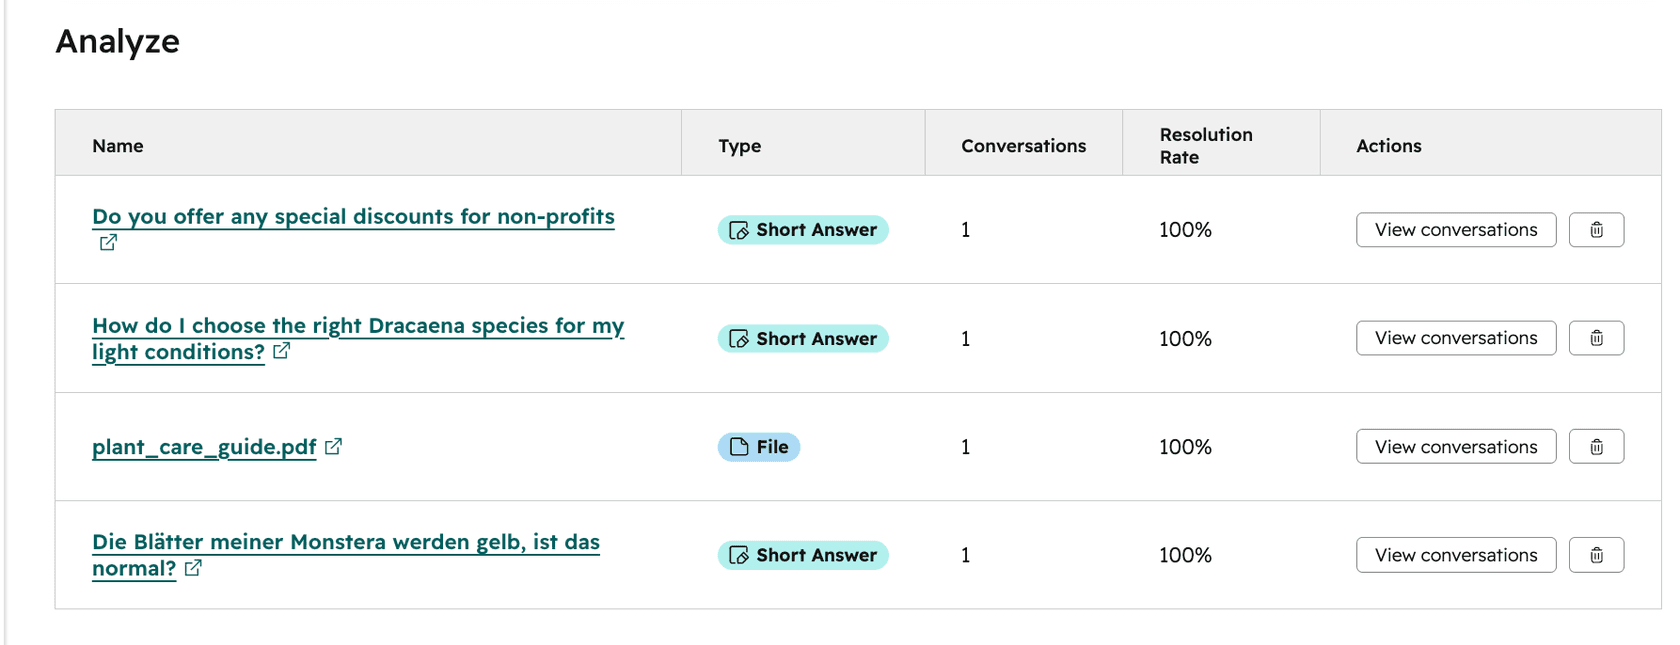
La capture ci-dessus rappelle bien qu'un taux de 100 % sur une conversation n'est pas une conclusion. Le volume d'abord, le taux ensuite.
La phrase que j'épinglerais au-dessus de chaque tableau de bord IA vient de la documentation de performance de HubSpot elle-même : « Deflections do not always indicate resolution. For example, if the customer agent was unable to answer a question, the customer may have left the chat without requesting a human agent. » HubSpot facture aussi à la résolution en HubSpot Credits, et si un client répond à un fil d'e-mails après 72 heures, la conversation est rouverte et « additional credits are consumed » si elle est de nouveau résolue. L'article sur le Breeze customer agent couvre la configuration.
Salesforce : déviation et résolution séparées
L'Agent Analytics d'Agentforce définit une session déviée comme une session « ended by user (not by escalation or abandonment) », et garde à part un Task Resolution Rate jugé par un modèle. Cette séparation est le bon réflexe. La facturation est plus stricte que la déviation : une résolution facturable exige au moins deux échanges, un retour final « not explicitly negative » et aucune escalade, avec une résolution de chat plafonnée à 2 heures. Voir tarifs Agentforce pour la grille complète.
L'enquête de Salesforce auprès de 3 075 professionnels du service a révélé que l'adoption des agents IA est passée de 39 % à 66 % de 2025 à 2026, la satisfaction client étant classée « #1 improved KPI ». Ce sont des réponses déclaratives d'équipes de service, pas un CSAT client mesuré, ce qui est précisément pourquoi votre propre mesure compte.
Les indicateurs d'IA pour le CX qui montrent que ça marche
Alors, que suivre ? Voici l'ensemble que j'utiliserais, avec la formule, car un indicateur sans formule n'est qu'une impression. L'argumentaire détaillé de chacun se trouve dans des articles sur le CSAT de l'IA, le confinement et la qualité d'escalade et la résolution au premier contact par l'IA.
Taux de résolution vérifiée (l'étoile polaire)
Formule : conversations que l'IA a closes, moins celles revenues sur le même problème sous 7 jours, moins celles qui ont quand même atteint un humain, moins le spam et les clôtures « merci ! », divisées par toutes les conversations que l'IA a touchées.
Prenez le niveau le plus strict de votre fournisseur comme point de départ (le niveau vérifié de Zendesk, la task resolution de Salesforce), puis soustrayez vous-même les contacts répétés. Présentez-le à côté du chiffre du fournisseur, jamais à sa place, pour que personne ne pense que vous cachez le plus flatteur.
Contact répété sous 7 jours
Formule : conversations résolues par l'IA où le même client ouvre une nouvelle conversation sur le même sujet sous 7 jours, divisées par les conversations résolues par l'IA.
C'est le garde-fou qu'aucun fournisseur ne propose. Croisez par e-mail ou identifiant client plus étiquette de sujet. S'il monte pendant que votre taux de résolution monte, l'IA clôt des choses qu'elle n'a pas réglées.
"Don't track deflection without tracking subsequent contact. A bot might "successfully" complete a chat, but if the user submits an email ticket 20 mins later – that bot was trash. You have to analyze repeat contact rates to get true transparency."
Notez le changement de canal dans cet exemple. Un contrôle de répétition qui ne regarde que le même ticket rate le client qui abandonne le chat et écrit par e-mail, alors croisez par client, pas par ticket.
Qualité du transfert
Formule : conversations escaladées où l'humain n'a pas eu à redemander des informations que le client avait déjà données, divisées par toutes les escalades. Suivez aussi le temps de réponse humain après le transfert (Gorgias le rapporte nativement).
Un faible taux d'escalade n'est pas l'objectif. Une escalade propre l'est. Les clients pardonnent bien plus facilement « je vous passe quelqu'un » que de devoir se répéter. Mes notes sur le transfert d'agent IA couvrent ce que contient une bonne note de synthèse.
Précision contrôlée par des humains
Formule : sur un échantillon aléatoire de conversations résolues par l'IA (j'en prends 50 par semaine), la part qu'une personne juge entièrement correcte, avec zéro erreur de politique.
La vérification par LLM et les boutons pouce levé sont utiles, mais une personne qui lit un échantillon aléatoire est le seul contrôle qui détecte une mauvaise réponse énoncée avec assurance que le client a crue. Répartissez les erreurs par gravité et appliquez un seuil plus strict aux remboursements, aux prix et aux modifications de compte. Une séance de calibrage QA du support garde les relecteurs cohérents, et assurance qualité du support IA couvre les outils.
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer..."
A CX lead handling about 7,000 tickets a month, on an eesel sales call
C'est l'argument en faveur de l'échantillonnage. Personne ne lit 7 000 tickets, mais tout le monde peut en lire 50, et 50 au hasard révèlent les tendances. Un développeur sur Hacker News a appris la même chose à la dure :
"our dashboard only tracked immediate task completion, and had no idea a cheaper model had quietly produced a worse answer that the customer reopened a week later."
CSAT de l'IA, à lire avec prudence
Trois choses différentes sont vendues comme du CSAT de l'IA, et elles ne sont pas interchangeables :
| Type | Qui note | Où le voir | Points d'attention |
|---|---|---|---|
| Note d'enquête | Le client, de 1 à 5 | Zendesk BSAT, Gorgias Average CSAT | Qui est interrogé (Zendesk saute les chats escaladés) et le taux de réponse |
| Retour par pouces | Le client, oui ou non | Freddy, part « helpful » de HubSpot, nombres de retours Salesforce | Échantillons minuscules, les clients en colère ne répondent pas |
| Qualité notée par un modèle | Une IA qui note l'IA | Salesforce Quality Score, CSAT de l'IA d'eesel | Ce n'est pas du tout un retour client |
Indiquez toujours le taux de réponse à l'enquête à côté de la note. Une note de 90 % sur 4 % des conversations dit très peu.
Taux de lacunes de connaissances
Formule : conversations où l'IA n'avait pas la connaissance pour répondre, divisées par toutes celles qu'elle a touchées, ventilées par sujet.
C'est l'indicateur le plus utile pour réellement améliorer l'agent, car il désigne l'article que vous devez écrire. Une lacune croissante sur un sujet est une liste de tâches. Voir analyse des lacunes de connaissances du support pour savoir comment la mener.
Coût par résolution vérifiée
Formule : coût total d'IA du mois (licence plus usage) divisé par les résolutions vérifiées, pas par celles qui sont déclarées.
La tarification à la résolution fait ressembler le chiffre déclaré à votre coût par résultat, mais ce n'est plus le cas une fois les répétitions et les faux succès retirés. Coût par résolution le compare au traitement humain.
Calculez votre vrai taux de résolution
Saisissez dans le calculateur ci-dessous les chiffres du mois dernier de votre helpdesk. Il retire les « résolutions » qui n'en étaient pas et réévalue le reste.
Saisissez votre propre mois : conversations touchées, résolutions déclarées et les trois types qui ne tiennent pas. Le taux vérifié et le coût se mettent à jour pendant que vous tapez.
Avec les chiffres par défaut, un taux de tableau de bord de 50 % devient environ 34 % vérifié, et chaque vrai résultat coûte environ 1,5 fois ce que le tableau de bord laisse entendre. Ce ratio est le chiffre que j'apporterais à une discussion de renouvellement. Pour l'argumentaire économique plus large, mon guide pour mesurer le ROI du support IA détaille le reste.
Un tableau de bord avec des garde-fous
Un chiffre unique se fait contourner, même sans que personne le veuille. Réglez l'agent pour qu'il clôture davantage et il clôturera davantage, y compris des choses qu'il ne devrait pas. Associez donc l'étoile polaire à des garde-fous qui bougent dans le mauvais sens quand cela arrive.
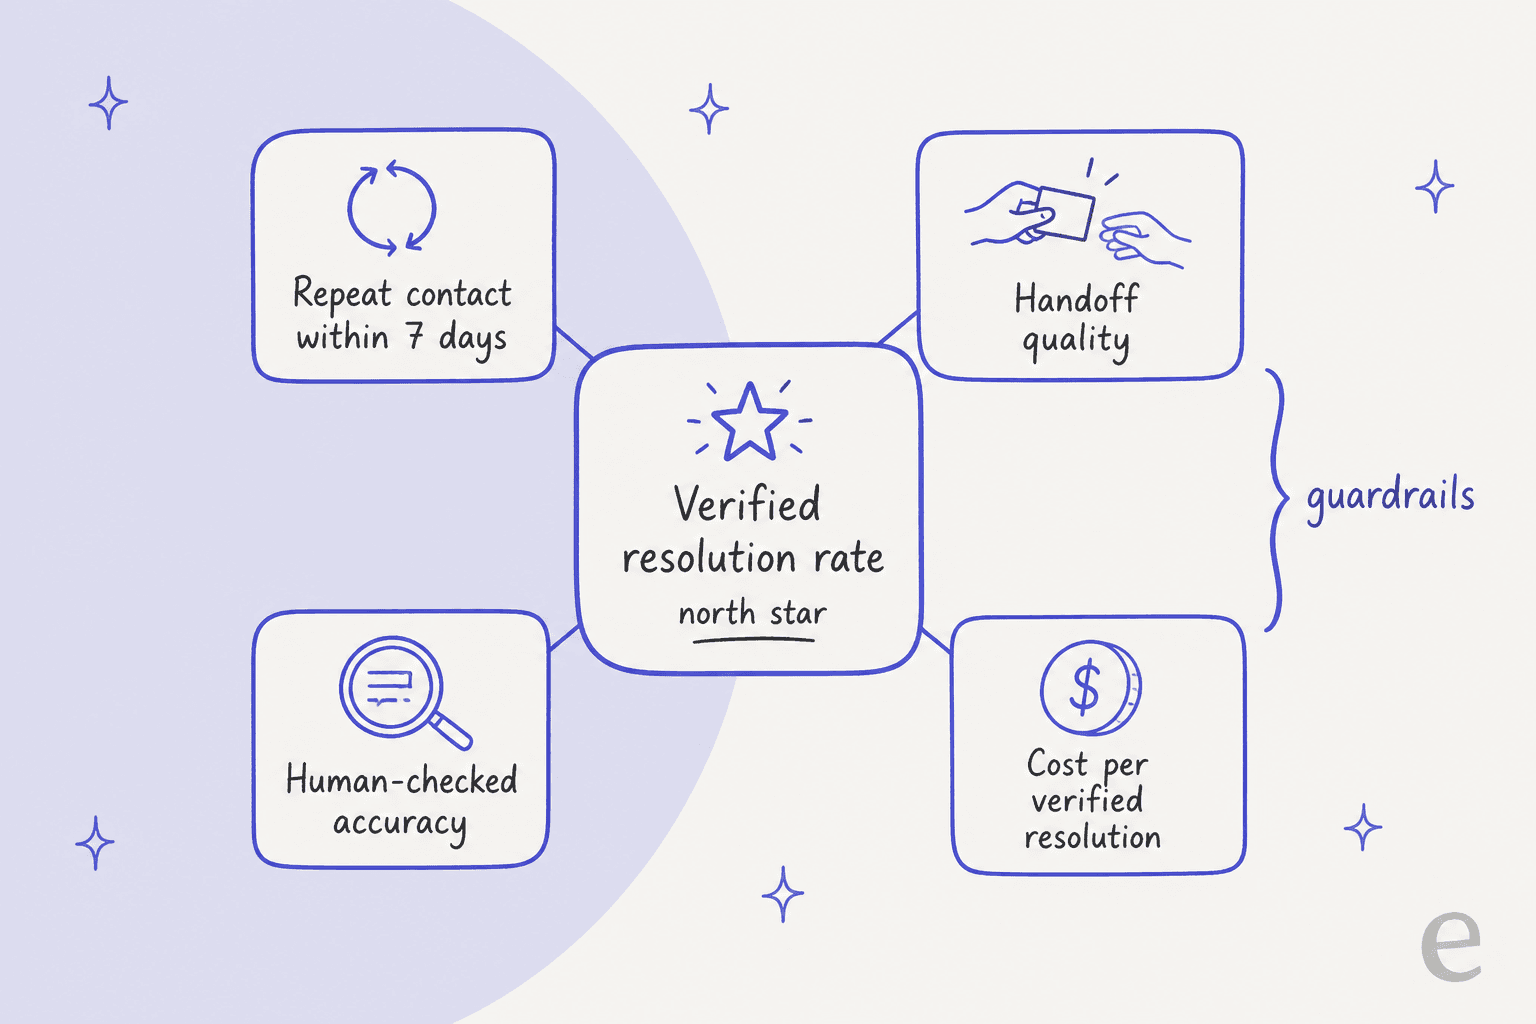
Voici le tableau de bord dont je partirais. Les cibles sont mes points de départ, pas des benchmarks du secteur, donc fixez les vôtres après le premier mois de données.
| Indicateur | Formule | Garde-fou de départ | À vérifier |
|---|---|---|---|
| Taux de résolution vérifiée | Closes, non répétées, non escaladées, hors spam / toutes les touchées | En hausse d'un mois à l'autre | Chaque semaine |
| Taux de résolution du fournisseur | La définition propre à votre helpdesk | À présenter à côté du vérifié, jamais seul | Chaque semaine |
| Contact répété sous 7 jours | Même client, même sujet, nouvelle conversation / résolues par l'IA | Ne doit pas monter quand le taux de résolution monte | Chaque semaine |
| Qualité du transfert | Escalades sans redemande / toutes les escalades | Au-dessus de 90 % | Échantillon mensuel |
| Précision contrôlée par des humains | Entièrement correctes / échantillon aléatoire de 50 résolutions IA | Zéro erreur sur les remboursements, les prix, les modifications de compte | Chaque semaine |
| CSAT de l'IA (enquête) | Notes de 4 à 5 / toutes les notes, avec taux de réponse | À quelques points du CSAT humain sur les mêmes sujets | Chaque mois |
| Taux de lacunes de connaissances | Conversations sans connaissance / toutes les touchées, par sujet | En baisse sur vos 5 principaux sujets | Chaque semaine |
| Coût par résolution vérifiée | Coût total d'IA / résolutions vérifiées | Sous votre coût humain par ticket | Chaque mois |
Ventilez chaque ligne par sujet et par canal. Une moyenne sur tous les sujets cache le parcours qui échoue à chaque fois, et un sujet remboursement à 40 % vérifié à côté d'un sujet suivi de colis à 90 % vous dit exactement où travailler. L'article sur le modèle de tableau de bord analytique propose une mise en page que vous pouvez copier.
"This is a management / measurement issue, not a tooling issue. Specifically, it's an offshoot of Goodhardt's Law: a metric that becomes a target ceases to become a good metric (because the business will solve for the target to its detriment). The solution is to pair Deflection Rate with a strong guardrail metric"
À quoi cela ressemble sur une vraie file
Les témoignages clients rendent concret l'écart entre « répondu » et « résolu », car eesel les rapporte séparément.
Question Beauty utilise eesel sur Gorgias et Shopify. Entre le 8 août et le 8 septembre 2026, l'agent a traité environ 990 tickets et envoyé environ 960 réponses, mais seulement environ 280 tickets ont été clos par eesel et environ 250 ont été assignés à une personne. Si l'on compte les réponses, cela ressemble à 97 % d'automatisation. Si l'on compte les clôtures, on est plus près de 28 %. Les deux sont vrais, et un seul est un résultat.
Swiftreg, qui vend des plaques d'immatriculation personnalisées au Royaume-Uni, montre le côté précision. Le même mois, eesel a traité environ 2 100 tickets Zendesk, envoyé 1 494 réponses publiques et laissé 1 055 notes internes là où une étape revenait au personnel. Les consultations de commandes passent par des scripts que Swiftreg a écrits, et un validateur contrôle chaque réponse par rapport à ces résultats avant tout envoi. C'est de la précision contrôlée par des humains intégrée au flux de travail plutôt que greffée après coup.
ClutchLoop est la version à périmètre étroit : l'agent répond seul uniquement aux retours et aux questions produit, et a envoyé environ 180 réponses directement sur environ 230 tickets Gorgias, « about seven in ten conversations, no person needed. » Le périmètre est aussi une décision d'indicateur. Un ensemble plus restreint de sujets que l'IA maîtrise de bout en bout est plus facile à vérifier qu'un grand ensemble qu'elle traite à moitié.
Comment eesel rapporte la performance de l'IA
Je serai franc sur la façon dont eesel procède, puisque c'est le produit sur lequel je travaille. La page Reports affiche le volume, le CSAT de l'IA, les lacunes de connaissances et les approbations, et la documentation dit clairement que « AI CSAT is not customer feedback. It is an AI's rating of your agent's answers. » J'aime qu'elle le dise, car cela évite qu'une note de modèle passe pour une note client.
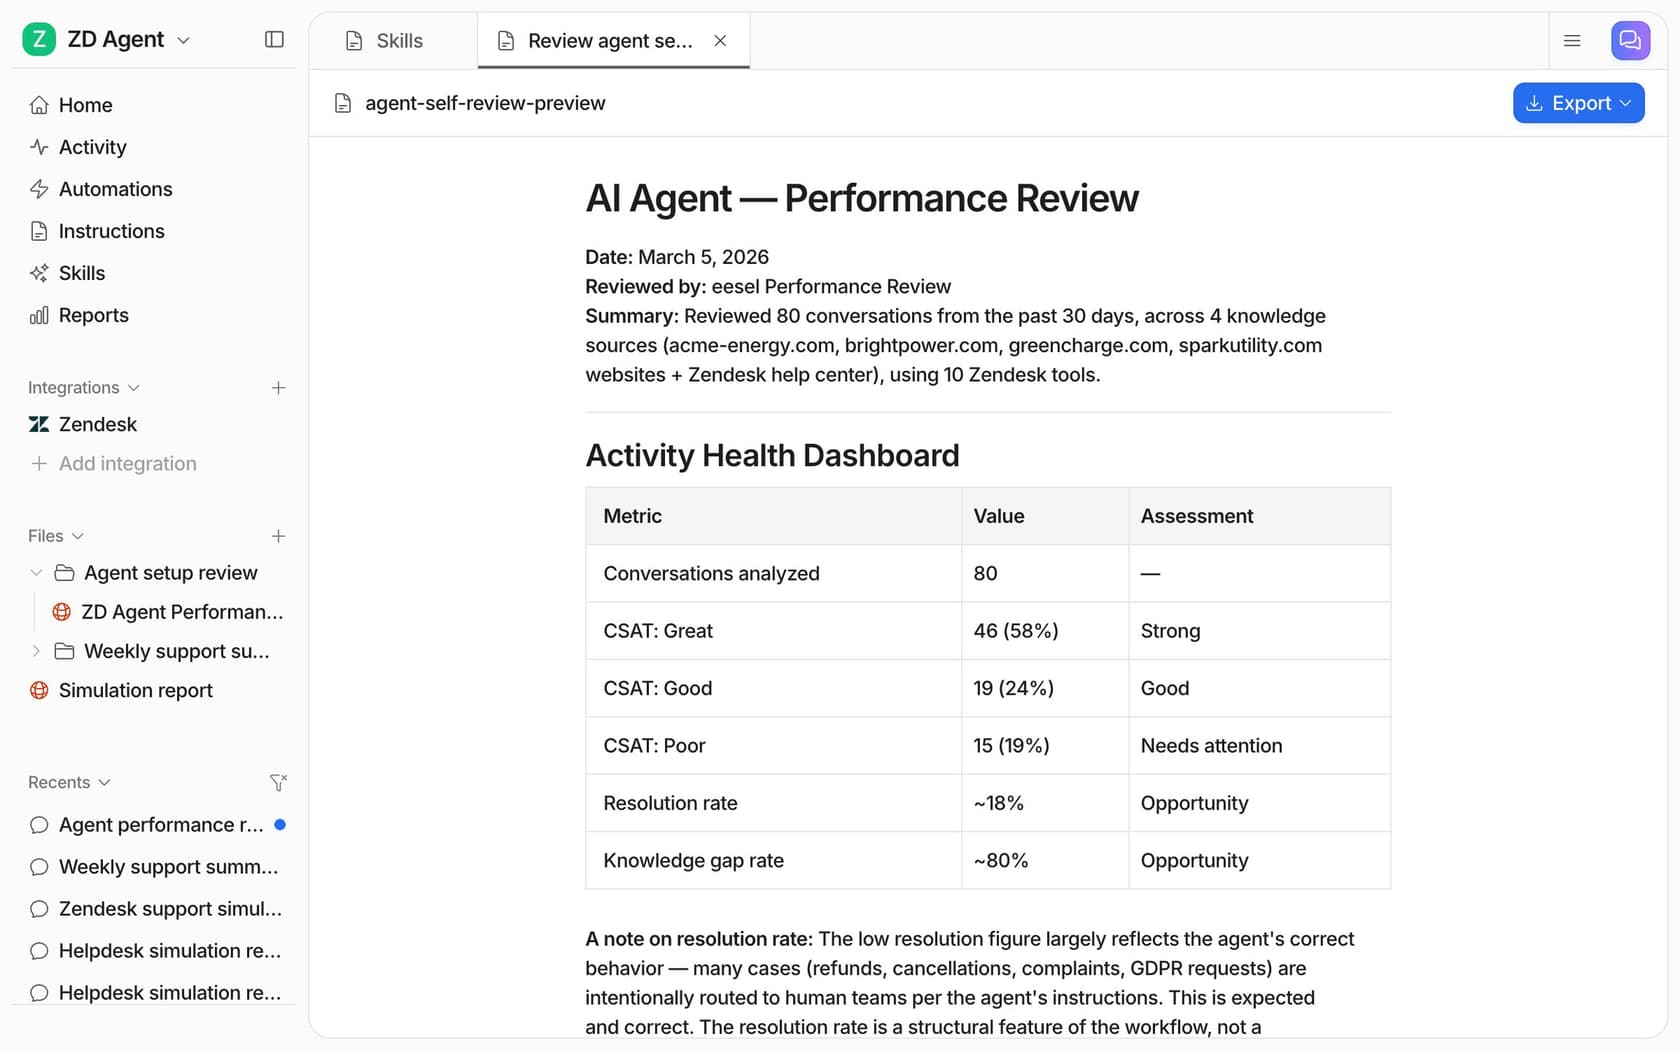
Vous pouvez aussi demander à l'agent une revue de performance dans le chat, et il en rédige une avec les chiffres d'abord, puis les correctifs classés. Dans le rapport de démonstration ci-dessus, le taux de résolution est d'environ 18 %, et le rapport explique que les remboursements, les annulations et les réclamations ont été orientés vers des personnes volontairement. Un taux bas avec les bons transferts vaut mieux qu'un taux élevé qui devine.
Deux autres éléments correspondent directement au tableau de bord :
- Simulation avant la mise en production. La compétence Simulation « runs your agent against real past tickets or generated test cases, scores each answer, and suggests instruction changes. » C'est de la précision contrôlée, exécutée sur votre propre historique, avant qu'un client ne voie quoi que ce soit.
- Les approbations comme indicateur de graduation. Selon la documentation des rapports, « an action approved every time without edits is ready to run on its own. » Commencez en mode brouillon, observez les taux d'approbation par sujet et n'activez que les sujets qui le méritent.
Côté coût, les tarifs d'eesel sont un forfait mensuel fixe où « a ticket or a chat is 1 credit », à partir de 299 $ par mois pour 500 crédits. Il facture les tickets traités, pas les résolutions, donc la facture ne dépend pas de ce qui est étiqueté résolu. Le compromis est simple : vous payez un ticket même quand l'agent le transmet à une personne, donc le coût par résolution vérifiée reste le chiffre à surveiller.
Essayer eesel
Si votre tableau de bord IA rapporte de la déviation et que vous avez besoin de résolutions vérifiées, eesel fonctionne dans le helpdesk que vous avez déjà, sur Zendesk, Freshdesk, Gorgias ou HubSpot. Il rejoue vos anciens tickets dans une simulation avant la mise en production, commence par rédiger des brouillons pour votre équipe et indique séparément ce qu'il a envoyé, clos et transmis.

Le forfait gratuit inclut 100 crédits, de quoi voir de vrais brouillons sur vos propres tickets avant de payer. Essayez eesel et comparez les chiffres à votre propre file.
Comment Zendesk mesure-t-il les résolutions des agents IA ?