

Pourquoi « résolu » ne veut pas dire « juste »
Je travaille sur la recherche chez eesel depuis deux ans, et peu de sujets du support portent autant d'intention d'achat que celui-ci. Personne ne cherche « how to train AI on past tickets » par curiosité. On le cherche parce qu'on est assis sur des années d'historique de helpdesk et qu'on vient de comprendre que c'est la trace la plus détaillée de la façon dont son équipe travaille. Entraîner une IA sur d'anciens tickets est aussi la demande qui revient le plus régulièrement dans les propres appels commerciaux d'eesel.
Mais il y a un hic. Le statut d'un ticket dit que la conversation s'est terminée. Il ne dit pas que le client a reçu la bonne réponse, que la politique citée est toujours en vigueur, ni que la réponse ressemblait à l'agent que vous voudriez cloner. Beaucoup de tickets « résolus » ont été fermés par une règle de fermeture automatique, rouverts une semaine plus tard ou traités par quelqu'un dans son premier mois.
La bonne nouvelle, c'est que l'historique enseigne justement ce que l'IA fait le moins bien d'emblée : ressembler à votre équipe. Lors d'un essai eesel, une marque de bijoux e-commerce traitant environ 1 000 tickets par mois sur Zendesk et Shopify, les agents n'ont envoyé tels quels que 12% des brouillons de l'IA. Quand l'équipe a cherché pourquoi, environ les deux tiers des réécritures portaient sur la longueur et le ton, transformant de longs brouillons en réponses d'une à trois phrases, tandis qu'environ 5% seulement corrigeaient un fait erroné. C'est exactement l'écart que comble un ensemble trié des réponses envoyées par votre propre équipe.
Le travail n'est donc pas « entraîner l'IA sur d'anciens tickets ». C'est « apprendre à l'IA à partir de vos meilleurs anciens tickets, et garder le reste dehors ». C'est ce que parcourt ce guide, en six étapes. Si vous cherchez encore à déterminer de quelles données vous avez besoin en général, commencez par les données dont vous avez besoin pour entraîner une IA, puis revenez.
Ce qu'un seul ancien ticket peut apprendre à une IA
Avant d'exporter quoi que ce soit, il est utile de voir qu'un ticket enseigne plusieurs choses différentes, et que chaque leçon a sa place.
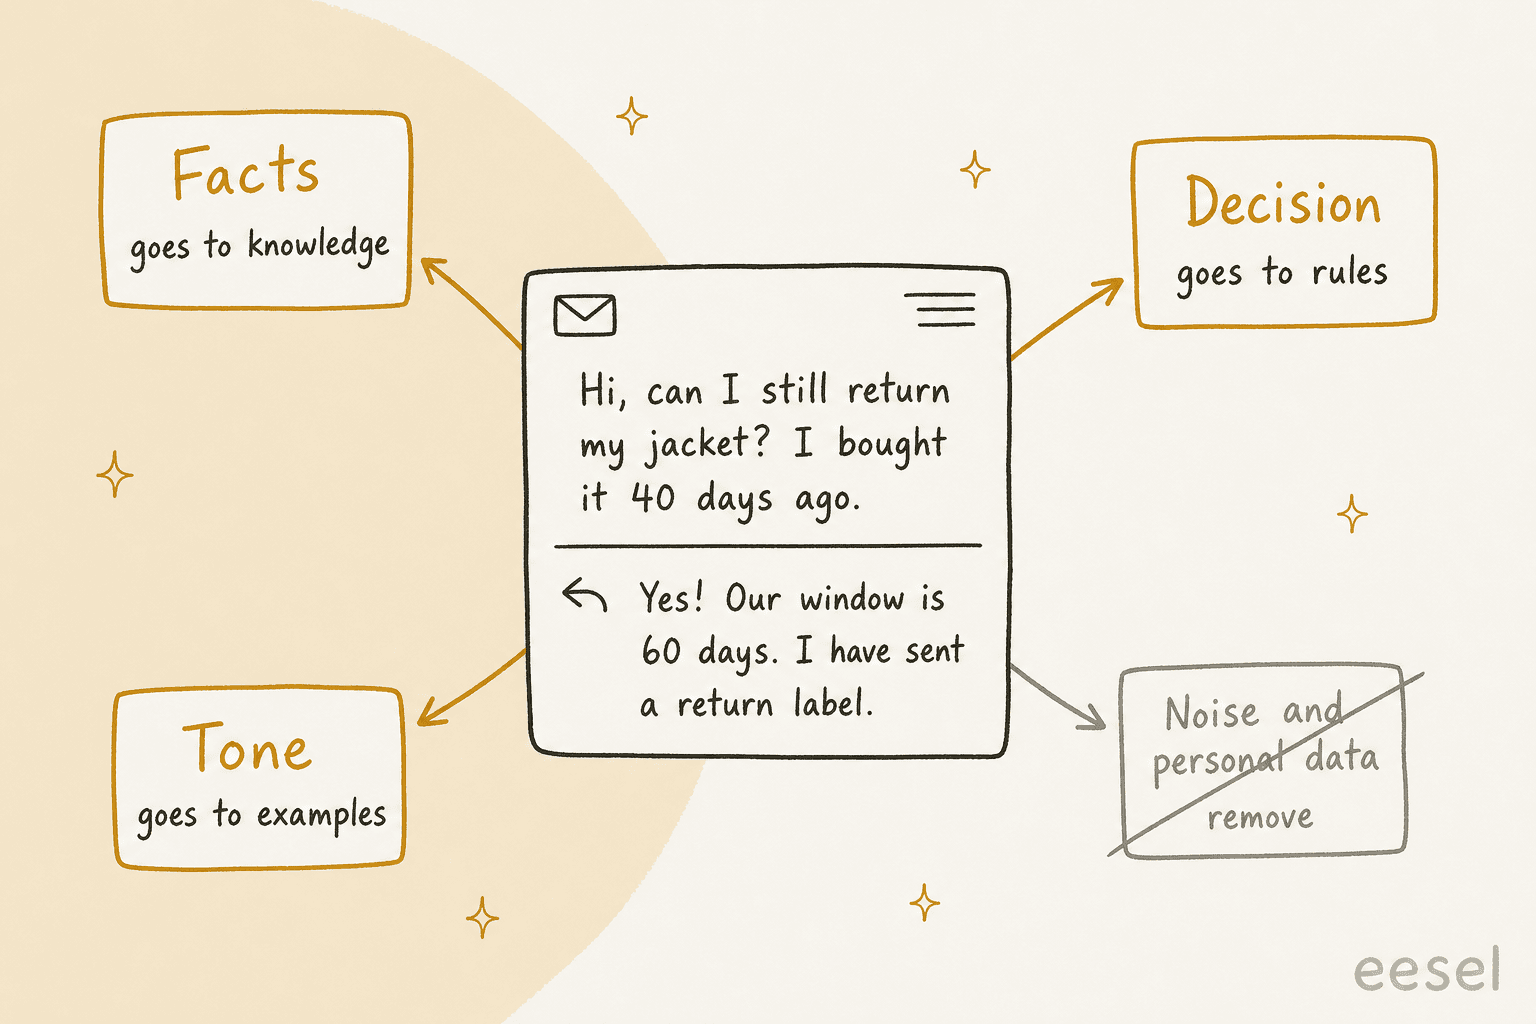
Prenons une simple demande de retour. La réponse de l'agent contient :
- Un fait : le délai de retour est de 60 jours. Cela relève de votre base de connaissances, où on peut le mettre à jour en un seul endroit quand la politique change.
- Une décision : ce client y a droit, donc on envoie une étiquette. C'est une règle (« sous 60 jours, non porté, envoyer une étiquette ; au-delà, transférer »), et les règles sont plus sûres écrites que déduites de centaines d'exemples.
- Le ton : court, chaleureux, un point d'exclamation, pas d'excuses. C'est ce qu'enseignent les réponses d'exemple.
- Du bruit : le nom du client, son adresse, son numéro de commande, la signature de l'agent et une note interne. Rien de tout cela ne doit atteindre l'IA.
Si vous déversez le ticket entier dans une IA, elle apprend les quatre à la fois et ne sait pas les distinguer. C'est ainsi que vous obtenez un bot qui cite un délai de 30 jours datant de 2023 d'une voix parfaitement aimable. Gorgias décrit le risque sans détour : "if a help center article says your return window is 30 days but a guidance says 14, AI Agent might not respond the same way every time" (documentation de connaissances Gorgias). Les anciens tickets sont la plus grande source de ce genre de conflit.
Les trois façons d'utiliser d'anciens tickets
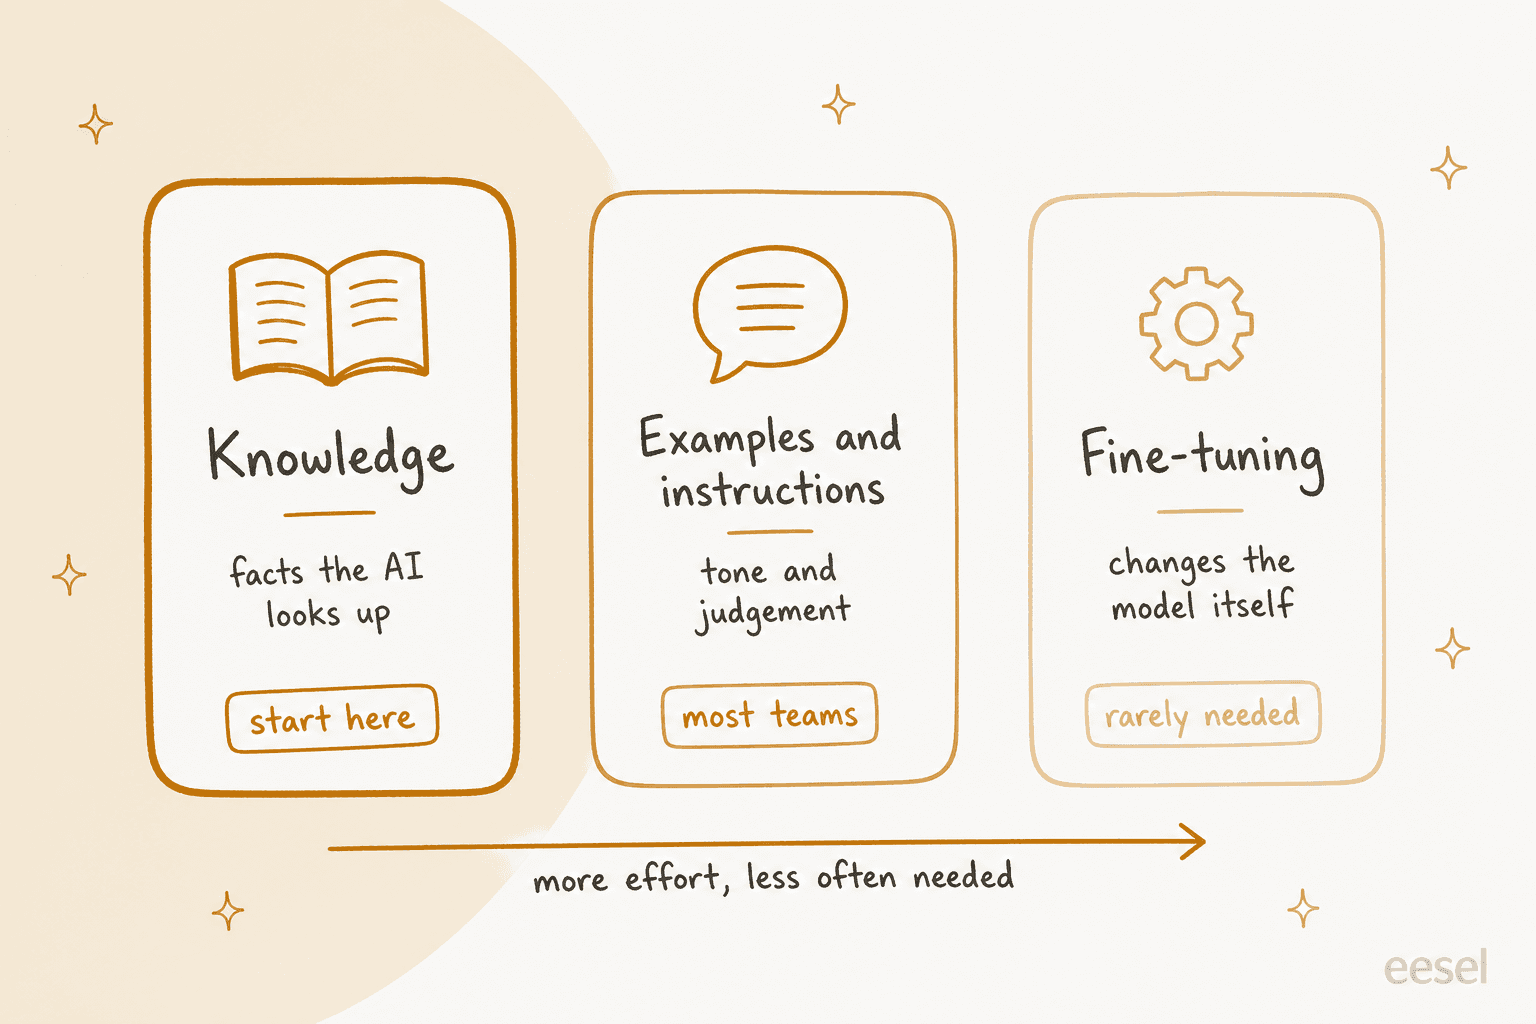
Il y a trois façons de transformer l'historique des tickets en comportement de l'IA, et elles ne se valent pas.
| Méthode | Ce qu'elle enseigne | Comment elle fonctionne | Effort | Quand c'est le bon choix |
|---|---|---|---|---|
| Extraction de connaissances et récupération | Faits, étapes, politiques | Extraire les réponses des tickets, les transformer en articles ou en questions-réponses, et laisser l'IA les consulter au moment de répondre (RAG) | Faible à moyen | Toujours. C'est d'ici que vient l'exactitude |
| Exemples et instructions | Ton, longueur, jugement | Choisir quelques dizaines de vos meilleures réponses comme exemples, écrire les décisions sous forme de règles | Faible | Presque toujours. C'est d'ici que vient le « ça sonne comme nous » |
| Fine-tuning | Format et style à grande échelle | Entraîner les poids d'un modèle sur des milliers de conversations d'exemple | Élevé | Rarement : très gros volume, une tâche étroite et des évaluations prouvant que le prompting ne suffit pas |
La récupération, c'est là que vit l'exactitude. L'IA cherche dans votre centre d'aide, vos macros et les réponses de tickets nettoyées quand une question arrive, et répond d'après ce qu'elle trouve. Quand une politique change, vous modifiez un article et la réponse suivante est juste. Pour la version approfondie de cet argument, voyez RAG contre fine-tuning.
Les exemples et les instructions, c'est là que vit le ton. Le conseil de Freshdesk lui-même pour son agent e-mail est "Include examples of ideal responses in your instructions. The agent learns from concrete examples faster than it does from abstract rules" (configuration de l'agent IA e-mail de Freshdesk). Vous n'avez pas besoin de 10 000 tickets pour cela. Il vous faut de 20 à 50 réponses dont vos meilleurs agents seraient fiers.
Le fine-tuning, c'est ce dont tout le monde parle et dont presque personne n'a besoin. La documentation d'OpenAI présente le fine-tuning supervisé comme le plus adapté à la classification, à la traduction, aux formats de sortie fixes et à "correcting instruction-following failures" (fine-tuning supervisé d'OpenAI). Apprendre votre politique de remboursement actuelle ne figure pas sur cette liste, car des faits gravés dans les poids du modèle deviennent obsolètes le jour où la politique change. La documentation dit aussi "The prompt engineering process may be all you need" (optimisation de modèles OpenAI).
Un développeur sur Reddit a tenté le coup quand même, et le résultat est l'image la plus claire que j'aie trouvée de ce que fait réellement le fine-tuning sur des tickets bruts :
"So I pulled about 8k past tickets which were mostly about shipping, returns, account issues and product information and anonymized the sensitive data then set up a training run. The good news was that it picked up the brand tone and mirrored our macros, but it also prioritized weird quirks too often. Our old agent would write 'hey there' for nearly every tricket so this model started spraying it everywhere."

Ils sont finalement revenus à un prompt système strict et une couche de récupération légère. Le modèle a appris le ton, et aussi la manie d'un agent, car un fine-tune ne distingue pas une habitude d'une politique.
Et il y a maintenant une raison pratique de s'en passer. OpenAI met fin au fine-tuning en libre-service : les organisations qui n'avaient jamais fait de fine-tuning ont perdu l'accès le 7 mai 2026, et les clients actifs ne peuvent plus créer de nouveaux jobs après le 6 janvier 2027 (dépréciations OpenAI). Si vous êtes déjà utilisateur, entraîner un modèle gpt-4.1-mini coûte $5.00 par million de tokens d'entraînement, puis le modèle affiné tourne à $0.80 en entrée et $3.20 en sortie par million de tokens, soit le double du tarif du modèle de base (tarifs OpenAI). Pour en savoir plus sur cette voie, consultez le guide de l'API de fine-tuning d'OpenAI.
Vous ne savez pas lequel convient à votre problème ? Choisissez le symptôme que vous observez.
Choisissez le symptôme que vous observez pour savoir quelle partie de votre historique de tickets le corrige.
Ce que votre helpdesk fait déjà avec les anciens tickets
Avant de construire quoi que ce soit, vérifiez ce que votre helpdesk fait de lui-même, car la réponse varie plus que ne le laisse croire le marketing. J'ai parcouru le centre d'aide de chaque éditeur pour que vous n'ayez pas à le faire.
| Helpdesk | Apprend des anciens tickets ? | Comment | Période couverte | Prix de l'IA (page de l'éditeur) |
|---|---|---|---|---|
| Zendesk | En partie | Auto assist utilise des tickets résolus similaires uniquement quand aucune procédure ni aucun article ne convient ; des procédures et des brouillons de centre d'aide sont générés à partir des tickets résolus pour que vous les publiiez | 90 jours pour les brouillons générés | Copilot $50/agent/mois en annuel ; agent IA $1.50 par résolution automatisée engagée, $2.00 à l'usage |
| Freshdesk | Pour tester, pas pour répondre | Les anciens tickets ne figurent pas parmi les sources de connaissances ; les tickets résolus peuvent être importés comme jeu de test | 30 jours par API par défaut | Freddy AI Agent : 500 premières sessions incluses, puis $49 par 100 sessions |
| Gorgias | Indirectement | « Opportunities » (bêta) suggère des lacunes de connaissances et des conflits à partir de conversations que l'IA n'a pas pu résoudre ; vous approuvez chaque suggestion | Les rapports utilisent 28 jours | $0.85 à $1.00 par interaction automatisée |
| HubSpot | Oui | Génère des paires de questions-réponses à partir de tickets résolus ou de conversations de la boîte de réception ; vous acceptez, ignorez ou refusez chacune | 90 jours ou un segment de tickets | 50 crédits par résolution, $0.50 aux tarifs à l'usage |
Quelques détails ressortent.
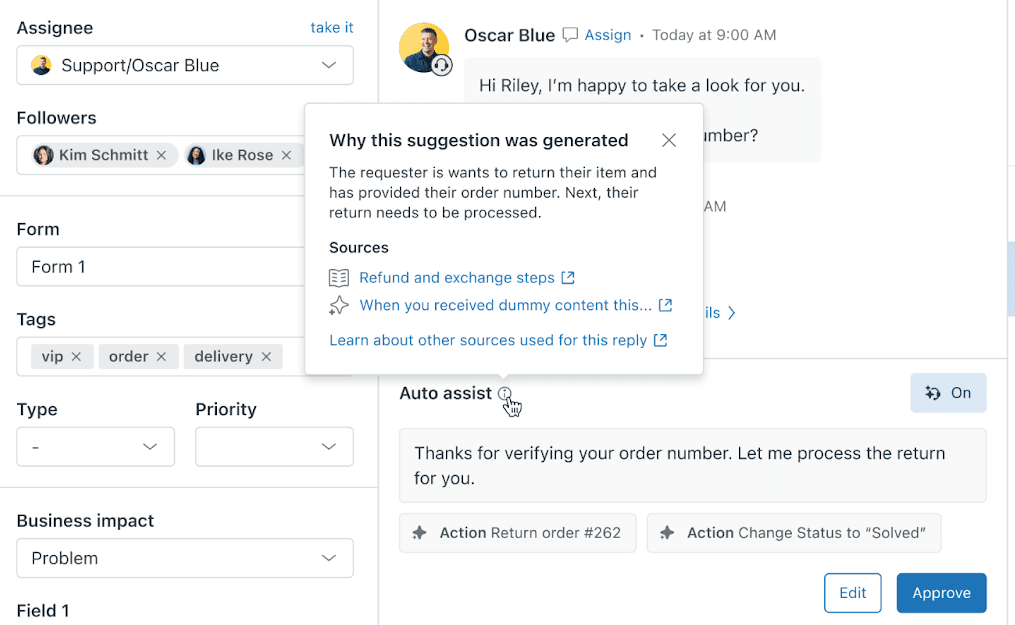
Zendesk traite les tickets comme dernier recours. Auto assist suggère des réponses "based on procedures, help center articles, similar solved tickets", et l'ordre compte : "If there are no relevant procedures or help center articles available, then similar solved tickets are used" (À propos d'auto assist). Seuls comptent les tickets de la même marque. Zendesk rédige aussi jusqu'à trois procédures par marque chaque semaine à partir de "Relevant solved tickets from the last 90 days", mais chacune attend qu'un administrateur la publie (procédures générées par IA). Les tarifs sont sur la page de tarifs de Zendesk.
Le Knowledge builder de Zendesk mérite aussi d'être connu si vous n'avez pas encore de centre d'aide. Il lit les 90 derniers jours de tickets et propose jusqu'à 40 articles. Ses règles sur les tickets sont un bon modèle pour votre propre filtre : uniquement Résolu ou Fermé, uniquement des commentaires publics non vides, et ni notes internes, ni spam, ni problèmes ponctuels. Zendesk dit lui-même que cela "will likely not be helpful" pour un centre d'aide bien entretenu.
Freshdesk tient les tickets hors du chemin de la réponse. Il liste les sources de l'agent IA comme "URLs, files, solution articles, custom Q&As, and external apps" (documentation de connaissances Freshdesk). L'historique apparaît dans les tests : vous pouvez importer des tickets historiques résolus dans une session d'évaluation. Plus de détails à l'étape 5. Les tarifs sont sur la page de tarifs de Freshdesk.
HubSpot est le plus direct. Il va "generate knowledge sources from your resolved tickets, inbox conversations, or uploaded files", regroupés par sujets sous forme de paires de type FAQ que vous relisez (générateur de connaissances HubSpot). Il est disponible dans les offres Professional et Enterprise.
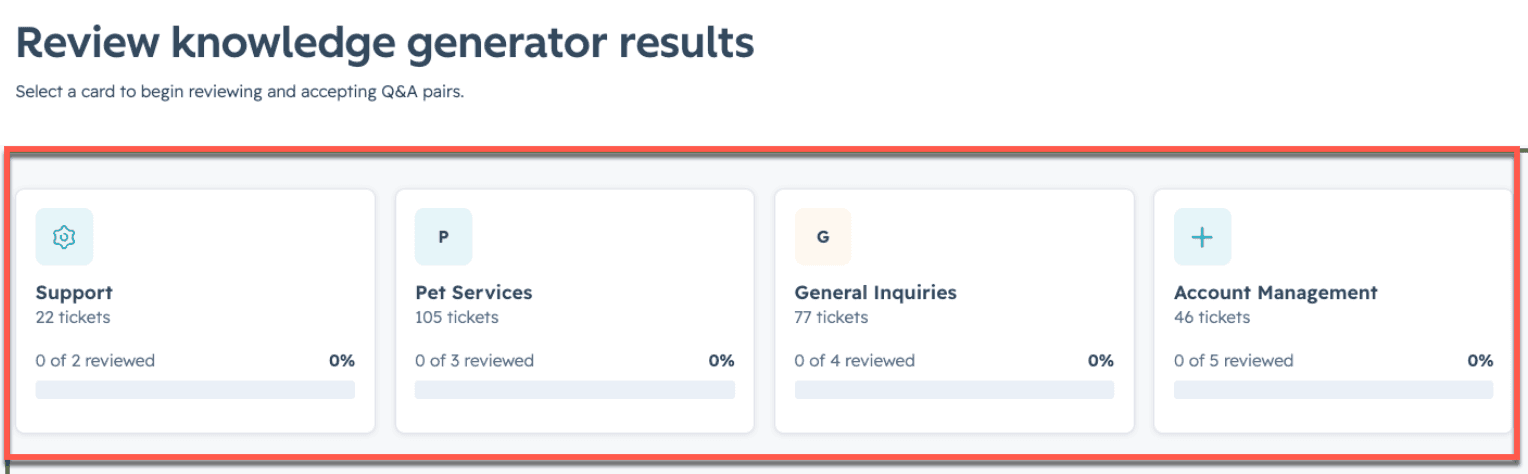
Remarquez le schéma : tout éditeur qui apprend des tickets place une étape d'approbation humaine au milieu. C'est l'éditeur qui vous dit poliment que l'historique brut des tickets n'est pas sûr à apprendre sans relecture.
Étape 1 : exporter les tickets, avec la conversation jointe
Première surprise pour la plupart des équipes : l'export standard des tickets n'inclut généralement pas la conversation. Vous obtenez l'objet, le statut et les champs, mais pas les échanges dont vous voulez justement apprendre.
- Zendesk : l'export incrémental recommandé est le point d'accès
GET /api/v2/incremental/tickets/cursor.json, jusqu'à 1 000 tickets par page et 10 requêtes par minute (30 avec le module High Volume), réservé aux administrateurs. Les commentaires n'y figurent pas. Récupérez-les dans le flux d'événements de tickets avecinclude=comment_events, ou ticket par ticket depuis le point d'accès des commentaires, oùpublic: falsesignale une note interne. Le guide de l'export incrémental Zendesk détaille toute la marche à suivre. - Freshdesk : l'export depuis l'interface "will NOT give you the entire conversation from the ticket or historical data" (documentation d'export Freshdesk). Utilisez un export du compte ou l'API, qui ne renvoie que les 30 derniers jours sauf si vous passez
updated_since, et au plus 30 000 tickets par appel de liste (API Freshdesk). - Gorgias : l'export de vues gère jusqu'à 1 million de tickets mais sans le texte des messages. "Export with message content" depuis un détail d'analytique ne couvre que les 30 jours les plus récents, jusqu'à 100 000 tickets, messages publics uniquement (documentation d'export Gorgias).
N'exportez que les messages publics. Les notes internes sont l'endroit où les agents écrivent « le client ment, remboursez quand même pour qu'on ait la paix », et vous ne voulez pas que l'IA apprenne de cela. Les outils de Zendesk écartent eux-mêmes les notes internes pour la même raison.
Étape 2 : écarter les tickets qui enseigneraient la mauvaise chose
C'est l'étape qui fait ou défait le projet. Vous ne cherchez pas à garder le plus de tickets possible. Vous cherchez à garder ceux que vous montreriez volontiers à un nouvel arrivant en disant « voilà comment on fait ».
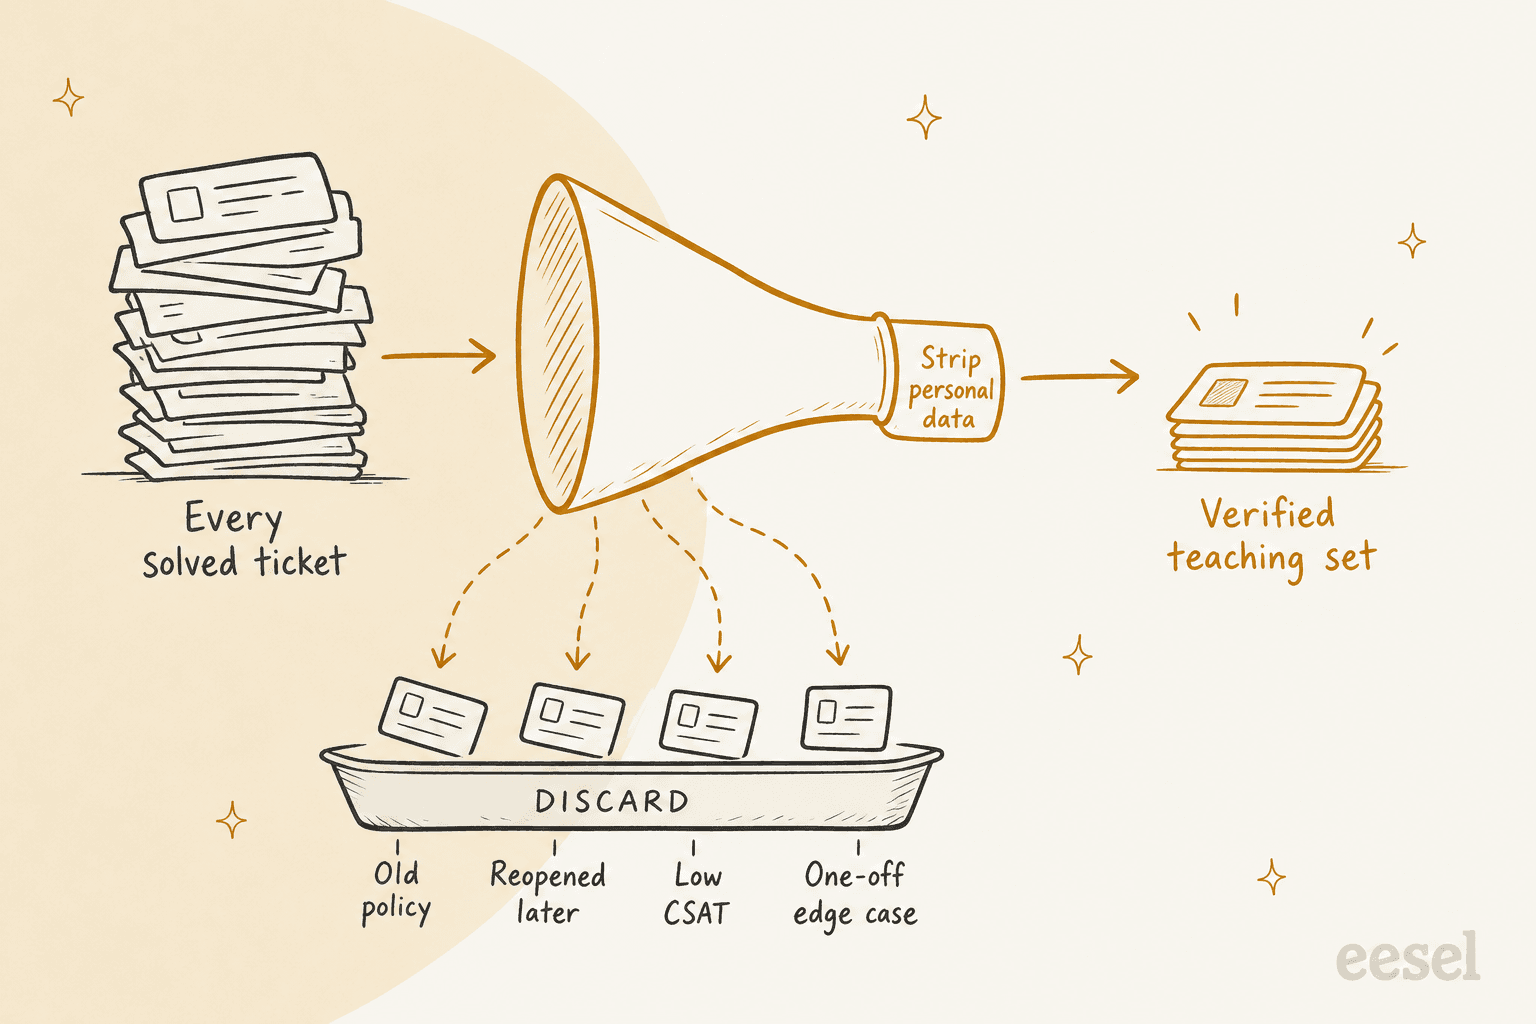
Écartez ceux-ci :
- Les tickets antérieurs à votre dernier changement de politique. Si votre politique de retour a changé en mars, tout ce qui précède mars enseigne l'ancienne règle. Dans le doute, commencez par les trois à six derniers mois. Zendesk et HubSpot utilisent tous deux 90 jours par défaut pour leurs propres fonctions d'apprentissage sur les tickets.
- Les tickets rouverts, escaladés après la « résolution » ou suivis d'un second ticket sur le même problème. La première réponse n'a pas marché.
- Les tickets avec une mauvaise note CSAT ou une revue QA échouée. Si vous faites de la QA du support, les tickets validés par la QA sont votre ensemble de référence.
- Les tickets fermés automatiquement sans réponse d'un agent, le spam et les relances « merci ! ».
- Les cas isolés. L'arrangement sur mesure que votre responsable du support a consenti une fois à un VIP ne doit pas devenir la réponse par défaut.
- Les pics saisonniers, s'ils faussent le mélange. Une marque de livraison de fleurs, lors d'un appel commercial d'eesel, a demandé 300 tickets aléatoires par mois sur 10 mois, en excluant les pics de la Saint-Valentin et de la fête des Mères, pour qu'une vague de février ne noie pas les 10 autres mois.
Les recommandations d'OpenAI sur les données d'entraînement disent la même chose par l'autre bout : "a smaller amount of high-quality data is generally more effective than a larger amount of low-quality data" (bonnes pratiques de fine-tuning d'OpenAI). Elles préviennent aussi qu'un déséquilibre enseigne des habitudes. Si 60% des réponses d'exemple disent "I cannot answer this" alors que seulement 5% le devraient, "you will likely get an overabundance of refusals." Votre historique de tickets a sa propre version de ce biais, en général vers votre mois le plus chargé.
Un administrateur Zendesk sur Reddit a bien décrit le problème de l'historique brut, et c'est la raison d'être de cette étape :
"I am not entirely sure this approach would be bullet-proof (especially for businesses that have struggled to offer consistent customer support across agents - yes, I've worked for one!). Also, training on tickets is only half the battle, it's integrating all the other "knowledge" sources that makes a difference."
Étape 3 : retirer les données personnelles avant toute indexation
Les tickets de support sont pleins de noms, d'e-mails, d'adresses, de numéros de commande, et parfois de numéros de carte et de mots de passe que les clients collent quand ils sont agacés. Si cela entre dans la connaissance d'une IA, le risque n'est pas seulement la conformité. C'est que l'IA répète les informations d'un client dans la réponse à un autre.
Les éditeurs sont explicites là-dessus. La documentation de HubSpot prévient que les sources de connaissances privées "will not be cited, but their content may still appear in responses", donc "do not include personal, confidential, sensitive information, or private customer data" (sources de connaissances HubSpot). Le module Advanced Data Privacy and Protection de Zendesk repère les noms, e-mails, adresses, numéros de carte, numéros de sécurité sociale, adresses IP et numéros de téléphone dans les commentaires, avec un avertissement à lire deux fois : "Ticket redaction cannot be reversed" (caviardage Zendesk).
L'aspect juridique est simple à énoncer, comme l'a fait un commentateur de Hacker News :
"A support ticket or live chat with a customer is customer data. With things like GDPR you need to know exactly where customer data is stored and for how long."

Ne caviardez donc pas les tickets dans votre helpdesk pour préparer un ensemble d'entraînement. Caviardez la copie sur laquelle vous entraînez. Quelques règles que je suivrais :
- Masquez, ne supprimez pas. Remplacez un e-mail par
[EMAIL]plutôt que de le retirer, pour que l'exemple se lise naturellement et que l'IA apprenne à « demander l'e-mail de la commande » sans apprendre l'adresse réelle de quelqu'un. - Gardez les identifiants de commande hors des exemples, sauf si vous enseignez le format. L'IA doit consulter les commandes en direct, pas les mémoriser.
- En cas de doute, bloquez. Si un ticket ne peut pas être nettoyé, ignorez-le. Un ensemble plus petit vaut mieux qu'une fuite.
- Vérifiez le réglage. Les paramètres de caviardage sont souvent désactivés par défaut. Dans eesel, par exemple, le caviardage des anciens tickets est désactivé sur les espaces de travail récemment créés, et la documentation dit "Check the toggle rather than assuming it's on" (caviardage des PII d'eesel).
Pour plus de détails sur la mécanique, voyez caviarder les PII dans les transcriptions de support et l'analyse de la confidentialité des données de l'IA Zendesk.
Étape 4 : répartir chaque ticket en faits, décisions et ton
Prenez maintenant votre ensemble nettoyé et dirigez chaque leçon vers sa place.
Les faits deviennent de la connaissance. Quand la même question reçoit la même bonne réponse dans 15 tickets et qu'il n'y a pas d'article d'aide pour elle, c'est un article manquant, pas un exemple d'entraînement. Rédigez-le une fois, dans votre centre d'aide ou un document interne, et laissez l'IA le récupérer. Cette partie rend aussi votre équipe humaine plus rapide, car les réponses qui vivaient dans la tête d'une personne se retrouvent écrites. Une analyse des lacunes de connaissances est la version systématique de cette étape.
Les décisions deviennent des règles. Un remboursement au-dessus d'un plafond, une demande de garantie, une menace juridique, un VIP en colère : ce sont des décisions de jugement, et une IA qui les a apprises par des exemples sera incohérente, parce que vos agents l'étaient aussi. La documentation d'OpenAI chiffre la raison : si les gens ne s'accordent que sur 70% des cas, "the model would likely not be able to do better than this" (bonnes pratiques de fine-tuning d'OpenAI). Écrivez la règle, avec le chemin d'escalade, et testez-la. La conception de Zendesk reflète aussi cela : auto assist ne suggère des actions que "if they're defined in your procedures", jamais à partir de tickets similaires.
Le ton devient des exemples. Choisissez de 20 à 50 réponses de vos meilleurs agents sur vos principaux sujets : une réponse courte à « où est ma commande », une réponse de facturation soignée, un non aimable. Étiquetez chacune avec ce qui la rend bonne (« deux phrases, pas d'excuses, lien de suivi »). C'est suffisant pour faire bouger longueur et voix, là où passe l'essentiel du temps de retouche. Les guides sur la voix de marque de l'IA et le ton du support expliquent comment écrire les règles qui accompagnent les exemples.
OroSoft, qui fait des logiciels pour l'industrie des métaux précieux, montre ce que cela donne en pratique. Son agent eesel sur Freshdesk apprend d'environ 6,100 anciens tickets, resynchronisés chaque nuit, mais il a pour consigne de préférer les tickets résolus et fermés, de pondérer les récents et de traiter le centre d'aide comme la source de vérité pour les politiques, en suivant la source la plus récente quand les deux divergent. Quand un ancien ticket correspond, le brouillon en copie la structure, le ton et la longueur, de sorte qu'une réponse courte qui avait fonctionné reste courte. Et il ne recopie jamais les noms ni les informations des clients depuis d'anciens tickets.
Extraire des connaissances des tickets n'a pas besoin d'être sophistiqué non plus. Un commentateur de Hacker News a décrit ainsi comment il a lancé un modèle sur son historique :
"read this historical dump of 15k support tickets and break them into categories that make sense, then propose help docs that i could write to handle the most frequent queries in each category"
C'est le bon réflexe : le résultat, ce sont des documents d'aide qu'une personne rédige et approuve, pas un modèle qui a mémorisé 15 000 tickets.
Étape 5 : mettre de côté les tickets récents et les rejouer
Voici l'erreur de test que je vois le plus souvent : les équipes testent l'IA sur les mêmes tickets que ceux dont elle a appris, obtiennent un excellent score et lancent. Évidemment qu'elle a bien réussi. Elle avait vu les réponses.
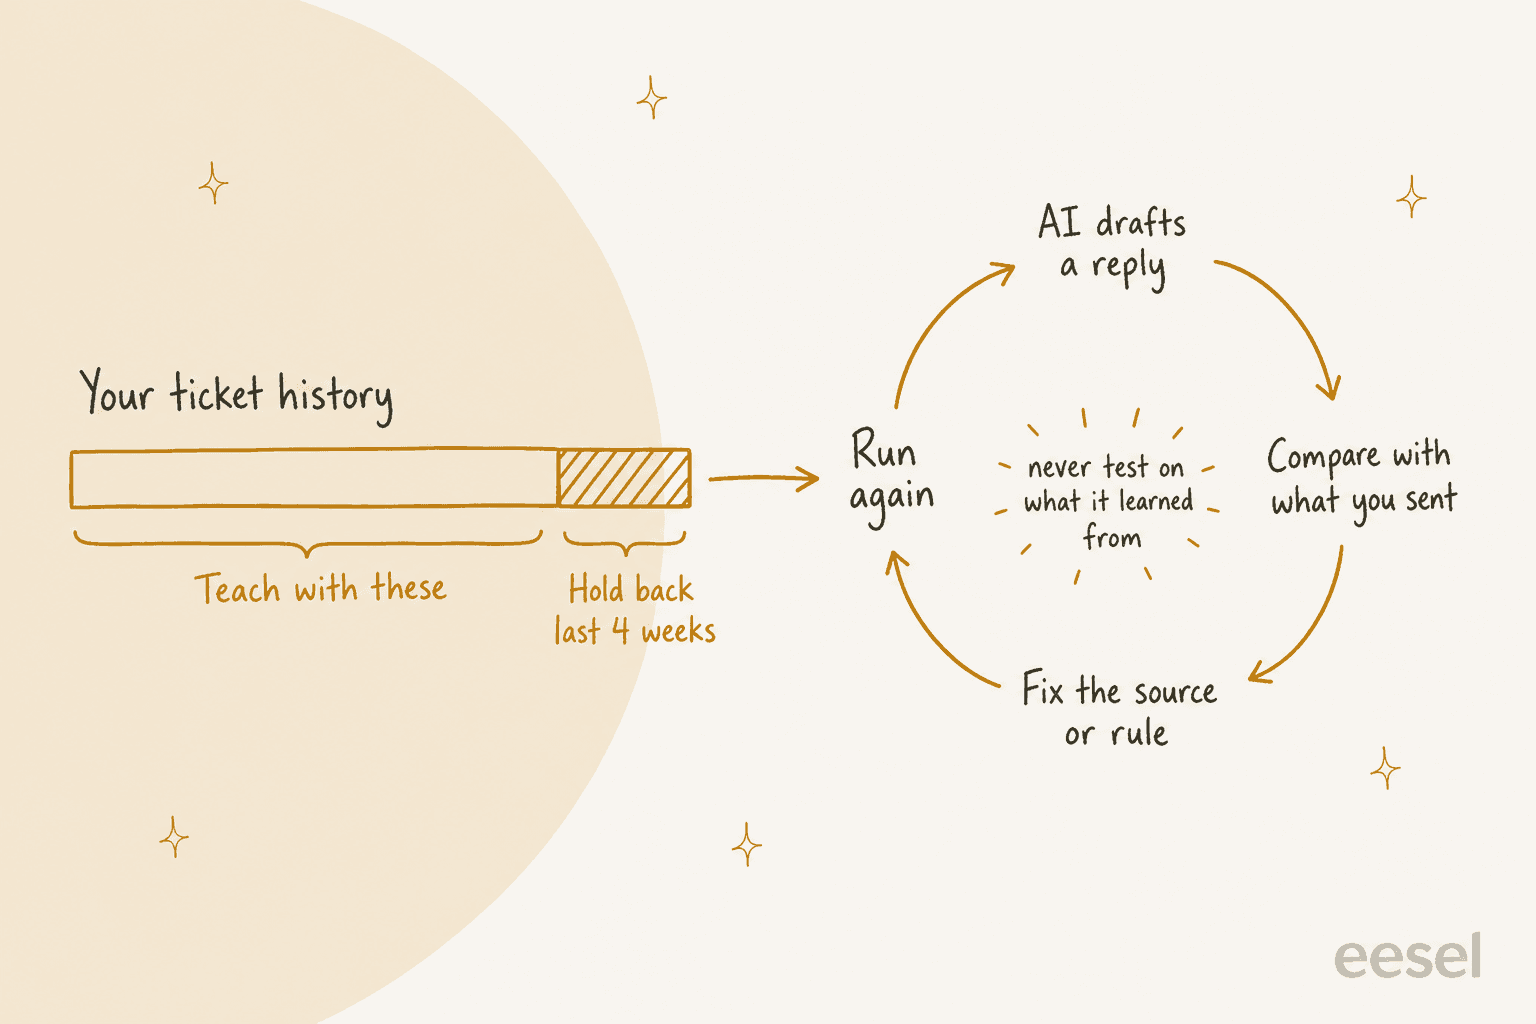
La documentation d'OpenAI le dit sans détour : "Good evals first!", et recommande un jeu de réserve qui "acts as a control group" (fine-tuning supervisé d'OpenAI). Cela vaut aussi quand vous ne faites pas de fine-tuning du tout. Une version simple :
- Mettez de côté vos trois à quatre semaines les plus récentes de tickets résolus lors de l'import. Ce sont les plus représentatives des questions d'aujourd'hui et l'IA ne les a pas vues.
- Rejouez-en 50 à 100. Faites rédiger à l'IA une réponse à chaque message client sans rien envoyer.
- Comparez chaque brouillon avec ce que votre équipe a réellement envoyé, et notez séparément l'exactitude et le ton. Un brouillon peut être juste sur le fond et demander tout de même une réécriture complète.
- Rattachez chaque erreur à une cause : un article manquant (corrigez la connaissance), une mauvaise décision (corrigez la règle) ou la mauvaise voix (corrigez les exemples). Puis relancez.
La plupart des helpdesks vous donnent un outil pour la relecture. L'agent e-mail de Freshdesk vous permet de "Import tickets to use solved historical tickets" comme jeu de test, jusqu'à 50 requêtes par session, et recommande au moins 20 requêtes représentatives avant le déploiement (configuration de l'agent IA e-mail de Freshdesk). Les tests par lot de HubSpot ne consomment pas de crédits. La compétence Simulation d'eesel rédige une réponse à 20 tickets que votre équipe a récemment résolus, compare chacune à ce que votre équipe a envoyé et regroupe les résultats par thème avec des correctifs, sans rien envoyer aux clients.
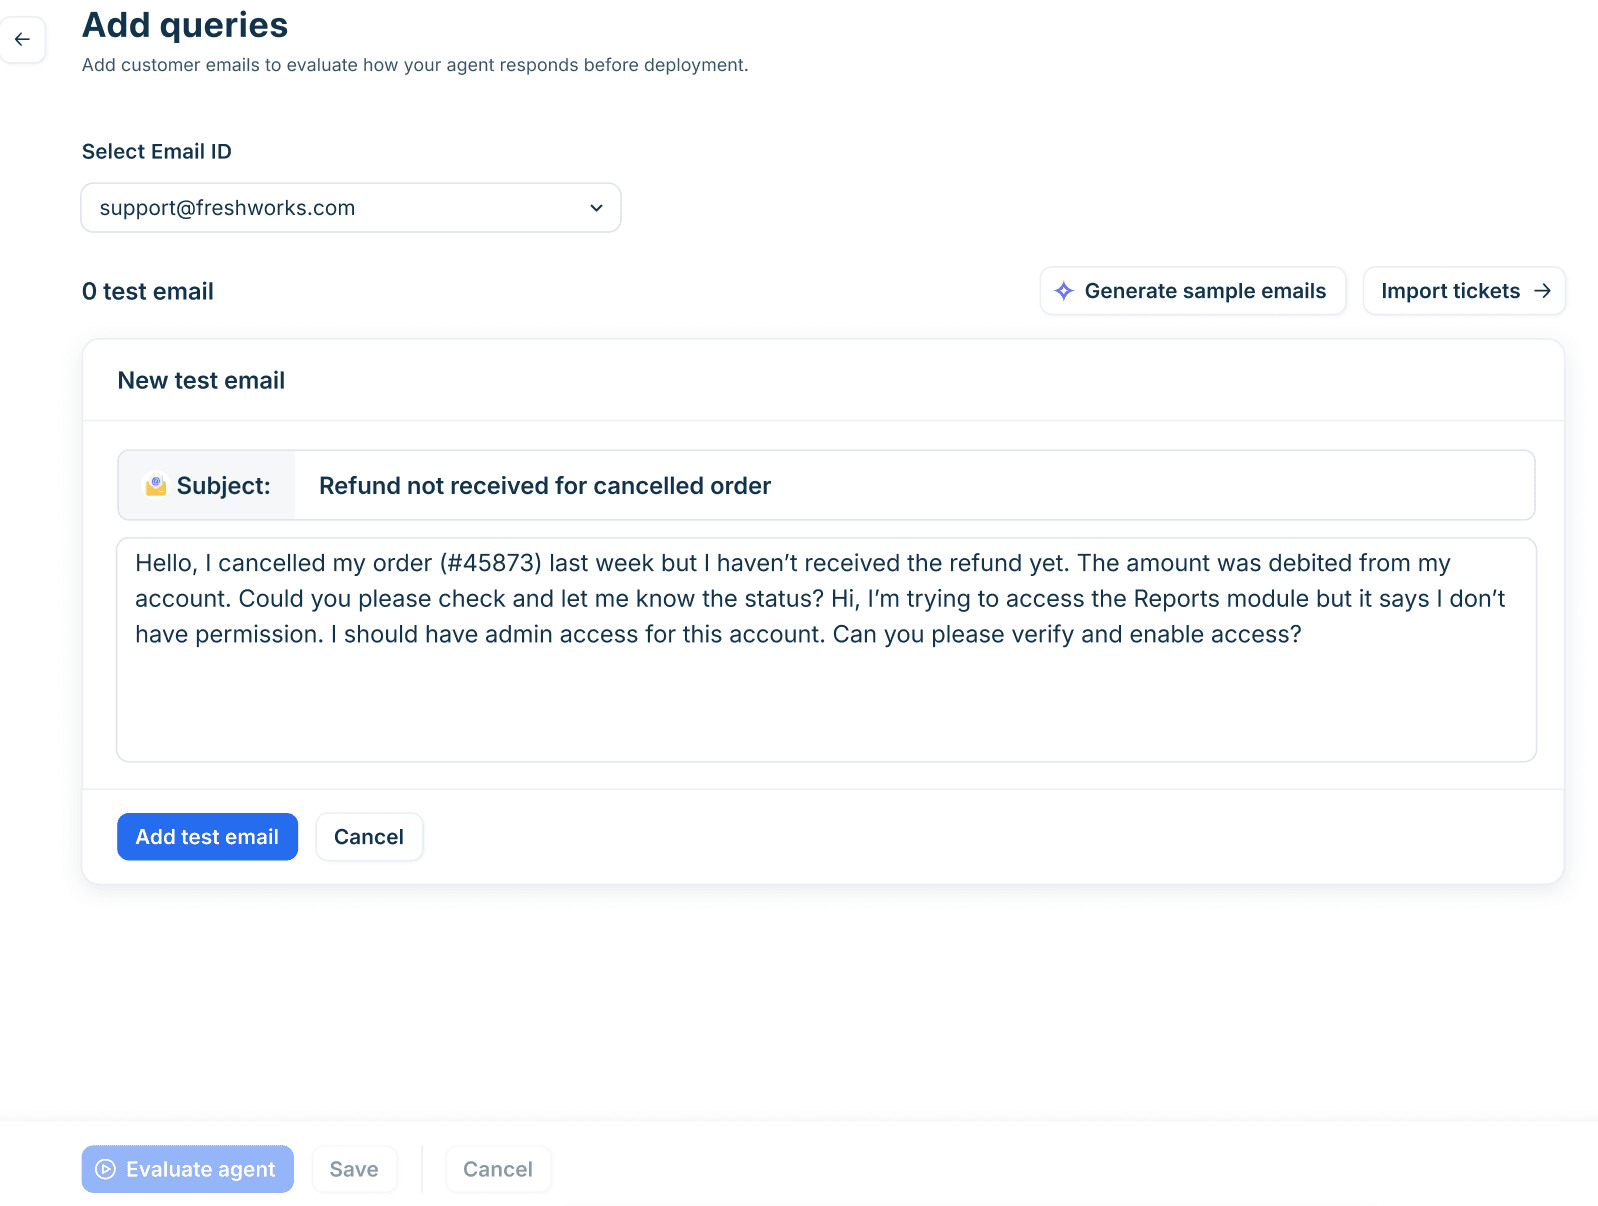
L'éditeur d'ERP cloud Qontro a fait de cette comparaison une habitude plutôt qu'une barrière de lancement. Son agent eesel rédige sur chaque nouveau ticket Freshdesk, et l'équipe compare chaque brouillon avec la réponse qu'une personne a réellement envoyée. Quand le brouillon était faux, cela renvoie en général à un article d'aide manquant ou à une règle à resserrer, et ils corrigent. Environ un brouillon sur dix part désormais avec peu ou pas de retouches, et la part augmente lentement. Pour un plan de test complet, voyez les tests d'agents de support IA et les vérifications de tester avant le lancement.
Étape 6 : garder l'entraînement à jour
L'entraînement sur les tickets n'est pas un import ponctuel. Vos produits, vos politiques et vos clients changent, et une IA qui a appris des tickets de l'an dernier devient peu à peu obsolète.
- Resynchronisez selon un calendrier. L'éditeur danois de logiciels Timengo resynchronise son centre d'aide Freshdesk chaque dimanche, ré-explore sa documentation chaque lundi, récupère les tickets ouverts chaque semaine et l'historique complet des tickets chaque mois. Les bots de Norden-Frisia se resynchronisent depuis Zendesk, de sorte qu'un changement dans un article sur les barres de toit ou les remises pour personnes handicapées atteint le bot sans réentraînement.
- Retirez les tickets quand une politique change. Quand vous mettez à jour le délai de retour, les anciens tickets qui le citent doivent quitter l'ensemble d'entraînement le jour même.
- Cherchez des lacunes dans les nouveaux tickets. Les questions auxquelles l'IA n'a pas su répondre ce mois-ci sont les articles d'aide du mois prochain. HubSpot signale les lacunes de connaissances sur les tickets que l'agent n'a pas pu traiter, et Opportunities de Gorgias fait remonter les sujets que son IA "has repeatedly handed over to your team" (Gorgias Opportunities). Une base de connaissances qui se met à jour seule est l'objectif, avec une personne qui approuve chaque changement.
- Faites un audit trimestriel des connaissances sur lesquelles l'IA s'appuie. Un audit de la base de connaissances IA repérera plus de réponses périmées que n'importe quel ajustement de prompt.
Erreurs courantes lors de l'entraînement d'une IA sur d'anciens tickets
- Tout importer « par précaution ». Plus de tickets, c'est plus d'anciennes politiques et plus de décisions incohérentes. Triez d'abord.
- Dire à l'IA d'ignorer certains tickets au lieu de les retirer. Les instructions ne filtrent pas la connaissance de façon fiable. Si une file ne doit pas servir à apprendre (données de test, ancien produit, tickets d'une autre équipe), excluez-la de l'import.
- Apprendre les décisions par des exemples. Les plafonds de remboursement et les règles d'escalade doivent être écrits, là où vous pouvez les tester.
- Oublier les données personnelles jusqu'à ce que le service juridique pose la question. Caviardez la copie d'entraînement avant toute indexation.
- Tester sur les données d'entraînement. Mettez de côté les tickets récents, sinon votre score vous flatte.
- Se tourner d'abord vers le fine-tuning. C'est l'option la plus lente et la plus chère, et elle règle le problème le moins courant.
- Voir le lancement comme une fin. La phase pilote est le moment où vous trouvez les lacunes que votre historique ne couvrait pas.
Comment eesel apprend de vos anciens tickets
Je précise d'emblée que je suis partial, mais eesel a été conçu autour de ce flux précis, il vaut donc la peine de montrer comment il correspond aux six étapes.
- Import maîtrisé. Avec une connexion complète à Zendesk, Freshdesk ou Gorgias, eesel lit votre centre d'aide, vos macros et vos anciens tickets. Le premier import est un échantillon d'au plus 1 000 tickets résolus récents, et vous pouvez filtrer par statut et par date pour en importer davantage (documentation de configuration Zendesk). Si une source ne doit pas servir à apprendre, vous la désactivez sur la page de l'intégration car, comme le dit la documentation, lui dire d'ignorer les anciens tickets "does not stop it finding them; the switch does."
- Données personnelles masquées avant l'indexation. Les anciens tickets passent par un détecteur couvrant 15 types de données personnelles, remplacées par des masques typés comme
[REDACTED:EMAIL], et les tickets qui ne peuvent pas être nettoyés sont ignorés plutôt que stockés bruts (documentation du caviardage des PII). - Rejeu avant la mise en service. La compétence Simulation rejoue des tickets résolus récents, note chaque réponse par rapport à ce que votre équipe a envoyé et suggère des changements d'instructions. Rien ne tourne sur de vrais tickets tant que vous n'avez pas créé d'automatisation, et la plupart des équipes commencent par des brouillons.
- Des corrections qui durent. Quand vous corrigez une réponse dans le chat, eesel inscrit la correction dans ses propres instructions, si bien que le correctif tient la semaine suivante.
- Une CLI pour la tuyauterie d'export et d'import. Si vous préférez scripter cela, ou le confier à un agent de code comme Claude Code ou Cursor, la CLI eesel pilote le même agent depuis un terminal, avec une sortie JSON.
eesel integrations sources zendeskmontre ce que contiennent les sources centre d'aide, macros et tickets,eesel integrations download start zendeskles copie dans la connaissance d'eesel, eteesel chatvous permet de lui demander d'importer une plage de dates précise ou de lancer une simulation. C'est le même agent que le tableau de bord, donc tout ce que vous y configurez apparaît dans les deux.
Le revendeur suédois de véhicules électriques Nordbutiker est un bon exemple de l'idée « trier, ne pas déverser ». Il exploite quatre boutiques en Suède, en Norvège, au Danemark et en Finlande, et le bot de chaque boutique apprend des tickets résolus de sa propre marque Zendesk, de sorte que les réponses reflètent ce que les agents de cette boutique ont réellement dit. Tout ce que le site et les anciens tickets ne couvrent pas, comme les pièces détachées et les demandes de garantie, va à une personne.
Entraîner une IA sur vos anciens tickets avec eesel
Si vous êtes assis sur des années d'historique de helpdesk et que vous voulez une IA qui répond comme vos meilleurs agents, eesel est le chemin le plus court que je connaisse. Il rejoint Zendesk, Freshdesk ou Gorgias comme un nouvel arrivant qui a déjà lu votre centre d'aide, vos macros et vos meilleurs anciens tickets, avec les données personnelles masquées. Puis il rejoue vos tickets récents pour vous montrer où il se serait trompé avant de rédiger la moindre vraie réponse.
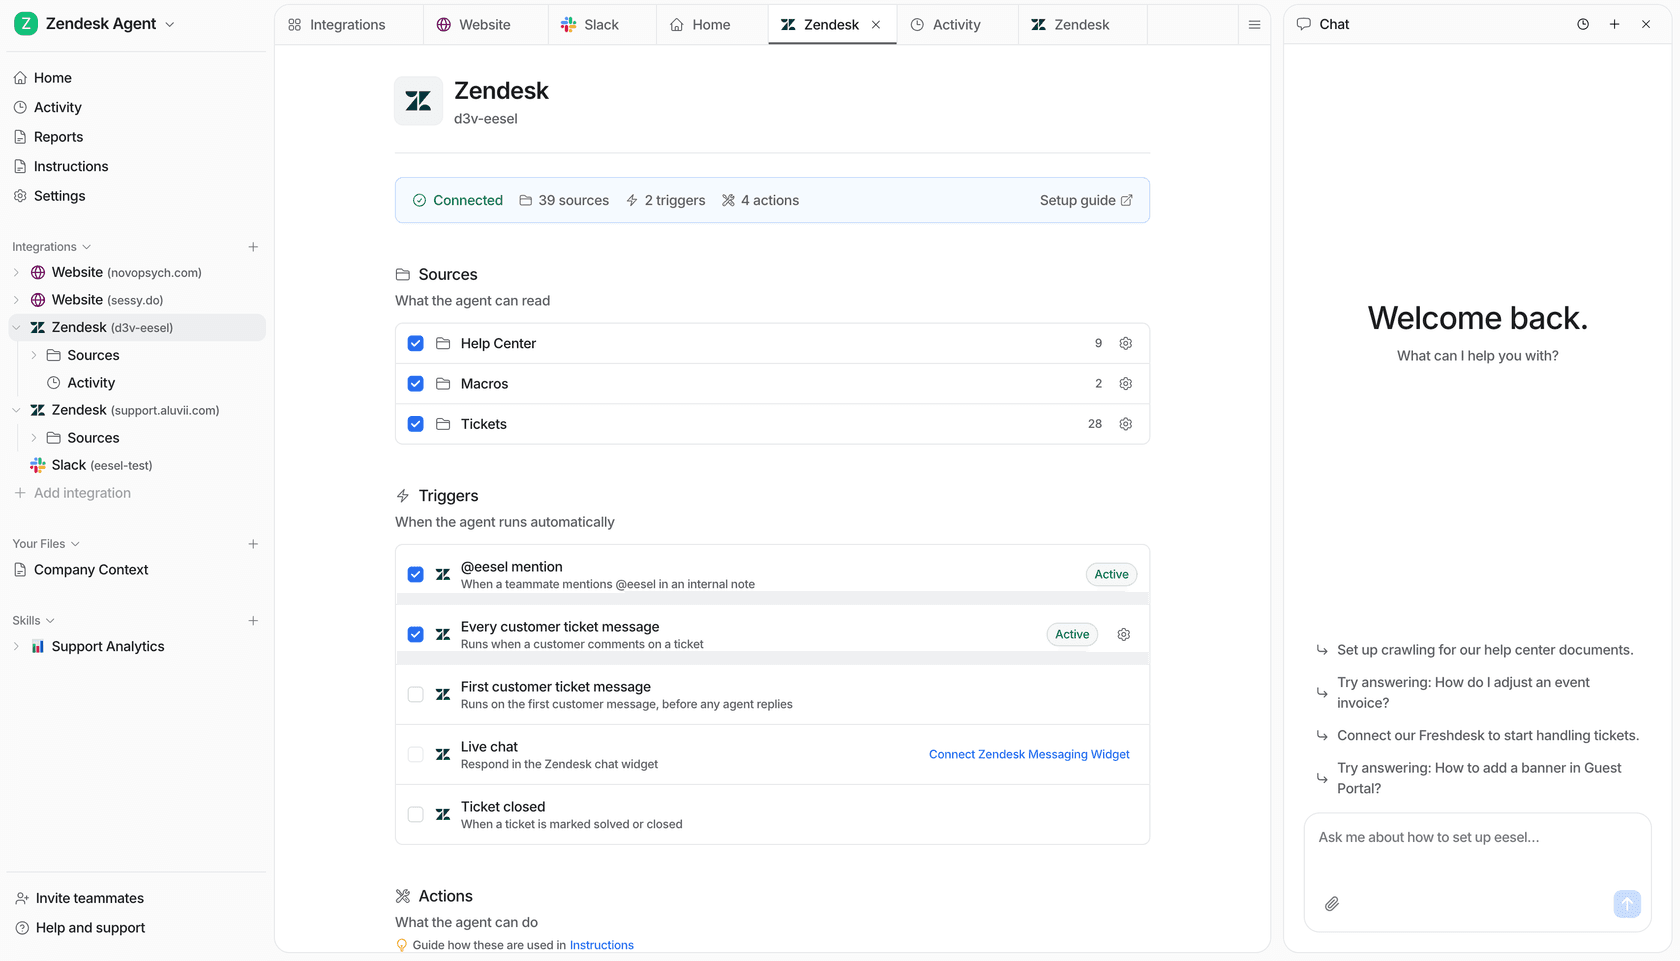
C'est ce qui a convaincu Norden-Frisia : pendant la semaine d'essai, l'équipe a connecté Zendesk, importé les macros et les trois derniers mois de tickets, et s'est abonnée en quelques jours. L'offre gratuite inclut 100 crédits sans carte, et les offres payantes démarrent à $299/month pour 500 crédits, un ticket coûtant un crédit quel que soit le nombre de réponses échangées (tarifs eesel). Essayez eesel sur votre propre historique de tickets et voyez les brouillons avant de payer quoi que ce soit.
Comment entraîner une IA sur d'anciens tickets ?