

« Connecter un agent », ce sont en réalité trois questions
Je livre des intégrations chez eesel, donc je passe l'essentiel de ma semaine sur exactement ce problème, et l'erreur la plus courante que je vois est de traiter « connecter l'agent à nos outils » comme une seule case à cocher. Ce n'en est pas une. Une connexion, ce sont trois capacités différentes, et un outil donné peut en offrir une, deux, ou les trois.
- Les sources sont ce que l'agent peut lire : votre centre d'aide, les anciens tickets, les macros, les pages de wiki, les fiches de commande, la documentation produit. C'est la connaissance à partir de laquelle il répond.
- Les déclencheurs sont le moment où il se réveille : un client envoie un message, un ticket est ouvert, quelqu'un le mentionne avec @, un webhook se déclenche. Sans déclencheur, l'agent reste simplement inactif.
- Les actions sont ce qu'il peut faire dans l'outil : rédiger une réponse, l'envoyer, taguer un ticket, consulter une commande, créer un ticket (issue), mettre à jour un champ.
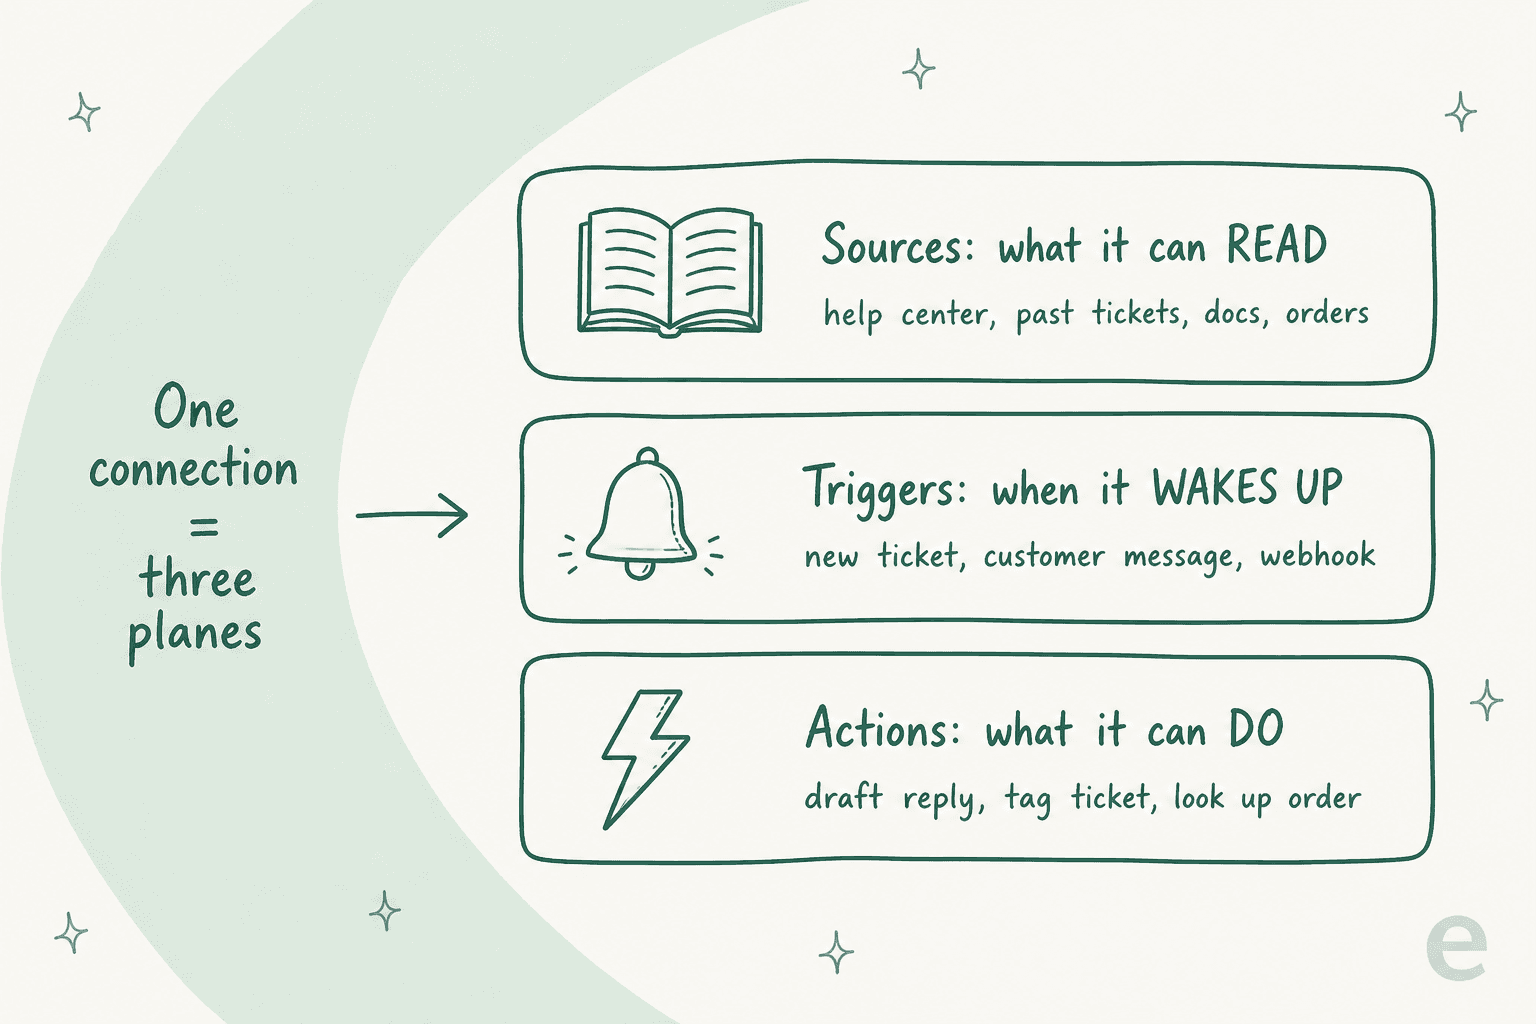
Pourquoi cette façon de voir les choses compte-t-elle ? Parce qu'elle indique exactement ce qui manque à « connecté ». Un agent capable de lire votre centre d'aide mais sans déclencheur ne répondra jamais à un ticket en direct. Un agent avec un déclencheur mais sans action ne peut que rédiger, jamais envoyer. Quand quelqu'un dit « notre bot est connecté à Zendesk mais il est inutile », neuf fois sur dix, l'un de ces trois plans est désactivé.
Cela explique aussi une limite qui trébuche beaucoup d'équipes : certains outils ne sont que des sources. Confluence, Notion et Google Drive sont des choses que votre agent lit mais dans lesquelles il ne peut pas agir, car il n'y a rien à « faire » dans un document qui compte pour une réponse de support. Quelques intégrations sont l'inverse : des actions sans rien à apprendre. Savoir laquelle est laquelle à l'avance vous évite d'attendre d'un agent qu'il crée un ticket Jira via un connecteur qui n'a été conçu que pour lire.
Encore une chose qui m'a surpris la première fois que je l'ai vue fonctionner : avec la bonne plateforme, toutes vos sources se regroupent. Un agent connecté à Zendesk, Confluence et votre site marketing recherche dans les trois à la fois, si bien qu'une seule réponse peut puiser dans votre centre d'aide, votre wiki interne et une page publique dans le même souffle. Ce regroupement fait la différence entre un agent qui répète un document et un agent qui raisonne réellement sur toute votre base de connaissances.
Les quatre façons de connecter un agent à un outil
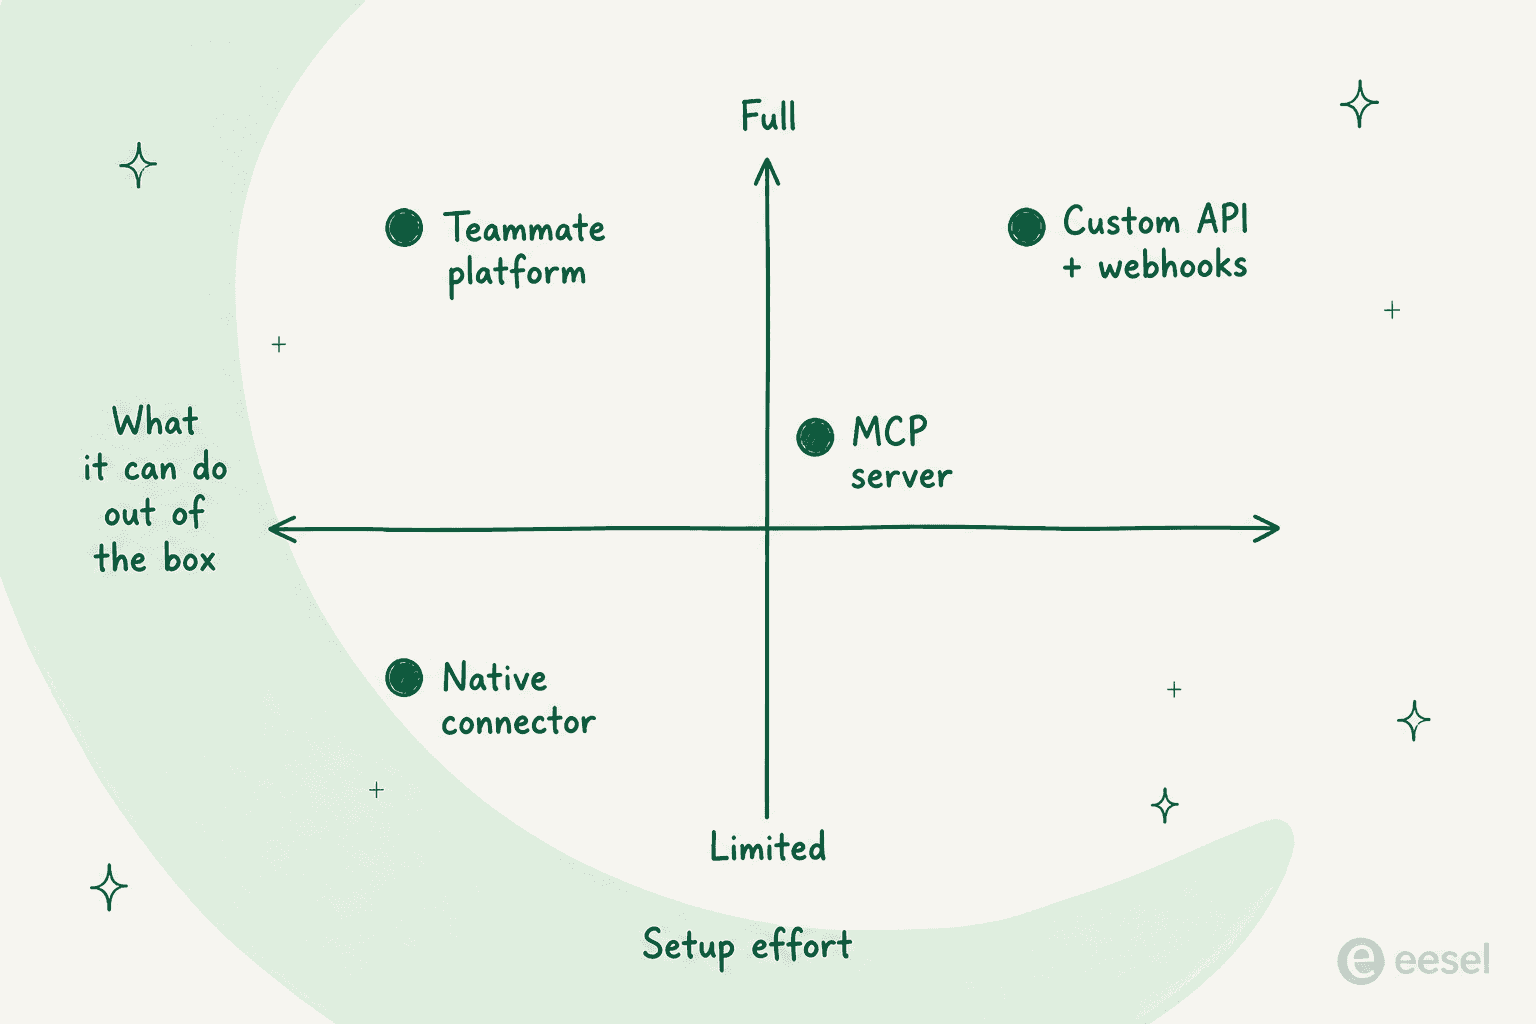
Une fois que vous savez ce que vous voulez que l'agent lise, ce qui doit le réveiller et ce qu'il doit faire, la question suivante est comment établir la connexion. Il existe quatre surfaces, et la bonne dépend de la quantité que vous voulez construire par rapport au contrôle dont vous avez besoin.
Connecteurs natifs : les boutons fournis par l'éditeur
Votre helpdesk ou CRM vend probablement sa propre IA, déjà connectée aux données juste à côté. Les agents IA de Zendesk, Freddy de Freshdesk et l'agent client de HubSpot fonctionnent tous ainsi. Vous activez un interrupteur, et l'agent voit déjà les tickets et articles de cette plateforme.
L'attrait est évident : aucune construction, et la connexion à l'outil d'origine est infaillible. Le hic, c'est que l'IA native est généralement un jardin clos. Elle lit bien les données de cet éditeur mais peine à atteindre quoi que ce soit en dehors, et elle est généralement facturée à la résolution ou à la conversation en plus du coût de vos licences. Si tout ce dont votre agent a besoin se trouve dans un seul outil, un connecteur natif est vraiment le chemin le plus rapide. Dès que l'agent doit aussi consulter votre CRM et votre wiki interne, vous vous heurtez au mur.
API REST et webhooks : construisez-le vous-même
Presque tous les outils métier sérieux exposent une API REST et des webhooks. L'API permet à votre code de lire et d'écrire des données ; le webhook indique à l'outil de vous signaler qu'il s'est passé quelque chose. Placez un modèle au milieu et vous avez un agent entièrement personnalisé qui peut, en principe, toucher tout ce qui possède un point de terminaison.
C'est la surface la plus puissante et la plus exigeante. Vous écrivez la gestion de l'authentification, la logique de nouvelle tentative, le backoff de limitation de débit, et une intégration neuve pour chaque outil, puis vous maintenez tout cela pendant que les éditeurs modifient leurs API sous vos pieds. J'aime construire sur des API, et je ne me tournerais malgré tout vers une construction d'API partant de zéro que lorsque j'ai besoin d'un comportement qu'aucun connecteur n'offre. Pour la plupart des équipes, c'est beaucoup de plomberie à porter. Si vous voulez la version honnête de ce compromis, je l'ai développée dans notre guide sur l'API d'agent de support client.
Serveurs MCP : la nouvelle lingua franca
Le Model Context Protocol est le développement intéressant de l'année écoulée. Un serveur MCP enveloppe l'API d'un outil dans un format standard que n'importe quel modèle peut lire seul, si bien qu'au lieu d'écrire du code de liaison sur mesure pour chaque outil, vous pointez l'agent vers le serveur, et il découvre ce que l'outil sait faire. Front, Gorgias et une liste croissante d'éditeurs publient désormais des serveurs MCP officiels.
MCP est réellement utile, et c'est pourquoi le même agent peut désormais dialoguer avec une dizaine d'outils sans une dizaine de constructions sur mesure. Mais il faut être clair sur ce que c'est : MCP est un protocole de transport, pas un produit fini. Il standardise comment l'agent et l'outil se parlent ; il ne décide pas quand l'agent doit agir, ne place pas une action risquée derrière un humain, et n'entraîne pas l'agent à votre ton. Il vous faut toujours quelque chose autour. C'est tout l'argument que je développe dans notre article sur l'exploitation d'un serveur MCP d'agent IA.
Connecter des agents à de vrais outils SaaS reste suffisamment compliqué pour revenir constamment dans les forums de développeurs :
Have you tried building any AI agent or using an AI product with Slack MCP? This is one of the hardest problems in SaaS data access and Slack tries to literally block any form of API or OAuth based access.

Plateformes de coéquipier IA : les connexions sont déjà en place
La quatrième option consiste à engager une plateforme qui a déjà fait le travail de connexion. C'est là qu'intervient eesel. Plutôt que de construire sur une API ou de mettre en place vous-même un serveur MCP, vous obtenez un coéquipier IA qui fournit déjà des connecteurs vers votre helpdesk, CRM, documents et outils de chat, et vous passez votre temps à configurer le comportement plutôt qu'à écrire de la plomberie.
Le compromis est l'image miroir du connecteur natif : vous obtenez une portée large et transversale et un contrôle complet lecture-réveil-action avec presque aucune construction, mais vous travaillez à l'intérieur du modèle de la plateforme quant au comportement des intégrations. Pour la plupart des équipes de support et d'opérations, c'est exactement le compromis qu'elles recherchent. C'est la différence entre un accès programmatique à un seul outil et un coéquipier qui vit déjà à travers tous.
Voici comment se comparent les quatre surfaces :
| Surface de connexion | Effort de configuration | Portée transversale | Contrôle du comportement | Idéal pour |
|---|---|---|---|---|
| Connecteur natif | Le plus faible (un interrupteur) | Faible, surtout ses propres données | Défini par l'éditeur | Tout se trouve dans un seul outil |
| API REST + webhooks | Le plus élevé (code personnalisé) | Tout ce qui possède un point de terminaison | Total | Un comportement qu'aucun connecteur n'offre |
| Serveur MCP | Moyen | Bon, par serveur publié | Le protocole, pas la politique | Développeurs connectant de nombreux outils |
| Plateforme de coéquipier | Faible (configurer) | Large, déjà construit | Lecture-réveil-action complet, sans code | Équipes qui veulent être en production vite |
Quelle surface convient à quel outil
Les surfaces ne sont pas interchangeables selon le type d'outil. Pour certains outils, vous voulez que l'agent agisse ; pour d'autres, vous voulez seulement qu'il lise. Faire correspondre la surface à la tâche évite beaucoup de configuration gaspillée.
| Catégorie d'outil | Exemples | Ce que vous voulez généralement | Surface la plus adaptée |
|---|---|---|---|
| Helpdesks | Zendesk, Freshdesk, Gorgias, Help Scout, Front | Lire + se réveiller + agir (rédiger et envoyer) | Plateforme de coéquipier ou natif |
| CRM | HubSpot, Salesforce | Lire les fiches, mettre à jour les champs | Plateforme de coéquipier ou API |
| Docs / connaissances | Confluence, Notion, Google Drive | Lecture seule (source) | Connecteur natif ou plateforme |
| Chat | Slack, Microsoft Teams | Se réveiller sur @mention, répondre, escalader | Plateforme ou MCP |
| E-commerce | Shopify | Consulter les commandes, vérifier le statut | Plateforme ou API |
Quelques schémas se dégagent de tout cela. Les helpdesks sont la catégorie où vous voulez le plus les trois plans, car tout l'intérêt est de rédiger et d'envoyer des réponses dans la file que vous exploitez déjà. C'est pourquoi j'y privilégierais une plateforme ou l'option native plutôt qu'une construction d'API brute, et c'est le cas que je détaille dans notre guide sur la connexion d'agents à votre helpdesk.
Les documents sont l'inverse. Vous ne voulez presque jamais qu'un agent écrive dans Confluence ; vous voulez qu'il lise Confluence pour que ses réponses soient fondées. Traitez-les comme des sources, connectez-les en lecture seule, et laissez-les se regrouper avec tout le reste.
Pour eesel en particulier, une connexion Slack est un bon exemple d'un outil de chat utilisé comme une intégration complète en trois parties : l'agent se réveille sur une mention, répond à partir de vos connaissances regroupées, et peut transférer à un humain.
La façon sûre de tout mettre en place, étape par étape
Quelle que soit votre façon de vous connecter, l'ordre dans lequel vous le faites compte plus que la surface que vous choisissez. J'ai vu un bot au ton confiant donner tranquillement de mauvaises réponses sur une file en direct, et c'est exactement pourquoi nous simulons désormais chaque déploiement sur des tickets historiques avant qu'il ne touche un client. Voici la séquence que je suivrais à chaque fois.
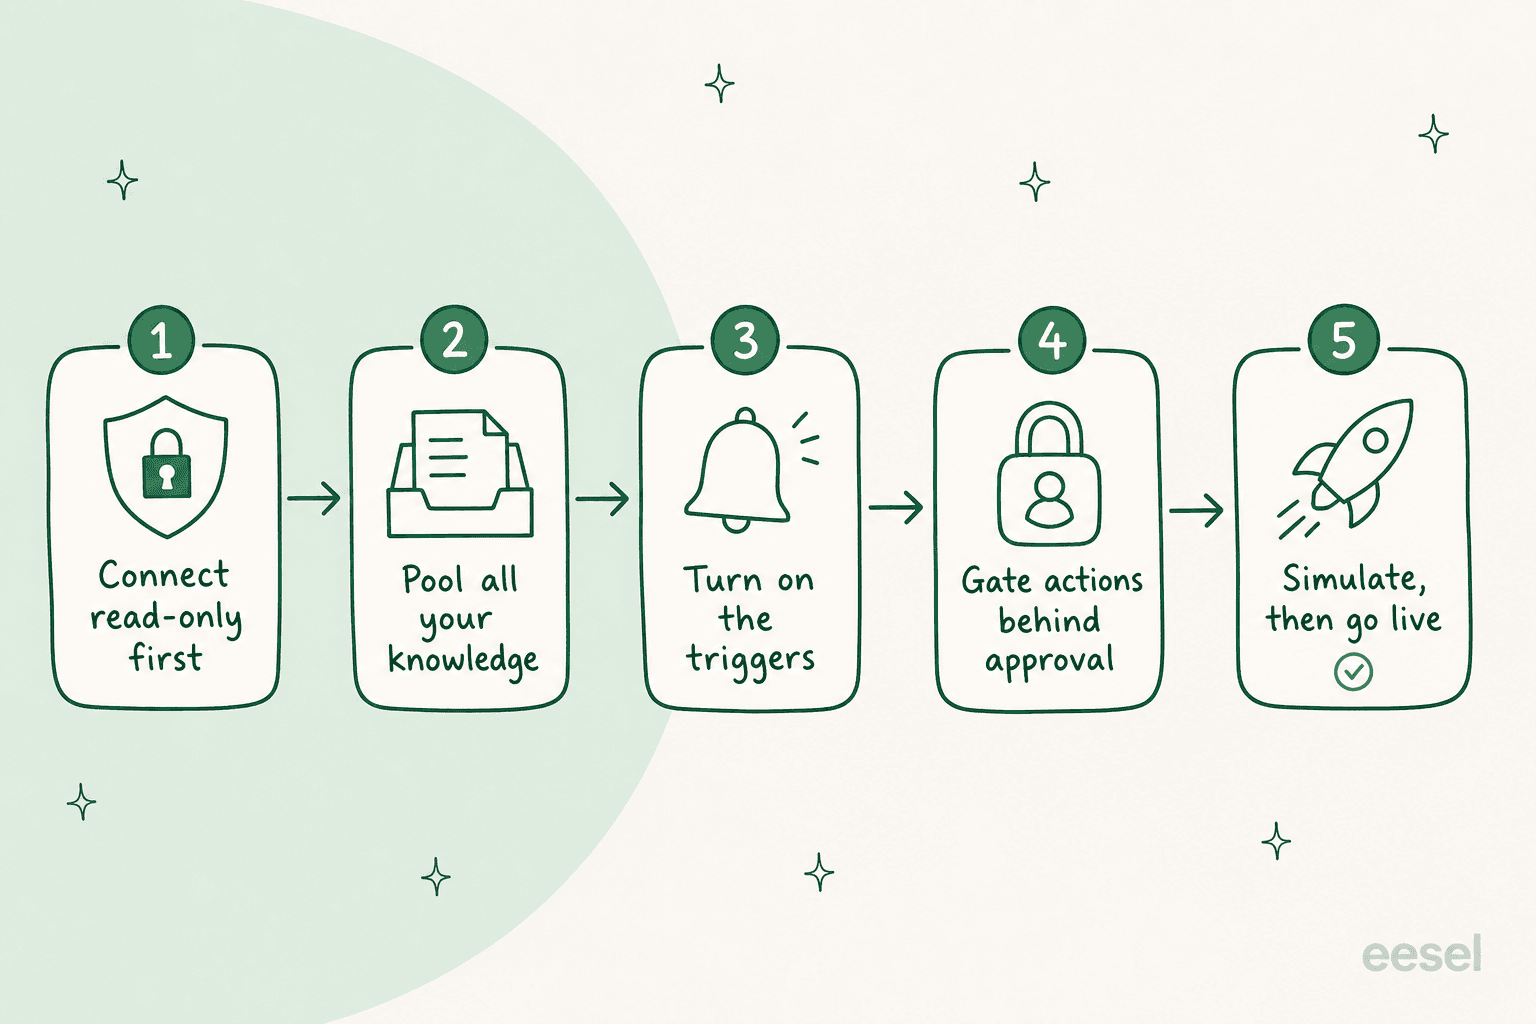
- Connectez d'abord en lecture seule. Connecter un outil ne fait qu'accorder un accès. Rien ne s'exécute tant que vous n'activez pas un déclencheur, alors connectez tout ce que vous pouvez en mode lecture seule et laissez l'agent apprendre à partir de cela en privé. La plupart des plateformes proposent une connexion rapide sans identification préalable pour exactement cela, même si elle ne lit généralement que le contenu public tant que vous n'effectuez pas une connexion complète.
- Regroupez toutes vos connaissances. Connectez chaque source avant de vous soucier des actions : centre d'aide, anciens tickets, wiki interne, documentation produit. La qualité de chaque réponse est plafonnée par ce que l'agent peut lire, et les anciens tickets sont généralement la source la plus riche, alors ne sautez pas la connexion complète qui les débloque.
- Activez les déclencheurs. Décidez quand l'agent doit se réveiller. Un nouveau ticket ? Un tag spécifique ? Un webhook provenant d'un autre système ? Commencez de façon restreinte, sur une seule file ou un seul sujet, avant d'ouvrir les vannes.
- Protégez les actions par une approbation. Chaque action devrait avoir trois états : entièrement automatique, soumise à approbation (l'agent rédige et attend un humain), ou désactivée. La plupart des équipes commencent par « l'agent rédige, un humain envoie », et ne font passer les actions en automatique qu'une fois qu'elles leur font confiance.
- Simulez, puis passez en production. Avant qu'un seul vrai client ne soit touché, faites tourner l'agent sur vos tickets historiques pour voir comment il aurait répondu. C'est l'étape que les gens sautent et regrettent ensuite. La simulation d'eesel fait exactement cela, afin que vous voyiez le comportement sur vos propres anciens tickets avant la mise en production.
Erreurs courantes lors de la connexion d'agents
Quelques pièges reviennent sans cesse, et tous sont évitables :
- Connecter un seul outil et considérer que c'est fait. Un agent relié uniquement à votre helpdesk ne peut pas consulter la commande dans Shopify ni la politique dans Confluence. La portée transversale est généralement tout l'intérêt de la démarche.
- Oublier que la connexion en lecture seule est limitée. Une connexion rapide sans identification préalable ne peut généralement pas voir vos anciens tickets ni effectuer d'actions. Si votre agent semble ne connaître que votre centre d'aide public, c'est généralement la raison. Effectuez la connexion complète.
- Activer l'envoi avant de lui faire confiance. Automatiser les réponses dès le premier jour, c'est le meilleur moyen d'obtenir une réponse assurée mais fausse devant un client. Rédiger d'abord, simuler ensuite, puis automatiser.
- Supposer que MCP est toute la solution. MCP connecte l'agent à l'outil, mais ne décide ni de la politique, ni du ton, ni de l'escalade. Il vous faut toujours une couche qui s'en charge. Notre point de vue sur les plateformes d'agents API-first explore où se situe cette couche.
- Stocker des identifiants bruts dans le prompt. L'authentification devrait résider dans la connexion, sous forme d'en-têtes que l'agent ne voit jamais, et non collée dans une instruction. Toute plateforme sérieuse, et l'accès réseau d'eesel, garde les secrets hors du modèle.
Essayez eesel
Si vous avez lu jusqu'ici, vous n'avez probablement pas envie de passer un trimestre entier à écrire et maintenir des intégrations d'API juste pour qu'un agent dialogue avec vos outils. C'est le vide que comble eesel. C'est un coéquipier IA qui se branche sur le helpdesk, le CRM, les documents et les outils de chat que vous utilisez déjà, lit dans tous en même temps, et agit à l'intérieur avec le même contrôle lecture-réveil-action que j'ai décrit plus haut, sans construction sur mesure.
Les éléments qui sécurisent la connexion sont intégrés : connexion en lecture seule, regroupement de vos connaissances, protection de chaque action par une approbation, et simulation sur vos tickets historiques avant la mise en production. Un client, Global Pay, a constaté jusqu'à 80 % de gain de temps une fois que son équipe a pu trouver instantanément des réponses dans toutes les sources connectées, un résultat partagé sur notre page tarifaire. Et pour les développeurs qui veulent vraiment le terminal, eesel propose une véritable CLI et un serveur MCP au-dessus des mêmes connecteurs.

C'est en libre-service et gratuit pour démarrer, sans carte bancaire ni appel commercial. Vous pouvez connecter votre premier outil et avoir un coéquipier qui lit vos connaissances en quelques minutes.
Questions fréquentes
Quelle est la différence entre une API et un serveur MCP pour les agents IA ?
Un agent IA peut-il à la fois lire et agir dans un outil comme Zendesk ?
Combien coûte la connexion d'un agent IA à des outils métier ?
Que se passe-t-il si je connecte un outil mais que je ne veux pas encore que l'agent y agisse ?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.




Comment connecter un agent IA à mes outils métier ?