

Le meilleur modèle d'IA pour les tickets de support en 2026 est Qwen 3.8 Max d'après les chiffres, mais le modèle n'est pas la variable qui décide si votre file fonctionne. Sur τ-bench, le seul benchmark public qui oblige un agent d'IA à récupérer des réponses dans une vraie base de connaissances de 698 documents, puis à agir en conséquence, Qwen 3.8 Max obtient 55,2 % au premier essai, Claude Opus 5 atteint 48,7 %, et Claude Fable 5, le modèle le plus cher du marché, arrive sixième à 39,7 %.
Voici la partie qui devrait changer ce que vous faites ensuite. Prenez un modèle et gardez-le constant. Claude Opus 4.5 obtient 92,3 % sur le domaine télécoms, où la réponse se trouve derrière un appel d'outil, et 24,7 % sur le domaine bancaire, où la réponse se trouve dans un tas de documents. Même modèle, même semaine, 68 points d'écart, décidés entièrement par la façon dont la connaissance était stockée. L'écart entre le meilleur et le pire modèle du peloton actuel est de 30 points. L'écart créé par l'endroit où vous placez votre documentation est de 68.
Et l'argument du coût est lui aussi à l'envers. Claude Opus 5 revient à environ 0,11 $ par ticket avec des volumes de tokens réalistes. Zendesk facture 1,50 $ par résolution automatisée en plus. Vous marchandez 7 % de la facture.
Donc : choisissez un modèle compétent de milieu de gamme, consacrez l'effort économisé à votre base de connaissances et à vos règles d'escalade, et testez le tout sur votre propre historique de tickets avant qu'un client ne le voie. Cette dernière étape, c'est ce que fait eesel, en rejouant vos anciens tickets et en notant les réponses de l'IA par rapport à ce que votre équipe a réellement envoyé.
La question qu'on me pose, et celle qui décide vraiment
Je construis des agents d'IA chez eesel, et la question la plus courante des responsables techniques du support qui évaluent des logiciels de service client avec IA est une version de « quel modèle devrions-nous utiliser ? ». C'est une question raisonnable. C'est aussi, la plupart du temps, la mauvaise première question.
Je le sais parce que j'ai vu ce qui se passe quand les équipes y répondent et s'arrêtent là. Quelques-uns de nos propres clients sont partis construire leur propre solution directement sur les API de pointe. En regardant honnêtement cette liste, on y trouve une entreprise de réalité augmentée et de technologie du bâtiment et une marque de beauté DTC, cette dernière partant directement sur l'API de Claude. Ce n'est pas une critique. Ce sont des équipes d'ingénierie compétentes et l'API est vraiment bonne. Mais chacune cherchait à résoudre le problème du modèle, et le modèle n'a jamais été la partie difficile.
Le responsable ingénierie d'une entreprise de distributeurs de Bitcoin sur notre offre Team, avec une base Confluence de 300 articles, a exprimé l'autre côté sans détour :
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Deux équipes, la même question de départ, des conclusions opposées. La différence entre elles n'est pas le modèle choisi. C'est d'avoir ou non un moyen de savoir si la chose fonctionnait.
Cet article est ma tentative de répondre correctement à la question du modèle, avec de vrais chiffres, puis de vous montrer pourquoi la réponse compte moins que ce qui se trouve en dessous.
Il existe un benchmark conçu exactement pour cela, et presque personne ne le cite
Chaque lancement de modèle cite MMLU, SWE-bench, GPQA ou l'un des indices agrégés d'intelligence. Aucun ne dit rien d'utile sur la capacité d'un modèle à clore un ticket de support, car clore un ticket de support n'est pas un test de connaissances. C'est une séquence : comprendre une demande confuse, trouver la politique pertinente, appeler les bons outils dans le bon ordre, refuser ce qu'on n'a pas le droit de faire et laisser la base de données dans le bon état. C'est la différence entre un modèle de langage et un système de tickets avec IA qui fonctionne.
Sierra a construit un benchmark précisément pour cela, et il s'appelle τ-bench. L'article original de τ-bench est paru en 2024 avec des domaines retail et aérien. τ²-bench a ajouté un domaine télécoms en 2025, et sa contribution clé était de faire agir aussi l'utilisateur, de sorte que l'agent doit guider un client à travers des étapes que seul le client peut réaliser. C'est le support technique tel qu'il se passe vraiment. La conclusion de l'article lui-même est sans détour : les performances chutent nettement dès que l'agent doit guider un utilisateur au lieu d'agir simplement à sa place.
Puis, en 2026, est arrivée la version qui compte le plus pour les équipes de support. τ³-bench a ajouté τ-Knowledge, un domaine bancaire où l'agent doit travailler à partir d'une base de connaissances plutôt que d'une liste d'outils bien rangée.
Voici à quoi ressemble cette base de connaissances, d'après le texte de Sierra lui-même : 698 documents répartis en 21 catégories de produits, environ 195 000 tokens. Chaque tâche demande en moyenne 18,6 documents et 9,5 appels d'outils, certaines allant jusqu'à 33. Les tâches sont notées selon que l'agent a produit le bon état final de la base de données, pas selon que la réponse se lisait bien.
Si vous vous êtes déjà demandé pourquoi votre centre d'aide semble lutter contre l'IA, c'est la version benchmark de votre centre d'aide. C'est aussi pourquoi les guides de déflexion passent plus de temps sur le contenu que sur les réglages du modèle.
La falaise de la récupération
C'est le graphique que j'accrocherais au mur de quiconque évalue l'IA pour les systèmes de tickets.
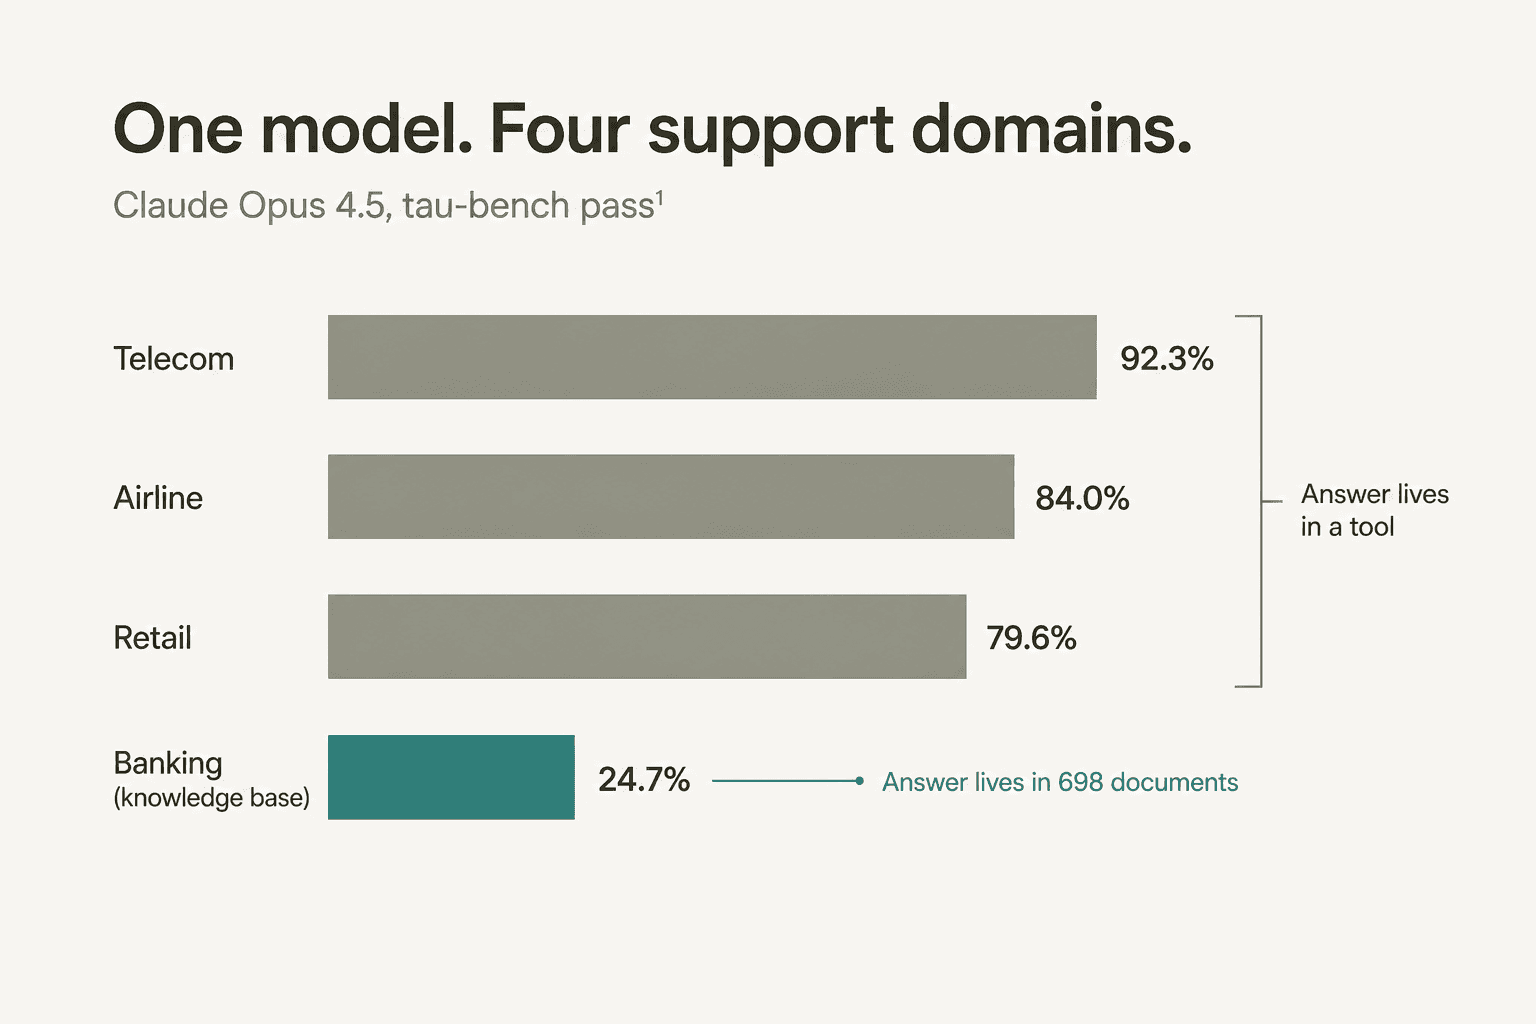
Un modèle. Une exécution d'évaluation. Quatre domaines. Télécoms 92,3 %, aérien 84,0 %, retail 79,6 %, banque 24,7 %.
Les trois premiers domaines donnent à l'agent un ensemble propre d'outils et la réponse est accessible en les appelant. Le quatrième oblige l'agent à d'abord aller chercher la réponse dans des documents. Ce seul changement coûte 68 points, soit plus que tout l'écart entre le meilleur et le pire modèle de pointe sur le même test.
Qwen3.5-397B montre la même forme de façon encore plus crue : 97,81 % en télécoms contre 9,79 % en banque. Un effondrement de 88 points avec les mêmes poids.
Je veux être prudent sur ce que cela prouve et ne prouve pas. C'est un seul benchmark, et un benchmark synthétique. Mais le mécanisme qu'il révèle est exactement celui que je vois en production. Quand un client me dit que son chatbot de base de connaissances avec IA « n'est pas assez intelligent », neuf fois sur dix environ le modèle est bon et la récupération ramène les trois mauvais paragraphes.
Le classement 2026 pour les tickets de support
Sierra a lancé un nouveau lot le 04/08/2026 couvrant l'essentiel de la frontière actuelle. Toutes ces entrées ont utilisé la même configuration de récupération, le même simulateur d'utilisateur GPT-5.2, la même version du benchmark et quatre essais, elles se comparent donc proprement entre elles.
| Modèle | Fournisseur | Correct au 1er essai | Correct 4 sur 4 | Niveau d'effort |
|---|---|---|---|---|
| Qwen 3.8 Max | Qwen | 55,2 % | 35,1 % | xhigh |
| Claude Opus 5 | Anthropic | 48,7 % | 32,0 % | max |
| Grok 4.5 | xAI | 47,9 % | 32,0 % | high |
| GPT-5.6 Sol | OpenAI | 46,9 % | 27,8 % | xhigh |
| Meta Muse Spark 1.1 | Meta | 40,5 % | 20,6 % | xhigh |
| Claude Fable 5 | Anthropic | 39,7 % | 28,9 % | max |
| Claude Opus 4.8 | Anthropic | 39,7 % | 22,7 % | max |
| GLM-5.2 | Z.ai | 37,1 % | 13,4 % | xhigh |
| Kimi K3 | Moonshot AI | 37,1 % | 17,5 % | max |
| Inkling | Thinking Machines Lab | 25,0 % | 11,3 % | max |
Plusieurs choses sautent aux yeux dans ce tableau.
Le modèle le plus cher n'est pas le meilleur. Claude Fable 5 est facturé 10 $ par million de tokens en entrée et 50 $ par million en sortie. Qwen 3.8 Max est facturé 2 $ et 6 $. Le modèle moins cher marque 15,5 points de plus sur la tâche de support. Si vous supposiez que le prix de pointe achète des performances de pointe en support, ce n'est pas le cas.
Les écarts entre les quatre premiers sont faibles. De Qwen 3.8 Max à GPT-5.6 Sol, il y a 8,3 points, et d'Opus 5 à Grok 4.5 moins d'un point. Ce ne sont pas des classes d'outils différentes. Ce sont des voisins.
Le progrès est réel mais lent. Claude Opus 4.5 obtenait 24,7 % sur ce domaine en février. Opus 5 l'a doublé à 48,7 % en août. Un vrai progrès sur deux générations. Cela veut quand même dire que le modèle se trompe plus souvent qu'il ne réussit, un point de départ très différent de ce qu'implique d'habitude une comparaison de fournisseurs de chatbots.
Deux modèles évidents manquent. Ni Gemini 3.7 Flash ni DeepSeek V4 Flash n'ont de soumission sur ce domaine, je ne peux donc pas les classer honnêtement ici. Les anciennes entrées Gemini utilisaient une autre configuration de récupération, ce qui les rend non comparables plutôt que simplement plus basses.
Une note de méthode à retenir : les entrées plus anciennes du classement utilisaient d'autres configurations de récupération, les comparaisons entre lots sont donc plus fragiles qu'elles n'en ont l'air. Sierra a aussi renoté le domaine bancaire en juillet 2026 et indique que les résultats antérieurs à cette correction ne sont pas comparables. Quiconque cite un score bancaire du début de l'année en cite probablement un périmé.
Juste une fois n'est pas juste à chaque fois
La colonne que la plupart des gens sautent est celle que je regarderais en premier.
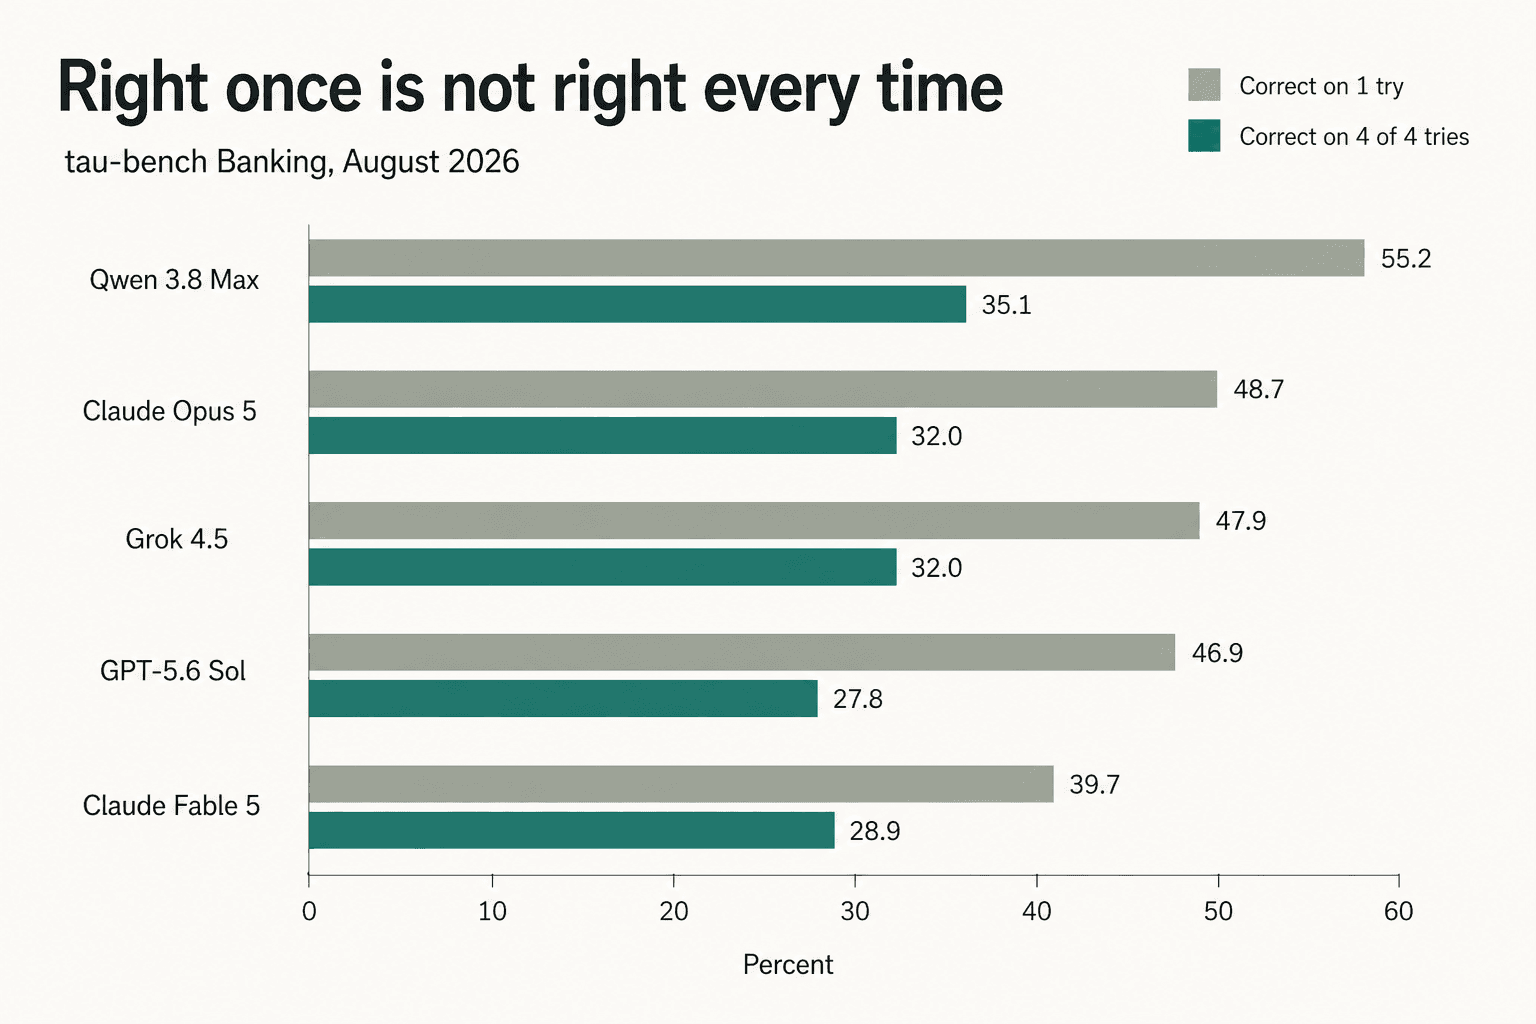
τ-bench rapporte pass^k, qui demande si un modèle a réussi la même tâche à chacun de k essais indépendants. Pass^1, c'est « il sait le faire ». Pass^4, c'est « il le fait de façon fiable ».
Le meilleur modèle du peloton est correct de façon fiable sur 35,1 % de ces tâches. Opus 5 passe de 48,7 % à 32,0 %. GPT-5.6 Sol passe de 46,9 % à 27,8 %. GLM-5.2 s'effondre, de 37,1 % à 13,4 %, ce qui indique qu'il devine bien plutôt qu'il ne raisonne de façon constante.
Cet écart entre pass^1 et pass^4 est le chiffre qui décide si vous pouvez laisser une IA seule avec une file. Un modèle à 48,7 % de pass^1 et 32,0 % de pass^4 n'est pas un modèle qui résout la moitié de vos tickets. C'est un modèle qui traitera le même type de ticket différemment selon le jour.
Une responsable CX d'une marque DTC de compléments alimentaires qui traite environ 7 000 tickets Gorgias par mois m'a dit la version opérationnelle de cela mieux que n'importe quel benchmark :
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
C'est pass^k énoncé comme une exigence métier. La variance n'est pas un problème de qualité qu'on règle avec un meilleur modèle, c'est un problème de routage qu'on règle avec une escalade fondée sur la confiance. Tous les déploiements de support sérieux sur lesquels j'ai travaillé finissent ici, et c'est la raison pour laquelle une configuration de copilote est souvent une première phase plus sûre que l'autonomie complète.
Les trois façons dont les modèles échouent vraiment sur un vrai ticket
Sierra a publié la taxonomie des échecs en même temps que le benchmark, et la lire m'a paru désagréablement familier. Ce ne sont pas des échecs exotiques d'IA. Ce sont exactement les trois choses dont se plaignent les responsables du support.
Il rate la politique qui dépend d'une autre politique. Dans l'exemple du benchmark, un client veut contester une transaction et demander une augmentation de sa limite de crédit. L'agent cherche la politique de contestation, la trouve et dépose d'abord la contestation parce que c'est l'ordre dans lequel le client l'a demandé. Il ne cherche jamais la politique de limite de crédit, qui dit que les augmentations de limite sont automatiquement refusées lorsqu'une contestation est en cours. Le client reçoit un refus qu'un agent humain aurait évité en faisant les deux étapes dans l'autre ordre.
Il annonce un succès pour quelque chose qui a échoué. Beaucoup d'outils du benchmark doivent être déverrouillés avant utilisation. Quand l'agent saute cette étape et reçoit une erreur, le texte de Sierra note que certains agents hallucinent alors une réponse de succès à l'utilisateur. C'est le mode d'échec qui vous coûte un client plutôt qu'un ticket. Une équipe danoise de télématique de véhicules B2B sur Zendesk, avec environ 200 tickets par mois et en route vers 2 000, a connu la version grand public de cela quand son bot a confirmé la prise en charge de marques de voitures absentes de la base de données, parce que la base de connaissances disait « nous prenons en charge tous les modèles ».
Il croit le client. Quand l'utilisateur simulé affirme que sa contestation a été approuvée, les agents appliquent souvent le crédit sans vérifier le statut réel. Chaque équipe de support en a une version. Un responsable du support eCommerce a été direct dans notre propre chat du tableau de bord :
"stop promising customer things we cant do. we cannot guarantee this customer's order to them by friday"
Aucun de ces trois problèmes n'est résolu par un modèle plus gros. Ils se résolvent en limitant ce que l'agent a le droit de toucher. Il y a un commentaire sur Hacker News qui le formule mieux que la plupart des documentations de fournisseurs :
"Give your LLM the same level of permissions that you would give a human you just hired in the same role. The examples given, tricking the customer support LLM into sending text messages to all users, or into transferring money, are not things that you would ever give a human customer support agent the tools to do."

C'est toute la posture de sécurité et de fiabilité en deux phrases, et l'adopter ne coûte rien. C'est aussi ainsi que se construit la plupart de l'automatisation du service client durable, une permission étroite à la fois.
Ce que coûte réellement chaque modèle par ticket
Mettons de vrais chiffres, car « ça dépend de votre usage » n'est pas une réponse.
Un ticket de support traité avec récupération a une forme assez prévisible. Disons 15 000 tokens en entrée (prompt système, politique, extraits récupérés de la base de connaissances, historique de la conversation) et 1 500 tokens en sortie (la réponse plus les tokens de raisonnement, facturés au tarif de sortie chez tous les grands fournisseurs). Vos chiffres différeront, mais les rapports entre modèles ne changeront pas.
| Modèle | Entrée / sortie par 1 M | Coût pour 1 000 tickets | Par ticket |
|---|---|---|---|
| Claude Fable 5 | $10.00 / $50.00 | $225.00 | $0.225 |
| GPT-5.6 Sol | $5.00 / $30.00 | $120.00 | $0.120 |
| Claude Opus 5 | $5.00 / $25.00 | $112.50 | $0.113 |
| Kimi K3 | $3.00 / $15.00 | $67.50 | $0.068 |
| GPT-5.6 Terra | $2.00 / $12.00 | $48.00 | $0.048 |
| Claude Sonnet 5 | $2.00 / $10.00 | $45.00 | $0.045 |
| Qwen 3.8 Max | $2.00 / $6.00 | $39.00 | $0.039 |
| Claude Haiku 4.5 | $1.00 / $5.00 | $22.50 | $0.023 |
| Gemini 3.7 Flash | $0.75 / $3.75 | $16.88 | $0.017 |
| GPT-5.6 Luna | $0.20 / $1.20 | $4.80 | $0.005 |
| DeepSeek V4 Flash | $0.22 / $0.66 | $4.29 | $0.004 |
Les tarifs proviennent de la page de prix de chaque fournisseur. Les chiffres d'Anthropic et de Qwen sont liés dans la section ci-dessus ; les autres se trouvent sur la grille tarifaire d'OpenAI et sur celle de Google, celle de DeepSeek étant liée plus bas.
Quatre pièges se cachent dans ce tableau.
Le prix de Gemini est promotionnel. Les 0,75 $ et 3,75 $ de Google courent jusqu'au 31 décembre 2026, puis doublent à 1,50 $ et 7,50 $ le 1er janvier. Si vous construisez aujourd'hui un modèle de coûts sur Gemini 3.7 Flash, construisez-le sur le tarif de l'an prochain.
DeepSeek facture désormais selon l'heure de la journée. La grille de DeepSeek indique des heures de pointe de 01:00 à 04:00 et de 06:00 à 10:00 UTC à exactement le double du tarif creux, de sorte que les 0,22 $ et 0,66 $ ci-dessus passent à 0,44 $ et 1,32 $ pendant ces plages. Ces heures suivent les heures de bureau chinoises, qui, pour une file de support américaine ou européenne, tombent surtout en dehors de votre période la plus chargée. C'est une particularité réellement en votre faveur, et aussi fragile.
Les 2 $ et 10 $ de Sonnet 5 sont un tarif de lancement. Le tarif publié d'Anthropic revient à 3 $ et 15 $ le 31 août 2026. C'est dans deux semaines à la date de cette rédaction.
La résidence des données s'accompagne d'une majoration. Anthropic applique un multiplicateur de 1,1 quand vous limitez l'inférence aux États-Unis, et OpenAI facture 10 % de plus sur les points d'accès de traitement régionaux pour les modèles sortis après le 5 mars 2026. Si vous traitez des données personnelles de clients sous une exigence de résidence, ajoutez-le.
Essayez les chiffres sur votre propre volume
Le modèle représente environ 7 % de votre facture
Lancez ce calculateur avec n'importe quel compteur de plateforme réaliste et la forme de la réponse cesse de changer.
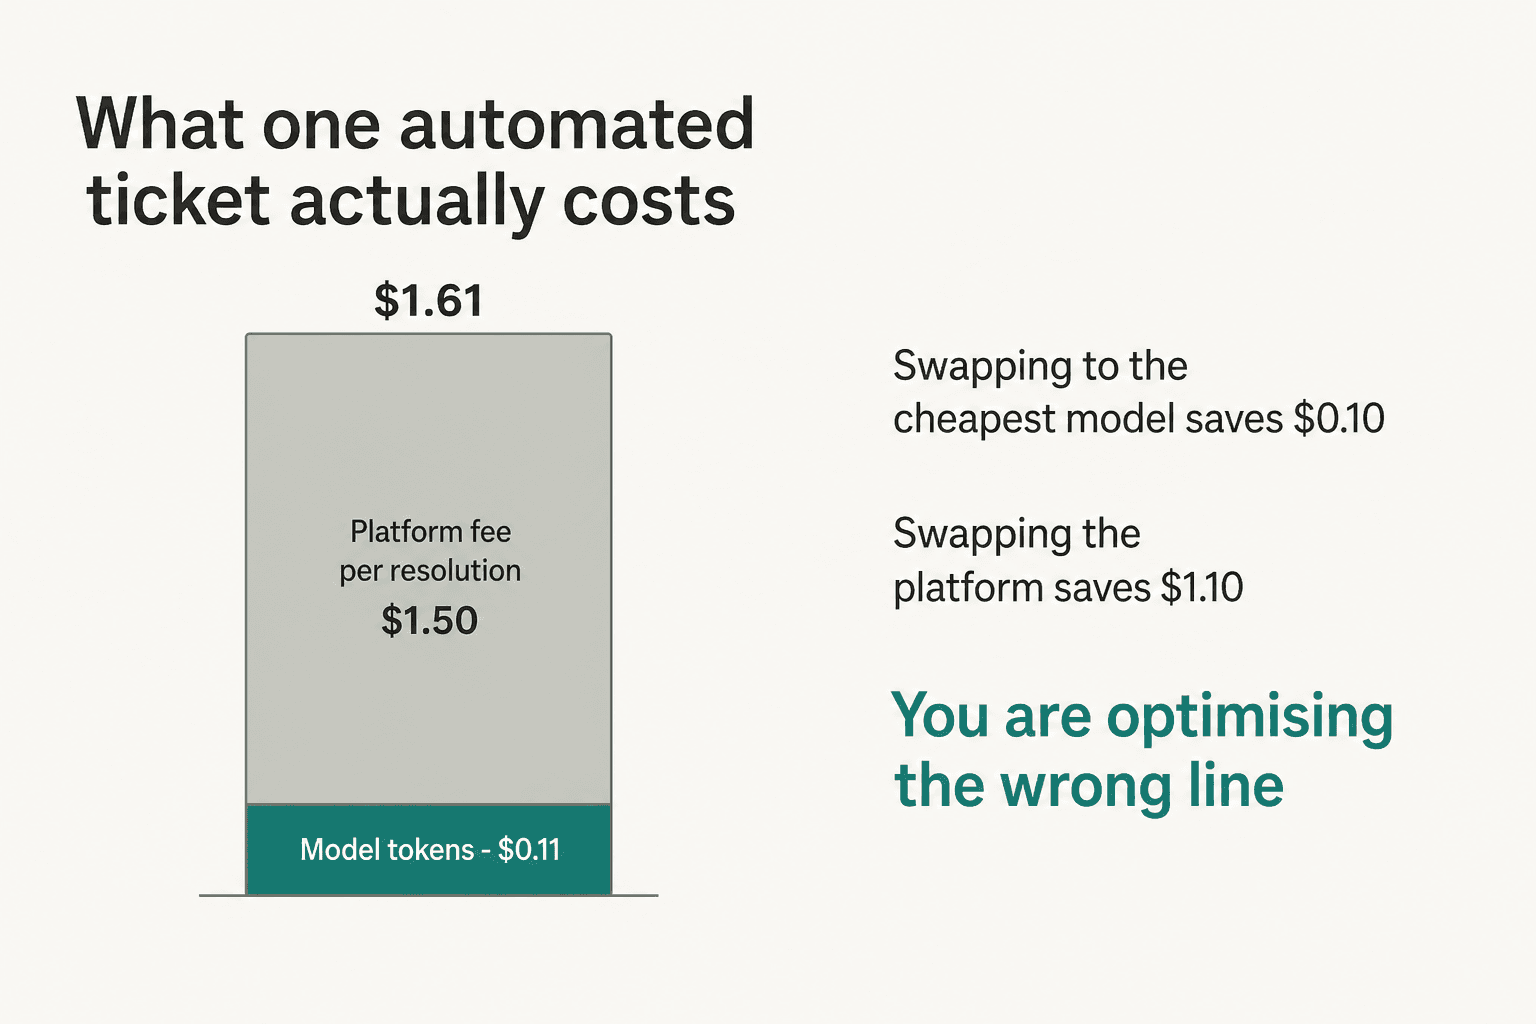
Zendesk publie 1,50 $ par résolution automatisée avec engagement et 2,00 $ en paiement à l'usage, dans le tableau de comparaison des offres plutôt que sur les cartes des offres. Gorgias facture de 0,85 $ à 1,00 $ par interaction automatisée selon l'offre. Freshdesk facture 0,49 $ par session au-delà des 500 incluses. Help Scout facture 0,75 $ par résolution, avec la règle la plus équitable de la catégorie : une résolution par conversation, quel que soit le nombre de questions auxquelles l'IA répond à l'intérieur.
Placez Claude Opus 5 derrière le tarif d'engagement de Zendesk et votre coût par ticket est de 1,61 $, dont 0,11 $ pour l'intelligence elle-même. Passer au modèle le moins cher du marché vous fait économiser six centimes et vous coûte neuf points de benchmark. C'est le pire marché de tout cet article.
L'unité facturée compte aussi plus que le tarif. Un compteur par session refacture quand un ticket résolu rouvre le lendemain. Un compteur par interaction facture même quand l'IA transfère à un humain. Si votre taux de réouverture est élevé, ces deux détails vous coûtent plus que n'importe quelle décision de modèle. Notre analyse du taux de résolution de l'IA explique comment les définitions diffèrent d'un fournisseur à l'autre. Pour la comparaison avec une base d'effectifs, voir coût de l'IA face à un agent humain.
Alors quel modèle choisir vraiment
Voici ma lecture honnête, avec le raisonnement joint plutôt qu'un haussement d'épaules sur vos besoins spécifiques.
Si vous voulez les meilleurs scores de support et que la résidence des données n'est pas un blocage : Qwen 3.8 Max. Il domine le domaine de connaissances avec 55,2 % et coûte 2 $ et 6 $, moins de la moitié du tarif de sortie d'Opus 5. Le revers est réel et vous devez le peser sérieusement : il est servi depuis Alibaba Cloud, ce qui, pour la plupart des équipes de support occidentales traitant des données personnelles de clients, est une discussion de conformité avant d'être technique. Vérifiez vos obligations d'accord de traitement des données avant de vérifier le benchmark.
Si vous avez besoin d'un choix par défaut hébergé en Occident : Claude Opus 5 ou GPT-5.6 Sol. Ils sont à moins de deux points l'un de l'autre sur le benchmark et à moins de huit centimes pour mille tickets. Opus 5 a une fiabilité légèrement meilleure sur quatre sur quatre, 32,0 % contre 27,8 %, ce qui compte si vous automatisez sans supervision. Les deux sont bien documentés et soutenus par de vrais accords entreprise.
Si vous avez un gros volume avec une base de connaissances propre et petite : Gemini 3.7 Flash ou Claude Haiku 4.5. Il n'existe pas de soumission bancaire τ-bench pour l'un ni l'autre, je ne peux donc pas les classer honnêtement face au peloton. Ce que je peux dire, c'est que la falaise de la récupération joue dans les deux sens : quand votre base de connaissances compte 40 articles bien écrits plutôt que 698 documents en désordre, la tâche ressemble beaucoup plus au domaine télécoms où presque tout dépasse 80 %. Évaluez avec soin le tarif promotionnel côté Gemini.
Si votre budget est serré et que vous pouvez accepter de la variance : DeepSeek V4 Flash. C'est de loin l'option crédible la moins chère, et les plages creuses favorisent réellement les heures de bureau occidentales. Deux réserves. Les conditions de son API payante sont muettes sur l'usage pour l'entraînement plutôt qu'explicitement protectrices, et il n'existe pas d'option de rétention zéro publiée, ce n'est donc pas un remplacement direct pour des données clients. Et Artificial Analysis a mesuré un taux d'hallucination élevé, exactement le mauvais mode d'échec pour une réponse visible du client.
Passez votre tour sur Claude Fable 5 pour ce travail. C'est un modèle superbe et le plus cher ici, à 10 $ et 50 $. Sur le benchmark de support, il se classe sixième, derrière Opus 5 et GPT-5.6 Sol, qui coûtent la moitié ou moins. Aucune lecture des données n'en fait le bon choix pour une file de tickets. Il en va de même pour Kimi K3 : à 3 $ et 15 $, il coûte plus que Qwen 3.8 Max et marque 18 points de moins.
Une dernière chose à dire clairement : les taux d'hallucination sont allés dans la mauvaise direction sur cette génération. Artificial Analysis a mesuré le taux de Claude Opus 5 en hausse de 14 points à 50 %, et Gemini 3.7 Flash qui régresse à 64,5 % contre 55,6 % pour Gemini 3.6 Flash, alors même que la précision s'améliorait. Les modèles sont devenus plus intelligents et plus sûrs d'eux dans l'erreur en même temps. Pour l'IA en service client, cet échange est mauvais d'une façon qui ne l'est pas pour un assistant de programmation, parce qu'une mauvaise réponse part directement chez un client.
Ce qu'il faut corriger avant de toucher à la liste déroulante des modèles
Si la falaise de la récupération est réelle, et je pense que les preuves sont solides, voici où se trouve réellement le levier.
Corrigez d'abord la base de connaissances. C'est le changement au meilleur rendement disponible. La discussion sur τ-bench sur Hacker News contient une démonstration du principe qui m'est restée : quelqu'un a réécrit les documents de politique du benchmark en arbres de décision clairs et en étapes numérotées, sans toucher au modèle ni aux tâches, et a fait progresser GPT-5-mini de 22 %. L'explication de l'auteur sur le pourquoi est la ligne la plus acérée du fil :
"If a model only performs well once the rules are clarified, that's still revealing something important about its agency: it's brittle when policies are ambiguous, but much stronger when they're structured."
Vingt-deux points en réécrivant la documentation. Aucun changement de modèle n'en approche. Nos guides sur l'IA pour la gestion des connaissances et les meilleurs outils de base de connaissances couvrent le côté pratique.
Limitez les outils comme vous le feriez pour une nouvelle recrue. Retour à la question des permissions. Si l'IA ne peut pas émettre de remboursements au-dessus d'un seuil, on ne peut pas la convaincre d'en émettre un. C'est moins cher et plus fiable que de lui demander dans le prompt de ne pas le faire, et c'est ce qui sépare un vrai coéquipier IA d'un chatbot avec des clés d'API. Les exemples d'agents qui fonctionnent ont plutôt des listes d'outils étroites que des prompts astucieux.
Routez selon la confiance, pas selon le type de ticket. Pass^k dit que le même modèle traite le même ticket différemment d'une exécution à l'autre. La réponse n'est pas un meilleur modèle, c'est de laisser l'IA s'abstenir. Mettez en place des règles de transfert qui traitent « je ne suis pas sûr » comme un résultat valide et courant plutôt que comme un échec. C'est aussi là que le coaching d'agents se rentabilise, car les tickets refusés vous disent quoi rédiger ensuite.
Mesurez les bonnes choses en production. Un commentateur de Hacker News a décrit un fournisseur qui suivait τ-bench aérien sur une moyenne glissante de 32 jours, avec le taux d'erreur des appels d'outils et le taux d'erreur des sorties structurées. C'est un meilleur tableau de bord que le seul taux de résolution, car il sépare « le modèle s'est trompé » de « le modèle a appelé le mauvais outil ». Notre article sur les métriques du service client couvre ce qu'il faut leur associer.
Testez sur votre propre historique avant la mise en production. Chaque benchmark de cet article est la file de quelqu'un d'autre. La vôtre a d'autres produits, d'autres cas limites et un autre ton. Le seul test qui vous dit si un modèle fonctionnera pour vous est un rejeu de vos propres tickets résolus.
Ce dernier point n'est pas facultatif, et c'est l'étape que les équipes qui construisent sur l'API brute sautent le plus souvent. C'est aussi la raison pour laquelle un classement de benchmark doit nourrir votre présélection et ne jamais la décider.
Essayez eesel sur votre file de tickets
Tout ce qui précède mène à la même conclusion : le modèle est un composant, et ce qui décide si votre automatisation du support fonctionne, c'est l'échafaudage autour. Cet échafaudage, c'est eesel.
L'élément que je mettrais en avant, vu l'argument de cet article, est la simulation. Vous pouvez demander à eesel de lancer une simulation sur vos tickets récents : il rejoue des centaines de vos anciens tickets et note les réponses de l'IA par rapport à ce que votre équipe a réellement envoyé, puis vous renvoie les écarts et des modifications d'instructions suggérées. C'est le problème de pass^k traité avec vos propres données plutôt que celles d'un benchmark. Il ne vous prévoit pas de taux de résolution, et je me méfierais de tout fournisseur qui prétend le faire.

Il se connecte à Zendesk, Gorgias, Freshdesk, Front, Help Scout, HubSpot, Salesforce et Jira Service Management. La tarification est un prix mensuel fixe à partir de 299 $/mois pour 500 crédits (1 crédit par ticket ou chat), sans frais par siège. Il existe une offre gratuite de 100 crédits sans carte, ce qui, pour la plupart des équipes, représente assez de vrais tickets pour tester.
Si vous comparez des noms de modèles dans un tableur depuis une semaine, voici le raccourci : choisissez l'un des quatre premiers, connectez votre helpdesk, rejouez vos propres tickets et laissez les résultats vous dire si le modèle a jamais été le problème.