


L'IA pour le suivi des demandes de fonctionnalités fait quatre choses : elle repère la demande dans un ticket de support, la distingue des bugs et des questions d'utilisation, la relie à une demande partagée pour que la demande soit comptée, et répond à tous ceux qui l'ont faite une fois la fonctionnalité livrée. Les trois premières sont bien couvertes par des outils comme Canny, Linear et Productboard. La quatrième, la réponse, est celle que presque aucun ne fait dans le ticket, et c'est celle que vos clients remarquent.
Mettez-la donc en place du côté du support, pas du côté du produit. Laissez l'IA étiqueter chaque ticket à partir d'une liste figée, créer ou retrouver la demande correspondante et garder le ticket lié. Quand la demande est livrée, ces tickets liés sont votre liste de notification. L'Autopilot de Canny est inclus dans tous les forfaits et lit seul les tickets fermés. L'intégration Zendesk de Linear rouvre le ticket quand l'issue est terminée, mais une personne écrit toujours la réponse.
Si votre file tourne sur Zendesk, Freshdesk ou Gorgias et votre équipe produit sur Jira, eesel fait la moitié support en une seule passe : il étiquette la demande, cherche dans Jira une issue existante avant d'en créer une nouvelle et rédige la réponse « c'est en ligne » quand l'issue se ferme. smava l'utilise déjà pour classer 14 600 tickets Zendesk par mois dans des champs, c'est-à-dire la même compétence sur laquelle repose l'étiquetage des demandes de fonctionnalités.
Que fait réellement l'IA pour le suivi des demandes de fonctionnalités ?
L'IA pour le suivi des demandes de fonctionnalités lit chaque conversation de support, décide si le client demande quelque chose que le produit ne fait pas encore, et en fait un enregistrement compté et lié que votre équipe produit peut exploiter. Elle ne décide pas de ce qui sera construit.
Je m'occupe de la file de support d'eesel et je vois la version brute de cela tous les jours. Quelqu'un envoie quatre paragraphes sur une question de facturation, puis la toute dernière ligne dit « et ce serait super si ça s'exportait vers Sheets ». Cette ligne est la demande. Pour un product manager, le reste est du bruit, et un commentateur de Hacker News l'avait dit des années avant que les LLM puissent aider :
"The Customer Support teams of your customers are going to be one of the main channels for capturing feature requests. We use Zendesk and have custom fields for categorizing and sub-categorizing requests along with a brief description. We do this so that the PMs don't have to read the entire Support ticket if one sentence is about the feature request out of 10 pages of text."

C'est à peu près tout le travail. Vous extrayez la phrase et vous la classez là où elle est comptée, en gardant le lien vers le ticket. Pour l'IA, cela se décompose en quatre étapes :
- La repérer. Trouver la demande, même enfouie dans un ticket sur autre chose.
- La trier. Est-ce une vraie demande, un bug, une question d'utilisation ou quelque chose que le produit fait déjà ?
- La lier et la compter. Rattacher le ticket à une demande partagée, plutôt que d'en ouvrir une nouvelle à chaque fois.
- Répondre à la livraison. Utiliser les tickets liés pour prévenir chaque client qui l'a demandée.
Les étapes une à trois sont la partie « suivi » et recoupent largement l'étiquetage de tickets par IA et la déduplication de tickets. La plupart des configurations s'arrêtent avant l'étape quatre. Si vous avez déjà un programme de voix du client, voyez ceci comme la tranche « tickets de support » de ce programme.
Pourquoi les demandes de fonctionnalités se perdent-elles dans le support ?
Les demandes de fonctionnalités se perdent parce que le support les note dans ce qui est le plus à portée de main, tandis que le produit va les chercher ailleurs. Le ticket dit « j'ai transmis ça à l'équipe ». Après cela, la demande finit dans un fil Slack ou une feuille de calcul, ou peut-être dans une étiquette de ticket dont personne ne fait de rapport.
Voici la version tableur, d'un Head of Product sur Reddit :
"So, what ends up happening is each of these customers has a google sheet of their asks/needs/requests. As the Head of Product, I am always checking these spreadsheets and trying to prioritize burning asks into our dev cycles. Its a nightmare to see it all in one place, and understand "what is the biggest need from our clients right now". I find myself prioritizing one feature only impacting a $400K client vs. a feature that would benefit 10 $20K clients."

Et voici le côté client du même désordre, de quelqu'un dont le ticket est resté un mois sans réponse :
"I'm not asking for instantaneous results. I'm asking for communication. My ticket sat untouched for something like a month before I sent a support ticket in and it was then tagged as a feature request."
Regardez ce qui a vraiment agacé ce client. Ce n'est pas que la fonctionnalité n'ait pas été livrée. C'est que le ticket a été étiqueté comme demande de fonctionnalité et que plus rien n'est revenu. Une étiquette, c'est du classement, pas une réponse.
J'ai vu cela bien se passer sur le propre produit d'eesel. Les demandes qui revenaient le plus dans les notes commerciales d'eesel étaient des intégrations de helpdesk manquantes : Front, HubSpot Service Hub, Jira Service Management et Zoho Desk revenaient sans cesse, et des contrats ont été perdus à cause de cela. Ces demandes ont été comptées au lieu d'être dispersées, elles sont donc devenues du travail, et les quatre figurent désormais dans la liste des intégrations. Quand la demande d'un client est livrée, la mise à jour dans le canal d'équipe d'eesel ressemble à celle que mon collègue Amogh a postée en mai : « CUS-605 prompt compressor shipped, unblocked. » Un identifiant d'issue et un client, plus une personne qui sait maintenant qu'elle doit aller le prévenir.
Comment l'IA distingue-t-elle une demande de fonctionnalité d'un bug ou d'une question d'utilisation ?
L'IA trie par intention, mais elle ne le fait bien que si vous écrivez les catégories avec des exemples. Le découpage habituel compte trois voies : « le bouton d'export est cassé » est un bug, « pouvez-vous ajouter des exports hebdomadaires » est une demande de fonctionnalité, « je ne trouve pas le bouton d'export » est une question d'utilisation. J'en ajouterais une quatrième, car c'est celle qui fait gagner le plus de temps.
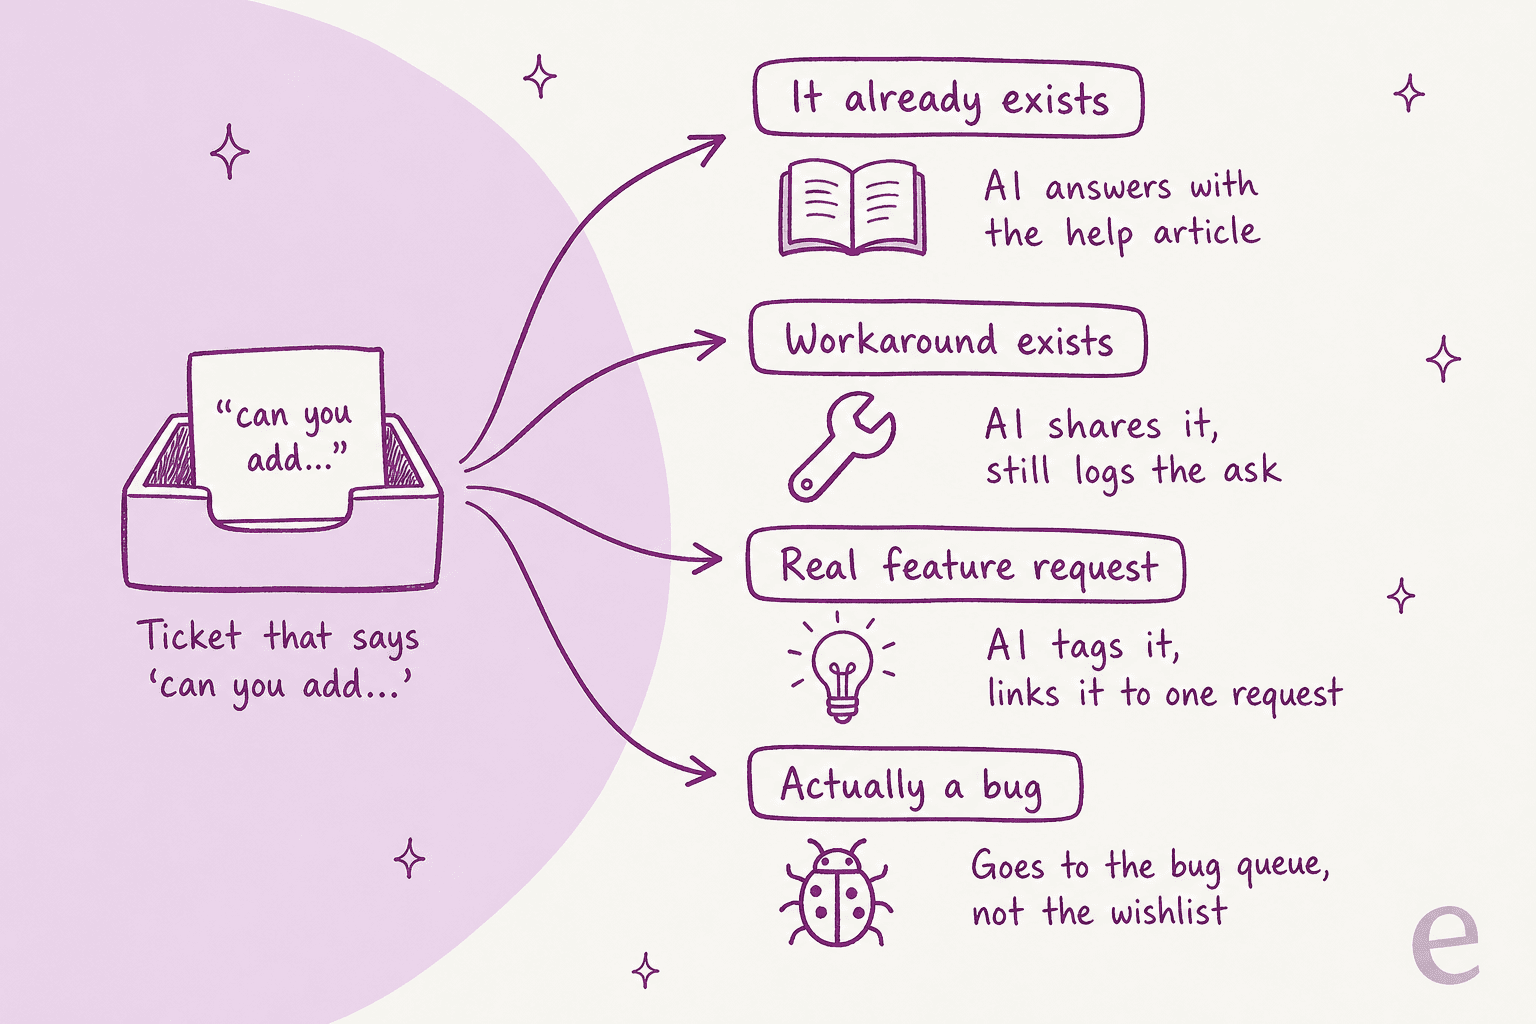
Ça existe déjà. Pas mal de tickets « pouvez-vous ajouter X » portent en fait sur quelque chose que le produit fait déjà. Une bonne IA de support doit y répondre depuis votre centre d'aide plutôt que de les enregistrer, car une demande pour une fonctionnalité existante est en réalité un problème de découvrabilité. Une customer success manager sur Reddit a critiqué les transmissions vagues précisément pour cette raison :
"So you don't have any detail on the request? No validation? What if its actually something they could already do or approximately do 80% of with existing features? You don't have conversations around why they want it or how it will benefit them? "Hey PM. Mr customer said they want to send emails! Figure it out!""
Une solution de contournement existe. Partagez-la, mais enregistrez quand même la demande. Quelqu'un qui vit avec un contournement compte toujours comme un vote.
C'est une vraie demande. Étiquetez-la et écrivez la demande avec les mots du client, puis reliez-la à la demande correspondante.
C'est en fait un bug. Envoyez-le vers le flux de triage des bugs. Un bug classé comme souhait peut rester des mois sur un tableau de feuille de route, et pendant ce temps le client pense que vous ignorez quelque chose de cassé.
Ce qui rend cela fiable, c'est une liste figée. Rúngne, une marque de vêtements d'escalade sur Gorgias, fait tourner son agent de triage eesel sur une liste d'étiquettes définie. Le chiffre de l'étude de cas est 880 tickets étiquetés en un mois, tous issus de cette liste, « nothing invented ». Une étiquette de demande de fonctionnalité fonctionne de la même manière. L'IA choisit dans votre liste au lieu d'inventer une nouvelle catégorie chaque mardi. Si vous partez de zéro, mon guide sur comment automatiser l'étiquetage des tickets explique comment construire cette liste.
Que doit enregistrer chaque demande suivie ?
Chaque demande suivie doit contenir la demande avec les mots du client, un lien vers chaque ticket, qui l'a faite, toute solution de contournement que vous avez donnée et un statut. Cela fait cinq champs, et vous aurez besoin de chacun plus tard.
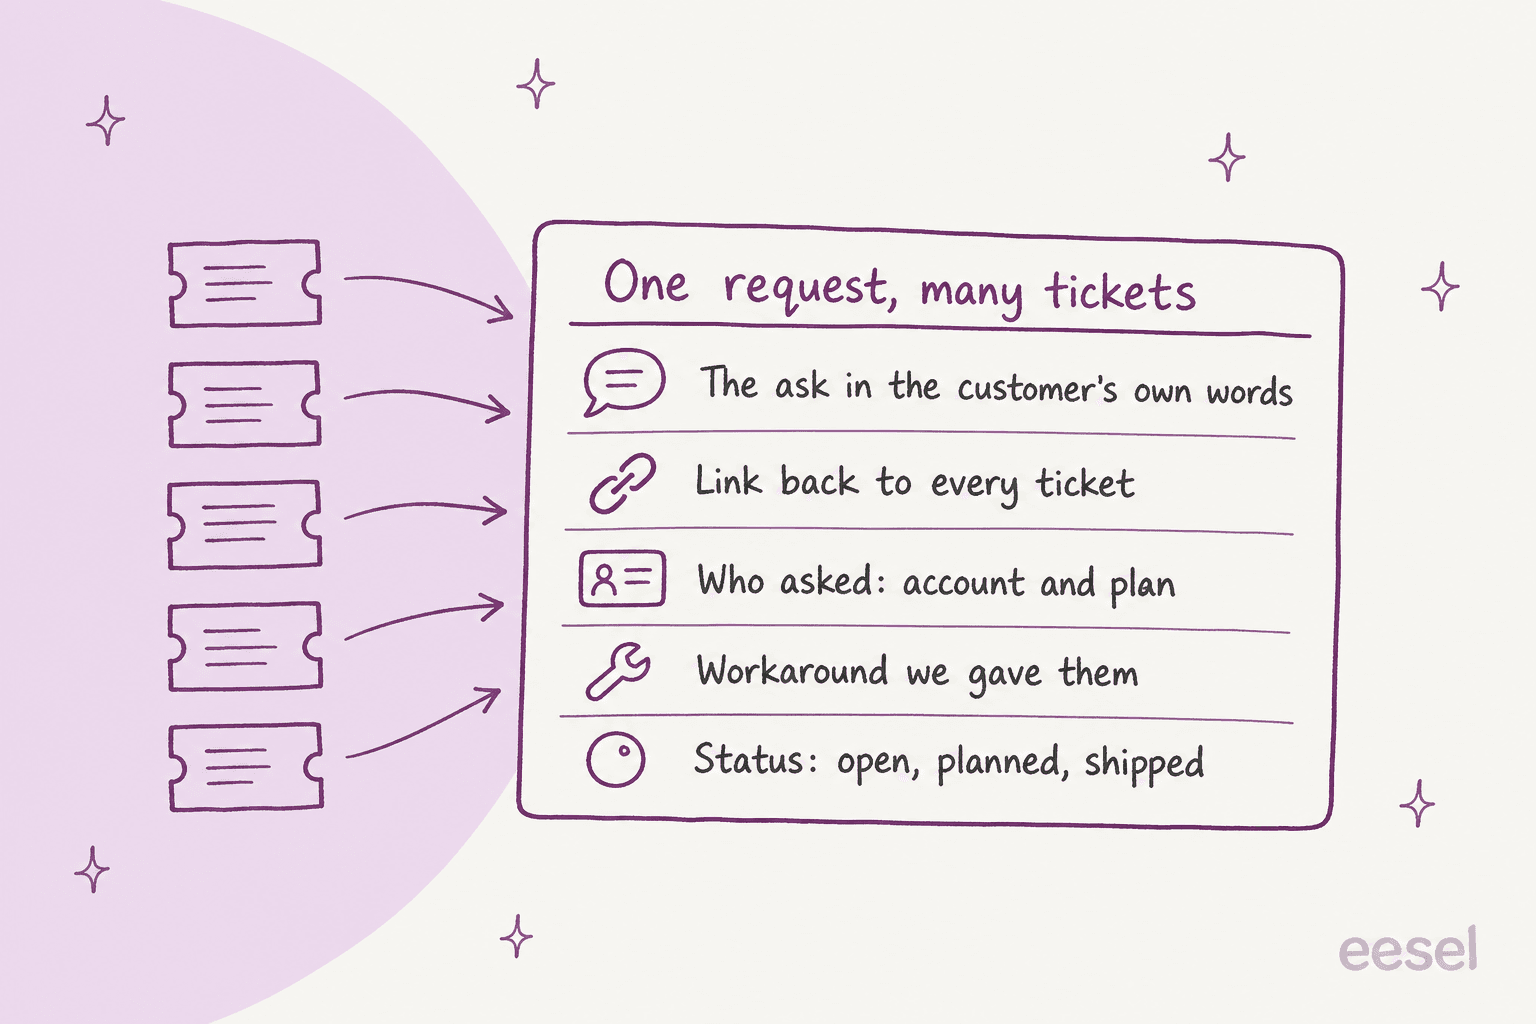
La plupart des configurations perdent le lien vers chaque ticket. Collez un résumé dans un tableur et le lien du ticket disparaît tout simplement, si bien que six mois plus tard, quand la fonctionnalité est livrée, personne ne peut dire qui l'a demandée. Linear gère bien cela : quand une issue est créée ou liée depuis Zendesk, elle « will automatically add a request pointing back to the source », et la demande cite le message d'origine du client avec son nom et un horodatage.
« Qui l'a demandée » compte parce qu'un compteur brut ment à lui seul. Le Head of Product de Reddit plus haut pesait un client à 400 000 $ contre dix clients à 20 000 $. Linear vous permet de marquer une demande comme importante par client, et la liste des votants de Canny affiche le MRR de chaque client à côté du ticket Zendesk lié. Quand votre helpdesk connaît déjà le forfait ou la taille du compte, demandez à l'IA de l'écrire sur la demande, afin que le compteur puisse être pondéré et pas seulement additionné.
Paul Graham a exprimé l'autre moitié de l'argument dès 2009, en écrivant sur la propre page de demandes de fonctionnalités de Hacker News :
"One of the main points of the feature request page is to separate feature requests from submmissions. You want to do this because most are either duplicates or bad ideas, and yet (like all meta discussion, including this post) tend to get a lot of upvotes. The feature request page serves that purpose even if no one reads it."
Les doublons sont la norme, pas l'exception. Il faut donc que « relier à une demande existante » soit le premier réflexe de l'IA, avec « en créer une nouvelle » en solution de repli.
Quels outils suivent les demandes de fonctionnalités depuis les tickets de support ?
Les outils qui suivent les demandes de fonctionnalités depuis les tickets de support se répartissent entre tableaux côté produit (Canny, Productboard, Featurebase, Jira Product Discovery), un outil de suivi d'issues qui accepte des demandes (Linear) et l'IA au sein du helpdesk lui-même (le triage intelligent de Zendesk, ou un agent comme eesel). Voici comment ils se comparent sur les quatre tâches. Les prix proviennent de la page tarifs de chaque éditeur, consultée le 30/10/2026.
| Outil | Comment les tickets arrivent | Ce que fait l'IA | Comment le demandeur est prévenu | Prix de départ |
|---|---|---|---|---|
| Canny | Autopilot lit les tickets fermés de Zendesk, Freshdesk, Help Scout ; app dans la barre latérale Zendesk | Trouve les demandes, fusionne les doublons, mode manuel ou automatique | E-mails de statut, y compris aux « users tracked internally » | Gratuit pour 25 utilisateurs suivis ; Pro 99 $/mois pour 100 (79 $ en annuel) |
| Linear | Créer ou lier une issue depuis la barre latérale Zendesk ou Front | « Create with Linear Agent » écrit l'issue à partir de toute la conversation ; Triage Intelligence signale les doublons | Note interne + ticket rouvert ; une personne écrit la réponse | Business 16 $/utilisateur/mois, facturé annuellement (requis pour Zendesk) |
| Productboard | Tickets Zendesk importés par étiquette ou déclencheur ; Freshdesk un par un | Spark classe les retours en opportunités ; la liaison automatique aux fonctionnalités est « Not yet » dans Spark | Un product manager écrit une mise à jour du portail | Non publié ; minimum 5 makers |
| Featurebase | Sa propre boîte de réception (IA), apps Zendesk et HubSpot (manuel) | Relie les retours aux demandes, fusionne les doublons évidents, découpe les messages à plusieurs demandes | E-mail de statut ; une mise à jour personnalisée peut répondre dans les conversations liées | Growth 29 $/siège/mois en annuel (37 $ en mensuel) |
| Jira Product Discovery | Coller un lien Zendesk ou JSM sur une idée comme insight | Rovo résume et fait du brainstorming, Premium uniquement | Rien d'intégré aujourd'hui | Gratuit pour 3 créateurs ; Standard 10,50 $/créateur/mois |
| Triage intelligent de Zendesk | Classe chaque ticket avec un commentaire public | Étiquette l'intention ; nécessite un sujet personnalisé « demande de fonctionnalité » | Rien d'intégré | Suite Professional ; Copilot 50 $/agent/mois pour l'utiliser dans les workflows |
| eesel | Rejoint Zendesk, Freshdesk, Gorgias et d'autres helpdesks comme agent | Étiquette à partir de votre liste, écrit des champs, cherche les doublons dans Jira avant de créer | Rédige la réponse dans chaque ticket lié, réveillé par un webhook | 100 crédits gratuits ; 299 $/mois pour 500 crédits |
Quelques lignes de ce tableau méritent un examen plus attentif.
Canny est le plus autonome pour la capture. Autopilot est « Included in all plans » et ne lit les tickets qu'« after they are closed out » dans le helpdesk, en commençant par les 30 jours précédents à la première connexion. Il ignore aussi les champs de données personnelles. Ce qu'il faut surveiller, c'est le compteur : les personnes dont Autopilot trouve les retours comptent comme utilisateurs suivis, et le prix de Pro monte avec les utilisateurs suivis (100 pour 99 $ par mois, 500 pour 349 $, 1 000 pour 661 $ en facturation mensuelle).
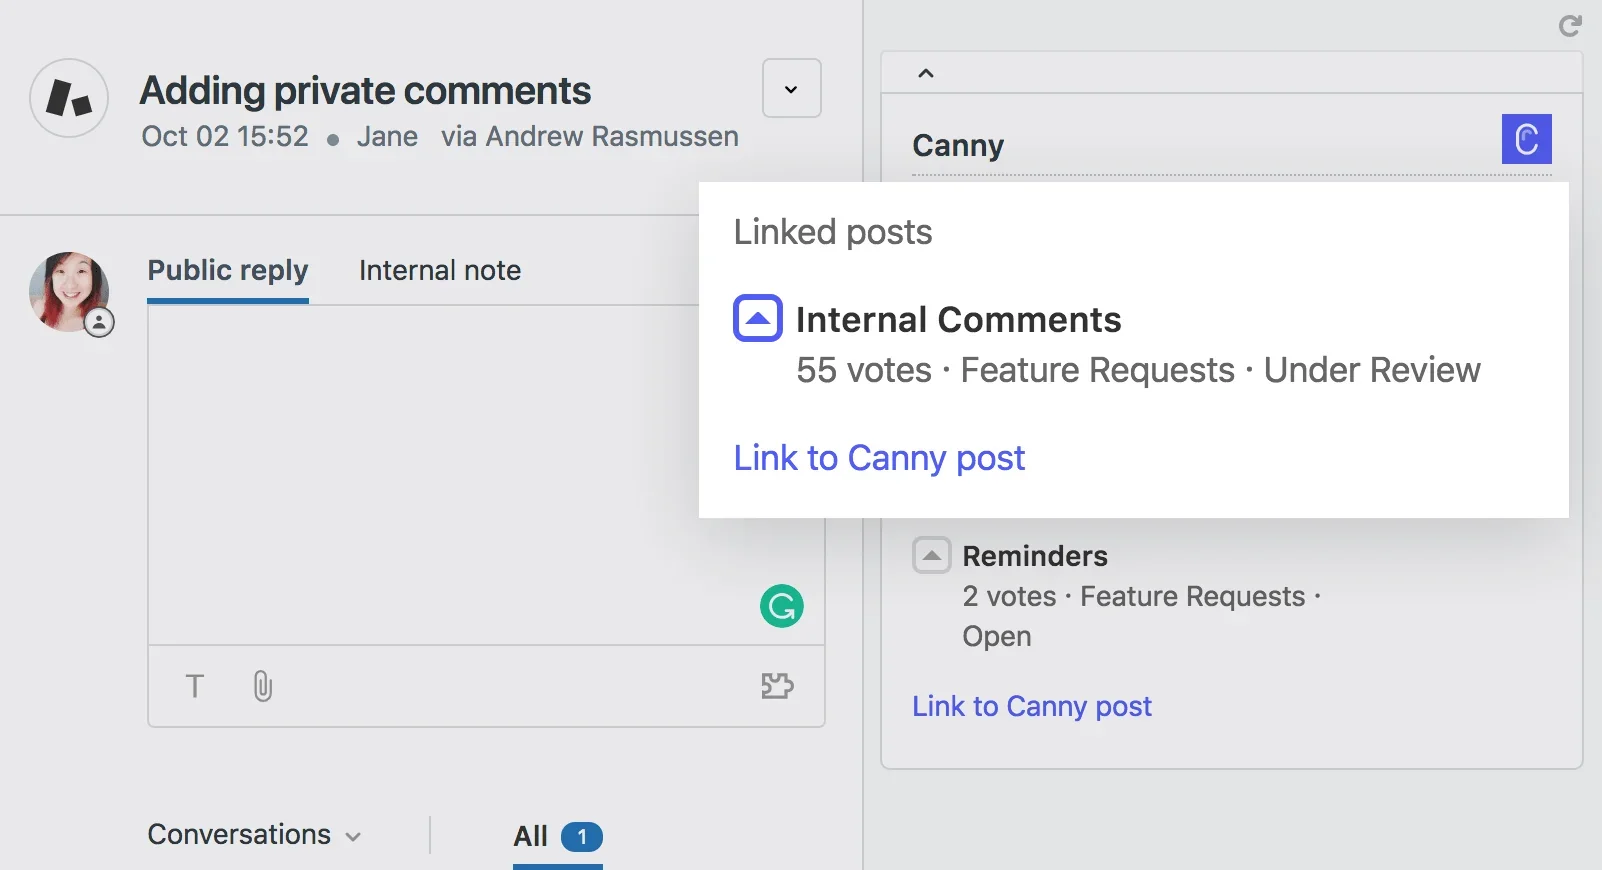
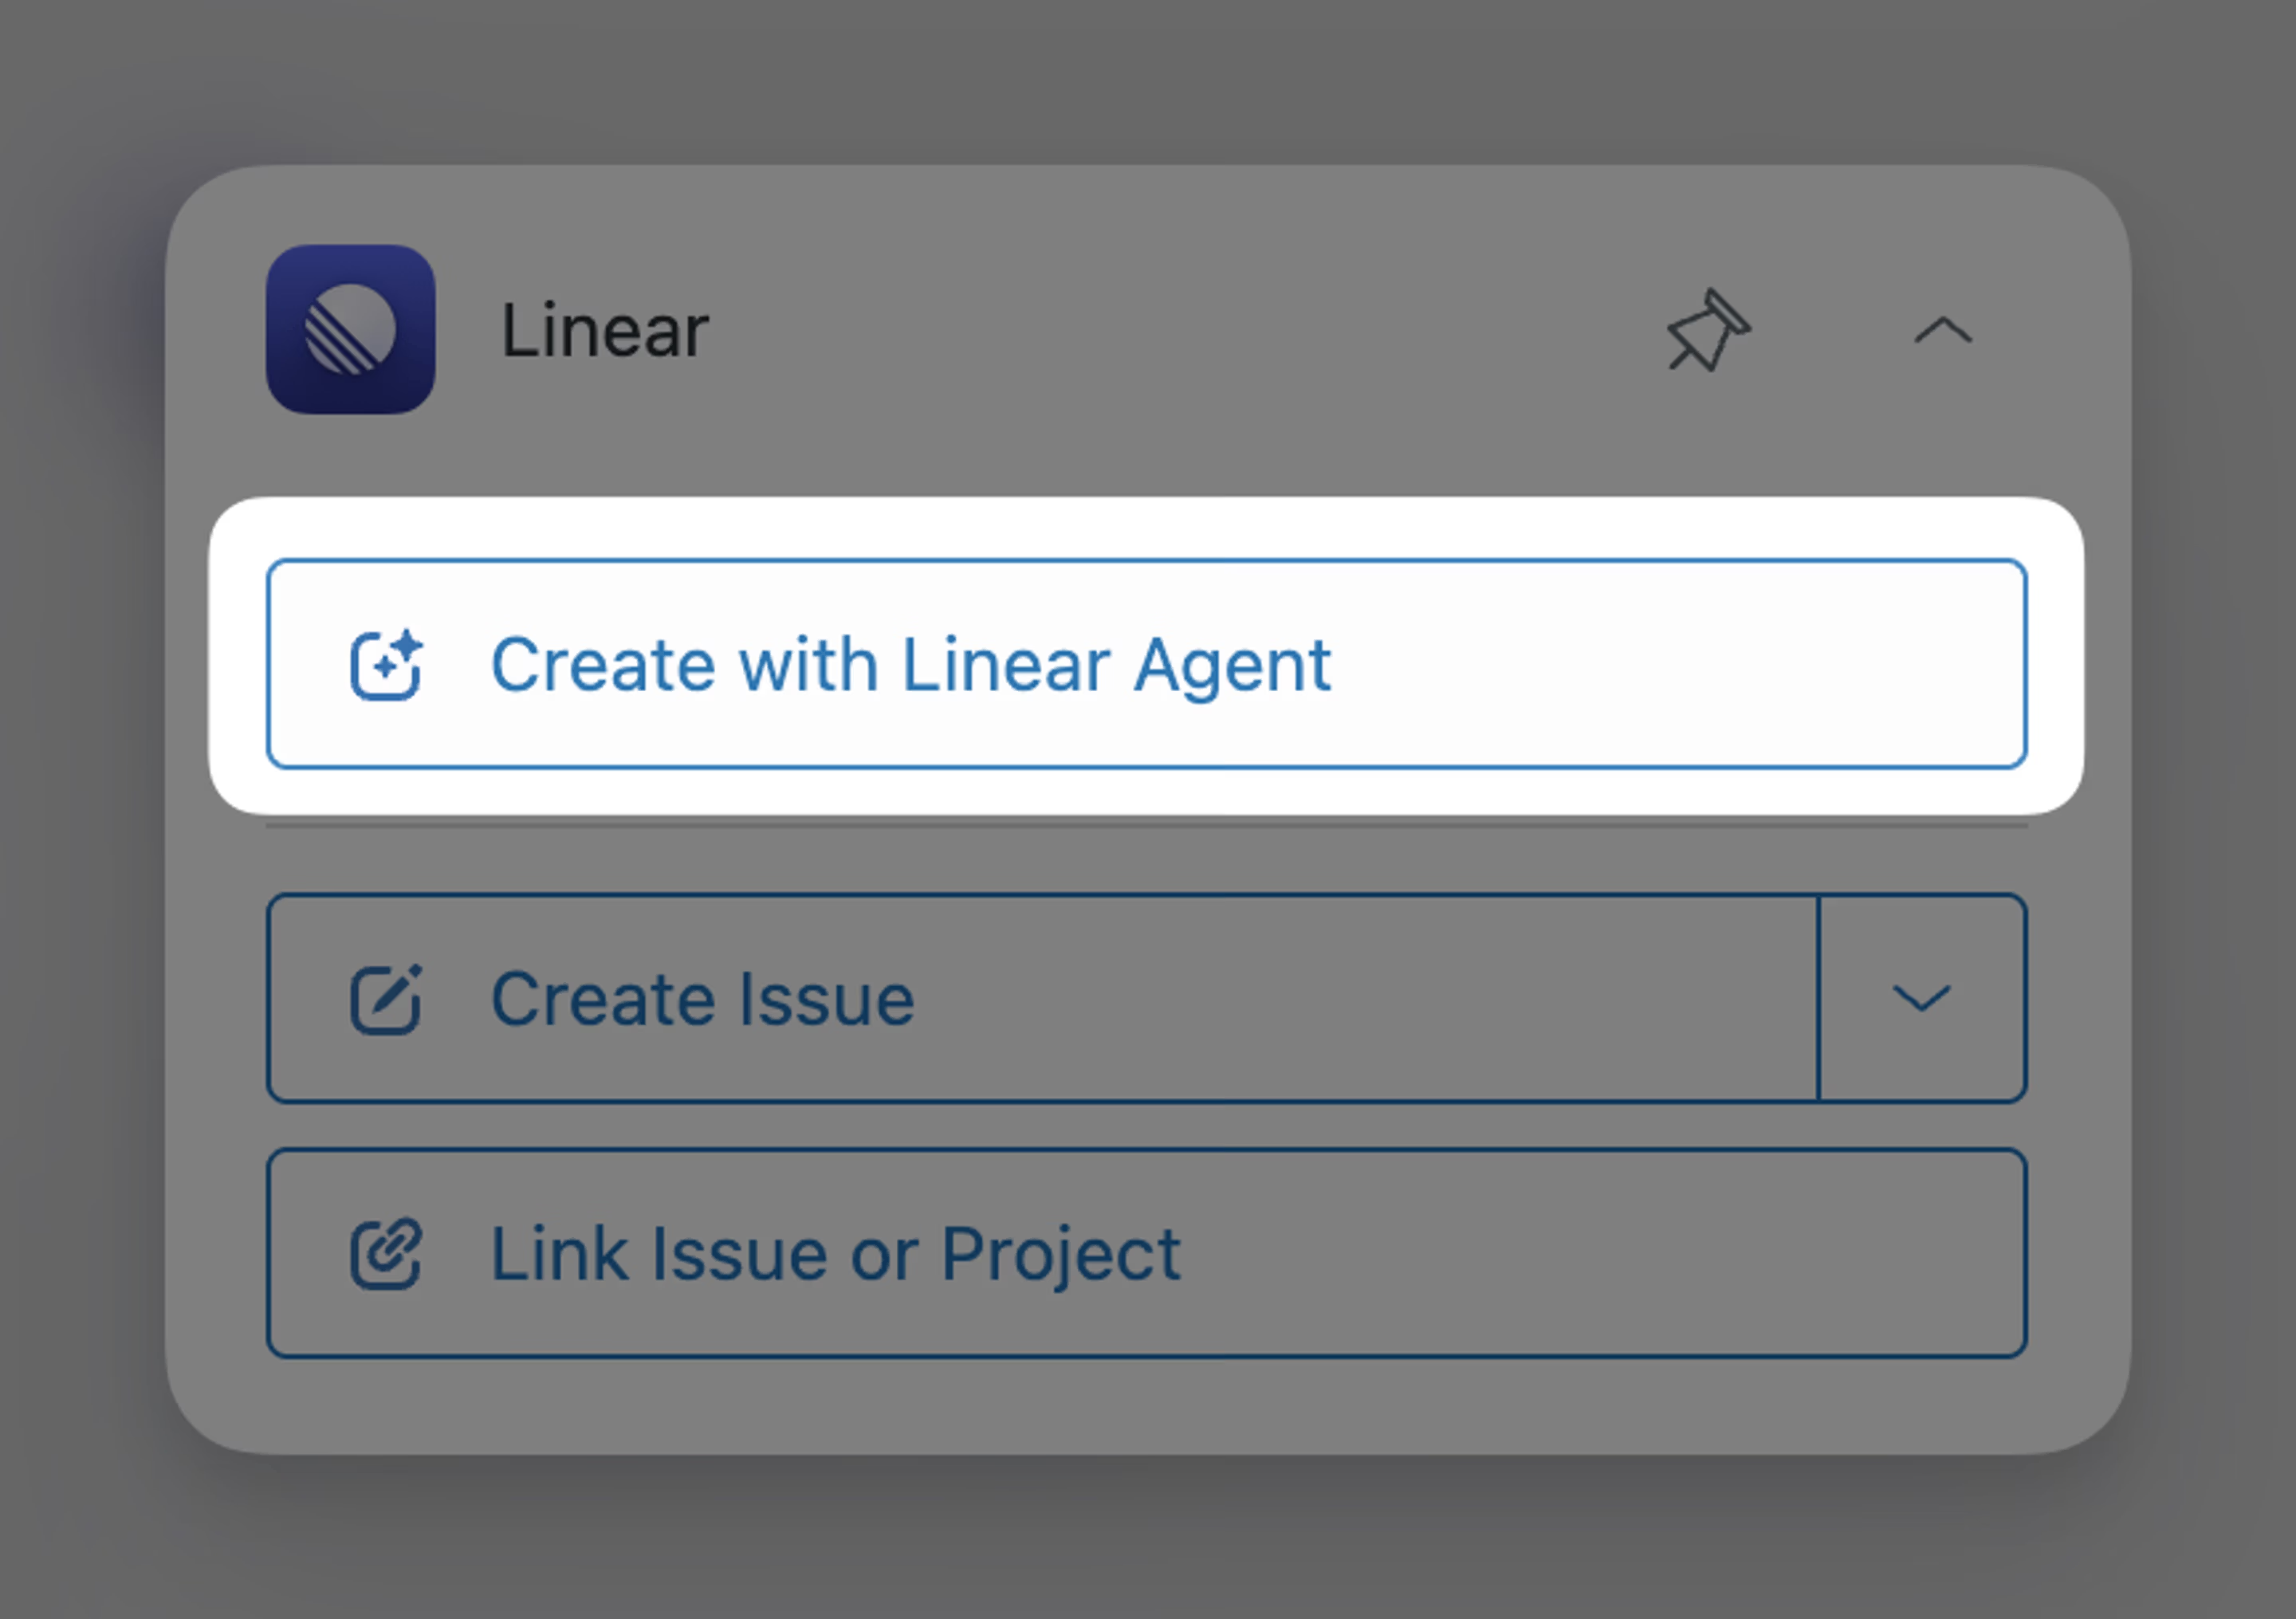
Linear est le plus solide pour garder le lien. Vous pouvez lier « as many Zendesk tickets to a Linear issue as you like », et quand des issues en double sont fusionnées, les liens Zendesk passent à l'issue restante, de sorte que les automatisations continuent de fonctionner. Son IA est déclenchée par un agent. Celui qui traite le ticket clique sur « Create with Linear Agent », puis Linear lit toute la conversation, pièces jointes comprises, pour écrire l'issue. Il ne scannera pas seul chaque ticket.
L'IA propre à Zendesk peut étiqueter mais pas suivre. Le triage intelligent classe les tickets par intention, mais je n'ai pas trouvé dans sa documentation de sujet intégré « demande de fonctionnalité ». Vous devriez créer vous-même un sujet personnalisé. Il ne compte pas non plus la demande par fonctionnalité, il vous faudrait donc encore un tableau ou un outil de suivi à l'autre bout. Mon analyse du triage intelligent détaille les forfaits.
L'IA de Productboard lit mais ne relie pas encore. Spark est inclus dans chaque espace de travail et transforme les retours Zendesk en une liste classée d'opportunités avec citations. Mais dans le propre tableau comparatif de Productboard, la liaison automatique des insights pour Spark est marquée « Not yet », et l'ancienne Productboard AI qui le faisait n'est plus en vente.
Si vous comparez les outils côté produit pour eux-mêmes, mes articles sur les alternatives à Featurebase, Jira Product Discovery AI et Linear vs Jira vont plus loin que je ne peux ici.
Que se passe-t-il quand la fonctionnalité demandée est livrée ?
Quand la fonctionnalité est livrée, la plupart des outils envoient soit un e-mail de statut depuis l'outil produit, soit une note interne dans le ticket. Quelqu'un au support doit encore écrire la vraie réponse. Le « suivi » est automatisé presque partout. Le « prévenir le client » ne l'est presque jamais.
Voici ce que fait chaque outil à cette dernière étape, d'après sa propre documentation :
- Linear publie une note interne et rouvre le ticket Zendesk ou Front « so that your agents will be able to notify the customers ». Une personne écrit la réponse.
- Featurebase ajoute une note interne aux conversations liées lors d'un changement de statut. « Sending a customer reply is a separate action », d'après sa documentation sur les mises à jour de statut, même si une mise à jour personnalisée peut répondre dans les conversations liées.
- Canny envoie un e-mail aux utilisateurs dont la demande est arrivée par un ticket si vous cochez « Notify users tracked internally ». L'e-mail vient de Canny, et « if a user replies directly to the email, the reply is not recorded », d'après sa documentation sur les e-mails de changement de statut.
- Productboard permet à un product manager d'écrire une mise à jour du portail et de l'envoyer aux votants ainsi qu'à toute personne ayant un insight lié. « It is not yet possible to reply to email updates », d'après son guide pour boucler la boucle.
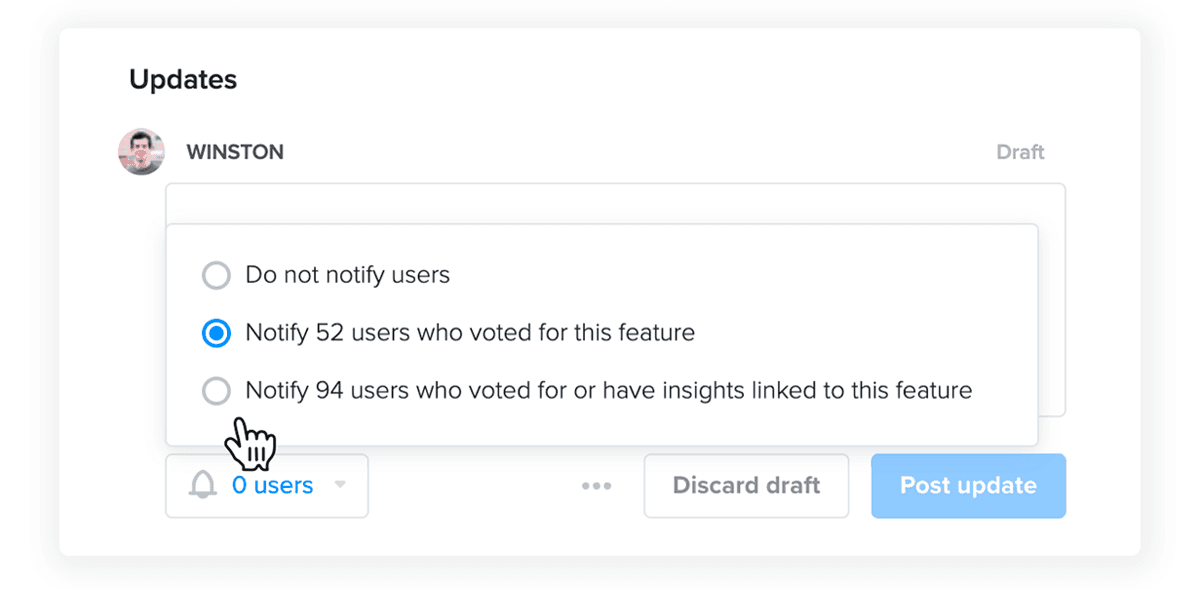
Dans cet exemple Productboard, 52 personnes ont voté, mais 94 avaient voté ou avaient des retours liés. Ceux qui ont demandé via le support forment donc une grande partie de l'audience, et ils n'ont jamais touché au tableau. Ils ont demandé dans un ticket. Un évaluateur G2 de Canny a décrit clairement ce manque :
"It is very basic. Unless the PM makes comments, it is difficult to understand if there has been any progress. There is no way to close the loop when a feature has been released."

Cet avis vient d'une équipe où Canny « was a way for our support team to submit feature ideas to the Product team », ce qui est exactement la configuration dont parle cet article.
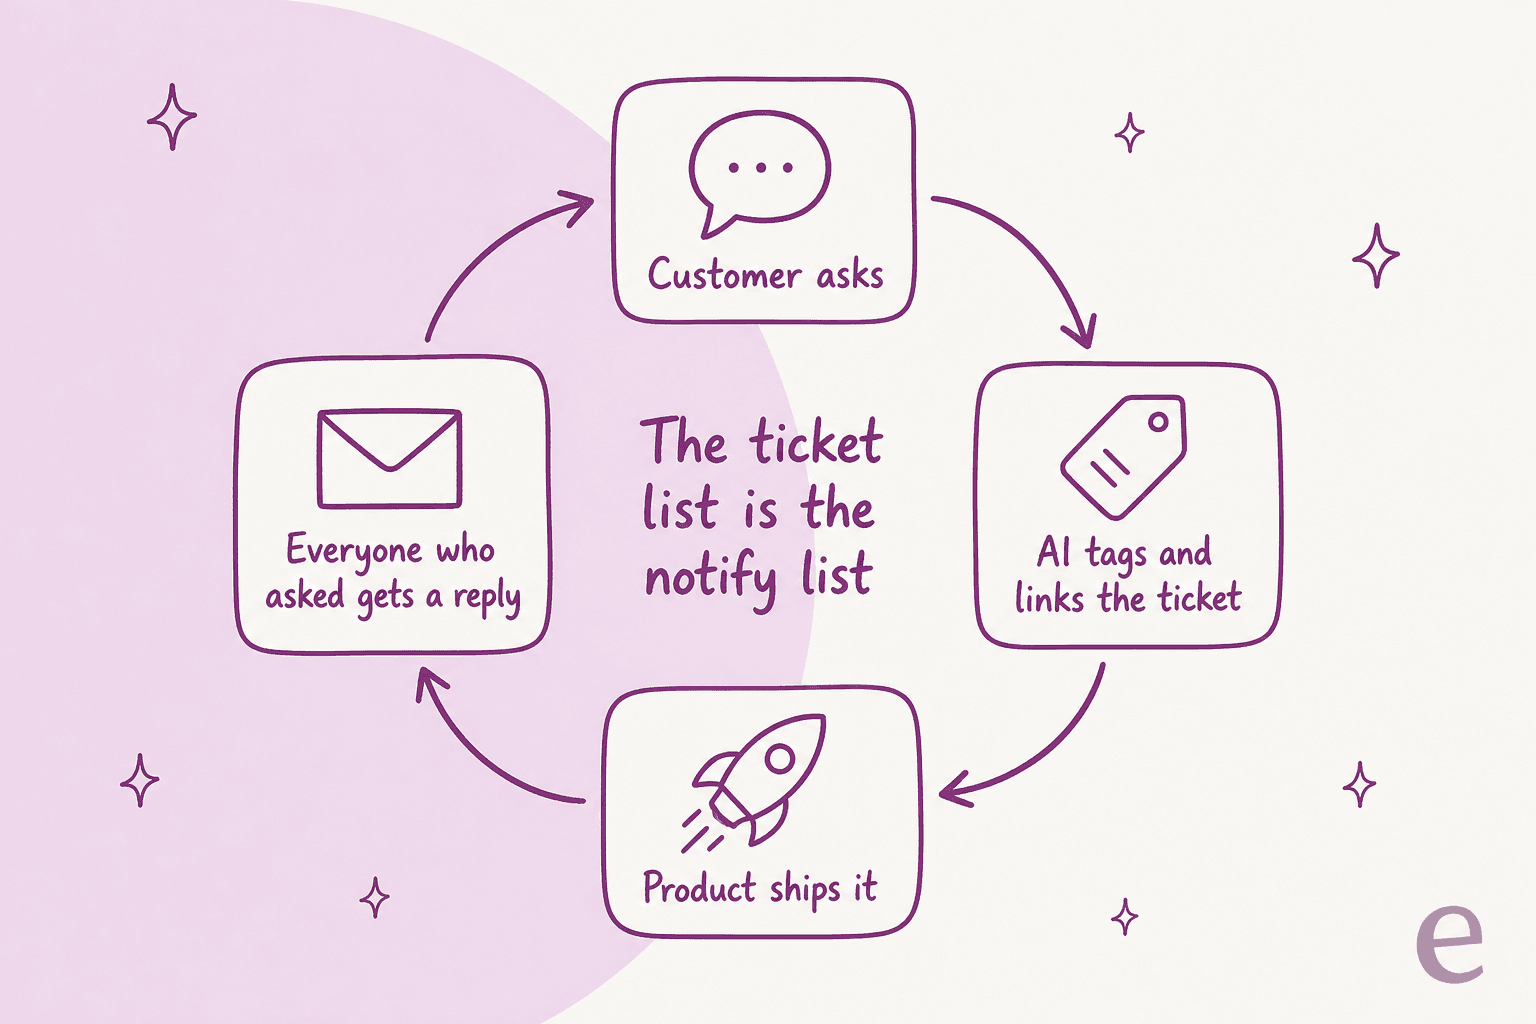
C'est le changement que je ferais si je mettais cela en place aujourd'hui. Traitez la liste des tickets comme la liste de notification. Si chaque demande garde un lien vers chaque ticket qui l'a formulée, alors « c'est livré » devient une liste connue de conversations, chacune avec son propre contexte. Une IA peut rédiger une réponse dans chacune, en mentionnant ce que ce client voulait et ce qu'il a utilisé entre-temps, et une personne les approuve. Le client reçoit la réponse dans le même fil où il a demandé, de la part de la même équipe. C'est la même idée que l'escalade des tickets Zendesk vers Jira, mais dans l'autre sens.
Comment mettre en place le suivi des demandes de fonctionnalités par IA dans votre helpdesk ?
Vous le mettez en place en six étapes : définir ce qui compte comme demande, donner à l'IA une liste d'étiquettes figée, choisir où vivent les demandes, lui faire chercher avant de créer, commencer par des approbations et brancher la réponse « c'est livré ». Voici comment je m'y prendrais pour chacune. J'utilise eesel comme exemple parce que c'est ce que je connais, mais les étapes valent pour n'importe quel agent.
1. Écrivez ce qu'est une demande de fonctionnalité
Mettez les quatre voies de tout à l'heure dans les instructions de l'agent avec deux ou trois vrais exemples chacune, tirés de vos propres tickets. Incluez la voie « ça existe déjà », avec les articles d'aide à partir desquels il doit répondre. Les instructions dans eesel sont du texte simple, ce qui veut dire que changer ce qui compte est une modification rapide plutôt qu'un projet. La configuration de smava fonctionne de la même façon : son agent de catégorisation « picks one category from smava's mapping document, judging by intent », et chaque règle vit dans les instructions.
2. Donnez-lui une liste d'étiquettes figée et un champ
Choisissez une étiquette pour les demandes de fonctionnalités et, si votre helpdesk a des champs personnalisés, un champ pour le domaine produit. Les actions Zendesk d'eesel comprennent Add tags, Update ticket et Get ticket field options, cette dernière pour qu'il lise vos vraies valeurs de champ au lieu de deviner. SE Ranking s'en sert pour la mesure. Il a demandé une étiquette ai_handled sur chaque ticket qu'eesel touche, pour que les chiffres vivent dans Zendesk et pas dans la tête de quelqu'un. Si vous faites vos rapports dans Zendesk Explore, mon guide sur les rapports par étiquettes de tickets montre comment tracer les compteurs.
3. Décidez où vivent les demandes
Si votre équipe produit tourne sur Jira, l'agent peut créer directement là-bas (mon guide Zendesk et Jira couvre aussi la voie native). L'intégration Jira Service Management d'eesel propose Create Issue (projet, résumé, description, assigné, étiquettes) et Label Issue. Si votre équipe utilise Asana, il existe une intégration Asana native qui crée des tâches. Pour Linear, Canny ou Productboard, il n'y a pas d'intégration eesel native dans la documentation, vous connecteriez donc leur API via Network Access, qui permet à l'agent de faire des appels GET, POST, PATCH et DELETE vers n'importe quelle API REST que vous autorisez. L'autre option est de garder l'app Zendesk propre à l'outil de suivi pour lier, et de n'utiliser l'agent que pour l'étiquetage et les réponses.
4. Faites-le chercher avant de créer
Cette étape est ce qui évite les doublons. L'intégration Jira d'eesel a une action Search Issues qui « finds issues with a JQL query, so your agent can find related or duplicate issues ». La documentation Asana le dit sans détour : « Tell it to search before it creates. Otherwise you get a second copy of a task that already exists. » Écrivez-le dans les instructions. Chercher d'abord et lier s'il y a une correspondance, ne créer que s'il n'y en a pas, et dans les deux cas ajouter le lien du ticket et le client à l'issue.
5. Commencez par des fusions et de nouvelles issues soumises à approbation
Chaque action d'eesel peut tourner en Auto, Needs approval ou Disabled, par agent, comme le décrit la documentation sur les actions et approbations. Mon choix serait l'étiquetage en Auto dès le premier jour, avec Create Issue en Needs approval pendant les premières semaines. Des fusions d'IA non contrôlées peuvent enterrer la demande d'un client, et c'est ce qui est arrivé à cet utilisateur de Canny :
"Their AI assistant that auto-creates features for you merges tickets in a way that's not helpful. What the AI tool was doing was: 1. Creating a feature request based on feedback 2. Merging an old ticket into the newly created feature request That was driving me mad! The trouble was being able to find my old ticket that I KNEW I created."
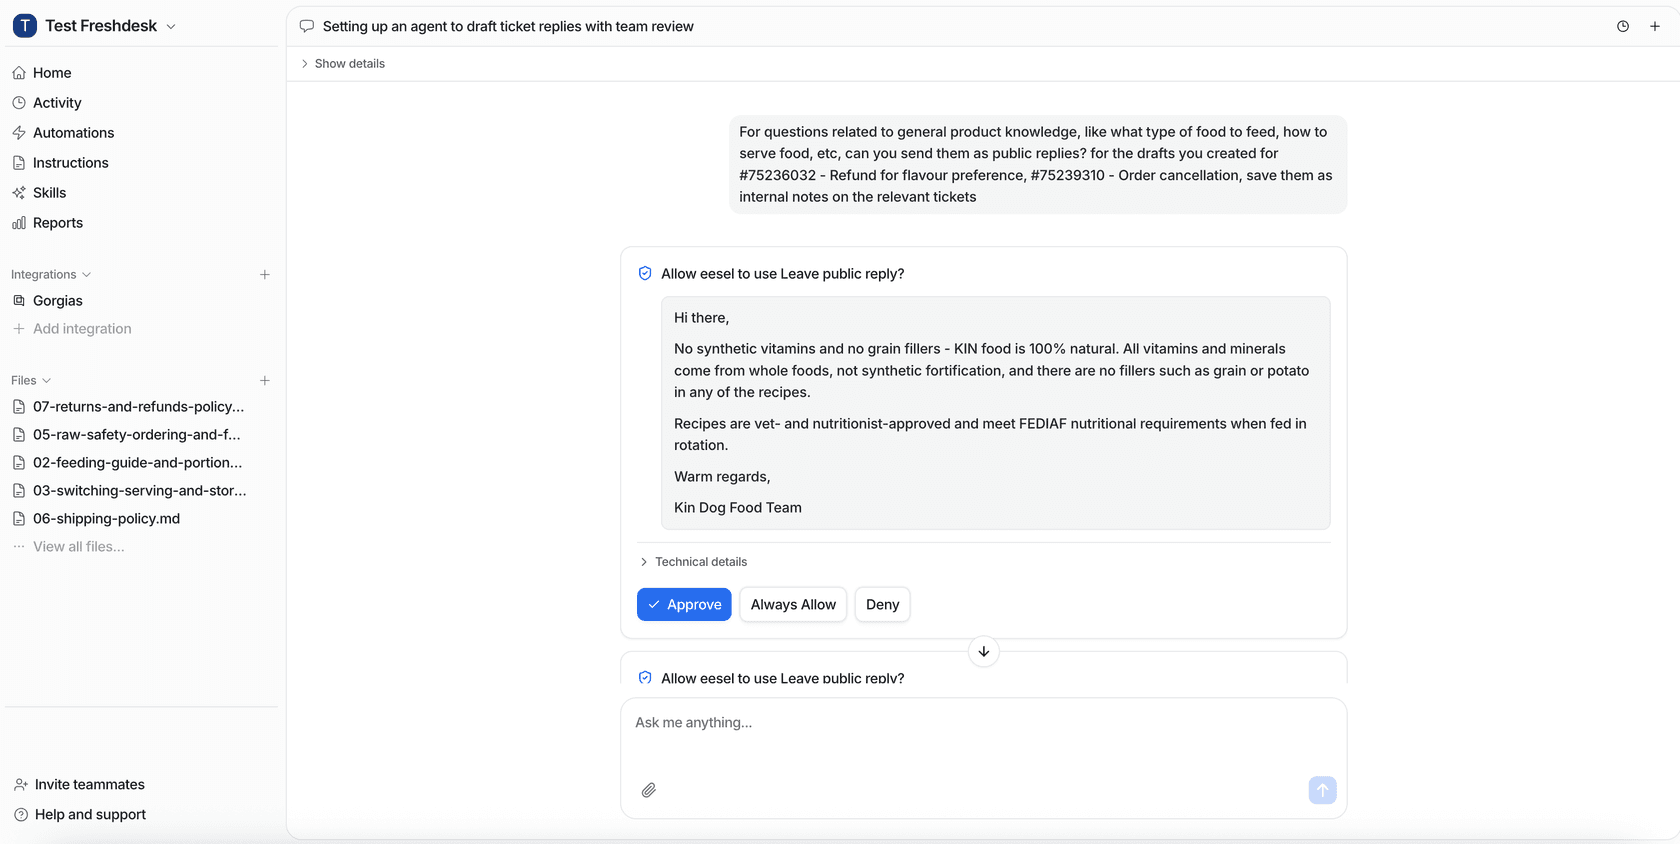
Après quelques semaines, si les approbations vous semblent bonnes, cliquez sur « Always allow » pour celles auxquelles vous faites confiance, et cette action passe en Auto à partir de là.
6. Branchez la réponse « c'est livré »
Il y a ici une vraie limite. Les déclencheurs Jira d'eesel se déclenchent quand une issue est créée ou commentée, pas quand son statut change, il n'entendra donc pas « Done » tout seul. La solution est une règle Jira Automation qui envoie une requête web à un webhook eesel quand une issue passe à Done. « Send any JSON you like, and your agent reads all of it. » L'agent se réveille avec la clé de l'issue, cherche dans le helpdesk les tickets étiquetés et liés à elle et rédige une réponse dans chacun. Je garderais les réponses en Needs approval, au moins jusqu'à ce que vous ayez relu un lot.
Pour la vue hebdomadaire, une planification peut tourner chaque lundi et publier les principales demandes dans un canal Slack avec l'intégration Slack d'eesel, à condition qu'il ait été invité dans ce canal. La compétence Reports « Analyze ticket trends » couvre le même terrain sous l'autre angle : les thèmes qui reviennent, avec volume et sentiment. Si vous préférez le piloter depuis un terminal, la CLI eesel liste les automatisations avec eesel automations, connecte Jira avec eesel integrations connect jira et gère les approbations depuis le terminal, de sorte qu'un agent de code comme Claude Code peut piloter le même agent que vous avez configuré dans le tableau de bord.
Faut-il compter les demandes de fonctionnalités ou les pondérer ?
Pondérez-les, mais gardez aussi le compteur brut visible. À lui seul, un compteur brut récompense celui qui écrit le plus. Un product manager sur Reddit qui utilise Canny a décrit exactement ce biais :
"I just feel like they just make it easier for users to throw feature requests at my team and in my experience often the vast majority of feature request don't help a ton unless a common request and they could be biased by power users."
Un score d'IA plus malin n'y changera rien. De meilleures données d'entrée, oui. Si chaque ticket lié porte le compte et le forfait, un product manager peut trier par « demandes de clients du forfait supérieur » ou « demandes de comptes qui ont mentionné une résiliation ». La documentation de Linear donne l'exemple d'une vue d'issues de niveau Enterprise « where each issue has at least 20 requests », triée par nombre de clients. Le rôle du support est de s'assurer que ces données figurent sur la demande, et décider quoi construire reste l'affaire du produit.
Il y a aussi une raison côté support de bien l'enregistrer, et une customer success manager sur Reddit l'a bien dit :
"It's pretty big, especially in a CYA way. For example, if an Enterprise customer threatens to cancel for years due to a missing feature, you need to make that well known in case they churn so people know that you sounded the alarms."
Une étiquette avec le compte dessus, c'est cette alerte, mise par écrit. Et une fois les demandes étiquetées de façon cohérente, elles s'intègrent directement dans les rapports par motif de contact à côté de tout ce que votre file vous apprend.
Suivez les demandes de fonctionnalités avec eesel
eesel est un coéquipier IA de helpdesk qui rejoint votre file existante dans Zendesk, Freshdesk ou Gorgias, de sorte que le suivi des demandes de fonctionnalités se fait là où la demande arrive, pas dans un outil séparé que le support doit penser à ouvrir. Il répond aux tickets « ça existe déjà » depuis votre centre d'aide, étiquette les vraies demandes à partir de votre propre liste, cherche dans Jira avant de créer pour que les doublons soient liés au lieu de se multiplier, et rédige la réponse « c'est livré » dans chaque ticket lié quand le travail est terminé.
La partie étiquetage tourne déjà à grande échelle : smava classe 14 600 tickets Zendesk par mois dans des champs, Dokument 24 étiquette 430 tickets par mois par produit, et les agents de SE Ranking ont créé environ 400 tickets pour leur équipe de second niveau en un mois avec les preuves jointes.
La tarification se fait au ticket, pas au siège : 299 $ par mois pour 500 crédits, et un ticket vaut 1 crédit quel que soit ce que l'agent y fait, donc étiqueter, chercher dans Jira et créer une issue dans un ticket coûte toujours un crédit. Il existe un forfait gratuit avec 100 crédits pour tester sur votre propre file. Essayez eesel.
Comment prévenir les clients quand une fonctionnalité demandée est livrée ?