

En bref
La gestion d'une file d'attente de support partagée, c'est la façon dont une équipe de support répartit un seul pool de tickets pour que chaque ticket ait rapidement un responsable. Ce qui casse les files partagées est rarement le volume. C'est l'écart entre un ticket vu par tout le monde et possédé par personne. Réglez cela d'abord : choisissez un modèle d'attribution en connaissance de cause (pull, push ou hybride), donnez à chaque nouveau ticket un responsable dans un délai fixé et surveillez l'âge du plus ancien ticket sans responsable, pas seulement le délai de première réponse.
La plupart des helpdesks peuvent pousser les tickets vers les agents à votre place, mais le réglage se trouve souvent derrière une limite de forfait. Le round robin est dans Freshdesk Pro ($55 par agent) et Help Scout Plus ($45), l'équilibrage de charge de Front est dans Professional ($65), et le routage par compétences est dans Zendesk Suite Professional ($115) ou Freshdesk Enterprise ($89). Gorgias inclut l'attribution automatique dans tous les forfaits helpdesk.
L'IA gère désormais bien l'étape de tri. Lors d'un test eesel sur du trafic Zendesk réel, le tri a atteint 93 % de précision et repéré 100 % du spam. Le coéquipier IA pour helpdesk d'eesel étiquette, route et répond aux tickets faciles dans votre file existante, pour que votre équipe ne prenne que ce qui demande une personne.
Qu'est-ce que la gestion d'une file d'attente de support partagée ?
Une file d'attente de support partagée est une liste unique de tickets entrants sur laquelle toute une équipe travaille, au lieu que chaque agent ait sa propre boîte. La gestion d'une file d'attente de support partagée est l'ensemble des règles qui décident qui prend quel ticket, à quelle vitesse il obtient un responsable, ce qui se passe quand quelqu'un est absent et comment vous repérez ce qui passe entre les mailles.
Je travaille sur la file de support d'eesel tous les jours, et j'ai appris que le plus dur dans une file partagée, ce ne sont pas les tickets difficiles. Les tickets difficiles attirent l'attention parce qu'ils font du bruit. Ceux qui se perdent sont les tickets ordinaires que quatre personnes ont ouverts, lus et refermés, chacune supposant qu'une autre s'en chargerait.
Chaque helpdesk présente la file partagée un peu différemment :
- Zendesk utilise des vues, dont une vue des non attribués standard (documentation Zendesk).
- Freshdesk utilise des vues de liste de tickets, avec le routage défini par groupe (documentation Freshdesk).
- Help Scout donne à chaque boîte des dossiers fixes : Unassigned, Mine, Assigned, Closed et Spam (documentation Help Scout).
- Front fonctionne à partir d'une boîte partagée avec des onglets Unassigned, Assigned et Waiting.
- Gorgias utilise des vues, avec une vue standard « Unassigned » des tickets ouverts que personne ne possède (documentation Gorgias).
Les noms des outils changent. Les modes de défaillance, non.
Pourquoi les files partagées cassent : le vide de responsabilité
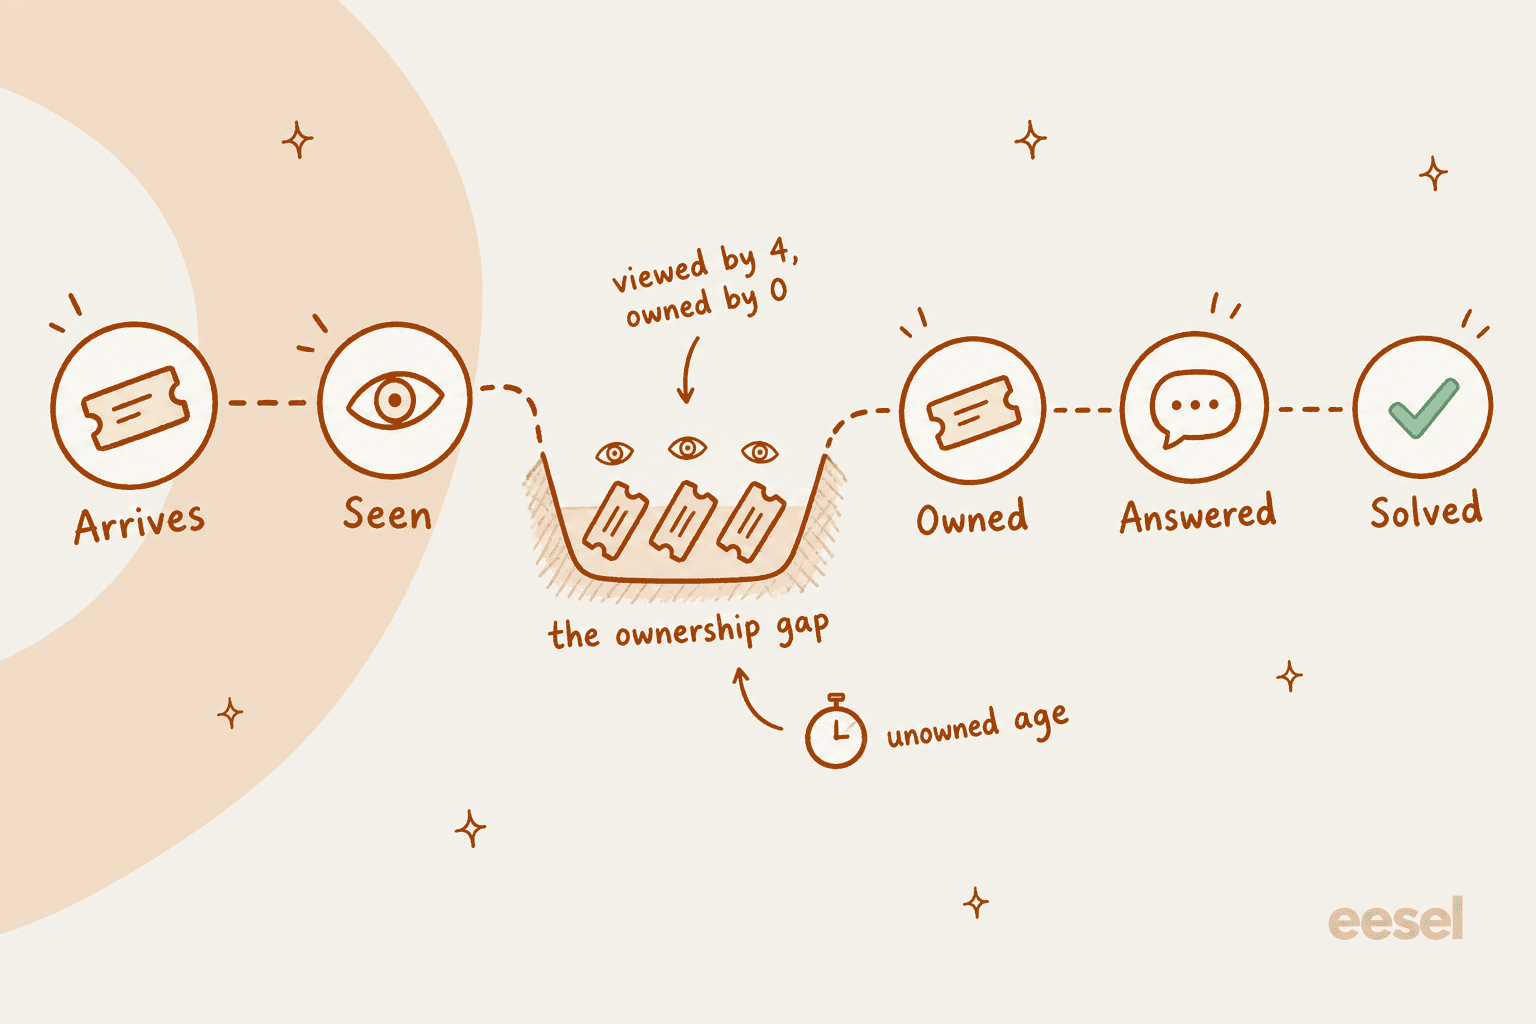
Voici le schéma que je vois le plus. Un ticket arrive. Trois agents le voient dans la file. Chacun a autre chose d'ouvert, donc chacun passe à autre chose. Le nom de personne n'est dessus, donc personne ne sent qu'il vieillit.
Un responsable informatique d'un établissement scolaire a décrit il y a des années la version « piocher dans le tas », et cela ressemble encore à toutes les files de support surchargées que j'ai vues :
"We currently have an unending bucket of tickets, the engineers and I pluck out calls with little oversight, however this results in some calls falling to the bottom of the pile and getting ignored. There's no ownership of unassigned calls."

Cela devient coûteux quand le ticket qui se perd est l'urgent. Un administrateur Zendesk a publié en février 2026 à propos d'un client entreprise dont le système de production est tombé à 9 h. Le ticket est resté jusqu'à 14 h derrière plus de 30 tickets de la nuit, si bien que le client est resté à l'arrêt plus de 5 heures avant que quelqu'un ne remarque qu'il était critique (r/Zendesk).
Et dans un fil sur un ticket resté deux jours sans attribution et qui a valu un avis 1 étoile, l'histoire était la classique : tout le monde a supposé que quelqu'un d'autre l'avait pris. Une réponse en a donné la cause sans détour :
"That's not a system issue (crappy help desk software, bad ticketing system). It's a bad work ethic ("Meh, Bob can get that. Or Cindy. IDC, I'm busy on Reddit.")
Systems can help with setting SLAs and possibly even forcing ownership, but ultimately it's up to the team to take responsibility and do their jobs."
Je suis à moitié d'accord. L'éthique de travail compte. Mais une conception de file qui dépend du fait que chacun pense à prendre le ticket suivant échouera le jour le plus chargé, quand tout le monde en tient déjà trois. La solution est de rendre la responsabilité automatique ou d'en faire le travail de quelqu'un, pas d'espérer.
C'est le changement sur lequel repose cet article : mesurez le temps sans responsable, pas seulement le temps de réponse. Votre moyenne de délai de première réponse peut sembler correcte pendant qu'un ticket vieillit tout l'après-midi, parce que les moyennes cachent la queue de la distribution.
Les trois façons d'attribuer le travail dans une file partagée
Toute file partagée fonctionne selon l'un de trois modèles, que l'équipe l'ait choisi ou non.
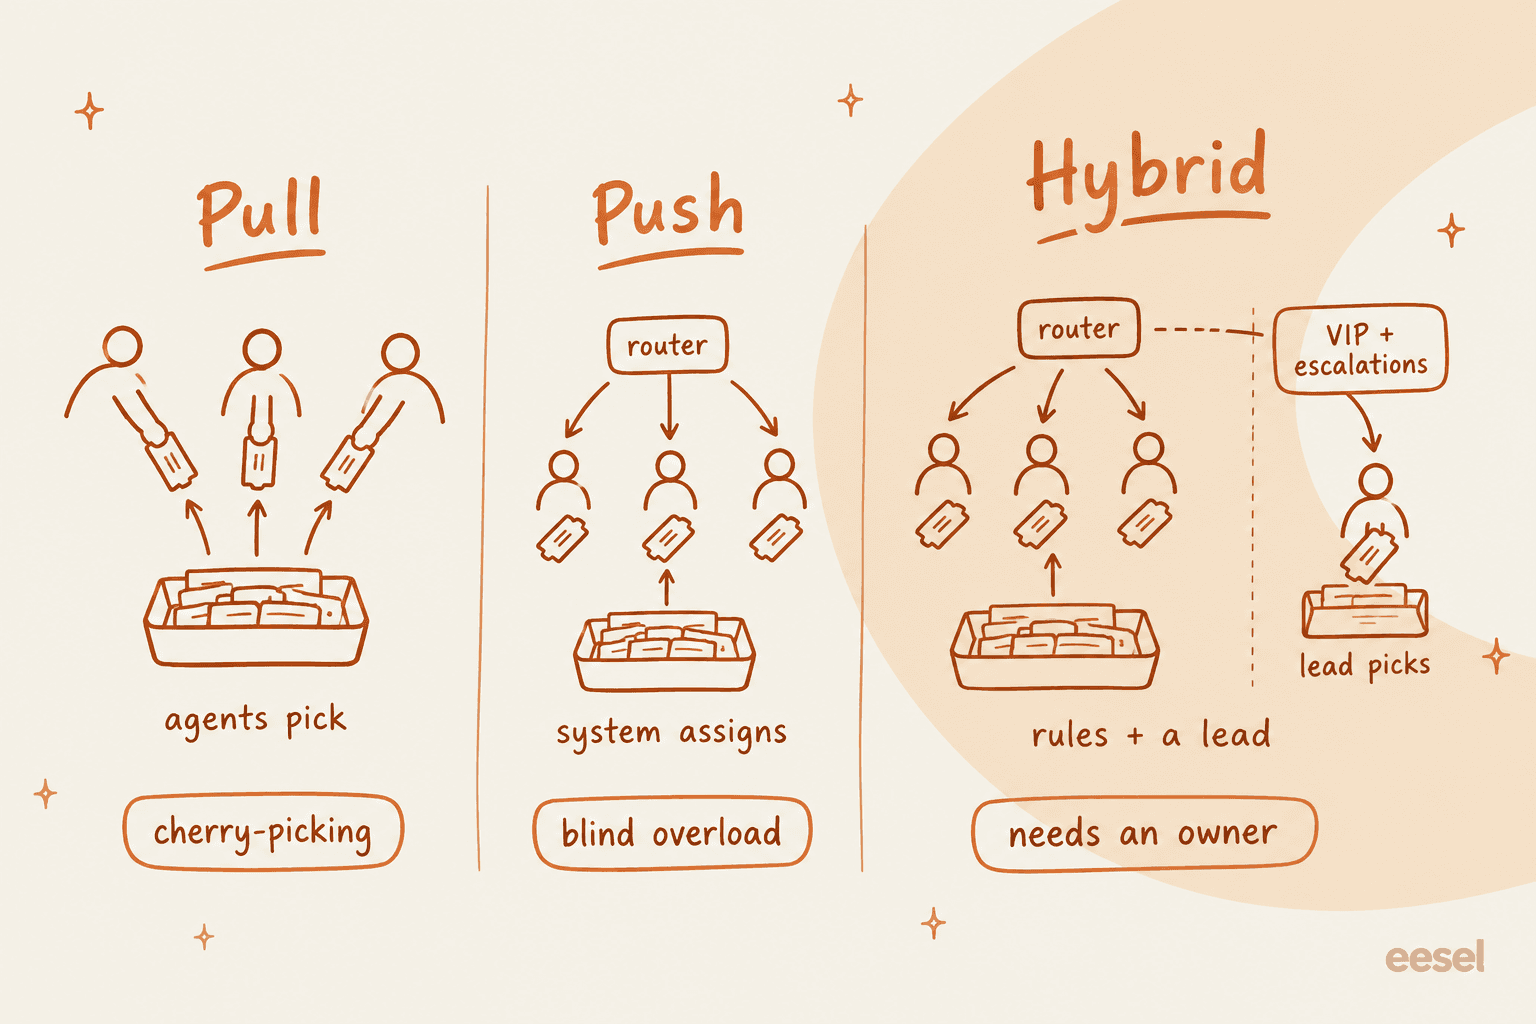
Pull signifie que les agents choisissent eux-mêmes leurs tickets dans la vue partagée. C'est le réglage par défaut de la plupart des helpdesks et cela semble équitable, car les bons agents peuvent en prendre plus. Sa faiblesse est de ne prendre que ce qui est facile. Une équipe Zendesk a admis le faire exprès quand elle était débordée :
"If we're underwater we do an easy out method where we cherry-pick the simple tickets (can be handled in less than 5 minutes) and have a portion of the team hit those while the rest does fifo."
C'est la version maligne et délibérée. La version accidentelle, c'est tout le monde qui évite en silence le même ticket pénible.
Push signifie que le helpdesk attribue les tickets à votre place, avec des règles de routage des tickets : round robin (agent suivant dans la rotation), selon la charge (moins de tickets ouverts) ou par compétences (langue, produit ou niveau correspondants). Cela règle la responsabilité, mais peut surcharger ceux qui sont en ligne par hasard, et ne sait pas quels tickets sont difficiles. Une équipe Zendesk l'a découvert après avoir changé :
"We recently moved from Round Robin to OCR and it's been a bit of a nightmare."
Dans le même message, ils décrivaient 2-3 agents recevant 15 tickets e-mail pendant que les autres en recevaient quelques-uns ou aucun, et certains tickets qui ne sortaient jamais de la vue des non résolus. C'est généralement un problème de capacité et de réglage des statuts, pas une raison de revenir au pull, mais cela montre que le push demande un réglage fin.
Hybride signifie une attribution automatique pour le flux normal, plus une petite voie qu'un responsable traite à la main : comptes VIP, escalades, tout ce que les règles ne savent pas placer. La plupart des équipes que je conseillerais finissent ici.
| Modèle | Qui décide | Idéal pour | Risque principal | Quoi ajouter |
|---|---|---|---|---|
| Pull | Les agents choisissent | Petites équipes, tickets similaires | Ne prendre que le facile, tickets qui vieillissent | Vue du plus ancien en premier, un responsable du tri par jour |
| Push | Règles du helpdesk | Files chargées, chat et messagerie | Surcharger celui qui est en ligne | Limites de capacité, statut d'absence, réattribution |
| Hybride | Règles plus un responsable | Niveaux mixtes, VIP, plusieurs langues | La voie manuelle n'a pas de responsable | Un responsable nommé de la voie par service |
Si vous restez sur pull, ajoutez une règle à laquelle aboutit d'une manière ou d'une autre chaque fil Reddit sur le sujet : une personne qui possède les restes. Un responsable de MSP a décrit la sienne :
"our helpdesk team functions as one big resource pool. Inbound phone calls and tickets are automatically queued, and the techs check it every so often to take tickets. Helpdesk manager gets an alert if a ticket's been sitting in the intake queue for 30 minutes, at which point he'll assign to a resource."
Cette alerte de 30 minutes est toute l'astuce. Du pull pour la vitesse, un filet de sécurité pour la responsabilité.
Quel modèle d'attribution convient à votre file ?
Choisissez la ligne qui ressemble le plus à votre équipe. Chacune donne le modèle par lequel je commencerais et le réglage qui le fait fonctionner.
Quel modèle d'attribution convient à votre file ?
Touchez la description qui ressemble le plus à votre équipe.
Commencez par : pull, plus un responsable du tri
Laissez les agents choisir dans une vue partagée triée du plus ancien au plus récent. Faites tourner un responsable du tri quotidien qui attribue tout ce qui reste sans propriétaire après votre limite (30 à 60 minutes pour l'e-mail est un bon départ).
Fonctionne avec n'importe quel forfait. Activez la détection des collisions si votre helpdesk en dispose.
Commencez par : push, selon la charge
Attribuez automatiquement les nouveaux tickets à celui qui a le moins de tickets ouverts, avec une limite de capacité par agent pour que personne ne soit enseveli. Gardez une voie manuelle pour les escalades.
Freshdesk Pro ($55), Help Scout Pro ($75) pour Balanced, Front Professional ($65), routage par capacité Zendesk à partir des forfaits Team, Gorgias dans tous les forfaits.
Commencez par : hybride, routage par compétences ou par groupe
Routez d'abord par langue, produit ou niveau, puis équilibrez la charge à l'intérieur de chaque groupe. Un responsable tient la voie des VIP et des cas limites à chaque service.
Le routage par compétences est dans Zendesk Suite Professional ($115) et Freshdesk Enterprise ($89). Sur Help Scout, Front et Gorgias, utilisez des équipes ou des boîtes séparées et routez vers elles avec des règles.
Commencez par : push uniquement
Les clients dans un chat en direct n'attendront pas pendant que les agents parcourent la file. Poussez les conversations vers les agents disponibles, réglez un court minuteur d'acceptation ou de réattribution et plafonnez les chats simultanés par agent.
Zendesk peut réattribuer un ticket qu'un agent n'accepte pas à temps à partir des forfaits Professional. Gorgias peut retirer l'attribution des chats quand l'agent devient indisponible.
Comment chaque helpdesk gère une file partagée
C'est là que les limites de forfait pèsent. Voici ce que chaque outil sait faire seul, d'après la documentation et la page de tarifs de chaque éditeur en octobre 2026. Les prix sont par agent et par mois, tels qu'affichés sur chaque page de tarifs, en facturation annuelle quand la page la propose.
| Helpdesk | Round robin | Selon la charge ou la capacité | Par compétences | Détection des collisions | Politiques de SLA |
|---|---|---|---|---|---|
| Zendesk | Routage omnicanal, forfaits Team et supérieurs (Suite Team $55) | La capacité est le réglage par défaut, forfaits Team et supérieurs | Suite Professional $115, Support Enterprise | Tous les forfaits sauf Team | Suite Growth et supérieurs |
| Freshdesk | Pro $55 | Pro $55 | Enterprise $89 | Growth $19 et supérieurs | Une politique dès Growth ; plusieurs et escalades dans Pro |
| Help Scout | Plus $45 | « Balanced », Pro $75 | Absent de la documentation | Tous les forfaits | Standard 1, Plus 2, Pro illimitées |
| Front | Action de règle, tous les forfaits | Équilibrage de charge, Professional $65 | Absent de la documentation | Oui, aucune limite de forfait indiquée | Objectifs de temps, Professional $65 |
| Gorgias | Attribution auto au moins chargé, tous les forfaits helpdesk | Une limite de capacité, tous les forfaits | Absent de la documentation | Bannière « Also viewing » | Tous les forfaits helpdesk |
Zendesk
Le routage omnicanal de Zendesk pousse e-mails, appels et messages vers les agents selon leur statut et leur capacité disponible. L'attribution selon la capacité est la valeur par défaut : le travail va à l'agent éligible qui a le plus de marge pour ce canal (règles de capacité Zendesk). Vous pouvez passer la méthode d'attribution en round robin, qui choisit l'agent resté le plus longtemps sans nouveau ticket, tant qu'il a encore de la capacité.
Mon guide du round robin Zendesk détaille la configuration.
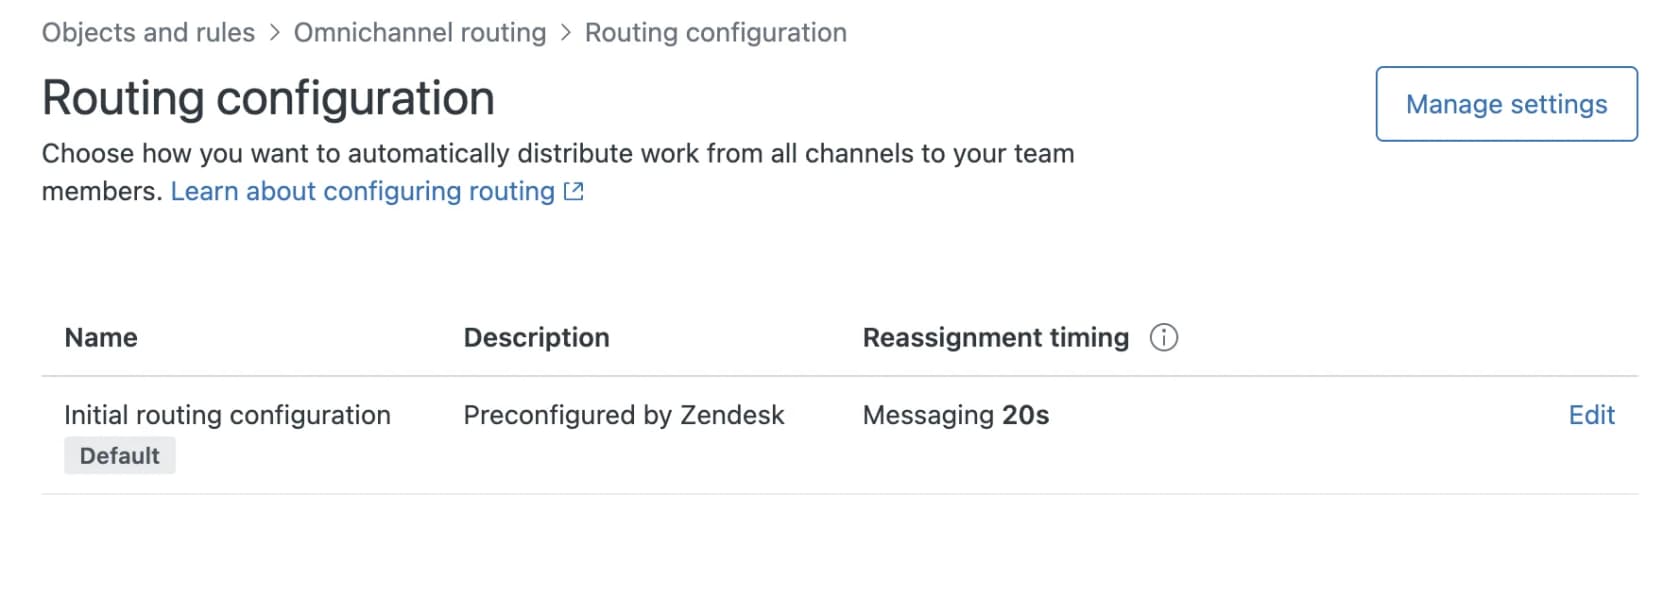
Trois réglages comptent le plus pour une file partagée :
- Compétences. Le routage par compétences est disponible à partir de Suite Professional. Les compétences requises n'expirent jamais ; les compétences facultatives tombent après un délai que vous fixez (documentation Zendesk sur les compétences).
- Réattribution. Zendesk peut réattribuer jusqu'aux 50 tickets e-mail et messagerie ouverts les plus récemment mis à jour quand le statut d'un agent passe à celui que vous choisissez. Réattribuer les tickets rouverts, et réattribuer quand un agent n'accepte pas à temps, sont disponibles à partir de Professional (configuration du routage Zendesk).
- Collision. Une icône en forme d'œil dans les vues marque les tickets qu'une autre personne consulte, mais la collision d'agents n'est pas disponible dans les forfaits Team (documentation Zendesk sur la collision).
Le tri intelligent de Zendesk classe désormais l'intention, le sentiment et la langue dans les forfaits Professional et supérieurs sans coût supplémentaire, selon l'annonce de Zendesk. Utiliser ces classifications dans le routage exige toujours le module Copilot, affiché à $50 par agent et par mois sur la page de tarifs de Zendesk.
Freshdesk
Freshdesk définit le routage par groupe. Sous Admin, Groups, Group Properties, vous choisissez manuel ou Advanced Automatic Routing (propulsé par Omniroute) avec attribution round-robin, selon la charge ou par compétences.
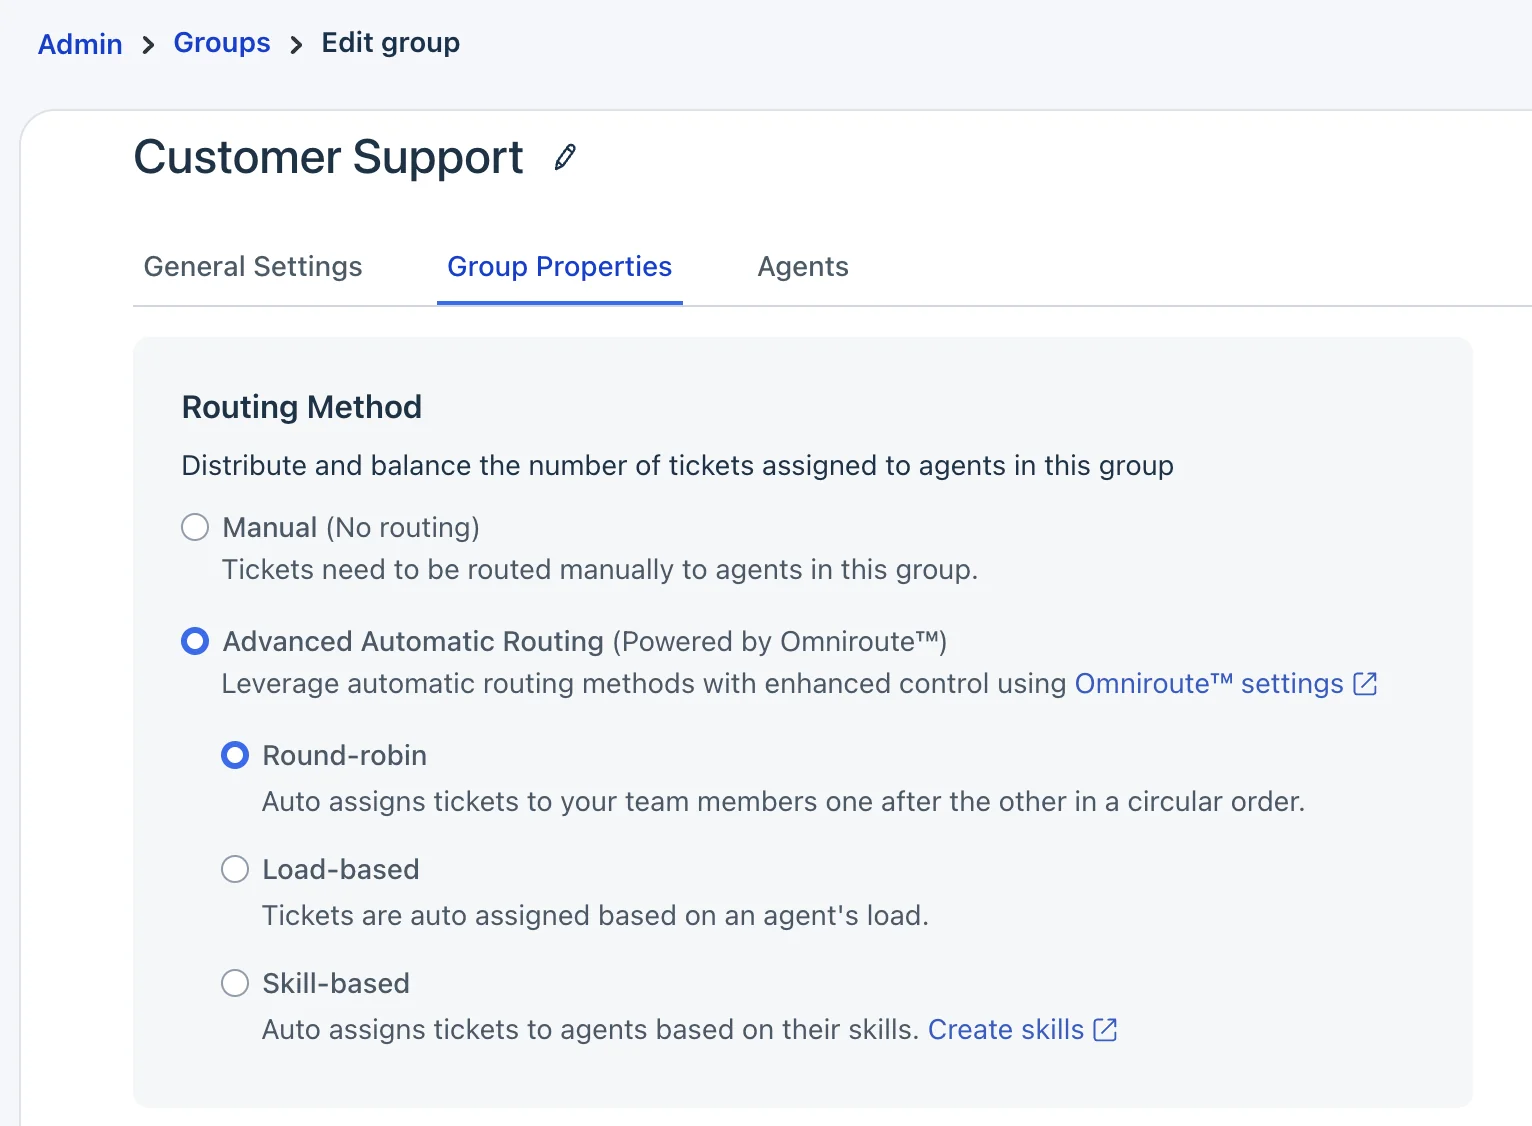
Le round robin et l'attribution selon la charge sont dans Pro et Enterprise, et le round robin saute les agents déjà à leur capacité (documentation round-robin de Freshdesk). L'attribution selon la charge donne chaque ticket à l'agent disponible le moins chargé jusqu'à ce que chacun atteigne sa limite. Le routage par compétences est réservé à Enterprise.
Sur la page de tarifs de Freshdesk, cela donne Growth $19, Pro $55 et Enterprise $89 par agent.
Deux détails piègent les équipes. D'abord, un agent hors ligne ne peut pas recevoir de nouveaux tickets, et si personne n'est disponible le ticket reste non attribué. Ensuite, une attribution manuelle peut faire dépasser sa limite à un agent, et cet excédent bloque alors son attribution automatique (documentation Freshdesk Omniroute). Je n'ai pas trouvé de réglage qui remette dans le pool les tickets e-mail ouverts d'un agent hors ligne, alors prévoyez un balayage manuel au changement d'équipe. La détection des collisions est disponible à partir de Growth.
Help Scout
Help Scout reste simple. Le routage propose deux méthodes : Round Robin, qui attribue « one by one in alphabetical order », dans Plus, et Balanced, qui attribue au collègue ayant le moins de conversations actives, dans Pro (documentation de routage Help Scout).
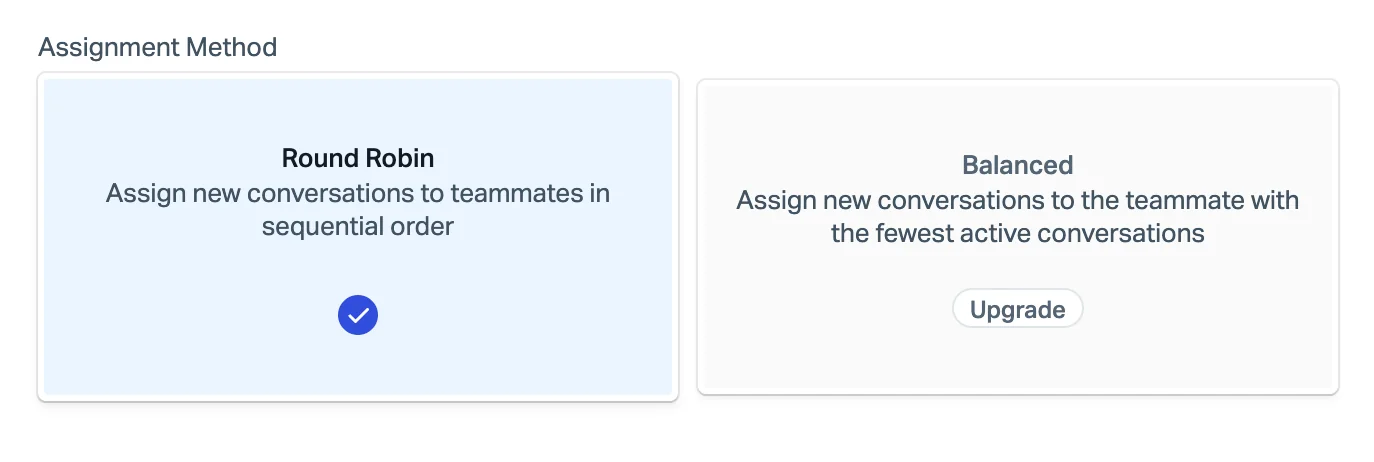
Le routage saute les collègues Away ou à leur limite (jusqu'à 100), traite d'abord la conversation qui attend depuis le plus longtemps et récupère ce qui se trouve déjà dans Unassigned. Les attributions manuelles et par workflow ignorent ces règles. La détection des collisions est disponible dans tous les forfaits, et Help Scout met votre réponse en pause si un collègue a répondu ou si le client a écrit depuis que vous avez ouvert la conversation (documentation Help Scout sur la collision). Les tarifs de Help Scout affichent Standard à $25, Plus à $45 et Pro à $75 par utilisateur et par mois. Si vous l'associez à l'IA, mon guide du tri Help Scout explique ce qui peut être automatisé.
Front
Front route avec des règles. Une règle de round robin attribue à tour de rôle aux collègues en ligne, mais si tout le monde est hors ligne rien n'est attribué et il n'y a pas de file, si bien qu'un collègue qui revient plus tard ne récupère pas les conversations manquées (documentation de routage de Front). Une règle d'équilibrage de charge est plus intelligente pour une file partagée : elle attribue à celui qui a le moins de conversations ouvertes jusqu'à sa limite (max 100), met en file quand tout le monde est plein et reprend à partir de la conversation sans réponse la plus ancienne. Elle est disponible à partir de Professional (documentation de Front sur l'équilibrage de charge).
La gestion des absences de Front est l'une des meilleures pour une file partagée : les réponses aux conversations attribuées à un collègue absent du bureau retirent l'attribution et reviennent automatiquement dans Unassigned, dans tous les forfaits (documentation de Front sur l'absence du bureau). Les tarifs de Front affichent Starter $25, Professional $65 et Enterprise $105 par poste. Côté IA, voir mon article sur le tri Front.
Gorgias
Gorgias ne facture pas par agent. Il facture selon le volume de tickets, avec des forfaits helpdesk allant de Starter à $10 par mois pour 50 tickets jusqu'à Advanced à $750 pour 5 000 en facturation annuelle (tarifs Gorgias). L'attribution automatique est incluse dans tous les forfaits helpdesk : des règles envoient un ticket à une équipe, puis Gorgias classe les tickets par priorité et date de création et les donne aux agents disponibles ayant le moins de tickets (documentation Gorgias sur l'auto-attribution).
La limite de capacité est un seul nombre pour tous les agents, donc vous ne pouvez pas donner à une nouvelle recrue une charge plus légère qu'à un agent senior. Gorgias peut retirer l'attribution d'un ticket rouvert quand son agent est hors ligne, et retirer l'attribution des chats quand l'agent devient indisponible. Mon guide des règles d'attribution Gorgias va plus loin, et l'article sur les vues Gorgias couvre le côté file.
Empêchez deux personnes de répondre au même ticket
L'échec opposé au ticket perdu est le ticket en double : deux agents répondent au même client avec des réponses légèrement différentes. C'est plus rare que les tickets perdus, mais les clients le remarquent davantage. Un responsable CS, dans un fil sur les boîtes partagées, a pointé la solution :
"Zendesk or hubspot would be good for tracking, and assigned ownership so multiple people don't try to take ownership and end up causing issues."
Il y a deux niveaux de protection. Le premier est l'attribution : un ticket qui a un seul responsable dès son arrivée ne peut pas être pris deux fois. Le second est la détection des collisions, qui montre qui d'autre consulte ou écrit. La version de Front est un bon exemple de ce qu'il faut chercher :
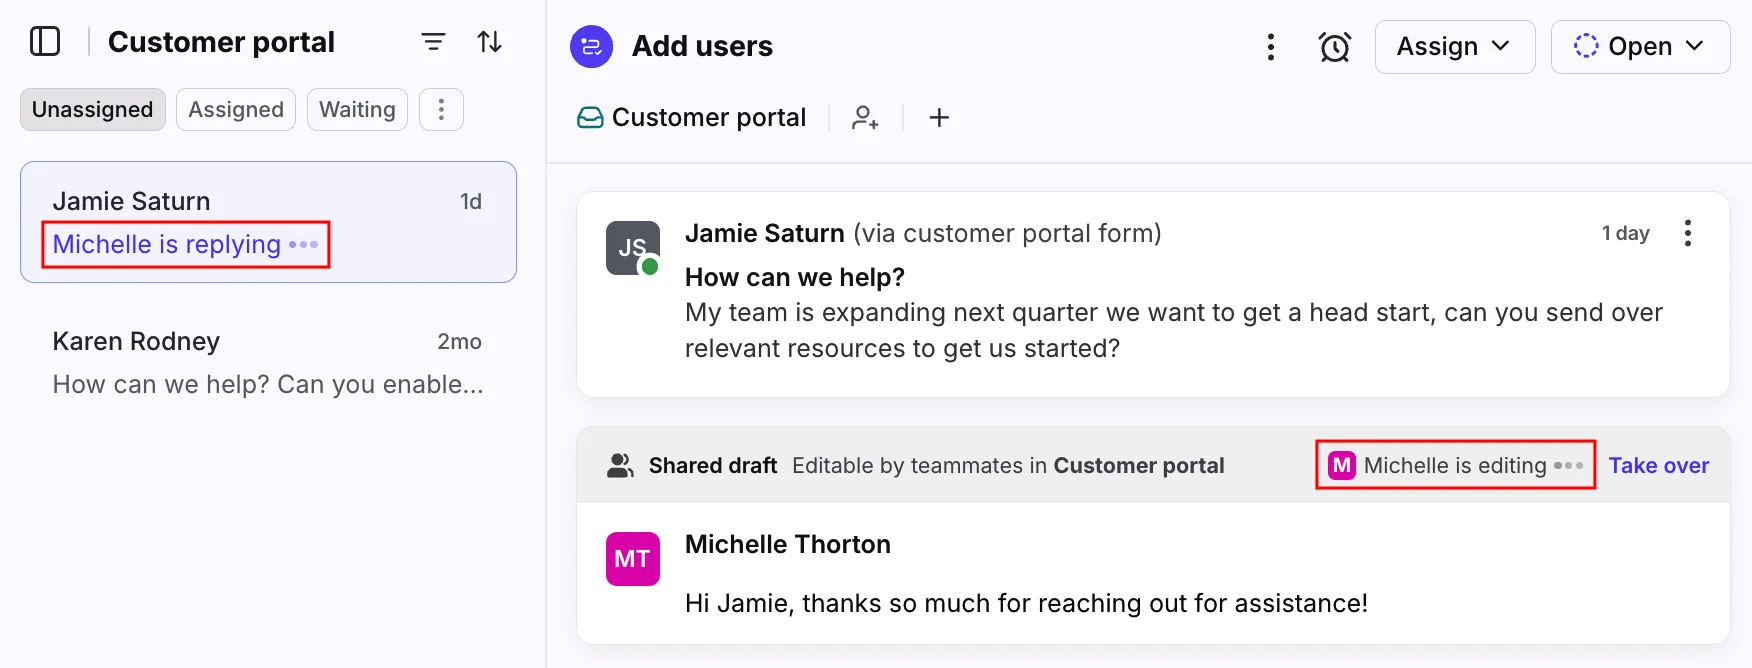
Le marqueur « replying » s'affiche dans la liste elle-même, avant même d'ouvrir la conversation, et le brouillon partagé a un bouton Take over pour les passations (documentation de Front sur la collision). Si votre forfait actuel n'a pas de détection des collisions (Zendesk Team, Freshdesk Free), l'attribution push compte encore plus, car c'est votre seule protection.
Les règles qui gardent une file partagée honnête
Les outils vous donnent les réglages. Ces six règles décident si les réglages fonctionnent.
- Chaque nouveau ticket obtient un responsable dans un délai fixé. Choisissez un chiffre par canal, par exemple 30 minutes pour l'e-mail et quelques secondes pour le chat. Suivez-le comme un objectif à part, distinct de votre SLA de première réponse.
- Une personne possède les restes à chaque service. Un commentateur du fil sur le ticket resté deux jours sans attribution a suggéré la version la plus simple : "Make one person responsible each day/week for triage; reading all calls as they come in, fixing the 5 minute ones and assigning out the remainder" (r/CustomerService).
- Triez les vues partagées du plus ancien au plus récent. Les vues du plus récent en premier récompensent le fait de prendre des tickets frais et faciles. Avec le plus ancien en premier, le ticket qui vieillit est la première chose que tout le monde voit.
- Fixez des limites de capacité, puis respectez-les. Tous les helpdesks ci-dessus laissent les agents s'attribuer des tickets au-delà de leur limite. Si les responsables continuent de déverser des tickets sur l'agent le plus rapide, le routage push n'équilibre plus rien.
- Donnez un sens au statut d'absence. Le routage ne saute que les agents marqués absents ou hors ligne. Si les agents oublient de régler leur statut à midi, les tickets s'accumulent à leur nom. Associez cela à un balayage de passation de relais de tout ce qui est encore attribué à quelqu'un de parti.
- Escaladez automatiquement les tickets sans responsable. Un déclencheur ou une automatisation qui alerte un responsable quand un ticket est resté non attribué au-delà de votre limite est une assurance bon marché. Mon guide pour escalader les tickets non attribués contient une recette Zendesk, et les escalades par SLA couvrent le côté réponse.
Il y a aussi un point d'équité que les responsables oublient. Un sysadmin sur Reddit a décrit qu'il traitait 3 fois plus d'appels que le reste de l'équipe et qu'on lui reprochait d'avoir trop de tickets ouverts, tandis que des collègues qui ne touchaient jamais à la file étaient félicités pour un chiffre « sain » (r/sysadmin). Si vous mesurez les tickets ouverts par agent dans un modèle pull, vous punissez ceux qui tirent. Mesurez plutôt les tickets traités et l'âge sans responsable.
Que surveiller dans une file partagée
Vous n'avez pas besoin d'un tableau de bord de 20 tuiles. Il vous faut quatre chiffres, vérifiés plusieurs fois par jour.
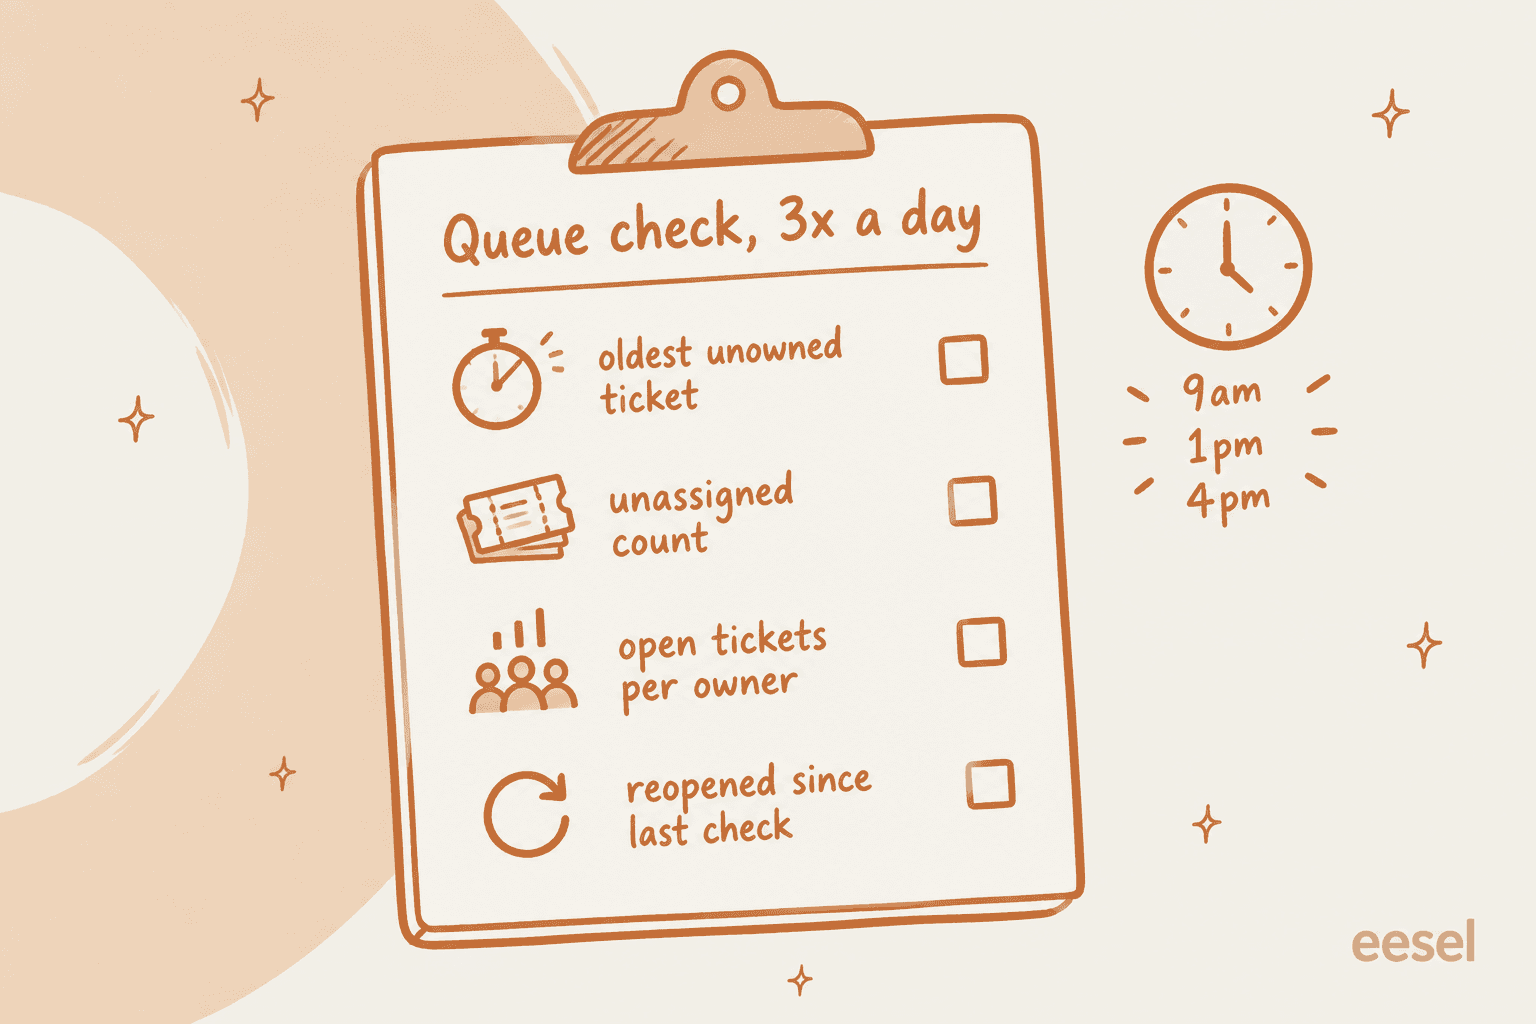
| Chiffre | Ce qu'il vous dit | Où il se trompe |
|---|---|---|
| Plus ancien ticket sans responsable | La vraie pire attente | Les moyennes le cachent complètement |
| Nombre de tickets non attribués | Si le routage ou les personnes suivent | Un pic signifie que le statut ou la capacité sont mal configurés |
| Tickets ouverts par responsable | Si la charge est équilibrée | Un agent à 3 fois les autres signifie que le push n'équilibre pas ou qu'un responsable le contourne |
| Rouverts depuis la dernière vérification | Si les réponses rapides résolvent vraiment les choses | Beaucoup de réouvertures signifient que la vitesse s'achète au prix de la qualité |
Ces chiffres s'ajoutent à vos KPI du service client habituels, ils ne les remplacent pas. Si votre arriéré de tickets est déjà important, commencez par mon guide pour résorber un arriéré de support avant d'ajuster le routage.
Le routage ne peut pas réparer une file qui manque simplement de personnel. Mon article sur la planification de la couverture du support contient le calcul des effectifs.
Où l'IA s'intègre dans une file partagée
L'essentiel du travail dans une file partagée n'est pas de répondre. C'est de lire un ticket, de décider ce que c'est, de l'étiqueter et de décider qui doit l'avoir. Cette étape de tri est celle où l'IA est devenue bonne, et c'est par là que je commencerais.
eesel met de l'IA sur des files de support réelles depuis des années, et les chiffres de déploiements réels sont plus utiles que n'importe quelle promesse. Lors d'un test sur du trafic Zendesk réel chez un bijoutier en ligne allemand traitant environ 1 000 tickets par mois, l'IA d'eesel a atteint 93 % de précision de tri et 100 % de détection du spam, sans faux positif sur les 22 % de la boîte qui s'est révélée être du spam. Ses brouillons de réponse étaient justes dans la bonne direction à 88 %, et 12 % sont partis tels quels. Les agents l'ont surtout utilisée comme assistant de recherche et de tri automatique, exactement le travail dont une file partagée a besoin.
L'exigence d'achat la plus courante que j'entends concerne le contrôle, pas la vitesse. Un responsable CX d'une marque de compléments alimentaires sur Gorgias, avec environ 7 000 tickets par mois, l'a formulé ainsi lors d'un appel :
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
C'est le bon réflexe pour une file partagée. L'IA doit prendre les tickets qu'elle sait traiter entièrement, trier et router le reste, et laisser tout ce qui est incertain à une personne. Avec le coéquipier pour helpdesk d'eesel, le routage suit vos propres instructions (par exemple « attribue tout ce qui vient d'un client en colère à l'équipe senior ») en utilisant les actions d'attribution du helpdesk. Vous pouvez déployer par étapes : d'abord des brouillons en notes internes, puis la laisser répondre aux tickets faciles de bout en bout. Avant que quoi que ce soit ne passe en production, Simulation rejoue vos anciens tickets et note les réponses de l'IA par rapport à ce que votre équipe a réellement envoyé, pour que vous voyiez les erreurs avant vos clients.
Gridwise, une application d'analyse pour chauffeurs sur Zendesk, a écrit dans un avis G2 :
"In the first month, eesel is resolving 73% of our tier 1 requests... The platform even includes automations for ticket tagging, assignment, and status updates!"
Kim Simpson, Gridwise
Pour une file partagée, l'effet est que les tickets faciles n'arrivent jamais dans le tas, et que ceux qui arrivent sont déjà étiquetés et routés. Si vous comparez des options, mon tour d'horizon des meilleures IA pour le tri des tickets couvre le paysage, et le guide du copilote IA couvre le côté rédaction.
Erreurs courantes avec les files partagées
- Faire tourner une boîte partagée sans aucune attribution. Correct à 10 tickets par jour, chaotique à 40. Un responsable CS a décrit son passage à une plateforme dédiée "once it became unwieldy to manage the responses and mistakes were being made" (r/CustomerSuccess). Mon article sur la boîte partagée vs système de tickets explique quand changer.
- Diviser la file en boîtes personnelles. Cela paraît net, mais personne ne voit l'arriéré d'un collègue et les tickets meurent quand quelqu'un est malade. Gardez une seule file et routez à l'intérieur. Mon guide des opérations de support distribuées plaide pour la même chose avec les équipes multi-sites.
- Activer le routage push sans limites de capacité. Vous obtiendrez le schéma « 15 tickets pour trois personnes, aucun pour les autres » du fil Zendesk ci-dessus.
- Traiter les escalades comme faisant partie du pool général. Les tickets escaladés ont besoin d'un responsable nommé, pas d'une place dans le round robin. Voir mon guide du processus d'escalade des tickets et, pour les passations vers l'ingénierie, l'escalade inter-équipes.
- Ignorer les fuseaux horaires. Une file couverte par des personnes de régions différentes a besoin d'un routage par horaires, sinon le tas de la nuit tombe sur le premier connecté. Le support follow-the-sun couvre cette configuration.
eesel pour les files de support partagées
Si votre file partagée croule sous les tickets répétitifs, la solution la moins chère est un coéquipier qui les retire du tas. Le coéquipier IA pour helpdesk d'eesel se branche sur Zendesk, Freshdesk, Gorgias, Front, Help Scout et d'autres helpdesks en quelques minutes, apprend de vos anciens tickets, macros et centre d'aide, puis étiquette, route et répond aux tickets faciles dans la file que vous utilisez déjà. Vos agents gardent leurs vues, leur routage et leur flux de travail. Ils voient simplement moins de tickets, et ceux qu'ils voient sont déjà triés.

Vous pouvez le tester sur vos propres anciens tickets avec Simulation avant qu'il ne touche un vrai client, et il existe un forfait gratuit pour démarrer. Essayez eesel sur votre file partagée et voyez quels tickets il aurait réglés la semaine dernière.
Comment empêcher les agents de choisir uniquement les tickets faciles dans une file partagée ?