

En bref
La gestion du débordement du support est surtout une décision de routage, pas de recrutement. Dans Zendesk, Freshdesk, Help Scout, Front, Gorgias et HubSpot, le comportement par défaut quand tous les agents sont à pleine capacité est le même : le nouveau travail reste dans la file, non assigné, jusqu'à ce que quelqu'un se libère. Le débordement n'est traité que si vous décidez, à l'avance, où va le prochain ticket.
La configuration qui fonctionne pour la plupart des équipes est une cascade : équipe principale, puis un groupe de secours, puis une couche d'IA qui répond aux questions récurrentes, puis des réponses asynchrones avec un délai d'attente honnête, puis des rappels pour le téléphone. Les fonctions de groupe de secours dépendent du forfait (les files personnalisées de Zendesk exigent Suite Professional, la redirection vers un groupe de repli de Freshdesk est réservée à Enterprise) ; vérifiez donc votre forfait avant le pic, pas pendant.
Je travaille chaque jour dans la file du support d'eesel, et l'essentiel du volume en pic se résume aux mêmes quelques questions : statut de commande, changements d'abonnement, « est-ce en panne ? ». Un responsable des opérations d'une marque DTC traitant environ 7 000 tickets Gorgias par mois a expliqué à eesel que son équipe n'arrivait tout simplement pas à suivre et avait besoin d'une IA qui résolve au moins la moitié du volume d'e-mails. Cette part récurrente est celle que le coéquipier IA d'eesel retire de la file au sein de votre helpdesk actuel, pour que vos équipes consacrent le pic aux tickets qui exigent un humain.
Ce que couvre réellement la gestion du débordement du support
Le débordement, c'est tout travail qui arrive quand chaque agent qui pourrait le prendre est soit à sa limite, soit hors ligne. Ce dernier point compte : il ne s'agit pas seulement de « trop de tickets ». Un mardi après-midi avec deux personnes malades est un événement de débordement. Tout comme un chat à 2 h du matin quand votre couverture hors horaires se résume à un message de messagerie vocale.
Il prend en général l'une de ces trois formes :
| Forme | Ce qui le déclenche | Sa durée | Ce qu'il faut |
|---|---|---|---|
| Pic | Panne, lancement, publication virale, retard de livraison | De quelques heures à 2 jours | Réponses rapides en un-à-plusieurs, une filière de secours qui s'ouvre en quelques minutes |
| Pic saisonnier | Black Friday, fêtes, saison des renouvellements, échéances fiscales | De 2 à 12 semaines | Capacité supplémentaire planifiée, temporaires formés ou partenaire, réponses rédigées à l'avance |
| Trou de couverture | Arrêts maladie, fuseaux horaires, pause déjeuner, réunion d'équipe | De quelques minutes à quelques heures | Un routage qui ne dépend pas de la présence en ligne d'une seule personne |
La plupart des guides traitent cela comme un seul problème et sautent directement à « embauchez plus » ou « externalisez ». Je commencerais par quelque chose de moins coûteux : regardez ce que fait aujourd'hui votre helpdesk du ticket suivant quand tout le monde est saturé, car ce comportement par défaut vous coûte probablement plus cher que les effectifs.
Où va le débordement par défaut dans chaque helpdesk
J'ai parcouru la documentation de routage des sept outils que je vois le plus dans la file du support d'eesel. Le schéma est frappant. Quand chaque agent éligible est à son plafond, presque tous laissent le nouveau travail dans la file du support sans le nom de personne :
| Helpdesk | Plafond par agent | Tous les agents saturés ou hors ligne | Filière de débordement intégrée | Forfait requis |
|---|---|---|---|---|
| Zendesk | E-mail jusqu'à 500 ouverts, messagerie jusqu'à 20 | Le ticket reste dans la file | Groupes secondaires dans une file personnalisée | Suite Professional (115 $/agent/mois) |
| Freshdesk | Charge par file (ex. e-mail 5, messagerie 10) | Le ticket reste non assigné | « Reroute to a Fallback Group » après N secondes | Enterprise (89 $/agent/mois) |
| Help Scout | Limite d'assignation jusqu'à 100, chats 3 par défaut | La conversation reste dans Unassigned | Aucune documentée | Round Robin dans Plus (45 $), Balanced dans Pro (75 $) |
| Front | Limite d'équilibrage de charge, 100 par défaut et maximum | L'équilibrage de charge met le travail en file ; le round robin non | Aucune documentée | Forfait non indiqué sur la page de tarifs |
| Gorgias | Deux plafonds : chat et messagerie, autre texte | Le ticket reste non assigné | « Skip queue when it's too busy » sur la voix | Tous les forfaits Helpdesk (module Voice à partir de 25 $/mois) |
| HubSpot Service Hub | Capacité de tickets (Pro+), capacité de chat 3 par défaut, max 99 (Enterprise) | Le ticket reste non assigné jusqu'à une assignation manuelle | Repli optionnel des chats vers l'agent client | Professional (90 $/siège) ou Enterprise (150 $/siège) |
| Aircall (voix) | Basé sur les sonneries | L'appel attend le temps de file, puis messagerie vocale ou manqué | Enchaîner une autre étape Ring to après la première | Rappels dans Professional (50 $/licence) |
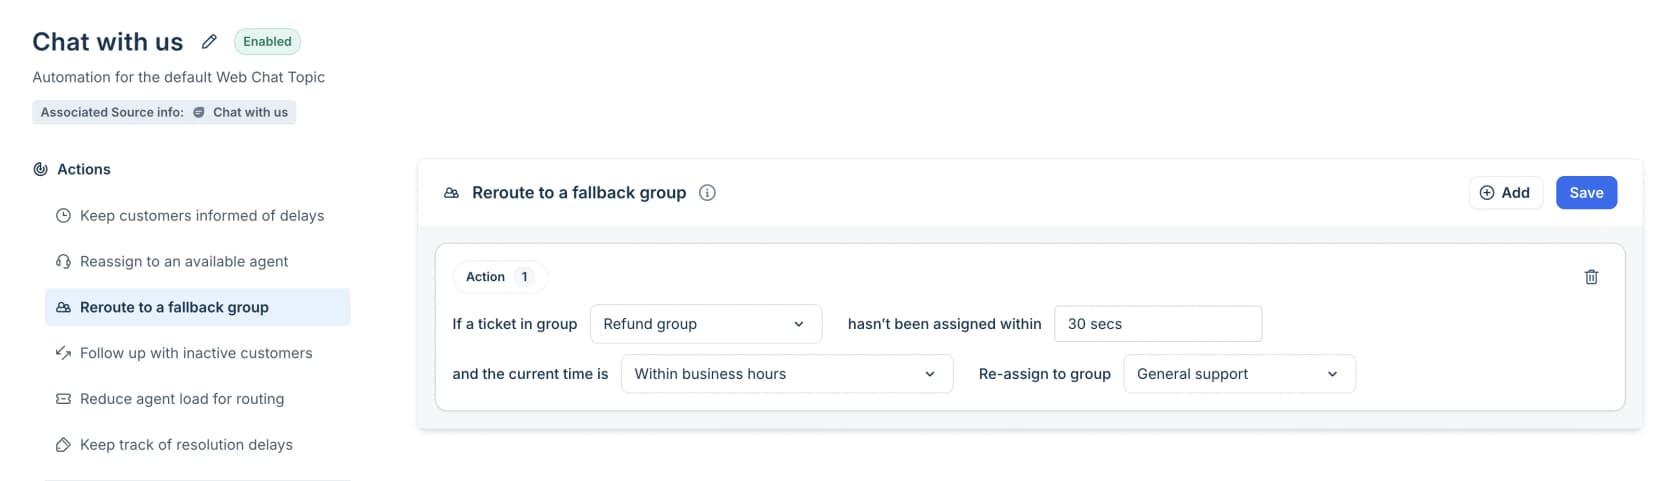
Deux choses sautent aux yeux. Premièrement, seuls Zendesk et Freshdesk proposent une vraie règle de débordement « envoyer vers un autre groupe », et tous deux la placent derrière un forfait supérieur. Deuxièmement, les deux outils fonctionnent différemment. Zendesk déborde selon la disponibilité : le travail va d'abord aux groupes principaux et ne bascule vers les groupes secondaires que si aucun agent principal n'est disponible. Freshdesk déborde selon le temps : la règle Quick Automations se déclenche quand un ticket d'un groupe n'a pas été assigné dans un nombre de secondes défini, par exemple cinq minutes pour un ticket Refunds avant qu'il passe à General Support.
Front est celui à surveiller. Si vous utilisez le round robin, il n'y a aucune file quand tout le monde est hors ligne, et une assignation manquée n'est pas retentée au retour de quelqu'un. L'équilibrage de charge, lui, met en file et distribue d'abord la conversation sans réponse la plus ancienne. Si votre équipe Front est petite et sujette aux pics, ce seul réglage décide si le débordement attend en file ou se perd.
C'est ainsi qu'un ticket critique se retrouve enterré. Un administrateur Zendesk a décrit exactement cela sur Reddit :
« Un client Enterprise a signalé à 9 h que son système de production était en panne. Le ticket est resté dans notre file jusqu'à 14 h parce que nous avions plus de 30 autres tickets arrivés pendant la nuit. »

Construisez une cascade de débordement, pas une équipe plus grande
Un sysadmin, dans un fil sur les pics d'appels imprévus, a résumé pourquoi recruter pour le pic fonctionne rarement :
« on ne dimensionne pas les effectifs pour les 1 % d'événements rares, on les dimensionne pour les 90 % de jours ordinaires. »
La solution au problème « le travail reste non assigné » est donc de donner à chaque ticket une prochaine étape. Je l'imagine comme une pile de bacs : quand l'un est plein, il déborde dans le suivant, et le bac du bas n'est jamais « personne ».
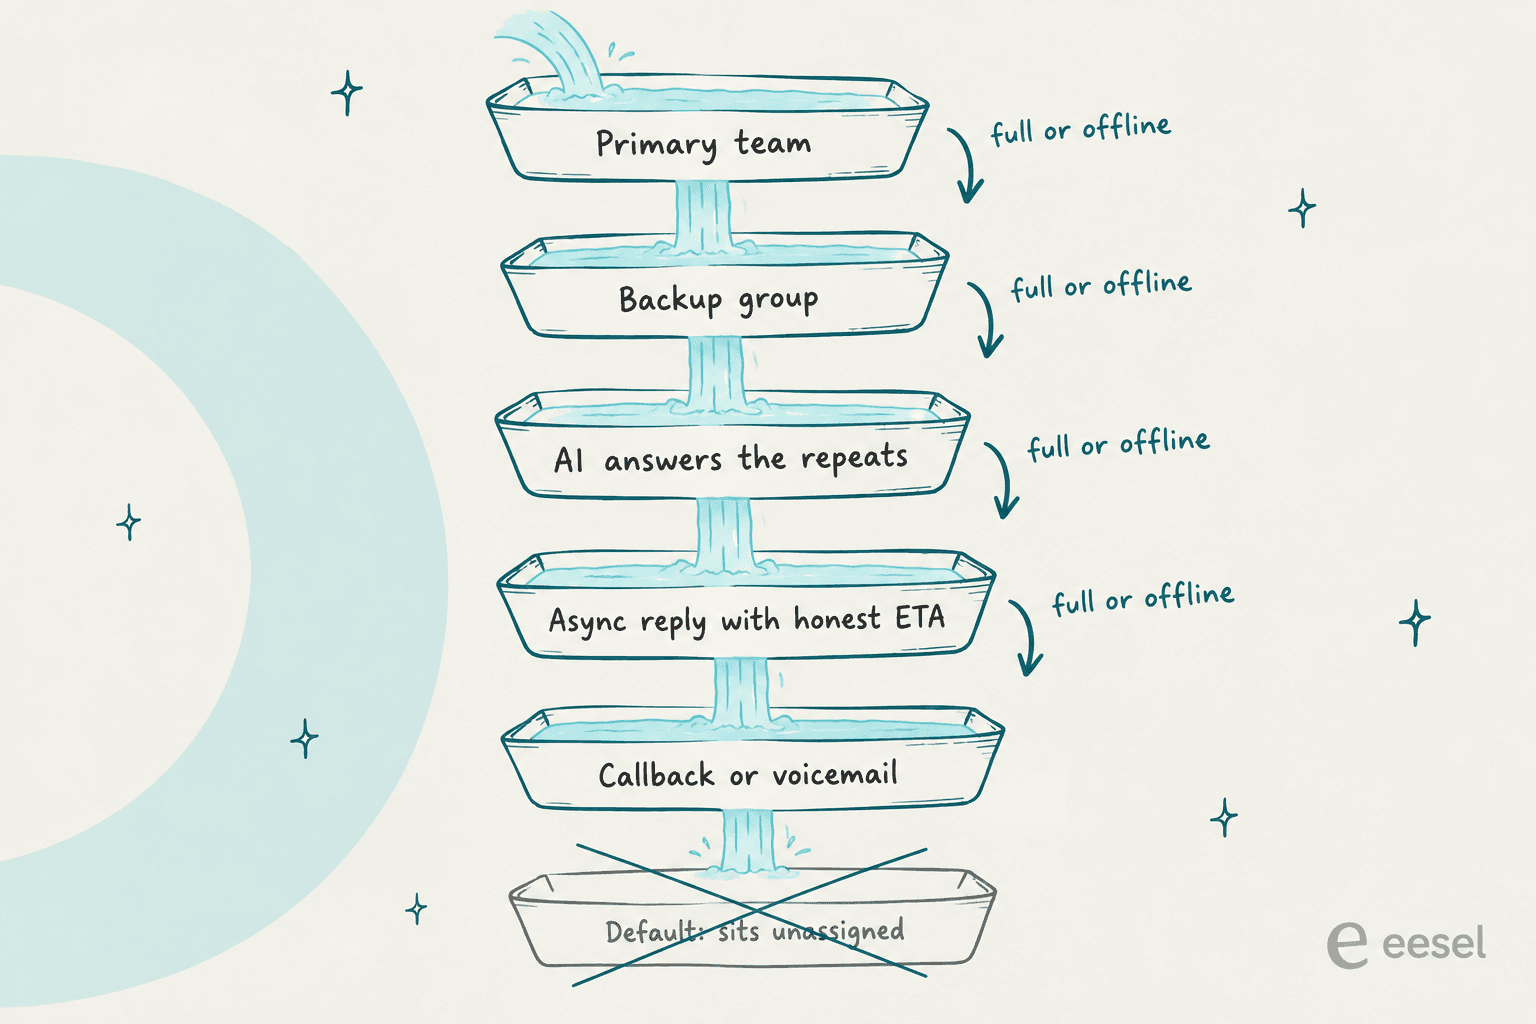
Voici comment je le construirais, dans l'ordre qui apporte le plus de soulagement pour le moins d'argent.
1. Fixez les seuils sur l'ancienneté des tickets, pas sur leur nombre
Une file de 150 tickets arrivés il y a dix minutes, ce n'est pas grave. Une file de 40 dont le plus ancien attend depuis 18 heures, c'est un incendie. Le nombre ment pendant un pic, car il grimpe et redescend vite. L'ancienneté du plus vieux ticket sans réponse indique si des clients sont réellement laissés de côté, et elle se rattache directement à votre délai de première réponse et à vos engagements de SLA.
Notez trois ou quatre niveaux et, pour chacun, l'unique chose qui change. Les chiffres ci-dessous sont un point de départ que j'ajusterais à votre propre SLA, pas un standard :
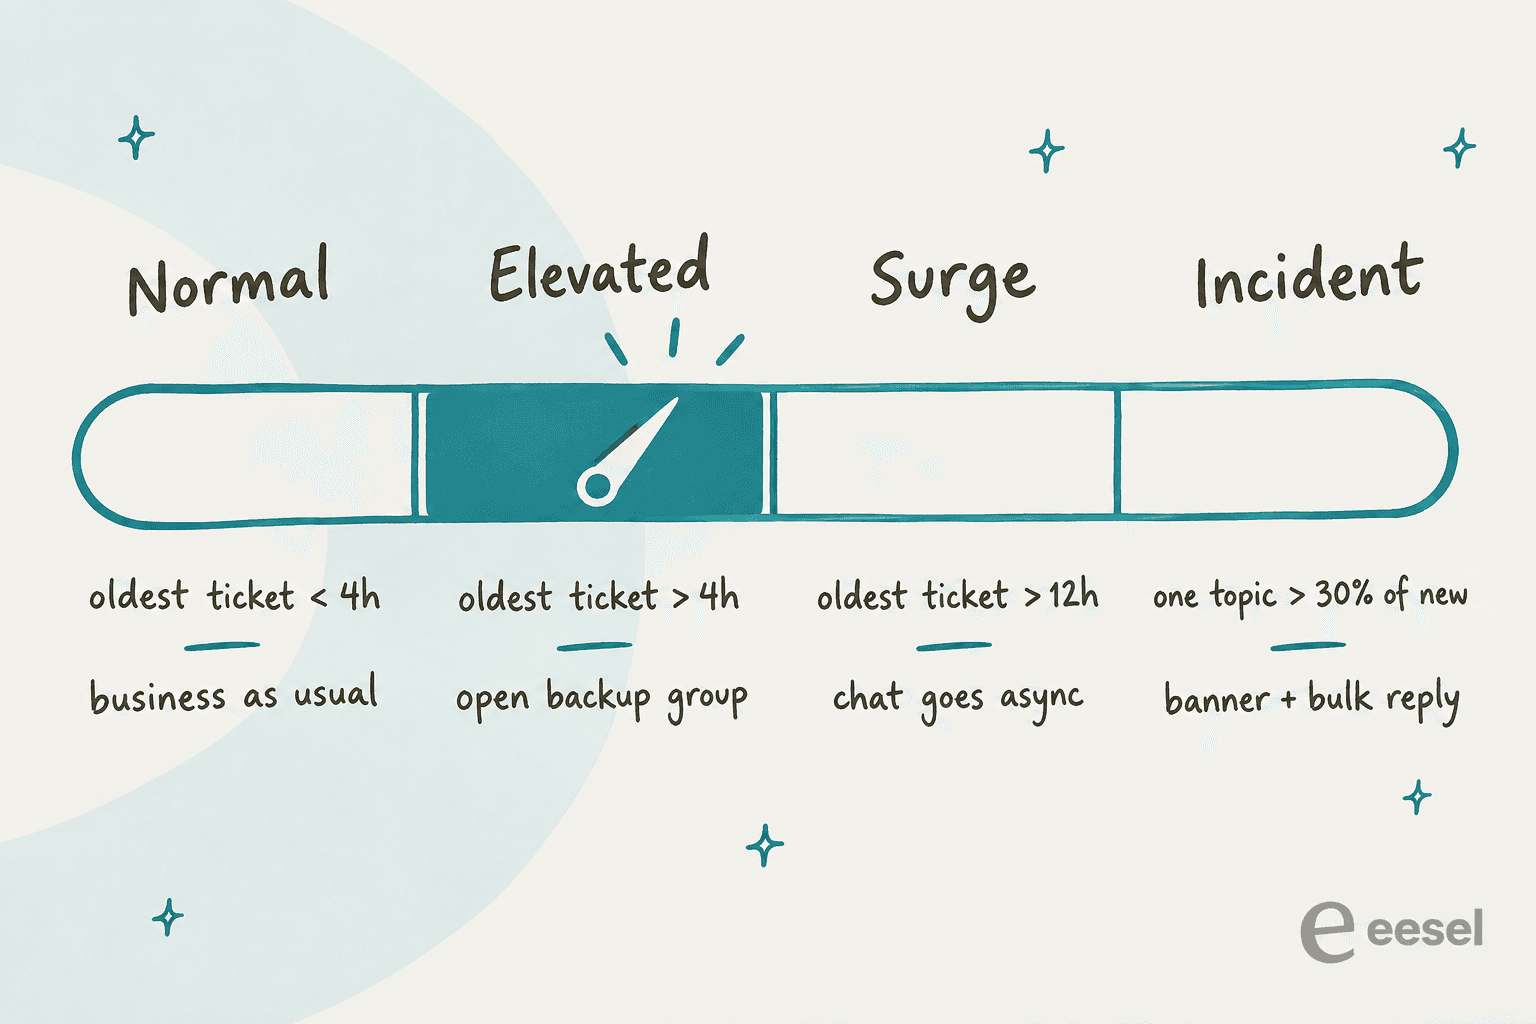
L'intérêt de l'écrire, c'est que personne n'a à prendre une décision au jugé à 16 h le jour du lancement. La règle existe déjà, et celui qui remarque la jauge bouger n'a qu'à actionner l'interrupteur.
2. Ouvrez un groupe de secours avant d'en avoir besoin
Le groupe de secours, ce sont les personnes qui peuvent prendre le travail de niveau 1 quand l'équipe principale est saturée : une seconde équipe, des agents seniors d'une autre région ou quelques volontaires formés issus du succès client et des ventes. Configurez-le dans l'outil pendant une semaine calme.
- Zendesk. Créez une file personnalisée, ajoutez vos groupes principaux comme primaires, puis « Turn on secondary groups » et ajoutez le groupe de secours. Chaque file personnalisée accepte jusqu'à 20 groupes primaires et 20 secondaires, et vous pouvez avoir jusqu'à 199 files. La recette de Zendesk pour la messagerie ajoute un groupe « Backup » en dernier recours afin que les tickets « ne restent pas bloqués dans les files plus longtemps que vous ne le souhaitez ».
- Freshdesk. En Pro, répartissez la capacité de chaque agent par file dans Omniroute pour que le chat et l'e-mail ne s'affament pas mutuellement. En Enterprise, ajoutez la quick automation « Reroute to a Fallback Group » pour les canaux en temps réel.
- Help Scout, Front, Gorgias, HubSpot. Il n'existe pas de groupe de débordement natif ; la solution de contournement est un workflow ou une règle qui réassigne selon une étiquette ou un temps d'attente, plus une file partagée que le renfort surveille pendant un pic.
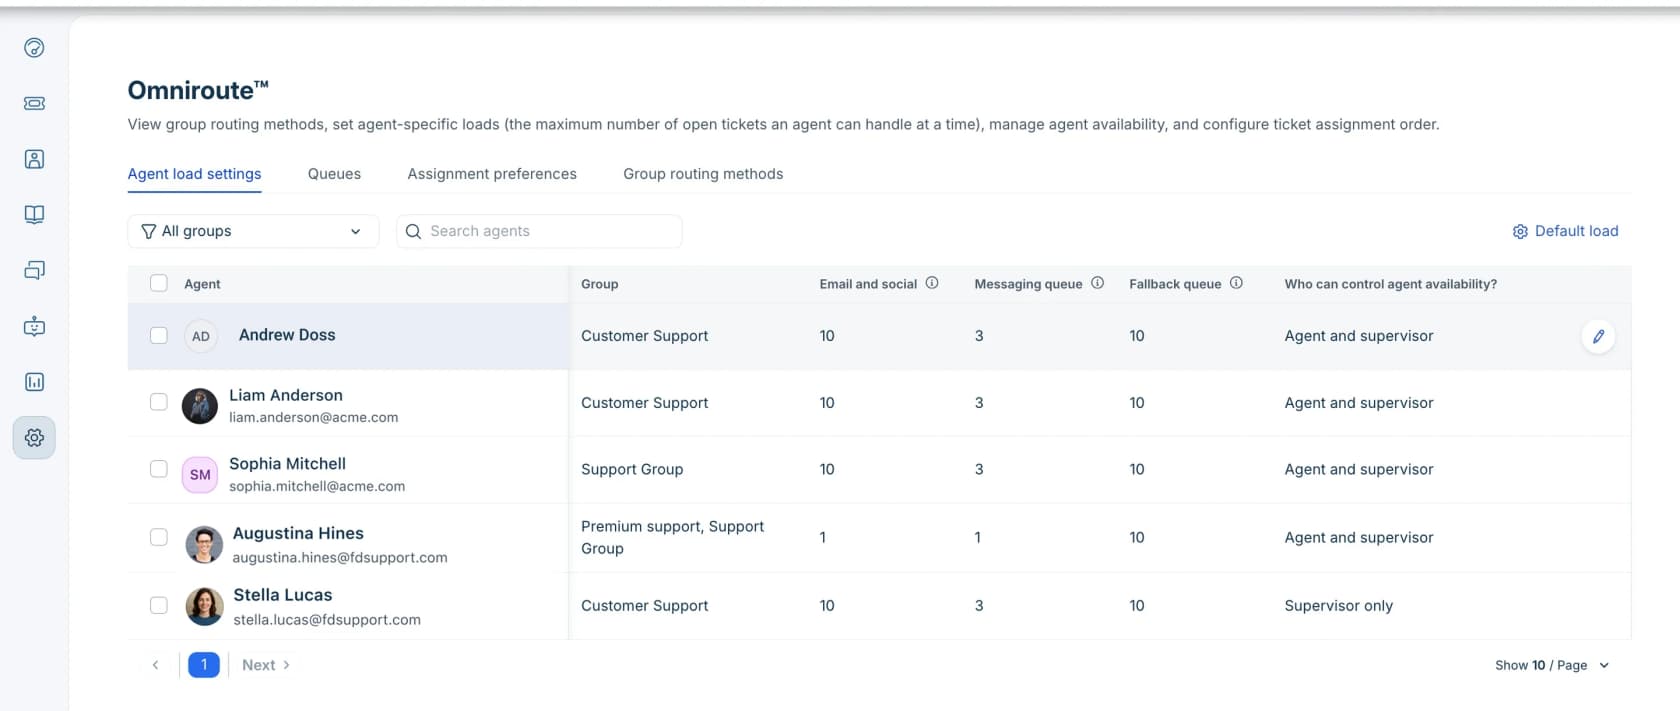
Un détail de Freshdesk est utile pour les pics qui ne durent qu'une semaine : les day passes coûtent 2 $ en Growth, 7 $ en Pro et 12 $ en Enterprise ; emprunter un collègue d'un autre service pour la semaine du lancement ne revient donc pas à payer un siège complet.
3. Protégez vos spécialistes du volume de niveau 1
Quand la file déborde, les premiers mobilisés sont ceux qui en savent le plus, et ils passent le pic à répondre à « où est ma commande ? » pendant que les tickets difficiles vieillissent. Répartissez le travail par type. Les questions de niveau 1 vont au groupe de secours et à la couche d'IA. Les litiges de facturation, les bugs et les VIP furieux restent aux spécialistes. Zendesk Suite Professional ajoute pour cela un routage par compétences et priorités, et Freshdesk propose un routage par compétences en Enterprise.
Si vous fonctionnez déjà par niveaux, c'est le moment où votre circuit d'escalade fait ses preuves. Un pic, c'est quand un vague « envoyez-le à l'ingénierie » devient 3 jours de silence.
4. Répondez une seule fois, publiquement, au sujet du pic
Lors d'une panne ou d'un retard de livraison, une grande part des nouveaux tickets pose la même question. Répondre à chacun à la main est la façon la plus coûteuse de dire « nous sommes au courant, voici la mise à jour ». Publiez-la une fois là où les clients regardent avant d'écrire : une bannière de statut, le centre d'aide, le message d'accueil du chat et les réponses de votre agent IA. Créez ensuite une macro qui répond, étiquette et clôt les tickets qui arrivent malgré tout.
La même astuce fonctionne au téléphone. Un responsable informatique place la mise à jour devant la file elle-même :
« Je mets un message avant que l'appel soit routé vers la file d'appels, qui explique ce qui ne va pas, quand aura lieu la prochaine mise à jour et de raccrocher si on a justement ce problème ; sinon, de rester en ligne pour être routé vers la file du helpdesk. »
C'est aussi là que l'IA fait son meilleur travail de débordement. Elle lit la note d'incident et répond à « le paiement est-il en panne ? » quelques centaines de fois avec la même mise à jour exacte, pendant que votre équipe s'occupe des clients dont la commande a réellement échoué. Plus de détails plus bas.
5. Passez les canaux en direct en asynchrone avec un délai d'attente honnête
Le chat en direct est le premier canal à lâcher lors d'un pic, car chaque agent ne peut en gérer que quelques-uns à la fois. Le Maximum Chat de Help Scout vaut 3 par défaut, et la capacité de chat de HubSpot est aussi de 3 par défaut. Quand tout le monde atteint cette limite, un visiteur face à une fenêtre de chat qui ne répond jamais est plus mal loti qu'avec un e-mail disant « nous répondons dans environ 4 heures ».
Les outils fournissent l'interrupteur :
- HubSpot vous laisse choisir ce qui se passe quand tous les agents sont à capacité maximale : afficher un message d'attente, masquer le lanceur ou ne rien faire.
- Le chat Gorgias peut n'être en direct que lorsque des agents sont disponibles, et les acheteurs hors ligne reçoivent un formulaire de capture qui devient un ticket e-mail. Il existe aussi le réglage « Share wait time with shoppers ».
- Front peut masquer le widget de chat en dehors des heures en ligne, mais un client qui l'a déjà ouvert peut encore envoyer des messages ; Front recommande donc une réponse automatique.
- Les conversations de messagerie Zendesk attendent dans la file jusqu'à ce qu'une place de capacité se libère, et celles qui ne sont pas assignées passent en inactif après 10 minutes sans réponse du client. Le guide sur la gestion hors ligne de la messagerie Zendesk couvre le côté client.
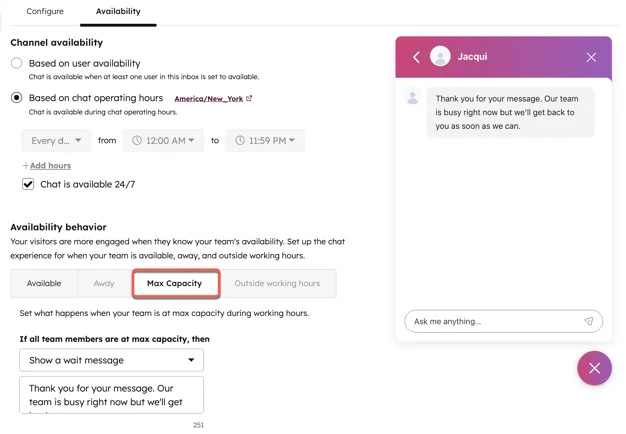
Le support asynchrone n'est pas ici un pis-aller. Une promesse précise que vous tenez vaut mieux qu'un canal en direct qui laisse les gens sans réponse.
Débordement de la voix : les réglages qui font tomber des appels
Le débordement téléphonique mérite sa propre section, car les réglages par défaut peuvent raccrocher au nez des gens. Chaque outil plafonne le nombre d'appelants en attente et la durée, et ce qui se passe ensuite dépend de votre configuration, y compris quand elle est vide.
| Outil | Taille max. de file | Attente max. | Quand l'attente expire | Rappel |
|---|---|---|---|---|
| Zendesk Talk | 750 (Team) ou 1 500 (Pro/Enterprise) avec routage omnicanal ; 15 ou 50 sans | 1 à 20 min, 1 à 60 en Enterprise | Messagerie vocale, ou numéro de débordement si la messagerie est désactivée | Professional et Enterprise |
| Freshcaller | 20 par défaut, davantage sur demande pour Pro et Enterprise | 30 s à 15 min | Messagerie vocale, autre file ou raccrochage | Touche 2, rappel dès qu'un agent se libère |
| Gorgias Voice | Capacité de file par file | Attente max. en secondes | Étape suivante du flux d'appel ; branche « Skip queue when it's too busy » | Touche étoile, crée un ticket « Callback requested » |
| Aircall | Basé sur les sonneries | 20 s à 40 min en file d'équipe | Widget suivant, ou l'appel est coupé | 0 à 5 nouvelles tentatives, Professional et supérieur |
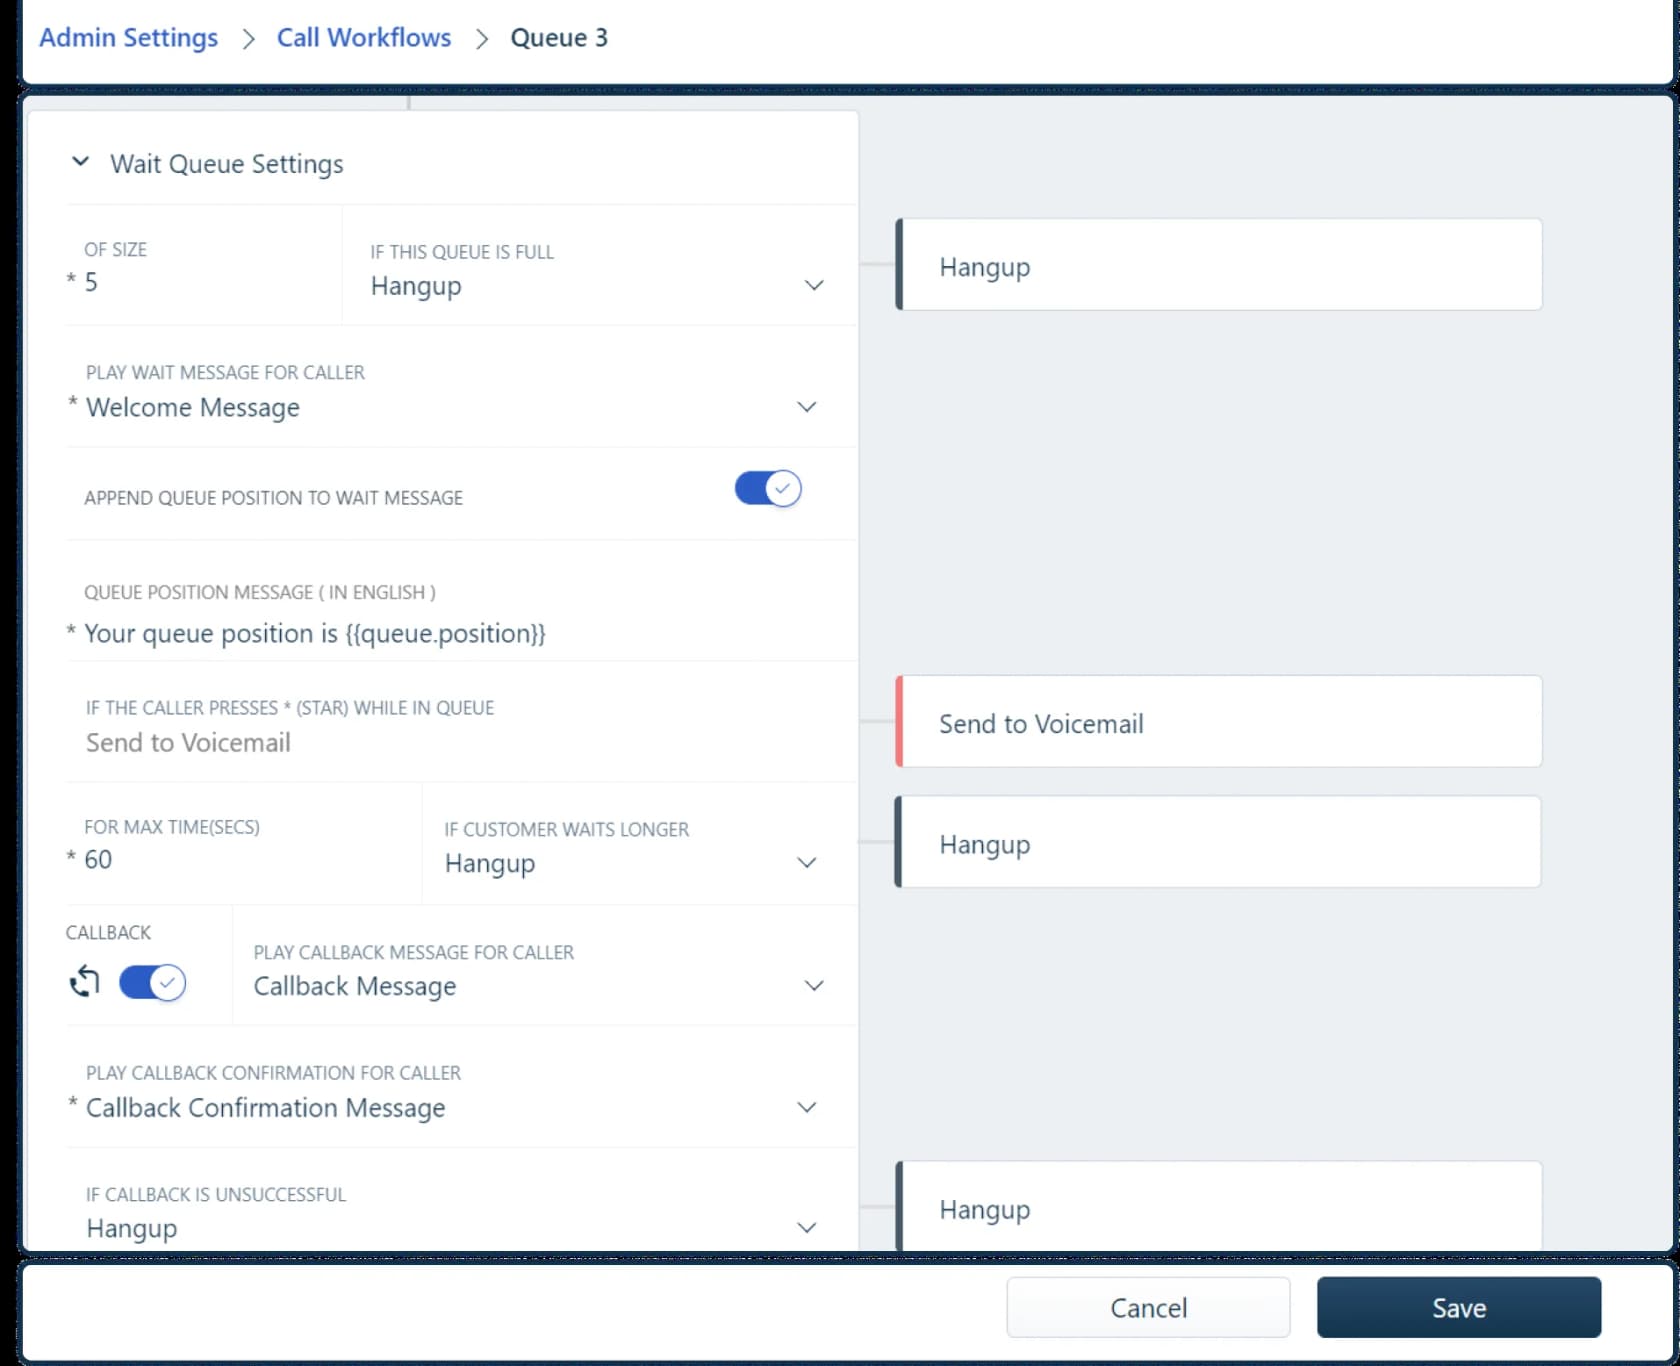
Trois pièges que je vérifierais dès aujourd'hui :
- Rien après la dernière étape. Dans Zendesk, avec la messagerie vocale désactivée et sans numéro de débordement, l'appelant entend le message d'accueil puis l'appel est coupé. Dans Aircall, si rien ne suit une étape Ring to, l'appel Aircall sonne une fois puis tombe. Terminez toujours le flux par une messagerie vocale ou un rappel.
- Les transferts ignorent votre plafond d'attente. L'attente maximale en file de Zendesk est ignorée après un transfert ; un appelant transféré reste donc en attente jusqu'à ce qu'un agent décroche. C'est exactement ce qui arrive pendant un pic quand le niveau 1 transfère tout au niveau 2.
- Les rappels exigent quelqu'un en ligne. Le rappel Zendesk nécessite au moins un agent Online ou Away, et les rappels Aircall n'attendent pas indéfiniment : avec zéro nouvelle tentative, un rappel échoué est consigné comme « Failed - No agents available ».
Avec le routage omnicanal de Zendesk activé, le débordement d'appels utilise le même repli des groupes primaires vers les secondaires que les tickets ; un numéro de débordement n'est donc pas nécessaire. Le guide sur le débordement et le délai d'expiration de Talk détaille les deux configurations.
Quelle est l'ampleur de votre problème de débordement ?
Le débordement s'accumule. Tout ticket que votre équipe ne peut pas traiter aujourd'hui passe à demain ; un pic de seulement 50 % au-dessus de la capacité crée donc du retard chaque jour qu'il dure. Prenons un exemple simple : une équipe qui reçoit normalement 200 tickets par jour, avec 4 agents qui en traitent 100 chacun, subit trois fois ce volume pendant cinq jours.
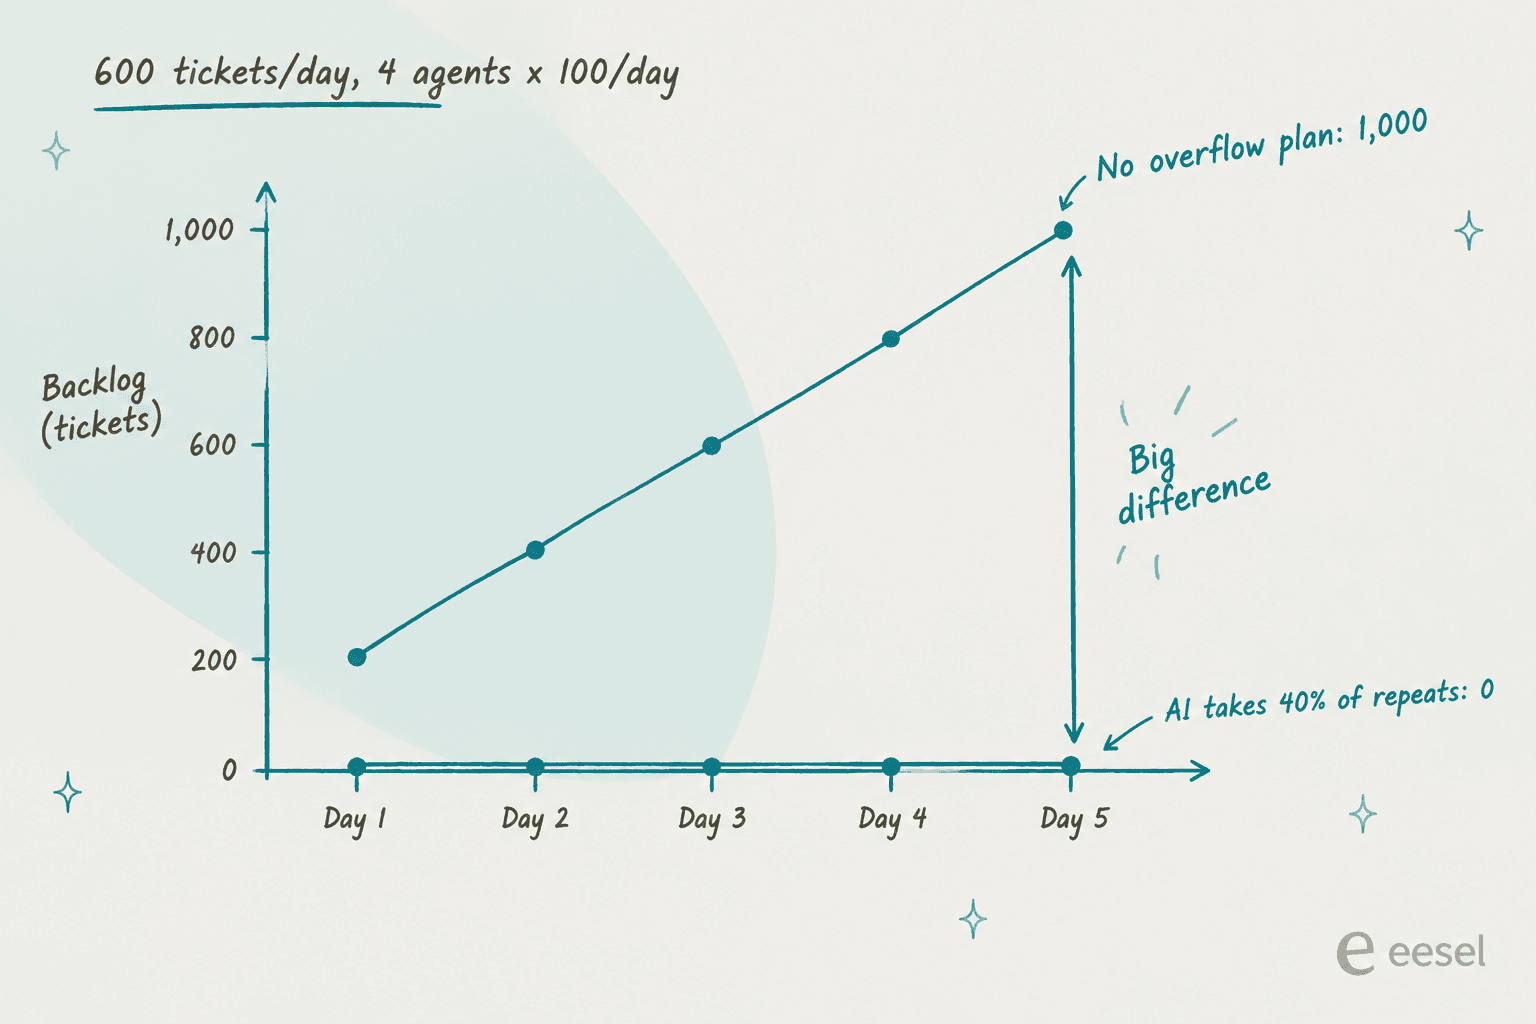
Sans filière de débordement, l'équipe traite 400 sur 600 chaque jour ; le retard augmente donc de 200 par jour et atteint 1 000 tickets au cinquième jour. Quand le volume retombe à 200, les 200 de capacité excédentaire par jour mettent encore cinq jours à le résorber. Les clients qui ont écrit le deuxième jour attendent presque une semaine. Si une filière de secours absorbe 40 % du pic, l'équipe n'en voit que 360 par jour et la file ne se forme jamais. Combler le même écart avec des personnes seules représente 10 jours-agent supplémentaires, formés et prêts dès le premier jour.
Entrez vos propres chiffres :
Le calculateur ignore beaucoup de choses (le temps de traitement varie, certains tickets sont rouverts, les agents ralentissent quand ils sont fatigués), mais la forme est juste. Un soulagement modeste et régulier tôt vaut mieux qu'un rattrapage héroïque plus tard.
D'où vient la capacité supplémentaire
Une fois le routage en place, il faut encore un endroit où le débordement atterrit. Il y a quatre sources réalistes, et chacune convient à une forme différente de débordement :
| Source | Prête en | Idéale pour | À surveiller |
|---|---|---|---|
| Collègues prêtés (succès client, ventes, ops) | Le jour même | Pics, semaine de lancement | Retire des personnes de leur propre travail ; exige des macros et un périmètre étroit |
| Temporaires ou recrutements saisonniers | 2 à 6 semaines | Pics saisonniers prévisibles | Montée en charge et formation ; voir le guide d'intégration saisonnière |
| Partenaire externe de débordement | 4 à 8 semaines de mise en place | Longs pics, couverture 24/7 | Contrôle qualité et manque de contexte ; lisez d'abord sur le chat en direct externalisé |
| Agent IA dans le helpdesk | Quelques jours | Questions récurrentes, quelle que soit la forme du débordement | Doit rester dans ce qu'il sait et passer la main proprement |
La meilleure version de l'option externalisée que j'ai vue décrite est un partenaire que l'on évalue pendant une semaine calme, pas un que l'on signe dans la précipitation en plein incendie :
« J'ai des entreprises que je peux appeler pour leur transférer notre volume d'appels pendant les gros projets ou les pannes. Elles ont déjà passé la due diligence et sont en hot standby, au cas où le besoin se présenterait. »
Pour les pics planifiés, faites le calcul tôt avec un vrai plan de couverture. Pour le Black Friday en particulier, je préparerais aussi un mois à l'avance les messages aux clients et le volet IA de la saison.
Où l'IA intervient dans le débordement (et où elle n'intervient pas)
J'ai passé beaucoup de temps à observer des agents IA gérer de vraies files, et le bilan honnête est que l'IA est la meilleure filière de débordement pour un type de ticket et un risque pour un autre. Elle excelle sur les questions récurrentes qui forment l'essentiel d'un pic : statut de commande, réinitialisation de mot de passe, « l'appli est-elle en panne ? », délais de retour. C'est le mauvais outil pour le client furieux dont la troisième commande a disparu.
Les équipes qui réussissent font choisir ses batailles à l'IA. Un responsable CX d'une marque DTC de compléments alimentaires sur Gorgias et Shopify, traitant environ 7 000 tickets par mois, l'a mieux formulé que moi lors d'un appel commercial avec eesel :
« L'IA ne pourra jamais répondre à 100 % des questions, mais si elle essaie et se contente de répondre "désolé, je ne sais pas", je ne peux pas aller vérifier mes 7 000 tickets pour voir si l'IA a vraiment donné une bonne réponse ; alors l'intérêt disparaît un peu. Il me faut une IA qui ne traite que les tickets dont elle est sûre et qui laisse tous les autres tranquilles. »
C'est le bon cahier des charges pour une IA de débordement. Répondre à ce qu'elle sait, transmettre le reste avec le contexte et ne jamais envoyer une réponse fausse avec assurance dans une file que personne n'a le temps de relire. Leur haute saison court de novembre à mai, précisément quand un retard de tickets « où est ma commande » enterrerait les personnes qui doivent traiter les vrais problèmes.
Les fondateurs qui gèrent eux-mêmes le support décrivent le même amoncellement de tickets quasi identiques :
« Les tickets s'accumulaient et c'étaient surtout des plaintes de niveau 1 avec des problèmes semblables, mais je n'arrivais PAS à suivre. Le churn dû au manque de résolution a causé un burn-out »
Les helpdesks ont leurs propres couches d'IA, et la plupart sont facturées au résultat, ce qui signifie que la facture grossit avec le pic :
| Couche d'IA | Mode de facturation | Prix |
|---|---|---|
| Zendesk AI agents | Par résolution automatisée | 1,50 $ avec engagement, 2,00 $ à l'usage |
| Freddy AI Agent | Par session | 500 incluses, puis 49 $ par 100 |
| Gorgias AI Agent | Par interaction automatisée | 0,85 à 1,00 $ |
| Help Scout AI Answers | Par résolution | 0,75 $, avec plafond de dépenses |
| Front Autopilot | Par conversation | À partir de 0,05 $ |
| Coéquipier IA d'eesel | Par ticket ou chat traité, 1 crédit chacun | À partir de 299 $/mois pour 500 crédits, dépassement plafonné par vous |
La tarification au résultat est équitable en temps normal. Lors d'un pic, elle mérite d'être modélisée. Une analyse de coûts réalisée par eesel pour une boîte e-commerce de 1 000 tickets par mois a montré une tarification à la résolution d'environ 792 $ par mois en mois normal et de 3 168 $ lors d'un mois de Black Friday à 4 000 tickets, avec le même taux de résolution de 80 %. Le centre d'aide de Zendesk note lui-même que les résolutions à l'usage coûtent plus cher qu'un bloc engagé, et permet de plafonner les résolutions mensuelles. Quel que soit votre choix, fixez le plafond avant le pic pour que la hausse ait une limite.
HubSpot propose une jolie version intégrée de l'idée de cascade : un réglage de chat en direct qui assigne les chats à l'agent client quand aucun utilisateur n'est disponible ou que tous sont à pleine capacité. C'est le schéma « IA comme groupe de secours », au sein d'un seul outil.
Essayez eesel comme filière de débordement
Si votre équipe utilise Zendesk, Freshdesk, Gorgias, Help Scout ou Front, le coéquipier IA de helpdesk d'eesel s'insère dans la cascade comme le bac entre votre groupe de secours et la réponse asynchrone. Il rejoint la file que vous avez déjà, apprend de vos anciens tickets, de votre centre d'aide et de vos macros, et répond aux questions récurrentes qui composent un pic. Tout ce dont il n'est pas sûr est transmis à votre équipe avec une note interne, et les remboursements ou autres actions irréversibles peuvent attendre une validation humaine.

Ce sur quoi je m'appuierais avant un pic, c'est la simulation : eesel fait tourner l'agent sur vos vrais anciens tickets et note chaque réponse par rapport à ce que votre équipe a réellement envoyé, afin que vous sachiez quels sujets il peut prendre avant le jour du lancement, pas pendant. Gridwise, sur Zendesk, a vu 73 % des tickets de niveau 1 résolus dès le premier mois. La facturation se fait par ticket ou chat traité, avec des sièges illimités ; ajouter votre groupe de secours pour superviser ne coûte donc rien de plus.
Essayez eesel gratuitement sur votre propre file : commencez avec 100 crédits gratuits, connectez votre compte Freshdesk ou Gorgias et lancez une simulation avant votre prochain pic.
Comment configurer le routage de débordement dans Zendesk ?