

Qu'est-ce que la calibration QA du support ?
Zendesk le dit simplement dans son guide de configuration de la calibration : la calibration est "the practice of having all your reviewers rate the same batch of conversations and compare their scores and comments." C'est toute l'idée. Les mêmes conversations, la même grille QA, des personnes différentes, puis une discussion sur la raison pour laquelle les chiffres ne concordent pas. Si vous n'avez pas encore construit la grille, commencez par la création d'une grille Zendesk QA et revenez ensuite.
Je travaille chaque jour sur la file de support d'eesel, et si cela compte, c'est que les notes QA ne restent pas dans l'outil de QA. Elles finissent dans les entretiens individuels, dans les plans de coaching, parfois dans les primes. Si un évaluateur donne 4 sur 5 en ton à une réponse et un autre 2 à la même réponse, la note de l'agent dépend de la file dans laquelle il est tombé. Les agents le remarquent vite, et une fois qu'ils décident que le QA est une loterie, le feedback ne passe plus.
"You could have five QA agents listen to the same call and get five different results. Which isn't fair to the agent as that score could be used to determine if they'll be fired."

La calibration est la solution. Ce n'est pas une formation pour les agents, et dans la plupart des outils les agents ne la voient jamais. Le guide de configuration de Zendesk dit "Agents do not see any conversation-related information in calibration", et les notes de calibration "don't affect the existing Internal Quality Score (IQS)." C'est un contrôle des évaluateurs, mené par les évaluateurs.
Pourquoi les notes QA divergent
Les évaluateurs ne divergent pas au hasard. Ils divergent sur les catégories où la grille laisse place au jugement : le ton, l'empathie, « la réponse avait-elle la bonne longueur », « l'agent est-il allé au-delà ». Le processus et l'exactitude concordent généralement, car une politique de remboursement est soit respectée, soit non. Le ton, c'est là où deux personnes consciencieuses lisent la même phrase et se retrouvent à deux points d'écart.
L'autre source de dérive, c'est ce que veut dire « réussi » au départ. Voici un exemple réel tiré du travail d'eesel. J'ai examiné un essai en trafic réel sur une boîte de réception Zendesk d'e-commerce, où 284 réponses rédigées par l'IA ont été notées de trois façons différentes.
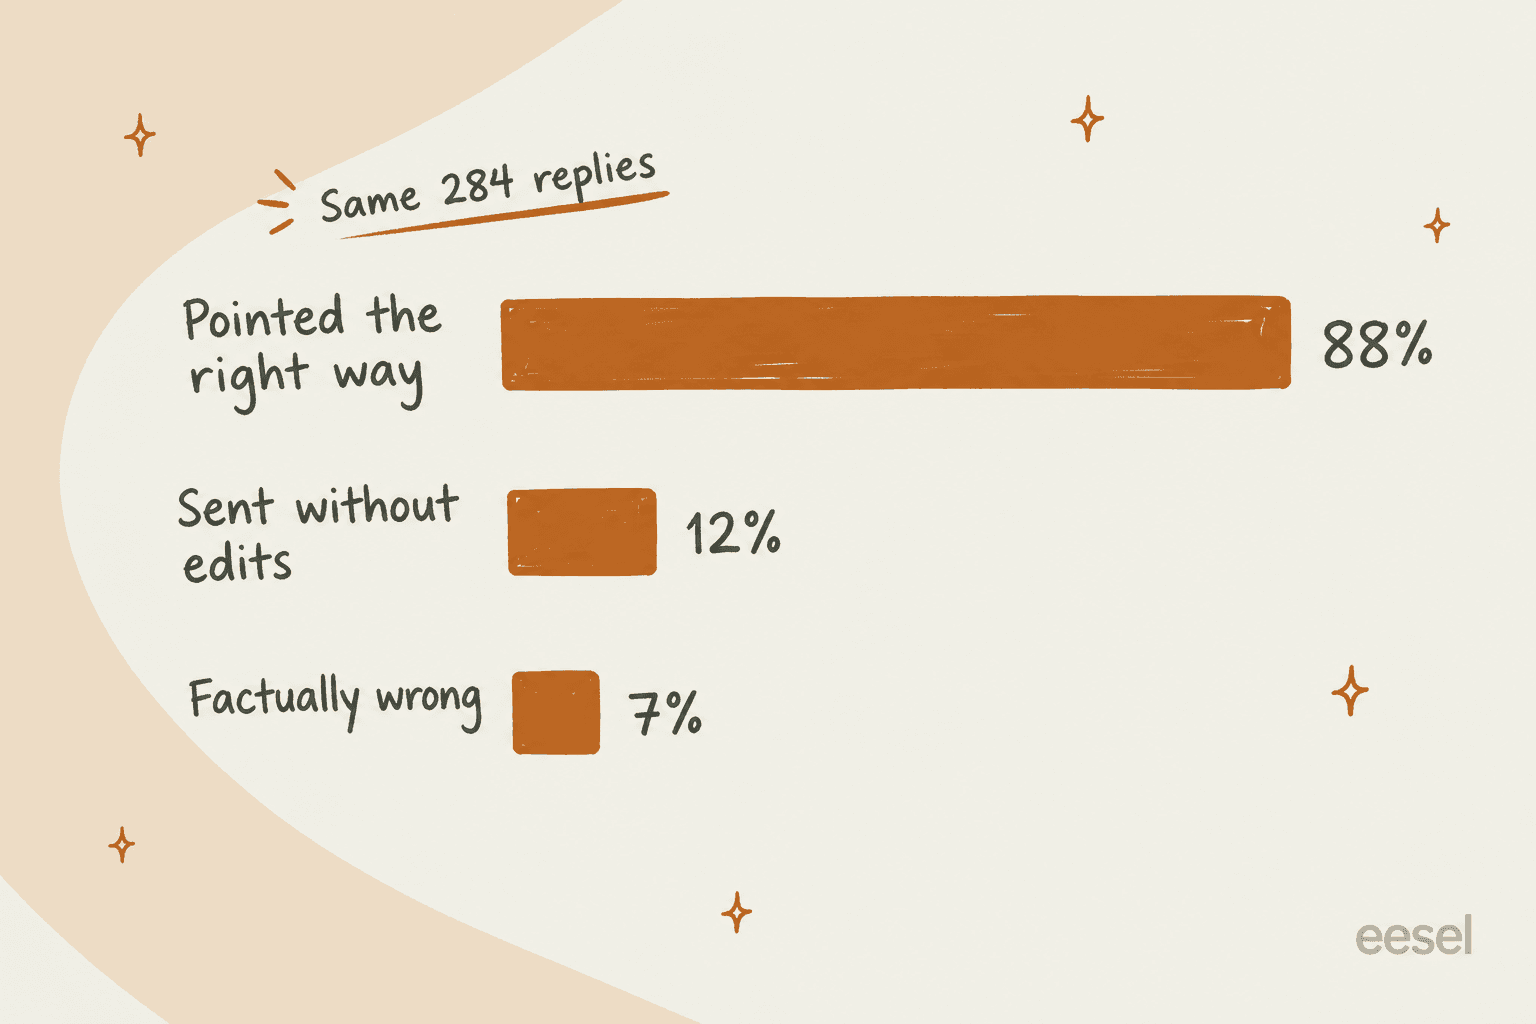
Mêmes réponses, trois verdicts : 88 % allaient dans la bonne direction, seulement 12 % ont été envoyées sans modification et 7 % étaient factuellement fausses. Aucun de ces chiffres n'est faux. Ils répondent simplement à des questions différentes. Un évaluateur qui note « est-ce que j'enverrais ça tel quel ? » et un autre qui note « la réponse est-elle correcte ? » noteront la même file très différemment, et tous deux penseront être équitables. Quand j'ai cherché pourquoi les agents réécrivaient les brouillons, environ 65 % des réécritures portaient sur la longueur et le ton, environ 20 % nécessitaient des données de commande que le brouillon ne pouvait pas voir et environ 5 % venaient du fait que le brouillon était factuellement faux. La longueur et le ton sont précisément les catégories sur lesquelles les évaluateurs humains se divisent aussi. (J'ai détaillé ce type d'analyse des réécritures dans mon guide sur l'analyse des erreurs.)
C'est pourquoi la calibration commence par le niveau d'exigence, pas par la note. Si votre grille ne dit pas à quoi ressemble un 3 par rapport à un 4 pour le ton, aucune discussion ne mettra les évaluateurs d'accord durablement.
Comment mener une session de calibration QA
Voici la session que je mènerais, en cinq étapes. Elle prend environ une heure par mois, plus 10 à 15 minutes de notation par évaluateur en amont.
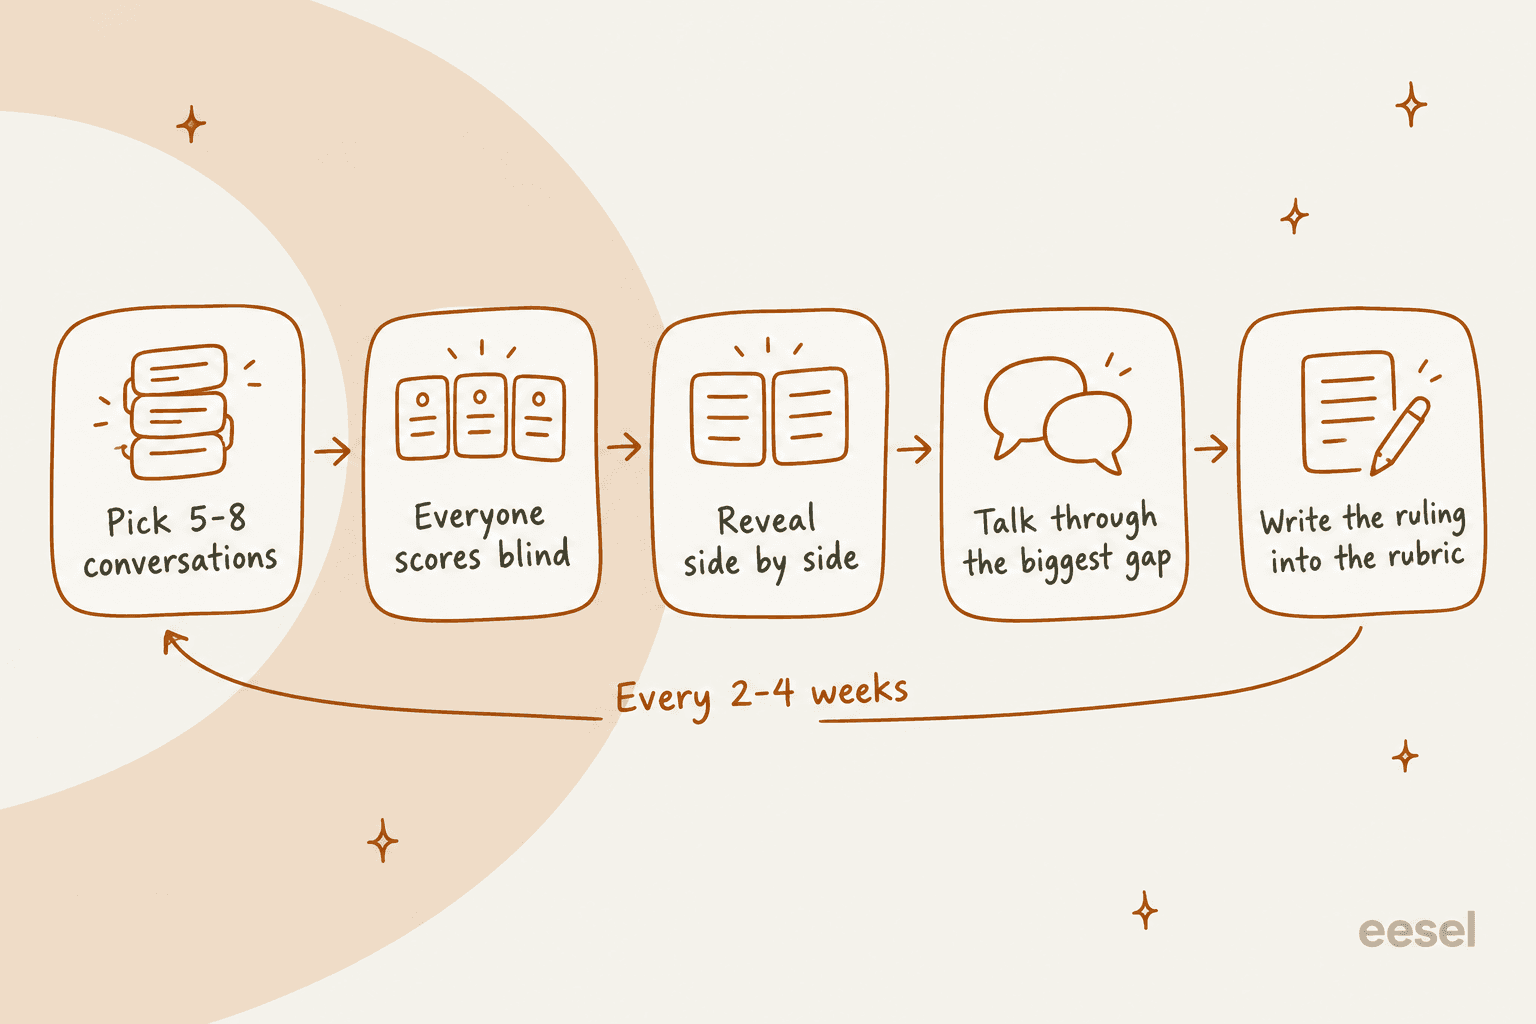
1. Choisissez 5 à 8 conversations qui vont provoquer un débat
Le guide de calibration de Zendesk suggère de commencer par environ cinq conversations. J'irais jusqu'à huit une fois l'équipe habituée. Au-delà, la discussion est bâclée.
La sélection compte plus que le nombre. Les tickets faciles n'apprennent rien, car tout le monde les note pareil. Le conseil de calibration de MaestroQA est de prendre des tickets avec de faibles notes QA, des sujets délicats, ou un processus ou produit récemment modifié. evaluagent ajoute un point juste dans son explication de la calibration : gardez un ensemble équilibré, pas seulement de mauvaises interactions, sinon la session tourne à la recherche de coupables.
Mon mélange : une conversation qui touche une politique qui vient de changer, une où le client était contrarié dès le premier message, un long fil avec de nombreuses réponses, une qui s'est bien passée mais qui semblait « étrange », et une qu'un agent a contestée récemment. Si vous assurez le support dans plusieurs langues, ajoutez aussi une conversation non anglophone ; mon guide sur le QA du support multilingue explique comment calibrer entre équipes de langues différentes.
2. Tout le monde note à l'aveugle
C'est l'étape que les équipes sautent, et c'est celle qui fait fonctionner le reste. Si les évaluateurs peuvent voir les notes des autres, ou notent ensemble dans la salle, la première personne sûre d'elle fixe le chiffre et tout le monde s'en rapproche. Le webinaire sur la calibration d'evaluagent décrit la version papier de ce problème : les gens "can change their scores on their paper, and they can be swayed to another person's point of view before they get an opportunity to speak."
Dans Zendesk QA, à l'aveugle ou ouvert est un réglage de l'espace de travail choisi par rôle. Les évaluateurs peuvent être réglés pour ne voir que leurs propres évaluations, ou pour ne voir celles de leurs pairs qu'après avoir soumis les leurs. Les responsables et managers ont la même option « après soumission », ou « toujours ».
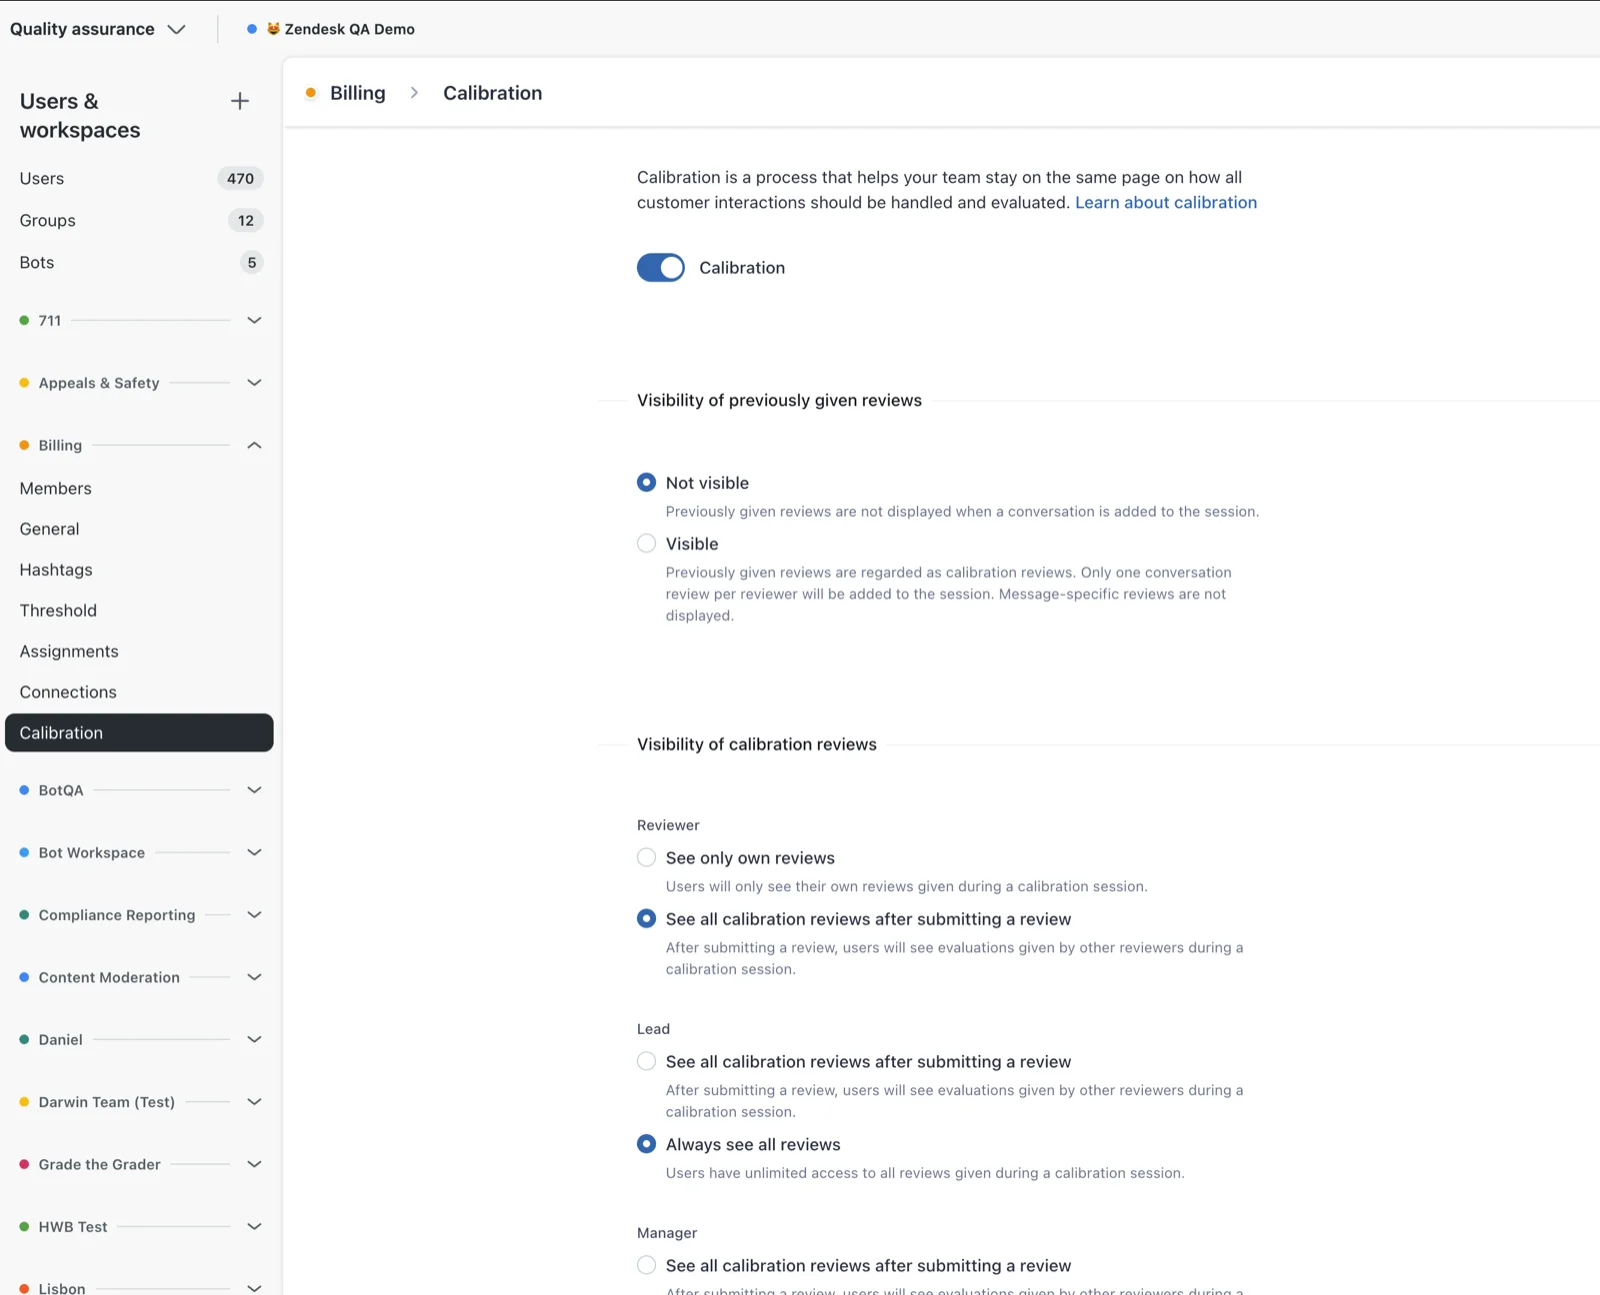
Un piège pratique : Zendesk QA n'envoie aucune notification pour la calibration. Selon la documentation de Zendesk, "it's up to the workspace manager or lead to inform reviewers about the calibration session and its due date." Mettez l'échéance dans le canal de l'équipe, sinon la moitié des évaluateurs noteront 10 minutes avant la réunion.
3. Révélez les notes côte à côte, face à une référence
Une fois que tout le monde a noté, mettez les notes dans une grille : les évaluateurs sur le côté, les catégories de la grille en haut. Vous cherchez deux choses, sur lesquelles je reviens dans la section suivante : les catégories très dispersées et les évaluateurs qui s'écartent sur tout.
Il vous faut aussi une référence, c'est-à-dire une note « juste » convenue avec laquelle comparer. Zendesk QA permet à un manager de marquer une évaluation comme Baseline review, ce qui, selon Zendesk, "makes it easier to compare scores against it." Le tableau de bord de calibration affiche alors la note de chaque évaluateur à côté de la note de référence.
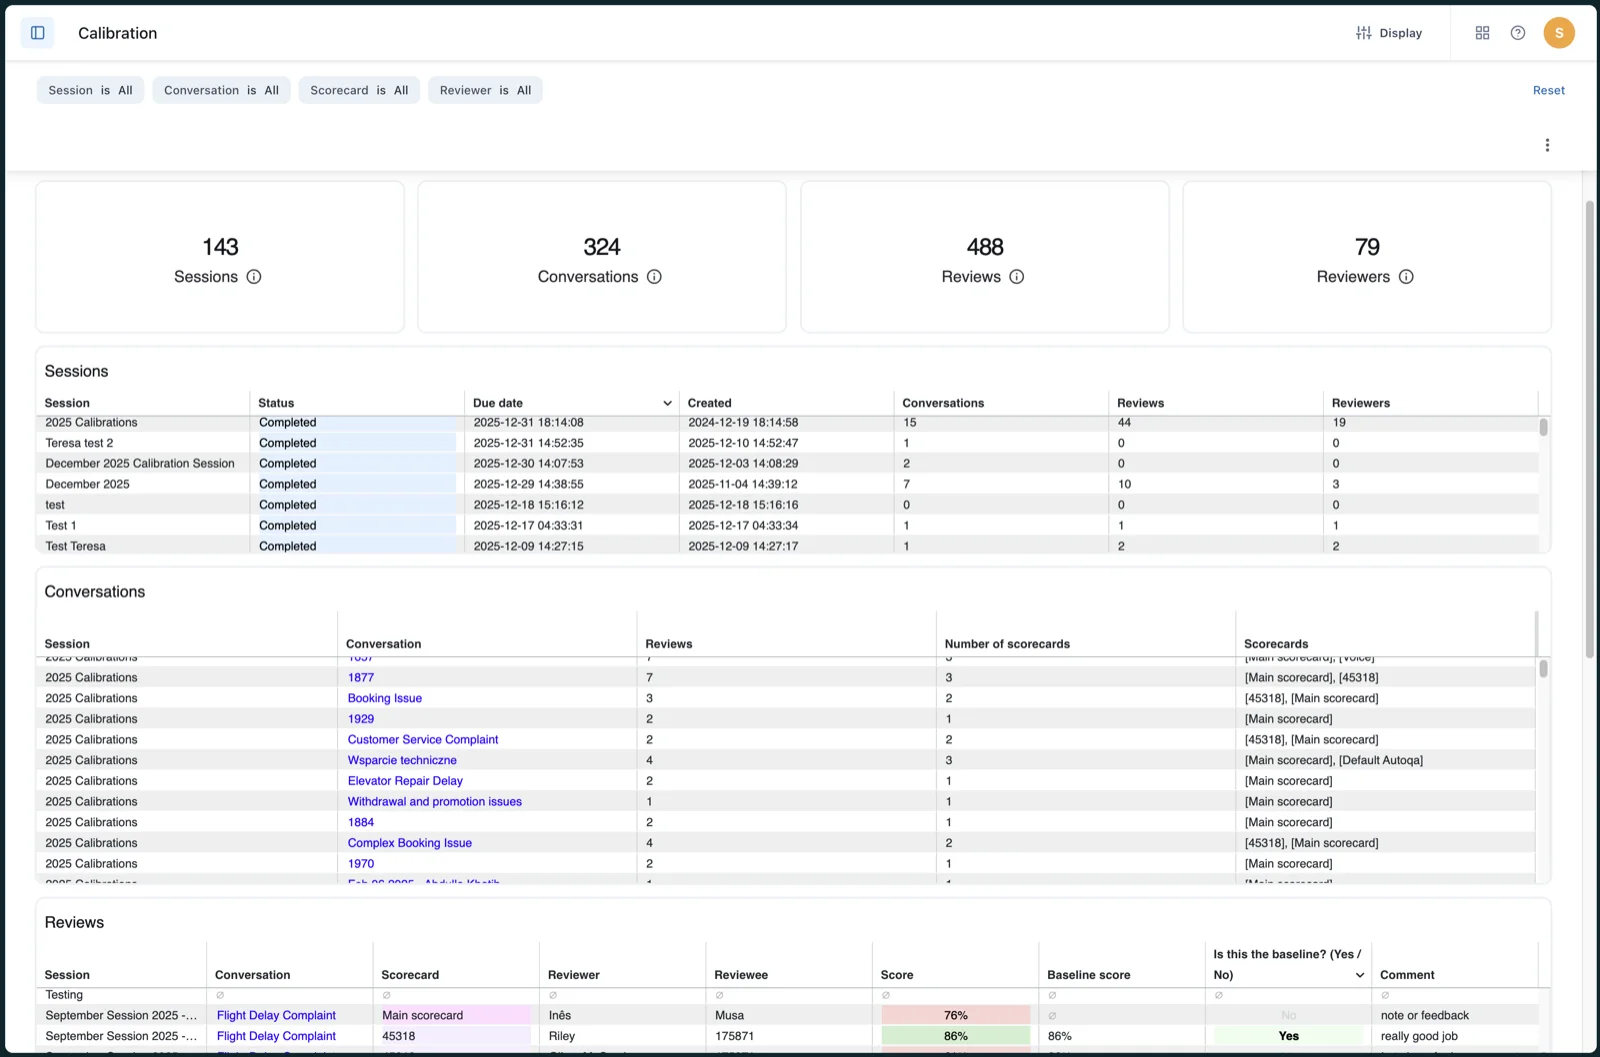
MaestroQA fait la même chose avec un calibrateur final désigné. Son guide d'alignement d'équipe appelle cette personne "your source of truth to measure alignment against", et chaque évaluateur reçoit un score d'alignement par rapport à elle.
4. Discutez du plus gros écart, pas de tous
Avec 5 conversations et 6 catégories, vous avez 30 occasions de diverger. Vous n'en viendrez pas à bout en une heure, et il ne faut pas essayer. Triez par dispersion et consacrez la réunion aux deux ou trois écarts les plus larges.
Le but est une décision, pas un consensus. Un responsable de Stitch Fix cité sur la page des calibrations de MaestroQA l'a bien formulé : "We've normalized the expectation that we're driving toward commitment, not consensus." evaluagent dit la même chose sous un autre angle : "It's not a democracy, if you like, where majority rules." Si trois évaluateurs disent 4 et un dit 2, la réponse n'est pas automatiquement 4. La personne qui connaît le mieux la politique tranche, et tout le monde s'engage sur cette décision.
5. Inscrivez la décision dans la grille
C'est là que la plupart des sessions de calibration échouent discrètement. L'équipe est d'accord, tout le monde acquiesce, et trois semaines plus tard le même désaccord réapparaît parce que rien n'a été écrit.
Chaque écart résolu doit devenir une ligne dans les consignes de votre grille, avec la conversation comme exemple concret. « Ton : une réponse qui s'excuse deux fois pour le même problème obtient 3, pas 4. Exemple : ticket #48213. » C'est l'élément qui raccourcit la session suivante. Il alimente aussi vos procédures de support et les exemples que vous utilisez pour l'intégration des nouveaux agents, puisqu'une recrue a besoin des mêmes décisions que vos évaluateurs viennent de convenir. De bonnes décisions se lisent comme de bons exemples de feedback QA : précises, rattachées à une ligne de la conversation et courtes.
Un responsable QA sur r/callcentres a décrit la version stricte de cela :
"Calibrations by quality need to be strictly enforced and maintained. My last team I ran was quality and every month we'd pick a random call, all score separately, then get together and decide the correct score for each quality point. Whatever we all decided on, we had to be within 3% of that score (and certain elements had to be 100% on point)."
Problème de grille ou problème d'évaluateur ?
C'est la partie de la calibration que la plupart des guides sautent, et c'est la plus utile. Quand les notes ne concordent pas, la forme du désaccord vous dit quoi corriger.
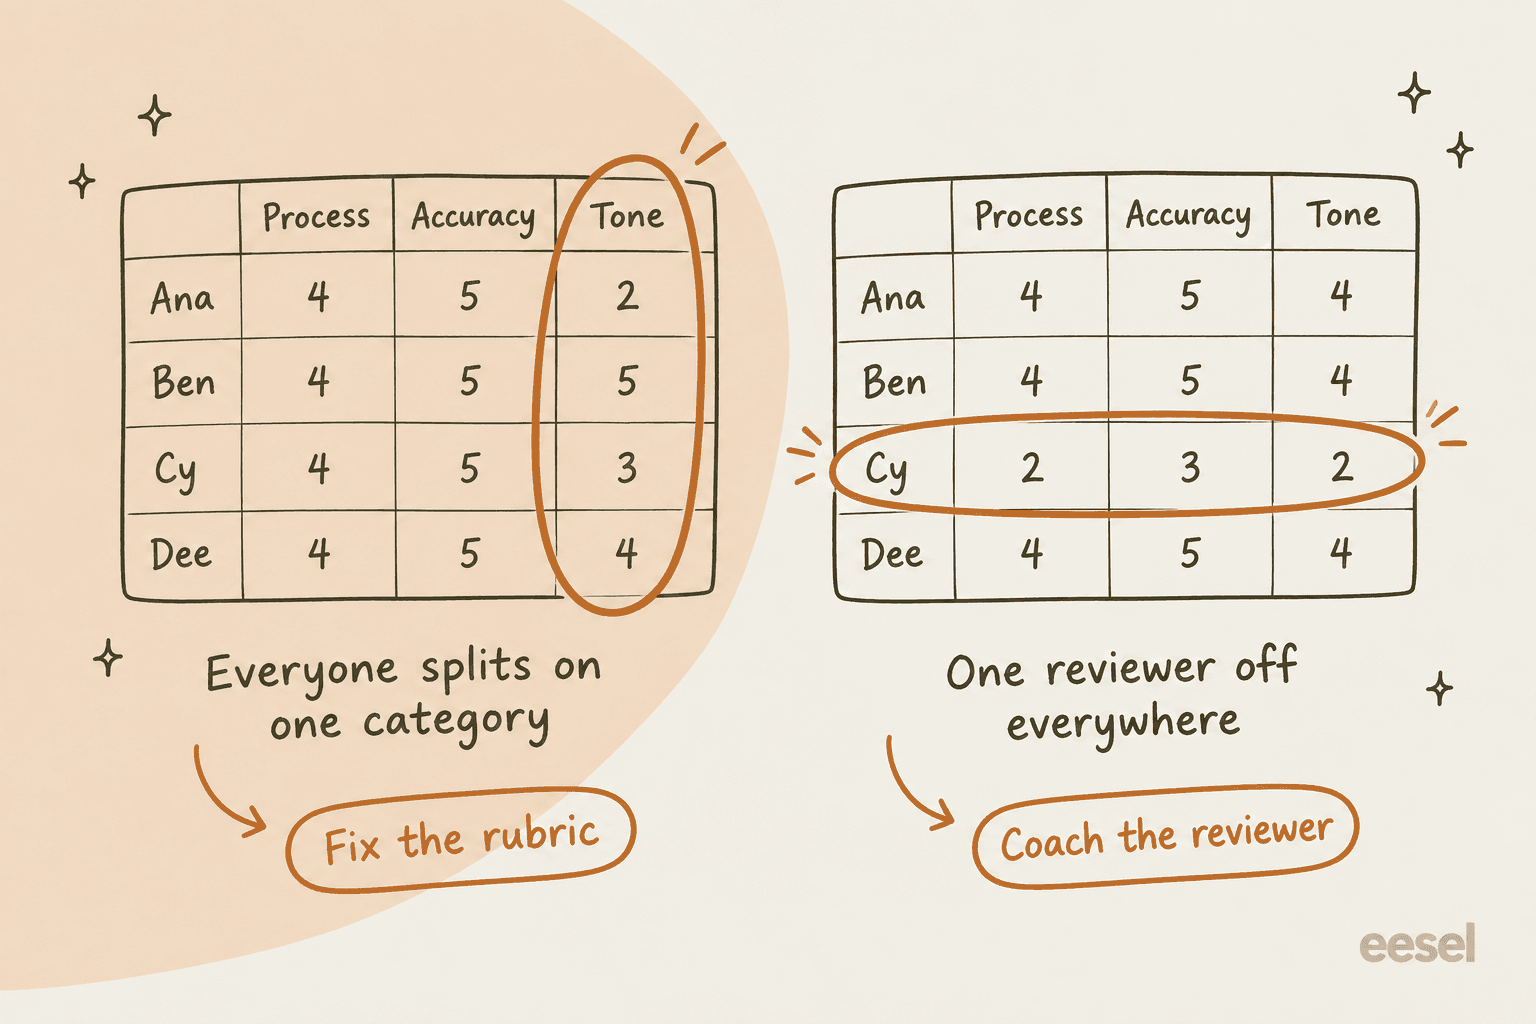
Tout le monde se divise sur une catégorie. Si le processus et l'exactitude concordent mais que le ton va de 2 à 5 entre quatre évaluateurs, personne n'a « tort ». Le critère est ouvert à l'interprétation, donc corrigez la grille. Réécrivez les consignes sur le ton avec des exemples concrets (mon guide du ton en service client propose un modèle) et renotez la même conversation à la session suivante pour vérifier que l'écart s'est refermé.
Un évaluateur s'écarte sur tout. Si une personne note deux points plus bas que tous les autres sur chaque catégorie, la grille est correcte. Cet évaluateur la lit différemment, donc coachez l'évaluateur. Asseyez-vous avec lui, comme vous le feriez pour coacher un agent, parcourez une conversation catégorie par catégorie et faites-lui en noter une autre seul.
Toute l'équipe s'écarte de la référence dans le même sens. Tout le monde met 4 et le responsable avait mis 2. Cela signifie en général que le responsable sait quelque chose que l'équipe ignore, comme un changement de politique qui n'est jamais arrivé dans la base de connaissances. C'est un problème de communication, pas de notation.
Essayez avec vos propres chiffres. Saisissez les notes de chaque évaluateur pour une conversation et le vérificateur vous dit à quel cas vous avez affaire.
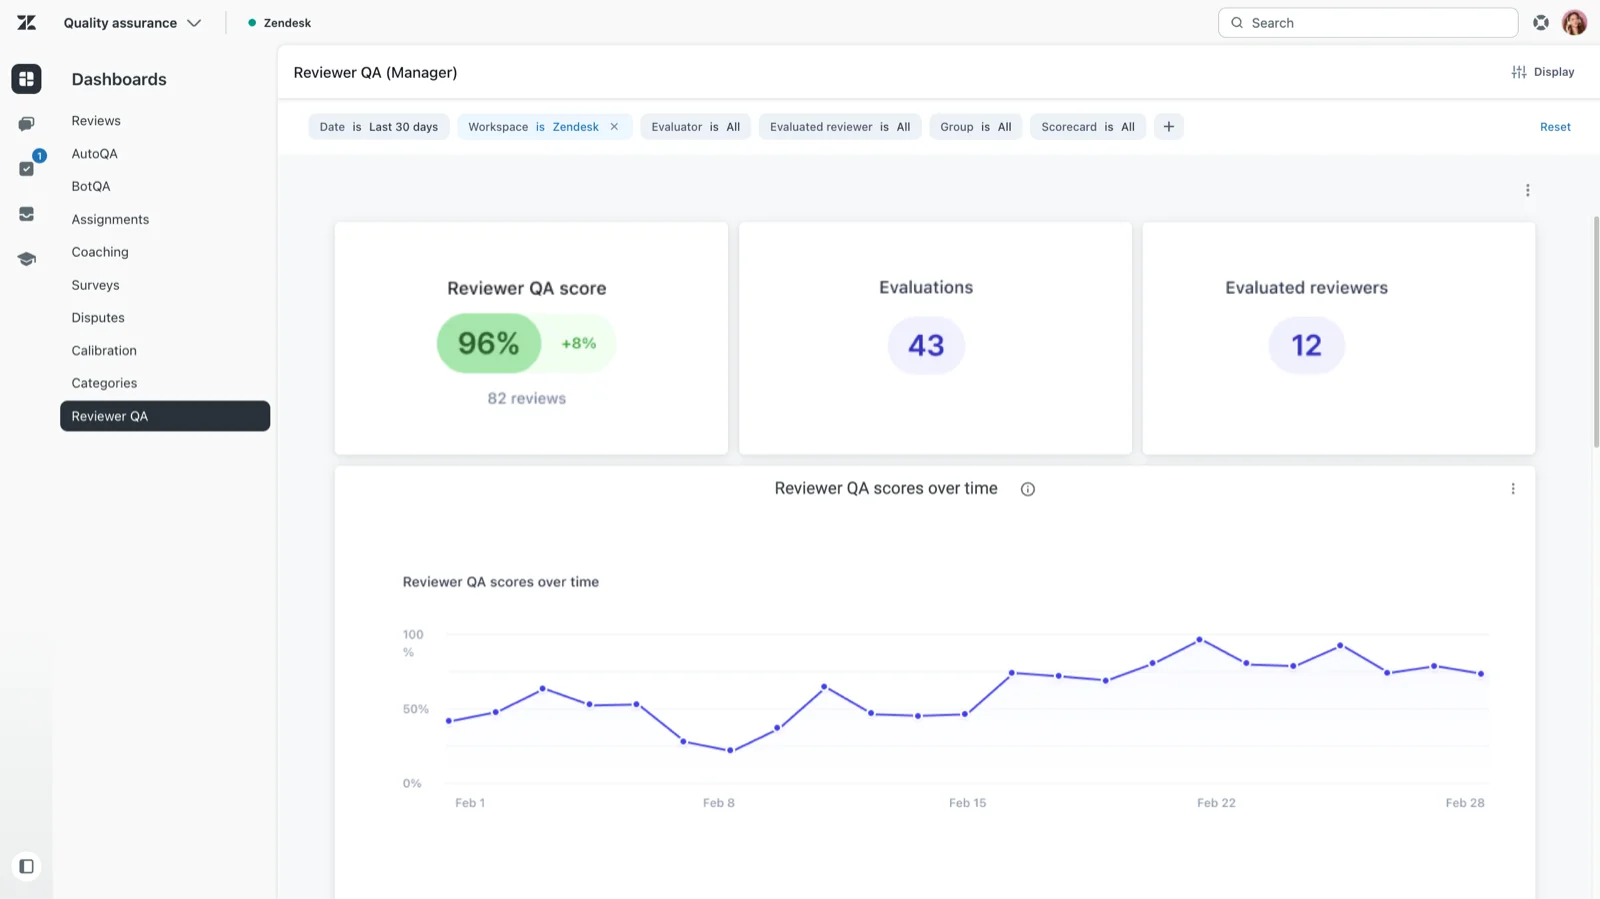
Zendesk QA suit aussi le côté évaluateur dans le temps avec un tableau de bord distinct, Reviewer QA. Il repose sur des attributions aléatoires où quelqu'un évalue les propres évaluations des évaluateurs, et la documentation du tableau de bord de Zendesk indique qu'il sert à "track reviewer accuracy, evaluation history, and coaching trends." Les évaluateurs évalués voient leurs propres notes mais ne peuvent pas voir qui les a évalués.
Qu'est-ce qui compte comme « calibré » ?
Aucun éditeur de QA que j'ai consulté ne publie de note de réussite ferme. Voici ce que ceux qui font ce métier utilisent à la place.
| Source | Objectif de calibration | Mesuré par rapport à |
|---|---|---|
| Guide de calibration de Zendesk | Écart "usually falls around 5 percent" | Référence fixée pendant la session |
| u/mattemer sur r/callcentres | À moins de 3 %, certains éléments à 100 % | Note convenue par le groupe |
| MaestroQA | Score d'alignement par évaluateur, pas de seuil fixe | Note du calibrateur final |
| Scorebuddy | % de réponses concordantes, plus Avg Variation | La note d'origine renotée |
| Zendesk QA AutoQA | Plus de 75 % de précision, c'est une « forte concordance » | Notes des évaluateurs humains |
Mon avis : visez chaque évaluateur à environ 5 points de la référence sur la note totale, et aucune catégorie où les évaluateurs sont à 2 points d'écart ou plus sur une échelle de 5. Ajoutez ensuite la règle de la citation de r/callcentres ci-dessus : certains éléments doivent être à 100 %. Une vérification d'identité manquée ou un montant de remboursement erroné n'est pas une affaire de goût. Marquez-les comme éléments critiques ou en échec automatique dans la grille (mon guide des critères de grille montre comment faire dans Zendesk QA) pour qu'ils ne soient jamais « calibrés » en note partielle.
Surveillez aussi le total. Deux évaluateurs peuvent arriver au même 80 % global tout en divergeant sur trois catégories en dessous, l'un haut là où l'autre est bas. Comparez toujours par catégorie, pas seulement la note globale.
À quelle fréquence faut-il calibrer ?
La réponse honnête est « plus souvent que vous ne le faites aujourd'hui ». Voici ce que suggèrent éditeurs et praticiens :
- Nouveau programme QA ou nouvelle grille : le guide de MaestroQA dit voir des équipes calibrer "as frequently as once a week", puis passer au mensuel quand l'alignement est élevé, et remonter d'un cran quand une nouvelle grille est lancée.
- Rythme de croisière : le guide de Zendesk dit que des sessions mensuelles conviennent à la plupart des équipes, et "the more reviewers you have, the more often you should calibrate."
- Grandes équipes QA : un ancien responsable QA sur r/callcentres animait "a weekly calibration call so that everyone was on the same page" en plus de 5 audits par conseiller et par mois.
Un analyste QA seul sur r/talesfromcallcenters a décrit l'envers du décor, quand c'est l'évaluateur qui est noté :
"I was the lone QA agent for a call center of 55-70 people. We had a calibration session each week which involved the call center manager, the management staff, and myself. They chose ten calls that I had evaluated to listen to and score... I was held to a 95% accuracy rating which compared to the average of their call scores."
J'ajouterais un déclencheur qui ne figure dans aucun calendrier : calibrez après tout ce qui change le sens de « correct ». Un changement de tarif, une nouvelle politique de retours, un nouveau circuit d'escalade. C'est là que les évaluateurs dérivent le plus vite, car certains connaissent le changement et d'autres non. Une session vaut aussi la peine à l'arrivée d'un nouvel évaluateur, de la même façon que vous raccourciriez la montée en compétence d'un agent avec des exemples concrets, avant que ses notes ne comptent dans les KPI de support de quiconque.
Les fonctions de calibration QA comparées
La plupart des outils de QA dédiés ont une forme de fonction de calibration. Ils diffèrent sur le fait que la notation soit à l'aveugle, sur ce par rapport à quoi la « bonne réponse » est mesurée, et sur ce que vous voyez ensuite.
| Outil | Fonction | Notation à l'aveugle | Mesuré par rapport à | Visible des agents ? |
|---|---|---|---|---|
| Zendesk QA | Sessions de calibration, Reviewer QA | Configurable par rôle | Évaluation de référence fixée par un manager | Non |
| MaestroQA (désormais Rippit) | Team Calibration, Grade-the-Grader | Oui, les évaluateurs ne voient que leur propre note et la note finale | Calibrateur final, score d'alignement | Non documenté |
| Scorebuddy | Listes de calibration | Non documenté | Note d'origine renotée | Option activable par liste |
| evaluagent | Sessions de calibration, Check-the-Checker | Oui, "blind evaluate" | "Calibrated outcome" convenu | Non documenté |
| Playvox (NICE) | Calibration | Non documenté | "Expert opinions" | Non documenté |
| Level AI | Calibration | Non documenté | Référence de l'auditeur | Non documenté |
Quelques détails à connaître avant de choisir :
Zendesk QA nécessite le module complémentaire QA ou Workforce Engagement Management. Chaque offre Suite indique que Quality Assurance "Requires QA add-on", et le Workforce Engagement Bundle est affiché à 50 $ par agent et par mois, facturé annuellement. La calibration n'est pas réservée à une offre supérieure en plus de cela. Une limite à connaître : le tableau de bord de calibration liste les conversations et leurs évaluations, et un commentaire client sur l'article de configuration note que les données "can only be downloaded conversation by conversation." Si vous voulez la tendance d'un évaluateur sur plusieurs sessions, prévoyez de la reporter dans un tableur, ou appuyez-vous sur le tableau de bord Reviewer QA.
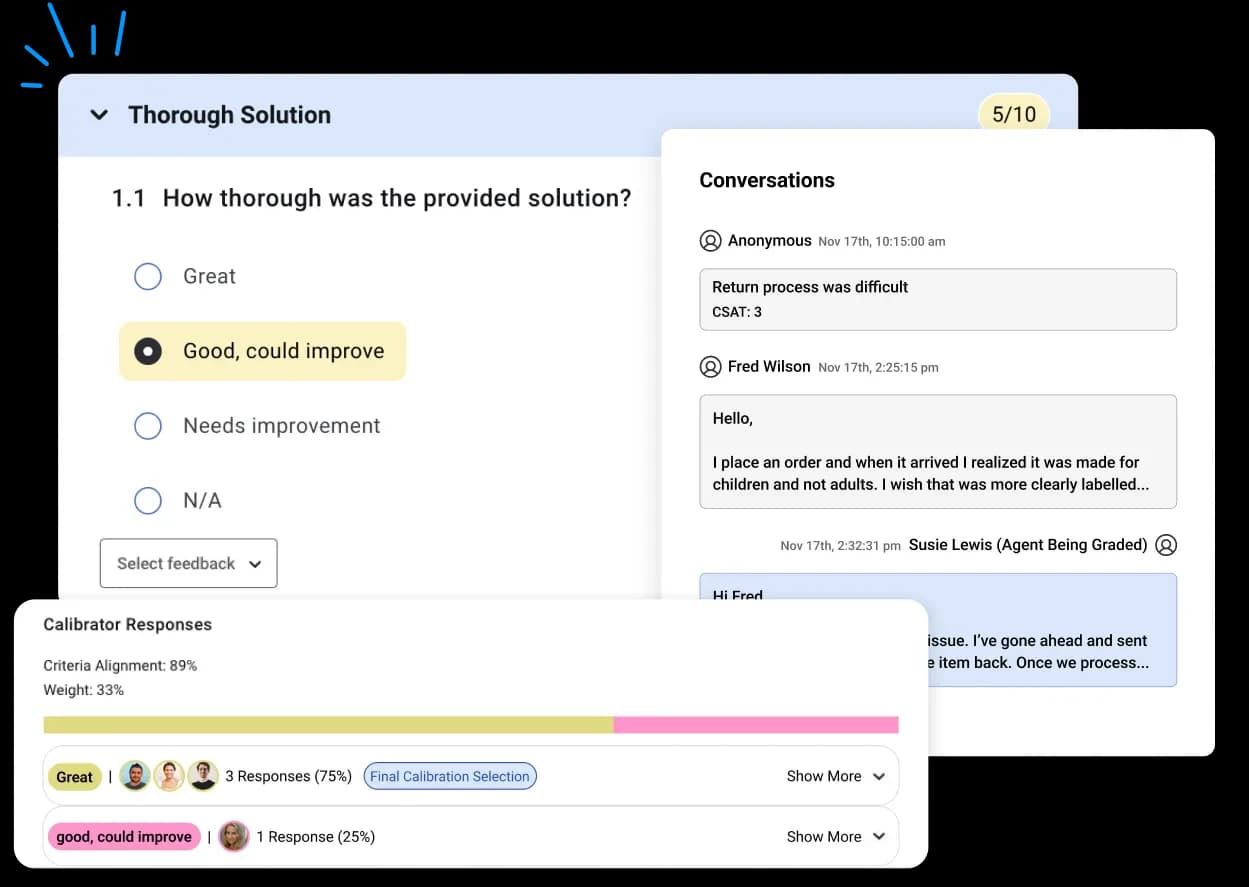
MaestroQA, rebaptisé Rippit, sépare deux tâches : la calibration d'équipe en direct et Grade-the-Grader, où un évaluateur de référence renote à l'aveugle des tickets déjà notés par quelqu'un d'autre. Sa vue de calibration montre comment chaque calibrateur a répondu à chaque question, avec un pourcentage de "Criteria Alignment".
Scorebuddy construit la calibration à partir de résultats déjà notés : vous les ajoutez à une liste de calibration et l'attribuez à des utilisateurs, y compris externes, ce qui est pratique si vous externalisez une partie de votre support à un prestataire BPO. Son glossaire définit Avg Variation comme "the average of all differences between a set of Calibration's numerical scores, and the numerical scores of the original Scores." Le module de calibration fait partie de son offre d'entrée Foundation, même si les prix sont "Request a price."
Si vous faites votre QA dans votre helpdesk, vérifiez ce qu'il couvre réellement. Je tiens une liste plus longue d'outils de QA par IA si vous comparez. Gorgias propose Auto QA, qui note automatiquement les conversations, mais je n'ai pas trouvé de workflow de calibration pour évaluateurs humains dans sa documentation. Idem pour Freshdesk et Front dans la documentation que j'ai consultée. Si votre helpdesk n'en a pas, un tableur partagé avec la grille de l'étape 3 fait très bien l'affaire pour une équipe de trois à cinq évaluateurs.
Calibrer les évaluateurs IA et les agents IA
De plus en plus d'équipes laissent l'IA noter 100 % des conversations, avec des humains qui relisent un échantillon. Cela ne supprime pas la calibration. Cela ajoute un évaluateur de plus à calibrer, et c'est celui qui examine le plus de tickets.
Zendesk QA le mesure directement. Son tableau de bord AutoQA comporte une Accuracy score qui "measures the consistency and level of agreement between ratings generated by AutoQA and those provided by human reviewers", un accord supérieur à 75 % comptant comme élevé. Il suit aussi les Modified AutoQA conversations, où un humain a modifié la note de l'IA dans au moins une catégorie. Cette liste est votre ordre du jour de calibration pour l'IA, et c'est le moyen le plus rapide de faire du QA de support avec l'IA sans lui faire aveuglément confiance : si les humains corrigent sans cesse la même catégorie, l'évaluateur IA et votre grille ne sont pas d'accord, et l'un des deux doit être corrigé. Les notes AutoQA restent aussi hors de l'IQS de l'agent, donc l'IA ne peut pas déplacer discrètement la note d'un agent toute seule.
Les agents le ressentent quand personne ne le fait :
"My company uses AI to score calls, too. You can have a great call, but if it doesn't pick up on certain keywords you get a lousy score for it"
Traitez l'évaluateur IA comme un nouvel évaluateur qui rejoint l'équipe. Mettez quelques conversations notées par AutoQA dans votre session de calibration, notez-les à l'aveugle à côté de lui et regardez où il se situe. Mon guide sur le QA de support par IA couvre le reste de cette configuration, et l'IA peut-elle faire du QA de support est honnête sur ses limites actuelles.
La même logique s'applique quand c'est l'agent qui est une IA. Si un agent IA répond aux tickets, vos évaluateurs doivent s'accorder sur la façon de noter ses réponses avant de commencer, sinon vous aurez le problème 88 % contre 12 % vu plus haut, le même écart que l'on voit quand les équipes débattent du taux de résolution de l'IA : un évaluateur juge une réponse réussie parce que la réponse est juste, un autre la juge ratée parce qu'elle fait trois paragraphes de trop. Accordez-vous d'abord sur le niveau d'exigence, puis notez. Une voix de marque écrite pour l'IA rend la catégorie du ton beaucoup plus facile à calibrer. Mon article sur les agents IA dans Zendesk QA explique comment noter des conversations de bots.
Erreurs courantes de calibration QA
- Noter ensemble dans la salle. Vous perdez la seule chose que vous veniez mesurer, le désaccord d'origine. Notez toujours d'abord à l'aveugle.
- Ne calibrer que des tickets faciles. Si chaque session se termine par un accord, vous choisissez les mauvaises conversations.
- Prendre la moyenne pour la réponse. Trois personnes qui disent 4 ne rendent pas 4 juste. Quelqu'un porte la décision.
- Aucun suivi écrit. Si la décision n'arrive pas dans les consignes de la grille, vous aurez la même dispute le mois prochain.
- Ne comparer que les notes totales. Deux évaluateurs peuvent donner tous deux 80 % tout en divergeant sur la moitié des catégories.
- Ne jamais calibrer l'évaluateur IA. Il examine plus de tickets que n'importe qui d'autre dans l'équipe. Il lui faut une place dans la session.
- Faire sans les contestations des agents. Les évaluations contestées sont du matériel de calibration gratuit. Le tableau de bord des contestations de Zendesk QA a même un tableau "Disputed reviewers" qui "shows which reviewers may need additional help with consistency and accuracy." Servez-vous-en pour choisir les conversations, et consultez mon article sur le feedback aux agents dans Zendesk QA pour voir comment les contestations remontent vers les agents.
Essayez eesel pour des réponses d'IA auxquelles votre équipe QA peut se fier
Si vous ajoutez de l'IA à votre file de support, la question de la calibration se pose dès le premier jour : comment vos évaluateurs vont-ils noter ce qu'elle écrit ? Le coéquipier IA de helpdesk d'eesel rejoint votre file Zendesk, Freshdesk, Gorgias ou Help Scout existante et laisse votre équipe régler cela avant sa mise en ligne. Il rejoue de vrais anciens tickets pour que les évaluateurs notent ses réponses par rapport à ce que vos agents ont réellement envoyé, il démarre sous forme de brouillons en notes internes, et chaque exécution affiche les sources et le raisonnement derrière la réponse. Quand un évaluateur le corrige, la correction devient une instruction permanente, de sorte que la même décision s'applique à tous les tickets futurs. L'essai est gratuit avec 100 crédits, et les offres payantes démarrent à 299 $ par mois sur la page de tarifs d'eesel.

Comment mener une session de calibration QA ?