

Qu'est-ce que l'analyse des erreurs du support client ?
L'analyse des erreurs du support client est une revue reproductible des réponses de support fausses ou faibles, où chaque défaillance reçoit une étiquette de cause racine, les étiquettes sont comptées, et la cause la plus fréquente est corrigée à la source. Elle fonctionne de la même façon que la réponse vienne d'un agent, d'une macro ou d'un agent IA.
Le terme vient de l'apprentissage automatique, où c'est l'étape que les gens sautent. Un commentateur de Hacker News l'a dit sans détour il y a plus de dix ans :
"3) Do error analysis/run diagnostics. Go to 1. It is the last step I find inexperienced people usually lacking. You need to examine your errors and find commonalities among them."

C'est toute l'idée. Une mauvaise réponse est une anecdote. Quarante mauvaises réponses triées en groupes forment une liste de tâches.
On la confond facilement avec le QA du support, voici donc comment je les distingue :
| QA du support | Analyse des erreurs | |
|---|---|---|
| Question à laquelle elle répond | Quelle était la qualité de la réponse de cet agent ? | Pourquoi les réponses échouent-elles, et où ? |
| Unité de revue | Un agent, une grille de notation | Une défaillance, une cause racine |
| Échantillon | Tickets aléatoires ou attribués | Tickets qui ont déjà mal tourné (réouvertures, mauvais CSAT, escalades, brouillons rejetés) |
| Résultat | Une note et des conseils de coaching | Une liste classée de causes, chacune avec un responsable |
| Qui corrige | L'agent | Le propriétaire de la cause : le rédacteur de la base de connaissances, le responsable de la politique, l'administrateur de l'IA, l'équipe produit |
Le QA garde toute son importance. L'analyse des erreurs, c'est ce que vous faites des défaillances que le QA trouve, pour qu'elles cessent de se répéter. Je construis des agents IA chez eesel, et l'heure la plus utile de tout déploiement est celle où quelqu'un lit 50 tickets en échec et note pourquoi chacun a échoué.
Pourquoi la plupart des erreurs de support ne sont pas la faute de l'agent
Quand un client reçoit une mauvaise réponse, le réflexe est de chercher qui l'a envoyée. Mais en lisant ce que les agents disent de leurs propres erreurs, un schéma apparaît vite : l'agent travaillait à partir d'informations erronées.
"Yes..and they're always outdated never load.. and if you have questions the supervisor will always refer you back there and give you a bad review saying you must not have checked it."

Les changements de politique sont le cas classique. La mise à jour arrive dans un e-mail ou un canal de discussion, et l'article de la base de connaissances ne change pas :
"Emails get buried so fast man I swear I will find a important update like 3 days later after already giving wrong info to 10 customers. The knowledge base is good when they actually update it but half the time someone forgot to change the article"
Une mauvaise réponse, dix clients. Coacher cet agent ne règle rien, car l'agent suivant lira le même article périmé. Dans un autre fil, un agent a décrit sa demande d'aide sur une question de remise : le superviseur a dit 30 $ par mois, un collègue a dit pas de remise, un autre a dit la moitié, et un coach a mis dix minutes à confirmer que c'était la moitié. Trois personnes, trois réponses. C'est l'absence d'une source de vérité, pas un agent négligent. Mon guide sur la gestion des changements de politique explique comment arrêter cela à la source.
Les agents IA échouent de la même façon, en plus rapide. Quand le bot de support de Cursor a dit aux utilisateurs qu'une déconnexion était une nouvelle politique « un seul appareil », Hacker News y a vu une histoire d'hallucination d'IA. Le cofondateur de Cursor a expliqué la vraie cause racine dans le fil :
"For context, this user's complaint was the result of a race condition that appears on very slow internet connections. The race leads to a bunch of unneeded sessions being created which crowds out the real sessions. We've rolled out a fix."
Le bot n'avait aucun document expliquant le bug, il a donc expliqué le symptôme par quelque chose de plausible. La mauvaise réponse était le dernier maillon d'une chaîne qui avait commencé par un bug produit que personne n'avait documenté. Si vous « réparez l'IA » seulement, vous manquez la partie qui était vraiment cassée. Mon article sur les hallucinations de l'IA dans le support approfondit ce schéma.
Et parfois, l'« erreur » n'en est pas une. Voici la répartition de cet essai e-commerce, où les agents pouvaient envoyer un brouillon d'eesel tel quel ou le réécrire. Seuls 12 % des brouillons sont partis sans modification sur 284 conversations, ce qui paraît terrible jusqu'à ce qu'on regarde pourquoi :
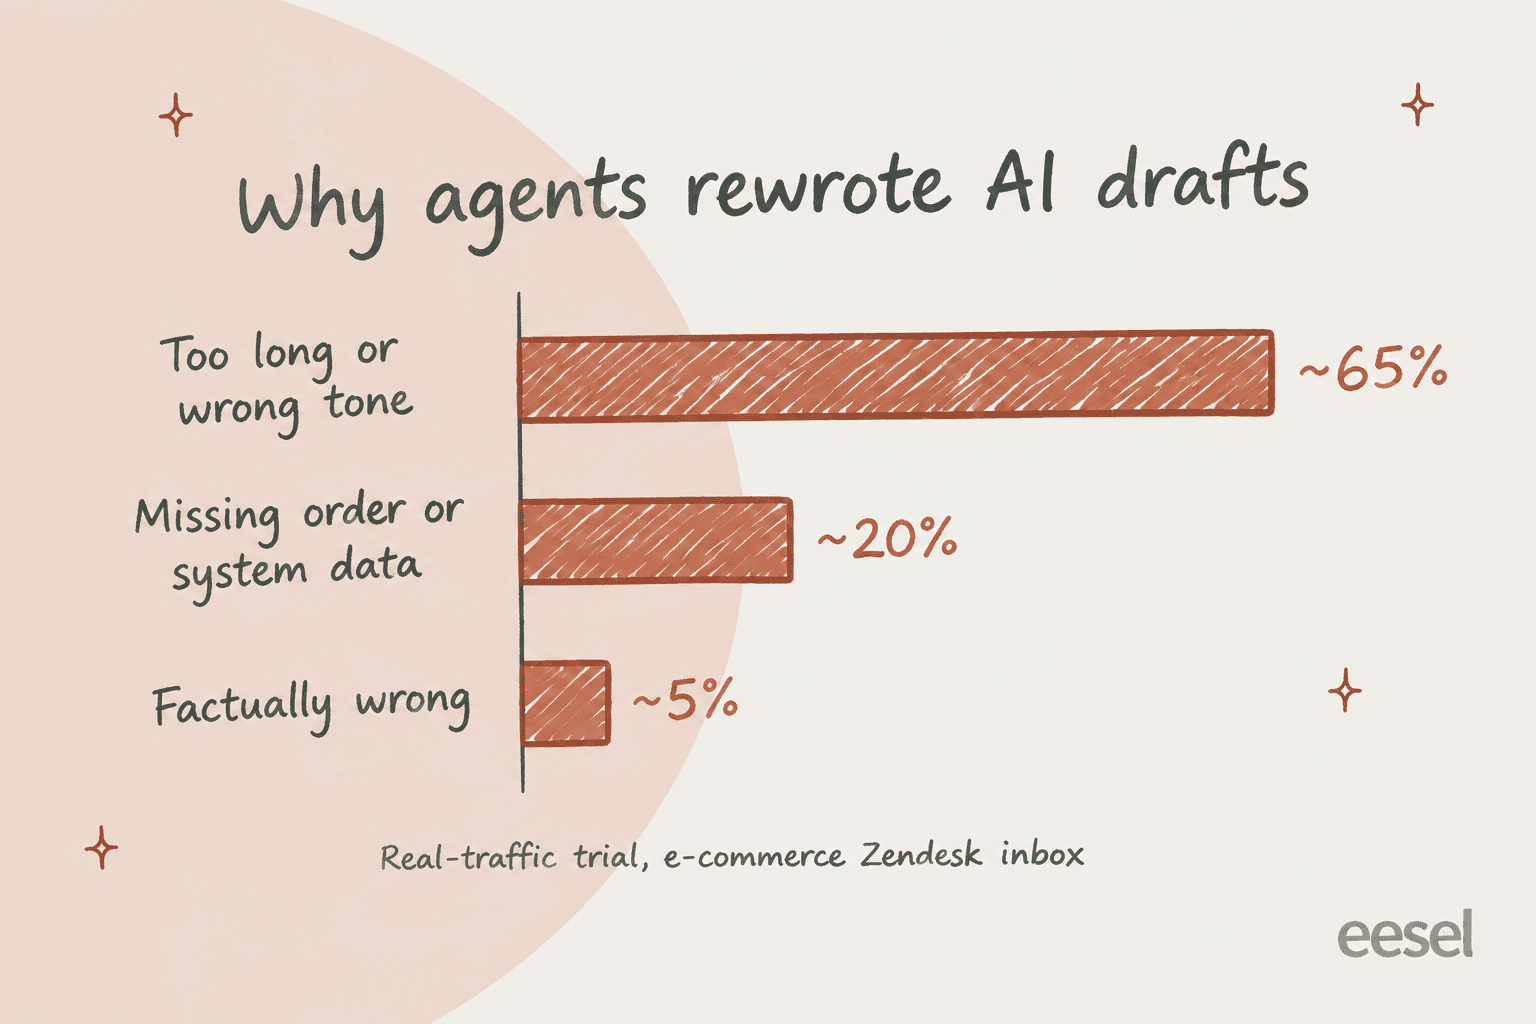
Les agents transformaient en général des brouillons de 8 à 15 phrases en réponses de 1 à 3 phrases. La plupart des réécritures relevaient du style, ce qu'on résout en entraînant l'IA sur les réponses envoyées de l'équipe et avec une voix de marque pour l'IA claire. Environ un cinquième nécessitait des données de systèmes pas encore connectés. Le « problème de précision » était surtout un problème de longueur et d'accès aux données. C'est exactement à cela que sert l'analyse des erreurs : elle vous évite de passer un mois à réécrire des articles d'aide alors que la vraie solution est « restez en trois phrases » et « connectez le système de commandes ».
Les six endroits où une réponse de support déraille
Toute mauvaise réponse a une première défaillance. L'astuce est de s'arrêter à la première, car tout ce qui suit en est une conséquence. Si l'IA a récupéré le mauvais article, peu importe que la réponse ait aussi été trop longue.
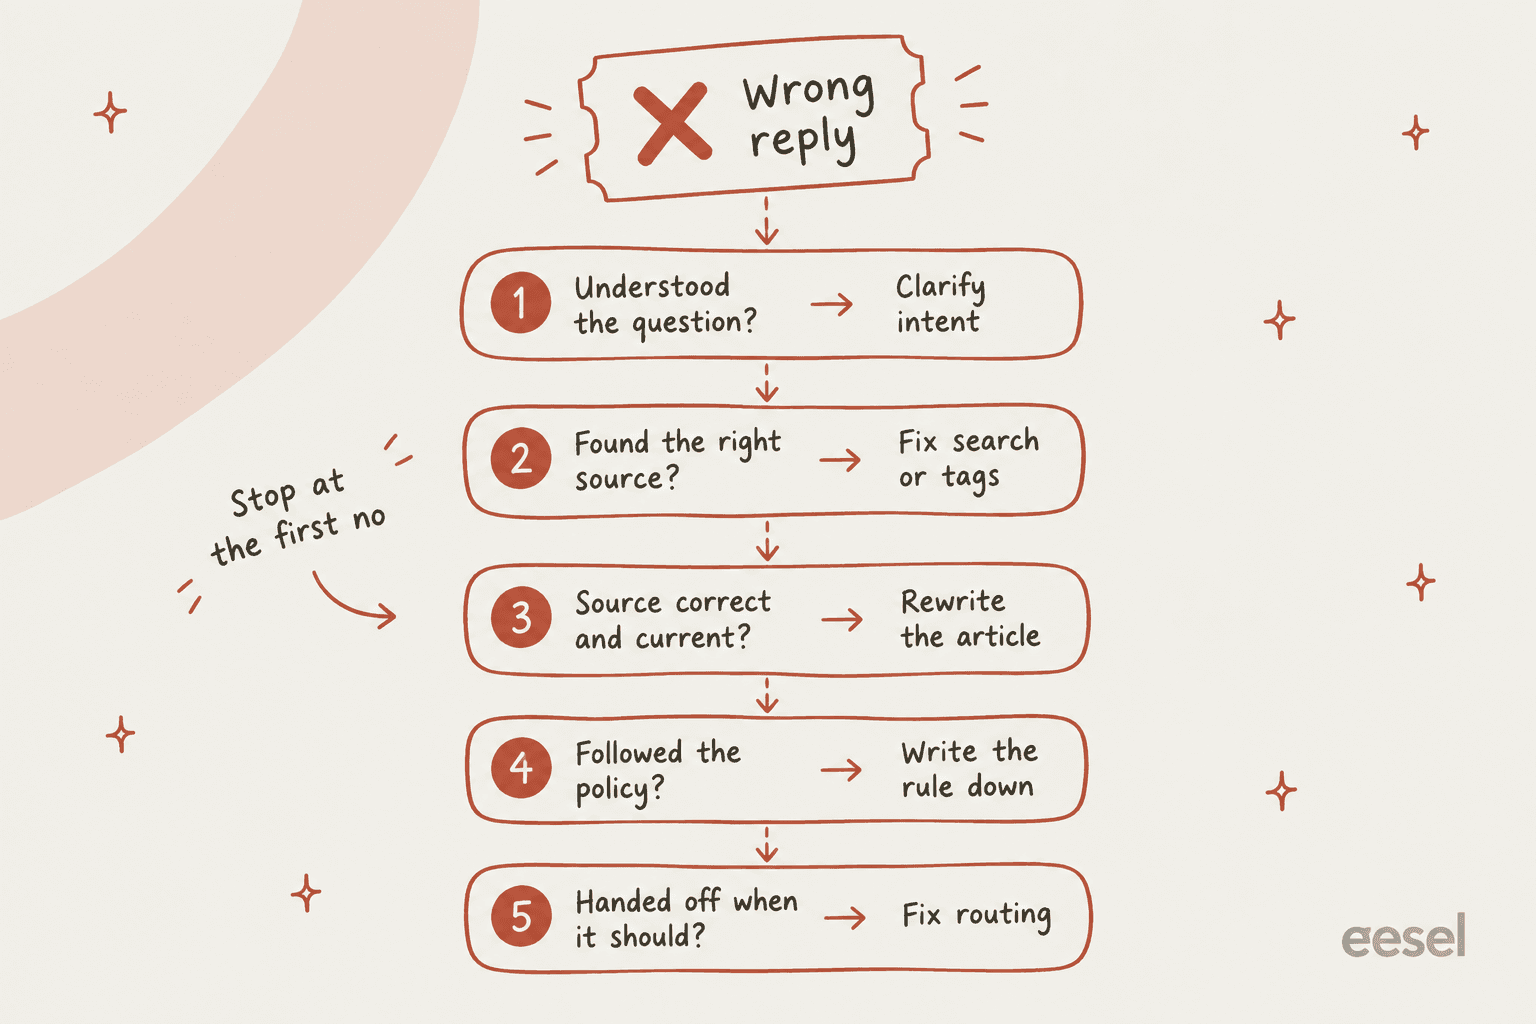
J'utilise six groupes : les cinq points de contrôle ci-dessus plus un sixième pour les réponses correctes qui ne passent pas. Choisissez un groupe pour voir à quoi il ressemble, comment le repérer et qui le corrige.
Remarquez que seul le premier groupe concerne la façon dont la question a été lue. Les groupes deux à cinq portent sur les connaissances, les règles et le routage, des choses qu'un responsable du support peut changer une fois pour tous. C'est pourquoi l'analyse des erreurs rapporte plus vite que le coaching individuel : la correction d'un seul article peut arrêter la même erreur chez tous les agents et l'IA à la fois.
Comment mener une analyse des erreurs du support client en 7 étapes
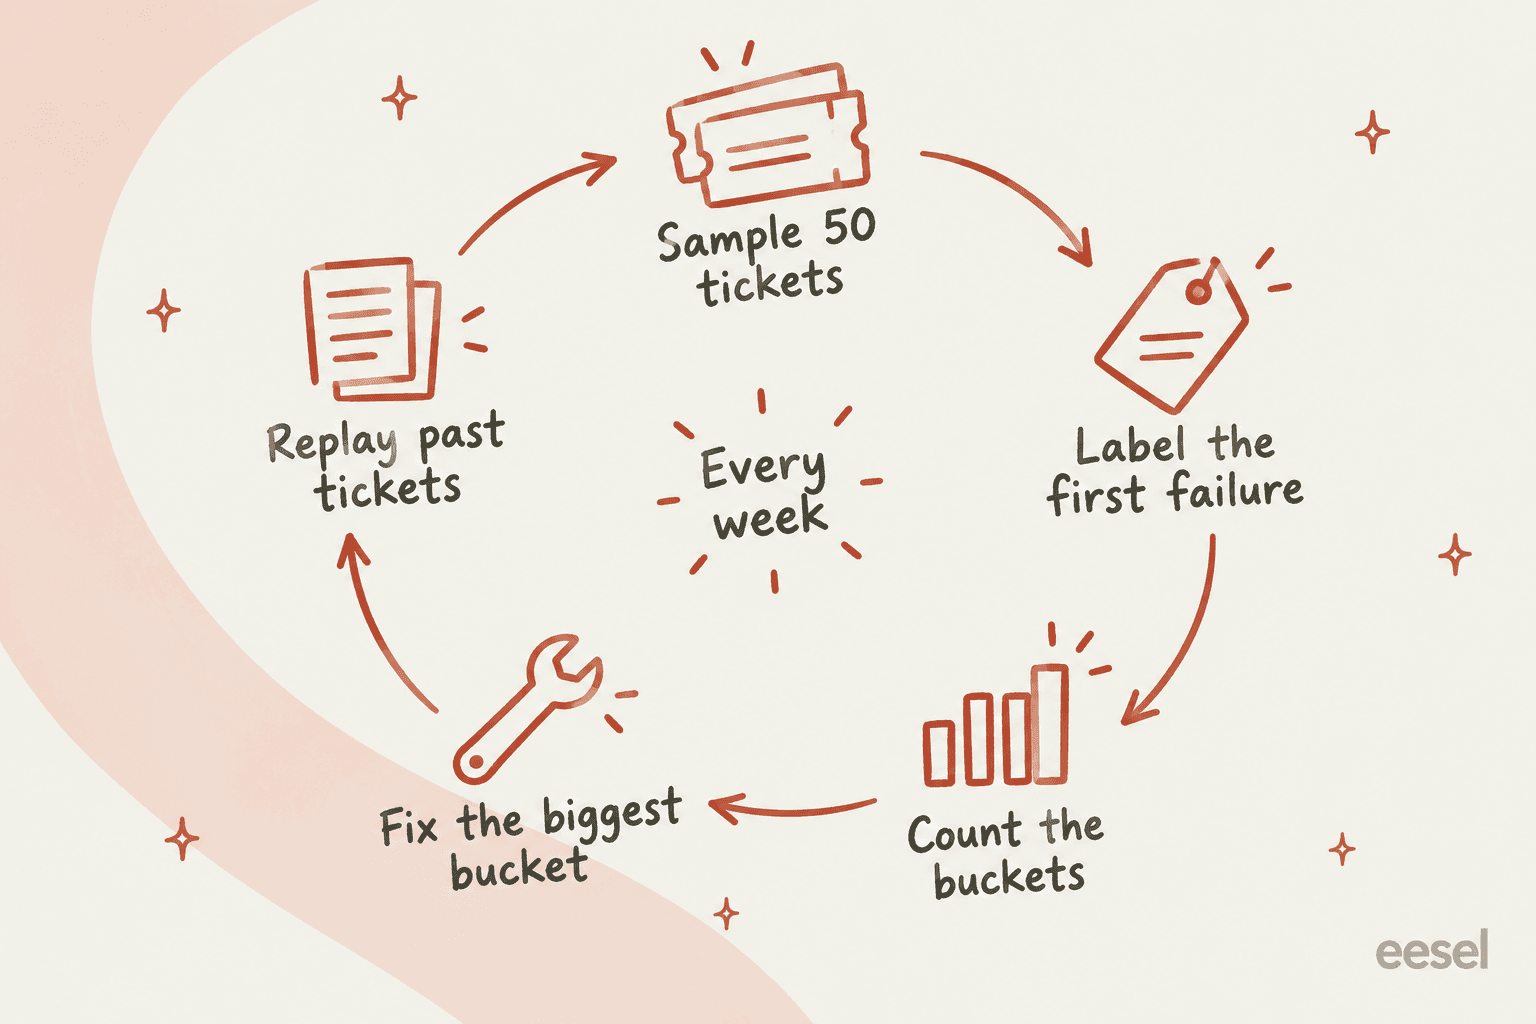
Vous pouvez faire votre premier passage en environ deux heures. Ensuite, c'est une habitude hebdomadaire de 30 minutes.
- Extrayez les échecs, pas un échantillon aléatoire. Tickets réouverts, mauvais CSAT, escalades de l'IA, tickets où un agent a rejeté ou réécrit un brouillon d'IA, et contacts répétés en quelques jours. Zendesk Explore propose pour cela les métriques Reopens et One-touch tickets, et mon guide sur la métrique des tickets réouverts montre comment les filtrer.
- Prenez-en 50. Moins, et une semaine étrange fausse tout. Plus, et personne ne finit. Si votre volume est faible, prenez tout le dernier mois.
- Lisez chacun et étiquetez la première défaillance. Utilisez les six groupes ci-dessus. Une étiquette par ticket. Si vous ne pouvez pas décider en 30 secondes, étiquetez « incertain » et passez au suivant.
- Comptez les groupes. C'est l'étape qui fait changer d'avis. « L'IA est mauvaise » devient « 14 sur 50 étaient le même article périmé sur les retours ».
- Corrigez le plus gros groupe à la source. Réécrivez l'article, inscrivez la règle dans vos SOP de support, modifiez le routage. Donnez à chaque correction un responsable et une date.
- Rejouez des tickets passés pour vérifier la correction. Repassez le même type de question à votre agent ou à votre IA et voyez si la réponse a changé. Ne vous contentez pas d'attendre les tickets de la semaine prochaine.
- Répétez chaque semaine et suivez la répartition des groupes. Dans un programme sain, le groupe principal diminue et un nouveau prend sa place.
La première étape est celle où la plupart des équipes échouent en silence, parce que la métrique évidente ment. Un ticket que l'IA a « résolu » peut quand même être un échec :
"Don't track deflection without tracking subsequent contact. A bot might "successfully" complete a chat, but if the user submits an email ticket 20 mins later – that bot was trash. You have to analyze repeat contact rates to get true transparency."
La documentation de HubSpot dit elle-même la même chose : les déviations « do not always indicate resolution », puisqu'un client peut simplement partir (base de connaissances HubSpot). Rapprochez donc les conversations du bot des tickets de suivi du même client avant de vous fier à un taux de résolution. Mon article sur la mesure de la déviation par l'IA traite ce rapprochement.
Pour l'étape quatre, un simple décompte suffit au début. Un responsable informatique sur Reddit a décrit exactement cela : compter combien de tickets se rattachent à la même cause et relier les points, sans imposer à l'équipe un « 5 pourquoi » complet à chaque fois. Une fois les groupes stables, transférez-les dans votre helpdesk sous forme de tags ou de causes racines QA pour que le comptage se fasse tout seul. Mon guide d'analyse des tickets de support contient un modèle de feuille de comptage.
Comment analyser les erreurs d'un agent de support IA
L'analyse des erreurs d'un agent IA est plus facile que celle d'humains sur un point important : l'IA peut montrer son travail. Vous voyez ce qu'elle a cherché, ce qu'elle a trouvé et pourquoi elle a choisi sa réponse. Vous n'obtiendriez jamais cela d'un agent humain en fin de longue journée.
Le piège : il faut vraiment le lire. Un commentateur de Hacker News qui construit des agents a plaidé pour le faire à la main, même quand on dispose d'une notation automatique :
"there's still a huge benefit in looking at traces yourself and labeling them. It's time-consuming, yes, but you'll learn a lot about the ways an agent fails in your particular domain, it gives you more reliable golden datasets, you have a mechanism to evaluate your judges, etc."
Quand vous lisez des traces d'IA, les six groupes s'appliquent toujours, mais les indices sont différents :
- Question mal comprise : l'intention ou le cas d'usage indiqué par l'IA ne correspond pas à la question du client.
- Mauvaise source : la liste des sources montre un article proche mais faux.
- Source mauvaise ou manquante : l'IA a cité le bon article et l'article est faux, ou elle n'a rien trouvé et a répondu quand même. Ce second cas est la version dangereuse. Quand la récupération revient vide, un modèle peut combler le vide avec des connaissances générales. Dans une configuration eesel pour une équipe de télématique automobile sur Zendesk, le bot a confirmé la prise en charge de modèles de voiture absents de la base de données du produit, parce que le centre d'aide disait « nous prenons en charge tous les modèles ».
- Politique non suivie : la règle existe dans la tête de votre équipe mais pas dans les instructions de l'IA.
- Aurait dû transférer : la conversation a touché un sujet de votre liste de transferts, ou qui aurait dû y figurer, et a continué. Mon guide sur le transfert par l'IA couvre ce qui doit figurer sur cette liste.
Un avertissement tiré de l'expérience : ne passez pas directement au changement de modèle. Simon Willison a posé sur HN la bonne question : si vous changez de modèle sans évaluations, "how will you tell if the model switch actually helped?" Et souvent le modèle n'est pas du tout le problème. Un autre commentateur a noté que les équipes qui accusaient le LLM ont trouvé que "upstream calls to services that produce data" étaient la vraie cause. En termes de support : la recherche de commande n'a rien renvoyé, alors l'IA a deviné. C'est le groupe des 20 % de l'essai ci-dessus.
Si votre IA rédige des brouillons pour les agents au lieu de répondre directement, chaque brouillon rejeté ou réécrit est une donnée gratuite pour l'analyse des erreurs. Traitez la modification comme une étiquette. Mon guide sur l'entraînement d'un agent de support IA explique comment réinjecter ces modifications.
Ce que montre chaque helpdesk quand une réponse se trompe
Chaque grand helpdesk offre désormais un moyen de voir pourquoi son IA a répondu ainsi. Ils diffèrent beaucoup par ce qu'ils montrent et par la possibilité de tester une correction sur des tickets passés.
| Helpdesk | Où voir le « pourquoi » | Sources affichées par réponse ? | Codes de motif intégrés | Tester une correction sur l'historique ? | Condition | Source |
|---|---|---|---|---|---|---|
| Zendesk | Journaux de conversation : par message Plan, Response before customization, instructions actives | Par conversation (Resources used), pas par article pour les réponses de connaissances simples | Résolutions personnalisées dont Unresolved, Escalation failed ; causes racines QA avec niveaux | Non documenté en masse | Journaux sur tous les forfaits Suite ; QA nécessite le module QA ou WEM | Documentation Zendesk |
| Freshdesk | AI Agent Studio Analyze : onglet Improve, Knowledge usage, Ticket logs | Answer Source dans les tests ; compteurs par source de réponses et de retours | Types d'Improve : New content, Edit content | Onglet Test : jusqu'à 100 requêtes saisies ou générées | Growth, Pro, Enterprise | Documentation Freshdesk |
| Gorgias | Show reasoning sous chaque message de l'IA ; onglet AI Feedback | Oui, avec pouce haut ou bas par source | Liste « What went wrong » ; 3 motifs de transfert ; Opportunities : Fill knowledge gap, Resolve conflict | Un ticket existant à la fois | Le feedback exige Lead ou Admin | Documentation Gorgias |
| HubSpot | Coaching opportunities ; agent insights dans Help Desk | Oui, sources de connaissances citées par réponse | Reason : Knowledge, Handoff, Experience, Action, Other | Non documenté | Pro ou Enterprise plus HubSpot Credits | Documentation HubSpot |
| Help Scout | Onglet Beacon Sessions, Improvements | Seulement quand l'IA échoue ou demande une précision (Attempted Sources) | Contact helped, Contact not helped, Human escalation | Non documenté | Tous les forfaits payants, $0.75 par résolution IA | Documentation Help Scout |
| Front | Hub des réponses IA (AI replies hub) | Oui, avec l'extrait exact tiré de chaque source | Non documenté pour les transferts IA | Une conversation existante à la fois | Module Copilot ou Autopilot ; Smart QA $20/seat/month | Documentation Front |
Toutes les fonctionnalités et conditions ont été vérifiées dans la documentation de chaque éditeur en octobre 2026.
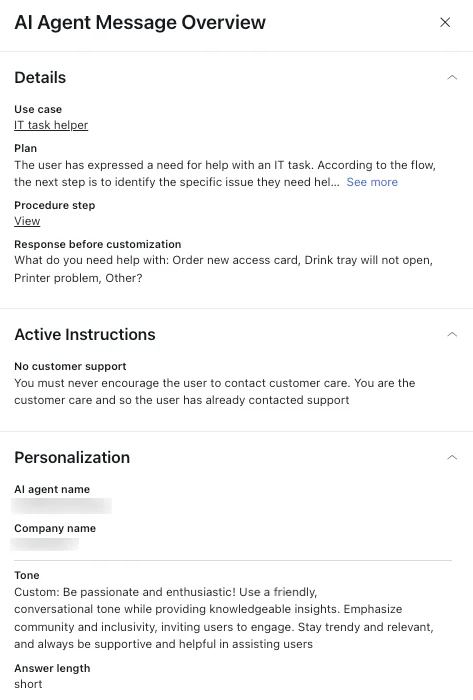
La vue au niveau du message de Zendesk est la plus détaillée pour ses procédures génératives. Le champ Plan montre le raisonnement de l'IA, et Response before customization montre le texte avant l'application de votre persona et de vos instructions, ce qui indique si une mauvaise réponse vient du raisonnement ou de vos réglages de ton :
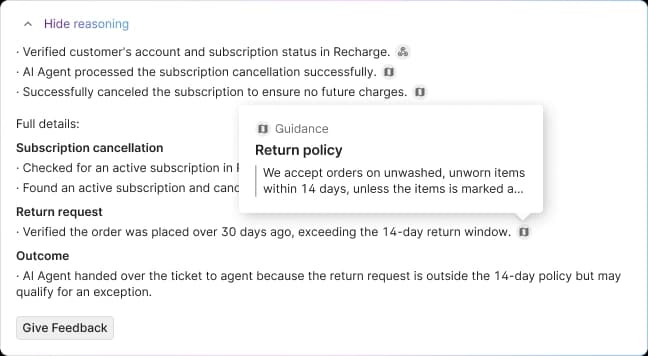
Gorgias rend le raisonnement lisible pour tous les rôles, ce qui compte plus qu'il n'y paraît. Quand les agents peuvent voir pourquoi l'IA a transféré ou répondu, ils peuvent signaler la cause au lieu de simplement « le bot s'est trompé » :
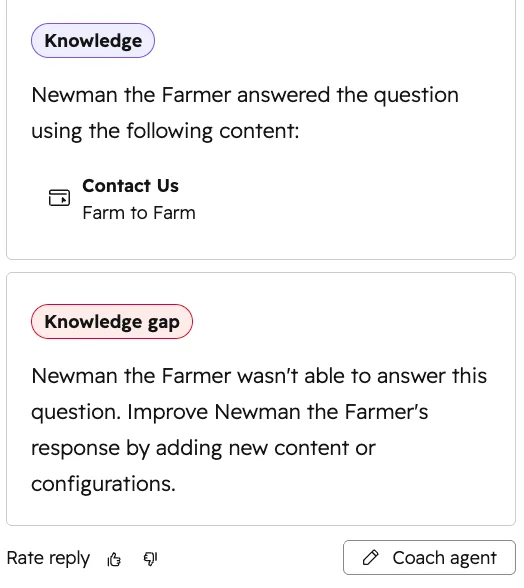
HubSpot étiquette chaque réponse de l'IA avec ce qu'elle a utilisé, ou la signale comme une lacune de connaissances. Cette étiquette, c'est en gros le groupe trois, déjà fait pour vous :
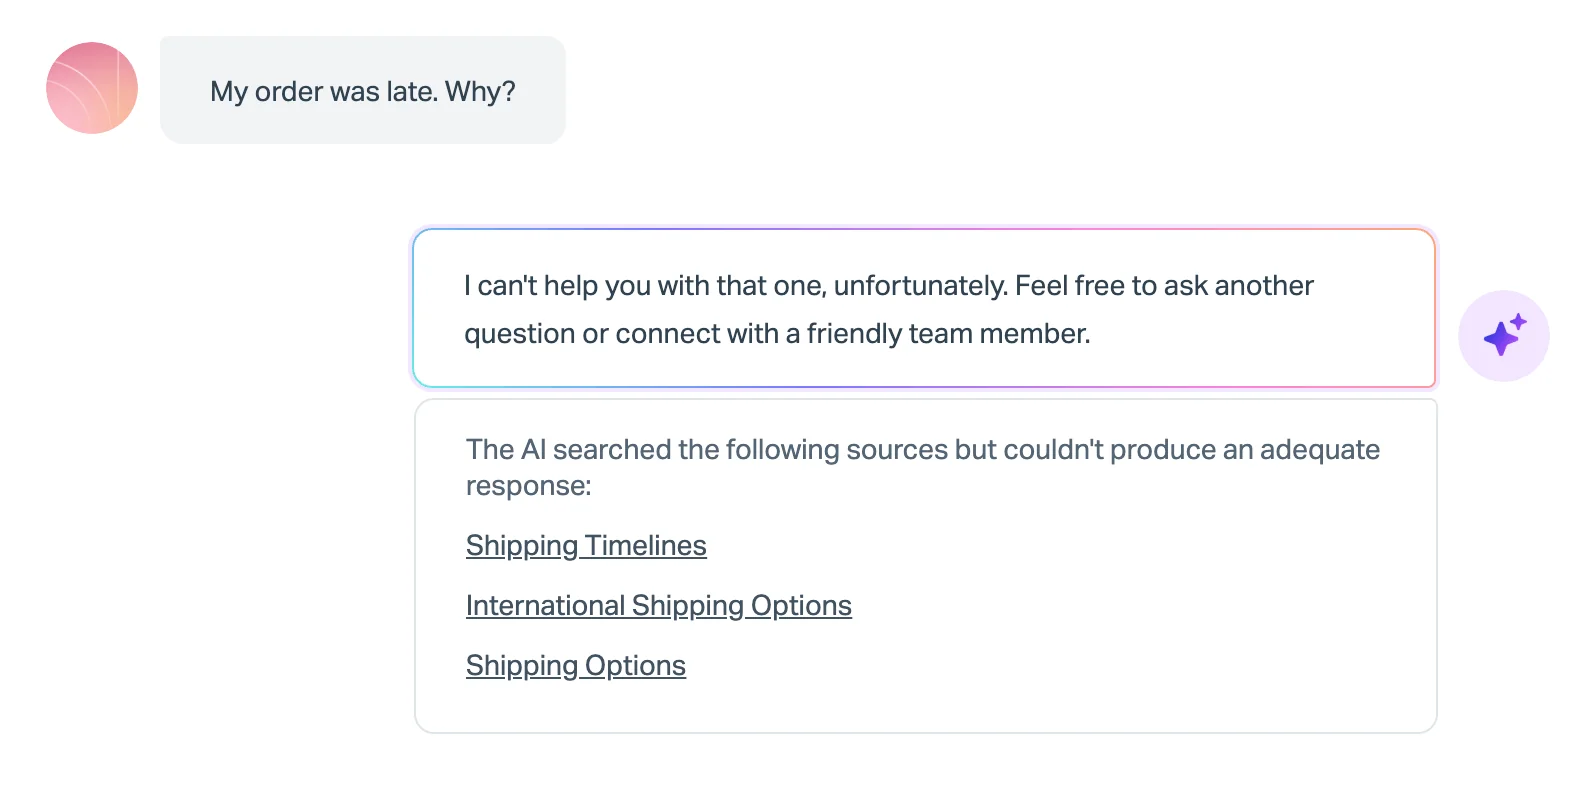
Help Scout n'affiche les sources que lorsque l'IA échoue, mais pour l'analyse des erreurs, c'est justement le moment où vous en avez besoin. Une réponse qui a cherché dans trois articles de livraison sans pouvoir répondre à « ma commande est en retard, pourquoi ? » pointe vers un article manquant, pas vers un mauvais modèle :
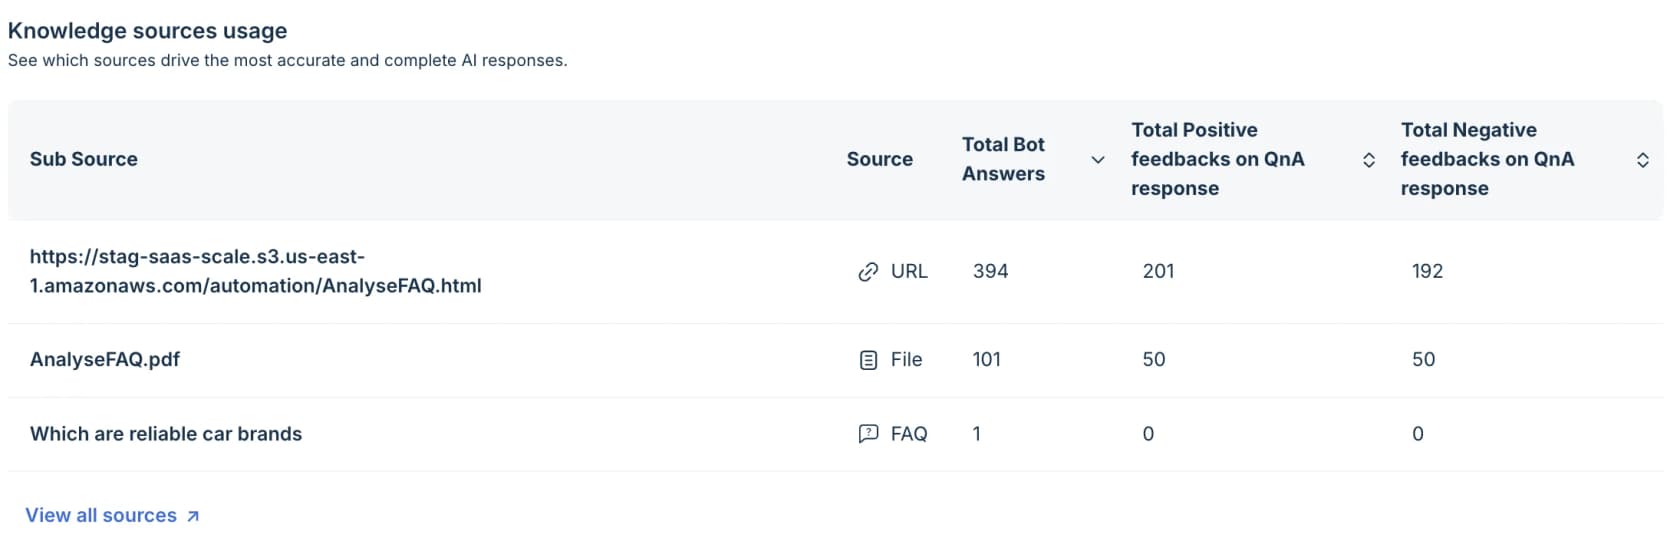
Le tableau Knowledge usage de Freshdesk est la meilleure vue intégrée pour le groupe deux. Il compte combien de fois chaque source a été utilisée dans les réponses du bot, à côté des retours positifs et négatifs. La consigne de Freshdesk lui-même : une source souvent citée avec un rapport élevé entre négatifs et positifs est votre première cible de révision de contenu :
Deux choses à savoir avant de vous appuyer sur l'un de ces outils. D'abord, le Root Cause Analysis de Freshdesk, malgré son nom, explique les pics de volume de tickets avec une carte arborescente, pas les mauvaises réponses individuelles, et il est réservé à Enterprise. Ensuite, la colonne « tester une correction » est le point faible partout. Gorgias et Front permettent de rejouer un ticket existant à la fois, et Freshdesk teste des questions saisies ou générées. C'est utile pour des vérifications ponctuelles, mais cela ne dira pas si la correction de la semaine dernière a fait bouger le taux d'erreur sur 50 vrais tickets.
Où consigner les causes racines pour pouvoir les compter
La lecture des traces trouve la cause. Compter exige que la cause soit stockée quelque part où l'on peut produire des rapports. Voici les meilleurs endroits intégrés que j'aie trouvés.
Causes racines de Zendesk QA. Les évaluateurs peuvent ajouter une cause racine facultative en notant une catégorie, choisie dans une liste que vous définissez, organisée en niveaux et sous-niveaux, et rapportée dans des tableaux de bord. Elle est conçue pour les notes négatives, c'est-à-dire exactement l'échantillon de l'analyse des erreurs. Il faut le module QA ou WEM. Mon aperçu de Zendesk QA et le guide des critères de scorecard couvrent la configuration.
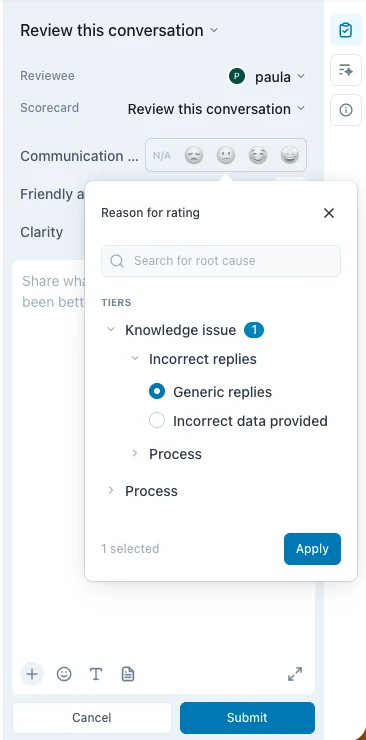
Je configurerais des niveaux qui correspondent aux six groupes, avec des sous-niveaux pour vos cas les plus fréquents (« Source mauvaise ou manquante > Retours », « Source mauvaise ou manquante > Livraison »). Zendesk QA note aussi les agents IA dans des scorecards et dispose d'un tableau de bord BotQA pour les taux d'escalade et de répétition du bot, mais il ne prend en charge que les bots installés depuis le Zendesk Marketplace.
Coaching opportunities de HubSpot. Chacune porte un Reason (Knowledge, Handoff, Experience, Action, Other) et un Type, dont Knowledge gap, Knowledge conflict et « Flagged by Help Desk rep ». C'est l'ensemble le plus complet de codes de motif intégrés que j'aie trouvé, et il correspond bien aux groupes trois et cinq.
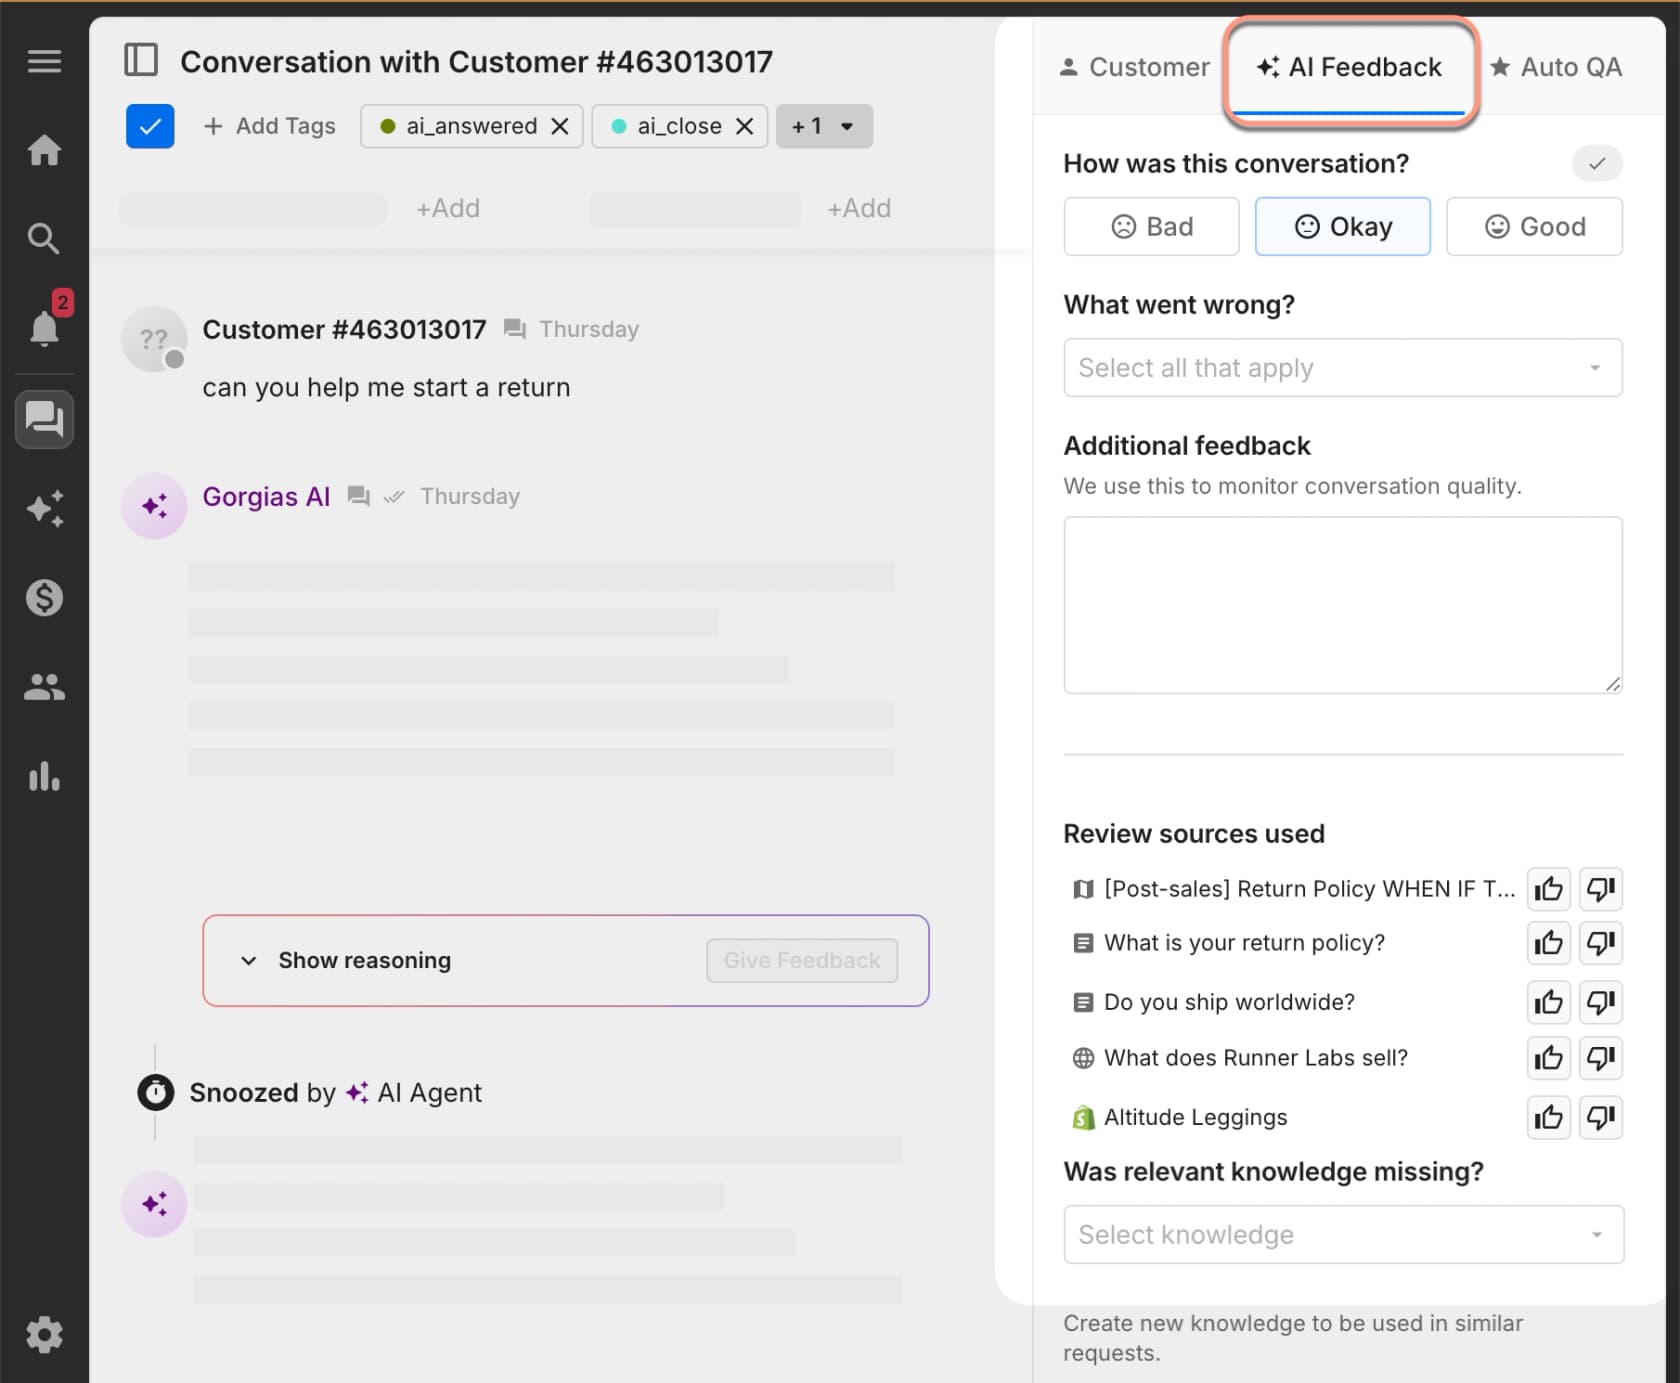
AI Feedback de Gorgias. Sur une note Bad ou Okay, les leads choisissent dans une liste « What went wrong », donnent un pouce haut ou bas à chaque source et peuvent indiquer la connaissance qui aurait dû être utilisée :
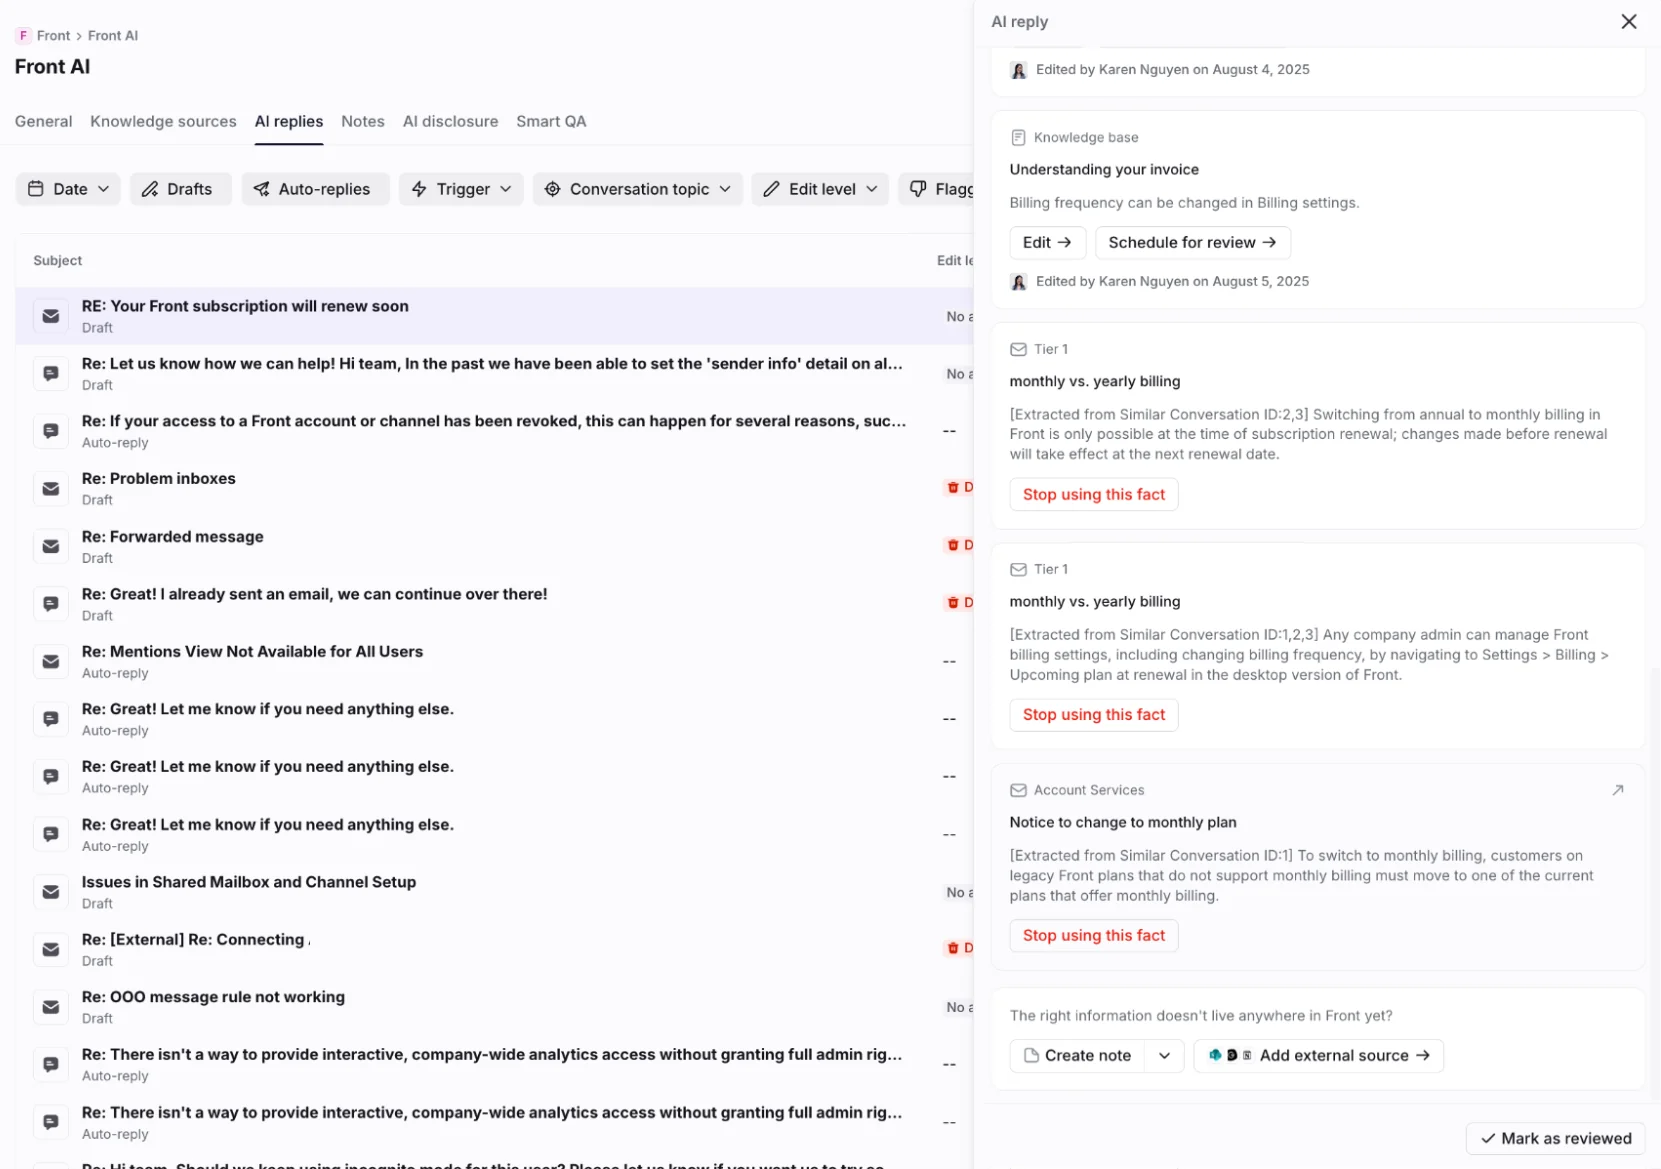
Hub des réponses IA de Front. Ce n'est pas un code de motif, mais c'est le chemin de correction le plus rapide que j'aie vu : chaque source derrière une réponse, avec l'extrait exact, et des actions directes Edit, « Stop using this fact » et Create note.
Si votre helpdesk n'a rien de tout cela, un tag de ticket par groupe fonctionne très bien. Gardez la liste courte. Six tags sont utilisés ; trente sont ignorés. Mon guide sur le tagging du support par IA montre comment les appliquer sans ajouter de clics aux agents.
Corrigez le système, pas la personne
L'analyse des erreurs ne fonctionne que si les gens vous signalent les erreurs. Cela s'arrête dès qu'elle devient un moyen de prendre les gens en faute. Les agents disent clairement ce que cela fait :
"Hold hands up it was something I missed (or didn't consider) but the complaint feedback was otherwise good so it stung to get a fail rather than a learning and fix it"
Parfois, c'est la métrique elle-même qui est la cause racine. Un agent a décrit être pénalisé pour des mises en attente de plus de trois minutes, alors que confirmer la bonne réponse prend trois minutes ou plus :
"If I put them on hold that long, some get annoyed or escalate. Either way, I'm doomed: penalized if you placed the caller on hold for more than 3 mins or returned back to the caller and tell them you needed more time."
Si un objectif pousse les gens à répondre avant d'avoir vérifié, les mauvaises réponses en sont le résultat prévisible. Mettez « le KPI » dans votre liste de groupes quand il apparaît. Mon article sur les KPI du service client couvre ceux qui se retournent contre vous.
Rien de tout cela ne veut dire que personne n'est responsable. La distinction que j'aime vient d'un fil sur les revues sans reproche : les gens sont "still held to account for their decisions and actions but are not blamed for their results." Un agent qui a sauté l'article doit l'entendre. Un agent qui a suivi un article faux doit être remercié de l'avoir trouvé.
À quoi ressemble une bonne boucle en pratique, selon un agent dont l'équipe s'y prend bien :
"But where I work if an agent finds inaccurate information, requests information, or has figured something out that isn't in KB all we have to do is send a message to our supervisor and they pass it along to our head of sales, and the next day KB is updated."
Des mises à jour de la base de connaissances dès le lendemain. C'est la cible. Associez-la à un audit de la base de connaissances régulier et à une analyse des lacunes de connaissances, et utilisez des séances de retours aux agents pour les erreurs qui sont vraiment individuelles.
Il en va de même pour une IA. Un commentateur de HN a dit, à propos de l'erreur d'un conseiller humain, qu'il voulait "better training/docs so it doesn't happen again", pas quelqu'un de renvoyé. Traitez l'IA de la même façon, et orientez les erreurs humaines répétées vers le coaching plutôt que vers des avertissements.
Comment eesel gère l'analyse des erreurs
Je construis des agents IA chez eesel, donc je vais être précis sur ce que fait et ne fait pas le nôtre ici.
Il montre son travail sur chaque ticket. Chaque exécution sur la page Activity d'eesel montre où elle a eu lieu, ce qui l'a déclenchée, quelles sources elle a cherchées, ce qu'elle a fait, son raisonnement étape par étape et si elle a rencontré une lacune de connaissances. Dans Zendesk, chaque brouillon nomme ses sources. Étiqueter une mauvaise réponse prend donc un clic dans l'exécution, pas une supposition.

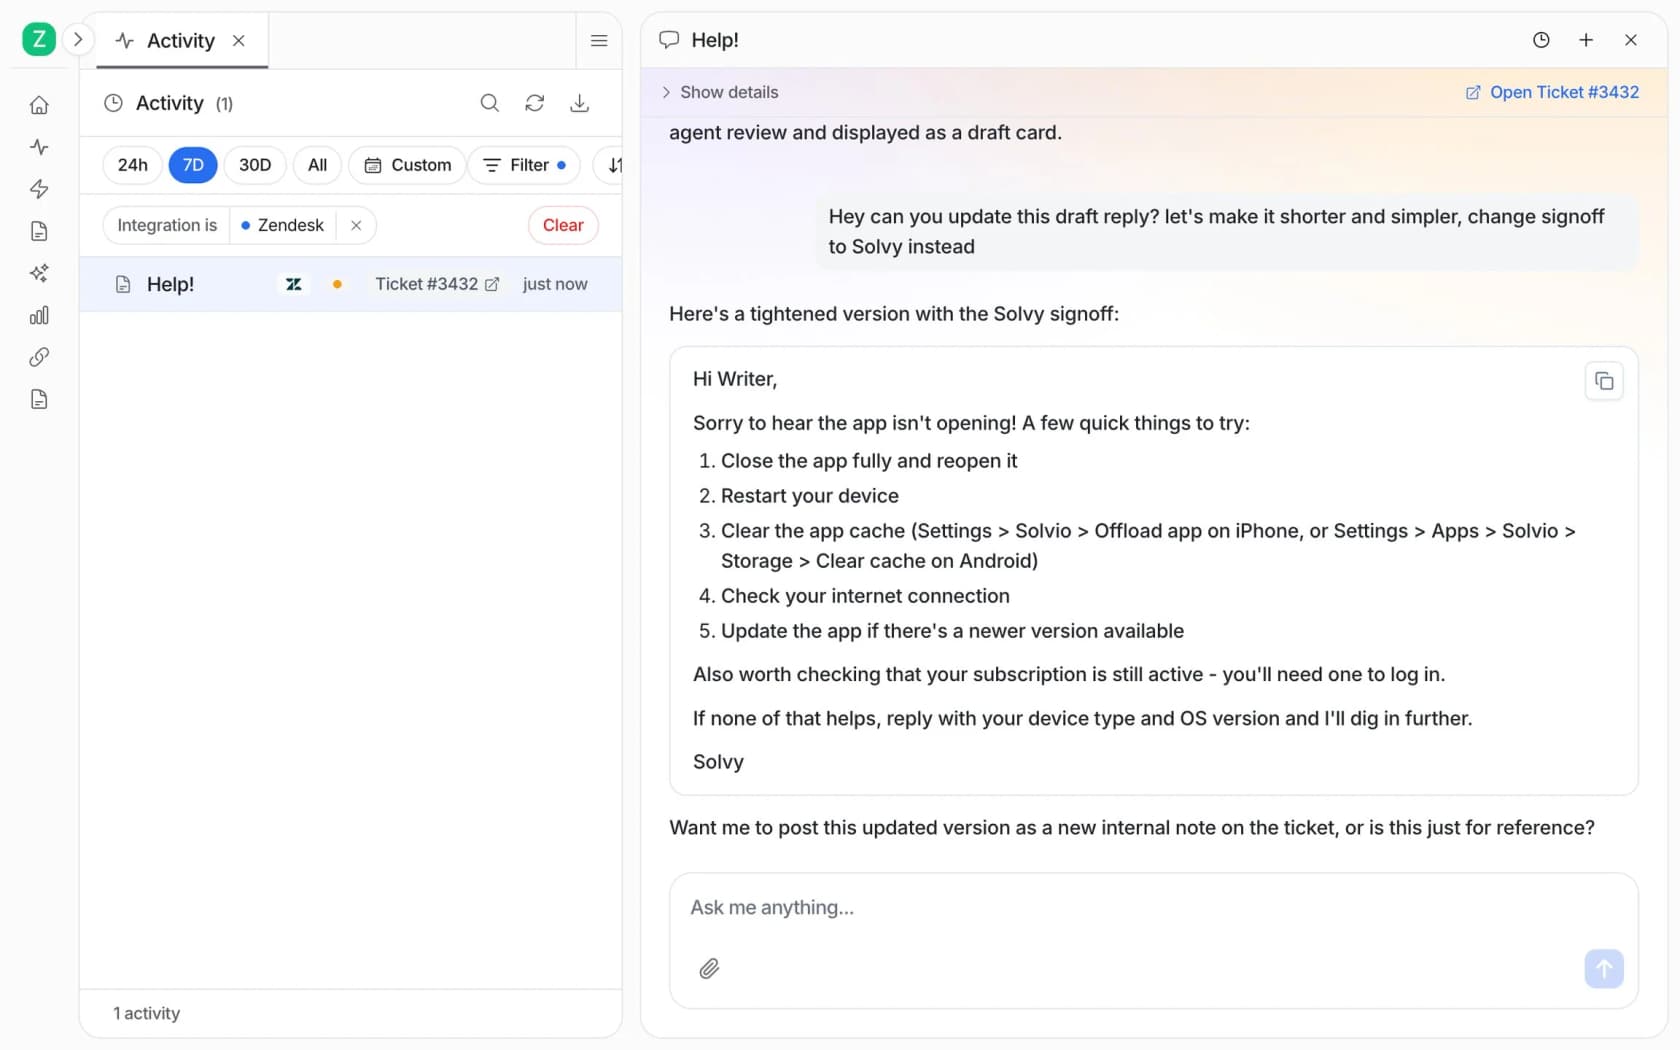
Les corrections deviennent des règles. Quand une réponse est fausse, vous lui dites ce qui n'allait pas, dans le ticket ou dans le chat, et elle écrit la correction dans ses propres instructions, ou modifie la règle existante s'il y en a déjà une qui couvre le cas. Un administrateur Zendesk lui a enseigné une correction du groupe politique en deux lignes : "I have a rule in CS where we do not address a cancel or refund request when there is an issue attached to it." Puis, sur le brouillon suivant : "This is incorrect. You have not provided troubleshooting steps yet." Cette règle s'applique désormais à tous les tickets futurs, pas seulement à celui-là.
Il trouve le schéma pour vous. La skill « Analyze and improve replies » examine ce que votre équipe a rejeté ou modifié, trouve le schéma et suggère des corrections. Ce sont les étapes trois à cinq de la méthode ci-dessus, exécutées sur vos propres données.
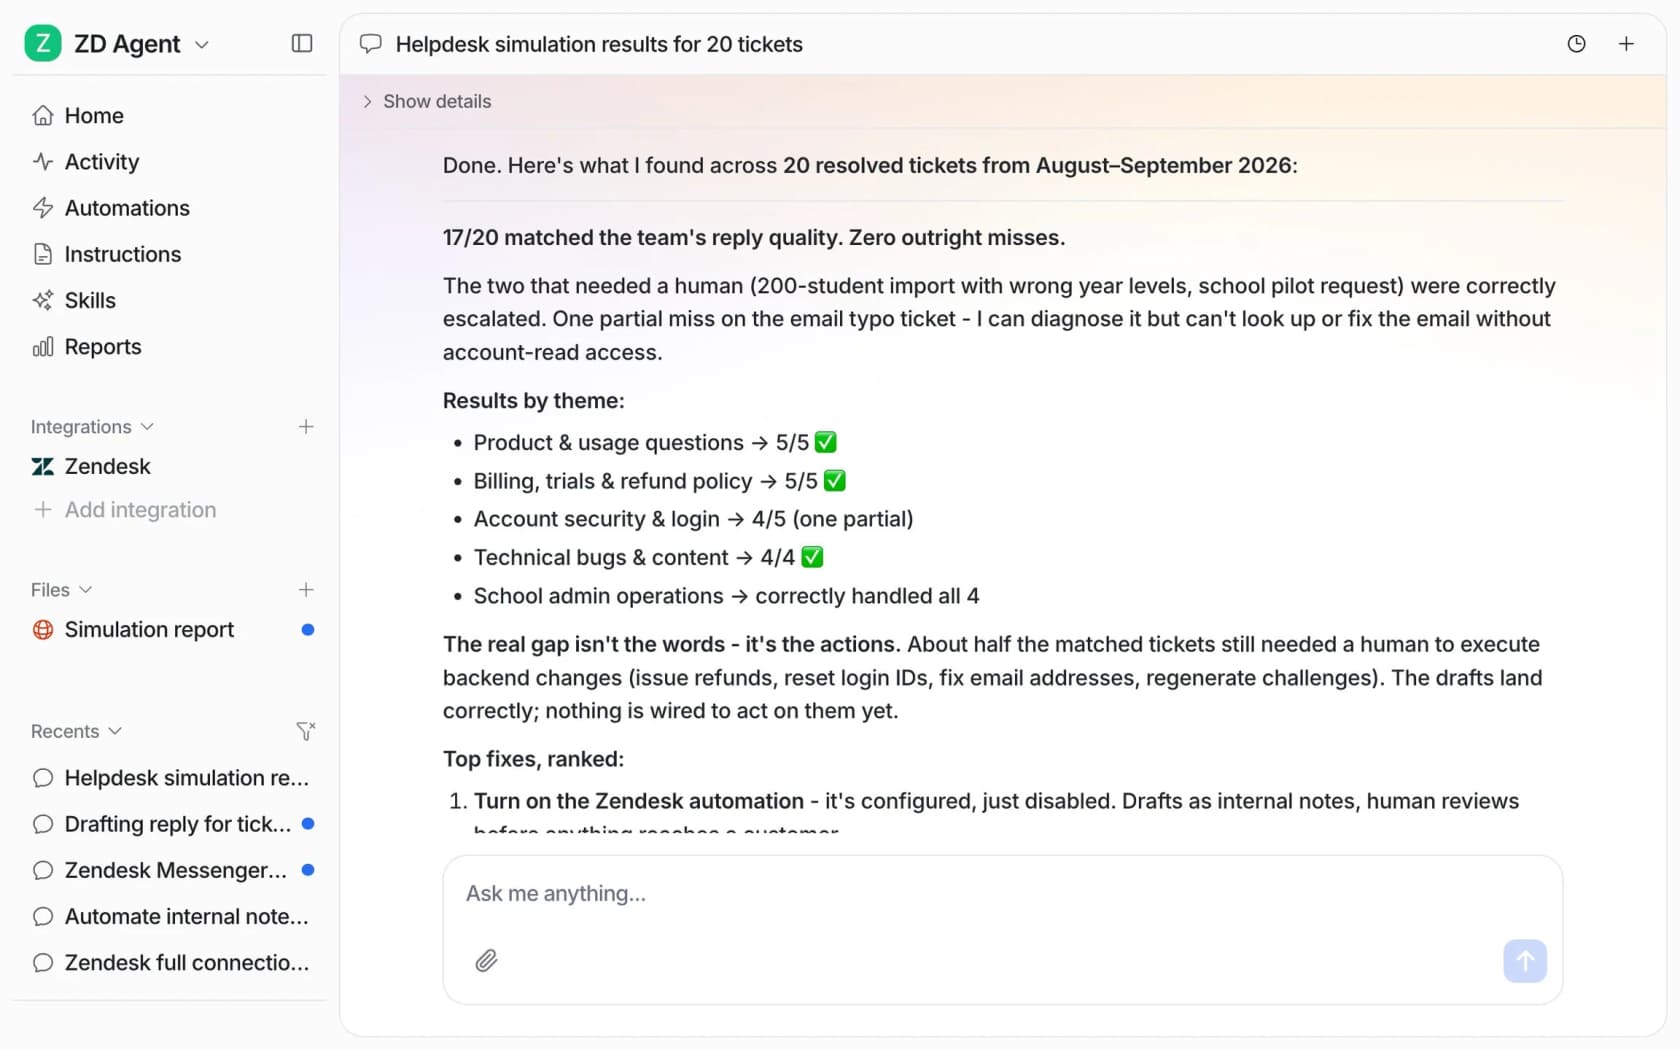
Il rejoue de vrais tickets passés. La skill de simulation exécute votre agent sur de vrais tickets résolus, compare chaque réponse avec ce que votre équipe a réellement envoyé, la note par thème de ticket et suggère des changements d'instructions. Dans l'exemple de la documentation sur 20 tickets, 17 égalaient la qualité de réponse de l'équipe, et le rapport a trouvé que l'écart réel n'était pas la formulation mais les actions des agents, comme consulter un journal ou escalader à l'ingénierie :
C'est l'étape que je ne sauterais jamais. C'est la seule façon que je connaisse de vérifier qu'une correction a fonctionné sur des dizaines de vrais tickets avant que les clients la voient. Et si votre équipe travaille depuis un terminal ou des scripts, la CLI d'eesel permet de corriger l'agent et d'afficher ses règles actuelles en ligne de commande, de sorte qu'un agent de code puisse aussi faire la revue hebdomadaire.
Ce qu'il n'est pas : un remplacement d'une grille de QA pour vos agents humains. Son CSAT IA est une note donnée par une IA aux réponses, pas un retour client, et je garderais votre programme de QA humain en parallèle. Mon tour d'horizon des outils de QA du support couvre ce côté.
Menez votre analyse des erreurs avec eesel
Si votre IA ou votre équipe commet sans cesse les mêmes erreurs, le coéquipier IA de helpdesk d'eesel vous donne la trace des erreurs au même endroit. Il se branche sur votre file Zendesk, Freshdesk, Gorgias ou Help Scout existante, consigne ce qu'il a lu et pourquoi sur chaque ticket, transforme vos corrections en règles permanentes et rejoue de vrais tickets passés pour que vous voyiez une correction fonctionner avant sa mise en ligne. Démarrez avec des brouillons en notes internes, lancez une simulation sur les tickets du mois dernier, et vous aurez votre premier décompte de groupes avant la fin de la journée. L'essai est gratuit avec 100 crédits, et les forfaits payants démarrent à $299 par mois sur la page de tarifs d'eesel.
Comment faire une analyse des erreurs sur des tickets de support ?