

Ce qu'est une base de connaissances par client, et qui en a besoin
Une base de connaissances par client est un contenu d'aide limité à une entreprise cliente ou à une audience. Le client voit ses articles plus les articles partagés. Tous les autres ne voient que les articles partagés.
Quatre types d'équipes finissent par en avoir besoin :
- Les agences et les équipes de support externalisées qui assurent le support de plusieurs marques depuis un seul helpdesk. La politique de remboursement du client A ne peut pas apparaître dans le chat du client B.
- Les MSP qui documentent le réseau, les fournisseurs et les runbooks de chaque client, ce qui constitue à lui seul toute une catégorie de logiciels (plus de détails sur Hudu et IT Glue ci-dessous).
- Les équipes SaaS B2B dont les clients grands comptes ont des configurations personnalisées, des SSO spécifiques ou des SLA propres à leur contrat.
- Les entreprises multimarques, que j'ai abordées dans mon guide du support client multimarque.
Voici comment un administrateur Zendesk a décrit la forme du problème, et c'est la version la plus claire que j'aie trouvée :
"Can anyone advise on configuration for guide where I have 100 unique sites that need a help center? 2/3 of the content needs to be available for all end users but 1/3 of content is site-specific and needs to be invisible to users outside of that specific site. Multi brand? Orgs/tags? Labels?"

Notez le ratio. Deux tiers partagés, un tiers propre au client. Ce ratio détermine presque tout le reste de cet article, de la façon dont vous structurez votre gestion de base de connaissances à la configuration de l'IA.
Je suis Alicia, et je construis les agents IA chez eesel, donc je passe beaucoup de temps sur le côté recherche : ce qu'une IA a le droit de lire quand un client du client A pose une question. C'est là que je passerai la seconde moitié de cet article, car c'est là que le contenu propre à un client cesse discrètement de l'être.
Les trois niveaux de séparation
Tous les helpdesks proposent un mélange des mêmes trois niveaux, qu'ils les appellent marques, portails, espaces de travail ou sites Docs. Choisissez le plus bas qui fait le travail, car chaque marche ajoute de la maintenance.
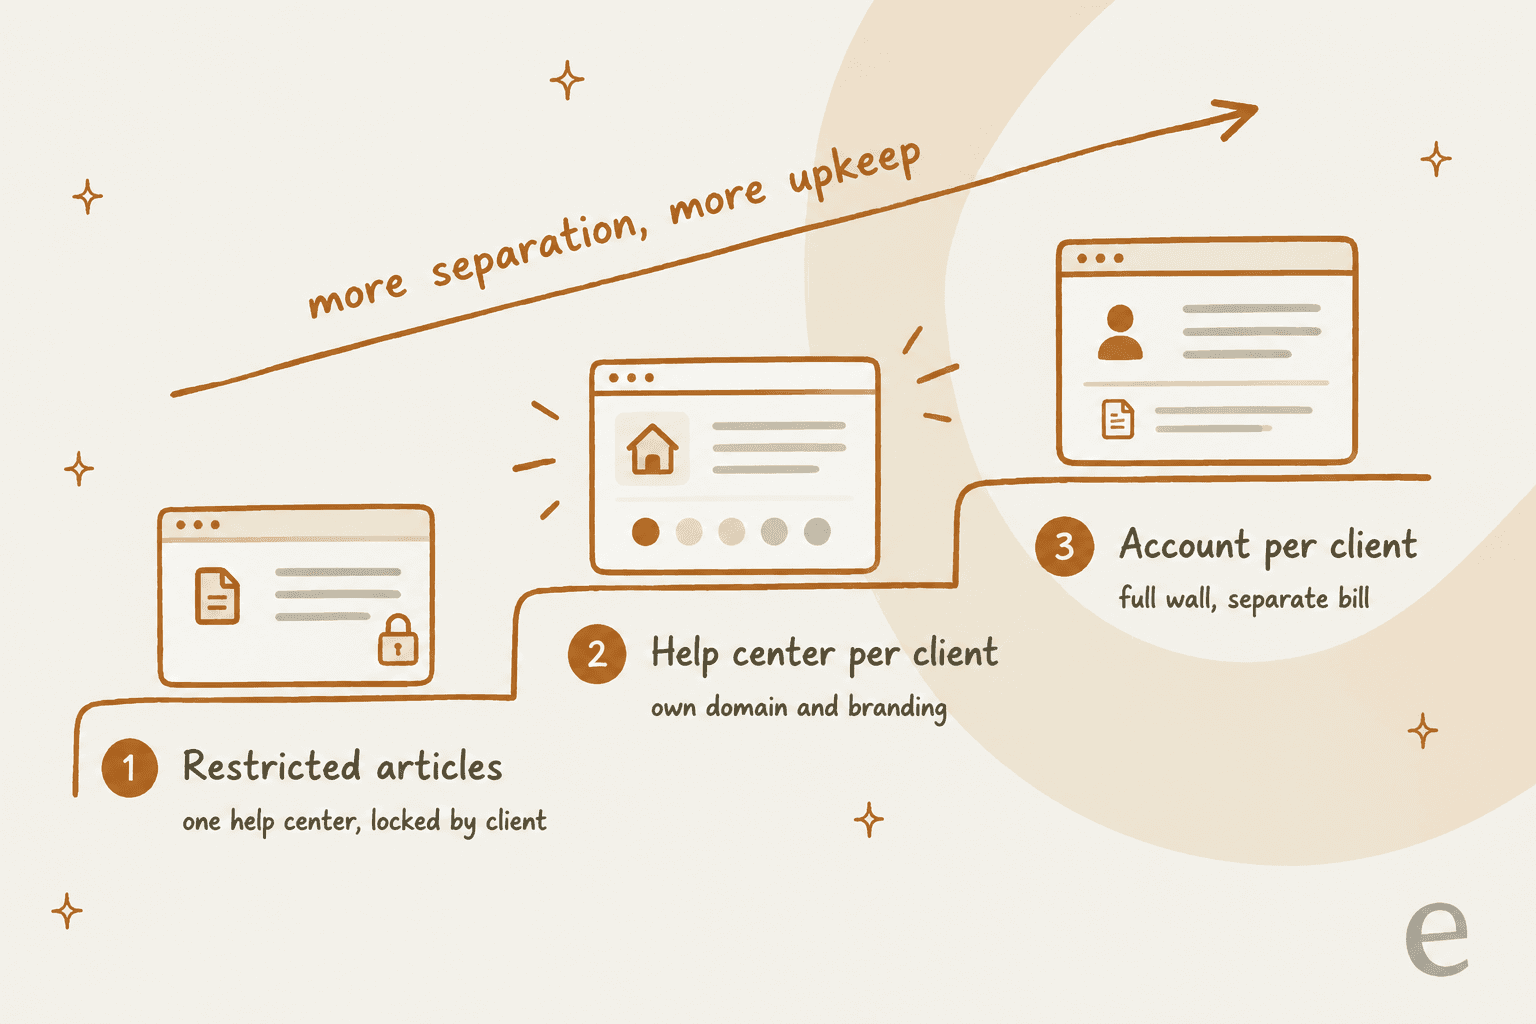
Niveau 1 : articles restreints dans un seul centre d'aide. Les clients se connectent, et les utilisateurs de chaque client voient leurs articles plus les articles partagés. Une seule bibliothèque d'articles, une seule URL. C'est le bon choix par défaut pour la plupart des équipes, et c'est ce que pointaient les réponses sur r/Zendesk :
"User Segments all the way. Cool part though if you have User data coming from say Azure. You can premap info. Or domains as well. Then user segments check that data and allow access to articles pertaining to their content. Little bit of maintenance but it's the best way"
Le piège, c'est la connexion. La restriction ne fonctionne que si le helpdesk sait qui lit, donc les visiteurs anonymes ne voient que le contenu public.
Niveau 2 : un centre d'aide par client. Chaque client obtient son propre domaine, son logo et son jeu d'articles. C'est ce que veulent généralement les clients qui revendent votre service ou y mettent leur propre marque, et c'est la configuration que parcourt mon guide de la configuration multimarque de Zendesk. Ce n'est pas privé pour autant. Le document de Zendesk sur les centres d'aide de marque dit : "you cannot restrict users to a specific help center. All of your help centers are accessible to all of your end users." Un centre d'aide séparé est une décision de marque, pas de confidentialité. Il faut toujours une connexion plus une restriction si le contenu est confidentiel.
Niveau 3 : un compte par client. Helpdesk séparé, facture séparée, administrateurs séparés. Le document Workspaces de Freshdesk indique qu'une facturation ou une propriété juridique distinctes peuvent nécessiter des comptes séparés. C'est le mur complet, et c'est aussi le plus de travail : chaque article partagé est maintenu N fois.
Ne copiez pas chaque article par client
L'erreur la plus courante que je vois consiste à traiter « propre au client » comme « copier toute la bibliothèque par client ». Avec le ratio de deux tiers partagés vu plus haut, cela signifie que la plupart de vos modifications sont la même correction collée douze fois, et que les copies divergent dès que quelqu'un en oublie une.
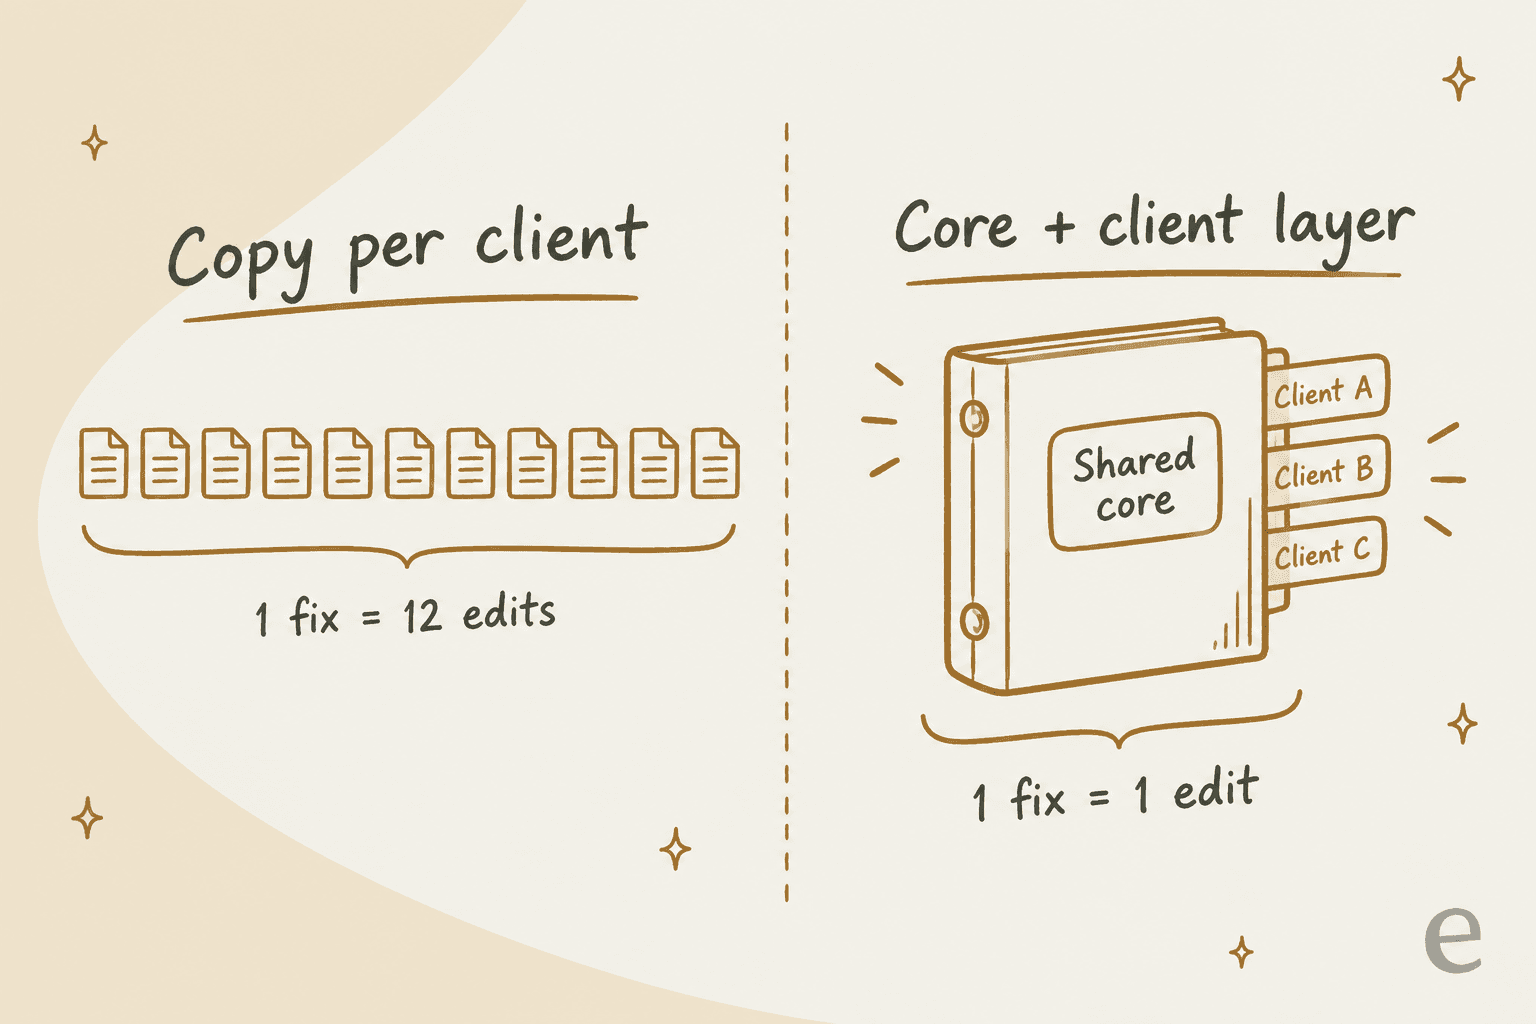
Le schéma qui tient la route est un noyau partagé plus une couche fine par client :
- Noyau partagé : comment le produit fonctionne, politiques standard, dépannage. Écrit une seule fois.
- Couche client : seulement ce qui diffère. Configuration personnalisée, termes du contrat, contacts nommés, chemins d'escalade propres au client, exceptions à la politique standard.
La même répartition fonctionne pour les bases de connaissances internes, où la couche client est faite de notes réservées aux agents que vos clients ne voient jamais.
Les outils de documentation pour MSP sont construits exactement ainsi. Hudu parle de bibliothèques de base de connaissances doubles : des articles centraux "for information that pertains to multiple clients" et des articles clients qui "pertain only to that space." Zendesk a deux fonctions qui font le même travail dans un seul compte. Le placement multiple d'articles place un article dans jusqu'à 10 sections réparties sur plusieurs marques, et chaque placement garde ses propres permissions d'affichage.
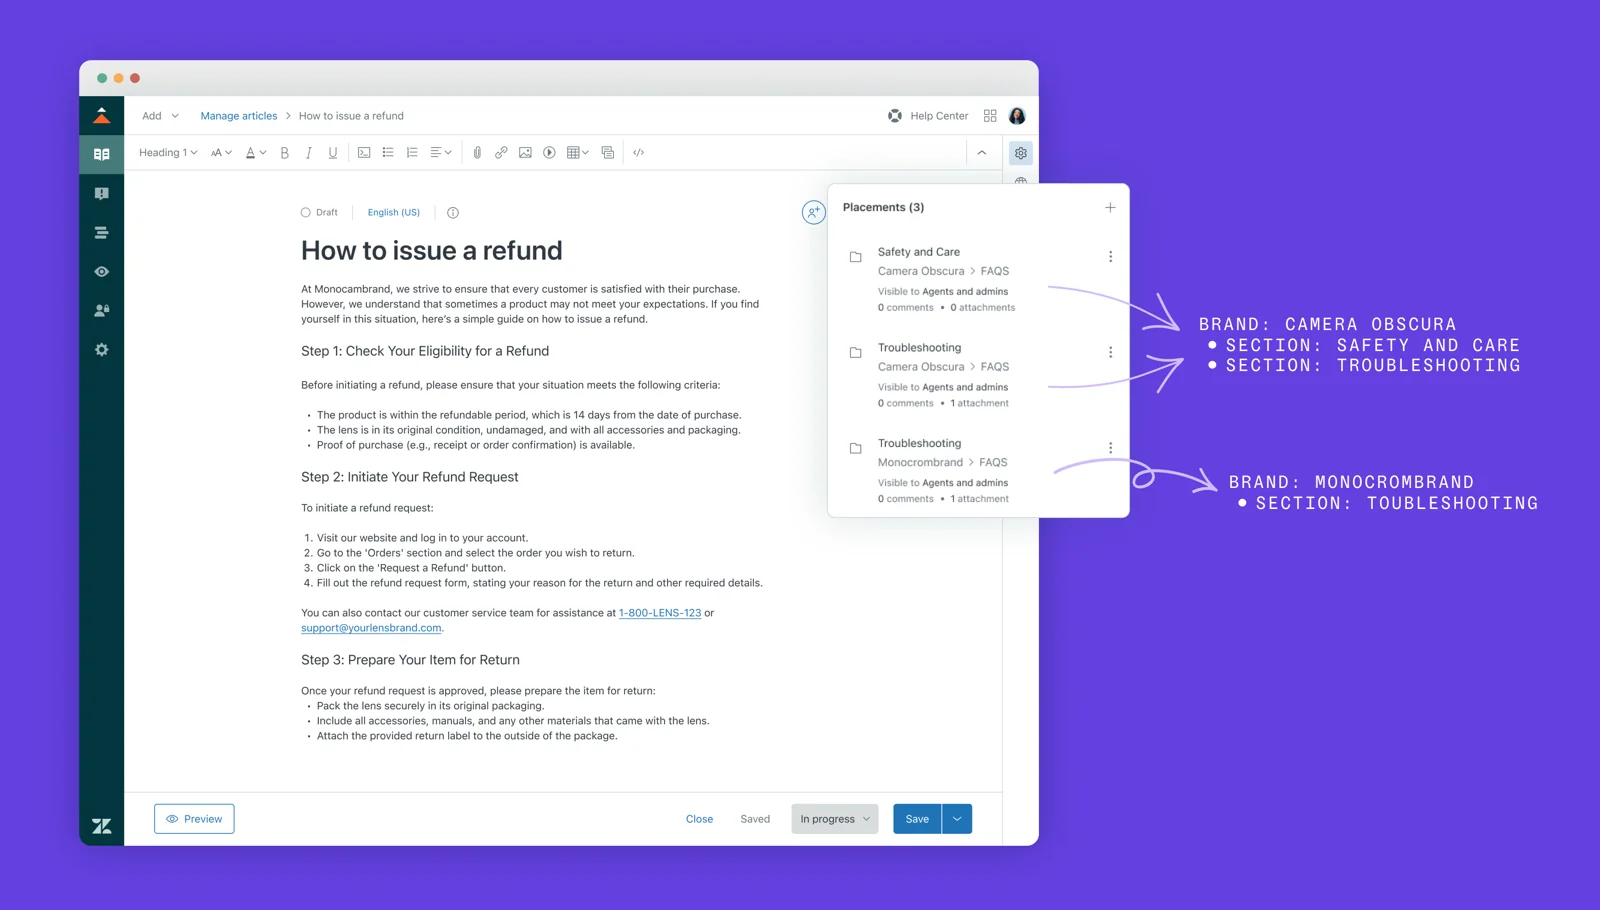
Les blocs de contenu vont un cran plus petit : un paragraphe ou un tableau réutilisable qui se met à jour partout où il est inséré. Ils sont toutefois réservés à Enterprise, donc la plupart des équipes s'appuieront plutôt sur le placement multiple et une convention de nommage claire.
Une remarque honnête sur IT Glue : il n'a pas de bibliothèque partagée native. Son propre document sur les permissions suggère de créer une organisation "named something like 'Common Documents'" pour le contenu partagé. Ça marche, mais c'est une convention que vous devez faire respecter, pas une structure fournie par l'outil.
Comment chaque helpdesk gère les articles par client
Voici ce que chaque outil restreint, à quel niveau et dans quelle offre. Les prix sont par agent ou par utilisateur et par mois en facturation annuelle, d'après la page de tarifs de chaque éditeur en octobre 2026.
| Helpdesk | Plus petite unité restreignable | Mécanisme par client | Offre pour la restriction par client | Centre d'aide séparé par client |
|---|---|---|---|---|
| Zendesk | Article | Segments d'utilisateurs par organisation, tag ou utilisateur nommé | Suite Professional $115 (segments personnalisés) ; plusieurs segments par article nécessitent Enterprise | 5 en Professional, 300 en Enterprise |
| Freshdesk | Dossier | Dossier visible pour des entreprises sélectionnées, des segments de contacts ou des segments d'entreprises | Indiqué sur toutes les offres dans la documentation des dossiers de Freshdesk | Pro $55 (jusqu'à 5 portails), Enterprise $89 (illimités) |
| HubSpot Service Hub | Article ou base de connaissances entière | Groupes d'accès (statiques ou basés sur des filtres) | Professional : 2 groupes d'accès ; Enterprise : 100 | Enterprise uniquement (jusqu'à 100 bases de connaissances) |
| Help Scout | Site Docs entier | Un site Docs restreint par client | Plus $45 ou Pro $75, plus du code sur mesure | Sites : Plus 3, Pro 5, supplément $20/mois |
| Zoho Desk | Catégorie, section ou article | Groupes d'utilisateurs du centre d'aide (jusqu'à 200 par centre d'aide) | Pas dans Free ; base de connaissances à partir de Standard $14 | Enterprise $40 (centre d'aide multimarque) |
| Front | Centre d'aide entier | Un centre d'aide à accès contrôlé par connexion par client | Professional $65 | Professional et supérieur |
Quelques points de ce tableau méritent plus qu'une cellule.
Zendesk : les segments d'utilisateurs font le vrai travail
Les segments d'utilisateurs de Zendesk sont l'option la plus flexible ici. Un segment peut filtrer jusqu'à 50 organisations, 50 tags dans chaque groupe de tags et 50 utilisateurs nommés, et vous avez jusqu'à 200 segments par compte, partagés entre les marques. Placez les utilisateurs de chaque client dans une organisation et vous obtenez un segment client en correspondance directe.
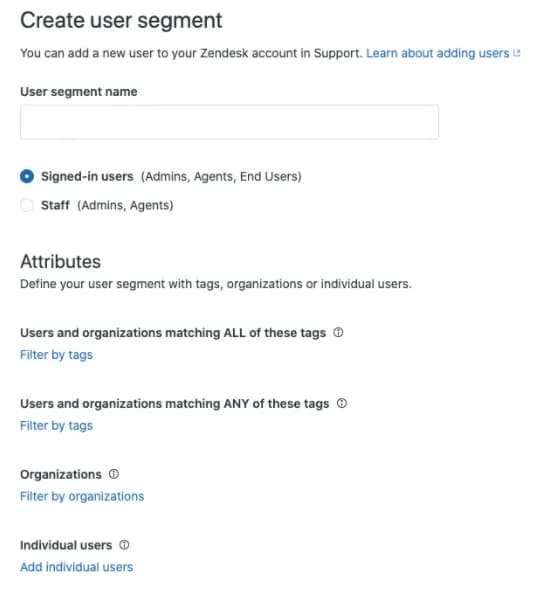
Deux détails d'offre comptent. Suite Team ne peut choisir que « tout le monde » ou « utilisateurs connectés », donc pas de segments clients ni d'articles réservés aux agents. Et la restriction se fait par article, pas par section, donc vous verrouillez toute une section client par mises à jour en masse. Mon guide pour restreindre des articles par segment le détaille, et l'article sur les centres d'aide multimarques couvre le Niveau 2.
Freshdesk : par dossier, et par entreprise d'office
Freshdesk définit la visibilité sur le dossier, pas sur l'article. Les options incluent Tous les utilisateurs, Utilisateurs connectés, Tous les agents, Bot et Entreprises spécifiques, plus des segments de contacts et d'entreprises. La documentation du widget de Freshdesk nomme directement le cas client : afficher des articles "about a company to just contacts from that company".
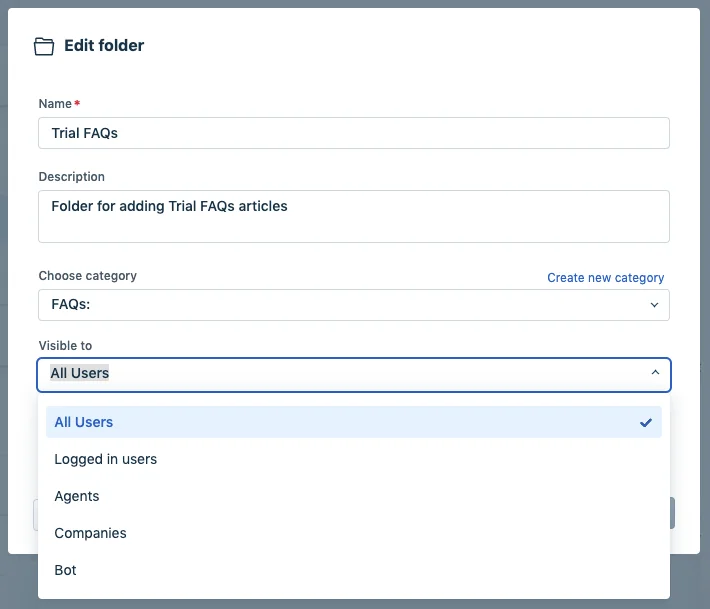
Cela fait de Freshdesk l'une des façons les moins chères de réaliser le Niveau 1 (mon détail des tarifs Freshdesk contient la grille des offres). La forme à prévoir : un dossier par client, puisque la visibilité ne peut pas varier d'un article à l'autre au sein d'un dossier.
HubSpot : correct en Enterprise, serré en Professional
HubSpot restreint des articles individuels ou une base de connaissances entière via des groupes d'accès. Professional autorise 2 groupes d'accès et 1 base de connaissances. C'est suffisant pour « public plus partenaires plus un niveau VIP », pas pour dix clients. Enterprise autorise 100 groupes et jusqu'à 100 bases de connaissances, et le contenu privé de HubSpot ne fonctionne que sur un domaine personnalisé connecté. Plus de détails sur l'IA de HubSpot ci-dessous, car c'est là que ça devient intéressant. Mon tour d'horizon de la base de connaissances HubSpot contient le reste, et l'article sur l'IA de la base de connaissances Service Hub couvre le volet IA.
Help Scout, Zoho Desk et Front
Help Scout restreint des sites Docs entiers, pas des collections. Les Docs restreints nécessitent Plus ou Pro et "custom code development by your own team" pour émettre le jeton du visiteur. Des collections privées existent, mais « privé » désigne vos propres utilisateurs Help Scout, pas un client. Help Scout précise aussi que Docs n'est pas couvert par ses engagements RGPD ou HIPAA, donc gardez-y les données de comptes clients à l'écart.
Zoho Desk est le plus granulaire des trois. Les catégories peuvent être réglées sur Aucun, Groupes, Public, Agents ou IP personnalisée, et les groupes d'utilisateurs du centre d'aide sont décrits comme liés à "a specific account". Les limites sont de 200 groupes par centre d'aide et 2,000 utilisateurs par groupe. Si vous prévoyez d'entraîner Zia dessus, lisez d'abord la section IA ci-dessous.
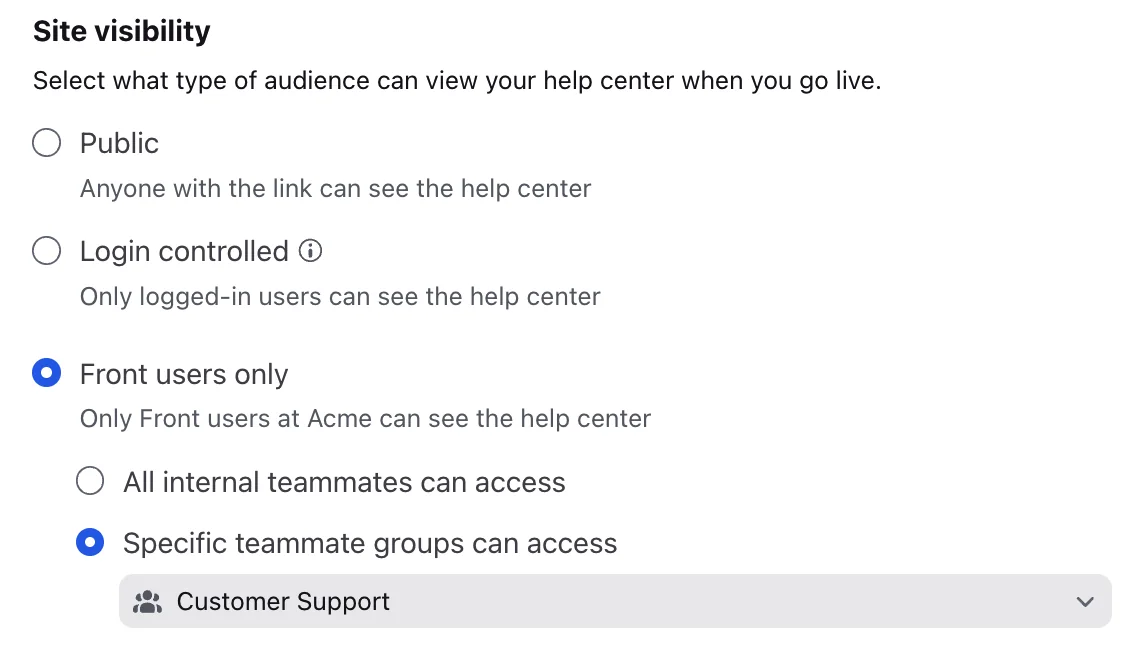
Front restreint au niveau du centre d'aide : Public, Accès contrôlé par connexion (via votre propre fournisseur d'identité) ou Utilisateurs Front uniquement. Ses catégories privées ne cachent le contenu que dans la navigation, et toute personne disposant du lien direct peut les ouvrir, donc ce n'est pas un mur pour les clients. Mon test de Front AI couvre ce que lit son IA.
Où le contenu par client fuit : l'IA
Voici le changement de perspective que je défends. Les équipes passent des semaines à régler correctement les permissions du centre d'aide, puis activent un agent IA qui lit la base de connaissances selon un autre jeu de règles. Le modèle de permissions que voient vos clients n'est pas toujours celui que suit votre IA.
| Fonction IA | Utilise les articles restreints par client ? | Ce que cela signifie pour vous |
|---|---|---|
| Agents IA de Zendesk (configuration actuelle) | Oui, et respecte les permissions d'affichage pour les utilisateurs connectés | La messagerie nécessite une connexion JWT avec un ID externe correspondant ; les réponses restreintes ne peuvent pas être testées dans le widget de test |
| Agents IA de Zendesk achetés avant le 10 mars 2026 | Les articles étaient "public or private to everyone" | La migration va du 1er juillet à fin 2026 |
| Freshdesk Freddy AI Agent | Non. "Private or restricted articles are excluded" | Les dossiers clients ne sont pas une source ; il faudrait les rendre publics |
| Freshdesk Freddy Copilot (côté agent) | Oui, limité à l'accès propre de l'agent | Bien pour les agents, pas pour les réponses destinées aux clients |
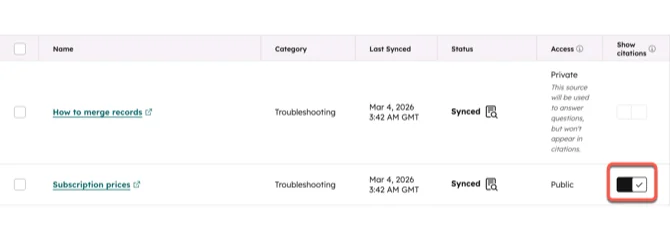
| Agent client HubSpot | Oui, sans citations | HubSpot prévient que le contenu privé "may still appear in responses" |
| Help Scout AI Answers | Peut activer les collections privées dans les paramètres Beacon | Je limiterais par client avec un agent IA par Beacon |
| Zoho Desk Answer Bot | Zoho dit uniquement "published and public resources" | Un commentaire d'utilisateur sur la même page signale des articles réservés aux agents qui remontent ; testez |
Deux lignes méritent un examen plus attentif.
Freshdesk est strict dans le bon sens. La documentation sur les connaissances de l'AI Agent dit "only articles visible to All users are used for AI learning." Le bot ne peut donc pas faire fuiter le dossier du client A vers le client B, mais il ne peut pas non plus répondre au client A à partir du dossier du client A. La solution de contournement de Freshdesk, la recherche filtrée, restreint la recherche par propriétés du contact ou de la conversation, mais ne peut filtrer que du contenu dont l'IA avait le droit d'apprendre au départ.
HubSpot va dans l'autre sens. La documentation sur les sources de l'agent client dit que les sources privées "will not be cited, but their content may still appear in responses", et vous demande de ne pas inclure de données clients confidentielles ou privées. Je n'ai trouvé aucun moyen documenté de limiter une source privée à son groupe d'accès au moment de la réponse.
Le même problème apparaît entre régions, pas seulement entre clients. Un administrateur Zendesk l'a bien résumé :
"The problem: Zendesk AI pulls knowledge from the Help Centers linked to the same brand, regardless of language or region. So if a Brazilian customer asks something, the AI might base its answer on all related contents, even in articles just created for US."
D'abord délimiter, ensuite chercher
La solution est celle à laquelle arrivent ceux qui construisent la leur : décider de qui est le contenu en jeu avant que la recherche ne s'exécute, pas après. Un développeur n8n qui fait tourner un workflow IA pour dix clients l'a décrit ainsi :
"Once I've filtered the clientid the model won't make a mistake because if it gets the clientid gonna search for everything related to the client id, even the chat history is connected trough clientid so it seems pretty solid."
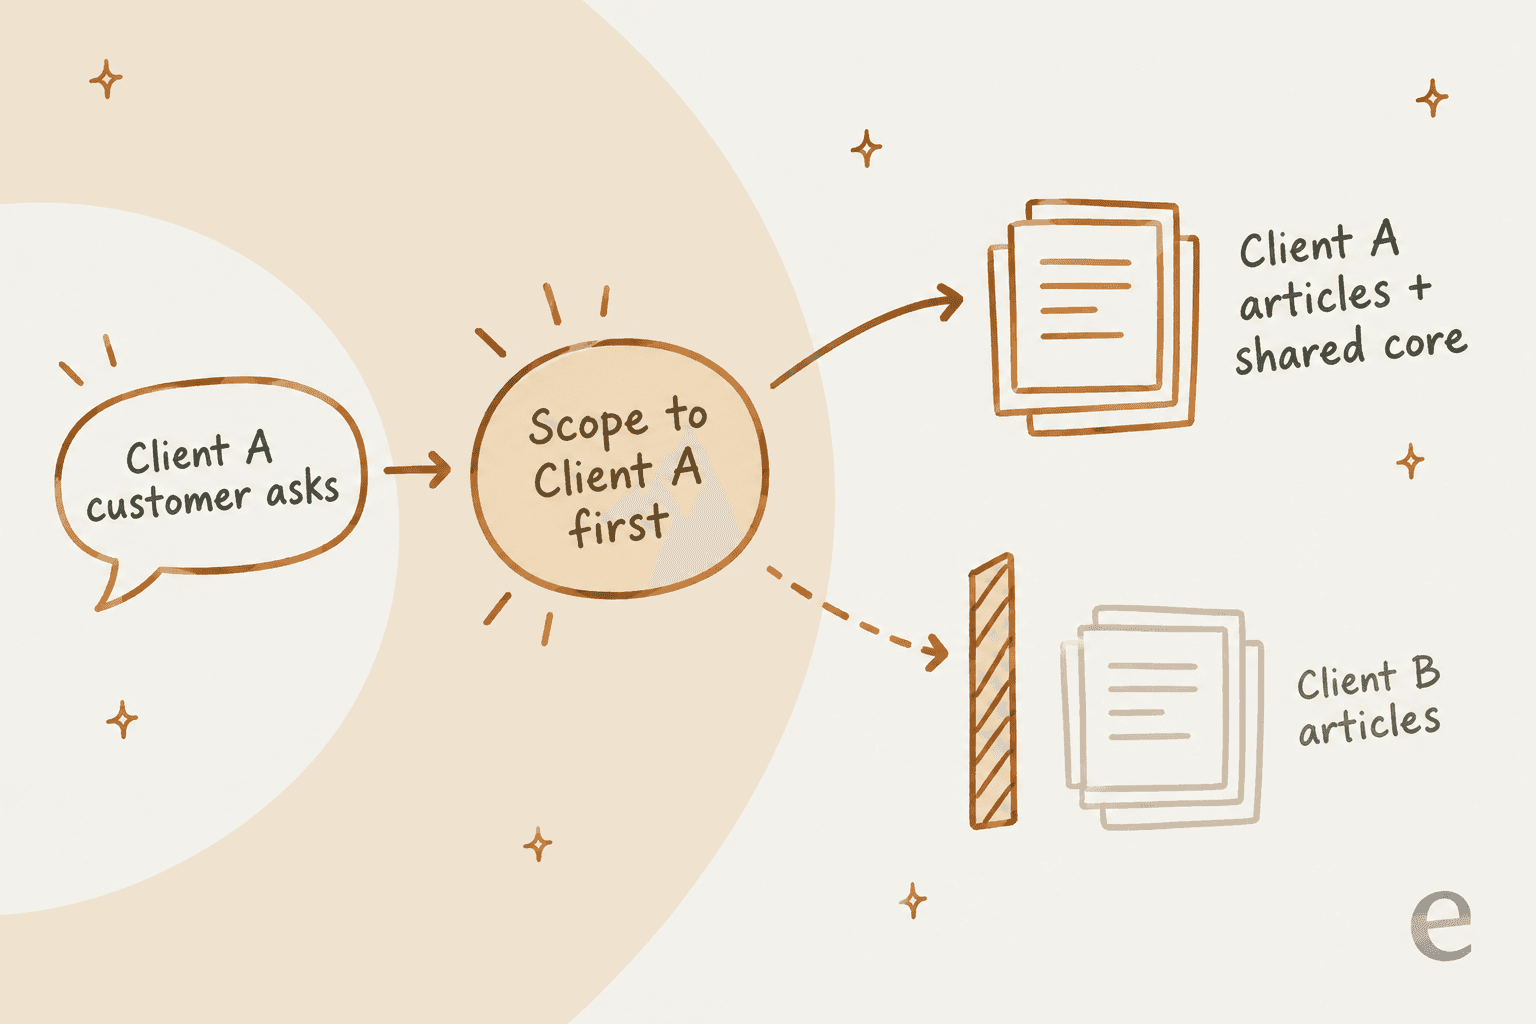
Dans un helpdesk, le moyen le plus simple de délimiter d'abord est d'avoir un agent IA par client, connecté uniquement aux sources de ce client. Des consignes comme « utilise uniquement les articles du client A » ne sont pas un mur. Si le contenu est dans l'index de l'agent, partez du principe qu'il peut ressortir. C'est vrai que l'IA utilise de la recherche ou un modèle affiné, comme je l'explique dans RAG vs fine-tuning.
C'est aussi là que les anciens tickets comptent. L'historique des tickets est la connaissance propre aux clients la plus riche dont vous disposez, car il contient tous les cas limites que les articles n'ont jamais couverts. C'est aussi la source la plus facile à mélanger, parce qu'un helpdesk contient généralement les tickets de tous les clients. Un copilote de helpdesk côté agent est un point de départ moins risqué, puisqu'un humain relit chaque brouillon avant son envoi.
Ce que j'ai appris en construisant cela chez eesel
Plus tôt cette année, une équipe belge de technologie de livraison (néerlandais et anglais, 1,625 documents, l'essai le plus actif de sa cohorte) voulait deux agents IA sur un même Zendesk. L'un répondrait aux utilisateurs anonymes à partir des articles publics, l'autre aux utilisateurs connectés à partir des articles publics plus un sous-ensemble d'articles restreints. L'import d'eesel pouvait filtrer par catégorie mais pas choisir un sous-ensemble restreint article par article, ils se sont donc retrouvés bloqués. À peu près à la même époque, j'ai vu d'autres équipes multimarques résilier parce que la configuration par marque était trop fastidieuse à faire seules.
Deux leçons en sont sorties. Premièrement, placez le contenu propre à chaque client dans sa propre catégorie ou section dès le premier jour, car presque tous les outils, IA comprise, délimitent plus fiablement par conteneur que par article individuel. Deuxièmement, la connexion par marque doit être le réglage par défaut, pas un paramètre avancé. Aujourd'hui dans eesel, chaque marque Zendesk se connecte séparément et importe uniquement les tickets et les articles du centre d'aide de cette marque, et chaque marque peut aller vers un agent différent. Une entreprise multimarque de bien-être fait tourner 5 agents IA propres à chaque marque de cette façon, chacun entraîné sur les tickets de sa propre marque.
Comment configurer des bases de connaissances par client en 6 étapes
Cela fonctionne dans n'importe lequel des outils ci-dessus. L'ordre compte plus que l'outil.
- Triez vos articles entre partagés et propres au client. Faites un rapide audit de base de connaissances et étiquetez chaque article. Attendez-vous à quelque chose de proche du ratio de deux tiers partagés, et notez les lacunes de connaissances au passage. Si la couche d'un client est plus grande que le noyau partagé, ce client a peut-être besoin du Niveau 2 ou 3.
- Donnez à chaque client un conteneur que votre helpdesk comprend. Une organisation Zendesk, une entreprise Freshdesk, un groupe d'accès HubSpot, un groupe d'utilisateurs Zoho. Associez les utilisateurs automatiquement par domaine e-mail ou données SSO quand c'est possible, pour que les nouveaux utilisateurs du client ne tombent pas dans le mauvais groupe.
- Placez les articles du client dans une catégorie ou un dossier réservé au client. Pas mélangés aux sections partagées. C'est l'étape qui rend l'IA et les changements de permissions en masse gérables par la suite.
- Décidez ce qui est partagé par référence, pas par copie. Utilisez le placement multiple, les blocs de contenu ou les catégories de portail rattachées à plusieurs portails. Ne copiez que lorsque la version du client diffère réellement.
- Activez la connexion, puis testez en tant que chaque client. Connectez-vous en tant qu'utilisateur réel du client A et du client B et cherchez le contenu de l'autre. La documentation Zendesk sur la restriction par connexion et sur les segments indique que le filtre d'organisation est ignoré pour les agents connectés et que les administrateurs de la base de connaissances contournent toutes les restrictions, donc tester en tant que vous-même ne prouve rien.
- Limitez l'IA par client et testez-la sur l'historique de ce client. Un agent par client ou par marque, connecté uniquement aux sources de ce client. Lancez-le sur les anciens tickets de ce client avant qu'il ne réponde à qui que ce soit en direct.
Après le lancement, mettez la couche client sur un rythme de révision. Les articles propres aux clients vieillissent plus vite que les articles partagés, car ils dépendent d'un contrat ou d'un contact qui a pu changer. Liez leur révision à votre processus de changement de politique, pour qu'une mise à jour de contrat déclenche une mise à jour d'article. Mon article sur le contenu obsolète du centre d'aide explique comment le repérer.
MSP : Hudu et IT Glue fonctionnent déjà ainsi
Si vous êtes un MSP, votre base de connaissances par client n'est probablement pas du tout dans votre helpdesk. Elle est dans un outil de documentation, où la séparation par client est toute la conception.
| Hudu | IT Glue | |
|---|---|---|
| Conteneur par client | Espace d'entreprise | Organisation |
| Bibliothèque partagée | Base de connaissances centrale native | Une organisation partagée « Common Documents » |
| Prix | $27/utilisateur/mois en annuel, sans minimum | $29 / $38 / $44 par utilisateur/mois, minimum de 5 utilisateurs, engagement de 36 mois |
| Portail client | Utilisateurs de portail gratuits | Module MyGlue, $407/mois |
| IA | Assistant Hudini et MCP, inclus | Cooper Copilot, listé sur tous les niveaux |
Sources : tarifs Hudu et tarifs IT Glue.
Une date à surveiller : la version 2.47 de Hudu commence son déploiement le 12 octobre 2026, remplaçant les portails clients par un rôle d'utilisateur de portail. L'avertissement de Hudu lui-même est que les utilisateurs de portail hériteront de "everything their groups can see", alors que l'ancien portail ne montrait que les enregistrements marqués pour lui. Si vous partagez des documents clients via le portail de Hudu, vérifiez les permissions de vos groupes avant cette date.
Le problème de recherche ne disparaît pas non plus avec un outil dédié :
"It can be really difficult to find client specific information unless you know exactly how to search for it. There is sometimes lost time spent there."

Mon guide du système de ticketing pour MSP couvre le côté ticketing de la même pile.
Essayer eesel pour les bases de connaissances par client
Si vous assurez le support de plusieurs clients ou marques sur Zendesk, Freshdesk, Gorgias ou Zoho Desk, eesel donne à chaque client son propre coéquipier IA de helpdesk, la même configuration que je décris dans support IA pour agences. Il rejoint la file existante, se connecte par marque Zendesk ou par compte de helpdesk, et n'apprend qu'à partir du centre d'aide, des macros et des anciens tickets de ce client. Chaque source est un interrupteur, vous pouvez donc désactiver un historique de tickets dont l'agent ne devrait pas apprendre, et "uninstall from agent" retire une connexion de l'agent d'un client sans toucher aux autres.

Avant qu'un agent ne passe en production pour un client, la compétence de simulation rejoue les vrais anciens tickets de ce client et compare ses réponses à ce que votre équipe a envoyé. Les actions sont aussi par agent, donc autoriser les remboursements pour le client A ne change pas ce que peut faire l'agent du client B.
Les tarifs incluent des agents et des sièges illimités dans toutes les offres, en commençant gratuitement avec 100 crédits, puis à partir de $299 par mois pour 500 crédits, où un ticket vaut 1 crédit. Comme la facturation se fait au niveau de l'espace de travail, une agence avec six petits clients achète un seul forfait de crédits pour l'ensemble de ses tickets plutôt que six abonnements. Si vous préférez scripter un agent par client, la CLI eesel peut utiliser eesel agents create pour créer un nouvel agent et cibler n'importe lequel avec --agent, depuis un terminal ou depuis un agent de codage comme Claude Code.

Ce qu'eesel n'est pas : une plateforme d'IA en marque blanche ni un programme de revente, et ses rôles utilisateurs valent pour tout l'espace de travail plutôt que par client. Si vos clients ont besoin de leurs propres identifiants pour gérer leur propre agent, c'est une lacune aujourd'hui. Si vous voulez que l'IA de chaque client reste dans sa voie, essayez eesel gratuitement.
Comment créer des bases de connaissances par client dans Zendesk ?