

Qu'est-ce qu'un audit de la base de connaissances du support ?
Un audit de la base de connaissances du support est une revue planifiée de chaque article de votre centre d'aide (et des documents internes que lisent vos agents et l'IA) pour décider, article par article, s'il reste tel quel, est corrigé, est intégré à un autre article ou est retiré.
C'est la tâche sœur de l'analyse des lacunes de connaissances du support. L'analyse des lacunes part des questions des clients et demande "qu'est-ce qui manque ?". L'audit part des articles et demande "ce qui est là est-il toujours juste, toujours utilisé et la seule copie ?". Vous voulez les deux, mais elles produisent des listes de tâches différentes :
| Analyse des lacunes de connaissances | Audit de la base de connaissances | |
|---|---|---|
| Point de départ | Tickets, recherches sans résultat, escalades de l'IA | Votre liste d'articles publiés |
| Question à laquelle elle répond | Que demandent les clients que personne n'a rédigé ? | Chaque article est-il toujours exact, utilisé et unique ? |
| Résultat | Articles à écrire | Articles à conserver, mettre à jour, fusionner ou archiver |
| Cadence typique | Mensuelle, à partir de données de tickets récentes | Trimestrielle pour les contenus de politiques, annuelle pour le reste |
| Plus gros risque détecté | Les clients ne peuvent pas résoudre seuls une question courante | Les clients (et l'IA) reçoivent une réponse fausse ou contradictoire |
Je travaille dans la file du support d'eesel tous les jours, et l'audit est la tâche que tout le monde saute. Écrire un nouvel article (ou le générer avec l'IA) donne l'impression d'avancer. Relire 300 anciens articles ressemble à des devoirs. Mais les anciens sont ce que clients et bots lisent en ce moment, et un article faux avec aplomb fait plus de dégâts qu'un article manquant. Un commentateur d'un fil r/ITCareerQuestions l'a dit aussi bien que quiconque :
"It leads to documentation become out of date and erroneous, which is often worse than nothing at all, and perpetuates the cycle."

Pourquoi un audit compte davantage quand l'IA lit votre centre d'aide
Pendant des années, un article périmé était une fuite lente. Un client le lisait, se perdait et ouvrait un ticket. Un agent qui savait mieux répondait correctement. Le dégât se limitait à un ticket de plus.
Un agent IA supprime ce filet de sécurité. C'est le scénario classique de l'hallucination de l'IA, sauf que le modèle répète fidèlement vos propres mots périmés. Il récupère l'article qui correspond le mieux, répond d'une voix assurée, et personne entre les deux n'en sait plus. Un commentateur de r/Rag a résumé le mécanisme en une phrase :
"Your pipeline can retrieve an article successfully and still produce the wrong operational answer because the article itself is stale or incomplete."
Et voici ce que cela donne quand cela atteint un client :
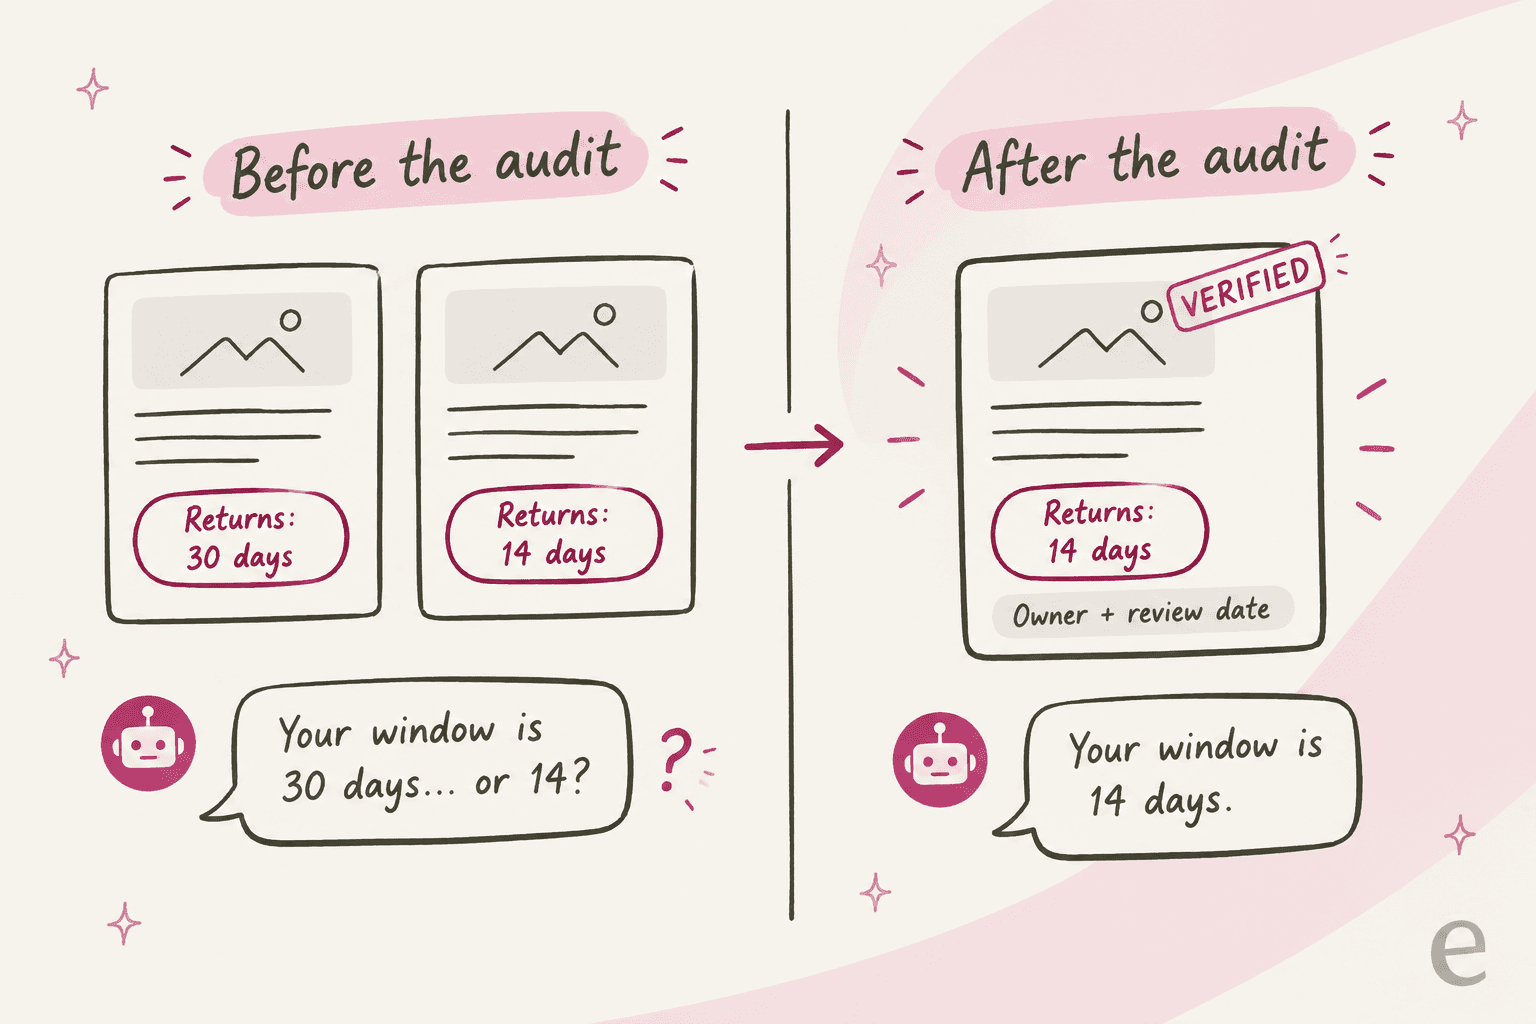
"the two docs disagreeing thing is the scariest part, bot just picks whichever one it grabbed first and sounds totally sure about it we started doing the source-of-truth cleanup after one of our bots told a customer they could return something 3 years past the actual policy window, support had to eat that one"
Les éditeurs le savent aussi. La documentation sur les connaissances de Gorgias donne l'exemple exact : "if a help center article says your return window is 30 days but a guidance says 14, AI Agent might not respond the same way every time." Zendesk note désormais les centres d'aide sur l'"AI readability" dans son Knowledge copilot, en pénalisant les articles chargés en médias, longs, non structurés ou pleins de liens. L'audit est discrètement devenu une partie de la gestion des connaissances pour les équipes de support qui utilisent un agent IA.
C'est aussi de là que vient mon propre point de vue. eesel passe depuis quelques années à placer un coéquipier IA sur de vraies files de support, et la première semaine de presque chaque déploiement devient un audit des connaissances, que quelqu'un l'ait prévu ou non. Un cas typique issu des appels commerciaux d'eesel : une marque DTC sur Gorgias avec environ 7 000 tickets e-mail par mois voulait que l'IA en résolve la moitié, et ses connaissances étaient dispersées entre des SOP dans un outil de projet, des enregistrements d'écran non transcrits et un tas de macros périmées, sans aucune FAQ sur le site. Aucune IA ne peut être plus précise que ce matériau de départ. C'est pourquoi chaque déploiement eesel est simulé sur des tickets passés avant de répondre à un vrai client : c'est dans la simulation que les articles périmés apparaissent.
Ce qu'il faut extraire avant de commencer l'audit
Un audit va vite quand les données sont dans une seule feuille de calcul avant que quiconque ouvre un article. Voici ce que je mettrais en colonnes, et pourquoi chacune mérite sa place.
| Colonne | D'où elle vient | Ce qu'elle vous apprend |
|---|---|---|
| Titre, URL, section de l'article | Export du centre d'aide ou API | L'inventaire lui-même |
| Date de dernière mise à jour | Liste d'articles ou export | Candidats à une vérification de péremption (le copilot de Zendesk considère six mois comme périmé) |
| Responsable | Auteur de l'article ou responsable assigné | Qui valide la correction |
| Vues, 90 derniers jours | Analytique du centre d'aide | Si quelqu'un le lit |
| Votes utile / pas utile | Retours sur l'article | S'il répond à la question une fois lu |
| Fois lié depuis des tickets | Liens d'articles des agents, références dans les macros | Si les agents s'y fient |
| Usage par l'IA et passages de relais | Le rapport de connaissances de votre agent IA | Si le bot le cite et si ces conversations escaladent quand même |
| Contient une politique, un prix ou un nom de forfait | Vous, en lisant le titre | S'il demande une revue trimestrielle plutôt qu'annuelle |
La dernière ligne compte plus qu'il n'y paraît. Sur les articles de politiques et de prix, une mauvaise réponse coûte de l'argent, donc je les marque en premier et je les révise à un rythme plus court. Le guide sur les changements de politique d'eesel explique quoi faire le jour où l'une de ces politiques change ; l'audit est le moyen de repérer celles qui ont changé sans que personne n'en informe le support.
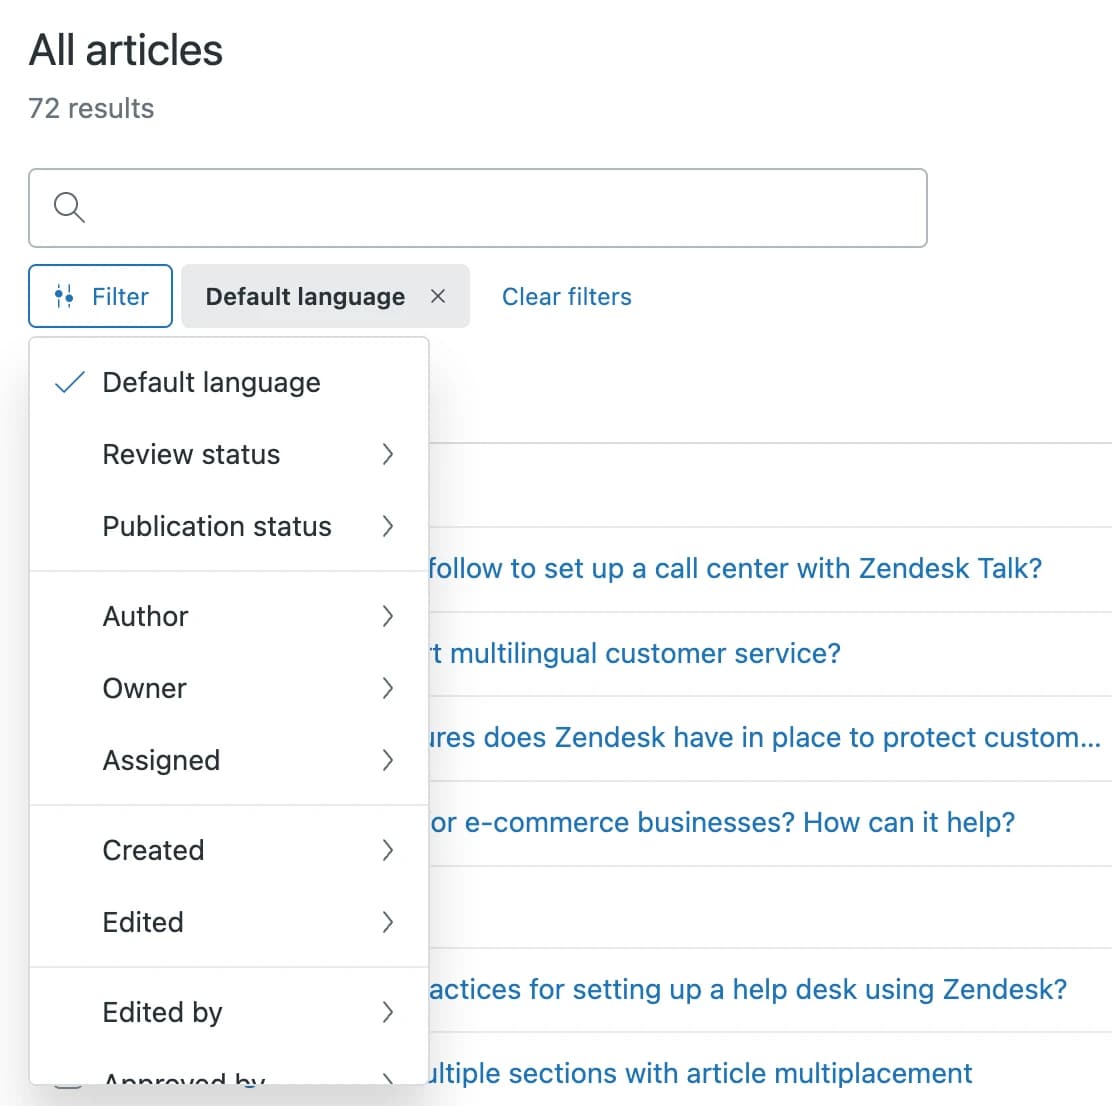
La plupart de ces colonnes viennent directement de votre helpdesk. Dans Zendesk, les listes d'articles de l'admin Knowledge se filtrent par responsable, auteur, date de création et de modification et statut de revue, et le tableau de bord Knowledge Base classe les articles par votes positifs, négatifs et nets.
Le rapport de base de connaissances curated de Freshdesk propose des listes toutes faites des "10 moins consultés" et "les plus mal notés" à partir de Pro. L'onglet Analyze de HubSpot donne les vues, les décomptes utile et pas utile et les termes de recherche sans résultat, et le rapport Docs de Help Scout marque d'un visage triste les articles sous 60 % d'évaluations positives.
Une métrique Zendesk que j'ajouterais toujours : "Tickets submitted after view" dans le jeu de données d'efficacité des pages d'Explore. Zendesk la décrit comme un moyen de trouver des "articles where users couldn't get the answers they needed." Un chiffre élevé sur un article très consulté est le signe le plus net qu'il faut le réécrire. Elle demande Suite Professional ou Explore Professional et supérieur.
Comment trier les articles : conserver, mettre à jour, fusionner ou archiver
Chaque article finit l'audit dans l'une de quatre cases. Les deux questions qui décident de la case sont simples : est-il utilisé, et est-il toujours juste ? Les doublons sont la troisième question, car deux copies d'une même réponse sont la façon dont un centre d'aide finit par se contredire.
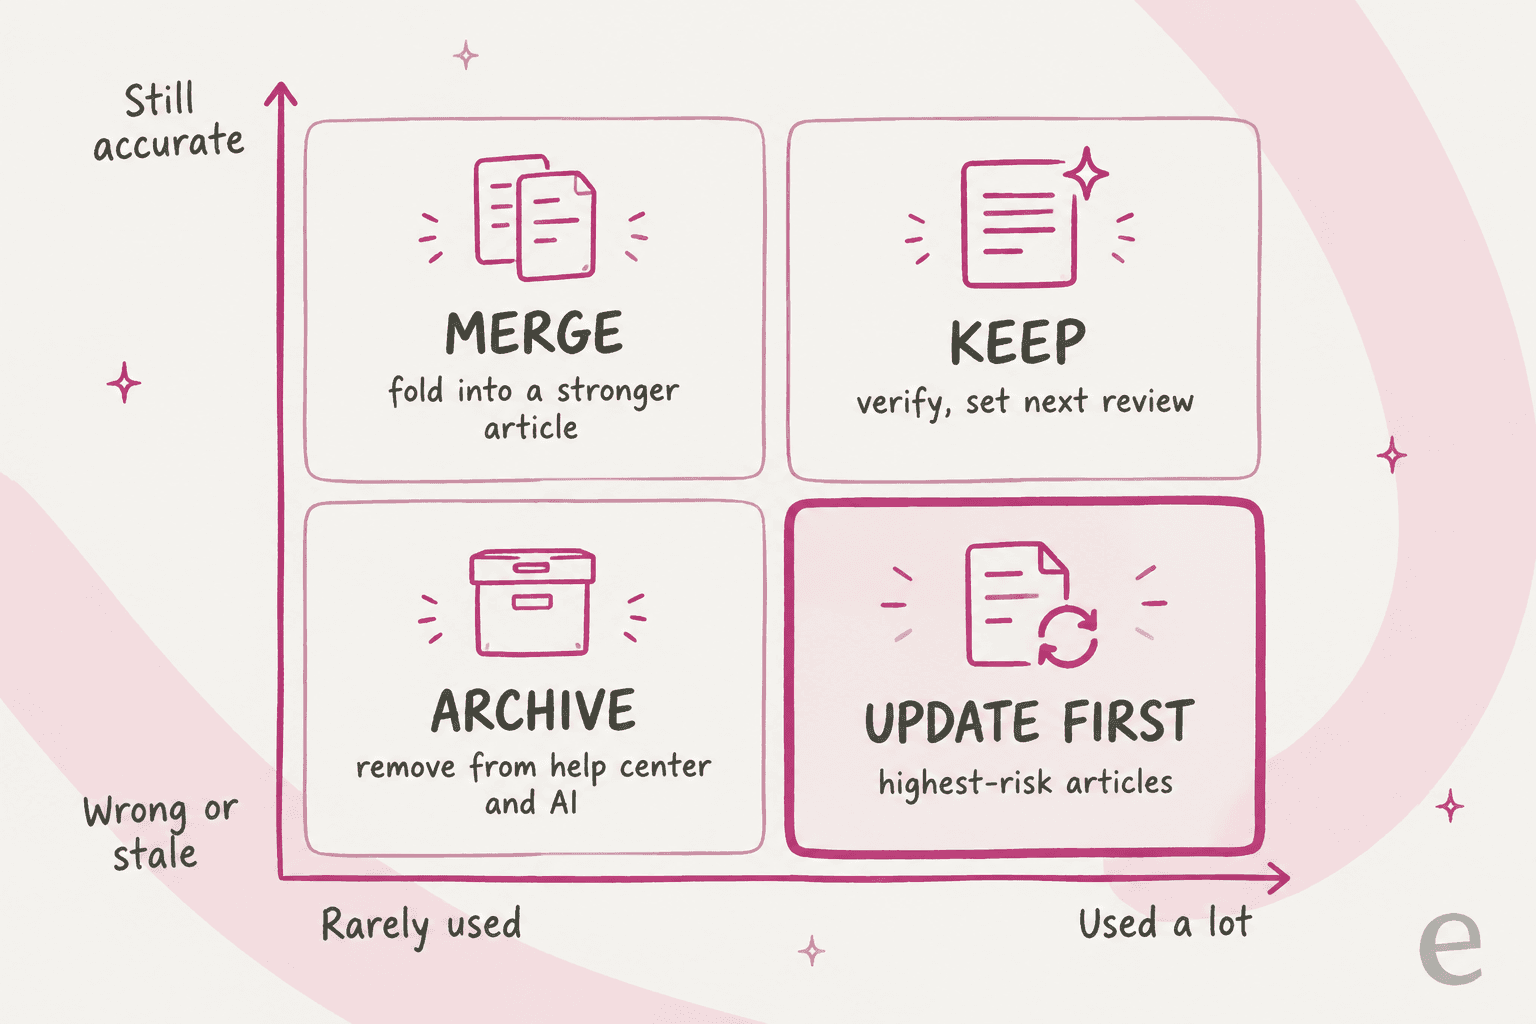
- Conserver : utilisé et exact. Marquez-le comme vérifié, nommez un responsable, fixez la prochaine date de revue.
- Mettre à jour d'abord : utilisé et faux. Ceux-là passent en tête de liste, car ce sont les articles qui induisent aujourd'hui les clients en erreur.
- Fusionner : exact, mais un second article répond à la même question. Intégrez ce qui est utile dans le plus solide et redirigez l'ancienne URL.
- Archiver : inutilisé et faux, ou portant sur une fonction ou une politique qui n'existe plus. Retirez-le du centre d'aide et de tout ce que lit votre agent IA.
Essayez sur un article de votre propre centre d'aide :
Conserver, mettre à jour, fusionner ou archiver ? Triez un article
Répondez à trois questions sur un seul article du centre d'aide. Le verdict vous dit quoi en faire dans cet audit.
1. A-t-il été utilisé ces 90 derniers jours ?Vues de l'article, liens depuis des tickets ou citations par votre agent IA.
2. Chaque information qu'il contient est-elle toujours vraie aujourd'hui ?Prix, noms de forfaits, délais de politique, captures d'écran, étapes.
3. Un autre article répond-il à la même question ?Cherchez dans le centre d'aide la question principale de l'article.
Deux arbitrages que la grille ne fait pas à votre place. D'abord, "inutilisé" ne veut pas dire "inutile". Un article exact que personne ne lit est souvent un problème de titre, pas de contenu : les clients cherchent "annuler mon abonnement" et l'article s'appelle "Gérer votre forfait". Comparez les titres avec vos termes de recherches sans résultat avant d'archiver. Ensuite, mettez en place une redirection avant d'archiver quoi que ce soit (voici comment fonctionnent les redirections dans Zendesk). Les anciens liens d'articles vivent dans des macros, des réponses enregistrées et d'anciens e-mails, et sans redirection ils cassent tous le jour où l'article disparaît.
Comment mener un audit de la base de connaissances du support, étape par étape
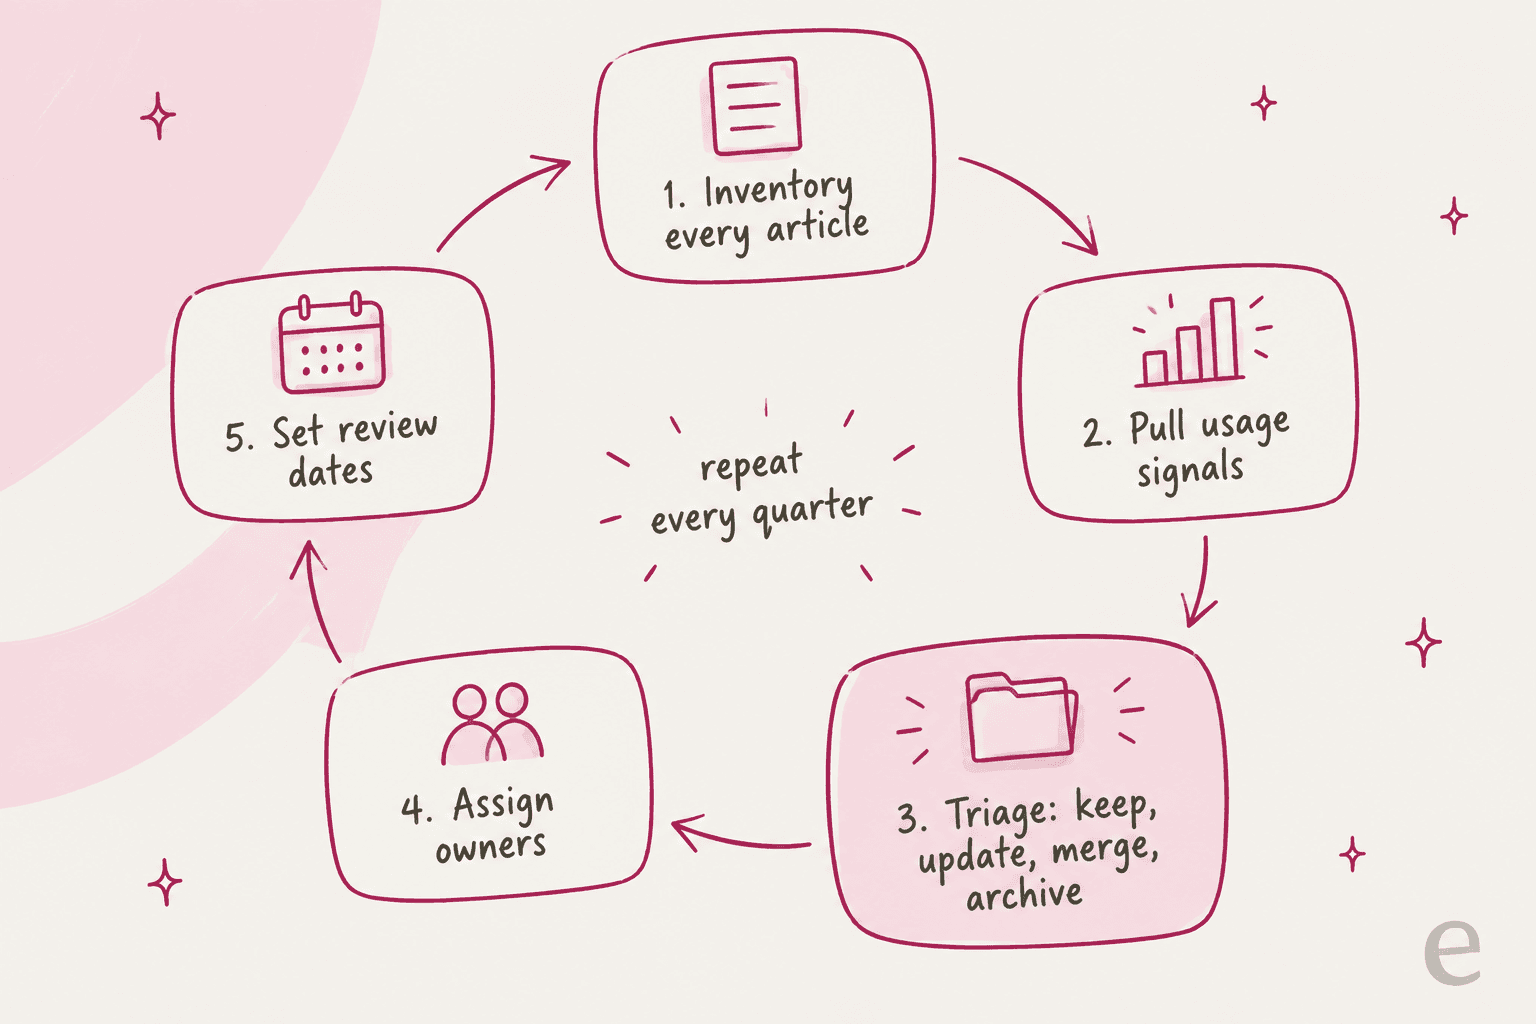
Voici la boucle que je lancerais, du début à la fin. Le premier passage est le lent. Les passages suivants vont beaucoup plus vite, car la plupart des articles atterrissent dans "conserver" et seuls ceux arrivés à échéance demandent une lecture complète.
Étape 1 : Inventoriez chaque article, y compris ceux que les clients ne voient pas
Exportez la liste complète des articles : articles publics, articles internes, brouillons et chaque version linguistique. Ajoutez ensuite les endroits que lit votre agent IA et qui ne sont pas des articles. Ce sont en général des macros et réponses enregistrées, un dossier Confluence ou Google Drive de SOP et les pages du site que l'IA explore. La documentation de l'IA de Help Scout précise que les "Improvements" d'AI Answers sont une source de connaissances distincte, donc une ancienne Improvement peut continuer à répéter une réponse périmée après que vous avez corrigé le Doc. L'audit doit couvrir chaque source, sinon l'ancienne réponse survit quelque part.
Étape 2 : Extrayez 90 jours de signaux d'usage
Renseignez les vues, les votes, les liens depuis les tickets et l'usage par l'IA pour chaque ligne. Quatre-vingt-dix jours suffisent à lisser les pics saisonniers et restent assez courts pour que les données reflètent votre produit actuel. Triez par vues, par ordre décroissant. Le haut de cette liste est l'endroit où vous passerez l'essentiel de votre temps de revue.
Étape 3 : Classez chaque article dans une case
Lisez en entier chaque article de la tranche à fort trafic. Pour la longue traîne, un coup d'œil suffit : la date de dernière mise à jour, si la fonction existe toujours et si les captures d'écran correspondent à l'interface actuelle. Le guide sur la détection des contenus périmés donne d'autres indices. Placez chacun dans conserver, mettre à jour, fusionner ou archiver. Quand deux articles répondent à la même question, décidez sur-le-champ lequel est la référence, tant que les deux sont ouverts.
Étape 4 : Corrigez par ordre de priorité
Traitez la case "mettre à jour d'abord" avant tout, puis les fusions, puis les archivages. Pour chaque article mis à jour, changez les faits, rafraîchissez les captures d'écran et réécrivez le titre avec les mots que les clients cherchent réellement. Si vous utilisez des blocs de contenu ou des extraits partagés pour des choses comme un délai de retour, mettez le bloc à jour une fois plutôt que chaque article. Retestez ensuite votre agent IA sur le sujet de l'article, car l'article n'est que la moitié de ce qu'il lit (voici pourquoi modifier un document vaut mieux que réentraîner).
Étape 5 : Attribuez des responsables et fixez des dates de revue
C'est l'étape qui décide si vous recommencez de zéro dans un an. Chaque article reçoit un responsable nommé (une personne, pas "le Support") et une date de prochaine revue. Si vous voulez une étape de validation en plus, les workflows d'approbation Zendesk en ajoutent une. J'utiliserais deux rythmes : trimestriel pour tout ce qui contient une politique, un prix, un nom de forfait ou un terme juridique, annuel pour le reste. Laissez ensuite le helpdesk relancer les gens à votre place, et c'est là qu'interviennent les outils natifs ci-dessous.
Étape 6 : Relancez la boucle chaque trimestre
Le deuxième audit est beaucoup plus rapide que le premier, car les responsables et les dates de revue font l'essentiel du travail. Chaque trimestre, extrayez des signaux frais, ne révisez que les articles arrivés à échéance ou dont les chiffres ont bougé (un pic de votes "pas utile", un bond des passages de relais de l'IA sur ce sujet) et archivez tout ce qui est resté à zéro vue pendant deux trimestres de suite.
Quels helpdesks aident à auditer, et ce qui est réservé à certains forfaits
Aucun des grands helpdesks ne fait tout l'audit pour vous, et les fonctions qui font le plus de travail se trouvent dans les forfaits supérieurs. Voici ce que chacun offre nativement, d'après la documentation de chaque éditeur.
| Helpdesk | Trouver les anciens articles | Rappels de revue ou vérification | Données d'usage par article | Archivage en masse | Notes de forfait |
|---|---|---|---|---|---|
| Zendesk | Les listes filtrent par responsable, création, modification | Règles de vérification, jusqu'à 20, exécution hebdomadaire | Vues, votes, tickets soumis après consultation | 30 articles à la fois, tous forfaits | Vérification et vérification en masse réservées à Enterprise |
| Freshdesk | Filtre par "Last modified at" | Aucun documenté | Les moins consultés, les plus mal notés, tickets de feedback | Actions en masse | Filtres, actions en masse et rapports à partir de Pro |
| Gorgias | Filtrer les connaissances par dernière mise à jour (7 à 90 jours) | Aucun documenté | Tickets, passages de relais, CSAT par article (28 jours) | Activer, désactiver, supprimer en masse | Opportunities signale les connaissances en conflit (bêta) |
| Front | Filtre par statut et date de revue | Revues planifiées avec e-mails de rappel quotidiens | Rapport de base de connaissances | Planifier des revues en masse par section | Revues à partir de Professional (65 $/siège) |
| Zoho Desk | Filtre par expire aujourd'hui, 7 ou 30 jours | Expiration d'article avec e-mails aux responsables | Tableau de bord KB, mots-clés sans résultat | Mise à jour en masse des tags, responsable, statut | Tableau de bord à partir de Standard |
| HubSpot | Liste d'articles ; date de dernière mise à jour fixée à chaque publication | Aucun ; l'agent KB (bêta) suggère des modifications | Vues, votes utiles, recherches sans résultat | Archiver et dépublier | La KB exige Service Hub Professional (90 $/siège) |
| Help Scout | Pas de tri par dernière mise à jour dans l'app (API seulement) | Aucun documenté | Évaluations, recherches sans résultat | Pas de modification en masse dans l'app | Historique des rapports : 2 ans en Standard |
Quelques-uns méritent un examen plus attentif, car ils changent la part de l'audit que vous faites à la main.
Zendesk : règles de vérification et Knowledge copilot
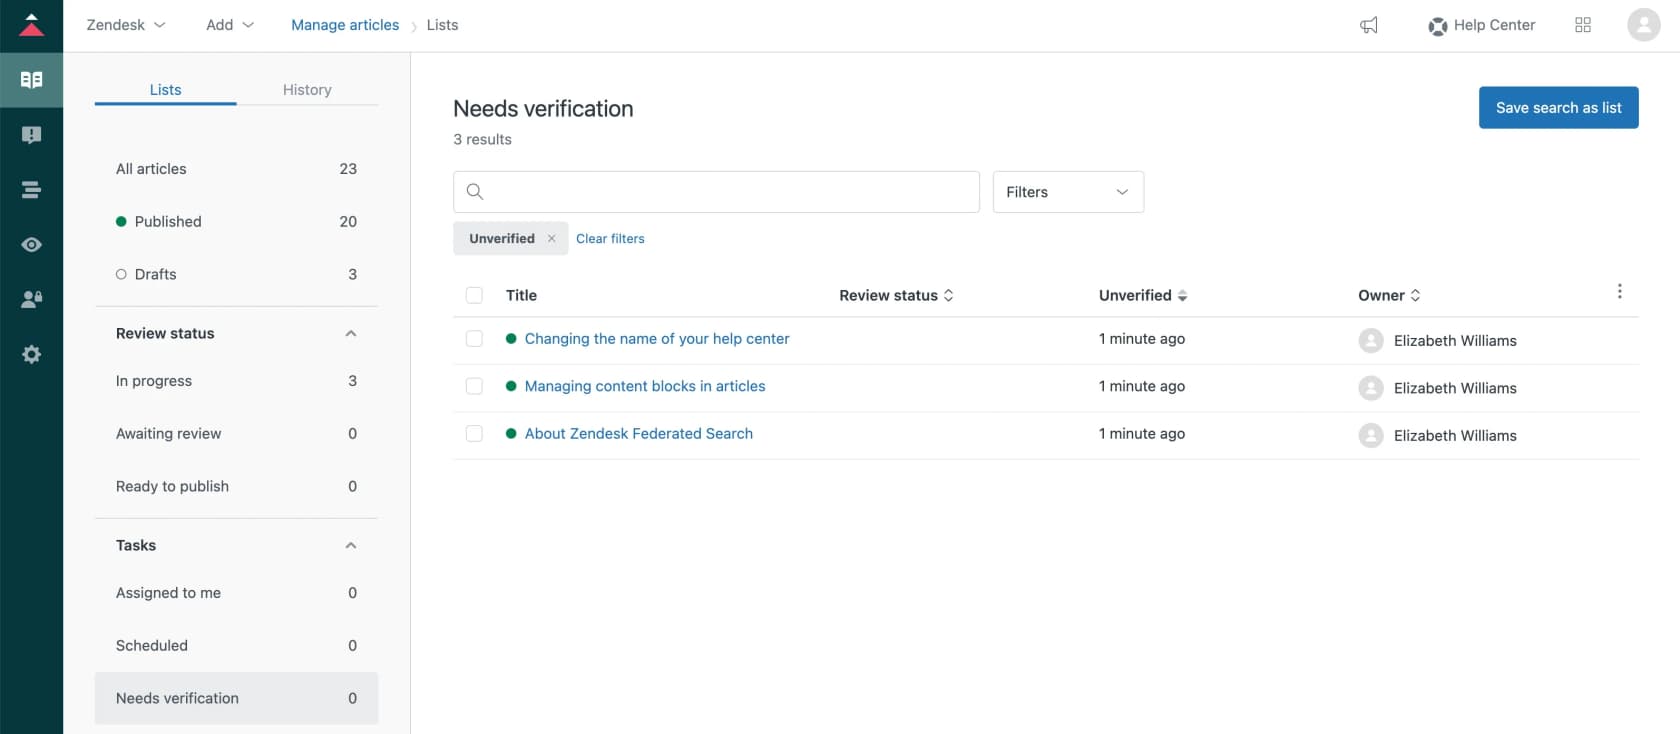
Zendesk a la boîte à outils la plus complète, répartie entre les forfaits, et son historique des versions d'articles rend les retours en arrière sûrs. La vérification d'articles permet de créer jusqu'à 20 règles avec une fréquence (deux semaines, six mois, un an) et des filtres par marque, section ou libellé. Les règles s'exécutent chaque semaine, les articles non vérifiés atterrissent dans une liste "Needs verification" et les responsables reçoivent des e-mails bimensuels jusqu'à ce qu'ils vérifient. C'est exactement l'habitude de date de revue de l'étape 5, automatisée, mais elle exige Suite Enterprise ou Knowledge Enterprise, un palier sur devis uniquement.
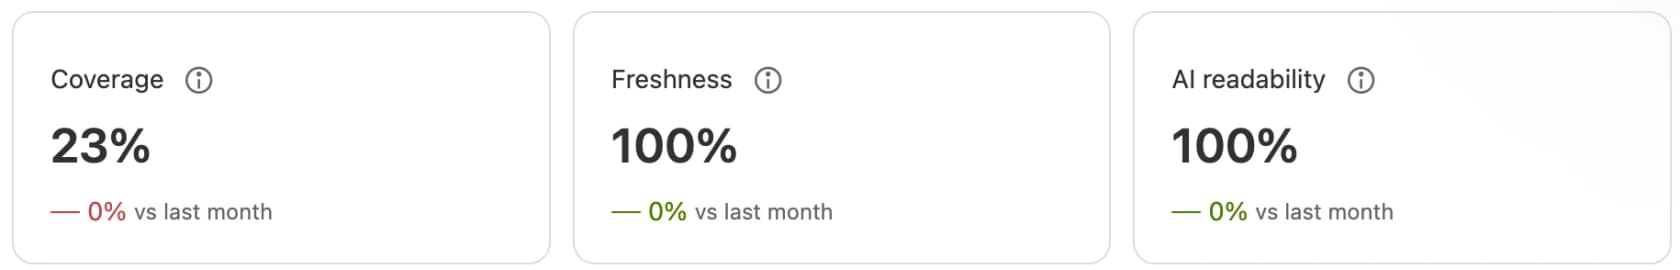
Le plus récent est Knowledge copilot, un programme d'accès anticipé à partir de Suite Professional. Il note votre centre d'aide chaque semaine sur Coverage (combien de problèmes courants de tickets ont un article), Freshness (les articles non mis à jour depuis six mois tirent la note vers le bas) et AI readability, puis suggère des tâches de création, de mise à jour ou de refus. Rien ne se publie tout seul ; tout arrive en brouillon. Voyez-le comme un tableau de bord d'audit permanent plutôt qu'un remplacement de l'audit.
Pour le nettoyage lui-même, Zendesk permet de sélectionner 30 articles à la fois et de les archiver sur tous les forfaits. Deux choses à savoir avant : archiver supprime l'article et toutes ses traductions, et seuls les admins Knowledge peuvent voir ou restaurer les articles archivés, qui reviennent en brouillons. Les articles archivés ne comptent d'ailleurs plus dans la limite de 40 000 articles de Zendesk.
Front : revues planifiées avec rappels
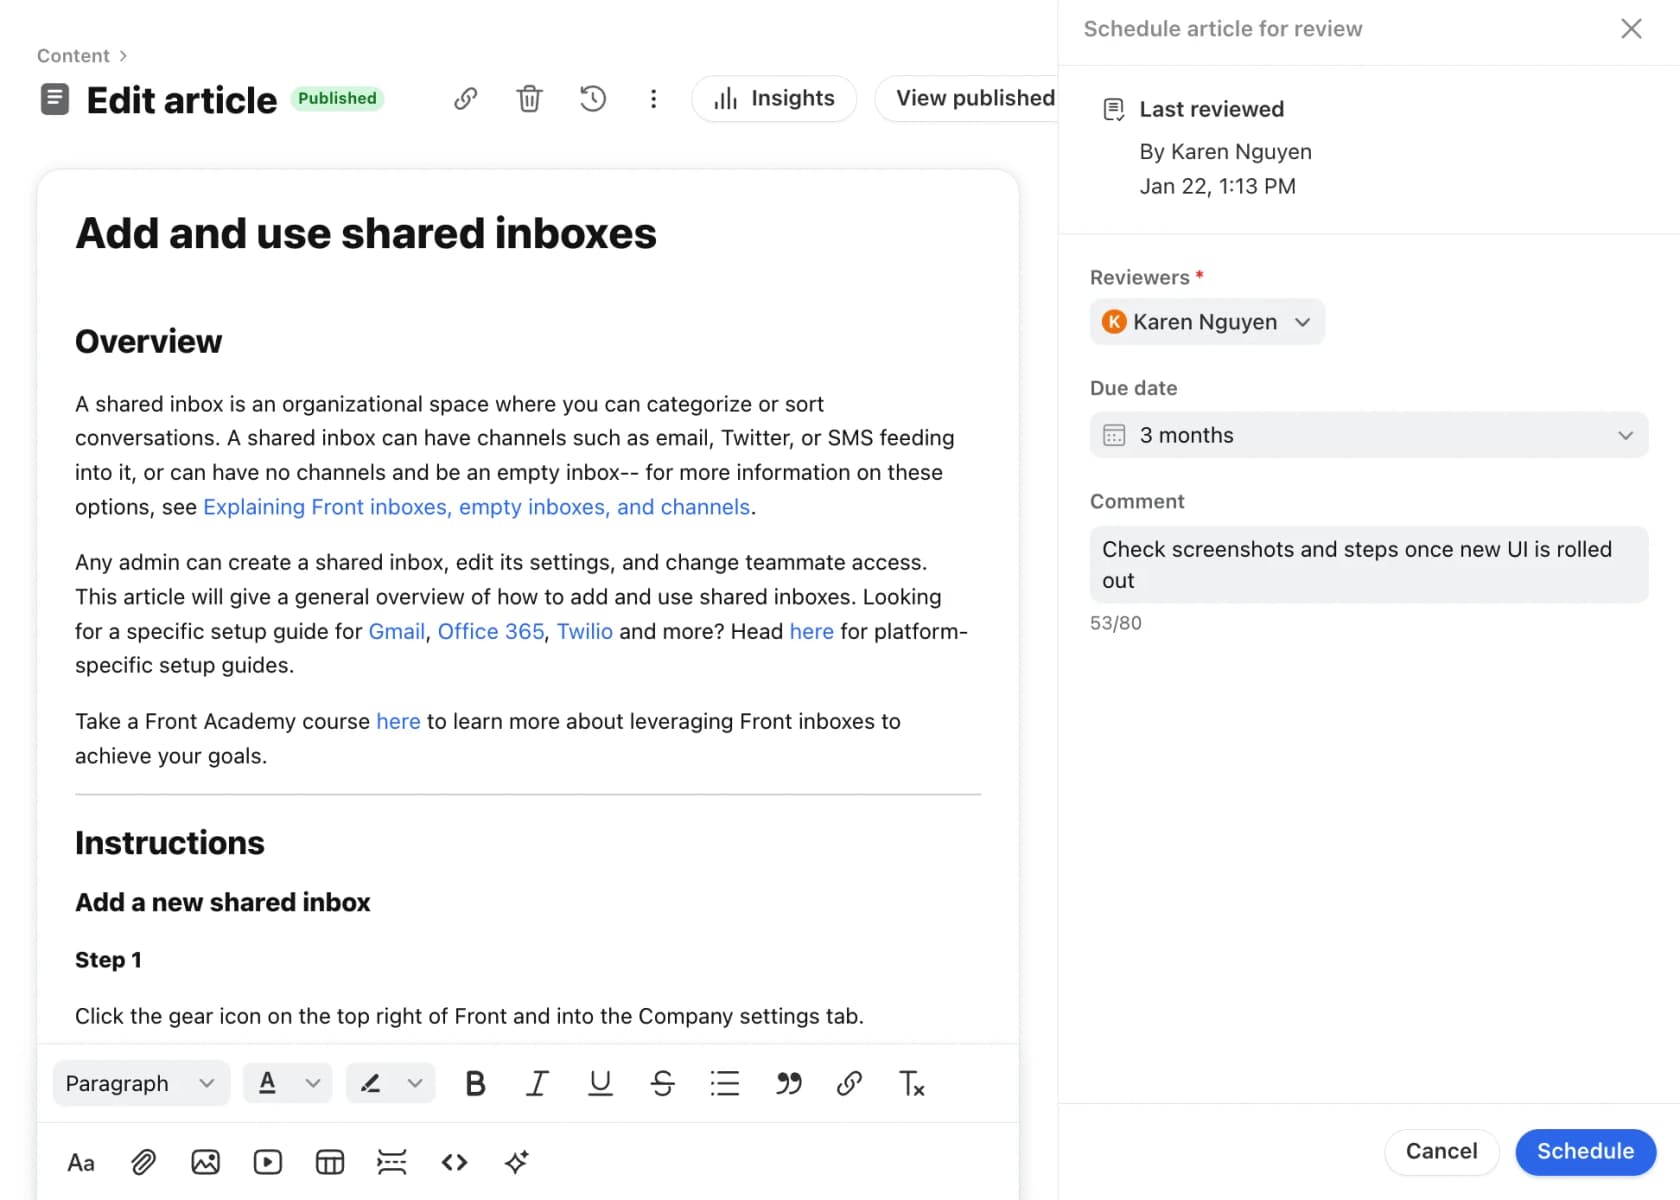
Les revues planifiées de Front sont la version la plus propre de "fixez une date de revue et soyez relancé". Vous choisissez des relecteurs, une échéance et un commentaire ; les relecteurs reçoivent chaque jour un e-mail de rappel listant les revues du jour et celles en retard, et vous pouvez planifier ou clôturer des revues en masse par catégorie ou section. C'est dans le forfait Professional actuel (65 $ par siège et par mois) et au-dessus.
Zoho Desk : des articles qui expirent tout seuls
Zoho Desk est le seul du groupe à pouvoir retirer un article automatiquement. Vous fixez une date d'expiration et l'article "will no longer be available in the help center" quand elle arrive ; le responsable reçoit des e-mails sept jours avant, la veille et à l'expiration. Pour une promotion saisonnière ou une politique limitée dans le temps, c'est l'audit qui se fait tout seul. Son tableau de bord de base de connaissances liste aussi les mots-clés de recherche "Failed" à partir de Standard (14 $ par agent et par mois en facturation annuelle).
Gorgias : usage par article et détecteur de conflits
Gorgias s'appuie sur les données d'usage. Chaque élément de connaissance affiche des statistiques de performance (volume de tickets, passages de relais, CSAT moyen et intent) sur les 28 derniers jours, et vous pouvez filtrer les connaissances par dernière mise à jour (7, 30, 60 ou 90 jours). Le point fort pour les audits est Opportunities, une bêta qui signale des éléments "Resolve knowledge conflict" et montre côte à côte les deux éléments contradictoires. C'est la case fusionner, trouvée pour vous.
Freshdesk, HubSpot et Help Scout : des rapports, pas des rappels
Ces trois-là donnent de bonnes données d'usage et vous laissent le calendrier de revue. Freshdesk appelle ses articles des articles de solutions.
Freshdesk transforme les retours des lecteurs en tickets : quand quelqu'un vote "No" sur un article et ajoute un commentaire, il devient un ticket avec l'auteur de l'article ajouté comme observateur, un signal d'audit gratuit.
La base de connaissances de HubSpot n'a pas de fonction de date de revue ; son agent de base de connaissances en bêta suggère des modifications pour les articles peu clairs ou périmés, à 200 HubSpot Credits par article généré.
Help Scout Docs conserve un historique des révisions mais n'a pas de revue planifiée, donc un rappel dans votre calendrier est votre règle de vérification.
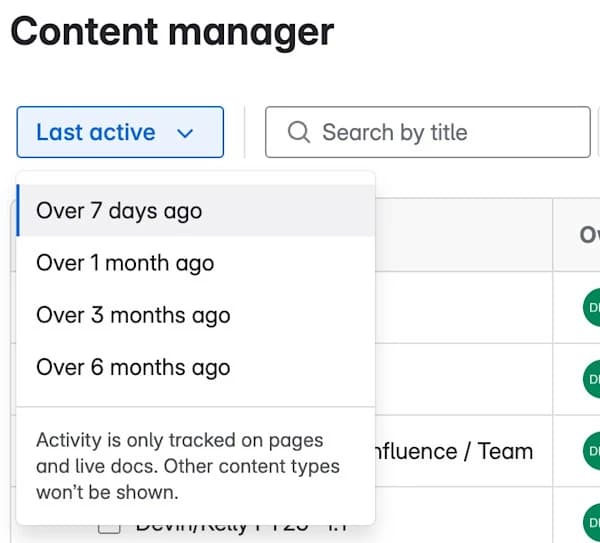
Si votre base de connaissances interne vit dans Confluence, le gestionnaire de contenu de Premium et Enterprise filtre les pages par "Last active" (plus de 7 jours à plus de 6 mois) et par responsables désactivés, et archive jusqu'à 500 pages à la fois. Les pages archivées gardent des liens fonctionnels, ce qui fait de Confluence l'endroit le plus doux pour être radical.
Ce que disent les équipes de support sur l'entretien d'une base de connaissances
Les fils de communauté sur le sujet sont d'une cohérence rafraîchissante : l'outillage compte moins que le fait que quelqu'un s'approprie la tâche.
La demande la plus courante est celle que Zendesk a déjà construite, derrière un mur de forfait. Un admin Zendesk l'a demandée sur r/Zendesk :
"Has anyone found an integration or way to audit articles yearly? It would be nice if there was a way to set a "renewal date" or something similar that would notify the author on a set date."
Un jour plus tard, après qu'on lui a indiqué la vérification d'articles, le même admin a ajouté : "Looks like Enterprise level is required and we are on professional." C'est le trou que la plupart des équipes de taille moyenne comblent avec une feuille de calcul et un rappel de calendrier.
Le modèle responsable plus expiration a ses fans, et un mode de défaillance connu. Un commentateur de Hacker News a proposé de traiter la documentation comme la littérature médicale :
"every page is owned and every page has an expiry: when a page expires, the owners are obligated to review it."

La réponse dans le même fil mérite d'être collée au-dessus de votre écran :
"This becomes a problem if multiple people leave at once or someone is very busy when expiration comes up and rubber stamps the renewal with outdated information..."
C'est pourquoi j'associerais les dates de revue aux données d'usage, pour qu'une revue qui arrive à échéance sur un article de politique très consulté reçoive une vraie lecture et pas un simple clic. Côté usage, un sysadmin a décrit une règle simple :
"if an article has not been viewed in one or two years then it automaticlly gets archieved and not part of then main search process, or it flags itself for review and then gets archieved."
Et quand le bot se met à donner des réponses différentes à la même question, ce commentaire de r/customerexperience nomme la cause habituelle :
"They are pulling from different KB entries, or one entry is outdated and the others are not, so the bot is not actually being inconsistent. It is being accurate to three slightly different pieces of content that should have been one."
"Three pieces of content that should have been one", c'est la case fusionner en une phrase. Et si l'arriéré paraît trop lourd, résistez à l'envie de repartir d'une base de connaissances neuve. Comme l'a averti un commentateur de HN, la nouvelle "quickly falls into disarray just the same", et vous cherchez alors dans deux. Auditez celle que vous avez.
Erreurs qui gaspillent un audit de la base de connaissances
- Auditer les articles mais pas les macros. Les agents collent des macros bien plus souvent qu'ils ne lient des articles, et votre agent IA peut aussi les lire. Une macro qui cite le délai de retour de l'an dernier défait l'article que vous venez de corriger. Les équipes Zendesk peuvent exporter les macros pour les parcourir dans un seul fichier. Le guide de gestion des macros couvre le nettoyage.
- Archiver sans redirections. Les anciennes URL vivent dans des réponses enregistrées, d'anciens e-mails et d'autres articles. Archiver sans redirection transforme une réponse périmée en lien mort.
- Corriger le centre d'aide et oublier les autres sources de l'IA. Si votre agent IA lit aussi un site exploré, un dossier Google Drive ou un wiki interne, l'ancienne réponse y survit jusqu'à ce que cette source soit resynchronisée ou que l'ancien fichier soit retiré.
- Aucun responsable à la fin. Un audit sans responsables ni dates de revue est un nettoyage ponctuel, pas de la gestion de base de connaissances. Vous serez de retour à la case départ en moins d'un an.
- Traiter "non consulté" comme "non nécessaire". Vérifiez d'abord le titre par rapport aux recherches sans résultat, ou faites une rapide vérification des lacunes de connaissances. Beaucoup d'articles exacts à faible trafic portent simplement le nom de votre équipe plutôt que celui du client.
- Vouloir tout faire d'une traite. Faites correctement la tranche à fort trafic, puis grignotez la longue traîne dans les semaines suivantes. Un audit partiel terminé vaut mieux qu'un audit complet abandonné.
eesel pour l'audit de votre base de connaissances du support
Un audit corrige les articles. Le plus difficile est de savoir, semaine après semaine, de quel article chaque réponse est réellement issue. C'est ce que le coéquipier helpdesk IA d'eesel est conçu pour vous montrer.
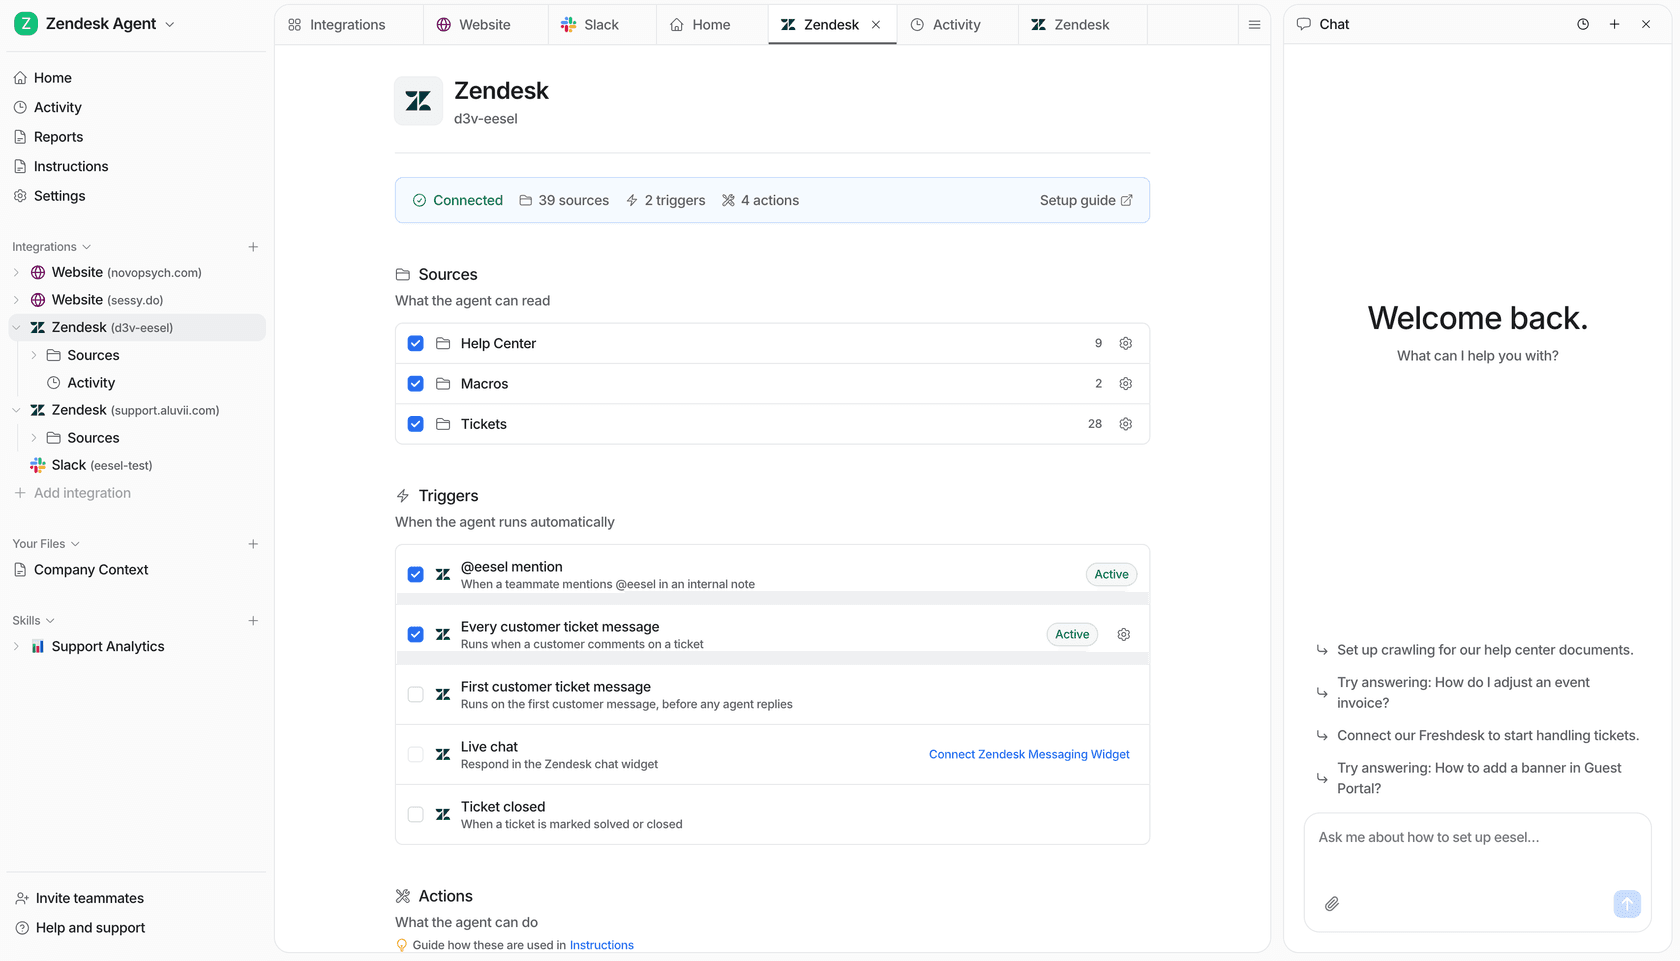
Il se branche sur Zendesk, Freshdesk et le reste de votre pile helpdesk, et lit votre centre d'aide, vos macros et vos tickets passés avec des documents dans Confluence, Google Drive ou Notion. Chaque source a son propre interrupteur, donc le jour où votre audit archive un dossier périmé, vous le désactivez sans rien déconnecter.
Trois choses le rendent utile pour un audit en particulier :
- Chaque réponse montre ce qu'elle a lu. Le journal d'activité de chaque ticket liste les sources que l'agent a consultées et s'il a rencontré une lacune de connaissances, et chaque brouillon nomme l'article utilisé. Si une réponse s'appuie sur un article périmé, vous voyez lequel.
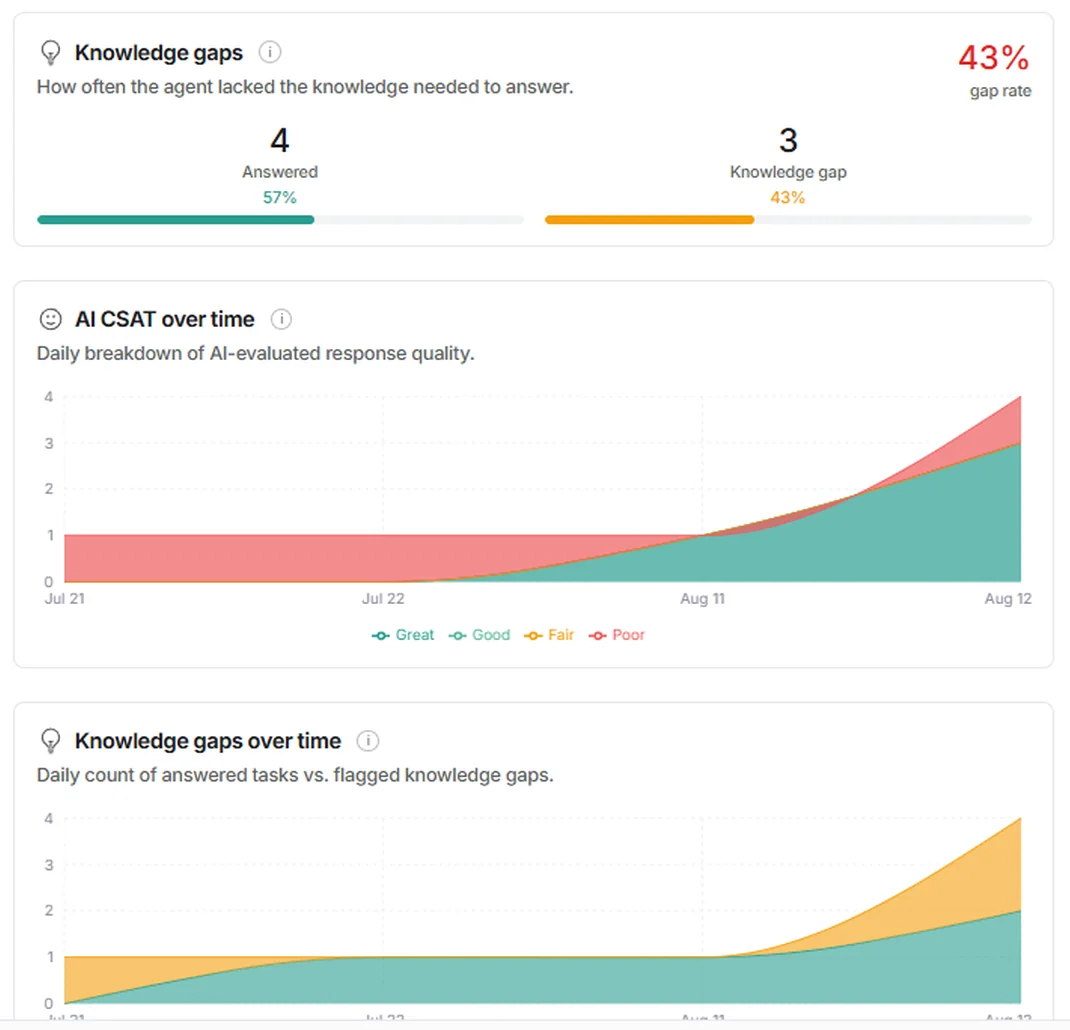
- Les lacunes sont comptées pour vous. La page Reports a une carte Knowledge gaps et une courbe de tendance. La documentation d'eesel le dit simplement : "A knowledge gap is your agent telling you something is missing." La skill Update knowledge base rédige ensuite les articles manquants pour votre relecture.
- Vous pouvez retester après le nettoyage. La skill Simulation rejoue de vrais tickets passés, note chaque réponse par rapport à ce que votre équipe a envoyé et suggère des corrections, sans rien envoyer à un client.
Là où ce n'est pas le bon outil : eesel ne fera pas l'audit à votre place. Les décisions de conserver, mettre à jour, fusionner et archiver restent à votre équipe, et ses connexions au site web, à Google Drive et à Confluence sont en lecture seule. Ce qu'il vous donne, ce sont les preuves de l'endroit où regarder en premier. Les tarifs commencent avec 100 crédits gratuits sans carte, puis le forfait Teammate à partir de 299 $ par mois pour 500 crédits, où un ticket coûte un crédit quelle que soit sa durée. Essayez eesel sur votre propre centre d'aide et voyez quels articles il consulte en premier.
Comment décider de mettre à jour, fusionner ou archiver un article du centre d'aide ?