

L'essentiel
La recherche de réponses internes pour le support est la façon dont un agent trouve la bonne réponse à un ticket dans les connaissances de votre propre entreprise : centre d'aide, notes internes, macros, anciens tickets, fils Slack et wikis. Le problème n'est que rarement que la réponse n'existe pas. C'est que la recherche remet à l'agent dix documents alors qu'il lui fallait une phrase et sa source.
Ce qui marche, c'est la recherche de réponses, pas une meilleure barre de recherche : l'agent pose une question complète, reçoit une réponse courte qui nomme l'article ou le ticket d'où elle vient, et se voit dire clairement quand rien ne la couvre. Zendesk Copilot ($50 par agent et par mois à partir de Professional) et Front Copilot ($20 par siège) cherchent tous deux dans d'anciens tickets ainsi que dans Confluence ou Notion. Le panneau Freddy de Freshdesk cite des tickets mais reste en accès anticipé. Les outils de recherche d'entreprise comme Glean et Guru atteignent Slack et les wikis, mais les agents les utilisent surtout en dehors du ticket.
Si vous voulez un coéquipier qui répond dans Slack et dans le ticket à partir du même centre d'aide, des mêmes anciens tickets, de Confluence et de Notion, avec la source liée à chaque fois, c'est ce que fait le coéquipier IA de helpdesk d'eesel. Gratuit à essayer avec 100 crédits.
Qu'est-ce que la recherche de réponses internes pour le support ?
La recherche de réponses internes pour le support est le versant de vos connaissances tourné vers l'agent : l'endroit où un agent va en plein ticket pour vérifier une politique, une solution, une exception, ou "a-t-on déjà vu ça ?". Elle diffère de la recherche du centre d'aide qu'utilisent vos clients sur deux points. Elle atteint du contenu que les clients ne voient jamais (articles internes uniquement, macros, historique des tickets, Slack), et la personne qui cherche est sous pression, avec un client qui attend.
Je travaille sur le produit d'eesel, je construis les fonctionnalités et les agents IA qui se placent dans les files de support, et eesel passe des années à mettre de l'IA sur des helpdesks en production, sur des milliers de vrais tickets. La demande la plus fréquente des responsables support n'est pas "dévier plus de tickets". C'est une version de "mes agents ne trouvent pas ce que nous savons déjà". Un responsable support d'une société de services informatiques du secteur public a dit à l'équipe d'eesel lors d'un appel commercial qu'ils perdaient deux agents seniors cette année-là et voulaient capter leurs connaissances dans une IA avant leur départ. Un autre, une équipe de support matériel, en a fait une exigence ferme : chaque réponse donnée à un agent doit citer son origine.
Ces deux demandes sont tout le sujet en miniature. Les connaissances existent, éparpillées. Et une réponse que personne ne peut retracer est une réponse à laquelle personne ne fera confiance.
Pourquoi les agents ne trouvent toujours pas les réponses
La plupart des équipes ont déjà une recherche. Chaque helpdesk a un panneau de connaissances, chaque wiki une barre de recherche, et Slack un champ de recherche. Les agents sollicitent pourtant toujours la personne la plus expérimentée de l'équipe. Voici ce qui se passe.
La recherche par mots-clés ne marche que si vous connaissez déjà la réponse. Si un agent ignore que le document s'appelle "Chargeback handling (EU)", il ne le trouvera pas en tapant "client a contesté le paiement". Un agent de centre d'appels a décrit l'amélioration promise comme "comme Google" :
"Yes, you (technically) no longer have to know the exact name of the document to find what you're looking for, but now instead vital documents are buried under 50 other documents even when you put in the exact document name."

La réponse n'est généralement pas dans le centre d'aide. Les articles publics propres couvrent les questions évidentes. Les épineuses vivent dans d'anciens tickets, des notes internes, un fil Slack de mars ou la mémoire d'un agent senior. Un commentateur de r/CustomerSuccess l'a exposé mieux que je ne saurais le faire :
"The real context is usually scattered across old tickets, internal notes, product quirks, edge cases, sales promises, customer-specific exceptions, random Slack/Teams threads, and the stuff senior support people just "know". If the bot only has a clean help center and some docs, it will answer the obvious questions and fall apart on anything that actually needs judgement."
Quand la recherche échoue, les gens deviennent le moteur de recherche. C'est le coût caché. Chaque "petite question" atterrit chez vos agents les plus expérimentés, qui répondent ensuite la même chose à chaque nouvelle recrue. Un sysadmin a résumé où cela mène :
"This means I'll need to announce that I documented a process. In my experience, people remember that announcement... and then just ask me how to do it instead of looking at the docs."
La recherche trouve la version périmée aussi volontiers que la version actuelle. Deux politiques de remboursement, une de l'an dernier, toutes deux correspondent à la requête. L'agent choisit la mauvaise et le client reçoit une réponse assurée mais obsolète. C'est pourquoi un audit de la base de connaissances et la recherche de réponses vont ensemble : la recherche de réponses rend le contenu périmé plus visible, pas moins, car chaque réponse pointe vers l'article utilisé.
Recherche contre réponse : le changement qui compte
Voici le recadrage que je défendrais auprès de toute équipe qui s'équipe. La partie coûteuse pour trouver une réponse n'a jamais été de taper la requête. C'est ce qui vient ensuite : ouvrir quatre onglets, parcourir chacun, déterminer lequel est à jour, puis le réécrire avec ses propres mots pour le client. Un meilleur algorithme de classement fait gagner quelques secondes à la première étape et laisse le reste intact.
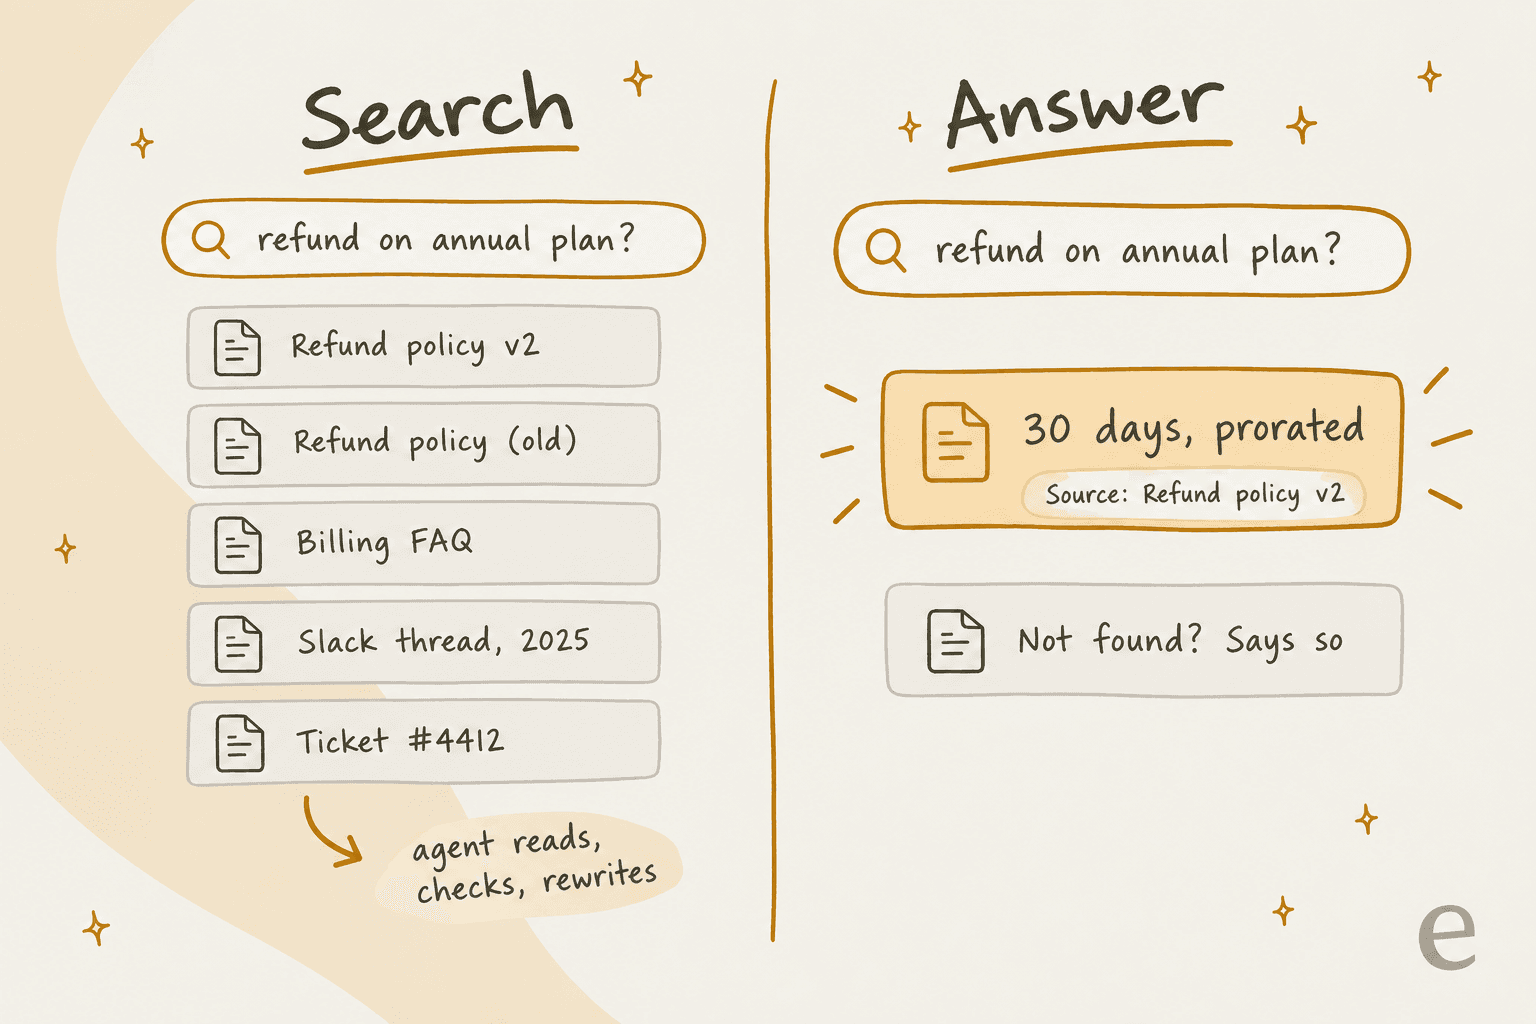
La recherche de réponses change l'unité de sortie. Vous posez une question complète, elle lit les candidats pour vous et renvoie une réponse courte avec un lien vers la source. Trois propriétés distinguent une recherche de réponses utile d'un chatbot qui paraît sûr de lui :
- Elle cite. Chaque réponse nomme l'article, le ticket ou la page derrière elle, pour que l'agent puisse vérifier en un clic avant d'envoyer.
- Elle avoue ses lacunes. "Je n'ai pas trouvé" est une fonctionnalité. Cela dit à l'agent d'escalader, et cela vous dit quel article écrire ensuite (c'est le cœur d'une analyse des lacunes de connaissances).
- Elle lit les sources désordonnées. Anciens tickets et notes internes, pas seulement le centre d'aide public, car c'est là que vivent les cas limites.
La documentation même de Zendesk pousse les agents dans ce sens : les réponses rapides ne renvoient souvent rien pour des requêtes d'un seul mot, et Zendesk recommande de formuler une question complète.
Les trois façons dont les équipes mettent en place la recherche de réponses
Il existe trois grandes configurations. La plupart des équipes en combinent deux.
- Recherche native du helpdesk. Le panneau de connaissances et le copilote IA intégrés à Zendesk, Freshdesk, Front et les autres. Elle vit dans le ticket. La couverture dépend beaucoup du forfait et des modules complémentaires.
- Recherche d'entreprise. Des outils comme Glean, Guru, GoSearch, Atlassian Rovo, la recherche d'entreprise de Slack et Notion AI. Ils sont forts sur Slack et les wikis, et quelques-uns indexent les tickets du helpdesk, mais la plupart s'ouvrent dans un onglet, une barre latérale ou une application de chat séparés.
- Un coéquipier IA. Un agent connecté au helpdesk et au wiki, qui répond dans Slack et rédige dans le ticket, à partir du même fonds de connaissances.
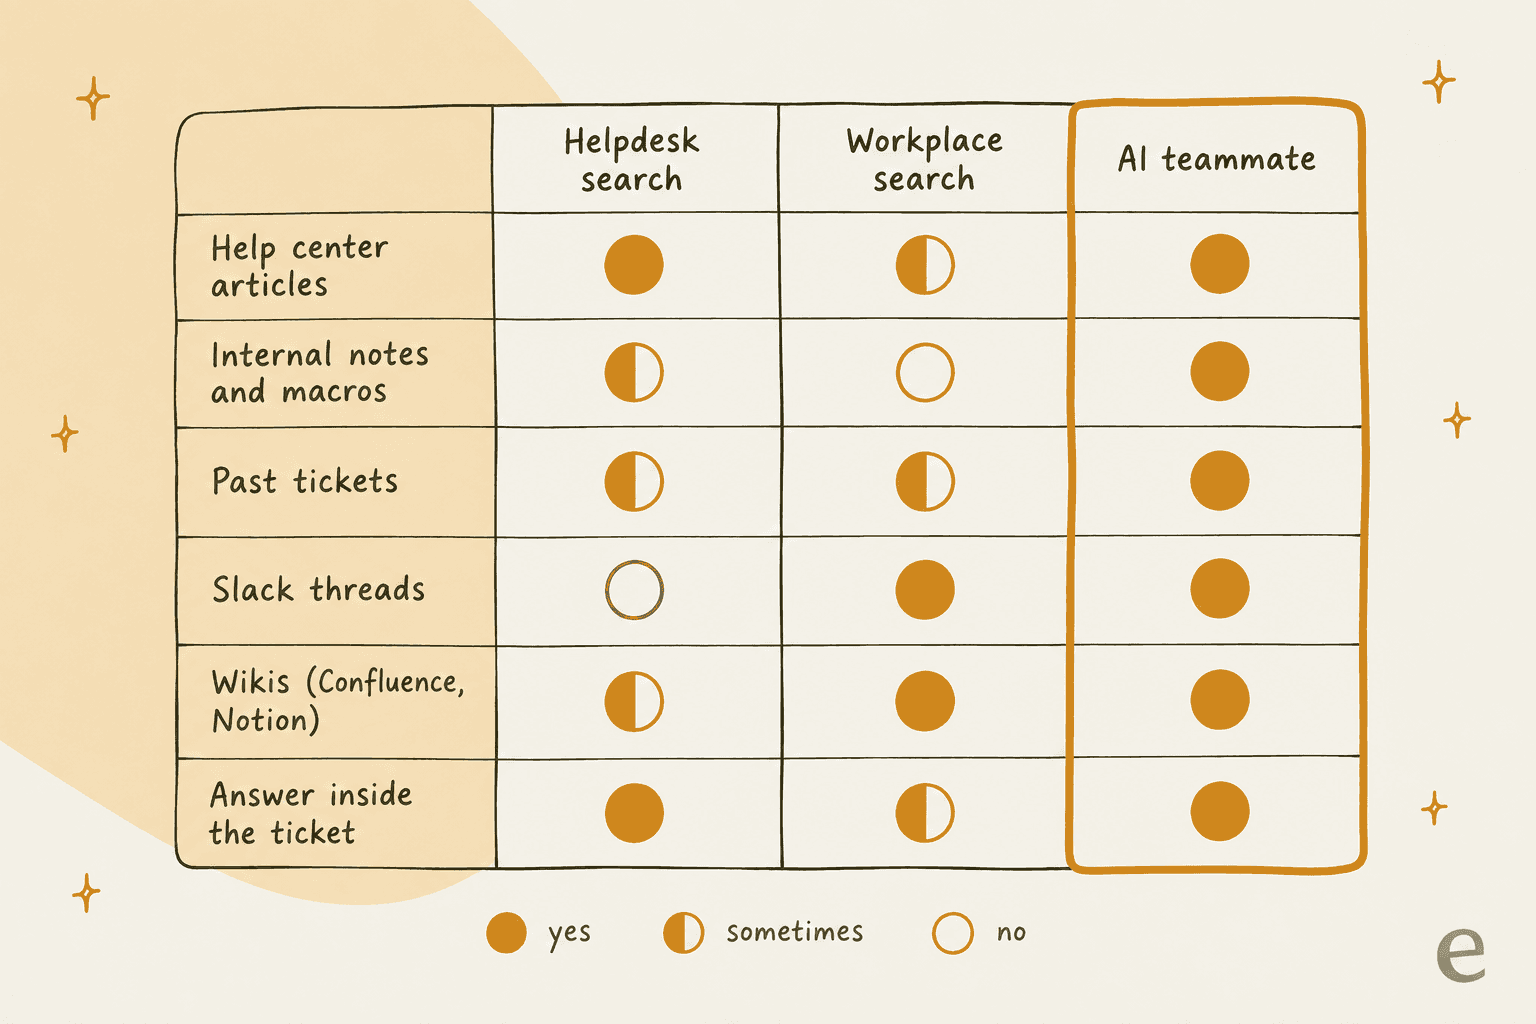
Voici comment la couverture se compare généralement selon les sources qui comptent pour le support :
Pas sûr de ce qui vous convient ? Ce sélecteur parcourt les situations les plus courantes que je rencontre :
Où se trouve généralement la réponse dont vos agents ont besoin ?
Choisissez la plus proche. La carte montre par où je commencerais.
Ce que chaque helpdesk offre nativement aux agents
Avant d'acheter quoi que ce soit, vérifiez ce que vous payez déjà. Voici ce que six helpdesks offrent à l'agent dans le ticket, d'après leurs propres documents et pages de tarifs en octobre 2026.
| Helpdesk | Où l'agent cherche | Sources couvertes | Anciens tickets ? | Cite la source ? | Forfait et prix |
|---|---|---|---|---|---|
| Zendesk | Panneau de connaissances dans le ticket, réponses rapides IA ; Copilot auto assist | Centre d'aide, communauté, jusqu'à 50 sources externes ; articles internes dans auto assist | Oui, avec Copilot | Oui | Suite Team $55, Professional $115 par agent/mois ; Copilot $50/agent/mois, Professional+ |
| Freshdesk | Panneau Freddy AI ("Ask me anything"), Article Suggester | Articles de solutions, réponses prédéfinies, tickets résolus | Oui (24 heures de décalage) | Oui | Pro $55, Enterprise $89 + Freddy AI Copilot $29/agent/mois |
| HubSpot Service Hub | Recommandation de réponse dans le fil du ticket | Articles de la base, pages de site, blogs, fichiers, URL | Non | Si "Show citations" est activé | Professional à partir de $90/siège + $1,500 d'onboarding |
| Help Scout | Recherche de liens Docs via le menu "/", AI Draft | Articles Docs, conversations passées | Oui, dans AI Drafts | Non précisé | Plus $45, Pro $75 par utilisateur/mois |
| Gorgias | Recherche de macros avec les 3 meilleures choisies par IA | Macros (Knowledge alimente l'agent IA côté acheteur) | Aucune recherche côté agent trouvée | s. o. | À partir de $40/mois, selon le volume de tickets |
| Front | Barre latérale Copilot, réponses suggérées | Base Front, sites web, Confluence, Notion, Google Drive, Guru, SharePoint, etc. | Oui | Oui | Copilot $20/siège/mois ; inclus dans Enterprise $105 |
Zendesk : réponses rapides plus Copilot
Dans un ticket Zendesk, l'agent clique sur l'icône Knowledge du panneau de contexte. Il suggère automatiquement des articles pour le ticket, et si l'agent saisit une question, la recherche générative affiche une réponse rapide au-dessus des résultats avec un lien "AI suggestion based on" vers l'article utilisé (documentation Zendesk).
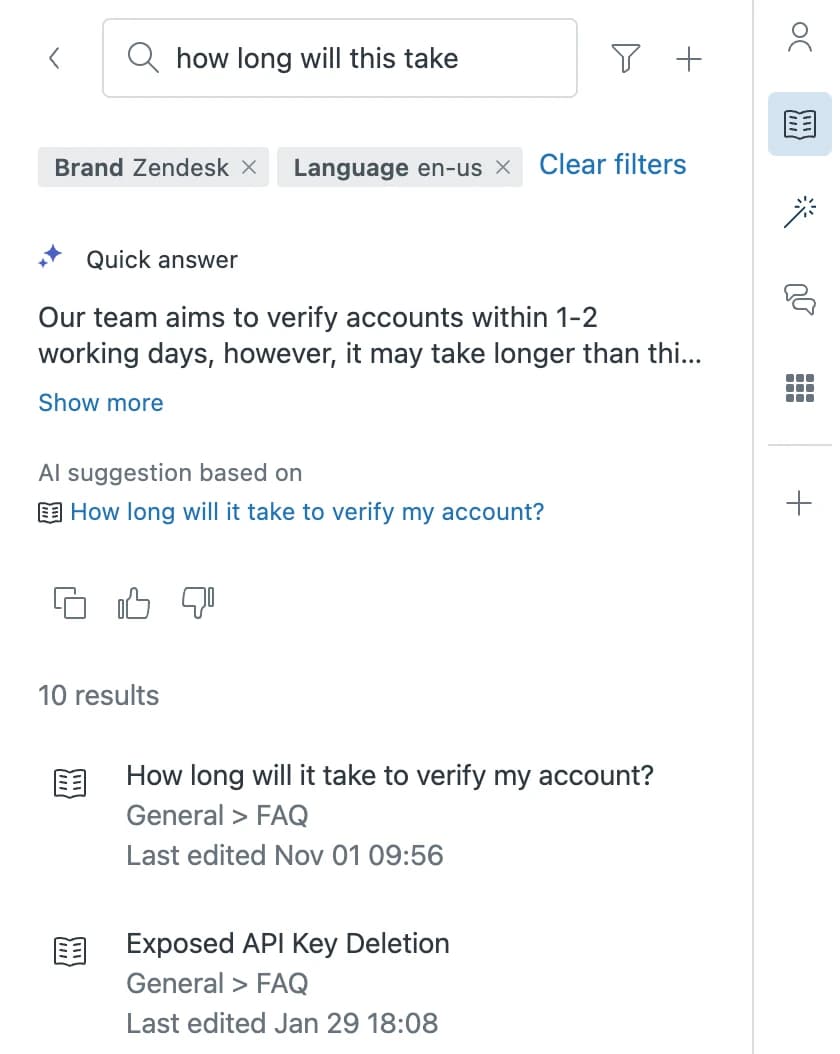
Le pas le plus important est Zendesk Copilot. Auto assist lit d'abord les procédures, puis les articles du centre d'aide, puis des tickets résolus similaires. Depuis juillet 2026, il lit aussi 10 sources externes (Confluence, Notion, Google Drive, SharePoint, Box, Guru et d'autres) ainsi que les articles de connaissances internes, une fois qu'un administrateur rend ces segments disponibles. Copilot coûte $50 par agent et par mois en plus de Professional ou supérieur, donc une équipe de 20 agents sur Suite Professional paie $3,300 par mois avant toute autre chose. Une lacune à connaître : sur r/Zendesk, un administrateur a noté "you can't really train the AI on agents correcting responses right now" (u/lakwanza88, Reddit), donc les corrections doivent être reportées dans les articles à la main.
Plus de détails sur le panneau lui-même dans mon analyse de la recherche IA de Zendesk.
Freshdesk : Freddy cite les tickets utilisés
Le Copilot conversationnel de Freshdesk est ce qui se rapproche le plus de "demander à un collègue qui se souvient de chaque ticket". L'agent ouvre le panneau Freddy AI et demande quelque chose comme "have we seen refund delays like this before?", et la réponse arrive avec des pastilles pour les tickets derrière chaque point.
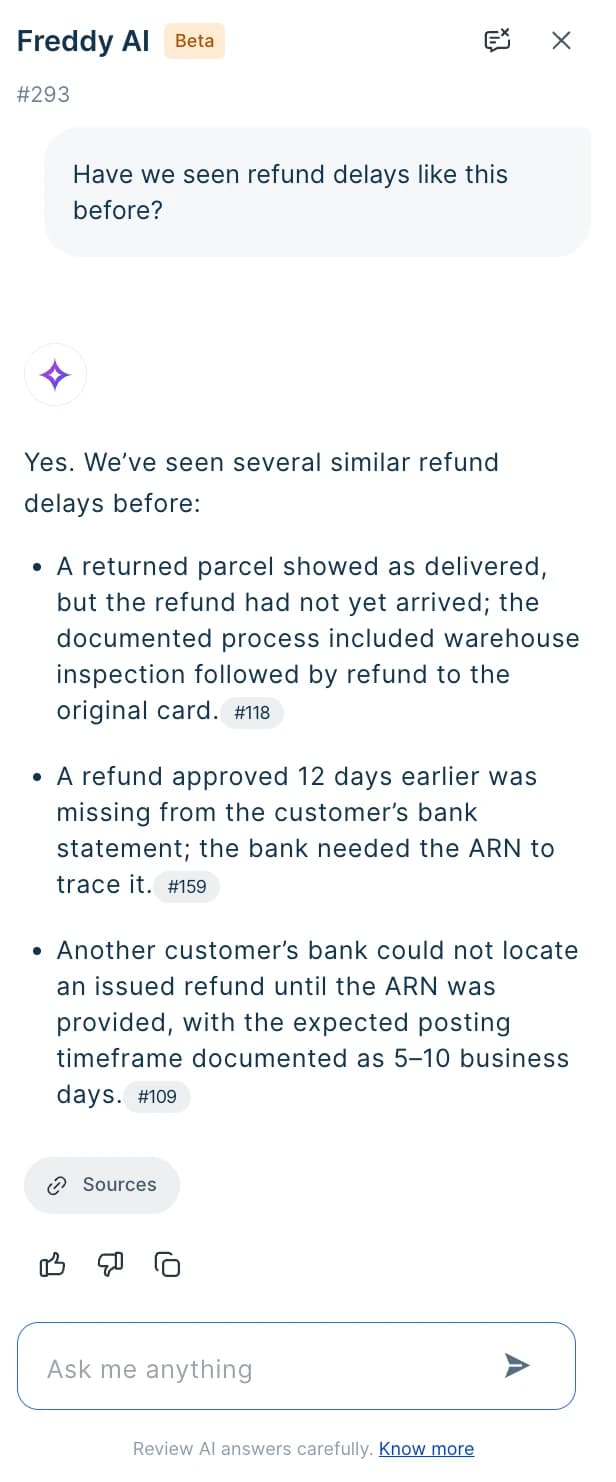
Trois réserves tirées de la documentation de Freshdesk : il est en accès anticipé pour des clients sélectionnés, les nouveaux articles demandent au moins 6 heures et les tickets résolus 24 heures avant que Freddy puisse les citer, et il ne cherche que dans le contenu Freshdesk (articles, réponses prédéfinies, tickets résolus). Il faut Pro ou Enterprise plus le module Freddy AI Copilot à $29 par agent et par mois.
Front : Copilot cherche dans les conversations et les wikis connectés
La barre latérale Copilot de Front permet à un agent de poser une question et de choisir les sources de connaissances à utiliser. Elle cherche dans les conversations passées, les bases de connaissances Front, les sites web jusqu'à 3 000 pages et sept applications connectées dont Confluence, Notion et Google Drive, et elle montre les sources utilisées (centre d'aide Front).
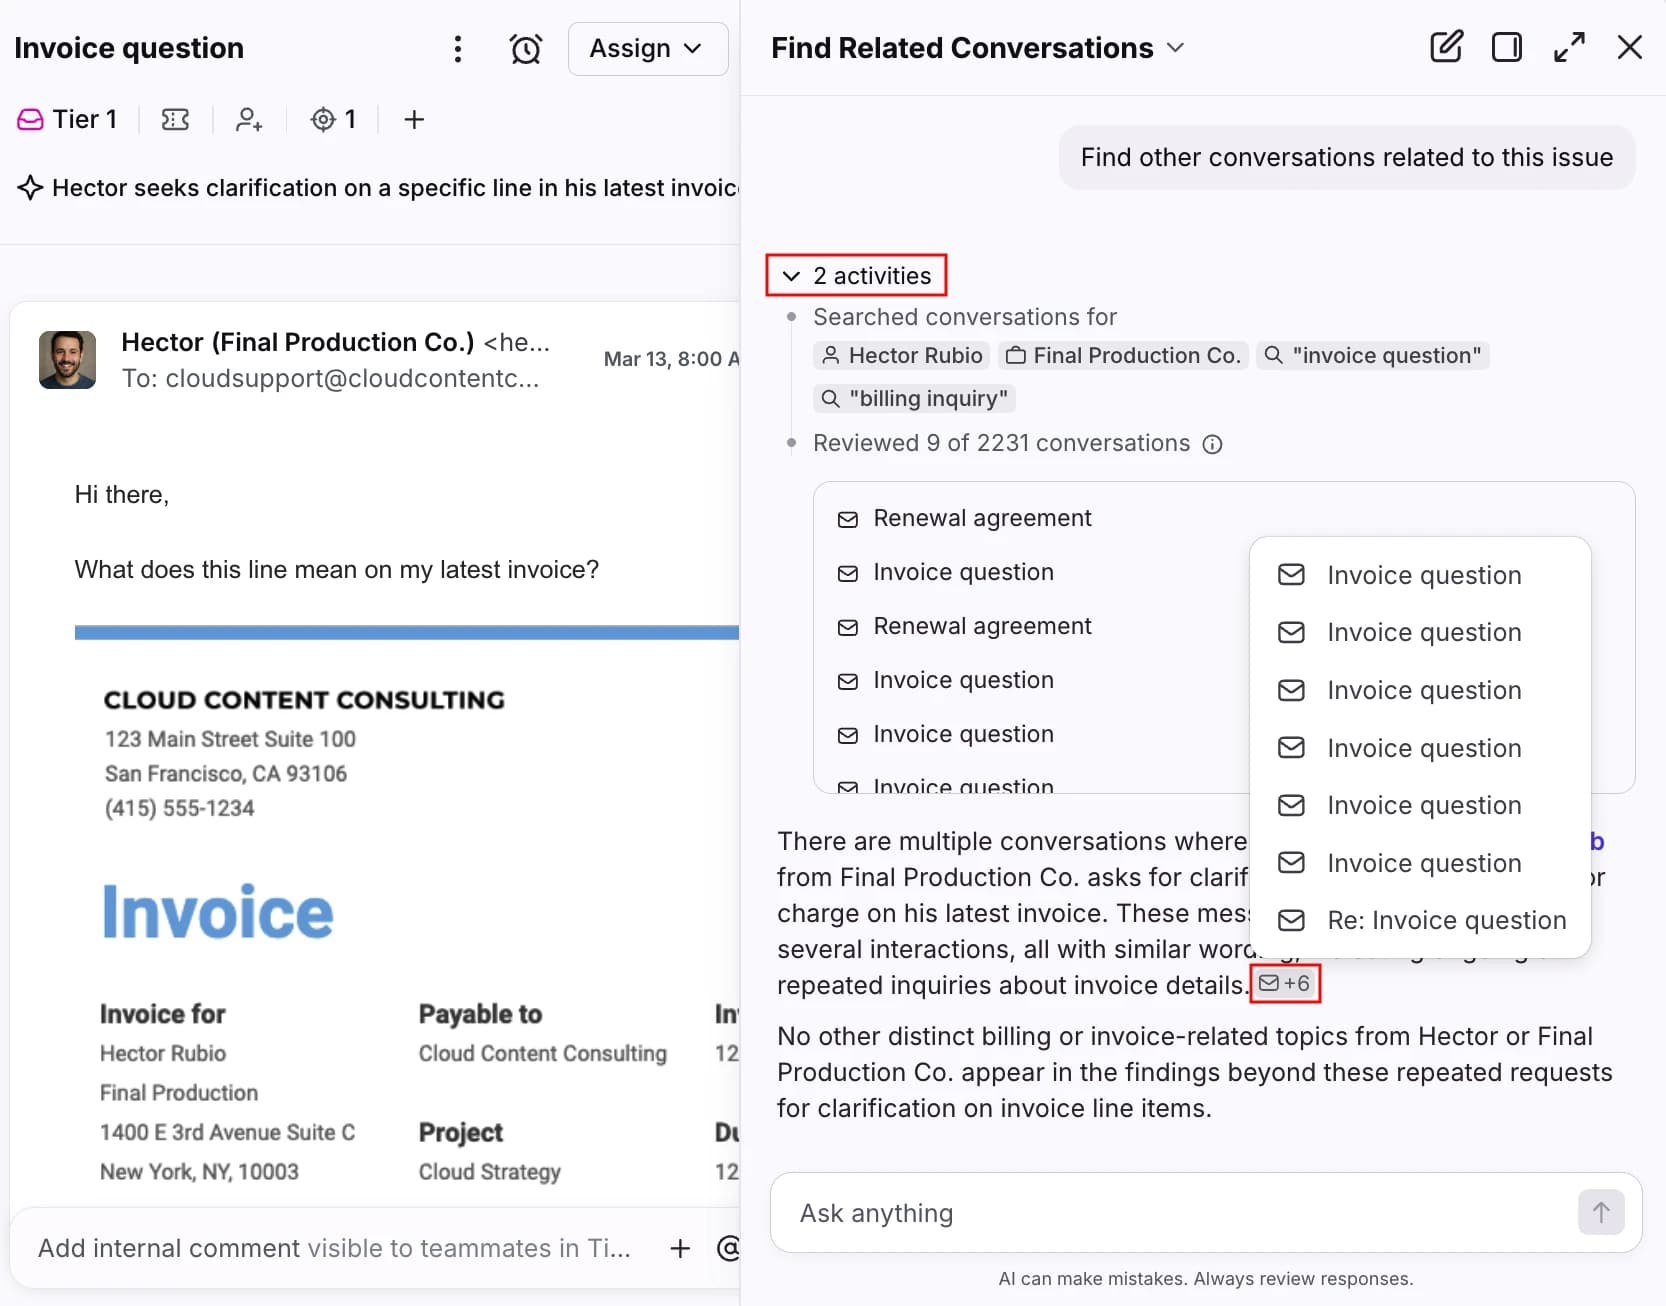
Front Copilot coûte $20 par siège sur Starter et Professional et est inclus dans Enterprise. Deux points à prévoir : les applications connectées ne se resynchronisent pas toutes seules (documentation Front), donc une modification dans Confluence n'apparaîtra pas tant que quelqu'un ne resynchronise pas, et les réponses suggérées sont passées dans le module Autopilot distinct en avril 2026.
HubSpot, Help Scout et Gorgias : le centre d'aide d'abord
Ces trois s'appuient sur votre propre contenu d'aide. Les recommandations de réponse de HubSpot puisent dans les articles de la base de connaissances, les pages de site, les blogs et les fichiers, mais pas dans d'anciens tickets, et les sources ne s'affichent que si l'option "Show citations" est activée (documentation HubSpot). Les AI Drafts de Help Scout apprennent des conversations passées et des articles Docs sur Plus et Pro, bien que la documentation ne dise pas si les brouillons montrent leurs sources.
Chez Gorgias, la recherche côté agent que j'ai trouvée est la recherche de macros, avec les 3 macros recommandées par l'IA épinglées en premier ; la bibliothèque Knowledge alimente l'agent IA côté acheteur (centre d'aide Gorgias). Si votre équipe travaille avec les macros Gorgias, les tenir à jour est votre recherche de réponses.
Outils de recherche d'entreprise : forts sur Slack et les wikis
Si vos réponses vivent dans Confluence, Notion, Google Drive et Slack plus que dans le helpdesk, un outil de recherche d'entreprise est l'autre moitié du tableau. Le revers est que les agents les utilisent surtout en dehors du ticket.
| Outil | Prix | Indexe les tickets du helpdesk ? | Indexe Slack ? | Dans le helpdesk ? | Cite et respecte les permissions ? |
|---|---|---|---|---|---|
| Glean | Sur devis uniquement | Oui : Zendesk, Freshdesk | Oui | Barre latérale du navigateur | Oui |
| Guru | Sur devis uniquement | Cite Zendesk, Freshdesk (objets non précisés) | Oui | Extension de navigateur dans Zendesk | Oui |
| GoSearch | Gratuit, Pro $20/utilisateur/mois | Oui : Zendesk | Oui | Non (extension Chrome, Slack, Teams) | Oui |
| Atlassian Rovo | Inclus dans Jira/Confluence/JSM Standard+ | Oui : tickets + articles Zendesk | Oui | Seulement dans Jira Service Management | Oui |
| Recherche d'entreprise Slack | Enterprise+ uniquement | Aucun connecteur de helpdesk cité | Native | Non | Oui |
| Notion AI | Business $20/siège/mois | Zendesk "coming soon" | Oui | Non | Oui |
| Microsoft 365 Copilot | $30/utilisateur/mois (annuel) | Tickets Zendesk (aperçu) | Pas de connecteur créé par Microsoft | Non | Oui |
Quelques points ressortent des pages des éditeurs eux-mêmes.
Glean va le plus loin sur les tickets. Son connecteur Zendesk indexe les tickets avec leurs commentaires, présenté pour trouver des "cas passés similaires", et applique les permissions jusqu'au niveau de l'enregistrement. Ses utilisateurs peuvent être enthousiastes : un commentateur de Hacker News a qualifié ses réponses de "downright magical" (vladgur, Hacker News). Le hic est le prix et l'adéquation : il n'y a pas de grille tarifaire publique, et un autre commentateur l'a résumé ainsi : "the pricey one aimed at big companies" (earcar, Hacker News).
Si le budget est le frein, mon tour d'horizon des alternatives à Glean couvre des options moins chères.
GoSearch et Notion sont les options en libre-service. GoSearch Pro coûte $20 par utilisateur et par mois et indexe les tickets Zendesk, les articles du centre d'aide et les détails clients des tickets, avec des citations intégrées.
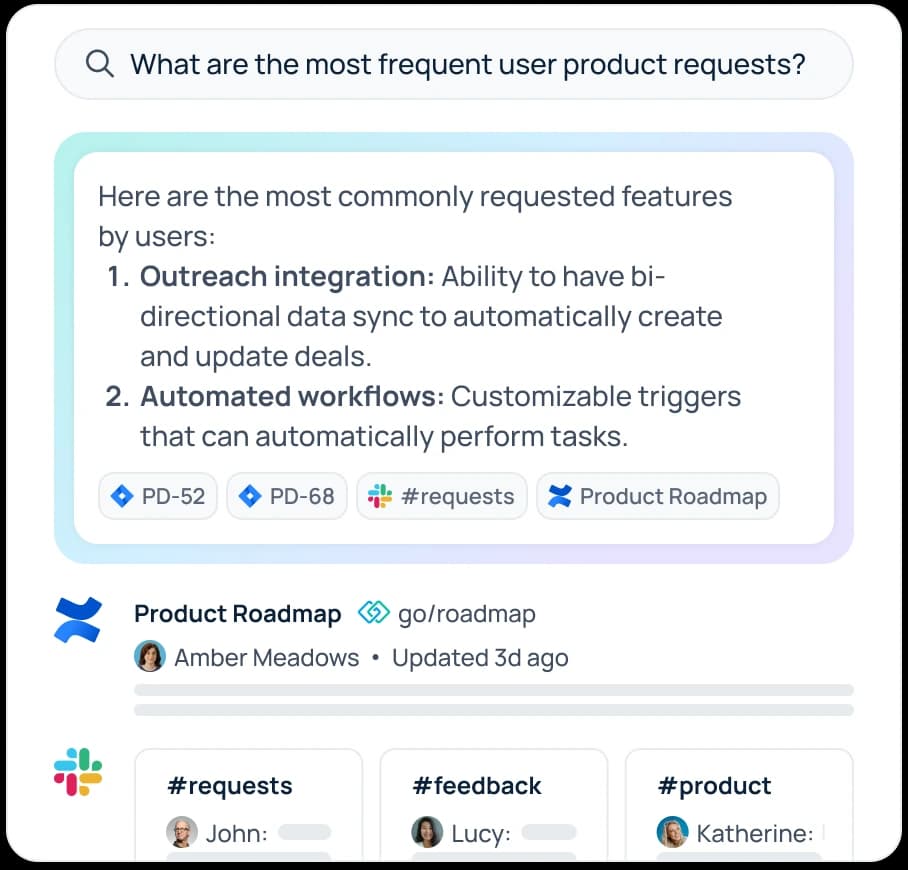
Rovo est "gratuit" si vous êtes déjà chez Atlassian. La recherche Rovo est fournie avec Jira, Confluence et Jira Service Management à partir des forfaits Standard, et la recherche comme l'indexation ne consomment pas de crédits (Atlassian). Son connecteur Zendesk indexe les tickets d'incident et les articles de connaissances. Pour une équipe Zendesk, c'est une surface séparée ; pour une équipe JSM, il est déjà dans le helpdesk. Mon explication des tarifs de Rovo détaille le calcul des crédits.
La recherche d'entreprise de Slack est réservée au niveau supérieur. Elle n'est cochée que pour Enterprise+ sur la page de tarifs de Slack, et la liste des connecteurs de lancement (Asana, Box, GitHub, Google Drive, Jira, Salesforce) ne nomme aucun helpdesk.
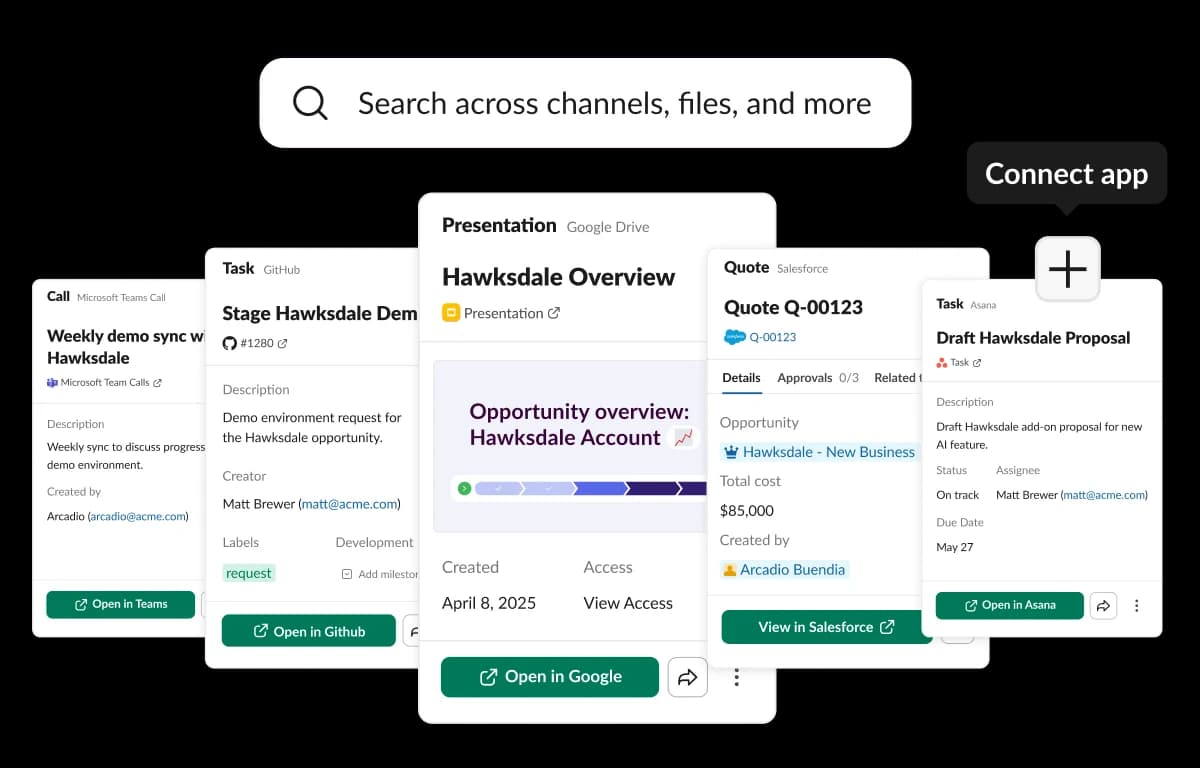
Le constat sur les sept : aucun ne rédige la réponse dans le ticket. Ils trouvent et résument. L'agent doit encore copier la réponse et écrire le message. Et un outil conçu pour cela dépend toujours du contenu en dessous, comme l'a noté un évaluateur de Guru dans une équipe de service client télécom : "at times, the search bar doesn't display the specific article needed to process a client's request" (Jandolf L, Capterra).
Comment mettre en place la recherche de réponses internes en cinq étapes
Quelle que soit la configuration choisie, le déploiement qui fonctionne se ressemble. Je prévoirais deux à trois semaines pour une équipe de 10 à 30 agents.
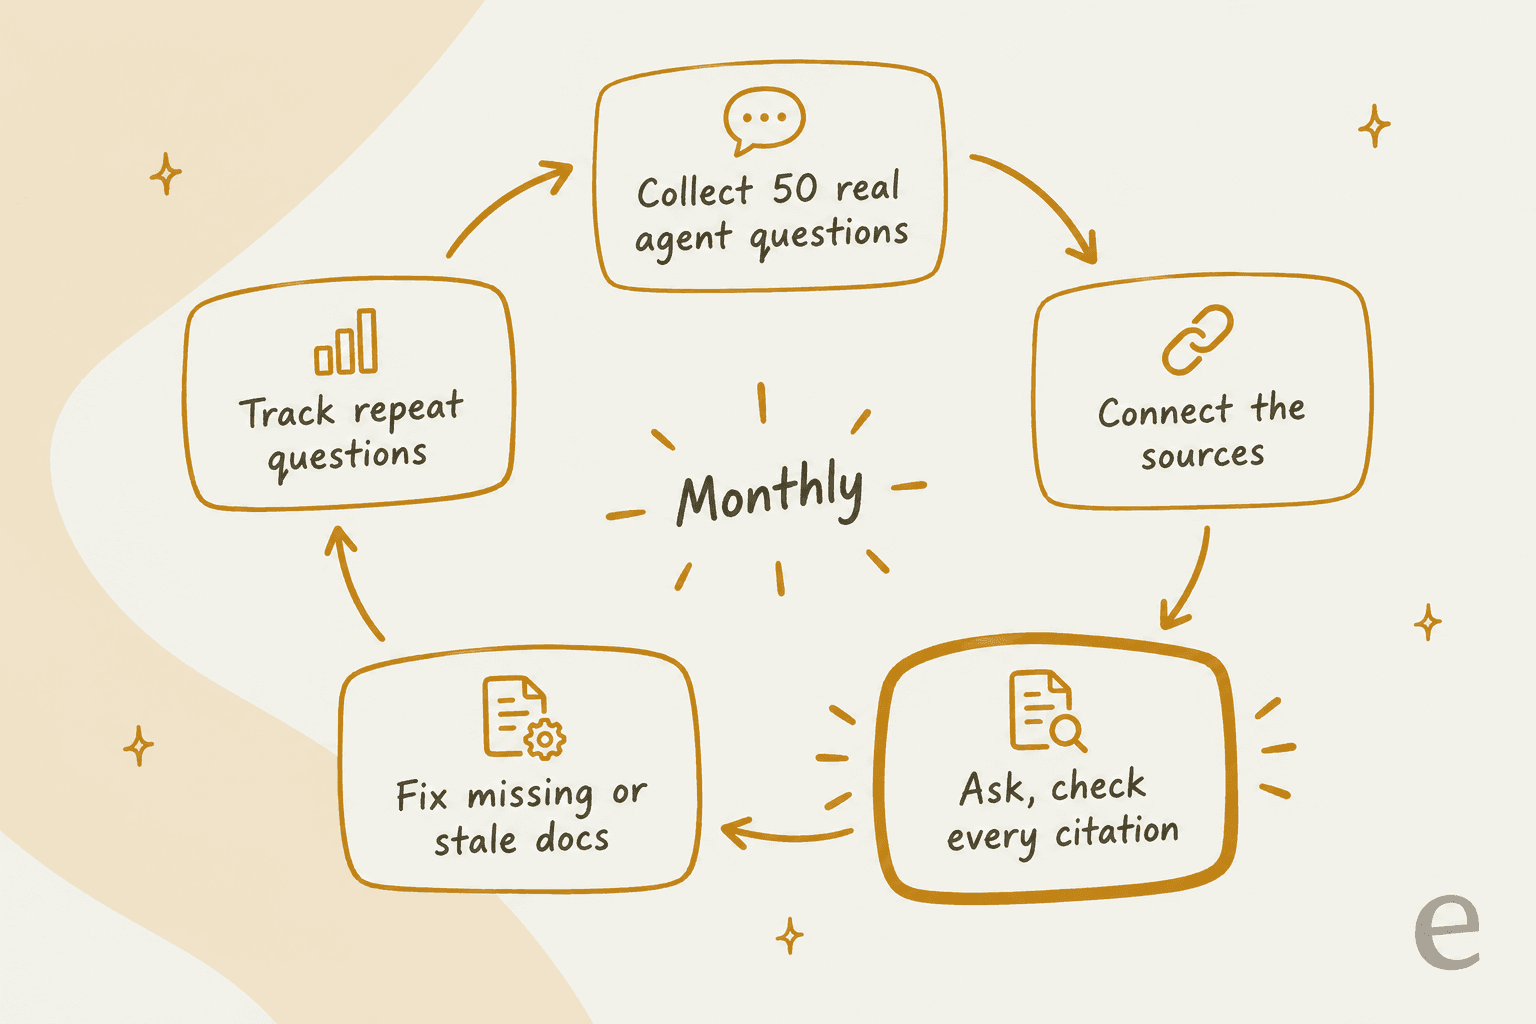
Étape 1 : Rassemblez 50 vraies questions d'agents
Ne commencez pas par l'outil. Récupérez les questions que les agents posent réellement : votre canal Slack interne du support, les notes "comment faire" dans les tickets et ce que les nouvelles recrues ont demandé pendant leur premier mois. Cinquante suffisent pour voir un schéma. Cette liste devient votre jeu de test, et elle sera plus honnête que n'importe quelle démo d'éditeur.
Étape 2 : Connectez les sources qui contiennent les réponses
Associez chacune des 50 questions à l'endroit où sa réponse se trouve aujourd'hui. Si la moitié pointe vers des fils Slack et d'anciens tickets, un outil limité au centre d'aide ne suffira pas, aussi bonne que soit sa recherche. Connectez d'abord le centre d'aide, les articles internes et les macros, puis les anciens tickets (filtrés sur les résolus et récents), puis le wiki. Laissez de côté tout ce que vous ne voudriez pas qu'un agent cite, comme des brouillons de politiques ou un dossier juridique.
Étape 3 : Posez chaque question et vérifiez chaque citation
Lancez les 50 questions et notez chaque réponse : juste, juste mais avec une source périmée, fausse ou "introuvable". La vérification de la citation compte autant que la réponse. Une réponse correcte qui pointe vers la politique de remboursement de l'an dernier est une future réponse fausse.
Étape 4 : Corrigez les documents manquants et périmés
Les catégories "introuvable" et "source périmée" sont votre liste de rédaction. Fusionnez les doublons, archivez les anciennes versions et transformez les meilleures réponses Slack en articles internes. C'est là que la recherche de réponses se rentabilise deux fois : elle vous montre exactement quelles lacunes de connaissances font perdre du temps aux agents.
Étape 5 : Suivez les questions récurrentes chaque mois
Une fois en production, surveillez quelles questions reviennent et lesquelles finissent encore en sollicitation d'un agent senior. Une question posée trois fois par semaine que le système ne sait pas traiter est votre prochain article. Alimentez-vous en particulier des questions des nouvelles recrues, car elles sont le signal le plus net de ce qui manque à votre intégration des agents.
Erreurs qui font échouer la recherche de réponses
Tout connecter dès le premier jour. Dix ans de Confluence, espaces abandonnés compris, signifient que la page périmée l'emporte aussi souvent que la bonne. Commencez étroit puis élargissez.
Ignorer les anciens tickets parce qu'ils sont désordonnés. Ils sont désordonnés parce qu'ils sont réels. Pour les cas limites, un ticket résolu le mois dernier vaut souvent mieux que n'importe quel article. Filtrez sur des tickets résolus d'une période récente et masquez les données personnelles lorsque votre outil le permet.
Accepter des réponses sans sources. Si un agent ne peut pas cliquer pour vérifier, il fera soit confiance aveuglément, soit ignorera. Les deux sont mauvais. Faites des citations une condition non négociable lors de l'évaluation des outils.
Le traiter comme un projet ponctuel. Les politiques changent. Un membre d'une équipe de documentation a décrit un lancement où "associates can't find anything in the knowledge base, managers start panicking" parce que personne ne les avait prévenus du changement (u/lockshield, Reddit). Liez les mises à jour des connaissances à votre processus de changement de politique.
Oublier où les agents demandent réellement. Si votre équipe pose ses questions dans Slack, une page de recherche à ouvrir ne changera pas les comportements. Placez les réponses là où la question est déjà posée.
eesel pour la recherche de réponses internes du support
Chaque configuration ci-dessus couvre une partie de la carte. Les copilotes de helpdesk vivent dans le ticket mais lisent surtout du contenu du helpdesk. La recherche d'entreprise atteint Slack et les wikis mais reste surtout hors du ticket. Le coéquipier IA de helpdesk d'eesel est conçu pour couvrir les deux : un agent, un fonds de connaissances, accessible là où votre équipe pose ses questions.
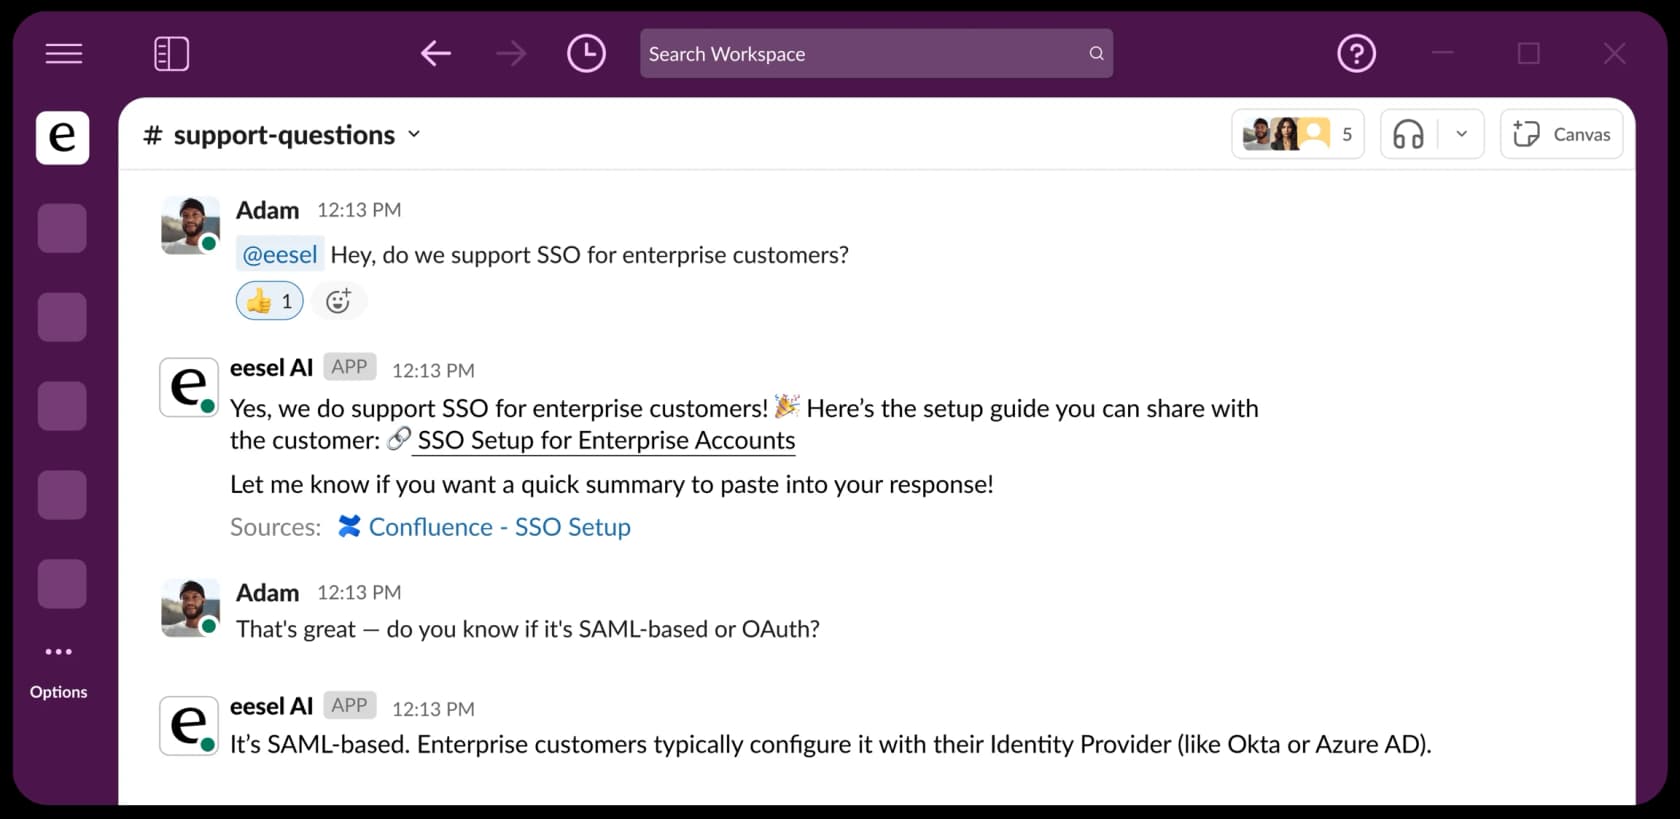
Dans Slack, un agent mentionne eesel par @ dans un canal ou un message privé et obtient une réponse dans le fil avec la source liée. Il cherche dans vos connaissances connectées et dans les messages Slack en direct, uniquement dans les canaux publics où il se trouve et les canaux privés dont la personne qui pose la question fait aussi partie, de sorte qu'il ne peut pas révéler un canal privé à quelqu'un qui n'y est pas (documentation eesel).
Dans le ticket, le même agent rédige la réponse. Il peut poster des brouillons comme notes internes dans Zendesk, Freshdesk, Front et d'autres helpdesks pour qu'une personne les vérifie et les envoie, ou les agents peuvent utiliser le panneau latéral Chrome gratuit, qui lit le ticket ouvert et rédige à partir de lui (sur Zendesk, il colle directement dans le champ de réponse).
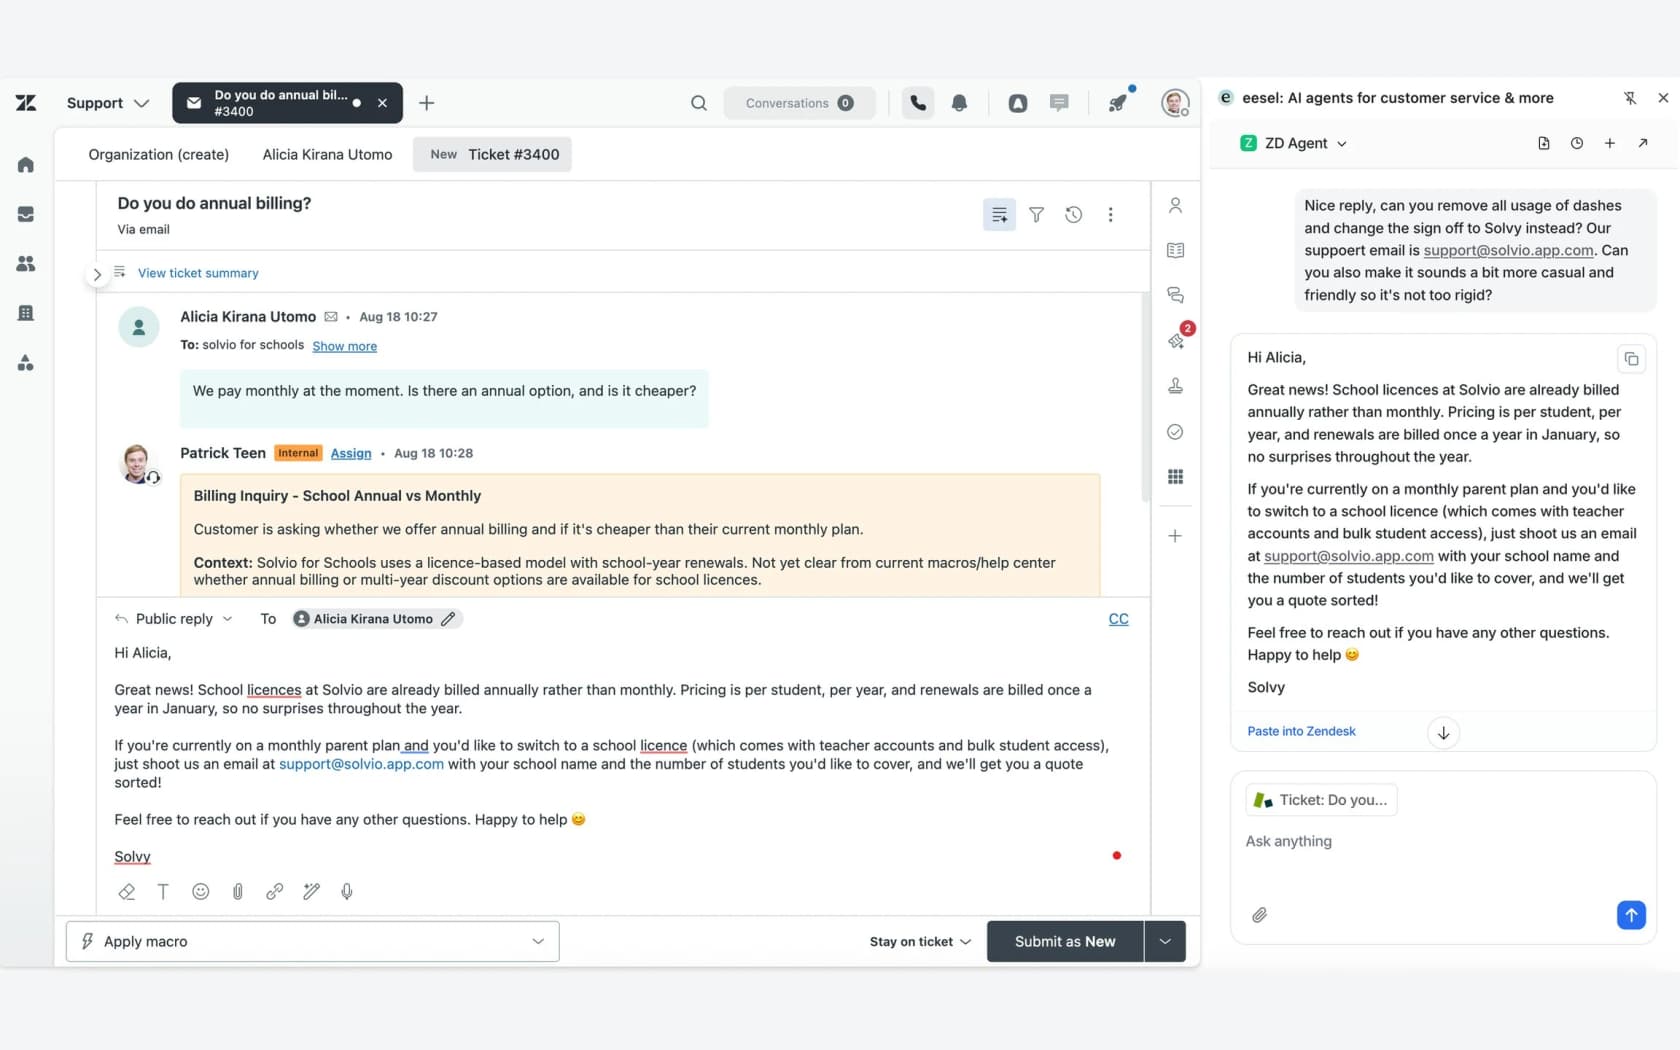
Ce qu'il lit : votre centre d'aide, vos macros et vos anciens tickets (filtrables par statut et par date) avec une connexion complète au helpdesk, plus Confluence Cloud, Notion, Google Drive, des sites web et des fichiers importés, le tout interrogé ensemble.
Chaque réponse lie sa source, et quand il ne trouve pas quelque chose, il le dit au lieu de deviner (documentation eesel). Avant toute mise en production, la compétence Simulation rejoue de vrais anciens tickets et note les réponses, ce qui est en gros l'étape 3 ci-dessus, faite pour vous.
Pour les responsables des opérations et les ingénieurs, la CLI eesel exécute le même coéquipier depuis un terminal. eesel chat "what's our refund policy?" interroge exactement l'agent que votre équipe interroge dans Slack, eesel files upload ./refund-policy.pdf ajoute une nouvelle source, et eesel integrations sources zendesk montre quelles sources du helpdesk sont activées. Chaque commande affiche du JSON, de sorte que Claude Code, Cursor ou Codex peuvent piloter votre configuration, et eesel mcp token transforme l'espace de travail en serveur MCP pour interroger vos connaissances de support directement depuis ces outils. Une limite : activer l'automatisation des mentions Slack est une étape du tableau de bord, pas une commande CLI.
De vraies équipes l'utilisent ainsi. BitGo fait tourner un bot eesel interne dans Slack, alimenté par des manuels techniques, des documents de politique et des spécifications produit, de sorte qu'un agent bloqué sur un ticket délicat n'a qu'à demander. Une société de paiement l'a dit simplement :
"With eesel, we can find specific answers to questions extremely fast. We can onboard new employees very quickly and have seen up to 80% time savings."
Là où ce n'est pas la bonne solution : eesel ne reproduit pas les permissions par utilisateur de Confluence ou de Google Drive, donc la configuration la plus propre est un agent interne distinct qui ne reçoit que les sources que toute votre équipe de support doit voir. Microsoft Teams n'est pas encore en libre-service non plus. Les tarifs : 100 crédits gratuits sans carte, puis le forfait Teammate à partir de $299 par mois pour 500 crédits, avec agents et sièges illimités ; un ticket coûte un crédit et les questions Slack consomment aussi des crédits. Essayez eesel sur vos 50 questions de test et voyez combien reviennent avec la bonne source.
Comment faire fonctionner la recherche de réponses internes dans Slack ?