

Pour relire les conversations de support IA, lisez chaque escalade, chaque conversation à faible CSAT, chaque ticket rouvert et chaque conversation de remboursement ou de politique, plus un échantillon aléatoire de 20 à 30 conversations marquées comme résolues, car « résolue » signifie souvent juste que le client s'est tu. Vérifiez chacune pour une réponse correcte et sourcée, le respect de la politique, les actions, le moment du transfert et le ton. Nommez ensuite la cause racine (connaissance manquante, manque d'instructions, mauvaise action, transfert tardif), corrigez-la à la source et rejouez les mêmes anciens tickets avant que le changement ne passe en production. Relisez chaque jour la première semaine, puis chaque semaine. eesel montre les sources et le raisonnement derrière chaque réponse et rejoue les tickets résolus sans rien envoyer.
Pourquoi « résolue » ne veut-il pas dire que l'IA a bien fait son travail ?
Je travaille dans la file de support d'eesel, et la chose à laquelle j'ai appris à me méfier le plus est un badge vert « résolue ». Un agent IA peut clore une conversation avec une réponse fluide, polie et fausse, et rien dans le tableau de bord ne bouge. Le client abandonne, ou revient en colère deux jours plus tard sur un autre canal.
Les éditeurs le disent eux-mêmes. HubSpot fixe le statut de résolution d'une conversation du customer agent 72 heures après la dernière réponse du visiteur, et un retour négatif ultérieur « ne changera pas le statut de résolution ». La même page est directe : « Les déflexions n'indiquent pas toujours une résolution. » Le nouveau tableau de bord d'évaluation de la qualité de Zendesk, publié le 10 novembre 2026, note la compréhension et l'empathie, puis avertit que « la compréhension ne veut pas dire que le problème a été résolu ». L'écart entre déflexion et résolution a son propre article.
Voici à quoi ça ressemble du côté opérationnel, selon une équipe qui gère un bot de support auto-hébergé :
"just ast week a customer sent a screenshot where the bot told him accidental damage was covered under warranty and we'd repair it for free. It isn't and we don't. The doc it pulled was about the extended plan, which he doesn't have, and the bot blended the two we had to honor it ... haunting part is nothing in our logs looked obviously wrong. The answer was fluent and on topic, it was just built on the wrong chunk"

eesel a vu le même schéma dans ses propres déploiements. Lors d'un essai, une équipe de support technique B2B a vu l'agent dire aux clients qu'un produit était pris en charge alors qu'il ne l'était pas, parce qu'un article d'aide disait, mot pour mot, « nous prenons en charge tous les modèles ». L'agent n'a rien inventé. Il a lu une phrase trop large et l'a répétée avec assurance. Ce genre d'échec ne se voit que lorsqu'une personne lit la conversation à côté de la source.
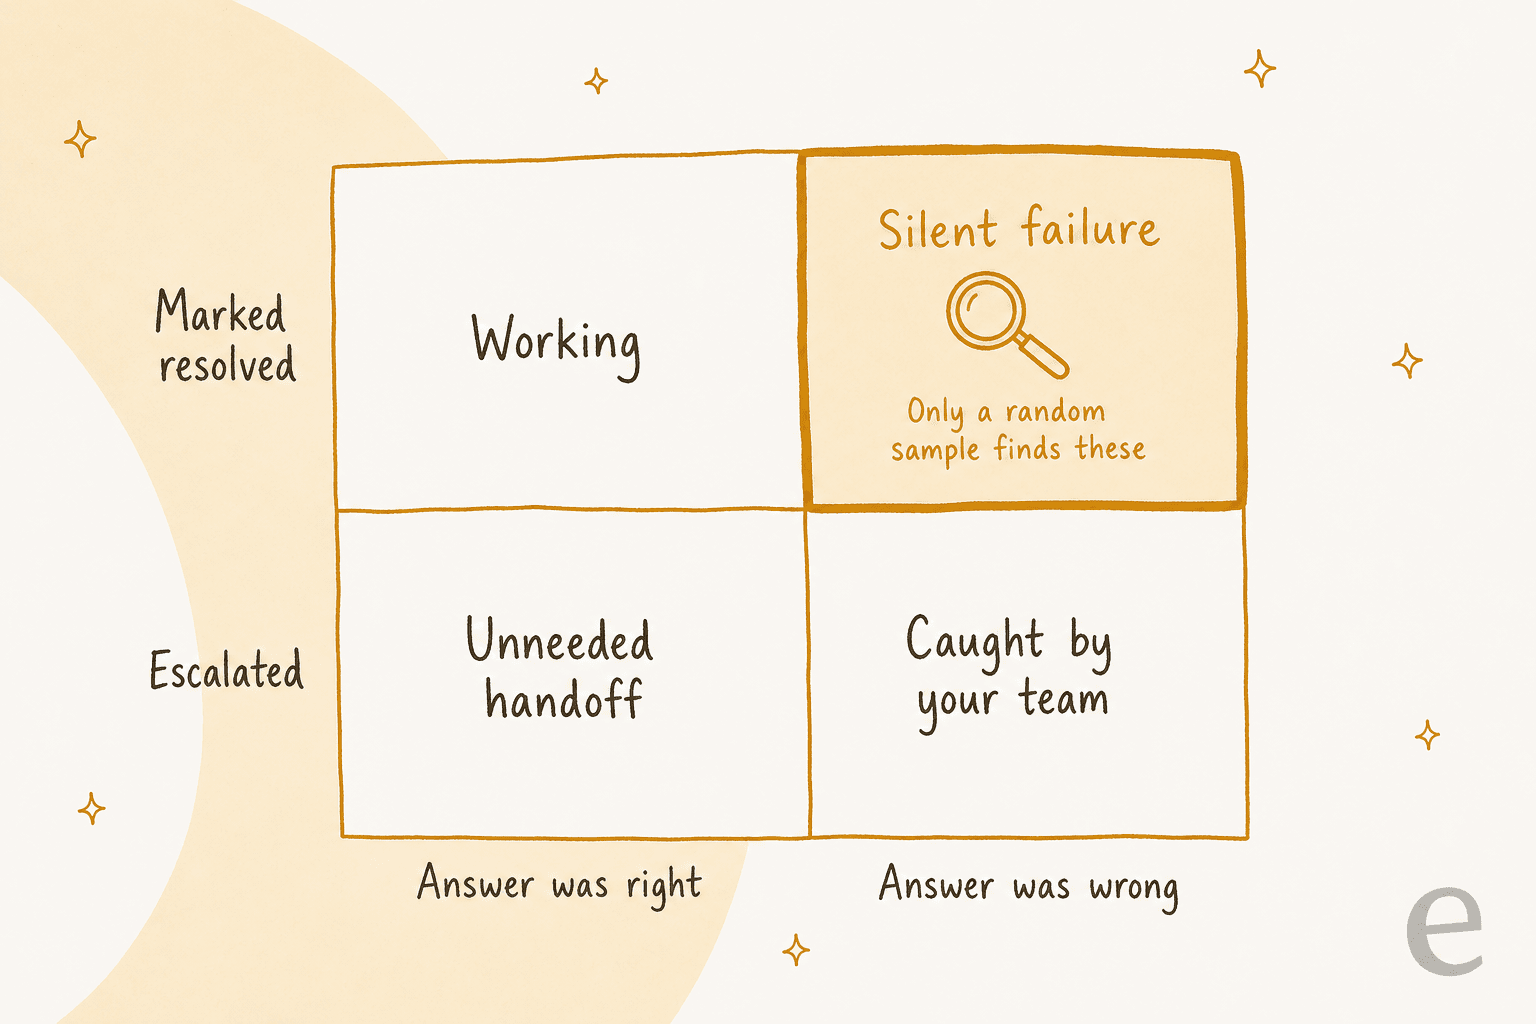
Les escalades arrivent devant votre équipe de toute façon. Les échecs silencieux de la case en haut à droite, non, c'est pourquoi la routine ci-dessous consacre une partie de son temps à des conversations qui semblent normales. C'est un travail différent du contrôle qualité du support pour agents humains : vous ne coachez pas une personne, vous cherchez quelle entrée reçue par l'agent était fausse.
Si votre équipe utilise des agents de codage, la CLI eesel permet à l'un d'eux de participer à cette boucle. Après avoir corrigé une règle, l'agent peut envoyer la correction avec eesel chat, relire la règle enregistrée avec eesel instructions, puis reposer les questions des tickets ayant échoué et vérifier les réponses avant que rien ne change pour les clients. Connecter le support desk au départ demande toujours qu'une personne avec un accès administrateur l'approuve.
Quelles conversations de support IA devriez-vous relire ?
Vous ne pouvez pas tout lire, et vous ne devriez pas essayer. Une responsable CX d'une marque de compléments alimentaires traitant environ 7 000 tickets par mois l'a dit clairement lors d'un appel avec l'équipe commerciale d'eesel :
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer"
Elle a raison sur le plan mathématique. La réponse est un plan d'échantillonnage en deux parties : lisez chaque conversation dans les lots à risque, et prenez un petit échantillon aléatoire dans le gros lot « résolue ».
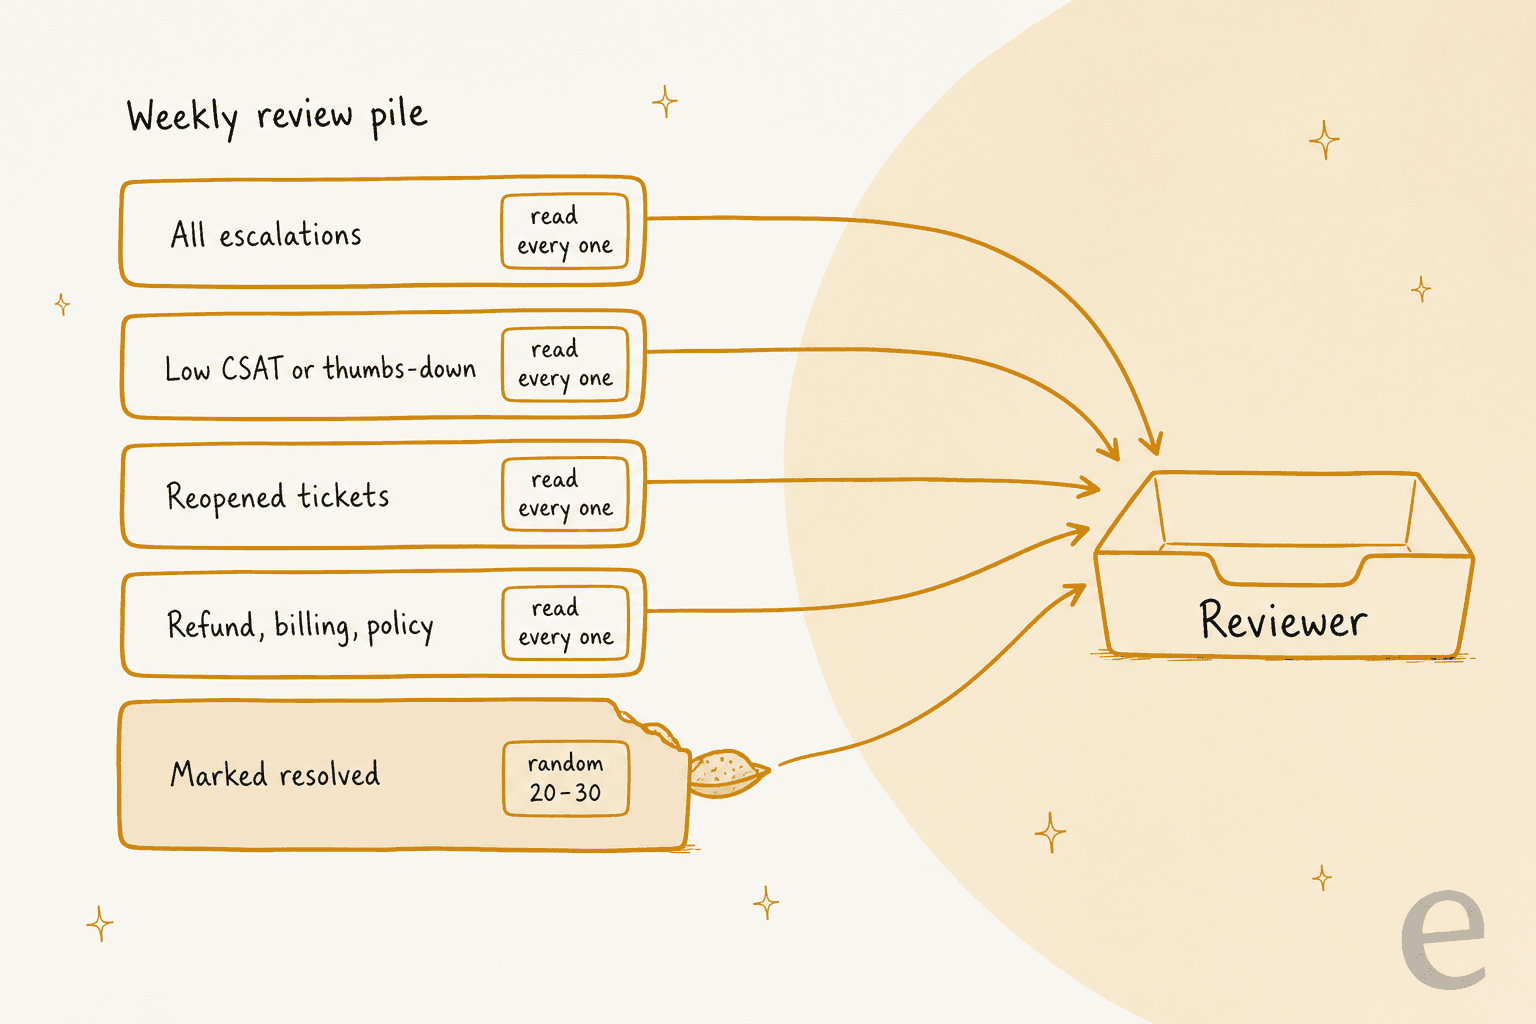
| Lot | Combien en lire | Pourquoi il est dans la pile |
|---|---|---|
| Toutes les escalades et transferts | Chacune | Montre ce que l'agent n'a pas pu faire, et s'il a abandonné trop tôt ou trop tard |
| CSAT faible ou pouce baissé | Chacune | Les clients vous disent que quelque chose s'est mal passé, même si le ticket a été fermé |
| Tickets rouverts | Chacune | La réponse n'a pas tenu. Souvent une réponse fausse ou partielle marquée comme résolue |
| Remboursement, facturation et politique | Chacune au début | Une mauvaise réponse ici coûte de l'argent ou une promesse que vous devez tenir |
| Échantillon aléatoire de « résolue » | 20 à 30 par semaine | Le seul moyen de trouver les échecs silencieux |
Une remarque sur le CSAT : un score de satisfaction généré par IA n'est pas la même chose que demander au client. La documentation d'eesel dit elle-même que « le CSAT IA n'est pas un retour client » sur sa page Reports, et le traite uniquement comme un signal interne. Utilisez de vrais retours CSAT pour l'IA quand vous en avez.
D'où vous les récupérez dépend de votre support desk, et chaque grand acteur a désormais un endroit pour cela :
- Zendesk. Les journaux de conversation se trouvent sous Optimize > Monitoring > Conversation logs et montrent les 7 derniers jours par défaut. Les filtres correspondent bien aux lots ci-dessus : messages non compris, abandons, escalade échouée, BSAT, et si une réponse de connaissance a été utilisée. Le guide des journaux de conversation Zendesk les détaille.
- Freshdesk. Dans AI Agent Studio, Analyze > Ticket logs filtre par statut, y compris le transfert à un agent, et sépare les vraies conversations des tests en aperçu. Le conseil de Freshdesk lui-même est que « lire deux ou trois vraies conversations est le moyen le plus rapide » de confirmer qu'un sujet échoue (documentation Freshdesk). Plus de détails sur ses analyses ici.
- Gorgias. La vue des tickets de l'AI Agent a une section To review qui regroupe chaque ticket où l'AI Agent a envoyé une réponse, et une étiquette
ai_failed_actionpour les actions échouées (documentation Gorgias). Un ticket étiqueté à la foisai_answeredetai_handovermérite d'être lu en premier : il a répondu et a quand même escaladé. - HubSpot. Le customer agent regroupe les échecs sous Analyze > Coaching opportunities, avec le message exact qu'il n'a pas pu répondre surligné en rouge.
Un détail pratique : les dernières 72 heures sont encore en mouvement. Gorgias ne facture une interaction comme automatisée qu'une fois 72 heures passées sans transfert humain, et HubSpot attend les mêmes 72 heures. Prenez les conversations de la semaine dernière, pas celles d'hier, pour tout ce que vous comptez.
Que devriez-vous vérifier dans chaque conversation ?
Six contrôles par conversation. La plupart prennent quelques secondes une fois qu'on y est habitué. Le plus lent est l'ancrage, et c'est celui qui attrape les échecs du type garantie.
| Contrôle | Ce qu'il faut regarder | Signal d'alerte |
|---|---|---|
| Réponse correcte | Votre meilleur agent aurait-il dit la même chose ? | Bon sujet, mauvais détail (forfait, région, date, montant) |
| Ancrée dans une source | Quel article, quelle macro ou quel ancien ticket a-t-il utilisé ? | Aucune source, la mauvaise source, ou deux sources mélangées |
| Politique respectée | Délais de remboursement, éligibilité, ce qui nécessite une approbation | A promis quelque chose que votre politique n'autorise pas |
| Actions correctement exécutées | Remboursements, annulations, étiquettes, recherches de commande | Une action exécutée sur la mauvaise commande, ou échouée en silence |
| Moment du transfert | Quand il a escaladé, et ce que disait la note de transfert | A tourné en boucle après que le client a demandé une personne, ou la note ne correspond pas à la transcription |
| Ton | Est-ce que ça sonne comme votre équipe ? | Excuses excessives, robotique, ou enjoué avec un client mécontent |
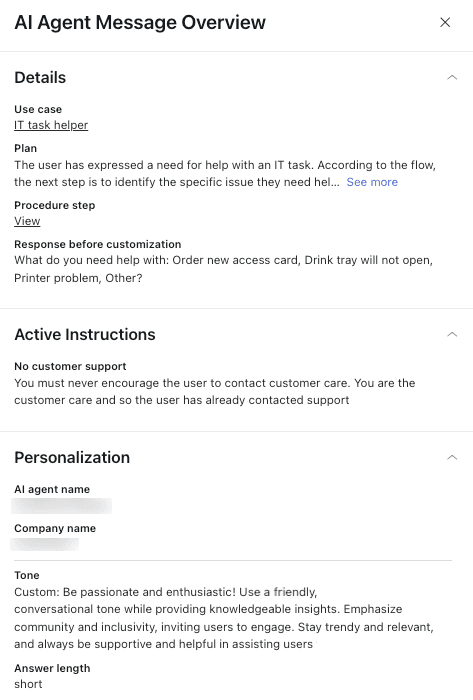
L'ancrage a besoin du cheminement de l'agent, pas seulement de sa réponse. Le View details par message de Zendesk montre le Plan de l'agent, la réponse avant personnalisation et les Active instructions qu'il a suivies, ce qui permet de distinguer un problème de connaissances d'un problème d'instructions.
Pour le contrôle de politique, portez une attention particulière à l'argent. Si votre agent peut émettre des remboursements, lisez chaque conversation de remboursement le premier mois, signalée ou non. L'article sur les garde-fous de remboursement couvre les limites qui vont dans les réglages plutôt que dans le prompt.
Traitez la note de transfert comme un contrôle à part. Il est facile de lire la réponse de l'IA, de voir qu'elle a escaladé, et de passer à autre chose. Mais la note que reçoit votre agent humain peut elle aussi être fausse :
"My place added an AI bot that handles the chat first and gives the summary of what the client said to the agent, but the thing is, its summaries are often just lies that it hallucinated lol. It just makes up stuff that the customer never said, and you still have to check the whole history."
Comparez le résumé à la transcription. S'ils ne correspondent pas, c'est un échec même si l'escalade en elle-même était justifiée. L'article sur les bonnes pratiques de transfert couvre ce que doit contenir une bonne note.
Le ton est le dernier contrôle et le plus facile à surestimer. Une réponse un peu rigide mais correcte vaut mieux qu'une réponse chaleureuse mais fausse. Corrigez le ton en lot une fois que vous avez plusieurs exemples, avec une règle de voix de marque plutôt que des corrections au cas par cas.
Comment nommer ce qui s'est mal passé ?
Une fois qu'une conversation échoue à un contrôle, donnez-lui une étiquette de cause racine. L'étiquette décide où va le correctif, et l'erreur habituelle est de tout réparer dans le prompt. J'utilise quatre étiquettes :
- Connaissance manquante ou obsolète. Le fait n'était dans aucune source, ou la source était fausse.
- Manque d'instructions. Les faits étaient corrects, mais l'agent en a fait quelque chose de mal.
- Mauvaise action ou autorisation. Il a exécuté, ignoré ou bâclé une action, ou a été autorisé à faire quelque chose qu'il n'aurait pas dû.
- Aurait dû transférer. Il a continué alors qu'une personne aurait dû prendre le relais, ou a transféré quelque chose qu'il aurait pu traiter.
Votre support desk a peut-être déjà une version de ceci. Les coaching opportunities de HubSpot trient les échecs par Reason : Knowledge, Handoff, Experience, Action et Other (documentation HubSpot). Zendesk vous laisse ajouter des étiquettes aux conversations et déconseille une étiquette unique par conversation, puisque les étiquettes sont « conçues pour regrouper des conversations à des fins d'analyse ». Gardez vos étiquettes dans une liste courte et fixe pour que les comptages aient un sens.
Un piège à connaître : dans certains outils, noter une conversation ne change absolument rien à l'agent. Gorgias indique que ses notes Bad, Okay et Good « ne changent pas immédiatement la façon dont AI Agent se comporte dans les conversations avec vos clients » ; pour changer le comportement, il faut plutôt noter ou ajouter des sources (documentation Gorgias). Les options de retour intégrées de Zendesk pour les réponses génératives (Incomplete answer, Made-up facts, Missing article, etc.) partent vers les chercheurs IA de Zendesk. Les deux sont utiles, mais aucune n'est un correctif de votre côté.
Choisissez un type d'échec ci-dessous pour voir à quoi il ressemble dans une transcription, où va le correctif dans chaque support desk, et comment le retester.
Choisissez un type d'échec pour voir où va son correctif dans Zendesk, Freshdesk, Gorgias, HubSpot et eesel.
La meilleure preuve de cette approche que je connaisse est Qontro, qui fabrique des logiciels ERP et utilise eesel sur Freshdesk comme copilote. L'équipe compare chaque brouillon d'eesel avec la réponse réellement envoyée par une personne. Quand le brouillon était faux, cela pointe généralement vers un article d'aide manquant ou incomplet, ou une règle à resserrer, et c'est ce qu'ils corrigent plutôt que le ticket isolé. Environ un brouillon sur dix part désormais avec peu ou aucune modification, et la part augmente lentement. Ce sont les quatre étiquettes qui fonctionnent en pratique, sur environ 190 tickets Freshdesk rédigés par mois.
Quand une étiquette revient sans cesse, prenez du recul par rapport aux tickets isolés. Beaucoup de « connaissance manquante ou obsolète » signifie qu'il est temps pour un audit de la base de connaissances, et l'IA peut aider à détecter le contenu obsolète avant que l'agent ne le répète.
Comment le corriger et le retester avant la mise en production ?
Corrigez-le à la source que pointe l'étiquette, puis rejouez les mêmes anciens tickets qui ont échoué. Pas de nouvelles questions inventées, les tickets réels. Un correctif qui passe votre propre question de test peut tout de même échouer sur la formulation du client, et les tickets ayant échoué sont exactement la formulation dont vous savez déjà qu'elle casse les choses.
Un commentateur a décrit l'habitude qui fait que cela s'accumule :
"Keep the transcript reads too, but let them compound instead of evaporate: every escalation like this becomes a case in a small regression set, re-run on every prompt, chunking, or model change, so the failure classes you've already paid for stay fixed."
Chaque support desk reteste un peu différemment, et la différence compte :
| Outil | Où retester | Quelles sont les questions de test |
|---|---|---|
| Zendesk | Widget de test et le simulateur de conversation | Scénarios d'une bibliothèque ou écrits par vous |
| Freshdesk | Onglet Test, jusqu'à 100 requêtes par exécution | Requêtes collées, ou 50 générées à partir de vos connaissances |
| Gorgias | Playground, incluant les Draft Skills et les articles | Messages que vous tapez, en tant que client nouveau ou existant |
| HubSpot | Tests par lots, jusqu'à 8 ensembles de test | Générés à partir de conversations réelles (5+ similaires par thème) ou écrits par vous |
| eesel | Simulation du support desk | Vos anciens tickets résolus, notés par rapport à ce que votre équipe a envoyé |
Gorgias ajoute un avertissement qui vaut la peine d'être copié dans votre propre runbook : si vous activez des actions dans un test, elles « peuvent affecter de vraies données de clients et de commandes » (documentation Gorgias). Utilisez un profil de faux client.
La raison pour laquelle eesel travaille à partir d'anciens tickets est que c'est ce qui ressemble le plus à un essai à blanc sur votre vraie file. Sa simulation rejoue les tickets résolus, rédige une réponse pour chacun, la place à côté de ce que votre équipe a envoyé, et regroupe les résultats par thème. « Elle n'envoie rien aux clients », selon la documentation d'eesel. L'exécution d'exemple dans la documentation du support desk a échantillonné 20 tickets résolus, en a trouvé 17 correspondants, et a renvoyé cinq correctifs classés. Cette liste de 3 échecs sur 20 est exactement la pile de relecture que vous voulez avant que les clients ne voient quoi que ce soit.
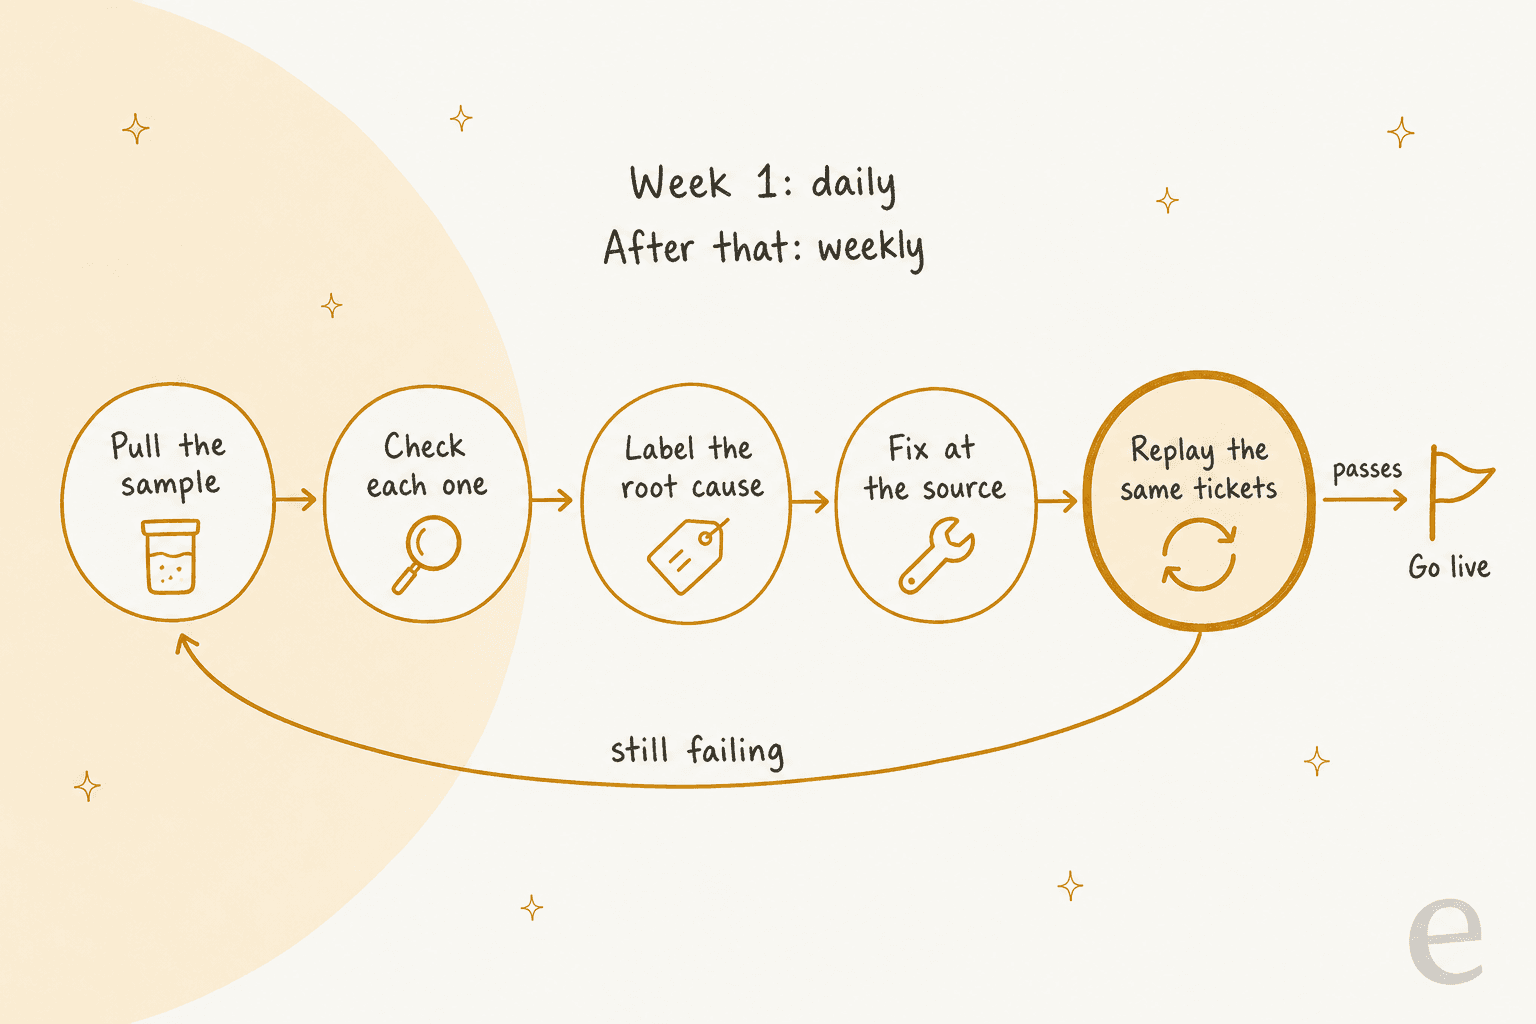
Ne passez en production que lorsque le replay réussit. S'il échoue encore, l'étiquette était probablement fausse, ça arrive. Un échec « connaissance manquante » qui persiste après l'ajout de l'article peut être une instruction qui dit à l'agent de préférer une autre source. Pour en savoir plus sur la conception des tests, voir le guide des tests d'agents de support IA.
À quelle fréquence devriez-vous relire les conversations de support IA ?
Chaque jour la première semaine, puis chaque semaine. C'est le rythme avec lequel je commencerais pour tout nouvel agent, ou tout agent auquel vous venez de donner un nouveau canal ou une nouvelle action.
Semaine un, chaque jour. Lisez chaque conversation signalée et environ 10 résolues au hasard chaque jour. Les échecs se regroupent au début, car les premiers vrais clients trouvent les lacunes que vos questions de test ont manquées.
Ensuite, chaque semaine. Chaque conversation signalée plus 20 à 30 résolues au hasard, et un coup d'œil aux comptages d'étiquettes. Si le compte d'une étiquette baisse après un correctif, ça a fonctionné. Si l'échantillon aléatoire cesse de révéler des échecs pendant trois ou quatre semaines, réduisez-le, mais jamais à zéro.
Revenez à une fréquence quotidienne après tout changement important. Un nouveau canal, une nouvelle action, un changement de modèle ou une grosse importation de connaissances remet le compteur à zéro.
Ce que vous relisez dépend aussi de ce que l'agent fait sans supervision. Chez eesel, chaque action est réglée sur On, Ask first ou Off, et la documentation des actions suggère de commencer supervisé et de passer les actions courantes en On « une fois que les brouillons sont systématiquement corrects ». Une exception : les réponses de chat en direct sont toujours en On, car personne ne peut mettre un chat en direct en pause pour approbation. Cela fait du chat le canal où l'échantillon aléatoire compte le plus.
La page Reports d'eesel a une zone Approvals qui montre la même chose de l'autre côté. Sa documentation indique qu'une action « approuvée chaque fois sans modification est prête à fonctionner seule », tandis qu'une qui « continue d'être rejetée a besoin d'une correction des instructions ».

Pour que le passage hebdomadaire ne glisse pas, mettez-le sur un calendrier. eesel a une compétence Weekly digest qui résume les conversations traitées par thème et canal, les approbations en attente, et ce qui a été ignoré et pourquoi, et la carte le configure pour qu'il soit envoyé chaque lundi (documentation eesel). Quel que soit l'outil que vous utilisez, le digest devrait se terminer par une courte liste de conversations à lire pour une personne, pas seulement des chiffres.
Quelles erreurs font s'effondrer une routine de relecture ?
Les plus courantes :
- Ne lire que les escalades. Vous apprendrez ce que l'agent ne peut pas faire, et vous manquerez ce qu'il fait mal avec assurance. Gardez l'échantillon aléatoire de résolues.
- Tout réparer dans le prompt. Un fait manquant écrit dans les instructions fonctionne pour un ticket et devient obsolète le jour où la politique change. Les faits vont dans votre base de connaissances ou dans les macros.
- Faire confiance au taux de résolution comme score. Utilisez-le pour décider où regarder, pas comme preuve que les réponses étaient correctes.
- Retester uniquement avec de nouvelles questions. Rejouez les tickets ayant échoué. Sinon, vous ne prouvez jamais que le correctif a fonctionné sur la formulation qui l'a cassé.
- Pas de responsable. Les relectures faites « quand quelqu'un a le temps » s'arrêtent discrètement. Désignez une personne par semaine, et utilisez la calibration du contrôle qualité si plusieurs personnes se partagent le travail, pour que les étiquettes restent cohérentes.
- Utiliser une grille de notation QA humaine telle quelle. Les grilles conçues pour des personnes, comme celles de Zendesk QA, notent l'empathie et le processus. Ajoutez les contrôles d'ancrage et d'actions, sinon vous noterez une réponse polie mais fausse comme réussie.
Le coût d'ignorer les étiquettes se voit vite. Quand une équipe ne peut pas distinguer quelles décisions de l'IA sont fausses, elle finit par toutes les vérifier, comme le décrit ce commentaire sur Hacker News :
"The AI would confidently misroute 15-20% of tickets, requiring human review of ALL AI decisions"

Relisez le travail de votre agent de support IA avec eesel
eesel est un coéquipier IA pour le support qui rejoint la file que vous gérez déjà dans Zendesk, Freshdesk, Gorgias ou HubSpot. Il a été conçu pour être relu. Chaque exécution apparaît dans Activity avec un lien vers le ticket, ce qui l'a déclenchée, quelles sources il a cherchées, chaque action qu'il a prise, son raisonnement étape par étape, et s'il a rencontré une lacune de connaissance. Si une réponse est fausse, vous ouvrez l'exécution et lui dites dans le chat à côté quoi changer, et le correctif passe dans ses instructions ou dans une mémoire.

Vous pouvez aussi choisir combien il fait seul pendant que vous construisez la confiance. STIL Classics utilise eesel sur Gorgias en brouillons : en un mois, il a laissé environ 430 notes internes, la plupart des brouillons de réponse que l'équipe vérifie et envoie, et quand un fait manque, le brouillon laisse un vide entre crochets plutôt que de deviner. Cela rend la relecture rapide, car les vides pointent directement vers la connaissance manquante.
SamCart utilise des agents séparés sur les tickets Freshdesk et sur le chat de son site, et quand un vendeur demande une personne ou que la question dépasse le centre d'aide, le ticket est étiqueté pour transfert et l'agent arrête de répondre. Cette étiquette donne à la relecture hebdomadaire une pile nette à lire.
Avant toute mise en production, la simulation rejoue vos tickets résolus et montre où l'agent et votre équipe ne sont pas d'accord, sans rien envoyer. Les forfaits démarrent à 299 $ par mois pour 500 crédits après un essai gratuit de 7 jours, selon les tarifs d'eesel.
Essayez eesel sur vos propres anciens tickets et voyez à quoi ressemble votre pile de relecture avant vos clients.
Comment relire les conversations de support IA sans toutes les lire ?