

L'IA pour le reporting du support lit chaque ticket, l'étiquette selon la raison pour laquelle le client a écrit, repère les pics et les articles d'aide manquants, et rédige à votre place le résumé hebdomadaire. Votre rapport passe ainsi de « combien de tickets » à « pourquoi ils sont arrivés et qui devrait corriger la cause », la partie qu'un export de tableur ne vous dit jamais.
La plupart des helpdesks incluent désormais une partie de tout cela. Zendesk étiquette le sujet et le sentiment avec Suite Professional ($115 par agent et par mois), Gorgias détecte l'intention et le sentiment sur tous les forfaits Helpdesk, et les alertes de pics et de cause racine de Freshdesk sont réservées à Enterprise ($89 par agent). Le piège, c'est que les étiquettes d'IA ne valent que ce que vaut la liste que vous leur donnez, et que la plupart des rapports intégrés s'arrêtent à un graphique. Quelqu'un doit encore transformer le graphique en correction.
Un coéquipier IA comme eesel comble cet écart parce qu'il traite déjà les tickets : chez smava, il a classé environ 14,600 tickets Zendesk en un mois dans une liste fixe, et il peut envoyer par e-mail un rapport hebdomadaire avec les principaux thèmes, les lacunes de connaissances et ce qu'il faut corriger en premier. Les forfaits démarrent à $299 par mois pour 500 crédits.
Que fait vraiment l'IA pour le reporting du support ?
Dans le reporting du support, l'IA accomplit cinq tâches. Elle étiquette chaque ticket avec un motif de contact et lit le sentiment du client, elle remarque quand un sujet explose, elle pointe les questions que votre centre d'aide ne sait pas traiter, puis elle met les chiffres en mots simples. La première tâche porte toutes les autres. Quand chaque ticket a un motif fiable, les quatre autres viennent assez facilement ; quand les motifs sont un fouillis, plus rien en aval n'est vraiment digne de confiance.
Je travaille chaque jour sur la file de support d'eesel, et le rapport que je veux le lundi est court : sur quoi les gens ont écrit et ce qui a changé depuis la semaine dernière, plus lesquelles de ces choses quelqu'un hors du support peut corriger. Le nombre de tickets seul est la ligne la moins utile de cette page.
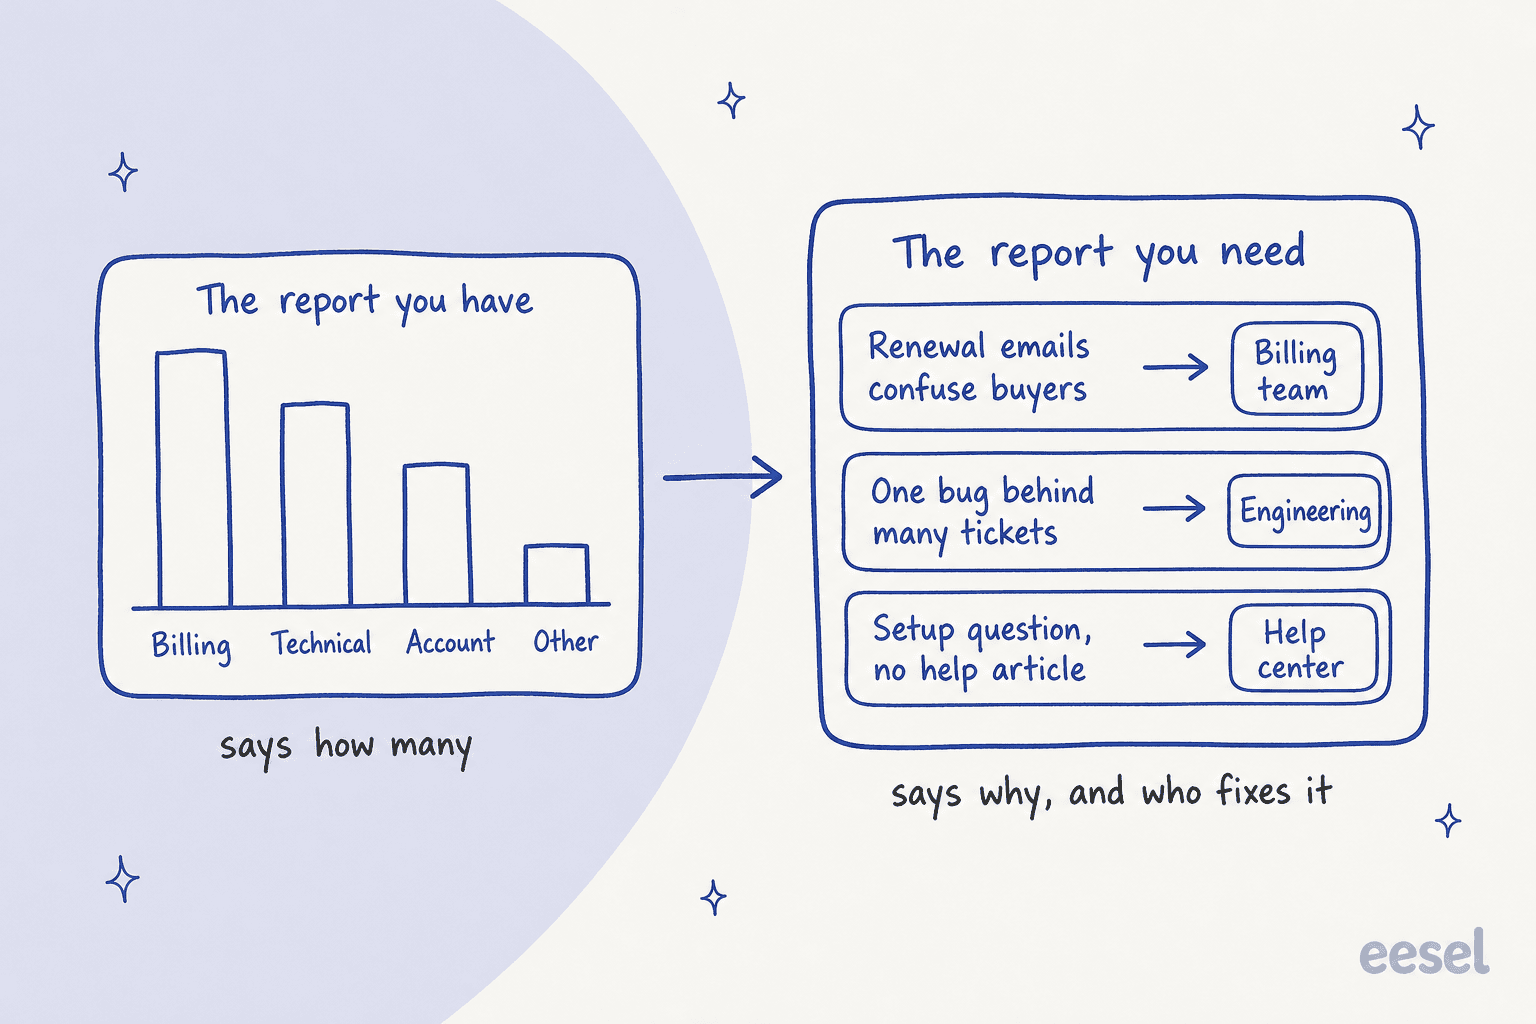
Voici à quoi ressemble chaque tâche en pratique :
| Tâche | Ce que fait l'IA | Ce que vous obtenez dans le rapport |
|---|---|---|
| Motifs de contact | Lit l'objet et le fil, choisit un motif dans votre liste | Volume par motif réel, pas par « Autre » |
| Sentiment | Classe chaque message en positif, neutre ou négatif | Quels motifs irritent le plus les clients |
| Pics | Compare cette semaine aux semaines récentes par motif ou par groupe | Une alerte avant la réunion hebdomadaire, pas après |
| Lacunes de connaissances | Note les questions qu'elle n'a pas pu traiter avec vos documents | Une liste d'articles d'aide à écrire |
| Résumé rédigé | Transforme les chiffres en quelques phrases avec des exemples | Un rapport que les personnes hors du support liront |
Pour le côté technique de la première tâche, mon guide sur l'étiquetage du support par IA va plus loin, et l'analyse de sentiment par IA pour le support couvre la deuxième.
Pourquoi vos rapports de support actuels n'expliquent-ils pas pourquoi les tickets arrivent ?
Vos rapports actuels ne peuvent pas expliquer pourquoi les tickets arrivent parce que le champ du motif est rempli à la main, à la fin d'un ticket, par des personnes fatiguées. Chaque agent étiquette un peu différemment et la moitié des tickets finit dans un fourre-tout, ce qui n'aide pas quand la liste déroulante a été conçue deux lancements de produit plus tôt.
"We have been using ZD for a number of years but the system was never designed properly. Most tickets are not being tagged properly and we find it very difficult to see trends."

Vient ensuite le générateur de rapports. Les tableaux de bord natifs se débrouillent bien pour les volumes, le délai de première réponse et les SLA, et sont beaucoup plus faibles pour dire ce qu'il y a derrière un chiffre. Chaque semaine, les équipes exportent donc vers un tableur ou un outil de BI, et c'est dans cet export que les heures partent vraiment.
"the native dashboards are fine for weekly pulse checks but anything deeper gets messy fast, I end up pulling everything into a BI tool anyway for proper trend analysis and sentiment tracking"
Le troisième problème est la responsabilité. Même un bon rapport tend à s'arrêter à « les tickets de facturation ont augmenté de 20 % ». Il ne dira pas que l'e-mail de renouvellement est confus, et il ne le transmettra pas non plus à la personne responsable de cet e-mail. Cette étape est celle qui réduit réellement les tickets, et si je concevais un dispositif de reporting de zéro, je bâtirais tout autour d'elle. Les indicateurs standard figurent dans mon article sur les KPI du service client ; celui-ci traite de la couche qui se place au-dessus.
Quel reporting par IA votre helpdesk inclut-il déjà ?
La plupart des grands helpdesks proposent désormais l'étiquetage de sujets par IA, même si le forfait nécessaire varie beaucoup. Avant d'acheter quoi que ce soit, vérifiez ce que vous payez déjà. Voici ce que disent les documentations de chaque éditeur, consultées le 29 octobre 2026 :
| Helpdesk | Étiquetage IA par motif | Sentiment | Demander un rapport en langage courant | Alertes de pics ou d'anomalies | Signal de lacunes de connaissances | Forfait requis |
|---|---|---|---|---|---|---|
| Zendesk | Tri intelligent : sujet, entité, langue | Oui, dans le tableau de bord de tri | Rapports rapides | Via le module Zendesk QA (Spotlight) | Module Zendesk QA | Suite Professional, $115/agent/mois en annuel |
| Freshdesk | Regroupements de sujets pour les chats de son agent IA | Non couvert dans ces documents | Conversational Insights | Proactive Insights avec cause racine | Onglet Improve pour son agent IA | Insights avec Enterprise, $89/agent/mois en annuel |
| Gorgias | Intention sur chaque message | Un sentiment par message | Introuvable | Introuvable | Transferts par article | Tous les forfaits Helpdesk, à partir de $10/mois |
| HubSpot | Sujets (bêta) | Score CX | Breeze explique un rapport existant | Introuvable | Le score CX signale les documents de libre-service peu clairs | Service Hub Professional, $90 à $100/poste/mois |
| Help Scout | AI Topics (bêta), 8 à 15 par boîte | Introuvable | Via son serveur MCP dans Claude ou ChatGPT | Une analyse quotidienne crée de nouveaux sujets | Introuvable | Plus $45/utilisateur/mois |
| Front | AI Topics, 85 % de précision moyenne | Smart CSAT avec Enterprise | Introuvable | Introuvable | Introuvable | Starter $25/poste/mois |
Quelques détails méritent d'être connus avant de vous appuyer sur l'un d'eux.
Zendesk a ramené le tri intelligent aux forfaits Professional en juillet 2026 sans frais supplémentaires. Utiliser un sujet dans une règle de routage exige toutefois toujours le module Copilot à $50 par agent. Le tableau de bord de tri comporte les onglets Overview, Topic, Entity, Language et Sentiment. Une particularité à connaître : il conserve la valeur attribuée en premier par le tri, de sorte que lorsqu'un agent corrige le sujet plus tard, le tableau de bord affiche toujours l'original. Avec Quick reports, vous tapez une question au lieu de choisir des indicateurs, mais c'est limité au jeu de données Tickets et à des prompts de 200 caractères, sans champs personnalisés. Plus de détails dans mon guide du tri intelligent de Zendesk.
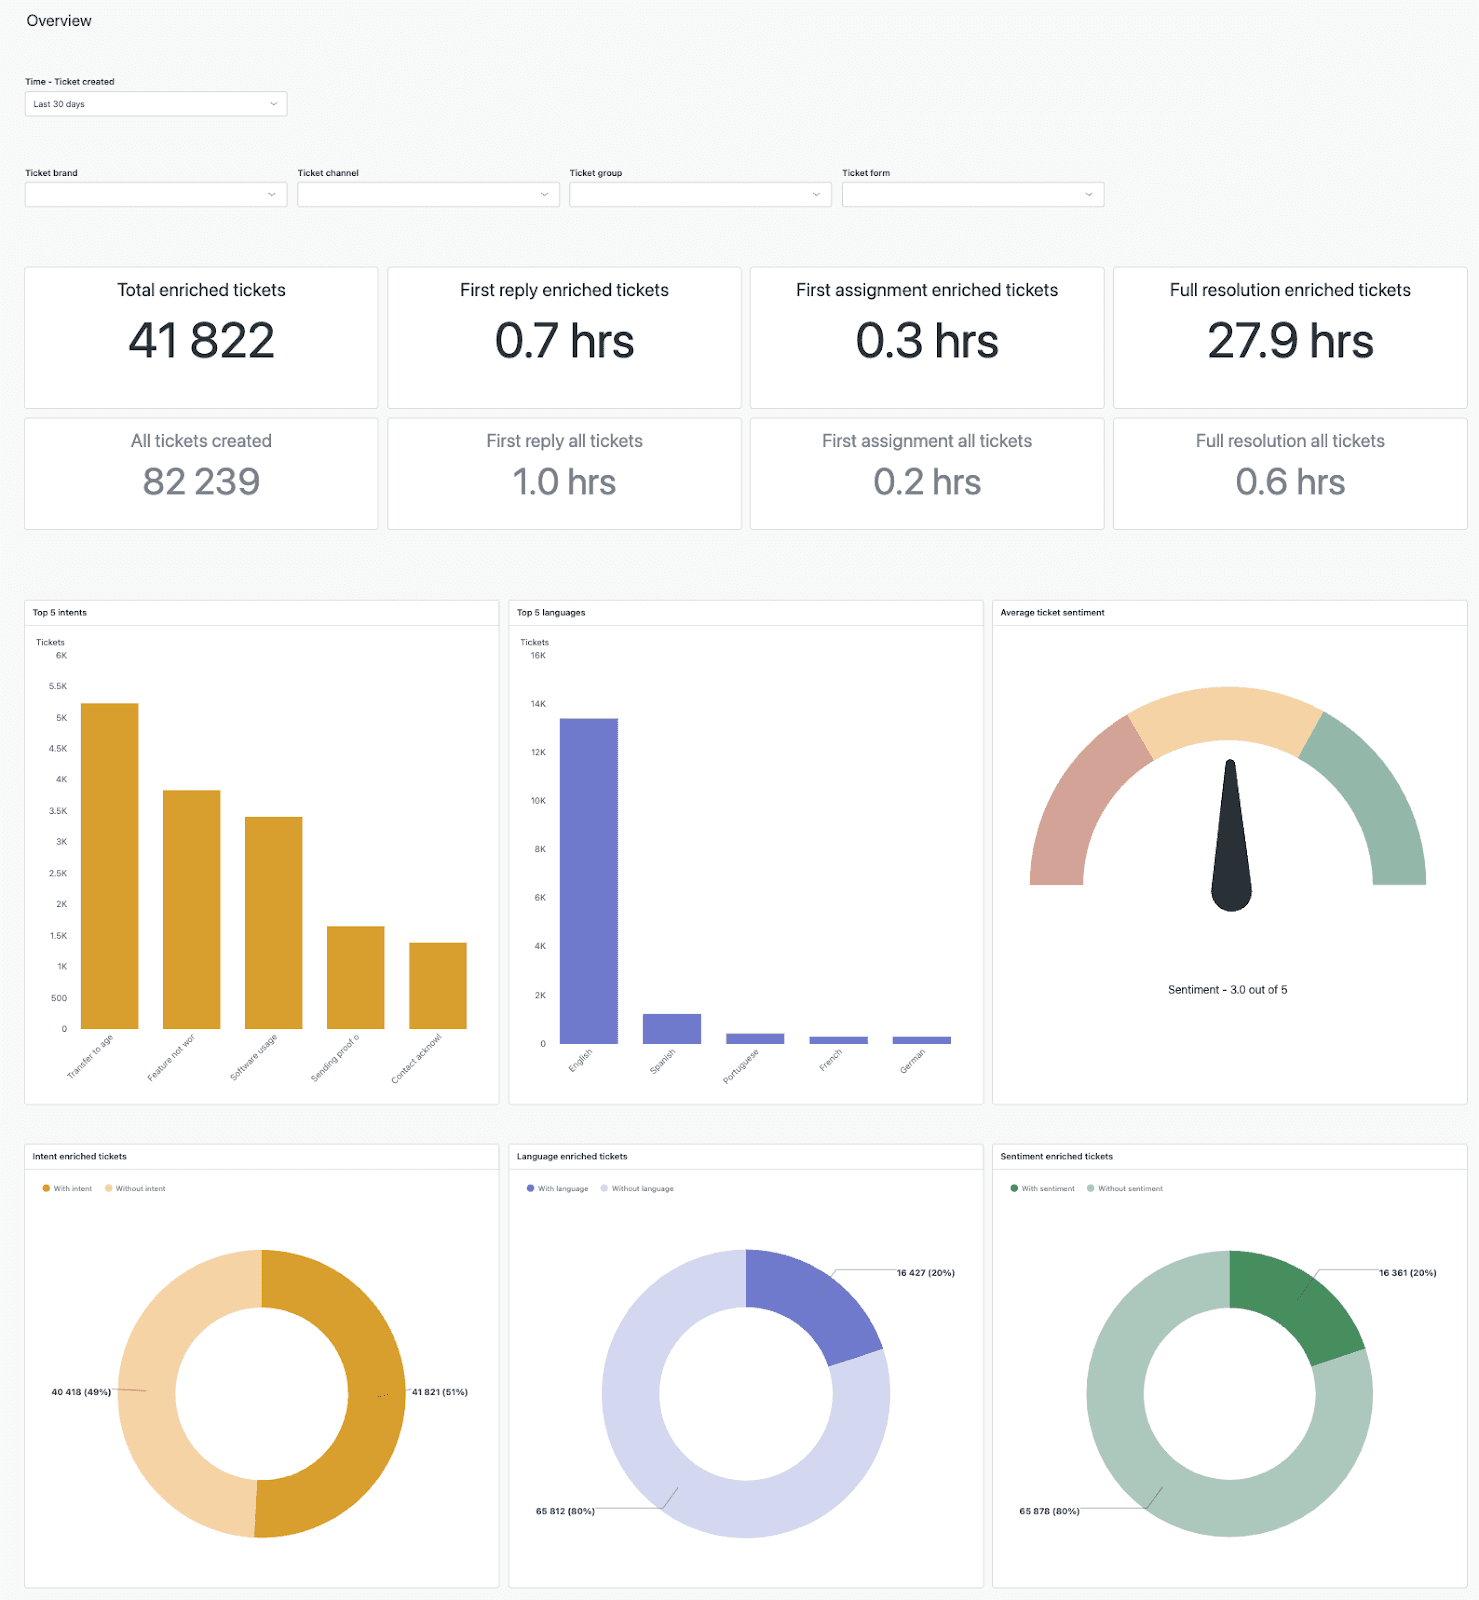
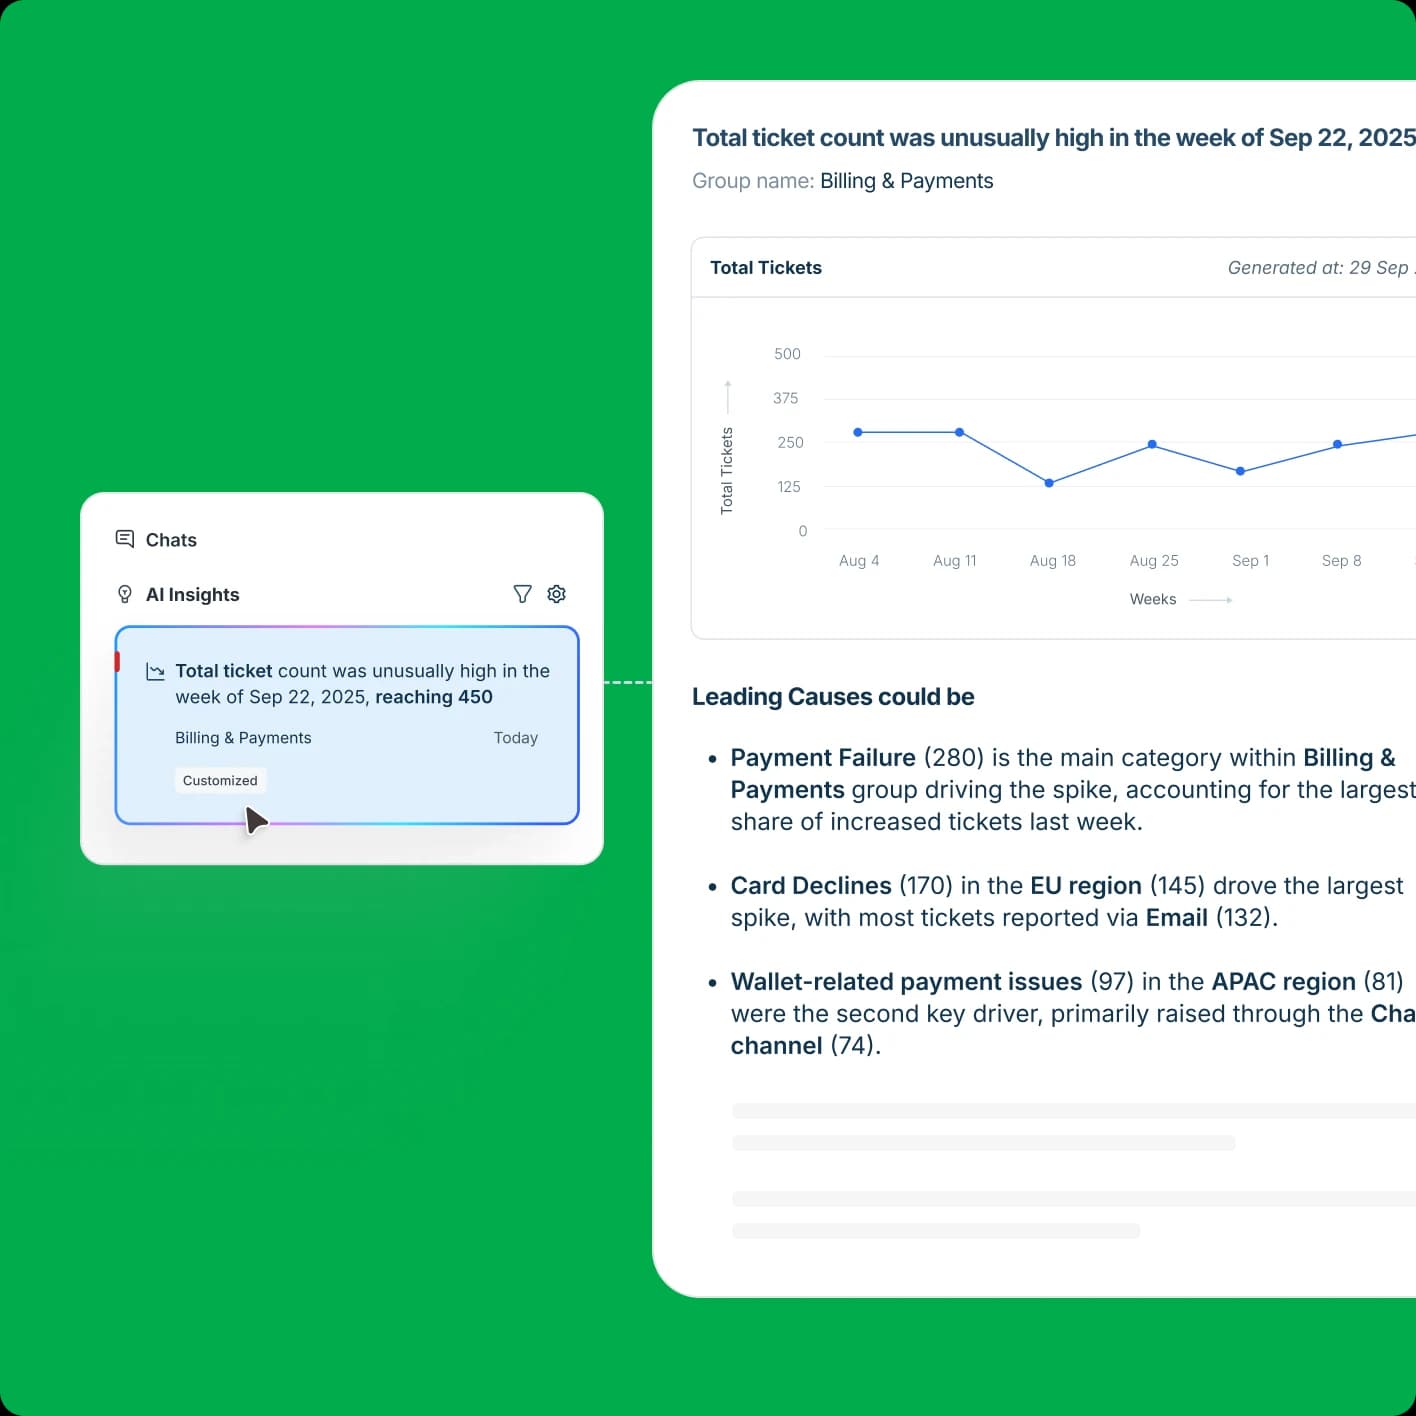
Freshdesk est le seul des six à documenter une vraie détection de pics avec un arbre de cause racine. Proactive Insights signale les valeurs aberrantes et les changements de tendance par groupe d'agents, tandis que Root Cause Analysis suit le « chemin critique » derrière une mauvaise semaine. Sa propre FAQ énumère les limites : anglais uniquement, actualisation hebdomadaire, au moins 10 tickets en 12 semaines par groupe, et pas encore d'alertes par e-mail ou Slack. La configuration est décrite dans mon article sur Freddy AI Insights.
Gorgias détecte l'intention et le sentiment sur chaque message entrant, en choisissant dans une liste fixe (Order/Damaged, Refund/Request, etc.), et ce sur tous les forfaits Helpdesk. Le signal de reporting le plus utile concerne son AI Agent, où chaque article d'aide affiche ses transferts, et Gorgias affirme que "handovers are the clearest signal" qu'un contenu doit être mis à jour. Mon guide des rapports Gorgias en dit plus.
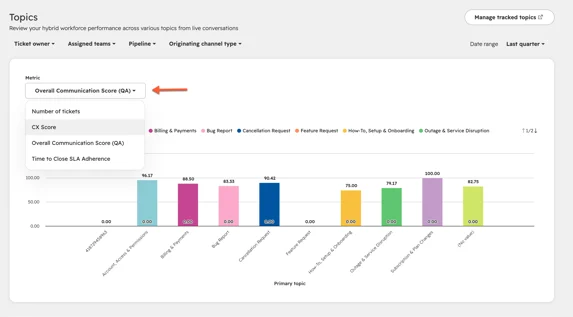
HubSpot Topics est en bêta sur Service Hub Professional et Enterprise. Son rapport met côte à côte, par sujet, le nombre de tickets, le score CX, le score QA et le respect des SLA, ce qui se rapproche davantage de « que dois-je corriger » qu'un simple décompte.
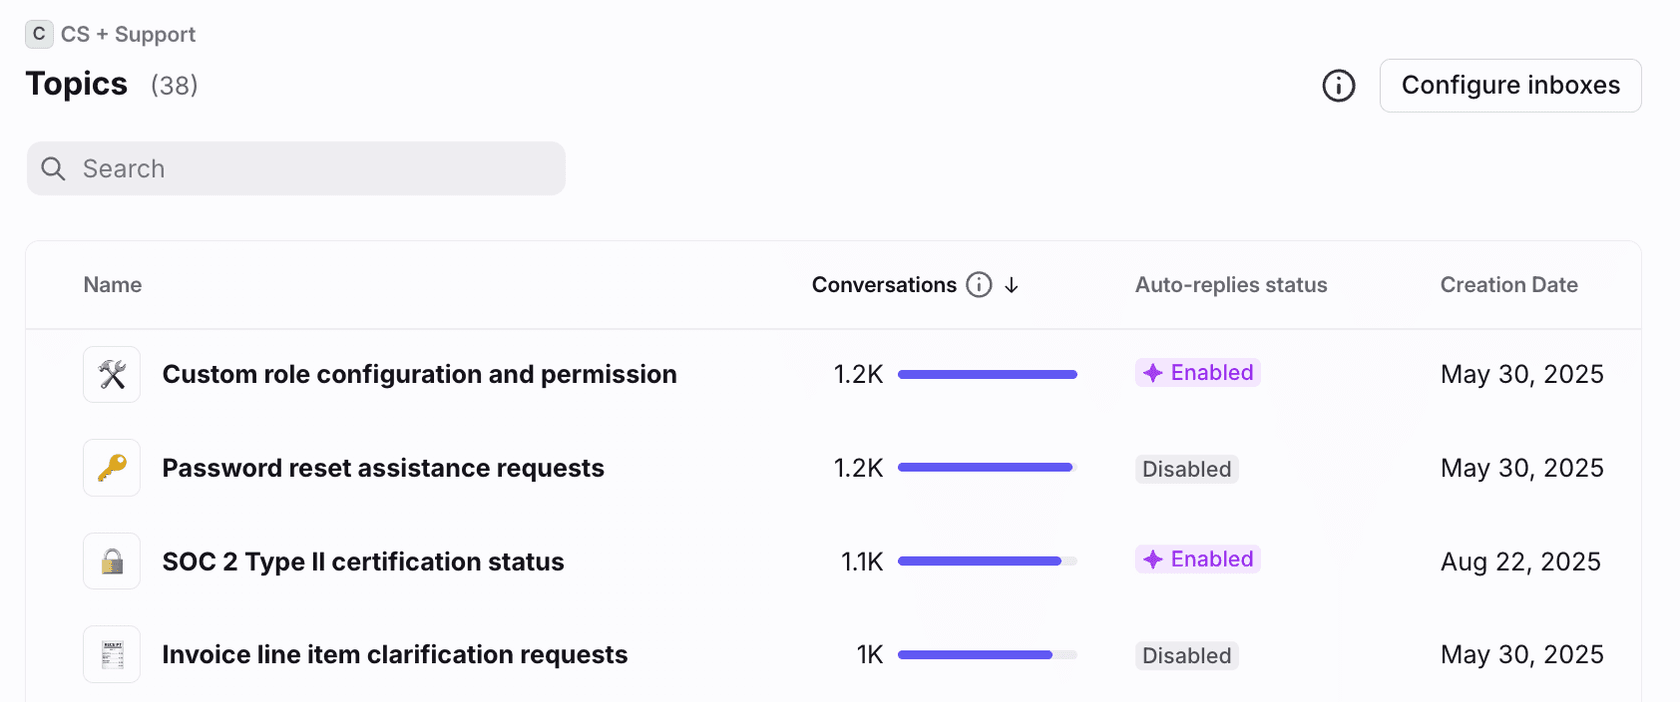
Help Scout AI Topics propose de 8 à 15 sujets par boîte, et une analyse quotidienne peut créer un nouveau sujet quand une tendance apparaît. Front Topics regroupe les conversations en motifs de contact. Il est conçu pour les boîtes de plus de 1 000 conversations par mois et affiche une précision moyenne d'attribution de 85 %.
Où les rapports d'IA intégrés montrent-ils leurs limites ?
Les rapports d'IA intégrés montrent leurs limites à trois endroits : les étiquettes dérivent, le périmètre est étroit et le rapport s'arrête à un graphique. Rien de tout cela n'est une raison de s'en passer. Voyez-y plutôt des points à anticiper.
Les étiquettes dérivent et ne sont lues qu'une fois. Plusieurs de ces outils ne classent que d'après le premier message. Un ticket qui commence comme une question de livraison et devient un remboursement garde la première étiquette reçue. Front publie une précision moyenne de 85 %, ce qui est honnête et utile, et signifie aussi qu'environ un ticket sur sept se trouve dans le mauvais casier.
"it only detects the parameters on the first ticket, so if a customer goes from angry to happy or vice versa, or has a new need/"intent" on the same ticket, nothing is updated. Intent is not always accurate, therefore is a little bit difficult to make rules according to it, and even language detection does not work from time to time"
Les meilleurs signaux ne couvrent que le bot de l'éditeur. L'onglet Improve de Freshdesk, les transferts par article de Gorgias et les ventilations Autopilot de Front sont tous solides, mais ils décrivent surtout des conversations traitées par l'agent IA de l'éditeur. Les tickets auxquels répond votre équipe humaine n'alimentent pas la même vue des lacunes de connaissances.
Un graphique n'est pas une correction. Tous les outils ci-dessus peuvent vous montrer que les tickets de facturation ont augmenté. Relier cela à l'e-mail de renouvellement et l'envoyer au responsable de la facturation demande une personne, ou un agent qui suit vos instructions. Si l'IA vous épargne l'export mais que personne n'agit, les heures se déplacent simplement ailleurs.
"The ticket still needs tagging, the CRM still needs updating, the summary still needs writing, and half the time someone has to re categorise it anyway because the bot picked the wrong macro. So my team's hours did not really go down. They just shifted to cleanup work"
Contre la dérive, la réponse pratique est une liste de motifs fixe dans laquelle l'IA choisit sans jamais inventer, accompagnée d'un coup d'œil hebdomadaire sur un échantillon d'étiquettes. J'ai détaillé le réglage dans mon guide sur les faux positifs de l'étiquetage de tickets.
Comment transformer les thèmes de tickets en corrections ?
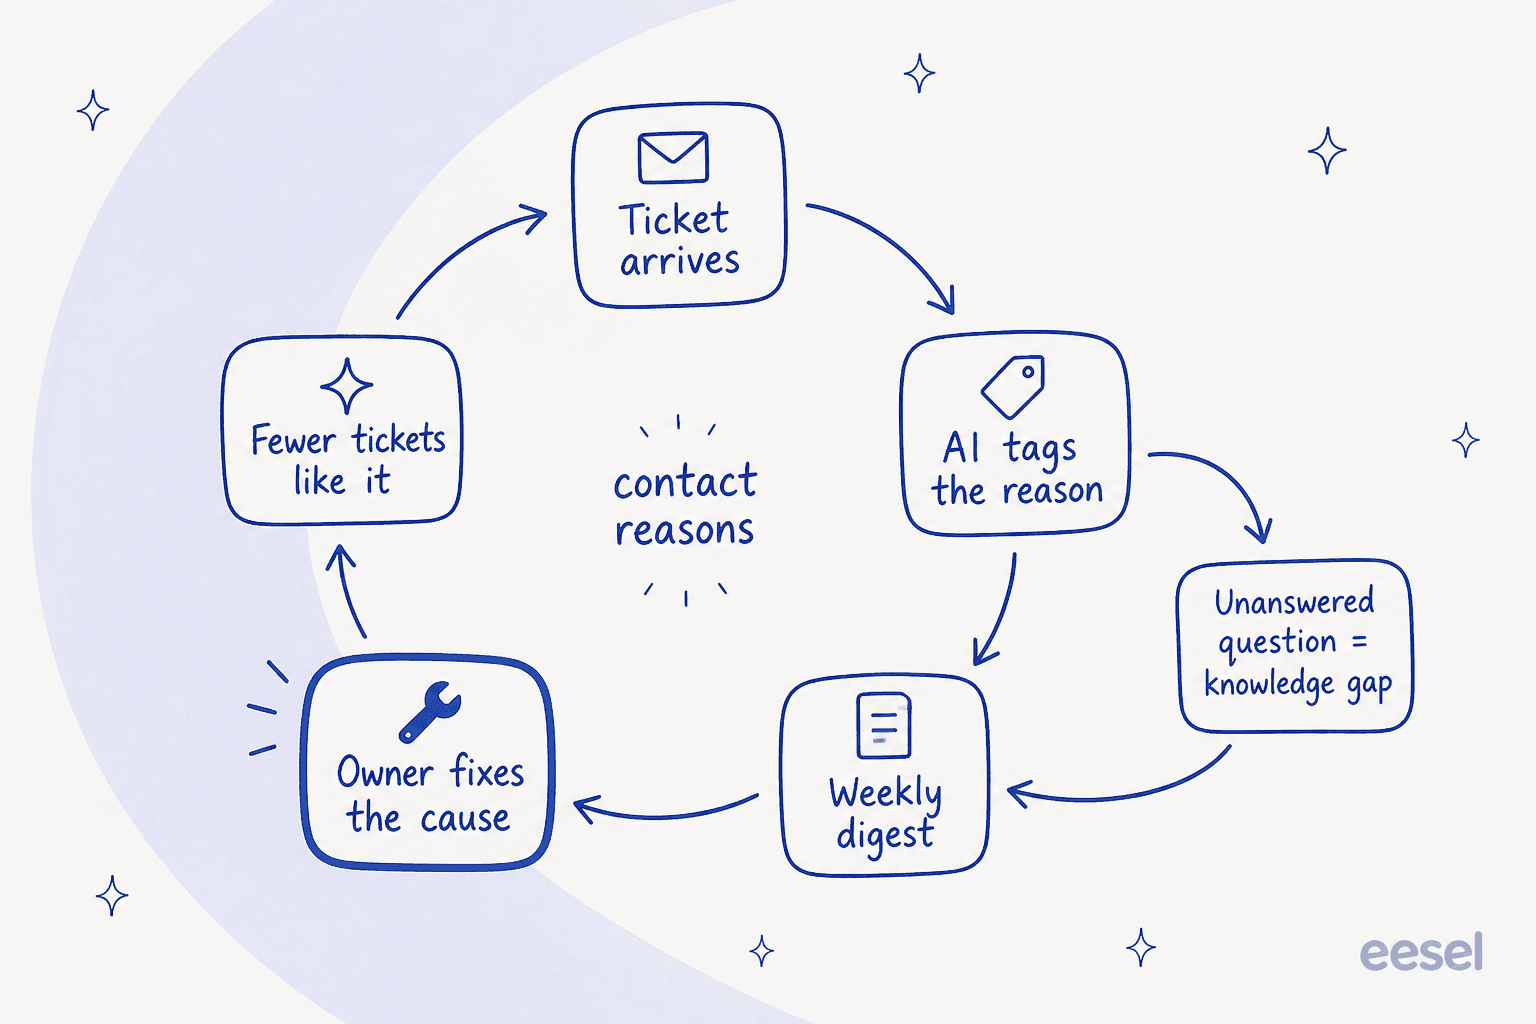
Vous transformez les thèmes de tickets en corrections en donnant à chaque motif de contact un responsable hors du support, plus un créneau hebdomadaire pour l'examiner. L'IA rend cette boucle peu coûteuse. Elle étiquette le motif à l'arrivée du ticket, note ce qu'elle n'a pas pu traiter, rédige le récapitulatif et vous montre la semaine suivante si la correction a fonctionné.
Tous les motifs ne méritent pas une correction. La répartition que je trouve utile oppose la fréquence d'un motif à ce que chacun coûte à votre équipe, c'est-à-dire surtout le temps de traitement plus les recontacts :
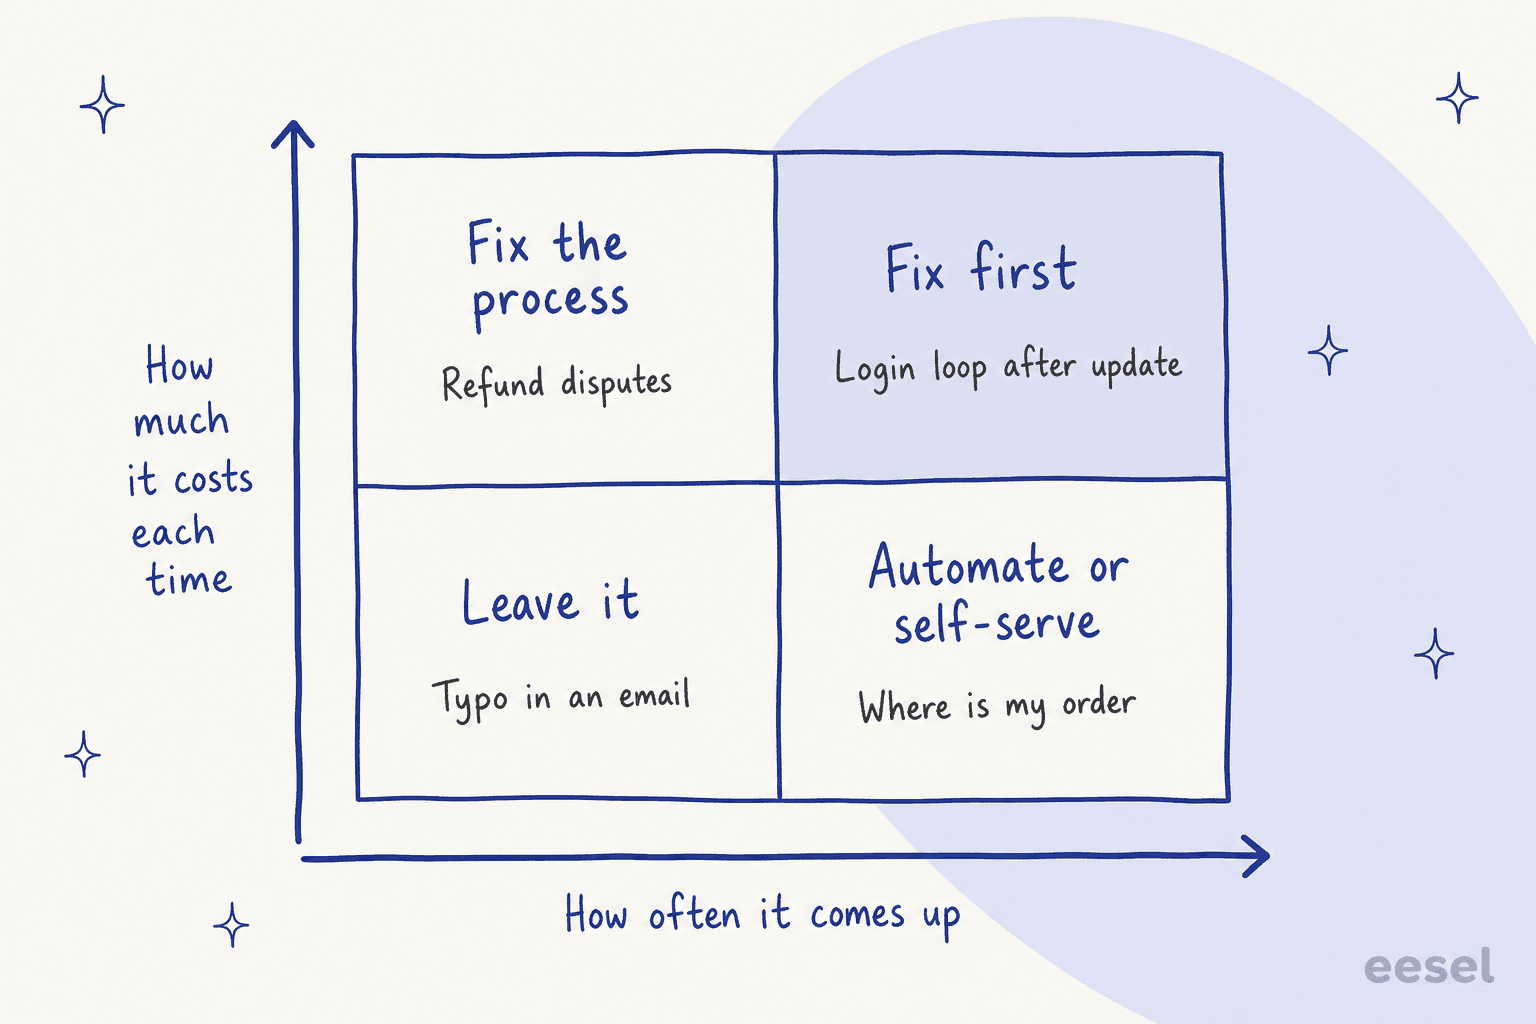
- Fréquent et coûteux : à corriger en premier. Une boucle de connexion après une mise à jour est un bug, et l'ingénierie a besoin d'un décompte hebdomadaire avec des tickets d'exemple.
- Rare et coûteux : corriger le processus. Les litiges de remboursement appellent généralement une politique plus claire plutôt que plus d'agents.
- Fréquent et peu coûteux : automatiser ou proposer en libre-service. « Où est ma commande » est le cas classique, et un agent IA avec consultation des commandes peut y répondre de bout en bout. L'effet sur vos moyennes est détaillé dans mon article sur l'IA pour réduire le temps de traitement.
- Rare et peu coûteux : laisser tel quel. Toute faute de frappe n'a pas besoin d'un projet.
L'erreur que je vois le plus souvent est de classer uniquement par volume. Un motif avec moins de tickets, mais des contacts longs et répétés, peut discrètement consommer plus d'heures d'agent que la plus grosse catégorie.
Combien chaque motif de contact vous coûte-t-il ?
Chaque motif de contact coûte ses tickets multipliés par les minutes par ticket, plus les recontacts qu'il provoque, le tout multiplié par le coût d'une heure d'agent. Saisissez vos propres chiffres ci-dessous et les motifs sont reclassés par coût plutôt que par nombre.
Avec les chiffres d'exemple, « Where is my order » a le plus de tickets, mais le problème de connexion coûte plus, parce que chacun prend 14 minutes et que 30% de ces clients écrivent de nouveau. Un rapport qui ne compte que le volume masque précisément ce genre de reclassement. Les nombres de tickets viennent de vos données d'étiquettes ; la plupart des helpdesks indiquent aussi le temps de traitement et les réouvertures par étiquette, et mon article sur les indicateurs du service client par IA montre où les trouver.
Quels indicateurs doivent figurer dans un rapport de support par IA ?
Un rapport de support par IA a besoin de six indicateurs par motif de contact, pas de vingt pour toute la file. Ces six-là vous disent quoi corriger et si la correction a fonctionné :
| Indicateur | Ce qu'il vous dit | Où l'IA aide |
|---|---|---|
| Volume par motif de contact, d'une semaine à l'autre | Ce qui croît ou diminue | Étiquettes cohérentes sur chaque ticket |
| Taux de recontact par motif | Quels problèmes ne sont pas vraiment résolus | Relie les relances au même motif |
| Temps de traitement par motif | Quels motifs consomment des heures d'agent | Décompose la moyenne globale |
| Taux d'escalade ou de transfert par motif | Quels motifs nécessitent une personne ou une politique | Montre où l'IA ou le niveau 1 s'arrête |
| Sentiment par motif | Quels motifs irritent le plus les clients | Détecte le ton sans enquêtes |
| Lacunes de connaissances par motif | Quels articles d'aide manquent | Consigne les questions que les documents n'ont pas pu traiter |
Deux autres méritent d'être gardés à l'œil pour l'IA elle-même : la fréquence à laquelle on corrige ses étiquettes, et celle à laquelle on rejette ses brouillons ou ses actions. Si l'un des deux augmente, corrigez la liste de motifs ou les consignes avant de vous fier aux tendances. Pourquoi le chiffre de réussite d'un bot demande la même prudence, c'est dans mon article sur la déflexion et le taux de résolution, et le CSAT par IA traite de la satisfaction notée par une IA.
Comment mettre en place le reporting du support par IA en 30 jours ?
Vous pouvez mettre en place le reporting du support par IA en environ 30 jours si vous fixez d'abord la liste de motifs et n'automatisez le rapport qu'ensuite. Dans l'ordre :
- Semaine 1 : rédigez la liste de motifs. Récupérez les tickets des 60 à 90 derniers jours et rédigez 15 à 25 motifs de contact avec les mots de vos clients, chacun avec une définition d'une ligne et un responsable. Supprimez « Autre », ou au moins plafonnez-le.
- Semaine 1 : vérifiez ce que vous avez déjà. Utilisez le tableau ci-dessus. Si votre forfait inclut déjà les sujets par IA, activez-les et comparez leurs sujets à votre liste.
- Semaine 2 : étiquetez à l'arrivée. Demandez à l'IA de choisir un motif dans la liste fixe sur chaque nouveau ticket et de consigner une lacune de connaissances chaque fois qu'elle ne peut pas répondre avec vos documents. En fin de semaine, vérifiez 50 étiquettes à la main.
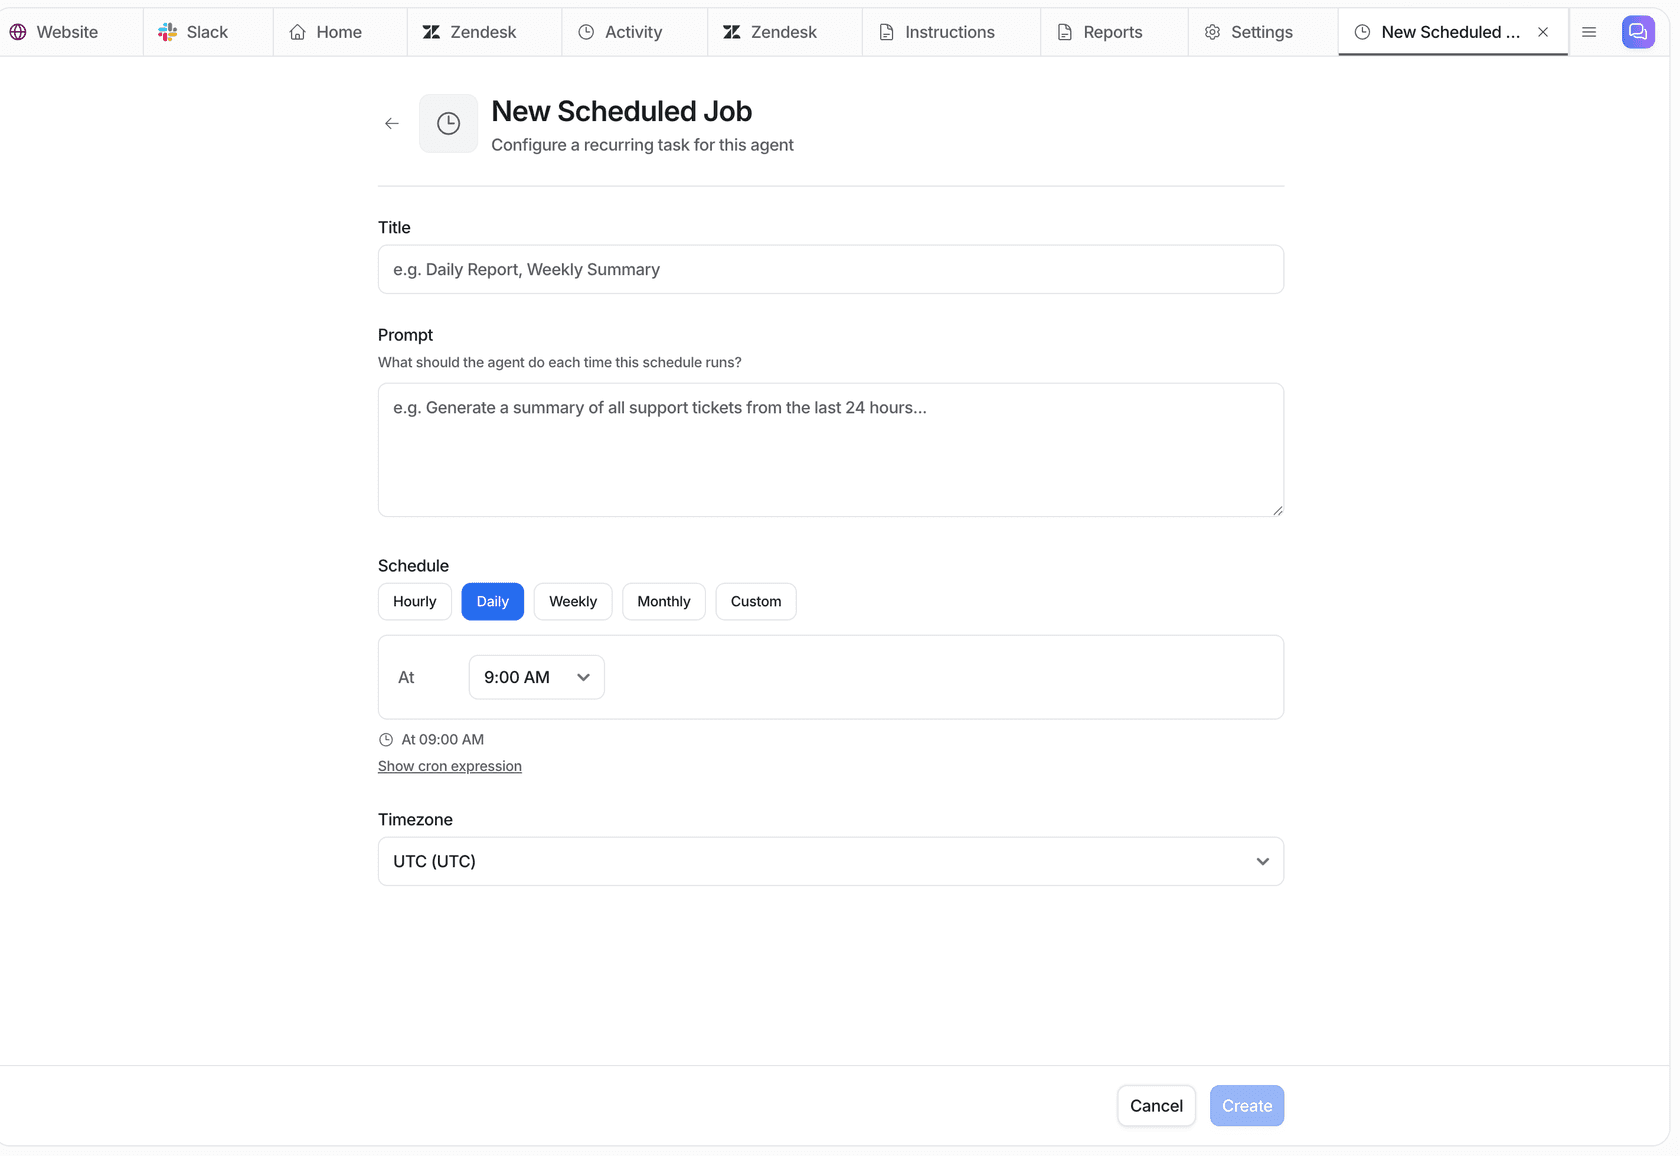
- Semaine 3 : planifiez le récapitulatif. Un rapport hebdomadaire le même jour à la même heure, avec le volume et la variation par motif, les trois principales lacunes, trois tickets d'exemple par constat et une correction recommandée par responsable.
- Semaine 4 : bouclez la boucle. En réunion, chaque responsable prend une correction. Le récapitulatif suivant montre alors si le volume et les recontacts pour ce motif ont bougé.
Si vous utilisez Zendesk Explore aujourd'hui, les rapports planifiés de Zendesk couvrent l'étape de diffusion. Le plus difficile reste les étapes 1 et 5.
Comment eesel gère-t-il le reporting du support ?
eesel gère le reporting du support depuis l'intérieur de la file. Le même coéquipier IA qui répond à vos tickets ou en rédige les brouillons les étiquette aussi à partir de votre liste, consigne ce qu'il n'a pas pu traiter et rédige le rapport que vous demandez. Il rejoint Zendesk, Freshdesk, Gorgias, HubSpot, Help Scout ou Front, donc il n'y a aucune étape d'export.
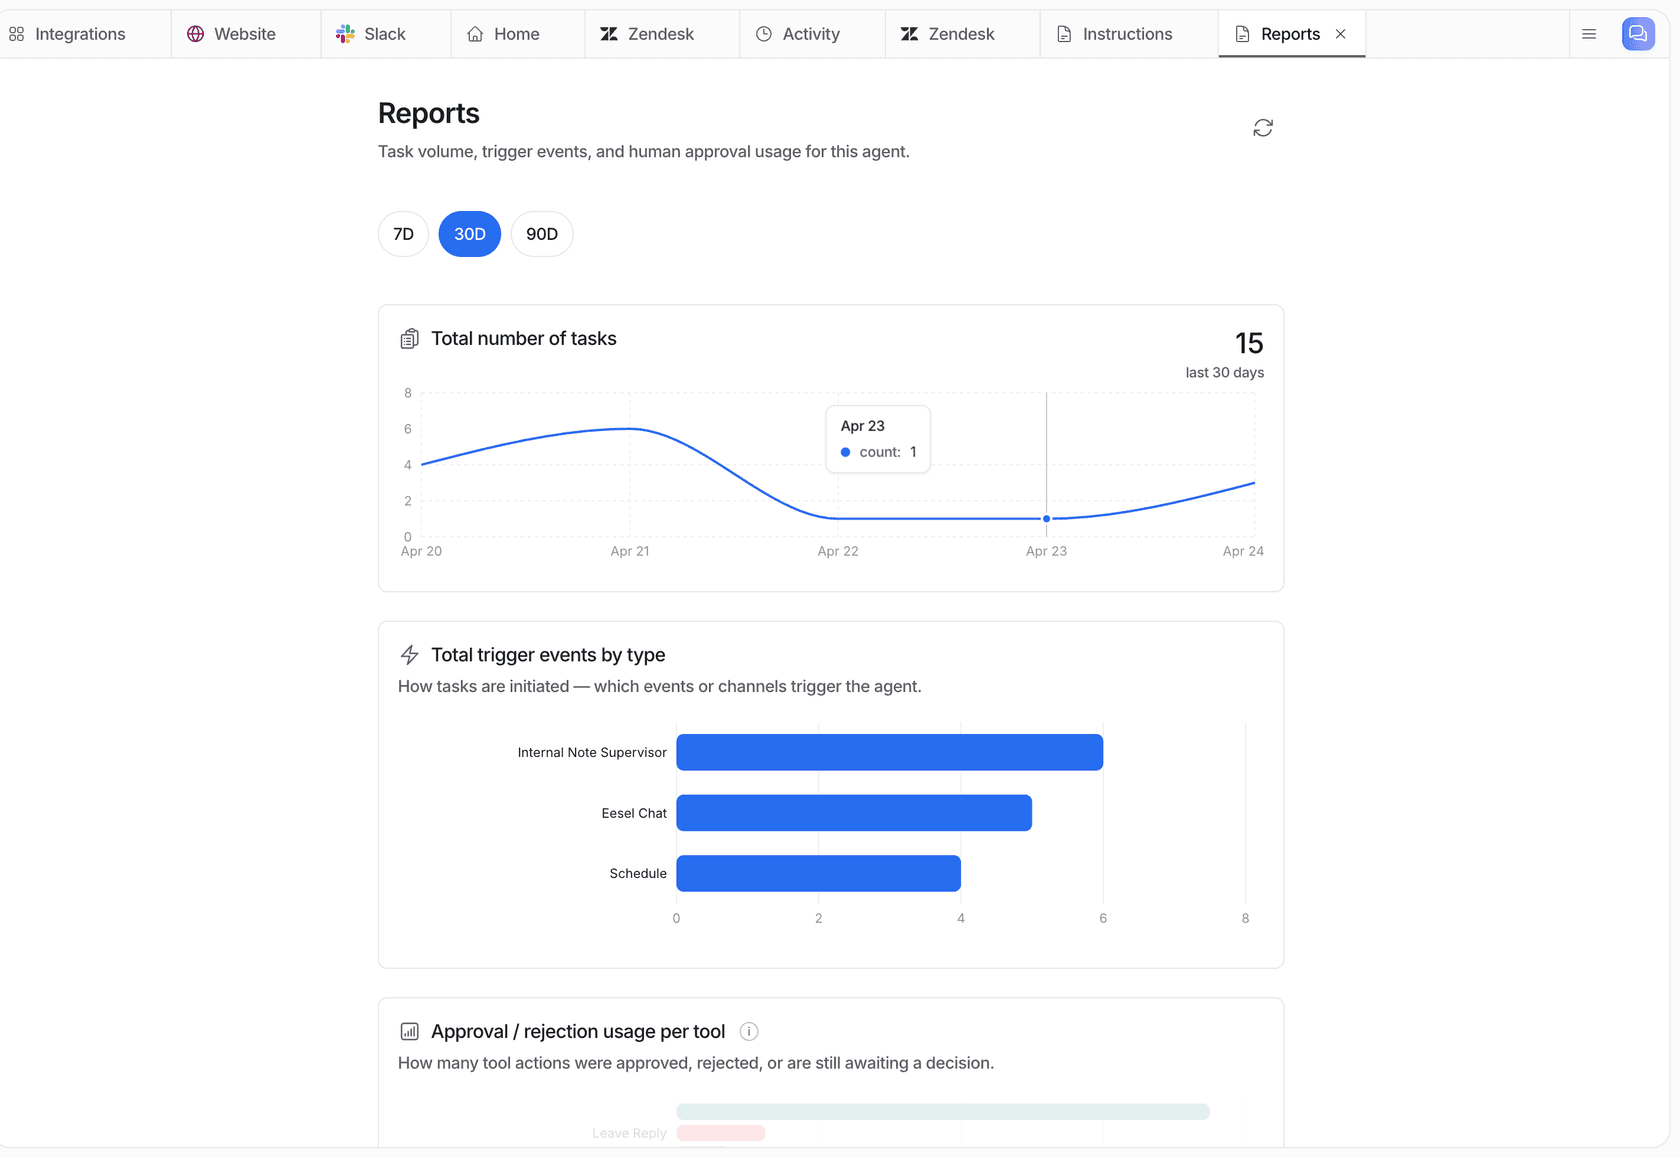
La page Reports affiche le volume, un score de qualité de l'IA, les lacunes de connaissances dans le temps et la fréquence à laquelle votre équipe approuve ou rejette ses actions, sur 24 heures, 7, 30 ou 90 jours, ou une période personnalisée. Une remarque honnête tirée de la documentation d'eesel : le score de qualité "is not customer feedback". C'est la note qu'une IA donne aux réponses de l'agent, je le lirais donc comme un signal interne.
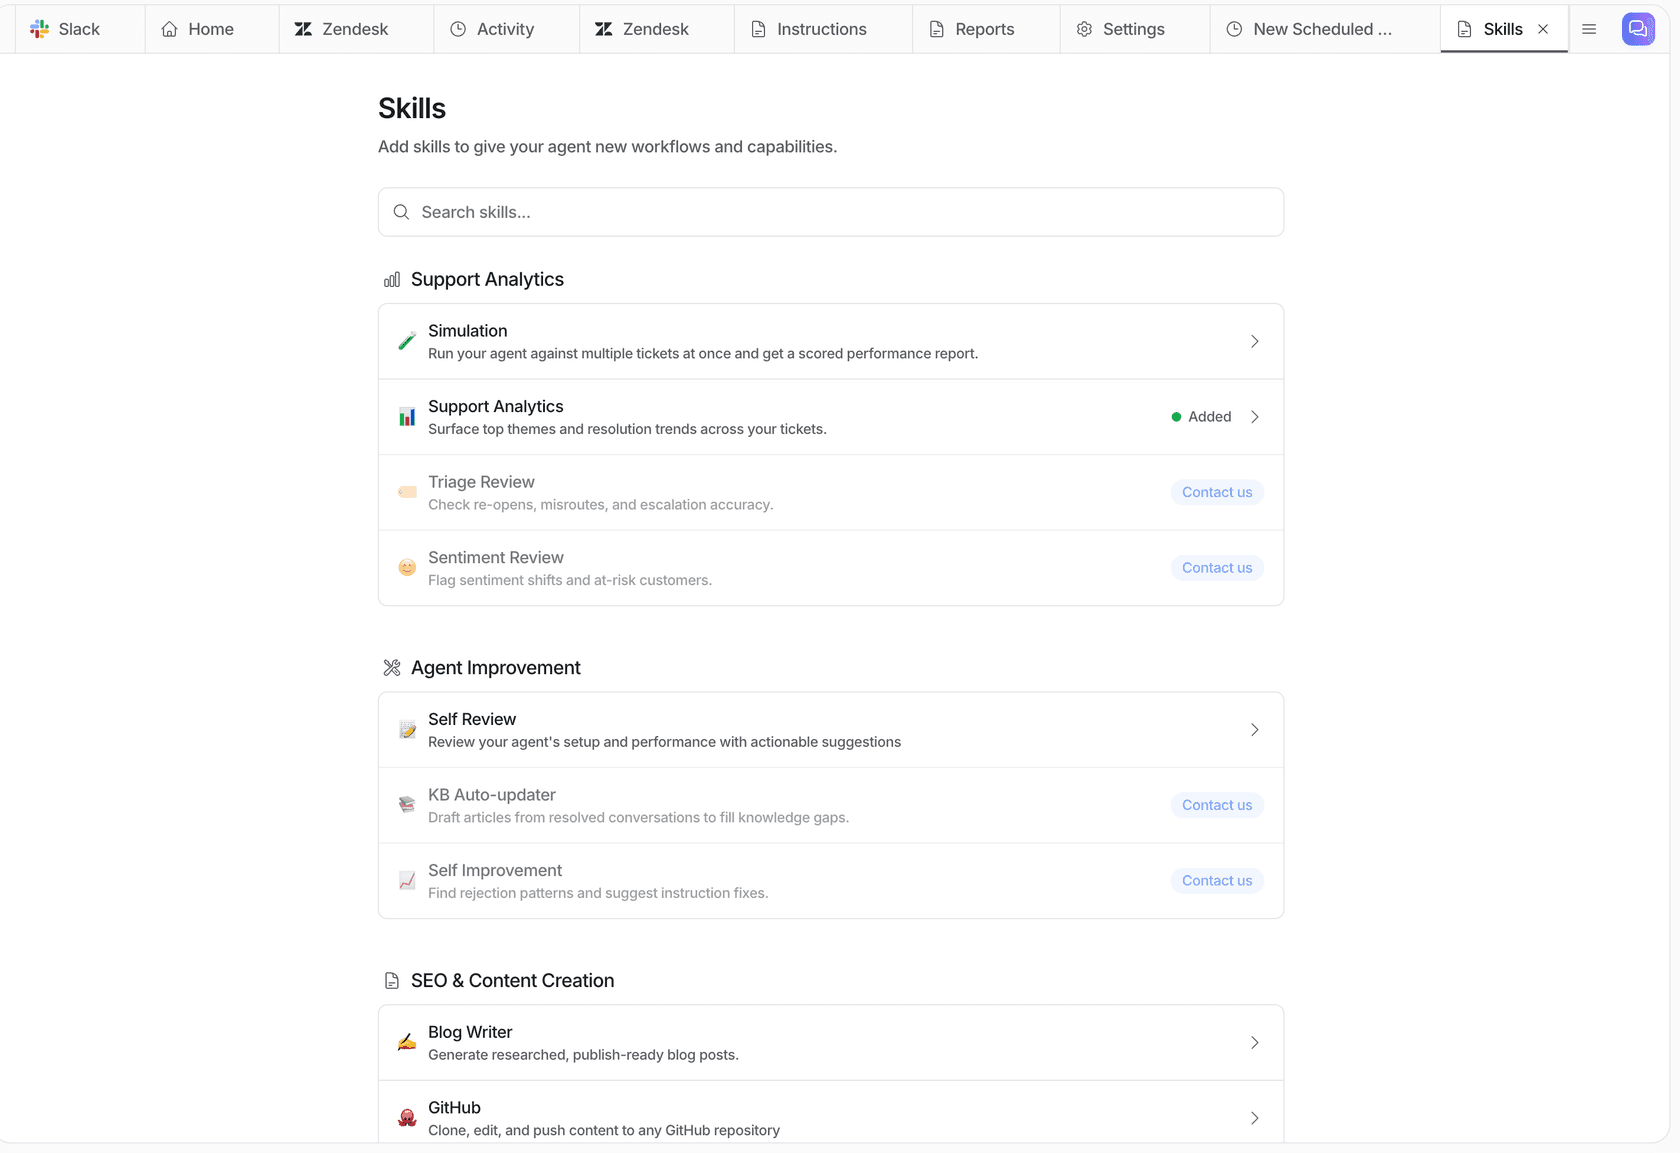
Pour le rapport rédigé, il suffit de le demander dans le chat. Le skill Analyze ticket trends trouve les thèmes récurrents avec le sentiment, le volume et la façon dont ils sont résolus. L'exemple Weekly support report de la documentation des Skills couvre le volume et la tendance par thème, ce que l'IA a traité par rapport à ce qu'elle a transmis, les lacunes de connaissances et ce qu'il faut corriger en premier, et il est envoyé par e-mail chaque lundi. Il existe aussi un Knowledge gaps report qui regroupe par sujet les questions sans réponse des 30 derniers jours et rédige les trois pages les plus manquantes.
Voici ce que cela donne chez de vrais clients :
- smava reçoit environ
27,000tickets Zendesk par mois sur deux marques. Un agent eesel étiquette la langue et choisit une seule catégorie dans une liste fixe pour chaque ticket, soit environ14,600catégorisés en un mois, et les écrit dans des champs Zendesk que leurs rapports utilisent déjà. - Rúngne fait tourner un agent de tri sur Gorgias qui étiquette le sujet, VIP et B2B à partir d'une liste fixe, avec "nothing invented" : environ
880tickets étiquetés en un mois. - Dokument 24 fait étiqueter par eesel chaque nouveau ticket Zendesk par produit (testament, contrat de mariage, mandat de protection future ou création d'entreprise), ce qui représente environ
430tickets étiquetés en un mois. - Cape Coffee Beans lance cinq balayages planifiés de Zendesk, la plupart chaque matin, à la recherche de tickets non assignés, de tickets en attente sans date de suivi et de leads clos sans résultat. Chacun se termine par un court e-mail au fondateur, ou par aucun e-mail quand il n'y a rien à signaler. Un rapport hebdomadaire sur les lacunes de contenu regroupées par produit est déjà rédigé et prêt à être activé.
- Une entreprise d'automatisation industrielle envoie à son équipe de documentation un récapitulatif régulier de ce qu'on a demandé au chat, des réponses mal notées et des lacunes de connaissances. Ces lacunes alimentent directement le backlog de documentation.
Une objection que j'entends chez les acheteurs : les rapports regardent en arrière, alors que les clients ont besoin de la bonne réponse maintenant. C'est juste. C'est aussi pourquoi l'étiquetage et le routage s'exécutent à l'arrivée, dès le premier message du client dans Zendesk, et le rapport n'est que la vue hebdomadaire de ces mêmes données.
Si votre équipe vit dans un terminal, la CLI eesel pilote le même agent. eesel activity liste ce qu'il a fait, du plus récent au plus ancien. eesel files récupère les rapports enregistrés, et eesel chat "analyze our ticket trends for last month" lance le skill de tendances depuis un script. Chaque commande affiche du JSON, de sorte que Claude Code, Cursor ou Codex peuvent récupérer les chiffres dans le tableau de bord que vous tenez déjà.
Combien coûte l'IA pour le reporting du support ?
L'IA pour le reporting du support ne coûte rien de plus si votre forfait helpdesk actuel inclut déjà les sujets par IA. Sinon, le coût se situe entre une montée en gamme du forfait et un outil d'IA séparé. Les points d'entrée courants, tirés de la page de tarifs de chaque éditeur :
| Option | Ce que vous payez | Ce que cela couvre |
|---|---|---|
| Zendesk Suite Professional | $115/agent/mois en annuel, Copilot $50/agent/mois pour utiliser les sujets dans les règles | Étiquettes du tri intelligent, tableau de bord de tri, rapports rapides |
| Freshdesk Enterprise | $89/agent/mois en annuel | Proactive Insights, cause racine, Conversational Insights |
| Gorgias | Helpdesk à partir de $10/mois | Intention et sentiment sur chaque message |
| HubSpot Service Hub Professional | $90 à $100/poste/mois | Sujets (bêta), score CX, synthèses de rapports Breeze |
| Help Scout Plus | $45/utilisateur/mois | AI Topics (bêta) et rapport Topics |
| Front Starter | $25/poste/mois | AI Topics |
| eesel | Gratuit avec 100 crédits, puis $299/mois pour 500 crédits jusqu'à $1,749/mois pour 5 000 | Étiquettes, tri, réponses, rapports et récapitulatifs planifiés sur votre helpdesk existant |
La tarification par poste augmente avec l'équipe, alors que celle d'eesel augmente avec les tickets. Un ticket ou un chat vaut un crédit, et les rapports et exécutions planifiées consomment aussi des crédits, prévoyez donc un peu au-delà de votre volume mensuel de tickets. Si vous êtes sur Freshdesk Pro et voulez des alertes de pics, comparez la montée vers Enterprise pour tous les agents à l'ajout d'un coéquipier qui étiquette et établit des rapports sur les tickets que vous avez déjà. Les grilles complètes des forfaits se trouvent dans mes articles sur les tarifs IA de Zendesk et les tarifs de Freshdesk.
Essayer eesel pour le reporting du support
Si votre lundi matin commence encore par un export de tableur, eesel fonctionne comme un nouveau coéquipier qui a déjà lu tous les tickets de la semaine dernière. Il rejoint votre file Zendesk, Freshdesk, Gorgias ou Help Scout et étiquette chaque ticket à partir de votre propre liste de motifs. Il note chaque question que votre centre d'aide n'a pas pu traiter, puis envoie par e-mail un rapport hebdomadaire avec les thèmes, les lacunes et ce qu'il faut corriger en premier, tout en rédigeant ou en traitant les tickets eux-mêmes.
C'est la configuration que smava fait tourner sur 27,000 tickets Zendesk par mois. Une Simulation sur 20 de vos tickets résolus récemment montre comment ses réponses se comparent à celles de votre équipe avant toute mise en service, et vous commencez avec 100 crédits gratuits, sans carte.
Essayez eesel sur les tickets de la semaine dernière, ou lisez d'abord mon comparatif du tri de tickets par IA.
Comment l'IA peut-elle aider pour le reporting du support ?