

La planification des effectifs du support tient en cinq étapes en boucle : prévoir le volume par intervalle de 30 minutes, multiplier par la durée moyenne de traitement (AHT), appliquer Erlang C aux canaux en direct, ajouter l'absentéisme, puis comparer la prévision à ce qui s'est réellement passé. Sautez-en une et vous obtenez l'échec classique : une équipe dimensionnée sur la moyenne quotidienne qui coule à 10 h le lundi.
Les chiffres bougent plus que la plupart des équipes ne le pensent. À 60 chats par demi-heure et 6 minutes de traitement, Erlang C demande 15 agents sur la file pour répondre à 80 % en 60 secondes, et 30 % d'absentéisme transforment cela en 22 personnes au planning. L'e-mail et les tickets fonctionnent autrement, car ils peuvent attendre : dimensionnez-les sur la fenêtre de SLA, pas avec Erlang C.
Parmi les helpdesks que j'ai examinés, seul Zendesk propose une vraie prévision (le module WFM). Gorgias, Help Scout et HubSpot offrent des cartes de chaleur et des exports, et la prévision se construit ailleurs. Et un agent IA change le calcul d'une façon que la plupart des plans ratent : il prend les tickets faciles, donc le volume baisse mais la durée de traitement du reste augmente. eesel fait tourner son coéquipier IA pour helpdesk sur des files réelles depuis 2023, et l'exemple le plus parlant que j'aie est Norden-Frisia, une compagnie allemande de ferries qui prévoit 10,000 interactions par mois en haute saison et redescend d'octobre à mars au lieu d'embaucher pour l'été.
Pourquoi les équipes de support sont-elles toujours prises au dépourvu ?
Je suis Riell et je travaille la file de support d'eesel tous les jours. La question derrière cet article arrive en général sous la forme : « on a embauché deux personnes le trimestre dernier, pourquoi sommes-nous encore débordés tous les lundis ? » La réponse n'est presque jamais l'effectif seul. C'est que l'effectif a été planifié sur une moyenne quotidienne ou hebdomadaire, et que les clients n'arrivent pas en moyenne.
Une équipe qui reçoit 400 tickets par jour n'en reçoit pas 50 par heure sur une journée de 8 heures. Elle peut en recevoir 90 entre 9 h et 10 h, 20 après le déjeuner et un pic à 18 h, quand les gens rentrent chez eux et vérifient leur commande. Dimensionner pour 50 par heure revient à être en sureffectif la moitié de la journée et submergé l'autre moitié. C'est l'écart que cherche à combler la planification de la couverture, et la prévision en est le calcul sous-jacent.
Les centres de contact ont résolu cela il y a des décennies avec la gestion des effectifs (WFM). Le vocabulaire est un peu intimidant (Erlang C, absentéisme, occupation, niveau de service), mais chaque terme répond à une question simple, et vous pouvez faire tourner toute la méthode dans un tableur. Ce qui est plus récent, c'est que la plupart des équipes de support travaillent aujourd'hui sur un helpdesk et non sur un système téléphonique, et qu'une part croissante de leur volume passe d'abord par un agent IA. Les deux changent la façon d'appliquer l'ancienne méthode.
Comment fonctionne la planification des effectifs du support ?
Tous les outils WFM que j'ai examinés, de Zendesk WFM à Assembled, suivent le même enchaînement. Les éditeurs diffèrent par l'algorithme qui prévoit le volume et par la part que vous pouvez régler, mais la forme ne change pas.
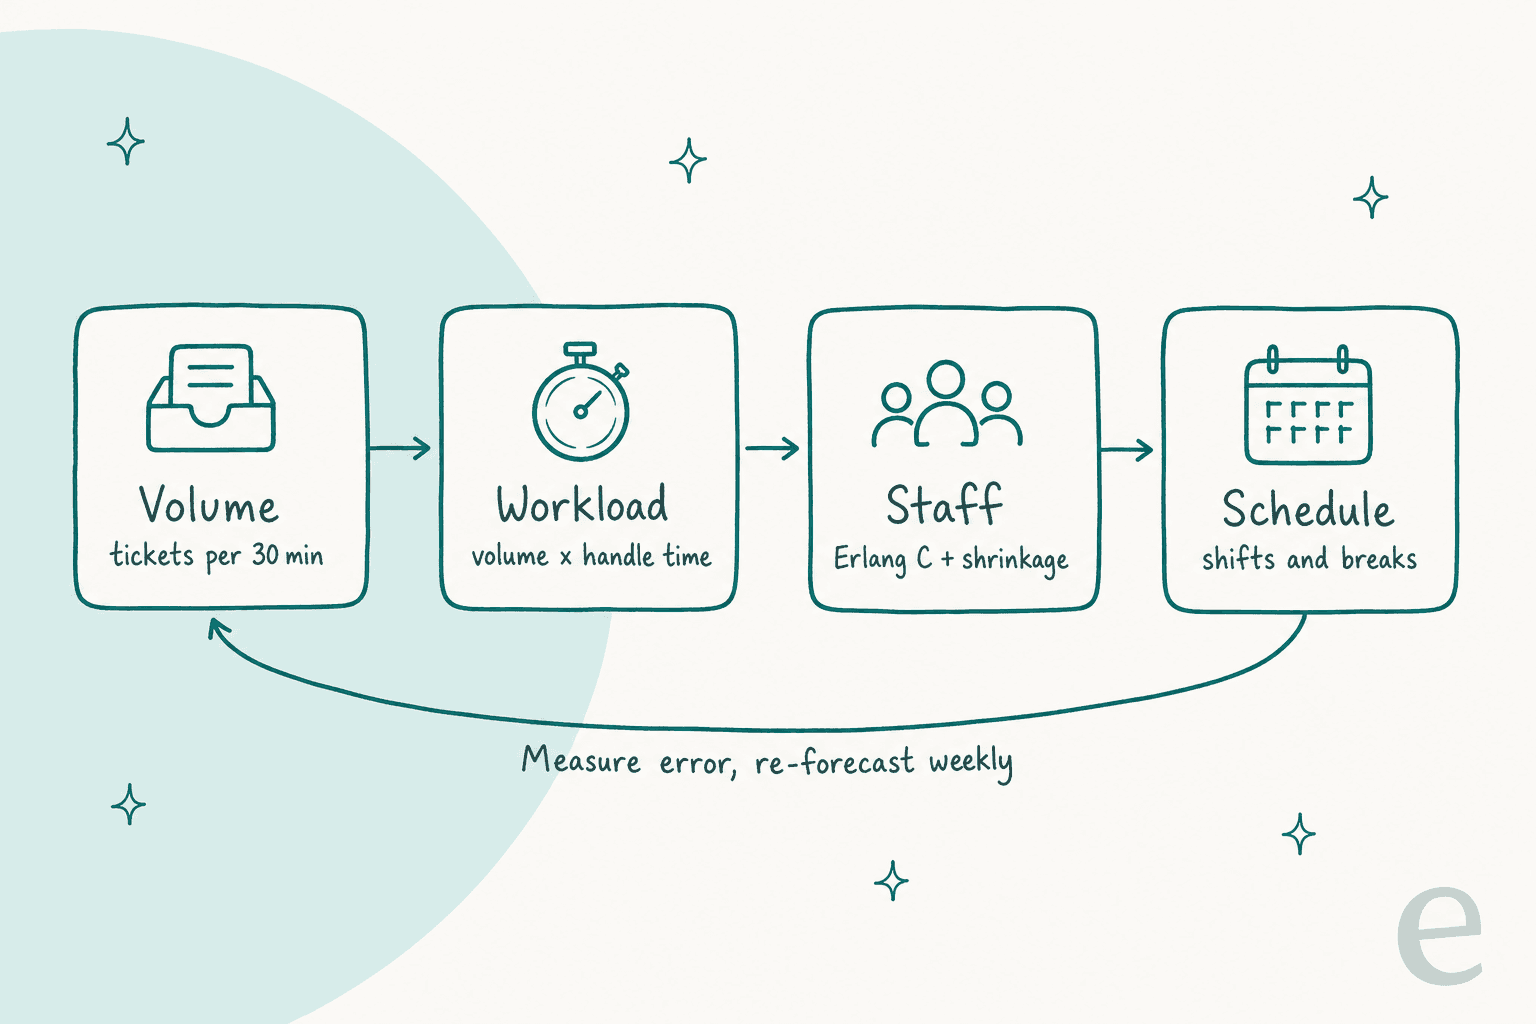
- Volume : combien de contacts arrivent dans chaque intervalle de 15 ou 30 minutes, par canal.
- Charge de travail : volume multiplié par la durée moyenne de traitement, pour savoir combien de minutes d'agent chaque intervalle demande.
- Dotation : combien d'agents il faut pour atteindre votre niveau de service, avec Erlang C pour les canaux en direct, puis majoré de l'absentéisme.
- Planning : postes et pauses posés sur le besoin, pour que la couverture suive la courbe.
- Mesure : comparer prévision et réel à l'intervalle, corriger les entrées, recommencer chaque semaine.
Le reste de cet article détaille chaque étape, puis regarde ce que votre helpdesk peut faire pour vous, comment planifier les pics et ce qui change quand un agent IA est dans la file.
Comment prévoir le volume de tickets par intervalle ?
Commencez par l'historique. Il vous faut les contacts par canal, regroupés par date et par intervalle de 15 ou 30 minutes, dans votre propre fuseau horaire. Zendesk WFM ne produit pas de prévision avec moins d'un mois de données et en importe six par défaut (Zendesk docs). C'est aussi un plancher raisonnable pour un tableur.
La méthode de base est la moyenne sur N semaines : pour mardi prochain de 10 h à 10 h 30, faites la moyenne des N derniers mardis de 10 h à 10 h 30. La documentation d'Assembled la présente comme le choix par défaut recommandé, « generally very accurate for short term forecasting (~1 to 4 weeks) », et suggère 8 semaines (Assembled forecast models). L'algorithme le plus simple de Zendesk WFM est la même idée : le même créneau de 15 minutes moyenné sur les huit dernières semaines (Zendesk algorithms).
La moyenne sur N semaines a un angle mort : elle ne voit ni les tendances ni les saisons. Si le volume croît de 5 % par mois, une moyenne sur 8 semaines est toujours en retard. C'est là qu'interviennent les modèles plus sophistiqués. Assembled propose une variante à élan, un modèle saisonnier qui multiplie une courbe de croissance sur 12 mois par des profils par semaine de l'année, jour de la semaine et quart d'heure, et la bibliothèque Prophet de Meta. Zendesk ajoute XGBoost, LightGBM et un réseau de neurones LSTM, et choisit automatiquement le meilleur par flux de travail. Les deux éditeurs veulent un an d'historique ou plus avant que les modèles saisonniers et d'apprentissage automatique ne valent leur coût.
Trois choses améliorent davantage une prévision qu'un meilleur algorithme :
- Nettoyer les données. Zendesk WFM compte le spam dans son volume, et compte à nouveau un ticket chaque fois qu'il entre dans un nouveau flux de travail (Zendesk best practices). MentorShow, une plateforme française de formation en ligne sous HubSpot, a dit à eesel recevoir entre
5,000et13,000tickets par mois selon la période, et qu'« a large share is not a question at all » : notifications PayPal, réponses automatiques, réponses à des enquêtes, un membre qui écrit « merci ». Prévoyez le travail, pas le bruit. - Prévoir à partir d'un moteur quand vous en avez un. Une marque DTC de compléments alimentaires qui a parlé à eesel lors d'un appel commercial traite environ
7,000tickets Gorgias pour30,000commandes par mois, soit un ratio tickets/commandes de 25 à 30 %, avec une haute saison de novembre à mai. Si le marketing vous donne une prévision de commandes, le ratio la transforme en prévision de tickets plus vite que n'importe quelle série temporelle. - Marquer les valeurs aberrantes. Une panne ou une publication virale gonfle l'historique puis empoisonne chaque moyenne qui l'inclut. Zendesk WFM permet d'exclure les valeurs aberrantes et d'ajouter des ajustements manuels de volume pour les événements connus ; Assembled propose les mêmes ajustements et outils.
Un tableur suffit pour cela à taille moyenne, comme le décrit une responsable WFM avec 35 agents :
"I use salesforce reports to build Google sheets forecasts based on volume history. This allows me to analyze the historic volume for specific days of the week and days of the month. Using a rolling last 60 days report, I built several pivot tables breaking down volume by hourly intervals by days of the week. ... For context, we have 35 agents and handle around 400-600 contacts per day, 24/7"

Si vous n'avez pas encore d'historique propre, réglez cela avant d'acheter un outil WFM. Étiquetez de façon cohérente, séparez les canaux et vérifiez que le tri des tickets place bien les contacts dans la bonne file, car une prévision par file ne vaut que ce que vaut le routage qui l'alimente.
Comment transformer le volume en charge de travail avec la durée de traitement ?
La charge de travail, c'est le volume multiplié par la durée moyenne de traitement (AHT) : les minutes qu'un agent passe sur un contact, post-traitement compris. Soixante chats en une demi-heure à 6 minutes chacun, cela fait 360 minutes d'agent, soit le temps de 12 agents si chacun ne faisait que du chat pendant les 30 minutes complètes. Les centres de contact appellent ce nombre intensité de trafic, mesurée en Erlangs : 60 × 6 ÷ 30 = 12 Erlangs.
Deux ajustements comptent sur les canaux de support :
- Concurrence sur le chat. Si les agents traitent deux chats à la fois, la durée de traitement effective par chat est à peu près divisée par deux. Mais le réglage et la réalité diffèrent. Un praticien WFM situe la concurrence réelle « between 1.2 and 1.6 » là où les agents peuvent prendre deux chats, et l'AHT du chat à « maybe 130% of voice at least » (Reddit thread). Utilisez votre moyenne mesurée, pas le plafond.
- L'AHT varie selon le type de ticket. Une réinitialisation de mot de passe prend une minute ; un litige de facturation vingt. Une moyenne des deux convient pour un mix stable et trompe quand le mix change, ce qui arrive précisément quand un agent IA débarque (plus bas).
Votre helpdesk rapporte généralement quelque chose de proche de l'AHT, mais pas toujours la même chose. Les métriques de durée de Zendesk, par exemple, séparent les métriques en heures ouvrées du temps calendaire, et le temps de résolution complet n'est pas la durée de traitement. Si vous ne pouvez pas obtenir la vraie durée de traitement, chronométrez à la main un échantillon de tickets pendant une semaine. C'est mieux que deviner.
Combien d'agents Erlang C dit-il qu'il vous faut ?
La charge de travail donne le minimum. Dimensionner exactement 12 agents pour 12 Erlangs signifie 100 % d'occupation et une file qui grossit sans fin, car les contacts n'arrivent pas en ligne ordonnée. Erlang C est la formule qui répond à « combien d'agents me faut-il pour que X % des contacts soient traités en Y secondes ? » avec des arrivées aléatoires. Zendesk WFM calcule les effectifs requis par intervalle de 15 minutes avec « a modified version of Erlang C » (Zendesk docs), et Assembled utilise Erlang C pour ses canaux synchrones.
Les entrées sont les trois que vous avez déjà plus deux objectifs :
- Niveau de service : la part des contacts traités dans un délai cible, comme 80 % en 60 secondes.
- Occupation maximale : la part du temps connecté que les agents passent sur des contacts. Zendesk l'expose comme réglage ; planifier autour de 75 à 85 % est courant, car 95 % d'occupation use les gens vite.
Voici l'exemple des 60 chats déroulé. À 12 Erlangs, Erlang C indique que 15 agents donnent 80,6 % en 60 secondes, une attente moyenne d'environ 38 secondes et 80 % d'occupation. Avec 14 agents, le niveau de service tombe nettement en dessous. Ce saut de 12 à 15 est le coût du hasard, et il se réduit à mesure que le volume croît : les grandes files sont efficaces, les petites non. À 6 chats par demi-heure (1,2 Erlang), il vous faut 3 agents pour le même objectif, à 40 % d'occupation. Zendesk le dit dans sa propre documentation : pour les flux à faible volume, « Erlang C may give slightly higher staffing recommendations » (Zendesk best practices).
Erlang C vaut pour les files en direct, pas pour l'e-mail
Erlang C suppose qu'un client attend dans une file en ce moment même. Le chat et le téléphone conviennent. L'e-mail et les tickets non, car le client n'est pas assis à attendre ; il s'attend à une réponse en quelques heures. Un praticien WFM a posé le problème des files de tickets sans détour :
"If you have very consistent handle times and a good way to capture it, you basically have a live queue and Erlang C works really well. Most of the time, that is pie in the sky because, for example, Zendesk tickets can take 30 seconds or 45 minutes…so how do you get a good handle time for those tickets?"
Pour le support asynchrone, dimensionnez plutôt sur la fenêtre de SLA. La documentation d'Assembled explique pourquoi : son ancien mode par intervalles supposait que le travail arrivé dans un intervalle de 15 minutes était écoulé dans cet intervalle, ce qui « significantly over-staffs async work ». Son mode plus récent répartit la charge sur l'objectif de réponse, si bien que 100 e-mails arrivés à 9 h avec un SLA de 24 heures n'ont pas tous besoin d'un agent à 9 h (Assembled async staffing). Zendesk WFM fait quelque chose de similaire pour les e-mails reçus hors horaires : il redistribue ce volume sur la fenêtre de première réponse de la prochaine période ouverte.
Dans un tableur, la version asynchrone est simple : totalisez la charge de la journée en heures d'agent, divisez par les heures productives par agent et vérifiez que l'arriéré ne vieillit jamais au-delà de vos politiques de SLA. Si c'est le cas à une certaine heure, cette heure a besoin de plus de monde.
Calculez vos effectifs avec une calculatrice Erlang C
La calculatrice ci-dessous exécute Erlang C pour un intervalle de 30 minutes d'un canal en direct, puis ajoute l'absentéisme. Passez en mode e-mail pour les files qui peuvent attendre. Les champs IA vous permettent de tester ce qui se passe quand un agent prend une partie du volume et que les tickets restants durent plus longtemps.
Valeurs par défaut : 60 chats par demi-heure, AHT de 6 minutes, 80 % traités en 60 secondes, 30 % d'absentéisme et un agent IA qui résout 40 %, avec 8 minutes de traitement pour le reste.
Avec les valeurs par défaut, le plan sans IA demande 15 agents sur la file de chat et 22 au planning. Avec l'IA qui prend 40 % des chats et les chats restants qui durent 8 minutes, c'est 13 sur la file et 19 planifiés. Un taux de résolution de 40 % a réduit le planning d'environ 14 %, pas de 40 %. C'est la chose la plus utile que montre la calculatrice, et la raison pour laquelle je ne planifierais jamais un gel des embauches sur le taux de déflexion d'un éditeur d'IA.
Quel absentéisme faut-il prévoir ?
Erlang C vous dit combien d'agents doivent être sur la file. L'absentéisme est l'écart entre cela et le nombre qu'il vous faut au planning : pauses, réunions, formation, coaching, arrêts maladie, congés et temps connecté mais indisponible. La formule est scheduled = required ÷ (1 - shrinkage). L'exemple de Zendesk : 100 agents productifs à 40 % d'absentéisme font 167 au planning (Zendesk docs).
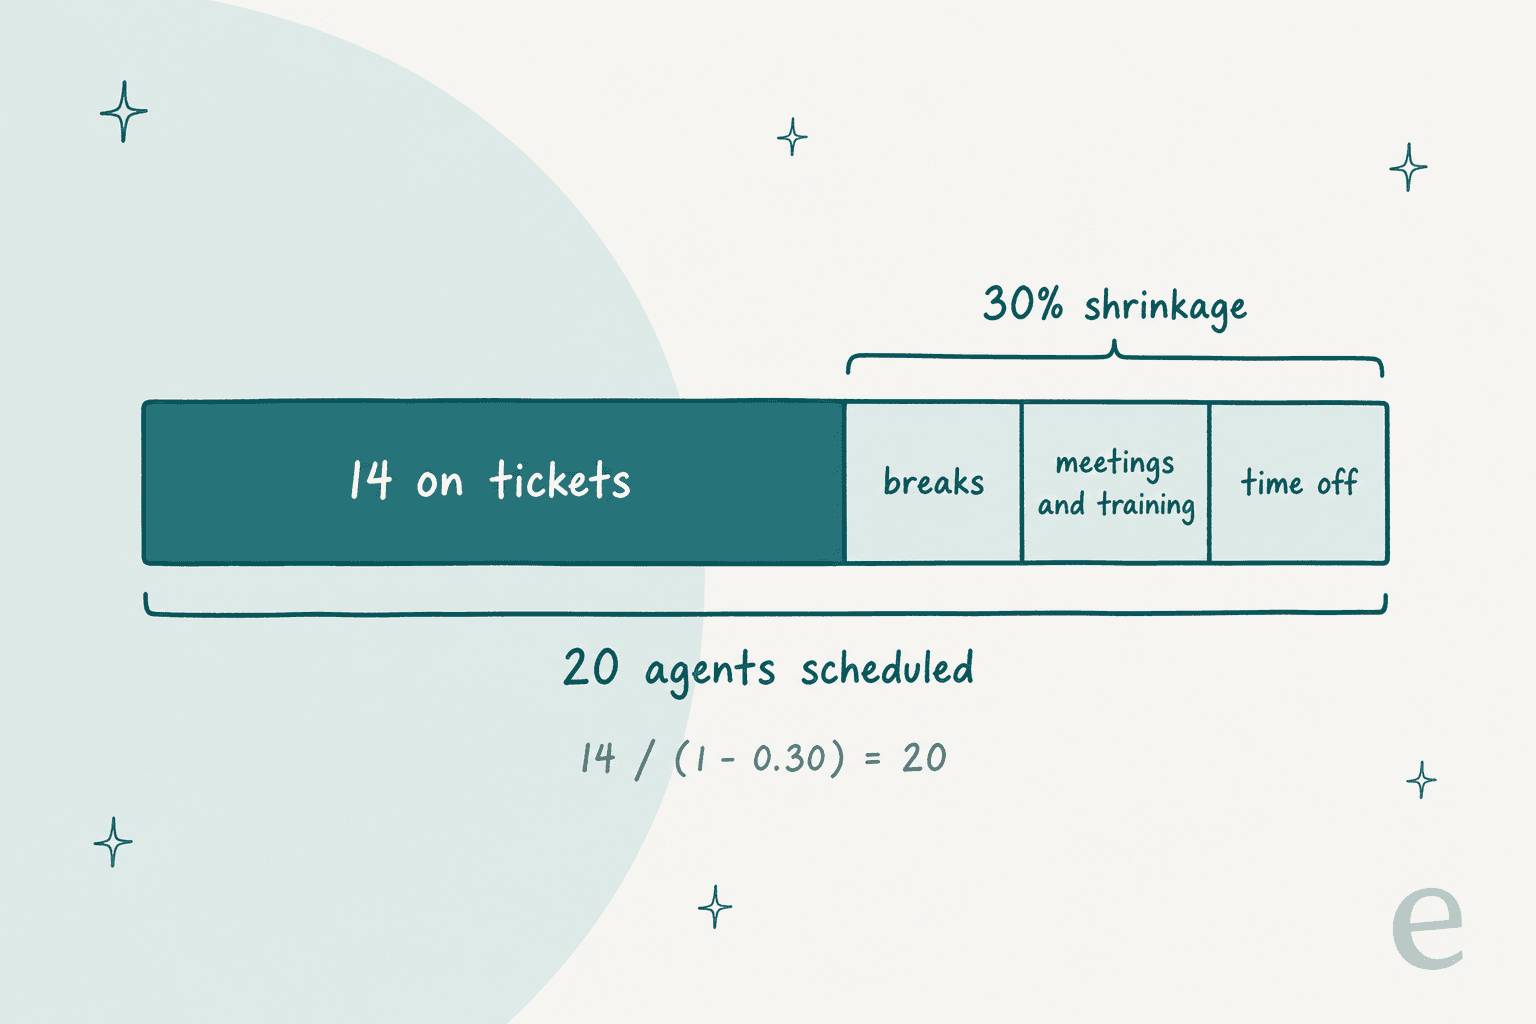
Le chiffre que les équipes utilisent est généralement trop bas. Deux définitions circulent, et les mélanger est une source fréquente de sous-effectif :
- L'absentéisme restreint ne compte que le temps planifié non délivré, soit à peu près
100% - adherence. Assembled utilise cette définition et planifie séparément pauses, congés et réunions ; sa documentation donne 5 à 10 % pour la voix, 10 à 15 % pour l'omnicanal et 15 % et plus pour les équipes complexes orientées numérique (Assembled staffing docs). - L'absentéisme complet compte tout ce qui retire de la file un agent payé. C'est la définition dont la plupart des prévisions sur tableur ont besoin, et elle est bien plus élevée :
"A 15% shrinkage rate seems low. Breaks alone account for approximately 6.25% on a standard 8-hour schedule. Most of our teams average shrinkage in the low 30% range once you factor in absenteeism, PTO, meetings, training, etc."
L'absentéisme bouge aussi. Un autre praticien de r/workforcemanagement note que l'absentéisme du lundi est généralement le plus élevé et que janvier est élevé pour son équipe (thread). Les nouvelles recrues comptent aussi : quelqu'un dans ses premiers mois traite moins de contacts, et plus simples, donc une équipe qui vient d'embaucher cinq personnes a moins de capacité que son effectif ne le laisse croire. Si vous embauchez avant un pic, prévoyez le temps de montée en compétence des agents et un vrai plan d'intégration saisonnière plutôt que de compter un nouvel arrivant comme un agent complet dès la première semaine.
Quelle précision viser pour une prévision du support ?
Assez précise pour que le planning bâti dessus atteigne votre niveau de service. Cela ressemble à une dérobade, mais c'est le bon test, car une prévision qui se trompe de 2 % sur le total hebdomadaire peut quand même se tromper aux heures qui comptent.
Les mesures standard sont l'erreur absolue moyenne (MAE) et l'erreur absolue moyenne en pourcentage (MAPE). Le rapport Forecast Management d'Assembled étiquette le modèle à la MAE la plus basse comme « most accurate » et affiche aussi séparément l'erreur par excès et par défaut, car vous pouvez préférer un modèle qui sous-prévoit rarement (Assembled docs). Il avertit aussi que le MAPE échoue quand le volume réel est nul, ce qui arrive souvent sur de petits intervalles. Zendesk WFM a une page prévision contre réel en accès anticipé pour vérifier le scénario actif.
Ce que signifie « bon » dépend de l'horizon. La règle empirique d'un praticien :
"Unless you tie forecast accuracy to a specific business metric, you setup the forecasting team for failure. Also 3% intra-day (in)accuracy? Maybe annual 3%, 5% monthly, 10% weekly and 25%-40% daily."
Deux habitudes repèrent la plupart des problèmes. D'abord, vérifiez l'intervalle, pas seulement le total : « Many wfm teams only look at the daily total to forecast as a kpi, which doesn't help if the call arrival pattern is wrong » (Reddit). Ensuite, utilisez les réels comme entrées. Si le plan suppose 2 chats simultanés et 15 % d'absentéisme et que l'équipe délivre 1,4 et 30 %, la prévision promettra un niveau de service que vous n'atteindrez jamais. Surveillez le délai de première réponse et l'ancienneté de l'arriéré par intervalle à côté de la prévision ; ce sont les premières métriques à signaler que les entrées ont dérivé.
Que prévoient réellement Zendesk WFM et les autres helpdesks ?
C'est là que les équipes de support diffèrent le plus des centres d'appels. Les systèmes téléphoniques livrent du WFM depuis des décennies. Les helpdesks, pour la plupart, non. Voici ce que j'ai trouvé dans la documentation de chaque éditeur.
Zendesk WFM
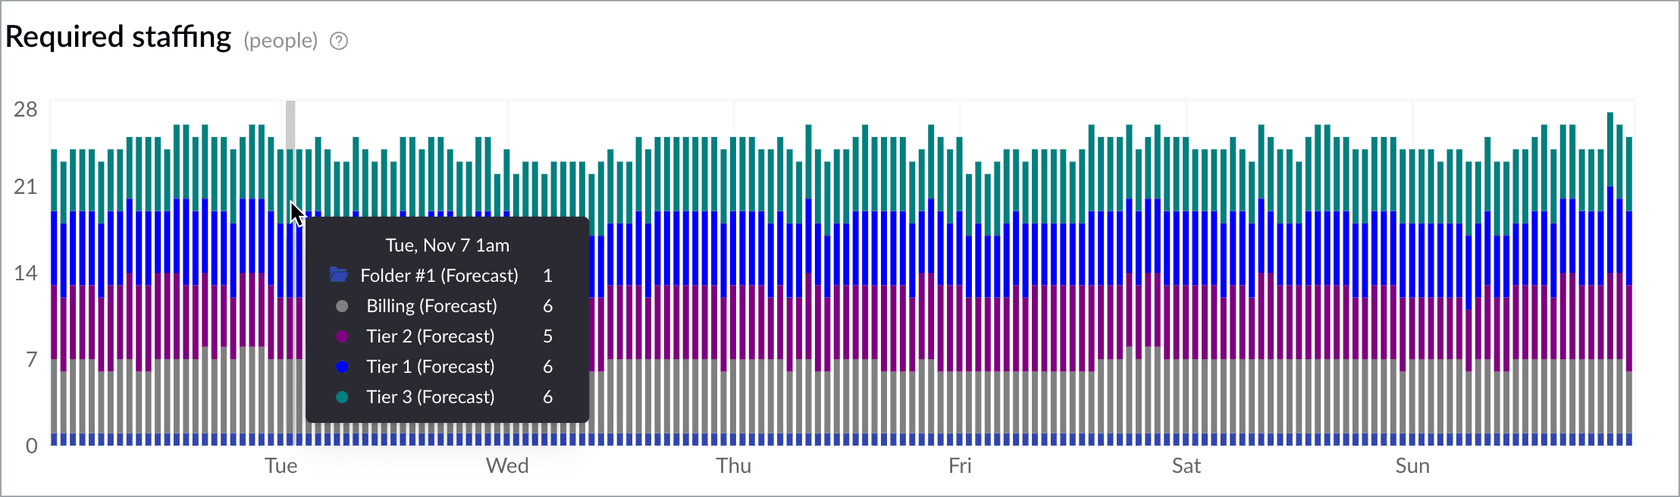
Zendesk est le seul helpdesk ici avec une prévision native, et c'est une vraie. Dans le module WFM, vous obtenez :
- Des prévisions de volume jusqu'à un an à l'avance, par intervalles de 15 minutes, à partir de six mois de données de tickets migrées (jusqu'à deux ans sur demande).
- Un choix d'algorithme par flux de travail : moyenne sur huit semaines, moyenne sur huit semaines avec élan, Prophet, XGBoost, LightGBM et un réseau de neurones LSTM. WFM les teste tous et choisit le meilleur, et vous pouvez le remplacer (Zendesk algorithms).
- Des effectifs requis à partir d'un Erlang C modifié, avec occupation, concurrence du chat, AHT, objectif de SLA, absentéisme et dotation minimale (1 ETP par défaut) comme entrées.
- Des scénarios pour tester des hypothèses sans toucher la prévision active, plus des ajustements de volume et l'exclusion des valeurs aberrantes (Zendesk setup guide).
Les limites à connaître : WFM ne prévoit pas les flux de travail combinés (le contournement est un dossier qui les additionne), le spam compte dans le volume, et aucune des documentations de prévision ne mentionne la séparation des résolutions de l'agent IA du volume humain, de sorte qu'un déploiement d'IA se modélise par des ajustements manuels. Côté coût, le module est acheté pour chaque agent du compte, et la page de tarifs de Zendesk indique le Workforce Engagement Bundle (WFM plus QA) à $50 par agent et par mois, payé annuellement (Zendesk pricing). Pour une vue complète des formules de base, voyez mon détail des tarifs de Zendesk.
Assembled
Assembled n'est pas un helpdesk ; c'est un outil WFM autonome qui se branche sur Zendesk, Salesforce, Gorgias et d'autres. Il suit le même enchaînement avec des modèles sur N semaines, à élan, saisonniers et Prophet, des intervalles de dotation de 30 minutes par défaut, Erlang C pour les canaux en direct et un mode fenêtre de SLA pour l'e-mail. La page de tarifs affiche le WFM à $25 (Core), $45 (Pro) et $75 (Enterprise) par mois, et les docs d'aide placent les modèles de prévision, les rapports de précision et la dotation asynchrone par SLA sur Pro et Enterprise (Assembled pricing). Le marketing d'Assembled affirme que ses plans de dotation tiennent compte de la capacité des agents IA aux côtés des humains, mais je n'ai trouvé aucun document d'aide expliquant le mécanisme. Si vous comparez les options, j'ai traité les alternatives à Assembled séparément.
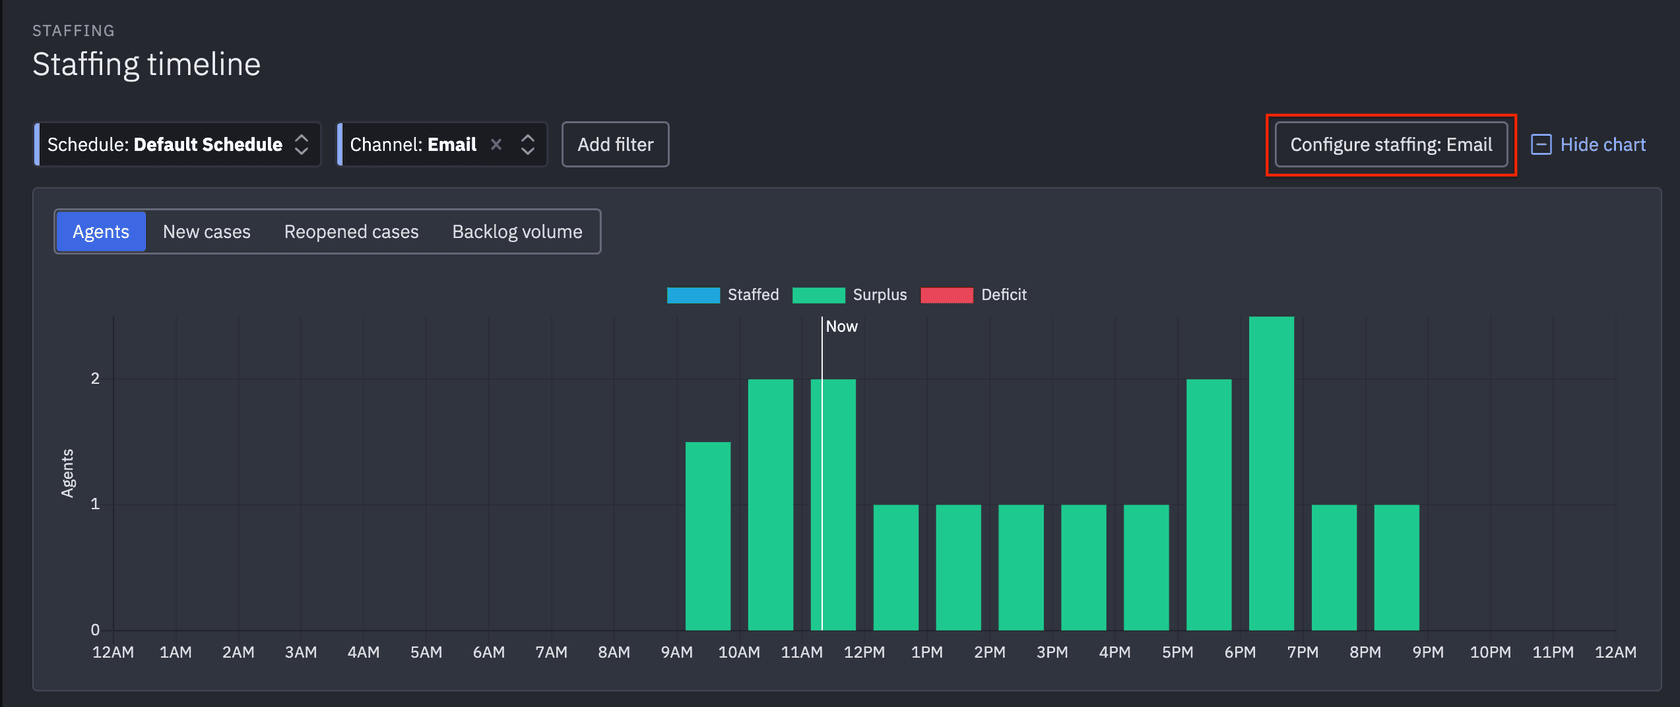
Gorgias
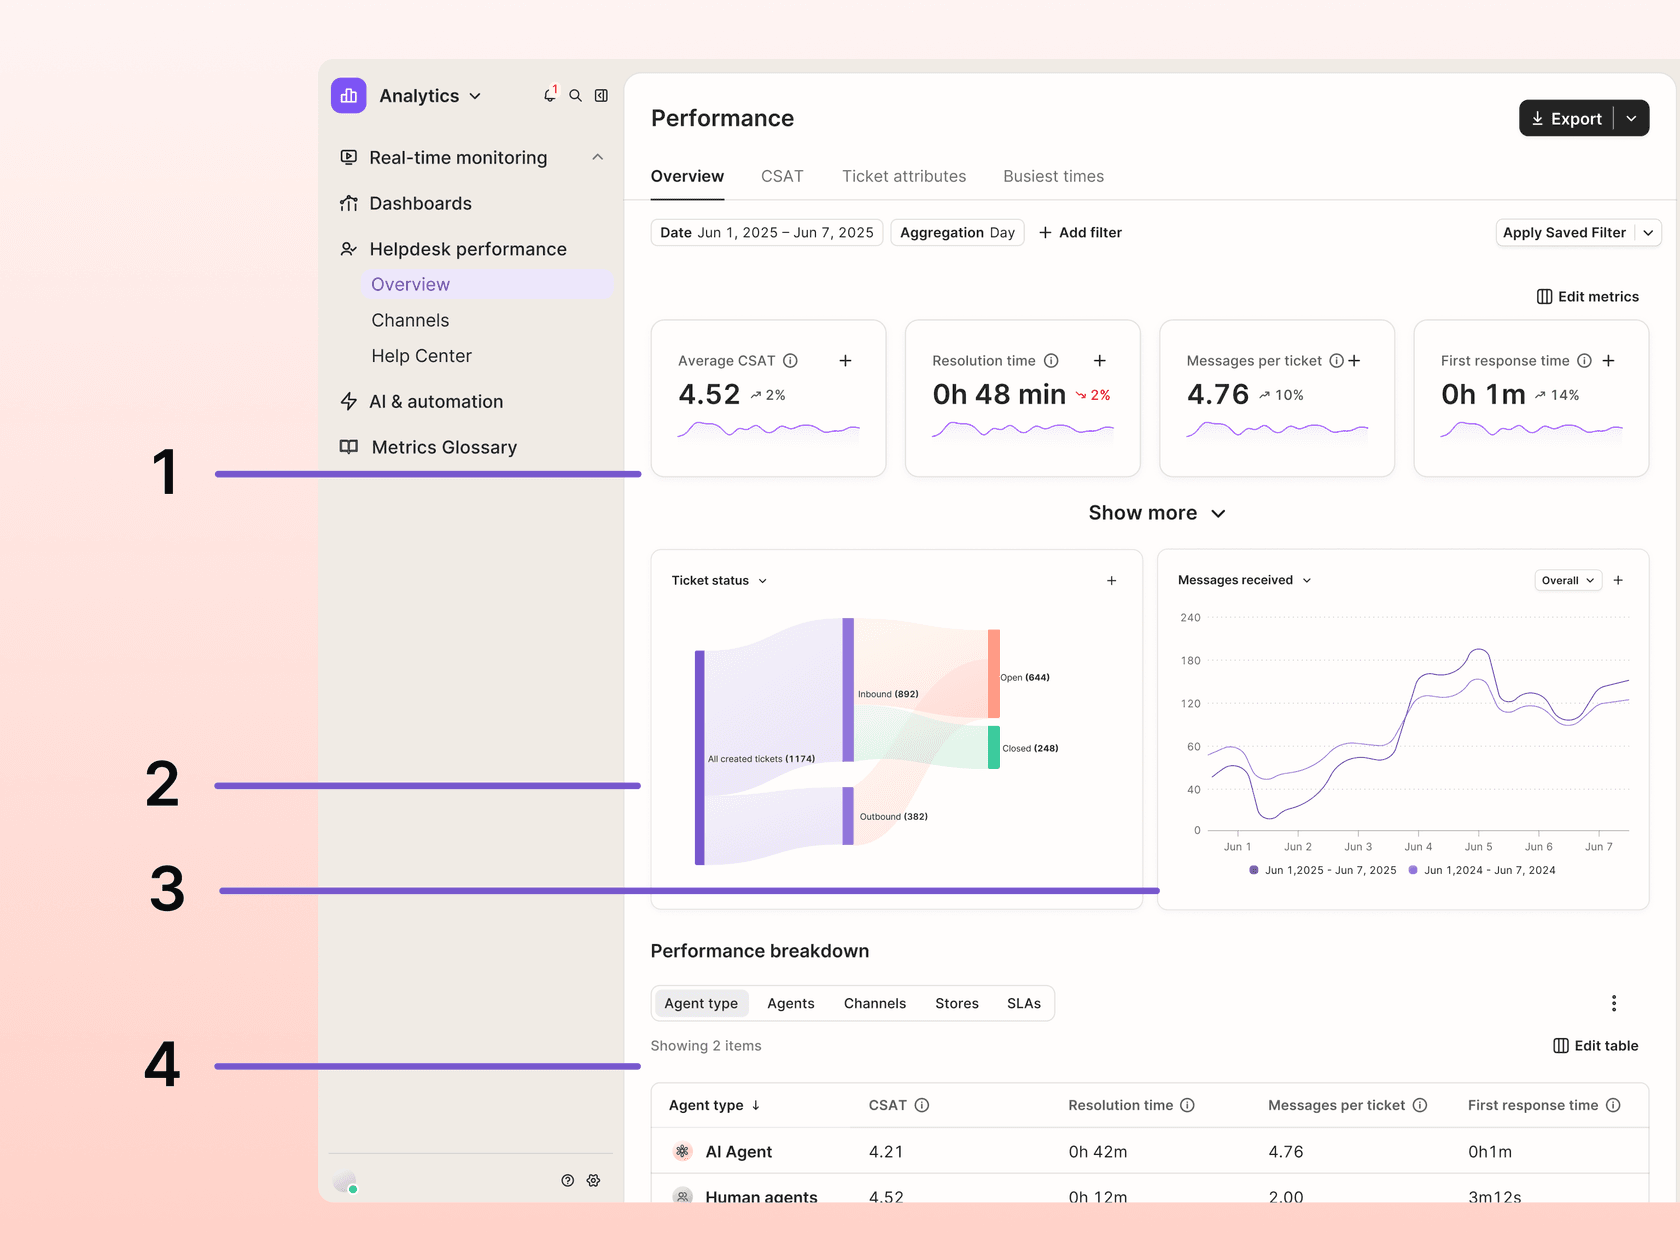
Gorgias n'a pas de prévision de volume, mais ses rapports vous donnent la plupart des entrées. L'onglet Busiest times affiche une métrique (tickets créés, messages reçus et autres) sous forme de carte de chaleur par heure et jour de la semaine avec vos heures ouvrées marquées, et le conseil de Gorgias lui-même est que « A dark cell outside your business hours is demand arriving when nobody is scheduled » (Gorgias docs). Les graphiques de tendance peuvent superposer l'année précédente pour distinguer un vrai changement d'un schéma saisonnier, et chaque rapport s'exporte en CSV jusqu'à 365 jours par plage. Si vous utilisez l'AI Agent de Gorgias, son rapport donne un taux d'automatisation que vous pouvez utiliser pour séparer le volume IA du volume humain.
Help Scout
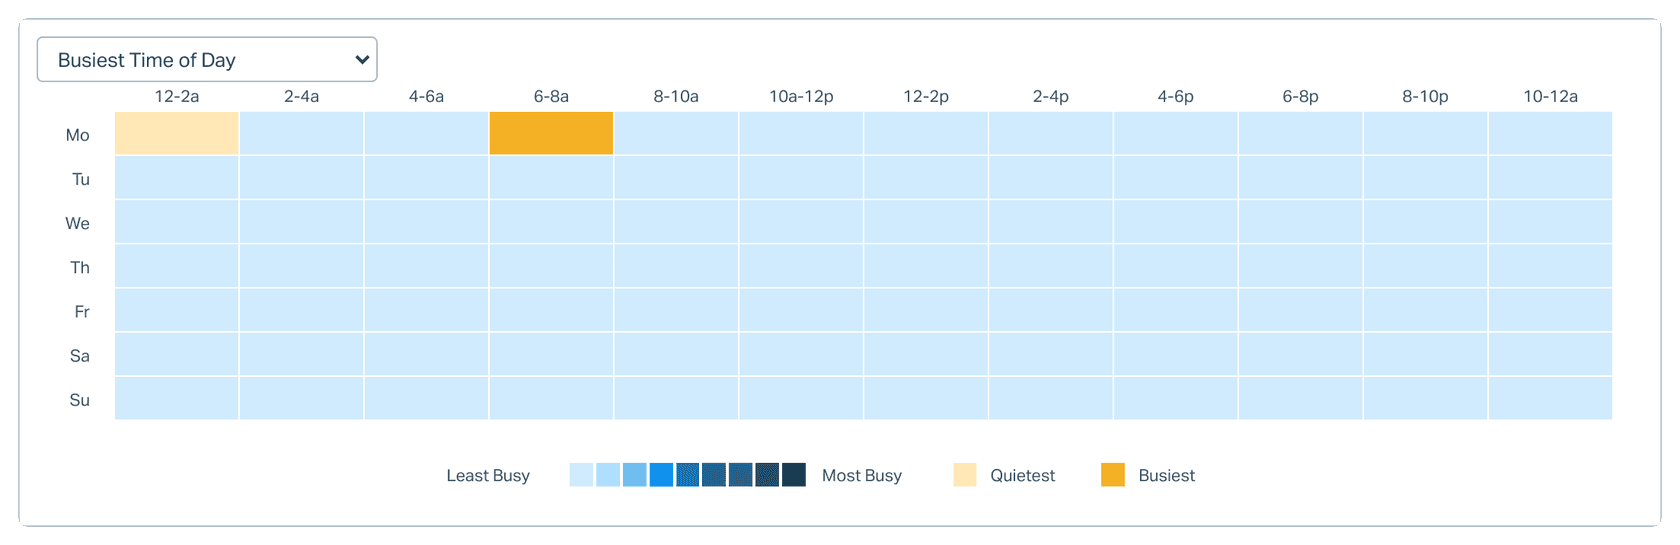
Les rapports de Help Scout sont uniquement historiques, et sa documentation dit qu'on ne peut pas créer de rapports personnalisés dans l'application. Le rapport All Channels inclut une carte de chaleur Busiest Time of Day que Help Scout décrit comme « helpful for hiring » (Help Scout docs). Les formules Standard couvrent deux ans d'historique ; Plus et Pro toute la durée de vie du compte. L'export est un CSV ou XLSX au niveau de la conversation, ce que vous voulez pour une prévision, avec un piège : les horodatages du XLSX sont en UTC tandis que le CSV utilise le fuseau horaire de votre entreprise. Regroupez avec le mauvais et votre heure de pointe se décale. Plus de détails sur les limites des formules dans mon article sur les tarifs de Help Scout.
HubSpot Service Hub
L'outil de prévision de HubSpot est un outil de revenus fondé sur les étapes de transaction, pas sur les tickets. Ce qui s'en rapproche le plus pour le support est une option de courbe de tendance « predictive » dans les paramètres de rapport de la suite d'analyse du service, appliquée aux graphiques historiques (HubSpot docs). Les entrées utiles y sont pourtant : un rapport de volume de support, un rapport par heure de la journée « to help inform team planning » et des rapports de planification comme Maximum available rep qui montrent si des gens travaillaient pendant les pics. Si vous utilisez le Customer Agent de HubSpot, notez le délai de 72 heures avant que les résolutions fondées sur la réponse ne soient définies, si bien que le taux de résolution de cette semaine paraît toujours bas.
Comparatif
| Prévision de volume native | Détail par intervalle | Calcul de dotation | Répartition IA dans les rapports | Export pour tableur | |
|---|---|---|---|---|---|
| Zendesk (module WFM) | Oui, jusqu'à 1 an | 15 min | Erlang C modifié, absentéisme, occupation, concurrence | Pas dans les docs de prévision | Oui, plus imports |
| Assembled | Oui, 4 modèles | 15-30 min | Erlang C (direct), fenêtre de SLA (asynchrone) | Affirmations marketing uniquement | API ou import CSV |
| Gorgias | Non | Carte de chaleur horaire | Aucun | Taux d'automatisation de l'AI Agent | CSV, 365 jours par plage |
| Help Scout | Non | Carte de chaleur de 2 heures | Aucun | Non couvert | CSV ou XLSX, niveau conversation |
| HubSpot Service Hub | Non (courbe de tendance seulement) | Rapport par heure de la journée | Aucun | Rapports du Customer Agent | Export non synthétisé |
Si vous êtes sur l'un des trois derniers et que votre équipe compte moins de 20 agents, un tableur utilisant la méthode ci-dessus suffit. Au-delà, ou avec plusieurs canaux et plannings, un outil WFM commence à se rentabiliser en heures non passées à reconstruire des tableaux croisés dynamiques. Pour les équipes qui comparent le helpdesk lui-même, mon comparatif des helpdesks pour tickets à fort volume couvre aussi la partie reporting.
Comment planifier les pics et les hautes saisons ?
Une prévision construite sur des moyennes manquera toujours le pic, par conception. La solution est de planifier le pic comme son propre scénario. J'en garderais trois en réserve pour chaque période de pic : normal, +30 % et +60 % de volume, chacun avec sa propre dotation et son propre planning. Vous ne dimensionnez pas pour le pire cas ; vous décidez à l'avance ce que vous ferez quand vous le verrez venir (heures supplémentaires, personnel polyvalent d'autres équipes, un plan de débordement ou une pause sur le travail non urgent).
Avant de dimensionner un pic, demandez pourquoi il se produit :
"Why is it spiky? Do you send bills to customers all on the same day? Does your ad campaign run at a certain pattern? Identify "the why" in spikes and see if you can educate on the impacts to the call center."
La plupart des pics ont une cause que quelqu'un dans l'entreprise connaît déjà : un cycle de facturation, un e-mail promo, un lancement de produit, une date limite d'expédition. Mettez ces dates dans le calendrier du support et ajoutez-les comme ajustements manuels. Pour le commerce, mes guides sur les pics de support des fêtes et l'IA pour le Black Friday détaillent le coup de feu de novembre à décembre.
Les activités saisonnières affrontent la version la plus difficile, car embaucher pour l'été signifie garder des gens tout l'hiver. Norden-Frisia, la compagnie de ferries mentionnée dans le TL;DR, reçoit la plupart de ses questions de passagers entre mai et septembre : horaires, voitures, barres de toit, vélos. Embaucher et former une équipe qui grandit et rétrécit avec la saison était coûteux et lent, donc avant sa première haute saison l'équipe a fait passer son offre eesel à 10,000 interactions par mois, avec l'accord de la réduire d'octobre à mars. Le coéquipier IA répond aux questions récurrentes à partir des FAQ de Zendesk, et tout ce qu'il ne peut pas clore devient un ticket Zendesk pour l'équipe humaine. C'est une décision d'effectifs autant que de logiciel.
Rúngne, une marque norvégienne de vêtements d'escalade sous Gorgias, illustre la version d'une semaine à l'autre. Entre le 8 août et le 8 septembre 2026, eesel a traité pour elle environ 2,100 tickets, entre environ 300 et 780 par semaine. Une variation de cette taille au sein d'un seul mois est exactement ce qu'un planning fondé sur des moyennes rate, et c'est pourquoi les contrôles en cours de journée comptent même avec une prévision correcte. Les équipes qui couvrent plusieurs fuseaux horaires peuvent aussi lisser les pics avec le support follow-the-sun, en se passant la file d'une région à l'autre plutôt qu'en étirant un poste.
Comment un agent IA change-t-il la prévision des effectifs ?
C'est la partie que la plupart des guides de prévision n'ont pas encore rattrapée. Dès qu'un agent IA répond à une partie de la file, l'ancienne prévision se trompe dans deux directions à la fois.
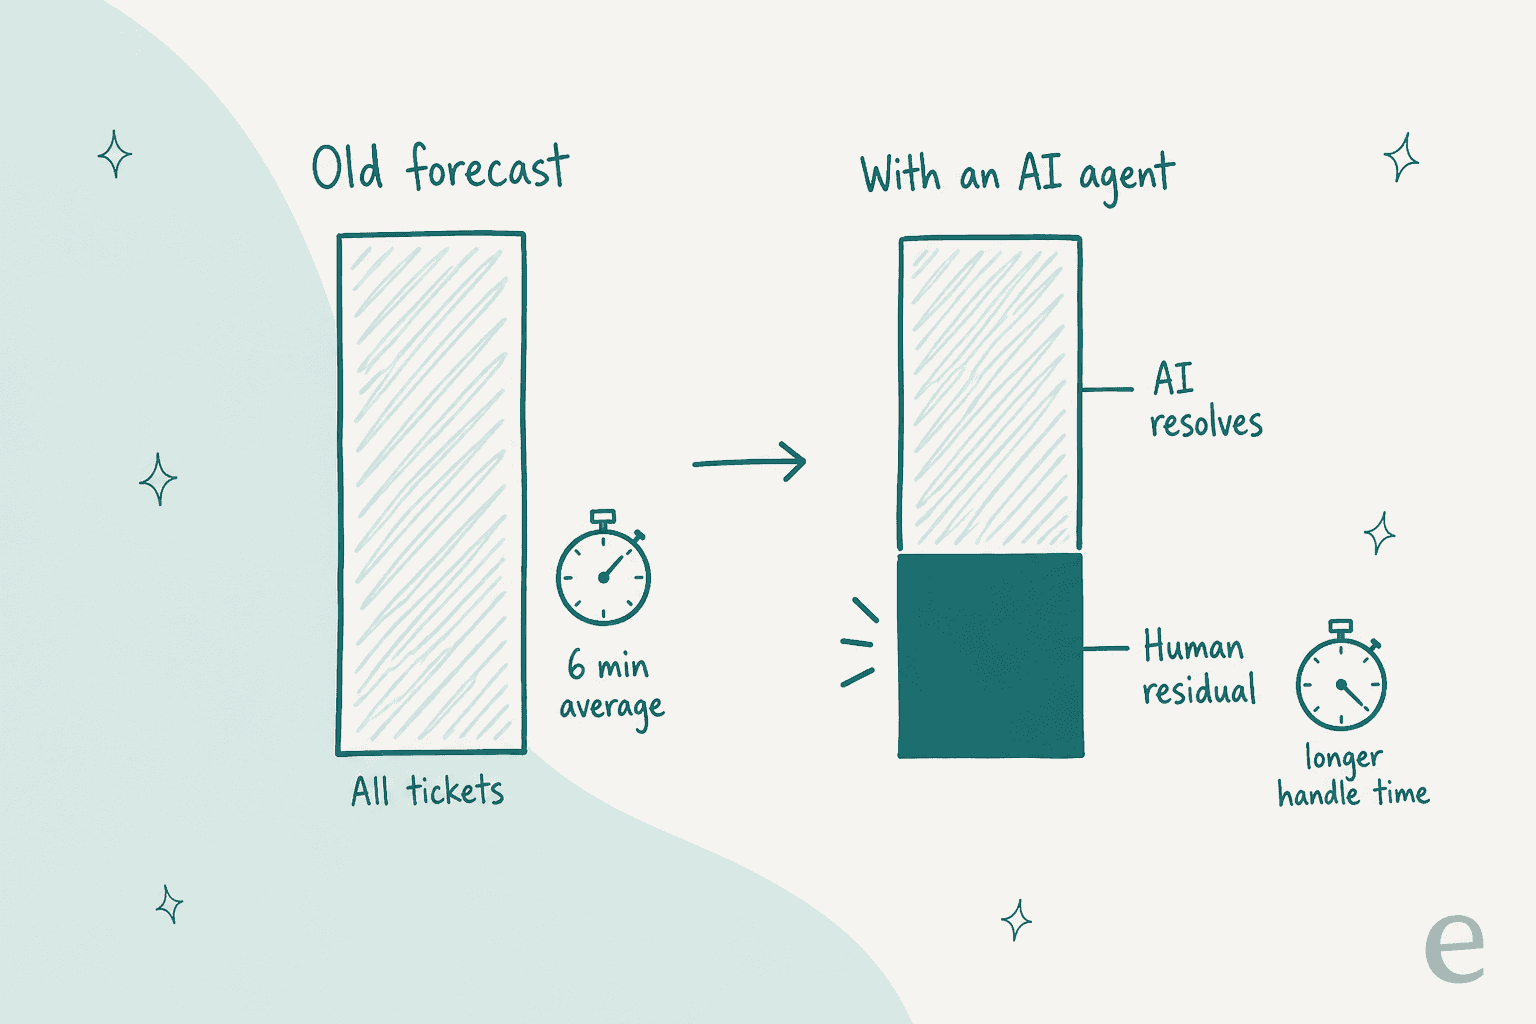
Le volume vers votre équipe baisse, car l'IA résout les questions de statut de commande, de mot de passe et de politique. Mais c'étaient aussi vos tickets les plus rapides, donc la durée de traitement de ce qui reste augmente. Soustrayez le taux de résolution de l'IA du volume total en gardant l'ancien AHT, et vous serez en sous-effectif. La calculatrice ci-dessus montre l'ampleur de l'effet : un taux de résolution de 40 % avec un glissement d'AHT de 6 à 8 minutes réduit le planning d'environ 14 %.
Voici comment je prévoirais avec un agent IA dans la file :
- Prévoir deux files, pas une. Les arrivées totales comme avant, puis le reliquat humain comme série propre, avec son propre AHT mesuré sur les tickets transmis par l'IA.
- Utiliser la résolution, pas la déflexion. Une conversation terminée sans intervention humaine n'est pas toujours un problème résolu ; certaines reviennent un jour plus tard par un autre canal. L'écart entre déflexion et résolution est l'erreur de votre prévision.
- Remesurer pendant quelques semaines après chaque changement. Nouveaux sujets confiés à l'IA, nouveau canal, changement de politique : chacun déplace le reliquat. La moyenne sur 8 semaines d'Assembled rattrapera, mais lentement.
- Ne pas geler les embauches sur le chiffre d'appel d'un éditeur. Lancez d'abord un pilote de support sur vos propres tickets, et ne planifiez que sur le reliquat que vous avez mesuré.
L'IA a aussi besoin d'un périmètre clair pour que cela fonctionne. Un responsable CX d'une marque DTC traitant environ 7 000 tickets par mois a dit à l'équipe commerciale d'eesel que vérifier chaque réponse de l'IA à la main irait à l'encontre du but, puis a ajouté :
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
C'est aussi ce qui rend la prévision stable. La configuration de Rúngne est un bon modèle : un agent eesel trie et étiquette chaque ticket, un autre laisse des brouillons à l'équipe, et un troisième ne répond qu'aux sujets choisis par l'équipe (politique d'expédition et de retour, où est ma commande, stock, précommandes). Ce mois-là, l'agent répondeur a travaillé sur environ 280 des quelque 2 100 tickets, « around one ticket in seven ». Comme le périmètre est une liste fixe de sujets, le reliquat est prévisible : vous savez quels types de tickets ont quitté la file humaine et pouvez mesurer le nouvel AHT sur ce qui est resté. Les praticiens du WFM arrivent au même point côté prévision :
"I wouldn't trust an LLM to replace forecasting, Erlang/staffing calculations, shrinkage modelling or proper statistical analysis. Those should still be handled by the right models, tools and validated data. ... Basically: it would let AI explain the spreadsheet, not become the spreadsheet."
Je suis d'accord. Utilisez l'IA pour retirer du travail de la file et pour expliquer les chiffres, et gardez la prévision sur des données réelles. Si vous vous demandez si l'IA change plus largement la forme de votre équipe, mes articles sur la construction d'une équipe de support IA d'abord et sur la question de savoir si l'IA peut remplacer votre équipe reprennent ce fil. Côté argent, comparez le coût par résolution avec et sans IA.
Essayer eesel
Si votre prévision continue de vous dire d'embaucher pour un pic que vous n'aurez que trois mois, le coéquipier IA pour helpdesk d'eesel est l'autre levier. Il rejoint la file que vous gérez déjà sur Zendesk, Gorgias, HubSpot ou Help Scout, apprend de vos anciens tickets et de votre centre d'aide, et ne traite que les types de tickets que vous lui confiez, ce qui rend le reliquat humain assez prévisible pour planifier autour.
La tarification convient aussi à une prévision saisonnière. Sur les tarifs d'eesel, un ticket ou un chat vaut 1 crédit, les formules démarrent à $299 par mois pour 500 crédits, et un changement de formule prend effet immédiatement : vous montez d'une taille pour le pic et redescendez après, comme le fait Norden-Frisia chaque été. Vous pouvez commencer avec 100 crédits gratuits et voir quelle part de votre file il prendrait avant de changer le moindre poste.

Comment prévoir le volume de tickets du support ?