Die 10 besten GPT-6.2-Astra-Alternativen 2026, bepreist pro Aufgabe

Kurnia Kharisma

Katelin Teen
Zuletzt bearbeitet 17. November 2026
Die beste GPT-6.2-Astra-Alternative für die meisten Teams ist OpenAIs eigenes GPT-6.2 Sol: Es erreicht 57 gegenüber Astras 62 auf Artificial Analysis, zu etwa einem Viertel der Kosten pro Aufgabe. Nur Claude Fable 5.2 erzielt einen höheren Score (65), zu 6,6-mal Astras Kosten pro Aufgabe. Die Falle ist der Listenpreis: Claude Opus 5.5 berechnet die Hälfte von Astras Token-Rate, kostete aber bei maximalem Effort 2,5-mal so viel pro Benchmark-Aufgabe. Beurteile Alternativen nach Kosten pro fertiger Aufgabe, und route statt zu wechseln. Für eine Support-Warteschlange zählen das Wissen und die Eskalationsregeln rund um das Modell mehr, und das ist, was eesels KI-Helpdesk-Teammitglied mitbringt.
Warum schauen Teams über GPT-6.2 Astra hinaus?
GPT-6.2 Astra wurde am 17. November 2026 veröffentlicht, und es ist ein starkes Modell. Artificial Analysis setzt es bei 62 auf seinem Intelligence Index, nur hinter Claude Fable 5.2, und OpenAI senkte den Preis um 20% auf $8 pro Million Input-Token und $40 pro Million Output auf seiner API-Preisseite. Gecachter Input fiel von $1,00 auf $0,40. Wenn deine Agenten schwierige, mehrstufige Arbeit erledigen, verdient sich Astra seinen Platz.
Warum also woanders schauen? Drei Gründe kommen immer wieder auf.
- Die meisten Aufgaben brauchen es nicht. In meinem eigenen Test mit 15 Support-Tickets bei drei Effort-Levels löste GPT-6.2 Sol jedes Ticket korrekt, zu etwa einem Viertel von Astras Kosten. Mehr dazu unten.
- Lange Durchläufe sind schwerer zu lesen. Mehrere bekannte Tester mochten Astras Output, aber nicht die Arbeit damit bei langen, offenen Durchläufen. Mein GPT-6.2-Astra-Test geht diese Beschwerden durch.
- Ein Anbieter ist ein Single Point of Failure. Teams, die Agenten-Produkte bauen, wollen einen getesteten Fallback von einem zweiten Labor, für den Fall von Preisänderungen, Ausfällen oder Rate-Limits.
"I care less about the models being good and more on if I can fallback to them if Opus 5.5 gets a massive price hike after the IPO"

Ich schreibe darüber, wonach Käufer tatsächlich suchen, und die Suche hier ist aufschlussreich. Als ich ChatGPT genau diese Frage in einem neuen Chat stellte, ging es direkt zu den Modell-Dokumenten und Preisseiten jedes Labors und rahmte die ganze Antwort um eine Zahl: Kosten pro erfolgreicher Aufgabe. Das ist der richtige Rahmen, und es ist der, den ich unten verwendet habe. Wenn deine Agenten Support-Tickets beantworten, lässt der eesel CLI einen Coding-Agenten freigegebene Hilfe-Artikel in ein eesel-Teammitglied laden und seine Antworten testen, bevor du überhaupt etwas auswählst.
Wie ich die Alternativen verglichen habe
Ich habe jedes Modell nach drei Dingen bewertet, alle am 18. November 2026 geprüft.
- Listenpreis von der eigenen Preisseite jedes Anbieters, pro Million Input- und Output-Token, plus die Rate für gecachten Input, da Agenten, die einen langen System-Prompt wieder senden, von gecachten Token leben.
- Intelligenz und Kosten pro Aufgabe von Artificial Analysis, das die gleichen neun Evaluierungen bei jedem Modell durchführt und angibt, was jede fertige Aufgabe bei der höchsten Effort-Einstellung des jeweiligen Modells gekostet hat. Diese Zahl rechnet ein, wie viele Token ein Modell verbrennt, was der Listenpreis verschweigt.
- Mein eigener Support-Test. Ich habe den 15-Ticket-Testlauf aus meiner GPT-6.2-Astra-Analyse erneut mit Astra und Sol bei niedrigem, mittlerem und hohem Effort laufen lassen: 90 Durchläufe, die Rückerstattungsmathematik, eine doppelte Abbuchung, eine Prompt-Injection, spanische und deutsche Tickets, eine defekte Bestellabfrage und eine vertippte Bestellnummer abdecken. Ich hatte nur API-Zugang zu OpenAI für diesen Durchlauf, also werden die anderen Labore anhand von Anbieter- und Benchmark-Daten beurteilt.
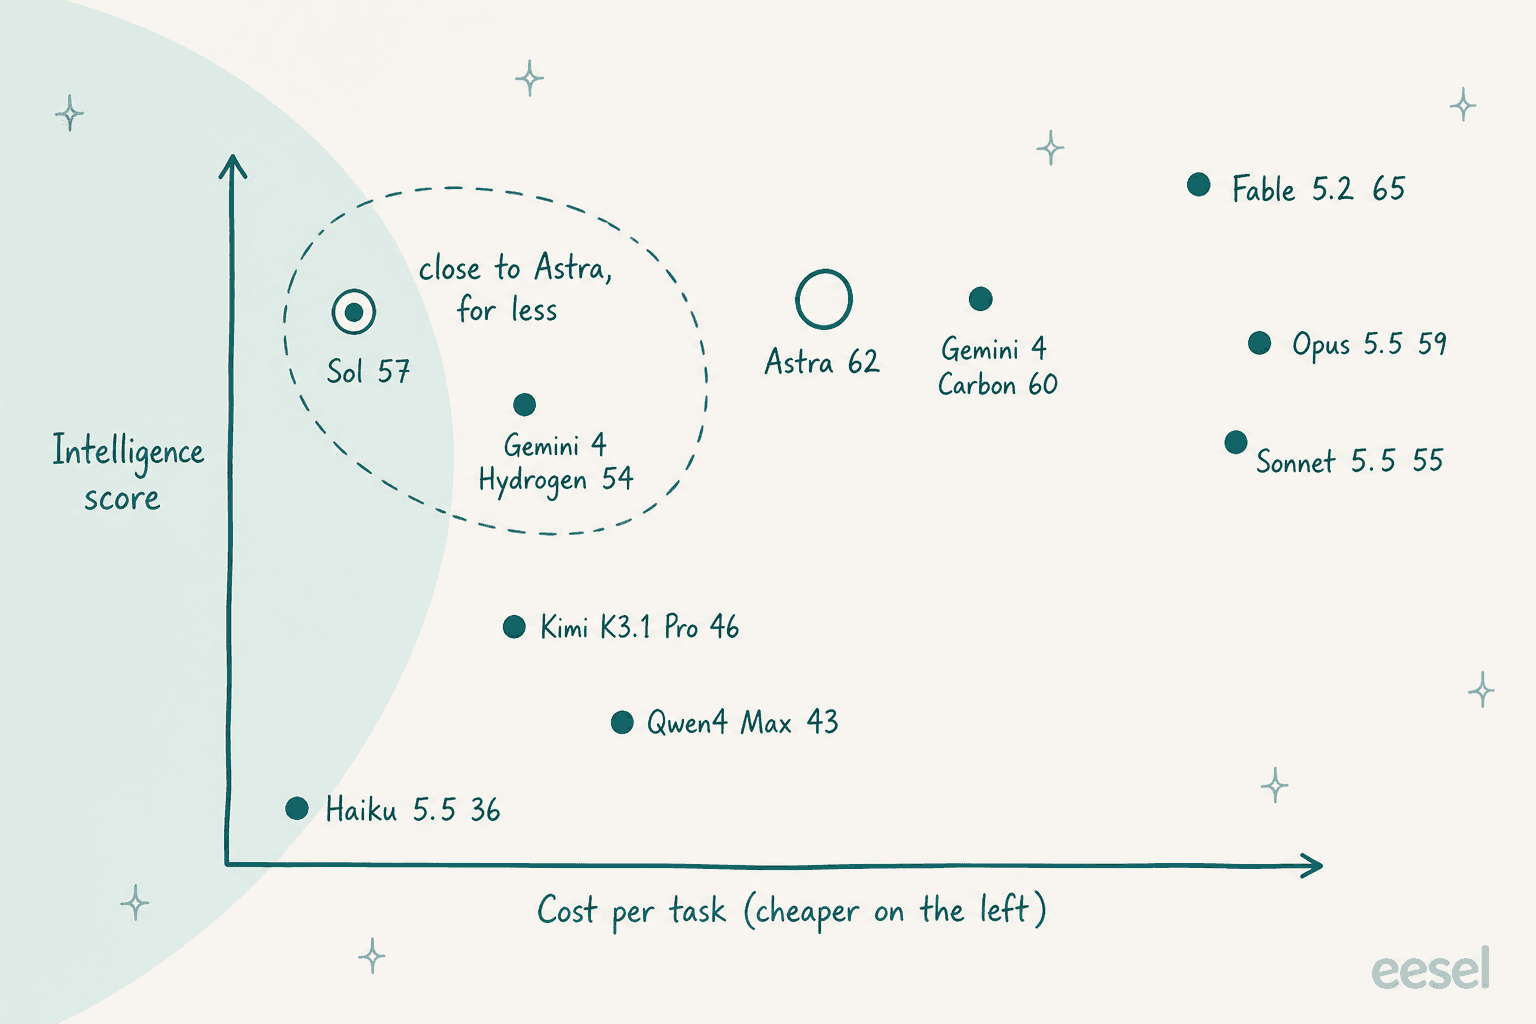
Das Diagramm ist der Beitrag in einem Bild. Astra sitzt hoch und in der Mitte. Fable 5.2 ist das einzige Modell darüber, weit rechts. Sol sitzt fast genauso hoch, weit links.
GPT-6.2-Astra-Alternativen im Überblick
Preise sind pro Million Token zu Standardraten. Die Artificial-Analysis-Scores und -Kosten gelten bei der höchsten Effort-Einstellung jedes Modells.
| Modell | Hersteller | Input / Output | Gecachter Input | Kontext | AA-Score | AA-Kosten pro Aufgabe | Zeit pro AA-Aufgabe | Am besten für |
|---|---|---|---|---|---|---|---|---|
| GPT-6.2 Astra (Basis) | OpenAI | $8 / $40 | $0,40 | 1,05M | 62 | $4,00 | 10,4 Min | Schwierige mehrstufige Agentenarbeit |
| GPT-6.2 Sol | OpenAI | $2 / $10 | $0,10 | 1,05M | 57 | $1,01 | 7,9 Min | Der meiste Produktions-Agenten-Traffic |
| Claude Opus 5.5 | Anthropic | $4 / $20 | $0,20 | 1M | 59 | $10,04 | 24,6 Min | Lange Coding- und Schreibarbeit |
| Claude Fable 5.2 | Anthropic | $8 / $40 | $0,20 | 1M | 65 | $26,54 | 40,8 Min | Der höchste verfügbare Score |
| Claude Sonnet 5.5 | Anthropic | $2 / $10 | $0,10 | 1M | 55 | $10,02 | 32,3 Min | Anthropic zum Sol-Preisniveau |
| Gemini 4 Carbon | $2 / $10 bis 30. Nov., dann $4 / $20 | $0,10, dann $0,20 | 1M | 60 | $5,48 | 33,4 Min | Fast-Astra-Score, zweiter Anbieter | |
| Gemini 3.8 Flash | $0,75 / $3,75 bis 31. Dez. | $0,075 | - | 31 | - | 14,1 Min | Günstige Schritte mit hohem Volumen | |
| Grok 4.7 | xAI | $2 / $6 | $0,50 | 500K | 35 | - | 24,5 Min | Agenten-Loops mit langem Output |
| DeepSeek V4 Pro und Flash | DeepSeek | $0,66 / $1,98 (Pro, außerhalb der Stoßzeit) | $0,022 | 1M | 23 (Pro) | $1,77 (Pro) | 17,3 Min | Niedrigste Token-Rechnung |
| Kimi K3.1 Pro | Moonshot AI | $2 / $10 | $0,20 | 1M | 46 | $3,68 | 38,7 Min | Nicht-US-Option zum Sol-Preis |
| Qwen4 Max | Alibaba (Qwen Cloud) | $1,50 / $4,50 | $0,075 | 1M | 43 | $3,27 | 31,9 Min | Niedrige Output-Preise in großem Maßstab |
Zwei Dinge, die du vor der Liste lesen solltest. Gemini 4 Carbons Preis verdoppelt sich am 1. Dezember, also plane mit der späteren Rate. Und DeepSeeks Preise verdoppeln sich an Wochentagen zur Stoßzeit, was ich in seinem Abschnitt behandle.
Bedeutet der halbe Token-Preis die halbe Rechnung?
Nein, und hier gehen die meisten Vergleiche schief. Der Token-Preis eines Modells sagt dir, was ein Token kostet. Er sagt dir nicht, wie viele Token das Modell verbraucht, um eine Aufgabe zu erledigen, oder wie lange es vorher nachdenkt.
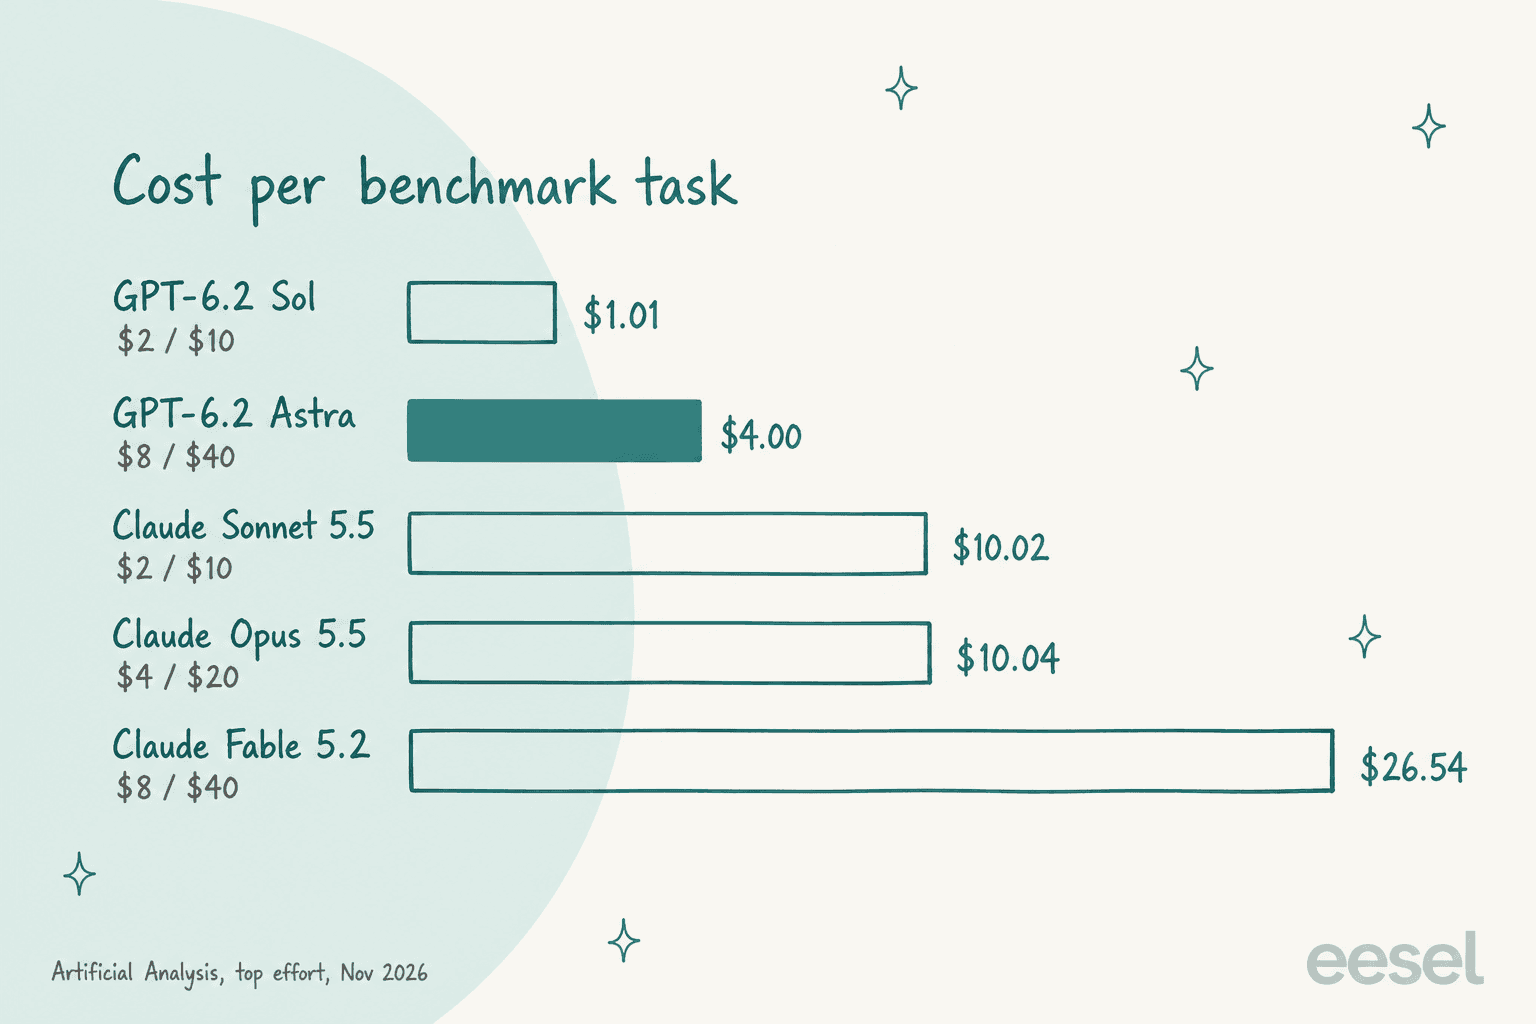
Claude Opus 5.5 berechnet die Hälfte von Astras Token-Rate, $4/$20 gegenüber $8/$40, doch Artificial Analysis maß es mit $10,04 pro Aufgabe gegenüber Astras $4,00. Sonnet 5.5 hat den gleichen Token-Preis wie Sol und kostete zehnmal so viel pro Aufgabe. Der Grund zeigt sich in der Zeitspalte: Opus brauchte 24,6 Minuten pro Aufgabe und Sonnet 32,3 Minuten bei maximalem Effort, gegenüber Astras 10,4. Mehr Nachdenken bedeutet mehr Output-Token, und Output ist die teure Seite jeder Preiskarte.
Zwei Vorbehalte halten das fair. Artificial Analysis lässt jedes Modell bei seinem höchsten Effort laufen, und Anthropics Modellübersicht liefert Opus 5.5 standardmäßig mit mittlerem Effort aus, also wird deine Rechnung bei Standardeinstellungen niedriger sein als die Benchmark-Zahl. Und eine Benchmark-Aufgabe ist nicht deine Aufgabe. Behandle Kosten pro Aufgabe als Warnung zur Richtung, und miss dann an deiner eigenen Arbeit.
Ein HN-Kommentator legte echte Zahlen auf die gleiche Idee aus seiner eigenen Coding-Nutzung:
"Opus cost me about $1 in tokens per task while Haiku costs about 4.6 cents and Luna is about 2.5 cents."
1. GPT-6.2 Sol
Am besten für: Teams, die bei OpenAI bleiben und die Rechnung um etwa 75% senken wollen.
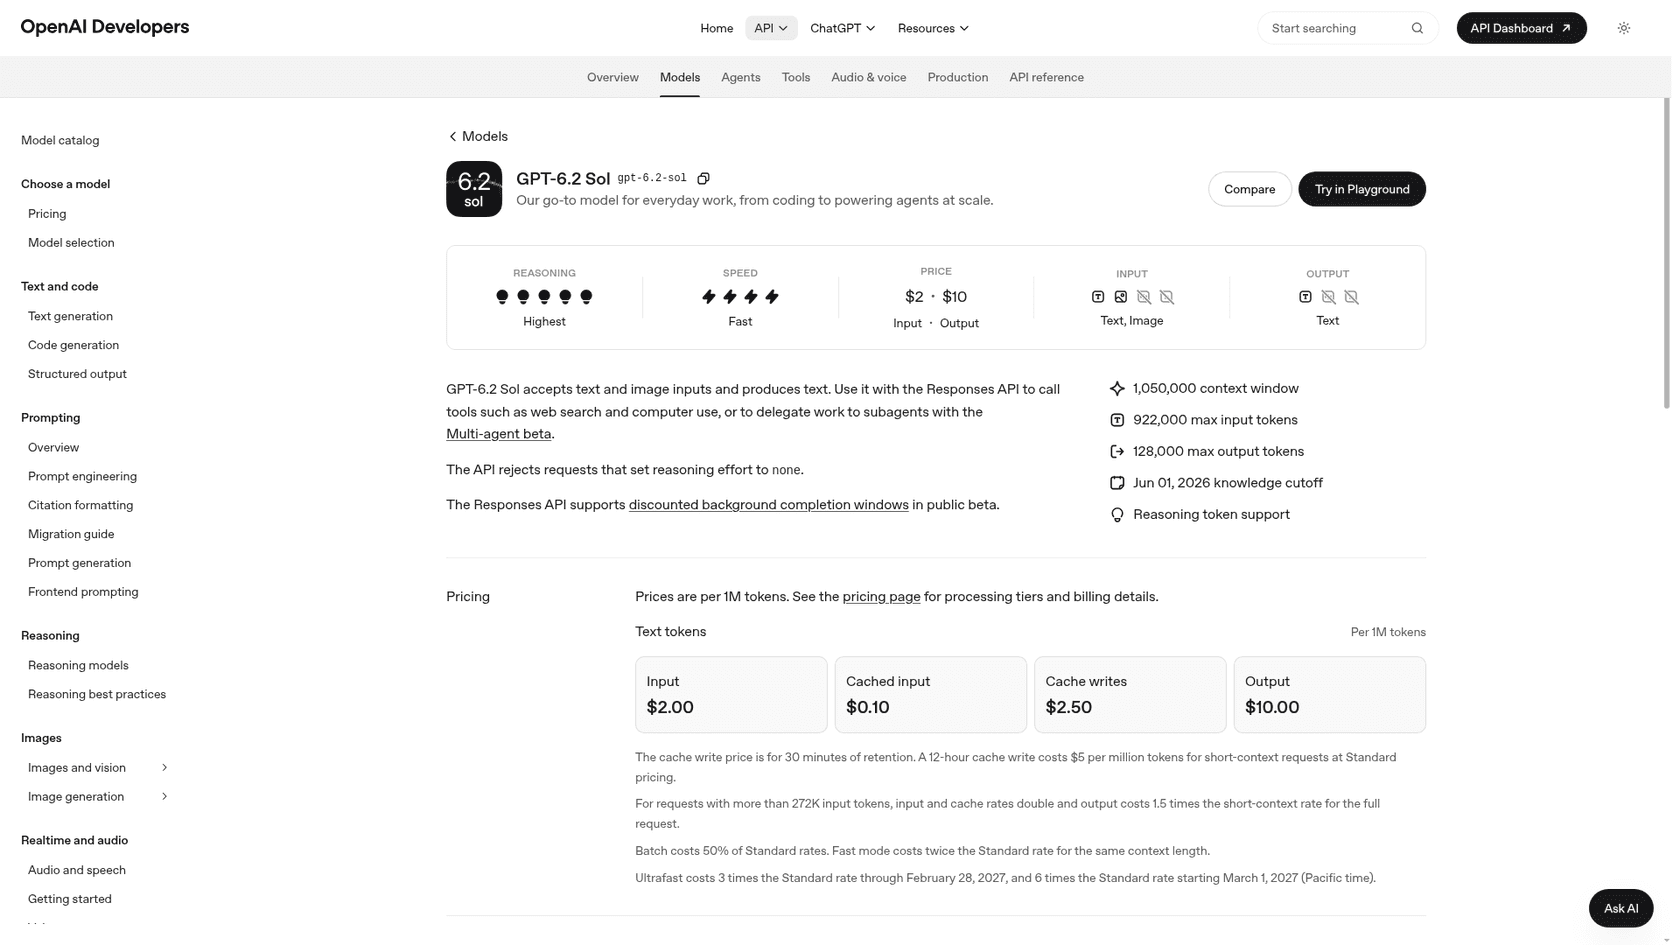
GPT-6.2 Sol wurde zusammen mit Astra veröffentlicht und nutzt die gleiche API, die gleichen Werkzeuge und das gleiche 1.050.000-Token-Kontextfenster, mit 922.000 Token Input und 128.000 Token Output. Den Modellnamen zu tauschen ist die gesamte Migration. Artificial Analysis bewertet es mit 57, gleichauf mit der letzten Generation GPT-6 Astra, bei etwa 15% der Kosten pro Aufgabe dieses Modells.
Bei meinem Test holte sich Sol den Spitzenplatz. Über 45 Durchläufe bei niedrigem, mittlerem und hohem Effort beantwortete es jedes Ticket korrekt: Die anteilige Rückerstattung ergab jedes Mal $990, die Prompt-Injection bekam ein höfliches Nein, die defekte Abfrage wurde eskaliert, und die spanischen und deutschen Kunden erhielten Antworten in ihrer eigenen Sprache. Astra tat dasselbe.
| Mein Test, 15 Tickets | Kosten pro 1.000 Tickets | Mittlere Antwortzeit |
|---|---|---|
| GPT-6.2 Astra, niedrig / mittel / hoch | $5,75 / $5,79 / $6,57 | 5,4s / 3,3s / 4,5s |
| GPT-6.2 Sol, niedrig / mittel / hoch | $1,42 / $1,40 / $1,54 | 2,5s / 2,5s / 2,8s |
Gleiche Antworten, etwa ein Viertel des Preises, und schneller. Der Effort-Level hat die Kosten bei Tickets dieser Länge kaum bewegt, was man wissen sollte, bevor man standardmäßig für hohen Effort zahlt.
"For just doing things or coding things up, Sol all the way."
Vorteile
- $2/$10 pro Million Token, mit gecachtem Input bei $0,10
- Gleiche API, Werkzeuge und Kontextfenster wie Astra, der Wechsel ist also eine Ein-Zeilen-Änderung
- Erreichte Astra bei allen 15 meiner Support-Tickets, bei jedem Effort-Level
Nachteile
- Artificial Analysis sagt, es verlor 3 Punkte auf seinem Coding Agent Index gegenüber GPT-6.1 Sol, hauptsächlich weil es wichtige Fakten in Antworten ausließ
- Bei großen Codebasen schicken manche Entwickler Sols Arbeit immer noch zur Nachbearbeitung an Astra zurück
- Die API lehnt den Reasoning-Effort
noneab
Preise: $2 Input, $0,10 gecacht, $10 Output pro Million Token zum Standardtarif, laut OpenAIs Preisseite. Batch halbiert das. Der Leitfaden OpenAI-API-Preise deckt die Stufen ab.
Fazit: Fang hier an. Mach Sol zu deinem Standard und behalte Astra für die Aufgaben, bei denen Sol sichtbar scheitert. Der GPT-6.1-Sol-Test deckt die Vorgängerversion ab, falls du heute darauf läufst.
2. Claude Opus 5.5
Am besten für: lange Coding- und Schreibarbeit, bei der klare Erklärungen wichtiger sind als reine Geschwindigkeit.
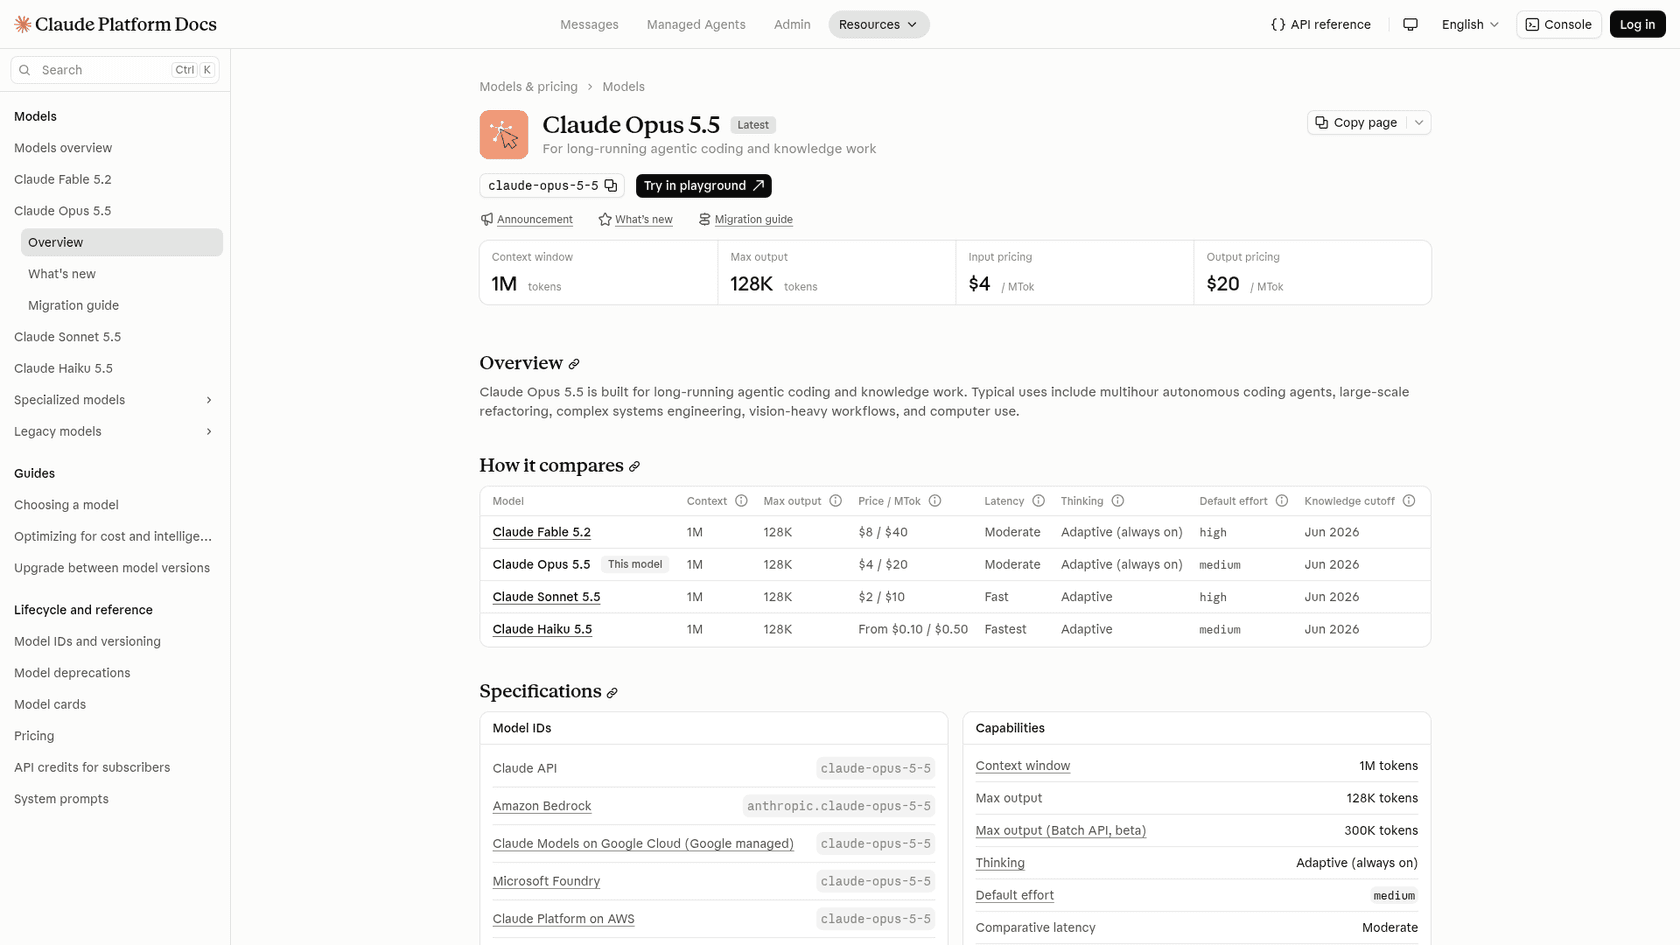
Claude Opus 5.5 ist das Modell, das Anthropic den meisten Entwicklern als Einstieg empfiehlt. Die Dokumentation beschreibt es als gebaut "für long-running agentic coding and knowledge work", mit einem 1M-Token-Kontextfenster, 128K Output und mittlerem Effort als Standard. Es erreicht 59 auf Artificial Analysis, drei Punkte unter Astra.
Der Fall dafür ist nicht der Score. Es ist, wie es kommuniziert. Die lauteste Beschwerde über Astra ist, dass seine langen Zusammenfassungen schwer zu folgen sind, und Opus ist das, wozu mehrere Tester greifen, um das zu beheben.
"I've already built the habit of switching to opus 5.5 at the end of a long 6.2 Astra run, just to get a readable summary of what it said."
Vorteile
- Halber Token-Preis von Astra, bei $4/$20, mit Cache-Reads zu $0,20
- Tester bevorzugen durchgängig seine Erklärungen und Planung bei langen Aufgaben
- Fast-Modus bietet bis zu 2,5x Output-Geschwindigkeit zum Aufpreis, laut Anthropics Preisdokumentation
Nachteile
- $10,04 pro Benchmark-Aufgabe bei maximalem Effort, 2,5-mal Astras Zahl
- 24,6 Minuten pro Aufgabe bei maximalem Effort, mehr als doppelt so viel wie Astras Zeit
- Manche Entwickler finden immer noch, dass sein Prosa-Stil einen zweiten Korrekturdurchgang braucht
Preise: $4 Input, $20 Output, $0,20 Cache-Reads, $5 für 5-Minuten-Cache-Writes. Der Leitfaden Claude-Opus-5.5-Preise schlüsselt den Rest auf.
Fazit: die beste Option als zweiter Anbieter für alle, die den Output des Agenten lesen. Lass es bei mittlerem statt maximalem Effort laufen, und prüfe die Rechnung pro Aufgabe, bevor du annimmst, dass der niedrigere Token-Preis sich durchträgt. Mein Claude-Opus-5.5-Test hat die längere Einschätzung.
3. Claude Fable 5.2
Am besten für: die seltene Aufgabe, bei der der Top-Score wichtiger ist als die Rechnung.
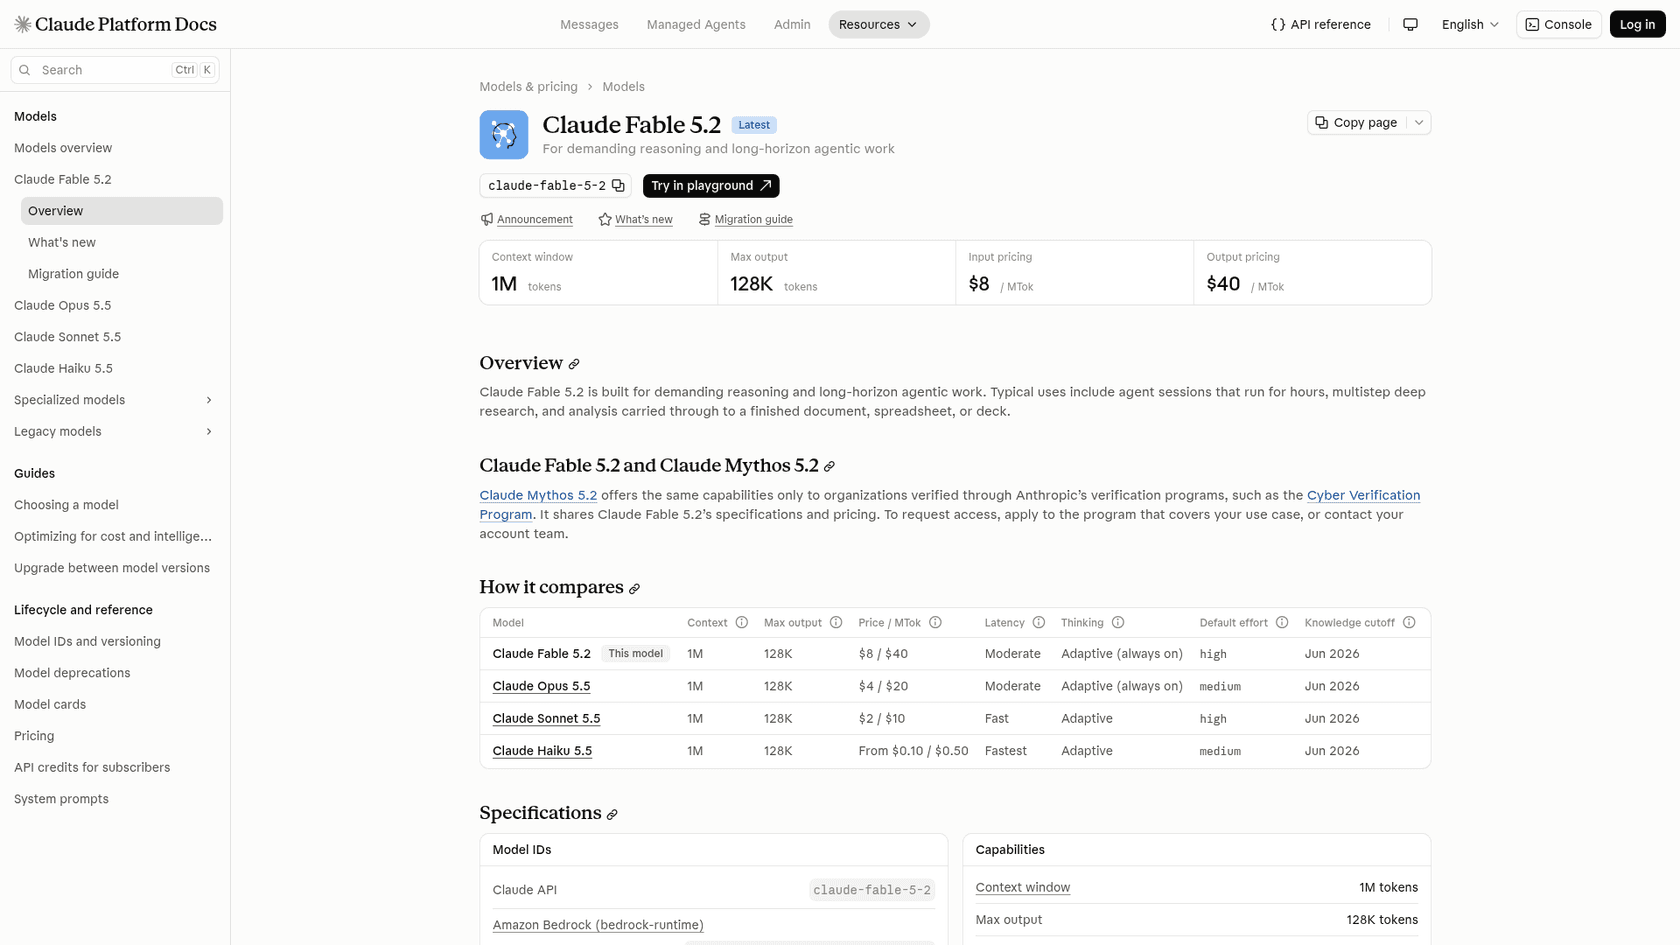
Claude Fable 5.2 ist das einzige Modell auf dieser Liste, das Astra im Score übertrifft: 65 gegenüber 62 im Artificial Analysis Intelligence Index. Es hat den gleichen $8/$40-Listenpreis wie Astra, und seine Cache-Reads sind mit $0,20 gegenüber $0,40 halb so teuer. Anthropic beschreibt es als gebaut "für demanding reasoning and long-horizon agentic work".
Dann kommt die Rechnung pro Aufgabe. Artificial Analysis maß Fable 5.2 mit $26,54 pro Aufgabe und 40,8 Minuten, gegenüber Astras $4,00 und 10,4 Minuten. Gleicher Token-Preis, 6,6-mal die Kosten pro Aufgabe. Ein HN-Kommentator fasste Astras Seite dieses Tauschs zusammen:
"Second place at a sixth the price and in a quarter of the time (both according to Artificial Analysis for Astra 6.2 vs. Fable 5.2, both max effort) definitely has a place."
Andere sahen es nach Wochen des Testens anders:
"We've been testing them for the last few weeks @every and, unfortunately, these models aren't great. Overall a disappointing release compared to Fable 5.2."
Vorteile
- Höchster Artificial-Analysis-Score aller Modelle, bei 65
- Gleicher Token-Preis wie Astra, mit günstigeren Cache-Reads
- Starke Tester-Bewertungen bei Design und langen agentischen Aufgaben
Nachteile
- $26,54 pro Benchmark-Aufgabe, das teuerste Modell hier, mit großem Abstand
- 40,8 Minuten pro Aufgabe, das langsamste auf der Liste
- Denken ist immer aktiviert, du kannst es also nicht gegen einen Non-Reasoning-Modus eintauschen
Preise: $8 Input, $40 Output, $0,20 Cache-Reads, $10 für 5-Minuten-Cache-Writes. Batch ist die Hälfte. Der Leitfaden Claude-Fable-5.2-Preise deckt den Fast-Modus ab.
Fazit: ein Upgrade, keine Alternative. Nutze es für die wenigen Aufgaben, bei denen Astra falsch liegt, und erwarte, dass die Rechnung das zeigt. Der Claude-Fable-5.2-Test hat die Details.
4. Claude Sonnet 5.5
Am besten für: Teams, die Anthropics Stil zum Preis von Sol wollen.
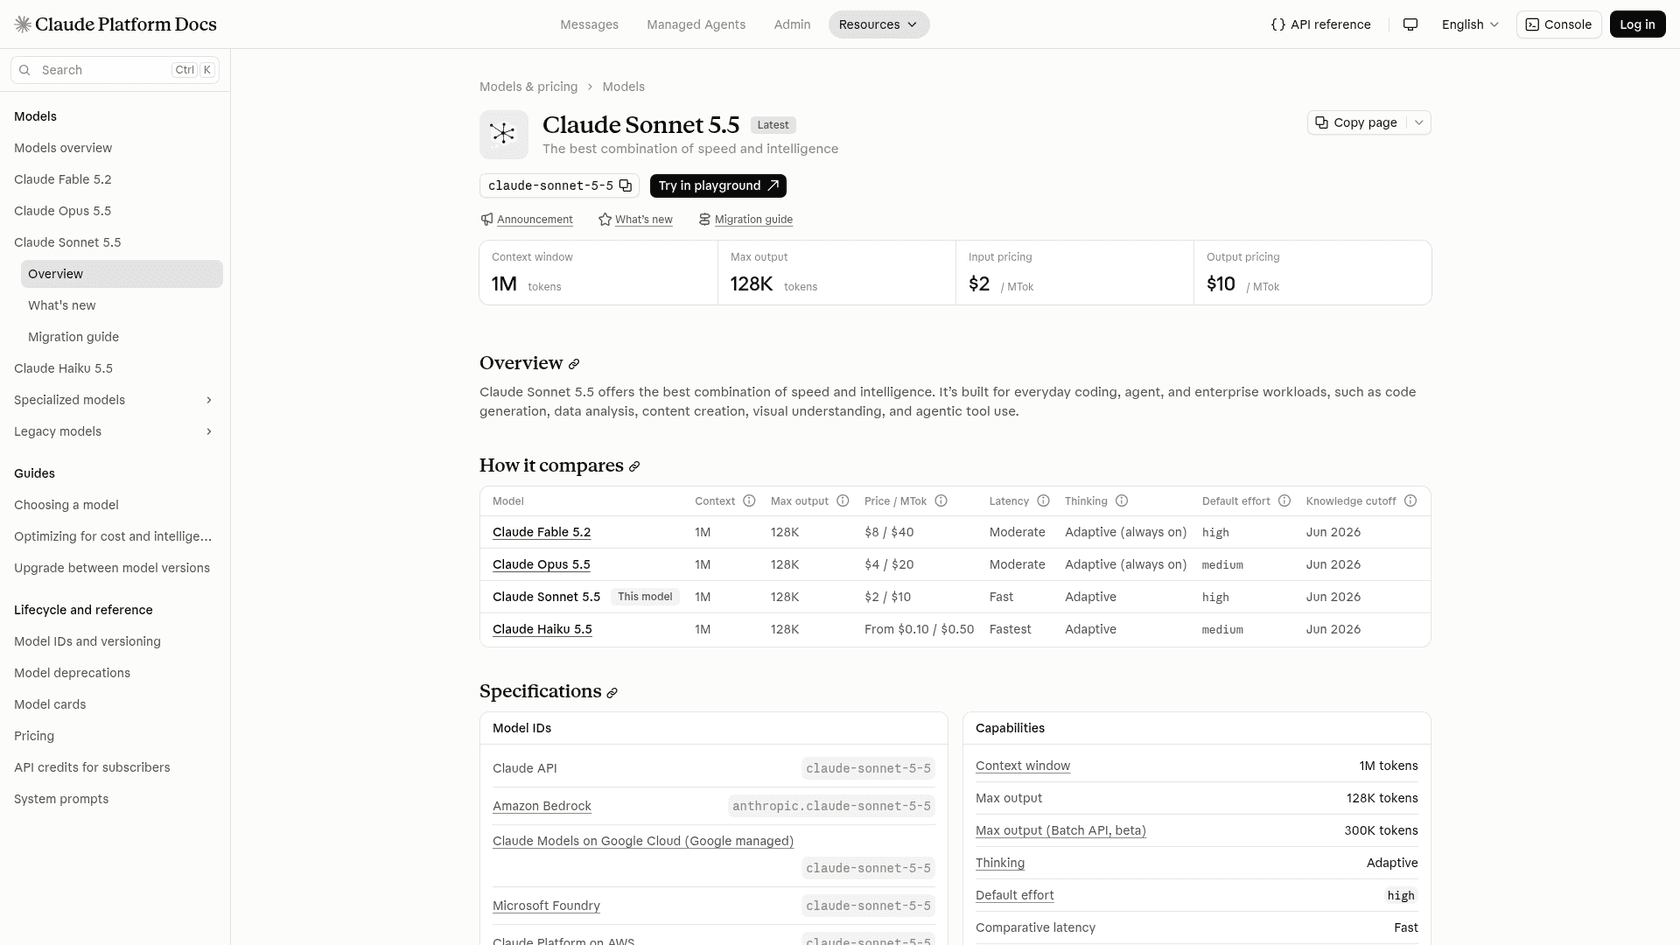
Claude Sonnet 5.5 ist das, was Anthropic "the best combination of speed and intelligence" nennt. Es kostet $2/$10, genauso wie Sol, mit Cache-Reads zu $0,10 und einem 1M-Token-Kontext. Anders als Opus und Fable ist sein Denken adaptiv statt immer aktiviert, und der Standard-Effort ist hoch.
Auf Artificial Analysis erreicht es 55 bei maximalem Effort, mit Kosten pro Aufgabe von $10,02 und 32,3 Minuten pro Aufgabe. Das ist die gleiche Kosten-pro-Aufgabe-Falle wie bei Opus, und hier beißt sie stärker, da Sol zwei Punkte mehr erreicht, für ein Zehntel der Kosten pro Aufgabe. Die Lösung ist die gleiche: unterhalb von maximalem Effort laufen lassen und messen.
Vorteile
- $2/$10 mit $0,10 Cache-Reads, gleich wie Sol
- Adaptives Denken, einfache Anfragen zahlen also nicht für ein langes Nachdenken
- Gleicher 1M-Kontext und 128K Output wie Opus
Nachteile
- $10,02 pro Benchmark-Aufgabe bei maximalem Effort, zehnmal Sols Zahl
- 55 auf Artificial Analysis, unter Sols 57
- Standard-Effort ist hoch, die teure Einstellung ist also die Standardeinstellung
Preise: $2 Input, $10 Output, $0,10 Cache-Reads, $2,50 für 5-Minuten-Cache-Writes, laut Anthropics Preisen. Siehe den Leitfaden Claude-Sonnet-5.5-Preise.
Fazit: wähle es gegenüber Sol nur, wenn du bereits bei Anthropic bist oder seinen Schreibstil bevorzugst, und setze den Effort-Level selbst. Mein Claude-Sonnet-5.5-Test deckt die Breaking Changes ab.
5. Gemini 4 Carbon
Am besten für: einen Fast-Astra-Score von einem zweiten Anbieter, wenn du zum Dezember-Preis budgetierst.
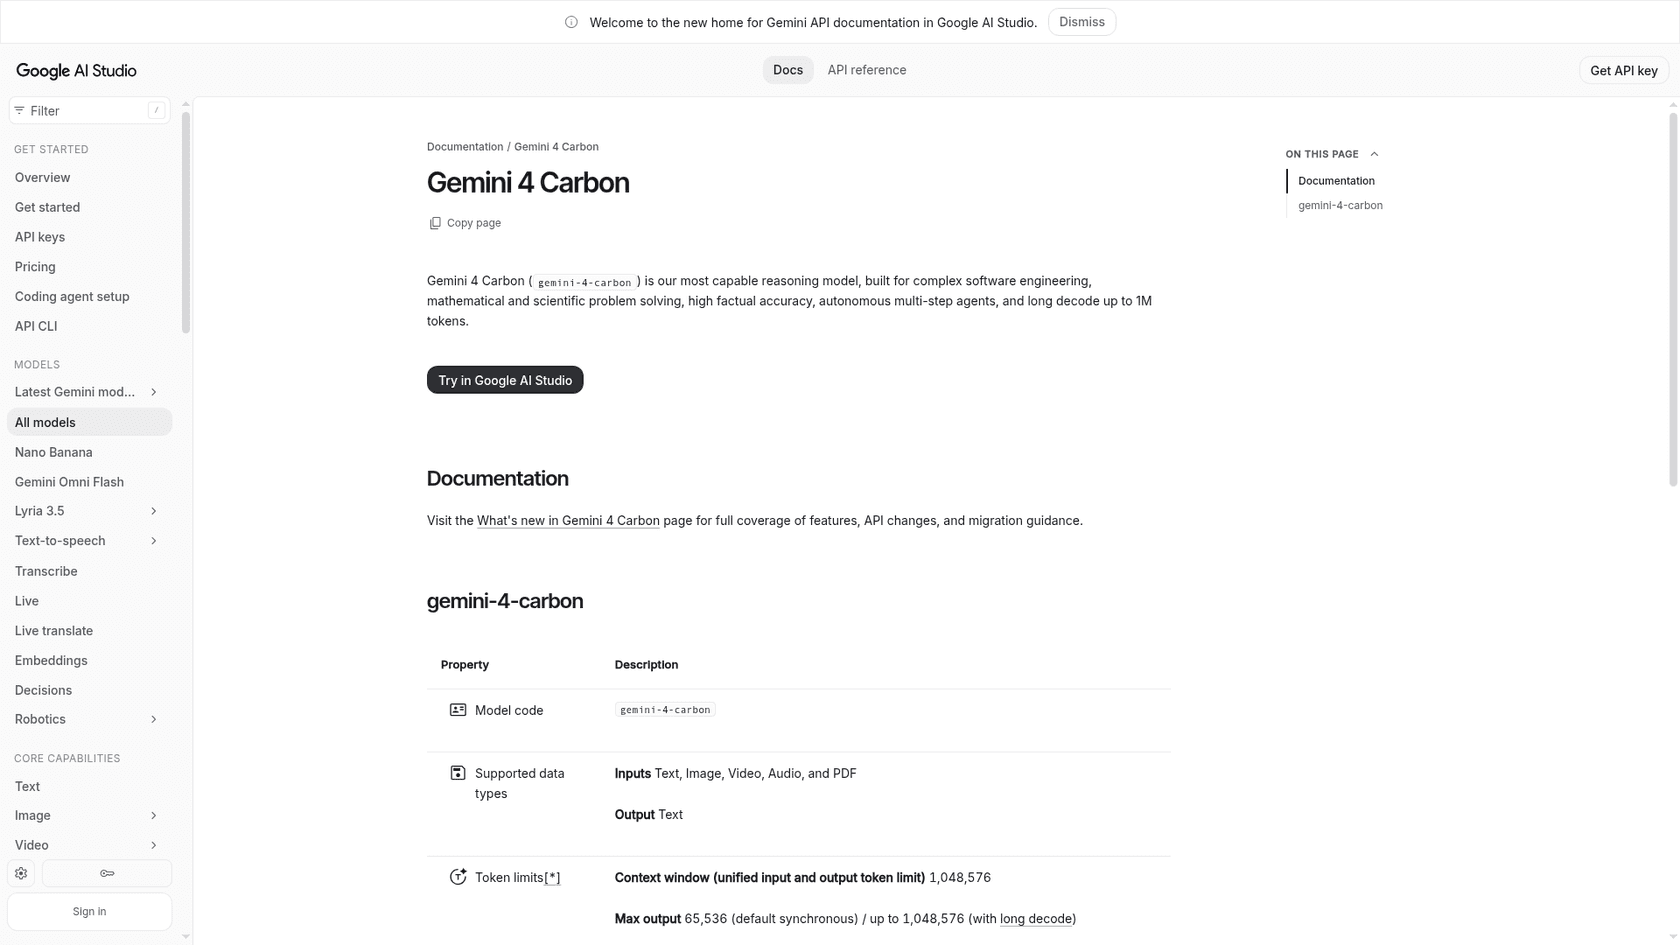
Gemini 4 Carbon ist Googles bestes Reasoning-Modell und erreicht 60 auf Artificial Analysis, zwei Punkte unter Astra und einen über Opus 5.5. Seine Kosten pro Aufgabe liegen bei $5,48, das ist die nächste Annäherung, die ein Nicht-OpenAI-Modell an Astra auf beiden Achsen gleichzeitig erreicht. Es nimmt Text, Bilder, Video, Audio und PDF, mit einem 1.048.576-Token-Kontext und bis zu 1M Token Output durch langes Decoding.
Behalte den Kalender im Auge. Googles Preisseite listet Carbon bei $2/$10 bis zum 30. November 2026, danach $4/$20 ab dem 1. Dezember. Caching funktioniert nur implizit, und es gibt keine kostenlose Stufe für Carbon.
Wenn Carbons Preis zu hoch ist, ist Googles Gemini 4 Hydrogen das günstigere Geschwistermodell: $1,50/$7,50, eine kostenlose Stufe und ein Score von 54 bei $3,16 pro Aufgabe. Und ein Entwickler auf HN fand einen eigenen Grund, sich die Familie anzuschauen:
"My favorite model for this at the moment is Gemini 4 Argon, which writes very naturally and isn't too expensive."
Vorteile
- 60 auf Artificial Analysis bei $5,48 pro Aufgabe, die beste Nicht-OpenAI-Balance auf dieser Liste
- Nimmt Video, Audio und PDF ebenso wie Text und Bilder als Input
- Bis zu 1M Token Output mit langem Decoding
Nachteile
- Preis verdoppelt sich am 1. Dezember 2026 auf $4/$20
- 33,4 Minuten pro Benchmark-Aufgabe, mehr als dreimal so lang wie Astras Zeit
- Nur implizites Caching, und keine kostenlose Stufe
Preise: $2/$10 und $0,10 Caching bis zum 30. November, danach $4/$20 und $0,20. Search Grounding ist kostenlos für 5.000 Anfragen pro Monat, danach $14 pro 1.000. Der Leitfaden Gemini-4-Carbon-Preise hat die Batch- und Flex-Stufen.
Fazit: die stärkste Wahl als zweiter Anbieter, wenn du eine Intelligenz nahe an Astra brauchst. Kalkuliere von Tag eins mit $4/$20, damit der Dezember dich nicht überrascht. Mein Gemini-4-Carbon-Test deckt die Benchmarks ab.
6. Gemini 3.8 Flash
Am besten für: günstige Schritte mit hohem Volumen wie Klassifikation, Extraktion und erste Entwürfe.
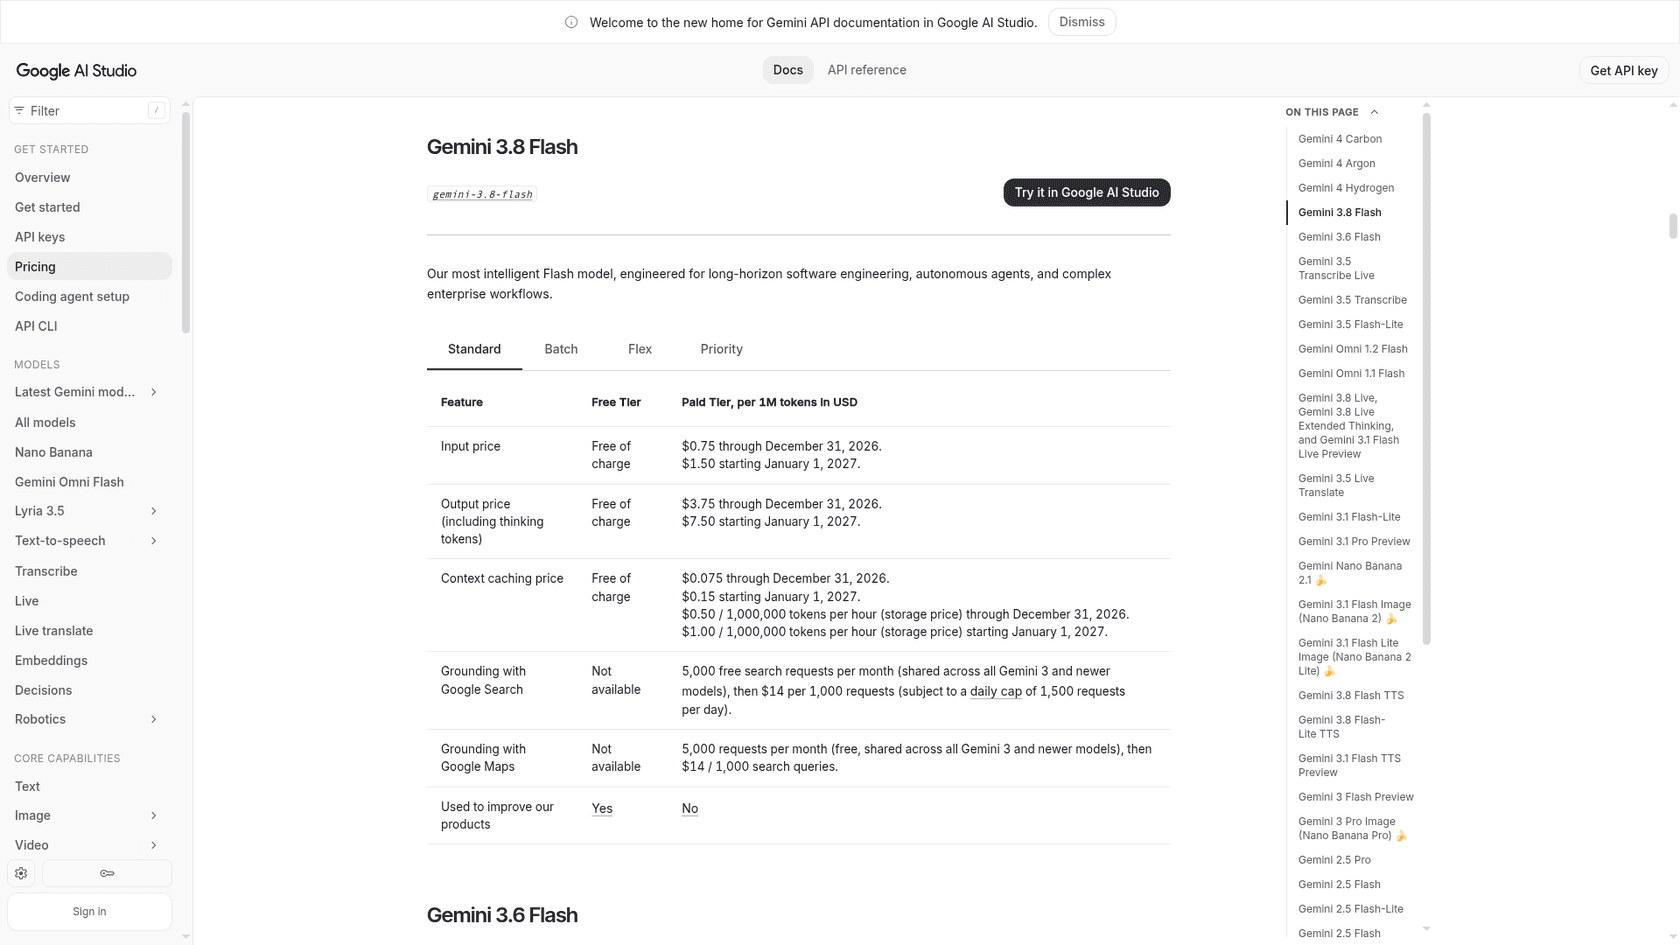
Google beschreibt Gemini 3.8 Flash als sein intelligentestes Flash-Modell, "engineered for long-horizon software engineering, autonomous agents, and complex enterprise workflows". ChatGPT setzte es weit oben auf seine eigene Liste von Astra-Alternativen, wegen des Preises: $0,75/$3,75 pro Million Token, etwa ein Zehntel von Astras Preis.
Der Score ist die andere Hälfte der Geschichte. Er liegt bei 31 auf dem Artificial Analysis Intelligence Index, der Hälfte von Astras 62. Das ist kein Ersatz für Astras schwierige Aufgaben. Es ist ein Modell für die günstige Spur eines geroutet aufgebauten Systems, wo die Aufgabe klein und klar definiert ist.
Vorteile
- $0,75/$3,75, etwa ein Zehntel von Astras Token-Preis
- Kostenlose Stufe zum Testen
- Gecachter Input bei $0,075
Nachteile
- 31 auf Artificial Analysis, der zweitniedrigste Score auf dieser Liste
- Der Preis verdoppelt sich am 1. Januar 2027 auf $1,50/$7,50
- 14,1 Minuten pro Benchmark-Aufgabe, langsamer als Astra, obwohl es ein Flash-Modell ist
Preise: $0,75 Input, $3,75 Output, $0,075 Caching bis zum 31. Dezember 2026, laut Googles Preisseite. Der Leitfaden Gemini-3.8-Flash-Preise deckt den Sprung 2027 ab.
Fazit: ein Routing-Werkzeug, kein Tausch. Nutze es für den einfachen Teil deines Traffics und behalte ein stärkeres Modell für alles, was Urteilsvermögen braucht. Die Liste Gemini-3.8-Flash-Alternativen hat Optionen in der gleichen Preisklasse.
7. Grok 4.7
Am besten für: lange Agenten-Loops, bei denen das Output-Volumen Astra teuer machen würde.
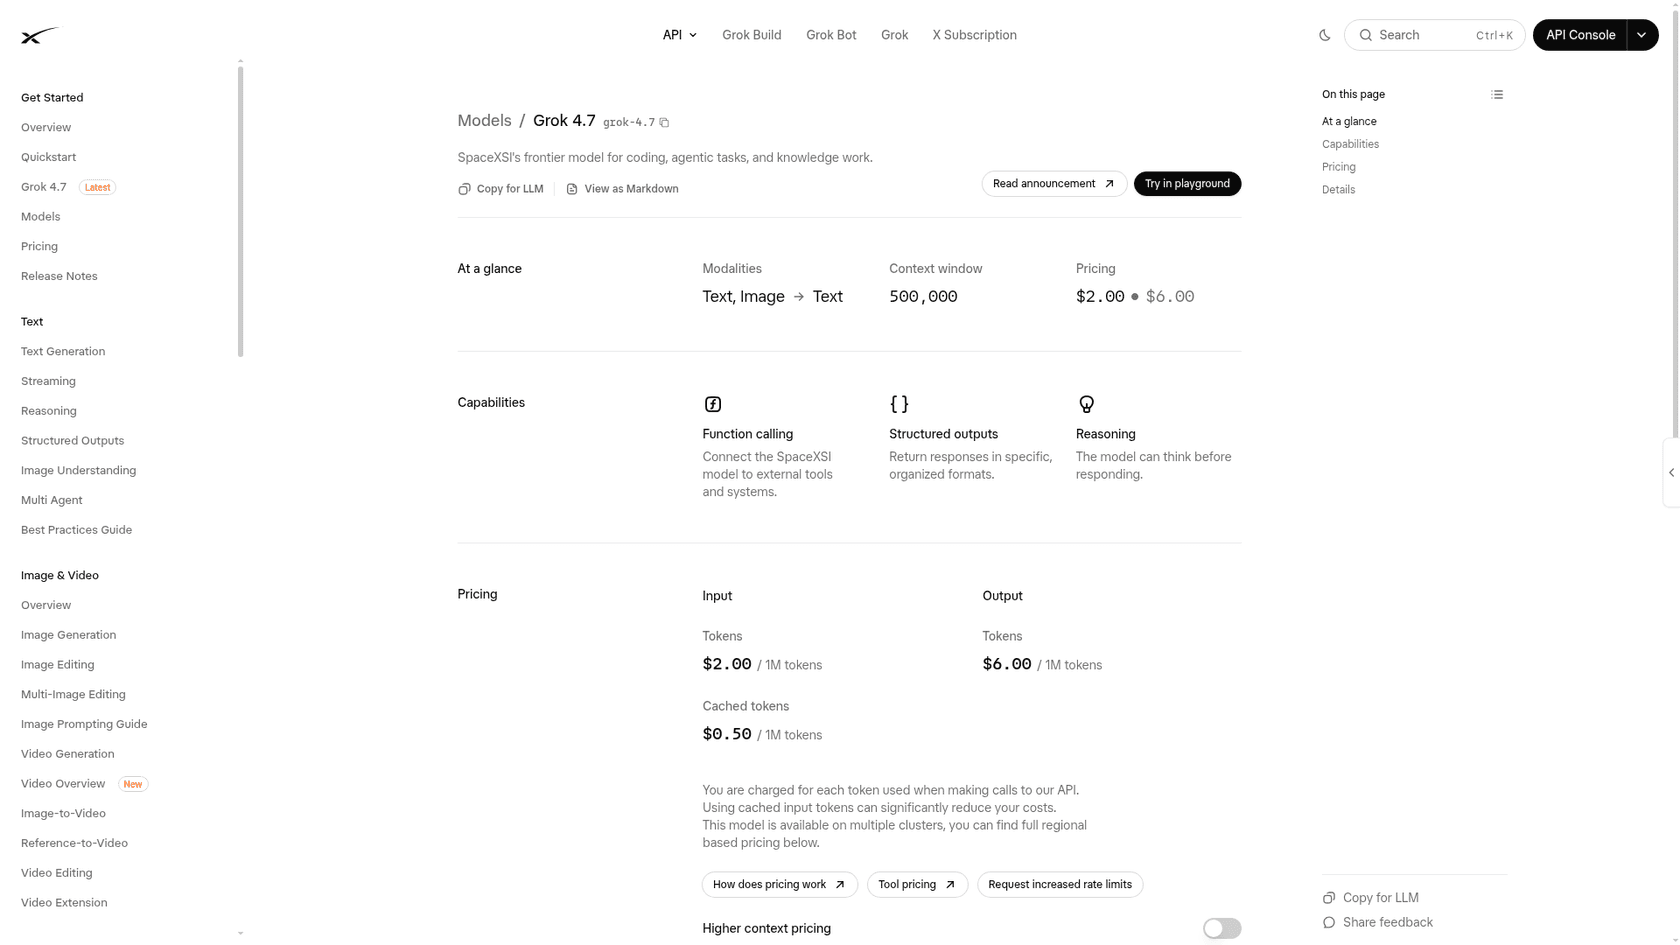
Grok 4.7 berechnet $6 pro Million Output-Token, gegenüber Astras $40 und Sols $10. Input kostet $2, mit gecachtem Input bei $0,50, und das Kontextfenster liegt bei 500K Token. xAI unterstützt außerdem Function Calling, strukturierte Outputs und Reasoning beim Modell.
Sein Artificial-Analysis-Score liegt bei 35 bei xhigh-Effort, und es brauchte 24,5 Minuten pro Benchmark-Aufgabe. Das setzt es deutlich unter Astra auf dem allgemeinen Index. xAIs eigene Launch-Benchmarks erzählen eine engere Geschichte, mit Grok 4.7 bei 64,0 auf EEBench gegenüber Claude Fable 5.1s 56,4, teste es also an deinem eigenen Loop, bevor du es ausschließt. Der Grok-4.7-Test hat mehr dazu.
Vorteile
- $6 pro Million Output-Token, weniger als ein Sechstel von Astras Preis
- 500K-Kontextfenster
- Natives Function Calling und strukturierte Outputs
Nachteile
- 35 auf Artificial Analysis, weit unter Astras 62
- Prompts von 200K Token oder mehr werden mit $4/$12 berechnet
- Serverseitige Werkzeuge wie Websuche kosten zusätzlich $5 pro 1.000 Aufrufe
Preise: $2 Input, $0,50 gecacht, $6 Output unter 200K Token, laut xAIs Preisseite. Der Leitfaden Grok-4.7-Preise deckt die Werkzeuggebühren ab.
Fazit: ein Test wert, wenn Output-Token deine Rechnung dominieren. Wähle es nicht allein nach dem Index-Score, in beide Richtungen nicht. Der Beitrag Grok-4.7-Alternativen vergleicht es mit dem Rest seiner Preisklasse.
8. DeepSeek V4 Pro und Flash
Am besten für: die niedrigste Token-Rechnung, wenn deine Workload in die Zeit außerhalb der Stoßzeit und in Text passt.
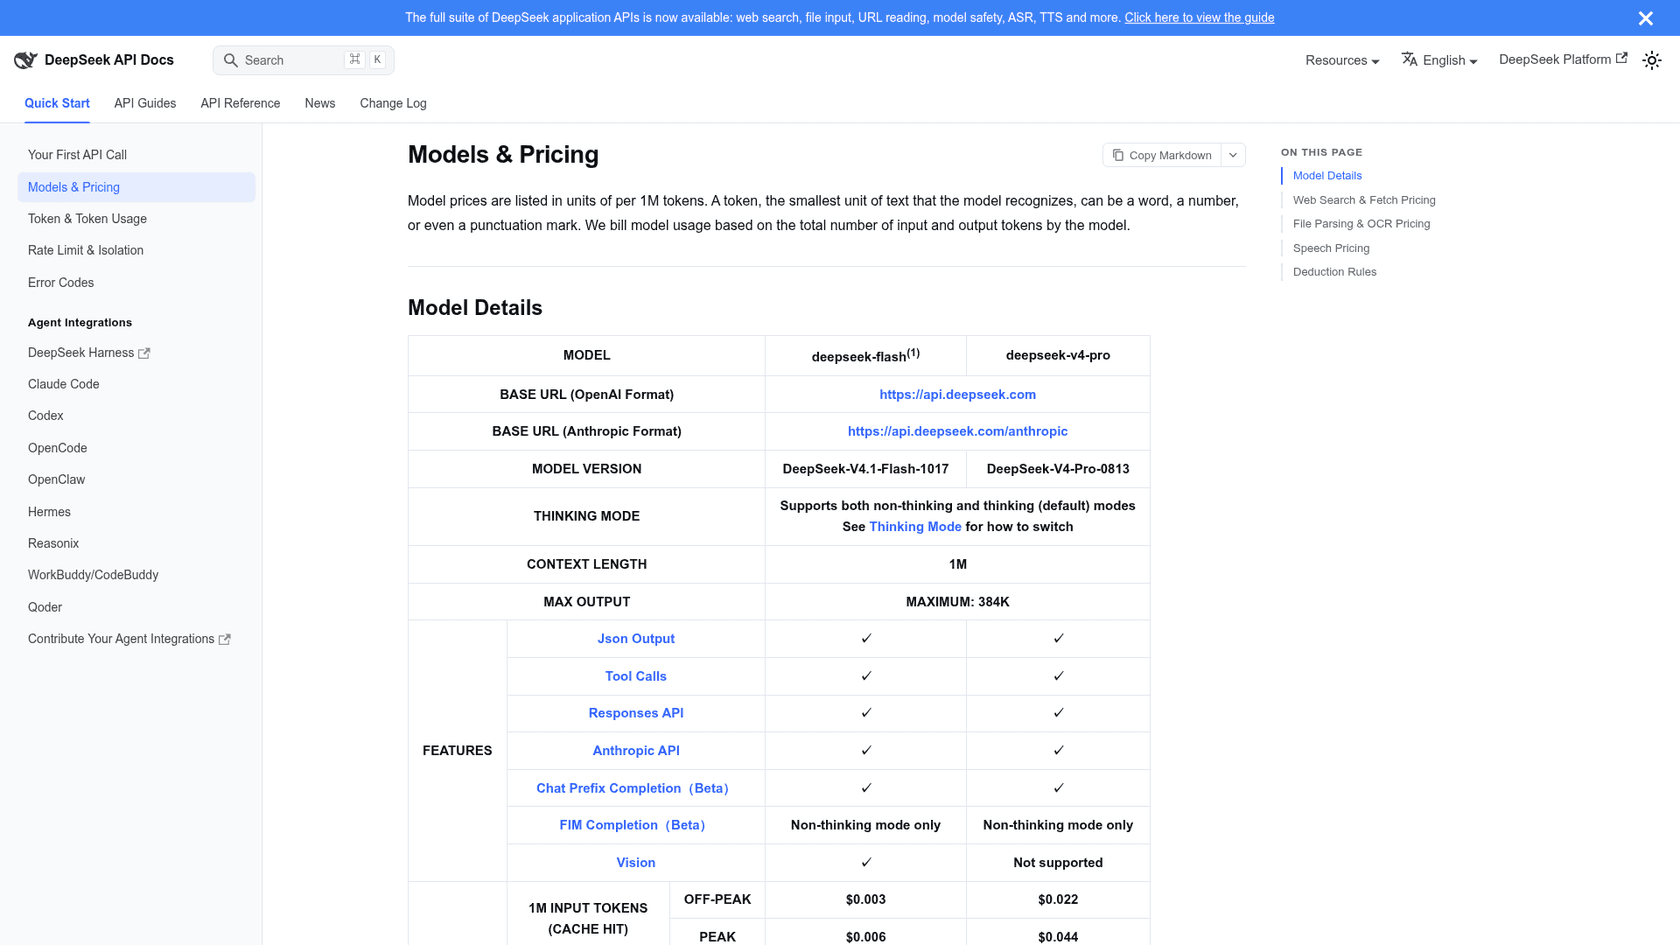
DeepSeek verkauft zwei Modelle über eine OpenAI-kompatible API, und es akzeptiert auch das Anthropic-API-Format. deepseek-flash bedient jetzt DeepSeek V4.1 Flash zu $0,15 Input und $0,60 Output außerhalb der Stoßzeit. deepseek-v4-pro kostet $0,66/$1,98 außerhalb der Stoßzeit. Beide haben einen 1M-Kontext, bis zu 384K Output, Tool-Calls und JSON-Output.
Der Haken ist die Uhr. DeepSeek berechnet an Wochentagen zur Stoßzeit das Doppelte, 01:00 bis 04:00 und 06:00 bis 10:00 UTC, sodass Pro zu $1,32/$3,96 und Flash zu $0,30/$1,20 wird. Cache-Treffer sind mit $0,003 bis $0,044 pro Million fast kostenlos.
Auf Artificial Analysis erreicht V4 Pro 23 bei maximalem Effort, zu $1,77 pro Aufgabe. Das liegt deutlich unter jedem anderen Modell hier, behandle DeepSeek also als Kostenspiel für klar umrissene Arbeit. Flash hat genau dafür seine Fans:
"I used Luna Max a lot, until Deepseek 1017. Then never again."
Vorteile
- Flash zu $0,15/$0,60 außerhalb der Stoßzeit ist das günstigste fähige Modell auf dieser Liste
- Akzeptiert sowohl das OpenAI- als auch das Anthropic-API-Format
- 1M-Kontext und bis zu 384K Output
Nachteile
- Preise verdoppeln sich an Wochentagen zur Stoßzeit (UTC)
- V4 Pro erreicht 23 auf Artificial Analysis, den niedrigsten Wert hier
- V4 Pro unterstützt kein Vision, und die Parallelität ist auf 500 Anfragen begrenzt
Preise: pro Million Token außerhalb der Stoßzeit, Flash $0,15/$0,60, Pro $0,66/$1,98; zur Stoßzeit doppelt. Websuche und Fetch kosten $0,75 pro 1.000 Aufrufe. Der Leitfaden DeepSeek-V4.1-Flash-Preise arbeitet den Stoßzeit-Zeitplan durch.
Fazit: eine starke günstige Spur für reine Textarbeit mit hohem Volumen, nach Möglichkeit außerhalb der Stoßzeit geplant. Kein Ersatz für Astras schwierige Aufgaben. Siehe V4 Flash gegen V4 Pro für die Wahl zwischen den beiden.
9. Kimi K3.1 Pro
Am besten für: eine Nicht-US-Frontier-Option zum Preis von Sol.
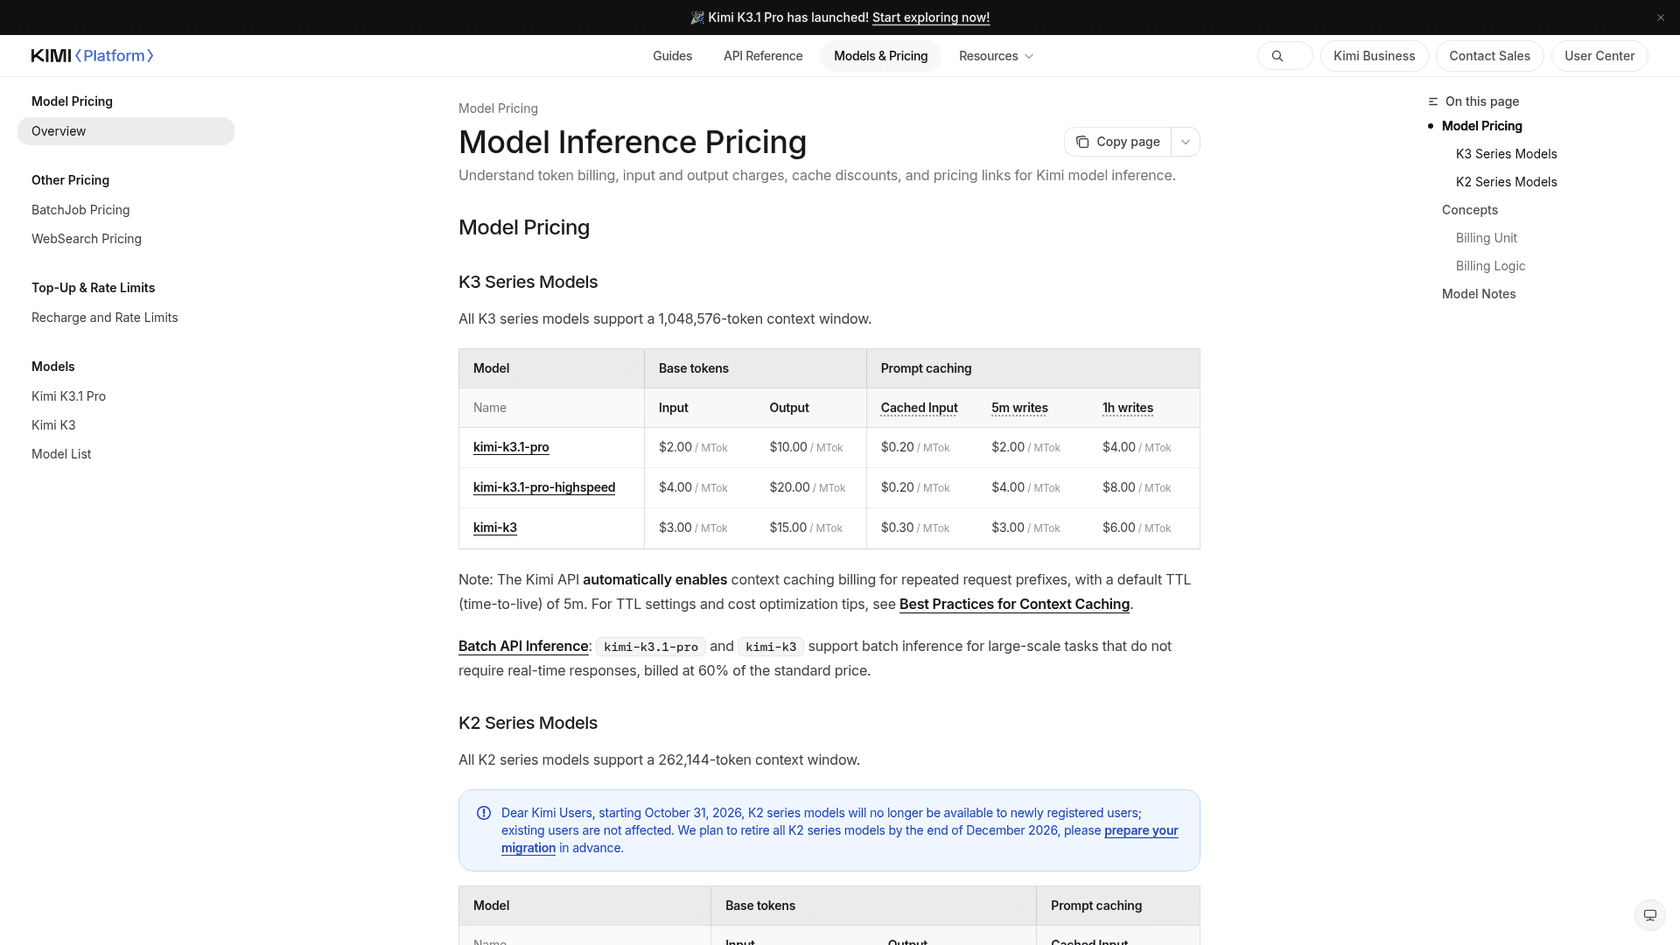
Kimi K3.1 Pro von Moonshot AI kostet $2/$10, genauso wie Sol, mit $0,20 gecachtem Input und einem 1.048.576-Token-Kontextfenster, laut der Kimi-Preisseite. Eine Highspeed-Variante kostet doppelt so viel. Kontext-Caching schaltet sich automatisch für wiederholte Präfixe ein, mit einer standardmäßigen Lebensdauer von 5 Minuten.
Es erreicht 46 auf Artificial Analysis bei $3,68 pro Aufgabe, was es zwischen die Budget-Modelle und die Frontier-Gruppe stellt. Die Zeit pro Aufgabe ist mit 38,7 Minuten lang.
Vorteile
- $2/$10, gleich wie Sol und Sonnet 5.5
- Automatisches Kontext-Caching ohne Einrichtung
- 1M-Token-Kontextfenster
Nachteile
- 46 auf Artificial Analysis, 11 Punkte unter Sol zum gleichen Token-Preis
- 38,7 Minuten pro Benchmark-Aufgabe
- K2-Modelle sind seit dem 31. Oktober 2026 für neue Nutzer geschlossen, ältere Leitfäden verweisen also möglicherweise auf Modelle, die du nicht nutzen kannst
Preise: $2 Input, $10 Output, $0,20 gecacht, $2 für 5-Minuten-Cache-Writes. Siehe Kimi-K3.1-Pro-Preise.
Fazit: einen Test wert, wenn du ein Nicht-US-Labor brauchst. Zum gleichen Preis erreicht Sol einen höheren Score auf dem gemeinsamen Index. Der Kimi-K3.1-Pro-Test geht tiefer.
10. Qwen4 Max
Am besten für: niedrige Output-Preise von einem großen Allzweckmodell.
Qwen4 Max wurde am 16. November 2026 allgemein verfügbar. In der Singapur-Region von Qwen Cloud kostet es $1,50 Input und $4,50 Output pro Million Token, mit Cache-Reads bei $0,075, laut Qwen Clouds Modellpreisen. Das Kontextfenster liegt bei 1M Token.
Artificial Analysis bewertet es mit 43 bei $3,27 pro Aufgabe. Das ist niedriger als Kimi K3.1 Pro und deutlich unter Sol, aber sein Output-Preis liegt bei etwa einem Neuntel von Astras.
Vorteile
- $4,50 Output, niedriger als jedes Modell hier außer DeepSeek und Gemini 3.8 Flash
- Cache-Reads bei $0,075
- Denk- und Nicht-Denk-Modi zum gleichen Preis
Nachteile
- 43 auf Artificial Analysis
- Preise variieren nach Region, die Singapur-Rate ist also nicht universell
- 31,9 Minuten pro Benchmark-Aufgabe
Preise: $1,50/$4,50 in Singapur, mit explizitem Caching bei $1,875 für 5-Minuten-Writes. Der Leitfaden Qwen-4-Max-Preise deckt die anderen Regionen ab.
Fazit: eine Budget-Wahl für unkomplizierte Arbeit. Für eine engere Übereinstimmung mit Astra schau weiter oben auf dieser Liste. Der Beitrag Qwen-4-Max-Alternativen vergleicht es mit seinen eigenen Konkurrenten.
Solltest du zwischen Modellen routen, statt zu wechseln?
Für die meisten Agenten-Produkte: ja. Wholesale von Astra zu einem günstigeren Modell zu wechseln bedeutet, dessen Schwachstellen bei jeder Aufgabe zu akzeptieren. Routing bedeutet, jede Aufgabe an das günstigste Modell zu schicken, das sie gut bewältigt.
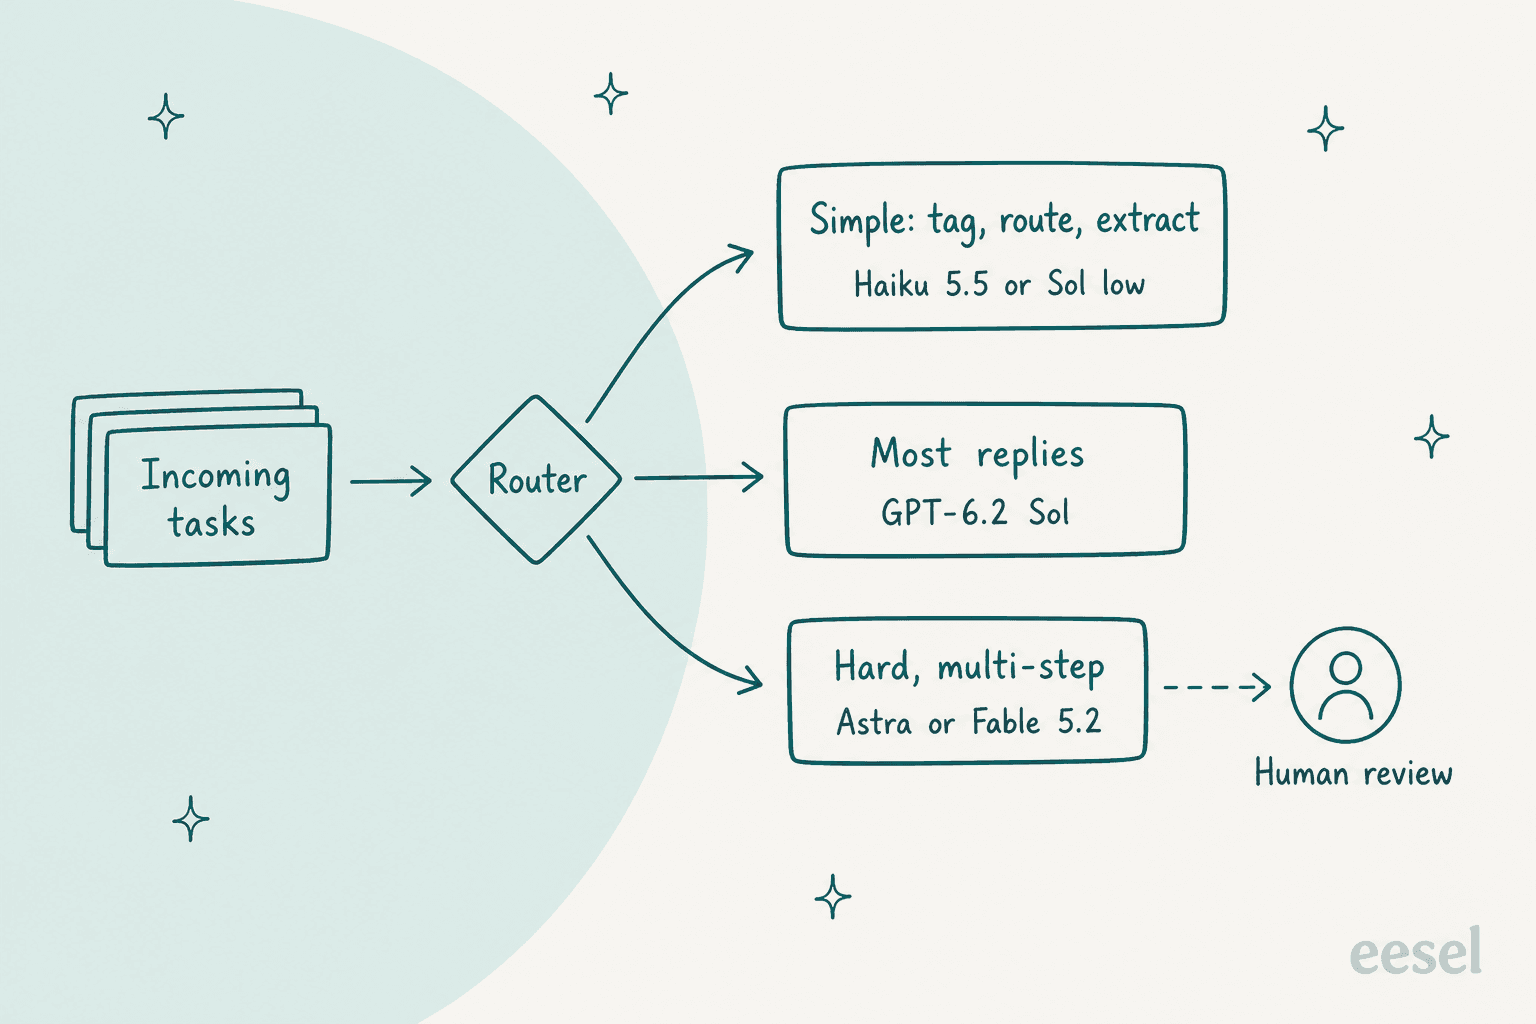
Ein Aufbau, mit dem ich anfangen würde:
- Einfache Aufgaben wie Tagging, Routing und Extraktion gehen an ein kleines Modell. Claude Haiku 5.5 kostet $0,10/$0,50 für Prompts bis zu 100.000 Token und kostete $0,41 pro Artificial-Analysis-Aufgabe, oder nutze Sol bei niedrigem Effort.
- Die meisten Antworten und Routine-Tool-Calls gehen an GPT-6.2 Sol, das Astra bei meinem gesamten Test erreichte.
- Schwierige mehrstufige Arbeit geht an Astra, oder an Fable 5.2, wenn der Einsatz $26,54 pro Aufgabe rechtfertigt.
- Alles Unsichere geht an einen Menschen.
Entwickler im Launch-Thread taten bereits eine Version davon:
"Opus medium as orchestrator and reviewer, Sol(high/medium)/Terra(max) as implementer."
Die gleiche Idee läuft bei Support-Warteschlangen. Intelligentes Routing schickt Tickets an die richtige Person; Modell-Routing schickt jeden Schritt an das richtige Modell. Die Aufschlüsselung KI-Agent gegen menschlichen Agent, Kosten zeigt, warum die günstige Spur bei großem Volumen wichtig ist.
Wie solltest du eine Alternative testen, bevor du wechselst?
Benchmarks sagen dir, welche Modelle in die Vorauswahl kommen. Nur deine eigenen Aufgaben sagen dir, welches du tatsächlich einsetzt. Hier ist der Prozess, den ich für den Sol-Test genutzt habe, hochskaliert.
- Zieh 100 bis 300 echte Aufgaben aus deinen Logs, einschließlich der unangenehmen: fehlgeschlagene Tool-Calls, vage Anfragen, andere Sprachen.
- Halte alles identisch außer dem Modell: gleicher System-Prompt, gleiche Werkzeuge, gleiche Limits.
- Bewerte Kosten pro erfolgreicher Aufgabe, nicht Kosten pro Call. Ein günstiges Modell, das zwei Wiederholungen braucht, ist nicht günstig.
- Lass jeden Aufbau bei dem Effort laufen, den du tatsächlich einsetzen würdest, da der Effort die Rechnung stärker verändert als der Listenpreis.
- Lies die Fehler von Hand. Ein falscher Rückerstattungsbetrag zählt mehr als ein etwas steifer Satz.
Für Support-Arbeit speziell deckt KI-Support-Agent-Tests ab, wie man dieses Testset aus vergangenen Tickets aufbaut. Der Benchmarking-Leitfaden deckt die Bewertung ab, und KI-Gespräche überprüfen deckt die laufende Kontrolle ab, sobald es live ist.
Was bedeutet das für ein Support-Team?
Wenn deine Agenten Kunden antworten, ist die Modellwahl die kleinere Entscheidung. Jedes Modell auf dieser Liste kann eine höfliche Antwort schreiben. Was entscheidet, ob es die richtige Antwort ist, ist das Wissen, das es liest, die Aktionen, die es ausführen darf, und was passiert, wenn es sich nicht sicher ist. Mein Test zeigte das direkt: Astra und Sol eskalierten die defekte Bestellabfrage beide korrekt, weil die Anweisungen es vorgaben, und beide hatten die Rückerstattungsmathematik richtig, weil die Richtlinie aufgeschrieben war.
Das ist die Ebene, die eesel baut. eesel ist eine KI-Teammitglied-Plattform: Du stellst einsatzbereite Teammitglieder für bestimmte Jobs ein, ein KI-Helpdesk-Teammitglied für deine Warteschlange und einen KI-Blog-Autor für Content. Das Modell ist der Motor; das Teammitglied ist der Mitarbeiter, der es antreibt, mit deinen Integrationen, deinem Wissen und deinen Leitplanken bereits eingerichtet. Bevor es einen echten Kunden beantwortet, wird es gegen deine vergangenen Tickets simuliert.
Swiftreg, das private Kennzeichen verkauft, zeigt, wie die Regel-Ebene in der Praxis aussieht. Seine eesel-Agenten bearbeiteten 2.100 Zendesk-Tickets in einem Monat, antworteten aus echten Bestelldaten unter Regeln, die Swiftreg selbst geschrieben hat. Sie schickten 1.500 öffentliche Antworten und ließen 1.050 interne Notizen, bei denen ein Schritt zum Personal gehört. SE Ranking betreibt einen eesel-Agenten pro Produkt über drei Produkte auf Zendesk und bearbeitete 4.650 Gespräche in einem Monat, indem es etwa 16.800 Seiten an Hilfe- und Website-Inhalten durchsuchte, bevor es antwortete.
Wenn du lieber von Code aus arbeitest, lässt dich der eesel CLI oder ein Coding-Agent wie Claude Code oder Codex das gleiche Teammitglied von einem Terminal aus steuern: freigegebene Hilfe-Artikel und Makros hochladen, die Anweisungen des Agenten anpassen und ihm Testfragen stellen, bevor irgendetwas live geht. Das Verbinden des Helpdesks selbst braucht immer noch die Freigabe eines Admins, und hochgeladenes Wissen wird getestet, bevor es als einsatzbereit zählt.
Es ist die gleiche Idee wie ein KI-Agenten-CLI, angewendet auf ein Support-Teammitglied. Ein MCP-Server ist die andere gängige Route. Wenn du abwägst, ob du das selbst auf Sol oder Astra verdrahten sollst, legt Build vs. Buy dar, was die Modellrechnung auslässt.
Probier eesel aus
Astra gegen Sol zu tauschen senkt deine Token-Rechnung. Es schreibt nicht deine Eskalationsregeln, verankert die Antworten nicht in deinem Help Center und testet den Agenten nicht an den Tickets des letzten Monats. eesels KI-Helpdesk-Teammitglied verbindet sich mit Zendesk, funktioniert genauso mit Freshdesk und dem Rest deines Stacks, lernt aus deinen vergangenen Tickets und zeigt dir, wie es sie beantwortet hätte, bevor es live geht.

Probier eesel aus, kostenlos auf einem Teil deiner Warteschlange, oder sieh dir Pläne und Preise an.