

GPT-6.2 Astra kostet 8 $ pro Million Input-Token, 0,40 $ im Cache und 40 $ Output, 20 % unter dem Listenpreis von GPT-6 Astra. Die größere Änderung ist die zwischengespeicherte Eingabe, die um 60 % sinkt. Bei einem Support-Agenten, der einen wiederverwendeten 12.500-Token-Prompt einsetzt, macht das etwa 35 % weniger pro Ticket (21,80 $ gegenüber 33,50 $ pro 1.000), aber nur wenn der Cache tatsächlich trifft: ein Fehlschlag kostet mehr als das Fünffache.
Behalten Sie drei Messgrößen im Blick: Prompts über 272.000 Token, den Fast-Modus und Ultrafast, das am 1. März 2027 von 3x auf 6x Standard steigt. Für die meisten Support-Aufgaben leistet GPT-6.2 Sol dieselbe Arbeit für ein Viertel des Preises.
Wie viel kostet GPT-6.2 Astra?
GPT-6.2 Astra kostet 8 $ pro Million Input-Token und 40 $ pro Million Output-Token in der Standard-Stufe, bei einer zwischengespeicherten Eingabe von 0,40 $. OpenAI veröffentlichte es am 17. November 2026 zusammen mit GPT-6.2 Sol, dem Nachfolger von GPT-6.1 Sol. Der Launch-Beitrag beschreibt den Preis als „einen Rabatt von 20 % auf Input- und Output-Token und einen tieferen Rabatt von 60 % auf zwischengespeicherte Input-Token" gegenüber GPT-6 Astra.
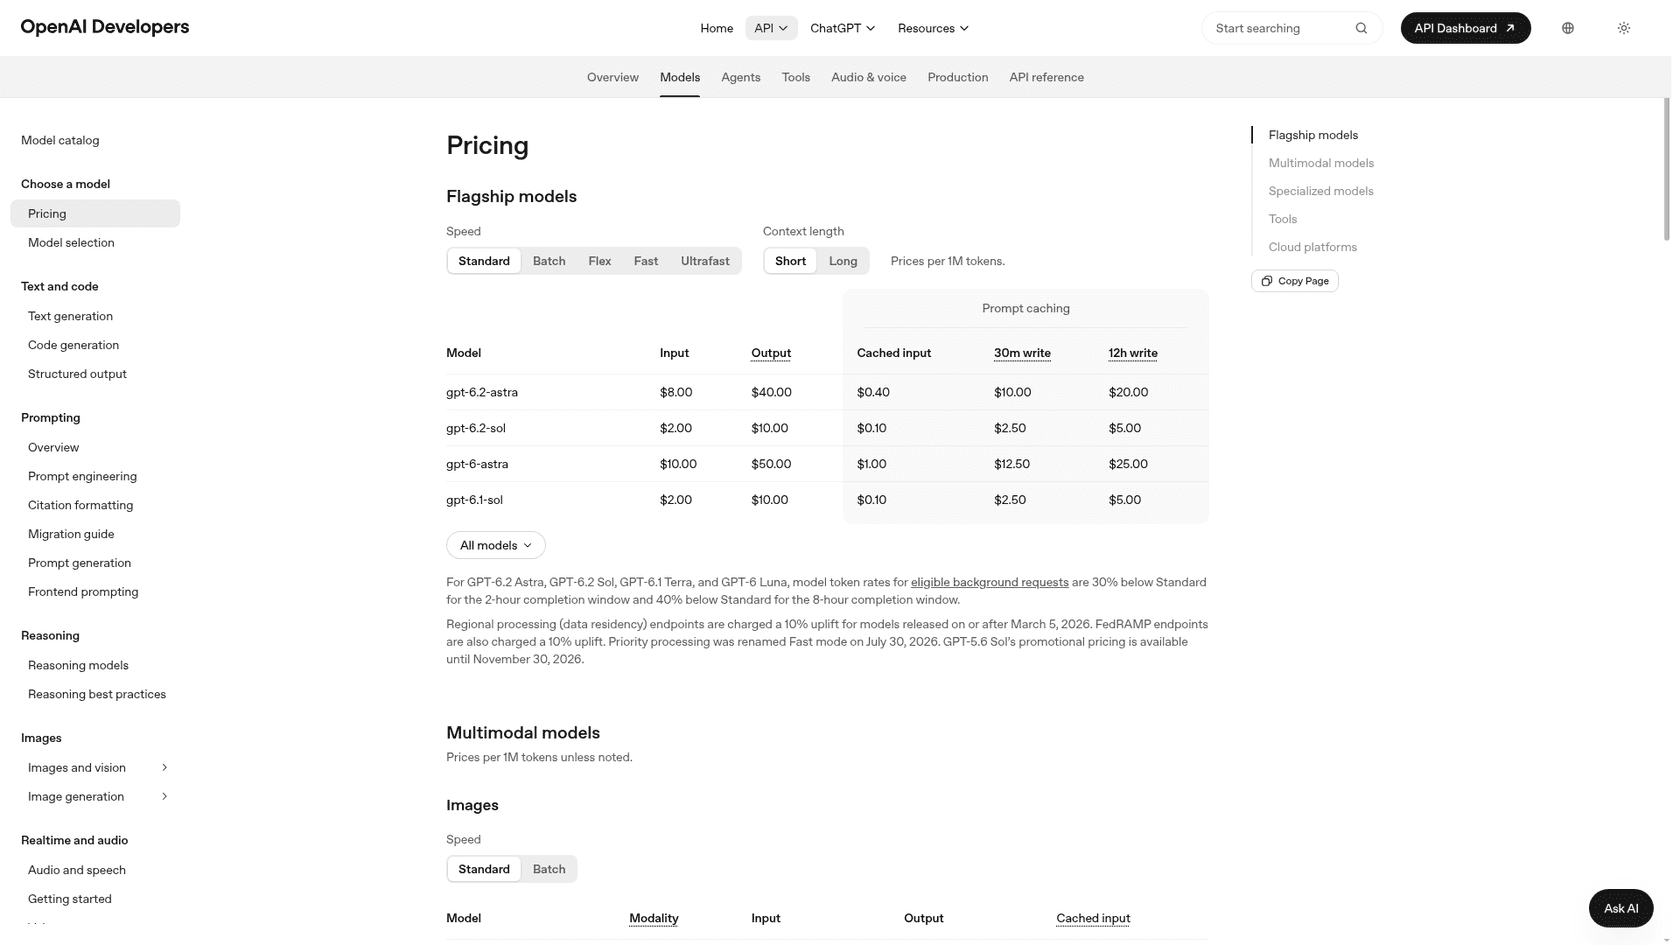
Ich baue bei eesel Integrationen und API-Anbindungen und setze seit einigen Jahren KI-Agenten auf laufende Support-Warteschlangen, daher rechne ich einen neuen Modellpreis zuerst in Kosten pro Ticket um. Der Listenpreis pro Million Token sagt fast nichts aus, solange Sie nicht wissen, auf welche Messgröße jedes Token fällt. Hier sind alle Messgrößen aus OpenAIs Preisseite und der GPT-6.2-Astra-Modellseite, pro Million Token:
| Stufe | Input | Zwischengespeicherte Eingabe | 30-Min.-Cache-Schreibvorgang | 12-Std.-Cache-Schreibvorgang | Output |
|---|---|---|---|---|---|
| Standard | 8,00 $ | 0,40 $ | 10,00 $ | 20,00 $ | 40,00 $ |
| Standard, über 272.000 Input | 16,00 $ | 0,80 $ | n/a | n/a | 60,00 $ |
| Batch | 4,00 $ | 0,20 $ | 5,00 $ | 10,00 $ | 20,00 $ |
| Fast | 16,00 $ | 0,80 $ | 20,00 $ | 40,00 $ | 80,00 $ |
| Ultrafast (bis 28. Feb. 2027) | 24,00 $ | 1,20 $ | 30,00 $ | 60,00 $ | 120,00 $ |
| Ultrafast (ab 1. März 2027) | 48,00 $ | 2,40 $ | 60,00 $ | 120,00 $ | 240,00 $ |
| Flex | nicht verfügbar |
Die Zeile zum Long-Context stammt von der Modellseite, die besagt, dass sich jenseits von 272.000 Input-Token „die Input- und Cache-Sätze verdoppeln und der Output das 1,5-Fache des Short-Context-Satzes für die gesamte Anfrage kostet." Sie nennt keine Long-Context-Preise für Cache-Schreibvorgänge, daher habe ich diese Felder lieber leer gelassen, als zu raten.
Das Modell selbst hat ein Kontextfenster von 1.050.000 Token, maximal 922.000 Input-Token und maximal 128.000 Output-Token. Eine weitere Zeile auf der Modellseite wirkt sich auf die Kosten aus: Die API lehnt Anfragen ab, die den Reasoning-Aufwand auf none setzen, sodass Sie das Reasoning nicht wie bei manchen Teams auf älteren Modellen abschalten können, um Output-Token zu sparen. Reasoning-Token werden laut OpenAIs Reasoning-Leitfaden als Output abgerechnet.
Wofür werden Sie genau abgerechnet?
Sie werden pro Token auf vier getrennten Messgrößen abgerechnet, und sie kosten drastisch unterschiedlich viel. Jede Anfrage teilt sich auf in:
- Input-Token zu 8 $ pro Million: alles Neue im Prompt, etwa die Nachricht des Kunden.
- Zwischengespeicherte Eingabe zu 0,40 $ pro Million: der Anfang des Prompts, der exakt mit einer kürzlichen Anfrage übereinstimmt, etwa Ihre Anweisungen und Help-Center-Texte.
- Cache-Schreibvorgänge zu 10 $ (30 Minuten) oder 20 $ (12 Stunden) pro Million: wenn ein wiederverwendbares Präfix zum ersten Mal gespeichert wird.
- Output-Token zu 40 $ pro Million: die Antwort, plus jedes Reasoning, das das Modell davor durchführt.
OpenAIs Leitfaden zum Prompt-Caching stellt klar, dass ein Cache-Schreibvorgang „keine zusätzliche Gebühr" ist. Jedes Input-Token wird einmal abgerechnet, entweder zum unzwischengespeicherten, zwischengespeicherten oder Schreib-Satz. Das kleinste cachefähige Präfix sind 1.024 Token bei GPT-5.6 und neueren Modellen.
Die Lücke zwischen diesen Messgrößen ist die ganze Geschichte. Ein zwischengespeichertes Token kostet ein Zwanzigstel eines frischen Input-Tokens und ein Hundertstel eines Output-Tokens. Die Form Ihres Prompts zählt also mehr als der Listenpreis in der Überschrift.
Um wie viel günstiger ist es in der Praxis als GPT-6 Astra?
Bei jeder Arbeitslast, die einen langen Prompt wiederverwendet, ist GPT-6.2 Astra etwa 35 % günstiger als GPT-6 Astra, nicht 20 %. Die zusätzliche Ersparnis kommt aus der Kürzung bei der zwischengespeicherten Eingabe.
Zur Überprüfung habe ich einen typischen Support-Agent-Aufruf durchgerechnet. Jedes Ticket sendet ein Präfix von 12.500 Token (Anweisungen plus Help-Center-Inhalt, in derselben Größe wie der Cache-Test, den ich am Launch-Tag durchgeführt habe), 600 Token neuen Input und 300 Output-Token einschließlich Reasoning. Unter der Annahme, dass das Präfix den Cache trifft:
| Modell | Zwischengespeicherte Eingabe | Input | Output | Pro Ticket | Pro 1.000 Tickets |
|---|---|---|---|---|---|
| GPT-6 Astra | 1,00 $ | 10 $ | 50 $ | 0,0335 $ | 33,50 $ |
| GPT-6.2 Astra | 0,40 $ | 8 $ | 40 $ | 0,0218 $ | 21,80 $ |
| GPT-6.2 Sol | 0,10 $ | 2 $ | 10 $ | 0,0055 $ | 5,45 $ |
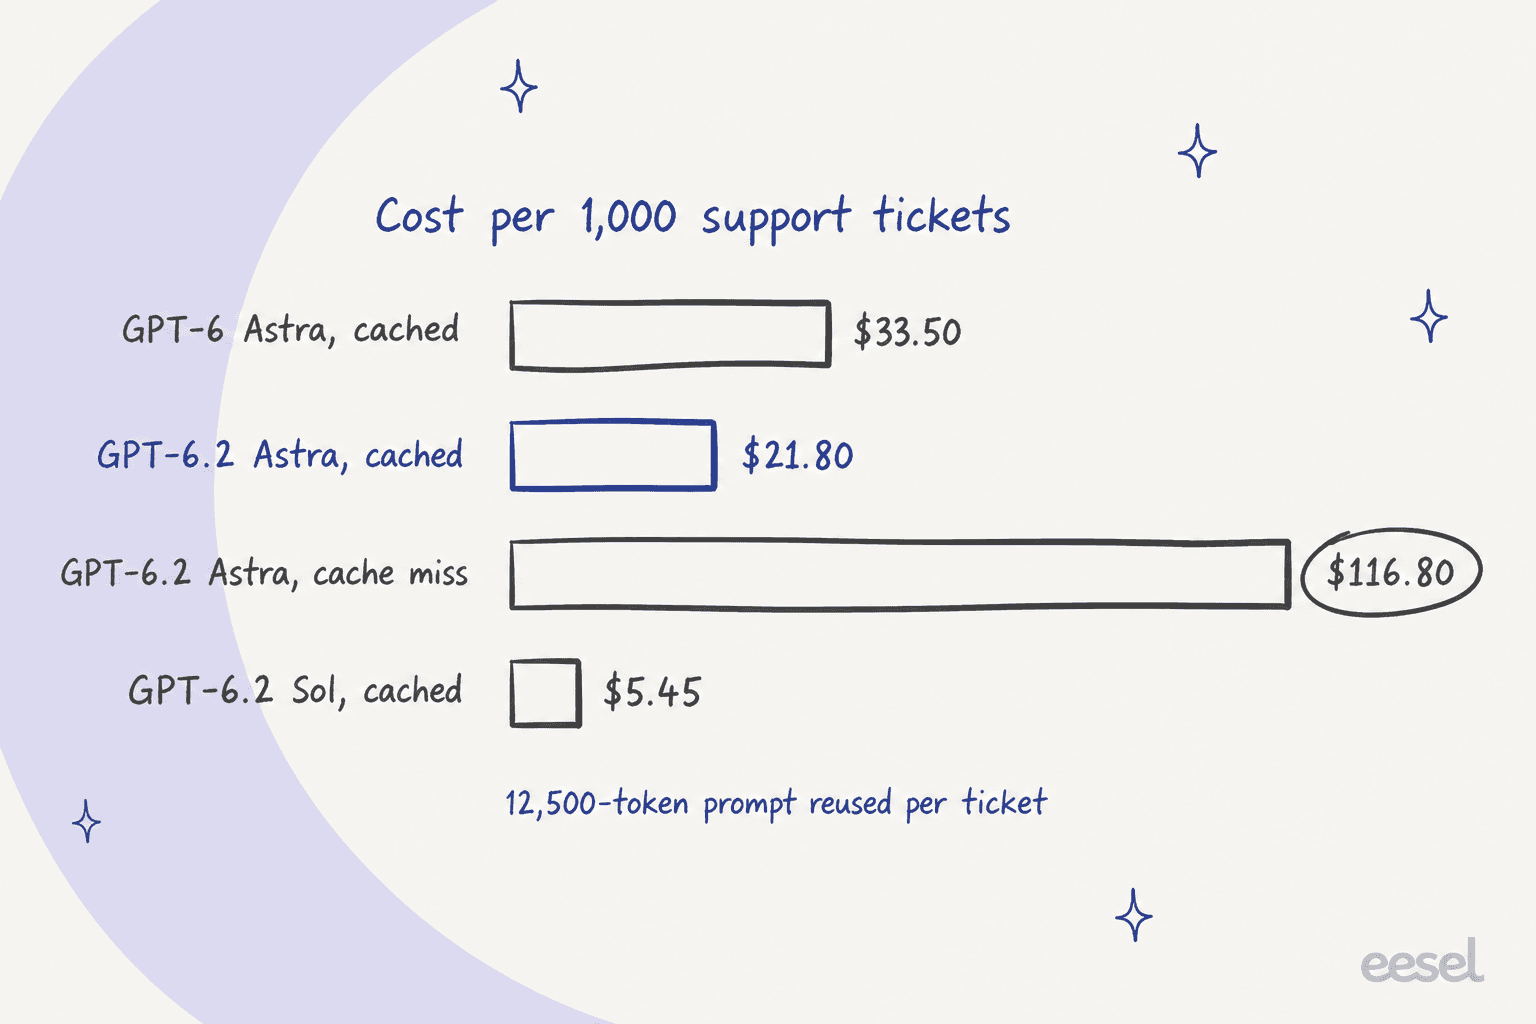
Zwei Dinge fallen auf. Erstens dominiert der wiederverwendete Prompt die Rechnung. In meinem Launch-Tag-Test von GPT-6.2 Astra mit einem winzigen 278-Token-Prompt ohne Help-Center-Inhalt kosteten 1.000 Tickets 5,79 $ bei mittlerem Aufwand. Fügen Sie das Wissen hinzu, das ein Agent wirklich braucht, und der Preis steigt um etwa das Vierfache, selbst wenn der Cache funktioniert.
Zweitens der Balken beim Cache-Fehlschlag. Wird dasselbe Präfix bei jedem Ticket als frischer Input abgerechnet, kostet GPT-6.2 Astra 116,80 $ pro 1.000 Tickets, mehr als das Fünffache des zwischengespeicherten Preises und mehr als GPT-6 Astra mit einem funktionierenden Cache. Ein verpasster Cache löscht den gesamten Upgrade-Rabatt aus und noch mehr.
Artificial Analysis sieht auf Benchmark-Ebene dieselbe Richtung: Sein vollständiger Intelligence Index kostet 4,00 $ pro Aufgabe bei GPT-6.2 Astra gegenüber 6,24 $ bei GPT-6 Astra, ein Rückgang von 36 %. Das kommt von günstigeren Token plus weniger davon, da OpenAI angibt, dass das Modell bei anspruchsvollen Aufgaben weniger Output-Token verwendet.
Was kostet Sie ein Cache-Fehlschlag wirklich?
Ein Cache-Fehlschlag kostet bei GPT-6.2 Astra etwa fünfmal so viel pro Ticket, und er lässt sich leichter auslösen, als man denkt. In meinem Launch-Tag-Test habe ich ein 12.500-Token-Help-Center in das oberste instructions-Feld der Responses API gelegt. Drei Aufrufe in Folge zeigten null zwischengespeicherte Token und null Cache-Schreibvorgänge. Denselben Text in eine Developer-Nachricht zu verschieben, löste das Problem: Der erste Aufruf schrieb 12.513 Token in den Cache, und die nächsten zwei lasen jeweils 12.501 Token.
OpenAIs Caching-Leitfaden erklärt einen Teil des Grunds. „Oberste instructions können keinen expliziten Breakpoint enthalten", heißt es dort, und wiederverwendbare Developer-Anweisungen gehören „in einen input_text-Block innerhalb einer Developer-Nachricht". Der Launch-Beitrag empfiehlt außerdem für beide 6.2-Modelle, „Prompt-Präfixe unverändert zu lassen und neue Anweisungen anzuhängen". Schreibt Ihre Integration den System-Prompt bei jeder Runde neu, um Kundendaten einzufügen, zahlen Sie für jedes Token davon den vollen Input-Satz.
Cache-Schreibvorgänge haben ihre eigene Rechnung. Ein 30-Minuten-Schreibvorgang eines 12.500-Token-Präfixes kostet 0,125 $, verglichen mit 0,10 $, um es einmal unzwischengespeichert zu senden. Der Schreibvorgang verliert also Geld, wenn niemand das Präfix wiederverwendet, und zahlt sich vom zweiten Treffer an aus. Bei den Sätzen von GPT-6.2 Astra kosten ein Schreibvorgang und neun Lesevorgänge das 1,70-Fache des reinen Input-Preises, gegenüber dem 10-Fachen ganz ohne Caching.
Der 12-Stunden-Schreibvorgang kostet doppelt so viel (0,25 $ für dieses Präfix). Für eine ruhige Warteschlange lohnt er sich: Treffen Tickets über Nacht mit mehr als 30 Minuten Abstand ein, läuft ein 30-Minuten-Cache immer wieder ab, und Sie zahlen jedes Mal erneut fürs Schreiben. Eine stark ausgelastete Warteschlange braucht ihn nicht, weil jeder Lesevorgang das 30-Minuten-Fenster erneuert. Sie können Trefferraten in OpenAIs Prompt-Caching-Dashboard beobachten, bevor Sie sich entscheiden.
Welche Stufen und Multiplikatoren verändern die Rechnung?
Acht Multiplikatoren liegen über dem Standard-Satz, und zwei davon sind groß genug, um mehr zu zählen als die Modellwahl. Hier sind sie auf einer Leiter:
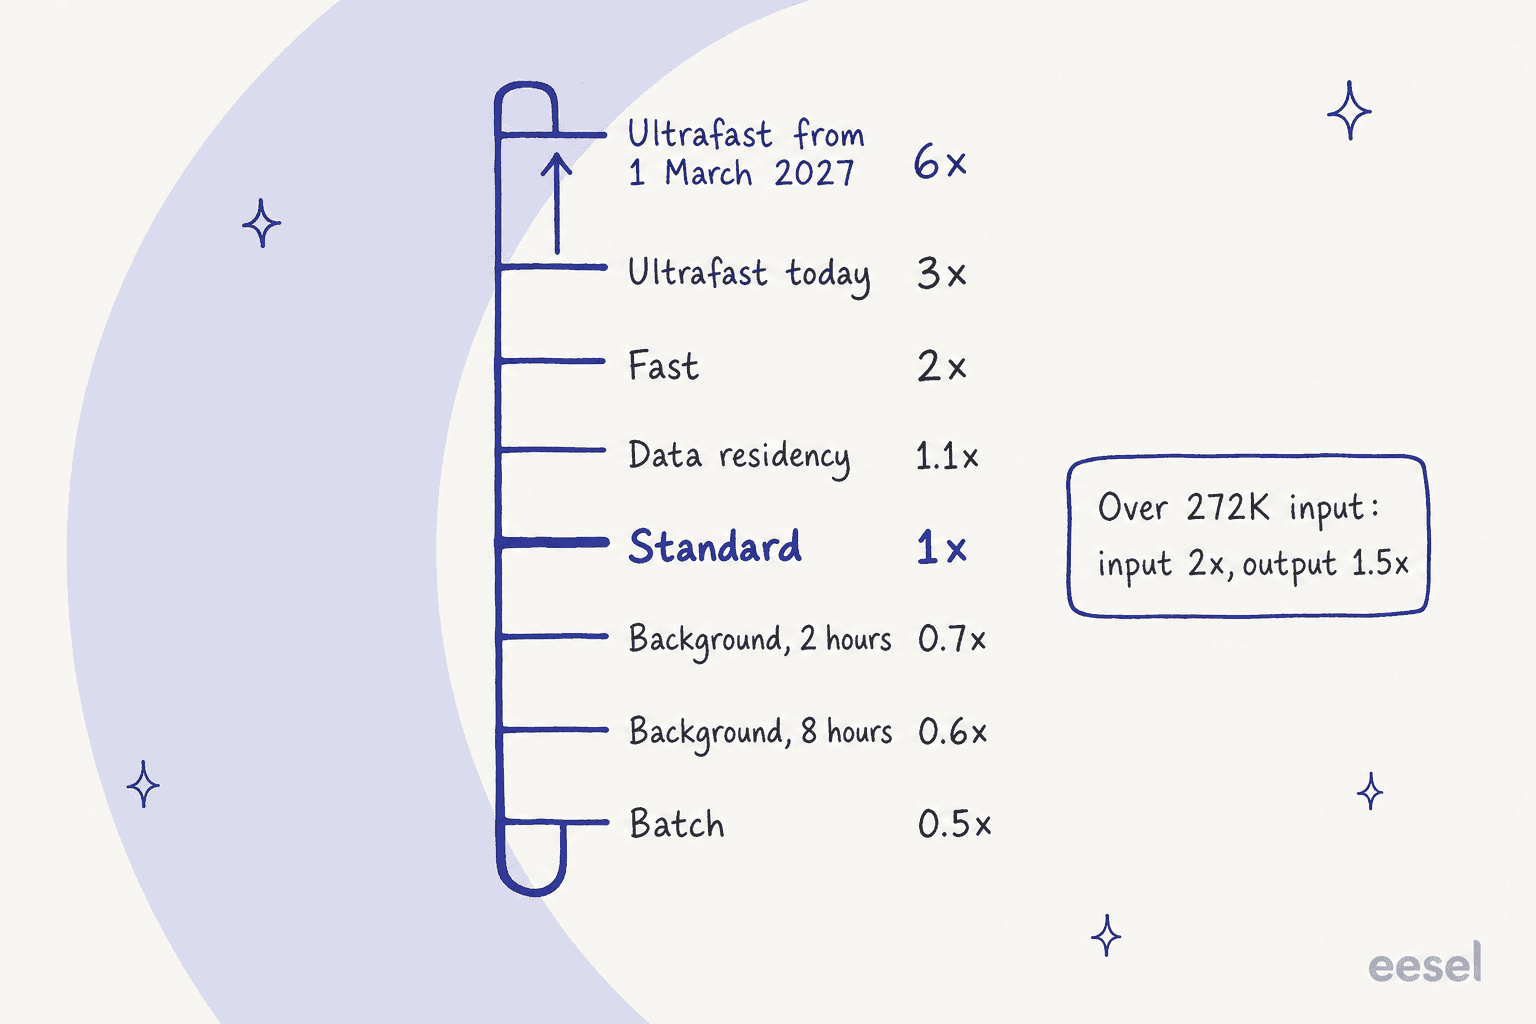
- Batch (0,5x). Die Batch-API halbiert jeden Satz, einschließlich zwischengespeicherter Eingabe und Schreibvorgängen. Sie passt zu Nachtjobs wie dem Taggen der Tickets vom letzten Monat oder dem Umschreiben von Hilfeartikeln, nicht zu Live-Antworten.
- Background-Anfragen (0,6x bis 0,7x). Laut Preisseite laufen geeignete Background-Anfragen in der Responses API „30 % unter Standard für das 2-Stunden-Fenster und 40 % unter Standard für das 8-Stunden-Fenster". Das ist in der öffentlichen Beta.
- Datenresidenz (1,1x). Regionale Verarbeitungs-Endpunkte tragen „einen Aufschlag von 10 % für Modelle, die am oder nach dem 5. März 2026 veröffentlicht wurden", was GPT-6.2 Astra einschließt. FedRAMP-Endpunkte tragen denselben Aufschlag von 10 %.
- Fast (2x). Der Fast-Modus, den OpenAI am 30. Juli 2026 von Priority Processing umbenannt hat, verdoppelt jeden Satz.
- Ultrafast (3x, dann 6x). Ultrafast kostet bis zum 28. Februar 2027 das 3-Fache des Standard-Satzes und ab dem 1. März 2027 das 6-Fache. Bauen Sie jetzt ein latenzkritisches Feature darauf, verdoppelt sich Ihre Rechnung an diesem Datum, ohne dass Sie Code ändern.
- Long Context (2x Input, 1,5x Output). Überschreiten Sie 272.000 Input-Token, wechselt die gesamte Anfrage zum höheren Satz, nicht nur die Token über der Grenze.
Die eine Stufe, die Sie vielleicht erwarten und nicht finden, ist Flex. Die Preisseite listet Flex für GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra und GPT-6 Luna, aber nicht für GPT-6.2 Astra. Batch und Background-Anfragen sind vorerst die Rabatt-Routen.
Die Long-Context-Regel ist am heimtückischsten. Eine einzelne Vertragsprüfung mit 400.000 Token und einer Antwort von 4.000 Token kostet 6,64 $ bei GPT-6.2 Astra. Dieselben Token zu Short-Context-Sätzen würden 3,36 $ kosten. Teilen Sie ein Dokument in Abschnitte unter 272.000, halbieren Sie die Input-Rechnung.
Was würde GPT-6.2 Astra für Ihr Volumen kosten?
Geben Sie unten Ihr eigenes Ticketvolumen und die Prompt-Form ein. Er berechnet dieselbe Arbeitslast für GPT-6.2 Astra, GPT-6 Astra und GPT-6.2 Sol, mit den Sätzen aus OpenAIs Preisseite. Cache-Fehlschläge werden als 30-Minuten-Cache-Schreibvorgänge abgerechnet, was beim impliziten Caching passiert, wenn das Präfix noch nicht gespeichert ist.
Ziehen Sie die Cache-Trefferrate von 95 % auf 0 %, und die Rechnung von GPT-6.2 Astra bei 8.000 Tickets springt von 222,40 $ auf 1.134,40 $ im Monat, etwa das Fünffache. Diese eine Einstellung verändert die Rechnung mehr als das Modell-Upgrade.
Was kostet es bei unterschiedlichen Teamgrößen?
Hier ist dieselbe Support-Arbeitslast bei drei monatlichen Volumen, zu Standard-Sätzen mit einer Cache-Trefferrate von 95 %. Fehlschläge werden als 30-Minuten-Cache-Schreibvorgänge abgerechnet:
| Tickets pro Monat | GPT-6.2 Astra | GPT-6.2 Astra, Batch | GPT-6 Astra | GPT-6.2 Sol |
|---|---|---|---|---|
| 1.000 | 27,80 $ | 13,90 $ | 40,69 $ | 6,95 $ |
| 8.000 | 222,40 $ | 111,20 $ | 325,50 $ | 55,60 $ |
| 50.000 | 1.390,00 $ | 695,00 $ | 2.034,38 $ | 347,50 $ |
Zum Vergleich: Der eesel-Kunde SamCart betreibt einen Agenten für Freshdesk-Tickets und einen weiteren für den Website-Chat, der aus rund 280 Help-Center-Artikeln antwortet, auf einem Plan, der 8.000 Interaktionen im Monat abdeckt. Diese mittlere Zeile entspricht in etwa diesem Volumen. Rein an Token gemessen liegt die Modellrechnung bei ein paar hundert Dollar im Monat, bevor überhaupt jemand die Retrieval, das Function Calling für Bestellabfragen, die Eskalationsregeln oder die Observability geschrieben hat, um zu sehen, was es gesagt hat.
Das ist die ehrliche Form der KI-Kundenservice-Kosten: Die Token sind die kleine Zeile, und die Retrieval-Schicht gehört zur größeren. Das Engineering und die Pflege rund um beides sind der große Posten, weshalb die Kosten eines KI-Agenten weit mehr von Bauen oder Kaufen abhängen als davon, welches Modell Sie wählen.
Ist GPT-6.2 Astra günstiger als Claude Fable 5.2?
Token für Token: nein, sie haben denselben Listenpreis, und Fables Cache ist günstiger. Pro erledigter Aufgabe ist GPT-6.2 Astra deutlich günstiger. Anthropics Preisseite listet Claude Fable 5.2 mit 8 $ Input und 40 $ Output pro Million Token, exakt gleich wie Astra, mit Cache-Treffern bei 0,20 $.
| Pro Million Token | GPT-6.2 Astra | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|---|
| Input | 8,00 $ | 8,00 $ | 4,00 $ | 2,00 $ |
| Output | 40,00 $ | 40,00 $ | 20,00 $ | 10,00 $ |
| Cache-Lesevorgang | 0,40 $ | 0,20 $ | 0,20 $ | 0,10 $ |
| Günstigster Cache-Schreibvorgang | 10,00 $ (30 Min.) | 10,00 $ (5 Min.) | 5,00 $ (5 Min.) | 2,50 $ (30 Min.) |
| Lange Prompts | 2x Input, 1,5x Output über 272.000 | Gleicher Satz bis 1 Mio. | Gleicher Satz bis 1 Mio. | 2x Input, 1,5x Output über 272.000 |
| AA Intelligence Index | 62 | 65 | 59 | 57 |
Bei meiner Support-Arbeitslast mit zwischengespeichertem Präfix kommt Fable 5.2 tatsächlich etwas günstiger heraus (19,30 $ gegenüber 21,80 $ pro 1.000 Tickets) wegen dieses 0,20-$-Cache-Lesevorgangs. Und für eine einzelne Anfrage mit 400.000 Token kostet Fable 3,36 $, wo Astra 6,64 $ kostet, weil Anthropic „denselben Satz pro Token" über das gesamte 1-Millionen-Kontextfenster berechnet.
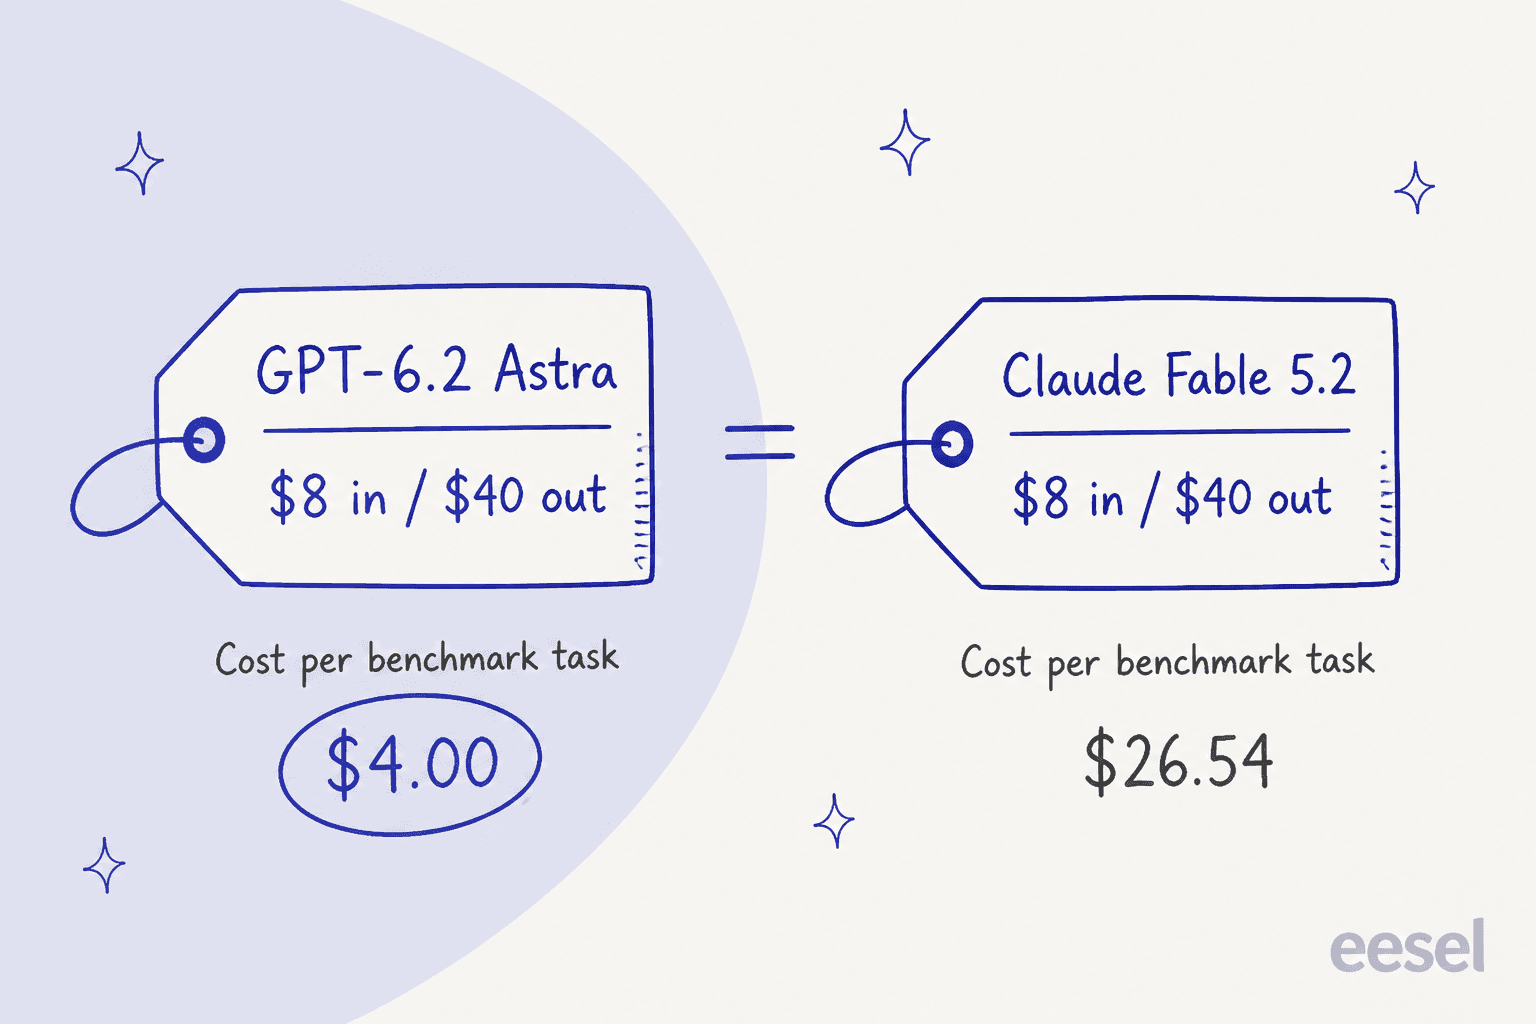
Die Sicht pro Aufgabe dreht es um. Artificial Analysis setzt die Kosten, um seinen Intelligence Index laufen zu lassen, auf 4,00 $ pro Aufgabe für GPT-6.2 Astra gegenüber 26,54 $ für Claude Fable 5.2, weil Astra deutlich weniger Token braucht, um zu einer Antwort zu kommen. Fable erzielt trotzdem die höhere Punktzahl, 65 gegenüber Astras 62. Bei langen Agenten-Aufgaben, bei denen das Modell viel schreibt und nachdenkt, zählt die Token-Zahl mehr als die Preistabelle. Bei kurzen, cache-intensiven Aufrufen wie Support-Antworten zählt die Preistabelle mehr.
Die richtige Vergleichsgrundlage hängt also von Ihrer Arbeitslast ab. Für kurze Antworten mit einem großen wiederverwendeten Prompt vergleichen Sie die Cache-Sätze. Für lange, offene Arbeit vergleichen Sie die Kosten pro Aufgabe. Claude Opus 5.5 liegt dazwischen, bei der Hälfte des Token-Preises von Astra und einer niedrigeren Punktzahl. Die Zusammenstellung Alternativen zu GPT-6 Astra deckt den Rest des Feldes ab.
Was kostet GPT-6.2 Astra in ChatGPT?
In ChatGPT zahlen Sie ein flaches Abonnement, nicht pro Token. OpenAI gibt an, dass GPT-6.2 Astra und Sol „für alle Plus-, Pro-, Enterprise- und Edu-Nutzer in ChatGPT Work und Codex verfügbar" sind, wobei Enterprise und Edu Zugriff erhalten, sobald ein Workspace-Admin ihn aktiviert.
| Plan | Preis | Zugriff auf GPT-6.2 Astra |
|---|---|---|
| Free | 0 $ | Nicht im Launch-Beitrag genannt |
| Go | 8 $/Monat | Nicht im Launch-Beitrag genannt |
| Plus | 20 $/Monat | Ja, in ChatGPT Work und Codex |
| Pro | Ab 100 $/Monat (Pro 100, Pro 200, Pro 500) | Ja; Pro 500 erhält damit auch Ultrafast |
| Enterprise und Edu | Vertrieb kontaktieren | Ja, sobald ein Admin es aktiviert |
Die Preise stammen von ChatGPTs Preisseite. Die Pro-Stufen enthalten außerdem monatliche API-Guthaben: 100 $ bei Pro 100, 200 $ bei Pro 200 oder 500 $ bei Pro 500. Bei meinem zwischengespeicherten Support-Satz von 21,80 $ pro 1.000 Tickets deckt ein Guthaben von 500 $ etwa 22.900 GPT-6.2-Astra-Tickets im Monat, solange Sie OpenAIs Teilnahmebedingungen für das Guthaben erfüllen. Die vollständige Plan-Aufschlüsselung finden Sie im Leitfaden ChatGPT-Preise.
Lohnt sich GPT-6.2 Astra für den Kundensupport?
Für die meisten Support-Warteschlangen ist GPT-6.2 Astra mehr Modell, als die Aufgabe braucht. In meinem Launch-Tag-Test haben GPT-6.2 Sol und GPT-6.2 Astra alle 15 Testtickets korrekt bearbeitet, einschließlich Rückerstattungsrechnung, einer Prompt-Injection und einer fehlgeschlagenen Bestellabfrage, und Sol kostete etwa ein Viertel so viel. OpenAIs Agent-Evals-Tooling kann dieselbe Art Prüfung auf Ihren eigenen Tickets durchführen. Astra verdient seinen Preis bei langer, mehrstufiger Arbeit wie Finanzmodellen, juristischer Recherche und Tabellenkalkulationen, wofür OpenAI es auch vorsieht.
Es gibt auch einen Grund jenseits der Kosten, Astra von unüberwachten Kundenantworten fernzuhalten. Artificial Analysis stellte fest, dass seine Halluzinationsrate bei unbekannten Fakten bei maximalem Aufwand von 50 % auf 59 % gegenüber GPT-6 Astra anstieg. Das macht die Absicherung und die Halluzinationsprävention-Schicht wichtiger als die Modellwahl, egal welches Sie betreiben.
Die größere Budgetfrage ist, ob Sie überhaupt eine Token-Rechnung wollen. Die Token-Preise bewegen sich mit jeder Prompt-Änderung, jedem Cache-Fehlschlag und jeder Preisaktualisierung wie der Ultrafast-Änderung im März. Eine Engineering-Leitung bei einem Krypto-Hardware-Unternehmen mit einer Wissensdatenbank von über 300 Artikeln brachte die Entscheidung so auf den Punkt, als sie sich für eesel entschied:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Das ist die Abwägung zwischen Bauen oder Kaufen in einem Satz. Wenn Sie auf GPT-6.2 Astra bauen, planen Sie die Token und die Pflege ein. Wenn Sie kaufen, planen Sie eine feste monatliche Zahl ein und verwenden Ihre Zeit darauf, den Agenten zu testen, statt an echten Tickets.
eesel ausprobieren
Wenn Sie die Preise von GPT-6.2 Astra prüfen, weil Sie KI in Ihrer Support-Warteschlange wollen, gibt Ihnen eesel das ohne Token-Rechnung zum Beobachten. Der KI-Helpdesk-Mitarbeiter bindet sich in den Helpdesk ein, den Sie bereits nutzen, etwa Zendesk oder Freshdesk, lernt aus Ihren vergangenen Tickets und dem Help Center und läuft auf einem festen monatlichen Plan. Bevor er einem echten Kunden antwortet, können Sie ihn gegen Ihre historischen Tickets laufen lassen und jede Antwort lesen.

Entwickler können dasselbe Setup über die eesel CLI steuern: Ein KI-Coding-Agent wie Claude Code oder Codex kann freigegebenes Wissen wie exportierte Hilfeartikel und Makros hochladen, dem Agenten Testfragen stellen und die Antworten prüfen, bevor etwas live geht. Den Helpdesk selbst anzubinden, braucht weiterhin jemanden mit Admin-Zugriff, der das freigibt.
Sie können eesel kostenlos ausprobieren auf einem Teil Ihrer Warteschlange, Pläne und Preise ansehen, oder es mit der direkten Nutzung von ChatGPT vergleichen, falls Sie noch entscheiden, ob Sie es selbst bauen wollen.