

Mistral Large 4 Preise im Überblick
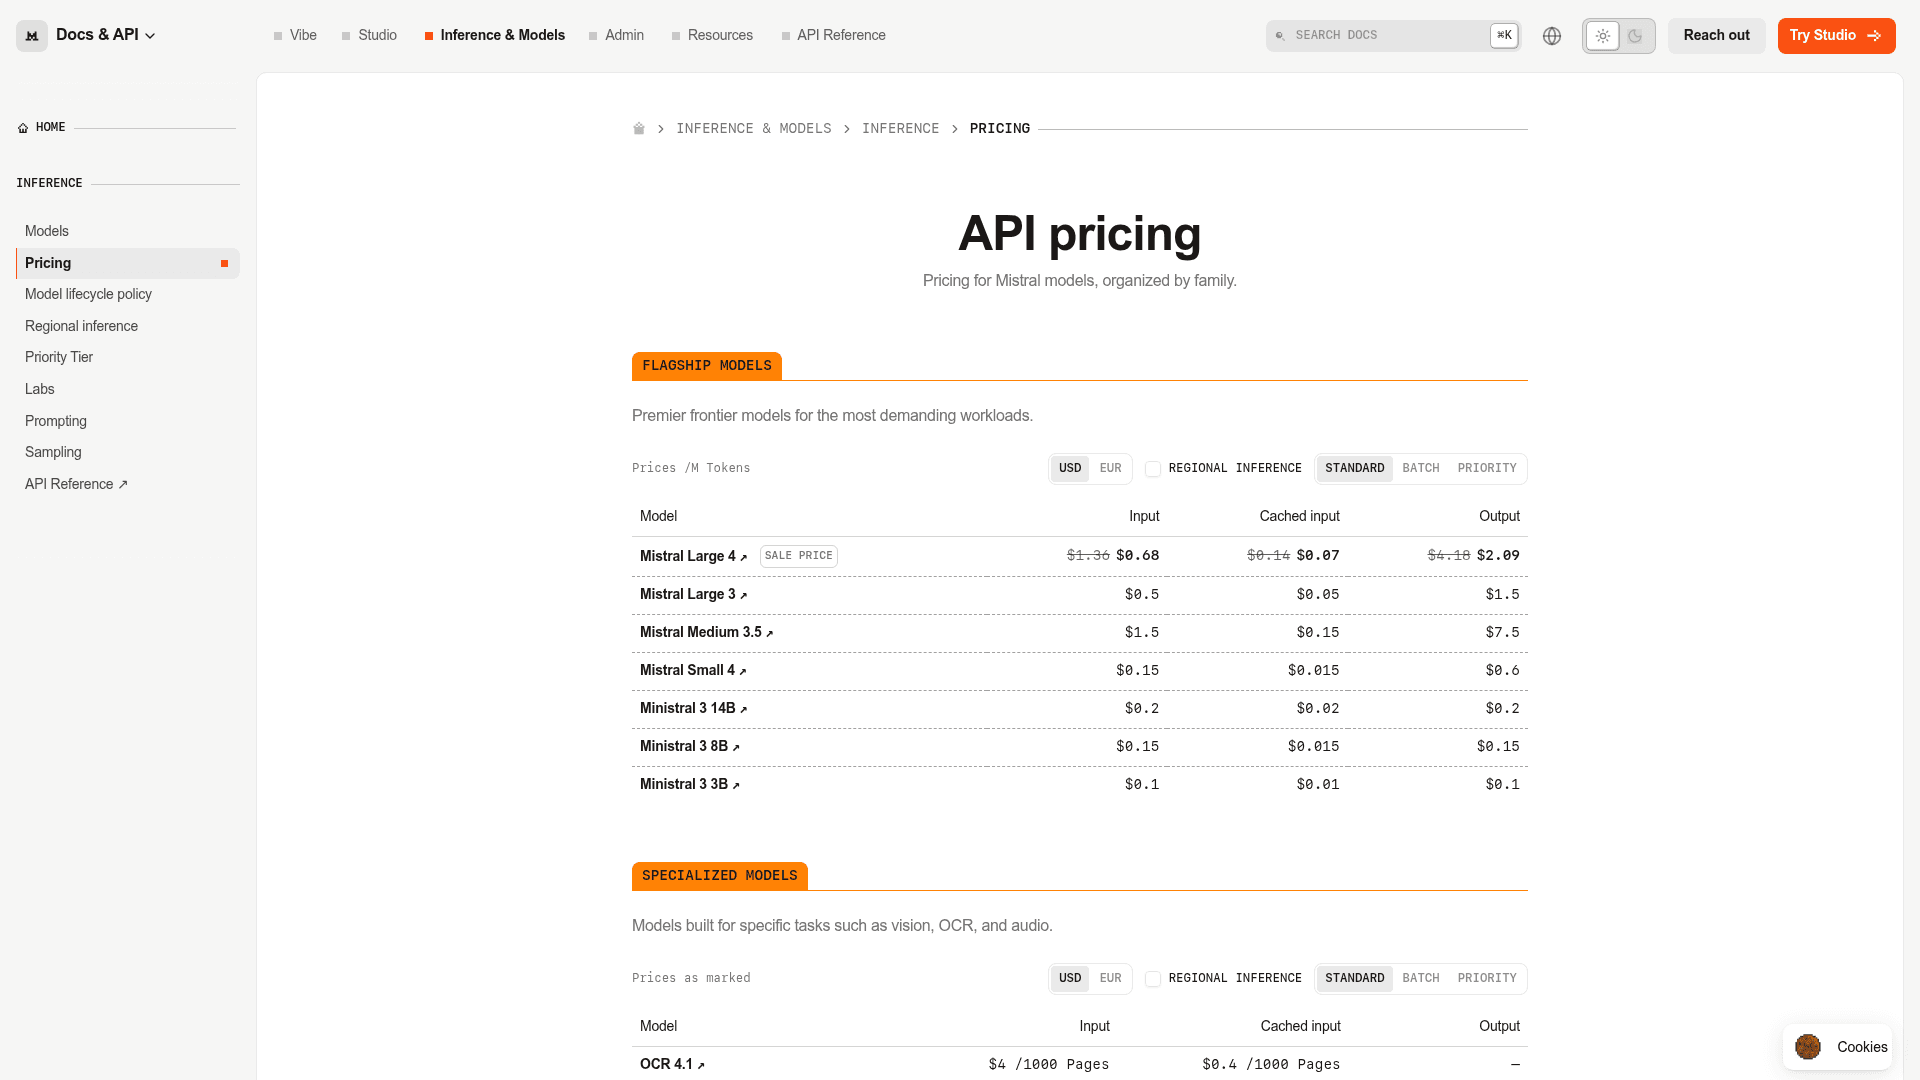
Ich baue bei eesel die API-Integrationen, und das Helpdesk-Teammate läuft auf Modellen von OpenAI, Anthropic und Google. Ein großer Teil meiner Woche besteht also darin, Tariftabellen zu lesen und dann hinter die Schlagzeilenzahl zu schauen. Mistrals Tariftabelle für Large 4 ist kurz, verbirgt aber mehr, als sie zeigt. Hier ist alles von Mistrals API-Preisseite für die Flaggschiff-Familie, Standard-Tier, Stand 8. Oktober 2026.
| Modell | Input (pro 1M) | Gecachter Input (pro 1M) | Output (pro 1M) | Hinweise |
|---|---|---|---|---|
| Mistral Large 4 (Angebot) | $0.68 | $0.07 | $2.09 | Öffentliche Preview, 1M Kontext |
| Mistral Large 4 (Liste) | $1.36 | $0.14 | $4.18 | Auf der Seite durchgestrichen |
| Mistral Large 3 | $0.50 | $0.05 | $1.50 | Vorheriges Flaggschiff, noch gelistet |
| Mistral Medium 3.5 | $1.50 | $0.15 | $7.50 | Vorheriges Reasoning-Modell |
| Mistral Small 4 | $0.15 | $0.015 | $0.60 | Budget-Tier |
| Ministral 3 14B | $0.20 | $0.02 | $0.20 | Kleines dichtes Modell |
| Z.ai GLM 5.3 (von Mistral gehostet) | $1.40 | $0.14 | $4.40 | Modell eines Drittanbieters |
Ein paar Dinge sollten Sie wissen, bevor Sie diese Zahlen in eine Tabelle übernehmen:
- Das Angebot ist exakt 50% Rabatt, bei allen drei Messgrößen. Die Modellkarte von Large 4 zeigt dasselbe Durchstreichmuster und nennt kein Enddatum.
- Mistrals eigener Launch-Beitrag nennt den Listenpreis. Die Ankündigung von Mistral Large 4 nennt $1.36 / $4.18, das Angebot ist also eine aufgesetzte Aktion, nicht der "echte" Preis.
- Gecachter Input ist ein Rabatt von 90%. $0.07 gegenüber $0.68 im Angebot. Bei diesem Modell zählt das mehr als sonst, warum, erkläre ich weiter unten.
- Large 4 kostet pro Token mehr als Large 3. Der Listenpreis stieg von $0.50 / $1.50 auf $1.36 / $4.18, grob das 2,7-Fache beim Input und das 2,8-Fache beim Output. Selbst im Angebot sind es 36% mehr beim Input und 39% mehr beim Output.
Für die Vorgeschichte, wie Mistral hierher kam, deckt meine Übersicht zu neuen Mistral-Modellen die Launches von Large 3 und Medium 3.5 ab.
Was "Angebotspreis" bei einem Preview-Modell wirklich bedeutet
Large 4 ist in Mistrals API eine Public Preview, und das Label ändert, wie Sie den Preis lesen sollten. Mistrals Richtlinie zum Modell-Lebenszyklus sagt drei Dinge über Preview-Modelle, die für Käufer wichtig sind:
- Sie werden zum selben Tarif wie Modelle mit General Availability berechnet. Das Angebot ist also kein "Preview-Rabatt", der designbedingt bei GA verschwindet. Es ist eine separate Aktion.
- Es gibt keinen garantierten Weg zu General Availability, und sie können vorher eingestellt werden.
- Die Abkündigungsfrist für ein Preview-Modell beträgt 1 Monat, gegenüber 6 Monaten für ein GA-Modell. Nach der Einstellung geben Anfragen ein
404zurück.
Zusammengenommen ist der sichere Planungswert der Listenpreis, plus ein Migrationsplan, den Sie in vier Wochen umsetzen könnten. Mistral-Mitgründer Guillaume Lample auf X hat bereits gesagt, dass die finale Version kommt:
"The RL run behind this preview is still in flight and shows no sign of saturation -- we will release a final version before the end of the month along with the weights of the model."
Das Lifecycle-Dokument vermerkt außerdem, dass Preview-Modelle keinen -latest-Alias nutzen können und dass Aliase "may expose you to silent updates in model behavior and pricing." Mein Rat ist derselbe wie bei jedem Modell in Produktion: Fixieren Sie die exakte Versionskennung und kalkulieren Sie neu, wenn Sie wechseln.
Ein Token, vier Preise: Batch, Standard, Regional und Priority
Die Preisseite hat Tabs für Standard, Batch und Priority sowie einen Schalter für regionale Inferenz, während die Multiplikatoren auf separaten Dokumentationsseiten stehen. Die meiste Berichterstattung zu Mistral Large 4 überspringt diesen Teil, und hier kann sich die Rechnung mehr als verdreifachen.
| Tier | Preisgestaltung | Input / gecacht / Output pro 1M | Latenz | Uptime-SLA |
|---|---|---|---|---|
| Batch | 50% Rabatt | $0.34 / $0.035 / $1.045, wenn er sich mit dem Angebot kumuliert; $0.68 / $0.07 / $2.09 auf Listenbasis | In der Warteschlange, bis zu 24 Stunden | Keine |
| Standard (Angebot) | Launch-Aktion | $0.68 / $0.07 / $2.09 | Sekunden bis Minuten | Keine |
| Standard (Liste) | Tariftabelle | $1.36 / $0.14 / $4.18 | Sekunden bis Minuten | Keine |
| Regional (EU oder US) | 1,1x Standard-Liste | $1.496 / $0.154 / $4.598 | Sekunden bis Minuten | Keine |
| Priority Tier | 1,75x Standard-Liste | $2.38 / $0.245 / $7.315 | Sekunden | 99,5% |
Die Quellen für jede Zeile:
- Batch. Mistrals Dokumentation zur Batch-Verarbeitung verspricht "a 50% discount" und bis zu 1 Million Anfragen pro Batch. Die Dokumentation sagt nicht, ob der Rabatt auf den Angebots- oder den Listenpreis gilt. Beachten Sie, dass 50% auf den Listenpreis exakt den aktuellen Angebotspreis ergeben.
- Regionale Inferenz. Die Seite zur regionalen Inferenz sagt, sie werde "billed at 1.1× standard list pricing (a 10% upcharge) for input tokens, output tokens, cached reads, and cache writes." Die Regionen sind derzeit die EU und die USA.
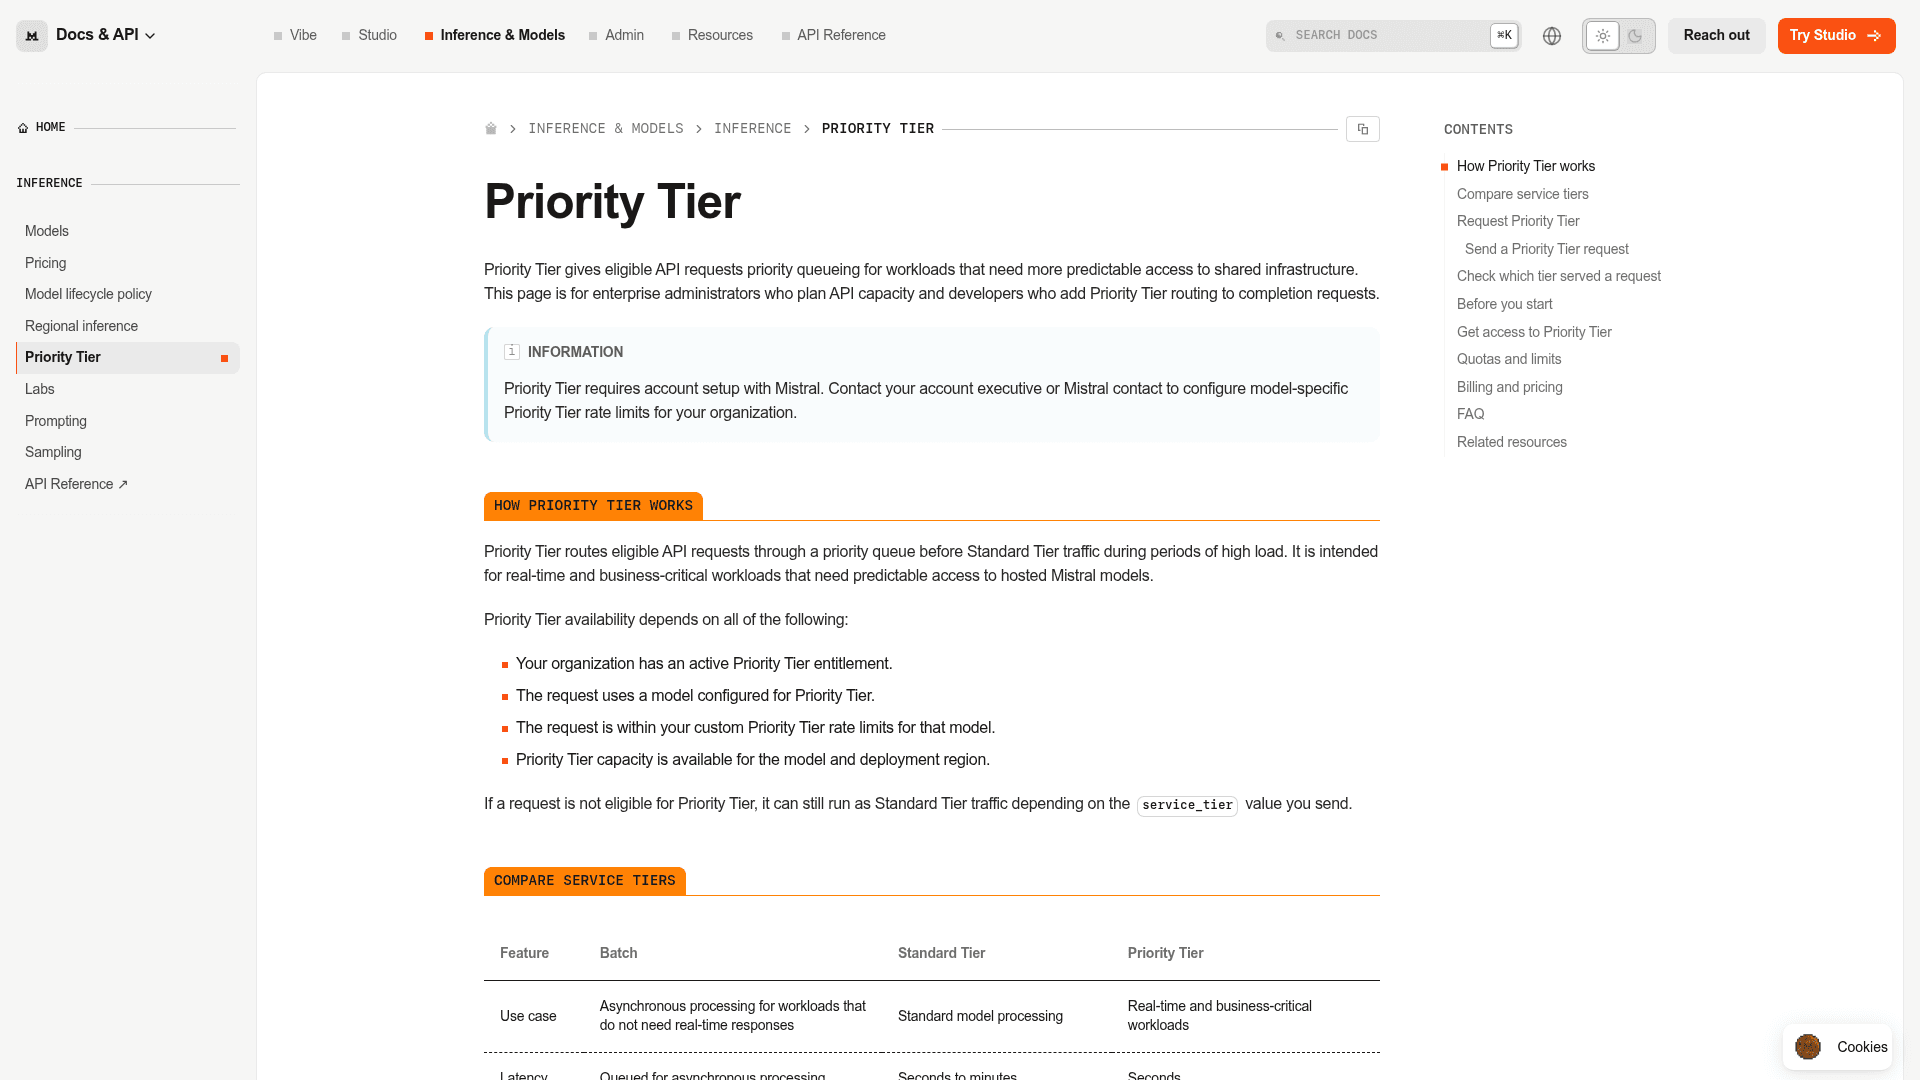
- Priority Tier. Die Priority-Tier-Seite sagt, der Multiplikator "is 1.75x standard list pricing." Er erfordert eine Einrichtung über den Vertrieb, fällt bei Überschreiten Ihrer Limits auf Standard zurück und ist der einzige Tier mit Uptime-SLA.
Das zählt bei Mistral mehr als bei den meisten Anbietern. Der stärkste Grund, Mistral zu wählen, ist, dass es europäisch ist. Mistrals eigener Launch-Beitrag auf X beginnt damit:
"Forged in Europe end-to-end and is deployable from Europe via our own Mistral Cloud infrastructure."
Aber der Endpunkt, der garantiert, dass die Inferenz innerhalb der EU läuft, ist der regionale, und sein Multiplikator von 1,1x bezieht sich auf den Listenpreis. Beide Dokumentationsseiten sind allgemein gehalten und sagen nichts zum Angebot von Large 4, Mistral könnte den Multiplikator in der Praxis also auf den rabattierten Tarif anwenden. Darauf würde ich nicht kalkulieren. Wenn Residenz der Grund für den Kauf ist, kalkulieren Sie mit etwa dem 2,2-Fachen des Schlagzeilenpreises, bis Ihre Rechnung etwas anderes sagt.
Dieselbe Logik gilt für ein Support-Team, das ein SLA braucht. Der Priority Tier ist die einzige Option mit einem, und bei 1,75x Liste sind es $7.32 pro 1M Output-Tokens und $2.38 Input. Dieser Input-Tarif liegt über den $2, ab denen die Claude-Sonnet-5.5-Preise beginnen, und der Output-Tarif liegt deutlich näher an Sonnets $10 als an den $2.09 der Schlagzeile.
Warum der Token-Preis die Rechnung unterschätzt
Tariftabellen vergleichen Modelle pro Token, aber Ihre Rechnung vergleicht sie pro Job. Bei Reasoning-Modellen widersprechen sich die beiden Rankings. Ein Reasoning-Modell schreibt vor der Antwort einen langen internen Entwurf, und Sie zahlen für jedes Wort davon den Output-Tarif.
Artificial Analysis hat den vollständigen Intelligence Index auf Mistral Large 4 Preview laufen lassen und eine Kostenaufschlüsselung veröffentlicht. Zum Listenpreis kostete der gesamte Lauf $1,601.97, und so verteilte sich das Geld:
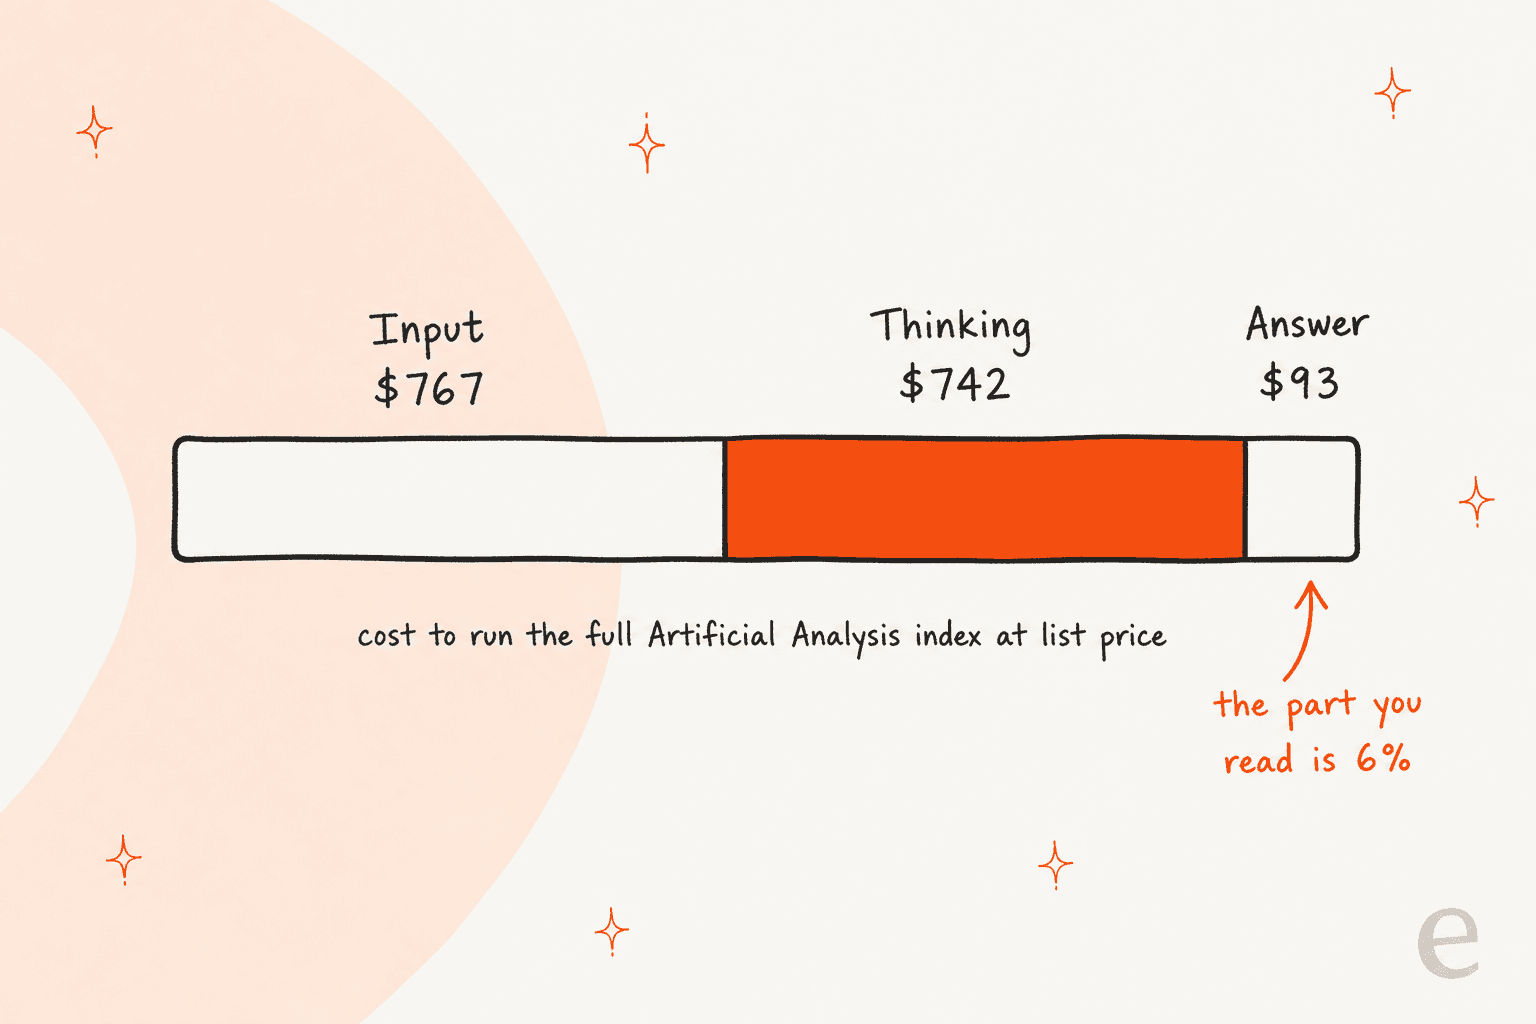
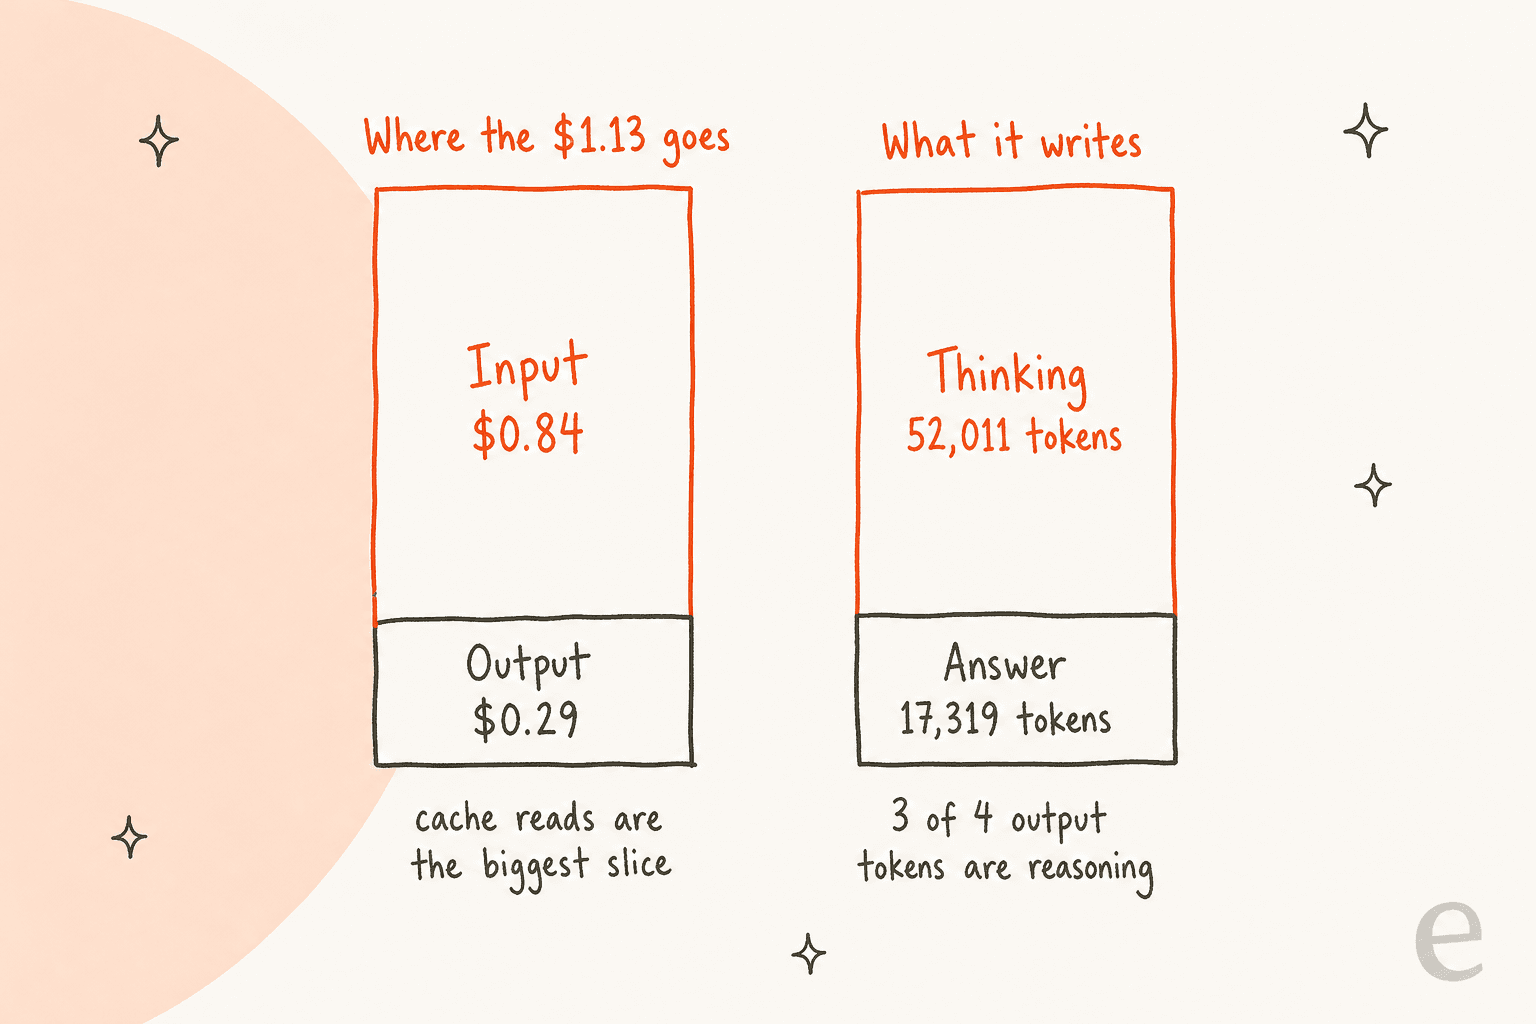
- Reasoning-Output: $742.45. Large 4 erzeugte im Schnitt 69,330 Output-Tokens pro Aufgabe, davon 52,011, also 75%, Reasoning.
- Input: $766.79, davon $479.04 Cache-Lesezugriffe. Lange agentische Aufgaben senden ihren Kontext in jeder Runde erneut, weshalb sich der Cache-Rabatt von 90% technisch lohnt.
- Die Antwort, die Sie tatsächlich lesen: $92.73. Das sind unter 6% der Rechnung.
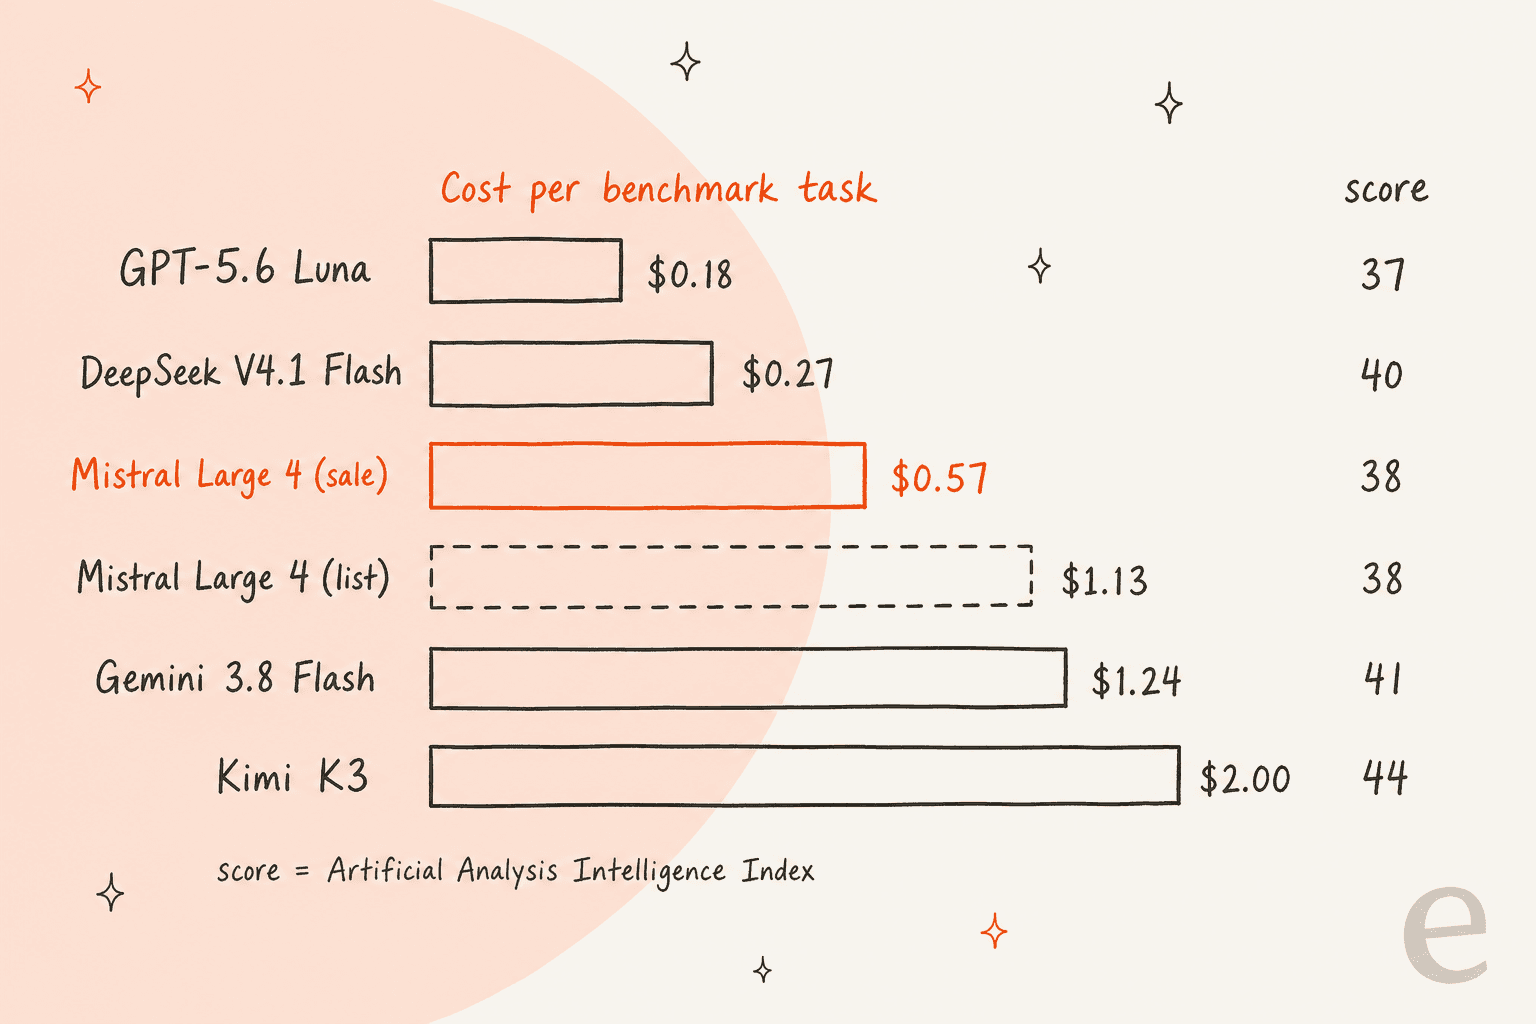
Die nützliche Einheit sind also die Kosten pro Aufgabe. Artificial Analysis beziffert Large 4 auf $1.13 pro Index-Aufgabe zum Listenpreis, was beim Angebotstarif grob $0.57 ergibt, wenn sich jede Messgröße halbiert. Daneben vergleicht die Tabelle Modelle, die im selben Index in der Nähe landen.
| Modell | Intelligence Index | Preis Input / Output pro 1M | Kosten pro Index-Aufgabe | Output-Tokens pro Aufgabe |
|---|---|---|---|---|
| GPT-5.6 Luna (Max) | 37.3 | $0.20 / $1.20 | $0.178 | 41,235 |
| DeepSeek V4.1 Flash (Max) | 39.5 | $0.30 / $1.20 | $0.265 | 88,574 |
| Mistral Large 4 Preview (Angebot, abgeleitet) | 38.4 | $0.68 / $2.09 | ~$0.57 | 69,330 |
| Mistral Large 4 Preview (Liste) | 38.4 | $1.36 / $4.18 | $1.132 | 69,330 |
| Gemini 3.8 Flash (High) | 40.9 | $0.75 / $3.75 | $1.243 | 71,003 |
| Kimi K3 (Max) | 43.6 | $3 / $15 | $2.000 | 48,455 |
| Claude Sonnet 5.5 (Xhigh) | 51.9 | $2 / $10 | $2.012 | 74,810 |
Alle Zahlen stammen von der Artificial-Analysis-Seite des jeweiligen Modells, abgerufen am 8. Oktober 2026; die Zeile mit dem Angebotstarif ist meine Rechnung. Mein Fazit: Selbst im Angebot kostet Large 4 pro Aufgabe etwa das Doppelte von DeepSeek V4.1 Flash, bei einem Score innerhalb von etwa einem Punkt (die Tarife des älteren Modells stehen in meinem Leitfaden zu den DeepSeek-V4-Flash-Preisen). Es ist pro Aufgabe günstiger als Kimi K3, aber Kimi erreicht 5 Punkte mehr. Dasselbe gilt für Gemini 3.8 Flash, dessen Tarife in meinem Leitfaden zu den Gemini-3.8-Flash-Preisen stehen.
Leser auf Hacker News bemerkten am Launch-Tag dieselbe Spannung. Ein Kommentator mochte die Tariftabelle, war aber nicht überzeugt:
"The pricing ($.68 in/$.07 cached/$2.09 out) makes it much cheaper than Kimi K3, GLM 5.3, and Meta Muse Spark 1.3. That's great! But also much more expensive than GLM 5.3-flash and Spark 1.3 Contributor (the Meta-takes-your-data pricing of Spark 1.3)."

Ein anderer Kommentator verwies auf einen anderen Benchmark, bei dem die Kosten pro Test selbst gegenüber einem pro Token teureren Konkurrenten in die andere Richtung gingen:
"Otherwise, behind on the broader Pareto frontier, but not by much (Vals Index: 48.05% vs. GLM-5.3's 53.51%; $13.78 vs. $7.25 per test). Many companies will prefer it over Chinease models."
Das zweite Zitat ist die ganze Lektion in einer Zeile: GLM 5.3 kostet auf Mistrals eigener Preisliste pro Token mehr ($1.40 / $4.40 gegenüber Liste $1.36 / $4.18) und kam in diesem Lauf trotzdem günstiger pro Test heraus, weil es weniger Tokens brauchte.
Mistral-Large-4-Kostenrechner
Geben Sie Ihr eigenes Aufkommen ein. Der Rechner nutzt die oben genannten veröffentlichten Tarife pro 1M, wendet die Multiplikatoren für Regional und Priority auf den Listenpreis an, wie Mistrals Dokumentation es beschreibt, und behandelt Batch als 50% auf den Angebotstarif. Output-Tokens sollten Reasoning einschließen, das bei Large 4 laut Artificial Analysis im Schnitt etwa 3 Reasoning-Tokens pro Antwort-Token ausmacht.
Rechenbeispiele: Was drei reale Workloads kosten würden
Abstrakte Zahlen nickt man leicht ab. Das hier sind Workloads, die ich tatsächlich jemanden kalkulieren sehen würde, durchgerechnet mit den veröffentlichten Tarifen.
| Workload | Annahmen | Angebot | Liste | Regional | Priority |
|---|---|---|---|---|---|
| Support-Chatbot | 20.000 Konversationen/Monat, je 8.000 Input-Tokens (70% gecacht), 1.200 Output-Tokens | $90.64 | $181.28 | $199.41 | $317.24 |
| Derselbe Bot, ohne Caching | Wie oben, 0% gecacht | $158.96 | $317.92 | $349.71 | $556.36 |
| Agentische Aufgaben | 1.000 Aufgaben/Monat in der Größe des Artificial-Analysis-Index | ~$566 | $1,132 | ~$1,245 | ~$1,981 |
| Batch-Dokumentenverarbeitung | 1M Dokumente, je 3.000 Input- + 500 Output-Tokens | $3,085 | $6,170 | n/a | n/a |
Drei Erkenntnisse aus dieser Tabelle:
- Caching ist mehr wert als das Angebot. Beim Support-Bot kommt Caching zum Listenpreis ($181) fast an den Angebotspreis ohne Cache ($159) heran. Wenn Sie Prompts so aufbauen, dass der System-Prompt und Teile der Wissensdatenbank vorn stehen und stabil bleiben, behalten Sie den Großteil dieser Ersparnis auch nach dem Ende des Angebots.
- Die Tier-Wahl bewegt die Rechnung stärker als die Modell-Wahl. Derselbe Bot reicht von $91 bis $317 im Monat, nur abhängig davon, welcher Mistral-Tier ihn bedient.
- Beim Batch-Dokumentenjob glänzt das Angebot von Large 4. Wenn sich der Batch-Rabatt mit dem Angebotspreis kumuliert, fällt dieser Job mit 1M Dokumenten auf etwa $1,542. Wenn nicht, landet er bei $3,085, was immer noch der Angebotstarif ist.
Vibe-Pläne: Brauchen Sie die API überhaupt?
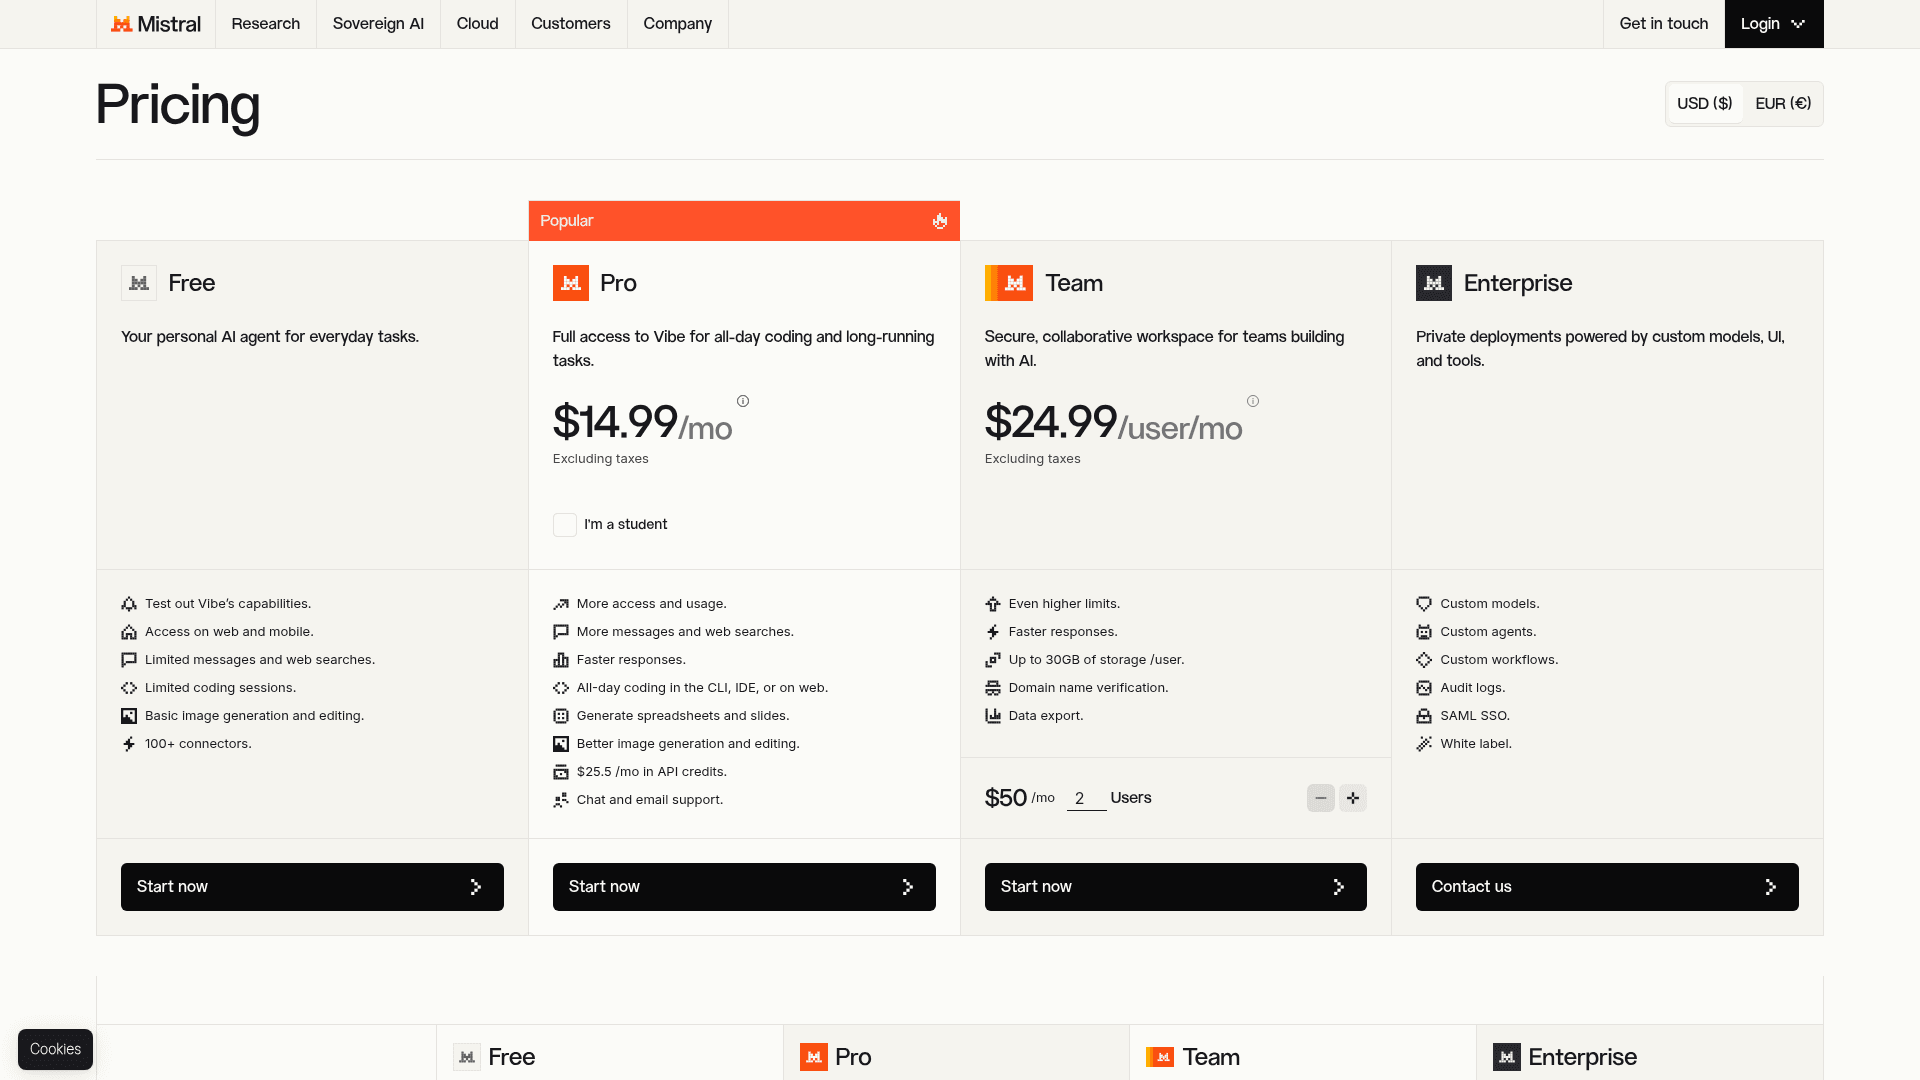
Wenn Sie Mistrals Modelle nur für die eigene Arbeit nutzen und nicht darauf aufbauen wollen, ist die Verbraucherseite Vibe (das Produkt, das früher Le Chat hieß). Preise von Mistrals Preisseite:
| Plan | Preis | Was Sie bekommen |
|---|---|---|
| Free | $0 | Begrenzte Nachrichten, Websuchen und Coding-Sitzungen, 100+ Konnektoren, Zugang zu Mistral Studio |
| Pro | $14.99/Monat | Mehr Nutzung, ganztägiges Coding in CLI, IDE oder Web, $25.50/Monat an API-Guthaben |
| Pro (Studierende) | $5.99/Monat | Verifizierte Studierende; $15/Monat an API-Guthaben |
| Team | $24.99/Nutzer/Monat | Höhere Limits, bis zu 30GB Speicher pro Nutzer, Domain-Verifizierung, Datenexport; der Rechner der Seite beginnt bei 2 Nutzern ($50/Monat) |
| Enterprise | Vertrieb kontaktieren | Eigene Modelle und Agenten, Audit-Logs, SAML SSO, White Label |
Ein Detail ist erwähnenswert: Der Pro-Plan enthält $25.50 im Monat an API-Guthaben. Zum Angebotstarif sind das etwa 12M Output-Tokens von Large 4, reichlich für Prototypen, bevor Sie sich auf die API festlegen. Was die Seite nicht sagt, ist, welche Vibe-Pläne Large 4 in der Chat-App selbst ausführen, gehen Sie also nicht davon aus, dass Free das Flaggschiff bekommt. Meine Übersicht zu Mistral-AI-Bewertungen und der Vergleich ChatGPT vs. Mistral behandeln Vibe als Arbeitsumgebung ausführlicher.
Self-Hosting: Der Preis, nachdem die Gewichte erscheinen
Mistral sagt, Large 4 sei Open-Weight, mit Gewichten "end of October" angekündigt. Heute ist keine Lizenz genannt und es gibt keine öffentlichen Gewichte, also ist der Self-Hosting-Preis noch eine Prognose. Zwei Fakten prägen diese Prognose.
Erstens die Größe. Die Modellkarte nennt 1.05T Parameter insgesamt und 52B aktive, plus einen 1.6B-Vision-Encoder. Ein Modell mit 1T Parametern zu betreiben braucht einen Multi-GPU-Server, keinen Laptop. Die am häufigsten gelikte Antwort auf Mistrals Launch-Tweet bringt es besser auf den Punkt, als ich es könnte:
"me with 12 GB of VRAM reading "open weights, 1.05T parameters""
Zweitens die Lizenz. Mistrals Preis-FAQ sagt, seine Open-Weight-Modelle seien "Apache 2.0 licensed for research/individual use; while commercial deployments require a Mistral license with separate terms." Dieser Satz bezieht sich auf ältere Modelle wie Mistral 7B, und die Lizenz von Large 4 ist nicht veröffentlicht, aber er ist ein Grund, nicht anzunehmen, "Open Weights" heiße "kostenlos für den kommerziellen Einsatz". Wenn Self-Hosting Ihr Plan ist, warten Sie auf den Lizenztext, bevor Sie die GPUs kalkulieren. Bis dahin sind Open-Source-KI-Agenten auf Basis bereits veröffentlichter Modelle die sicherere Wahl.
Lohnt sich Mistral Large 4 für den Preis?
Die Antwort hängt davon ab, für welche von Mistrals Stärken Sie bezahlen, also würde ich konkret werden.
Es lohnt sich, wenn:
- Sie EU-gehostete Inferenz von einem europäischen Anbieter brauchen. Das ist der klarste Fall, und selbst bei 1,1x Liste zahlen Sie $4.60 pro 1M Output-Tokens, was immer noch deutlich unter den meisten US-Frontier-Modellen liegt. Ein Reddit-Kommentator in r/singularity formulierte den Kompromiss deutlich:
"In most corporate workflows, it is probably good enough. And you don't have to sell your soul to Xi or Trump. As a european, I had feared much worse."

- Ihre Arbeit zu seinen Benchmark-Stärken passt. Mistrals Diagramme zeigen es vorn bei Cyber-Abwehr und Harveys Benchmark für Rechtsagenten, und Lample sagt, es erreiche 82% bei der Reproduktion und Behebung von Schwachstellen. Für solche Jobs sind $0.57 pro Aufgabe ein gutes Preis-Leistungs-Verhältnis.
- Sie große Batch-Jobs während des Angebots laufen lassen. Dokumentenarbeit mit langem Kontext zu $0.68 Input ist günstig, und Artificial Analysis bewertet das Reasoning mit langem Kontext mit 81.3%.
Verzichten Sie, wenn:
- Sie das günstigste Modell auf diesem Intelligenzniveau wollen. DeepSeek V4.1 Flash und GPT-5.6 Luna kommen bis auf etwa einen Punkt heran, bei einem Drittel bis der Hälfte der Kosten pro Aufgabe. Meine DeepSeek-V4-Flash-Bewertung deckt die DeepSeek-Seite ab. Für OpenAIs Tiers siehe GPT-5.6-Preise.
- Faktentreue wichtig ist. Artificial Analysis maß eine Halluzinationsrate von 41.9% in seinem Wissenstest AA-Omniscience. Bei allem, was kundennah ist, heißt das: Jede Antwort in Ihren eigenen Dokumenten verankern mit RAG.
- Sie ein Jahr lang stabile Preise brauchen. Ein Preview-Modell mit 1 Monat Abkündigungsfrist und einem undatierten Angebot ist ein bewegliches Ziel.
Für einen breiteren Blick darauf, wie sich Large 4 schlägt, siehe meine Übersicht zu Mistral Large 4 oder die Liste der Mistral-Alternativen.
Wenn Sie zwischen Anbietern statt Modellen wählen, vergleicht Claude vs. Mistral die kompletten Produkte. Das tut auch meine Gegenüberstellung Gemini vs. Mistral.
Was der Token-Preis für Support-Teams auslässt
Viele, die Large 4 diese Woche bewerten, tun das für einen Job: einen Support-Bot. Wenn Sie das sind, zeigt die Tabelle oben den unangenehmen Teil bereits. Selbst zu Priority-Tarifen liegt die Modellrechnung für 20.000 Konversationen bei ein paar hundert Dollar. Teuer ist alles um das Modell herum: Retrieval, Fallbacks, Tests, die Helpdesk-Anbindung und auch die Person, die das alles pflegt.
Das ist der Kompromiss, den Karel von GENERAL BYTES, ein eesel-Kunde, beschrieb, als man sich gegen den Eigenbau entschied:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Was ein günstigeres Modell ebenfalls nicht behebt, ist ein Bot, der antwortet, wenn er es nicht sollte. Bei einer Halluzinationsrate von 41.9% bei Wissensfragen zählen die Kontrollen mehr als die Tariftabelle: nur aus den eigenen Dokumenten antworten, bei Unsicherheit mit einem Human in the Loop übergeben und vor dem Livegang an echten früheren Tickets testen. Mein Beitrag zu KI-Halluzinationen im Support behandelt die Fehlerarten.
Wenn Sie noch bei der Modellwahl sind, gehen meine Leitfäden zum besten LLM für den Support und zum Trainieren eines KI-Support-Agenten auf beide Hälften des Jobs tiefer ein.
Wie ich es sehe, ist das Modell Infrastruktur, und was ein Support-Team einstellen möchte, ist die Mitarbeiterin, die es nutzt. Für einen weiteren Blick auf diese Kategorie siehe die Übersicht zur besten KI-Helpdesk-Software.
eesel ausprobieren
Wenn Sie hier waren, um Mistral Large 4 für einen Support-Bot zu bewerten, gibt es eine Abkürzung. Das KI-Helpdesk-Teammate von eesel schließt sich Ihrer bestehenden Zendesk-, Freshdesk- oder Gorgias-Queue an, lernt aus Ihren früheren Tickets und Ihrem Help Center und führt eine Simulation an Hunderten Ihrer früheren Tickets durch, bevor es je einem Kunden antwortet. Es wird pro bearbeitetem Ticket abgerechnet, ab $299 für 500 Credits auf der Preisseite. Ob das Modell darunter 1,000 oder 50,000 Tokens lang denkt, ist also eeseels Problem, nicht Ihre Rechnung. Zwei ehrliche Anmerkungen: eesel läuft auf Modellen von OpenAI, Anthropic und Google, nicht Mistral, und EU-Datenresidenz ist ein Add-on für $500/Monat.

Entwickler können es auch über ein Terminal einrichten: Die eesel CLI gibt für jeden Befehl JSON aus, sodass Claude Code oder Cursor Ihr Helpdesk verbinden, Anweisungen bearbeiten und Test-Chats für Sie ausführen können. Der kostenlose Plan enthält 100 Credits ohne Karte. eesel testen.